
09 de setembro de 2026
Segmentação de Mercado: Aplicação de Técnicas de Clusterização para Orientar Iniciativas de Marketing
Artur de Menezes Venâncio Martins; Fernando Celso de Campos
DOI: 10.22167/2675-6528-202602128
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A segmentação de mercado é uma prática fundamental para direcionar estratégias de marketing eficazes. O trabalho teve como objetivo elaborar um protocolo de análise de dados para direcionar estratégias de marketing, utilizando segmentação de consumidores por meio de aprendizado de máquina não supervisionado, com base em variáveis demográficas e comportamentais. Para isso, implementou-se o algoritmo K-Means, após um pré-processamento do conjunto de dados que incluiu tratamento de variáveis, exclusão de dados faltantes, escalonamento, padronização e redução de dimensionalidade por Análise de Componentes Principais (PCA). A determinação do número ótimo de agrupamentos foi realizada pelos métodos cotovelo e silhueta. A análise resultou na criação de três clusters de consumidores, validados por visualização 2D via PCA e t-SNE, que demonstraram robustez e consistência. Identificaram-se três perfis: Clientes Econômicos (mais jovens, menor renda e consumo, mais filhos), Clientes Moderados (mais velhos, renda e consumo equilibrados) e Clientes Elite (alta renda, alto consumo de produtos sofisticados, menos filhos). Concluiu-se que as técnicas de clusterização são eficazes para identificar perfis de consumidores com base em características sociodemográficas, comportamento de consumo e estrutura familiar, podendo otimizar o desempenho e alcance de iniciativas de marketing.
Palavras-chave: Análise de agrupamentos; Aprendizado de máquina; Comportamento de consumo; Fatores sociodemográficos; K-Means.
1. Introdução
A segmentação de mercado, um conceito fundamental no marketing, consiste em visualizar um mercado heterogêneo como um conjunto de mercados menores e homogêneos (Smith, 1956). Esta prática é essencial para o desenvolvimento de produtos, a definição de ofertas e o planejamento publicitário (Kotler, 1999; Shirole et al., 2021). A segmentação é o ponto de partida para a avaliação de estratégias de marketing, reconhecendo a diversidade de interesses, desejos e necessidades dos clientes (Toledo, 1972).
Tradicionalmente, a segmentação pode ser abordada por meio de variáveis demográficas, geográficas, psicográficas e comportamentais (Kotler e Keller, 2012). No entanto, em um cenário de investimentos massivos em marketing, como os trilhões de dólares estimados para publicidade online e offline em 2024 (DataReportal, 2025), um produto genérico não consegue satisfazer as necessidades de todos os clientes (Lopes, 2005). A ausência de uma segmentação precisa pode levar a esforços de marketing ineficientes e desperdícios orçamentários (Cortez et al., 2021; Dolnikar et al., 2013).
Nesse contexto, a Ciência de Dados oferece abordagens avançadas para a segmentação de mercado, utilizando técnicas de aprendizado de máquina não supervisionado, como a análise de agrupamentos (Favero e Belfiore, 2023). Essas técnicas visam agrupar observações em conjuntos internamente homogêneos e heterogêneos entre si, permitindo a identificação de perfis de consumidores com características e comportamentos semelhantes.
Entre os métodos de agrupamento, o algoritmo K-Means destaca-se por sua popularidade e eficácia. Ele é uma técnica exploratória e não hierárquica, onde o número de agrupamentos (K) é definido previamente pelo pesquisador. Sua eficiência computacional, capacidade de lidar com grandes volumes de dados e facilidade de aplicação o tornam amplamente utilizado em ambientes corporativos para segmentação de mercado (Sarkar et al., 2024; Maryani et al., 2018; Prabhas et al., 2023). A implementação do K-Means requer um pré-processamento do conjunto de dados, que envolve tratamento de variáveis, exclusão de dados faltantes, escalonamento, padronização e redução de dimensionalidade, frequentemente utilizando a Análise de Componentes Principais (PCA). A determinação do número ótimo de agrupamentos é verificada por métodos como o cotovelo e a silhueta.
A identificação de padrões de consumo e perfis de clientes é um recurso fundamental para o marketing, pois permite o desenvolvimento de programas mais eficazes (Boyd et al., 1998) e a personalização de campanhas, evitando a ineficácia de abordagens genéricas. A adoção de um protocolo de análise de dados baseado em aprendizado de máquina para segmentação de mercado não apenas otimiza o direcionamento de produtos, mas também revela características latentes dos consumidores que seriam difíceis de observar em grandes conjuntos de dados sem uma análise técnica aprofundada (Yoseph et al., 2020; Osei et al., 2021). Essa abordagem contribui para a tomada de decisões mais robustas, reprodutíveis e direcionadas, resultando em campanhas mais eficientes e assertivas, com ganhos operacionais na redução do tempo de análise e escalabilidade para grandes volumes de dados.
Diante da necessidade de otimizar as estratégias de marketing por meio de uma compreensão aprofundada do comportamento do consumidor, este trabalho teve como objetivo elaborar um protocolo de análise de dados baseado na avaliação de variáveis demográficas e comportamentais para direcionar estratégias de marketing, utilizando segmentação de consumidores por meio de aprendizado de máquina não supervisionado.
2. Material e Métodos
A abordagem metodológica empregada neste trabalho consistiu em quatro etapas principais: obtenção e descrição da base de dados, análise e preparação dos dados, desenvolvimento do algoritmo e análise dos clusters. O estudo utilizou dados públicos extraídos do website Kaggle, acessíveis em https://www.kaggle.com/datasets/vishakhdapat/customer-segmentation-clustering. O conjunto de dados compreendia 2.240 registros de clientes e 29 variáveis, cujas descrições estão detalhadas na Tabela 1.
Tabela 1. Descrição das variáveis do banco de dados
| Nome da Variável | Descrição |
|---|---|
| ID | Identificador único para cada indivíduo da base de dados |
| Year_Birth | Ano de nascimento de cada indivíduo |
| Education | Nível mais alto de educação alcançado pelo indivíduo |
| Marital_Status | Estado civil do indivíduo |
| Income | Renda anual do indivíduo |
| Kidhome | Número de crianças no lar |
| Teenhome | Número de adolescentes no lar |
| Dt_Customer | Data na qual o cliente foi registrado no banco de dados da empresa |
| Recency | Número de dias desde a última compra ou interação |
| MntWines | Valor gasto em vinhos |
| MntFruits | Valor gasto em frutas |
| MntMeatProducts | Valor gasto em carnes |
| MntFishProducts | Valor gasto em peixes |
| MntSweetProducts | Valor gasto em doces |
| MntGoldProds | Valor gasto em produtos especiais |
| NumDealsPurchases | Número de compras feitas com desconto |
| NumWebPurchases | Número de compras realizadas pelo website da empresa |
| NumCatalogPurchases | Número de compras realizadas por meio de catálogos |
| NumStorePurchases | Número de compras realizadas em lojas físicas |
| NumWebVisitsMonth | Número de visitas ao website da empresa em um mês |
| AcceptedCmp1 | Indicador binário (1 = sim, 0 = não) se o indivíduo aceitou a primeira campanha de marketing |
| AcceptedCmp2 | Indicador binário (1 = sim, 0 = não) se o indivíduo aceitou a segunda campanha de marketing |
| AcceptedCmp3 | Indicador binário (1 = sim, 0 = não) se o indivíduo aceitou a terceira campanha de marketing |
| AcceptedCmp4 | Indicador binário (1 = sim, 0 = não) se o indivíduo aceitou a quarta campanha de marketing |
| AcceptedCmp5 | Indicador binário (1 = sim, 0 = não) se o indivíduo aceitou a quinta campanha de marketing |
| Complain | Indicador binário (1 = sim, 0 = não) se o indivíduo registrou uma reclamação |
| Z_CostContact | Custo constante associado ao contato com um cliente |
| Z_Revenue | Uma receita constante associada a uma resposta bem-sucedida da campanha |
| Response | Indicador binário (1 = sim, 0 = não) se o indivíduo respondeu à campanha de marketing |
| Z_Revenue | Uma receita constante associada a uma resposta bem-sucedida da campanha |
| Response | Indicador binário (1 = sim, 0 = não) se o indivíduo respondeu à campanha de marketing |
Fonte: Dados originais da pesquisa
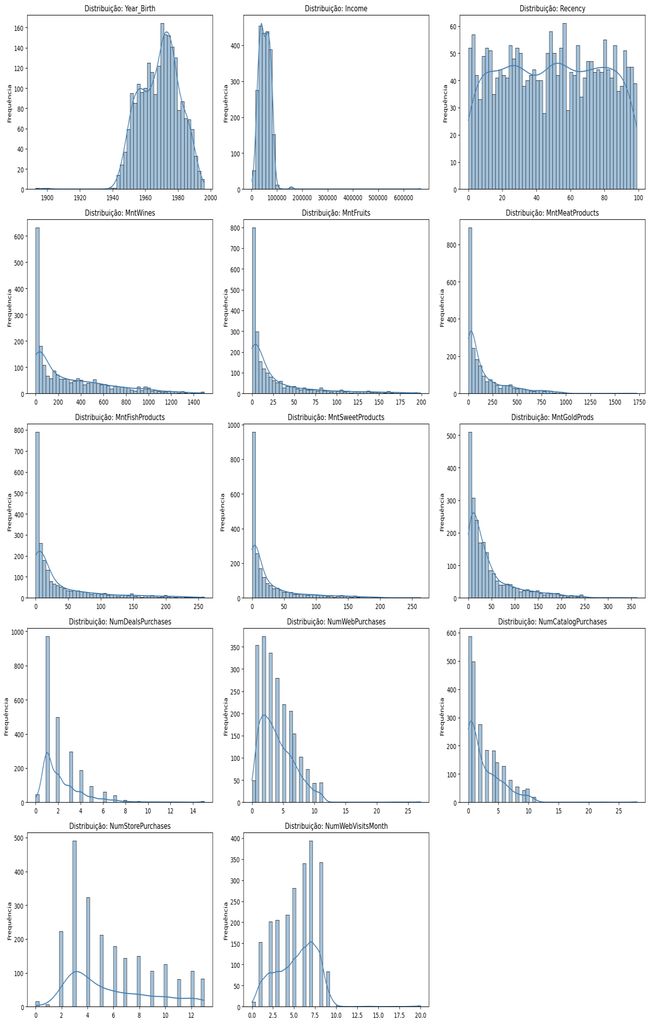
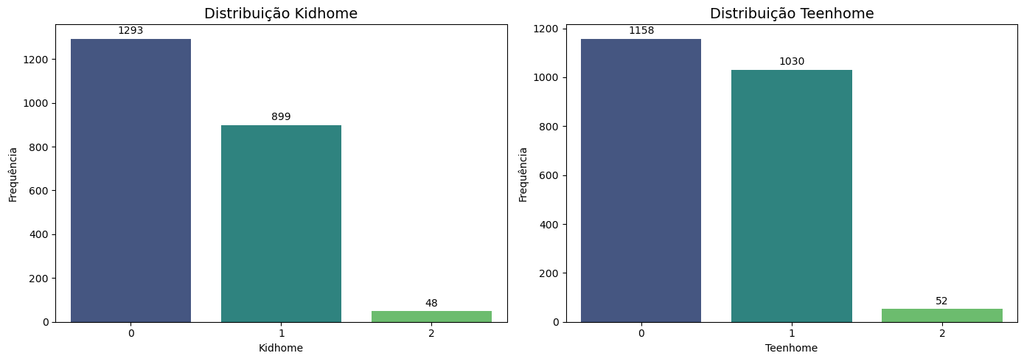
Na etapa de análise e preparação dos dados, realizou-se uma análise exploratória para identificar a estrutura e distribuição das variáveis, bem como a presença de outliers, valores faltantes ou inconsistências. As variáveis numéricas contínuas, como “Income”, “Recency” e “MntWines”, foram analisadas quanto à distribuição e necessidade de normalização, com a visualização de histogramas e estimativa de densidade (Figura 1). As variáveis numéricas discretas, como “Kidhome” e “Teenhome”, foram analisadas pela distribuição de frequência, apresentada em gráfico de barra (Figura 2).
Figura 1: Histograma com a distribuição das variáveis numéricas contínuas
Fonte: Dados originais da pesquisa
Figura 2: Frequência de crianças e adolescentes em casa
Fonte: Dados originais da pesquisa
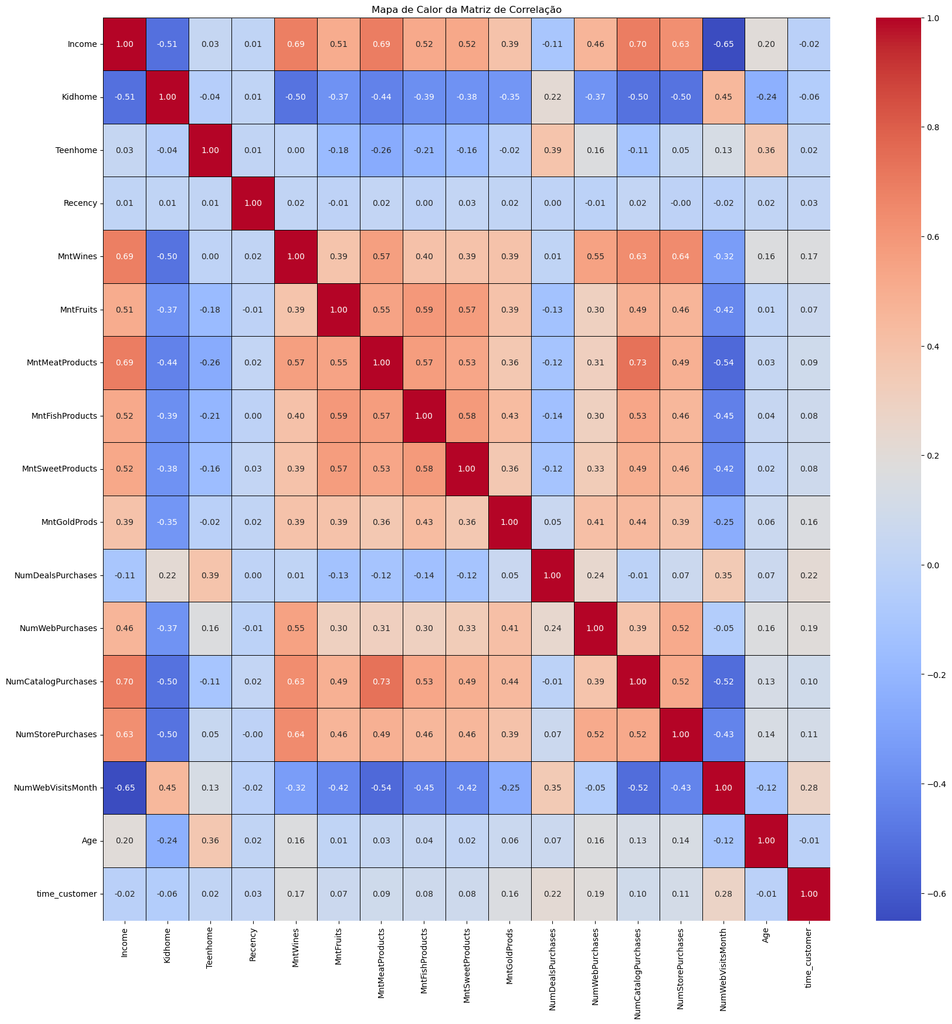
O pré-processamento dos dados foi realizado utilizando a linguagem de programação Python e as bibliotecas Pandas, Numpy, Matplotlib e Seaborn. Foram excluídas 24 observações com valores faltantes para a variável “Income”. As variáveis “AcceptedCmp1” a “AcceptedCmp5”, “Z_CostContact”, “Z_Revenue”, “Response” e “Complain” foram removidas por não agregarem informações relevantes para a segmentação. Outliers foram identificados e removidos das variáveis “Income” (1 indivíduo) e “Year_Birth” (3 indivíduos). A variável “Year_Birth” foi transformada em “Age” (subtraindo o ano de nascimento de 2014, ano de referência do último registro de cliente) e a variável “Dt_Customer” foi convertida em “time_customer” (dias corridos desde a data mais recente), sendo as variáveis originais excluídas. Variáveis categóricas também foram excluídas para garantir compatibilidade com a padronização e a formação dos clusters. As 17 variáveis numéricas restantes, que incluíam informações comportamentais e demográficas, foram escalonadas pelo método Z-score (“Standard Scaler”). A análise de correlação entre essas variáveis foi realizada para identificar redundâncias (Figura 3). A adequação dos dados para redução de dimensionalidade foi confirmada pelos testes Kaiser-Meyer-Olkin (KMO = 0.882; p < 0.05) e de Esfericidade de Bartlett (p = 0.0000).
Figura 3. Mapa de Calor da matriz de correlação entre variáveis conjunto de dados
Fonte: Dados originais da pesquisa
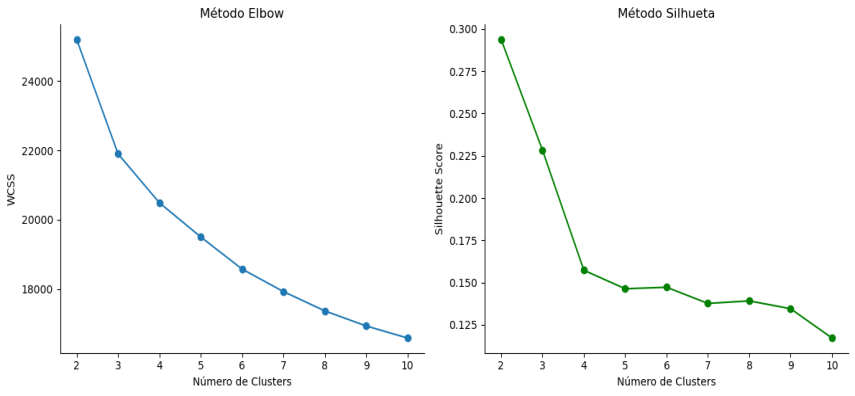
No desenvolvimento do algoritmo, aplicou-se a Análise de Componentes Principais (PCA), que reduziu as 17 variáveis para 14 componentes, mantendo 96,28% da variância explicada da estrutura original dos dados. Para pré-determinar o número ótimo de agrupamentos, foram utilizados o método cotovelo (“Elbow”) para medir a inércia intra-cluster e o método silhueta (“Silhouette Score”) para avaliar a qualidade da separação dos grupos. Os testes indicaram 3 e 2 clusters, respectivamente (Figura 4), e optou-se por 3 clusters para permitir uma identificação mais detalhada dos perfis comportamentais sem gerar separação artificial.
Figura 4. Checagem do número ótimo de “clusters” – “Elbow” (azul) e “Silhouette” (verde)
Fonte: Dados originais da pesquisa
Para a análise dos clusters formados, avaliou-se a influência de cada variável na formação do agrupamento por meio da Análise de Variância (ANOVA) aplicada aos dados não padronizados. O valor de F (“F-value”) foi utilizado como indicativo da discriminação das variáveis entre os clusters, e o tamanho de efeito (η²) para quantificar a magnitude dessa diferença.
3. Resultados e Discussão
A análise do conjunto de dados revelou a viabilidade de segmentar clientes e identificar comportamentos específicos que podem auxiliar no direcionamento de campanhas de marketing. Este estudo demonstrou a aplicação de técnicas de aprendizado de máquina não supervisionado, com foco no algoritmo K-Means, para agrupar consumidores com base em características demográficas e comportamentais. As etapas de pré-processamento, redução dimensional e validação foram cruciais para a construção de perfis de consumo distintos e consistentes, fornecendo uma base sólida para a interpretação dos achados.
A etapa inicial de análise e preparação dos dados envolveu a exploração dos dados brutos para identificar sua estrutura, distribuição de variáveis, e a presença de outliers ou inconsistências. Variáveis numéricas contínuas como “Income”, “Recency” e “MntWines” foram examinadas quanto à sua distribuição e necessidade de normalização. A visualização dessas distribuições, conforme ilustrado nos histogramas da Figura 5, permitiu compreender a magnitude diferenciada de cada categoria e a presença de caudas longas, indicando a necessidade de padronização antes da aplicação dos algoritmos de clusterização.
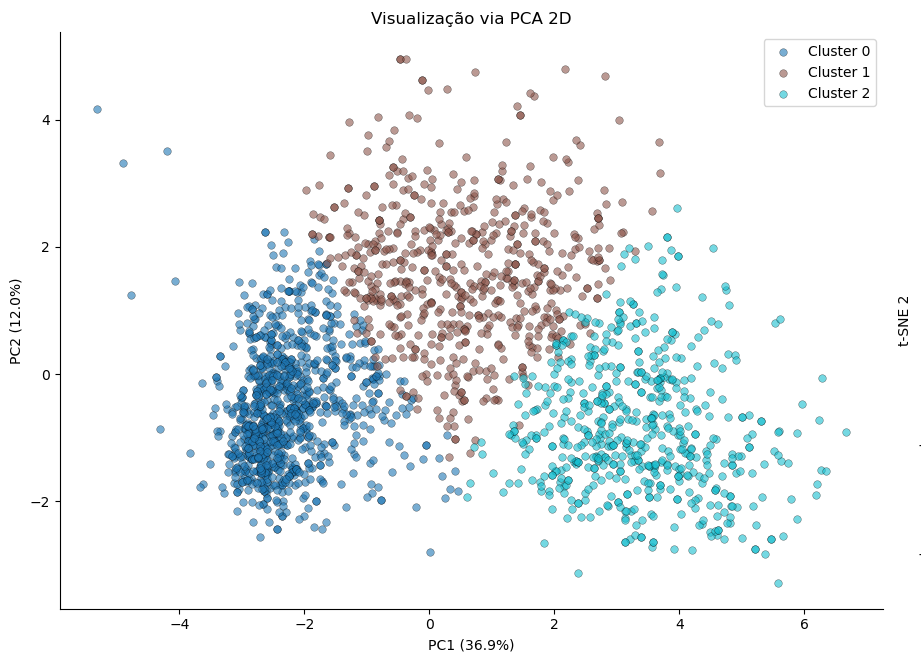
Figura 5. Visualização 2D do “clustering” usando a Análise de Componente Principal (PCA)
Fonte: Dados originais da pesquisa
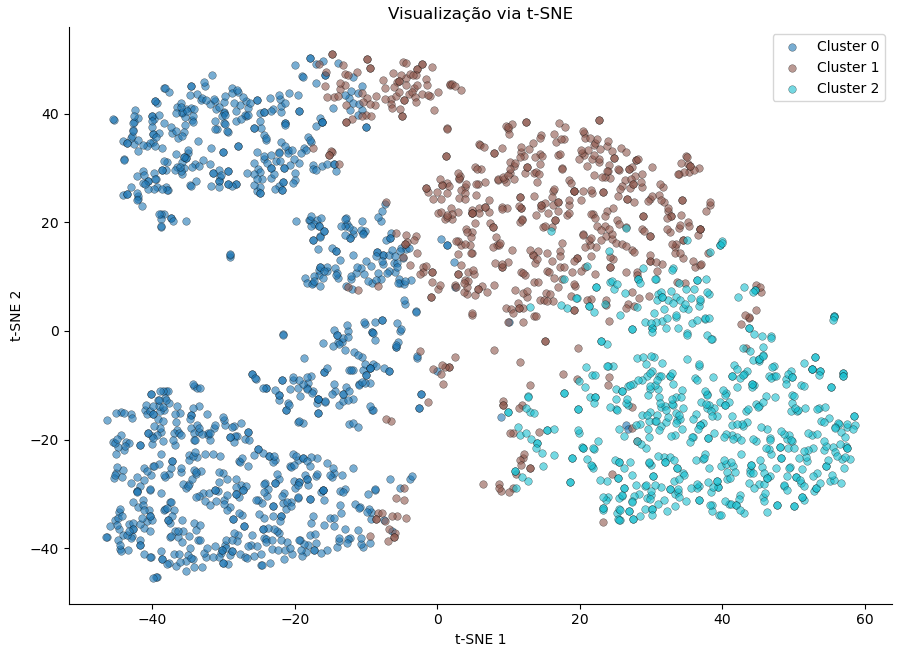
Complementar ao PCA, uma segunda representação 2D dos dados foi feita com o “t Distributed Stochastic Neighbor Embedding” (t-SNE) com o objetivo de observar a preservação da relação entre os pontos locais e verificar a consistência da segmentação
proposta pelo “K-Means” e “cluster” mais definidos, tendo informações sobre a diversidade dentro dos grupos maiores (Figura 6).
Figura 6. Visualização do agrupamento usando a técnica “t-Distributed Stochastic Neighbor Embedding” (t-SNE)
Fonte: Dados originais da pesquisa
Análise do perfil dos clusters e da estratégia de segmentação
Neste trabalho, o dataset original foi tratado para identificar perfis de consumidores a partir de padrões de consumo e estrutura familiar. Após etapas de tratamento, escalonamento, redução dimensional, escolha do número de grupos, aplicação do K-Means e análise estatística, foram identificados três agrupamentos principais: cluster 0, denominado Clientes Econômicos; cluster 1, Clientes Moderados; e cluster 2, Clientes Elite.
A análise reforçou a relevância da segmentação para o marketing, especialmente em contextos de varejo, e-commerce e livrarias, nos quais o K-Means é amplamente utilizado para apoiar o direcionamento de campanhas (Farhan et al., 2024; Tabianan et al., 2022). As etapas de pré-processamento contribuíram para uma separação mais coerente dos grupos, aspecto também observado em estudos sobre otimização de clusterings e uso de abordagens híbridas associadas ao K-Means (Juhari et al., 2022; Mulyono et al., 2023; Wang, 2025).
Embora o agrupamento tenha utilizado apenas o K-Means, a separação dos clusters com base em comportamento de compra, renda e estrutura familiar mostrou-se coerente com a literatura. Estudos indicam que renda, gastos com alimentos, consumo de itens de maior valor e interação por canais de compra são variáveis relevantes para caracterizar perfis de consumidores e identificar segmentos de maior valor econômico, como clientes premium (Reutterer e Dan, 2019; Tavor et al., 2023; Song, 2025; Thach e Olsen, 2015).
Além do K-Means, o estudo associou PCA e t-SNE para apoiar a visualização dos agrupamentos e refinar a identificação de possíveis subgrupos. Essas estratégias contribuem para mapear tendências de consumo menos evidentes, favorecendo uma leitura mais detalhada dos padrões de comportamento, como também observado em pesquisas voltadas ao e-commerce e ao marketing digital (Khan et al., 2023).
A literatura mostra que a segmentação baseada em aprendizado de máquina pode apoiar campanhas mais direcionadas, reduzir desperdícios orçamentários e melhorar a adequação de produtos e serviços a públicos distintos (Clarke et al., 2024; Dolnikar et al., 2013; Cortez et al., 2021). Estudos em setores como bancos, moda e varejo também indicam associação entre segmentação, satisfação do cliente, lucratividade e aumento de vendas (Francis Osei et al., 2021; Nurpazi et al., 2024; Fahed Yoseph et al., 2020).
Nesse contexto, o protocolo proposto favorece melhorias analíticas e estratégicas ao permitir o processamento automatizado de grandes volumes de dados, a identificação de padrões de consumo e a definição de grupos mais precisos. A comparação apresentada na Tabela 2 sintetiza os ganhos esperados em quatro dimensões: precisão da segmentação, personalização das campanhas, redução do tempo de análise e escalabilidade do processo.
Tabela 2. Comparação dos principais parâmetros para a aplicação do modelo proposto
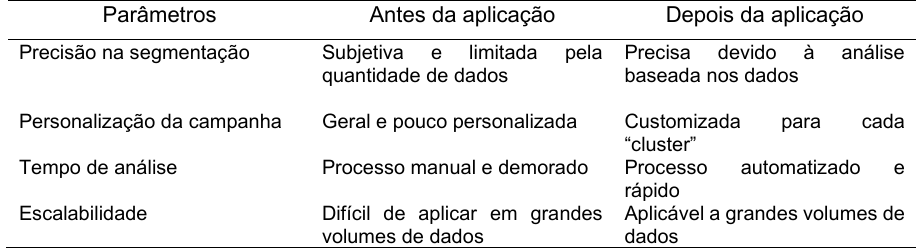
Portanto, a implementação do protocolo de agrupamento contribui para tornar o desenvolvimento de campanhas mais eficiente e direcionado. Ao segmentar clientes por perfis socioeconômicos, comportamentais, de gênero e idade, o modelo apoia decisões de marketing baseadas em dados e possibilita maior personalização das estratégias para cada cluster.
4. Conclusão
O presente estudo buscou elaborar um protocolo de análise de dados para direcionar estratégias de marketing, utilizando segmentação de consumidores por meio de aprendizado de máquina não supervisionado, com base em variáveis demográficas e comportamentais. Para tanto, implementou-se o algoritmo K-Means, após um pré-processamento rigoroso do conjunto de dados que incluiu tratamento de variáveis, exclusão de dados faltantes, escalonamento, padronização e redução de dimensionalidade por Análise de Componentes Principais. Verificou-se a formação de três agrupamentos de consumidores, cuja robustez e consistência foram validadas por técnicas de visualização bidimensional. Identificou-se o perfil dos Clientes Econômicos, caracterizados por serem mais jovens, com menor renda e consumo, e maior número de filhos. Os Clientes Moderados apresentaram idade mais elevada, renda e consumo equilibrados. Por sua vez, os Clientes Elite destacaram-se pela alta renda, elevado consumo de produtos sofisticados e menor número de filhos. A renda foi o atributo com maior poder discriminatório entre os clusters, seguida pelos gastos com carne e o número de compras por catálogo. A principal contribuição deste trabalho reside na demonstração de que a aplicação de um protocolo de análise de dados baseado em aprendizado de máquina otimiza significativamente o desempenho e o alcance das iniciativas de marketing, ao permitir uma segmentação de mercado mais precisa e personalizada.
O protocolo de análise implementado demonstrou melhorias significativas em comparação com abordagens tradicionais, ao aprimorar a precisão na segmentação, possibilitar a personalização de campanhas, reduzir o tempo de análise e conferir escalabilidade para grandes volumes de dados. Essa abordagem baseada em dados permite que as estratégias de marketing sejam mais assertivas e eficientes, evitando desperdícios orçamentários. Contudo, reconhece-se como limitação deste estudo o uso de uma única base de dados. Para pesquisas futuras, sugere-se a aplicação deste protocolo de análise em conjuntos de dados de casos reais, com a inclusão da medição da resposta da campanha e da receita gerada para o cliente, a fim de validar ainda mais sua eficácia e aplicabilidade em diferentes contextos de mercado.
Referências Bibliográficas
Cortez, R.; Clarke, A.; Freytag, P.. 2021. B2B market segmentation: a systematic review and research Journal of Business
https://doi.org/10.1016/j.jbusres.2020.12.070.
DataReportal. 2025. Digital 2025: Global Overview Report. Disponível em: https://datareportal.com/reports/digital-2025-global-overview-report. Acesso em: 09 mar. 2025.
Kotler, P.. 1999. Marketing para o século XXI: como criar, conquistar e dominar mercados. São Paulo: Futura, 1999.
Kotler, P.; Keller, K. L.. 2012. Administração de Marketing. 14ed. Pearson Education do Brasil. São Paulo, SP, Brasil.
Lopes, I.J. 2005. A Segmentação de Mercado como Estratégia de Marketing. Geo Cities. Disponível em: http://www.geocities.com/Eureka/2471/segmerca.html. Acesso em: 23 mar. 2025.
Shirole R, Salokhe L., Jadhav S. 2021. Customer Segmentation using RFM Model and “K-Means” Clustering. International Journal of Scientific Research in Science and Technology 8 (3), 591-597.
Smith, W.R. 1956. Product Differentiation and Market Segmentation as Alternative Marketing Strategies. Journal of Marketing, 21(1), 3-8.
Toledo, G. L. 1972. Segmentação de mercado e estratégia de marketing. Tese de Doutorado em Administração de Empresas. Faculdade de Economia, Administração e Contabilidade, Universidade de São Paulo, SP, Brasil.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

