
09 de setembro de 2026
Análise de Componentes Principais e Clusterização de Dados Censitários na Identificação de Assentamentos Precários
Carolina Horta Cattaneo; Jéssica Eloá Poletto
DOI: 10.22167/2675-6528-202602130
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A identificação de assentamentos precários em áreas metropolitanas brasileiras ainda depende, em grande medida, de abordagens qualitativas e classificações institucionais, frequentemente subjetivas e temporalmente defasadas. Este estudo avaliou a aplicação combinada da Análise de Componentes Principais (PCA) e do algoritmo K-Means para segmentar setores censitários urbanos do Censo Demográfico de 2010, comparando os resultados com a classificação oficial de Aglomerados Subnormais (AGSN) do Instituto Brasileiro de Geografia e Estatística (IBGE). Utilizaram-se dados de 33 regiões metropolitanas que continham AGSN. Testaram-se quatro configurações metodológicas, combinando dois conjuntos de variáveis (um amplo e outro focado em vulnerabilidade) com k=4 e k=5 agrupamentos. As variáveis incluíram infraestrutura urbana, saneamento, características domiciliares e perfis socioeconômicos e raciais, e foram submetidas à transformação de Yeo-Johnson e padronização. A correspondência dos agrupamentos com a classificação oficial foi avaliada pelo Adjusted Rand Index (ARI). Os resultados revelaram baixa correspondência na maioria das regiões, com índices de ARI predominantemente inferiores a 0,03. Desempenhos mais elevados foram observados em Belém, Campinas e Aracaju. Apesar da baixa correspondência com a classificação oficial, a abordagem demonstrou capacidade de identificar gradientes de vulnerabilidade urbana de forma sistemática e replicável. Isso oferece potencial para subsidiar a priorização territorial em políticas públicas, sem, contudo, substituir as classificações institucionais estabelecidas.
Palavras-chave: Agrupamento; Aprendizado de máquina não supervisionado; Assentamentos precários; Setores censitários; Vulnerabilidade urbana.
1. Introdução
A urbanização acelerada no Brasil tem gerado desafios significativos para a gestão territorial, incluindo a expansão contínua de assentamentos precários em áreas metropolitanas. Desde o Censo de 1950, o Instituto Brasileiro de Geografia e Estatística (IBGE) tem se dedicado à caracterização e identificação desses territórios (IBGE, 2023), os quais demonstram expansão constante ao longo das últimas décadas (IPEA, 2016). As tipologias utilizadas para essa classificação têm sido revisadas, inclusive em pesquisas recentes (MCID, 2024), mas esses assentamentos persistem com características recorrentes, exigindo ações governamentais estratégicas para melhorar as condições de vida de seus moradores. Atualmente, tanto o IBGE quanto o Ministério das Cidades (MCID) empregam critérios específicos para classificar essas áreas, considerando aspectos como condições de moradia, acesso a serviços essenciais e regularização fundiária (MCID, 2023).
Apesar dos esforços institucionais, a identificação desses assentamentos ainda enfrenta desafios metodológicos relevantes. As abordagens tradicionais frequentemente dependem de classificações qualitativas e institucionais, que são suscetíveis à subjetividade e à defasagem temporal. Existe uma lacuna na aplicação de métodos quantitativos robustos que possam complementar as análises existentes, oferecendo uma visão mais sistemática e replicável dos padrões de vulnerabilidade urbana.
Nesse contexto, metodologias baseadas em estatística multivariada e aprendizado de máquina não supervisionado apresentam um potencial considerável para aprimorar a identificação de padrões espaciais e socioeconômicos subjacentes nos dados censitários. A Análise de Componentes Principais (PCA) é um método amplamente empregado para a redução de dimensionalidade, que preserva a variabilidade original dos dados e permite a identificação de padrões latentes entre as variáveis (Fávero e Belfiore, 2017). Essa técnica é crucial para sintetizar informações complexas de grandes conjuntos de dados.
A clusterização, por sua vez, com técnicas como o algoritmo K-Means, demonstra eficácia na segmentação de dados espaciais, agrupando elementos com características semelhantes (Fávero e Belfiore, 2017). A combinação de PCA e K-Means tem sido aplicada em estudos urbanos complexos. Kubrusly e Saboia (2006) utilizaram análise estatística multivariada para examinar a população empregada em regiões metropolitanas. Carvalho (2015) empregou métodos multivariados para simulação da paisagem urbana. Mais recentemente, Carmo e Costa (2021) aplicaram PCA para tipologias urbanas, e Bortoletto et al. (2017) usaram PCA e clusterização para avaliar a vulnerabilidade socioambiental. No campo dos dados geoespaciais censitários, Krishnan (2023) e Rey et al. (2023) apresentaram aplicações de K-Means e agrupamento hierárquico em dados socioeconômicos, avaliando o desempenho por métricas como os coeficientes de Silhouette e Davies-Bouldin.
A lacuna na identificação sistemática e replicável de assentamentos precários, aliada à necessidade de ferramentas complementares às classificações institucionais, justifica a exploração de abordagens quantitativas. Assim, o presente estudo buscou avaliar a aplicação de algoritmos não supervisionados de aprendizado de máquina, especificamente PCA e K-Means, para a segmentação de setores censitários urbanos do Censo Demográfico de 2010, verificando a correspondência dos agrupamentos obtidos com a classificação oficial do IBGE para assentamentos precários e explorando o potencial da abordagem como ferramenta de priorização territorial para análises e intervenções mais aprofundadas.
2. Material e Métodos
O estudo utilizou uma abordagem quantitativa, baseada na aplicação de algoritmos não supervisionados de aprendizado de máquina, especificamente Análise de Componentes Principais (PCA) e K-Means, para segmentar setores censitários urbanos. A pesquisa foi realizada com dados do Censo Demográfico de 2010, comparando os agrupamentos obtidos com a classificação oficial de Aglomerados Subnormais (AGSN) do Instituto Brasileiro de Geografia e Estatística (IBGE).
O dataset foi construído a partir de fontes secundárias de acesso público do IBGE, combinando tabelas de resultados do Censo Demográfico de 2010 agregadas por setor censitário, a malha de setores censitários do mesmo ano e a base de AGSN de Áreas de Interesse Social de 2019. A integração dessas fontes foi realizada por meio de junção espacial e tabular, resultando em um GeoDataFrame com informações socioespaciais e a classificação de AGSN para cada setor censitário urbano das regiões metropolitanas brasileiras. As tabelas do Censo 2010 foram obtidas do servidor FTP do IBGE em arquivos CSV temáticos (Domicilio01, DomicilioRenda, Entorno01, Pessoa01 e Pessoa03). A malha de setores censitários foi obtida do servidor FTP do IBGE em formato “shapefile” e exportada como geopackage [GPKG]. A delimitação das regiões metropolitanas foi obtida de um “shapefile” do Centro de Estudos da Metrópole [CEM/USP], convertido para GPKG via QGIS. A base de AGSN, em formato GeoJSON, foi usada para marcar setores cujos centroides se localizam dentro dos polígonos de aglomerados subnormais, gerando a variável binária de referência.
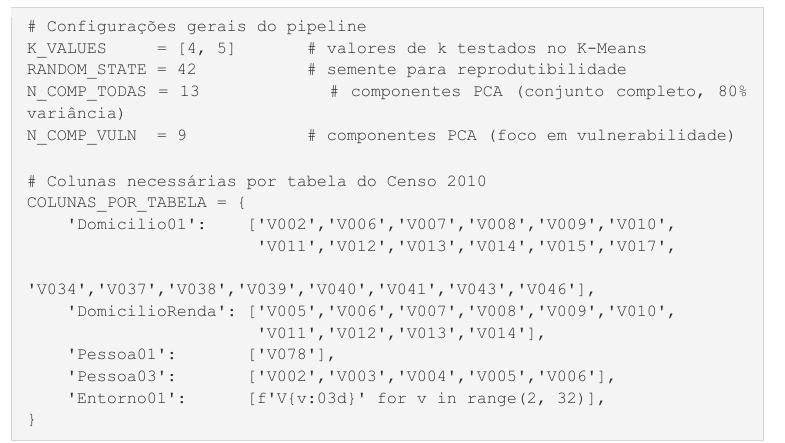
O pipeline de preparação dos dados foi desenvolvido em Python, utilizando as bibliotecas geopandas, pandas, numpy e pyogrio. As etapas incluíram: (1) download automatizado dos “shapefiles” de setores por UF; (2) extração e leitura seletiva dos CSVs temáticos, filtrando setores de regiões metropolitanas e colunas necessárias; (3) junção tabular entre dados do “shapefile” e CSVs por código de setor; e (4) junção espacial entre centroides dos setores e polígonos de AGSN para marcação da variável de referência. O resultado foi exportado em formato GPKG. As configurações gerais do pipeline e o mapeamento de colunas são detalhados na Figura 1.
Figura 1. Código 1 – configurações gerais e mapeamento de colunas por tabela do Censo 2010
Fonte: Dados originais da pesquisa
Após a integração, os dados foram filtrados para incluir exclusivamente setores urbanos (Situacao_setor = 1) e excluídos setores com ausência total de informações de entorno. Valores nulos residuais nas variáveis domiciliares foram substituídos por zero.
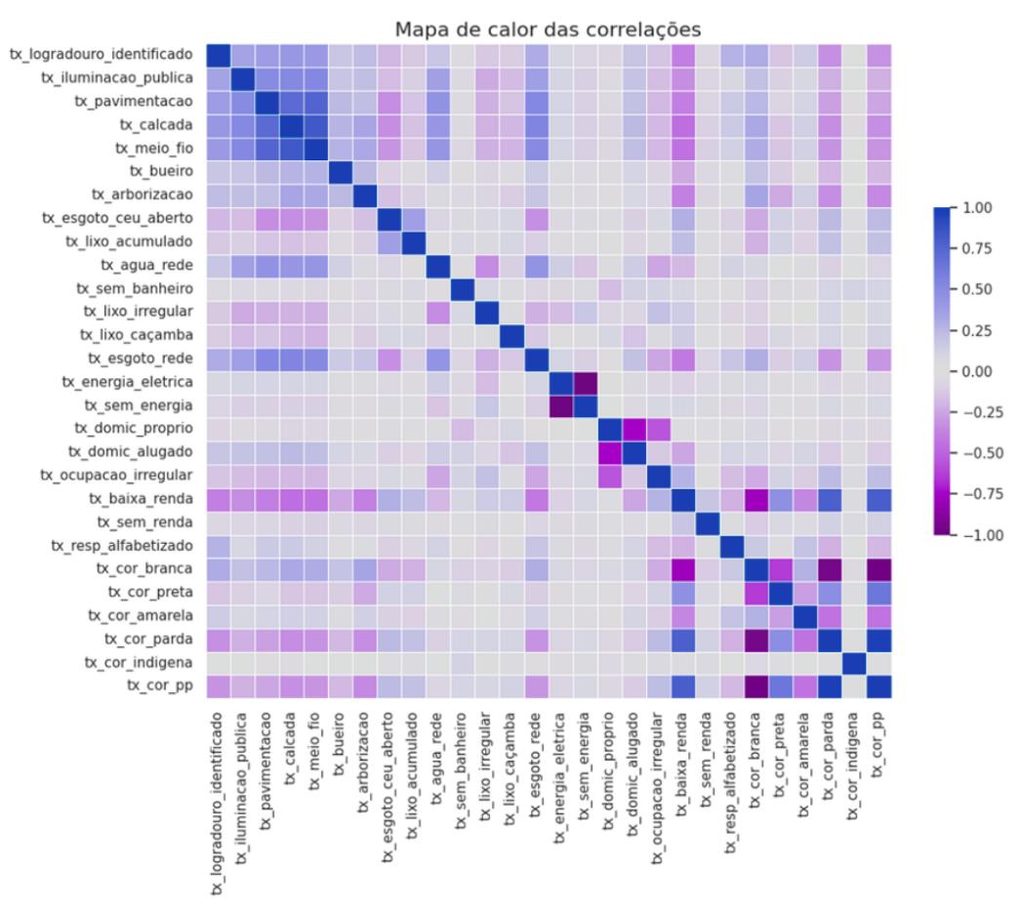
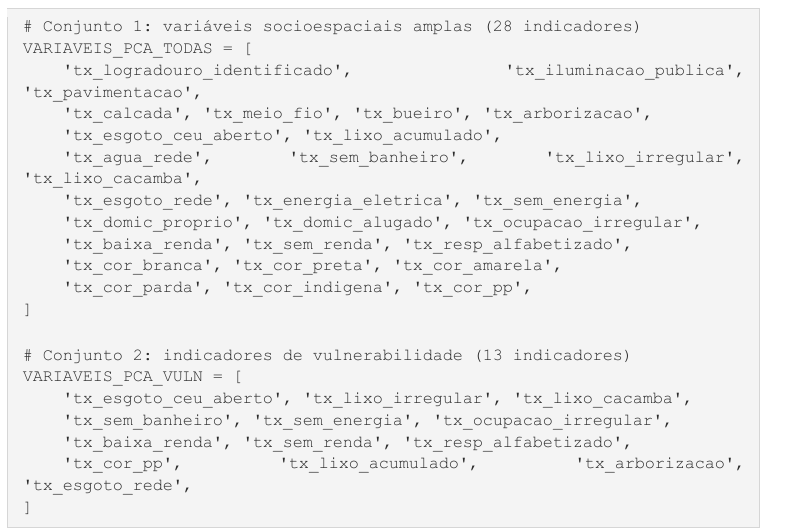
Para a construção dos indicadores, foi realizada uma análise de correlação exploratória na Região Metropolitana de São Paulo (RMSP) para calibração metodológica. Os padrões de correlação são ilustrados na Figura 2. Indicadores proporcionais foram calculados para cada setor censitário, dividindo contagens absolutas por totais de domicílios, rendimento ou pessoas. Os indicadores foram organizados em quatro categorias temáticas: infraestrutura urbana, saneamento e coleta, características dos domicílios e perfil socioeconômico e racial. Foram definidos dois conjuntos de variáveis para a PCA: o primeiro, “todas as variáveis”, com 28 indicadores socioespaciais amplos; e o segundo, “foco em vulnerabilidades”, com 13 indicadores associados à precariedade habitacional e exclusão social. A definição desses conjuntos é apresentada na Figura 3.
Figura 2. Correlação entre indicadores socioespaciais da Região Metropolitana de São Paulo
Fonte: Dados originais da pesquisa
Figura 3. Código 2 – definição dos dois conjuntos de variáveis para a PCA
Fonte: Dados originais da pesquisa
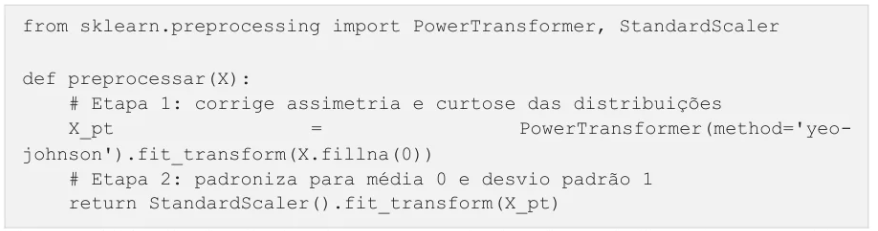
Antes da aplicação dos algoritmos, os dados foram pré-processados em duas etapas: (1) transformação de Yeo-Johnson (classe PowerTransformer da biblioteca scikit-learn) para reduzir assimetria e curtose; e (2) padronização com StandardScaler para obter variáveis com média zero e desvio padrão unitário. A função de pré-processamento é ilustrada na Figura 4.
Figura 4. Código 3 – função de pré-processamento: transformação Yeo-Johnson seguida de padronização
Fonte: Dados originais da pesquisa
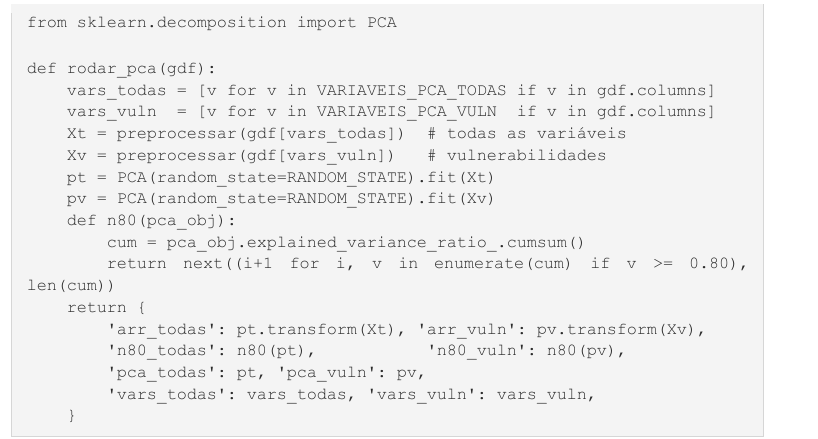
A Análise de Componentes Principais (PCA) foi aplicada separadamente para cada conjunto de variáveis, utilizando a classe PCA da biblioteca scikit-learn. O número de componentes retidos foi definido pelo critério de 80% de variância explicada acumulada: 13 componentes para o conjunto completo de variáveis e 9 para o conjunto de vulnerabilidades (Apêndice A). As projeções nos dois primeiros componentes principais foram exportadas. A aplicação da PCA é detalhada na Figura 5.
Figura 5. Código 4 – aplicação da PCA para os dois conjuntos de variáveis, com critério de 80% de variância acumulada
Fonte: Dados originais da pesquisa
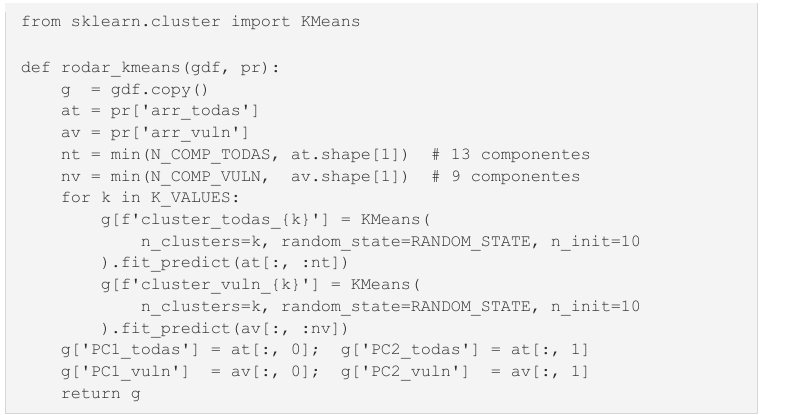
A clusterização foi realizada com o algoritmo K-Means, implementado pela biblioteca scikit-learn. Foram testados dois valores de k (4 e 5 agrupamentos) para cada tipo de PCA, resultando em quatro configurações por região metropolitana: todas_k4, todas_k5, vuln_k4 e vuln_k5. A definição dos valores de k foi orientada pela análise de inércia total e pelo coeficiente de silhueta, aplicados na RMSP. O algoritmo foi inicializado com n_init=10 inicializações aleatórias e random_state fixo para reprodutibilidade. A entrada para o K-Means foi a projeção dos dados nos primeiros componentes principais selecionados (13 para o conjunto completo e 9 para o conjunto de vulnerabilidades). A aplicação do K-Means é mostrada na Figura 6.
Figura 6. Código 5 – aplicação do K-Means para as quatro configurações (tipo de PCA × k)
Fonte: Dados originais da pesquisa
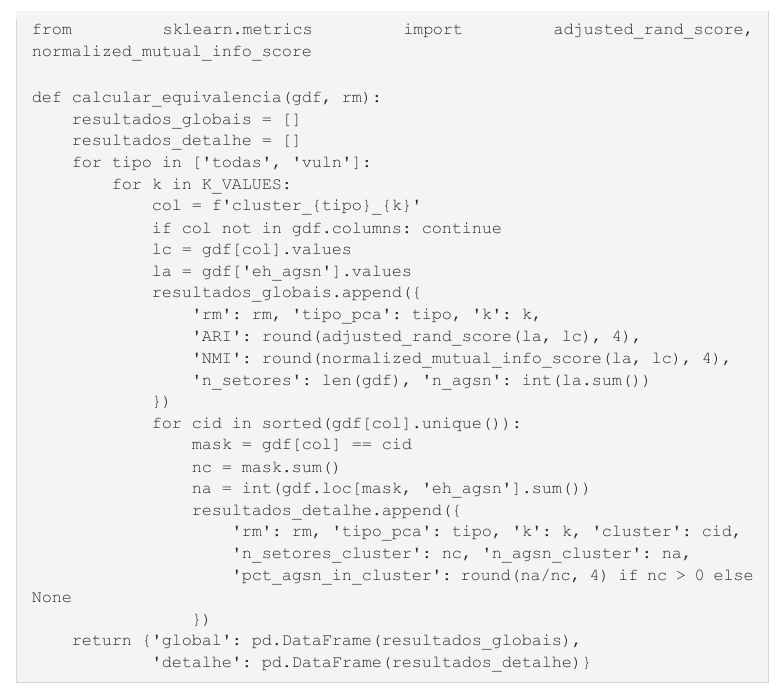
A correspondência entre os agrupamentos gerados e a classificação oficial de AGSN foi avaliada pelo Adjusted Rand Index (ARI), implementado pela função adjusted_rand_score da biblioteca scikit-learn. O ARI mede a similaridade entre dois conjuntos de rótulos discretos, ajustando o “Rand Index” pelo acaso esperado. O Normalized Mutual Information (NMI) foi calculado como métrica complementar. Para cada região metropolitana e configuração, foram registrados o ARI, o NMI, o número total de setores e o número de setores classificados como AGSN, além do detalhamento por cluster. Para cada região metropolitana e cada
configuração, foram registrados o ARI, o NMI, o número total de setores e o número de setores classificados como AGSN, além do detalhamento por cluster com a proporção de setores AGSN em cada agrupamento (Figura 7).
Figura 7. Código 6 – cálculo do ARI e NMI por configuração, com detalhamento por “cluster”
Fonte: Dados originais da pesquisa
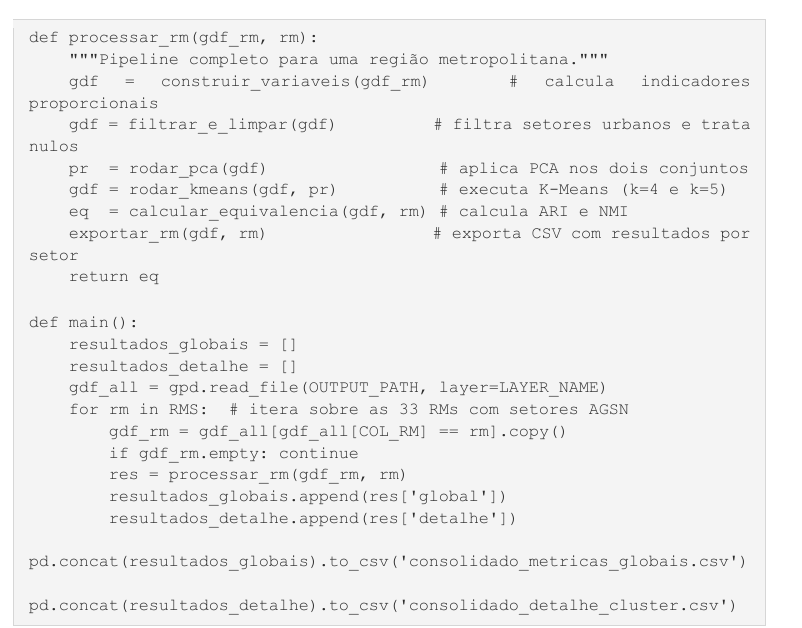
O estudo foi inicialmente desenvolvido e validado na Região Metropolitana de São Paulo. Em uma segunda etapa, o pipeline foi expandido para todas as 33 regiões metropolitanas brasileiras com presença de setores classificados como AGSN. Para viabilizar o processamento em escala nacional, o pipeline foi estruturado de forma modular, processando cada região metropolitana de forma independente por meio de uma função que encapsula todas as etapas: construção dos indicadores, filtragem e limpeza dos dados, aplicação da PCA, execução do K-Means, cálculo das métricas e exportação dos resultados. Os resultados foram consolidados em arquivos CSV. A função principal do pipeline é ilustrada na Figura 8.
Figura 8. Código 7 – função principal do “pipeline”: processamento modular por região metropolitana
Fonte: Dados originais da pesquisa
3. Resultados e Discussão
A análise foi conduzida para todas as 33 regiões metropolitanas brasileiras que apresentavam setores classificados como Aglomerados Subnormais (AGSN) pela base do IBGE de 2019. Para cada região, foram testadas quatro configurações metodológicas, combinando dois tipos de Análise de Componentes Principais (PCA) – um com todas as variáveis socioespaciais e outro focado em indicadores de vulnerabilidade – e dois valores para o algoritmo K-Means (k=4 e k=5). A correspondência entre os agrupamentos gerados e a classificação oficial do IBGE foi avaliada pelo Adjusted Rand Index (ARI), uma métrica que varia entre -1 e 1, onde valores próximos de zero indicam concordância equivalente ao acaso.
No primeiro componente principal (PC1) do conjunto completo de variáveis, destacaram-se indicadores associados à precariedade urbana e às desigualdades raciais, como a proporção de domicílios com baixa renda, a proporção de pessoas pretas ou pardas e a infraestrutura deficiente. Esses fatores apresentaram correlação inversa com variáveis que refletem maior infraestrutura consolidada, como pavimentação e calçada, sugerindo que PC1 representa um gradiente de desigualdade territorial. O segundo componente (PC2) refletiu diferenças no tipo de posse do domicílio e no acesso à infraestrutura, distinguindo áreas regulares de ocupações informais, conforme detalhado no Apêndice A do TCC original.
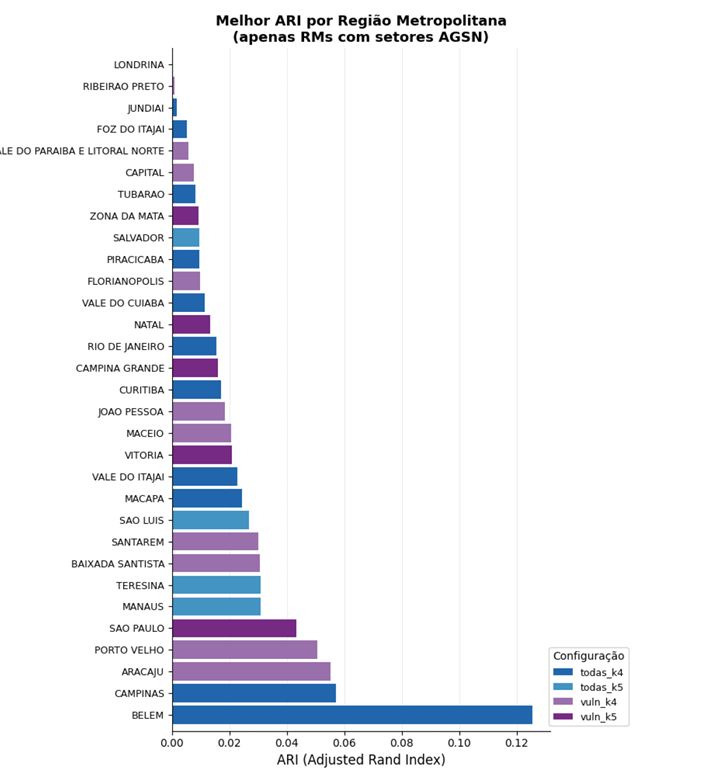
A Figura 9 apresenta o melhor ARI obtido entre as quatro configurações testadas para cada região metropolitana, ordenadas de forma crescente. Observa-se que a grande maioria das regiões concentra valores próximos de zero, com destaque para Belém (ARI = 0,125), Campinas (ARI = 0,057) e Aracaju (ARI = 0,055), que apresentaram os desempenhos mais elevados.
Figura 9. Melhor ARI por região metropolitana (apenas RMs com setores AGSN)
Fonte: Resultados originais da pesquisa
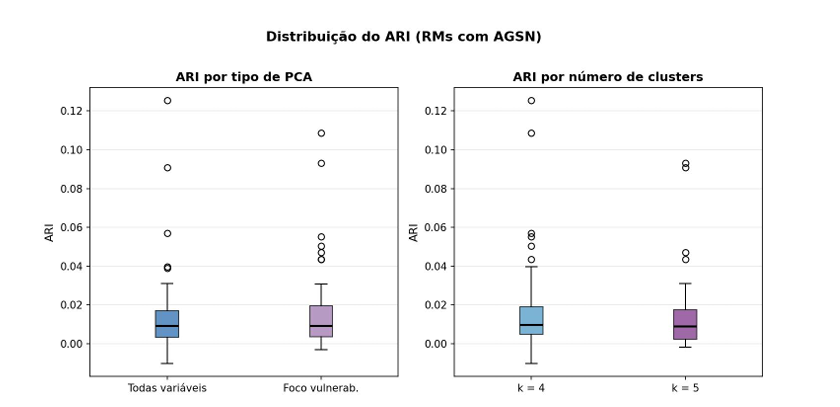
A Figura 10 complementa essa análise por meio de “boxplots” comparativos, exibindo a distribuição do ARI separadamente por tipo de PCA e por número de “clusters”. Em ambos os painéis, a dispersão é reduzida e os valores medianos situam-se próximos de zero, indicando que nem a escolha do conjunto de variáveis nem a definição do número de agrupamentos produziu impacto sistemático expressivo sobre a correspondência com a classificação oficial. A ausência de diferença relevante entre as configurações reforça que o desempenho do modelo está mais condicionado às características socioespaciais de cada região metropolitana do que aos parâmetros metodológicos adotados.
Figura 10. Distribuição do ARI por tipo de PCA e por número de clusters (RMs com AGSN)
Fonte: Resultados originais da pesquisa
Desempenho por região metropolitana e configuração
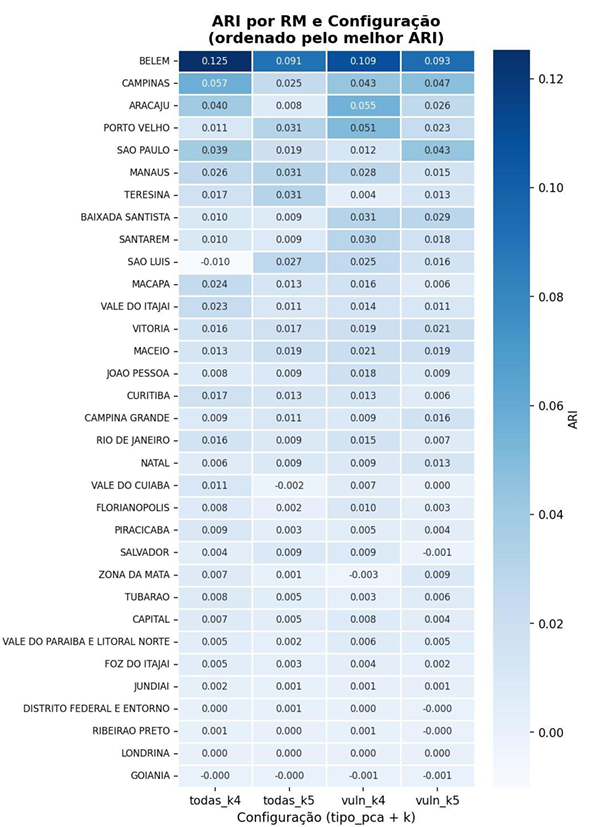
A distribuição do ARI por região metropolitana revelou uma hierarquia clara de desempenho (Figura 11). Belém apresentou o maior valor de ARI entre todas as regiões e configurações analisadas (ARI = 0,125, configuração todas_k4), destacando-se de forma expressiva em relação às demais.
Figura 11. ARI por região metropolitana e configuração metodológica (ordenado pelo melhor ARI)
Fonte: Resultados originais da pesquisa
A análise da relação entre o ARI e a proporção de setores AGSN na região metropolitana indicou uma tendência positiva (Figura 12). Regiões com maior participação de AGSN no conjunto de setores urbanos tenderam a apresentar valores mais elevados de ARI. Essa associação sugere que, quando os setores precários representam parcela expressiva do universo analisado, suas características socioespaciais geram maior variabilidade sistemática, favorecendo a identificação dos agrupamentos pelos algoritmos. Belém, com cerca de 50% dos setores urbanos classificados como AGSN, foi o caso mais expressivo, o que ajuda a explicar seu desempenho superior. Entre as demais regiões, destacaram-se Campinas (ARI = 0,057, todas_k4) e Aracaju (ARI = 0,055, vuln_k4).
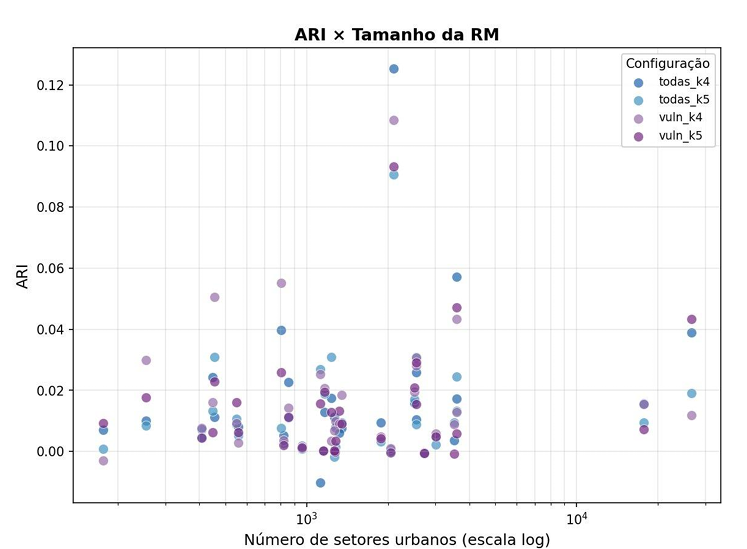
Por outro lado, não foi identificada relação clara entre o número de setores censitários urbanos e o desempenho do modelo (Figura 13). Esse resultado indica que o volume de dados, isoladamente, não determina a qualidade dos agrupamentos. O desempenho parece estar mais associado à estrutura interna da variabilidade socioespacial de cada região, especialmente ao grau de diferenciação entre setores precários e não precários no conjunto de variáveis censitárias, do que à escala da análise.
Figura 12. Relação entre ARI e proporção de setores AGSN por região metropolitana
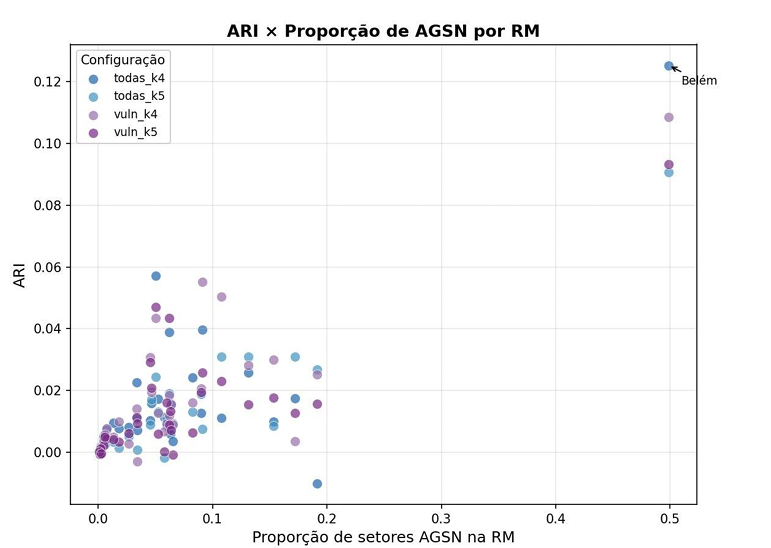
Figura 13. Relação entre ARI e número de setores censitários urbanos da região metropolitana (escala logarítmica)
Análise espacial: o caso de Belém
Para aprofundar a interpretação dos resultados, Belém foi selecionada por apresentar o melhor desempenho métrico e um contexto urbano favorável à aplicação da metodologia. Na configuração todas_k4 (ARI = 0,125), a segmentação territorial produziu um padrão interpretável e territorialmente coerente. O cluster 3, composto por 559 setores, concentrou 75,7% de seus setores em AGSN, ao passo que o cluster 1, com 484 setores, apresentou apenas 5,8% de sobreposição com essa classificação. Essa polarização reflete a estrutura urbana da região, marcada pela coexistência de áreas com elevada infraestrutura e setores de precariedade habitacional intensa.
Figura 14. Distribuição espacial dos “clusters” em Belém, todas as variáveis, k=4 (ARI = 0,125)
Fonte: Resultados originais da pesquisa; IBGE e Censo Demográfico (2010); IBGE e AGSN (2019)
A distribuição espacial dos agrupamentos revela uma estrutura territorial coerente com o processo de urbanização de Belém, marcado pela ocupação de áreas de baixadas e zonas ribeirinhas associadas à precariedade habitacional, características recorrentes das cidades amazônicas (Castro, 2008). O cluster 3, com maior concentração de setores AGSN, organiza-se predominantemente nas porções oeste e sul da região metropolitana, coincidindo com as áreas de baixadas e ocupações ribeirinhas historicamente associadas à precariedade habitacional. O cluster 2, com 52,3% de sobreposição com os AGSN, ocupa posição intermediária e aparece de forma dispersa ao longo do tecido urbano, sugerindo a presença de gradientes de vulnerabilidade que permeiam diferentes porções do território.
O cluster 1, com menor proporção de AGSN, concentra-se nas áreas centrais e nos setores com maior infraestrutura consolidada, evidenciando o padrão de segregação socioespacial característico das metrópoles amazônicas. Essa organização espacial reforça a capacidade da abordagem em capturar estruturas territoriais reais, ainda que operando exclusivamente a partir de variáveis censitárias agregadas. A projeção dos setores no espaço dos dois primeiros componentes principais (PC1 e PC2) evidencia a separação entre os grupos, conforme a Figura 15.
Figura 15 Distribuição dos setores no espaço PCA em Belém, colorido por “cluster” (esquerda) e por classificação AGSN (direita)
Fonte: Resultados originais da pesquisa
4. Conclusão
O presente estudo avaliou a aplicação combinada da Análise de Componentes Principais (PCA) e do algoritmo K-Means para segmentar setores censitários urbanos do Censo Demográfico de 2010, buscando verificar a correspondência dos agrupamentos obtidos com a classificação oficial de Aglomerados Subnormais (AGSN) do IBGE e explorar o potencial da abordagem como ferramenta de priorização territorial. Verificou-se que, na maioria das 33 regiões metropolitanas analisadas, a correspondência entre os agrupamentos gerados e a classificação oficial foi modesta, com valores de Adjusted Rand Index (ARI) predominantemente inferiores a 0,03. Desempenhos mais elevados foram observados em Belém, Campinas e Aracaju, e constatou-se que regiões com maior proporção de AGSN tenderam a apresentar ARI mais altos. A análise espacial demonstrou que os clusters mais vulneráveis, identificados pela metodologia, organizaram-se de forma coerente com os padrões de segregação socioespacial e precariedade habitacional das metrópoles brasileiras, com os setores AGSN concentrando-se em regiões bem definidas no espaço estatístico da PCA. Essa abordagem, portanto, demonstrou capacidade de identificar gradientes de vulnerabilidade urbana de maneira sistemática e replicável, oferecendo uma contribuição prática relevante como instrumento de triagem territorial em escala metropolitana, capaz de orientar a alocação de esforços para investigações mais aprofundadas e subsidiar políticas públicas.
Os resultados obtidos devem ser interpretados considerando-se algumas limitações. A classificação de AGSN, baseada em critérios urbanísticos e topológicos, não coincide necessariamente com os perfis socioespaciais captados pelas variáveis censitárias, o que impõe um limite intrínseco à comparação e sugere que a metodologia pode identificar territórios vulneráveis ainda não formalmente reconhecidos. Além disso, o algoritmo K-Means, sensível à estrutura de covariância dos dados, pode não capturar a heterogeneidade interna dos agrupamentos em regiões de grande porte, indicando que métodos alternativos poderiam ser explorados em estudos futuros. A base de dados do Censo 2010 também apresentou limitações de completude em variáveis de entorno. Para aprimoramento da pesquisa, sugere-se a replicação da metodologia com os dados do Censo Demográfico de 2022, que oferecerá uma base mais completa e atualizada. Recomenda-se, ainda, a incorporação de variáveis complementares, como dados de imagens de satélite de alta resolução, indicadores ambientais de sensoriamento remoto e informações sobre legislação urbana, visando enriquecer o conjunto de atributos e aumentar a sensibilidade do modelo na identificação de padrões de vulnerabilidade urbana.
Referências Bibliográficas
Bortoletto, K.C.; Freitas, M.I.C.; Rossetti, L.A.F.G.; Freitas, A.C.; Oliveira, R.B.N. 2017. Análise da vulnerabilidade socioambiental e do uso do solo urbano da área insular de Santos – SP. Revista Brasileira de Cartografia 69(4): 769-790.
Carmo, M.B.S.; Costa, S.M.F. 2021. Tipologias urbanas para as pequenas cidades do delta do Rio Amazonas: uma proposição de categorização. Revista Política e Planejamento Regional 8(3): 440-459.
Carvalho, G.A. 2015. Comparação de métodos de análise multivariada na seleção de variáveis explicativas para modelos de simulação da paisagem urbana. Tese de Doutorado em Geografia. Universidade Federal de Minas Gerais, Belo Horizonte, MG, Brasil. Disponível em: . Acesso em: 12 mar. 2025.
Castro, E.M.R. 2008. Urbanização, Pluralidade e Singularidades das Cidades Amazônicas. 1ed. NAEA/UFPA, Belém, PA, Brasil.
Fávero, L.P.; Belfiore, P.P. 2017. Análise de componentes principais (PCA). p. 379-436. In: Fávero, L.P.; Belfiore, P.P. Manual de Análise de Dados: estatística e modelagem multivariada com Excel, SPSS e Stata. 1ed. Elsevier, Rio de Janeiro, RJ, Brasil.
Instituto Brasileiro de Geografia e Estatística [IBGE]. 2010. Dados de aglomerados subnormais e do universo do Censo Demográfico 2010. Disponível em: . Acesso em: 12 mar. 2025.
Instituto Brasileiro de Geografia e Estatística [IBGE]. 2022. Dados do Censo Demográfico 2022. Disponível em: . Acesso em: 12 mar. 2025.
Instituto Brasileiro de Geografia e Estatística [IBGE]. 2023. Favelas e comunidades urbanas: IBGE muda denominação dos aglomerados subnormais. Agência de Notícias IBGE, 13 out. 2023. Disponível em: . Acesso em: 10 mar. 2025.
Instituto de Pesquisa Econômica Aplicada [IPEA]. 2016. Caracterização e tipologia de assentamentos precários. Disponível em: . Acesso em: 09 mar. 2025.
Krishnan, R. 2023. Applied Geospatial Data Science with Python. 1ed. Packt Publishing, Birmingham, Reino Unido.
Kubrusly, L.S.; Saboia, J. 2006. Uma análise multivariada da população ocupada nas regiões metropolitanas brasileiras. Ensaios FEE 27(2): 411-436.
Ministério das Cidades [MCID]. 2023. Guia para o mapeamento e caracterização de assentamentos precários. Disponível em: . Acesso em: 05 mar. 2025.
Ministério das Cidades [MCID]. 2024. Favelas e comunidades urbanas: IBGE retoma termo histórico para censos e pesquisas. Disponível em: . Acesso em: 08 mar. 2025.
Rey, S.J.; Arribas-Bel, D.; Wolf, L.J. 2023. Geographic Data Science with Python. 1ed. Chapman and Hall/CRC, Londres, Reino Unido.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

