
Data Science / Ciencia De Datos
Energía
Estrategia
Herramientas De Gestión
14 de noviembre de 2023
El uso del enfoque multinivel para la predicción de fallos en aerogeneradores
DOI: 10.22167/2675-6528-20230110
E&S 2023,4: e20230110
João Gilberto Máximo Da Silva; José Erasmo Silva
La indisponibilidad de un aerogenerador causada por una falla inesperada de un componente, además de los costos de mantenimiento asociados a la dificultad de acceso de algunos parques eólicos, genera inestabilidad en la generación de energía, pudiendo impactar no solo a las empresas que operan los parques eólicos, sino también a miles de personas que dependen de la energía generada en estos parques.
En un mercado global cada día más competitivo, las empresas buscan la optimización de sus procesos de modo a ser cada vez más productivas. Dentro de este contexto, la disponibilidad de los activos industriales se vuelve un ítem muy importante para la garantía de la productividad, y el área de mantenimiento impacta directamente estos resultados operacionales[1].
Entre los diversos métodos de mantenimiento aplicados hoy, el mantenimiento predictivo se destaca por la capacidad de diagnosticar posibles fallas de equipos en su etapa inicial, evitando así averías inesperadas. Una buena planificación con el uso de las técnicas de mantenimiento predictivo, contribuyen al aumento de la vida útil de los activos, disminuyendo los costos[2].
Uno de los métodos de mantenimiento predictivo más potentes y que aún se utiliza ampliamente es la inspección visual[3]. Este método ha evolucionado hacia el uso de modelos automatizados que realizan la recopilación, el tratamiento y la predicción de eventos utilizando “machine learning”.
El avance en las investigaciones y las publicaciones orientadas al mantenimiento predictivo mediante análisis de vibraciones, han demostrado ser relevantes en los últimos años. Podemos atribuir a este escenario el creciente número de datos obtenidos a través de sistemas cada vez más integrados entre sí, y el avance en la difusión y utilización de algoritmos de “machine learning” como herramientas para tratar y entender el enorme volumen de información obtenida de estos sistemas[4].
Aunque los modelos de regresión logística son muy útiles y fáciles de implementar, todavía se aplican poco en muchas áreas del conocimiento humano. A diferencia de la técnica tradicional de regresión estimada por el método de mínimos cuadrados, en la que la variable dependiente se presenta cuantitativamente, el fenómeno a estudiar se presenta cualitativamente y, por lo tanto, se representa mediante una variable indicadora, pudiendo tener dos o más categorías[5].
Sin embargo, cabe destacar que, en general, los modelos de regresión tradicionales no logran capturar las interacciones entre los componentes de efectos fijos y las interacciones entre las variables en los componentes de efectos aleatorios y los términos de error. En este contexto, el enfoque multinivel surge como una alternativa prometedora. Presenta una ventaja para este estudio de caso, ya que tiene en cuenta el análisis de datos estructurados jerárquicamente[6]. El concepto de análisis de vibraciones, en el que se inserta el mantenimiento predictivo, aborda cada equipo industrial como parte de un conjunto. Este, a su vez, constituye un parque de máquinas. Por lo tanto, la naturaleza jerárquica de los datos justifica la elección de esta técnica para el estudio en cuestión.
Con base en lo discutido, el presente estudio tiene como objetivo emplear el modelado multinivel logístico en la construcción de un modelo predictivo. Este modelo busca identificar la necesidad de mantenimiento en aerogeneradores utilizando datos vibracionales como referencia. Para alcanzar este propósito, se recopilarán y analizarán meticulosamente informaciones relacionadas con los parámetros de vibración generados por estos equipos.
El estudio utilizó un conjunto de datos que contenía registros históricos de análisis vibracionales en aerogeneradores, recopilados entre 2010 y 2012. Estos datos se obtuvieron de una fuente industrial confidencial, garantizando la privacidad y la no divulgación de la empresa en cuestión. Cada aerogenerador, situado en una región única, presenta una organización jerárquica distinta en el conjunto de datos, destacando la naturaleza multinivel de la información. La base de datos abarca 117 torres eólicas, agrupadas en parques con un máximo de 11 torres cada una, distribuidas en tres continentes: Asia, Europa y América del Norte. A pesar de la amplitud en el número de torres, una de las limitaciones del estudio fue tratar las más de 48 millones de líneas de datos generados a partir de las torres. En este sentido, se optó por transformar los datos originales generados cada 10 minutos a la media diaria de estos datos.
La técnica de análisis de vibraciones cuenta con una gama enorme de tecnologías desarrolladas para mejorar la recolección y el análisis de los datos vibracionales provenientes de los equipos rotativos[7],[8]. Para el estudio, se utilizaron los datos provenientes de una de estas tecnologías disponibles en el mercado. Se trata de un módulo de adquisición que realiza la función de colector y analizador de vibraciones; una vez configurado para su finalidad, este módulo realiza la recolección de datos de vibración en tiempo real, sin la necesidad de intervención humana. A través de configuraciones realizadas vía software propietario, el módulo realiza las mediciones y las disponibiliza directamente en el software, donde un analista de vibraciones realiza los análisis y diagnostica el estado del aerogenerador, clasificándolo en niveles de criticidad basados en la norma ISO 20816-3. Para cada torre presente en la base de datos, parámetros de monitoreo condicional de los componentes del aerogenerador fueron recolectados en puntos predefinidos y en común para todas las torres. La Figura 1 ilustra la disposición de los puntos de medición.
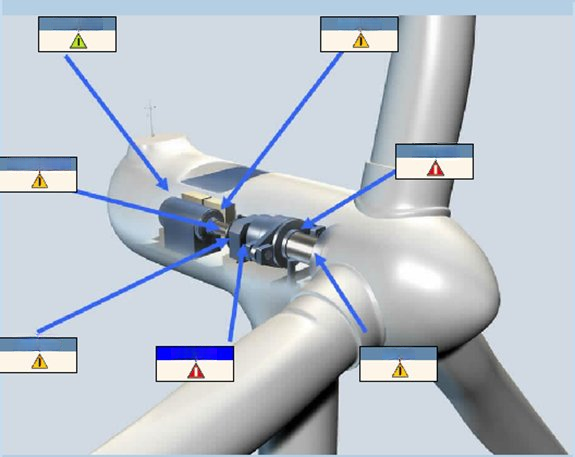
Figura 1. Puntos de medición de vibración en los componentes del aerogenerador
Fuente: Datos originales del trabajo.
En cada punto de medición se dispuso un sensor de aceleración de tipo piezoeléctrico, cada sensor a su vez realiza el registro de los parámetros vibracionales del componente en el que fue instalado, de esta forma es posible obtener los valores globales de vibración para cada magnitud medida.
Los puntos de medición se determinan a través de los cojinetes de eje más importantes de todo el equipo. Un accionamiento de un aerogenerador se define por[9]:
- eje principal “Main”: es el eje acoplado a las hélices del aerogenerador, el viento impulsa las hélices que a su vez giran el eje principal;
- engranaje de entrada del planetario (Planet): la rotación del eje principal se amplifica gracias a un conjunto de engranajes que aumentan la relación de transmisión, de modo que la velocidad de rotación del eje de salida (Shaft3), sea mayor que la velocidad de rotación del eje de entrada “Main”;
- eje intermedio “Shaft2AX”: se trata del eje intermedio del conjunto de engranajes, compuesto por piñón y corona dentados, el acrónimo AX se utiliza para indicar que el posicionamiento del sensor es axial en relación con el eje.
- eje de salida “Shaft3”. es el eje de salida del sistema amplificador de velocidad. Este punto está acoplado directamente al generador, donde se genera la energía;
- cojinete acoplado del generador “GEN_DE”. es el cojinete frontal del generador, donde existe el acoplamiento con el eje de salida del sistema de amplificación de velocidad;
- Cojinete del extremo opuesto al acoplamiento del generador “GEN NDE”. Se trata del cojinete trasero del generador, forma parte del eje del generador, donde el rotor, responsable de la generación de energía, está instalado.
Los parámetros medidos en diferentes puntos se dividen entre operacionales (que se refieren a la operación del aerogenerador, con “Puissance”, o potencia generada) y vibracionales (que se refieren al valor de vibración generado por el aerogenerador en el instante de la recolección, como “Ng Accélération” o Nivel Global de Aceleración). Entre los principales parámetros evaluados, se priorizó definir aquí aquellos que fueron estadísticamente significantes después del procedimiento “stepwise” para el modelo logístico binario[5], y que fueron descritos a continuación:
- “Puissance” (Potencia): parámetro operativo, obtenido a través del sistema “Supervisory Control And Data Acquisition” [SCADA], que informa la potencia generada en MW/h en el momento de la adquisición;
- “VitesseRotation” (Velocidad de Rotación): velocidad angular del eje principal;
- “VitesseVent” (Velocidad del Viento): parámetro operativo, obtenido a través del sistema SCADA, que informa la velocidad del viento en m/s en el momento de la adquisición. Para el estudio, se consideraron las mayores velocidades filtradas del sistema de adquisición, con el fin de observar el escenario de mayor efecto vibratorio;
- “OVL_ACC” (Aceleración Global): el nivel global de vibración es un número obtenido a partir de un cálculo que considera las diversas frecuencias y sus respectivas amplitudes presentes en el espectro, en este caso en el espectro de aceleración;
- “OVL_VEL” (Velocidad de Vibración Global): el nivel global de vibración es un número obtenido a partir de un cálculo que considera las diversas frecuencias y sus respectivas amplitudes presentes en el espectro, en este caso el espectro de Velocidad de Vibración. Todos estos parámetros son utilizados por analistas de vibración para identificar posibles fallas en los componentes de máquinas rotativas en general.
Los datos referentes a las mediciones realizadas en cada punto fueron exportados de la base de datos original en formato .CSV y, posteriormente, cargados en el software R y IDE RStudio para tratamiento y análisis[10],[11].
Aplicando la técnica supervisada de “machine learning” conocida como Regresión Logística, el objetivo fue explicar la probabilidad de ocurrencia del evento estudiado, en este caso, la probabilidad de que un componente del aerogenerador entre en alarma, en función de las variables explicativas que, para este estudio, están representadas por los valores de vibración asociados a los parámetros de monitoreo. Por lo tanto, se aplicó el método de Máxima Verosimilitud para estimar los parámetros de la función logística; a continuación, se verificó la significancia estadística de los parámetros estimados por el método[5].
A continuación, se utilizó el modelado multinivel para capturar los comportamientos de grupo, así como los efectos aleatorios derivados de una estructura multinivel. En el modelado multinivel, además de la naturaleza de los datos, es importante la observación de la estructura del “dataset” y la disposición de los datos, de modo que sea posible observar niveles contextuales. El análisis multinivel permite entonces la elaboración de nuevos constructos, no observables en el modelo logístico.
Para ambas las situaciones, las métricas de mayor interés para la evaluación de los modelos fueron la curva ROC, la sensibilidad y la especificidad. La sensibilidad se refiere al porcentaje de aciertos para un determinado criterio, considerando solo las observaciones de evento, es decir, los valores predichos como eventos y que realmente lo son. La especificidad se refiere al porcentaje de aciertos para un determinado criterio, considerando solo las observaciones de no evento. Por su parte, la curva ROC muestra el comportamiento real del equilibrio entre sensibilidad y especificidad. En este sentido, un determinado modelo con una gran área bajo la curva ROC proporciona una mayor eficiencia predictiva global[5].
Después del proceso de Extracción, Tratamiento y Carga, los datos fueron sometidos a modelado logístico en el software R, siendo posible extraer la información que condujo este estudio. Para el análisis logístico binario, se consideró como variable respuesta el STATUS de alarma de cada parámetro observado, el cual indica los niveles de alarma definidos en el sistema de adquisición y que auxilian al analista de vibraciones en la toma de decisiones. La Tabla 1 presenta los tipos de STATUS provenientes de la base de datos.
Tabla 1. ESTADO de los parámetros
| ESTADO | SENTIDO |
| DNG | PELIGRO – Alarma de nivel 2 |
| ALADI | ALARMA – Alarma de nivel 1 |
| PRERREQUISITO | PREALARMA – Estado previo a la alarma de nivel 1 |
| RAS | Ausencia de alarmas |
Dado que para el analista de vibraciones el STATUS de alarma de nivel 2 es el más crítico, en esta etapa el STATUS “DNG” fue clasificado como ocurrencia del evento, por lo tanto es posible con valor 1 (uno), y los demás STATUS fueron clasificados como no evento o valor 0 (cero). Como es posible observar en la Tabla 2, tras la transformación de los STATUS en valores binarios, se obtuvieron las métricas referentes a la cantidad de eventos y no eventos de la variable respuesta.
Tabla 2. Variable de respuesta después del proceso de “Dummy”
| Fracaso 0 (cero) | Éxito “DNG” 1 (uno) |
| 16325 (86,6%) | 2525 (13,4%) |
En la Tabla 3 se pueden observar las estadísticas descriptivas de las variables explicativas de mayor relevancia dentro del “dataset”.
Tabla 3. Estadísticas descriptivas de los parámetros de vibración
| Variable | Mín | 1° Cuartil | Mediana | Media | 3° Cuartil | Max |
| Potencia | -0,1012 | 0,363 | 0,43 | 0,536 | 0,675 | 1,195 |
| VelocidadViento | 0,00875 | 7,064 | 7,57 | 7,785 | 8,384 | 36,174 |
| VitessRotat | 0,4619 | 21,618 | 22,84 | 24,013 | 26,062 | 30,274 |
| OVL_ACC | 0,00660 | 0,2724 | 0,3625 | 0,41392 | 0,4810 | 2,2927 |
| OVL_VEL | 0,01207 | 0,539 | 0,696 | 0,8928 | 1,057 | 25,6592 |
A continuación, se aplicó el procedimiento de “stepwise” para capturar las mayores relevancias estadísticas de las variables explicativas, excluyendo aquellas que no tienen gran relevancia para el modelo, es decir, no presentan suficiente significancia estadística para explicar el evento[5]. A través de la Tabla 4, se puede observar que la Puissance (Potencia) tiene un impacto negativo en la probabilidad de falla. En este sentido, es posible afirmar que los equipos más potentes están menos sujetos a fallas en la muestra estudiada. Se observa además que la Vitesse_Rotation (Velocidad de Rotación) tiene un impacto positivo, es decir, cuanto mayor es la velocidad, más sujeto a fallas estará el equipo. De esta forma, otros estudios pueden realizarse con el objetivo de definir la velocidad ideal para que el equipo continúe siendo productivo, pero menos sujeto a fallas. Finalmente, las variables OVL_ACC (Aceleración Global) y OVL_VEL (Velocidad de Vibración Global) también presentaron coeficientes positivos, indicando mayor probabilidad de fallas con el aumento de estos factores.
Tabla 4. Coeficientes estimados tras “stepwise”
| Variables | Apreciado | Error Estándar | Valor | Pr (>|z|) | Sgte. |
| (Intercepto) | -11,115 | 1,27854 | -8,693 | 2,00E-16 | *** |
| Potencia | -8,48461 | 0,99015 | -8,569 | 2,00E-16 | *** |
| Velocidad_Rotación | 0,48235 | 0,07591 | 6,354 | 2,1e-10 | *** |
| OVL_ACC | 2,92158 | 0,10763 | 27,145 | 2,00E-16 | *** |
| OVL_VEL | 0,8029 | 0,05008 | 19,574 | 2,00E-16 | *** |
Nota: *** significante al nivel de 0,001
Sin embargo, al analizar la matriz de confusión, responsable de indicar los aciertos y errores del modelo de clasificación, confrontando los eventos reales con los eventos predichos por el modelo, se observó que este presenta un índice de acierto bajo en relación a los eventos predichos como TRUE y que realmente presentan valor TRUE, para un “cutoff” estándar de 50%.
Tabla 5. Matriz de confusión
| REAL | ||||
| VERDADERO | INCORRECTO | SUMA | ||
| PLANIFICADO | VERDADERO | 233 | 187 | 420 |
| INCORRECTO | 2292 | 15429 | 17721 | |
| SUMA | 2525 | 15616 | 18141 | |
A pesar de una precisión interesante en el rango del 86%, el modelo presentó baja sensibilidad y alta especificidad, 9,2% y 98,8%, respectivamente, como se observa en la Tabla 6.
El área bajo la curva ROC es un índice importante para la evaluación global del modelo, ya que muestra gráficamente la relación entre especificidad y sensibilidad para diferentes valores “cutoff”; dentro de este contexto, el modelo presentó un área bajo la curva ROC del 73,9%, como se puede observar en la Figura 2.
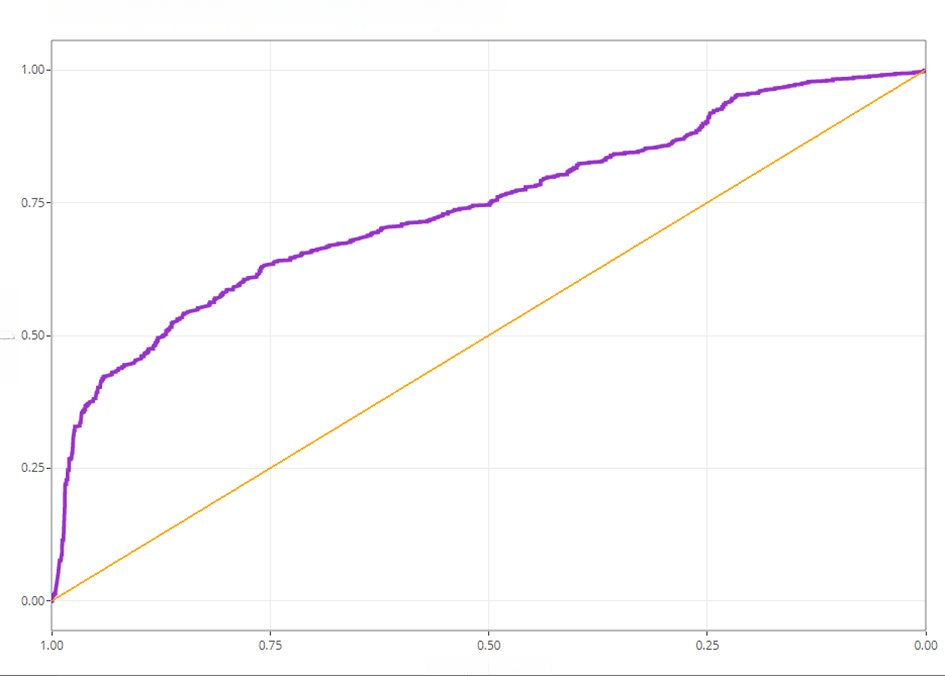
Figura 2. Curva ROC
Fuente: Resultados originales de la investigación.
Tras el análisis de los resultados obtenidos por el modelo logístico binario, se empleó la metodología multinivel para identificar los efectos aleatorios asociados a diferentes grupos. Teniendo en cuenta que las torres están distribuidas en diversas regiones del globo, los grupos fueron separados en el “dataset”. Estas torres fueron categorizadas por “farms”, término utilizado para designar los parques eólicos. Cabe destacar que una única región puede albergar múltiples “farms”.
La investigación analizó un total de 117 torres eólicas. Estas torres se distribuyen en parques que contienen hasta 11 torres cada una y están ubicadas en tres continentes distintos: Asia, Europa y América del Norte. Cabe destacar que una única región geográfica puede albergar varias “granjas”. Por ejemplo, en Europa, se encuentran las “granjas” WF1, WF2_L1 y WF2_L2, como se ilustra en la Figura 3.
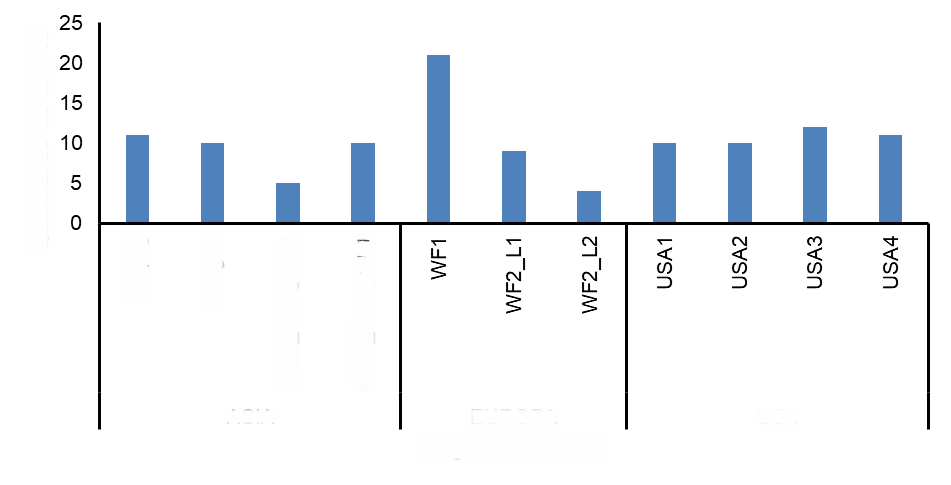
Figura 3. Número de torres por “farms” y región
Fuente: Resultados originales de la investigación
Dado que los modelos jerárquicos multinivel son capaces de capturar la descomposición de la varianza de los efectos aleatorios de grupo, donde la variable respuesta se presenta de forma categórica, como se ha observado hasta ahora, el principio fue precisamente dicotomizar la variable STATUS, de manera análoga a lo que se había realizado en el análisis con la metodología logística binaria[5]. Sin embargo, esta vez, además de considerar la categoría “DNG” (Peligro) como evento, se incluyó también la categoría “ALM” (Alarma) como evento. La Tabla 7 muestra cómo quedaron los recuentos de no eventos x eventos después de la dicotomización de la variable STATUS. Se observa que, en relación con el primer modelo, el aumento en el número de eventos fue de aproximadamente 265%, resultando así en un 63,10% de no eventos y un 36,9% de eventos.
Tabla 7. Variable de respuesta después del proceso de “Dummy”
| Fracaso 0 (cero) | Éxito “DNG” y “ALM” 1 (uno) |
| 11447 (63,10%) | 6694 (36,9%) |
Aún en la transformación del “dataset”, se incluyó la derivación de la variable FECHA DE MEDICIÓN en “dummies”, con el objetivo de observar la influencia de efectos climáticos (estaciones del año) en la variable respuesta. De este modo, los meses fueron dispuestos como categorías para la creación de las “dummies”. Tras este procedimiento, se generó el modelo multinivel que presentó los siguientes parámetros tras ser estimado, conforme a la Tabla 8.
Tabla 8. Resultados del modelo multinivel con interceptos aleatorios
| Variables | Apreciado | Error Estándar | valor | Pr(>|z|) | Sgte. |
| (Intercepto) | -2,15826 | 0,66310 | -3,25 | 0,00113 | ** |
| Potencia | -3,63266 | 0,13518 | -26,87 | < 2e-16 | *** |
| OVL_ACC | 7,00496 | 0,15169 | 46,18 | < 2e-16 | *** |
| OVL_VEL | 1,81259 | 0,05710 | 31,74 | < 2e-16 | *** |
| Arret_Acceleration | -0,71068 | 0,04476 | -15,88 | < 2e-16 | *** |
| mes_2 | 0,73728 | 0,06296 | 11,71 | < 2e-16 | *** |
| mes_3 | 0,18792 | 0,06620 | 2,84 | 0,00453 | ** |
| mes_cuatro | 0,29344 | 0,06575 | 4,46 | 8,08e-06 | *** |
| mes 5 | -0,18472 | 0,06084 | -3,04 | 0,00240 | ** |
| mes_siete | 0,17836 | 0,05842 | 3,05 | 0,00227 | ** |
| mes_8 | 0,16693 | 0,05680 | 2,94 | 0,00330 | ** |
| mes_9 | -1,15504 | 0,12609 | -9,16 | < 2e-16 | *** |
| mes_10 | 0,23240 | 0,11799 | 1,97 | 0,04889 | * |
| mes_11 | -2,16955 | 0,12854 | -16,88 | < 2e-16 | *** |
| mes_12 | -0,68953 | 0,10325 | -6,68 | 2,41e-11 | *** |
Nota: *** significante al nivel de 0,001; ** significante al nivel de 0,01; * significante al nivel
de 0,05
A partir de la Tabla 8 es posible percibir que los signos de los coeficientes se mantuvieron compatibles con la regresión logística multinivel, sin embargo, con valores diferentes. Los valores diferentes se debieron a otras variables que fueron insertadas en los efectos fijos, especialmente los meses, así como a los niveles aleatorios región y “farm”. Como los meses fueron insertados como “dummies”, sus resultados se dan en comparación con el mes de enero (mes_1) que fue insertado como variable de referencia. De esta forma, se puede interpretar que el mes de noviembre (mes_11) tiene menor probabilidad de falla en relación a enero; por otro lado, el mes de febrero tiene una mayor probabilidad en relación a enero. También se estimaron los parámetros de los efectos aleatorios, conforme presenta la Tabla 9.
Tabla 9. Estadísticas de los efectos
| Nombres de los Grupos | Varianza | Desviación Estándar | |
| región | (Intercepto) | 0,04424 | 0,2103 |
| granja | (Intercepto) | 4,32420 | 2,0795 |
La Tabla 9 muestra que la mayor varianza ocurre entre las diferentes fincas (“farm”) y que la varianza entre las regiones es discreta. Para evaluar la matriz de confusión, se elaboró un gráfico en el software R, con el objetivo de identificar el punto óptimo de intersección entre los valores de sensibilidad y especificidad. Conforme se ilustra en la Figura 4, el punto de corte (“cutoff”) seleccionado para la construcción de la matriz de confusión se estableció en 30%.
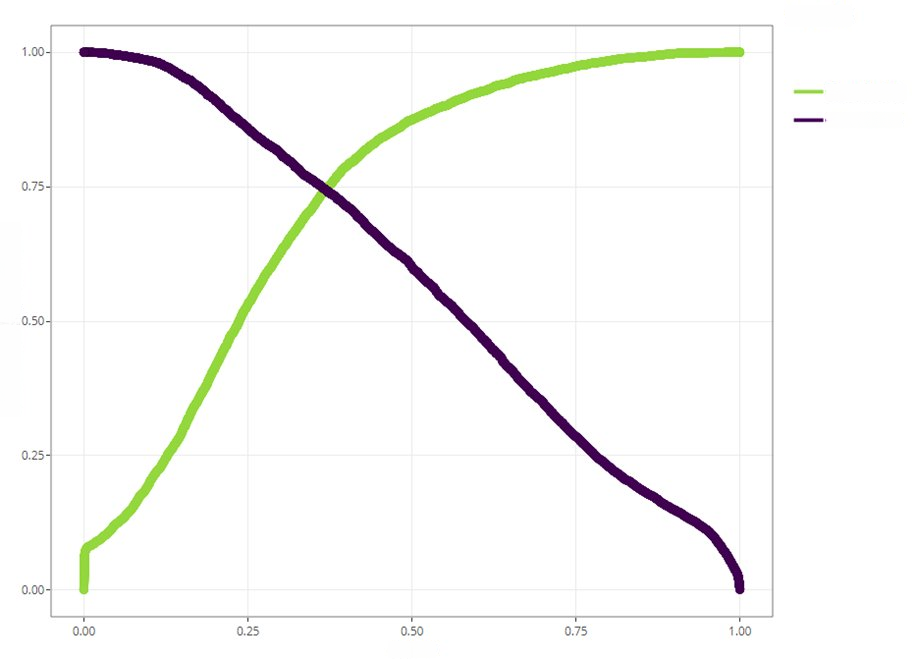
Figura 4. Gráfico sensibilidad x especificidad
Fuente: Resultados originales de la investigación
Con el mejor “cutoff” definido, se pudo entonces generar la matriz de confusión y los parámetros para la evaluación del modelo, como los valores de sensibilidad, es decir, cuán preciso es el modelo al clasificar los eventos, y la especificidad, es decir, cuán preciso es el modelo en evitar falsos positivos. Se resalta el considerable aumento de la sensibilidad en relación al modelo logístico binario (cerca de 71,8% de aumento), mientras que la especificidad tuvo una pequeña retracción. La Tabla 10 muestra la matriz de confusión y los parámetros de evaluación.
Tabla 10. Matriz de confusión
| REAL | ||||
| VERDADERO | INCORRECTO | SUMA | ||
| PLANIFICADO | VERDADERO | 6799 | 4922 | 11721 |
| INCORRECTO | 1585 | 8317 | 9902 | |
| SUMA | 8384 | 13239 | 21623 | |
Tabla 11. Parámetros de evaluación
| Métrica | Valía |
| Precisión | 0,6991 |
| Sensibilidad | 0,8109 |
| Especificidad | 0,6282 |
| Precisión balanceada | 0,7196 |
Al analizar la Tabla 11 en comparación con la Tabla 6, es evidente que algunas métricas presentaron empeoramiento, mientras que otras demostraron mejoras. Este cambio se debe al punto en que se aplicó el corte. En el caso del modelo logístico multinivel, se optó por un corte del 30%, en contraste con el modelo logístico binario, en el cual se utilizó el corte estándar del 50%. Sin embargo, es crucial destacar que se alcanzó el objetivo de ajustar el valor de “cutoff”, es decir, se logró equilibrar los valores de las métricas, pero cabe resaltar que el punto ideal de “cutoff” puede variar dependiendo del fenómeno en estudio.
Además de las métricas evaluadas anteriormente, otra métrica importante es el área bajo la curva ROC, ya que desempeña un papel crucial en la evaluación integral del modelo. En este contexto, cabe destacar que el modelo logístico multinivel alcanzó un área bajo la curva ROC del 81,9%, lo que representa un aumento del 8% en comparación con el modelo logístico binario, como se ilustra en la Figura 5.
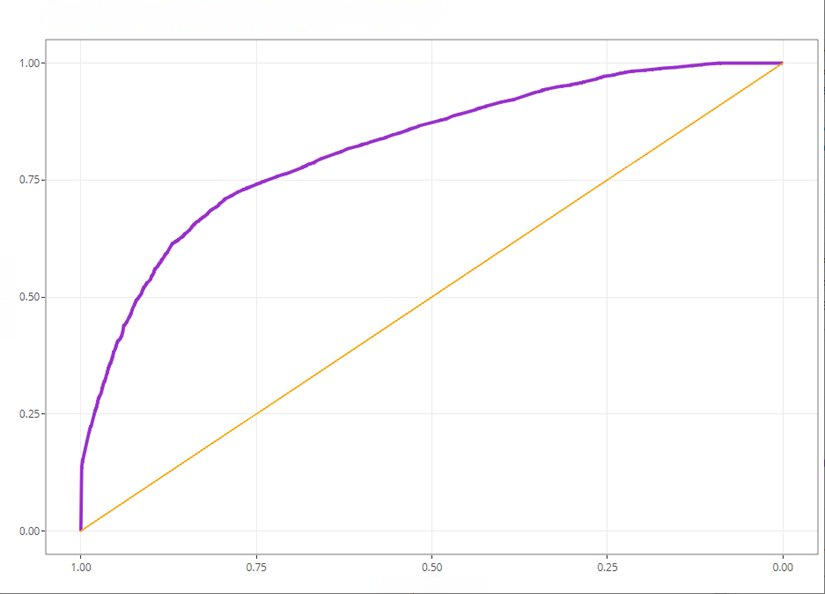
Figura 5. Curva ROC
Fuente: Resultados originales de la investigación
El estudio tuvo éxito en el logro del objetivo principal al demostrar las respectivas curvas ROC de los modelos logístico binario y multinivel logístico, de modo que fue posible observar que este último presenta mayor eficiencia predictiva global; de esta manera, la aplicación de modelado multinivel, teniendo en cuenta la influencia de efectos aleatorios imposibles de capturar con el modelado logístico binario, se muestra como una técnica relevante para la predicción de fallas en aerogeneradores.
Referencias
[1] Brito J. N. 2017. Plano De Manutenção de Ativos Físicos Como Parte Estratégica do Negócio. In: XVII Congresso Nacional de engenharia mecânica e industrial, 2017, Joinville, SC, Brasil. Disponível em: <http://doi.org/10.17648/conemi-2018-91231>. Acesso em: 16 out. 2022.
[2] Brito J. N. Marques A. C. 2019. Importância da manutenção preditiva para diminuir o custo em manutenção e aumentar a vida útil dos equipamentos. Brazilian Journal of Development. 5(7): 8913-8923. Disponível em: <https://doi.org/10.34117/bjdv5n7-095>. Acesso em: 16 out. 2022
[3] Hashemian H. M. 2011. State-of-the-Art Predictive Maintenance Techniques. IEEE Transactions on Instrumentation and Measurement. 60(1): 226–236. Disponível em: < https://doi.org/10.1109/TIM.2009.2036347>. Acesso em: 28 set. 2022.
[4] Carvalho T. P., et al. 2019. A systematic literature review of machine learning methods applied to predictive maintenance. Computers & Industrial Engineering. 137: 106024. Disponível em: <https://doi.org/10.1016/j.cie.2019.106024>. Acesso em: 12 out. 2022.
[5] Fávero L. P.; Belfiore, P. 2017. Manual de análise de dados: estatística e modelagem multivariada com Excel®, SPSS® e Stata®. Elsevier, Rio de Janeiro, Brasil.
[6] Confortini, D; Fávero L. P. 2010. Modelos multinível de coeficientes aleatórios e os efeitos firma, setor e tempo no mercado acionário Brasileiro. Pesquisa Operacional. 30(3): 703-727. Disponível em: <https://doi.org/10.1590/S0101-74382010000300011>. Acesso em: 12 out. 2022.
[7] Al-Musthafa M. I. Learning Vector Quantization Based Vibration Analysis for Steam Power Plant Rotating Equipment Fault Diagnosis. In: 2019 International Conference on Technologies and Policies in Electric Power & Energy. IEEE, 2019. p. 1-3. Disponível em: < https://dx.doi.org/10.1109/IEEECONF48524.2019.9102521>. Acesso em: 10 out. 2022.
[8] Soto-Ocampo, C. R.; Mera J. M.; Cano-Moreno J. D.; Bernardo J. L. G. Low-cost, high-frequency, data acquisition system for condition monitoring of rotating machinery through vibration analysis-case study. Sensors, v. 20, n. 12, p. 3493, 2020. Disponível em: <https://dx.doi.org/10.3390/s20123493>. Acesso em: 16 out. 2022
[9] Manwell J. F.; Mcgowan, Jon G.; Rogers, Anthony L. Wind energy explained: theory, design and application. John Wiley & Sons, 2010. Disponível em: <http://doi.org/10.1002/9781119994367>. Acesso em: 16 out. 2022.
[10] R Core Team. R: A language and environment for statistical computing. Viena, Áustria: R Foundation for Statistical Computing, 2022. Disponível em: <https://www.R-project.org/>. Acesso em: 10 set. 2022.
[11] RStudio Team. RStudio: Integrated Development Environment for R. Boston, MA: RStudio, PBC, 2022. Disponível em: <https://www.rstudio.com/>. Acesso em: 10 set. 2022.
Cómo citar
Silva J. G. M.; Silva J. E. El uso del enfoque multinivel para la predicción de fallos en aerogeneradores. Revista E&S. 2023; 4: e20230110.
Sobre los autores
João Gilberto Máximo Da Silva  , Alameda João Galego, 988 – Santa Maria; 09560-340 – São Caetano do Sul, São Paulo, Brasil.
José Erasmo Silva , Profesor Orientador MBA Data Science e Analytics, Rua Maria Társia, 51 – Jardim Elite; 13417-440. Piracicaba, São Paulo, Brasil.
Enlace de descarga: PDF