Entre sensores y algoritmos: la nueva lógica del mantenimiento industrial

Columna

Data Science / Ciencia De Datos

Data Science / Ciencia De Datos

Tecnología

09 de junio de 2025

Entre sensores y algoritmos: la nueva lógica del mantenimiento industrial

Antes restringido a ambientes altamente tecnológicos, o suporte preditivo agora se apresenta como uma possibilidade concreta e acessível
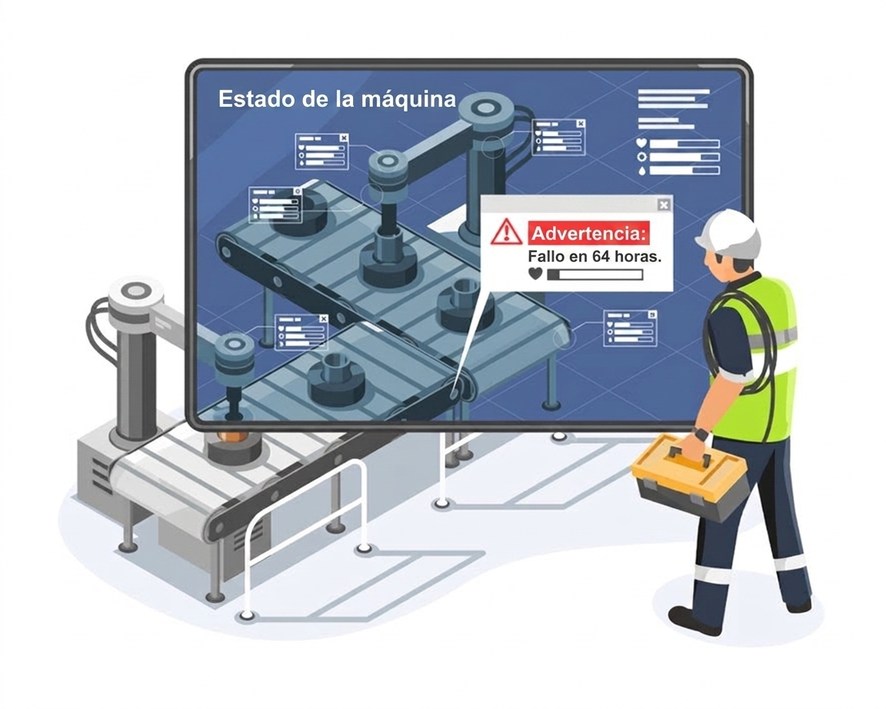
El mantenimiento predictivo ha ganado protagonismo en la industria moderna, al permitir la anticipación de fallas y la optimización de la disponibilidad de activos productivos. A diferencia de los modelos tradicionales, como el mantenimiento correctivo y el preventivo, este enfoque utiliza datos reales de operación y algoritmos inteligentes para indicar el momento ideal de intervención, reduciendo paradas no programadas y costos operativos (Es-sakali et al., 2022; Poór & Basl, 2019).

Con el avance de la Industria 4.0, sensores embebidos, redes industriales y sistemas de monitoreo pasaron a generar grandes volúmenes de datos en tiempo real, lo que abrió espacio para la aplicación de técnicas de Data Science / Ciencia de datos, como aprendizaje automático, redes neuronales y modelos estadísticos (DalzCochio et al., 2020; Esteban et al., 2022). En este contexto, la ciencia de datos actúa como un medio para convertir datos brutos en información útil para decisiones de mantenimiento.

La creciente disponibilidad de datos operativos y la madurez de las herramientas analíticas han convertido el mantenimiento predictivo en una aplicación concreta de la ciencia de datos dentro de las operaciones industriales. Modelos como redes neuronales recurrentes, máquinas de vectores de soporte, algoritmos de clasificación y técnicas de aprendizaje profundo ya se utilizan con éxito para predecir fallos, estimar la vida útil remanente de equipos y clasificar patrones de degradación (Nikfar et al., 2022; Singh et al., 2023; Wang et al., 2024).

 Además, enfoques más recientes, como el aprendizaje por transferencia, el aprendizaje continuo y el aprendizaje federado, se han estado explorando para sortear limitaciones como la escasez de datos etiquetados, entornos operativos no estacionarios y restricciones de privacidad en aplicaciones descentralizadas (Ahn et al., 2023; Azari et al., 2023; Hurtado et al., 2023). Estos avances demuestran que la Data Science / Ciencia de datos ocupa una posición estratégica en la transición de modelos de mantenimiento basados en reacción para estrategias orientadas por predicción y optimización.

Aplicaciones

La aplicación de la ciencia de datos en el mantenimiento predictivo ya es una realidad en diversos sectores industriales, destacando las áreas de energía, manufactura y transporte, y el sector aeroespacial. En motores industriales de baja tensión, por ejemplo, algoritmos como redes neuronales, random forest y máquinas de vector de soporte se han utilizado con éxito para detectar fallos y clasificarlos con una precisión superior al 95%, incluso con conjuntos de datos relativamente pequeños (Nikfar et al., 2022).

En entornos industriales más complejos, como líneas de producción automotriz y turbinas eólicas, sensores multivariados integrados a modelos de aprendizaje profundo, como CNNs y LSTMs, han permitido diagnósticos más robustos e intervenciones tempranas, con una precisión cercana al 100% en la detección de anomalías (Abdullahi et al., 2024; Gawde et al., 2024). Estos resultados ilustran cómo la recolección y el tratamiento adecuado de datos, aliados a modelos predictivos bien calibrados, pueden reducir fallas inesperadas y aumentar la disponibilidad de los activos con impacto directo en la productividad.

Además de los modelos predictivos convencionales, el uso de gemelos digitales se ha consolidado como una extensión sofisticada de la ciencia de datos aplicada al mantenimiento. El término “gemelo digital” se refiere a la creación de una réplica virtual de un activo físico, como un motor o una turbina, que refleja su comportamiento en tiempo real mediante la integración de sensores y modelos computacionales. Al igual que un gemelo humano comparte características genéticas, el gemelo digital comparte datos operativos con su equivalente físico. Al integrar modelos físicos y basados en datos, los gemelos digitales permiten simulaciones en tiempo real, diagnósticos continuos y estimaciones precisas de la vida útil restante de componentes críticos, como motores, cajas de engranajes y sistemas de baterías (Singh et al., 2023; van Dinter et al., 2022; Zhong et al., 2023).

En estudios recientes, arquitecturas distribuidas de gemelos digitales se han aplicado con éxito en turbinas eólicas, combinando sensores físicos, computación en la nube y modelos de aprendizaje profundo para la predicción de fallos con elevada precisión y baja latencia (Abdullahi et al., 2024). En otro ejemplo, la conversión de series temporales en imágenes mediante técnicas como Gramian Angular Fields, posteriormente analizadas por redes convolucionales, permitió la detección de fallos críticos en motores industriales con un 100% de acierto, superando modelos tradicionales como SVM (Kiangala & Wang, 2020).

Estos casos demuestran que, cuando se aplican correctamente, las herramientas de ciencia de datos ofrecen no solo precisión predictiva, sino también visualización, transparencia y toma de decisiones más ágil.

Baremo

Ante la diversidad de equipos, contextos operativos y restricciones de privacidad, enfoques más recientes han buscado hacer que los modelos predictivos sean más generalizables, escalables y colaborativos. El aprendizaje federado, por ejemplo, se ha utilizado para entrenar modelos predictivos distribuidos en múltiples fábricas sin la necesidad de centralizar los datos, protegiendo la confidencialidad y adaptando los algoritmos a las peculiaridades de cada unidad industrial (Ahn et al., 2023). Por su parte, el aprendizaje por transferencia ha demostrado ser útil para aprovechar modelos previamente entrenados en equipos similares, reduciendo la necesidad de grandes volúmenes de datos etiquetados y acelerando la adopción en nuevos activos (Azari et al., 2023).

En escenarios dinámicos, en los que el comportamiento del sistema cambia con el tiempo, el aprendizaje continuo se ha explorado para garantizar que los modelos se actualicen sin perder el conocimiento adquirido, manejando diferentes regímenes operativos y variaciones en los datos de los sensores (Hurtado et al., 2023). Estas aplicaciones demuestran la madurez de la ciencia de datos en el campo del mantenimiento, no solo como herramienta de predicción, sino como tecnología adaptativa y estratégica.

Desafíos

A pesar de los avances, la implementación del mantenimiento predictivo basado en ciencia de datos enfrenta desafíos. Uno de los principales obstáculos está relacionado con la calidad y disponibilidad de los datos. Equipos antiguos a menudo no están preparados para proporcionar datos en tiempo real, y, aun cuando los sensores están disponibles, la recolección puede verse afectada por ruidos, pérdidas e inconsistencias, comprometiendo la eficacia de los modelos predictivos (Dalzochio et al., 2020; Esteban et al., 2022).

Además, la escasez de registros de fallos es un problema recurrente, ya que la mayoría de los activos operan durante largos períodos sin presentar fallos críticos. Esta limitación afecta especialmente a los modelos supervisados, que dependen de datos etiquetados para aprender patrones de degradación (Azari et al., 2023; Divya et al., 2023).

En respuesta a este escenario, muchos estudios han invertido en enfoques híbridos o no supervisados, así como en el uso de datos sintéticos y gemelos digitales como alternativas para simular fallas y enriquecer los conjuntos de entrenamiento (Singh et al., 2023; Zhong et al., 2023).

Otro desafío se refiere a la integración de los modelos predictivos en la cultura y los procesos de toma de decisiones de las organizaciones. Incluso cuando hay disponibilidad de datos y capacidad analítica, es común encontrar resistencia por parte de gerentes y equipos operativos para confiar plenamente en las recomendaciones proporcionadas por algoritmos de inteligencia artificial, especialmente cuando estos modelos funcionan como cajas negras — aunque los algoritmos generen predicciones o diagnósticos, no explican de forma transparente cómo llegaron a esas conclusiones, lo que dificulta la validación de los profesionales que dependen de esta información para tomar decisiones críticas (Chen et al., 2021; Gawde et al., 2024).

Para mitigar este problema, diversos enfoques han incorporado técnicas de inteligencia artificial explicable (XAI), como LIME y análisis de importancia de variables, permitiendo que los expertos comprendan los factores que llevaron a la predicción de una falla o al desencadenamiento de una intervención (Ahn et al., 2023; Gawde et al., 2024). Además, la adopción de tecnologías predictivas a menudo se ve obstaculizada por la ausencia de personal cualificado, exigiendo nuevos perfiles profesionales con competencias en ciencia de datos, mantenimiento y tecnologías digitales (Poór & Basl, 2019). Esto refuerza la necesidad de programas de capacitación y cambio cultural que alineen la transformación digital con los objetivos estratégicos de confiabilidad y desempeño operacional.

Adicionalmente, aspectos regulatorios y financieros también imponen barreras a la adopción a gran escala del mantenimiento predictivo basado en ciencia de datos. En sectores como el ferroviario, aeronáutico y energético, la implementación de sistemas predictivos necesita atender exigencias rigurosas de seguridad y trazabilidad, lo que exige validación técnica de los modelos y transparencia en la toma de decisiones (Rokhforoz & Fink, 2021; Scott et al., 2022).

Desde el punto de vista económico, la inversión inicial necesaria para la adquisición de sensores, infraestructura de red, almacenamiento en la nube y desarrollo de modelos analíticos puede ser elevada, especialmente para pequeñas y medianas empresas (Chen et al., 2021; Meng et al., 2022). Aunque diversos estudios demuestran un retorno positivo de la inversión a lo largo del tiempo, la ausencia de estandarización en arquitecturas, plataformas y protocolos dificulta la replicación de soluciones entre empresas y sectores (Ton et al., 2020; van Dinter et al., 2022). Como respuesta, iniciativas recientes han buscado desarrollar frameworks genéricos y modelos de madurez que ayuden a las organizaciones a planificar la transición gradual del mantenimiento tradicional al predictivo (Mesarosova et al., 2022; Poór & Basl, 2019).

Conclusión

La consolidación del mantenimiento predictivo como una práctica estratégica en las organizaciones industriales ha sido impulsada directamente por el avance de la ciencia de datos. Los modelos estadísticos, los algoritmos de aprendizaje automático y las técnicas de inteligencia artificial han demostrado ser altamente eficaces en la predicción de fallos, la estimación de la vida útil restante de los activos y la generación de alertas tempranas basadas en datos reales de operación (Esteban et al., 2022; Nikfar et al., 2022; Singh et al., 2023).

Al mismo tiempo, la ciencia de datos ha posibilitado el desarrollo de soluciones más sofisticadas, como gemelos digitales y arquitecturas distribuidas con computación en el borde, capaces de procesar información en tiempo real y tomar decisiones localmente (Abdullahi et al., 2024; Zhong et al., 2023). El mantenimiento predictivo, antes restringido a entornos altamente tecnológicos, ahora se presenta como una posibilidad concreta y accesible, siempre que esté estructurado con base en datos relevantes, métodos adecuados y una visión organizacional integrada.

El futuro del mantenimiento predictivo está directamente ligado a la evolución de enfoques cada vez más adaptativos, colaborativos y explicables. Tendencias como el aprendizaje continuo, el aprendizaje federado y la transferencia de aprendizaje ganarán protagonismo, ya que permiten la actualización constante de los modelos incluso en entornos descentralizados, con poco etiquetado o sujetos a cambios operativos (Ahn et al., 2023; Azari et al., 2023; Hurtado et al., 2023).

Además, la integración entre ciencia de datos y áreas como logística, producción y gestión de activos posibilita una visión más amplia, conectando decisiones técnicas a estrategias de negocio (Meng et al., 2022; Wang et al., 2024). En este contexto, la capacidad de interpretar los modelos, garantizar la calidad de los datos y formar profesionales capaces de intermediar conocimiento técnico y analítico será determinante para el éxito. Más que una evolución tecnológica, el mantenimiento predictivo representa un cambio de mentalidad: del reparo reactivo a la anticipación inteligente, del análisis aislado a la decisión basada en datos. En este nuevo escenario, la ciencia de datos deja de ser una herramienta de soporte y pasa a ocupar un lugar central en la ingeniería, en la gestión de activos y en la construcción de operaciones industriales resilientes. Las organizaciones que sepan unir conocimiento técnico, datos de calidad y visión estratégica estarán más preparadas para competir en entornos industriales cada vez más exigentes, dinámicos y orientados por información.

Para tener acceso a las referencias de este texto haga clic aquí.

Quién publicó esta columna

José Erasmo Silva
José Erasmo Silva é professor, formado em Matemática e Administração, com mais de 25 anos de experiência em gestão empresarial e de pessoas. É mestre e doutor em Administração, com foco em Finanças, e especialista em Data Science e Analytics e em Finanças e Controladoria. Realizou pós-doutorado na Universidade Federal da Bahia (UFBA). Atualmente, atua como professor orientador no MBA em Data Science, Inteligência Artificial e Analytics da USP/Esalq e leciona na EEP/FUMEP e na rede estadual de ensino de São Paulo.

También te puede interesar

17 de noviembre de 2026

Detección y Diagnóstico de Enfermedades en Maíz y Arroz en Mozambique con Deep Learning

La agricultura mozambiqueña depende del maíz y el arroz, cultivos fundamentales para la seguridad alimentaria, pero su productividad se ve fuertemente afectada por enfermedades fitosanitarias, cuya identificación temprana y precisa sigue siendo un desafío en contextos de recursos limitados. El estudio tuvo como objetivo desarrollar y comparar modelos basados en Deep Learning para la detección y el diagnóstico automático de enfermedades en hojas de maíz y arroz en Mozambique. Se utilizaron tres enfoques: una Red Neuronal Convolucional (CNN) clásica desarrollada desde cero, y dos modelos de transfer learning, ResNet50 y MobileNetV2. El conjunto de datos se compuso de imágenes de bases públicas y recolectadas en campo, que pasaron por etapas de limpieza, balanceo y aumento artificial. Los modelos fueron entrenados y evaluados con métricas de desempeño estándar, incluyendo precisión (accuracy), precisión (precision), recall, F1-score, Log Loss y Kappa de Cohen. La CNN clásica presentó el mejor desempeño global, con 94% de precisión (precision), recall y F1-score, y 93% de precisión (accuracy) y Kappa de Cohen. La MobileNetV2 alcanzó 91% de F1-score y 90% de precisión (accuracy), destacándose por el menor Log Loss (0,30) y tiempo de entrenamiento (6h32min59s). La ResNet50 alcanzó 80% de F1-score y 79% de precisión (accuracy). Se concluyó que las técnicas de Deep Learning poseen un elevado potencial para apoyar el diagnóstico fitopatológico en contextos agrícolas reales, contribuyendo a decisiones más rápidas y precisas en el manejo de enfermedades en maíz y arroz.

Palabras clave: Aprendizaje profundo; Arroz; Enfermedades en plantas; Maíz; Visión computacional.

17 de noviembre de 2026

Estructuración del proceso de cierre de proyectos de una industria de la construcción civil

Un estudio abordó el grupo de procesos de cierre de proyectos en una industria de manufactura de la construcción civil, utilizando la guía PMBOK como referencia principal. El proceso existente en la industria presentaba superficialidad y fragilidades, especialmente en el registro de lecciones aprendidas. Ante este escenario, el objetivo fue desarrollar un procedimiento para el cierre de proyectos de la organización, visando agregar valor por medio de la estandarización del proceso, registro del conocimiento adquirido, formalización de la conclusión y entrega de los proyectos, y mejoramiento de la comunicación, compromiso, integración y transparencia con los stakeholders. La investigación se clasificó como descriptiva, empleó datos cualitativos y adoptó la investigación-acción como delineamiento. El alcance del estudio se estructuró conforme a los cinco grupos de procesos de la guía PMBOK y fue representado por una Estructura Analítica de Proyecto (EAP). Los principales resultados obtenidos incluyeron el procedimiento desarrollado y diversas plantillas de documentos, que constituyeron los entregables del nuevo proceso de cierre de proyectos. Se verificó que el trabajo alcanzó el objetivo esperado, pues el procedimiento desarrollado viabilizó la estandarización del cierre de proyectos, el mejoramiento de la integración y el compromiso con los stakeholders, y la promoción de seguridad y transparencia en el proceso.

Palabras clave: Gestión del conocimiento; Lecciones aprendidas; PMBOK; Plantillas; Término de aceptación de proyecto.

17 de noviembre de 2026

Machine Learning y priorización de funcionalidades en productos digitales: un estudio de caso en una fintech

Una investigación analizó el potencial del uso de técnicas de machine learning aplicadas al análisis del comportamiento de los usuarios en la priorización de funcionalidades en productos digitales. El objetivo fue comprender los procesos de priorización utilizados en la práctica, el papel de los datos de comportamiento en la toma de decisiones y las percepciones sobre la aplicación de técnicas de machine learning en este contexto. Se adoptó un enfoque cualitativo y exploratorio, estructurado como un estudio de caso en productos desarrollados bajo el modelo Software as a Service (SaaS). La recolección de datos se realizó a través de entrevistas semiestructuradas con profesionales de las áreas de producto y de datos. El análisis de los datos siguió la técnica de análisis de contenido. Los resultados indicaron que, aunque los datos de comportamiento ya se utilizaban como apoyo a la decisión, los procesos de priorización aún presentaban baja formalización y enfrentaban limitaciones técnicas y organizacionales. Se observó, también, el reconocimiento del potencial del machine learning como soporte estratégico a la priorización de funcionalidades, aunque su aplicación práctica fuera incipiente. Como principal contribución, el estudio propuso un modelo conceptual que integra datos de comportamiento, procesos de priorización y el uso de machine learning como soporte a la decisión.

Palabras clave: Análisis de datos; Comportamiento del usuario; Datos de comportamiento; Software as a Service (SaaS); Toma de decisiones.

17 de noviembre de 2026

Inteligencia artificial en las rutinas operativas contables y en la eficiencia financiera

La incorporación de Inteligencia Artificial (IA) y de herramientas de automatización ha reconfigurado las rutinas de las oficinas contables brasileñas, impactando la productividad, la mitigación de errores y la eficiencia financiera. Se analizaron estos impactos en una oficina contable de pequeño tamaño, especializada en la atención a prestadores de servicios del área médica en São Caetano do Sul, São Paulo. La investigación adoptó un enfoque cualitativo, con un diseño de estudio de caso único y unidades de análisis incorporadas. Los datos se recolectaron mediante un cuestionario estructurado, aplicado vía Google Forms entre enero y febrero de 2026, a cinco profesionales de la estructura operativa de la oficina en un relevamiento censal. El tratamiento siguió un análisis de contenido con categorías a priori y emergentes. Todos los encuestados declararon uso de herramientas automatizadas o con recursos de IA. La percepción de reducción del tiempo de ejecución, de disminución de errores operacionales, de retrabajo y de mejor aprovechamiento del tiempo del equipo convergió en el 80% de las respuestas afirmativas y el 20% parciales. Las actividades más beneficiadas fueron la conciliación bancaria, la importación de documentos fiscales y la liquidación tributaria, con ganancias visibles sobre errores de digitación, asientos duplicados y clasificación incorrecta. La intervención humana permaneció indispensable en la planificación tributaria, el análisis de escenarios y la verificación de obligaciones accesorias. La evaluación general de la contribución de la IA fue predominantemente favorable, con moderación vinculada a la complejidad normativa fiscal.

Palabras clave: Análisis de contenido; Automatización de procesos; Contabilidad 4.0; Pequeño tamaño; Transformación digital.

17 de noviembre de 2026

Factores que influyen en la gestión de plazos en proyectos de “retrofit” de estaciones de tratamiento de aguas residuales

Los proyectos de “retrofit” en Plantas de Tratamiento de Aguas Residuales (PTAR) se caracterizan por su alta complejidad, restricciones operativas y múltiples interfaces técnicas. El estudio analizó la percepción de los profesionales involucrados sobre la gestión y el cumplimiento de los plazos en proyectos de “retrofit” de plantas de tratamiento de aguas residuales, considerando factores técnicos, operativos y organizacionales. La investigación se caracterizó como un estudio aplicado, con un enfoque cuali-cuantitativo, delineado como un levantamiento de campo de tipo “survey”. El análisis de los datos se realizó mediante estadística descriptiva y categorización cualitativa, utilizando las herramientas SWOT, matriz de riesgo (Probabilidad x Impacto) y plan de acción 5W2H. Los resultados indicaron una alta percepción de claridad (77,8%) y realismo de los plazos (100% de acuerdo), evidenciando una planificación inicial consistente. Sin embargo, el 77,7% de los encuestados señaló que los retrabajos y cambios de alcance impactaron directamente el cumplimiento de los plazos. La integración entre ingeniería, fabricación y Planificación y Control de la Producción (PCP) presentó una evaluación intermedia (77,7% de acuerdo parcial/total), indicando fragilidad en la coordinación interfuncional. La matriz de riesgo destacó como críticos: cambios de alcance, limitaciones operativas de la PTAR y complejidad técnica, todos con nivel alto. Como mejora central, se propuso la estandarización del control de cambios de alcance, análisis y aprobación, con el fin de reducir retrabajos y aumentar la previsibilidad del cronograma.

Palabras clave: Desempeño; Integración; Planificación; Retrabajo; Riesgo.

17 de noviembre de 2026

Captación B2C en medicina diagnóstica: acuerdos estratégicos con consultorios médicos especializados

El sector de la medicina diagnóstica en Brasil opera con una alta dependencia de las aseguradoras de planes de salud, lo que limita la autonomía financiera de los prestadores. Este estudio propuso y analizó un modelo de captación directa de pacientes (B2C) para una institución de medicina diagnóstica de alta complejidad, estructurado a partir de alianzas con consultorios de Oncología y Cardiología y operado por un servicio de atención personalizada denominado conserjería. La investigación adoptó un enfoque mixto en tres fases: levantamiento de campo con cuestionario estructurado aplicado a 87 pacientes, mapeo del flujo operativo mediante “Service Blueprint” y análisis de la tasa de conversión a partir de 312 indicaciones médicas registradas en el proyecto piloto. Los resultados indicaron que la confianza en la indicación médica obtuvo un 92,0% de concordancia, configurándose como el principal factor de adhesión. La conveniencia de realizar el examen el mismo día alcanzó el 78,2%, y la disposición al pago directo llegó al 55,2%, con una polarización asociada a la predominancia de usuarios de planes de salud. El “Service Blueprint” identificó tres puntos críticos en las transiciones entre etapas del recorrido. La tasa de conversión global fue del 51,0%, con un desempeño superior en Oncología (58,2%) en relación con Cardiología (45,0%), y la mayor pérdida se concentró en la etapa de aceptación y agendamiento (28,3%). Se concluyó que el modelo demostró posible viabilidad operativa e indicios de aceptación por parte de los pacientes, condicionado a la transparencia de precios y a la reducción del intervalo entre la consulta y el abordaje por la conserjería.

Palabras clave: Desembolso directo; Recorrido del paciente; Salud suplementaria; Servicio de conserjería; Tasa de conversión.

17 de noviembre de 2026

El papel del director escolar en la promoción de una cultura inclusiva: liderazgo y políticas educativas

La investigación analizó el desempeño del director escolar en la promoción de una cultura inclusiva, considerando la necesidad de transformar directrices legales y fundamentos pedagógicos en prácticas institucionales efectivas. Se partió del supuesto de que la inclusión escolar exige planificación, organización y liderazgo estratégico en el día a día de la escuela. Se adoptó un enfoque cualitativo de naturaleza aplicada, desarrollado en tres etapas complementarias: análisis documental de las legislaciones brasileñas sobre educación inclusiva, revisión bibliográfica sobre liderazgo y gestión escolar, y sistematización de los datos por medio de herramientas gerenciales como la matriz FODA y el ciclo PDCA. Los resultados indicaron que el desempeño de la gestión escolar influyó directamente en la consolidación de ambientes inclusivos, especialmente en la organización de procesos, formación continua del equipo y fortalecimiento de una cultura institucional colaborativa y respetuosa de la diversidad. También se identificaron desafíos estructurales, pedagógicos y relacionales que demandaron intervenciones planificadas. Al final, se elaboró una Guía Práctica para Directores Escolares, con directrices, protocolos y orientaciones operacionales para la toma de decisiones y organización de los procesos inclusivos. Se concluyó que la construcción de una cultura inclusiva dependió de la capacidad de gestión para articular políticas públicas, prácticas pedagógicas y procesos institucionales, consolidando la inclusión como un compromiso permanente en el contexto escolar.

Palabras clave: Accesibilidad educativa; Equidad educativa; Gestión participativa; Planificación estratégica; Procesos institucionales.

17 de noviembre de 2026

Un artefacto de IA basado en Design Thinking para apoyar la elicitación de requisitos de software a partir de las necesidades de los usuarios

El desarrollo de software orientado a las necesidades de los usuarios a menudo enfrenta desafíos en la elicitación de requisitos, derivados de ambigüedades en el lenguaje natural y fallos de comunicación. Ante esto, se propuso y validó un artefacto inteligente que integra Design Thinking e Inteligencia Artificial, con foco en las etapas de Empatía y Definición, para apoyar la recolección, interpretación y estructuración de las necesidades de los usuarios. La investigación, de naturaleza aplicada, cualitativa y exploratoria, condujo una Prueba de Concepto en un ambiente controlado, empleando escenarios hipotéticos. El artefacto operó mediante entrevistas guiadas en lenguaje natural, organizando información en elementos como dolor, contexto e impacto, y generando síntesis de problemas rastreables. Los resultados indicaron que el sistema organizó relatos no estructurados, redujo ambigüedades y preservó el sentido de la información original en la mayoría de los casos. Se observó también la capacidad de reorganización lógica en escenarios complejos, aunque con limitaciones en la separación de múltiples problemas y dependencia de las instrucciones. Se concluyó que el artefacto tiene potencial como apoyo a la elicitación de requisitos, mejorando la claridad y la estructuración de la información, pero requiere supervisión y control contextual.

Palabras clave: Design Thinking; Elicitación de Requisitos; Ingeniería de Requisitos; Inteligencia Artificial; Procesamiento del Lenguaje Natural.

17 de noviembre de 2026

La Extinción de la Sistemática de Retención en la Industria Farmacéutica a la Luz de la Reforma Tributaria

La Reforma Tributaria del consumo, establecida por la Enmienda Constitucional nº 132/2023, introdujo alteraciones estructurales en el sistema tributario brasileño, con la sustitución del Programa de Integración Social (PIS) y de la Contribución para el Financiamento de la Seguridad Social (COFINS) por la Contribución sobre Bienes y Servicios (CBS), en un modelo de Impuesto sobre el Valor Añadido (IVA dual). El objetivo fue analizar los impactos de la extinción de la sistemática monofásica en la industria farmacéutica, a la luz del nuevo diseño normativo y de sus efectos económicos y jurídicos. Se realizó una investigación cualitativa, de naturaleza exploratoria, por medio de estudio de caso y análisis documental de la legislación y la doctrina especializada. Se examinó si el fin de la monofasia implicaría un aumento relevante de la carga tributaria para el sector. Los resultados indicaron que, aunque la superación formal de la sistemática monofásica ha ocurrido, la desgravación material de los medicamentos fue preservada, sobre todo en razón de la aplicación de alícuotas reducidas del 60% y, en determinados casos, de alícuota cero del Impuesto sobre Bienes y Servicios (IBS) y de la CBS. El cambio de modelo puede provocar variaciones puntuales en la recaudación, sin caracterizar un aumento estructural de la carga tributaria, tendiendo a la neutralidad a lo largo del tiempo. Se concluyó, preliminarmente, que la Reforma Tributaria reorganizó la técnica de tributación en la industria farmacéutica, sustituyendo un régimen concentrado por mecanismos más transparentes de desgravación. Este enfoque se mostró compatible con los principios de neutralidad, de no acumulatividad plena y de extrafiscalidad, manteniendo la protección tributaria a los medicamentos esenciales y alineando la política fiscal al derecho fundamental a la salud.

Palabras clave: CBS; COFINS; IBS; IVA Dual; PIS.