
15 de setembro de 2026
Segmentação de Clientes Financeiros por Clusterização e Aprendizado Não Supervisionado
Luciana Martins Esteves; Henrique Raymundo Gioia
DOI: 10.22167/2675-6528-202602263
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A crescente disponibilidade de dados no setor financeiro tornou relevante o uso de técnicas analíticas para segmentação e apoio à decisão. O estudo teve como objetivo aplicar técnicas de clusterização a uma base de clientes, a fim de identificar grupos homogêneos e interpretar perfis distintos com base em variáveis financeiras, comportamentais e cadastrais. Metodologicamente, a pesquisa classificou-se como aplicada, descritiva e quantitativa, conduzida como estudo de caso com 750 registros. Inicialmente, os dados foram preparados, tratados e padronizados. Em seguida, aplicou-se o algoritmo K-Means, testando diferentes valores de k e utilizando métricas internas de validação (WCSS, silhouette, Calinski-Harabasz e Davies-Bouldin). Realizou-se também comparação com métodos hierárquicos e análise estatística complementar por ANOVA. Os resultados mostraram que, embora a solução com dois clusters tenha apresentado melhor desempenho estatístico em parte das métricas, a configuração com três grupos teve maior capacidade interpretativa e analítica. Os clusters identificados distinguiram clientes com maior vulnerabilidade financeira, perfil intermediário e maior valor econômico, com diferenças relevantes em renda, endividamento, utilização do crédito, investimento e reserva de emergência. Concluiu-se que a clusterização foi eficaz para segmentar a base analisada e demonstrou potencial para apoiar a interpretação de perfis e a tomada de decisão orientada por dados.
Palavras-chave: aprendizado não supervisionado; ciência de dados; clusterização; K-Means; segmentação de clientes.
1. Introdução
A crescente digitalização do setor financeiro ampliou de forma significativa a geração, o armazenamento e o uso estratégico de dados de clientes. No contexto bancário contemporâneo, a competitividade deixou de depender apenas da oferta de produtos padronizados e passou a exigir maior capacidade analítica para compreender perfis, comportamentos e necessidades específicas dos consumidores.
No Brasil, esse movimento tem sido intensificado pela expansão dos canais digitais, pelo amadurecimento do Open Finance e pelo uso crescente de inteligência artificial e análises preditivas para personalização de produtos e serviços. A Federação Brasileira de Bancos (FEBRABAN, 2025) aponta que a personalização é impulsionada, entre outros fatores, pelo uso de dados compartilhados via Open Finance e por análises baseadas em inteligência artificial. O Banco Central do Brasil (BCB, 2023) destaca que o ecossistema de Open Finance busca ampliar o acesso a serviços financeiros mais adequados ao perfil e à necessidade de cada cliente. Nesse cenário, o uso de métodos analíticos capazes de transformar grandes volumes de dados em conhecimento aplicável tornou-se relevante tanto para a diferenciação competitiva quanto para a melhoria da experiência do cliente.
Do ponto de vista teórico, a clusterização ocupa posição importante na Ciência de Dados e na mineração de dados por permitir a identificação de estruturas latentes em bases sem rótulos prévios. Jain, Murty e Flynn (1999) definem clusterização como a classificação não supervisionada de padrões em grupos, ressaltando sua utilidade como etapa de análise exploratória de dados. Na mesma direção, Han, Kamber e Pei (2012) tratam a clusterização como uma das técnicas centrais de mineração de dados para descoberta de padrões, organização de bases complexas e apoio à geração de conhecimento a partir dos dados.
Em uma perspectiva mais ampla de aprendizado estatístico, Hastie, Tibshirani e Friedman (2009), assim como James et al. (2021), situam os métodos não supervisionados como ferramentas apropriadas quando o interesse do pesquisador está menos em prever uma variável-resposta e mais em compreender a estrutura interna dos dados, identificar semelhanças e descrever perfis com base em múltiplos atributos observados. Assim, a clusterização se mostra especialmente pertinente quando o problema de pesquisa envolve heterogeneidade de clientes, diversidade comportamental e necessidade de segmentação orientada por evidências, e não apenas por critérios intuitivos ou administrativos.
No setor bancário e financeiro, a literatura recente tem reforçado a utilidade da segmentação analítica de clientes para fins de personalização, retenção, desenho de ofertas e priorização comercial. Estudos recentes mostram que algoritmos de clusterização, especialmente o K-Means, têm sido empregados para agrupar clientes a partir de atributos financeiros, transacionais e comportamentais, permitindo distinguir padrões de consumo, risco e valor econômico. Em trabalho recente, Yan et al. (2025) demonstraram que abordagens de clusterização aplicadas ao contexto bancário podem apoiar estratégias de marketing mais precisas, enquanto Nofal (2024) mostrou que a combinação entre características transacionais e técnicas de aprendizado de máquina possibilita identificar clientes de maior valor em bases bancárias reais.
Esses resultados dialogam com a literatura aplicada mais ampla, que reconhece a segmentação como instrumento para converter dados brutos em perfis acionáveis, com potencial para orientar decisões mais precisas. Apesar disso, a qualidade da segmentação depende de escolhas metodológicas consistentes, como seleção de variáveis, padronização dos dados, definição do número de clusters e validação da solução encontrada, o que exige rigor técnico e justificativa teórica para que os resultados não sejam interpretados como simples agrupamentos arbitrários.
A relevância deste trabalho decorre, portanto, de dois aspectos complementares. No plano prático, a pesquisa responde à necessidade crescente de segmentar clientes de forma mais precisa em ambientes financeiros marcados por competição, digitalização e personalização intensiva. No plano acadêmico, o estudo contribui ao aplicar fundamentos de Ciência de Dados a um problema concreto de segmentação, articulando técnicas de clusterização com métricas de validação e interpretação analítica dos grupos formados. Dessa forma, evita-se uma leitura meramente descritiva ou institucional do fenômeno e reforça-se uma abordagem metodologicamente embasada, apoiada na literatura de mineração de dados, aprendizado não supervisionado e aplicações financeiras. Nesse sentido, o objetivo deste trabalho foi aplicar técnicas de clusterização a uma base de clientes do setor financeiro, a fim de identificar segmentos com características homogêneas e estatisticamente distinguíveis, capazes de subsidiar a interpretação de perfis e apoiar decisões orientadas por dados.
2. Material e Métodos
A pesquisa foi classificada como aplicada, descritiva e quantitativa. Quanto à sua finalidade, buscou gerar conhecimento com utilidade prática para a compreensão e segmentação de clientes a partir de dados financeiros e comportamentais. Em relação aos objetivos, procurou identificar, analisar e descrever padrões presentes na base de dados, evidenciando diferenças entre os grupos formados. Sob a perspectiva da abordagem do problema, foi quantitativa, envolvendo o uso de dados numéricos, métricas estatísticas e técnicas computacionais. Em termos de procedimentos técnicos, o trabalho assumiu características de estudo de caso, desenvolvido a partir de uma base específica analisada em profundidade.
A base de dados utilizada foi composta por 750 registros de clientes e 26 colunas, contemplando variáveis de natureza financeira, comportamental e cadastral, além dos rótulos de cluster gerados. Tratou-se de uma base anonimizada, oriunda do ambiente analítico de uma instituição do setor financeiro atuante no Brasil, sem identificação nominal da organização, dos clientes ou de informações sensíveis individualizadas. As variáveis analisadas abrangeram indicadores de renda, patrimônio, saldo em conta, limite de cartão, investimento mensal, utilização de crédito, percentual de atraso, taxa de endividamento, reserva de emergência, tempo de relacionamento, canal de interação predominante e enquadramento em segmentos previamente identificados. A escolha dessas variáveis foi justificada por sua aderência ao problema de pesquisa, exigindo atributos capazes de discriminar diferentes perfis de clientes em termos de valor econômico, exposição ao risco, intensidade de uso de produtos financeiros e padrão de relacionamento com a instituição. A base final incorporou os rótulos gerados pelos métodos de agrupamento aplicados, incluindo K-Means e abordagens hierárquicas.
A etapa de preparação e tratamento dos dados visou garantir a qualidade, consistência e adequação da base para aplicação das técnicas de clusterização. Inicialmente, foi realizada a inspeção para identificação de inconsistências, como registros duplicados (removidos) e valores ausentes (tratados conforme a natureza da variável, com imputação simples ou manutenção). Em seguida, foram realizados ajustes de tipagem das variáveis (numéricas, categóricas e temporais). Também foi conduzida análise exploratória para compreender a distribuição das variáveis e identificar possíveis outliers, que foram mantidos quando representavam características reais dos clientes e removidos apenas se inconsistências ou erros. Variáveis categóricas relevantes foram mantidas para interpretação dos clusters. A base foi estruturada em formato adequado para aplicação dos algoritmos de clusterização.
A padronização das variáveis foi realizada por meio do z-score, técnica que transforma as variáveis para uma mesma escala com média igual a zero e desvio padrão igual a um. Esse procedimento foi aplicado exclusivamente às variáveis numéricas utilizadas na etapa de modelagem, com o objetivo de garantir que todos os atributos contribuíssem de forma equilibrada para a formação dos grupos, evitando que variáveis com maior escala numérica exercessem influência desproporcional.
A etapa de clusterização foi realizada para identificar grupos homogêneos de clientes, utilizando o algoritmo K-Means. O K-Means divide um conjunto de dados em k grupos, buscando maior similaridade interna e dissimilaridade externa, medida pela distância euclidiana. O processo envolve a definição de k, seleção aleatória de centróides iniciais, atribuição de observações ao centróide mais próximo, e recalculo iterativo dos centróides até a convergência. O objetivo do algoritmo é minimizar a soma das distâncias quadráticas entre os pontos e os centróides de seus respectivos clusters (WCSS), representada pela Equação 1:
WCSS = Σ₁=1* Σ(x ∈ Ci) ||x – μ₁||²
(Eq. 1)
Em que Ci representa o conjunto de pontos pertencentes ao cluster i, x representa cada observação do grupo e μ¡ corresponde ao centróide desse cluster. O algoritmo foi aplicado à base previamente tratada e padronizada, sendo justificado pela sua capacidade de lidar com bases de tamanho moderado e múltiplas variáveis numéricas.
A definição do número de clusters (k) e a validação da qualidade dos agrupamentos foram etapas essenciais. Foram testados diferentes valores de k, variando de 2 a 10, utilizando métricas internas de validação: Within-Cluster Sum of Squares (WCSS), silhouette score, índice de Calinski-Harabasz e índice de Davies-Bouldin. A análise conjunta dessas métricas indicou melhor desempenho estatístico para a configuração com dois clusters (k = 2). Entretanto, optou-se pela adoção de três clusters (k = 3) na análise final, fundamentada na maior capacidade de interpretação e segmentação dos perfis de clientes. Adicionalmente, foi analisada a curva de inércia (método do cotovelo), que demonstrou redução significativa da variabilidade até determinado ponto.
Para comparar a estrutura dos grupos e avaliar a robustez da segmentação, foram testadas abordagens hierárquicas de agrupamento, incluindo single linkage, complete linkage e average linkage. Para comparar os agrupamentos gerados, utilizou-se o Adjusted Rand Index (ARI), que avalia o grau de concordância entre duas soluções de clusterização. Os resultados mostraram que os métodos hierárquicos complete linkage e average linkage apresentaram elevada concordância entre si, enquanto o single linkage apresentou baixa estabilidade. Em comparação, o K-Means produziu grupos mais equilibrados em termos de distribuição de observações e mostrou concordância moderada com as abordagens hierárquicas mais robustas.
Após a definição e validação dos agrupamentos, realizou-se a análise dos perfis dos clusters para interpretar suas características predominantes. A análise foi conduzida a partir das médias das variáveis numéricas em cada cluster, considerando indicadores financeiros, comportamentais e de relacionamento. Variáveis categóricas, como canal predominante de interação e classificação em segmentos, também foram consideradas para enriquecer a interpretação. Os clusters foram descritos de forma interpretativa, sintetizando os principais traços de cada grupo e comparando as diferenças que os distinguem entre si.
Com o objetivo de verificar se os clusters identificados apresentavam diferenças estatisticamente significativas, aplicou-se a ANOVA às variáveis numéricas consideradas no estudo. A ANOVA foi aplicada às principais variáveis financeiras e comportamentais da base, como renda mensal, saldo em conta, investimento, utilização de crédito, percentual de atraso e taxa de endividamento. Além da significância estatística (p-valor), considerou-se a magnitude do efeito por meio do eta quadrado parcial (η²). Os resultados da ANOVA indicaram que a maior parte das variáveis analisadas apresentou diferenças estatisticamente significativas entre os clusters, com valores de p inferiores ao nível de significância adotado, e diversas variáveis apresentaram elevados valores de eta quadrado parcial.
A execução do pipeline analítico foi realizada com a linguagem de programação Python. Para tratamento e manipulação dos dados, foram utilizadas as bibliotecas Pandas e NumPy. A análise exploratória e a visualização dos dados, incluindo a análise da curva de inércia, foram conduzidas com o apoio da biblioteca Matplotlib. Para a aplicação das técnicas de clusterização (K-Means e métodos hierárquicos) e validação dos agrupamentos (silhouette score, índice de Calinski-Harabasz e índice de Davies-Bouldin), utilizou-se a biblioteca Scikit-learn. A análise estatística, incluindo a ANOVA, foi realizada com o suporte de bibliotecas especializadas em estatística computacional. O ambiente de desenvolvimento utilizado foi baseado em notebooks interativos.
3. Resultados e Discussão
A aplicação de técnicas de clusterização à base de clientes evidenciou a capacidade de transformar dados heterogêneos em grupos analiticamente distintos e interpretáveis, alinhando-se à literatura de mineração de dados e aprendizado não supervisionado. A qualidade da segmentação dependeu da combinação entre coesão interna, separação entre grupos e utilidade substantiva dos resultados (Jain, 2010; Han, Kamber e Pei, 2012; Hair et al., 2019). A discussão foi organizada para examinar a definição do número de clusters, a comparação entre métodos, o equilíbrio da partição final e a interpretação dos perfis identificados.
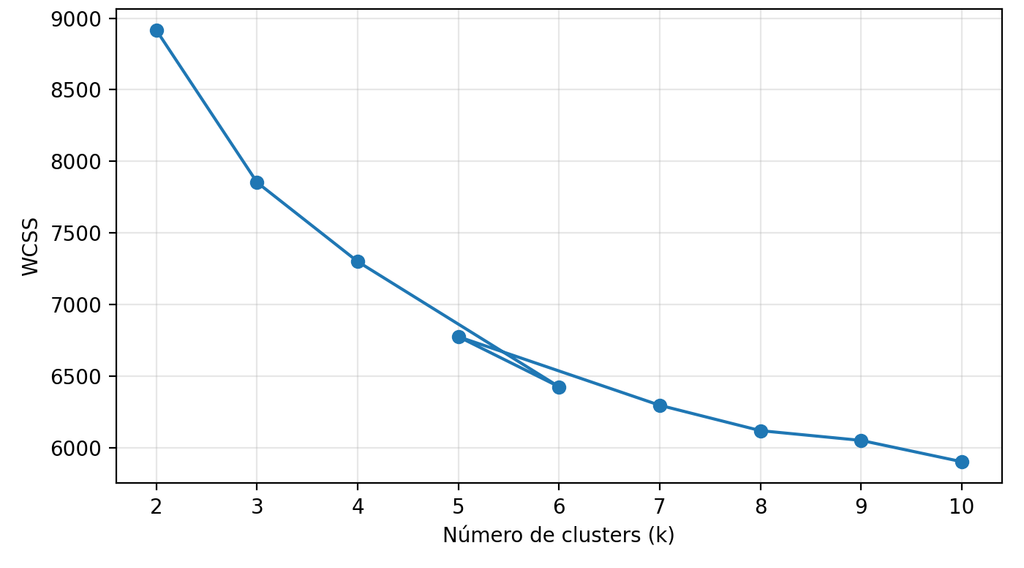
A curva de inércia foi utilizada para avaliar a redução da variabilidade intra-cluster à medida que o número de grupos aumentava. A Figura 1 ilustra esse comportamento.
Figura 1. Curva de inércia do K-Means
Fonte: Resultados originais da pesquisa
A Figura 1 demonstrou uma queda acentuada da inércia entre k=2 e k=4, seguida por uma redução progressivamente menor para valores superiores. Esse padrão, compatível com o método do cotovelo, sugeriu que os maiores ganhos de compactação ocorreram nas primeiras partições. Isso indica que soluções com poucos grupos já capturam uma parcela relevante da estrutura interna da base, mas a análise conjunta com métricas adicionais e a interpretabilidade dos segmentos gerados são indispensáveis.
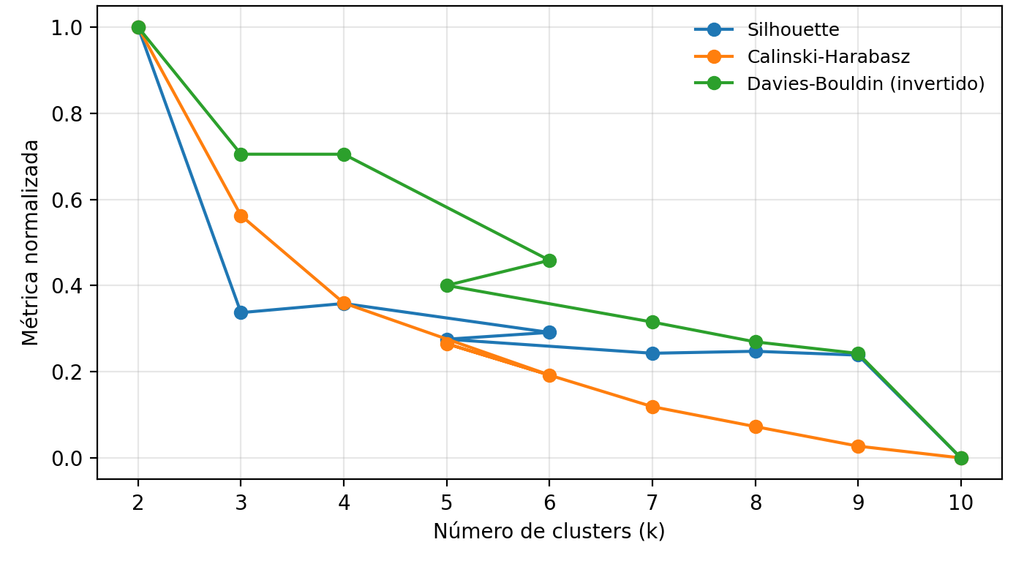
A comparação normalizada das métricas internas de validação, apresentada na Figura 2, permitiu confrontar diferentes critérios de qualidade para a escolha do número de clusters.
Figura 2. Comparação normalizada das métricas internas de validação
Fonte: Resultados originais da pesquisa
A Figura 2 indicou que k=2 apresentou o melhor desempenho relativo nas métricas de silhouette, Calinski-Harabasz e Davies-Bouldin (invertido), sinalizando maior equilíbrio entre coesão interna e separação entre grupos. Contudo, optou-se por aprofundar a análise com k=3, uma decisão metodologicamente defensável que considerou a maior capacidade de interpretação e segmentação dos perfis de clientes, conforme a literatura que recomenda considerar a utilidade analítica e prática dos agrupamentos (Han, Kamber e Pei, 2012).
Para comparar a consistência estrutural dos agrupamentos obtidos por técnicas distintas, a Tabela 1 apresenta os valores do Adjusted Rand Index (ARI) entre as soluções do K-Means e dos métodos hierárquicos.
Tabela 1. Comparação entre métodos de agrupamento pelo Adjusted Rand Index
| Comparação | ARI | Leitura |
|---|---|---|
| kmeans x hier_single | -0.000 | Baixa |
| kmeans x hier_complete | 0.452 | Moderada |
| kmeans x hier_average | 0.581 | Moderada |
| hier_single x hier_complete | 0.007 | Baixa |
| hier_single x hier_average | 0.009 | Baixa |
| hier_complete x hier_average | 0.886 | Alta |
Fonte: Resultados originais da pesquisa
A Tabela 1 evidenciou que a maior convergência ocorreu entre complete linkage e average linkage, com ARI elevado, enquanto o single linkage apresentou baixa aderência às demais soluções. Esse resultado confirmou a limitação do single linkage em bases com maior variabilidade. O K-Means, por sua vez, apresentou concordância moderada com as abordagens hierárquicas mais robustas, sugerindo que a partição final preservou coerência estrutural sem perder equilíbrio e interpretabilidade.
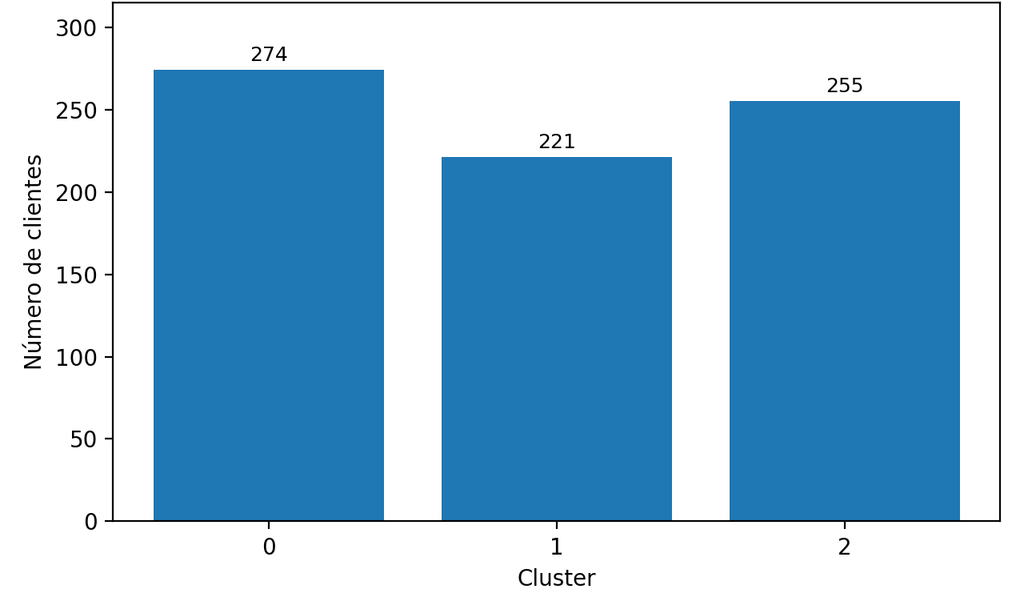
A distribuição final dos clientes na solução adotada pode ser observada na Figura 3, que permite verificar se os grupos formados se mantiveram representativos e operacionalmente úteis.
Figura 3. Distribuição dos clientes por cluster no K-Means
Fonte: Resultados originais da pesquisa
A Figura 3 mostrou uma partição relativamente equilibrada, com 274 clientes no Cluster 0, 221 no Cluster 1 e 255 no Cluster 2. Esse equilíbrio é relevante do ponto de vista analítico, pois reduz o risco de que um cluster residual comprometa a leitura substantiva dos resultados, garantindo massa crítica suficiente para sustentar interpretações consistentes.
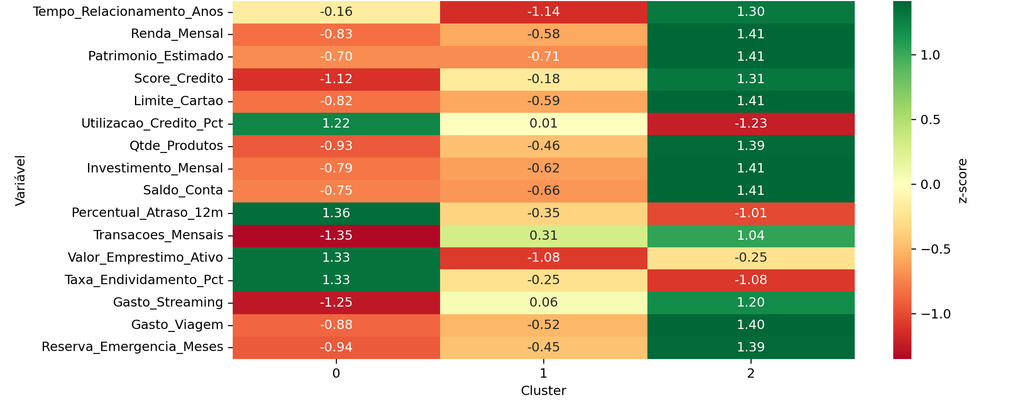
A Figura 4 aprofunda a leitura dos agrupamentos ao apresentar o perfil padronizado dos clusters nas variáveis mais relevantes do modelo.
Figura 4. Perfil padronizado dos clusters K-Means
Fonte: Resultados originais da pesquisa
A Figura 4 evidenciou três estruturas bastante distintas. O Cluster 0 concentrou valores padronizados mais elevados em utilização do crédito, atraso e endividamento, combinados com patamares inferiores de renda, patrimônio, investimento e reserva de emergência, caracterizando um perfil de maior vulnerabilidade financeira. O Cluster 1 apresentou comportamento mais intermediário, com menor tempo de relacionamento e indicadores geralmente moderados, sugerindo um segmento de transição. Já o Cluster 2 reuniu os maiores níveis relativos de renda, patrimônio, limite de cartão, investimento, saldo em conta e reserva de emergência, além de menor atraso e menor utilização do crédito, configurando o grupo de maior valor econômico e menor sensibilidade ao risco.
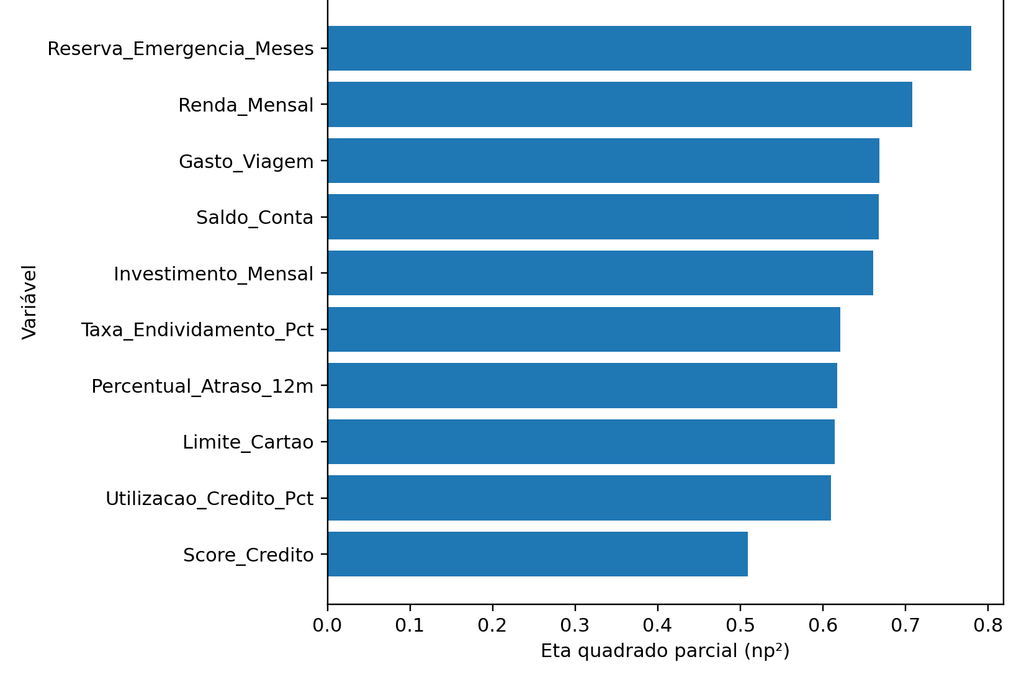
Para verificar quais atributos mais contribuíram para a separação estatística entre os grupos, a Figura 5 apresenta as principais variáveis discriminantes segundo a magnitude do eta quadrado parcial na ANOVA.
Figura 5. Principais variáveis discriminantes entre os clusters
Fonte: Resultados originais da pesquisa
A Figura 5 demonstrou que reserva de emergência, renda mensal, gasto com viagem, saldo em conta, investimento mensal, taxa de endividamento, percentual de atraso, limite do cartão, utilização do crédito e score de crédito foram os atributos com maior poder discriminante entre os clusters. Esse resultado reforça que a segmentação não foi formada por ruído estatístico, mas por diferenças estruturais associadas à capacidade financeira, liquidez, padrão de consumo e risco de crédito. A predominância dessas variáveis fortalece a validade interna da solução, confirmando que os grupos foram definidos por dimensões substantivamente coerentes com o problema estudado.
Em conjunto, os resultados mostraram coerência entre preparação dos dados, modelagem, validação e interpretação dos agrupamentos. Embora as métricas internas tenham indicado melhor ajuste estatístico para k=2, a escolha de k=3 revelou maior poder de discriminação analítica e maior utilidade prática, o que é compatível com estudos aplicados de Ciência de Dados quando a decisão metodológica é explicitada de forma transparente. A análise da base sustenta que a clusterização foi capaz de converter uma base financeira complexa em segmentos úteis para interpretação de perfis de clientes e apoio à decisão orientado por dados.
A execução do pipeline analítico foi realizada com o auxílio da linguagem de programação Python, utilizando bibliotecas como Pandas e NumPy para tratamento de dados, Matplotlib para análise exploratória e Scikit-learn para clusterização (K-Means e métodos hierárquicos) e validação. A análise estatística, incluindo a ANOVA, também foi suportada por bibliotecas especializadas. O ambiente de notebooks interativos facilitou a organização e reprodutibilidade das análises (VanderPlas, 2016).
A análise dos resultados obtidos a partir da aplicação do pipeline de clusterização evidenciou que a segmentação da base de clientes foi capaz de identificar padrões consistentes e estatisticamente relevantes, em consonância com o objetivo do estudo de identificar grupos homogêneos e interpretáveis por meio de técnicas de aprendizado não supervisionado. As diferenças observadas entre os clusters foram estatisticamente significativas, com variáveis como renda mensal, reserva de emergência, investimento e taxa de endividamento apresentando elevado poder discriminante, o que reforça que os agrupamentos refletem diferenças reais na estrutura dos dados (Hair et al., 2019). A segmentação obtida não apenas atendeu ao propósito analítico da pesquisa, mas também evidenciou potencial de aplicação prática, ao permitir a diferenciação de estratégias conforme o perfil dos grupos identificados.
4. Conclusão
A presente pesquisa buscou aplicar técnicas de clusterização a uma base de clientes do setor financeiro, com o propósito de identificar segmentos homogêneos e estatisticamente distinguíveis, capazes de subsidiar a interpretação de perfis e apoiar decisões orientadas por dados. Verificou-se que a clusterização foi eficaz para segmentar a base analisada, revelando três perfis distintos de clientes. O primeiro grupo caracterizou-se por maior vulnerabilidade financeira, com elevados níveis de utilização do crédito, atraso e endividamento, e menores patamares de renda, patrimônio, investimento e reserva de emergência. O segundo grupo apresentou um perfil intermediário, enquanto o terceiro reuniu clientes de maior valor econômico, com indicadores superiores de renda, patrimônio, investimento e reserva de emergência, e menor sensibilidade ao risco. A análise estatística confirmou que variáveis como renda mensal, reserva de emergência, investimento e taxa de endividamento foram os principais atributos discriminantes entre os grupos, reforçando a validade interna da segmentação. Essa abordagem demonstrou o potencial das técnicas de aprendizado não supervisionado para transformar dados complexos em conhecimento estruturado, oferecendo uma contribuição prática relevante para a diferenciação de estratégias e a tomada de decisão no setor financeiro.
Contudo, alguns limites do estudo devem ser reconhecidos. A análise foi realizada com base em uma única base de dados e um recorte específico de variáveis, o que restringe a generalização dos resultados para outros contextos ou populações. Embora a solução com três clusters tenha sido adotada pela sua maior utilidade interpretativa, as métricas internas apontaram um melhor desempenho estatístico para uma configuração com dois grupos, indicando que a escolha final envolveu um critério de utilidade analítica. Sugere-se, para estudos futuros, a ampliação da base analítica com novas variáveis, como indicadores de comportamento transacional e relacionamento digital, a fim de aprofundar a capacidade discriminante dos modelos. Recomenda-se também testar outras abordagens de clusterização, como DBSCAN ou Gaussian Mixture Models, e explorar a integração entre clusterização e modelos supervisionados para previsão de risco ou propensão de compra, ampliando a aplicabilidade da Ciência de Dados em ambientes financeiros.
Referências Bibliográficas
Banco Central do Brasil [BCB]. (2023). Open Finance no Brasil. https://www.bcb.gov.br/estabilidadefinanceira/openfinance
Federação Brasileira de Bancos [FEBRABRAN]. (2025). Pesquisa Febraban de Tecnologia Bancária 2025. https://cmsarquivos.febraban.org.br
Han, J., Kamber, M., & Pei, J. (2012). Data mining: Concepts and techniques (3rd ed.). Morgan Kaufmann.
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer.
Jain, A. K., Murty, M. N., & Flynn, P. J. (1999). Data clustering: A review. ACM Computing Surveys, 31(3), 264-323.
James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An introduction to statistical learning: With applications in Python (2nd ed.). Springer.
Nofal, S. (2024). Identifying highly-valued
Yan, X., Li, Y., Nie, F., & Li, R. (2025). Bank customer segmentation and marketing strategies based on improved DBSCAN algorithm. Applied Sciences, 15(6), 3138.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

