
15 de setembro de 2026
Métodos Não Supervisionados Aplicados a Leveduras Industriais Produtoras de Etanol de Primeira e Segunda Gerações
Luciana Souto Mofatto; Cleverson Henrique de Freitas
DOI: 10.22167/2675-6528-202602264
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A compreensão dos mecanismos moleculares na produção de etanol é crucial para a otimização industrial, dada sua consolidação como alternativa sustentável. O estudo avaliou os perfis transcriptômicos de leveduras industriais Saccharomyces cerevisiae “Pedra-2” na produção de etanol de primeira (1G) e segunda geração (2G), em diferentes tempos de fermentação, utilizando métodos não supervisionados. Dados públicos de RNA-seq foram empregados, submetidos a controle de qualidade, pré-processamento, alinhamento genômico e quantificação de transcritos em TPM. As análises incluíram correlação de Pearson, Análise de Componentes Principais (PCA), Análise Fatorial de Dados Mistos (FAMD) e clusterização hierárquica. Os resultados revelaram uma clara separação entre os perfis de expressão gênica de 1G e 2G, com o tipo de fermentação como principal fator de variabilidade. As amostras 1G exibiram maior organização temporal e estabilidade, enquanto as 2G mostraram maior heterogeneidade e complexidade metabólica. Diferenças nas vias metabólicas associadas ao fluxo de carbono foram identificadas, com predominância da glicólise em 1G e maior participação das vias da pentose fosfato e do ciclo do ácido tricarboxílico em 2G. Concluiu-se que os métodos não supervisionados foram eficazes na identificação de padrões biológicos relevantes, contribuindo para o entendimento das diferenças metabólicas entre os processos e oferecendo suporte para estratégias de otimização na produção de etanol.
Palavras-chave: Aprendizado de máquina; Bioinformática; Expressão gênica; Fermentação; Transcriptoma.
1. Introdução
A crescente demanda por fontes de energia renováveis tem impulsionado a produção de etanol como alternativa sustentável aos combustíveis fósseis (Goldemberg, 2008). O Brasil se destaca como um dos maiores produtores globais, utilizando a cana-de-açúcar como principal matéria-prima devido ao seu alto rendimento e viabilidade econômica (Basso et al., 2011; Renewable Fuels Association, 2024; Wheals et al., 1999). Programas governamentais e investimentos em pesquisa e desenvolvimento, como o Proálcool, o programa BIOEN da FAPESP e o Laboratório Nacional de Biorrenováveis (LNBR), têm sido fundamentais para o avanço e a consolidação do setor (Leite et al., 2009; Roman, 2010).
A produção de etanol ocorre por meio da fermentação de açúcares, processo no qual leveduras convertem glicose em etanol e dióxido de carbono (Basso et al., 2011). A espécie Saccharomyces cerevisiae é amplamente empregada em fermentações industriais devido a características como alta viabilidade celular, capacidade de conservação genética, tolerância a altas concentrações de etanol e carboidratos, e resistência a múltiplos ciclos de fermentação e variações de temperatura (Dequin, 2001). Linhagens industriais brasileiras, como “Pedra-2” e “CAT-1”, são exemplos de cepas que exibem essas qualidades (Argueso et al., 2009; Basso et al., 2008; Della-Bianca et al., 2013).
O etanol é classificado em gerações, sendo o de primeira geração (1G) obtido da fermentação da sacarose presente no caldo de cana. Este é um processo consolidado, de alta produtividade e que não requer pré-tratamento da matéria-prima. Contudo, a produção de etanol 1G enfrenta desafios como a sazonalidade da cana-de-açúcar e a competição com a produção de açúcar. O melhoramento genético da cana e a otimização dos processos industriais são estratégias adotadas para mitigar essas limitações (Goldemberg, 2008; Leite et al., 2009).
Em contraste, o etanol de segunda geração (2G) surge como uma alternativa promissora, utilizando resíduos lignocelulósicos, como bagaço e palha de cana, para aumentar o aproveitamento da biomassa e a sustentabilidade do setor (Lynd et al., 2005). Este processo envolve a conversão de celulose e hemicelulose em açúcares fermentáveis por hidrólise enzimática ou ácida. No entanto, a Saccharomyces cerevisiae não metaboliza naturalmente pentoses, açúcares abundantes na hemicelulose, o que limita a eficiência do processo fermentativo 2G (Matsushika et al., 2009).
Para superar as limitações do etanol 2G, a engenharia metabólica tem sido utilizada para modificar geneticamente leveduras, permitindo o consumo de hexoses e pentoses (xilose, arabinose) e, assim, viabilizando a produção de etanol 2G (Matsushika et al., 2009). Estratégias incluem a introdução de vias metabólicas redutivas/oxidativas e de isomerização, bem como a combinação de genes de microrganismos como Escherichia coli e Pichia stipitis (Karhumaa et al., 2007). A superexpressão de transportadores de açúcar também melhora a captação e o metabolismo de pentoses, aumentando a produtividade (Basso et al., 2011). Além disso, a engenharia evolutiva aprimora características como tolerância ao etanol, a temperaturas elevadas e a compostos tóxicos, selecionando cepas mais robustas para reduzir custos e aumentar a eficiência (Della-Bianca et al., 2013; Basso et al., 2011; Leite et al., 2009).
A bioinformática desempenha um papel crucial na engenharia de leveduras, auxiliando na análise genômica e na identificação de genes relacionados à fermentação. Técnicas de sequenciamento de DNA e RNA, juntamente com a modelagem computacional, permitem um entendimento aprofundado da fisiologia microbiana e otimizam as modificações genéticas (Abreu-Cavalheiro e Monteiro, 2014; Buschke et al., 2013). O sequenciamento de RNA é particularmente importante para detectar alterações na expressão gênica sob diferentes condições. Estudos anteriores já empregaram esta técnica para avaliar perfis gênicos de leveduras industriais durante a produção de bioetanol 1G e 2G (Carvalho-Netto et al., 2015; Carvalho et al., 2021).
Em conjunto com a bioinformática, o aprendizado de máquina tem sido amplamente aplicado na predição estrutural de proteínas, na análise de suas interações e na avaliação da expressão gênica. Como parte da inteligência artificial, o aprendizado de máquina utiliza modelos estatísticos e algoritmos que “aprendem” a partir de dados (Yousef e Allmer, 2023). No contexto da expressão gênica, metodologias de aprendizado de máquina são implementadas para prever variações nos níveis de expressão, como a aplicação de redes bayesianas baseadas no algoritmo de agrupamento k-means para identificar padrões (Al Taweraqi e King, 2022).
Apesar dos avanços significativos, desafios como a complexidade dos processos de hidrólise e fermentação, os custos elevados de enzimas e a necessidade de maior eficiência na conversão de pentoses persistem (Della-Bianca et al., 2013). A integração de engenharias metabólica e evolutiva, aliada à bioinformática e ao aprendizado de máquina, representa uma abordagem promissora para superar essas limitações (Karhumaa et al., 2007). Neste contexto, o presente trabalho possui como objetivo realizar análises, a partir de métodos não supervisionados, para avaliar os diferentes perfis transcricionais e variações na expressão gênica, a partir de dados já publicados (Carvalho-Netto et al., 2015; Carvalho et al., 2021), de leveduras Saccharomyces cerevisiae “Pedra-2” em condições de fermentação de etanol 1G e 2G, na escala industrial.
2. Material e Métodos
Coleta dos dados
Os dados de transcriptoma foram obtidos no formato FASTQ do repositório “Sequence Read Archives Database” [SRA] (2009) (https://www.ncbi.nlm.nih.gov/sra/). Estes dados, provenientes de sequenciamento de Nova Geração de leituras curtas (do inglês “short reads”) gerados por equipamentos “Illumina” (Cock et al., 2010), contêm sequências de nucleotídeos e notas de qualidade.
Para as leveduras industriais Saccharomyces cerevisiae [PE-2] de primeira geração [1G], os dados foram coletados em 2009, diretamente dos tanques de fermentação de uma destilaria em Maracaí, São Paulo, Brasil, conforme o artigo de Carvalho-Netto et al. (2015) (“BioProject number” “PRJNA172193”). As amostras de “Typical fermentation” foram obtidas nos tempos de 1h, 4h, 7h, 10h, 12h e 15 horas de fermentação.
Para as leveduras que fermentam etanol 2G, os dados foram obtidos do artigo de Carvalho et al. (2021) (“BioProject number” “PRJNA667443”), identificados como “Industrial fermentation”. As amostras foram coletadas em dezembro de 2016, diretamente da dorna de fermentação de uma usina em São Miguel dos Campos, Alagoas, Brasil, nos tempos de 7h, 12h, 16h e 24 horas de fermentação. A produção de etanol [2G] utilizou um hidrolisado lignocelulósico, obtido de pré-tratamento hidrotérmico sobre palha de cana-de-açúcar. A Tabela 1 detalha a identificação, tipo de fermentação, réplica e descrição dos experimentos.
Tabela 1. Descrição das variáveis de transcriptoma referentes às leveduras industriais submetidas a diferentes tempos de fermentação, para produção de etanol de primeira [1G] e segunda [2G] gerações
| ID | Tipo de fermentação (1G / 2G) | Réplica | Descrição |
|---|---|---|---|
| TF1_1G_1h | 1G | Única | Leveduras industriais (fermentação tradicional [TF]), coletadas no período de 1 hora. |
| TF2_1G_4h | 1G | Única | Leveduras industriais (fermentação tradicional [TF]), coletadas em dorna no período de 4 horas |
| TF3_1G_7h | 1G | Única | Leveduras industriais (fermentação tradicional [TF]), coletadas no período de 7 horas |
| TF4_1G_10h | 1G | Única | Leveduras industriais (fermentação tradicional [TF]), coletadas no período de 10 horas |
| TF5_1G_12h | 1G | Única | Leveduras industriais (fermentação tradicional [TF]), coletadas no período de 12 horas |
| TF6_1G_15h | 1G | Única | Leveduras industriais (fermentação tradicional [TF]), coletadas no período de 15 horas |
| F1_2G_7h | 2G | 1 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas na dorna no período de 7 horas |
| F5_2G_7h | 2G | 2 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 7 horas |
| F6_2G_7h | 2G | 3 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 7 horas |
| F1_2G_12h | 2G | 1 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 12 horas |
| F5_2G_12h | 2G | 2 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 12 horas |
| F6_2G_12h | 2G | 3 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 12 horas |
| F1_2G_16h | 2G | 1 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 16 horas |
| F5_2G_16h | 2G | 2 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 16 horas |
| F6_2G_16h | 2G | 3 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 16 horas |
| F1_2G_24h | 2G | 1 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 24 horas |
| F5_2G_24h | 2G | 2 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 24 horas |
| F6_2G_24h | 2G | 3 | Leveduras industriais (fermentação de bagaço de cana [F]), coletadas no período de 24 horas |
Fonte: Resultados originais da pesquisa
Tratamento dos dados
Os dados passaram por análise de qualidade com o software “FastQC” v0.11.4 (Andrews, 2010). As sequências de adaptadores do sequenciamento “Illumina” foram removidas usando “Trimmomatic” v0.39 (Bolger et al., 2014).
Para a quantificação dos transcritos, os dados foram alinhados contra as sequências de genes da levedura de laboratório Saccharomyces cerevisiae S288c do “Saccharomyces Genome Database” [SGD] (2007) (https://www.yeastgenome.org/), e 23 genes específicos de “Pedra-2” [PE-2] (Argueso et al., 2009), totalizando 5.938 genes. A quantificação foi realizada pelo software “Kallisto” v0.44 (Bray et al., 2016), com parâmetros “-k 31 -b 100”. Para “reads single-end” (leveduras industriais de etanol [1G]), foram usados os parâmetros “-I 150 -s 0.01”. Uma tabela final com todos os dados em Transcritos por milhão [TPM] foi gerada para as análises não supervisionadas.
A normalização [TPM] é calculada dividindo a contagem de “reads” pelo comprimento do “gene” (em “kilobases”) para obter “reads” por “kilobase” [RPK], e então dividindo todos os valores de [RPK] por 1.000.000. Esta normalização considera o comprimento do “gene” e a profundidade do sequenciamento, resultando na mesma soma de [TPM] para cada amostra (Zhao et al., 2021).
Análise de dados não supervisionados
Para comparar os dados de expressão entre leveduras industriais de fermentação [1G] e [2G], foram utilizadas metodologias de dados não supervisionados para identificar organização, padrões, semelhanças e diferenças. Os métodos incluíram Correlação de Pearson, Análise de Componentes Principais [PCA], Análise Fatorial de Dados Mistos [FAMD] (Pagès, 2004) e clusterização hierárquica aglomerativa.
A análise de correlação de Pearson, com matriz de correlação e mapa de calor, foi gerada por scripts em Python, utilizando os pacotes “pandas”, “numpy”, “pingouin” e “plotly.graph_objects”.
Para a Análise de Componentes Principais [PCA], scripts em Python foram usados com os pacotes “pandas”, “numpy”, “factor_analyzer” e “matplotlib”. O Teste de Esfericidade de Bartlett foi realizado, e a quantidade de componentes principais foi avaliada pelo Critério de Kaiser. A Tabela 2 apresenta os componentes principais, autovalores e variâncias.
Tabela 2. Componentes principais, autovalores, variância e variância acumulada obtidos a partir dos dados de expressão dos transcriptomas de leveduras industriais em diferentes tempos de fermentação, para produção de etanol de primeira [1G] e segunda [2G] gerações
| Componentes Principais | Autovalor | Variância Explicada | Variância Acumulada |
|---|---|---|---|
| Componente 1 | 11,9689 | 66,49% | 66,49% |
| Componente 2 | 2,8776 | 15,99% | 82,48% |
| Componente 3 | 1,3445 | 7,47% | 89,95% |
| Componente 4 | 1,0451 | 5,81% | 95,76% |
Fonte: Resultados originais da pesquisa
A Análise Fatorial de Dados Mistos [FAMD] foi realizada com scripts na linguagem R, utilizando as bibliotecas “ggplot2″, “dplyr”, “FactoMineR”, “factoextra”, “gridExtra” e “ggrepel”.
Para a clusterização hierárquica aglomerativa, scripts em Python foram empregados com os pacotes “pandas”, “numpy”, “matplotlib”, “scipy.stats” e “scipy”. O método de encadeamento “complete linkage” foi utilizado, aplicando a distância euclidiana a todos os dados de transcriptoma e a genes específicos de vias do fluxo de carbono que afetam o metabolismo da levedura. As vias metabólicas analisadas foram: via glicolítica [GP], rota do glicerol [GR], via da pentose fosfato [PPP] e o ciclo do ácido tricarboxílico [TCA]. A Tabela 3 lista os genes relacionados a essas vias.
Tabela 3. Genes relacionados às vias metabólicas do fluxo de carbono nas leveduras industriais
| Via Metabólica | Genes | ID dos Genes | Descrição do Gene |
|---|---|---|---|
| Via Glicolítica [GP] | GLK1 | YCL040W | Glicoquinase |
| Via Glicolítica [GP] | HXK1 | YFR053C | Isoenzima 1 da hexoquinase |
| Via Glicolítica [GP] | PGI1 | YBR196C | Enzima glicolítica fosfoglicose isomerase |
| Via Glicolítica [GP] | FBP1 | YLR377C | Frutose-1,6-bisfosfatase |
| Via Glicolítica [GP] | PFK1 | YGR240C | Subunidade alfa da fosfofrutoquinase heterooctamérica |
| Via Glicolítica [GP] | FBA1 | YKL060C | Frutose 1,6-bisfosfato aldolase |
| Via Glicolítica [GP] | TPI1 | YDR050C | Triose fosfato isomerase |
| Via Glicolítica [GP] | TDH1 | YJL052W | Gliceraldeído-3-fosfato desidrogenase (GAPDH), isozima 1 |
| Via Glicolítica [GP] | PGK1 | YCR012W | 3-fosfoglicerato quinase |
| Via Glicolítica [GP] | PGM1 | YKL127W | Fosfoglucomutase, isoforma menor |
| Via Glicolítica [GP] | ENO1 | YGR254W | Enolase I |
| Via Glicolítica [GP] | PYK2 | YOR347C | Piruvato quinase |
| Via Glicolítica [GP] | PDC1 | YLR044C | Piruvato descarboxilase |
| Via Glicolítica [GP] | ALD4 | YOR374W | Aldeído desidrogenase mitocondrial |
| Via Glicolítica [GP] | ALD5 | YER073W | Aldeído desidrogenase mitocondrial |
| Via Glicolítica [GP] | ADH1 | YOL086C | Álcool desidrogenase |
| Rota do Glicerol [GR] | GPD1 | YDL022W | Glicerol-3-fosfato desidrogenase dependente de NAD |
| Rota do Glicerol [GR] | GPD2 | YOL059W | Glicerol-3-fosfato desidrogenase dependente de NAD |
| Rota do Glicerol [GR] | GPP1 | YIL053W | Glicerol-1-fosfatase |
| Rota do Glicerol [GR] | GUT1 | YHL032C | Glicerol quinase |
| Via da Pentose Fosfato [PPP] | ZWF1 | YNL241C | Glicose-6-fosfato desidrogenase (G6PD) |
| Via da Pentose Fosfato [PPP] | GND1 | YHR183W | 6-fosfogluconato desidrogenase (descarboxilante) |
| Via da Pentose Fosfato [PPP] | GND2 | YGR256W | 6-fosfogluconato desidrogenase (descarboxilante) |
| Via da Pentose Fosfato [PPP] | RPE1 | YJL121C | D-ribulose-5-fosfato 3-epimerase |
| Via da Pentose Fosfato [PPP] | RKI1 | YOR095C | Ribose-5-fosfato cetoisomerase |
| Via da Pentose Fosfato [PPP] | TKL1 | YPR074C | Transcetolase |
| Via da Pentose Fosfato [PPP] | TAL1 | YLR354C | Transaldolase |
| Ciclo do ácido tricarboxílico [TCA] | PDA1 | YER178W | Subunidade alfa E1 do complexo piruvato desidrogenase (PDH) |
| Ciclo do ácido tricarboxílico [TCA] | PDB1 | YBR221C | Subunidade beta E1 do complexo piruvato desidrogenase (PDH) |
| Ciclo do ácido tricarboxílico [TCA] | LAT1 | YNL071W | Componente da di-hidrolipoamida acetiltransferase (E2) do PDC |
| Ciclo do ácido tricarboxílico [TCA] | PYC1 | YGL062W | Isoforma da piruvato carboxilase |
| Ciclo do ácido tricarboxílico [TCA] | CIT1 | YNR001C | Citrato sintase mitocondrial |
| Ciclo do ácido tricarboxílico [TCA] | ADH1 | YOL086C | Álcool desidrogenase |
| Ciclo do ácido tricarboxílico [TCA] | ADP1 | YCR011C | Permease dependente de ATP putativa da família de transportadores ABC. |
| Ciclo do ácido tricarboxílico [TCA] | KGD1 | YIL125W | Subunidade do complexo alfa-cetoglutarato desidrogenase mitocondrial |
| Ciclo do ácido tricarboxílico [TCA] | KGD2 | YDR148C | Di-hidrolipoil transsuccinilase |
| Ciclo do ácido tricarboxílico [TCA] | LSC1 | YOR142W | Subunidade alfa da succinil-CoA ligase |
| Ciclo do ácido tricarboxílico [TCA] | LSC2 | YGR244C | Subunidade beta da succinil-CoA ligase |
| Ciclo do ácido tricarboxílico [TCA] | SDH1 | YKL148C | Subunidade flavoproteína da succinato desidrogenase |
| Ciclo do ácido tricarboxílico [TCA] | FUM1 | YPL262W | Fumarases |
| Ciclo do ácido tricarboxílico [TCA] | MDH1 | YKL085W | Malato desidrogenase mitocondrial |
| Ciclo do ácido tricarboxílico [TCA] | ACO1 | YLR304C | Aconitase |
Fonte: Traduzido de Saccharomyces Genome Database [SGD] (2007)
3. Resultados e Discussão
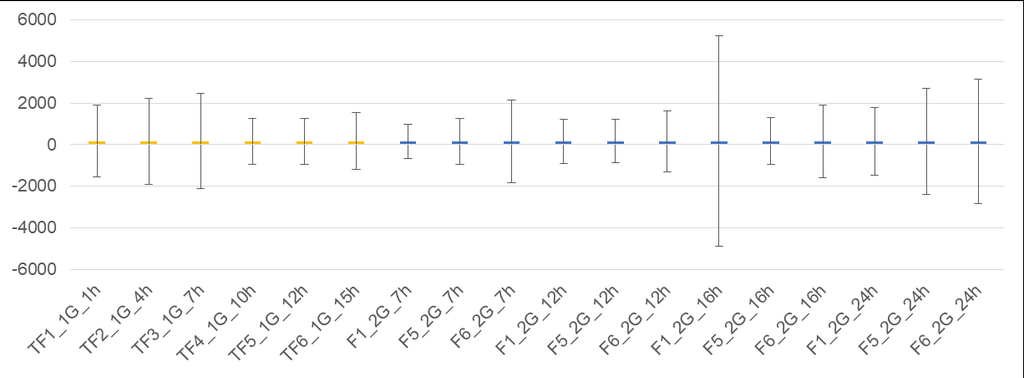
A análise estatística descritiva dos dados revelou que as médias de expressão gênica para todas as amostras de leveduras de primeira geração (1G) e segunda geração (2G) foram próximas a 168,41. Os desvios padrão para as amostras 1G variaram entre 1.108,82 e 2.297,97, enquanto para as amostras 2G, a variação foi de 829,04 a 5.064,89. Os valores de quartil 1 (25%) para 1G estiveram entre 6,37 e 13,4, e para 2G, entre 3,69 e 8,03. Os valores máximos para 1G variaram de 43.948 a 131.443, e para 2G, de 22.028,60 a 291.908. A uniformidade das médias em todas as amostras indica que a normalização dos dados por Transcritos por milhão (TPM) foi adequada, validando a comparabilidade dos dados de 1G (Carvalho-Netto et al., 2015) e 2G (Carvalho et al., 2021) (Zhao et al., 2021).
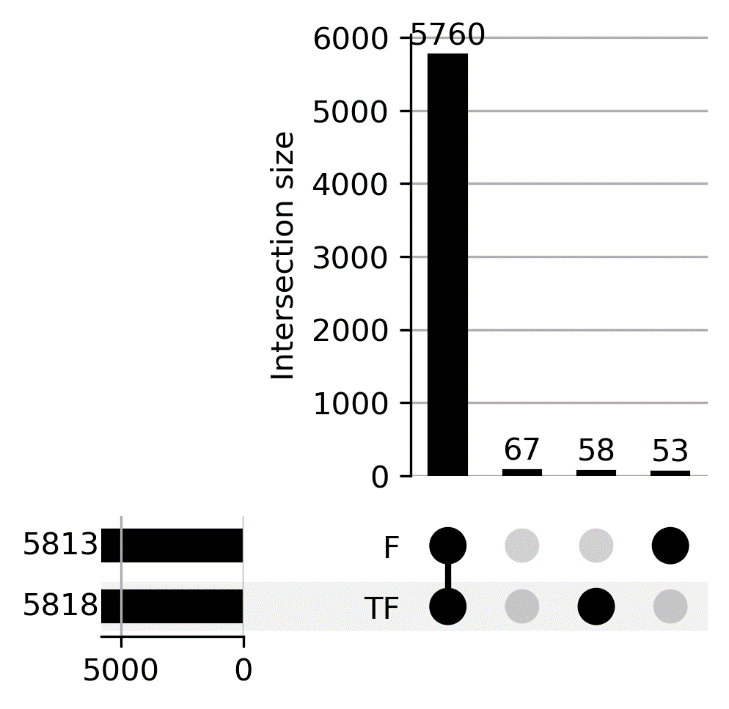
Para identificar os genes expressos, foi gerado um gráfico upset (Diagrama de Venn) (Figura 1). Dos 5.938 genes encontrados, 5.760 foram comuns aos dois grupos de fermentação (1G e 2G), 58 foram exclusivos do grupo 1G, 53 exclusivos do grupo 2G e 67 estavam ausentes em ambos. A presença de um grande número de genes comuns sugere que o maquinário básico de sobrevivência e fermentação da Saccharomyces cerevisiae é mantido, apesar das diferenças nos substratos (caldo de cana para 1G e hidrolisado lignocelulósico para 2G) e das dinâmicas temporais e de estresse metabólico.
Figura 1. Diagrama de Venn (“upset”) contendo a quantidade de genes expressos no transcriptoma de leveduras industriais em diferentes tempos de fermentação, para produção de etanol de primeira [1G] (amostras TF) e segunda [2G] gerações (amostras F)
Fonte: Resultados originais da pesquisa
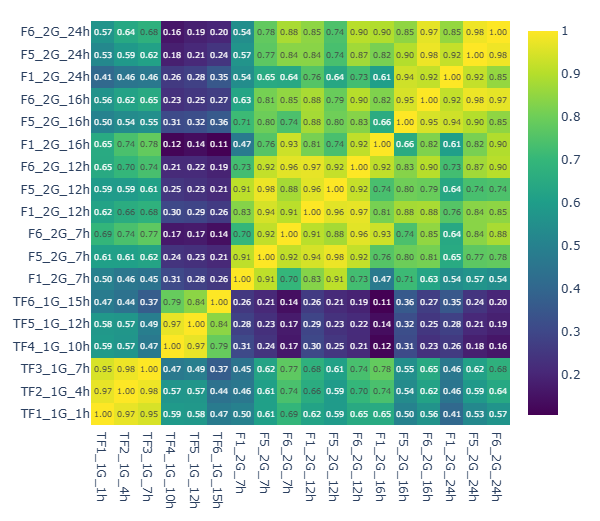
A análise de correlação de Pearson (Figura 2) revelou agrupamentos distintos nos perfis gênicos. As amostras de leveduras 1G formaram dois grupos: um com 1h, 4h e 7h de fermentação (coeficiente de correlação r > 0,95) e outro com 10h, 12h e 15h (r > 0,79). Nas amostras 2G, as réplicas de 16h e 24h apresentaram correlação mais baixa com a amostra F1_2G_7h (r < 0,70 e 0,54, respectivamente). A amostra F1_2G_24h também mostrou correlações mais baixas com as amostras de 7h (r < 0,65) e 16h (r < 0,76). Todas as correlações foram estatisticamente significativas (p < 0,05).
Figura 2. Mapa de calor referente aos métodos de correlação de Pearson sobre todos os genes obtidos nos dados de transcriptoma das fermentações [1G] (amostras [TF]) e [2G] (amostras [F]), em diferentes períodos de coleta Todas as correlações foram significantes (p-valor < 0,05)
Fonte: Resultados originais da pesquisa
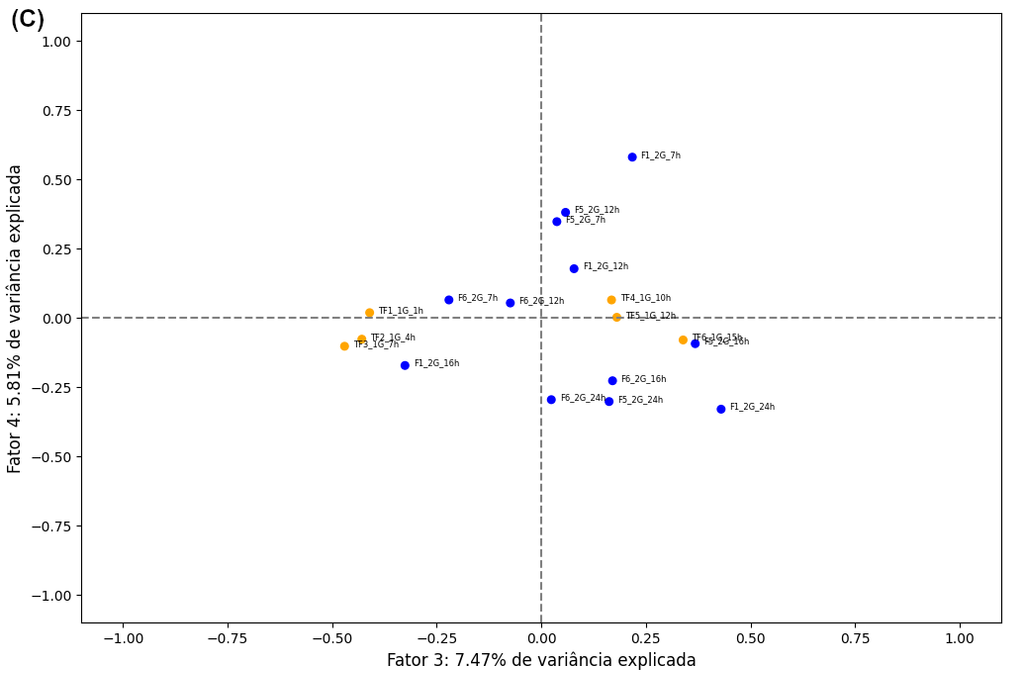
A Análise de Componentes Principais (PCA) foi aplicada para reduzir a dimensionalidade dos dados e analisar a variância. O Teste de Esfericidade de Bartlett (qui-quadrado = 312.811,59, p < 0,05) indicou a adequação da matriz de correlação. Quatro componentes principais (PCs) com autovalores maiores que 1 foram extraídas, explicando 95,76% da variância total dos dados. A Componente 1 explicou 66,49% da variância, seguida pela Componente 2 com 15,99%, Componente 3 com 7,47% e Componente 4 com 5,81%.
Os gráficos de cargas fatoriais (Figura 3) da PCA mostraram agrupamentos distintos, com uma clara separação entre as amostras de leveduras 1G e 2G, especialmente na Figura 3A, onde a PC1 explica a maior parte da variância (66,49%). Este achado indica que o tipo de fermentação é o principal fator de diferenciação transcricional entre as amostras.
Figura 3. “Loading plots” obtidos a partir das cargas fatoriais dos dados de transcriptomas de leveduras industriais submetidas a fermentações de etanol de primeira [1G] e segunda [2G] gerações. (A) Fator 1 (PC1) x Fator 2 (PC2); (B) Fator 2 (PC2) x Fator 3 (PC3); e (C) Fator 3 (PC3) x Fator 4 (PC4)
Fonte: Resultados originais da pesquisa Nota: Pontos em laranja: 1G; pontos em azul: 2G
Clusterização hierárquica por “complete linkage”
A clusterização hierárquica aglomerativa, utilizando o método “complete linkage” e distância euclidiana, agrupou as amostras de leveduras industriais conforme o tipo de produção de etanol (Figura 4), resultando em cinco grupos distintos com um corte na distância euclidiana de 60. As amostras 1G foram agrupadas em função do tempo de fermentação (tempos finais à esquerda e iniciais à direita do dendrograma), enquanto as amostras 2G não seguiram um padrão temporal claro, apresentando maior heterogeneidade transcriptômica.
Figura 4. Dendrograma gerado a partir da clusterização hierárquica por “Complete Linkage” de dados de transcriptoma de todos os 5.938 genes de leveduras industriais submetidas a diferentes tempos de fermentações para produção de etanol de primeira [1G] (amostras [TF]) e segunda [2G] (amostras [F])
Fonte: Resultados originais da pesquisa
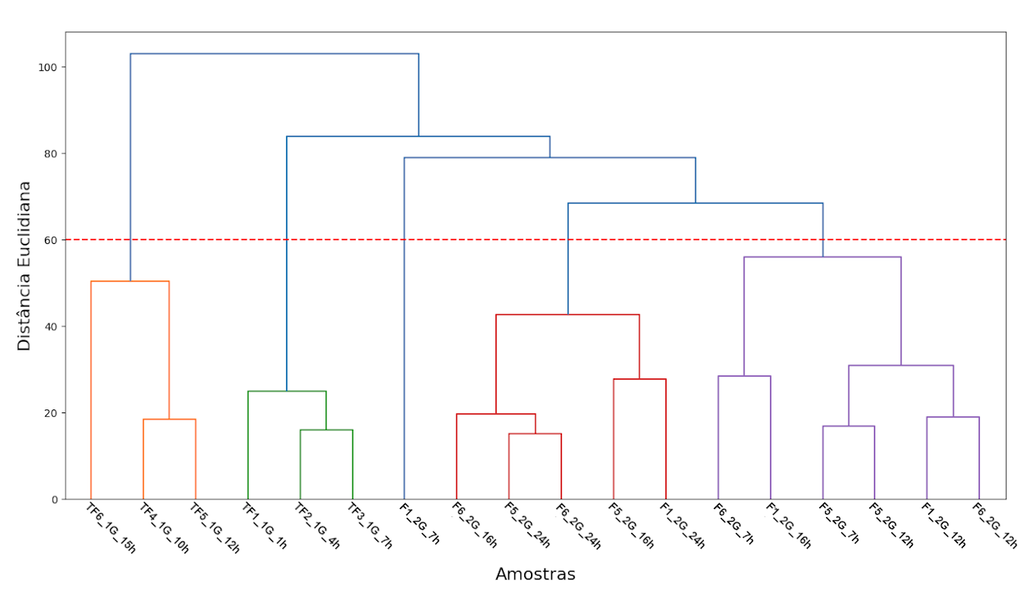
A análise dos genes específicos da via glicolítica (GP) (Tabela 5) também separou as leveduras por tipo de etanol (Figura 5), com dois grupos principais definidos por um corte na distância euclidiana de 6. As amostras 1G agruparam-se por tempo de fermentação (iniciais: 1h, 4h, 7h, 10h; finais: 12h, 15h). As amostras 2G, por sua vez, distribuíram-se em três subgrupos conforme o tempo de fermentação, sendo um exclusivo para 7h e os demais agrupando 12h, 16h e 24h.
Tabela 5. Genes relacionados às vias metabólicas do fluxo de carbono nas leveduras industriais
Fonte: Traduzido de Saccharomyces Genome Database [SGD] (2007)
Figura 5. Dendrograma gerado a partir da clusterização hierárquica por “Complete Linkage” de dados de transcriptomas dos genes específicos da Via Glicolítica [GP] de leveduras industriais submetidas a diferentes tempos de fermentações para produção de etanol de primeira [1G] (amostras TF) e segunda [2G] (amostras F)
Fonte: Resultados originais da pesquisa
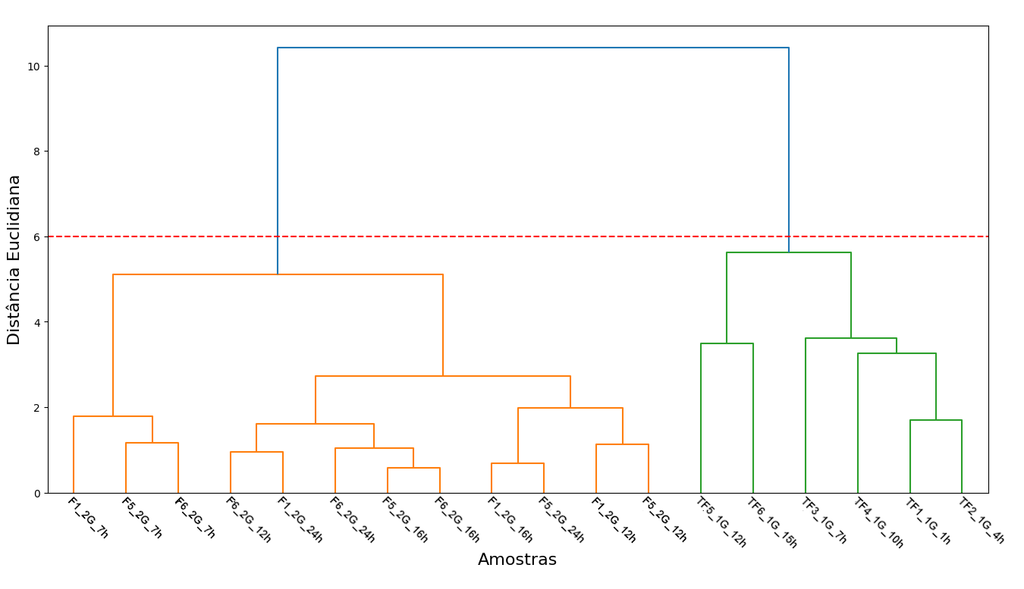
Para os genes da rota do glicerol (GR) (Tabela 5), a clusterização hierárquica (Figura 6) formou três agrupamentos com um corte na distância euclidiana de 3. Dois grupos corresponderam às leveduras 1G, separadas por tempo de fermentação (1h, 4h, 10h em um grupo; 12h, 15h em outro). O terceiro grupo foi composto pelas amostras 2G. Notavelmente, a amostra TF2_1G_7h (1G, 7h) agrupou-se com as leveduras 2G no mesmo tempo (7h), sugerindo um comportamento transcriptômico distinto.
Figura 6. Dendrograma gerado a partir da clusterização hierárquica por “Complete Linkage” de dados de transcriptomas dos genes específicos da Rota do Glicerol [GR] de leveduras industriais submetidas a diferentes tempos de fermentações para produção de etanol de primeira [1G] (amostras TF) e segunda [2G] (amostras F)
Fonte: Resultados originais da pesquisa
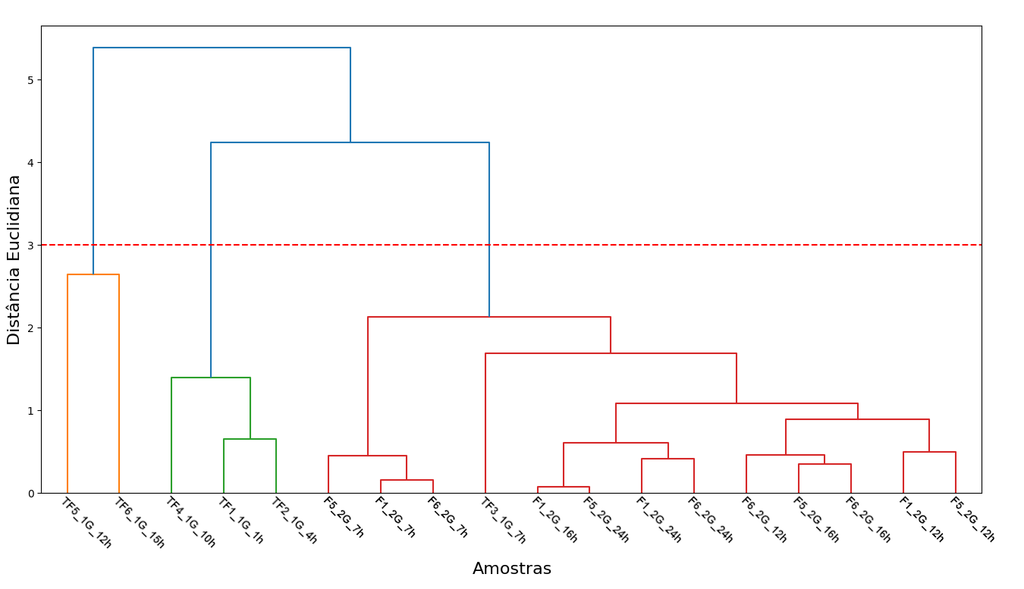
Na análise dos genes da via da pentose fosfato (PPP) (Tabela 5), a clusterização hierárquica (Figura 7) resultou em quatro grupos distintos com um corte na distância euclidiana de 3. O primeiro grupo incluiu amostras 2G de 7h e 12h. O segundo e terceiro grupos representaram as leveduras 1G, agrupadas por tempo de fermentação (tempos finais: 10h, 12h, 15h; e tempos iniciais: 1h, 4h, 7h). O último grupo reuniu amostras 2G nos tempos finais de fermentação (12h, 16h, 24h).
Figura 7. Dendrograma gerado a partir da clusterização hierárquica por “Complete Linkage” de dados de transcriptomas dos genes específicos da Via da Pentose Fosfato [PPP] de leveduras industriais submetidas a diferentes tempos de fermentações para produção de etanol de primeira [1G] (amostras TF) e segunda [2G] (amostras F)
Fonte: Resultados originais da pesquisa
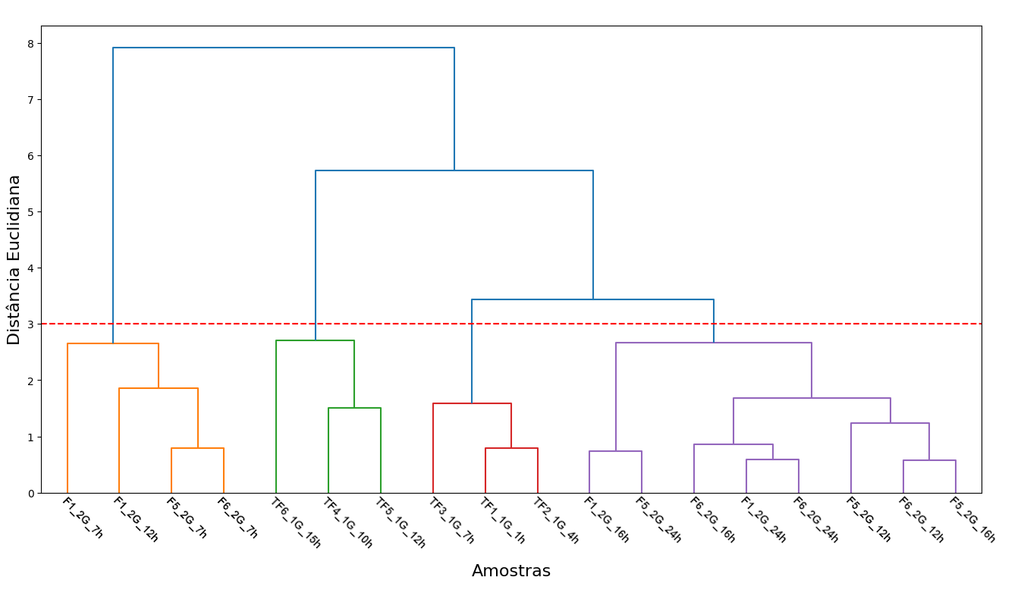
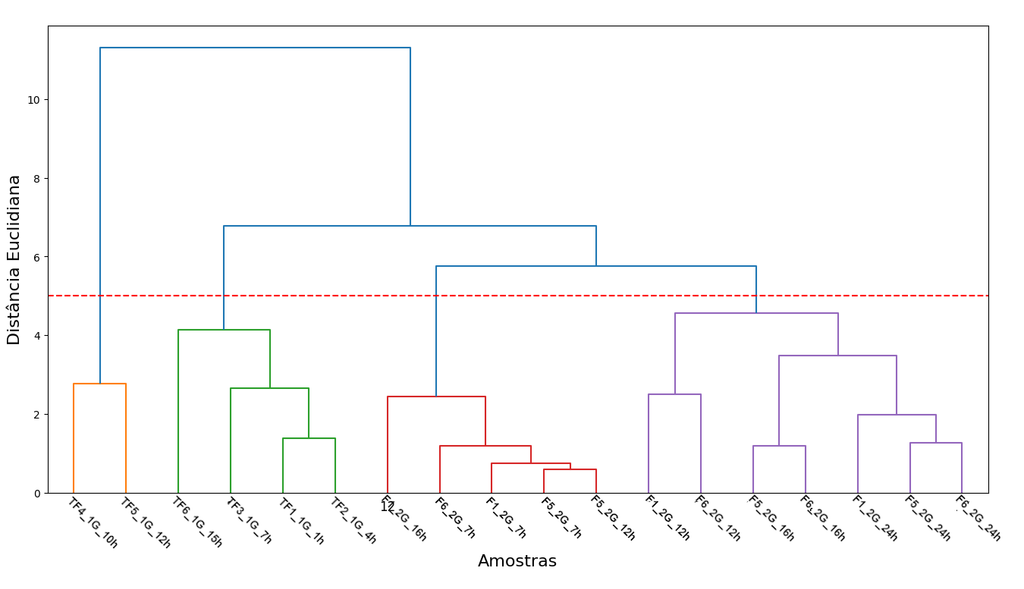
Por fim, a clusterização hierárquica baseada nos genes do ciclo do ácido tricarboxílico (TCA) (Tabela 5) (Figura 8) também mostrou a separação das leveduras por tipo de etanol (1G e 2G). Com um corte na distância euclidiana de 5, quatro grupos principais foram definidos. As amostras 1G formaram dois subgrupos (10h e 12h em um; 1h, 4h, 7h e 15h em outro). As amostras 2G também formaram dois subgrupos (todas as amostras de 7h, uma amostra isolada de 12h e outra de 16h em um; e as demais amostras de 12h, 16h e 24h em outro).
Figura 8. Dendrograma gerado a partir da clusterização hierárquica por “Complete Linkage” de dados de transcriptomas dos genes específicos do ciclo do ácido tricarboxílico [TCA] de leveduras industriais submetidas a diferentes tempos de fermentações para produção de etanol de primeira [1G] (amostras TF) e segunda [2G] (amostras F)
Fonte: Resultados originais da pesquisa
Análise Fatorial de Dados Mistos [FAMD]
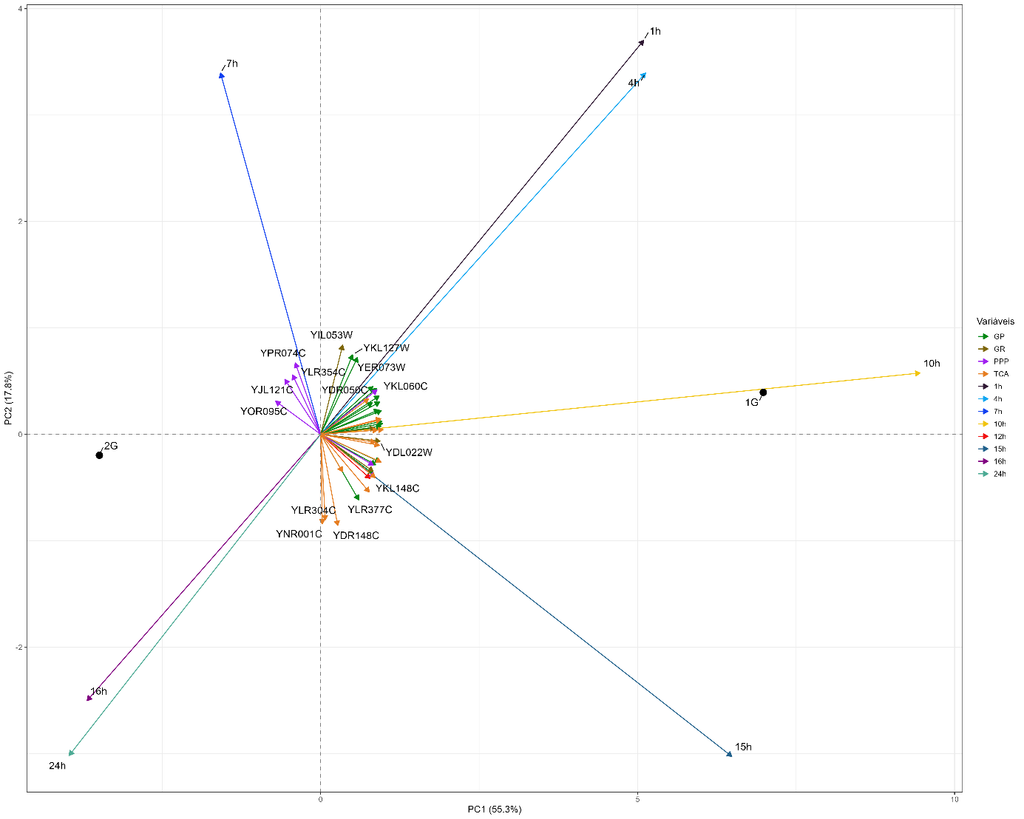
A Análise Fatorial de Dados Mistos (FAMD) integrou variáveis quantitativas (expressão gênica) e qualitativas (tempos e tipos de fermentação), permitindo identificar padrões de associação. As duas primeiras componentes principais (PC1 e PC2) explicaram 73,1% da variância total (PC1: 55,3%; PC2: 17,8%), indicando uma boa representação dos dados (Figura 9). Observou-se uma forte separação entre as amostras ao longo da PC1, com 1G no extremo positivo e 2G no extremo negativo, confirmando que o tipo de fermentação é a principal fonte de variação.
Figura 9. Biplot obtido pela análise fatorial de dados mistos [FAMD] a partir dos transcriptomas de leveduras industriais, considerando dimensões 1 e2
Fonte: Resultados originais da pesquisa Nota: Neste gráfico foram levadas em consideração variáveis como vias metabólicas associadas aos genes, tempos e tipos de fermentações para produção de etanol de primeira [1G] e segunda [2G]. Siglas: [GP]: via glicolítica, [GR]: rota do glicerol, [PPP]: via da pentose-fosfato, [TCA]: ciclo do ácido tricarboxílico
As componentes PC3 e PC4 (Figura 10) explicaram 12% da variância total (PC3: 7%; PC4: 5%), com 1G no extremo negativo de PC3 e 2G no positivo, indicando uma contribuição secundária para a estrutura global dos dados. Em relação aos tempos de fermentação, foram observados agrupamentos distintos: 1h e 4h correlacionados positivamente com PC2; 10h alinhado com PC1 positivo e 1G; 15h com forte contribuição em PC1 e componente negativo em PC2; e 16h e 24h com orientações opostas a 1G, mais próximas a 2G. O tempo de 7h mostrou um comportamento intermediário, contribuindo principalmente para PC2.
Figura 10. Biplot obtido pela análise fatorial de dados mistos [FAMD] a partir dos transcriptomas de leveduras industriais, considerando dimensões 3 e4
Fonte: Resultados originais da pesquisa Nota: Neste gráfico foram levadas em consideração variáveis como vias metabólicas associadas aos genes, tempos e tipos de fermentações para produção de etanol de primeira [1G] e segunda [2G]. Siglas: [GP]: via glicolítica, [GR]: rota do glicerol, [PPP]: via da pentose-fosfato, [TCA]: ciclo do ácido tricarboxílico
As análises por vias metabólicas associadas ao fluxo de carbono (Tabela 5) revelaram padrões distintos. Genes da via glicolítica (GP), como PFK1 (YGR240C), FBA1 (YKL060C), TPI1 (YDR050C), PGK1 (YJL052W) e PGI1 (YCR012W), associaram-se aos tempos iniciais e tardios de fermentação 1G, assim como genes da fermentação alcoólica (PDC1 (YLR044C) e ENO1 (YGR254W)). Genes da rota do glicerol (GR), como GPD1 (YDL022W) e GPD2 (YOL059W), associaram-se a tempos avançados de 1G, sugerindo seu papel no ajuste metabólico. Por outro lado, genes da via da pentose-fosfato (PPP), como ZWF1 (YNL241C), GND2 (YGR256W) e RPE1 (YHR183W), corresponderam à fermentação 2G. Genes do ciclo do ácido tricarboxílico (TCA), incluindo CIT1 (YNR001C), SDH1 (YKL148C), IDH1 (YPL262W) e ACO1 (YLR304C), correlacionaram-se com tempos tardios de 2G. Esses resultados indicam que a variação da expressão gênica está fortemente associada às diferenças entre as fermentações 1G e 2G, bem como à progressão temporal.
Este trabalho comparou os perfis de expressões gênicas de leveduras industriais em fermentações de primeira (1G) e segunda (2G) gerações em diferentes tempos, utilizando métodos não supervisionados. Os resultados evidenciaram uma clara separação entre os perfis de expressão gênica associados aos processos 1G e 2G, atribuída às diferenças metabólicas entre as leveduras sob essas condições de fermentação. O tipo de substrato e as condições do processo exercem influência sobre o comportamento molecular das leveduras. A fermentação 1G apresentou padrões mais organizados ao longo do tempo, enquanto a fermentação 2G exibiu maior variabilidade e complexidade metabólica, o que reflete os desafios de utilizar biomassa lignocelulósica. As análises também indicaram diferenças relevantes entre as vias metabólicas associadas ao fluxo de carbono, com a via da glicólise mais associada à 1G e as vias da pentose fosfato e do ciclo do ácido tricarboxílico mais envolvidas na 2G. Os métodos não supervisionados foram eficazes na identificação de padrões biológicos relevantes, permitindo a distinção entre os perfis moleculares das fermentações 1G e 2G e demonstrando potencial como ferramentas analíticas para aprimoramento biotecnológico da produção de etanol. É importante notar que os dados de transcriptoma foram provenientes de diferentes estudos, o que pode introduzir “batch effects” devido a variações nas tecnologias de sequenciamento e no número de réplicas biológicas entre as amostras de 1G (2009) e 2G (2016).
4. Conclusão
O presente estudo avaliou os perfis transcriptômicos de leveduras industriais Saccharomyces cerevisiae “Pedra-2” na produção de etanol de primeira e segunda geração, em diferentes tempos de fermentação, por meio de métodos não supervisionados. Verificou-se uma clara separação entre os perfis de expressão gênica associados aos processos de primeira e segunda geração, sendo o tipo de fermentação o principal fator de variabilidade. Observou-se que as amostras de primeira geração exibiram maior organização temporal e estabilidade, enquanto as de segunda geração demonstraram maior heterogeneidade e complexidade metabólica, refletindo os desafios da utilização de biomassa lignocelulósica. Identificaram-se diferenças nas vias metabólicas associadas ao fluxo de carbono, com predominância da glicólise na fermentação de primeira geração e maior participação das vias da pentose fosfato e do ciclo do ácido tricarboxílico na de segunda geração. A principal contribuição reside na demonstração da eficácia dos métodos não supervisionados para identificar padrões biológicos relevantes, aprofundando o entendimento das distinções metabólicas entre os processos e fornecendo subsídios para estratégias de otimização na produção de etanol.
Contudo, é importante considerar as limitações decorrentes da origem dos dados de transcriptoma, provenientes de diferentes estudos, o que pode introduzir “batch effects” devido a variações nas tecnologias de sequenciamento e no número de réplicas biológicas. Além disso, a natureza exploratória dos métodos não supervisionados impede inferências causais diretas. Para estudos futuros, sugere-se a incorporação de abordagens supervisionadas, maior padronização experimental e validação com novos conjuntos de dados. Tais iniciativas podem aprofundar a compreensão dos mecanismos moleculares envolvidos e ampliar o potencial de aplicação desses resultados em contextos industriais, contribuindo para o aprimoramento biotecnológico da produção de etanol.
Referências Bibliográficas
Basso, LC.; De Amorim, H. V.; De Oliveira, A. J.; Lopes, M. L. 2011. Yeast selection for fuel ethanol production in Brazil. FEMS Yeast Research 11(2): 151-164.
Goldemberg, J. 2008. The Brazilian biofuels industry. Biotechnology for Biofuels 1-6.
Leite, R.C.C.; Leal, M.R.L.V.; Cortez, L.A.B.; Griffin, W. M.; Scandiffio, M.I.G. (2009). Can Brazil replace 5% of the 2025 gasoline world demand with ethanol? Energy 34(5): 655-661.
Renewable Fuels Association [RFA]. 2024. Market & Statistics – Annual Ethanol Production – 2024. Disponível em: . Acesso em: 10 mar. 2025.
Roman, C. 2010. Portal Ecodebate – Brasil busca liderança na produção de biocombustível.
Wheals, Α.Ε.; Basso, L.C; Alves, D.M.; Amorim, H.V. 1999. Fuel ethanol after 25 years. Trends Biotechnology 17(12):482-487.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

