
15 de setembro de 2026
Entre o Artificial e o Humano: Identificação de Textos Humanizados no Enem por Features Linguísticas
Lucas Lopes Ribeiro; Ana Julia Righetto
DOI: 10.22167/2675-6528-202602261
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A crescente utilização de modelos de linguagem na produção de textos acadêmicos tornou relevante o desenvolvimento de métodos para identificar a autoria de produções textuais, especialmente diante de ferramentas de humanização que mascaram a origem sintética. O objetivo foi investigar a viabilidade da detecção de textos gerados por inteligência artificial, mesmo após reescrita automática, por meio de atributos linguísticos interpretáveis. Para isso, construiu-se um corpus de redações dissertativo-argumentativas no padrão do ENEM, abrangendo textos humanos, gerados por modelo de linguagem e versões humanizadas por ferramenta de paráfrase. Extraíram-se métricas estilométricas de diversidade lexical, complexidade sintática, legibilidade e previsibilidade textual, empregadas na modelagem de um problema de classificação binária supervisionada. Treinaram-se três algoritmos de aprendizado de máquina (Regressão Logística, Random Forest e XGBoost) e os avaliaram por validação interna, em um conjunto independente de dados e em comparação com uma ferramenta comercial. Os modelos apresentaram desempenho elevado na distinção entre textos humanos e sintéticos, mantendo consistência mesmo com textos humanizados, enquanto a ferramenta comercial demonstrou maior dificuldade. Concluiu-se que a abordagem baseada em atributos estilométricos mostrou-se eficaz e robusta para a detecção de autoria textual no contexto analisado.
Palavras-chave: Análise linguística; Aprendizado de máquina; Detecção de autoria textual; Humanização de texto; Processamento de linguagem natural.
1. Introdução
A Inteligência Artificial (IA) é um campo de estudo voltado à construção de sistemas capazes de perceber, raciocinar e agir sobre o mundo (Nilsson, 1998). Entre seus subcampos, destaca-se o Processamento de Linguagem Natural (PLN), responsável por permitir que máquinas compreendam e produzam linguagem humana. O avanço recente dos grandes modelos de linguagem (LLMs), como o GPT-3 (Brown et al., 2020), revolucionou a forma como textos são gerados automaticamente, tornando a escrita produzida por IA cada vez mais fluente, coerente e difícil de distinguir da humana. Com isso, surgiram não apenas detectores de textos artificiais, mas também ferramentas chamadas de “humanizadores”, que reescrevem textos de IA por meio de paráfrases e alterações estilísticas para dificultar sua identificação (Masrour et al., 2025).
Ao se debruçar sobre a literatura, a detecção de textos gerados por inteligência artificial tem se tornado uma linha de pesquisa muito ativa. Contudo, trabalhos evidenciam que detectores bem fundamentados podem perder eficácia quando textos são modificados, e detectores comerciais ou de pesquisa apresentam falsos positivos ou negativos elevados, especialmente em textos acadêmicos (Weber-Wulff et al., 2023). Quanto às ferramentas de humanização, estudos como o de Masrour et al. (2025) analisaram dezenove ferramentas comerciais e mostraram que elas reduzem significativamente a acurácia de detectores consolidados, reforçando a necessidade de métodos mais robustos, especialmente em contextos educacionais, onde textos artificialmente modificados podem afetar o aprendizado.
Haja vista esses estudos mencionados, apesar de apresentarem avanços significativos, compartilham algumas limitações: muitos focam em cenários gerais, como notícias ou textos online, e não em textos escolares ou gêneros como as redações do ENEM. Além disso, há escassez de pesquisas que explorem features linguísticas explicáveis, como sintaxe, coesão, conectores e variação lexical como parte central do modelo. Um exemplo recente é o trabalho de Yadagiri et al. (2024), que propõe a detecção de textos gerados por IA a partir de features linguísticas e estilísticas, como diversidade lexical, legibilidade e uso de voz passiva, demonstrando que essas informações podem melhorar tanto a acurácia quanto a interpretação dos resultados. O uso dessas features pode oferecer duas vantagens principais: melhorar a interpretabilidade e transparência do modelo, e capturar marcas mais sutis deixadas por processos de reescrita ou humanização, que detectores puramente probabilísticos ou baseados em perplexidade podem deixar passar.
Tendo isso em vista, no contexto educacional, a discussão sobre o uso de ferramentas de inteligência artificial na escrita torna-se cada vez mais relevante. Segundo o Centro Regional de Estudos para o Desenvolvimento da Sociedade da Informação (Cetic, 2023), sete em cada dez estudantes do ensino médio já utilizam recursos de IA generativa em atividades escolares, e o Brasil figura como o terceiro país que mais utiliza o ChatGPT, com mais de 140 milhões de mensagens trocadas diariamente (CNN Brasil, 2024). Embora essas ferramentas possam auxiliar na elaboração de textos, o uso indiscriminado pode comprometer o desenvolvimento de competências essenciais, como argumentação, coesão e criatividade (Costa; Von Rondon, 2024).
Diante desse cenário, o presente trabalho justifica-se pela necessidade de desenvolver métodos eficazes para a identificação de textos produzidos por inteligência artificial, mesmo após processos de humanização, no ambiente educacional. O presente trabalho teve como objetivo desenvolver um modelo de classificação capaz de identificar textos gerados por inteligência artificial, mesmo após a aplicação de ferramentas de humanização, com foco em redações dissertativo-argumentativas no padrão do Exame Nacional do Ensino Médio (ENEM).
2. Material e Métodos
A pesquisa adotou uma abordagem experimental de natureza aplicada, com elementos quase-experimentais. Buscou-se analisar empiricamente as diferenças entre textos produzidos sob condições de geração textual humana, artificial e humanizada, focando em características linguísticas mensuráveis. Os dados foram processados sob controle e repetibilidade, sendo que textos humanos pré-existentes não tiveram controle sobre variáveis externas, enquanto as produções artificiais foram geradas sob condições controladas por modelos de linguagem e prompts definidos, e ferramentas de humanização.
O corpus foi constituído por 1.800 redações dissertativo-argumentativas no padrão ENEM, divididas em três categorias de 600 textos cada: (i) redações humanas, produzidas por estudantes do ensino médio entre janeiro de 2020 e dezembro de 2022, com extensão mínima de 150 palavras e nota superior a 700 pontos, cedidas por uma startup brasileira de tecnologia educacional; (ii) redações artificiais, geradas pelo modelo de linguagem GPT-4o mini (OpenAI) a partir dos mesmos temas das redações humanas e prompts padronizados para simular instruções do ENEM; e (iii) redações humanizadas, obtidas pela reescrita automática das versões artificiais pela ferramenta de paráfrase QuillBot (modo Standard), com o objetivo de suavizar traços da escrita sintética. Cada conjunto de dados foi organizado em planilhas tabulares, com colunas para ID, texto completo, proposta de escrita, tema e, para redações humanas, nota atribuída; para artificiais, modelo de IA; e para humanizadas, ferramenta de humanização.
O processamento computacional dos textos foi realizado em linguagem Python, utilizando a biblioteca spaCy (Honnibal & Montani, 2017) para segmentação de sentenças, etiquetagem morfossintática (POS Tagging) e análise de dependência; a biblioteca Transformers (Wolf et al., 2020) para o modelo GPT-2 utilizado no cálculo de perplexidade; e Pandas (McKinney, 2010) para a estruturação tabular do corpus. Adotou-se uma abordagem conservadora de pré-processamento, restringindo-se à tokenização para preservar marcas estilométricas.
Para a caracterização quantitativa dos estilos de escrita, foram extraídas 26 features linguísticas, organizadas em quatro dimensões analíticas principais: a) Diversidade Lexical e Repetição (Type-Token Ratio – TTR, Hapax Legomena, Entropia de Shannon); b) Complexidade e Legibilidade (índices de Flesch e Gunning Fog adaptados para o português (Martins et al., 1996), tamanho médio de frases e linhas, complexidade sintática profunda); c) Análise Morfossintática (distribuição de classes de palavras via POS Tagging); d) Estrutura Argumentativa e Coesão (conectivos adversativos e conclusivos, Razão Lógica Conclusiva, incidência de voz passiva analítica); e) Ritmo e Previsibilidade (Burstiness, perplexidade com GPT-2 Small Portuguese).
O problema foi formalmente modelado como uma tarefa de classificação binária supervisionada. As três categorias originais do corpus foram recodificadas em duas classes mutuamente exclusivas: Humano (0) e Artificial/Humanizado (1), agrupando as redações geradas pelo GPT-4o mini e as versões reescritas pelo QuillBot. Essa decisão metodológica visou distinguir a autoria genuinamente humana de qualquer forma de produção sintética. A seleção do vetor de atributos finais foi orientada por análise exploratória comparativa, resultando em um conjunto definitivo de 10 características estilométricas de alto poder de separabilidade, que incluíram Perplexidade, Burstiness, Diversidade Lexical (TTR), Índice de Leiturabilidade de Flesch, Razão de Voz Passiva, Razão Lógica Conclusiva, e densidades sintáticas de Adjetivos, Advérbios, Pronomes e Conjunções Subordinativas. Variáveis sem poder discriminativo robusto foram excluídas. A realização dessa etapa previamente à divisão entre treino e teste pode introduzir viés de seleção de atributos (feature selection bias), o que foi considerado na interpretação dos resultados.
Para a condução dos experimentos de validação interna, o corpus completo de 1.800 redações foi dividido por holdout. Foram destinadas 1.500 instâncias para treinamento e otimização dos modelos, e 300 instâncias para o conjunto de teste interno. A divisão foi realizada com amostragem estratificada, por meio do parâmetro `stratify` da função `train_test_split` da biblioteca Scikit-Learn, resultando em 100 redações humanas e 200 redações sintéticas (100 artificiais e 100 humanizadas) no conjunto de teste. A semente aleatória `random_state=42` foi fixada para garantir a reprodutibilidade.
Foram treinados três algoritmos supervisionados: Regressão Logística, Random Forest e XGBoost. A Regressão Logística, adotada como baseline linear, teve os dados de treinamento padronizados com `StandardScaler` da biblioteca Scikit-Learn e foi instanciada com `max_iter=2000` e `random_state=42`. O Random Forest foi configurado com 100 árvores de decisão (`n_estimators=100`), balanceamento automático de classes (`class_weight=’balanced’`) e `random_state=42`. O XGBoost foi configurado com 100 estimadores (`n_estimators=100`), taxa de aprendizado de 0,1 (`learning_rate=0.1`), profundidade máxima das árvores igual a 5 (`max_depth=5`), métrica de avaliação interna `eval_metric=’logloss’` e `random_state=42`. Ao término do treinamento, os modelos e o `StandardScaler` ajustado foram serializados e persistidos em disco por meio da biblioteca `joblib`.
A validação externa foi conduzida aplicando os modelos treinados a um novo conjunto de dados independente, composto por 300 redações inéditas, que não integraram o corpus original. Este conjunto externo foi construído seguindo os mesmos critérios metodológicos do corpus principal: 100 redações humanas (nota superior a 700 no padrão ENEM), 100 redações geradas pelo modelo GPT-4o mini a partir de novos temas e prompts, e 100 redações humanizadas por meio da ferramenta QuillBot (modo Standard) aplicadas sobre os textos sintéticos. Os modelos foram carregados e aplicados diretamente, sem ajuste ou recalibração, com o `StandardScaler` utilizado para a Regressão Logística.
A avaliação do desempenho dos modelos foi realizada por meio de um conjunto padronizado de métricas de classificação binária (Sokolova & Lapalme, 2009; Fawcett, 2006): Acurácia Global, Precisão, Revocação (Recall) e F1-Score. Complementarmente, procedeu-se à análise das Matrizes de Confusão para examinar os padrões de erro, distinguindo falsos positivos (texto humano classificado como sintético) e falsos negativos (texto sintético, incluindo humanizados, classificado como humano).
Para contextualizar o desempenho dos modelos, foi conduzida uma avaliação comparativa com o GPTZero, uma ferramenta comercial de detecção de textos gerados por modelos de linguagem. A avaliação foi realizada sobre o mesmo conjunto de 300 redações da validação externa. Cada redação foi submetida individualmente à interface web do GPTZero, e as classificações foram registradas manualmente. As saídas do GPTZero foram convertidas para uma tarefa de classificação binária (textos humanos vs. textos sintéticos, incluindo humanizados) e as mesmas métricas de avaliação foram calculadas. Esta avaliação foi conduzida a partir de uma única amostra e mediante interação manual com a ferramenta, o que pode introduzir limitações quanto à reprodutibilidade e padronização do processo.
3. Resultados e Discussão
Esta seção apresenta e discute os resultados obtidos ao longo da pesquisa, estruturando-se em duas frentes analíticas principais. A primeira parte dedica-se à análise exploratória de dados, detalhando as métricas estilométricas avaliadas e os resultados dos testes estatísticos que fundamentaram a seleção dos atributos mais pertinentes para o problema de classificação binária. A segunda parte concentra-se na avaliação do desempenho preditivo das arquiteturas de aprendizado de máquina treinadas, incluindo validação interna e externa, e o benchmarking realizado contra uma ferramenta comercial.
Análise exploratória e seleção das features estilométricas
A etapa inicial de análise dos dados consistiu na validação do vetor de atributos (features) por meio de uma análise exploratória comparativa entre as três categorias de texto: humano, artificial e humanizado. O objetivo foi verificar a existência de padrões estatísticos que permitissem a distinção entre a produção humana genuína e os textos gerados por modelos de linguagem, bem como avaliar o impacto das ferramentas de ofuscação (humanização) sobre estas métricas.
Os gráficos gerados revelaram comportamentos distintos entre as classes, especialmente no que tange à estrutura profunda e à variabilidade lexical dos textos. Observou-se que certas métricas apresentaram uma separação clara entre a autoria humana e a artificial, enquanto outras demonstraram a limitação das ferramentas de humanização em alterar a “assinatura digital” dos modelos de base.
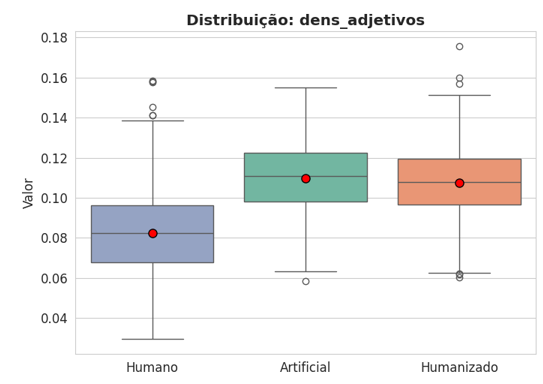
A análise da densidade de adjetivos, apresentada na Figura 1, revelou uma das distinções mais acentuadas entre as classes de autoria. Observou-se, por meio do diagrama de caixa (boxplot), que as redações de autoria humana apresentam uma mediana de adjetivação significativamente inferior, com 0,08 em comparação aos textos gerados por inteligência artificial e humanizados, com aproximadamente 0,11.
Figura 1. Análise de adjetivos – boxplot.
Fonte: Resultados originais da pesquisa
Este resultado sugere que a densidade de adjetivos constitui um forte marcador estilométrico para a detecção de autoria sintética, uma vez que modelos generativos tendem a utilizar adjetivos em excesso para emular assertividade e formalidade, distanciando-se da sobriedade característica da escrita estudantil natural.
A análise da diversidade lexical, operacionalizada pelo Type-Token Ratio (TTR) (Figura 2), revelou um divisor estatístico robusto entre as categorias. Enquanto o grupo humano apresentou uma mediana de 0,59, com uma amplitude interquartil que se estende até 0,62, as produções artificiais (IA e Humanizada) demonstraram um teto de diversidade significativamente inferior, com medianas situadas ambas em 0,52. Esta redução de aproximadamente 13% na riqueza vocabular das IAs sugere uma dependência de um núcleo lexical restrito, característica que as ferramentas de humanização não conseguiram mitigar, mantendo as produções sintéticas estatisticamente segregadas da variabilidade natural dos estudantes.
Figura 2. Análise de TTR – boxplot
Fonte: Resultados originais da pesquisa
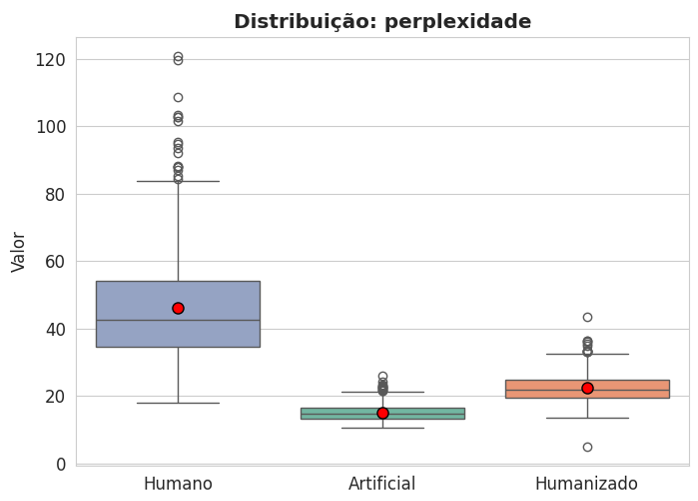
Em relação à perplexidade, esta métrica, oriunda da Teoria da Informação, mensura o grau de “surpresa” de um modelo de linguagem ao processar uma sequência. Verificou-se (Figura 3) que o grupo humano detém o maior nível de entropia, com uma mediana de 42,48, o que evidencia a natureza não linear e menos previsível da escrita estudantil. Em contraste, as produções da IA registraram apenas 14,78, refletindo a tendência dos modelos generativos de selecionar tokens de alta probabilidade estatística, resultando em textos mecanicamente “esperados”. A versão humanizada apresentou uma mediana de 22,03, indicando que a paráfrase introduz variações lexicais que elevam a perplexidade, mas ainda falha em atingir os níveis de complexidade informacional da autoria humana.
Figura 3. Análise de perplexidade – boxplot
Fonte: Resultados originais da pesquisa
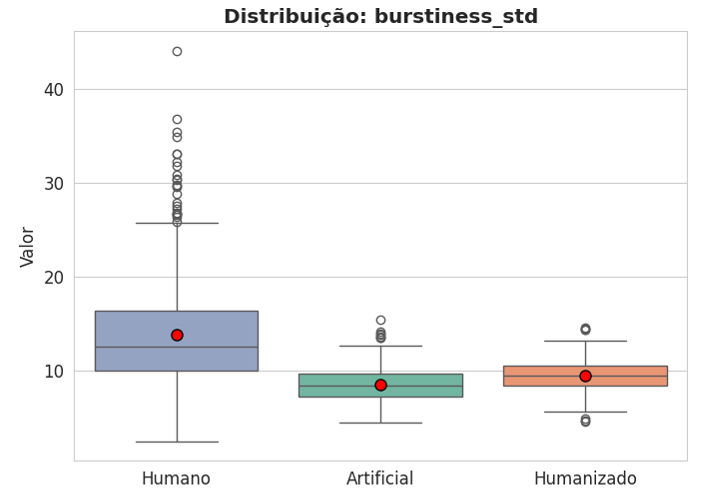
No que diz respeito ao Burstiness (Figura 4), o ritmo da escrita, operacionalizado pelo desvio padrão do tamanho das sentenças, revelou a monotonia sintática da máquina. A mediana do grupo humano 12,58 destaca-se pela ampla variabilidade, indicando que os estudantes alternam dinamicamente entre frases curtas e orações subordinadas longas. Nas produções artificiais e humanizadas, as medianas foram de 8,50 e 9,53, respectivamente. Essa compressão nos valores de Burstiness indica que a IA tende a gerar parágrafos com estruturas de comprimento quase uniforme para garantir a coesão, resultando em um ritmo de leitura padronizado que a ferramenta de paráfrase não consegue tornar orgânico.
Figura 4. Análise de Burstiness- BoxPlot
Fonte: Resultados originais da pesquisa
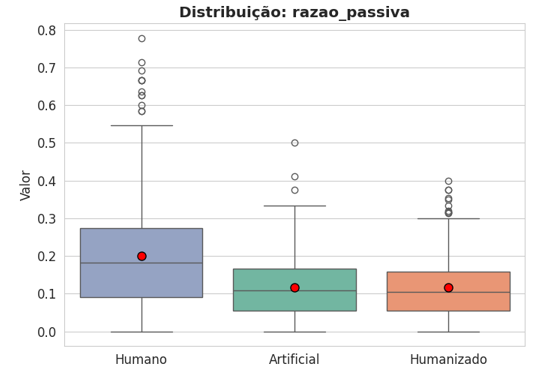
A incidência de voz passiva analítica atuou como um inesperado indicador de autoria humana no contexto do ENEM. A mediana observada (Figura 5) no grupo humano foi de 0,18, valor substancialmente superior aos 0,11 do grupo artificial e 0,10 do humanizado. Este achado sugere que, na busca por atender às competências do exame que exigem impessoalidade, o aluno humano faz um uso intensivo e, por vezes, exagerado da voz passiva. As IAs, por serem otimizadas para clareza e legibilidade (voz ativa), falham em emular esse comportamento estilístico específico do gênero textual investigado, criando uma lacuna estatística utilizável para detecção.
Figura 5. Análise de voz passiva – boxplot
Fonte: Resultados originais da pesquisa
Em relação ao Índice de Flesch, esta métrica avalia a complexidade de um texto com base na extensão das palavras e sentenças, onde scores mais baixos indicam textos mais densos e complexos. Observou-se (Figura 6) que as redações humanas apresentam uma mediana de 39,84, situando-se em uma zona de leitura “difícil”, mas ainda superior aos níveis registrados pelas produções artificiais. O grupo Artificial apresentou uma mediana de 30,12, e o grupo Humanizado 31,28, o que os coloca na categoria de leitura “muito difícil”. Esta diferença de quase 10 pontos sugere que a inteligência artificial gera textos significativamente mais densos e com palavras mais longas (polissílabos) do que o estudante médio. Além disso, a variabilidade do grupo humano é notável: o desvio padrão de 10,08 para humanos, contra apenas 6,03 para a IA, demonstra que enquanto os estudantes exibem diferentes níveis de proficiência e estilos de escrita, a IA mantém uma “densidade padronizada” e excessivamente complexa, que a humanização falha em suavizar de forma eficaz.
Figura 6. Análise de índice de flesch – boxplot
Fonte: Resultados originais da pesquisa
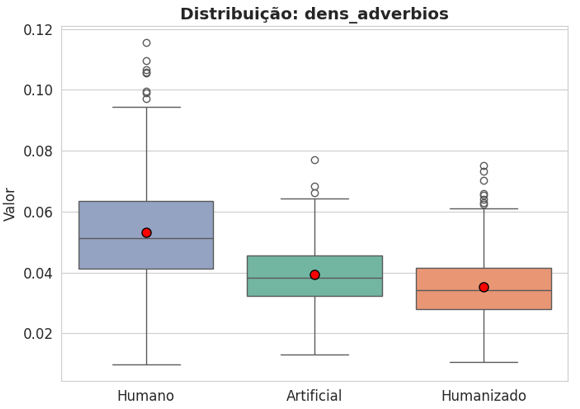
A análise da densidade de advérbios (Figura 7) revelou um comportamento inverso ao observado na adjetivação (Figura 1), consolidando-se como um marcador de autoria humana. Os estudantes apresentaram uma mediana de 0,051, valor significativamente superior aos 0,038 registrados pelo grupo artificial. Este achado sugere que a escrita humana é mais rica em adjuntos adverbiais que conferem nuances de modo, tempo e intensidade à argumentação. Notadamente, o processo de humanização resultou em um declínio adicional desta métrica para 0,034, indicando que a paráfrase automatizada tende a neutralizar o texto, eliminando marcadores circunstanciais que são essenciais para a fluidez e a subjetividade do discurso humano.
Figura 7. Análise de advérbios – boxplot
Fonte: Resultados originais da pesquisa
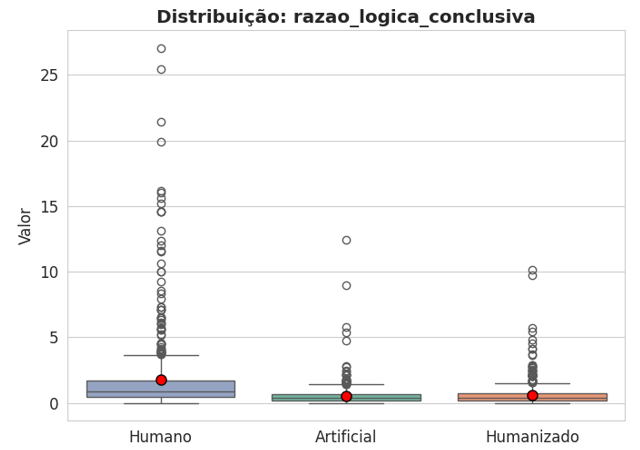
No que diz respeito à análise da razão de lógica conclusiva (Figura 8), esta métrica, que calcula a proporção entre conectivos conclusivos e adversativos, revelou uma discrepância entre os grupos. Enquanto os estudantes humanos apresentaram uma mediana de 0,87, os textos de IA e humanizados registraram valores de 0,40 e 0,41, respectivamente. Este dado indica que a redação humana utiliza quase o dobro de estruturas de fechamento lógico em relação às oposições dialéticas, sugerindo uma progressão argumentativa mais direcionada à conclusão, enquanto a IA mantém um equilíbrio artificial que resulta em uma argumentação mais neutra e menos assertiva.
Figura 8. Análise de razão lógica conclusiva – boxplot
Fonte: Resultados originais da pesquisa
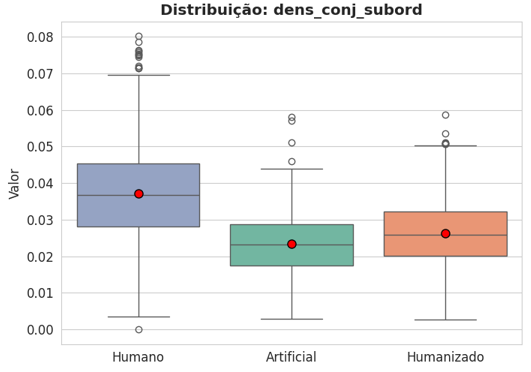
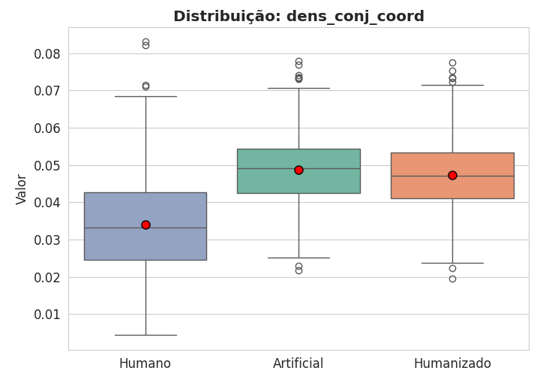
A análise das conjunções (Figura 9 e Figura 10) revelou uma diferença estrutural profunda na arquitetura das frases. O grupo humano utilizou significativamente mais conjunções subordinadas (mediana de 0,036) do que a IA (0,023) e o grupo humanizado (0,025). Em contrapartida, a IA demonstrou uma preferência por conjunções coordenadas (mediana de 0,049 vs. 0,033 do humano). Esta inversão prova que a escrita humana é inerentemente mais complexa e aninhada, enquanto os modelos de linguagem geram estruturas mais lineares e independentes, facilitando a leitura, mas perdendo a densidade sintática típica do ensino médio.
Figura 9. Análise de conjunções subordinativas – boxplot
Fonte: Resultados originais da pesquisa
Figura 10. Análise de conjunções coordenativas – boxplot
Fonte: Resultados originais da pesquisa
As demais métricas linguísticas extraídas não apresentaram variações estatísticas robustas ou poder discriminativo satisfatório para a distinção entre as classes estudadas, justificando sua exclusão do vetor de atributos final. Dessa forma, a análise exploratória consolidou um vetor definitivo composto por 10 características estilométricas de alto poder de separabilidade, que formaram a base de dados exclusiva para a modelagem preditiva. Este conjunto final engloba as seguintes métricas: Perplexidade, Burstiness, Diversidade Lexical (TTR), Índice de Leiturabilidade de Flesch, Razão de Voz Passiva e Razão Lógica Conclusiva, além das densidades sintáticas de Adjetivos, Advérbios, Pronomes e Conjunções Subordinativas.
Desempenho na validação interna e estabelecimento de baseline
Uma vez definido o vetor final composto por dez características estilométricas selecionadas, procedeu-se à etapa de modelagem preditiva, com o treinamento de três algoritmos supervisionados: Regressão Logística, Random Forest e XGBoost. A validação interna foi conduzida sobre uma amostra de teste composta por 300 redações, particionada por meio de holdout estratificado. Os resultados indicaram elevado desempenho preditivo. Conforme observado na Tabela 1, a Regressão Logística, adotada como baseline linear, atingiu acurácia global de 100% (1,00), com precisão, revocação e F1-Score próximos de 1,00 para ambas as classes. Os modelos baseados em árvores, Random Forest e XGBoost, também apresentaram desempenho elevado, com acurácia global de aproximadamente 99% e métricas equilibradas entre as classes Humano e Artificial/Humanizado.
Tabela 1. Desempenho preditivo dos modelos na Validação Interna
| Modelo | Classe | Precisão | Revocação (Recall) | F1-Score | Acurácia Global |
|---|---|---|---|---|---|
| Regressão Logística | Humano (0) | 1 | 0,99 | 0,99 | 1 |
| Sintético/Ofuscado (1) | 1 | 1 | 1 | ||
| Random Forest | Humano (0) | 0,98 | 0,99 | 0,99 | 0,99 |
| Sintético/Ofuscado (1) | 0,99 | 0,99 | 0,99 | ||
| XGBoost | Humano (0) | 0,98 | 0,98 | 0,98 | 0,99 |
| Sintético/Ofuscado (1) | 0,99 | 0,99 | 0,99 |
Fonte: Resultados originais da pesquisa.
Esses resultados sugerem que o conjunto de atributos estilométricos selecionado possui capacidade relevante de discriminação entre as classes no contexto da amostra analisada. O desempenho da Regressão Logística, em particular, indica que parte dessa separação pode ser capturada por fronteiras de decisão lineares no espaço de atributos. No entanto, é importante considerar que a seleção das features foi realizada previamente à divisão entre treino e teste, o que pode introduzir viés na estimativa de desempenho interno.
Desempenho na Validação Externa e a Falha Estrutural da Humanização
A validação externa foi conduzida com o objetivo de avaliar a capacidade de generalização dos modelos em dados não utilizados em nenhuma etapa anterior do processo. Para isso, foi construído um conjunto composto por 300 redações inéditas, sendo 100 humanas, 100 geradas por IA e 100 humanizadas por meio do QuillBot. Os resultados obtidos mantiveram-se elevados, ainda que ligeiramente inferiores aos observados na validação interna. De acordo com a Tabela 2, os modelos Random Forest e XGBoost atingiram acurácia global de aproximadamente 99,33%, enquanto a Regressão Logística apresentou acurácia de 99,67%. As métricas de precisão, revocação e F1-Score permaneceram equilibradas entre as classes, indicando consistência no desempenho dos classificadores.
Tabela 2. Desempenho preditivo dos modelos na Validação Externa
| Modelo | Classe | Precisão | Revocação (Recall) | F1-Score | Acurácia Global |
|---|---|---|---|---|---|
| Regressão Logística | Humano (0) | 1 | 0,99 | 0,99 | 0,9967 |
| Regressão Logística | Sintético/Ofuscado (1) | 1 | 1 | 1 | 0,9967 |
| Random Forest | Humano (0) | 0,99 | 0,99 | 0,99 | 0,9933 |
| Random Forest | Sintético/Ofuscado (1) | 0,99 | 0,99 | 0,99 | 0,9933 |
| XGBoost | Humano (0) | 0,99 | 0,99 | 0,99 | 0,9933 |
| XGBoost | Sintético/Ofuscado (1) | 0,99 | 0,99 | 0,99 | 0,9933 |
Fonte: Resultados originais da pesquisa.
Destaca-se que a Regressão Logística apresentou revocação igual a 1,00 para a classe Artificial/Humanizado, o que indica que, no conjunto avaliado, todos os textos sintéticos, incluindo aqueles submetidos ao processo de humanização, foram corretamente identificados. Embora esse resultado seja expressivo, sua interpretação deve ser contextualizada: trata-se de um desempenho observado em um conjunto específico de dados, limitado a um único modelo gerador (GPT-40 mini) e a uma única ferramenta de paráfrase (QuillBot, modo Standard). A proximidade entre os resultados das validações interna e externa sugere que os modelos não sofreram degradação significativa de desempenho ao serem aplicados em dados inéditos. Esse comportamento indica que, ao menos no contexto experimental adotado, os classificadores foram capazes de capturar padrões relativamente estáveis entre as classes.
Generalização e Mitigação do Viés de Seleção de Atributos
A consistência observada entre os resultados das validações interna e externa sugere que o conjunto de atributos estilométricos selecionado captura aspectos relevantes da diferenciação entre textos humanos e sintéticos no contexto analisado. Métricas como perplexidade, diversidade lexical, burstiness e indicadores morfossintáticos mostraram-se úteis para representar padrões estruturais e estilísticos associados às diferentes formas de produção textual. Entretanto, é importante ressaltar que a seleção dessas features foi baseada na análise do conjunto completo de dados original, o que pode introduzir viés de seleção de atributos. A utilização de um conjunto externo para validação contribui para mitigar parcialmente esse efeito, mas não o elimina completamente. Dessa forma, os resultados devem ser interpretados como evidência inicial da utilidade dessas métricas, e não como prova definitiva de sua generalização para outros contextos. Além disso, o corpus utilizado é composto exclusivamente por redações do gênero dissertativo-argumentativo no estilo ENEM, o que implica que os padrões identificados podem estar associados, em parte, às características específicas desse gênero textual.
Benchmarking com Ferramenta Comercial e a Especialização de Domínio
A comparação com a ferramenta GPTZero foi realizada sobre o mesmo conjunto de 300 redações utilizado na validação externa, permitindo uma análise comparativa direta entre os modelos. De modo geral, os classificadores desenvolvidos neste estudo apresentaram desempenho superior ao da ferramenta comercial, conforme apontado na Tabela 3. Em termos de padrão de erro, observa-se que os modelos propostos cometeram predominantemente falsos positivos e, em menor grau, falsos negativos, mantendo desempenho equilibrado entre as classes. Em contrapartida, o GPTZero apresentou um comportamento distinto: não registrou falsos positivos, mas concentrou seus erros em falsos negativos.
Tabela 3. Desempenho preditivo e análise de erros no benchmarking comparativo
| Modelo | Acurácia Global | Precisão | Revocação (Recall) | F1-Score | Falso Positivo (Errou Humano) | Falso Negativo (Errou IA/Humanizado) |
|---|---|---|---|---|---|---|
| Regressão Logística | 0.9967 | 0.995 | 1 | 0.9975 | 1 | 0 |
| Random Forest | 0.9933 | 0.995 | 0.995 | 0.995 | 1 | 1 |
| XGBoost | 0.9933 | 0.995 | 0.995 | 0.995 | 1 | 1 |
| GPTZero | 0.9833 | 1 | 0.975 | 0.9873 | 0 | 5 |
Fonte: Resultados originais da pesquisa.
A análise desses casos revela um aspecto particularmente relevante: os erros do GPTZero estão majoritariamente associados a textos que passaram por processo de humanização via QuillBot. Isso indica que a ferramenta apresenta maior dificuldade em identificar como sintéticos textos que sofreram alterações na superfície lexical e estrutural por meio de paráfrase automatizada. Em contraste, os modelos desenvolvidos neste estudo mostraram-se mais consistentes na detecção desse tipo de texto, mesmo após o processo de humanização. Esse resultado sugere que a utilização de features estilométricas pode contribuir para a captura de padrões mais globais da escrita, menos sensíveis a modificações superficiais. Ainda assim, essa comparação deve ser interpretada com cautela. O GPTZero é projetado para operar em múltiplos domínios textuais, enquanto o modelo proposto foi desenvolvido em um contexto específico – redações dissertativo-argumentativas no estilo ENEM. Além disso, a avaliação foi conduzida em uma única amostra, o que limita a generalização dos resultados.
Análise da Matriz de Confusão
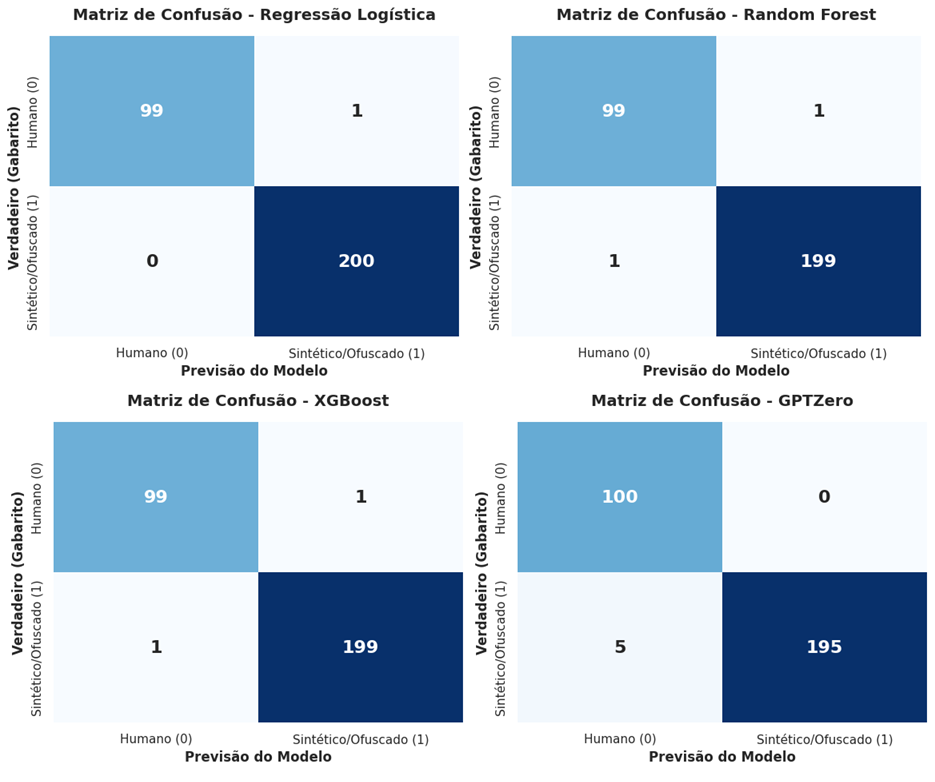
A análise das matrizes de confusão foi realizada com o objetivo de examinar não apenas o desempenho agregado dos modelos, mas também a natureza dos erros cometidos, distinguindo entre falsos positivos e falsos negativos. No contexto desta pesquisa, define-se como falso positivo o caso em que um texto humano é classificado como sintético, e como falso negativo o caso em que um texto sintético — incluindo textos humanizados — é classificado como humano. Essas duas categorias de erro possuem implicações distintas: enquanto falsos positivos podem levar à classificação indevida de produções humanas como artificiais, falsos negativos indicam falhas na detecção de textos gerados por inteligência artificial.
Na validação externa, observou-se baixa incidência de erros nos modelos desenvolvidos, conforme pode ser observado na Figura 11. A Regressão Logística apresentou um único falso positivo e nenhum falso negativo, enquanto os modelos Random Forest e XGBoost apresentaram um falso positivo e um falso negativo cada. Esses resultados indicam que, no conjunto analisado, os classificadores foram capazes de manter desempenho consistente tanto na identificação de textos humanos quanto sintéticos.
Figura 11. Matriz de confusão dos modelos
Fonte: Resultados originais da pesquisa.
Em contraste, a ferramenta GPTZero apresentou maior número de falsos negativos, totalizando cinco ocorrências. A análise desses casos revela um padrão consistente: todos os erros correspondem a textos sintéticos que foram previamente submetidos a processos de humanização por meio do QuillBot e que foram classificados como humanos pela ferramenta. No caso do GPTZero, a recorrência de falsos negativos em textos humanizados sugere que esse tipo de transformação pode impactar a capacidade de detecção da ferramenta, ao menos no conjunto analisado. Esse resultado não permite generalizações amplas, mas aponta para a relevância de considerar cenários de humanização na avaliação de sistemas de detecção de autoria. De modo geral, a análise das matrizes de confusão complementa as métricas agregadas ao evidenciar que, apesar do alto desempenho global, existem casos específicos em que a distinção entre textos humanos e sintéticos se torna menos nítida, especialmente quando intervenções de reescrita são aplicadas.
Parcimônia e interpretabilidade do modelo
Um dos achados deste estudo refere-se ao desempenho da Regressão Logística em comparação com modelos mais complexos. Mesmo sendo um classificador linear, com baixo custo computacional e alta interpretabilidade, seu desempenho foi comparável e, em alguns casos, ligeiramente superior ao de modelos baseados em árvores. Esse resultado sugere que, para o problema investigado, um conjunto reduzido de features estilométricas pode ser suficiente para capturar padrões relevantes de distinção entre textos humanos e sintéticos. Em contextos educacionais, essa característica é particularmente importante, uma vez que a transparência das decisões automatizadas pode ser um requisito relevante. Ainda assim, esse achado deve ser interpretado com cautela. O desempenho de modelos simples depende diretamente da qualidade das features e do domínio analisado, não sendo possível generalizar essa observação para outros contextos ou tipos de dados.
Os resultados obtidos indicam que a abordagem baseada em features estilométricas foi eficaz para discriminar textos humanos de textos sintéticos no contexto analisado. A utilização de métricas linguísticas estruturais mostrou-se suficiente para capturar diferenças relevantes entre os padrões de escrita, permitindo a construção de modelos com alto desempenho preditivo. Adicionalmente, verificou-se que textos submetidos a processos de humanização automática permanecem, em certa medida, distinguíveis dos textos genuinamente humanos quando analisados sob a perspectiva de características estilométricas. Esse resultado reforça a relevância da análise estrutural da linguagem como alternativa à dependência exclusiva de modelos complexos e pouco interpretáveis. A escolha por modelos supervisionados de menor complexidade também se mostrou adequada ao problema, evidenciando que abordagens mais simples, quando bem fundamentadas teoricamente, podem alcançar desempenho competitivo.
Nesse sentido, destaca-se a importância da interpretabilidade dos modelos no contexto educacional, especialmente em aplicações que envolvem tomada de decisão automatizada sobre produções textuais. Apesar dos resultados obtidos, algumas limitações devem ser consideradas, como o domínio específico de textos dissertativo-argumentativos do ENEM e a utilização de ferramentas específicas para geração e humanização, o que restringe a generalização dos achados. Investigações futuras poderiam explorar a aplicação dessas mesmas features em outros domínios para avaliar sua robustez, bem como a ampliação do corpus para incluir diferentes gêneros textuais, níveis de proficiência e ferramentas de geração e reescrita, além da investigação de abordagens híbridas que combinem atributos linguísticos interpretáveis com representações mais complexas. Este trabalho contribui ao demonstrar que a análise estilométrica constitui uma abordagem promissora para a detecção de autoria em textos, oferecendo uma alternativa interpretável e potencialmente aplicável em contextos educacionais reais.
4. Conclusão
O presente trabalho teve como objetivo desenvolver um modelo de classificação capaz de identificar textos gerados por inteligência artificial, mesmo após a aplicação de ferramentas de humanização, com foco em redações dissertativo-argumentativas no padrão do Exame Nacional do Ensino Médio (ENEM). Verificou-se que a abordagem baseada em atributos estilométricos foi eficaz para discriminar textos humanos de textos sintéticos. Métricas linguísticas estruturais, como densidade de adjetivos, diversidade lexical (TTR), perplexidade e Burstiness, revelaram padrões distintivos entre a escrita humana e a artificial, mesmo após a reescrita por ferramentas de humanização. Os modelos de aprendizado de máquina treinados, incluindo Regressão Logística, Random Forest e XGBoost, demonstraram alto desempenho preditivo na detecção desses textos, superando uma ferramenta comercial em cenários de humanização. A principal contribuição reside na demonstração de que a análise estilométrica oferece uma alternativa robusta e interpretável para a detecção de autoria textual, essencial para o contexto educacional.
Apesar dos resultados promissores, o estudo apresentou algumas limitações. A pesquisa foi conduzida em um domínio específico de redações dissertativo-argumentativas do ENEM, o que restringe a generalização dos achados para outros gêneros textuais. Além disso, a geração de textos sintéticos e humanizados utilizou ferramentas específicas (GPT-40 mini e QuillBot), não abrangendo a diversidade de modelos e estratégias de humanização existentes. Sugere-se, para estudos futuros, a ampliação do corpus para incluir diferentes gêneros textuais e níveis de proficiência, bem como a investigação de outras ferramentas de geração e reescrita. Recomenda-se também explorar abordagens híbridas que combinem atributos linguísticos interpretáveis com representações mais complexas, a fim de aprimorar a robustez e a aplicabilidade dos modelos em cenários mais amplos.
Referências Bibliográficas
BROWN, T. et al. Language Models Are Few-Shot Learners. Advances in Neural Information Processing Systems, v. 33, p. 1877-1901, 2020. Disponível em: https://arxiv.org/abs/2005.14165. Acesso em: 21 set. 2025.
MASROUR, E.; EMI, B. N.; SPERO, M. DAMAGE: Detecting Adversarially Modified Al Generated Text. In: Proceedings of the 1st Workshop on GenAl Content Detection (GenAIDetect), Abu Dhabi, 2025. Disponível em: https://arxiv.org/abs/2501.03437. Acesso em: 21 set. 2025.
NILSSON, N. J. Artificial Intelligence: A New Synthesis. San Francisco: Morgan Kaufmann, 1998.
WEBER-WULFF, D. et al. Testing of Detection Tools for Al-Generated Text. International Journal for Educational Integrity, v. 19, art. 26, 2023. Disponível em: https://edintegrity.biomedcentral.com/articles/10.1007/s40979-023-00146-z. Acesso em: 22 set. 2025.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

