
15 de setembro de 2026
Implementação e Aplicação de um Módulo de Aprendizado Não-supervisionado em um Arcabouço de Automl
Maria Laura Gabriel Kuniyoshi; Wallace Gusmão Ferreira
DOI: 10.22167/2675-6528-202602271
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A maioria das ferramentas de automação de aprendizado de máquina foca em aprendizado supervisionado, negligenciando recursos para dados não rotulados, como o AutoBioLearn (ABL), voltado para pesquisadores das Ciências Biológicas e da Saúde. O objetivo deste trabalho foi implementar e testar um módulo de Aprendizado Não-Supervisionado (ANS) no ABL. Primeiramente, identificaram-se as metodologias de ANS mais mencionadas em teses e dissertações brasileiras de ciências médicas e biológicas nos últimos oito anos. Em seguida, implementaram-se classes para Análise de Componentes Principais (PCA), agrupamento hierárquico e não-hierárquico no ABL, utilizando Python. O novo módulo passou por testes de validação, reprodutibilidade e escalabilidade. Para demonstrar sua aplicação, realizaram-se dois estudos de caso: um com dados de saúde mental de gestantes durante a pandemia de COVID-19 e outro com o perfil sensorial de crianças autistas. O módulo validado sugeriu, nos dados de gestantes, uma possível relação entre a duração de “lockdowns” e tipos de ansiedade. No conjunto de dados de perfil sensorial, o módulo de ANS identificou possíveis subgrupos de comportamentos alimentares. Espera-se que esta ferramenta simplifique a escrita de código por pesquisadores das Ciências da Saúde e Biológicas.
Palavras-chave: Aprendizado de Máquina Não-supervisionado; AutoML; Design de Software; Informática Médica; Validação de Software.
1. Introdução
O aprendizado de máquina, ou Machine Learning (ML), tem experimentado um crescimento notável em diversas áreas nos últimos anos, com aplicações significativas na saúde. Exemplos incluem a identificação de doenças por meio de exames de imagens (Maheswari et al., 2024), a seleção de variáveis associadas a condições médicas (Gabriel-Kuniyoshi et al., 2025) e a caracterização de subgrupos de pacientes (Moon et al., 2025). Essa expansão reflete a capacidade do ML de processar grandes volumes de dados e extrair padrões complexos.
Apesar do potencial do ML, muitos pesquisadores da área da saúde, como médicos e biólogos, frequentemente carecem de formação formal em programação ou ciência de dados. Essa lacuna de conhecimento dificulta a implementação de análises complexas, conforme evidenciado por estudos com estudantes de Ciências da Saúde, onde uma parcela significativa dos participantes indicou a necessidade de aprender Inteligência Artificial (IA) para suas carreiras, mas muitos não sabiam definir conceitos básicos da área (Almalki et al., 2025; Teng et al., 2022). Diante desse cenário, surge uma demanda crescente por soluções que tornem o ML mais acessível, automatizado e interpretável.
Em resposta a essa necessidade, surgiram arcabouços, ou frameworks, que automatizam diversas etapas de uma análise de ML, desde o pré-processamento até a visualização de resultados. Conhecidas como Auto-Machine Learning (AutoML), essas ferramentas são valiosas para pesquisadores com diferentes níveis de conhecimento em Ciência de Dados. As vantagens do AutoML incluem o aumento da produtividade, a facilitação do aprendizado de ML, a padronização de protocolos e a automatização do ajuste de hiperparâmetros (Quaranta et al., 2025). Ferramentas como H2OAutoML (Stetsenko, 2025), MLBox (Das e Cakmak, 2018), Auto-Sklearn (Feurer et al., 2022) e TPOT (Le et al., 2020) ilustram essa categoria (Aragão et al., 2025). Contudo, muitas dessas ferramentas apresentam desvantagens, como custos elevados para softwares pagos ou a ausência de recursos específicos, como as funcionalidades de aprendizado não-supervisionado.
Nesse contexto, destaca-se o AutoBioLearn (ABL), um arcabouço brasileiro de código aberto, desenvolvido para simplificar a análise de dados por cientistas das Ciências Biológicas e da Saúde (Moreira et al., 2024). O ABL recebe dados estruturados, realiza pré-processamento básico, treina e compara modelos de ML supervisionado, e oferece resultados explicados por técnicas de inteligência artificial explicável. Embora o ABL se baseie na biblioteca Scikit-Learn (Pedregosa et al., 2011) e integre pacotes como SHAP (Lundberg e Lee, 2017) e XGBoost (Chen e Guestrin, 2016), sua primeira versão ainda carece de documentação extensa, otimização de desempenho, usabilidade aprimorada e a implementação de recursos adicionais que o distingam de outras ferramentas disponíveis.
Uma funcionalidade crucial a ser implementada no ABL é um módulo de Aprendizado Não-Supervisionado (ANS). Atualmente, a maioria dos arcabouços de AutoML foca em ML supervisionado, negligenciando as funcionalidades de ANS. Embora o H2OAutoML (Stetsenko, 2025) inclua análise de componentes principais (PCA) e agrupamento não-hierárquico, ferramentas populares como MLBox, Auto-Sklearn e TPOT não oferecem uma ampla gama de funções nativas para essas técnicas. Essa lacuna é particularmente relevante para pesquisadores da saúde, que utilizam ANS em diversas aplicações, como a redução de dimensionalidade para sequenciamento de RNA single-cell, agrupamento hierárquico em análises de expressão gênica e clustering para identificação de subgrupos de pacientes.
O Aprendizado Não-Supervisionado (ANS) refere-se a algoritmos que identificam padrões em conjuntos de dados sem rótulos predefinidos, agrupando observações com base em suas características intrínsecas, em contraste com o ML supervisionado, que utiliza dados rotulados para treinamento (Hastie et al., 2009). As abordagens de ANS incluem agrupamento hierárquico, que organiza dados em uma estrutura de árvore, e agrupamento não-hierárquico, que aloca observações a um número predeterminado de grupos. Métodos de redução de dimensionalidade, como PCA e Uniform Manifold Approximation and Projection (UMAP), também são classificados como ANS (Eckhardt et al., 2023; Tyagi et al., 2022). A aplicação dessas metodologias pode envolver etapas complexas, como testar a normalidade dos dados ou definir métricas de distância, que podem ser desafiadoras para pesquisadores sem experiência na área.
Dada a importância de tornar o ML mais acessível e a lacuna de funcionalidades de ANS nos arcabouços existentes, a implementação de tal módulo no ABL é justificada por sua utilidade para o público-alvo, simplificando etapas que podem ser complexas ou negligenciadas. Assim, o objetivo geral deste trabalho é implementar, validar e testar um módulo de Aprendizado Não-Supervisionado no ABL, descrevendo a implementação de funcionalidades de agrupamento não-hierárquico, agrupamento hierárquico e redução de dimensionalidade, incluindo a visualização de resultados, e demonstrando o funcionamento do software por meio de uma análise exploratória de dois bancos de dados públicos: um de saúde mental em gestantes com COVID-19 e outro sobre o perfil sensorial em crianças autistas.
2. Material e Métodos
O AutoBioLearn (ABL) é uma ferramenta de AutoML desenvolvida para automatizar tarefas de pré-processamento de dados, seleção e avaliação de modelos, e visualização de resultados, com foco em cientistas das áreas de Saúde e Ciências Biológicas. A versão atual do ABL suporta aprendizado de máquina supervisionado (classificação e regressão), com interpretabilidade e validação cruzada. Este trabalho descreve o desenvolvimento, implementação e testes de um novo módulo de Aprendizado Não-Supervisionado (ANS) no ABL, baseado em dados de trabalhos acadêmicos brasileiros das áreas biológicas e de saúde.
Análise de textos acadêmicos das Ciências Biológicas e de Saúde
Para identificar as técnicas de ANS mais utilizadas e o tamanho amostral médio em pesquisas das Ciências Biológicas e da Saúde, realizou-se uma análise de textos acadêmicos brasileiros. Foram utilizados dados abertos da Coordenação de Aperfeiçoamento de Pessoal de Nível Superior (CAPES) referentes a 700.467 teses e dissertações de pós-graduação stricto sensu dos quadriênios 2017-2020 e 2021-2024. Os trabalhos foram filtrados para as grandes áreas de Ciências Biológicas (código 20000006) e Ciências da Saúde (código 40000001).
Após padronização do texto (remoção de acentos e pontuação), buscou-se por palavras-chave relacionadas a metodologias comuns de ANS, como redução de dimensionalidade, UMAP, t-SNE, PCA, NMF, GDA, agrupamento (cluster, kmeans, kmedoids, GaussianMixture, SpectralClustering, Birch, DBSCAN, Affinity propagation, Hierarchical), por meio de expressões regulares. Para estimar as dimensões dos dados, buscou-se por dígitos que seguiam as expressões “n=”, “n = ” e “sample size of”. As buscas foram realizadas nos campos de palavras-chave e resumos, tanto em português quanto em inglês. Esta análise foi conduzida em Python 3.10.
Implementação
O ABL é um pacote de código aberto desenvolvido em Python. O módulo de ANS foi desenvolvido e testado em Python 3.9.19, utilizando as bibliotecas Scikit-Learn (Pedregosa et al., 2011), Scipy (Virtanen et al., 2020), FactorAnalyzer (Biggs e Madnani, 2022), Pandas (The Pandas Development Team, 2020) e Numpy (Harris et al., 2020). A geração de gráficos foi realizada com Seaborn (Waskom, 2021) e Matplotlib (Hunter, 2007).
Arquitetura e fluxo de execução
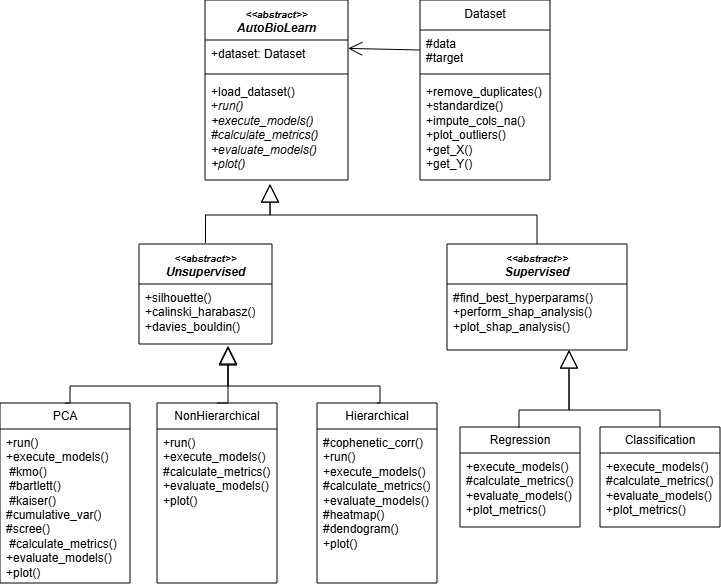
O ABL foi implementado seguindo o paradigma de programação orientada a objetos (Moreira et al., 2024). A superclasse AutoBioLearn define métodos comuns para carregamento e tratamento de dados, conforme ilustrado na Figura 1. Ela estabelece métodos abstratos como execute_models() para múltiplas análises com diferentes algoritmos e hiperparâmetros, calculate_metrics() para métricas de desempenho, evaluate_models() para comparação de métricas e sugestão de algoritmos/parâmetros, run() para uma única análise, e plot() para visualização de resultados.
Figura 1. Diagrama UML simplificado do software ABL. A superclasse AutoBioLearn instancia uma classe de tratamento de dados, cuja lista de métodos está resumida nesta figura para melhor interpretação. As setas com ponta triangular branca indicam herança, a com ponta aberta indica associação. + indica métodos públicos e # indica métodos privados
Fonte: Dados originais da pesquisa
Estes métodos são herdados pelas subclasses Supervised (para aprendizado supervisionado) e Unsupervised (para ANS). A subclasse Supervised e suas classes-filhas (classificação e regressão) foram previamente descritas (Moreira et al., 2024). A classe Unsupervised implementa três classes filhas: PCA, NonHierarchical e Hierarchical. A inclusão de PCA como metodologia de ANS foi baseada em seu amplo uso na análise de dados biológicos e na classificação por autores como Eckhardt et al. (2023) e Tyagi et al. (2022).
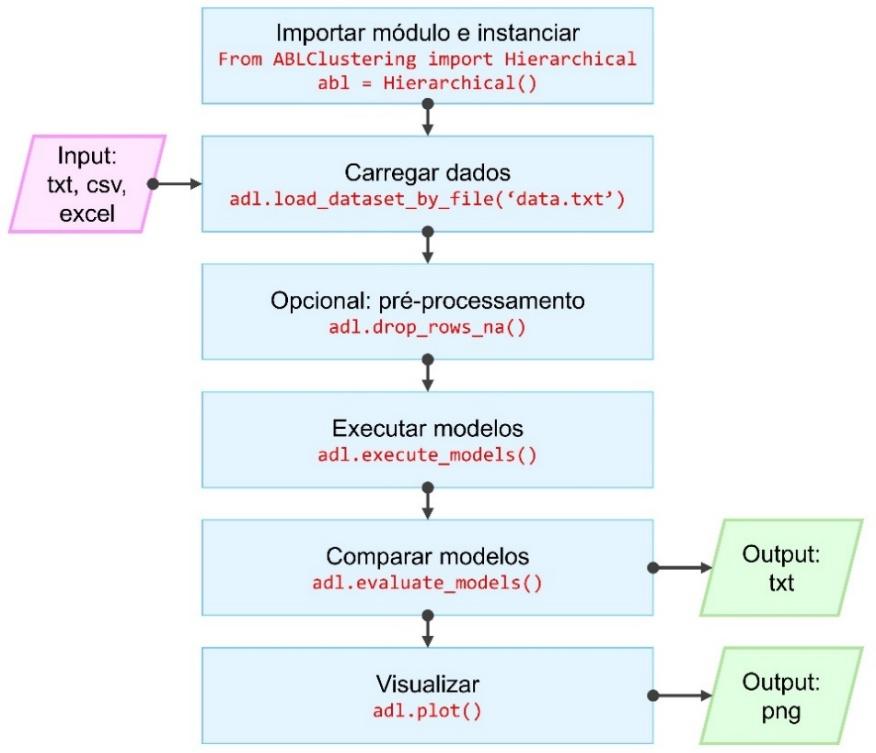
O fluxo de uso do ABL inicia-se pela importação de um dos módulos (NonHierarchical, Hierarchical, PCA, Regression ou Classification), seguido pelo carregamento do conjunto de dados (formatos xlsx, csv ou tsv). Em seguida, execute_models() realiza diversas análises com diferentes configurações (ex: métodos de linkage e métricas de distância para agrupamento hierárquico). A classe PCA é uma exceção, não possuindo execute_models() por ser uma técnica determinística. Posteriormente, evaluate_models() compara métricas de desempenho e seleciona a combinação ideal de algoritmo e parâmetros. Para PCA, este método avalia pré-suposições (testes de Bartlett e Kaiser-Meyer-Olkin [KMO]) e identifica o número ideal de componentes principais. Finalmente, plot() executa a análise com os parâmetros selecionados e visualiza os dados. O fluxo de execução é detalhado na Figura 2. Os principais métodos de cada classe e suas opções, como métodos de ligação, número de agrupamentos, métricas de distância e critérios de seleção de hiperparâmetros, são detalhados no TCC original.
Figura 2. Fluxo de execução das análises de aprendizado supervisionado e não-supervisionado com o ABL. Losangos indicam dados de entrada e saída. Retângulos indicam métodos e processos. O texto em vermelho exemplifica o código a ser escrito pelo usuário
Fonte: Dados originais da pesquisa
Testes de validação, estabilidade e escalabilidade
Os testes de validação verificaram a correta execução das análises de PCA e agrupamento pelos scripts do ABL. Para isso, foram utilizados os conjuntos de dados padrão “wine” (Aeberhard e Forina, 1992) e “iris” (Unwin e Kleinman, 2021), além de dados sintéticos gerados de distribuições Gaussianas isotrópicas com a função “make_blobs” do Scikit-Learn (Pedregosa et al., 2011), todos com rótulos conhecidos. A validação consistiu em executar os módulos NonHierarchical e Hierarchical com as variáveis numéricas dos conjuntos de dados (sem seus rótulos) e comparar os resultados do ABL com os rótulos originais.
O teste de estabilidade foi baseado no conjunto de dados COVID-ASSESS (Ravaldi e Vannacci, 2020), que contém dados de saúde mental de 1.567 pessoas grávidas ou lactantes durante a pandemia de COVID-19. Os dados foram divididos aleatoriamente em dez partes. Em cada iteração, os módulos NonHierarchical, PCA e Hierarchical foram executados nos 90% restantes dos dados, com 17 variáveis, para observar a consistência dos resultados.
Por fim, o teste de escalabilidade preliminar utilizou bancos de dados sintéticos gerados pela função “make_blobs” do Scikit-Learn (Pedregosa et al., 2011). Os módulos NonHierarchical, PCA e Hierarchical foram executados (desde a instanciação até evaluate_models()) com diferentes tamanhos amostrais: dez, 50, 100, 500, 1.000, 5.000 e 10.000 amostras aleatórias (e, para PCA, com 50.000 e 75.000).
Estudos de caso
Foram realizados dois estudos de caso com dados médicos para demonstrar o funcionamento do ABL. O primeiro utilizou o conjunto de dados COVID-ASSESS (Ravaldi e Vannacci, 2020), que inclui dados de saúde mental de gestantes e lactantes durante o lockdown da pandemia de COVID-19 em todas as províncias da Itália. As sete variáveis analisadas foram: idade, duração do lockdown, pontuação em questionário sobre preocupações com a pandemia, escala de eventos estressantes (LeBeau et al., 2014), nível de ansiedade traço, nível de ansiedade estado (Spielberger et al., 1983), e pontuação global em questionário de saúde mental (Derogatis et al., 1973).
O segundo estudo de caso envolveu 111 crianças autistas com dados de perfil sensorial (Panerai et al., 2020), da região da Sicília, Itália. As funções do ABL foram aplicadas para análises de ML supervisionado e ANS. As variáveis consideradas foram: seletividade alimentar, comportamento disruptivo durante refeições, recusa de comida, rigidez nos horários das refeições, sensibilidade tátil, sensibilidade olfato-gustativa e sensibilidade visual-auditiva. Essas pontuações foram obtidas dos questionários validados “Brief Autism Mealtime Behaviors Inventory” [BAMBI] (Lukens e Linscheid, 2008) e “Short Sensory Profile” [SSP] (Dunn, 1999).
Disponibilização
O ABL está atualmente disponível como script no repositório https://github.com/AutoBioLearn/AutoBioLearn, sob licença MIT. Planeja-se sua disponibilização futura como pacote no “Python Package Index” (PyPi) para instalação via pip.
Especificações de software e hardware
As análises de validação e os estudos de caso foram realizados em um laptop Dell com 16GB de RAM, processador 11th Gen IntelCore i7, sistema operacional Windows 11 e Python 3.9.16.
3. Resultados e Discussão
Avaliação de metodologias e tamanhos amostrais utilizados pela população-alvo
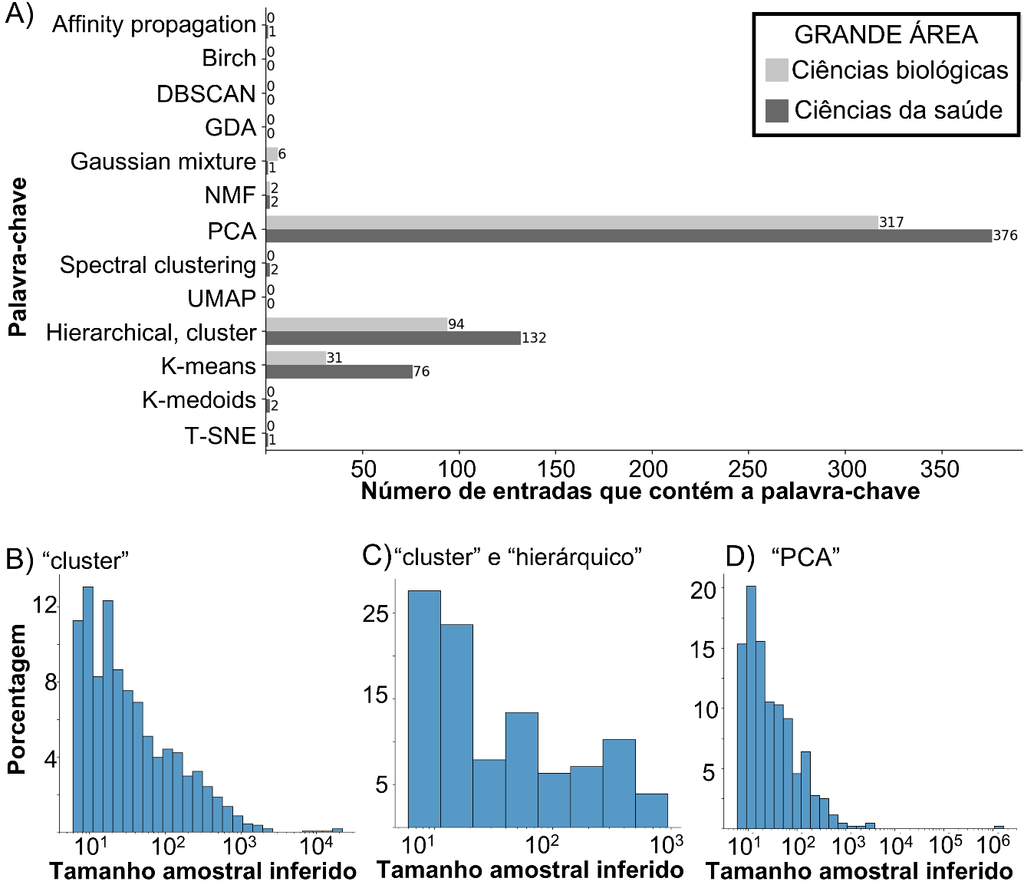
Para caracterizar o público-alvo do ABL, pesquisadores das Ciências Biológicas e da Saúde, foram analisados 156.011 trabalhos acadêmicos dessas áreas. Os padrões textuais mais frequentemente encontrados estavam relacionados à Análise de Componentes Principais (PCA), agrupamento hierárquico e k-means. Alguns estudos mencionavam mistura gaussiana, agrupamento espectral, NMF, t-SNE e k-medoides. Embora termos como “Birch” pudessem se referir a outros assuntos, a natureza exploratória e generalista desta análise considerou essa limitação tolerável.
Figura 3. Busca de termos relacionados a ANS na base de dados da CAPES. O subconjunto pesquisado foram as palavras-chave e resumos, em línguas inglesa e portuguesa, dos documentos das grandes áreas de Ciências Biológicas e Ciências da Saúde, de 2017 a 2024. A) Número de correspondências às expressões regulares relacionadas a palavras-chave do ANS. B-D) Tamanho amostral inferido, a partir de valores associados aos padrões “n=” e “sample size of”, em documentos com termos relacionados a “cluster”, “hierárquico” e “PCA”
Fonte: Resultados originais da pesquisa
Em relação ao tamanho amostral, a maioria das pesquisas analisadas parecia envolver amostras na escala de dezenas, centenas e milhares, conforme ilustrado na Figura 3B-D. Uma quantidade negligenciável de trabalhos indicou amostras com centenas de milhares ou milhões de observações. Esta análise, embora sujeita a dados faltantes devido às expressões de busca limitadas, forneceu um panorama parcial do público-alvo.
Teste de validação
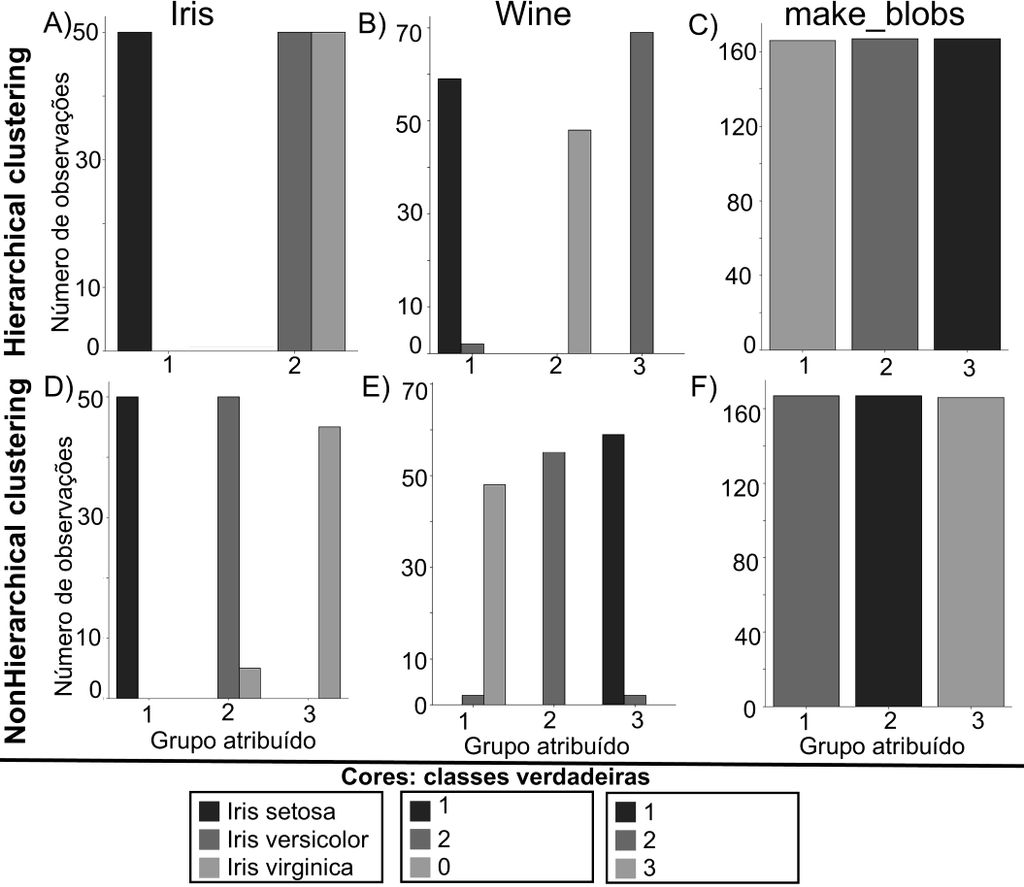
Verificou-se se o novo módulo do ABL produzia resultados adequados. Como não foram encontradas outras ferramentas de AutoML com análises de ANS semelhantes para comparação, o teste consistiu em avaliar a consistência dos agrupamentos atribuídos pelo ABL com as classes reais conhecidas. Esta hipótese foi amparada por testes em três conjuntos de dados distintos.
Figura 4. Validação da saída do ABL com conjuntos de dados sintéticos e padrão. Os testes foram feitos para as classes de agrupamento hierárquico (A-C) e não-hierárquico (D-F). Utilizou-se os conjuntos iris (A, D) e wine (B, E), assim como um conjunto de dados sintéticos (C, F). Comparou-se o agrupamento feito pelo ABL com as classes reais. A escala de cinza representa as classes reais, o eixo X representa o número de observações em um agrupamento, e o eixo Y representa o agrupamento retornado pelo ABL
Fonte: Resultados originais da pesquisa
Nos testes com os conjuntos de dados padrão “Iris” e “Wine”, os agrupamentos atribuídos pelo ABL majoritariamente corresponderam às classes reais, indicando o funcionamento esperado da ferramenta. No conjunto de dados sintético, o agrupamento realizado pelo ABL correspondeu totalmente às classes verdadeiras.
Teste de estabilidade
A importância da reprodutibilidade e replicabilidade no meio científico (National Academy of Sciences [NAS], 2019) motivou a verificação da consistência dos resultados do ABL na seleção de hiperparâmetros, número de clusters e algoritmos. Para isso, foram realizadas dez amostragens com 90% dos dados do estudo COVID-ASSESS (Ravaldi e Vannacci, 2020). Em todas as iterações, o ABL retornou as mesmas métricas e o número de componentes indicados.
No teste de PCA, todas as execuções sugeriram quatro componentes para a análise, com pouca variação na variância explicada pelos dois componentes principais, conforme detalhado na Tabela 1. As dez rodadas com a classe de agrupamento hierárquico indicaram ligação do tipo “average”, métrica de distância euclidiana e dois grupos. Para a classe não-hierárquica, todas as rodadas sugeriram agrupamento espectral com dois grupos. Esses resultados indicam que o ABL é capaz de retornar informações consistentes e reprodutíveis.
Tabela 1. Coeficiente de variância e valores máximo e mínimo em dez iterações de execução do módulo de redução de dimensionalidade. Cada iteração foi realizada com uma amostragem de 90% do conjunto de dados COVID-ASSESS.
| Palavra-chave | Expressões regulares buscadas |
|---|---|
| Redução de dimensionalidade | reducao\sd[ea]\sdimens dimensionality\sreduction dimension\sreduction |
| UMAP | \bumap\b uniform\smanifold\sapproximation\sand\sprojection aproximacao\se\sprojecao\suniformes\sde\svariedades |
| t-SNE | \bt\s?sne\b t\s+distributed\sstochastic\sneighbou?r\sembedding incorporacao\sestocastica\sde\svizinhos\scom\sdistribuicao |
| PCA | \bpca\b analise\sde\scomponentes\sprincipais principal\scomponent\sanalysis |
| NMF | \bnmf\b non\s?negative\smatrix\sfactorization fatoracao\smatricial\snao\s?negativa |
| GDA | \bgda\b generalized\sdiscriminant\sanalysis analise\sdiscriminante\sgeneralizada |
| Aprendizado não-supervisionado | aprendizado\snao\s?supervisionado unsupervised\smachine\slearning unsupervised\slearning |
| cluster | cluster\w* |
| kmeans | k\s?means |
| kmedoids | k\s?medoid\w* partitioning\saround\smedoids particionamento\sem\smedoides \bpam\b |
| GaussianMixture | gaussian\smixture mistura\sgaussiana |
| SpectralClustering | spectral\sclustering agrupamento\sespectral |
| Birch | \bbirch\b |
| DBSCAN | \bdbscan\b density\sbased\sspatial\sclustering\sof\sapplications\swith\snoise |
| Affinity propagation | affinity propagation propagacao de afinidade |
| Hierarchical | hierarquico hierarchical dendrogram |
Fonte: Resultados originais da pesquisa
Teste de escalabilidade preliminar
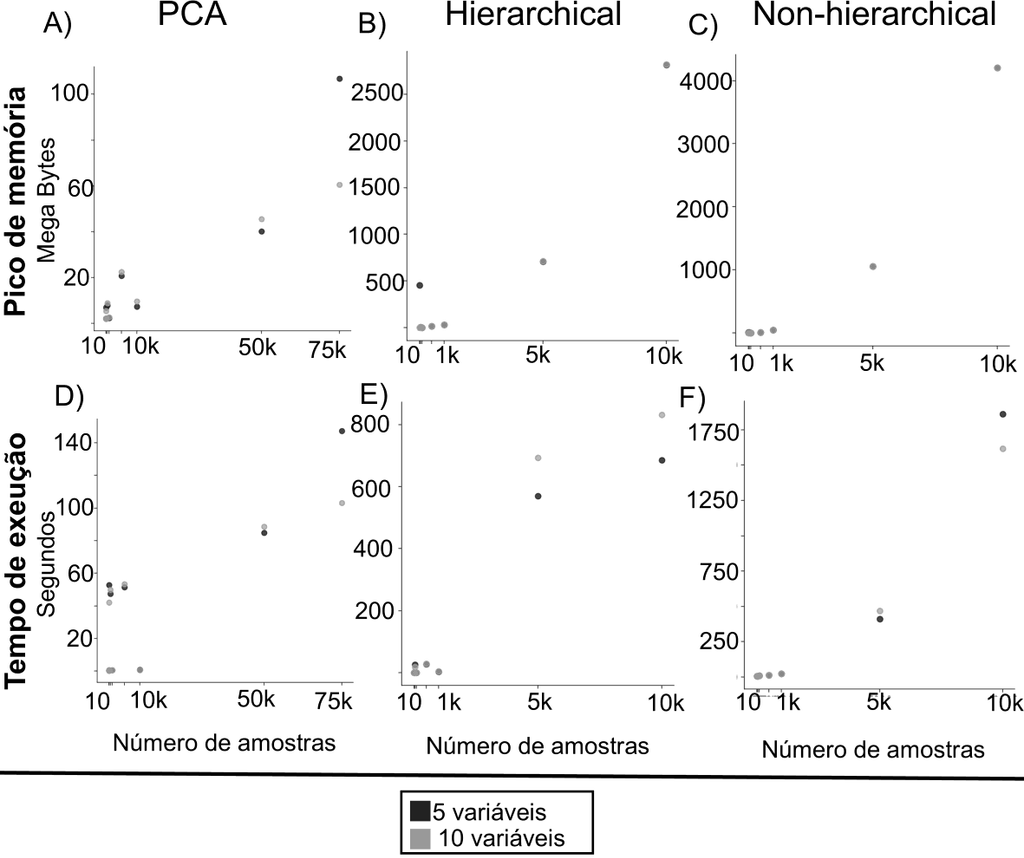
Para avaliar a adequação do ABL às dimensões dos conjuntos de dados preferidas pelo público-alvo, mensurou-se o tempo e a memória computacional gastos nas análises de conjuntos de dados de diferentes tamanhos. O máximo de memória e tempo utilizados foram 4,2 gigabytes e 30 minutos, respectivamente. Considerando um notebook convencional com 8 gigabytes de memória RAM, tal análise é viável. Esses resultados demonstram a viabilidade de análises com amostras de até 10.000 amostras, com dez variáveis, o que condiz com os tamanhos amostrais inferidos na análise do banco de teses e dissertações da CAPES (Figura 3), que parecem estudar conjuntos nas ordens de 10¹ a 10³.
Figura 5. Execução das três classes de ANS, desde sua instanciação até evaluate_models(), com diferentes tamanhos amostrais. A-C) Quantidade máxima de memória utilizada na execução das classes PCA (A), Hierarchical (B) e NonHierarchical (C). D-F) Tempo de execução médio para as classes PCA (D), Hierarchical (E) e NonHierarchical (F)
Fonte: Resultados originais da pesquisa
Estudos de caso: COVID-ASSESS
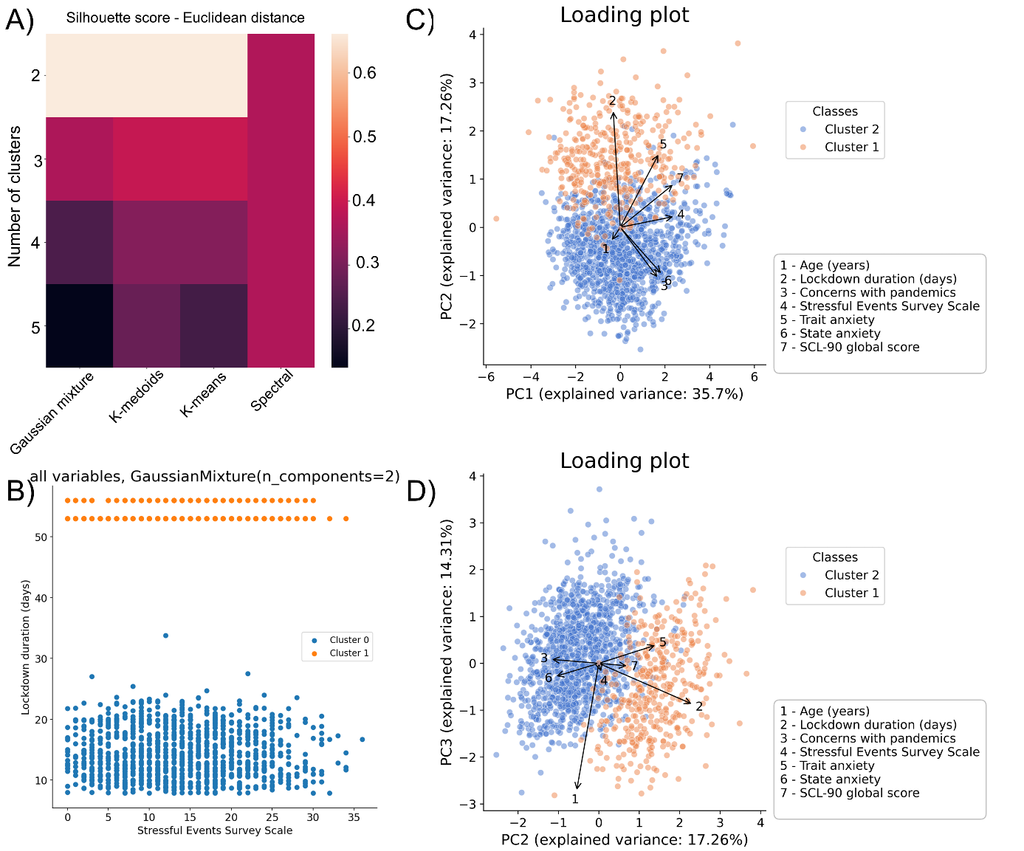
Para ilustrar o uso do ABL, realizou-se um estudo de caso com o conjunto de dados COVID-ASSESS, que contém informações sobre a saúde mental de gestantes e lactantes italianas durante o lockdown da pandemia de COVID-19 (Ravaldi e Vannacci, 2020). A análise inicial utilizou agrupamento não-hierárquico com as configurações padrão do ABL. O software sugeriu agrupamento por modelo de mistura gaussiana, resultando em dois grupos (Figura 6A) com 1.175 e 392 indivíduos, respectivamente. As métricas de avaliação foram silhueta de 0,6613, índice de Calinski-Harabasz de 3940,37 e índice de Davies-Bouldin de 0,5092. Gráficos de pontos mostraram separação relativa à duração do lockdown, embora a interpretação visual para outros fatores fosse mais complexa (Figura 6B).
Figura 6. Saída do ABL na análise dos dados do COVID-ASSESS. A) Figura resultante do método “evaluate_models()” da classe “NonHierarchical”. A fim de selecionar um modelo para os dados, executaram-se corridas com quatro algoritmos (eixo X) e diferentes números de agrupamentos (eixo Y), as quais foram comparadas pelo método silhueta, considerando a distância euclidiana (escala de cores). B) Figura resultante do método “plot()” da classe “NonHierarchical”, com a escala de eventos estressantes no eixo X e duração do “lockdown” no eixo Y. C-D) Gráfico de cargas resultante do método “plot()” da classe “PCA”. Os eixos X e Y os componentes principais. As cores representam os grupos identificados na análise de agrupamento não-hierárquico da Figura 6a. C) Componentes principais um e dois. D) Componentes principais dois e três
Fonte: Resultados originais da pesquisa
Para aprofundar a investigação das diferenças entre os grupos, utilizou-se o módulo PCA (Figuras 6C e 6D). O ABL indicou que a amostra atendia aos pressupostos para PCA (valor-p < 0.05 no teste de Bartlett e estatística KMO = 0,726). O critério de Kaiser levou o ABL a determinar três componentes principais. A análise sugeriu que o grupo com maior duração de lockdown apresentava maiores pontuações para ansiedade como um traço de personalidade. Em contraste, o grupo associado a coletas no início ou com menor duração de lockdown parecia relacionado a maior ansiedade como um estado momentâneo. Esses resultados sugerem padrões consistentes com uma possível associação entre a duração do lockdown e tipos de ansiedade, levantando hipóteses para estudos futuros. Embora outros estudos já tenham abordado a saúde mental a longo prazo durante a pandemia (Benke et al., 2023), há potencial para investigações mais específicas em dados de gestantes, o que pode auxiliar no planejamento para futuras pandemias.
Estudo de caso: Sensibilidade sensorial
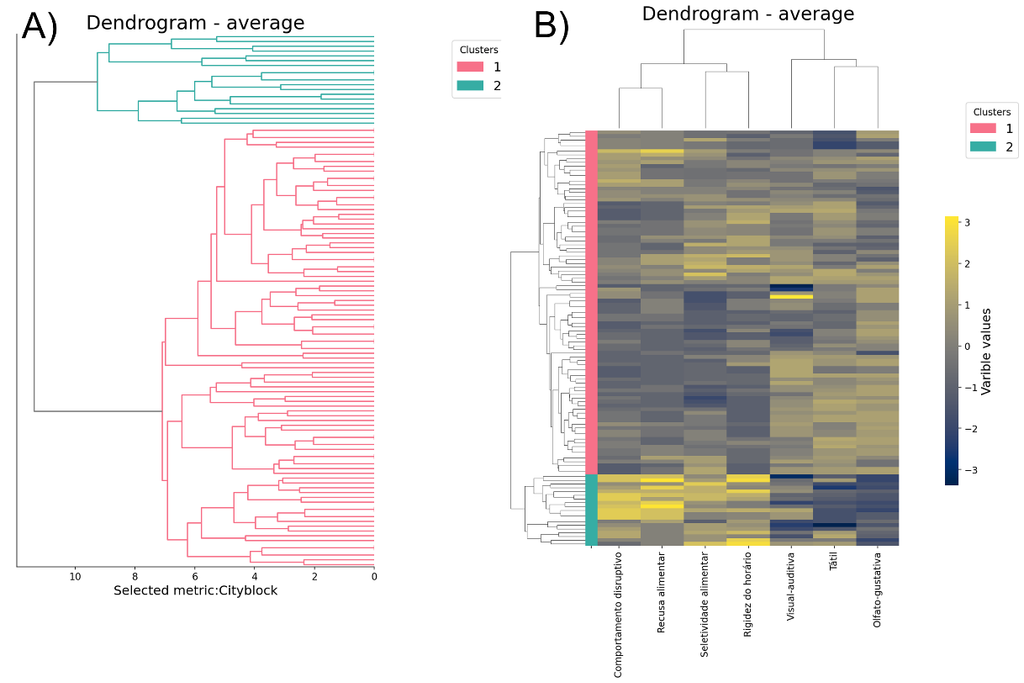
Para demonstrar as saídas do módulo de agrupamento hierárquico, analisaram-se dados do perfil sensorial e alimentar de 111 crianças autistas (Panerai et al., 2020). A configuração inicial buscou pelo menos dois agrupamentos. O ABL sugeriu agrupamento utilizando o método de ligação “average” com a métrica de distância “cityblock” (distância de Manhattan), resultando em dois grupos (Figura 7). O modelo apresentou bom ajuste, com correlação cofenética de 0,759.
Figura 7. Figuras resultantes da classe “Hierarchical” do ABL na análise dos dados do perfil sensorial infantil. O dendrograma tem duas visualizações disponíveis: a) apenas o dendrograma, ou b) dendrograma com mapa de calor das variáveis. Uma escala de cores representa o agrupamento retornado
Fonte: Resultados originais da pesquisa
Na análise biopsicológica, o grupo menor, com 20 indivíduos, pareceu associado a maiores pontuações na avaliação BAMBI, que inclui variáveis como comportamento disruptivo nas refeições, recusa alimentar, seletividade alimentar e rigidez nos horários. Os 91 indivíduos restantes pareciam ter menores pontuações BAMBI. O estudo original (Panerai et al., 2020) considerou apenas a pontuação geral BAMBI para separar os grupos (37 indivíduos com pontuação ≥34 para “problemas alimentares” e 74 restantes “sem problemas alimentares”). A diferença nos resultados decorre da análise de agrupamento hierárquico do ABL, que considera também as variáveis sensoriais sem um critério rígido, oferecendo novas perspectivas não exploradas.
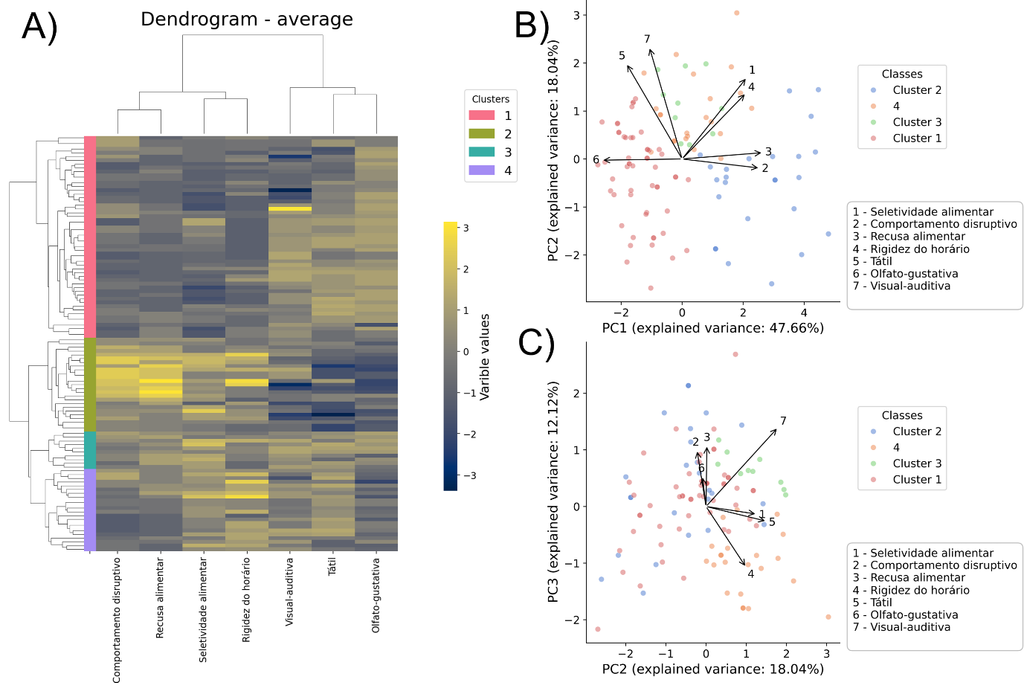
Para aprofundar as possíveis subdivisões e suas características, o agrupamento foi refeito configurando o ABL para retornar pelo menos quatro agrupamentos, combinado com PCA para compreender os pesos das variáveis. Esta nova execução resultou em quatro agrupamentos, com ligação “average” e métrica de Bray-Curtis. O ajuste foi médio, com correlação cofenética de 0,501.
Figura 8. Saída do ABL na análise dos dados do perfil sensorial infantil. A) Figuras resultantes de agrupamento com quatro grupos com a classe “Hierarchical”. B-C) Gráficos de cargas resultante da classe “PCA”. Os eixos X e Y os componentes principais. As cores representam os grupos identificados na análise de agrupamento hierárquico da Figura 8A. B) Componentes principais um e dois. C) Componentes principais dois e três
Fonte: Resultados originais da pesquisa
Nesta segunda análise, o maior agrupamento, com 54 crianças, pareceu corresponder àquelas com menores pontuações, embora ligado à sensibilidade olfato-gustativa atípica (Figura 8). O segundo maior grupo pareceu associar-se a maior comportamento disruptivo durante a alimentação e recusa de alimentos. Os agrupamentos três e quatro, com dez e 22 indivíduos, respectivamente, tinham menor distância entre si. Ambos aparentavam maiores pontuações de seletividade alimentar e, especialmente no grupo quatro, rigidez com horários de refeições. Esta análise exploratória pode gerar hipóteses para estudos mais amplos sobre padrões de alimentação atípica em crianças e seu processamento de estímulos ambientais.
Este trabalho descreveu a implementação de funcionalidades de PCA, agrupamento hierárquico e não-hierárquico no ABL, um arcabouço gratuito para pesquisadores das ciências médicas e biológicas. Os testes realizados validaram as capacidades da ferramenta e demonstraram seu potencial de uso. A aplicação em dados reais revelou padrões que podem gerar perguntas de pesquisa e orientar experimentos futuros, como a possível relação entre ansiedade e duração do isolamento social em gestantes. O ABL foi desenvolvido como uma ferramenta para análise exploratória inicial, permitindo que cientistas foquem na interpretação biológica e geração de hipóteses, em vez de detalhes de programação. Nos próximos passos, planeja-se refinar o ABL para aprimorar a personalização e estética das figuras, formatar bancos de dados, enriquecer a documentação e coletar feedback dos usuários.
4. Conclusão
O presente trabalho teve como objetivo implementar e testar um módulo de Aprendizado Não-Supervisionado (ANS) no arcabouço AutoBioLearn (ABL), visando aprimorar a capacidade de análise de dados para pesquisadores das Ciências Biológicas e da Saúde. Verificou-se que as metodologias de ANS mais relevantes para este público, como Análise de Componentes Principais (PCA), agrupamento hierárquico e não-hierárquico, foram implementadas com sucesso. Os testes de validação demonstraram que o módulo produziu agrupamentos consistentes com as classes reais em conjuntos de dados padrão e sintéticos. Adicionalmente, a ferramenta exibiu reprodutibilidade na seleção de hiperparâmetros e escalabilidade para conjuntos de dados de até 10.000 amostras, o que se alinha com os tamanhos amostrais comumente encontrados na literatura da área. A aplicação do módulo em estudos de caso revelou padrões significativos, como a possível associação entre a duração do lockdown e diferentes tipos de ansiedade em gestantes, e a identificação de subgrupos de comportamentos alimentares em crianças autistas, oferecendo novas perspectivas em relação a análises anteriores. A principal contribuição deste estudo reside na disponibilização de uma ferramenta de código aberto que simplifica a execução de análises complexas de ANS, permitindo que cientistas da saúde e biólogos concentrem seus esforços na interpretação biológica e na geração de hipóteses.
Apesar dos avanços, a análise inicial das metodologias de ANS na literatura acadêmica apresentou a limitação de possíveis falsos positivos devido à natureza exploratória das expressões de busca. Em termos de escalabilidade, embora o módulo seja viável para a maioria dos conjuntos de dados do público-alvo, análises com centenas de milhares ou milhões de observações podem exigir recursos computacionais mais robustos. Para estudos futuros, as descobertas nos dados de gestantes sugerem a necessidade de investigações mais aprofundadas sobre a relação entre a duração do isolamento social e a saúde mental em populações específicas, auxiliando no planejamento para futuras crises sanitárias. Similarmente, a análise exploratória dos perfis sensoriais de crianças autistas abre caminho para pesquisas mais amplas sobre padrões de alimentação atípica e processamento de estímulos ambientais. No que tange ao próprio ABL, planeja-se aprimorar a personalização e a estética das visualizações, otimizar o retorno de bancos de dados formatados, expandir a documentação e estabelecer um canal para coletar feedback dos usuários, garantindo a evolução contínua da ferramenta.
Referências Bibliográficas
Gabriel-Kuniyoshi, M.L.; Simões, S.N.; Moreira, L.P.B.; de Souza, J.Y.K.; Nogueira, T.O.; Catharini, T.M.A.; Della Torre, J.A.; Leoni, B.S.; Biancolin, K.E.; Ibidi, S.M.; Francisco, R.P.V.; Sabino, E.C.; Camilo, C.; Gouveia, G.R.; Brentani, A.; Martins, D.C.; Brentani, H. 2025. COVID-19 modulates pregnancy outcomes. Disponível em: . Acesso em: 3 mar. 2026.
Maheswari S.; Suresh S.; Ahamed A.S. 2024. A systematic literature review on machine learning and deep learning-based covid-19 detection frameworks using X-ray Images. Applied Soft Computing 166(1):112137.
Moon. H; Yoon, D.E.; Kim, J.; Choi, Y.; Kim, H.; Lee, I.S.; Chae Y. 2025. Identifying key features for determining the patterns of patients with functional dyspepsia using machine learning. Frontiers in Physiology 16(2025):165
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

