
15 de setembro de 2026
Previsão da Potência Radiativa do Fogo de Incêndios no Brasil
João Pedro Granzotto Campos; Lauro Marques Vicari
DOI: 10.22167/2675-6528-202602238
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
Este estudo investigou os determinantes climáticos e de uso do solo que impulsionam a intensidade de incêndios, mensurada pela Potência Radiativa do Fogo (FRP). A pesquisa combinou inferência estatística clássica, por meio de um modelo econométrico de dados em painel com Efeitos Fixos, e modelagem preditiva avançada utilizando o algoritmo Random Forest. Os resultados do modelo econométrico revelaram que o índice de desmatamento exerceu o maior impacto positivo e estrutural na intensidade do fogo, enquanto as áreas de agricultura, pastagem e silvicultura não apresentaram significância estatística. O modelo Random Forest, otimizado via Grid Search com validação cruzada, explicou 36,26% da variância preditiva do fenômeno. Apresentou um Erro Médio Absoluto (MAE) de 0,62 em escala logarítmica, indicando robustez nas previsões. A análise de interpretabilidade com valores SHAP confirmou o protagonismo da dinâmica atmosférica, com a umidade relativa do ar como principal fator de mitigação de incêndios e a temperatura máxima e o número de dias sem chuva como maiores catalisadores. Concluiu-se que os incêndios de alta severidade resultam da sobreposição de extremos macroclimáticos combinados à disponibilidade de combustível oriundo do desmatamento recente.
Palavras-chave: Econometria de Painel; Machine Learning; Potência Radiativa do Fogo; Random Forest; Valores SHAP.
1. Introdução
As queimadas e os incêndios florestais representam um desafio ambiental e socioeconômico significativo para o Brasil, com impactos anuais sobre extensas áreas de seus biomas. Dados do Instituto Nacional de Pesquisas Espaciais (INPE) indicam que, em 2024, foram registrados 278.299 focos de incêndio no país, um aumento de 46,5% em relação ao ano anterior. A Amazônia e o Cerrado figuram como os biomas mais afetados (CNN Brasil, 2025). Este cenário é influenciado por uma combinação de fatores, como períodos de estiagem prolongada, práticas inadequadas de manejo do solo e o desmatamento, que podem aumentar a vulnerabilidade das florestas à propagação do fogo (Nobre et al., 2016).
As consequências de um incêndio florestal abrangem severas alterações no ecossistema. No meio físico, observa-se a erosão, a redução da matéria orgânica do solo e a liberação de carbono para a atmosfera. No meio biótico, os impactos se manifestam na morte de animais e na destruição de seus habitats, afetando todo o processo de sucessão ecológica (Guimarães et al., 2014).
Nesse contexto, a quantificação da intensidade e da energia liberada por um incêndio é crucial para o seu monitoramento e manejo eficaz. Uma das métricas amplamente utilizadas para essa finalidade é a Potência Radiativa do Fogo (FRP), definida como a taxa de energia radiativa emitida por um incêndio, medida em Watts (Wooster et al., 2005). A medição da FRP, realizada por sensores de satélite, possui uma correlação direta com a taxa de consumo de biomassa pelo fogo, permitindo avaliar a intensidade de um incêndio e estimar a quantidade de biomassa consumida e, consequentemente, as emissões de poluentes para a atmosfera (Roberts et al., 2005).
A aplicação da FRP na gestão de incêndios é diversificada. As informações sobre a intensidade do fogo podem ser utilizadas na alocação de recursos de combate, permitindo que as equipes priorizem as frentes de fogo com maior liberação de energia. A análise da FRP também pode ser empregada na avaliação de danos potenciais à vegetação, no suporte a planos de evacuação de áreas de risco e na formulação de políticas de prevenção e manejo do fogo. A previsibilidade de queimadas e incêndios é, portanto, fundamental para a ação do poder público, visando a mitigação dos danos e ações preventivas (Viganó et al., 2017).
A estimativa da FRP é uma tarefa complexa, pois depende de múltiplas variáveis dinâmicas, como condições meteorológicas (temperatura, umidade, vento), características da vegetação (tipo, densidade, umidade do combustível) e topografia (Wooster et al., 2005; Roberts et al., 2005; Viganó et al., 2017). Neste cenário, as técnicas de aprendizado de máquina (machine learning) apresentam um potencial significativo para o desenvolvimento de modelos preditivos, projetados para identificar padrões e relações em grandes conjuntos de dados (Juvanhol et al., 2023). Esses modelos podem ser utilizados para analisar o comportamento de incêndios florestais e permitir uma previsibilidade de risco e impacto de variáveis sobre os eventos, incluindo modelos de regressão, redes neurais e árvores de decisão (Viganó et al., 2017; Juvanhol et al., 2023).
A aplicação dessas técnicas, especificamente para a predição da FRP, é um campo de pesquisa em desenvolvimento. Ao treinar algoritmos com dados históricos de focos de incêndio, variáveis meteorológicas e outras informações geoespaciais, busca-se desenvolver modelos preditivos robustos. Embora existam estudos baseados em aprendizado de máquina focados em regiões específicas da América Latina, a presente pesquisa se diferencia ao atuar na extensão do território brasileiro.
A problemática que este trabalho busca abordar é a possibilidade de se estimar a intensidade de um incêndio, representada pela FRP, por meio de um conjunto de variáveis descritivas e modelos de aprendizado de máquina. A pesquisa se ampara na necessidade de desenvolver ferramentas quantitativas para a gestão de queimadas no Brasil, aplicando a ciência de dados para a análise de um relevante desafio ambiental do país, esperando-se fornecer uma ferramenta de apoio à decisão para os órgãos de gestão ambiental e defesa civil. O objetivo geral é o desenvolvimento de um modelo de aprendizado de máquina para estimar a Potência Radiativa do Fogo (FRP) de focos de incêndio no Brasil, a partir de dados do Instituto Nacional de Pesquisas Espaciais (INPE) e de variáveis ambientais complementares, identificando as variáveis de maior importância para a determinação da FRP.
2. Material e Métodos
O estudo adotou uma abordagem quantitativa e explicativa, com delineamento focado na implementação de algoritmos de machine learning. A instrumentação baseou-se em pesquisa documental, utilizando registros oficiais do INPE como fonte de dados.
Coleta dos dados
A coleta de dados ocorreu entre 2019 e 2023, utilizando o catálogo de focos de incêndio do INPE como base principal. Esta base forneceu informações sobre latitude, longitude, data, satélite, estado, município, bioma, número de dias sem chuva, risco de fogo e Potência Radiativa do Fogo (FRP).
Para enriquecer a análise, foram incorporadas bases de dados auxiliares. O projeto PRODES (Base auxiliar 1) contribuiu com dados anualizados de desmatamento e hidrografia por município e bioma. A base do IBGE (Base auxiliar 1.1) foi utilizada para mesclar dados, contendo identificadores e nomes de municípios e estados. O MapBiomas (Base auxiliar 2) forneceu informações anualizadas sobre cobertura do solo, incluindo áreas de agricultura, pastagem e silvicultura por estado, município, bioma e ano.
Dados meteorológicos diários foram coletados via API da NASA Power (Base auxiliar 3), abrangendo latitude, longitude, ano, data, temperatura média e máxima, umidade relativa, velocidade do vento, precipitação e umidade do solo. Para otimizar a coleta, as coordenadas de latitude e longitude da base principal foram arredondadas em intervalos de 0,5°, agrupando localidades em um grid de aproximadamente 55 km.
Estruturação dos Dados
A estruturação dos dados envolveu a mesclagem das bases auxiliares com a base principal. Inicialmente, as chaves de mesclagem foram padronizadas em tipo de dados. A base principal teve a coluna “Data” convertida para formato de data, latitude e longitude arredondadas para 0,5°, e colunas de ano e mês criadas. As bases auxiliares 1, 1.1 e 2 foram conectadas à base principal utilizando junções internas baseadas em colunas como ano, bioma, município, estado e ID do município. A base auxiliar 3 foi conectada à base principal por meio de latitude (arredondada), longitude (arredondada) e data.
Devido às diferentes granularidades, a base principal (foco de incêndio individual) foi combinada com bases auxiliares 1 e 2 (resolução macro-espacial por município e bioma) e com a base auxiliar 3 (maior precisão espaço-temporal por data e coordenadas).
Pré-processamento e Preparação dos Dados
A etapa de pré-processamento e preparação dos dados incluiu o tratamento de dados faltantes, removendo observações com valores nulos ou códigos de erro (-999) nas variáveis “número de dias sem chuva”, “risco de fogo” e FRP. Realizou-se engenharia de atributos, criando índices de Desmatamento, Hidrografia, Pastagem, Agricultura e Silvicultura, calculados como a razão entre a área específica e a área total do bioma no município.
A variável dependente, FRP, que apresentava distribuição assimétrica, foi transformada utilizando o logaritmo natural para mitigar a variância e a influência de valores extremos, conforme a equação:
ln(FRP) = ln (FRPit + 1)
onde a constante 1 foi adicionada para evitar indefinição em valores nulos ou próximos de zero (Shumway e Stoffer, 2017; Wooldridge, 2010).
Dados inválidos, como ocupação do solo superior à área total ou porcentagens acima de 100%, foram limpos ou limitados. A filtragem dos dados selecionou apenas registros do satélite AQUA M-T, seguindo recomendação do INPE (2025). Finalmente, os dados foram agregados em formato de painel, utilizando chave primária de município, estado e bioma, para capturar a dinâmica histórica e variações climáticas. As variáveis foram agregadas por média aritmética (para FRP transformado e não transformado, precipitação, risco de fogo, índices de desmatamento, pastagem, silvicultura, agricultura, velocidade do vento, umidade relativa, temperatura média, umidade do solo e hidrografia), por máximo (para dias sem chuva e temperatura máxima do dia), e por soma e contagem (para FRP não transformado e focos).
O resultado da estruturação dos dados consistiu em duas bases: uma em formato de painel (agregada por município, bioma, ano e mês) para o modelo econométrico, e outra em nível de eventos (resolução original de foco de incêndio individual) para análise exploratória e o modelo Random Forest.
Análise exploratória dos dados
A análise exploratória dos dados buscou compreender a estrutura das variáveis, padrões de distribuição e validar premissas para a modelagem. Incluiu estatísticas descritivas (média, desvio padrão, mediana), análise temporal e de sazonalidade da quantidade de focos de incêndio, distribuição da variável dependente após transformação logarítmica e análise de correlação entre os dados.
Correlação entre variáveis
A multicolinearidade entre as variáveis explicativas foi avaliada pelo Teste de Inflacionamento da Variância (VIF), calculado como VIFi = 1 / (1-R²), onde R² é o coeficiente de determinação da regressão da variável preditora i contra as demais (Hair et al., 2009). Para mitigar esse problema, as variáveis “temperatura média” e “umidade do solo” foram removidas, mantendo “temperatura máxima” e “umidade relativa”. Uma matriz de correlação de Pearson também foi aplicada para identificar padrões de associação entre as variáveis climáticas e a intensidade do fogo.
Desenvolvimento e Treinamento dos Modelos Preditivos
Para a predição da intensidade das queimadas (logaritmo da FRP), utilizou-se uma abordagem híbrida, combinando modelos econométricos baseados em painel com um algoritmo de machine learning supervisionado. Os dados foram divididos em 80% para treinamento e 20% para teste e validação. A implementação foi realizada em Python, utilizando as bibliotecas Pandas para manipulação de dados, Scikit-learn para machine learning e Linearmodels para análise em painel.
Regressão com Dados em Painel (Efeitos Fixos)
Para a regressão, utilizou-se um modelo de Dados em Painel com Efeitos Fixos, que considera a estrutura longitudinal e transversal dos dados (Wooldridge, 2010). A escolha do estimador de Efeitos Fixos foi justificada pelo teste de Hausman, que avalia a consistência dos estimadores. A estatística do teste é calculada por m = q’V(9)¯¹9, onde ĝ é a diferença entre os coeficientes (Fixos – Aleatórios) e V(ĝ) é a variância dessa diferença. A rejeição da hipótese nula do teste de Hausman (Hausman, 1978) indicou a preferência pelo modelo de Efeitos Fixos. A equação geral do modelo é:
Yit = β₀ + β₁Xit + … + βkXkit + αi + Uit
onde Yit é o logaritmo da FRP no município i no mês t, Xit são as variáveis explicativas (Precipitação, Risco de Fogo, etc.), β são os coeficientes, αi é o efeito fixo de cada município e Uit é o termo de erro (Wooldridge, 2010).
Árvores de decisão e Random Forest Regressor
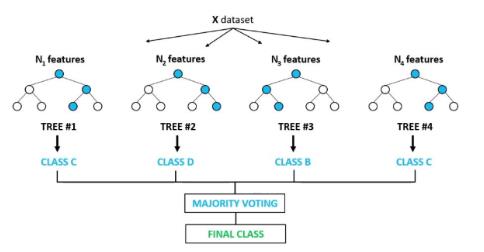
O modelo de Random Forest foi empregado como algoritmo de machine learning supervisionado para regressão, devido à sua robustez e capacidade de modelar interações não lineares. Este algoritmo de ensemble constrói uma “floresta” de árvores de decisão, onde a predição final é a média dos resultados das árvores individuais (Breiman, 2001). A arquitetura do Random Forest baseia-se em Bagging (Bootstrap Aggregating), que cria múltiplas amostras de treino aleatórias com reposição para treinar cada árvore, e Seleção Aleatória de Features, onde um subconjunto aleatório de variáveis explicativas é considerado em cada divisão do nó da árvore. O processo é ilustrado na Figura 1.
Figura 1. Diagrama do modelo “Random Forest”
Fonte: David (2020)
Otimização de hiper parâmetros (“Grid Search”)
A otimização dos hiperparâmetros do modelo Random Forest foi realizada utilizando a técnica de Grid Search com validação cruzada, visando maximizar a capacidade preditiva e mitigar o sobreajuste (Kuhn e Johnson, 2013). Os hiperparâmetros otimizados incluíram: número de estimadores (quantidade de árvores), profundidade máxima (limite de crescimento das árvores), features máximas (número de variáveis explicativas sorteadas por nó), amostras mínimas para o nó (mínimo de observações para subdivisão) e amostras mínimas para a folha (mínimo de eventos em nó final).
A melhor combinação de hiperparâmetros foi definida com base no estimador MAE e validação cruzada de 3 partes, resultando em profundidade máxima de 25, features máximas com Raiz Quadrada, amostras mínimas para o nó de 2, amostras mínimas para a folha de 1 e 300 estimadores.
Avaliação dos modelos
A avaliação do desempenho preditivo dos modelos foi realizada na amostra de teste (20% dos dados). As métricas estatísticas utilizadas para seleção do melhor modelo foram o Coeficiente de Determinação (R²), a Raiz do Erro Quadrático Médio (RMSE) e o Erro Absoluto Médio (MAE), todas refletindo a precisão na escala logarítmica da variável dependente (ln(FRP + 1)).
O R² quantifica a proporção da variabilidade da variável dependente explicada pelo modelo, calculado como:
R² = SSR/SST = 1 – SSRes/SST
onde SSR é a Soma dos Quadrados da Regressão, SST é a Soma dos Quadrados Total e SSRes é a Soma dos Quadrados dos Resíduos (Montgomery, Peck e Vining, 2012).
A RMSE mensura a magnitude média dos erros de predição, representando o desvio padrão dos resíduos, calculada por:
RMSE = sqrt( (1/n) * sum( (yi – y_hat_i)^2 ) )
onde n é o número de observações, yi é o valor real e y_hat_i é o valor previsto (Hastie, Tibshirani e Friedman, 2009).
O MAE mede a magnitude média das diferenças absolutas entre previsões e valores reais, sendo calculado por:
MAE = (1/n) * sum( |yi – y_hat_i| )
O MAE é menos sensível a outliers do que o RMSE (Hastie, Tibshirani e Friedman, 2009).
Análise de Importância das Variáveis e inferência
Para compreender os determinantes da intensidade do fogo, foi realizada uma análise interpretativa das variáveis preditoras, utilizando técnicas específicas para cada modelo.
Interpretação no Modelo Econométrico (Painel)
No modelo econométrico de Regressão com Dados em Painel, a importância das variáveis foi avaliada pela significância estatística e magnitude dos coeficientes, utilizando o Teste t de Student (Wooldridge, 2020). Os coeficientes foram interpretados em termos de elasticidade ou semi-elasticidade, indicando o impacto marginal e a direção da relação (+/-) com a FRP.
Testes de diagnóstico foram aplicados para validar as inferências estatísticas. A normalidade dos resíduos foi avaliada pelo teste de Jarque-Bera (Jarque e Bera, 1980), e a variância constante pelo teste de Breusch-Pagan (Breusch e Pagan, 1979). Para corrigir a heteroscedasticidade diagnosticada, a estimação final do modelo utilizou Erros-Padrão Robustos Clusterizados (Wooldridge, 2020).
Interpretação no Modelo de “Machine Learning” (“Random Forest”)
No algoritmo Random Forest, a importância das variáveis foi mensurada pela métrica de redução média da variância, que calcula a soma total da redução de erro proporcionada por cada variável ao longo das árvores da floresta (Hastie, Tibshirani e Friedman, 2009). Para complementar, a análise de Valores SHAP (Shapley, 1953; Lundberg e Lee, 2017) foi incorporada para quantificar a contribuição marginal de cada variável na previsão individual e identificar a direcionalidade dos efeitos (positivos ou negativos).
3. Resultados e Discussão
Análise da Distribuição e Tratamento da Variável Alvo (FRP)
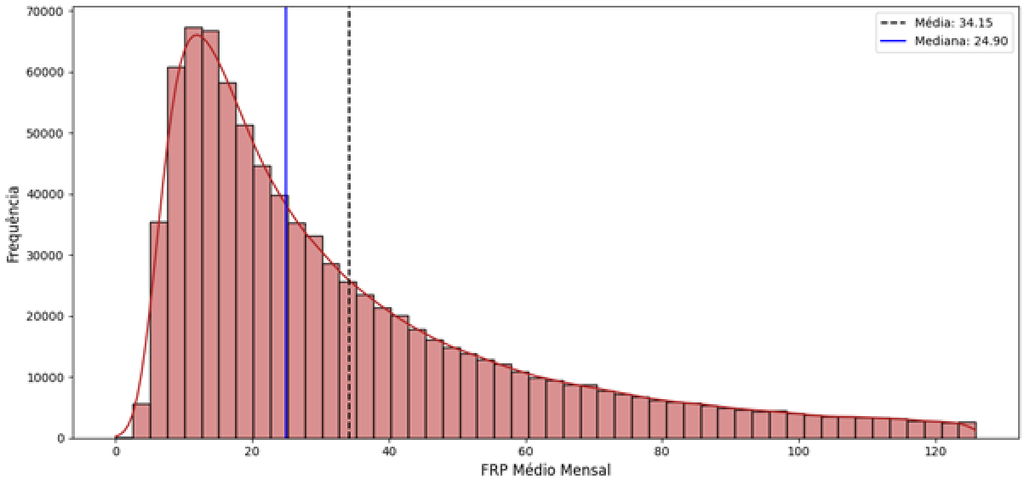
A análise inicial da variável Potência Radiativa do Fogo (FRP) confirmou uma alta assimetria na distribuição, com a maioria dos registros concentrando-se em valores baixos de energia. Uma pequena quantidade de eventos extremos, caracterizados por incêndios de grande magnitude, deslocava a média e elevava a variância, conforme ilustrado na Figura 2.
Figura 2. Distribuição da Intensidade Média (FRP)
Fonte: resultados originais da pesquisa
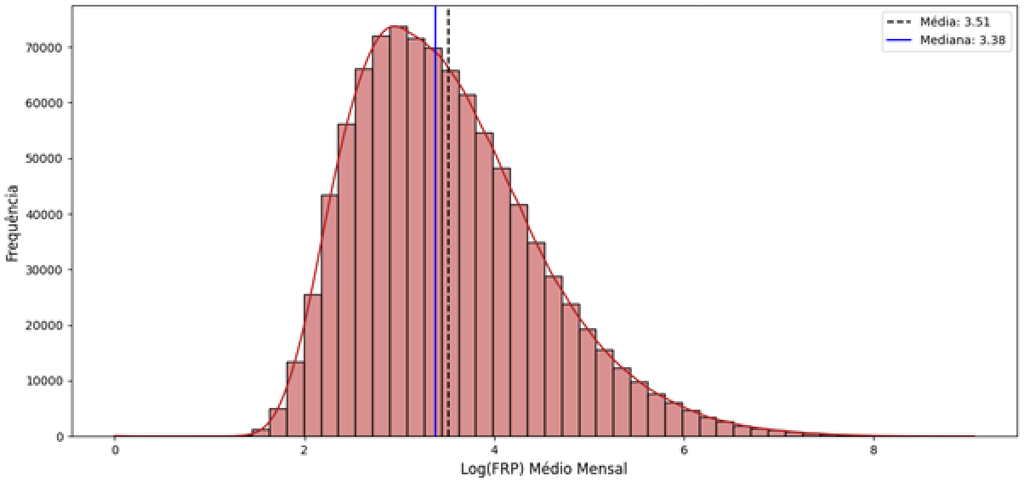
Para mitigar essa assimetria e estabilizar a variância, aplicou-se a transformação logarítmica natural (ln(FRP + 1)). Esta abordagem demonstrou-se eficaz ao reduzir significativamente a amplitude de variação e a influência desproporcional de valores extremos, permitindo a inclusão de observações de alta magnitude no modelo sem a necessidade de exclusão, como mostra a Figura 3.
Figura 3. Distribuição da Intensidade Média (Log FRP)
Fonte: resultados originais da pesquisa
Correlações entre variáveis
O Teste de Inflacionamento da Variância (VIF) indicou valores altos para temperatura média e máxima, e moderados para umidade relativa, desmatamento e umidade do solo. Para evitar multicolinearidade, as variáveis temperatura média e umidade do solo foram removidas, mantendo-se a temperatura máxima e a umidade relativa para preservar informações cruciais sobre o pico de temperatura e as condições climáticas de curto prazo.
Tabela 1. Tabela VIF para variáveis
| Nome da variável | Unidade de medida | Tipo | Descrição |
|---|---|---|---|
| Latitude | Grau | Decimal | Latitude em que ocorreu o foco |
| Longitude | Grau | Decimal | Longitude em que o ocorreu o foco |
| Data | Data | Data/Hora | Data do registro Satélite que realizou o registro do foco |
| Satélite | Categórica | Texto | Nome do Satélite que realizou o registro do foco |
| Estado | Categórica | Texto | Nome do estado brasileiro |
| Município | Categórica | Texto | Nome do município |
| Bioma | Categórica | Texto | Nome do bioma |
| Número de dias sem chuva | Dias | Inteiro | Número de dias sem chuva até a detecção do foco |
| Risco de fogo | Adimensional | Decimal | Valor do Risco de Fogo previsto para o dia da detecção do foco. |
| Potência radiativa do fogo | MW | Decimal | A potência do fogo detectado |
Fonte: resultados originais da pesquisa
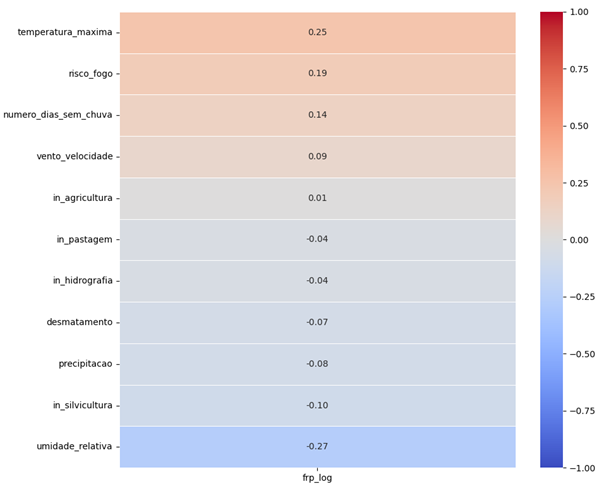
A matriz de correlação de Pearson revelou padrões de associação entre as variáveis climáticas e a intensidade do fogo. Observou-se que a Temperatura Máxima (0,25), o Risco de Fogo (0,19) e o Número de dias sem chuva (0,14) apresentaram as maiores correlações positivas com a variável alvo, sugerindo que a severidade energética de um incêndio está diretamente ligada ao pico de temperatura, ao risco de incêndio e ao período de estiagem. Em contraste, a Umidade relativa (-0,27) demonstrou correlação negativa, indicando ser um fator que contribui para a diminuição da intensidade dos incêndios, conforme a Figura 4.
Figura 4. Matriz de Correlação de Pearson
Fonte: resultados originais da pesquisa
Dinâmica temporal
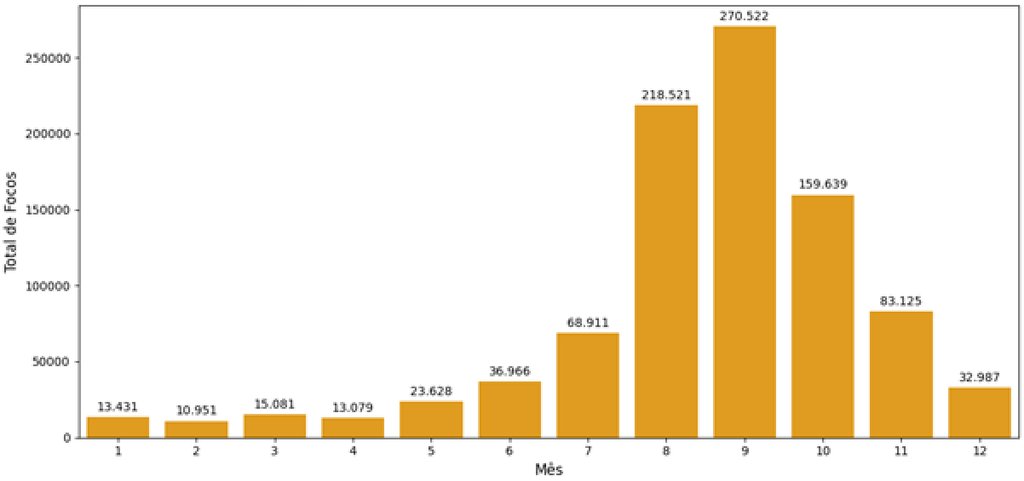
A análise temporal identificou uma sazonalidade expressiva na ocorrência de focos de incêndio. Os níveis mais baixos foram observados entre janeiro e abril, com um aumento a partir de maio, atingindo o pico em setembro e diminuindo em seguida. O período de agosto a outubro concentrou a maior parte dos focos, reforçando a relevância do mês como uma variável preditiva para o modelo Random Forest, como ilustrado na Figura 5.
Figura 5. Sazonalidade: Distribuição Total de Focos por Mês
Fonte: resultados originais da pesquisa
Modelo Econométrico de Dados em Painel
A estimação do modelo econométrico de Efeitos Fixos, que controlou características não observáveis e invariantes no tempo, explicou 18,41% (Rwithin= 0.1841) da variabilidade interna da intensidade do fogo (log FRP) nos painéis ao longo do tempo. Os coeficientes do modelo representam taxas de crescimento percentual, indicando o aumento percentual na FRP para cada unidade de aumento da variável.
A análise dos coeficientes, apresentada na Tabela 2, revelou que a dinâmica atmosférica exerce influência estatisticamente significante (p < 0.01) sobre a intensidade do fogo. A temperatura máxima (0.0261) e a velocidade média do vento (0.0469) apresentaram coeficientes positivos, indicando que picos de calor e ventos fortes elevam a intensidade do fogo. A umidade relativa, por sua vez, demonstrou uma relação negativa (-0.0089) com a intensidade das chamas. Essa dinâmica corrobora estudos que apontam a combinação de fatores térmicos, ventos fortes e baixa umidade como um ambiente propício à intensificação de incêndios florestais (Nobre et al., 2016).
O coeficiente do desmatamento (1.3612) foi o de maior magnitude e significância estatística (p < 0.01). Em contraste, os coeficientes para as áreas de pastagem, silvicultura e agricultura não apresentaram significância estatística (p > 0.05). Este achado sugere que a queima de “limpeza” em áreas de desmatamento recente consome combustíveis pesados, liberando maiores quantidades de energia, enquanto as queimadas de manejo em pastagens ou agricultura, que consomem combustíveis finos, liberam energia radiativa de forma rápida, sem gerar alterações estatísticas estruturais na ordem de grandeza do FRP municipal (Roberts et al., 2005). O Teste t de Student confirmou que todas as variáveis, com exceção de pastagem, silvicultura e agricultura, contribuem de fato para o FRP.
Tabela 2. Resultados da estimação do modelo de efeitos fixos (PanelOLS) para o Log de FRP
| Nome da variável | Unidade de medida | Tipo | Descrição |
|---|---|---|---|
| Ano | Ano | Inteiro | Ano registrado |
| Id do Município | Categórica | Inteiro | Código identificador do município |
| Bioma | Categórica | Texto | Nome do bioma |
| Área total | Km² | Decimal | Área total do bioma no município |
| Desmatado | Km² | Decimal | Área desmatada do bioma no município |
| Hidrografia | Km² | Decimal | Área de hidrografia do bioma no município |
Fonte: resultados originais da pesquisa
Modelo Random Forest
O modelo Random Forest foi elaborado utilizando o log do FRP como variável dependente e um conjunto de features que incluíram temperatura máxima, umidade relativa, velocidade do vento, precipitação, número de dias sem chuva, risco de fogo, desmatamento, índices de pastagem, silvicultura, agricultura, hidrografia e mês. A otimização dos hiperparâmetros foi realizada via Grid Search com validação cruzada, conforme as opções apresentadas na Tabela 3.
Tabela 3. Grade de hiper parâmetros utilizados no “Grid Search”
| Nome da variável | Unidade de medida | Tipo | Descrição |
|---|---|---|---|
| Id do Município | Categórica | Inteiro | Código identificador do município |
| Nome | Categórica | Texto | Nome do município |
| Estado | Categórica | Texto | Nome do estado brasileiro |
Fonte: resultados originais da pesquisa
O modelo com melhor desempenho, após otimização, resultou em um poder de explicação R² de 0.3626, com Erro Absoluto Médio (MAE) de 0.62 e Raiz do Erro Quadrático Médio (RMSE) de 0.79 na base de testes. O erro reflete unidades logarítmicas. Ao retornar à escala original, o MAE indica que as previsões do modelo desviam-se, em média, por um fator de aproximadamente 1,8, sendo capazes de antecipar a ordem de grandeza do incêndio. A proximidade entre os valores de RMSE e MAE sugere a ausência de outliers extremos e sistêmicos nas previsões, indicando consistência preditiva em torno da média do erro (Chai e Draxler, 2014). Embora o R² seja relativamente baixo, capturar mais de um terço da variância em sistemas ecológicos complexos e não controlados pode indicar que o modelo mapeou impulsionadores estruturais (Moller e Jennions, 2002).
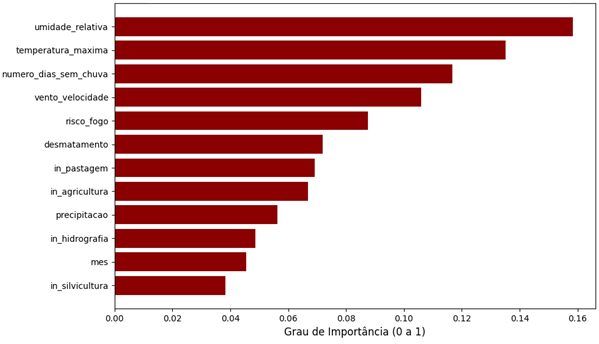
As principais variáveis que impactam a intensidade do fogo, conforme o grau de importância do modelo Random Forest, foram a umidade relativa, temperatura máxima e número de dias sem chuva, como mostra a Figura 6.
Figura 6. Variáveis com maior impacto na intensidade do fogo
Fonte: resultados originais da pesquisa
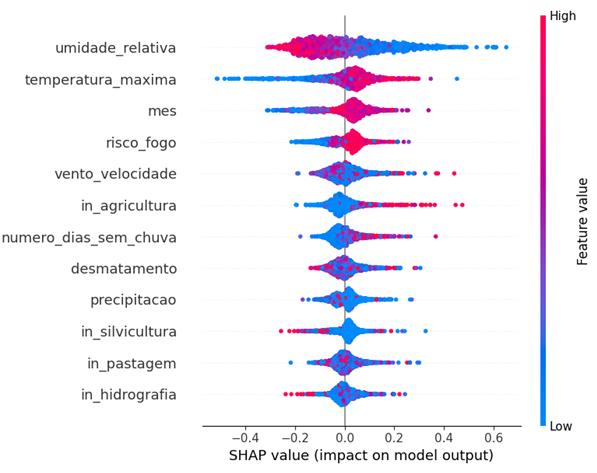
A análise de Valores SHAP complementou a compreensão da direcionalidade desses impactos. A umidade relativa demonstrou ser um forte fator de diminuição da intensidade do fogo, enquanto a temperatura máxima e o número de dias sem chuva apresentaram contribuição positiva para o aumento da intensidade, conforme a Figura 7. Valores mais próximos do vermelho indicam alto valor na variável e impacto positivo na FRP, enquanto valores azuis indicam baixo valor na variável e impacto negativo.
Figura 7. Valores SHAP das variáveis do modelo
Fonte: resultados originais da pesquisa
A identificação desses principais vetores dos incêndios de alta intensidade viabiliza o planejamento de estratégias preventivas e a alocação antecipada de recursos de contingência. A modelagem desenvolvida permite prever a ordem de grandeza dos eventos, contribuindo para uma mobilização mais ágil e eficaz no combate a incêndios de grandes proporções.
Em síntese, os resultados de ambos os modelos indicaram a influência de condições de seca, vento e temperatura na intensidade do fogo, além do impacto significativo do desmatamento. Esses achados demonstram que incêndios de alta severidade resultam da sobreposição de extremos macroclimáticos e da disponibilidade de combustível oriundo do desmatamento recente. Com acesso a informações e modelos preditivos, é possível atuar na prevenção e controle desses fenômenos.
4. Conclusão
Este estudo buscou desenvolver um modelo de aprendizado de máquina para estimar a Potência Radiativa do Fogo (FRP) de focos de incêndio no Brasil, a partir de dados do Instituto Nacional de Pesquisas Espaciais (INPE) e de variáveis ambientais complementares, identificando os fatores mais importantes para sua determinação. Verificou-se, por meio de um modelo econométrico de dados em painel, que o índice de desmatamento exerceu o maior impacto positivo e estrutural na intensidade do fogo, enquanto as áreas de agricultura, pastagem e silvicultura não apresentaram significância estatística. Complementarmente, a modelagem preditiva com o algoritmo Random Forest demonstrou que as condições climáticas possuem significativo impacto na propagação e intensidade do fogo. A umidade relativa do ar foi identificada como o principal fator de mitigação, ao passo que a temperatura máxima e o número de dias sem chuva atuaram como os maiores catalisadores. Os resultados de ambos os modelos convergiram ao indicar que os incêndios de alta severidade resultam da sobreposição de extremos macroclimáticos combinados à disponibilidade de combustível oriundo do desmatamento recente.
A principal contribuição deste trabalho reside na oferta de uma ferramenta quantitativa de apoio à decisão para órgãos de gestão ambiental e defesa civil, permitindo a previsão da ordem de grandeza dos eventos de incêndio e, consequentemente, uma mobilização mais ágil e eficaz no combate a focos de grandes proporções. A identificação dos principais vetores de incêndios de alta intensidade viabiliza o planejamento de estratégias preventivas e a alocação antecipada de recursos de contingência. Contudo, uma limitação do estudo decorreu da disponibilidade de recursos, que impediu a amplificação da quantidade de variáveis e o aumento dos anos considerados para a análise. Sugere-se, para estudos futuros, a exploração de um conjunto mais abrangente de variáveis e uma série histórica estendida, o que poderia refinar ainda mais a capacidade preditiva e explicativa dos modelos.
Referências Bibliográficas
Breiman, L. 2001. Random Forests. Machine Learning 45(1): 5-32.
CNN Brasil. 2025. Brasil registrou 278,3 mil focos de incêndio em 2024, diz Inpe. Disponível em: https://www.cnnbrasil.com.br/nacional/brasil-registrou-2783-mil-focos-de-incendio-em-2024-diz-inpe/. Acesso em: 28 set. 2025.
David, Davis. Random forest classifier tutorial: how to use tree-based algorithms for machine learning. freeCodeCamp, 6 ago. 2020. Disponível em: https://www.freecodecamp.org/news/how-to-use-the-tree-based-algorithm-for-machine-learning/. Acesso em: 14 abr. 2026.
Guimarães, P. P.; Souza, S. M.; Fiedler, N. C.; Silva, A. G. 2014. Análise dos Impactos Ambientais de um Incêndio Florestal. Agrarian Academy 1(1): 38-60.
Hair Jr., J. F.; Black, W. C.; Babin, B. J.; Anderson, R. E.; Tatham, R. L. 2009. Análise Multivariada de Dados. 6. ed. Bookman, Porto Alegre, RS, Brasil.
Hausman, Jerry A. Specification tests in econometrics. Econometrica, v. 46, n. 6, p. 1251-1271, 1978.
INPE (Instituto Nacional de Pesquisas Espaciais). Programa Queimadas: Monitoramento dos Focos Ativos por Satélite. Disponível em: http://terrabrasilis.dpi.inpe.br/queimadas/portal/pages/secao_informacoes/faq/. Acesso em: 26 jan. 2026.
Juvanhol, R. S.; Fiedler, N. C.; Santos, A. R.; Peluzio T. M. O.; Silva W. B.; Pinheiro C. J. G; Sousa H. C. P. 2023. Use of machine learning as a tool for determining fire management units in the brazilian atlantic forest. Anais da Academia Brasileira de Ciências 95(2): e20201039.
Kuhn, M.; Johnson, K. Applied Predictive Modeling. Nova York: Springer, 2013.
Montgomery, D. C.; Peck, E. A.; Vining, G. G. 2012. Introduction to Linear Regression Analysis. 5. ed. Wiley, Hoboken, NJ, USA.
Nobre, C. A.; Sampaio, G.; Borma, L. S.; Castilla-Rubio, J. C.; Silva, J. S.; Cardoso, M. 2016. Land-use and climate change risks in the Amazon and the need of a novel sustainable development paradigm. Proceedings of the National Academy of Sciences 113(39): 10759-10768.
Roberts, G.; Wooster, M. J.; Perry, G. L. W.; Kaufman Y. J. 2005. Retrieval of biomass combustion rates and totals from fire radiative power observations: FRP derivation and calibration relationships between biomass consumption and fire radiative energy release. Journal of Geophysical Research: Atmospheres 110(D24311).
Shumway, R. H.; Stoffer, D. S. Time Series Analysis and Its Applications: With R Examples. 4. ed. Cham: Springer, 2017
Viganó, H. H. G.; Souza, C. C.; Cristaldo, M. F.; Jesus, L. 2017. Redes Neurais Artificiais na Previsão de Queimadas e Incêndios no Pantanal. Revista Brasileira de Geografia Física 10(5): 1355-1367.
Wooldridge, J. M. Econometric Analysis of Cross Section and Panel Data. 2. ed. Cambridge: MIT Press, 2010.
Wooster, M. J.; Roberts, G.; Perry, G. L.; Drake, N.; Rebelo, L. M.; Dipotso, F. 2005. Retrieval of fire radiative energy from MODIS: Application to southern African savanna fires using geostationary SEVIRI imagery. Journal of Geophysical Research: Atmospheres 110(D21111).
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

