
15 de setembro de 2026
Padrões de Uso de Cartão de Crédito Convertidos em Perfis Interpretáveis por Clusterização
Jessica Pereira da Silva; Ítalo de Oliveira Braga
DOI: 10.22167/2675-6528-202602233
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A expansão dos meios de pagamento digitais e a intensificação da concorrência entre bancos e fintechs intensificaram a necessidade de compreender a diversidade de comportamentos de uso e relacionamento em cartões de crédito. Este trabalho teve como objetivo aplicar técnicas de análise de cluster em uma base de dados de cartão de crédito para identificar e descrever perfis comportamentais, avaliando a qualidade do agrupamento e produzindo uma segmentação interpretável. A metodologia foi quantitativa e aplicada, conduzida sobre uma base de dados de cartão de crédito, com etapas de análise exploratória, padronização z-score das variáveis numéricas e modelagem principal por K-Means. A escolha do número de clusters foi orientada pelo método do cotovelo (inércia/WCSS) e coeficiente de silhueta, com apoio de visualização por PCA (2D) e verificação de diferenciação entre grupos por ANOVA com tamanho de efeito (η²). Os resultados mostraram uma solução com três clusters que separou perfis principalmente por intensidade e mix de canais e por capacidade de crédito/estrutura de cartões. Identificou-se um grupo predominante com maior participação de visitas ao banco e menor intensidade total, um grupo minoritário com limite elevado e predominância de interações online, e um grupo com limite inferior e alta intensidade de chamadas telefônicas. Concluiu-se que a clusterização permitiu reduzir a complexidade do comportamento observado em perfis comparáveis e mensuráveis, oferecendo uma base objetiva para caracterização de clientes e apoio a decisões orientadas por dados.
Palavras-chave: Clusterização K-Means; Customer analytics; Interações multicanais; Limite de crédito; Segmentação de clientes.
1. Introdução
A expansão dos meios de pagamento digitais e a intensificação da concorrência entre bancos tradicionais, fintechs e emissores de cartão têm transformado o cenário financeiro. Nesse contexto, a crescente sensibilidade dos clientes à experiência de uso tornou a personalização um eixo central das estratégias de relacionamento. Em ambientes onde múltiplas interações são registradas, como compras, frequência, sazonalidade, canais de atendimento, limites e formas de pagamento, a gestão baseada apenas em recortes demográficos ou regras fixas tende a ser insuficiente para explicar a diversidade de comportamentos.
Diante dessa complexidade, organizações que operam com cartão de crédito demandam abordagens analíticas capazes de traduzir grandes volumes de dados comportamentais em perfis interpretáveis. Essa capacidade é crucial para apoiar decisões de negócio relacionadas a ofertas, comunicação, retenção e eficiência operacional, superando as limitações das estratégias genéricas.
A segmentação de clientes é um tema consolidado na literatura de marketing e CRM, reconhecida como um instrumento fundamental para compreender heterogeneidades e orientar a alocação de recursos de forma mais eficaz. A utilidade dos segmentos depende de serem mensuráveis, acionáveis e interpretáveis, contribuindo para decisões de posicionamento e relacionamento (Wedel & Kamakura, 2000).
No contexto de bases ricas em variáveis comportamentais, a segmentação baseada em técnicas de Ciência de Dados amplia a capacidade de capturar padrões não triviais, superando abordagens exclusivamente descritivas. A perspectiva de customer analytics reforça que identificar grupos com necessidades e comportamentos distintos permite elevar a efetividade das ações de relacionamento e otimizar investimentos em aquisição, fidelização e atendimento (Blattberg, Kim & Neslin, 2008).
Entre as técnicas quantitativas aplicadas à segmentação, destacam-se os métodos de aprendizado não supervisionado, especialmente a análise de cluster. Essa abordagem é apropriada quando o objetivo é descobrir estruturas latentes nos dados, sem a necessidade de rótulos prévios. O algoritmo K-means, introduzido por MacQueen (1967), é uma escolha frequente devido à sua simplicidade, escalabilidade e capacidade de produzir partições claras quando aplicado a variáveis numéricas padronizadas.
A literatura de clusterização enfatiza que resultados úteis dependem de decisões metodológicas consistentes, incluindo a seleção de variáveis, padronização de escalas, definição do número de grupos e validação da qualidade dos clusters (Everitt, Landau, Leese & Stahl, 2011). Procedimentos de validação e interpretabilidade são fundamentais para sustentar as conclusões. Métricas como o coeficiente de silhueta (Rousseeuw, 1987) oferecem suporte à avaliação da separação e coesão interna dos grupos. De modo complementar, técnicas de redução de dimensionalidade, como a Análise de Componentes Principais (PCA), são amplamente utilizadas para apoiar a visualização e compreensão dos padrões dominantes nos dados (Jolliffe, 2002). Adicionalmente, análises estatísticas de perfilamento, como a comparação de médias e dispersões entre clusters, podem fortalecer a caracterização dos grupos, tornando-os mais comunicáveis e acionáveis (Hair, Black, Babin & Anderson, 2010; Field, 2013).
Do ponto de vista gerencial, a contribuição esperada de uma segmentação baseada em comportamento de uso de cartão não se limita à descrição de grupos, mas reside em transformar padrões em decisões. A literatura de data-analytic thinking reforça que projetos analíticos bem-sucedidos conectam diretamente método, métricas e decisões, evitando análises que não resultem em ação (Provost & Fawcett, 2013). Assim, ao identificar perfis de comportamento, torna-se possível orientar estratégias como o desenho de campanhas mais aderentes, a priorização de atendimento, os ajustes de comunicação, a seleção de benefícios e as intervenções preventivas para retenção.
Diante desse cenário, a presente pesquisa justifica-se pela necessidade de compreender a diversidade de comportamentos de uso e relacionamento em cartões de crédito, fornecendo uma base objetiva para a caracterização de clientes e o apoio a decisões orientadas por dados. Este estudo teve como objetivo geral aplicar técnicas de análise de cluster a uma base de dados de cartão de crédito para identificar e descrever perfis comportamentais de clientes, avaliando a qualidade da segmentação por métricas apropriadas e comparando, de forma complementar, resultados do K-means com uma abordagem hierárquica.
2. Material e Métodos
A pesquisa caracterizou-se como aplicada, de natureza quantitativa, com caráter descritivo e exploratório. O estudo baseou-se em análise de dados secundários de clientes de cartão de crédito. A etapa analítica foi estruturada em quatro blocos complementares: (i) análise exploratória dos dados, (ii) pré-processamento, incluindo tratamento de inconsistências, padronização e seleção de variáveis, (iii) modelagem por clusterização, com aplicação do K-means como método principal e comparação complementar com método hierárquico, e (iv) interpretação e perfilamento dos clusters.
A base de dados foi composta por registros em nível de cliente, obtidos de um dataset público (Kaggle), estruturados em formato tabular. Incluiu um identificador do cliente (Customer Key) e variáveis comportamentais e de relacionamento, como limite de crédito médio (Avg_Credit_Limit), quantidade de cartões (Total_Credit_Cards) e indicadores de interação por canal (Total_visits_bank, Total_visits_online, Total_calls_made). A unidade de análise foi o cliente, e um dicionário de tradução das colunas para o português foi elaborado para padronização. O estudo utilizou dados secundários.
As variáveis do estudo foram organizadas em um dicionário de tradução, incluindo: (i) IDs/chaves (Id_Linha, Chave_Cliente), utilizadas apenas para rastreabilidade e não para o cálculo de distância; (ii) variáveis originais do dataset (limite de crédito médio, quantidade de cartões e interações por canal); e (iii) features derivadas determinísticas (interações totais, proporções por canal, razões entre canais, limite por cartão, interações por cartão e logaritmo do limite de crédito). Variáveis simuladas (como tempo de relacionamento, idade, renda anual, gasto médio mensal, taxa de utilização do limite, taxa de atraso de pagamento, score de crédito, taxa de uso de recompensas e reclamações em 12 meses) foram incluídas quando presentes. Colunas de saída dos modelos (cluster_kmeans e cluster_hier) foram reservadas para análise posterior. A base final apresentou predominância de variáveis numéricas e uma variável categórica (Segmento_Canal), reservada para interpretação e rotulagem dos perfis, sem integrar o cálculo de distância.
A preparação e pré-processamento dos dados foram realizados em ambiente Python para assegurar consistência e comparabilidade. Incluíram verificações estruturais, separação de variáveis numéricas e categóricas, rotinas de limpeza (checagem de duplicidades, conferência de identificadores, inspeção de valores ausentes/inconsistências e avaliação de outliers). As variáveis destinadas ao modelo principal foram organizadas em uma matriz apenas com atributos numéricos. Por fim, aplicou-se padronização por z-score (média zero e desvio-padrão um) via StandardScaler para evitar que variáveis em escalas diferentes dominassem a medida de distância do algoritmo.
A análise exploratória dos dados (EDA) foi realizada para compreender a estrutura do conjunto de dados, identificar padrões iniciais de comportamento e subsidiar a seleção de atributos. Incluiu o exame da base quanto à dimensão, tipos de dados, estatísticas resumo e consistência. Foram calculadas medidas de tendência central e dispersão para variáveis numéricas e utilizadas visualizações gráficas (histogramas e boxplots) para identificar assimetrias e outliers. A análise de associação entre variáveis foi conduzida com a correlação de Spearman para investigar redundâncias. Os achados da EDA foram sintetizados em tabelas e gráficos, destacando variáveis com maior poder discriminante potencial e padrões preliminares de comportamento.
Para a clusterização, foram selecionadas variáveis numéricas, excluindo identificadores (Id_Linha, Chave_Cliente) e atributos categóricos (Segmento_Canal) do cálculo de distância, reservando-os para perfilamento e rotulagem. A seleção incluiu variáveis originais (limite médio, quantidade de cartões e interações por canal) e features derivadas (interações totais, proporções por canal, razões entre canais, limite por cartão, interações por cartão e log do limite de crédito) que contribuíram para representar dimensões comportamentais relevantes. As variáveis numéricas foram padronizadas por z-score (média zero e desvio-padrão um) utilizando o StandardScaler, resultando em uma matriz final padronizada para os modelos de agrupamento.
A modelagem principal utilizou o algoritmo K-means, aplicado sobre a matriz padronizada de variáveis numéricas. Para definir o número de clusters (k), foi avaliado um intervalo de candidatos, calculando-se a inércia (within-cluster sum of squares) pelo método do cotovelo e o coeficiente de silhueta. O valor de k foi selecionado com base no desempenho mais consistente entre esses critérios. O modelo final foi estimado com o k escolhido e controle de reprodutibilidade (random_state), gerando rótulos (cluster_kmeans) para cada cliente, que foram incorporados à base para análises subsequentes.
Como modelagem complementar, aplicou-se a clusterização hierárquica aglomerativa, utilizando o método de Ward, sobre a mesma matriz padronizada de variáveis numéricas. O objetivo foi comparar a estrutura de agrupamento com a do K-means e avaliar a coerência da segmentação. O modelo aglomerativo foi ajustado com o número de grupos definido para comparação, gerando rótulos (cluster_hier) incorporados à base para perfilamento e verificação de convergência, servindo como referência de robustez para a validade interpretativa da segmentação.
O perfilamento dos clusters foi realizado para descrever e interpretar as características de cada grupo. Os rótulos gerados (cluster_kmeans e cluster_hier) foram incorporados à base para sumarização estatística e comparação. O perfilamento incluiu o cálculo de estatísticas descritivas por cluster (médias, medianas e dispersões de variáveis numéricas selecionadas, como limite de crédito, número de cartões, volume e composição das interações por canal, e features derivadas). Variáveis categóricas como Segmento_Canal foram usadas para rotular e caracterizar os grupos. Testes de comparação entre grupos, como ANOVA, foram aplicados para identificar diferenças estatisticamente relevantes e variáveis discriminantes. Por fim, os métodos K-means e hierárquico foram comparados para verificar convergências e divergências, reforçando a escolha do modelo principal.
A análise foi executada em ambiente Python, utilizando bibliotecas como pandas e numpy para manipulação de dados, matplotlib para visualização, e scikit-learn para modelagem e validação de clusters (incluindo StandardScaler, K-means, clusterização hierárquica aglomerativa, PCA e cálculo do coeficiente de silhueta). Rotinas estatísticas, como ANOVA, foram empregadas para apoio ao perfilamento e comparação. Os critérios gerais adotados incluíram: padronização por z-score para todas as variáveis numéricas; definição do número de clusters por método do cotovelo (inércia) e coeficiente de silhueta; controle de reprodutibilidade pela fixação de semente aleatória (random_state); e uso de variáveis categóricas apenas para interpretação e rotulagem dos perfis, sem compor a distância do modelo principal.
3. Resultados e Discussão
A análise foi conduzida a partir da base cartao_credito_enriquecida.csv, composta por 660 registros e 28 variáveis relacionadas a limite de crédito, quantidade de cartões e interações por canal (banco, online e telefone). Não foram identificados valores ausentes no conjunto de dados, permitindo avançar diretamente para a exploração das distribuições e dispersões das variáveis, conforme detalhado na Tabela 1.
Tabela 1. Estatística descritiva das variáveis principais (média, mediana, desvio padrão, mínimo, P25, P75 e máximo).
| Variável (relatório) | Variável (base) | Média | Mediana | Desvio Padrão | Mínimo | P25 | P75 | Máximo |
|---|---|---|---|---|---|---|---|---|
| Limite_Credito_Medio | Avg_Credit_Limit | 3454.24 | 18000 | 37625.49 | 3000 | 100 | 48000 | 200000 |
| Qtde_Cartoes_Credito | Total_Credit_Cards | 4.71 | 5 | 2.17 | 1 | 3 | 6 | 10 |
| Visitas_Banco_Total | Total_visits_bank | 2.4 | 2 | 1.63 | 0 | 1 | 4 | 5 |
| Visitas_Online_Total | Total_visits_online | 2.61 | 2 | 2.94 | 0 | 1 | 4 | 15 |
| Chamadas_Total_de | Total_calls_made | 3.58 | 3 | 2.87 | 0 | 1 | 5 | 10 |
| Interacoes_Totais | Total_Interactions | 8.59 | 8 | 3.41 | 2 | 6 | 11 | 19 |
| Limite_Por_Cartao | Limit_per_Card | 7200.18 | 5666.67 | 5454.32 | 714.29 | 300 | 9999.99 | 49999.98 |
| Proporcao_Online | Online_Share | 0.2586 | 0.25 | 0.223 | 0 | 0.125 | 0.333 | 1 |
| Proporcao_Banco | Bank_Share | 0.3642 | 0.375 | 0.287 | 0 | 0.0909 | 0.5714 | 1 |
| Proporcao_Telefone | Call_Share | 0.3772 | 0.4 | 0.233 | 0 | 0.1667 | 0.5714 | 0.8889 |
| Razao_Online_Banco | Online_to_Bank_Ratio | 1.4776 | 0.5 | 2.3789 | 0 | 0.1917 | 2 | 15 |
| Razao_Telefone_Online | Calls_to_Online_Ratio | 1.2966 | 1 | 1.0614 | 0 | 0.5 | 2 | 4 |
| Canais_Utilizados | Channels_Used | 2.48 | 3 | 0.6 | 1 | 2 | 3 | 3 |
| Interacoes_Por_Cartao | Interactions_per_Card | 2.91 | 1.5 | 3.21 | 0.29 | 1 | 3.5 | 16 |
| Log_Limite_Credito | Log_Credit_Limit | 10 | 9.8 | 0.93 | 8.01 | 9.21 | 10.78 | 12.21 |
| Idade_sim | Age_sim | 35.88 | 36 | 9.51 | 18 | 30 | 42 | 65 |
Fonte: Resultados originais da pesquisa
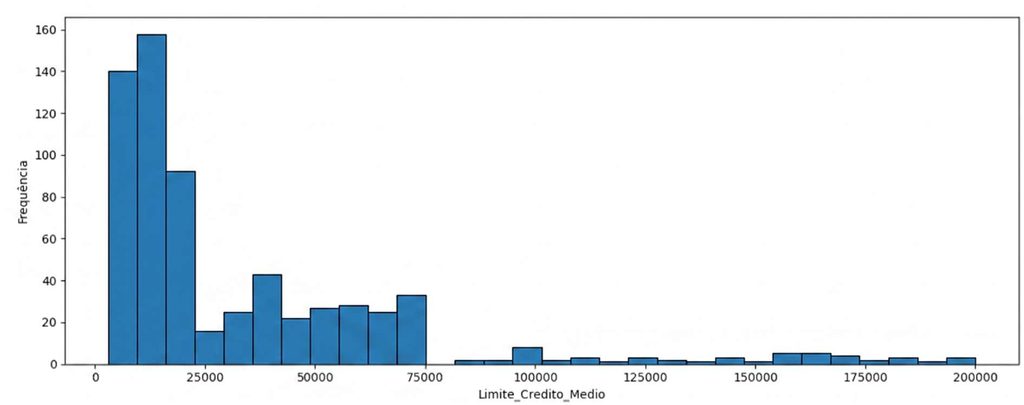
O Limite de Crédito Médio apresenta elevada heterogeneidade entre os registros. Observa-se concentração de valores em faixas mais baixas, acompanhada de uma cauda longa com poucos casos em valores muito elevados, caracterizando assimetria à direita, conforme Figura 1.
Figura 1. Distribuição do Limite_Credito_Medio.
Fonte: Resultados originais da pesquisa
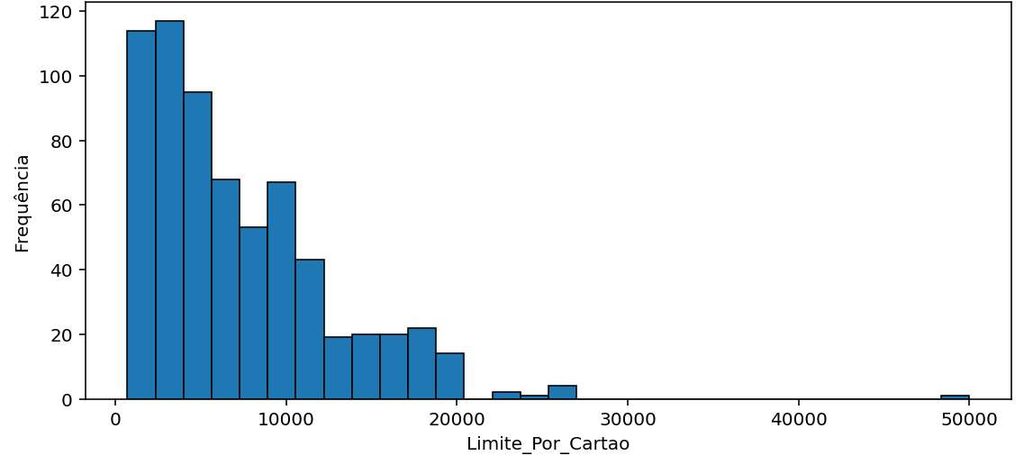
Como complemento, o Limite por Cartão também evidencia assimetria e dispersão relevantes, pois combina o efeito do limite total com o número de cartões. A presença de valores extremos nessa variável é coerente com a observada no limite médio, indicando que alguns registros apresentam uma relação limite/cartão substancialmente superior ao padrão da amostra, vide Figura 2.
Figura 2. Distribuição do Limite_Por_Cartao.
Fonte: Resultados originais da pesquisa
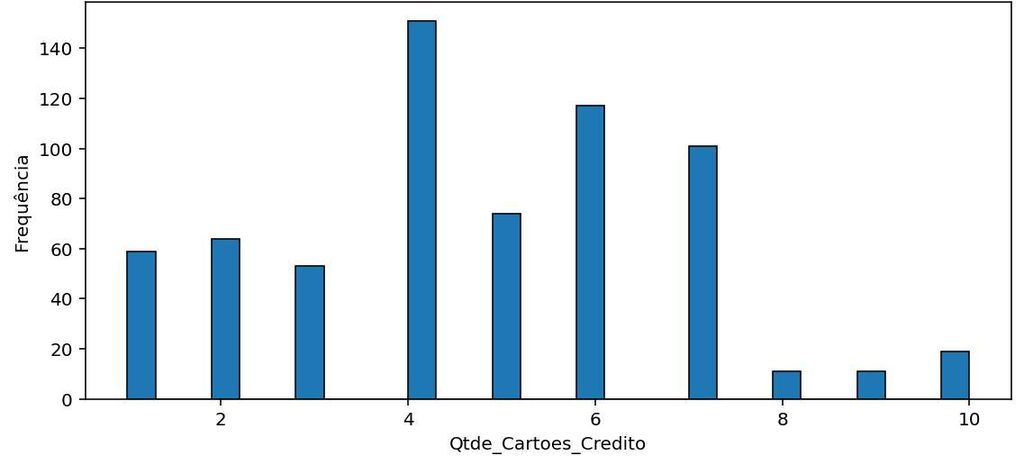
A variável Qtde_Cartoes_Credito é discreta e se concentra em valores intermediários, com ocorrência menor nas extremidades, conforme demonstrado na Figura 3. Essa característica sugere que a amostra possui predominância de clientes com quantidade moderada de cartões, enquanto poucos registros exibem valores muito baixos ou muito altos.
Figura 3. Distribuição da Qtde_Cartoes_Credito.
Fonte: Resultados originais da pesquisa
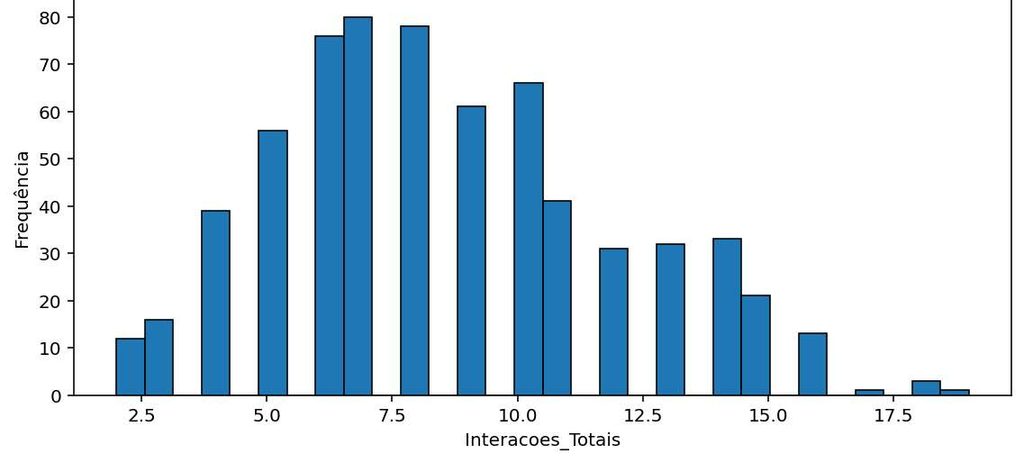
Na Figura 4, a variável Interacoes_Totais (soma de visitas ao banco, visitas online e chamadas) apresenta variação ampla e indica diferentes intensidades de relacionamento com os canais. O histograma mostra uma distribuição com maior concentração em faixas intermediárias, mas com amplitude suficiente para diferenciar grupos com baixa, média e alta intensidade de contato.
Figura 4. Distribuição de Interacoes_Totais.
Fonte: Resultados originais da pesquisa
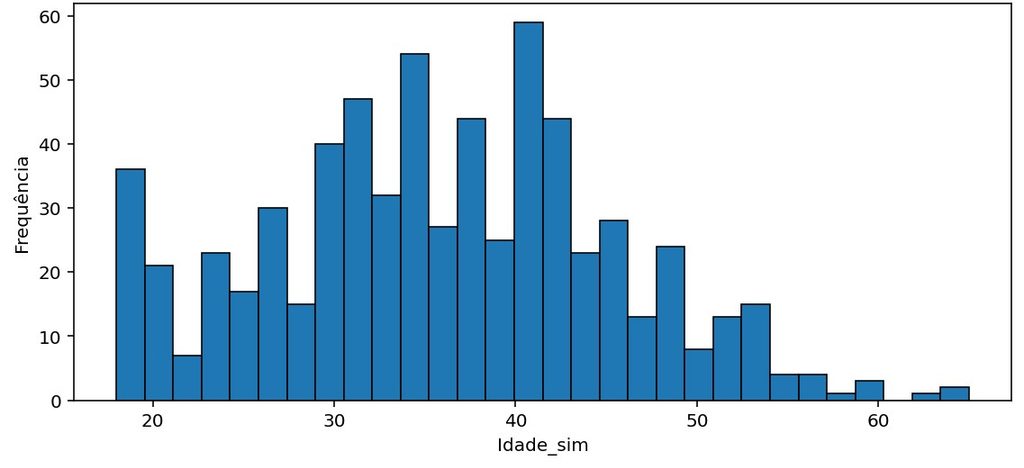
A variável Idade_sim apresenta distribuição distribuída ao longo das faixas etárias da base, com maior concentração em idades adultas, conforme observado na Figura 5. Por se tratar de variável simulada/enriquecida, ela é utilizada nesta etapa apenas como apoio interpretativo e de caracterização do conjunto.
Figura 5. Distribuição de Idade_sim.
Fonte: Resultados originais da pesquisa
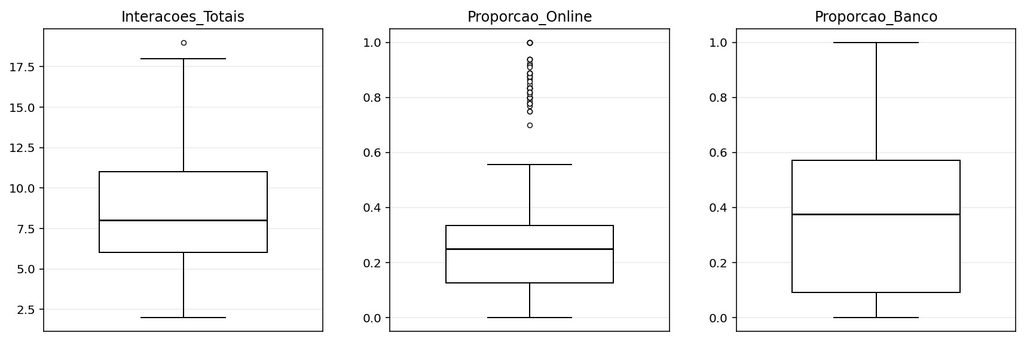
Na Figura 6, a inspeção por boxplots confirma diferenças de escala, dispersão e presença de pontos extremos nas variáveis analisadas. Em especial, as variáveis de limite e algumas métricas derivadas (proporções/razões) tendem a apresentar maior variabilidade, reforçando a necessidade de tratamento por padronização antes da modelagem de cluster.
Figura 6. Boxplots das principais variáveis analisadas na EDA.
Fonte: Resultados originais da pesquisa
Ao final desta etapa, a análise exploratória dos dados (EDA) forneceu evidências de: (i) heterogeneidade no limite de crédito e em métricas derivadas; (ii) padrões discretos e concentrados na quantidade de cartões; (iii) ampla variabilidade na intensidade de interações; e (iv) presença de dispersão e valores extremos em algumas variáveis. Esses achados orientaram a etapa seguinte, na qual foram definidos critérios para padronização e escolha do número de clusters com base em métricas internas.
Após a análise exploratória, foi realizada a definição do número de clusters a ser utilizado no agrupamento. Para isso, calcularam-se soluções de K-Means para diferentes valores de k e avaliou-se o comportamento da inércia (WCSS) e do coeficiente médio de silhueta, com o objetivo de identificar um ponto de equilíbrio entre simplicidade do modelo e qualidade de separação dos grupos.
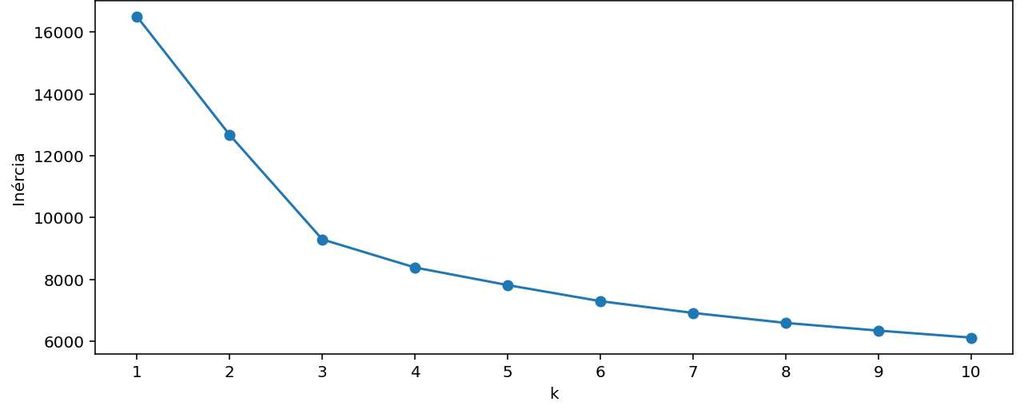
A Figura 7 apresenta o gráfico do método do cotovelo, no qual se observa a redução da inércia à medida que o número de clusters aumenta. O comportamento do traçado indica uma queda mais acentuada nos primeiros valores de k, seguida de ganhos marginais menores conforme os clusters adicionais passam a capturar variações mais finas dos dados.
Figura 7. Elbow (Inércia / WCSS).
Fonte: Resultados originais da pesquisa
A Tabela 2 apresenta os valores numéricos associados à inércia para cada k, permitindo reprodutibilidade e comparação.
Tabela 2. Inércia (WCSS) por número de clusters (k).
| K | Inércia (WCSS) |
|---|---|
| 2 | 12932.25 |
| 3 | 9292.39 |
| 4 | 8384.19 |
| 5 | 8148.81 |
| 6 | 7580.52 |
| 7 | 7153.64 |
| 8 | 6730.62 |
| 9 | 6402.56 |
| 10 | 6265.53 |
Fonte: Resultados originais da pesquisa
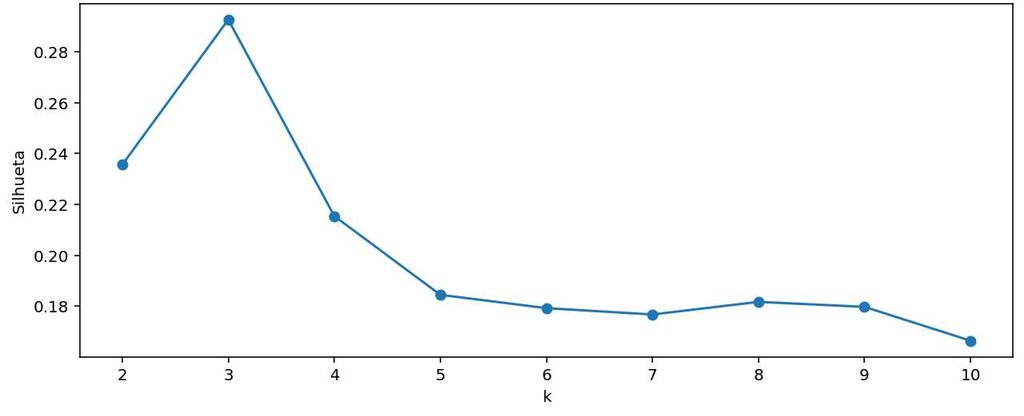
Em complemento, foi calculada a silhueta média para k ≥ 2, apresentada na Figura 8. A silhueta avalia simultaneamente a coesão interna e a separação entre clusters. Observa-se que o melhor desempenho ocorre em um valor específico de k, indicando a configuração com maior separação média entre os grupos no espaço das variáveis padronizadas.
Figura 8. Silhueta média (k≥2).
Fonte: Resultados originais da pesquisa
A Tabela 3 apresenta os valores de silhueta em formato tabular para documentar a comparação entre soluções.
Tabela 3. Silhueta média por número de clusters (k).
| K | Silhueta_média |
|---|---|
| 2 | 0.4292 |
| 3 | 0.2926 |
| 4 | 0.2154 |
| 5 | 0.2023 |
| 6 | 0.1729 |
| 7 | 0.1583 |
| 8 | 0.1679 |
| 9 | 0.1754 |
| 10 | 0.1531 |
Fonte: Resultados originais da pesquisa
Com base na leitura conjunta dos dois critérios (redução de inércia e silhueta média), selecionou-se o valor de k que apresenta desempenho superior na silhueta e comportamento coerente no gráfico de cotovelo. Essa escolha orientou a etapa seguinte, na qual o agrupamento final foi aplicado e visualizado por redução de dimensionalidade.
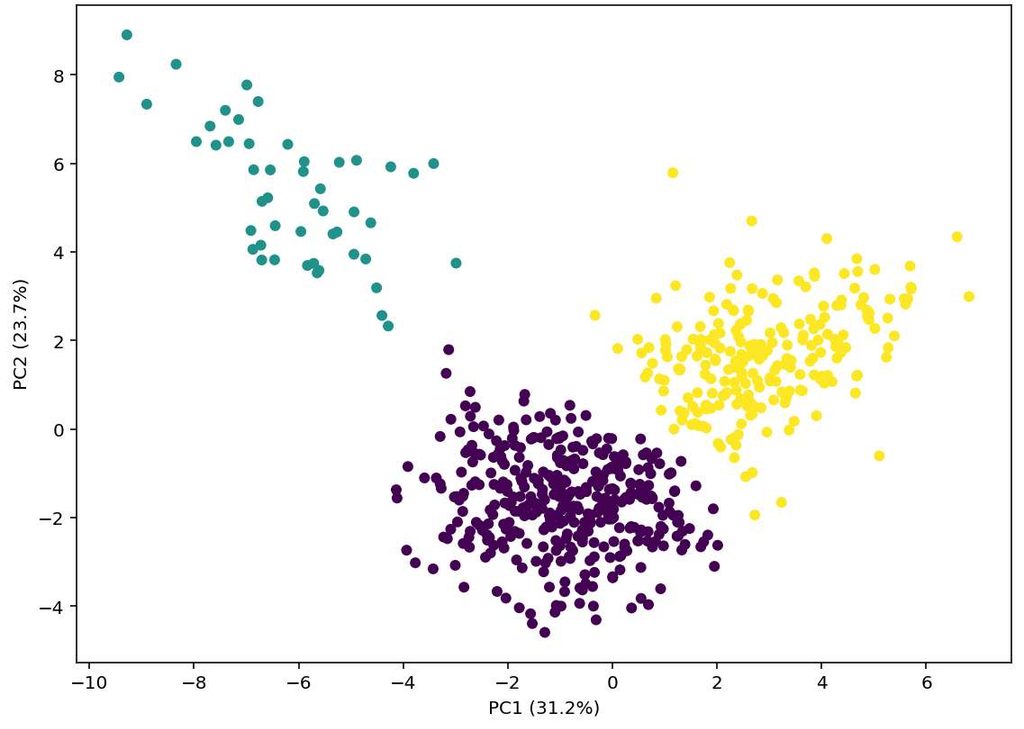
Após a definição do número de clusters, aplicou-se o K-Means com o valor de k selecionado e, na sequência, utilizou-se a Análise de Componentes Principais (PCA) como técnica de apoio para visualizar a separação dos grupos em duas dimensões. A PCA foi aplicada sobre as variáveis numéricas padronizadas (z-score), reduzindo a dimensionalidade do conjunto para componentes que concentram a maior parcela possível da variância total.
A Tabela 4 apresenta a variância explicada por cada componente principal utilizada na visualização (PC1 e PC2), bem como o percentual acumulado. Esses valores indicam quanto da informação do conjunto original é preservada quando os dados são projetados no plano bidimensional.
Tabela 4. Variância explicada pelo PCA (PC1, PC2 e acumulada).
| Componente | Variância explicada | Variância explicada (%) |
|---|---|---|
| PC1 | 0,311732 | 31,17 |
| PC2 | 0,236571 | 23,66 |
| Acumulado (PC1+PC2) | 0,548302 | 54,83 |
Fonte: Resultados originais da pesquisa
A Figura 9 apresenta o gráfico de dispersão dos registros no plano formado por PC1 e PC2, com as cores indicando a classificação atribuída pelo K-Means. A visualização permite observar o grau de separação entre os grupos, bem como regiões de maior sobreposição ou concentração de pontos.
Figura 9. PCA (2D): dispersão por cluster.
Fonte: Resultados originais da pesquisa
De forma descritiva, observa-se que os registros se organizam em regiões distintas do plano, evidenciando que os clusters obtidos capturam diferenças relevantes no conjunto de variáveis analisadas. Além disso, a presença de zonas com maior densidade de pontos em determinados grupos sugere padrões dominantes compartilhados por subconjuntos de registros, enquanto áreas com menor densidade indicam perfis menos frequentes.
Após a aplicação do K-Means com o número de clusters definido, realizou-se a análise das variáveis que mais contribuem para diferenciar os grupos formados. Para isso, foi aplicada ANOVA unidirecional comparando as médias das variáveis numéricas entre os clusters, com o objetivo de identificar quais variáveis apresentam diferenças estatisticamente relevantes entre os grupos. Além do valor de significância, foi reportado o tamanho de efeito (η²), que quantifica a proporção da variância explicada pela separação em clusters.
A Tabela 5 apresenta, para cada variável analisada, o valor da estatística F, o p-valor e o η². Esse conjunto de indicadores permite identificar não apenas se há diferença entre grupos, mas também o quanto essa diferença é expressiva.
Tabela 5. ANOVA por variável (F, p-valor e n²), ordenada por n².
| Variável | F | p_valor | eta2 |
|---|---|---|---|
| Total_visits_online | 1475,4154 | 1,0348E-243 | 0,8179 |
| Avg_Credit_Limit | 884,6022 | 4,1839E-187 | 0,7292 |
| Total_Credit_Cards | 851,1914 | 4,036E-183 | 0,7215 |
| Online_to_Bank_Ratio | 834,5351 | 4,3115E-181 | 0,7175 |
| Online_Share | 812,8615 | 2,0813E-178 | 0,7122 |
| Bank_Share | 777,8104 | 5,8652E-174 | 0,7031 |
| Total_calls_made | 717,7665 | 5,3624E-166 | 0,686 |
| Total_visits_bank | 504,9522 | 1,4878E-133 | 0,6059 |
| Total_Interactions | 424,2318 | 5,0762E-119 | 0,5636 |
| Payment_Delay_Rate_sim | 383,0381 | 5,4296E-111 | 0,5383 |
| Call_Share | 369,3354 | 3,2285E-108 | 0,5293 |
| Interactions_per_Card | 354,2241 | 4,2885E-105 | 0,5188 |
| Log_Credit_Limit | 320,6194 | 6,81159E-98 | 0,4939 |
| Tenure_Years_sim | 298,2946 | 6,70246E-93 | 0,4759 |
| Credit_Score_sim | 244,6749 | 3,84176E-80 | 0,4269 |
| Annual_Income_sim | 190,6389 | 5,14288E-66 | 0,3672 |
| Complaints_12M_sim | 119,8059 | 4,3618E-45 | 0,2672 |
| Limit_per_Card | 104,7814 | 3,18361E-40 | 0,2418 |
| Rewards_Usage_Rate_sim | 98,7625 | 3,15236E-38 | 0,2312 |
| Avg_Monthly_Spend_sim | 76,9689 | 9,28583E-31 | 0,1898 |
| Calls_to_Online_Ratio | 48,9912 | 1,47229E-20 | 0,1298 |
| Age_sim | 35,9507 | 1,52594E-15 | 0,0986 |
| Cards_per_100k_Limit | 23,7271 | 1,12352E-10 | 0,0674 |
| Utilization_Ratio_sim | 15,5905 | 2,42609E-07 | 0,0453 |
| Channels_Used | 14,473 | 7,06295E-07 | 0,0422 |
Fonte: Resultados originais da pesquisa
De modo descritivo, observa-se que as variáveis com maior poder discriminante são majoritariamente associadas a: (i) intensidade de uso de canal digital (visitas online e medidas derivadas), (ii) capacidade de crédito (limite médio e derivadas), (iii) estrutura de produto (quantidade de cartões), e (iv) mix de canal (proporções e razões). Esse padrão indica que a segmentação está fortemente orientada por diferenças no comportamento de relacionamento e no perfil de limite/produto. As variáveis com maiores valores de η² (por exemplo, as 8–12 primeiras) concentram maior variação explicada pela segmentação, sendo o conjunto principal de diferenciação entre os clusters.
Após identificar as variáveis com maior capacidade de diferenciação entre os clusters, procedeu-se ao perfilamento dos grupos, isto é, à descrição objetiva das características de cada cluster com base em medidas-resumo (principalmente média e mediana) das variáveis centrais do estudo. Essa etapa permite transformar a saída do algoritmo em perfis interpretáveis, destacando como os grupos se distinguem em termos de limite, quantidade de cartões e padrão de interação por canal.
Inicialmente, a Tabela 6 apresenta a distribuição dos registros por cluster, indicando o número de observações em cada grupo e sua participação percentual no total da amostra.
Tabela 6. Distribuição dos registros por cluster (n e %).
| Cluster | N | % |
|---|---|---|
| 0 | 385 | 58,33 |
| 1 | 49 | 7,42 |
| 2 | 226 | 34,24 |
| Total | 660 | 100 |
Fonte: Resultados originais da pesquisa
Na sequência, a Tabela 7 apresenta as medidas de tendência central e dispersão por cluster (por exemplo, médias e medianas) para as variáveis mais relevantes do ponto de vista analítico: Avg_Credit_Limit, Total_Credit_Cards, Total_Interactions, Total_visits_online, Total_visits_bank, Total_calls_made, além das variáveis derivadas (Online_Share, Bank_Share, Call_Share, Online_to_Bank_Ratio, Limit_per_Card).
Tabela 7. Perfil dos clusters (médias e/ou medianas por variável).
| Cluster | Avg_Credit_Limit | Total_Credit_Cards | Total_visits_bank | Total_visits_online | Total_calls_made | Total_Interactions | Online_Share | Bank_Share | Call_Share | Online_to_Bank_Ratio | Calls_to_Online_Ratio | Limit_per_Card | Interactions_per_Card | Channels_Used | Log_Credit_Limit | Age_sim | Annual_Income_sim | Credit_Score_sim |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 340 | 5.527 | 3.47 | 0.994 | 1.98 | 6.449 | 0.1 | 0.567 | 0.2427 | 1.2549 | 6.66 | 23 | 1.2152 | 56 | 639 | 37 | 41265 | 729 |
| 1 | 142 | 8.755 | 0.59 | 11 | 1.08 | 12.67 | 0.8 | 0.049 | 0.166 | 7.8163 | 0.0943 | 61.3 | 602 | 1.4787 | 53 | 338 | 42.7831 | 818 |
| 2 | 127 | 2.429 | 0.97 | 3.531 | 6.85 | 11.35 | 0.3 | 0.086 | 0.6 | 2.2069 | 1.6282 | 7.34 | 8 | 6.1121 | 6 | 2 | 32.2832 | 1814 |
| Total | 345 | 4.706 | 2.40 | 2.606 | 3.58 | 8.592 | 0.2 | 0.364 | 0.3 | 1.4776 | 1.2966 | 720 | 0.18 | 28 | 2.9116 | 33 | 62 | 35.9816 |
Fonte: Resultados originais da pesquisa
De forma descritiva, essa tabela permite observar diferenças consistentes entre os grupos, especialmente em relação a: (i) capacidade de crédito (níveis de Avg_Credit_Limit e Limit_per_Card), (ii) estrutura de produto (quantidade de cartões), e (iii) padrão de interação (intensidade total e predominância de canal).
O Cluster 0 (n=385; 58,33%) apresenta um Avg_Credit_Limit médio de 34.083,12 e Total_Interactions de 6,45. Este grupo demonstra maior presença de interações no canal físico (Total_visits_bank 3,47) com baixa atividade online (Total_visits_online 0,99). Seu mix de canal confirma esse padrão: Bank_Share 0,5674, Online_Share 0,1496, Call_Share 0,2831, e uma Online_to_Bank_Ratio baixa (0,2427). Trata-se de um grupo predominantemente “banco-centrado”, com menor intensidade total de contato quando comparado aos demais.
O Cluster 1 (n=49; 7,42%) é o grupo mais distinto e concentrado em perfis de alta capacidade: Avg_Credit_Limit médio de 142.061,22 e Total_Credit_Cards de 8,76. Em comportamento de canal, apresenta Total_visits_online 11,00, quase sem visitas ao banco (Total_visits_bank 0,59) e poucas chamadas (Total_calls_made 1,08). O mix de canal confirma dominância digital (Online_Share 0,8664) e uma razão online/banco extremamente elevada (Online_to_Bank_Ratio 7,8163). Esse perfil é coerente com a lógica de segmentação comportamental em customer analytics, na qual grupos de “alto valor” tendem a ser identificados combinando capacidade (limite/produtos) e padrão de interação (Blattberg, Kim, & Neslin, 2008).
O Cluster 2 (n=226; 34,24%) contrasta fortemente com o Cluster 1 no que se refere ao canal de suporte: Avg_Credit_Limit médio de 12.106,19 (mais baixo), Total_Credit_Cards de 2,43 e Total_Interactions de 11,36, alta intensidade, porém concentrada em Total_calls_made (6,85). O mix de canal evidencia predominância do telefone (Call_Share 0,6011), com participação online moderada (Online_Share 0,3127) e baixa participação de banco (Bank_Share 0,0863). Esse padrão sugere um grupo cuja jornada de relacionamento ocorre mais por contato reativo (chamadas), o que, em termos analíticos, costuma sinalizar maior necessidade de suporte, dúvidas operacionais ou maior fricção na experiência e hipóteses que devem ser verificadas com variáveis de motivo de contato, reclamações ou status de serviço, caso existam (Provost & Fawcett, 2013).
A solução de clusterização obtida a partir da base cartao_credito_enriquecida.csv evidenciou heterogeneidade substantiva no comportamento de relacionamento e no perfil de crédito dos registros. Na etapa de validação interna, a silhueta média apresentou o maior valor em k=2 (0,4292), com queda em k=3 (0,2926) e valores ainda menores para k mais altos. Esse padrão é comum em dados comportamentais com sobreposição entre perfis: a silhueta tende a favorecer soluções mais “grossas” (menos grupos), enquanto soluções com mais clusters podem capturar nuances ao custo de menor separação média (Rousseeuw, 1987; Hennig, Meila, Murtagh, & Rocci, 2015). Ainda assim, a escolha de k=3 se sustenta quando se considera o equilíbrio entre qualidade e interpretabilidade, uma recomendação recorrente na literatura aplicada de segmentação: clusters devem ser úteis, acionáveis e comunicáveis, não apenas “ótimos” em uma métrica isolada (Wedel & Kamakura, 2000). A redução de dimensionalidade via PCA ajudou a checar a coerência do agrupamento no plano bidimensional. Os dois primeiros componentes explicaram 54,83% da variância (PC1=31,17%; PC2=23,66%), o que é adequado para visualização exploratória sem pretender esgotar a estrutura do dado (Jolliffe, 2002). A etapa de ANOVA por variável reforçou que os clusters encontrados se diferenciam de modo consistente e, principalmente, por quais dimensões. As maiores magnitudes de tamanho de efeito (η²) concentraram-se em variáveis relacionadas ao canal digital e ao limite/produto: Total_visits_online (η²=0,8179), Avg_Credit_Limit (η²=0,7292), Total_Credit_Cards (η²=0,7215), Online_to_Bank_Ratio (η²=0,7175) e Online_Share (η²=0,7122). Em leitura aplicada, isso indica que a segmentação foi guiada por diferenças estruturais na intensidade de uso online, na capacidade de crédito e na estrutura de cartões, com forte papel das métricas derivadas de composição de canal (Hair et al., 2010; Field, 2013).
Em síntese, os resultados mostram que a segmentação por cluster, aplicada a variáveis numéricas e derivadas de comportamento, produziu uma estrutura de três perfis bem definidos por: (i) predominância de canal (banco vs online vs telefone), (ii) intensidade total de interações e (iii) capacidade/estrutura de crédito. Esse conjunto de evidências (métricas internas, PCA e ANOVA com η²) atende ao que a literatura recomenda como mínimo para sustentar uma segmentação quantitativa: solução estável/justificada, diferenças mensuráveis entre grupos e perfilamento interpretável (Wedel & Kamakura, 2000; Hair et al., 2010; Hennig et al., 2015).
4. Conclusão
O presente estudo buscou aplicar técnicas de análise de cluster a uma base de dados de cartão de crédito para identificar e descrever perfis comportamentais de clientes, avaliando a qualidade da segmentação por métricas apropriadas e apoiando a interpretação por análises estatísticas complementares. Verificou-se uma solução de agrupamento com três clusters, que organizou os registros em perfis distintos, principalmente pela intensidade e mix de canais de interação, bem como pela capacidade de crédito e estrutura de cartões. Identificou-se um grupo majoritário com maior participação de visitas ao banco e menor intensidade total de contato, um grupo minoritário com limite elevado e predominância de interações online, e um grupo com limite inferior e alta intensidade de chamadas telefônicas. Essa diferenciação foi consistentemente sustentada pela análise de variância, que apontou variáveis como visitas online, limite de crédito e quantidade de cartões como os principais discriminadores entre os grupos. A clusterização permitiu reduzir a complexidade do comportamento observado em perfis comparáveis e mensuráveis, oferecendo uma base objetiva para a caracterização de clientes e o apoio a decisões orientadas por dados em iniciativas de relacionamento e gestão.
Contudo, o estudo esteve condicionado às variáveis disponíveis em uma base de dados secundária e à natureza dos algoritmos de agrupamento, que envolvem julgamento analítico na definição do número de clusters, mesmo com o suporte de métricas internas. A escolha de três clusters privilegiou o equilíbrio entre qualidade e interpretabilidade gerencial, reconhecendo trade-offs entre separação e granularidade. Para estudos futuros, recomenda-se aprofundar a validação externa do agrupamento com variáveis de desempenho, risco ou retenção, testar soluções alternativas de clusterização e verificar a estabilidade temporal dos perfis, caso dados multiperíodo estejam disponíveis. Tais abordagens podem enriquecer a compreensão dos padrões de uso e relacionamento, ampliando a robustez e a aplicabilidade da segmentação.
Referências Bibliográficas
Blattberg, R. C., Kim, B.-D., & Neslin, S. A. 2008. Database marketing: Analyzing and managing customers. New York, NY, USA: Springer.
Everitt, Landau, Leese & Stahl, 2011 [Referência completa não encontrada no documento original]
Field, A. 2013. Discovering statistics using IBM SPSS statistics (4th ed.). London, UK: SAGE Publications.
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. 2010. Multivariate data analysis (7th ed.). Upper Saddle River, NJ, USA: Pearson.
Hennig, C., Meila, M., Murtagh, F., & Rocci, R., eds. 2015. Handbook of cluster analysis. Boca Raton, FL, USA: CRC Press.
Jolliffe, I. T. 2002. Principal component analysis (2nd ed.). New York, NY, USA: Springer.
MacQueen, J. 1967. Some methods for classification and analysis of multivariate observations. In L. M. Le Cam & J. Neyman, eds., Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, Volume 1: Statistics (pp. 281–297). Berkeley, CA, USA: University of California Press.
Provost, F., & Fawcett, T. 2013. Data science for business: What you need to know about data mining and data-analytic thinking. Sebastopol, CA, USA: O’Reilly Media.
Rousseeuw, P. J. 1987. Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65.
Wedel, M., & Kamakura, W. A. 2000. Market segmentation: Conceptual and methodological foundations (2nd ed.). Boston, MA, USA: Kluwer Academic Publishers.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

