
12 de agosto de 2026
Modelo preditivo da rotatividade em uma empresa de telecomunicações no Nordeste brasileiro
Tayná Mendonça Marques de Lima; Cristiana Correa Dias Lopes
DOI: 10.22167/2675-6528-202601462
Artigo elaborado pela ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege voltada à síntese e redação.
Resumo
A rotatividade de colaboradores representa um desafio significativo para a gestão de pessoas, impactando custos e a retenção de conhecimento institucional. O estudo teve como objetivo analisar os fatores associados ao desligamento geral em uma empresa de telecomunicação no Nordeste brasileiro, propondo um modelo preditivo com base em técnicas de People Analytics e Machine Learning. Conduziu-se uma pesquisa quantitativa, descritiva e exploratória, utilizando dados organizacionais anonimizados de 2.519 colaboradores, coletados entre junho de 2021 e junho de 2025. As informações incluíram variáveis demográficas e ocupacionais, como idade, gênero, tempo de casa, função e salário. Para estimar a probabilidade de desligamento, aplicaram-se os algoritmos de regressão logística, Random Forest e Gradient Boosted Trees. Os resultados indicaram que o modelo Random Forest obteve o melhor desempenho preditivo, alcançando uma acurácia de 80,2%. A variável mais relevante identificada foi o Tempo de Casa, que demonstrou maior probabilidade de saída entre colaboradores nos primeiros meses de empresa. Observou-se também uma concentração de colaboradores de alto risco em funções operacionais, como vendas, atendimento e áreas técnicas. Concluiu-se que os modelos preditivos desenvolvidos oferecem um suporte valioso para a tomada de decisão estratégica na gestão de pessoas, possibilitando a identificação antecipada de padrões de risco de desligamento e o desenvolvimento proativo de estratégias de retenção de talentos.
Palavras-chave: Análise de dados; Aprendizado de máquina; People Analytics; Retenção de talentos; Turnover.
1. Introdução
A gestão de pessoas enfrenta um desafio significativo na rotatividade de colaboradores, ou turnover, que impacta diretamente a sustentabilidade organizacional. Este fenômeno, caracterizado pela constante entrada e saída de pessoal, gera custos substanciais de desligamento e novas contratações, além de provocar a perda de conhecimento institucional tácito, um recurso de difícil documentação e reposição (Chiavenato, 2014; Sexton et al., 2005; Ndatshe et al., 2024). Tais impactos estendem-se à produtividade, ao clima organizacional e à capacidade de inovação da empresa. A área de Recursos Humanos (RH) tem evoluído de uma função meramente administrativa para um papel estratégico, utilizando dados para embasar decisões e antecipar tendências, como a retenção de talentos (Ulrich e Dulebohn, 2015; Lee e Lee, 2024). Prever e gerenciar a rotatividade tornou-se, assim, um imperativo para a competitividade.
Neste contexto, o People Analytics surge como uma abordagem inovadora, aplicando técnicas estatísticas e analíticas a grandes volumes de dados sobre colaboradores para identificar padrões, prever comportamentos e otimizar a gestão de pessoas (Kobayachi et al., 2023). A premissa é que a análise de dados aprofundada supera a intuição, fornecendo insights acionáveis e impulsionando a produtividade e lucratividade das empresas (McAfee e Brynjolfsson, 2012). Complementarmente, o Machine Learning, um ramo da inteligência artificial, capacita sistemas a aprenderem com dados para executar tarefas preditivas (Junior, 2025). Na gestão de pessoas, algoritmos como Regressão Logística, Random Forest e Gradient Boosted Trees são empregados para construir modelos que estimam a probabilidade de desligamento. Estes algoritmos são eficazes em lidar com múltiplas variáveis e identificar relações complexas em grandes conjuntos de dados, tornando-se ferramentas poderosas para a predição de turnover (Benabou et al., 2025; Narkbunnum e Hinthaw, 2025). A integração dessas disciplinas oferece um arcabouço robusto para uma gestão de talentos proativa.
O setor de telecomunicações no Brasil, especialmente na região Nordeste, apresenta um ambiente que intensifica a rotatividade, caracterizado por alta competitividade, rápida evolução tecnológica e desafios no equilíbrio entre vida pessoal e profissional, que contribuem para o desgaste e insatisfação dos colaboradores (Rodrigues et al., 2018; Nunes e Lira, 2024). Dados empíricos revelam que a predominância de colaboradores jovens e em funções operacionais, como vendas, atendimento e áreas técnicas, é um fator relevante. Observa-se que a maior parte dos desligamentos ocorre nos primeiros meses de vínculo empregatício, com cerca de 57% dos colaboradores tendo menos de um ano de empresa e a faixa etária predominante entre vinte e cinco e trinta anos (Rombaut e Guerry, 2018; Syce, 2012). A estrutura salarial, majoritariamente com vencimentos até dois mil reais, sugere uma base operacional onde a pressão por desempenho e a satisfação com a remuneração são críticas para a permanência (Chiavenato, 2014; Rombaut e Guerry, 2018). Apesar da relevância do tema, há uma lacuna na literatura brasileira sobre a aplicação de People Analytics e Machine Learning para prever o turnover especificamente em empresas de telecomunicações no Nordeste, o que este estudo busca abordar.
A complexidade da rotatividade e seus impactos negativos, somados à lacuna de estudos preditivos no setor de telecomunicações do Nordeste, evidenciam a necessidade de ferramentas para uma gestão estratégica e proativa. A identificação antecipada de colaboradores com maior probabilidade de desligamento e dos fatores que influenciam essa decisão permite a implementação de estratégias de retenção mais eficazes, mitigando custos e preservando o capital intelectual. Assim, este estudo justifica-se pela urgência em fornecer subsídios para a tomada de decisão estratégica em gestão de pessoas, contribuindo para a sustentabilidade e competitividade das empresas regionais. O objetivo deste trabalho é analisar os fatores associados ao desligamento geral em uma empresa de telecomunicação no Nordeste brasileiro, propondo um modelo preditivo com base em técnicas de People Analytics e Machine Learning.
2. Material e Métodos
O presente estudo caracterizou-se como uma pesquisa de natureza quantitativa, fundamentada na análise de dados numéricos e na aplicação de técnicas estatísticas para a compreensão do fenômeno investigado (Pereira et al., 2018). Quanto aos seus objetivos, a pesquisa foi classificada como descritiva e exploratória, buscando descrever padrões e características da rotatividade em uma população específica (Gil, 2008). Adicionalmente, foi de tipo aplicado, visando a resolução de um problema prático por meio da proposição de um modelo preditivo de desligamento de colaboradores (Vergara, 2016). O método empregado foi o estudo de caso, que permitiu uma análise aprofundada de um contexto organizacional particular (Yin, 2015).
A pesquisa foi desenvolvida em uma empresa de telecomunicações de médio porte, com atuação consolidada há aproximadamente cinco anos na região Nordeste do Brasil. O contexto operacional da empresa, marcado por alta competitividade e rápida evolução tecnológica, intensifica os desafios relacionados à gestão de pessoas e à rotatividade. O período de análise dos dados abrangeu quatro anos, especificamente de junho de 2021 a junho de 2025. A unidade de análise do estudo consistiu nos colaboradores da organização, incluindo aqueles que estavam ativos, os que foram admitidos e os que foram desligados durante o intervalo temporal definido para a coleta de dados.
A população e amostra do estudo foram compostas por 2.519 colaboradores que estiveram vinculados à empresa no período de junho de 2021 a junho de 2025. Deste total, 1.713 colaboradores foram desligados, seja por iniciativa própria ou da organização, durante o intervalo de tempo analisado. Os dados foram obtidos diretamente do setor de Recursos Humanos da empresa, seguindo rigorosos critérios de confidencialidade. Para garantir a privacidade dos indivíduos e a conformidade ética, todas as informações foram previamente anonimizadas e seu uso foi restrito exclusivamente para fins acadêmicos, conforme acordado com a instituição.
Os dados foram coletados a partir de registros organizacionais internos, disponibilizados em formato de planilha eletrônica (Excel), contendo informações demográficas e ocupacionais dos colaboradores. O instrumento de coleta, portanto, foi a própria base de dados da empresa, que forneceu um panorama detalhado do histórico funcional de cada indivíduo. As variáveis selecionadas para análise incluíram idade, gênero, raça, estado civil, regional de atuação, tempo de casa, função exercida, departamento, salário e o número de advertências recebidas. Essas variáveis foram consideradas relevantes para a construção do modelo preditivo de rotatividade.
A execução da pesquisa iniciou-se com o pré-processamento dos dados recebidos. Primeiramente, realizou-se a anonimização completa das informações para proteger a identidade dos colaboradores, seguida pelo tratamento de valores ausentes na base de dados. Em uma etapa subsequente, as variáveis categóricas como funções, regionais e departamentos, que apresentavam grande diversidade, foram agrupadas em categorias mais amplas para otimizar a análise e garantir maior representatividade. A base de dados foi então dividida em subconjuntos de treino e teste, utilizando uma proporção de 70% e 30%, respectivamente, para assegurar a robustez e a validade do modelo preditivo. Todo o processamento foi realizado com o auxílio do software RStudio.
Para a construção do modelo preditivo de rotatividade, aplicaram-se técnicas de People Analytics e Machine Learning. Foram selecionados três algoritmos de classificação amplamente reconhecidos pela sua eficácia em problemas de predição. O primeiro foi a Regressão Logística, adequada para variáveis resposta binárias, como a ocorrência ou não de desligamento (Bianchi, 2023). O segundo algoritmo foi o Random Forest, um método que combina múltiplas árvores de decisão para gerar um resultado mais preciso (Benabou et al., 2025). Por fim, utilizou-se o Gradient Boosted Trees, conhecido por seu alto poder preditivo e capacidade de capturar relações complexas entre variáveis (Narkbunnum e Hinthaw, 2025).
A avaliação da efetividade dos modelos preditivos foi realizada por meio de métricas de desempenho padrão em Machine Learning. Utilizou-se a Matriz de Confusão para visualizar os acertos e erros de cada modelo, permitindo a identificação de falsos positivos e falsos negativos. A taxa de acurácia foi calculada para medir o acerto global dos modelos, indicando a proporção de classificações corretas. Adicionalmente, a área sob a curva ROC (Receiver Operating Characteristic) foi empregada para avaliar a eficiência dos algoritmos no processo de predição, com valores variando de 0,0 a 1,0, onde valores mais próximos de 1,0 indicam maior poder discriminatório (Ramos et al., 2017).
Os procedimentos éticos foram rigorosamente observados durante todo o desenvolvimento do estudo. A anonimização dos dados dos colaboradores foi uma medida primordial para assegurar a confidencialidade e a privacidade das informações, sendo o acesso e o uso dos dados restritos exclusivamente para fins acadêmicos. Contudo, uma limitação metodológica identificada foi a ausência de preenchimento da variável raça/cor em uma proporção significativa da amostra. Essa lacuna nos dados pode impactar a robustez das interpretações relacionadas a essa variável, conforme destacado na literatura sobre a importância da qualidade dos dados em People Analytics (Lee e Lee, 2024).
3. Resultados e Discussão
A análise dos resultados e a subsequente discussão foram estruturadas para oferecer uma compreensão aprofundada dos fatores associados à rotatividade em uma empresa de telecomunicações no Nordeste brasileiro, bem como para avaliar a capacidade preditiva de modelos de Machine Learning. A base de dados utilizada para a construção do modelo compreendeu um universo de 2.519 colaboradores que estiveram vinculados à organização entre junho de 2021 e junho de 2025. Desse total, um número expressivo de 1.713 colaboradores, representando 68% da amostra, foi desligado durante o período analisado, o que já sinaliza uma taxa de rotatividade considerável e um desafio estratégico para a gestão de pessoas.
A composição demográfica da amostra revelou uma predominância de colaboradores do sexo masculino, com 64% do total, em contraste com 36% de mulheres, conforme detalhado na Tabela 1. Esta distribuição de gênero é um achado que se alinha consistentemente com a literatura do setor de tecnologia e telecomunicações no Brasil, que historicamente tem sido caracterizado por uma maior participação masculina e uma representatividade feminina comparativamente menor em relação a outros setores econômicos (Brasscom, 2022; Oliveira et al., 2014). A persistência dessa disparidade de gênero no setor levanta questões importantes sobre as barreiras de entrada e progressão de carreira para mulheres, bem como sobre a necessidade de políticas de diversidade e inclusão mais robustas. As implicações práticas desse cenário são multifacetadas, abrangendo desde a formulação de estratégias de recrutamento que visem ativamente a atração de talentos femininos, até o desenvolvimento de programas de mentoria e liderança que apoiem a ascensão de mulheres a cargos de maior responsabilidade. Além disso, a empresa pode se beneficiar ao revisar suas políticas de conciliação entre vida profissional e pessoal, que muitas vezes impactam desproporcionalmente as mulheres, a fim de criar um ambiente mais equitativo e propício à retenção de talentos diversos. A busca por um equilíbrio de gênero não é apenas uma questão de equidade, mas também uma estratégia de negócios, visto que equipes mais diversas tendem a ser mais inovadoras e resilientes (Lee e Lee, 2024).
Tabela 1. Distribuição de gênero dos colaboradores.
|
Gênero |
Frequência |
Percentual |
|
Feminino |
907 |
64% |
|
Masculino |
1.612 |
36% |
|
Total |
2.519 |
100% |
Fonte: Resultados originais da pesquisa
A análise da faixa etária dos colaboradores, apresentada na Tabela 2, indicou que a maior parte da força de trabalho é jovem, com 31,24% dos colaboradores na faixa de 20 a 25 anos e 30,49% entre 25 e 30 anos. Em seguida, 26,87% dos colaboradores estão entre 30 e 40 anos. As faixas etárias mais elevadas representam parcelas menores da amostra, com apenas 5,52% de colaboradores com até 20 anos, 5,24% entre 40 e 50 anos e meros 0,64% acima de 50 anos. Essa predominância de colaboradores jovens é um reflexo das características do setor operacional de telecomunicações, que frequentemente demanda cargos de entrada com menor exigência de experiência e uma disposição para lidar com a rápida evolução tecnológica. A literatura corrobora que colaboradores mais jovens tendem a apresentar maior rotatividade em comparação com funcionários mais velhos (Syce, 2012). Isso pode ser atribuído a diversos fatores, como a busca por novas oportunidades de carreira, menor estabilidade financeira inicial e uma maior flexibilidade para mudar de emprego. Em contrapartida, funcionários mais experientes podem enfrentar desvantagens financeiras e de benefícios ao considerar uma mudança, além de estarem mais sujeitos a vieses e discriminação por idade no mercado de trabalho. Para a empresa, a alta concentração de jovens na força de trabalho implica a necessidade de investir em programas de desenvolvimento de carreira claros e atrativos, bem como em estratégias de engajamento que ressoem com as expectativas dessa geração, como flexibilidade, propósito e oportunidades de aprendizado contínuo. A falta de tais iniciativas pode exacerbar a rotatividade entre os mais jovens, resultando em perda de investimento em treinamento e conhecimento institucional.
Tabela 2. Faixa etária dos colaboradores
|
Faixa etária |
Frequência |
Percentual |
|
Até 20 anos |
139 |
5,52% |
|
Entre 20 e 25 anos |
787 |
31,24% |
|
Entre 25 e 30 anos |
768 |
30,49% |
|
Entre 30 e 40 anos |
677 |
26,87% |
|
Entre 40 e 50 anos |
132 |
5,24% |
|
Acima de 50 anos |
16 |
0,64% |
|
Total |
2.519 |
100% |
Fonte: Resultados originais da pesquisa
Em relação ao tempo de casa, a Tabela 3 revelou uma concentração significativa de colaboradores com permanência mais curta na empresa. Cerca de 57,09% dos colaboradores possuíam menos de um ano de empresa no momento da coleta de dados, com 24,14% tendo menos de 3 meses de vínculo, 11,12% entre 3 e 5 meses, e 21,83% entre 6 e 11 meses. A maior concentração de colaboradores, 27,23%, estava na faixa de 1 a 2 anos de permanência, enquanto apenas 15,68% tinham entre 3 e 5 anos. Essa distribuição indica uma predominância de tempos de trabalho mais curtos, um achado que se alinha com a literatura que aponta os primeiros meses de trabalho como um período crítico para a decisão de permanência do colaborador (Rombaut e Guerry, 2018). Fatores como o alinhamento de expectativas, a qualidade da adaptação à cultura organizacional e a satisfação inicial com o trabalho são determinantes nesse estágio. Uma alta rotatividade nos primeiros meses pode indicar falhas nos processos de recrutamento e seleção, que podem não estar atraindo candidatos com o perfil adequado ou não estão comunicando de forma transparente as realidades do cargo e da empresa. As implicações práticas são vastas: a empresa deve fortalecer seus programas de onboarding, garantindo que os novos colaboradores recebam suporte adequado, mentoria e feedback contínuo. Investir em um processo de integração robusto pode aumentar o senso de pertencimento e a satisfação, reduzindo a probabilidade de desligamento precoce. Além disso, a revisão das descrições de cargo e das expectativas de desempenho pode ajudar a alinhar as percepções dos candidatos com a realidade da função, minimizando a frustração e o desengajamento que podem levar à saída.
Tabela 3. Tempo de casa dos colaboradores
|
Tempo de casa |
Frequência |
Percentual |
|
Menos de 3 meses |
608 |
24,14% |
|
Entre 3 a 5 meses |
280 |
11,12% |
|
Entre 6 a 11 meses |
550 |
21,83% |
|
Entre 1 a 2 anos |
686 |
27,23% |
|
Entre 3 e 5 anos |
395 |
15,68% |
|
Total |
2.519 |
100% |
Fonte: Resultados originais da pesquisa
A distribuição da variável salarial, conforme a Tabela 4, evidenciou que a vasta maioria dos colaboradores (87,54%) recebia até R$2.000. Apenas 7,70% recebiam entre R$2.001 e R$3.000, 4,21% entre R$3.001 e R$5.000, e uma parcela mínima de 0,56% recebia entre R$5.001 e R$8.000. Essa estrutura salarial sugere que a base organizacional é predominantemente composta por cargos operacionais e de entrada, o que é comum em empresas de telecomunicações com grandes equipes de campo e atendimento. A literatura acadêmica consistentemente demonstra que níveis salariais mais baixos e a insatisfação com a remuneração têm um efeito significativo nos níveis de rotatividade, especialmente quando combinados com funções que apresentam alta pressão por desempenho (Chiavenato, 2014; Rombaut e Guerry, 2018). Colaboradores em cargos operacionais, que frequentemente lidam com metas desafiadoras e condições de trabalho exigentes, podem ser mais sensíveis a uma remuneração percebida como inadequada. As implicações práticas para a empresa incluem a necessidade de revisar sua política de remuneração, buscando um equilíbrio entre a competitividade do mercado e a sustentabilidade financeira. Isso pode envolver a criação de planos de carreira claros com aumentos salariais progressivos, programas de bônus atrelados ao desempenho ou benefícios não monetários que agreguem valor à proposta de emprego. A falta de uma estratégia de remuneração competitiva pode não apenas aumentar a rotatividade, mas também dificultar a atração de talentos qualificados em um mercado cada vez mais disputado.
Tabela 4. Faixa salarial em reais dos colaboradores
|
Faixa salarial |
Frequência |
Percentual |
|
Até R$ 2.000 |
2.205 |
87,54% |
|
Entre R$ 2.001 e R$ 3.000 |
194 |
7,70% |
|
Entre R$ 3.001 e R$ 5.000 |
106 |
4,21% |
|
Entre R$ 5.001 e R$ 8.000 |
14 |
0,56% |
|
Total |
2.519 |
100% |
Fonte: Resultados originais da pesquisa
A Tabela 5, que apresenta a distribuição dos colaboradores por estado civil, mostrou que os solteiros representam a maior parcela, com 72,96% do total, seguidos pelos casados (22,99%). Os divorciados e aqueles com união estável representam 2,38% e 1,67%, respectivamente. Essa distribuição está alinhada com o perfil jovem da organização, onde é natural que uma maior proporção de indivíduos ainda não tenha estabelecido vínculos matrimoniais ou de união estável. Embora o estado civil possa não ser um preditor direto de rotatividade tão forte quanto outras variáveis, ele pode influenciar as prioridades e necessidades dos colaboradores. Por exemplo, colaboradores solteiros e mais jovens podem ter maior mobilidade e menos responsabilidades familiares que os prendam a uma localidade ou emprego específico, tornando-os potencialmente mais propensos a buscar novas oportunidades. As implicações práticas para a gestão de pessoas podem incluir a oferta de benefícios flexíveis que atendam às diferentes fases da vida dos colaboradores, como programas de bem-estar, opções de desenvolvimento profissional e oportunidades de mobilidade interna ou externa que possam ser atrativas para um público mais jovem e com menos amarras.
Tabela 5. Estado civil dos colaboradores
|
Estado Civil |
Frequência |
Percentual |
|
Solteiro |
1.838 |
72,96% |
|
Casado |
579 |
22,99% |
|
Divorciado |
60 |
2,38% |
|
União Estável |
42 |
1,67% |
|
Total |
2.519 |
100% |
Fonte: Resultados originais da pesquisa
No que tange à variável raça/cor, a Tabela 6 indicou que a maior parte dos colaboradores se autodeclarou parda (41,60%), seguida por “Não informado” (26,20%), branca (22,03%), preta (7,90%), amarela (2,02%) e indígena (0,24%). A ausência de preenchimento da variável raça/cor em uma proporção tão significativa da amostra (26,20%) representa uma limitação metodológica crucial, que pode impactar a robustez das interpretações relacionadas a essa variável. A literatura em People Analytics enfatiza que a qualidade e a disponibilidade dos dados são essenciais para a confiabilidade das análises e para a formulação de políticas equitativas (Lee e Lee, 2024). A falta de dados completos sobre raça/cor impede uma análise aprofundada de possíveis disparidades na rotatividade entre diferentes grupos raciais, o que poderia ser um indicador de vieses sistêmicos ou de experiências distintas dentro da organização. As implicações práticas são claras: a empresa precisa implementar mecanismos para garantir a coleta completa e precisa de dados demográficos, respeitando a privacidade e a autodeterminação dos colaboradores. Além disso, a ausência desses dados impede a empresa de monitorar eficazmente suas metas de diversidade e inclusão, bem como de desenvolver estratégias direcionadas para promover um ambiente de trabalho mais equitativo para todos os grupos raciais. A transparência e a conscientização sobre a importância desses dados para a construção de uma cultura organizacional inclusiva são passos fundamentais.
Tabela 6. Raça/Cor dos colaboradores
|
Raça/Cor |
Frequência |
Percentual |
|
Parda |
1.048 |
41,60% |
|
Não informado |
660 |
26,20% |
|
Branca |
555 |
22,03% |
|
Preta |
199 |
7,90% |
|
Amarela |
51 |
2,02% |
|
Indígena |
6 |
0,24% |
|
Total |
2.519 |
100% |
Fonte: Resultados originais da pesquisa
A variável “Advertências” corresponde ao número de ocorrências disciplinares registradas. Observou-se que a maioria dos colaboradores não recebeu advertências, enquanto 701 colaboradores apresentaram uma ou mais ocorrências. Este dado, embora não detalhado em uma tabela específica de frequência de advertências, é relevante para a compreensão dos padrões comportamentais associados ao desligamento (Sexton et al., 2005). A presença de advertências pode indicar problemas de desempenho, conduta ou alinhamento com as políticas da empresa. No entanto, a interpretação deve ser cautelosa, pois o sistema de advertências pode variar em sua aplicação e rigor. As implicações práticas sugerem que a empresa pode utilizar os dados de advertências como um indicador precoce de risco de rotatividade, mas deve combiná-lo com outras informações para entender o contexto. Programas de feedback construtivo, treinamento para líderes sobre como gerenciar o desempenho e a conduta, e a oferta de suporte para colaboradores que recebem advertências podem ser estratégias eficazes para corrigir comportamentos e reter talentos, em vez de apenas documentar a falha.
As variáveis “Função” e “Regional” também foram pré-processadas para otimizar a análise. A variável “Função”, que originalmente continha 181 cargos distintos, foi agrupada em famílias ocupacionais mais amplas, como Analista, Aprendiz, Assistente/Auxiliar, Atendimento, Coordenador, Especialista, Estagiário, Supervisor, Técnico, Vendas e Outros. Da mesma forma, as 17 regionais da empresa foram consolidadas por estados (PB, RN, PE e BA). Essa agregação de dados é uma prática comum em People Analytics para lidar com a alta cardinalidade de variáveis categóricas, garantindo maior representatividade e otimizando a capacidade preditiva dos modelos, conforme destacado por Sexton et al. (2005) sobre a importância de características ocupacionais e localização geográfica na predição de rotatividade. As implicações práticas desse agrupamento residem na capacidade de identificar padrões de rotatividade em níveis mais estratégicos. Por exemplo, se uma família de funções específica ou uma regional apresenta consistentemente taxas de rotatividade elevadas, a gestão de RH pode direcionar recursos e intervenções para essas áreas, como programas de desenvolvimento de liderança, revisão de cargas de trabalho ou melhoria das condições de trabalho específicas.
A análise inicial da base de dados revelou uma alta concentração de desligamentos precoces, com 35% das saídas registradas ocorrendo nos primeiros meses de vínculo empregatício. Este padrão de rotatividade é comum e esperado no período inicial, que é crucial para a adaptação e o alinhamento de expectativas entre o colaborador e a organização (Sexton et al., 2005; Rombaut e Guerry, 2018). O perfil predominante entre os colaboradores que se desligam neste período é de homens (64,3%), com idade entre 20 e 25 anos, sendo a maioria pertencente ao departamento Comercial. Essa combinação de fatores sugere que a fase inicial do vínculo organizacional, especialmente para jovens em funções operacionais e de vendas, é um ponto de vulnerabilidade. As implicações práticas são críticas: a empresa deve intensificar o suporte e o acompanhamento nos primeiros meses, com programas de mentoria, feedback regular e clareza sobre as expectativas de desempenho e cultura. Para o departamento Comercial, especificamente, pode ser necessário revisar as metas, o sistema de comissionamento ou o treinamento de vendas para garantir que os novos colaboradores se sintam apoiados e capazes de atingir o sucesso, minimizando a frustração e o desengajamento que levam ao desligamento precoce.
Construção dos modelos e análise de resultados
Após a preparação e análise inicial dos dados, foram aplicados três algoritmos de Machine Learning para prever a probabilidade de desligamento: Random Forest, Regressão Logística e Gradient Boosted Trees.
O primeiro modelo avaliado foi o Random Forest, configurado com quatro variáveis testadas em cada árvore e um total de 500 árvores construídas. A Matriz de Confusão, apresentada na Tabela 7, detalha o desempenho deste modelo.
Tabela 7. Matriz de Confusão do método Random Forest
|
Referência |
Predição: Ficou na empresa |
Predição: Deixou a empresa |
|
Ficará na empresa |
144 |
73 |
|
Deixará a empresa |
72 |
467 |
Fonte: Resultados originais da pesquisa
Conforme a Tabela 7, o modelo Random Forest classificou corretamente 467 colaboradores que foram desligados (verdadeiros positivos) e 144 que permaneceram na empresa (verdadeiros negativos). No entanto, houve 72 falsos positivos (colaboradores que permaneceram, mas foram previstos como desligados) e 73 falsos negativos (colaboradores que foram desligados, mas foram previstos como permanentes). Esses resultados indicam um bom desempenho geral do modelo, com uma acurácia de 80,82%. Isso significa que aproximadamente oito em cada dez classificações foram realizadas corretamente. Este nível de acurácia é competitivo e se alinha com estudos semelhantes na literatura, como o de Benabou et al. (2025), que encontraram uma acurácia de 85,7% utilizando o mesmo algoritmo para predição de turnover. A acurácia de 80,82% sugere que o modelo Random Forest possui uma capacidade robusta de identificar padrões complexos nos dados que levam ao desligamento. As implicações práticas dessa acurácia são significativas: a empresa pode confiar no modelo para identificar colaboradores em risco com uma alta probabilidade de acerto, permitindo a implementação de intervenções proativas. No entanto, é crucial considerar os tipos de erros. Falsos negativos (73 casos) são particularmente problemáticos, pois representam colaboradores que a empresa não identificou como de risco, mas que acabaram se desligando, resultando em perda de talentos e custos associados. Falsos positivos (72 casos), embora menos críticos, podem levar a intervenções desnecessárias, gerando custos e potencialmente impactando negativamente o engajamento de colaboradores que não tinham intenção de sair. A gestão deve ponderar o custo de cada tipo de erro ao definir o limiar de risco para as intervenções.
A principal variável identificada pelo modelo Random Forest como tendo maior influência na probabilidade de desligamento foi o “Tempo de Casa”, conforme ilustrado na Figura 1.
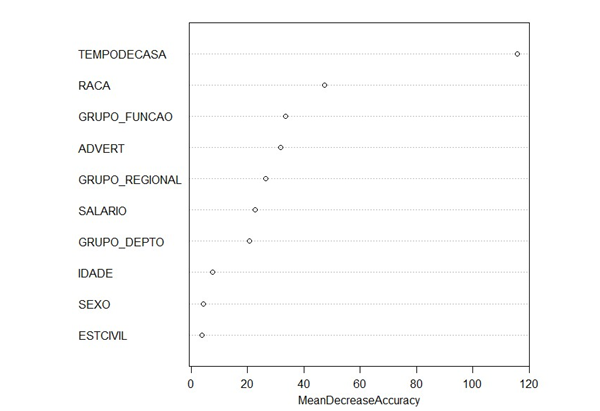
Figura 1. Importância das variáveis no método Random Forest
Fonte: Resultados originais da pesquisa
A Figura 1 demonstra claramente que o “Tempo de Casa” é a variável mais relevante, indicando que o período de permanência na empresa exerce uma influência substancial sobre a probabilidade de desligamento. Este achado reforça a observação de que os primeiros meses de vínculo empregatício são um período crítico, com maior propensão ao desligamento. Este resultado está em consonância com os estudos de Rombaut e Guerry (2018) e Sexton et al. (2005), que destacam a maior probabilidade de desligamento nos estágios iniciais do contrato e a diminuição dessa probabilidade à medida que o tempo de casa aumenta. A importância do “Tempo de Casa” como preditor primário sugere que a adaptação inicial, o alinhamento cultural e a satisfação com as expectativas do cargo são fatores cruciais para a retenção. As implicações práticas são profundas: a empresa deve priorizar e aprimorar continuamente seus programas de integração e acompanhamento de novos colaboradores. Isso inclui a designação de mentores, a oferta de treinamento contínuo, a promoção de um ambiente de trabalho acolhedor e a realização de verificações regulares de bem-estar e engajamento. Além disso, a gestão deve estar atenta aos sinais de desengajamento nos primeiros meses, como baixa produtividade, absenteísmo ou feedback negativo, e intervir proativamente. Ignorar a importância do “Tempo de Casa” pode levar a um ciclo vicioso de recrutamento e desligamento, com custos elevados e perda de capital humano.
A Curva ROC para o modelo Random Forest, apresentada na Figura 2, demonstrou um formato elevado e afastado da linha de referência, o que sugere uma boa capacidade preditiva do modelo.
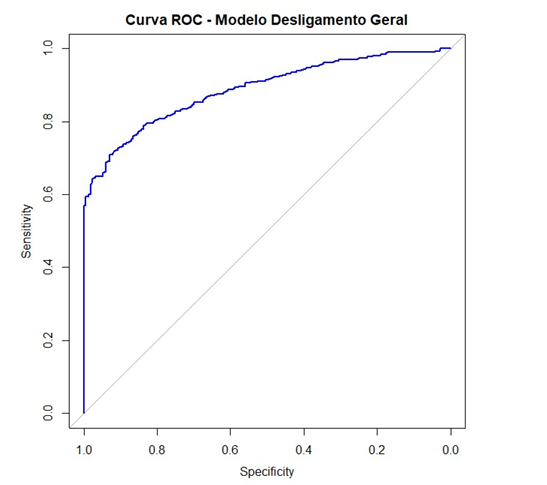
Figura 2. Curva ROC no método Random Forest
Fonte: Resultados originais da pesquisa
Conforme a Figura 2, a Área Sob a Curva (AUC) alcançou 0,887 (88,7%). Este valor, considerando a escala de 0 (pior) a 1 (ideal), caracteriza o modelo como tendo boa assertividade e um forte poder discriminatório (Benabou et al., 2025; Ramos et al., 2017). Uma AUC próxima de 1,0 indica que o modelo é capaz de distinguir com alta precisão entre colaboradores que permanecerão e aqueles que se desligarão. Este é um indicador robusto da qualidade do modelo, superando a mera acurácia, pois avalia o desempenho em diferentes limiares de classificação. As implicações práticas de uma AUC tão elevada são que a empresa pode ter grande confiança na capacidade do modelo Random Forest de identificar colaboradores em risco de desligamento. Isso permite que as intervenções de retenção sejam direcionadas de forma mais eficiente, focando nos indivíduos com maior probabilidade de saída e otimizando o uso de recursos. A alta capacidade discriminatória do modelo também pode ser utilizada para refinar as estratégias de recrutamento, identificando características de candidatos que se correlacionam com maior permanência na empresa, contribuindo para a construção de uma força de trabalho mais estável e engajada.
O segundo modelo construído foi a Regressão Logística, uma técnica estatística amplamente utilizada para modelar a probabilidade de ocorrências de eventos binários, onde a variável resposta foi definida como 0 para colaboradores ativos e 1 para colaboradores desligados (Bianchi, 2023). A Matriz de Confusão para este modelo, detalhada na Tabela 8, indica que ele classificou corretamente 465 desligados e 119 colaboradores que permaneceram na empresa. No entanto, 97 colaboradores que permaneceram foram previstos como desligados (falsos positivos) e 75 desligados reais foram previstos como permanentes (falsos negativos). A partir desses resultados, o modelo apresentou uma acurácia de 77,2%. Embora esse desempenho tenha sido inferior ao Random Forest, ele ainda demonstra boa capacidade preditiva. Em outros trabalhos, a regressão logística também apresenta um desempenho competitivo, alcançando acurácia de até 87,7% em algumas aplicações (Benabou et al., 2025). A Regressão Logística, apesar de ser um modelo mais simples em comparação com o Random Forest, oferece a vantagem da interpretabilidade dos coeficientes, o que pode ser valioso para entender a direção e a magnitude da influência de cada variável.
Tabela 8. Matriz de Confusão do método Regressão Logística
|
Predição |
Ficou na empresa |
Deixou a empresa |
|
Ficará na empresa |
119 |
75 |
|
Deixará a empresa |
97 |
465 |
Fonte: Resultados originais da pesquisa
Na regressão logística, os coeficientes indicam a direção e a intensidade da relação entre a variável preditora e a probabilidade do evento ocorrer (Fernandes et al., 2020). A Tabela 9 apresenta os coeficientes das variáveis mais significativas.
Tabela 9. Coeficiente das variáveis mais significativas no modelo Regressão Logística
|
Variável |
Coeficiente |
|
Advertência |
-0.2092 |
|
Tempo de casa |
-0.128 |
|
Raça – “Não informado” |
+1.75 |
|
Estado Civil – “União Estável” |
+1.594 |
|
Grupo Função – Auxiliar/Assistente |
-0.9797 |
Fonte: Resultados originais da pesquisa
A variável “Advertência” apresentou um coeficiente negativo (-0.2092), sugerindo que colaboradores que possuem advertência têm uma menor probabilidade de desligamento. Este resultado, à primeira vista, pode parecer contraintuitivo, mas pode ser interpretado de algumas maneiras. Uma possibilidade é que a aplicação de advertências funcione como um mecanismo corretivo eficaz, levando o colaborador a ajustar sua conduta e, consequentemente, a permanecer na empresa. Outra interpretação é que os colaboradores que permanecem após receber uma advertência podem ser aqueles mais resilientes ou mais comprometidos com a organização, ou que a empresa investe em seu desenvolvimento após a advertência. As implicações práticas sugerem que as advertências não devem ser vistas apenas como um passo para o desligamento, mas como uma oportunidade de intervenção e desenvolvimento. A empresa pode aprimorar seus processos de gestão de desempenho, garantindo que as advertências sejam acompanhadas de planos de ação claros, suporte e acompanhamento para que o colaborador possa melhorar e se reintegrar plenamente.
O “Tempo de Casa” e o “Grupo Função Auxiliar/Assistente” também apresentaram coeficientes negativos, -0.128 e -0.9797, respectivamente. Isso indica que colaboradores com maior tempo de casa e aqueles pertencentes ao grupo de função Auxiliar/Assistente têm menor probabilidade de desligamento. Este achado reforça os resultados anteriores sobre a importância do tempo de casa na redução da rotatividade (Rombaut e Guerry, 2018). Para o grupo Auxiliar/Assistente, o coeficiente negativo pode refletir uma maior estabilidade ou satisfação com as condições de trabalho, ou talvez uma menor pressão por desempenho em comparação com outras funções operacionais. As implicações práticas para o “Tempo de Casa” já foram discutidas, mas para o grupo Auxiliar/Assistente, a empresa pode investigar os fatores que contribuem para essa maior estabilidade e replicá-los em outras áreas. Isso pode incluir a análise de benefícios, cultura de equipe, oportunidades de desenvolvimento ou a natureza das tarefas desempenhadas.
Por outro lado, a variável “Raça – Não informado” apresentou um coeficiente positivo de +1.75, indicando uma maior probabilidade de desligamento para essa categoria. No entanto, como já discutido, a elevada proporção de registros sem informação limita severamente a interpretação robusta desta variável. A empresa deve priorizar a coleta de dados de raça/cor de forma ética e completa para poder extrair insights significativos e garantir a equidade. A categoria “União Estável” também apresentou um coeficiente positivo (+1,594), sugerindo maior probabilidade de desligamento em comparação às demais categorias de estado civil. Contudo, por ser uma categoria representada por uma parcela muito pequena da amostra, é crucial analisar as demais categorias com maior representatividade para evitar conclusões precipitadas. A interpretação cautelosa desses coeficientes é fundamental, especialmente para variáveis com dados limitados ou amostras pequenas, para evitar a formulação de políticas baseadas em informações incompletas ou enganosas.
A Curva ROC para o modelo de Regressão Logística, apresentada na Figura 3, demonstrou um formato semelhante ao modelo anterior, com uma AUC de 83,9%.
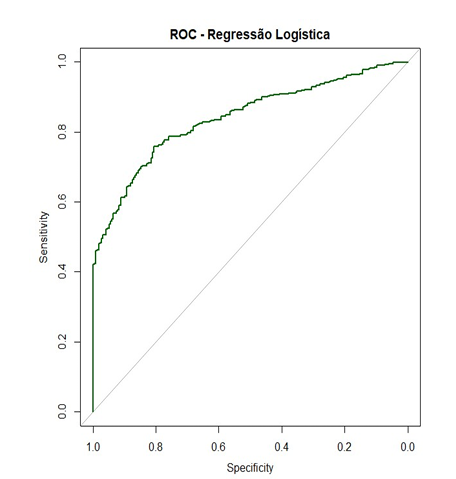
Figura 3. Curva ROC no método Regressão Logística
Fonte: Resultados originais da pesquisa
Conforme a Figura 3, a AUC de 83,9% indica uma boa capacidade preditiva, embora seja inferior ao desempenho do Random Forest. Este resultado, no entanto, indica a consistência da regressão logística como uma ferramenta válida para a predição de rotatividade, alinhando-se com a literatura que demonstra a competitividade deste modelo em diversas aplicações (Benabou et al., 2025). A capacidade de discriminação do modelo de Regressão Logística, mesmo sendo ligeiramente inferior, ainda é considerável, o que significa que ele pode ser útil para a empresa, especialmente se a interpretabilidade dos coeficientes for uma prioridade. As implicações práticas incluem a possibilidade de utilizar este modelo para análises exploratórias e para comunicar os fatores de risco de forma mais direta aos gestores, dada a sua simplicidade em relação a modelos mais complexos. O último modelo analisado foi o Gradient Boosted Trees (GBT), um método baseado em técnicas de boosting que constrói árvores de decisão de forma sequencial, buscando reduzir gradualmente os erros das árvores anteriores. Este algoritmo é amplamente utilizado em problemas de predição por seu alto poder preditivo e capacidade de capturar relações complexas entre variáveis (Narkbunnum & Hinthaw, 2025). Neste estudo, foram utilizadas 3.000 árvores de decisão, com profundidade de nível 3 para cada e 10 como número mínimo de observações por nó. A Matriz de Confusão para o GBT, detalhada na Tabela 10, indica que o modelo classificou corretamente 463 colaboradores desligados e 140 que permaneceram na empresa. Por outro lado, 77 colaboradores que permaneceram foram previstos como desligados (falsos positivos) e 76 desligados reais foram previstos como permanentes (falsos negativos). O modelo apresentou uma acurácia de 79,7%, indicando um bom desempenho. Resultados semelhantes são encontrados na literatura, como no estudo de Narkbunnum e Hinthaw (2025), que observaram uma acurácia próxima de 86,9%. O GBT, com sua capacidade de otimizar iterativamente o desempenho, é particularmente eficaz em identificar padrões sutis nos dados, o que o torna uma ferramenta poderosa para a predição de rotatividade.
Tabela 10. Matriz de Confusão do método Gradiente Boosted Trees
|
Predição |
Ficou na empresa |
Deixou a empresa |
|
Ficará na empresa |
140 |
77 |
|
Deixará a empresa |
76 |
463 |
Fonte: Resultados originais da pesquisa
O modelo GBT também identificou o “Tempo de Casa” como a variável mais relevante, representando 55,93% de importância relativa na redução do erro do modelo ao longo das árvores, conforme a Tabela 11.
Tabela 11. Variáveis com maior importância relativa no modelo Gradient Boosted Trees
|
Variável |
Importância relativa (%) |
|
Tempo de Casa |
55,93 |
|
Raça |
11,73 |
|
Função |
9,53 |
|
Advertência |
7,04 |
|
Departamento |
4,37 |
Fonte: Resultados originais da pesquisa
Conforme a Tabela 11, a proeminência do “Tempo de Casa” reforça os achados observados no modelo Random Forest e sugere que o tempo de permanência é um fator preponderante na predição de desligamento na empresa estudada. Além do “Tempo de Casa”, outras variáveis que apresentaram relevância foram “Raça”, “Função”, “Advertência” e “Departamento”. Essas variáveis refletem que fatores individuais e organizacionais podem influenciar a permanência dos colaboradores na empresa (Kovačević et al., 2024; Rombaut e Guerry, 2018). A consistência desses resultados entre diferentes modelos de Machine Learning valida a importância dessas variáveis para a gestão de pessoas. As implicações práticas são que a empresa deve desenvolver uma abordagem multifacetada para a retenção, que considere não apenas o tempo de permanência, mas também as características demográficas (como a raça, com a ressalva da qualidade dos dados), as funções desempenhadas, o histórico disciplinar e o departamento de atuação. Isso permite a criação de estratégias de retenção mais personalizadas e eficazes, adaptadas às necessidades específicas de diferentes grupos de colaboradores.
A Curva ROC para o modelo GBT, apresentada na Figura 4, demonstrou uma AUC de 87%, indicando elevada capacidade em distinguir colaboradores com maior e menor probabilidade de desligamento.
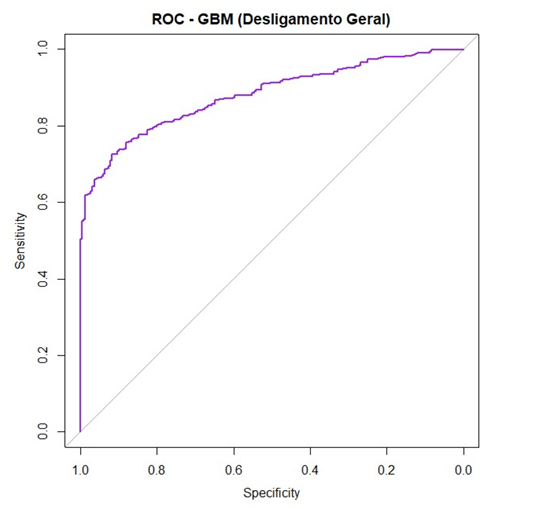
Figura 4. Curva ROC no método Gradient Boosted Trees
Fonte: Resultados originais da pesquisa
Conforme a Figura 4, valores elevados de AUC, como o de 87% para o GBT, indicam um bom desempenho de modelos de classificação, demonstrando que o algoritmo apresenta forte capacidade discriminatória (Ramos et al., 2017). A alta AUC do GBT, embora ligeiramente inferior à do Random Forest, confirma a robustez do modelo e sua utilidade para a predição de rotatividade. As implicações práticas são que a empresa pode utilizar o GBT com confiança para identificar colaboradores em risco, beneficiando-se de sua capacidade de capturar relações complexas nos dados. A escolha entre Random Forest e GBT pode depender de fatores como a necessidade de interpretabilidade (onde o GBT pode ser mais complexo) e a tolerância a diferentes tipos de erros, mas ambos demonstram ser ferramentas poderosas para a gestão proativa da rotatividade.
De modo geral, o modelo Random Forest apresentou o melhor desempenho em comparação com a Regressão Logística e o Gradient Boosted Trees, conforme a Tabela 12, embora as diferenças tenham sido ligeiramente sutis.
Tabela 12. Comparativo dos resultados dos métodos aplicados
|
Modelo |
Acurácia (%) |
AUC (%) |
|
Random Forest |
80,2 |
88,7 |
|
Regressão Logística |
77,2 |
83,9 |
|
Gradient Boosted Trees |
79,7 |
87 |
Fonte: Resultados originais da pesquisa
Conforme a Tabela 12, o Random Forest alcançou a maior acurácia (80,2%) e a maior AUC (88,7%), seguido pelo GBT (79,7% de acurácia e 87% de AUC) e pela Regressão Logística (77,2% de acurácia e 83,9% de AUC). Esses resultados reforçam a capacidade das técnicas de Machine Learning em identificar padrões associados à rotatividade de colaboradores. A superioridade do Random Forest pode ser atribuída à sua capacidade de lidar com a não linearidade e a interação entre variáveis de forma mais eficaz, construindo múltiplas árvores de decisão e agregando seus resultados para uma predição mais robusta. As implicações práticas dessa comparação são que a empresa deve priorizar o uso do modelo Random Forest para suas estratégias de predição de rotatividade, dada sua performance superior. No entanto, os outros modelos ainda oferecem insights valiosos e podem ser utilizados para validação cruzada ou para explorar diferentes aspectos dos dados. A capacidade de ter múltiplos modelos com bom desempenho aumenta a confiança na aplicação de People Analytics para a tomada de decisões estratégicas em RH.
Análise de predição do modelo Random Forest
Após a comparação entre os modelos preditivos, o Random Forest foi selecionado para uma análise mais detalhada, devido ao seu melhor desempenho na predição de desligamento de colaboradores. A partir deste modelo, buscou-se compreender quais características estão associadas à maior probabilidade de ocorrência de desligamento, considerando como alto risco aqueles com probabilidade superior a 0,50. O modelo identificou como variáveis mais relevantes para a predição do desligamento o “Tempo de Casa”, “Raça”, “Função”, “Advertência” e “Regional”.
A variável “Tempo de Casa” revelou que o grupo classificado como de maior risco de desligamento está concentrado nos primeiros meses de trabalho, com uma mediana de apenas 6 meses de permanência na empresa, conforme a Tabela 13.
Tabela 13. Resumo estatístico do grupo de risco na variável Tempo de Casa
|
Medida |
Frequência |
|
Mínimo |
0 |
|
Mediana |
6 |
|
1° quartil |
2 |
|
Média |
8 |
|
Máximo |
42 |
Fonte: Resultados originais da pesquisa
Conforme a Tabela 13, o tempo mínimo de permanência no grupo de risco foi de menos de um mês, o primeiro quartil foi de 2 meses, e a média de tempo de casa foi de 8 meses, com o colaborador mais antigo no grupo de risco tendo até 42 meses. Este resultado está alinhado com os achados de Narkbunnum e Hinthaw (2025) e Rombaut e Guerry (2018), que afirmam que colaboradores com menor tempo de permanência no cargo atual tendem a ter maior probabilidade de rotatividade, e que o aumento do tempo de empresa causa uma diminuição no turnover. A concentração de risco nos primeiros meses é um alerta crítico para a empresa. As implicações práticas são a necessidade urgente de fortalecer os processos de integração, acompanhamento e desenvolvimento nos primeiros seis meses de emprego. Isso pode incluir programas de mentoria mais intensivos, sessões de feedback estruturadas, treinamento de habilidades essenciais e um foco maior na cultura organizacional para garantir que os novos colaboradores se sintam engajados e valorizados desde o início. A falha em abordar essa vulnerabilidade inicial pode resultar em um ciclo contínuo de perda de talentos e custos associados ao recrutamento e treinamento.
No que diz respeito à variável “Raça”, a distribuição predominante do grupo de risco se concentra em 223 colaboradores pardos, 157 com raça não informada e 109 brancos. A ausência de informação para uma parcela significativa continua a limitar a interpretação robusta dessa variável, como já mencionado. A empresa deve priorizar a melhoria da coleta de dados de raça/cor para realizar análises mais equitativas e identificar possíveis disparidades.
Observa-se que as funções operacionais, como vendas, áreas técnicas e atendimento, concentram a maior parte dos colaboradores classificados como grupo de risco, conforme a Tabela 14.
Tabela 14. Resumo do grupo de risco na variável Função
|
Grupo de Função |
Frequência |
Percentual |
|
Vendas |
166 |
32,49% |
|
Técnico |
123 |
24,07% |
|
Atendimento |
105 |
20,55% |
|
Assistente/Auxiliar |
54 |
10,57% |
|
Aprendiz |
36 |
7,05% |
|
Analista |
27 |
5,28% |
|
Total |
511 |
100% |
Fonte: Resultados originais da pesquisa
Conforme a Tabela 14, o grupo de vendas apresentou a maior chance de desligamento (32,49%), seguido pelo grupo técnico (24,07%) e atendimento (20,55%). Os grupos com menor chance foram assistente/auxiliar (10,57%), aprendiz (7,05%) e analista (5,28%). Este resultado pode ser justificado pela alta pressão ao atingimento de metas, menor barreira para entrada e maior exposição a riscos operacionais inerentes a essas funções (Narkbunnum e Hinthaw, 2025). As funções de vendas, técnicas e atendimento frequentemente envolvem metas agressivas, interação direta com clientes (muitas vezes insatisfeitos) e condições de trabalho que podem ser estressantes ou fisicamente exigentes. A baixa barreira de entrada para algumas dessas funções também pode atrair indivíduos que estão explorando opções de carreira, tornando-os mais propensos a sair se encontrarem uma oportunidade melhor. As implicações práticas são cruciais: a empresa deve desenvolver estratégias de retenção específicas para essas funções de alto risco. Isso pode incluir a revisão dos sistemas de metas e recompensas para torná-los mais justos e alcançáveis, o investimento em treinamento de resiliência e gestão de estresse, a oferta de suporte gerencial mais próximo e a criação de planos de desenvolvimento de carreira claros para que esses colaboradores vejam um futuro na organização. Além disso, a melhoria das condições de trabalho e a promoção de um ambiente de equipe positivo podem mitigar os riscos associados a essas funções.
Em relação à variável “Regional”, foi possível identificar maior concentração dos colaboradores classificados no grupo de risco na regional PB, totalizando 298 colaboradores. As demais regionais, RN (129), BA (57) e PE (55), apresentaram menor número. Esse resultado corrobora com o estudo de Syce (2012), de modo que uma maior concentração de funcionários em uma região pode refletir em uma taxa maior de rotatividade. A concentração de risco na regional PB pode ser influenciada por fatores locais, como a competitividade do mercado de trabalho na região, a disponibilidade de outras oportunidades de emprego, as condições socioeconômicas locais ou até mesmo a eficácia da gestão local. As implicações práticas são que a empresa deve realizar uma análise aprofundada dos fatores específicos que contribuem para a alta rotatividade na regional PB. Isso pode envolver a realização de pesquisas de clima organizacional, entrevistas de desligamento focadas nessa região e a avaliação do desempenho e estilo de liderança dos gestores locais. Com base nesses insights, a empresa pode desenvolver estratégias de retenção regionalizadas, como programas de benefícios adaptados, iniciativas de engajamento comunitário ou treinamento específico para os líderes da PB.
Por fim, a variável “Advertência” demonstrou relevância, com aproximadamente 20% do grupo de risco registrando uma ou mais advertências. Esse resultado pode indicar que fatores relacionados ao comportamento e desempenho influenciam a probabilidade de desligamento, embora o coeficiente negativo na regressão logística sugira uma complexidade na relação. Para o grupo de risco, a presença de advertências pode ser um sinal de que o colaborador está enfrentando dificuldades que, se não forem abordadas, podem levar ao desligamento. As implicações práticas sugerem que a empresa deve utilizar as advertências como um gatilho para intervenções proativas, em vez de apenas um registro formal. Isso pode incluir a oferta de coaching, treinamento de habilidades, aconselhamento ou programas de apoio para colaboradores que recebem advertências, com o objetivo de ajudá-los a superar os desafios e permanecer na empresa. A comunicação clara das expectativas e o feedback construtivo são essenciais para transformar uma advertência em uma oportunidade de desenvolvimento e retenção.
De modo geral, a análise das previsões do modelo Random Forest indica que o perfil com maior propensão ao desligamento é composto, predominantemente, por profissionais com pouco tempo de casa, com funções operacionais como vendas, atendimento e áreas técnicas. Esses colaboradores concentram-se em determinadas regionais da empresa e apresentam, mesmo que de forma sutil, histórico de advertências. Esses resultados sugerem que fatores relacionados à fase inicial do vínculo organizacional e características funcionais exercem influência relevante sobre a rotatividade, indicando possíveis oportunidades para o desenvolvimento de estratégias organizacionais voltadas à retenção de talentos. A empresa pode, portanto, desenvolver um plano de ação abrangente que inclua programas de integração robustos, planos de desenvolvimento de carreira claros para funções operacionais, estratégias de remuneração e benefícios competitivas, e um sistema de gestão de desempenho que promova o feedback contínuo e o suporte aos colaboradores. A aplicação desses insights preditivos permite uma gestão de pessoas mais estratégica e proativa, transformando dados em ações concretas para a redução da rotatividade e a construção de uma força de trabalho mais estável e produtiva.
4. Conclusão
Conclui-se que o objetivo foi atingido, ao analisar os fatores associados ao desligamento geral em uma empresa de telecomunicação no Nordeste brasileiro e propor um modelo preditivo com base em técnicas de People Analytics e Machine Learning. O estudo demonstrou que o modelo Random Forest obteve o melhor desempenho preditivo, com acurácia de 80,2% e AUC de 88,7%, superando a Regressão Logística e o Gradient Boosted Trees. As análises revelaram que o “Tempo de Casa” é a variável mais relevante, indicando que colaboradores nos primeiros meses de vínculo empregatício possuem maior propensão ao desligamento. Além disso, funções operacionais como vendas, atendimento e áreas técnicas, e a regional PB, concentram o maior risco de rotatividade.
Contudo, o estudo apresentou limitações, notadamente a alta proporção de dados “Não informado” na variável raça/cor, o que impediu uma interpretação mais robusta e aprofundada sobre possíveis disparidades. A natureza de estudo de caso único também restringe a generalização dos achados para outras empresas ou setores. Para estudos futuros, sugere-se a ampliação da pesquisa para diferentes organizações e a inclusão de novas variáveis, como desempenho individual, engajamento e absenteísmo. Recomenda-se também a diferenciação entre desligamentos voluntários e involuntários, e a incorporação de métodos qualitativos, como entrevistas de desligamento, para obter insights mais ricos sobre as motivações dos colaboradores. A melhoria na coleta de dados demográficos é crucial para análises mais equitativas.
Referências Bibliográficas
Associação das Empresas de Tecnologia da Informação e Comunicação e de Tecnologias Digitais [BRASSCOM]. 2022. Relatório de Diversidade no Setor TIC. Disponível em: <https://brasscom.org.br/wp-content/uploads/2024/03/BRI2-2022-018-Relatorio-de-Diversidade-diagramado.pdf>. Acesso em: 16 mar. 2026.
Benabou, A.; Touhami, F.; Sabri, M.A. 2025. Predicting Employee Turnover Using Machine Learning Techniques. Acta Informatica Pragensia. 14(1): 112-127.
Bianchi, F.B. 2023. People Analytics: Previsão de desligamentos por meio das técnicas de regressão logística e análise de sobrevivência. Dissertação de Graduação em Estatística. Universidade Federal do Rio Grande do Sul, Porto Alegre, Rio Grande do Sul, Brasil.
Chiavenato, I. 2014. Gestão De Pessoas: O Novo Papel Dos Recursos Humanos Nas Organizações. 14ed. Manole, Barueri, São Paulo, Brasil.
Fernandes, A.A.T.; Filho, D.B.F.; Rocha, E.C.; Nascimento, W.S. 2020. Leia este artigo se você quiser aprender regressão logística. Revistas de Sociologia e Política 28(74): 1-20.
Gil, A.C. 2008. Métodos e Técnicas de Pesquisa Social. Atlas, São Paulo, São Paulo, Brasil.
Junior, D.H.G. 2025. Abordagens de aprendizado de máquina na seleção de genótipos de maracujazeiro amarelo resistentes ao CABMV. Monografia em Inteligência Artificial e Big Data do Programa de Pós Graduação. Universidade de São Paulo, São Carlos, São Paulo, Brasil.
Kobayachi, L.M.; Valvano, L.S.; Nascimento, M.F.S.F.; Pereira, M.S. 2023. Principais desafios para a utilização de People Analytics nas funções de recrutamento e seleção de candidatos. Trabalho de Conclusão de Curso. Universidade Presbiteriana Mackenzie, São Paulo, SP, Brasil.
Kovačević, I. Pantelić, O. Labrović, J.A. 2024. Predictors of employees’ voluntary turnover intentions: analytic hierarchy process approach. Yugoslav Journal of Operations Research. 34 (3): 587-602.
Lee, J. Y.; Lee, Y. 2024. Integrative literature review on people analytics and implications from the perspective of human resource development. Human Resource Development Review. 23(1): 58–87.
McAfee, A.; Brynjolfsson, E. 2012. Big data: the management revolution. Harvard Business Review. 90(10): 60-68.
Narkbunnum, W.; Hinthaw, K. 2025. Interpretable Gradient Boosted Modeling of Employee Attrition: A SHAP-Based Framework for HR Analytics. International Journal of Analysis and Applications. 23(236): 1-18.
Ndatshe, Y.; Mokhele, M.O.; Jakoet-Salie, A. 2024. The effects of employee turnover on the loss of organisational knowledge in South African municipalities: Balancing rhetoric with actual practice. Research in Business & Social Science. 13 (7): 204-211.
Nunes, C.P.P.; Lira, P.V.R.A. 2024. Interfaces entre trabalho e desgaste mental em trabalhadores das telecomunicações. Physis: Revista de Saúde Coletiva. 34: 1-35
Oliveira, R.R.; Martins, U.B; Almeida, L.I.R. 2014. A rotatividade de funcionários na empresa Alpha Telecom. Gestão Contemporânea 4(1): 207-226.
Pereira, A.S.; Shitsuka, D.M.; Parreira, F.J.; Shitsuka, R. 2018. Metodologia da Pesquisa Citentífica. 1ed. Núcleo de Tecnologia Educacional – NTE, Santa Maria, Rio Grande do Sul, Brasil.
Ramos, J.L.C.; Silva, J.C.S.; Prado, L.C.; Gomes, A.S.; Souza, F.F.S.; Zambon, E.G.; Rodrigues, R.L. 2017. Um Modelo Preditivo da Evasão dos Alunos na EAD a partir dos Construtos da Teoria da Distância Transacional. In: VI Congresso Brasileiro de Informática na Educação, 2017, Recife, Pernambuco, Brasil.
Rodrigues, D.H.; Reis, Z.C.; Matte, J.; Cardoso, J.J.; Gilbert, V.S.; Miri, D.H.; Chais, C.; Ganzer, P.P.; Olea, P.M. 2018. Motivos da rotatividade em uma empresa de telecomunicações da serra gaúcha. In: XVIII Mostra de Iniciação Científica, Pós-graduação, Pesquisa e Extensão, 2018, Caxias do Sul, Rio Grande do Sul, Brasil.
Rombaut, E.; Guerry, M. 2018. Predicting voluntary turnover through human resources database analysis. Management Research Review. 41 (1): 96-112.
Sexton, R.S.; McMurtey, S.; Michalopoulos, J.O.; Smith, A.M. 2005. Employee turnover: a neural network solution. Computers & Operations Research. 32 (10): 2635-2651.
Syce, C. 2012. Predicting employee voluntary turnover using human resources data. University of Cape Town. Cape Town, South Africa.
Ulrich, D. Dulebohn, J.H. 2015. Are we there yet? What’s next for HR?. Human Resource Management Review. 25 (2): 188-204.
Vergara, A.C. 2016. Projetos e Relatórios de Pesquisa em Administração. 16ed. Atlas, São Paulo, São Paulo, Brasil.
Yin, R.K. 2015. Estudo de Caso: Planejamento e Métodos. Bookman, Porto Alegre, Rio Grande do Sul, Brasil.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Gestão de Pessoas do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

