
10 de setembro de 2026
Desempenho de Modelos de Machine Learning na Seleção de Ações da Bolsa de Valores Brasileira
Gabriel Fernandes Masalskas; Ricardo Janes
DOI: 10.22167/2675-6528-202602221
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
O mercado acionário brasileiro, caracterizado por elevada volatilidade e restrições de liquidez, impõe desafios à aplicação de modelos de aprendizado de máquina na previsão de retornos e na construção de estratégias de investimento. O estudo comparou o desempenho preditivo e econômico de modelos de aprendizado de máquina e métodos estatísticos tradicionais na estimação de retornos futuros e na formação de carteiras baseadas em ranking de ativos. Utilizaram-se dados históricos de ações da B3, com variáveis técnicas e financeiras derivadas de preços e volume. Avaliaram-se modelos lineares (Regressão Linear, Ridge, LASSO, Elastic Net), de ensemble (Random Forest, XGBoost, LightGBM) e uma rede neural (Multilayer Perceptron). A avaliação preditiva ocorreu por métricas de erro em conjunto de teste, e a econômica por backtest de estratégias long-only, com custos operacionais baseados no turnover para análise de retornos brutos e líquidos. Os resultados revelaram baixa capacidade preditiva em todos os modelos, com R² negativos e erros elevados. Embora diferenças marginais nas previsões tenham gerado variações no desempenho econômico, estas foram de baixa magnitude e instáveis. O modelo LightGBM obteve o melhor desempenho econômico, mas com ganhos limitados em relação ao benchmark após a inclusão de custos operacionais. Não se observou evidência consistente de geração de retorno ajustado ao risco superior.
Palavras-chave: aprendizado de máquina; backtest; mercado acionário; previsão de retornos; seleção de ativos.
1. Introdução
O mercado acionário brasileiro, negociado pela B3 S.A. – Brasil, Bolsa, Balcão (B3), apresenta particularidades que o diferenciam de mercados desenvolvidos, impondo desafios específicos para a aplicação de modelos de aprendizado de máquina na previsão de retornos e na construção de estratégias de investimento. A compreensão de suas dinâmicas é fundamental para investidores e pesquisadores que buscam otimizar o desempenho e a gestão de riscos em um ambiente de alta complexidade.
Entre as características distintivas do mercado brasileiro, destacam-se a maior volatilidade, a menor profundidade de liquidez e os custos operacionais mais elevados. Estudos comparativos confirmam que mercados emergentes, como o Brasil, tendem a exibir maior sensibilidade a choques de volatilidade e menor liquidez estrutural em comparação a mercados maduros. Vartanian (2023), por exemplo, identificou o Brasil entre os mercados mais voláteis em períodos de instabilidade. De Carvalho (2021) evidenciou um prêmio de liquidez significativo nas ações da B3, enquanto Brito (2024) demonstrou que a relação entre liquidez e volatilidade no mercado nacional é acentuada durante crises. Adicionalmente, Benetti et al. (2007) destacaram que os custos operacionais e tributários no mercado acionário brasileiro permanecem superiores aos observados em países desenvolvidos. Essas particularidades estruturais tornam o Brasil um ambiente desafiador para a implementação de estratégias quantitativas.
Nesse contexto, o aprendizado de máquina (ML) surge como uma ferramenta promissora para analisar e prever retornos de ativos de renda variável. A literatura recente já demonstra avanços significativos na aplicação de ML em finanças. Arismendi-Zambrano et al. (2023) mostraram que métodos de ML baseados em regressões penalizadas são capazes de prever retornos intradiários no mercado brasileiro, gerando estratégias com desempenho ajustado ao custo de transação superior ao de benchmarks lineares. No campo de gestão de fundos, a CFA Society Brasil (2024) aplicou o XGBoost para distinguir gestores, constatando que carteiras formadas com base nas previsões do modelo apresentaram melhor relação risco-retorno. Felizardo e Pinto (2019) também avaliaram arquiteturas de redes neurais artificiais na previsão de retornos de ações brasileiras, demonstrando ganhos de assertividade em comparação a abordagens lineares, embora ressaltassem a sensibilidade do desempenho à calibragem de hiperparâmetros. Evidências adicionais (Henrique et al., 2019) indicam o potencial de modelos não lineares, como Support Vector Regression, na previsão de preços e retornos de ativos financeiros no Brasil, apesar de limitações associadas à estabilidade e generalização dos modelos.
Apesar desses avanços, lacunas relevantes persistem na literatura nacional. A maioria dos trabalhos concentra-se em previsões de alta frequência ou em análises de fundos, sendo raras as pesquisas que comparam de forma sistemática diferentes famílias de modelos de ML, como Random Forest, boosting (XGBoost, LightGBM) e redes neurais, em contextos de recomendação de ativos no mercado acionário. Além disso, poucos estudos incorporam elementos operacionais da realidade brasileira, como custos de transação, slippage e liquidez efetiva, em seus backtests e validações temporais. Essa carência impede uma avaliação completa da viabilidade prática e econômica das estratégias baseadas em ML no mercado local.
A aplicação de ML no mercado financeiro brasileiro, portanto, encontra-se em estágio promissor, mas ainda carente de abordagens que conciliem robustez preditiva e viabilidade operacional. Conforme ressaltam De Prado (2018) e Gu, Kelly e Xiu (2020), o sucesso de modelos de ML em finanças depende não apenas de desempenho estatístico, mas da capacidade de gerar previsões economicamente úteis e exequíveis. No contexto nacional, essa discussão torna-se particularmente relevante devido às restrições de liquidez e aos custos de negociação, que podem inviabilizar estratégias rentáveis em simulações. Assim, torna-se necessário desenvolver estudos que avaliem, de forma comparativa e reprodutível, o desempenho de diferentes algoritmos de ML em estratégias de recomendação de ativos no mercado acionário brasileiro, utilizando métricas ajustadas ao risco, como o índice de Sharpe, bem como medidas de drawdown e volatilidade. Em especial, compreender quais modelos oferecem o melhor trade-off entre desempenho e viabilidade operacional é uma contribuição relevante tanto para a pesquisa acadêmica quanto para a prática profissional. Diante disso, este trabalho tem como objetivo comparar os desempenhos preditivo e econômico de modelos de aprendizado de máquina e métodos estatísticos tradicionais na estimação de retornos futuros e na construção de estratégias de investimento baseadas em ranking no mercado acionário brasileiro.
2. Material e Métodos
Este trabalho avaliou a capacidade preditiva e a utilidade econômica de diferentes modelos de aprendizado de máquina e métodos estatísticos tradicionais aplicados ao mercado acionário brasileiro. A análise foi conduzida a partir de dados históricos de preços ajustados de ações negociadas na B3, contemplando um painel não balanceado de ativos.
Definição do universo investível e tratamento dos dados
O estudo utilizou dados históricos de preços ajustados de ações negociadas na B3, obtidos da plataforma “Dados de Mercado – Ações listadas na B3” e coletados via biblioteca Python yfinance (Yahoo Finance). As séries de preços corresponderam aos preços de fechamento ajustados (“adjusted close”), que incorporam eventos corporativos como dividendos e desdobramentos, garantindo consistência temporal dos retornos.
A partir do conjunto inicial de ativos, foram aplicados critérios de elegibilidade e filtragem sequencial para definir o universo investível. Esses critérios incluíram disponibilidade de dados históricos, consistência de preços, liquidez mínima (volume financeiro negociado) e exclusão de séries incompletas ou inconsistentes, conforme detalhado na Tabela 1.
Tabela 1. Etapas de definição do universo investível
| Etapa | Descrição |
|---|---|
| Base inicial | Ações listadas na B3 |
| Coleta de dados | Ativos com histórico disponível no provedor |
| Filtro de qualidade | Exclusão por inconsistências de preço e volume |
| Histórico mínimo | Exclusão de séries insuficientes |
| Liquidez | Seleção mensal dos 50 ativos mais líquidos |
| Universo final | Painel dinâmico de ativos elegíveis |
Fonte: Dados originais da pesquisa
Os dados diários foram agregados para periodicidade mensal, utilizando o último preço de fechamento disponível em cada mês. Adicionalmente, em cada período, os 50 ativos mais líquidos (com base no volume financeiro diário negociado) foram selecionados para compor um universo investível dinâmico, refletindo a realidade operacional do mercado.
Definição da variável target
A variável de interesse foi o retorno logarítmico mensal futuro de cada ativo, calculado a partir dos preços de fechamento mensais, conforme a Equação 1:
rt+1 = ln(Pt+1 / Pt) (1)
em que: rt+1 é o retorno logarítmico no período t+1; Pt+1 é o preço de fechamento no período t+1; e Pt é o preço de fechamento no período t. Este retorno foi associado ao período t (shift), de modo que as previsões realizadas ao final do mês t referiam-se ao retorno observado no mês t+1. O problema foi formulado como uma tarefa de regressão supervisionada para estimar retornos futuros contínuos. A avaliação econômica das estratégias foi realizada com base em retornos simples.
Construção das variáveis explicativas e dos modelos
As variáveis explicativas incluíram retornos defasados, medidas de volatilidade, indicadores de tendência e métricas técnicas baseadas em preço e volume, conforme detalhado na Tabela 2.
Tabela 2. Variáveis explicativas utilizadas na modelagem
| Grupo | Variável | Descrição |
|---|---|---|
| Retornos | ret_log_1d | Retorno logarítmico diário |
| Retornos | ret_5d | Retorno acumulado em 5 dias |
| Retornos | ret_21d | Retorno mensal |
| Retornos | ret_63d | Retorno trimestral |
| Retornos | ret_252d | Retorno anual |
| Volatilidade | vol_21d | Desvio padrão dos retornos (21 dias) |
| Volatilidade | vol_63d | Desvio padrão dos retornos (63 dias) |
| Tendência | price_sma21_ratio | Razão preço / média móvel 21 dias |
| Tendência | price_sma63_ratio | Razão preço / média móvel 63 dias |
| Tendência | sma_diff_21_63 | Diferença entre médias móveis (21d – 63d) |
| Indicadores | rsi_14 | Índice de Força Relativa (14 dias) |
| Indicadores | rsi_21 | Índice de Força Relativa (21 dias) |
| Indicadores | macd | Indicador MACD |
| Indicadores | macd_signal | Linha de sinal do MACD |
| Indicadores | macd_hist | Histograma do MACD |
| Risco | ATR_14 | Average True Range (14 dias) |
| Liquidez | vol_med_21d | Volume médio negociado |
| Liquidez | vol_med_63d | Volume médio (63 dias) |
| Liquidez | vol_fin_med_21d | Volume financeiro médio |
| Liquidez | vol_fin_med_63d | Volume financeiro médio (63 dias) |
| Liquidez | turnover_proxy | Proxy de liquidez |
| Outros | adx_14 | Índice Direcional Médio |
| Outros | obv | On Balance Volume |
Fonte: Dados originais da pesquisa
As variáveis foram calculadas diariamente e agregadas mensalmente, utilizando a última observação disponível. Todas as variáveis explicativas foram defasadas em um período (t-1) mensal para garantir que as previsões utilizassem apenas informações disponíveis até o final do mês anterior.
Foram selecionados modelos representativos de diferentes abordagens: regressões lineares (Regressão Linear, Ridge, LASSO e Elastic Net), modelos de ensemble baseados em árvores de decisão (Random Forest, XGBoost e LightGBM) e uma rede neural artificial (Multilayer Perceptron – MLP). A Tabela 3 lista os modelos e suas bibliotecas de implementação em Python.
Tabela 3. Modelos utilizados e respectivas bibliotecas de implementação
| Modelo | Biblioteca | Implementação |
|---|---|---|
| Regressão Linear | scikit-learn | LinearRegression |
| Ridge | scikit-learn | Ridge |
| LASSO | scikit-learn | Lasso |
| Elastic Net | scikit-learn | ElasticNet |
| Random Forest | scikit-learn | RandomForestRegressor |
| XGBoost | xgboost | XGBRegressor |
| LightGBM | lightgbm | LGBMRegressor |
| Rede Neural (MLP) | tensorflow / keras | Sequential (Dense) |
Fonte: Dados originais da pesquisa
As variáveis explicativas foram padronizadas por transformação z-score para modelos sensíveis à escala, enquanto modelos de ensemble foram estimados nas variáveis originais. Todos os modelos foram formulados como problemas de regressão supervisionada para prever retornos futuros contínuos. A amostra foi dividida temporalmente de forma sequencial, com 80% das observações iniciais para treinamento e 20% finais para teste, preservando a ordem cronológica dos dados.
A avaliação preditiva foi realizada por meio de métricas de erro (RMSE, MAE e R²), e a avaliação econômica foi conduzida por um “backtest” no conjunto de teste, utilizando métricas como retorno médio, volatilidade, índice de Sharpe e máximo “drawdown”. Um benchmark, definido como uma carteira igualmente ponderada de todos os ativos elegíveis com rebalanceamento mensal, foi usado como referência. Para garantir a reprodutibilidade, foram fixados “seeds” aleatórios nas bibliotecas Python (random), NumPy e TensorFlow.
Construção das estratégias baseadas em ranking
As previsões dos modelos foram usadas para construir estratégias de investimento “long-only” baseadas em ranking “cross-sectional”. Mensalmente, os 10 ativos com maior retorno previsto, dentre os 50 ativos mais líquidos do universo investível, foram selecionados para formar uma carteira igualmente ponderada. As carteiras foram integralmente rebalanceadas ao final de cada mês.
A rotatividade das carteiras foi mensurada pelo turnover médio mensal, que é a proporção de ativos substituídos entre períodos consecutivos. O retorno da estratégia foi calculado como a média simples dos retornos realizados dos ativos selecionados no mês subsequente. Custos operacionais foram incorporados como uma estimativa simplificada, aplicando um custo proporcional fixo de 0,2% por unidade de turnover. O retorno líquido (rliq) foi calculado deduzindo esse custo do retorno bruto (rbruto), conforme a Equação 2:
rliq = rbruto – c * turnovert (2)
onde c é o custo operacional (0,2%) e turnovert é a proporção de ativos substituídos no período t. O desempenho das carteiras foi avaliado no período de teste em termos de retorno bruto e líquido, sendo o retorno líquido a principal métrica de comparação econômica. O benchmark, por sua vez, não teve custos operacionais.
3. Resultados e Discussão
A interpretação dos resultados considerou o contexto metodológico adotado, incluindo o horizonte temporal do período do conjunto de teste e as simplificações inerentes ao backtest, como a modelagem de custos operacionais baseada no turnover das carteiras (fixada em 0,2%), sem a incorporação de componentes adicionais como slippage, impacto de mercado e restrições de liquidez.
Impacto dos filtros no universo de ativos
A aplicação dos critérios de elegibilidade e filtragem resultou em uma redução progressiva do universo inicial de ativos disponíveis para análise. A Tabela 4 apresenta o funil de seleção, detalhando o número de ativos remanescentes após cada etapa do processo.
Tabela 4. Funil de seleção do universo de ativos
| Etapa | Número de ativos |
|---|---|
| Base inicial (ações listadas – CSV) | 398 |
| Ativos com dados históricos no provedor | 393 |
| Após filtro de qualidade (preço e volume) | 150 |
| Após filtro de histórico mínimo | 150 |
| Top 50 por liquidez (amostra final) | 50 |
Fonte: Dados originais da pesquisa
Observou-se uma redução significativa do universo de ativos, de 398 para 50, o que representa uma contração de aproximadamente 87% do conjunto inicial. Essa redução evidencia a elevada concentração de liquidez no mercado acionário brasileiro e é consistente com a estrutura do mercado, onde poucos ativos possuem volume de negociação suficiente para estratégias sistemáticas. O universo final utilizado na modelagem e no backtest reflete predominantemente o comportamento de ativos de maior liquidez. Metodologicamente, essa filtragem implica que os resultados não são diretamente generalizáveis para ativos de menor negociação, e a definição dinâmica do universo investível influencia a composição das carteiras e do benchmark, impactando a avaliação comparativa das estratégias.
Estatísticas descritivas da variável alvo
Antes da modelagem, analisou-se a distribuição da variável alvo, o retorno logarítmico mensal futuro, para avaliar suas propriedades estatísticas e plausibilidade econômica. A Tabela 5 apresenta as estatísticas descritivas da variável.
Tabela 5. Estatísticas descritivas do retorno logarítmico mensal futuro
| Métrica | Valor |
|---|---|
| Observações | 3.207 |
| Média | 0,0121 |
| Desvio padrão | 0,1237 |
| Mínimo | -0,9252 |
| 1% | -0,3462 |
| 5% | -0,1661 |
| 25% | -0,0538 |
| Mediana | 0,0118 |
| 75% | 0,0807 |
| Máximo | 0,6987 |
Fonte: Resultados originais da pesquisa
Os resultados indicaram uma distribuição caracterizada por elevada volatilidade e caudas longas, padrão amplamente documentado na literatura financeira (Fama e French, 2015; Harvey et al., 2016). A média próxima de zero (0,012) e o desvio padrão elevado (0,124) evidenciaram um ambiente de baixa relação sinal-ruído, dificultando a identificação de padrões preditivos consistentes. A presença de valores extremos, com retornos mínimos próximos a -92% e máximos em torno de 70%, indicou a ocorrência de eventos idiossincráticos e uma assimetria negativa na distribuição, característica de mercados acionários emergentes. Essas propriedades implicam desafios na modelagem, como sensibilidade a outliers e instabilidade nas estimativas, reforçando a importância de avaliar o desempenho das estratégias de forma ajustada ao risco.
Avaliação preditiva dos modelos
A capacidade preditiva dos modelos foi avaliada por métricas de erro como RMSE, MAE e coeficiente de determinação (R²), calculadas no conjunto de teste. As previsões foram baseadas nas variáveis explicativas descritas na metodologia. A Tabela 6 apresenta o desempenho preditivo dos modelos, comparando abordagens lineares e não lineares.
Tabela 6. Desempenho preditivo dos modelos (RMSE, MAE e R²)
| Modelo | RMSE | MAE | R² |
|---|---|---|---|
| Linear | 0.1031 | 0.0754 | -0.0571 |
| Ridge | 0.1031 | 0.0754 | -0.0567 |
| LASSO | 0.1029 | 0.0753 | -0.0533 |
| ElasticNet | 0.1030 | 0.0754 | -0.0547 |
| RandomForest | 0.1017 | 0.0742 | -0.0297 |
| XGBoost | 0.1074 | 0.0792 | -0.1476 |
| LightGBM | 0.1121 | 0.0831 | -0.2503 |
| MLP | 0.1244 | 0.0943 | -0.5391 |
Fonte: Resultados originais da pesquisa
Todos os modelos apresentaram baixo poder preditivo no conjunto de teste, com coeficientes de determinação negativos em todas as especificações, indicando que suas previsões são, em média, inferiores a uma estratégia ingênua baseada na média histórica dos retornos. As diferenças entre os modelos em termos de RMSE e MAE foram relativamente pequenas, sem evidência de superioridade consistente de modelos mais complexos em relação às abordagens lineares. Modelos regularizados, como LASSO e Elastic Net, apresentaram desempenho marginalmente superior, enquanto modelos mais flexíveis, como Gradient Boosting e redes neurais, exibiram pior desempenho, sugerindo possível sobreajuste. A proximidade entre os valores de RMSE e o desvio padrão da variável alvo (Tabela 5) sugere que os modelos são incapazes de explicar parcela significativa da variância dos retornos em um ambiente de baixa relação sinal-ruído. As diferenças observadas devem ser interpretadas com cautela, dada a ausência de evidência estatística de capacidade preditiva superior (Giacomini e White, 2006).
Avaliação econômica das estratégias
A Tabela 7 apresenta os principais indicadores de desempenho econômico das estratégias baseadas em ranking, calculados no período de teste, já deduzidos dos custos operacionais estimados com base no turnover das carteiras. São reportados o retorno médio mensal, o retorno geométrico mensal, o retorno anualizado, a volatilidade dos retornos, o índice de Sharpe, o máximo drawdown e o turnover médio mensal, além do valor final de um investimento hipotético inicial de R$ 100.
Tabela 7. Desempenho econômico das estratégias por modelo
| Modelo | Ret. mensal (%) | Ret. geom (%) | Ret. anual (%) | Vol. (%) | Sharpe | Max DD (%) | Turnover médio mensal | R$ 100 final |
|---|---|---|---|---|---|---|---|---|
| LightGBM | 0,45 | 0,15 | 1,76 | 8,15 | 0,1920 | -28,79 | 0,5619 | 103,10 |
| Ridge | 0,28 | 0,01 | 0,10 | 7,75 | 0,1249 | -31,31 | 0,4619 | 100,18 |
| ElasticNet | 0,28 | -0,01 | -0,07 | 8,01 | 0,1225 | -33,30 | 0,4429 | 99,87 |
| Benchmark | 0,13 | -0,06 | -0,72 | 6,41 | 0,0703 | -25,34 | 98,74 | |
| LASSO | 0,21 | -0,10 | -1,21 | 8,29 | 0,0873 | -34,54 | 0,4143 | 97,90 |
| Linear | 0,13 | -0,11 | -1,31 | 7,22 | 0,0621 | -30,96 | 0,4714 | 97,72 |
| XGBoost | 0,24 | -0,12 | -1,38 | 8,83 | 0,0949 | -30,93 | 0,4524 | 97,60 |
| RandomForest | 0,16 | -0,18 | -2,10 | 8,42 | 0,0644 | -31,16 | 0,3476 | 96,35 |
| MLP | -0,43 | -0,62 | -7,14 | 6,30 | -0,2365 | -35,44 | 0,6000 | 87,84 |
Fonte: Resultados originais da pesquisa
O benchmark, uma estratégia passiva igualmente ponderada com rebalanceamento mensal, serviu como referência. Os resultados indicam que o desempenho econômico das estratégias baseadas em ranking foi, de forma geral, limitado. O modelo LightGBM apresentou o melhor desempenho, com retorno geométrico mensal positivo e valor final superior ao investimento inicial. Modelos lineares regularizados, como Ridge e Elastic Net, também exibiram retornos geométricos ligeiramente positivos. Contudo, modelos como Linear, LASSO, XGBoost, Random Forest e MLP mostraram retornos geométricos negativos, indicando perda de valor ao longo do tempo. A diferença entre retorno médio e geométrico reflete o impacto da volatilidade, resultando em crescimento composto negativo para a maioria dos modelos, onde a variabilidade dos retornos superou o ganho médio esperado. As diferenças de desempenho entre os modelos foram pequenas, e os índices de Sharpe permaneceram baixos, indicando que a relação risco-retorno das estratégias foi pouco atrativa. A janela de avaliação econômica, de 21 meses, é relativamente curta, o que implica sensibilidade dos resultados a condições específicas de mercado e limita a robustez das conclusões.
Evolução temporal do desempenho das estratégias
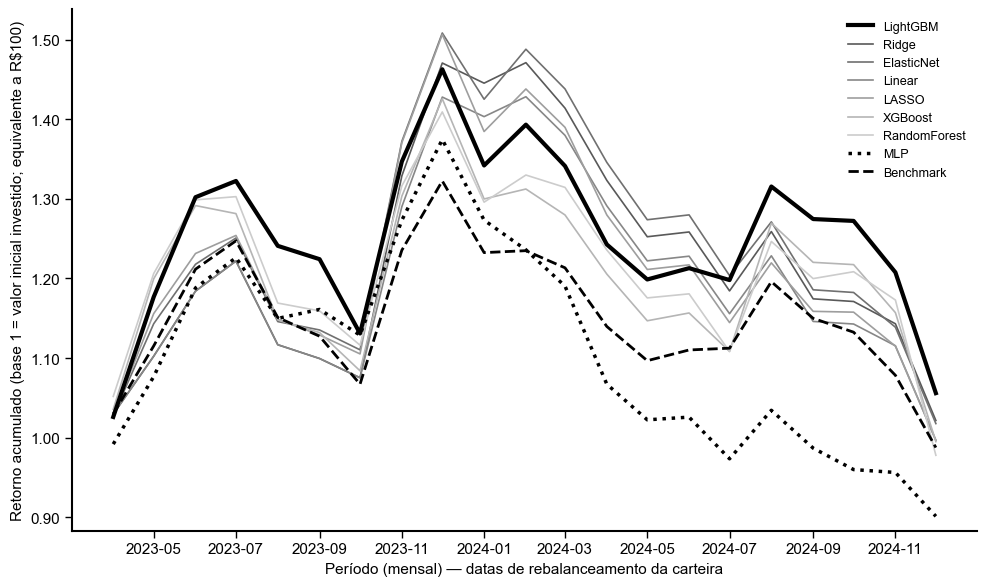
A Figura 1 apresenta a evolução temporal do retorno acumulado das estratégias baseadas em ranking no período do conjunto de teste, construído a partir da capitalização composta dos retornos mensais de cada modelo, incluindo o benchmark.
Figura 1. Evolução do retorno acumulado das estratégias baseadas em modelos de machine learning
Fonte: Resultados originais da pesquisa
A análise da Figura 1 evidencia diferenças relevantes na trajetória de desempenho entre as estratégias. O modelo com melhor desempenho apresentou uma trajetória de crescimento relativamente mais consistente, ainda que com episódios de queda, enquanto o modelo de pior desempenho exibiu deterioração progressiva do capital. O benchmark apresentou comportamento intermediário, com menor amplitude de variação, refletindo o efeito da diversificação. As estratégias não seguiram trajetórias monotônicas de crescimento, sendo caracterizadas por ciclos alternados de ganhos e perdas. Pequenas diferenças nas previsões dos modelos podem se traduzir em impactos relevantes no desempenho acumulado, reforçando a sensibilidade das estratégias à ordenação relativa dos ativos. A dispersão entre as curvas ao final do período foi limitada, sugerindo que a diferença de desempenho decorre mais de acertos pontuais do que de vantagens persistentes, alinhado à baixa capacidade preditiva. A presença de períodos prolongados de drawdown em quase todas as estratégias evidencia o risco significativo associado, mesmo em casos de desempenho final positivo, reforçando a importância de avaliar a dinâmica temporal das perdas em contextos de elevada volatilidade.
Relação entre turnover e desempenho econômico
A incorporação de custos operacionais, mesmo simplificada, alterou a ordenação relativa dos modelos, evidenciando a importância de uma modelagem acurada desses custos. A Tabela 8 apresenta o impacto dos custos operacionais estimados no desempenho das estratégias, incluindo retornos anualizados e valores finais antes e após a dedução de custos, bem como métricas associadas à rotatividade das carteiras.
Tabela 8. Impacto de custos de transação no desempenho das estratégias
| Modelo | Ret. anual bruto (%) | Valor final bruto (R$) | Turnover médio mensal | Total de ativos trocados | Custo total est. (R$) | Ret. anual líq. (%) | Valor final líq. (R$) |
|---|---|---|---|---|---|---|---|
| LightGBM | 3,15 | 105,58 | 0,5619 | 118 | 2,36 | 1,76 | 103,10 |
| Ridge | 1,22 | 102,14 | 0,4619 | 97 | 1,94 | 0,10 | 100,18 |
| ElasticNet | 1,00 | 101,75 | 0,4429 | 93 | 1,86 | -0,07 | 99,87 |
| Benchmark | -0,72 | 98,74 | -0,72 | 98,74 | |||
| LASSO | -0,21 | 99,62 | 0,4143 | 87 | 1,74 | -1,21 | 97,90 |
| Linear | -0,19 | 99,67 | 0,4714 | 99 | 1,98 | -1,31 | 97,72 |
| XGBoost | -0,29 | 99,49 | 0,4524 | 95 | 1,90 | -1,38 | 97,60 |
| RandomForest | -1,28 | 97,77 | 0,3476 | 73 | 1,46 | -2,10 | 96,35 |
| MLP | -5,78 | 90,10 | 0,6000 | 126 | 2,52 | -7,14 | 87,84 |
Fonte: Resultados originais da pesquisa
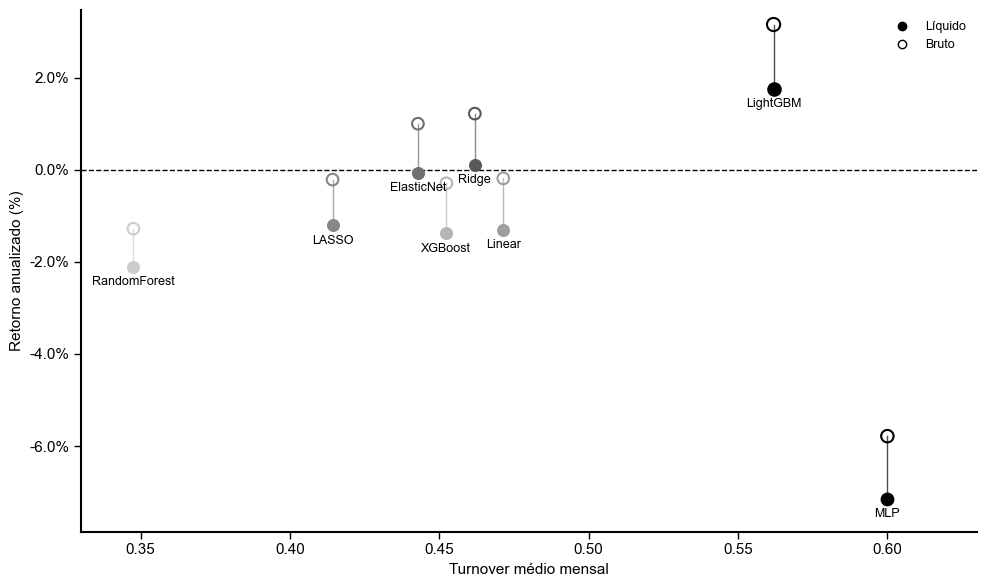
A comparação entre retornos brutos e líquidos mostra que a incorporação de custos não apenas reduz o retorno, mas pode alterar a ordenação relativa das estratégias. Modelos com desempenho bruto superior podem se tornar inferiores após a dedução de custos, especialmente com alta rotatividade, indicando que a avaliação baseada apenas em retornos brutos pode ser enviesada. O turnover médio mensal variou entre 0,35 e 0,60. Estratégias com maior rotatividade, como LightGBM e MLP, apresentaram maior custo acumulado. Em contraste, modelos com menor turnover, como Random Forest, tiveram menor erosão de retorno, sugerindo que a eficiência da estratégia depende da interação entre capacidade preditiva e intensidade de negociação. A Figura 2 ilustra a relação entre o turnover médio mensal e o retorno anualizado líquido.
Figura 2. Relação entre turnover médio mensal e retorno anualizado líquido das estratégias
Fonte: Resultados originais da pesquisa
A Figura 2 não mostra uma relação monotônica clara entre rotatividade e desempenho, indicando que níveis mais elevados de turnover não implicam necessariamente em pior desempenho econômico. No entanto, há maior dispersão dos resultados entre estratégias com maior rotatividade, sugerindo que o turnover amplifica a variabilidade do desempenho ao aumentar a exposição a custos operacionais. Esse resultado indica que o impacto econômico da rotatividade é determinado pela interação entre custos operacionais e qualidade do sinal preditivo. Estratégias com maior capacidade de ordenação relativa podem compensar custos de negociação, enquanto modelos com baixa capacidade preditiva tendem a ter seu desempenho deteriorado. A modelagem de custos operacionais é central na avaliação de estratégias de aprendizado de máquina, e o uso de proxies simplificadas, embora útil para comparação, pode não capturar integralmente as fricções reais de mercado, superestimando o desempenho econômico das estratégias.
Interpretação integrada dos resultados
Os resultados evidenciaram baixa capacidade preditiva dos modelos, com R² negativos no conjunto fora da amostra (Tabela 6), indicando que não superaram previsões baseadas na média histórica dos retornos. Isso é consistente com a elevada volatilidade e baixa relação sinal-ruído da variável alvo (Tabela 5). Apesar dessa limitação, pequenas diferenças nas estimativas foram suficientes para gerar variações no desempenho econômico das estratégias (Tabela 7), devido ao mecanismo de seleção por ranking, onde a ordenação relativa dos ativos foi mais relevante que a precisão absoluta. Contudo, essas variações foram reduzidas e não configuraram evidência robusta de geração consistente de valor, com as estratégias apresentando desempenho líquido próximo ao benchmark, com ganhos pontuais e dependentes do período. A incorporação de custos operacionais reduziu os retornos e, em alguns casos, alterou a ordenação relativa das estratégias, evidenciando a influência da intensidade de negociação. A relação entre turnover e desempenho (Figura 2) não indicou um padrão monotônico claro. A comparação com o benchmark revelou um trade-off entre estratégias ativas e passivas; embora algumas estratégias tenham superado o benchmark em certos momentos, este apresentou menor volatilidade e drawdowns mais controlados (Tabela 7 e Figura 1), refletindo o efeito da diversificação. A análise temporal indicou ausência de superioridade persistente entre os modelos, com alternância frequente de desempenho, sugerindo forte dependência do recorte temporal. Em conjunto, os modelos avaliados não apresentaram capacidade consistente de geração de retorno ajustado ao risco superior ao benchmark.
4. Conclusão
Este trabalho teve como objetivo comparar os desempenhos preditivo e econômico de modelos de aprendizado de máquina e métodos estatísticos tradicionais na estimação de retornos futuros e na construção de estratégias de investimento baseadas em ranking no mercado acionário brasileiro. Verificou-se que todos os modelos avaliados apresentaram baixa capacidade preditiva no conjunto de teste, com coeficientes de determinação negativos, indicando que suas previsões foram, em média, inferiores a uma estratégia ingênua. Apesar das diferenças marginais nas previsões, estas geraram variações no desempenho econômico das estratégias, embora de baixa magnitude e instáveis ao longo do tempo. O modelo LightGBM obteve o melhor desempenho econômico, mas com ganhos limitados em relação ao benchmark após a incorporação de custos operacionais. Não se observou evidência consistente de geração de retorno ajustado ao risco superior ao benchmark. A principal contribuição do estudo reside na avaliação sistemática de diferentes famílias de modelos de aprendizado de máquina em um mercado emergente desafiador, destacando a importância da modelagem de custos operacionais e a limitada viabilidade prática de estratégias de geração de alpha nas configurações testadas.
As limitações do estudo incluíram a simplificação na modelagem de custos operacionais, que não contemplou componentes como slippage e impacto de mercado, e a restrição do universo de ativos aos 50 mais líquidos, o que limita a generalização dos resultados para ativos de menor negociação. Adicionalmente, a janela de avaliação econômica, de 21 meses, implica sensibilidade dos resultados a condições específicas de mercado. Para estudos futuros, sugere-se a implementação de validação temporal mais robusta, como abordagens walk-forward, o tuning sistemático de hiperparâmetros, a modelagem mais realista de fricções de mercado e a exploração de diferentes regras de construção de portfólio e rebalanceamento, bem como a revisão dos critérios de definição do universo investível.
Referências Bibliográficas
ARISMENDI-ZAMBRANO, J.; LEONE ALEXANDRE, A.; GENARO, A. Intraday returns forecasting using machine learning: evidence from the Brazilian stock market. SSRN Electronic Journal, 2023. DOI: 10.2139/ssrn.5122977. Acesso em: 9 set. 2025.
BENETTI, C.; DECOURT, R.; RENATO, P. The practice of corporate finance in Brazil and in the USA: comparative survey evidence. São Paulo: ICN Business School; Universidade do Vale do Rio dos Sinos; Catholic University of Santiago de Guayaquil, 2007. Disponível em: https://www.researchgate.net/publication/265454641. Acesso em: 4 nov. 2025.
BRITO, A. D. Instability of returns and liquidity during the Covid-19 pandemic: evidence from the Brazilian stock market. Revista de Administração UFSM, v. 17, n. 2, p. 1–19, 2024. Disponível em: https://periodicos.ufsm.br/reaufsm/article/view/84713. Acesso em: 9 set. 2025.
CARVALHO, G. A. de. Pricing of liquidity risk in the Brazilian stock market. Revista Brasileira de Finanças, v. 19, n. 3, p. 67–94, 2021. Disponível em: https://periodicos.fgv.br/rbfin/article/view/81844. Acesso em: 8 set. 2025.
CFA SOCIETY BRASIL. Using machine learning to separate good and bad equity mutual fund managers: evidence from Brazil. São Paulo: CFA Society Brasil, 2024. Disponível em: https://cfasociety.org.br/wp-content/uploads/2024/09/final_paper.pdf. Acesso em: 14 out. 2025.
DE PRADO, M. L. Advances in financial machine learning. Hoboken: John Wiley & Sons, 2018. Acesso em: 7 fev. 2026.
FAMA, E. F.; FRENCH, K. R. A five-factor asset pricing model. Journal of Financial Economics, v. 116, n. 1, p. 1–22, 2015. DOI: 10.1016/j.jfineco.2014.10.010. Acesso em: 10 jan. 2026.
FELIZARDO, C.; PINTO, A. A study on neural network architecture applied to the prediction of Brazilian stock returns. arXiv preprint, arXiv:1901.09143, 2019. Disponível em: https://arxiv.org/abs/1901.09143. Acesso em: 1 nov. 2025.
GIACOMINI, R.; WHITE, H. Tests of conditional predictive ability. Econometrica, v. 74, n. 6, p. 1545-1578, 2006. DOI: 10.1111/j.1468-0262.2006.00718.x. Acesso em: 19 jan. 2026.
GU, S.; KELLY, B.; XIU, D. Empirical asset pricing via machine learning. The Review of Financial Studies, v. 33, n. 5, p. 2223–2273, 2020. DOI: 10.1093/rfs/hhaa009. Acesso em: 19 jan. 2026.
HARVEY, C. R.; LIU, Y.; ZHU, H. …and the cross-section of expected returns. The Review of Financial Studies, v. 29, n. 1, p. 5–68, 2016. DOI: 10.1093/rfs/hhv059. Acesso em: 19 jan. 2026.
HENRIQUE, B. M.; SOBREIRO, V. A.; KIMURA, H. Stock price prediction using support vector regression on daily and up to the minute prices. Journal of Finance and Data Science, v. 5, n. 1, p. 1–12, 2019. DOI: 10.1016/j.jfds.2018.04.003. Acesso em: 1 nov. 2025.
VARTANIAN, P. R. The VIX index and the volatility of the Latin American and G7 markets. International Journal of Economics and Finance, v. 15, n. 4, p. 1–15, 2023. DOI: 10.5539/ijef.v15n12p25. Acesso em: 1 nov. 2025.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

