
19 de agosto de 2026
Classificação Preditiva de Ações na B3 Via Indicadores Fundamentalistas e Machine Learning
Alexandre dos Santos de Souza; Cassia Renata Pinheiro
DOI: 10.22167/2675-6528-202601592
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A presente pesquisa investigou a aplicação de modelos de aprendizado de máquina na classificação preditiva de ativos da B3, utilizando indicadores fundamentalistas extraídos da Comissão de Valores Mobiliários (CVM) e da própria B3. O objetivo foi analisar a eficácia dessas técnicas para prever o desempenho futuro de ações no mercado brasileiro. A metodologia envolveu a estruturação de um pipeline de dados robusto, com normalização via Robust Scaler e o uso de retornos logarítmicos para garantir a estabilidade estatística das projeções. Entre os modelos testados, o Random Forest demonstrou maior consistência e desempenho superior, alcançando uma acurácia de 55,97% e identificando a Margem Líquida como o principal indicador de performance. Uma estratégia de investimento que combinou um Motor de Scoring Fundamentalista com aportes constantes apresentou resultados expressivos, obtendo um Índice de Sharpe de 1,15 e superando o benchmark Ibovespa com menor volatilidade anualizada. Concluiu-se que as tecnologias de inteligência artificial são ferramentas de suporte eficazes para a otimização de investimentos, embora o fator humano permaneça essencial na tomada de decisão final, dada a influência do comportamento humano na dinâmica econômica. Palavras-chave: Aprendizado de Máquina; Finanças Quantitativas; Indicadores Financeiros; Random Forest; XGBoost.
1. Introdução
A estabilidade financeira familiar é um pilar fundamental para o bem-estar social e a segurança de longo prazo. A capacidade de gerir as finanças domésticas, incluindo poupança e investimento, transcende a mera acumulação de riqueza, sendo uma ferramenta essencial para a resiliência econômica. A literatura acadêmica estabelece uma correlação direta entre baixos níveis de letramento financeiro e maiores índices de endividamento, o que acentua a vulnerabilidade das famílias frente a cenários econômicos adversos (Lusardi e Mitchell, 2014; BCB, 2021).
No Brasil, o mercado de capitais, apesar de abrigar empresas com décadas de lucros consistentes, ainda exibe uma participação popular significativamente inferior à observada em economias desenvolvidas. Dados da B3 (2024) indicam um crescimento no número de investidores pessoa física em renda variável, passando de 5,2 milhões para 5,4 milhões entre o terceiro trimestre de 2024 e 2025. Contudo, este percentual permanece baixo para um país com mais de 200 milhões de habitantes. Em contraste, mercados maduros, como o norte-americano, registram que mais de 60% da população adulta possui investimentos em ações, direta ou indiretamente (Gallup, 2024). Essa disparidade não apenas revela uma lacuna cultural, mas também uma vasta oportunidade para o desenvolvimento do mercado financeiro nacional.
A análise fundamentalista clássica é reconhecida como um método eficaz para a alocação de recursos financeiros, buscando identificar o valor intrínseco de uma empresa por meio da avaliação de seus dados econômico-financeiros. No entanto, sua aplicação prática apresenta complexidades crescentes, especialmente diante do volume cada vez maior de empresas com capital aberto. O processo de avaliação manual exige profundo conhecimento técnico, o que dificulta a entrada de investidores iniciantes. Além disso, a tomada de decisão humana é frequentemente influenciada por vieses cognitivos e emocionais, conforme abordado por Kahneman (2011), levando a tentativas de prever o “timing do mercado” que, estatisticamente, podem comprometer os retornos de longo prazo.
Diante dessas limitações e da crescente disponibilidade de dados, a aplicação de Machine Learning e Data Science emerge como uma abordagem promissora para aprimorar a qualificação de indicadores fundamentalistas e a previsão de retornos de ações. Essas tecnologias oferecem a capacidade de processar e analisar grandes volumes de dados de maneira eficiente, identificando padrões complexos que seriam inviáveis para a análise humana tradicional. A inteligência artificial, nesse contexto, pode atuar como uma ferramenta de suporte para otimizar as decisões de investimento, mitigando vieses e aumentando a objetividade.
A pesquisa se fundamenta na premissa de que a integração de modelos preditivos de Machine Learning com indicadores fundamentalistas pode revelar relações significativas entre a saúde financeira de uma empresa e o desempenho futuro de suas ações. Indicadores como Valor, Rentabilidade e Crescimento, extraídos de fontes como a Comissão de Valores Mobiliários (CVM) e a B3, são cruciais para a avaliação da performance de ativos. A utilização de algoritmos de aprendizado de máquina permite a construção de modelos quantitativos capazes de aprender com esses dados históricos e fazer classificações preditivas, oferecendo uma perspectiva mais estruturada e menos suscetível a falhas humanas na seleção de investimentos.
A lacuna prática reside na dificuldade de investidores, especialmente os iniciantes, em navegar pela complexidade do mercado de capitais e na ineficiência da análise manual frente à vasta quantidade de informações disponíveis. A lacuna teórica, por sua vez, é preenchida pela investigação de como algoritmos de Machine Learning podem ser otimizados para extrair valor preditivo de indicadores fundamentalistas em um contexto de mercado emergente como o brasileiro. A justificativa para este estudo reside, portanto, na necessidade de desenvolver ferramentas mais eficientes e objetivas para a classificação preditiva de ativos, contribuindo para a democratização do acesso a estratégias de investimento mais sofisticadas e para o desenvolvimento do mercado de capitais nacional.
Nesse sentido, este trabalho justifica-se pela aplicação de Machine Learning e Data Science na qualificação dos indicadores fundamentalistas e na previsão de retornos de ações, e tem como objetivo analisar a aplicação de modelos de Machine Learning na classificação preditiva de ativos da B3, fundamentando-se em indicadores fundamentalistas extraídos da Comissão de Valores Mobiliários (CVM) e da B3.
2. Material e Métodos
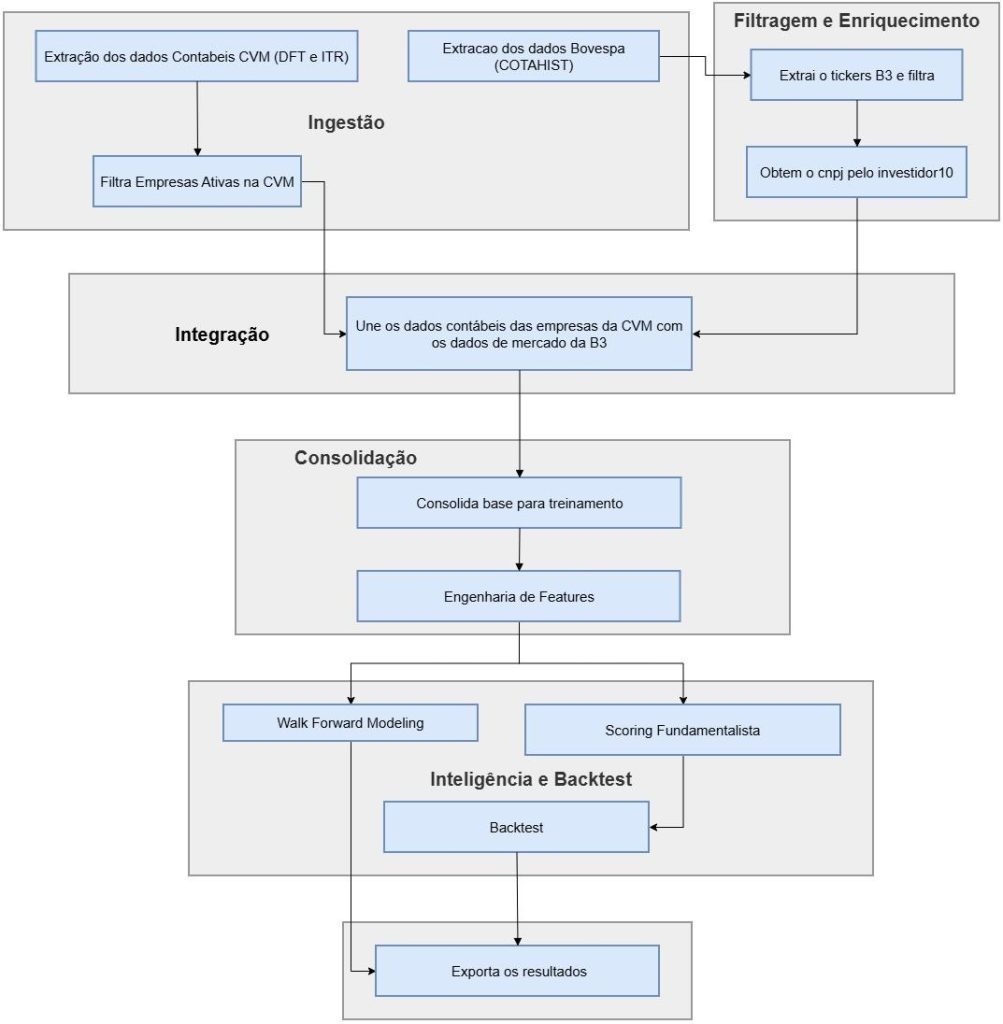
O estudo adotou abordagem quantitativa e aplicada, implementando um pipeline de Data Science em Python para otimizar a análise de informações financeiras e gerar previsões baseadas em indicadores fundamentalistas. A metodologia visou avaliar o desempenho e perspectivas futuras de empresas na B3. Desenvolveu-se um modelo quantitativo para processar grandes volumes de dados, identificando padrões que correlacionam indicadores financeiros com a performance futura dos ativos. O procedimento metodológico, ilustrado na Figura 1, organizou-se em etapas de coleta, organização e análise, desde a extração dos dados brutos até a fase de inteligência e backtest.Figura 1. Pipeline metodológico de processamento de dados e engenharia de atributos
Fonte: Dados originais da pesquisa
A Figura 1 detalha as fases de ingestão, filtragem, enriquecimento, integração, consolidação, engenharia de features, modelagem e backtest. Essa representação visual da estrutura metodológica foi essencial para compreender a arquitetura do processo de análise e modelagem preditiva, garantindo a robustez e a integridade de cada etapa.
A unidade de análise consistiu em ativos negociados na B3, focando em empresas de capital aberto no mercado acionário brasileiro. Os dados foram coletados de fontes oficiais, abrangendo período histórico relevante para a construção e validação dos modelos. A população de dados incluiu arquivos históricos de cotações (COTAHIST) da B3 e Demonstrações Financeiras Padronizadas (DFP) e Informações Trimestrais (ITR) da Comissão de Valores Mobiliários (CVM). Para a seleção do universo elegível, aplicaram-se critérios de inclusão: ações com presença em, no mínimo, 100 pregões e volume financeiro mediano diário superior a R$50.000,00, excluindo ativos de baixa liquidez ou micro-caps.
A pesquisa utilizou a linguagem Python para o desenvolvimento do pipeline de Data Science. As fontes de dados primárias foram os arquivos COHIST da B3 e os documentos DFP e ITR da CVM. Para integração e enriquecimento, empregou-se web scraping no site Investidor 10 para obter o CNPJ das empresas e a API do Yahoo Finance para resgatar cotações ajustadas. Os algoritmos de Machine Learning Random Forest e XGBoost foram selecionados para a modelagem preditiva, e o Robust Scaler foi utilizado para a normalização dos dados.
A coleta de dados iniciou-se com a extração dos arquivos COHIST da B3, filtrando cotações diárias de lote padrão (TIPREG = ’01’ e TPMERC = ‘010’). Concomitantemente, extraíram-se os arquivos DFP e ITR da CVM, focando em contas primárias como Ativo Total, Patrimônio Líquido, Receita e Lucro Líquido. Para evitar o look-ahead bias, aplicou-se atraso informacional de 60 dias entre o balanço e a cotação da ação. Os dados brutos foram organizados, com arquivos Fixed-Width da B3 convertidos para Parquet e os da CVM consolidados em CSV, além de ajustes de escala monetária e tipagem temporal.
A integração entre os dados da B3 e da CVM foi realizada utilizando o CNPJ como chave, obtido via web scraping no site Investidor 10, o que também filtrou tickers inativos. As contas contábeis brutas foram combinadas para gerar variáveis preditivas, como Margem Líquida, Retorno sobre o Patrimônio Líquido (ROE) e Nível de Alavancagem. Anomalias matemáticas foram tratadas, convertendo divisões por zero ou valores infinitos em nulos. A variável alvo foi otimizada pelo Logaritmo Natural dos retornos (Log-Returns) para maior estabilidade estatística. As features contínuas foram normalizadas via Robust Scaler, adequado para lidar com a assimetria do mercado e outliers (Malla et al., 2026).
A modelagem preditiva e a seleção de ativos foram estruturadas com abordagem híbrida, combinando inteligência artificial e análise fundamentalista. Os algoritmos Random Forest e XGBoost foram configurados para aprender as relações complexas entre indicadores contábeis e o desempenho futuro das ações. Para evitar o look-ahead bias, o treinamento seguiu ordem cronológica rigorosa, empregando a técnica de Walk-Forward Validation com janela expansiva. Paralelamente, desenvolveu-se um Motor de Scoring Fundamentalista, que atuou como filtro de qualidade e ranqueamento transparente para as empresas.
A validação prática foi realizada por um Backtest, simulando estratégia de Buy & Hold com rebalanceamentos periódicos, utilizando cotações ajustadas da API do Yahoo Finance para refletir o retorno real do acionista. O processo de backtest incluiu validação gráfica e estatística do desempenho da carteira frente ao índice Ibovespa, além da extração de métricas institucionais de risco, como Índice de Sharpe, Volatilidade Anualizada e Maximum Drawdown. A pesquisa utilizou exclusivamente dados públicos e anonimizados, não havendo necessidade de termos de consentimento ou outros cuidados éticos relacionados à privacidade de participantes.
3. Resultados e Discussão
A fase inicial da pesquisa revelou desafios significativos na obtenção e estruturação de dados financeiros. Embora plataformas proprietárias de consolidação de dados, como a Economatica, tenham sido consideradas, a necessidade de garantir a reprodutibilidade do projeto e controlar os custos levou à exploração de repositórios públicos. Contudo, as bases de dados disponíveis em plataformas como o Kaggle mostraram-se frequentemente incompletas, desatualizadas ou carentes da granularidade necessária para a análise proposta. Diante disso, optou-se por desenvolver um pipeline próprio de Extração, Transformação e Carregamento (ETL), processando os dados brutos diretamente das fontes oficiais da Comissão de Valores Mobiliários (CVM) e da B3.
Após a extração e estruturação das séries temporais, a integração das bases de dados da CVM e da B3 apresentou um desafio estrutural devido à ausência de uma chave primária comum. Para superar essa dificuldade, aplicou-se um filtro de liquidez nos ativos e, em seguida, desenvolveu-se um algoritmo de web scraping direcionado ao portal financeiro Investidor 10. Essa abordagem permitiu vincular as duas fontes por meio do CNPJ, consolidando uma base de dados rica em informações contábeis e de mercado. Adicionalmente, foi necessário ajustar as cotações nominais da B3 para refletir eventos corporativos, utilizando o preço de fechamento ajustado via API yfinance, e empregar a técnica de As-Of Merge para integrar balanços trimestrais com cotações diárias, prevenindo o viés de antecipação (look-ahead bias).
A variável alvo do modelo foi estruturada com base em retornos logarítmicos, em vez de retornos percentuais simples. Essa escolha conferiu maior simetria matemática entre altas e baixas, aproximando a distribuição dos dados de uma curva normal e otimizando a convergência dos modelos de Machine Learning, conforme destacado por Malla et al. (2026). Foram aplicados filtros de sanidade para limitar variações trimestrais entre perdas de 95% e ganhos de 500%, resultando em um dataset consolidado e robusto para as etapas subsequentes de modelagem e análise preditiva.
O dataset consolidado, essencial para o treinamento dos modelos, incluiu diversas variáveis contábeis e de mercado. Entre as variáveis mapeadas, destacam-se o identificador único CVM (CD_CVM), a razão social (DENOM_SOCIAL), o lucro líquido (LUCRO LIQUIDO), o patrimônio líquido (PATRIMONIO LIQUIDO), a receita (RECEITA), o setor econômico (SETOR_ATIV), o código de negociação da ação na B3 (TICKER_PREV) e o CNPJ, que serviu como chave de integração. Variáveis de mercado como a data do pregão (DATA_PREGAO), o preço ajustado da ação (PRECO_ADJUSTED), o retorno alvo (TARGET_RETORNO) e o preço futuro (PRECO_FUTURO) também foram incorporadas para enriquecer a base de dados, conforme detalhado na Tabela 1 do TCC original.
Com a base de dados consolidada, a etapa de engenharia de features transformou os dados contábeis absolutos em indicadores financeiros proporcionais, como Retorno sobre o Patrimônio Líquido (ROE), Margem Líquida, Nível de Alavancagem e Giro do Ativo. Esses indicadores foram submetidos a uma normalização transversal agrupada por trimestre, utilizando o Robust Scaler. A escolha do Robust Scaler, em detrimento de métodos tradicionais como o Z-Score, deveu-se à sua capacidade de neutralizar distorções macroeconômicas e minimizar o impacto de outliers, garantindo que o sinal preditivo de empresas saudáveis não fosse ofuscado por anomalias extremas, conforme recomendado por Malla et al. (2026).
A modelagem preditiva e a seleção de ativos foram estruturadas em uma abordagem dupla, combinando inteligência artificial com análise fundamentalista clássica. Os algoritmos Random Forest e XGBoost foram empregados para aprender as complexas relações entre os indicadores contábeis e o desempenho futuro das ações. Para evitar o look-ahead bias, o treinamento seguiu uma rigorosa ordem cronológica por meio da técnica de Walk-Forward Validation com janela expansiva. Paralelamente, um Motor de Scoring Fundamentalista foi desenvolvido para atuar como um filtro de qualidade, ranqueando empresas com base em rentabilidade (Margem Líquida e ROE) e penalizando aquelas com alto risco de endividamento (Nível de Alavancagem).
A avaliação do desempenho geral dos modelos Random Forest e XGBoost revelou uma leve superioridade do primeiro. O Random Forest alcançou uma acurácia de 55,97%, uma precisão de 55,52%, um recall de 62,11% e um F1 Score de 58,63%. Em comparação, o XGBoost obteve uma acurácia de 54,90%, precisão de 54,72%, recall de 59,23% e F1 Score de 56,89%. Esses resultados, apresentados na Tabela 2 do TCC original, indicam que o Random Forest demonstrou um equilíbrio superior entre a assertividade direcional e a capacidade de capturar oportunidades, o que, no mercado financeiro, pode se traduzir em ganhos acumulados mais consistentes no longo prazo.
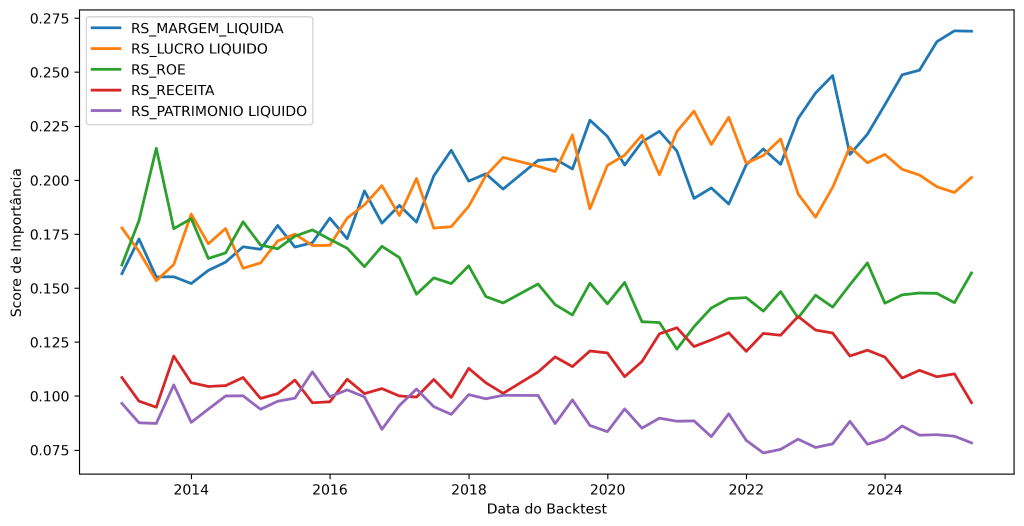
A análise da evolução da importância das variáveis preditoras ao longo do tempo, para ambos os modelos, forneceu insights cruciais sobre sua estabilidade e sensibilidade. A Figura 2 ilustra que o Random Forest manteve uma estrutura de aprendizado mais consistente, com a Margem Líquida e o Lucro Líquido consolidando-se como os principais preditores ao longo da última década. Essa estabilidade sugere uma menor sensibilidade ao ruído e um risco reduzido de overfitting, o que é fundamental para a robustez do modelo em cenários de mercado dinâmicos.Figura 2. Evolução da Importância das Features para o Random Forest
Fonte: Resultados originais da pesquisa
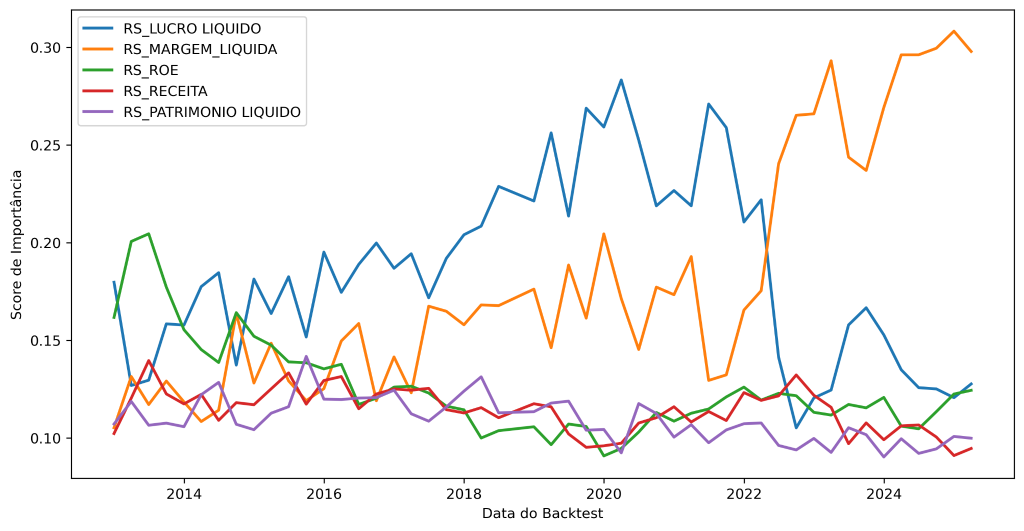
Em contraste, a Figura 3, que representa a evolução da importância das features para o XGBoost, revelou uma volatilidade extrema. Observaram-se inversões abruptas de dominância entre os indicadores a partir de 2022, o que aponta para uma maior sensibilidade do XGBoost ao ruído e um risco elevado de overfitting aos dados mais recentes. Essa característica pode comprometer a generalização do modelo em períodos de mudança de regime de mercado, tornando-o menos confiável para previsões de longo prazo em comparação com o Random Forest, que exibiu maior consistência em sua capacidade preditiva.Figura 3. Evolução da Importância das Features para o XGBoost
Fonte: Resultados originais da pesquisa
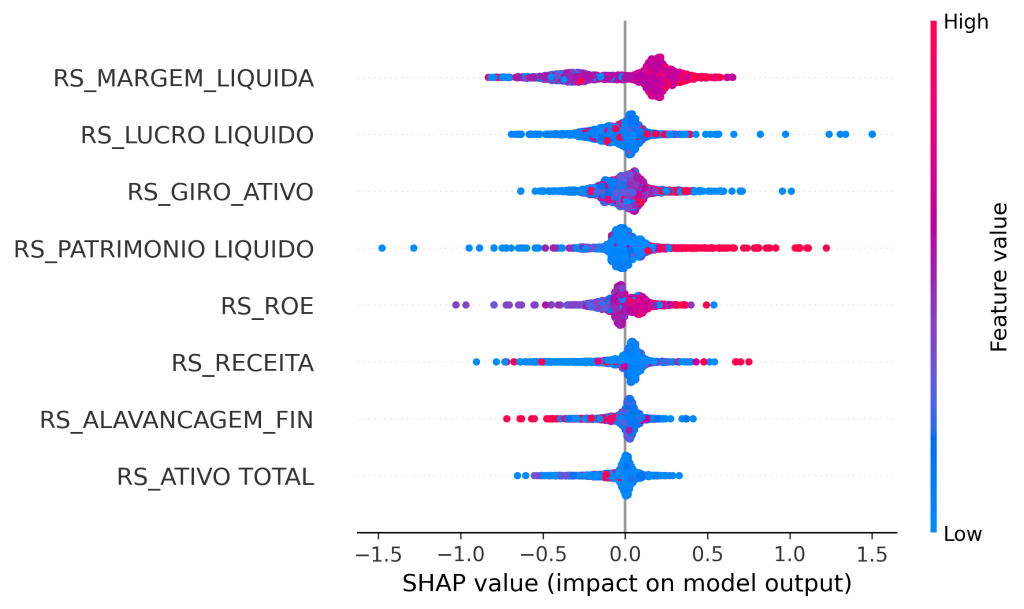
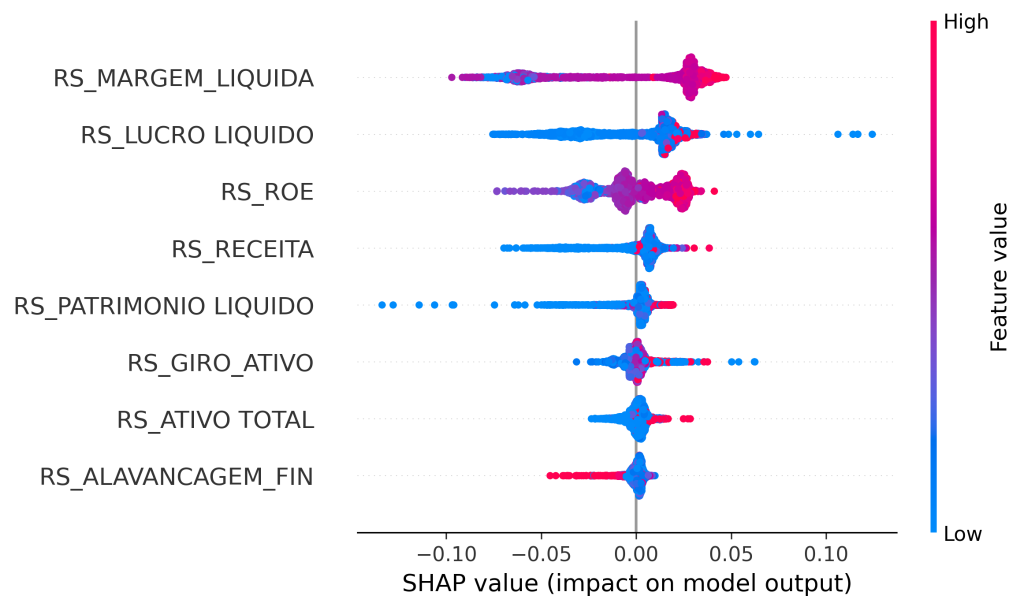
Os gráficos SHAP (Shapley Additive explanations) foram utilizados para aprofundar a compreensão da importância das variáveis, confirmando a Margem Líquida como o principal pilar preditivo para ambos os modelos. A Figura 4, referente ao XGBoost, e a Figura 5, para o Random Forest, evidenciam uma correlação direta e positiva entre margens altas e sinais de valorização. Contudo, o Random Forest demonstrou uma interpretação mais clara e estável das variáveis fundamentais, penalizando empresas com baixo patrimônio e recompensando a eficiência operacional de forma consistente, enquanto o XGBoost operou com uma agressividade superior, porém mais ruidosa e menos transparente em suas atribuições de importância.Figura 4. Gráfico de Importância de Variáveis (SHAP) para o XGBoost
Fonte: Resultados originais da pesquisa
A análise dos valores SHAP para o Random Forest, conforme a Figura 5, reforça a robustez do modelo na identificação de drivers de valor. A capacidade de penalizar empresas com patrimônio líquido reduzido e de recompensar aquelas com alta eficiência operacional indica que o modelo está alinhado com princípios fundamentais de investimento. Essa clareza na interpretação das variáveis é um diferencial importante para a aplicabilidade prática do modelo, pois permite aos investidores compreender melhor as razões por trás das classificações preditivas, aumentando a confiança na ferramenta de suporte à decisão.Figura 5. Gráfico de Importância de Variáveis (SHAP) para o Random Forest
Fonte: Resultados originais da pesquisa
O backtest realizado consolidou a superioridade das abordagens preditivas na geração de alpha a longo prazo. A Figura 6 demonstra que a Carteira Random Forest superou consistentemente o XGBoost e descolou expressivamente do Ibovespa em patrimônio acumulado, corroborando a maior robustez observada nas análises anteriores. No entanto, o painel inferior de drawdowns na mesma figura expõe o risco inerente a essa rentabilidade. Ambos os modelos sofreram quedas severas, frequentemente ultrapassando a barreira dos -30%, especialmente nos períodos de incerteza política em 2015 e no início da pandemia de COVID-19 em 2020, quando a bolsa brasileira se desvalorizou acentuadamente.Figura 6. Evolução Patrimonial: Random Forest vs XGBoost vs Ibovespa e Drawdowns Históricos.
Fonte: Resultados originais da pesquisa
Os resultados do backtest indicam que, embora os algoritmos sejam eficientes em alavancar ganhos durante tendências de alta, eles não oferecem proteção efetiva contra choques sistêmicos e reversões bruscas do mercado. Essa característica classifica a estratégia como de alta volatilidade e risco de cauda, exigindo do investidor maturidade para avaliar se os fundamentos das empresas pontuadas pelo modelo estão alinhados com a realidade. A Tabela 3 do TCC original, que apresenta as métricas institucionais, corrobora essa observação, detalhando o desempenho de ambos os modelos em relação ao Ibovespa.
As métricas institucionais revelaram que, embora ambos os modelos tenham superado o Ibovespa no longo prazo, com ganhos significativos para o Random Forest, os Índices de Sharpe alcançados foram de 0,14 para o Random Forest e 0,09 para o XGBoost. Esses valores, embora positivos e superiores ao Ibovespa (-0,05), estão abaixo do limiar de 1,0 exigido por alocadores institucionais para considerar uma estratégia robusta e comercialmente viável, conforme apontado por Pagliaro (2026). A volatilidade anualizada foi de 24,32% para o Random Forest e 25,04% para o XGBoost, enquanto o Ibovespa registrou 23,73%. O Maximum Drawdown (MDD) foi de -42,16% para o Random Forest e -42,49% para o XGBoost, ambos superiores ao do Ibovespa (-37,03%).
A alta taxa de drawdown, superior a 42% para ambos os modelos, evidencia a dificuldade em prever mudanças drásticas no cenário econômico. Para viabilizar a aplicação prática desses modelos, é fundamental a adoção de técnicas de mitigação de risco, como o redimensionamento das posições para limitar as quedas a níveis institucionais mais controlados, geralmente entre -20% e -30% (Pagliaro, 2026). Essa limitação ressalta que, apesar da capacidade dos algoritmos de identificar padrões, a intervenção humana e a gestão de risco são indispensáveis para a construção de uma estratégia de investimento mais resiliente e adequada a diferentes perfis de investidor.
Partindo da premissa de que bons fundamentos tendem a gerar ganhos futuros, foi implementado um algoritmo de Scoring Fundamentalista. Este algoritmo utiliza os principais preditores identificados pelos modelos de machine learning, como rentabilidade (ROE), solvência (Alavancagem) e eficiência (Margem Líquida). O modelo premia empresas com retorno sobre patrimônio acima da mediana do mercado (RS_ROE > 0) e bonifica aquelas que apresentaram melhora em relação ao trimestre anterior. Da mesma forma, identifica empresas com menor risco financeiro (RS_ALAVANCAGEM_FIN < 0) e valoriza a desalavancagem progressiva, além de avaliar a capacidade de conversão de receita em lucro, pontuando empresas com margens superiores aos seus pares em trajetória de crescimento.
Para validar a aplicabilidade prática do modelo, foi realizada uma simulação de aportes constantes (Dollar Cost Averaging – DCA). Os resultados obtidos, apresentados na Tabela 4 do TCC original, demonstraram a eficácia da estratégia. Com um total aportado de R$ 54.391,60, o patrimônio final alcançado pelo modelo de Machine Learning (ML) foi de R$ 208.262,30, representando um ganho de +282,89%. Em comparação, o patrimônio final do Ibovespa para o mesmo período foi de R$ 141.389,59, com um ganho de +159,95%. Essa simulação evidencia a capacidade do modelo de gerar retornos significativamente superiores ao benchmark.
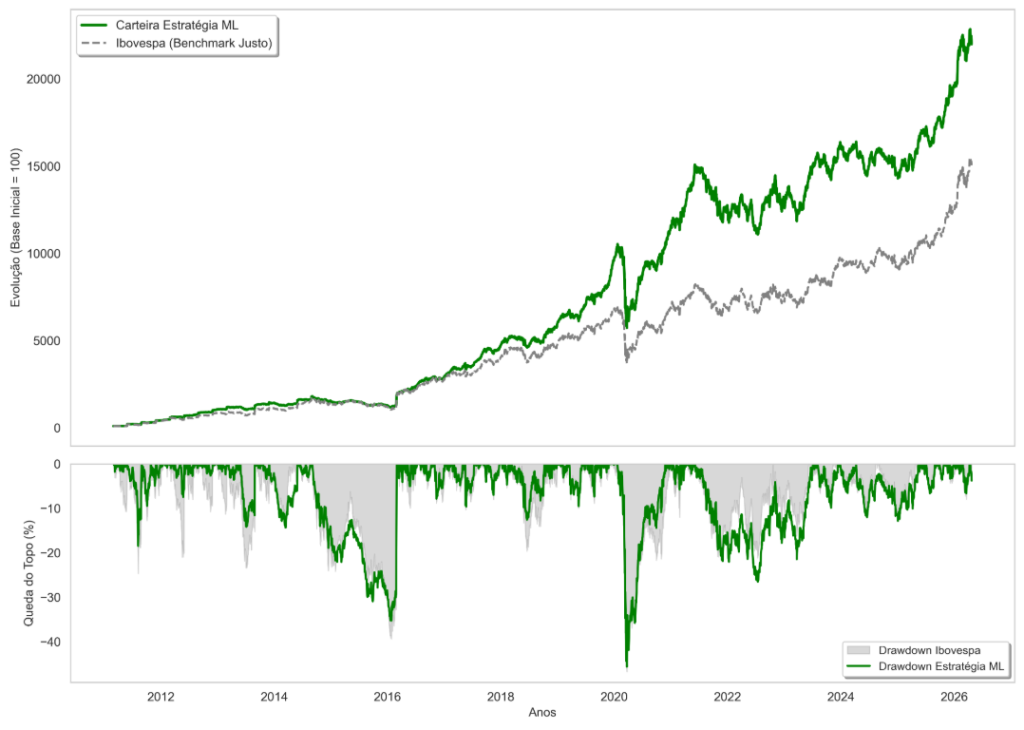
A Figura 7 ilustra a evolução patrimonial da estratégia de Score Fundamentalista em comparação com o Ibovespa e os drawdowns históricos. O gráfico superior mostra que a carteira da estratégia ML superou consistentemente o Ibovespa ao longo do tempo, indicando uma geração de alpha robusta. O painel inferior, que exibe os drawdowns, revela que, embora os picos de queda sistêmica sejam próximos aos do Ibovespa, a estratégia ML demonstra maior resiliência e velocidade de recuperação pós-crise, com um deslocamento positivo do gráfico após 2020, sugerindo uma capacidade de recuperação mais rápida em momentos de estresse do mercado.
Figura 7. Evolução Patrimonial: Score Fundamentalista vs Ibovespa e Drawdowns Históricos.
Fonte: Resultados originais da pesquisa
A eficácia da estratégia DCA combinada com o Score Fundamentalista é comprovada pela redução da volatilidade anualizada para 19,77%, em contraste com os 24,02% do Ibovespa. Além disso, o Índice de Sharpe anualizado da estratégia alcançou 1,15, superando significativamente o 0,67 do Ibovespa e atingindo o limiar de robustez exigido por alocadores institucionais. O Maximum Drawdown (MDD) da estratégia foi de -45,66%, ligeiramente inferior ao do Ibovespa (-46,82%), indicando uma proteção sistemática contra perdas extremas, conforme detalhado na Tabela 5 do TCC original.
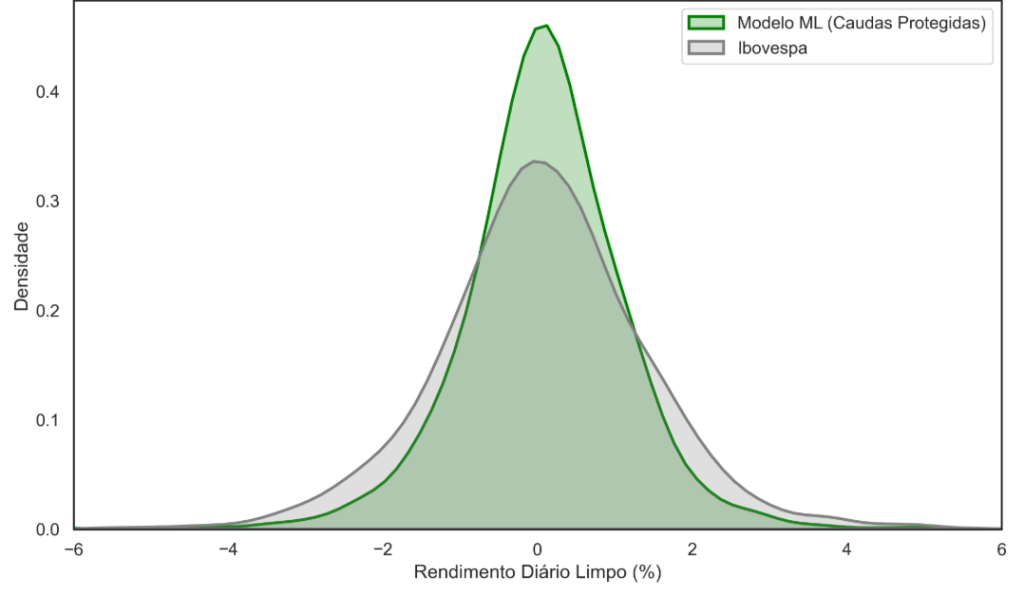
A distribuição de retornos da estratégia DCA + Score Fundamentalista, apresentada na Figura 8, mostra uma curva mais estreita e com assimetria positiva em comparação à base achatada e volátil do Ibovespa. Essa característica sugere que a estratégia não apenas oferece retornos mais consistentes, mas também uma menor probabilidade de perdas extremas, contribuindo para uma maior estabilidade e previsibilidade dos resultados. A maior resiliência e velocidade de recuperação pós-crise, evidenciada pelo deslocamento do gráfico após 2020, reforçam a capacidade da estratégia de mitigar os impactos de eventos adversos e de se recuperar de forma mais eficiente.
Figura 8. Histograma de Retornos
Fonte: Resultados originais da pesquisa
Em síntese, os resultados demonstram que a aplicação de modelos de aprendizado de máquina, especialmente o Random Forest, em conjunto com indicadores fundamentalistas e uma estratégia de aportes constantes, pode otimizar significativamente a classificação preditiva e o desempenho de carteiras de ações na B3. A Margem Líquida emergiu como um indicador crucial, e a estratégia combinada superou o Ibovespa com menor volatilidade e maior Índice de Sharpe, validando o potencial das tecnologias de inteligência artificial como ferramentas de suporte eficazes para a tomada de decisões de investimento, embora a necessidade de gestão de risco e a consideração do fator humano permaneçam essenciais para navegar pela complexidade do mercado financeiro.
4. Conclusão
O presente estudo analisou a aplicação de modelos de aprendizado de máquina na classificação preditiva de ativos da B3, utilizando indicadores fundamentalistas. Verificou-se que a estruturação de um pipeline de dados robusto, com normalização via Robust Scaler e o uso de retornos logarítmicos, otimizou a estabilidade estatística das projeções. Entre os algoritmos testados, o Random Forest demonstrou maior consistência e desempenho superior, alcançando uma acurácia de 55,97% e identificando a Margem Líquida como o principal indicador de performance. A integração de um Motor de Scoring Fundamentalista com uma estratégia de aportes constantes resultou em um Índice de Sharpe de 1,15 e superou o benchmark Ibovespa com menor volatilidade anualizada, evidenciando a capacidade de gerar retornos ajustados ao risco significativamente superiores.
Apesar dos resultados promissores, observou-se que os modelos preditivos apresentaram limitações em períodos de instabilidade sistêmica, como as crises de 2015 e 2020, não mitigando quedas expressivas e revelando uma alta volatilidade e risco de cauda. Essa característica ressalta que, embora as tecnologias de inteligência artificial sejam ferramentas de suporte eficazes para a otimização de investimentos, o fator humano permanece essencial na gestão de risco e na tomada de decisão final. A dinâmica econômica, influenciada por comportamentos e reações humanas, impõe limites à capacidade dos modelos algorítmicos de antecipar variáveis emocionais do mercado. Este estudo, de caráter estritamente acadêmico, contribui para o avanço do conhecimento sobre a aplicação de Machine Learning em finanças quantitativas no contexto brasileiro, sem configurar uma recomendação de investimento.
Referências Bibliográficas
Banco Central do Brasil [BCB]. 2021. Relatório de cidadania financeira 2021. BCB, Brasília, DF, Brasil.
Brasil, Bolsa, Balcão [B3]. 2024. Boletim pessoa física 3º trimestre de 2024. B3, São Paulo, SP, Brasil.
Gallup. 2024. What percentage of Americans owns stock?. Gallup, Washington, DC, EUA.
Kahneman, D. 2011. Thinking, Fast and Slow. Farrar, Straus and Giroux, New York, NY, EUA.
Lusardi, A.; Mitchell, O.S. 2014. The economic importance of financial literacy: theory and evidence. Journal of Economic Literature 52(1): 5-44.
Malla, S.R.; Kayastha, S.; Suwal, R.; Bhandari, H.C.; Adhikari, R. 2026. XGBoost forecasting of NEPSE index log returns with walk forward validation. arXiv, Ithaca, NY, EUA
Pagliaro, A. 2026. Regime-aware LightGBM for stock market forecasting: a validated walk-forward framework with statistical rigor and explainable Al analysis. Electronics 15(1): 1-30.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

