
17 de agosto de 2026
Avaliação de Modelos de Machine Learning Aplicados ao Trading de Ativos Financeiros por Backtesting
Igor Nazareno Soares; Pedro Rodrigues Oliveira
DOI: 10.22167/2675-6528-202601575
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
O presente estudo avaliou modelos de Machine Learning aplicados ao trading de ativos financeiros por meio de backtesting, com uma aplicação empírica ao mercado acionário brasileiro. O objetivo foi examinar a capacidade desses modelos de gerar sinais operacionais úteis e desempenho financeiro superior a benchmarks tradicionais. Utilizaram-se dados históricos diários da ação PETR4 (2020-2024), com variáveis explicativas construídas a partir de indicadores técnicos e medidas de preço e volume. Foram implementados e comparados modelos de Regressão Logística, Random Forest e XGBoost. A variável-alvo, inicialmente definida pela direção do pregão seguinte, foi reformulada para um limiar mínimo de retorno de 0,2%, visando maior aderência econômica. Os modelos foram treinados e validados em um esquema walk-forward (2020-2023) e testados fora da amostra em 2024. Os resultados indicaram que, embora o desempenho preditivo dos modelos tenha sido moderado, a Random Forest Balanceada apresentou o melhor desempenho financeiro no backtest de 2024, superando os demais modelos e benchmarks. Concluiu-se que a formulação da variável-alvo foi decisiva para a utilidade prática dos modelos, e que abordagens supervisionadas podem produzir melhoria financeira relativa quando avaliadas sob uma lógica operacional consistente, destacando a importância da seletividade operacional sobre a mera acurácia preditiva.
Palavras-chave: Backtesting; Machine Learning; Random Forest; Regressão Logística; XGBoost.
1. Introdução
A aplicação de técnicas de Machine Learning (ML) ao mercado financeiro tem experimentado uma expansão notável. Este crescimento é impulsionado pela crescente disponibilidade de dados, pela evolução do poder computacional e pela busca por métodos que possam explorar relações complexas em ambientes caracterizados por elevada incerteza e não linearidade. Em sua essência, os métodos de aprendizagem estatística oferecem um vasto conjunto de ferramentas para modelagem e predição, abrangendo regressão, classificação e abordagens baseadas em árvores, com aplicações em diversas áreas, incluindo o setor financeiro (James et al., 2023; Fávero e Belfiore, 2024; El Hajj e Hammoud, 2023).
No contexto específico das finanças, a literatura demonstra que a utilização de ML tem sido explorada em problemas como a previsão de retornos, a classificação de movimentos de mercado, a detecção de padrões em séries temporais e a construção de estratégias quantitativas. A consolidação desse campo e o aumento de suas aplicações em mercados financeiros evidenciam a relevância tanto acadêmica quanto prática do tema (Nazareth e Ramana Reddy, 2023; Olorunnimbe e Viktor, 2023).
Contudo, a mera capacidade preditiva dos modelos de ML não é suficiente para aferir sua utilidade em finanças. A relevância analítica de um modelo, em aplicações financeiras, está intrinsecamente ligada não apenas à sua habilidade de prever corretamente uma determinada classe, mas também ao potencial de suas previsões serem convertidas em decisões que gerem vantagens econômicas. Estudos recentes sublinham que, embora os métodos de ML possam gerar ganhos econômicos significativos, é fundamental avaliá-los fora da amostra e examinar a utilidade econômica de suas previsões (Gu et al., 2020; Bianchi et al., 2020; López de Prado, 2020).
As séries temporais financeiras, por sua natureza, apresentam características que dificultam a modelagem, como o elevado ruído, as frequentes mudanças de regime e a baixa previsibilidade em horizontes de curto prazo. Diante disso, a formulação do problema, a seleção das variáveis explicativas e a definição da variável-alvo tornam-se decisões metodológicas cruciais. Indicadores técnicos, retornos e medidas derivadas de preço e volume são abordagens frequentemente empregadas em estudos aplicados, mas sua capacidade preditiva é fortemente dependente do contexto empírico e do método escolhido (Tsay, 2020; Peng e De Moraes Souza, 2024).
Nesse cenário, o backtesting assume um papel fundamental. Ele é o procedimento pelo qual se verifica em que medida os sinais gerados por modelos preditivos podem ser traduzidos em estratégias que apresentem desempenho financeiro superior ao de benchmarks simples. A avaliação por backtesting envolve a análise de como as previsões estatísticas se convertem em resultados econômicos reais, considerando os custos operacionais e a dinâmica efetiva do mercado (López de Prado, 2018; Chan, 2013).
A pesquisa é motivada pela crescente utilização de métodos de aprendizagem estatística em finanças e pela necessidade de examinar não apenas o desempenho preditivo desses modelos, mas também sua utilidade econômica em um ambiente de simulação. A principal contribuição deste trabalho reside em evidenciar que decisões metodológicas, como a definição da variável-alvo e a conversão de previsões em sinais operacionais, podem ser decisivas para a utilidade financeira dos modelos, indo além da mera previsibilidade estatística. Assim, o problema de pesquisa não se restringe à comparação entre algoritmos, mas envolve também a análise da conversão de previsões estatísticas em resultados econômicos.
Diante deste contexto, o objetivo deste trabalho foi avaliar modelos de Machine Learning aplicados ao trading de ativos financeiros por meio de backtesting, examinando sua capacidade de gerar sinais operacionais úteis e desempenho financeiro superior a benchmarks tradicionais, a partir de uma aplicação empírica ao mercado acionário brasileiro.
2. Material e Métodos
A presente pesquisa caracterizou-se como um estudo de natureza quantitativa, com delineamento experimental, voltado à aplicação de técnicas de Machine Learning (ML) em séries temporais financeiras. O objetivo central foi avaliar modelos de ML aplicados ao trading de ativos financeiros por meio de backtesting, examinando sua capacidade preditiva e utilidade financeira em um ambiente de simulação, conforme alinhado com o problema de pesquisa.
A aplicação empírica do estudo foi realizada no mercado acionário brasileiro, utilizando a ação preferencial da Petrobras (PETR4), negociada na B3. A escolha desse ativo justificou-se por sua elevada liquidez, sua relevância no mercado acionário nacional e a ampla disponibilidade de dados históricos públicos. Os dados utilizados foram informações diárias de preço e volume, obtidas por meio da API pública do Yahoo Finance.
O período de coleta dos dados abrangeu de 1º de janeiro de 2020 a 31 de dezembro de 2024. Para fins de modelagem e avaliação, a base de dados foi dividida temporalmente. Os anos de 2020 a 2023 foram destinados ao treinamento e validação dos modelos, enquanto o ano de 2024 foi reservado para o teste final fora da amostra, garantindo o rigor metodológico e evitando vazamento de informação.
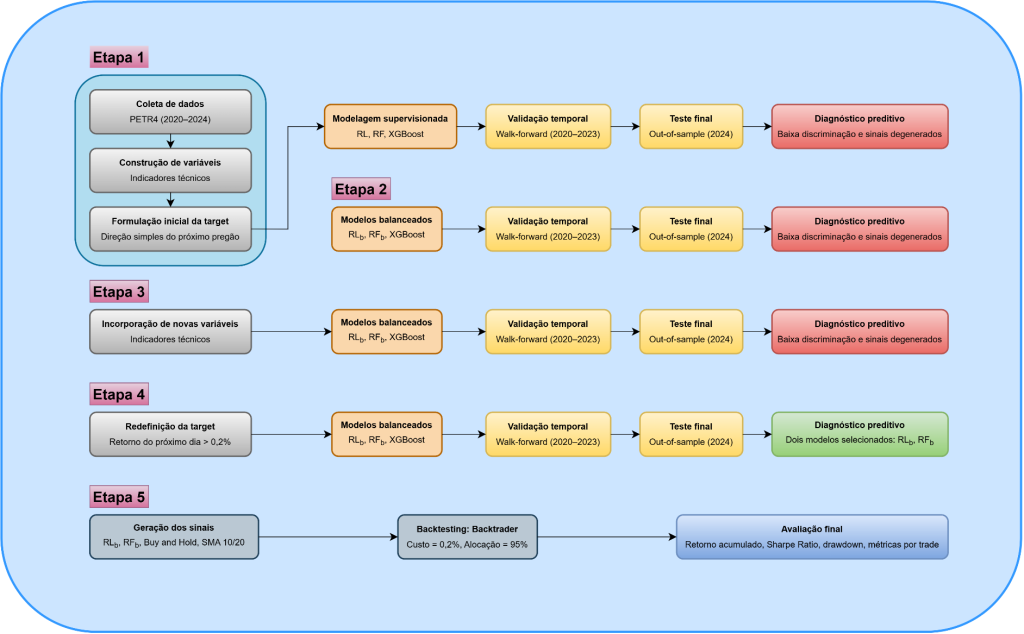
O processo metodológico completo, desde a coleta de dados até a avaliação final das estratégias, foi estruturado em um pipeline sequencial. A Figura 1 ilustra as etapas principais e suas interconexões, fornecendo uma visão geral do fluxo de trabalho adotado para a modelagem e o backtesting.
Figura 1. Fluxograma do pipeline metodológico do estudo
Fonte: Dados originais da pesquisa
Este fluxograma detalha as fases de construção de variáveis, formulação da variável-alvo, modelagem supervisionada, validação temporal e geração de sinais, culminando na avaliação final. A representação visual auxilia na compreensão da arquitetura do estudo e da progressão dos procedimentos metodológicos.
A etapa de pré-processamento consistiu na construção de variáveis explicativas derivadas da série diária de preços e volume da PETR4. Inicialmente, utilizou-se um conjunto de variáveis técnicas composto por retorno logarítmico diário, médias móveis simples de 10 e 20 períodos, Índice de Força Relativa de 14 períodos, MACD e linha de sinal do MACD, visando sintetizar informações sobre direção e tendência dos preços.
Posteriormente, a base explicativa foi enriquecida com medidas adicionais, incluindo retorno acumulado de três e cinco dias, volatilidade móvel de cinco e dez dias, distância relativa do preço em relação às médias móveis de 10 e 20 períodos, e razão entre volume diário e média móvel de volume de 10 períodos. Essas variáveis adicionais buscaram ampliar a representação estatística do comportamento recente do ativo.
Na formulação inicial, a variável-alvo foi definida de forma binária simples, assumindo valor 1 quando o preço de fechamento do pregão seguinte era superior ao preço de fechamento atual, e 0 nos demais casos. Contudo, essa definição mostrou-se excessivamente sensível a pequenas oscilações, comprometendo a capacidade discriminatória dos modelos.
Diante disso, a variável-alvo foi redefinida para considerar como evento positivo apenas os casos em que o retorno do pregão seguinte fosse superior a 0,2%. Esse limiar de 0,2% foi adotado por corresponder, de forma aproximada, ao custo total de uma operação completa no ambiente de backtest, alinhando a modelagem estatística à lógica financeira da estratégia avaliada.
Foram avaliados três algoritmos supervisionados de classificação: Regressão Logística (RL), Random Forest (RF) e XGBoost. A escolha desses modelos buscou contemplar diferentes graus de complexidade e capacidade de representação das relações entre as variáveis. Após testes preliminares, foram também avaliadas versões balanceadas da Regressão Logística (RLb) e da Random Forest (RFb), utilizando o parâmetro `class_weight=’balanced’` para reduzir o viés de classificação.
No período de treinamento e validação, de 2020 a 2023, empregou-se uma estratégia de validação temporal do tipo `walk-forward`, implementada por meio do procedimento `TimeSeriesSplit`. Essa abordagem preservou a ordem cronológica das observações, essencial para séries temporais financeiras. As variáveis explicativas foram padronizadas em cada iteração por meio do `StandardScaler`, ajustado exclusivamente com os dados de treino.
Para fins de comparação, foram adotados dois benchmarks. O primeiro foi a estratégia passiva de “Buy and Hold”, que consistiu na manutenção contínua da exposição ao ativo. O segundo benchmark foi uma regra técnica baseada no cruzamento de médias móveis simples de 10 e 20 períodos (SMA 10/20), representando uma abordagem tradicional de seguimento de tendência.
A estratégia operacional adotada foi do tipo “long-only”, ou seja, as estratégias assumiram posição comprada apenas quando o sinal previsto pelo modelo era igual a 1. O sinal era gerado no fechamento do dia t, a posição era aberta no fechamento do dia t+1 e encerrada no fechamento do dia t+2. O backtest foi implementado com a biblioteca Backtrader (Backtrader, 2025; Chan, 2013).
O capital inicial da carteira foi fixado em R$ 100.000,00 para todas as estratégias, buscando comparabilidade. Adotou-se um custo de transação de 0,1% por operação, totalizando 0,2% por trade, para simular custos reais. A regra de alocação proporcional consistiu em investir aproximadamente 95% do caixa disponível a cada nova entrada, mantendo uma pequena reserva técnica.
As estratégias foram comparadas no período de teste de 2024 com base em métricas financeiras agregadas da carteira, calculadas a partir da trajetória diária do valor do portfólio. As métricas incluíram retorno acumulado, retorno médio diário, volatilidade diária, Sharpe Ratio, drawdown máximo e valor final da carteira.
Adicionalmente, foram calculadas métricas por operação para complementar a análise da qualidade operacional dos sinais gerados. Essas métricas abrangeram o número de trades, a taxa de acerto por trade, o retorno médio por trade, o retorno médio dos trades vencedores e perdedores, e o profit factor, definido como a razão entre a soma dos ganhos e das perdas absolutas.
Este estudo apresenta algumas limitações metodológicas. A análise empírica foi restrita a um único ativo, a ação preferencial da Petrobras (PETR4), o que limita a generalização dos achados para outros ativos ou mercados. A modelagem foi conduzida com dados em frequência diária, o que pode implicar perda de informações intradiárias relevantes para estratégias de curtíssimo prazo.
Outras limitações incluem o conjunto de variáveis explicativas, baseado exclusivamente em indicadores derivados de preço e volume, sem contemplar outras fontes como variáveis macroeconômicas ou dados intradiários. As simplificações no ambiente de backtest, como custos de transação fixos e regra de alocação padronizada, também devem ser consideradas na interpretação dos resultados.
3. Resultados e Discussão
A avaliação inicial dos modelos de Machine Learning revelou que a previsibilidade da ação PETR4, quando baseada em uma variável-alvo simples e um conjunto inicial de variáveis explicativas, mostrou-se limitada. A formulação original da variável-alvo, que classificava como positivo qualquer movimento de preço para cima no pregão seguinte, resultou em baixa capacidade discriminatória e uma concentração excessiva de previsões na classe positiva. Esse comportamento sugere que a sensibilidade a pequenas oscilações diárias introduziu ruído significativo, dificultando a distinção entre movimentos economicamente relevantes e variações aleatórias, o que comprometeu a utilidade operacional dos modelos.
As métricas de validação temporal e de teste final corroboraram essa limitação. Na validação, a Regressão Logística (RL) apresentou um F1-score de 0,4678, enquanto Random Forest (RF) e XGBoost registraram 0,3430 e 0,4261, respectivamente. No teste final, a RL obteve um F1-score de 0,6649, com todas as 251 previsões na classe positiva, indicando uma forte concentração de sinais. RF e XGBoost também mostraram F1-scores de 0,6537 e 0,6501, com 236 e 238 previsões positivas, respectivamente, e pouquíssimas previsões na classe zero. Esses resultados demonstram que, com a especificação inicial, os modelos não conseguiam discernir movimentos significativos de ruído estatístico.
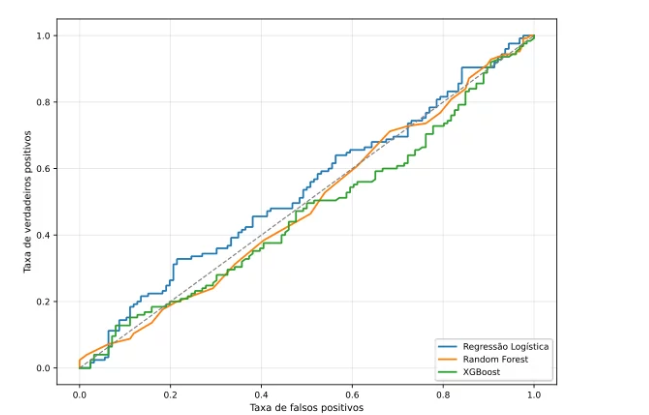
A análise probabilística reforçou o diagnóstico de baixa capacidade discriminatória. As curvas ROC dos modelos com a variável-alvo original e o conjunto inicial de variáveis se aproximaram da diagonal de aleatoriedade, indicando uma fraca habilidade de ranqueamento entre eventos positivos e negativos. Esse padrão é crucial para entender a dificuldade dos modelos em gerar sinais operacionais seletivos e economicamente úteis, pois a sobreposição das probabilidades previstas para as classes real 0 e 1 era acentuada, como ilustrado na Figura 2.
Figura 2. Curvas ROC dos modelos com variável-alvo original e conjunto inicial de variáveis
Fonte: Dados originais da pesquisa
A proximidade das curvas ROC à diagonal de aleatoriedade indica que os modelos, em sua configuração inicial, não conseguiam separar de forma eficaz os eventos de alta dos eventos de não alta. Esse comportamento reflete a dificuldade em identificar padrões robustos em um ambiente de alta incerteza, onde pequenas variações de preço eram tratadas com a mesma relevância que movimentos mais substanciais, o que limitava a capacidade de ranqueamento dos eventos.
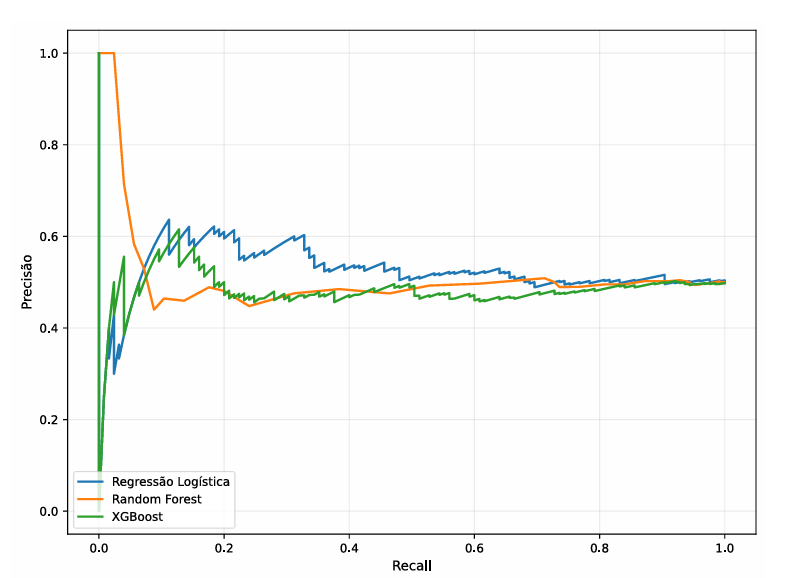
De maneira similar, as curvas “Precision-Recall” também não apresentaram um ganho consistente em relação ao nível de base do problema, o que reforça a limitação dos modelos nessa formulação inicial. A ausência de um desempenho superior nessas curvas sugere que a precisão das previsões para a classe positiva era insuficiente para gerar um valor prático, mesmo quando a sensibilidade (recall) era alta, como ilustrado na Figura 3.
Figura 3. Curvas “Precision-Recall” dos modelos com variável-alvo original e conjunto inicial de variáveis
Fonte: Resultados originais da pesquisa
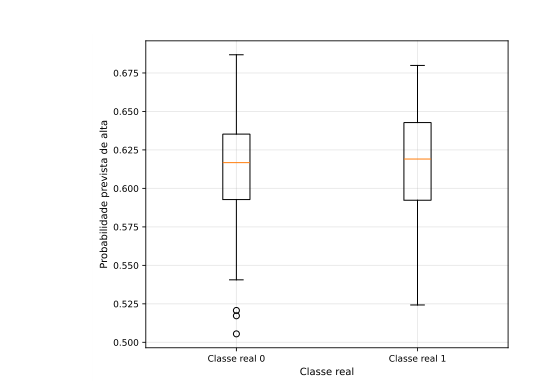
A análise das curvas “Precision-Recall” complementa a avaliação das curvas ROC, evidenciando que a capacidade dos modelos de gerar previsões precisas para a classe positiva era limitada. Isso significa que, mesmo quando os modelos identificavam um potencial movimento de alta, a confiança nessas previsões era baixa, tornando-as menos úteis para decisões operacionais. A sobreposição das probabilidades previstas por classe real, ilustrada na Figura 4, confirmou que os classificadores não estavam separando adequadamente os eventos de alta e de não alta.
Figura 4. “Boxplots” das probabilidades previstas por classe real com variável-alvo original e conjunto inicial de variáveis, utilizando a RL como modelo de referência
Fonte: Resultados originais da pesquisa
Os boxplots das probabilidades previstas demonstram que a distribuição das previsões para a classe real 0 e a classe real 1 eram muito semelhantes, com uma forte sobreposição. A mediana das probabilidades previstas para a classe real 0 e a classe real 1 estava próxima de 0,600 e 0,625, respectivamente, com caixas interquartis que se sobrepunham amplamente. Esse comportamento indica que os modelos não conseguiam atribuir probabilidades distintivas o suficiente para diferenciar os eventos, resultando em baixa seletividade operacional e um problema preditivo excessivamente ruidoso. Balanceamento dos modelos e diagnóstico da formulação original
Diante da forte concentração de previsões na classe positiva, uma nova configuração dos modelos foi avaliada por meio do ajuste de balanceamento de classes, com foco na Regressão Logística Balanceada (RLb) e Random Forest Balanceada (RFb). O objetivo era verificar se a ponderação diferenciada das classes poderia reduzir o viés de classificação e tornar os sinais gerados mais seletivos, buscando uma melhor adequação à lógica operacional do estudo.
Na validação temporal, os resultados do balanceamento permaneceram modestos. A RLb apresentou um F1-score de 0,4486, enquanto o XGBoost manteve desempenho similar ao anterior, com F1-score de 0,4261. A RFb, por sua vez, registrou o F1-score mais baixo entre os modelos nessa etapa, com 0,3453. No teste final de 2024, o balanceamento também não produziu alteração substancial no comportamento geral dos modelos. A RLb obteve um F1-score de 0,6667, com apenas quatro previsões para a classe 0, mantendo a concentração de sinais positivos. A RFb apresentou um F1-score de 0,6540, com nove previsões para a classe 0, e o XGBoost permaneceu com F1-score de 0,6501 e treze previsões para a classe 0. Esses dados indicam que o balanceamento, isoladamente, não foi suficiente para resolver a limitada capacidade de discriminação dos modelos.
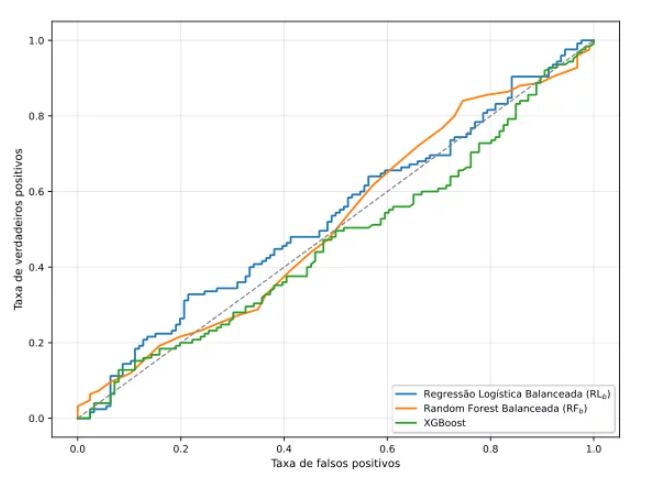
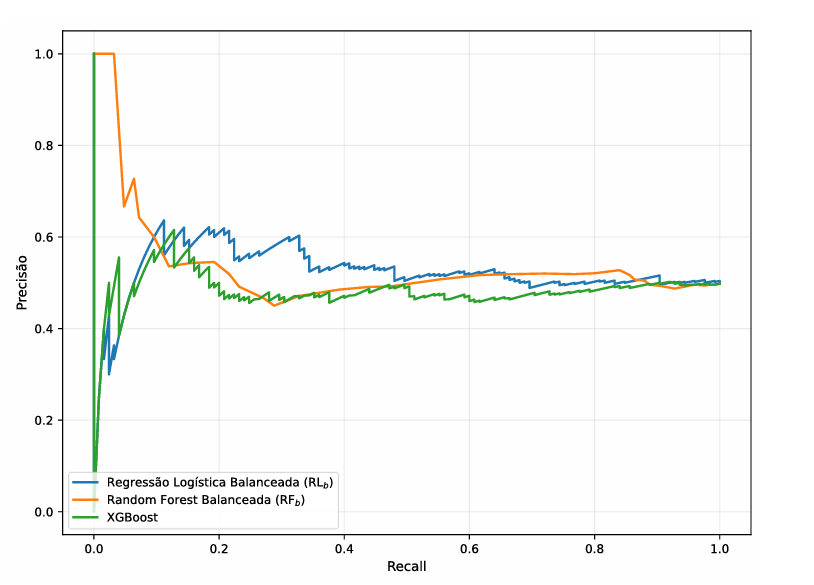
A análise probabilística reforçou esse diagnóstico, mostrando que, embora o balanceamento tenha gerado pequenas alterações relativas, os valores de ROC AUC e PR AUC permaneceram baixos. A RLb apresentou ROC AUC de 0,5350 e PR AUC de 0,5281, enquanto a RFb registrou 0,5153 e 0,5312, e o XGBoost obteve 0,4684 e 0,4882, respectivamente. Esses valores, próximos de 0,5, indicam que o ajuste não foi suficiente para melhorar a capacidade de discriminação dos modelos, como se observa nas Figuras 5 e 6.
Figura 5. Curvas ROC dos modelos balanceados
Fonte: Resultados originais da pesquisa
As curvas ROC dos modelos balanceados continuaram próximas da diagonal de aleatoriedade, sugerindo que a capacidade de ranqueamento entre eventos positivos e negativos permaneceu limitada. Isso indica que, mesmo com o ajuste para balancear as classes, os modelos ainda não conseguiam distinguir de forma robusta os movimentos de preço que seriam economicamente relevantes.
Figura 6. Curvas “Precision-Recall” dos modelos balanceados
Fonte: Resultados originais da pesquisa
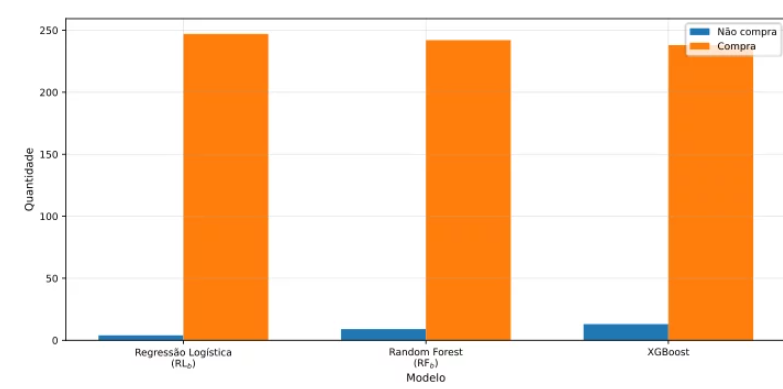
As curvas “Precision-Recall” dos modelos balanceados também mostraram um desempenho modesto, indicando que a precisão das previsões para a classe positiva não melhorou significativamente. A distribuição dos sinais previstos em 2024, mesmo após o balanceamento, continuou a exibir uma ampla predominância de previsões positivas, com baixa seletividade operacional. Isso significa que os modelos, apesar do ajuste, ainda tendiam a classificar a maioria dos dias como de alta, o que não é útil para uma estratégia de trading que busca identificar oportunidades seletivas.
Figura 7. Distribuição dos sinais previstos em 2024 pelos modelos balanceados
Fonte: Resultados originais da pesquisa
A Figura 7 ilustra a distribuição dos sinais de compra e não compra gerados pelos modelos balanceados em 2024. Observa-se que a Regressão Logística Balanceada (RLb) e o XGBoost continuaram a emitir um número significativamente maior de sinais de compra (247 e 238, respectivamente) em comparação com os sinais de não compra (4 e 13). A Random Forest Balanceada (RFb) apresentou 242 sinais de compra e 9 de não compra. Essa assimetria reforça a baixa seletividade operacional dos modelos, indicando que o balanceamento, embora tenha sido uma tentativa metodológica pertinente, teve efeito limitado sobre o problema central da formulação original, que era a elevada concentração de previsões na classe positiva e a limitada capacidade discriminatória dos algoritmos. Resultados com variável-alvo original e conjunto enriquecido de variáveis
Após a etapa de balanceamento, o estudo prosseguiu com o enriquecimento do conjunto de variáveis explicativas, incorporando medidas adicionais como retorno acumulado, volatilidade móvel, distância relativa do preço em relação às médias móveis e volume relativo. O objetivo dessa etapa foi ampliar a representação estatística da dinâmica recente do ativo, mantendo-se, inicialmente, a formulação original da variável-alvo. Essa abordagem visava capturar de forma mais abrangente o comportamento do ativo e, consequentemente, melhorar a capacidade preditiva dos modelos.
Na validação temporal, o enriquecimento das variáveis produziu uma melhora relativa no desempenho de alguns modelos, embora os resultados gerais tenham permanecido moderados. A RLb obteve o melhor desempenho nessa etapa, com um F1-score de 0,4846. O XGBoost registrou um F1-score de 0,4523, enquanto a RFb alcançou 0,3826. Esses resultados sugerem que a ampliação da base explicativa contribuiu para um ganho preditivo, mas não alterou de forma decisiva o quadro geral de limitada discriminação entre as classes, indicando que a complexidade do problema não era resolvida apenas pela quantidade de atributos.
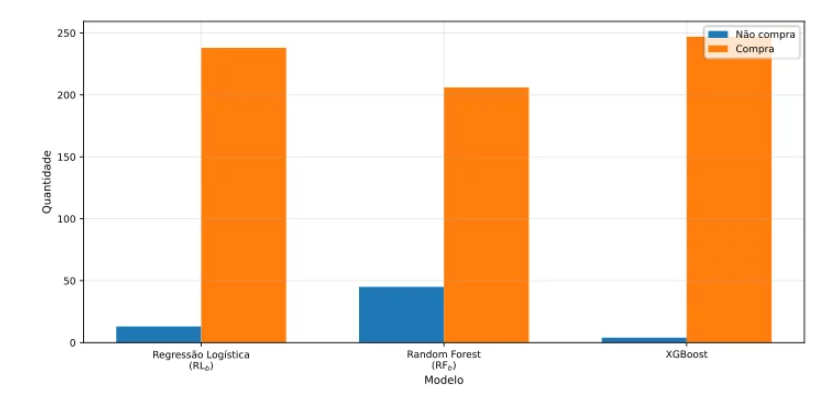
No teste final de 2024, os efeitos do enriquecimento das variáveis tornaram-se mais perceptíveis no comportamento operacional dos sinais. A RFb apresentou o melhor desempenho relativo nessa etapa, com um F1-score de 0,6647, além de gerar 45 previsões para a classe 0 e 206 para a classe 1, indicando um comportamento relativamente mais seletivo do que o observado nas etapas anteriores. A RLb manteve desempenho próximo, com um F1-score de 0,6612, mas continuou apresentando forte concentração de previsões na classe positiva, com apenas 13 previsões para a classe 0. O XGBoost, por sua vez, permaneceu com desempenho inferior e baixa utilidade operacional, com um F1-score de 0,6505, conforme os dados.
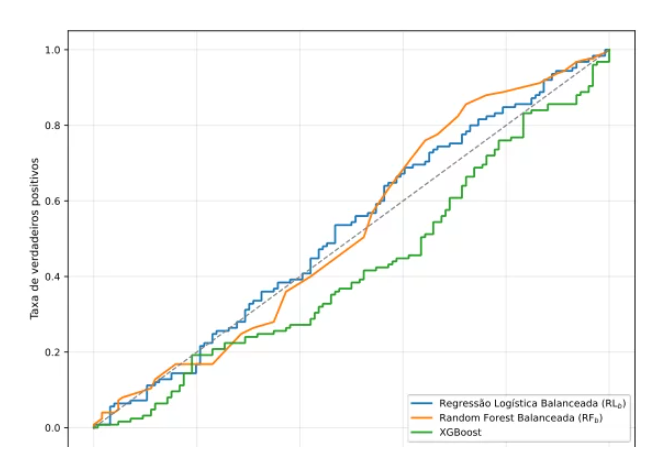
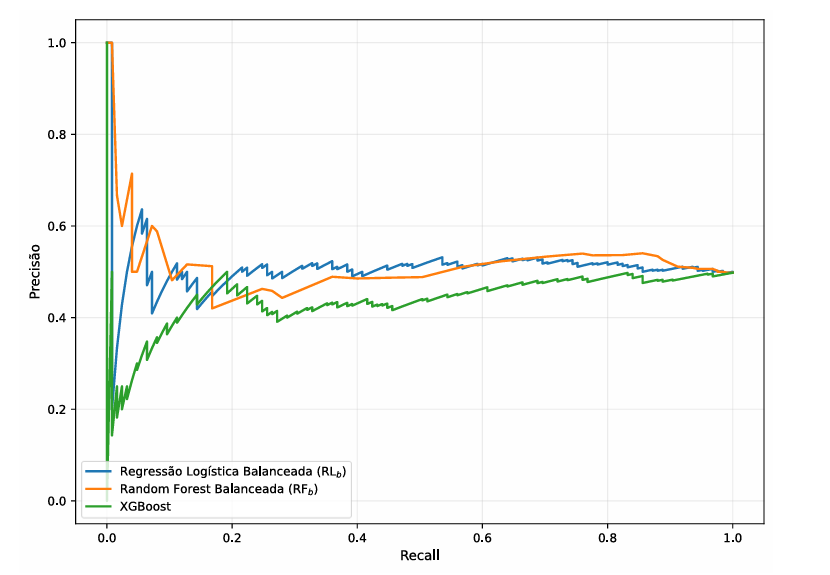
A análise probabilística e a distribuição dos sinais reforçaram esse diagnóstico. Embora o enriquecimento das variáveis tenha contribuído para melhorar relativamente o comportamento da RFb, especialmente em termos de seletividade dos sinais, os valores de ROC AUC e PR AUC permaneceram próximos de 0,5. A RLb apresentou ROC AUC de 0,5240 e PR AUC de 0,5128, enquanto a RFb registrou 0,5236 e 0,5179, e o XGBoost obteve 0,4239 e 0,4451. Esses valores indicam que a capacidade discriminatória dos modelos ainda era limitada, como se observa nas Figuras 8 e 9.
Figura 8. Curvas ROC com conjunto enriquecido de variáveis
Fonte: Resultados originais da pesquisa
As curvas ROC com o conjunto enriquecido de variáveis ainda demonstram uma capacidade discriminatória limitada, com as curvas próximas à diagonal de aleatoriedade. Isso sugere que, apesar da inclusão de mais atributos, os modelos ainda enfrentavam dificuldades em separar de forma robusta os eventos positivos dos negativos. A distribuição dos sinais previstos em 2024 mostra que apenas a RFb passou a emitir uma quantidade um pouco menos concentrada de previsões positivas, enquanto a RLb e o XGBoost mantiveram um comportamento fortemente assimétrico, como ilustrado na Figura 10.
Figura 9. Curvas “Precision-Recall” com conjunto enriquecido de variáveis
Fonte: Resultados originais da pesquisa
As curvas “Precision-Recall” com o conjunto enriquecido de variáveis também indicam um ganho apenas moderado na precisão das previsões para a classe positiva. A persistência de um desempenho limitado nessas curvas, mesmo com a ampliação da base de variáveis, reforça que a previsibilidade do ativo em frequência diária continuava restrita. A distribuição dos sinais previstos em 2024, apresentada na Figura 10, evidencia que a maioria dos modelos ainda gerava uma proporção desequilibrada de sinais de compra, comprometendo a seletividade operacional.
Figura 10. Distribuição dos sinais previstos em 2024 com conjunto enriquecido de variáveis
Fonte: Resultados originais da pesquisa
A Figura 10 mostra a distribuição dos sinais de compra e não compra para os modelos com o conjunto enriquecido de variáveis. A Regressão Logística Balanceada (RLb) e o XGBoost continuaram a apresentar uma forte predominância de sinais de compra (238 e 247, respectivamente) em relação aos de não compra (13 e 4). A Random Forest Balanceada (RFb), por sua vez, demonstrou um comportamento um pouco mais seletivo, com 206 sinais de compra e 45 de não compra. Esses resultados indicam que, embora o enriquecimento das variáveis tenha representado um avanço metodológico, o problema de previsibilidade limitada e baixa capacidade de discriminação absoluta persistiu, motivando a redefinição da variável-alvo. Resultados com variável-alvo reformulada e conjunto enriquecido de variáveis
A etapa mais relevante do estudo consistiu na reformulação da variável-alvo, que passou a considerar como evento positivo apenas os casos em que o retorno do pregão seguinte superava 0,2%. Essa redefinição buscou alinhar a modelagem estatística à lógica econômica da operação, excluindo movimentos de pequena magnitude que seriam insuficientes para compensar os custos de transação (0,1% na entrada e 0,1% na saída, totalizando 0,2% por trade). Essa abordagem visou tornar o problema de classificação mais aderente à realidade operacional e economicamente significativa.
Na validação temporal, os resultados permaneceram moderados em termos de desempenho preditivo absoluto, mas a nova formulação produziu um problema de classificação mais coerente do ponto de vista operacional. A RLb e o XGBoost apresentaram F1-scores de 0,3670 e 0,3696, respectivamente, enquanto a RFb obteve um F1-score de 0,2916. Esses resultados indicam que, embora a reformulação da variável-alvo não tenha elevado substancialmente o desempenho preditivo médio, ela tornou a estrutura do problema menos sensível a oscilações economicamente pouco relevantes, focando em movimentos com potencial de lucro real.
No teste final de 2024, a RLb apresentou o maior F1-score, de 0,5868. O XGBoost obteve um F1-score de 0,5548, enquanto a RFb registrou um F1-score de 0,4519, mas com maior acurácia e comportamento mais seletivo na distribuição dos sinais. Em particular, a RFb emitiu 153 previsões para a classe 0 e 98 para a classe 1, enquanto a RLb permaneceu mais agressiva, com 44 previsões para a classe 0 e 207 para a classe 1. O XGBoost, embora tenha apresentado recall relativamente elevado, continuou com desempenho inferior em termos probabilísticos e operacionais, com 69 previsões para a classe 0 e 182 para a classe 1. Esses dados demonstram a importância da seletividade dos sinais para a utilidade prática dos modelos.
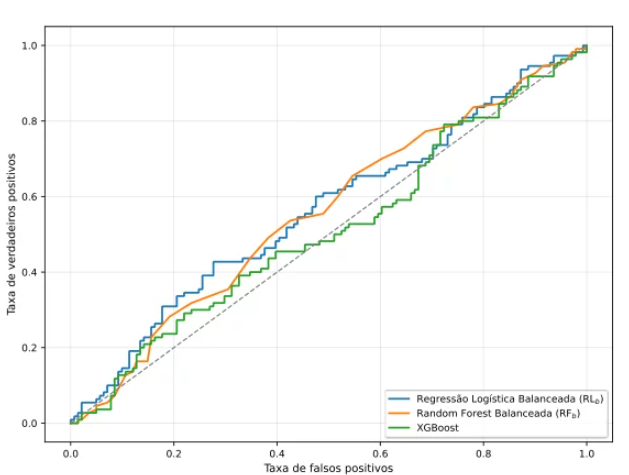
A análise probabilística reforçou essa interpretação. As curvas ROC apresentaram uma melhora modesta em relação às etapas anteriores, mas permaneceram relativamente próximas da diagonal de aleatoriedade, indicando que a capacidade discriminatória dos modelos ainda era limitada, como se observa na Figura 11. A RLb registrou ROC AUC de 0,5618 e PR AUC de 0,5039, enquanto a RFb obteve 0,5519 e 0,4728, e o XGBoost apresentou 0,5120 e 0,4532. Esses valores sugerem que, mesmo com a variável-alvo reformulada, a separação entre as classes ainda era um desafio.
Figura 11. Curvas ROC dos modelos com variável-alvo reformulada
Fonte: Resultados originais da pesquisa
As curvas ROC dos modelos com a variável-alvo reformulada mostraram uma leve melhora na capacidade de ranqueamento, mas ainda indicavam uma limitação na discriminação robusta entre os eventos. Isso significa que, embora a nova definição da variável-alvo tenha tornado o problema mais coerente economicamente, a capacidade preditiva intrínseca dos modelos para identificar esses movimentos ainda era moderada.
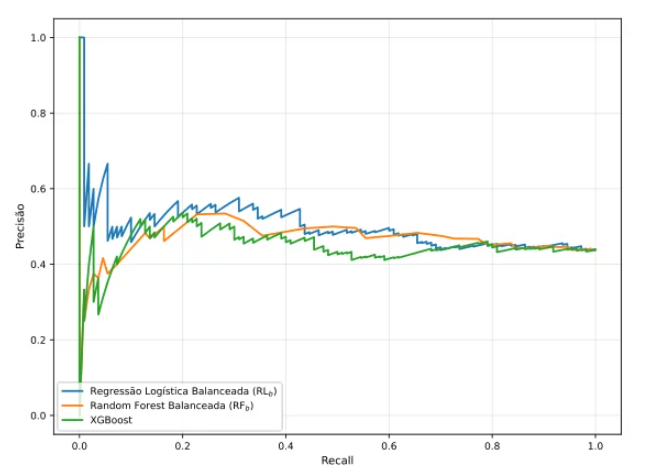
Figura 12. Curvas “Precision-Recall” dos modelos com variável-alvo reformulada
Fonte: Resultados originais da pesquisa
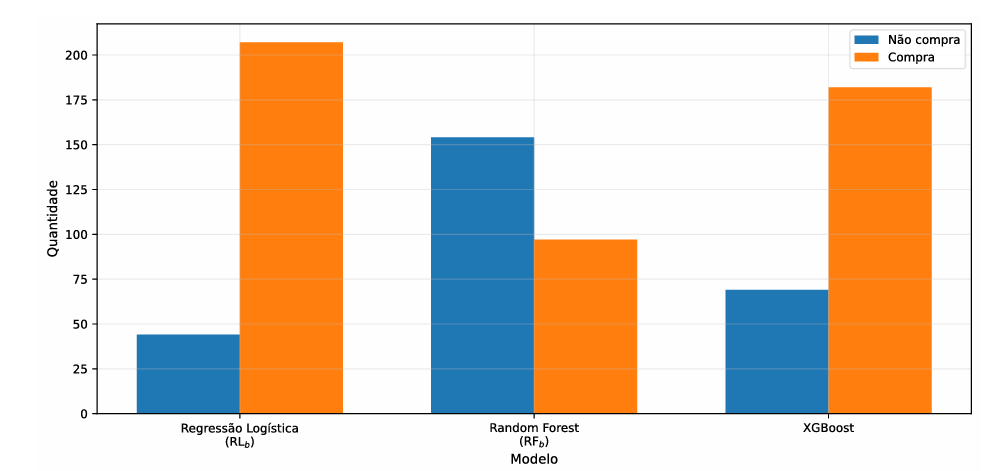
As curvas “Precision-Recall” dos modelos com a variável-alvo reformulada também apresentaram um ganho apenas moderado, sugerindo que a previsibilidade do ativo em frequência diária continuava restrita, mesmo com a nova formulação. A distribuição dos sinais previstos em 2024 evidencia, contudo, uma diferença operacional relevante entre os modelos. A RLb continuou gerando maior proporção de sinais positivos, enquanto a RFb passou a apresentar comportamento mais seletivo, com menor exposição ao ativo, como mostrado na Figura 13.
Figura 13. Distribuição dos sinais previstos em 2024 com variável-alvo reformulada
Fonte: Resultados originais da pesquisa
A Figura 13 ilustra a distribuição dos sinais de compra e não compra para os modelos com a variável-alvo reformulada. A Regressão Logística Balanceada (RLb) continuou a gerar uma proporção maior de sinais de compra (207) em comparação com os de não compra (44). O XGBoost também manteve essa tendência, com 182 sinais de compra e 69 de não compra. Em contraste, a Random Forest Balanceada (RFb) demonstrou um comportamento mais seletivo, com 98 sinais de compra e 153 de não compra. Essa diferença na seletividade dos sinais foi decisiva para a etapa final do trabalho, que avaliou a capacidade desses sinais de se converterem em desempenho financeiro superior por meio de backtesting. Resultados do “backtest”
A etapa final do estudo consistiu na avaliação financeira das estratégias por meio de backtesting, utilizando a configuração metodológica definida após a reformulação da variável-alvo e o uso do conjunto enriquecido de variáveis explicativas. Foram comparadas quatro abordagens: Regressão Logística Balanceada (RLb), Random Forest Balanceada (RFb), “Buy and Hold” e o “benchmark” técnico baseado no cruzamento de médias móveis SMA 10/20. O backtest foi realizado sobre o período de teste de 2024, com capital inicial de R$100.000,00, custo de transação de 0,2% por operação completa e alocação de 95% do caixa disponível a cada nova entrada, em regime “long-only”.
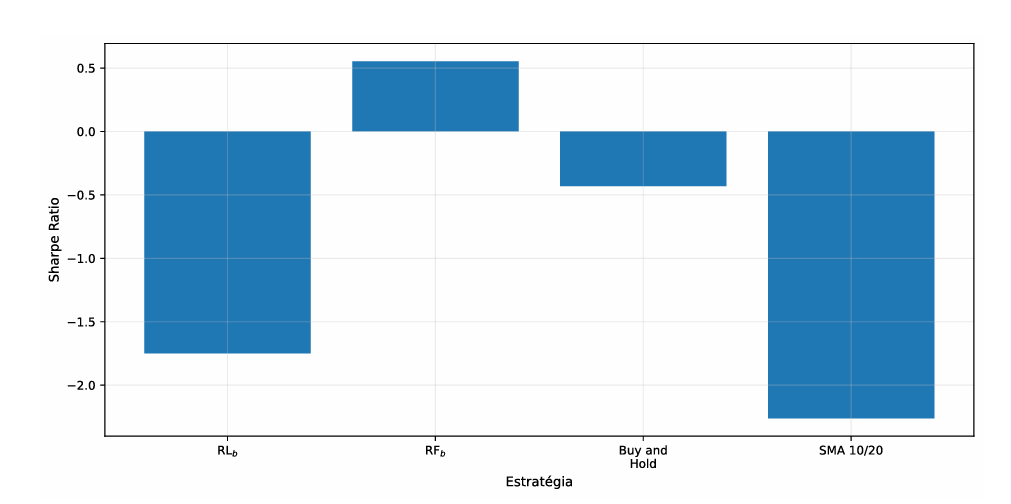
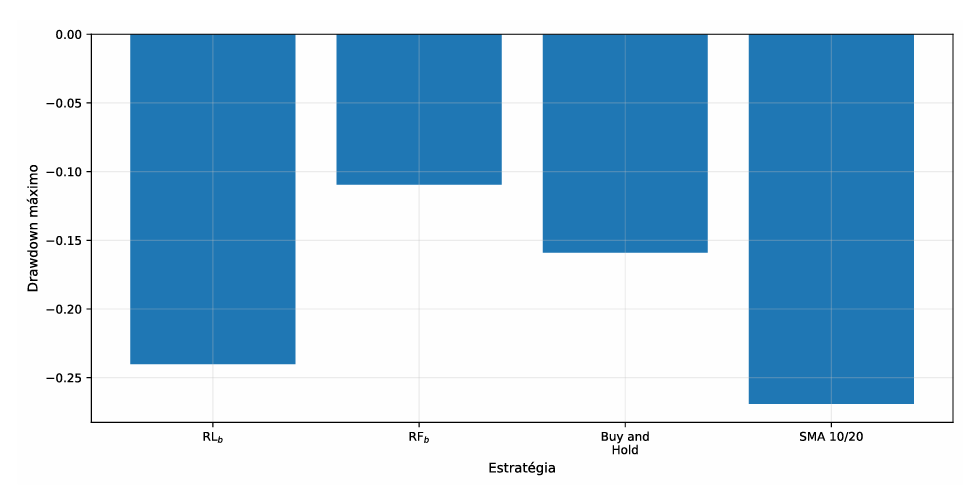
Os resultados financeiros agregados indicaram que a RFb foi a única estratégia a apresentar retorno acumulado positivo no período analisado, com valorização de 5,82%, encerrando o backtest com R$ 105.824,92. Em contraste, o “Buy and Hold” apresentou retorno acumulado de -9,25%, a RLb registrou -22,06%, e a estratégia SMA 10/20 obteve -23,55%. A RFb também se destacou com o melhor Sharpe Ratio (0,55) e o menor drawdown máximo (-10,95%), enquanto as demais estratégias apresentaram Sharpe Ratios negativos e drawdowns mais severos, como -1,75 para RLb, -0,43 para “Buy and Hold” e -2,26 para SMA 10/20.
A análise por operação complementa essa interpretação. A RFb executou 97 trades, com uma taxa de acerto de 46,39%, retorno médio por trade de -0,027% e profit factor de 0,95, o maior entre as estratégias avaliadas. A RLb, por sua vez, executou 207 trades, com taxa de acerto de 43,48% e profit factor de 0,78, evidenciando um comportamento mais agressivo e menor seletividade operacional. A estratégia SMA 10/20 e o “Buy and Hold” também apresentaram desempenho inferior, com profit factors de 0,65 e 0,78, respectivamente. Esses resultados sugerem que a principal vantagem da RFb não esteve na geração de operações individualmente muito lucrativas, mas em sua maior capacidade de filtrar a exposição ao ativo em momentos menos favoráveis.
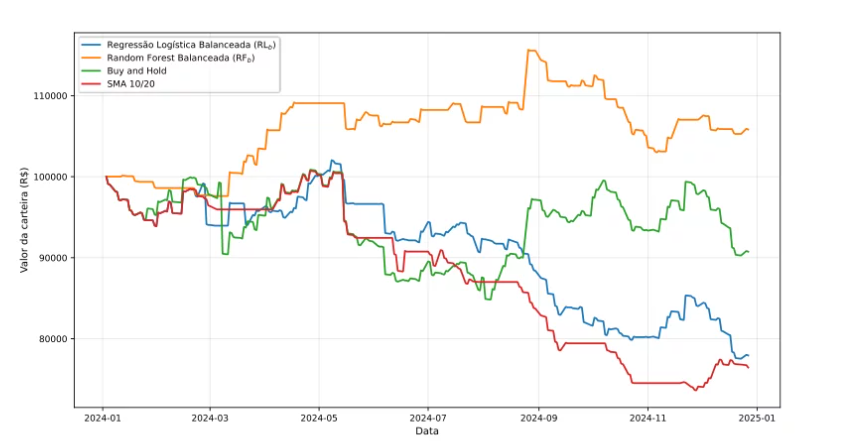
A trajetória das carteiras ao longo do período de teste de 2024 evidencia a superioridade relativa da RFb em relação às demais estratégias, como se observa na Figura 14. A curva de capital da RFb mostra um crescimento consistente, enquanto as outras estratégias apresentaram declínio ou estagnação. Essa visualização reforça a robustez do desempenho financeiro da RFb em um período desafiador para o mercado, onde os benchmarks tradicionais e a RLb não conseguiram gerar retornos positivos.
Figura 14. Curvas de capital acumulado no “backtest”
Fonte: Resultados originais da pesquisa
A Figura 14 demonstra claramente que a estratégia Random Forest Balanceada (RFb) foi a única a apresentar uma curva de capital ascendente ao longo de 2024, iniciando em R$ 100.000,00 e terminando acima de R$ 105.000,00. Em contraste, a Regressão Logística Balanceada (RLb), “Buy and Hold” e SMA 10/20 mostraram curvas de capital decrescentes, indicando perdas significativas. Essa visualização é um forte indicativo da capacidade da RFb de gerar valor em um ambiente de simulação, superando as abordagens passivas e técnicas tradicionais.
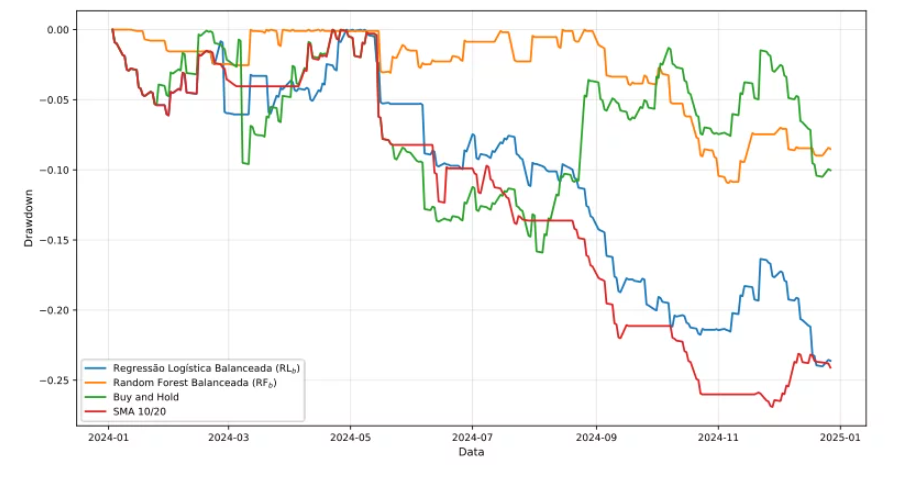
De maneira consistente, a análise do drawdown máximo mostra que a RFb apresentou perdas máximas menos severas ao longo do tempo, como ilustrado na Figura 15. O drawdown máximo da RFb foi de -10,95%, significativamente menor do que os -24,02% da RLb, -15,90% do “Buy and Hold” e -26,91% da SMA 10/20. Essa métrica é fundamental para avaliar a resiliência de uma estratégia, e o desempenho superior da RFb nesse quesito reforça sua capacidade de gerenciar o risco de forma mais eficaz em comparação com as outras abordagens.
Figura 15. Curvas de “drawdown” no “backtest”
Fonte: Resultados originais da pesquisa
A Figura 15 ilustra as curvas de drawdown das estratégias, evidenciando que a Random Forest Balanceada (RFb) manteve o menor nível de perda máxima em relação ao pico anterior da carteira. Enquanto as outras estratégias experimentaram drawdowns mais profundos e prolongados, a RFb demonstrou maior resiliência, o que é um fator crítico para a sustentabilidade de uma estratégia de trading. Essa capacidade de limitar as perdas é um dos pilares para a obtenção de retornos consistentes no longo prazo, mesmo em mercados voláteis.
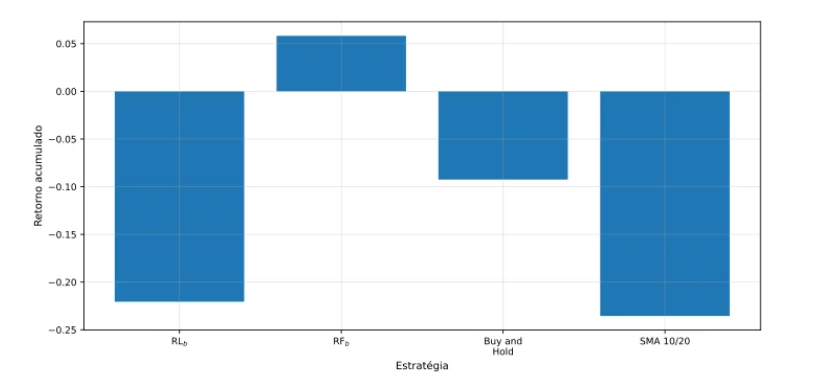
A comparação gráfica das métricas financeiras agregadas reforça o resultado de superioridade da RFb. A Figura 16 mostra que a RFb foi a única estratégia com retorno acumulado positivo, enquanto as demais apresentaram retornos negativos. A Figura 17 destaca o Sharpe Ratio da RFb como o único positivo, indicando um melhor retorno ajustado ao risco. Por fim, a Figura 18 reitera que a RFb teve o menor drawdown máximo, consolidando sua posição como a estratégia de melhor desempenho financeiro no backtest.
Figura 16. Retorno acumulado por estratégia
Fonte: Resultados originais da pesquisa
A Figura 16 demonstra visualmente o retorno acumulado de cada estratégia, confirmando que a Random Forest Balanceada (RFb) foi a única a gerar um retorno positivo de 5,82%. Em contraste, a Regressão Logística Balanceada (RLb), “Buy and Hold” e SMA 10/20 apresentaram retornos acumulados negativos, com -22,06%, -9,25% e -23,55%, respectivamente. Esse gráfico sintetiza a principal contribuição da RFb em termos de desempenho financeiro, destacando sua capacidade de superar os benchmarks em um período de teste desafiador.
Figura 17. “Sharpe Ratio” por estratégia
Fonte: Resultados originais da pesquisa
A Figura 17 ilustra o Sharpe Ratio de cada estratégia, uma medida crucial de retorno ajustado ao risco. A Random Forest Balanceada (RFb) obteve o único Sharpe Ratio positivo (0,55), indicando que gerou retornos superiores em relação ao risco assumido. As demais estratégias, incluindo RLb (-1,75), “Buy and Hold” (-0,43) e SMA 10/20 (-2,26), apresentaram Sharpe Ratios negativos, reforçando a superioridade da RFb não apenas em retorno absoluto, mas também em eficiência de capital. Essa métrica é fundamental para avaliar a qualidade de uma estratégia de investimento.
Figura 18. “Drawdown” máximo por estratégia
Fonte: Resultados originais da pesquisa
A Figura 18 apresenta o drawdown máximo de cada estratégia, que mede a maior perda percentual de capital em relação a um pico anterior. A Random Forest Balanceada (RFb) registrou o menor drawdown máximo (-10,95%), o que significa que foi a estratégia mais resiliente a quedas de mercado. Em comparação, a Regressão Logística Balanceada (RLb) teve um drawdown de -24,02%, o “Buy and Hold” de -15,90% e a SMA 10/20 de -26,91%. A capacidade da RFb de limitar as perdas é um fator chave para seu desempenho financeiro superior, pois preserva o capital e permite a recuperação mais rápida. Discussão sobre os resultados obtidos
Os resultados do estudo indicam que a previsibilidade da PETR4 em frequência diária, quando modelada exclusivamente por variáveis derivadas de preço e volume, mostrou-se limitada em termos absolutos. Desde a formulação inicial, observou-se baixa capacidade discriminatória e forte concentração de previsões na classe positiva, com desempenho probabilístico próximo ao limiar de aleatoriedade. Esse achado sugere que oscilações diárias de pequena magnitude introduzem elevado nível de ruído no problema preditivo, dificultando a distinção entre movimentos informativos e variações pouco relevantes do ponto de vista operacional (Tsay, 2010; Peng e De Moraes Souza, 2024).
A etapa de balanceamento dos modelos produziu efeitos modestos, enquanto o enriquecimento do conjunto de variáveis explicativas representou um avanço metodológico mais relevante, especialmente para a RFb, por favorecer a seletividade operacional dos sinais. Ainda assim, os ganhos permaneceram moderados e insuficientes para produzir separação robusta entre as classes. Isso indica que a limitação observada não decorria apenas do balanceamento ou do conjunto de atributos, mas também da própria formulação da variável-alvo, que inicialmente não considerava a relevância econômica dos movimentos de preço.
O ajuste metodológico mais importante do estudo foi a reformulação da variável-alvo com base em um limiar mínimo de retorno de 0,2%. Essa mudança não elevou de forma expressiva as métricas preditivas absolutas, mas tornou o problema mais aderente à lógica econômica da operação. Ao excluir movimentos de pequena magnitude, a nova target deixou de tratar como igualmente relevantes variações que, na prática, seriam incapazes de superar os custos de transação. Esse resultado reforça que, em aplicações financeiras, a utilidade de um modelo depende não apenas de sua capacidade de classificar corretamente eventos, mas também da forma como o problema é formulado em termos economicamente significativos (Gu et al., 2020; Bianchi et al., 2020; López de Prado, 2018).
Nesse contexto, um dos achados mais importantes do trabalho foi a divergência entre desempenho preditivo e desempenho financeiro. Embora a RLb tenha apresentado resultados relativamente melhores em parte das métricas de classificação na etapa final, foi a RFb que produziu o melhor resultado no backtest. Esse contraste mostra que o modelo estatisticamente mais competitivo nem sempre é o mais eficiente na geração de sinais operacionalmente úteis. No caso em análise, a vantagem da RFb parece ter estado menos na superioridade de suas métricas preditivas isoladas e mais em sua maior seletividade operacional, isto é, em sua capacidade de reduzir a exposição ao ativo em momentos menos favoráveis.
Os resultados do backtest reforçam essa interpretação. A RFb foi a única estratégia a apresentar retorno acumulado positivo em 2024, superando o “Buy and Hold”, a RLb e o “benchmark” técnico baseado em médias móveis. Ao mesmo tempo, apresentou o melhor “Sharpe Ratio” e “drawdown” máximo inferior ao das estratégias concorrentes. A análise por trade mostra que essa superioridade não decorreu de retornos médios muito elevados por operação, mas de um conjunto de sinais que, mesmo imperfeitos, foi mais eficiente na filtragem de exposição ao risco. Esse achado é particularmente relevante porque sugere que, em problemas de trading quantitativo, pequenas melhorias na seletividade dos sinais podem ter impacto mais importante no resultado financeiro do que diferenças marginais em métricas preditivas agregadas.
Outro ponto importante é o fraco desempenho do “benchmark” técnico de cruzamento de médias móveis SMA 10/20 no período analisado. Embora se trate de uma regra tradicional e amplamente utilizada como referência de seguimento de tendência, seus resultados ficaram abaixo não apenas da RFb, mas também do “benchmark” passivo. Isso sugere que, no recorte temporal e no ativo considerados, uma regra técnica simples não foi capaz de capturar de forma eficiente a dinâmica do mercado. Ao mesmo tempo, o resultado negativo do “Buy and Hold” em 2024 mostra que o período de teste foi desafiador, o que torna ainda mais relevante o fato de a RFb ter conseguido gerar retorno acumulado positivo.
Em termos mais amplos, os achados do estudo reforçam que a aplicação de ML ao trading de ativos financeiros não deve ser avaliada exclusivamente por métricas tradicionais de classificação. Em problemas dessa natureza, a qualidade da variável-alvo, a coerência entre modelagem e lógica operacional, a seletividade dos sinais e a avaliação fora da amostra por meio de backtesting são elementos centrais. Assim, a principal contribuição do trabalho não está em demonstrar alta previsibilidade da PETR4 em frequência diária, mas em evidenciar que decisões metodológicas aparentemente simples, como a definição da target e a forma de converter previsões em sinais operacionais, podem ser decisivas para a utilidade financeira dos modelos. Limitações do estudo
Este estudo apresenta algumas limitações que devem ser consideradas na interpretação dos resultados. Em primeiro lugar, a análise empírica foi restrita a um único ativo, a ação preferencial da Petrobras [PETR4], o que limita a generalização dos achados para outros papéis, setores ou mercados. Embora a escolha desse ativo tenha sido metodologicamente justificada por sua elevada liquidez e ampla disponibilidade de dados, os resultados obtidos não podem ser automaticamente estendidos a outros contextos sem investigação adicional, sendo necessário cautela ao inferir conclusões para outros ativos financeiros.
Em segundo lugar, a modelagem foi conduzida com dados em frequência diária, opção compatível com o escopo do estudo e com a necessidade de reduzir ruídos associados a oscilações de muito curto prazo. Ainda assim, essa escolha implica perda de informações intradiárias potencialmente relevantes para a geração de sinais mais precisos, especialmente em estratégias de curtíssimo prazo. Dessa forma, os resultados devem ser interpretados como válidos para o horizonte temporal considerado, e não como evidência exaustiva sobre a previsibilidade do ativo em outras frequências, o que poderia ser explorado em estudos futuros com dados de maior granularidade.
Outra limitação importante diz respeito ao conjunto de variáveis explicativas utilizado. A modelagem foi baseada exclusivamente em indicadores derivados de preço e volume, incluindo medidas de tendência, momentum, volatilidade e intensidade relativa de negociação. Embora essa escolha seja coerente com a proposta do trabalho, ela não contempla outras fontes potencialmente relevantes, como variáveis macroeconômicas, fundamentos corporativos, notícias, medidas de sentimento de mercado ou dados intradiários. Assim, parte da limitada capacidade discriminatória observada pode estar associada à própria restrição informacional do conjunto de atributos adotado, sugerindo que a inclusão de outras fontes de dados poderia aprimorar o desempenho dos modelos.
Também devem ser consideradas as simplificações inerentes ao ambiente de backtest. O custo de transação foi modelado de forma fixa em 0,1% na entrada e 0,1% na saída, sem incorporar explicitamente outros atritos de mercado, como “spread bid-ask”, “slippage”, impacto de mercado, restrições de liquidez mais finas ou tributação. Além disso, foi adotado capital inicial fixo de R$ 100.000,00 e regra de alocação proporcional de 95% do caixa disponível a cada nova entrada, parâmetros definidos com finalidade de padronização e comparabilidade entre estratégias, e não de otimização financeira. Dessa forma, os resultados do backtest devem ser interpretados como aproximações consistentes do desempenho relativo das estratégias, e não como reprodução exata de condições reais de negociação, o que pode ser um campo para estudos mais detalhados.
Por fim, embora a reformulação da variável-alvo com limiar mínimo de 0,2% tenha representado o ajuste metodológico mais relevante do estudo, essa escolha também constitui uma simplificação. Outros limiares, horizontes de previsão e formas de definição do evento positivo poderiam produzir resultados distintos. Em conjunto, essas limitações não invalidam os achados, mas delimitam seu alcance e indicam oportunidades para pesquisas futuras, como a exploração de diferentes configurações da variável-alvo e a análise de sua sensibilidade aos resultados obtidos, a fim de aprofundar a compreensão sobre a utilidade econômica dos modelos de Machine Learning em trading.
4. Conclusão
O presente estudo avaliou modelos de Machine Learning aplicados ao trading de ativos financeiros por meio de backtesting, examinando sua capacidade de gerar sinais operacionais úteis e desempenho financeiro superior a benchmarks tradicionais no mercado acionário brasileiro. Verificou-se que a formulação inicial da variável-alvo, baseada na direção do pregão seguinte, resultou em baixa capacidade discriminatória e sinais ruidosos, comprometendo a utilidade prática dos modelos. O balanceamento de classes e o enriquecimento do conjunto de variáveis explicativas produziram melhorias modestas. Contudo, a reformulação da variável-alvo para um limiar mínimo de retorno de 0,2% foi decisiva, alinhando a modelagem estatística à lógica econômica da operação ao focar em movimentos economicamente relevantes. Nesse contexto, a Random Forest Balanceada (RFb) destacou-se no backtest de 2024, sendo a única estratégia a gerar retorno acumulado positivo de 5,82%, superando o “Buy and Hold”, a Regressão Logística Balanceada e o benchmark técnico de médias móveis. Observou-se que a superioridade da RFb não residiu em métricas preditivas absolutas, mas em sua maior seletividade operacional, evidenciando que a capacidade de filtrar a exposição ao ativo em momentos desfavoráveis foi crucial para o desempenho financeiro. A principal contribuição do trabalho reside em demonstrar que decisões metodológicas, como a definição da variável-alvo e a conversão de previsões em sinais operacionais, são mais decisivas para a utilidade financeira dos modelos do que a mera acurácia preditiva.
Este estudo apresenta limitações importantes, como a restrição da análise empírica a um único ativo (PETR4) e a utilização de dados em frequência diária, o que impede a generalização irrestrita dos achados para outros mercados ou horizontes temporais. O conjunto de variáveis explicativas, focado em indicadores de preço e volume, não incorporou outras fontes de informação potencialmente relevantes, como dados macroeconômicos ou de sentimento de mercado. Além disso, as simplificações inerentes ao ambiente de backtest, como custos de transação fixos e regras de alocação padronizadas, representam aproximações das condições reais de negociação. Para estudos futuros, sugere-se ampliar a análise para outros ativos e setores, explorar dados de maior granularidade (intradiários), incorporar variáveis explicativas adicionais e investigar a sensibilidade dos resultados a diferentes configurações da variável-alvo e a condições de backtest mais detalhadas, a fim de aprofundar a compreensão sobre a aplicação de Machine Learning em trading de ativos financeiros.
Referências Bibliográficas
Backtrader. 2025. Disponível em: https://www.backtrader.com/. Acesso em: 26 mar. 2025.
Bianchi, D.; Büchner, M.; Tamoni, A. 2020. Bond risk premiums with machine learning. The Review of Financial Studies 34(2): 1046-1089.
Chan, E. 2013. Algorithmic trading: winning strategies and their rationale. Wiley.
El Hajj, M.; Hammoud, J. 2023. Unveiling the influence of artificial intelligence and machine learning on financial markets: a comprehensive analysis of ai applications in trading, risk management, and financial operations. Journal of Risk and Financial Management 16(10): 434
Fávero, L. P.; Belfiore, P. 2024. Manual de análise de dados: estatística e machine learning com Excel®, SPSS®, Stata®, R® e Python®. 2. ed. GEN LTC, Rio de Janeiro, RJ, Brasil.
Gu, S.; Kelly, B.; XIU, D. 2020. Empirical asset pricing via machine learning. Review of Financial Studies 33(5): 2223-2273.
James, G.; Witten, D.; Hastie, T.; Tibshirani, R.; Taylor, J. 2023. An introduction to statistical learning: with applications in Python. Springer, Cham, Suiça.
López de Prado, M. 2018. Advances in financial machine learning. John Wiley & Sons, Hoboken, NJ, EUA.
López de Prado, M. 2020. Machine learning for asset managers. Cambridge University Press, Cambridge, Inglaterra.
Nazareth, D. L.; Ramana Reddy, V. Y. 2023. Financial applications of machine learning: a literature review. Expert Systems with Applications 219: 119640.
Olorunnimbe, K., Viktor, H. 2023. Deep learning in the stock market a systematic survey of practice, backtesting, and applications. artificial Intelligence Review 56: 2057–2109.
Peng, Y.; De Moraes Souza, J. G. 2024. Chaos, overfitting and equilibrium: to what extent can machine learning beat the financial market? International Review of Financial Analysis 95: 103474.
Tsay, R. S. 2010. Analysis of financial time series. 3. ed. John Wiley & Sons, Hoboken, NJ, EUA.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

