
08 de julho de 2026
Fatores Socioeconômicos da Violência Letal Urbana: uma Análise Multinível e de Aprendizado de Máquina em Municípios Brasileiros
Lucas Valoz Castellucci; Édipo Menezes da Silva
DOI: 10.22167/2675-6528-202600003
Artigo elaborado pela ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege voltada à síntese e redação.
Resumo
A violência letal urbana no Brasil representa um desafio social persistente, com elevadas taxas de homicídios e a necessidade de compreender suas raízes socioeconômicas. Este estudo analisou 282 municípios brasileiros para identificar a contribuição de indicadores socioeconômicos na explicação das taxas de mortes violentas intencionais em 2010. Para mitigar a multicolinearidade, empregou-se a Análise de Componentes Principais (PCA), que condensou 18 variáveis em cinco indicadores complexos: Pobreza e Desigualdade, Educação, Emprego, Infraestrutura e População. Em seguida, aplicaram-se cinco modelos estatísticos e de aprendizado de máquina, dos quais a Regressão Multinível e o Random Forest se destacaram. O modelo multinível alcançou um poder explicativo relevante (R² ≈ 0,617), indicando que População e Emprego apresentaram os maiores coeficientes, seguidos por Educação e Infraestrutura. Observou-se que densidade populacional e desemprego associaram-se positivamente ao aumento da violência letal, enquanto a educação exerceu efeito redutor. O Random Forest obteve melhor ajuste (R² ≈ 0,683), com importâncias mais equilibradas entre os fatores e acurácia em previsões futuras. A comparação entre os modelos revelou que, enquanto a Regressão Multinível destacou relações lineares, o Random Forest capturou interações não lineares complexas e duradouras, sublinhando a necessidade de políticas públicas integradas que abordem emprego, urbanização e desigualdade.
Palavras-chave: Análise de Componentes Principais; Florestas Aleatórias; Indicadores Socioeconômicos; Políticas Públicas; Regressão Multinível.
1. Introdução
A violência e a criminalidade representam desafios persistentes nas sociedades urbanas, e o Brasil não é uma exceção. Apesar de recentes quedas em alguns índices, os números da violência letal permanecem alarmantes. Conforme o Fórum Brasileiro de Segurança Pública (FBSP, 2024), o país registrou 46.328 Mortes Violentas Intencionais (MVI) em 2023, equivalentes a 22,8 mortes por 100 mil habitantes, quase quatro vezes a média mundial de 5,8 homicídios por 100 mil habitantes. O Atlas da Violência 2024 (IPEA; FBSP, 2024) sugere que esses dados podem estar subestimados devido ao elevado número de mortes classificadas como de “causa indeterminada” (Cerqueira e Bueno, 2024). A letalidade policial também se intensificou, com 6.393 mortes decorrentes de intervenções policiais em 2023, resultando em uma taxa de 3,1 mortes por 100 mil habitantes, indicando escalada da violência policial na última década (FBSP, 2024).
Historicamente, as tentativas de explicar a violência e o desvio social foram marcadas por abordagens pouco científicas, frequentemente preconceituosas e pseudocientíficas. No século XIX, a criminologia, por exemplo, atribuía a criminalidade a características inatas ou raciais (Lombroso, 1876; Rodrigues, 2011). Contudo, a partir da segunda metade do século XX, as teorias sociais promoveram uma mudança de paradigma. A violência e a criminalidade passaram a ser compreendidas como produto de fatores ambientais e socioeconômicos. Nesse contexto, a utilização de indicadores sociais tornou-se fundamental para operacionalizar conceitos abstratos, como violência, pobreza e desigualdade, fornecendo a base para a formulação e avaliação de políticas públicas (Januzzi, 2001).
Nesse cenário de busca por explicações robustas, surgiram estudos pioneiros que investigaram a relação entre violência letal e fatores socioeconômicos. Trabalhos como o de Shaw e Mckay (1969) nos Estados Unidos e a discussão de Cano e Santos (2001) sobre a violência letal, renda e desigualdade social no Brasil foram marcos importantes. Essas pesquisas, no entanto, enfrentaram limitações relacionadas à qualidade dos registros e à capacidade computacional da época. Em contrapartida, o contexto atual, caracterizado pela vasta disponibilidade de dados e pelo alto poder de processamento computacional, oferece uma oportunidade singular para aprofundar essas teorias por meio de modelos de aprendizado de máquina. É crucial, porém, considerar as dimensões éticas do uso de algoritmos de aprendizado de máquina e inteligência artificial na análise preditiva da criminalidade, a fim de evitar o reforço de desigualdades (O’Neil, 2016; Ludwig e Mullainathan, 2021; Silva, 2022; Coelho, 2024). A fundamentação teórica da sociologia é essencial para uma análise crítica e para a proposição de variáveis explicativas, especialmente as socioeconômicas, como preditores da violência letal.
A literatura empírica já apresenta estudos que exploram a relação entre criminalidade, indicadores socioeconômicos e aprendizado de máquina. Nos Estados Unidos, Goin et al. (2018) desenvolveram um modelo que identificou preditores de violência armada em comunidades urbanas da Califórnia. No Brasil, Alves et al. (2018) propuseram um modelo para prever crimes a partir de indicadores urbanos, apontando fatores como desemprego, analfabetismo e população masculina como relevantes para a previsão de homicídios. Mais alinhado à presente pesquisa, o trabalho de Ribeiro e Cano (2016) sobre violência letal e desigualdade em municípios brasileiros demonstrou a renda dos mais pobres como um dos principais fatores explicativos. Esses estudos servem como precedentes para a aplicação de estatística e aprendizado de máquina no campo da violência e criminalidade, enquanto as teorias sociológicas fornecem hipóteses sobre quais indicadores, como educação, desemprego e desigualdade, podem estar mais associados às taxas de violência.
Com base nessas considerações e na necessidade de aprofundar a compreensão dos complexos fatores que impulsionam a violência letal urbana no Brasil, esta pesquisa se justifica pela sua contribuição potencial para a formulação de políticas públicas mais eficazes. A lacuna reside na necessidade de modelos que capturem as interações lineares e não lineares entre múltiplos fatores socioeconômicos e a violência. Assim, este estudo propõe investigar as relações entre violência letal e indicadores socioeconômicos em municípios brasileiros por meio de uma abordagem que combina aprendizado de máquina e regressão multinível, com o objetivo de identificar os principais fatores explicativos da violência letal em municípios urbanos.
2. Material e Métodos
A presente pesquisa caracterizou-se como um estudo observacional setorial, de natureza quantitativa, conforme a classificação de Kellstedt e Whitten (2018). O objetivo central foi investigar as relações entre a violência letal e indicadores socioeconômicos em municípios brasileiros, utilizando uma abordagem que combinou aprendizado de máquina e regressão multinível. Os dados utilizados foram secundários, provenientes de autarquias e institutos públicos, agregados e disponibilizados pelo Instituto de Pesquisa Econômica Aplicada (IPEA). A seleção dos indicadores sociais, definidos por Januzzi (2001), baseou-se na bibliografia existente e na disponibilidade para o nível municipal, com todos os dados socioeconômicos referenciados ao ano de 2010.
A variável dependente do estudo foi a Taxa de Mortes Violentas por 100.000 habitantes (“TAXA_VIOLENCIA”), calculada pelo IPEA a partir da soma de Crimes Violentos Letais e Intencionais (CVLI) e Mortes por Intervenção de Agente do Estado (MIAE), padronizada como MVI, com fonte primária no sistema DATASUS. A unidade de análise consistiu em municípios brasileiros. Inicialmente, um banco de dados com 5565 municípios e 19 variáveis foi construído. Para garantir a padronização e mitigar subnotificações, a base foi restringida a municípios com população superior a 100.000 habitantes. Após a remoção de cidades sem dados de violência, a amostra final compreendeu 282 municípios.
A presença de multicolinearidade entre as variáveis preditoras socioeconômicas foi diagnosticada por meio do coeficiente de correlação de Pearson e do Variance Inflation Factor (VIF), conforme James et al. (2023). Para mitigar esse problema, empregou-se a Análise de Componentes Principais (PCA), uma técnica de redução de dimensionalidade que transformou as 18 variáveis originais em cinco indicadores complexos e ortogonais. Esses fatores temáticos foram: População, Educação, Infraestrutura, Pobreza e Desigualdade, e Emprego. A interpretação desses fatores, que funcionaram como indicadores sintéticos conforme Januzzi (2002), baseou-se nas cargas fatoriais. Após a transformação, o diagnóstico de VIF para os novos fatores confirmou valores inferiores a cinco, garantindo o pressuposto de independência dos preditores.
Para responder à questão de pesquisa, testaram-se cinco modelos supervisionados: Regressão Linear Múltipla (RLM), RLM com Transformação Logarítmica (Log-RLM), RLM com transformações de Box-Cox (RLM-BC), Regressão Multinível com Transformações de Box-Cox (RLMM-BC) e Random Forest Regressor (RFR). Os modelos paramétricos foram implementados utilizando a biblioteca `statsmodels` do Python, enquanto o RFR foi desenvolvido com a classe `RandomForestRegressor` da biblioteca `scikit-learn`. Os pressupostos de normalidade dos resíduos foram diagnosticados pelos testes de Shapiro-Francia e Shapiro-Wilk, e a variância constante dos resíduos pelo teste de Breusch-Pagan, ambos implementados via `statsmodels` ou `scipy`.
A otimização dos hiperparâmetros para o RFR foi realizada por meio da classe `RandomizedSearchCV` da biblioteca `scikit-learn`, que utilizou validação cruzada e procura exaustiva. A escolha do modelo RLMM-BC justificou-se pela estrutura hierárquica dos dados de violência, aninhados em Unidades Federativas e Regiões do país, conforme Goldstein (2011). Para lidar com a dependência entre as observações, utilizou-se a Máxima Verossimilhança Restrita (REML). O Random Forest Regressor, por ser não-paramétrico, baseou-se na construção de múltiplas árvores de decisão a partir de amostras distintas, combinadas para uma predição final (Géron, 2023; Mandalapu et al., 2023), permitindo capturar relações não-lineares. A comparação do desempenho dos modelos foi realizada utilizando o coeficiente de determinação (R²), o Erro Quadrático Médio (MSE) e a Raiz do Erro Quadrático Médio (RMSE).
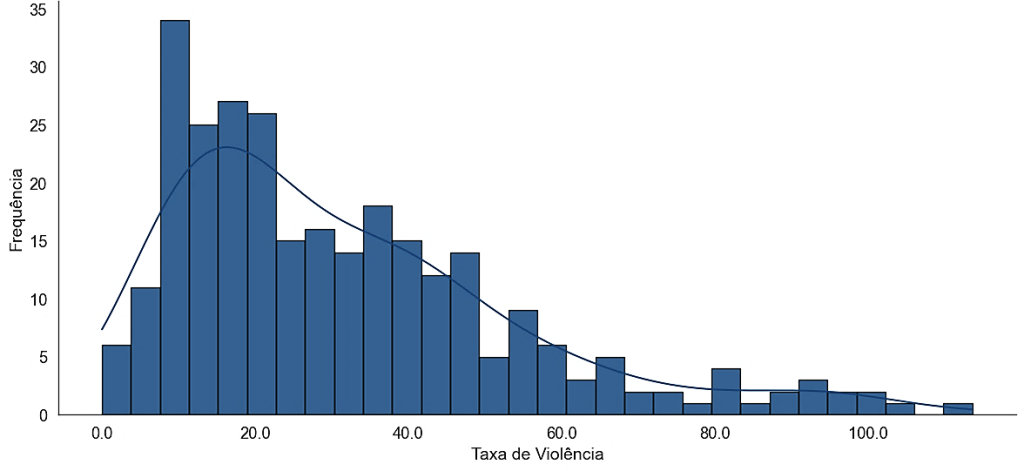
A análise exploratória da taxa municipal de mortes violentas intencionais, padronizada para 100.000 habitantes, revelou uma dispersão considerável nos 282 municípios estudados. Os dados indicaram uma média de 31,60 mortes por 100.000 habitantes, superando a mediana de 25,30 em 6,3 pontos, o que sugere uma assimetria positiva na distribuição. Essa assimetria é reforçada pela amplitude dos valores, que variaram de um mínimo de zero a um máximo de 113,67 mortes por 100.000 habitantes, uma taxa considerada extremamente alta pela Organização Mundial da Saúde (OMS) para qualquer valor igual ou superior a dez.
A distribuição das taxas de violência letal nos municípios estudados, conforme visualizado, demonstra que a maioria dos municípios se concentra em taxas mais baixas, mas há uma cauda longa de municípios com taxas elevadas, contribuindo para a média mais alta. O desvio padrão de 22,59 ressalta a heterogeneidade da violência entre as cidades, indicando que o problema não se manifesta de maneira uniforme em todo o território. Essa variabilidade inicial já aponta para a complexidade do fenômeno e a necessidade de investigar fatores explicativos que possam dar conta dessas disparidades. Um exemplo de árvore de regressão trazido por Géron (2023, p. 279) pode ser visualizado na Figura 1.
Figura 1. Funcionamento de uma Árvore de Regressão
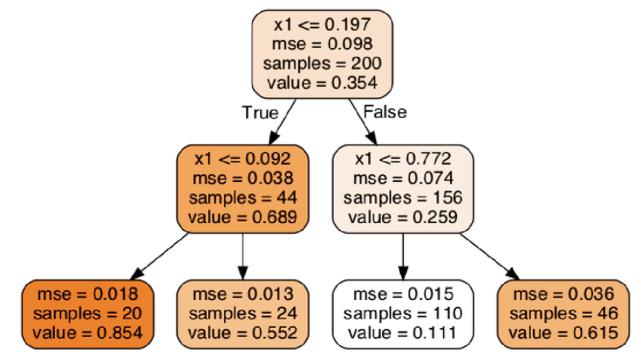
Fonte: Géron (2023, p. 279)
3. Resultados e Discussão
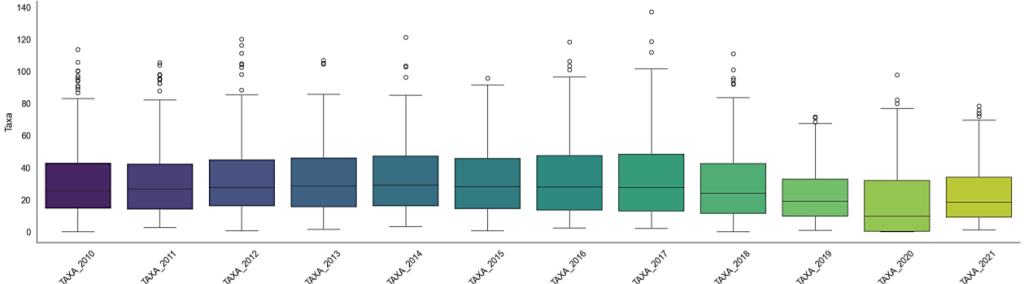
Ao examinar a evolução temporal da taxa de violência letal entre 2010 e 2021, observou-se uma tendência inicial de alta, com o pico em 2017, quando a média atingiu 33,83 e a mediana 27,66. Nesse período, a dispersão também foi máxima, com um desvio padrão de 25,02 e um valor extremo de 137,20, indicando um cenário de violência elevada e desigual. Contudo, a partir de 2018, houve uma quebra estrutural, com uma queda acentuada que levou a violência ao seu mínimo histórico em 2020, ano da pandemia de COVID-19, com a mediana caindo para 9,70 e a média para 18,05.
A recuperação da violência em 2021, com a mediana quase dobrando para 18,51 e a média subindo para 23,03, foi acompanhada por uma redução na dispersão, com o desvio padrão caindo para 17,18. Esse padrão sugere que a retomada da violência em 2021 foi mais homogênea e generalizada, afetando um conjunto mais amplo de municípios de forma similar. A persistência da média acima da mediana ao longo de toda a série temporal confirma uma assimetria positiva na distribuição, indicando a presença contínua de municípios com taxas de violência extremas que elevam a média geral.
Figura 2. Distribuição das taxas de violência letal nos municípios estudados
Fonte: Resultados originais da pesquisa
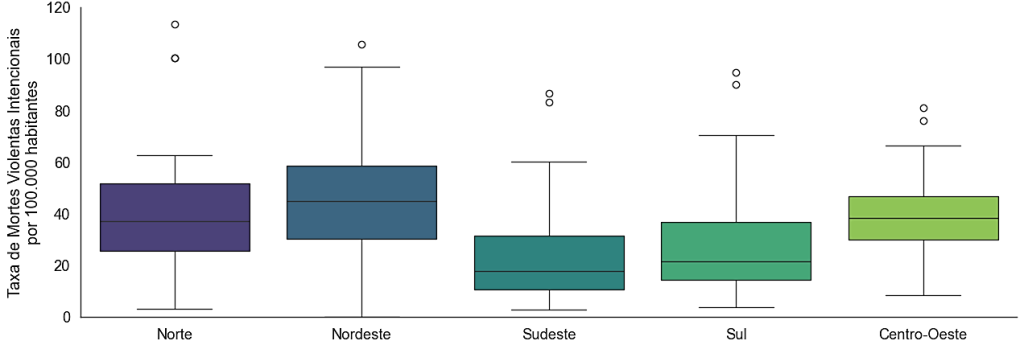
A agregação da taxa de Mortes Violentas Intencionais (MVI) por grande Região do Brasil em 2010 revelou uma profunda desigualdade territorial. As regiões Norte e Nordeste destacaram-se como os epicentros da violência letal, com o Nordeste apresentando a mediana mais elevada, pouco acima de 40 mortes por 100.000 habitantes. Essa região também exibiu uma vasta dispersão, indicando a presença de municípios com violência moderada e outros com as taxas mais elevadas do país.
Em contraste, a região Sudeste apresentou a menor mediana e uma distribuição mais compacta, seguida pela região Sul, sugerindo um cenário de violência menos intensa e mais homogênea. O Centro-Oeste ocupou uma posição intermediária, com os menores “outliers”. Essa disparidade regional sublinha a necessidade de abordagens diferenciadas para as políticas de segurança pública, considerando as particularidades socioeconômicas e estruturais de cada área geográfica, conforme a distribuição visualizada.
Figura 3. Boxplot da taxa de violência letal 2010 a 2021
Fonte: Resultados originais da pesquisa
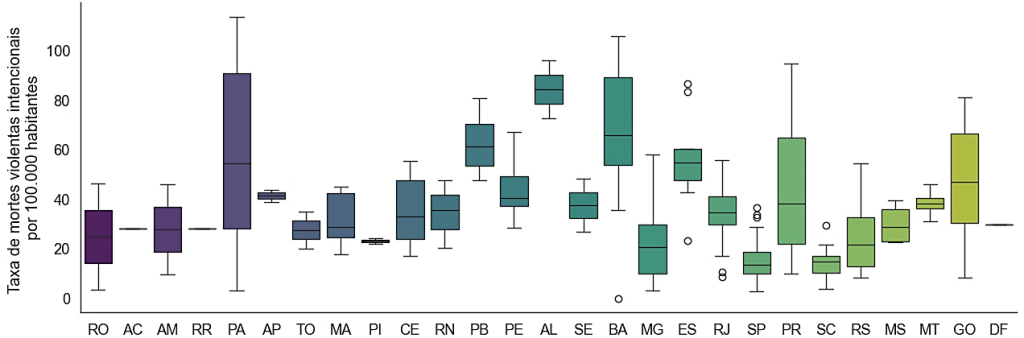
A desagregação da variável dependente por Unidade Federativa (UF) revelou uma heterogeneidade ainda mais profunda na violência letal, sendo um dos achados mais relevantes da análise exploratória. Estados como Alagoas, Bahia, Paraíba e Pará apresentaram as medianas mais elevadas, com o Pará exibindo alta variabilidade intraestadual, indicando um problema de violência severo e desigual dentro do próprio estado. Essa situação contrasta fortemente com estados como Santa Catarina e São Paulo, que registraram medianas substancialmente mais baixas e distribuições mais compactas, sugerindo um cenário de violência mais homogêneo e menos intenso.
Figura 4. Distribuição das taxas de violência letal dos municípios segundo Região do Brasil
Fonte: Resultados originais da pesquisa
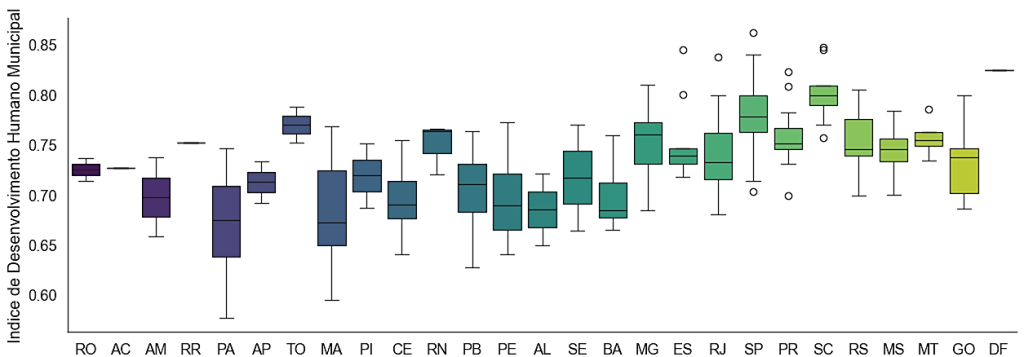
Na análise das variáveis independentes, o Índice de Desenvolvimento Humano Municipal (IDHM) por UF apresentou um padrão geográfico que é quase o espelho da distribuição da violência, revelando uma correlação visual inversa. Os estados com as maiores taxas de violência letal, como Alagoas, Pará e Bahia, exibiram as medianas de IDHM mais baixas. Por outro lado, estados com melhores cenários de segurança, como Santa Catarina e São Paulo, possuíam as medianas de IDHM mais elevadas e distribuições mais concentradas em patamares superiores.
Este achado fornece uma forte evidência exploratória para a hipótese central da pesquisa, indicando uma relação clara entre indicadores socioeconômicos e violência letal. A inversão dos padrões geográficos entre violência e IDHM sugere que o desenvolvimento humano, que engloba renda, educação e longevidade, atua como um fator protetivo contra a violência letal. A visualização dessas relações é crucial para compreender a complexidade do fenômeno e direcionar intervenções eficazes.
Figura 5. Distribuição das taxas de violência em municípios segundo UF
Fonte: Resultados originais da pesquisa
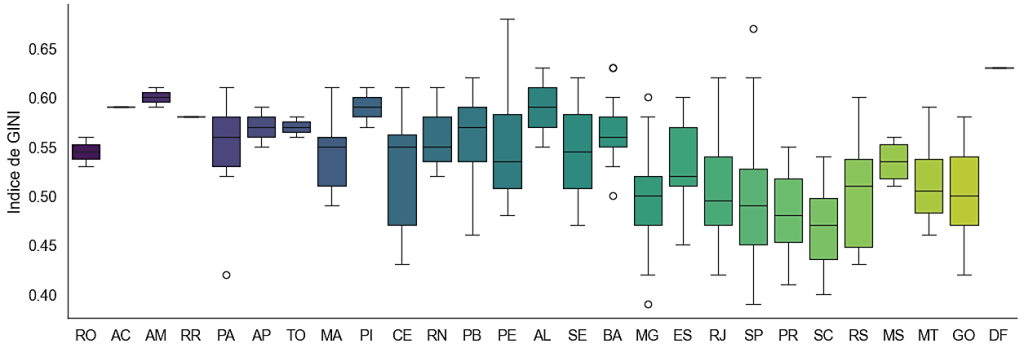
A análise do Índice de Gini por UF, que mede a desigualdade de renda, também seguiu um padrão geográfico bem definido, assemelhando-se aos indicadores anteriores. Os estados das regiões Norte e Nordeste, juntamente com o Distrito Federal, tenderam a apresentar os maiores índices de Gini, indicando uma maior concentração de renda. Em contrapartida, os estados da região Sul, com destaque para Santa Catarina, exibiram os menores níveis de desigualdade.
A sobreposição deste padrão com o da violência letal sugere uma potencial correlação positiva, levantando a hipótese de que ambientes com maior desigualdade podem ser mais propensos à violência. Essa relação é consistente com a literatura que aponta a desigualdade como um fator de risco para a criminalidade, reforçando a importância de políticas de redução das disparidades sociais para a prevenção da violência. A visualização desses dados é fundamental para contextualizar as análises subsequentes.
Figura 6. Indice de Desenvolvimento Humano Municipal em 2010
Fonte: Resultados originais da pesquisa
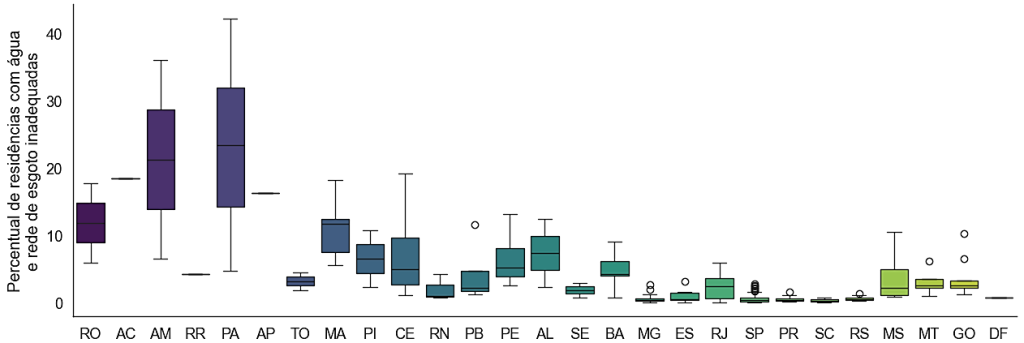
As condições de infraestrutura, avaliadas pelo percentual de domicílios com esgotamento sanitário e fornecimento de água inadequados, serviram como um indicador de precariedade habitacional e ausência de serviços estatais. O boxplot evidenciou um forte contraste regional, com o Norte concentrando os maiores déficits, enquanto a maioria dos municípios do Sudeste e Sul registrava inadequação próxima ou inferior a cinco por cento. Essa geografia do déficit de infraestrutura se sobrepõe à da violência letal.
Essa correspondência sugere que a ausência do Estado na provisão de serviços essenciais e as condições de vida precárias favorecem a incidência de violência letal. A infraestrutura inadequada pode ser um reflexo de desinvestimento público e de condições socioeconômicas desfavoráveis, que, por sua vez, criam um ambiente propício para a criminalidade. A visualização desses dados reforça a interconexão entre diferentes dimensões da vulnerabilidade social e a violência.
Figura 7. Indice de GINI em 2010
Fonte: Resultados originais da pesquisa
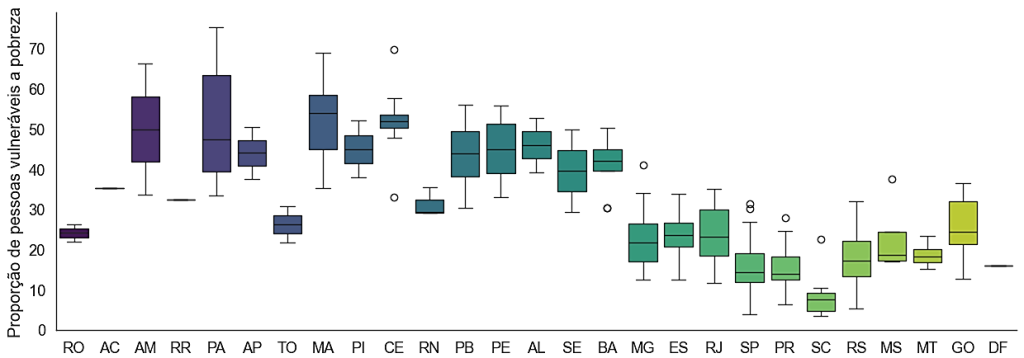
A distribuição de vulneráveis à pobreza por UF consolidou os padrões geográficos observados, apontando uma acentuada concentração no Norte e Nordeste, onde estados como Maranhão e Pará exibiram medianas superiores a cinquenta por cento. Em contraste, os estados do Sul, com destaque para Santa Catarina, registraram os menores percentuais. A forte correspondência visual entre a geografia da vulnerabilidade à pobreza e a da violência letal sugere que a precariedade econômica, somada aos déficits de desenvolvimento, desigualdade e infraestrutura, compõe uma sinergia de fatores associada a maiores níveis de violência.
Figura 8. Rede de esgoto e fornecimento de água inadequados em 2010
Fonte: Resultados originais da pesquisa
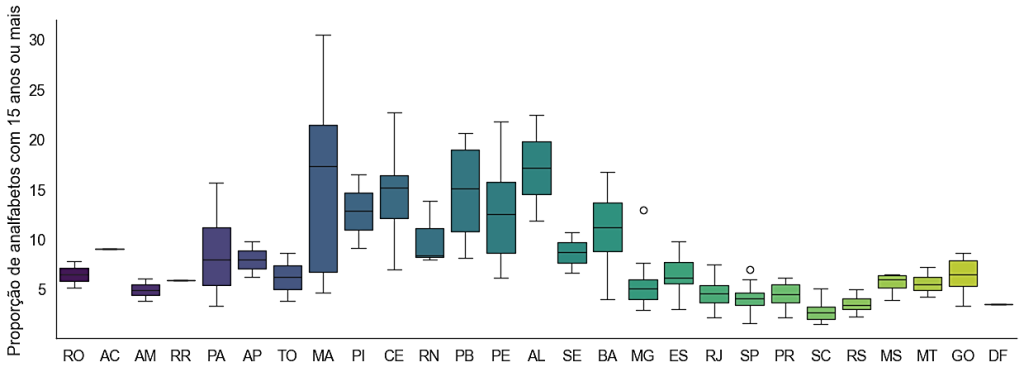
A proporção de analfabetos com 15 anos ou mais, um indicador fundamental do capital humano e educacional, reiterou o padrão geográfico observado. Houve uma forte concentração das taxas de analfabetismo nos estados do Nordeste, com Alagoas, Maranhão e Paraíba apresentando os níveis mais críticos. Em oposição, o Distrito Federal e as regiões Sul e Sudeste, lideradas por Santa Catarina e São Paulo, exibiram as menores medianas. Esse achado reforça a hipótese de que a educação desempenha um papel crucial na redução da violência.
Figura 9. Proporção de vulneráveis a pobreza
Fonte: Resultados originais da pesquisa
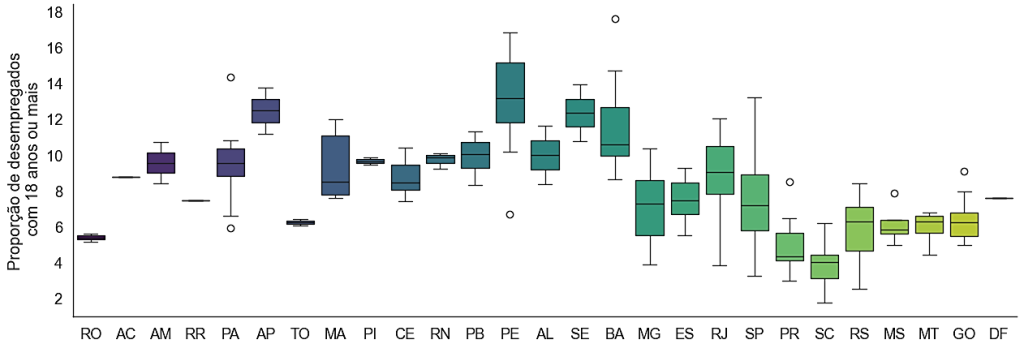
Por fim, a proporção de desempregados com 18 anos ou mais, uma medida direta da instabilidade econômica e da escassez de oportunidades no mercado de trabalho, também revelou uma nítida correlação visual positiva com a taxa de violência letal. Os estados com altos índices de mortalidade violenta, como Bahia e Alagoas, foram justamente os que exibiram as medianas mais elevadas de desemprego. Em contrapartida, os estados com os cenários mais favoráveis de segurança pública, como Santa Catarina e São Paulo, apresentaram as menores taxas de desocupação.
Este alinhamento geográfico entre a precariedade no mercado de trabalho e a incidência da violência letal fortalece a hipótese de que a deterioração das condições econômicas constitui um ambiente que potencializa a ocorrência de crimes violentos. Em síntese, a análise dos preditores socioeconômicos (IDHM, Gini, saneamento, vulnerabilidade à pobreza, analfabetismo e desemprego) revela uma notável convergência de vulnerabilidades. As mesmas Unidades Federativas que sofrem com as maiores taxas de violência letal tendem a apresentar, consistentemente, os piores indicadores sociais e econômicos, fornecendo uma base empírica sólida para a hipótese de que a violência é um fenômeno associado a um complexo de fatores socioeconômicos.
Figura 10. Proporção de analfabetos com 15 anos ou mais em 2010
Fonte: Resultados originais da pesquisa Análises de Multicolinearidade e Análise de Componentes Principais
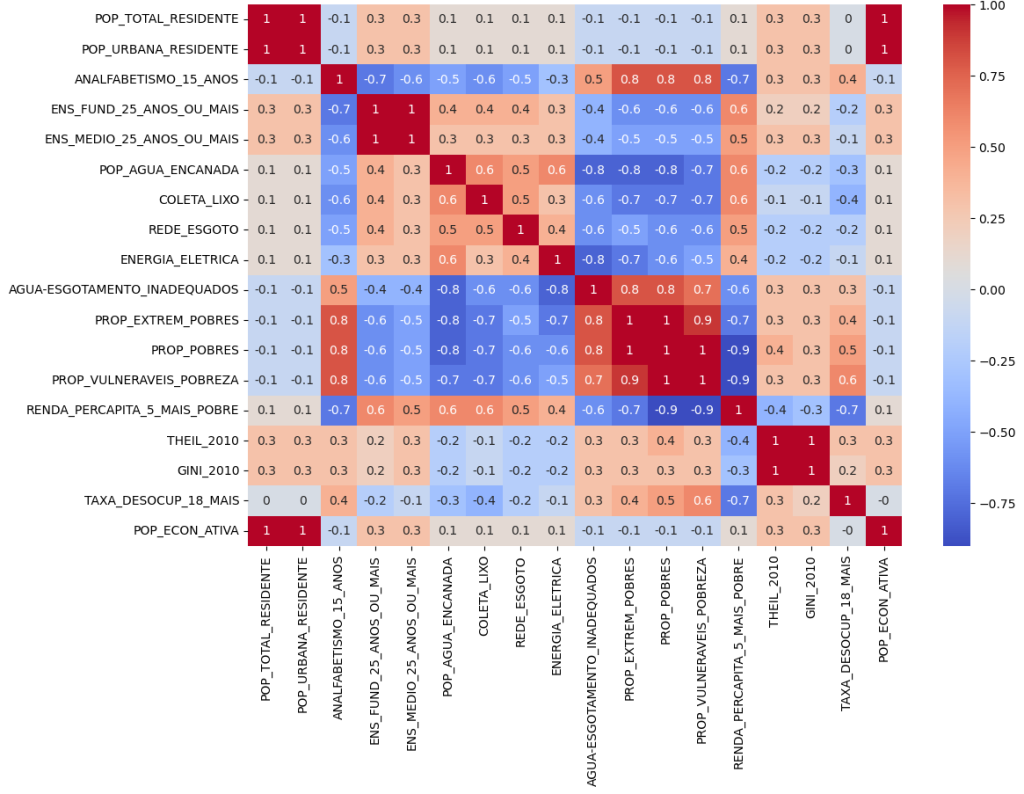
A análise inicial da matriz de correlações de Pearson entre as variáveis preditoras do estudo, ilustrada na Figura 11, indicou a presença de multicolinearidade. Muitos cruzamentos apresentaram coeficientes acima de 0,4, sugerindo que as variáveis socioeconômicas estavam altamente correlacionadas entre si. Esse fenômeno é comum em estudos sociais, onde diferentes indicadores de desenvolvimento e bem-estar tendem a se mover juntos, mas pode enviesar seriamente os modelos de regressão, dificultando a interpretação dos coeficientes.
Figura 11. Proporção desempregados com 18 anos ou mais
Fonte: Resultados originais da pesquisa
Para confirmar a presença e a gravidade da multicolinearidade, foi calculado o Fator de Inflação da Variância (VIF) para cada variável. Os resultados mostraram níveis gravíssimos de VIF, com valores como 8.324,28 para População Residente e 6.376,48 para População Urbana Residente. Outras variáveis, como Percentual de residências com energia elétrica (4.283,77) e Índice de Gini (3.849,12), também apresentaram VIFs muito acima do limite de 5 ou 10, que James et al. (2023) consideram problemático. Essa alta colinearidade inviabilizava o uso das variáveis em seu estado bruto nos modelos.
Diante desse desafio, a Análise de Componentes Principais (PCA) foi empregada para transformar as 18 variáveis originais em um conjunto menor de fatores temáticos ortogonais, ou seja, independentes. Essa técnica de redução de dimensionalidade é crucial para mitigar a multicolinearidade e melhorar a interpretabilidade dos modelos. A PCA condensou as variáveis em cinco indicadores complexos: População, Educação, Infraestrutura, Pobreza e Desigualdade, e Emprego, cada um com uma variância explicada significativa.
O fator População, composto por População Total Residente e População Urbana Residente, explicou 99,99% da variância de suas variáveis originais. O fator Educação, que incluiu Percentual da população com ensino fundamental e médio completo e Analfabetismo, explicou 84,10%. Infraestrutura, com variáveis como Energia Elétrica, Coleta de Lixo, Água Encanada e Esgotamento Inadequado, explicou 66,86%. Pobreza e Desigualdade, abrangendo Gini, Theil, Proporção de Pessoas Pobres, Vulneráveis e Extremamente Pobres, explicou 68,73%. Por fim, o fator Emprego, composto por População Economicamente Ativa e Taxa de Desocupação, explicou 50,21% da variância. Esses fatores sintéticos funcionam como indicadores temáticos, condensando múltiplas variáveis em dimensões interpretáveis, conforme Januzzi (2002).
A interpretação dos fatores foi realizada com base nas cargas fatoriais das variáveis originais, onde a magnitude indica a força da contribuição e o sinal, a direção da associação. Por exemplo, o fator População (peso 0,707 para ambas as variáveis) representa o tamanho total da população e, em menor grau, a população urbana. O fator Educação (pesos positivos para escolaridade e negativo para analfabetismo) indica o nível de escolaridade da população. Infraestrutura (pesos positivos para acesso a serviços e negativo para inadequação) mede a qualidade da infraestrutura básica. Pobreza e Desigualdade (pesos positivos para pobreza e desigualdade e negativo para renda per capita dos mais pobres) reflete a precariedade econômica e a concentração de renda. O fator Emprego (peso positivo para população economicamente ativa e negativo para taxa de desocupação) reflete uma situação favorável no mercado de trabalho.
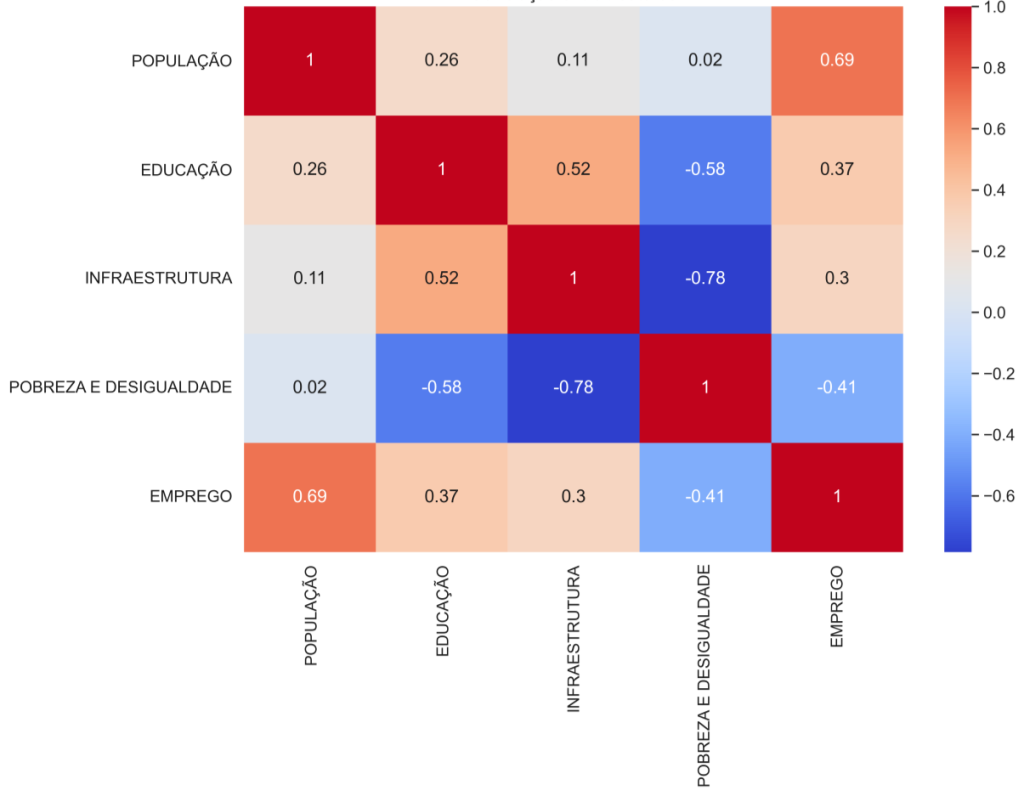
Apesar da transformação por PCA, que gerou ortogonalidade parcial dentro de cada fator temático, a correlação entre os novos fatores ainda persistiu, como mostra a Figura 12. No entanto, o diagnóstico de VIF para esses novos fatores revelou que todos possuíam valores menores que 5, garantindo o pressuposto de independência dos preditores necessário para a modelagem por regressão. Os VIFs variaram de 4,575 para Pobreza e Desigualdade a 1,707 para Educação, indicando que a multicolinearidade foi significativamente reduzida, permitindo a continuidade da pesquisa com maior confiabilidade nos resultados dos modelos.
Figura 12. Matriz de correlações entre as variáveis preditoras
Fonte: Resultados originais da pesquisa Resultados da modelagem paramétrica
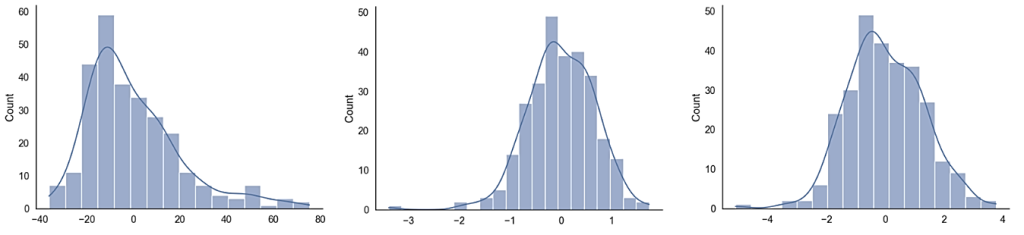
Os modelos paramétricos iniciais, Regressão Linear Múltipla (RLM), RLM com Transformação Logarítmica (Log-RLM) e RLM com transformações de Box-Cox (RLM-BC), apresentaram sérias limitações. A testagem revelou violação do pressuposto de normalidade dos resíduos para os modelos RLM e Log-RLM (p-valor < 0.05 nos testes de Shapiro-Wilk), e baixo poder explicativo (R² entre 0.21 e 0.23). A análise dos resíduos, ilustrada na Figura 13, mostra que esses modelos tendiam a errar de forma mais intensa os valores mais altos, com pouca melhoria nas previsões mesmo após as transformações.
Figura 13. Correlação entre os novos fatores criados
Fonte: Resultados originais da pesquisa
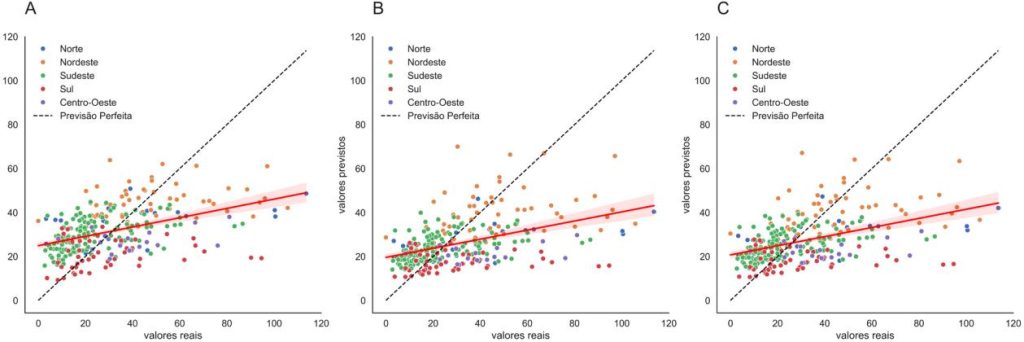
A comparação entre os valores reais e previstos pelos modelos RLM, Log-RLM e RLM-BC, apresentada na Figura 14, reforça a dificuldade desses modelos em capturar a variância da violência letal, especialmente nos valores mais extremos. A linha de previsão perfeita a 45° mostra que as previsões se desviam consideravelmente dos valores reais, indicando um ajuste insatisfatório. Essa limitação dos modelos paramétricos lineares ressalta a complexidade do fenômeno da violência, que pode envolver relações não-lineares e interações que não são adequadamente capturadas por essas abordagens mais simples.
Figura 14. Resíduos RLM (A), Log-RLM (B) e RLM-BC (C)
Fonte: Resultados originais da pesquisa
A análise das figuras 14 e 15 mostra que os modelos também tendiam a errar de forma mais intensa os valores mais altos, com pouca melhoria nas previsões após transformações.
Figura 15. Comparação dos Modelos RLM (A), Log-RLM (B) e RLM-BC (C)
Fonte: Resultados originais da pesquisa
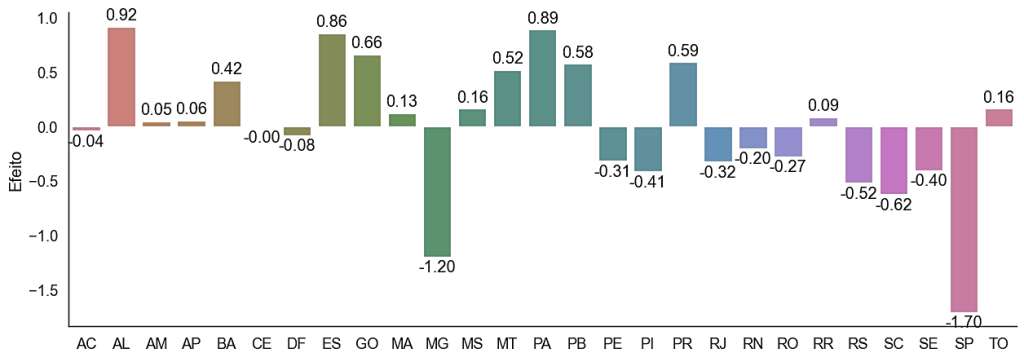
Com essa informação, pode-se observar, na Figura 16, os diferentes valores de intercepto dos Estados, o que, como esperado, mostra os diferentes valores médios de violência letal quando todos os coeficientes são zerados.
Figura 16. Efeitos aleatórios de intercepto no modelo RLMM-BC
Fonte: Resultados originais da pesquisa Resultados da modelagem não-paramétrica
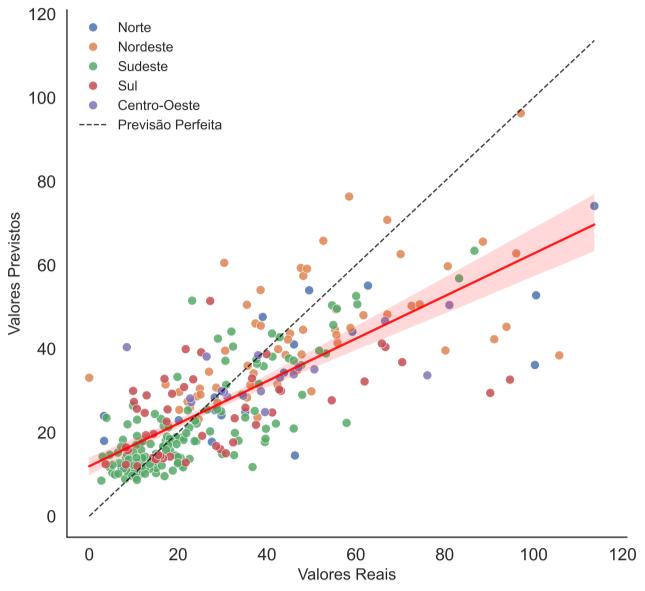
A Figura 17 ilustra os diferentes valores de intercepto dos Estados, que, como esperado, mostram as variações médias de violência letal quando todos os coeficientes são zerados. Em termos preditivos, o modelo RLMM-BC representou um avanço significativo em relação aos modelos anteriores, alcançando um Pseudo-R² de 0.617.
Figura 17. Comparação dos valores reais e previstos pelo Modelo RLMM-BC
Fonte: Resultados originais da pesquisa
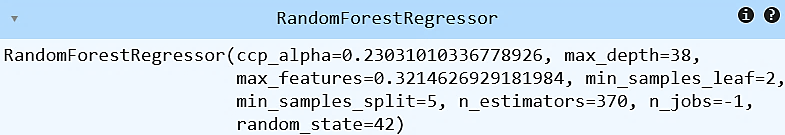
Durante o treinamento do modelo não-paramétrico Random Forest Regressor (RFR), observou-se que o desempenho melhorava com maiores quantidades de amostra de treino. Após exaustiva experimentação de valores aleatórios dos parâmetros, utilizando um intervalo de 88% a 95% da base de dados para treino, o melhor modelo foi obtido com 94% da base de dados. Os hiperparâmetros encontrados, como `max_depth=38`, `n_estimators=370` e `min_samples_leaf=2`, otimizaram o desempenho do modelo, conforme detalhado na Figura 18.
Figura 18. Hiperparâmetros do melhor modelo encontrado
Fonte: Resultados originais da pesquisa
A validade dos resultados do RFR foi aprofundada pela comparação dos valores previstos para 2010 com os valores reais de anos posteriores, de 2011 a 2021. Um achado importante, já apontado por Ribeiro e Cano (2016), é a relação entre o ano de referência das variáveis socioeconômicas e seus efeitos a longo prazo. Observou-se uma queda no R² do modelo ao longo dos anos, com seu pico em 2011 e degradação a partir de 2019. Essa diminuição do desempenho, pode ser atribuída tanto a mudanças na distribuição da violência quanto na importância das variáveis estudadas ao longo do tempo.
Os coeficientes observados, no entanto, sugerem que os indicadores de 2010 mantiveram boa parte de sua validade até a queda em 2019 e a perda de validade em 2020, ano da pandemia de COVID-19. Essa resiliência parcial dos fatores de 2010 indica que, apesar das dinâmicas sociais e econômicas terem se alterado, alguns fundamentos explicativos da violência letal permaneceram relevantes por um período considerável, reforçando a importância de dados atualizados para a formulação de políticas públicas.
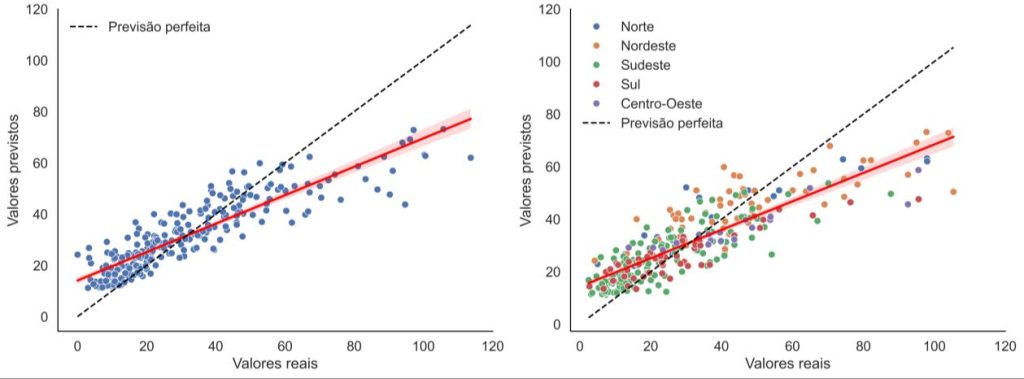
Como resultado, o modelo RFR alcançou um coeficiente de determinação (R²) de 0.706 para o ano de 2010 e 0.683 para 2011. Isso significa que o modelo, construído a partir dos componentes parciais das variáveis selecionadas, foi capaz de explicar aproximadamente 70,6% da variação das taxas de violência nos municípios brasileiros em 2010 e 68,3% em 2011. A performance do modelo, ilustrada na Figura 19, mostra um ajuste significativamente melhor aos dados em comparação com os modelos paramétricos, com as previsões se alinhando mais próximas à linha de previsão perfeita.
Figura 19. Performance do modelo RFR em 2010 e 2011
Fonte: Resultados originais da pesquisa Compreendendo os fatores socioeconômicos da violência letal urbana
A comparação das métricas dos modelos testados revelou pouca diferença entre os três primeiros modelos paramétricos (RLM, Log-RLM, RLM-BC), que apresentaram R² entre 0.212 e 0.229. Em contraste, o modelo Random Forest Regressor (RFR) foi o mais performático, com R² de 0.706 para 2010 e 0.683 para 2011, seguido pelo modelo de Regressão Multinível com Transformações de Box-Cox (RLMM-BC), que alcançou um R² de 0.617. Em termos de erro, o RFR também se destacou, com o menor RMSE de 12,27, enquanto o RLMM-BC registrou 14,39, e os modelos lineares simples variaram entre 20,02 e 20,81.
Ao analisar os coeficientes normalizados dos modelos paramétricos, o RLMM-BC indicou que População (0,732) e Emprego (-0,645) foram os fatores mais impactantes, seguidos por Educação (-0,148) e Infraestrutura (0,185). A População e o desemprego (implícito no fator Emprego com coeficiente negativo) mostraram-se positivamente relacionados ao aumento da violência, enquanto a educação exerceu um efeito redutor. O fator Infraestrutura, curiosamente, apresentou uma relação marginalmente positiva com a violência letal, o que pode refletir sua concentração em grandes centros urbanos que também possuem maior população e, por vezes, maior incidência de violência.
Em contraste, no modelo RFR, a importância relativa dos fatores foi mais equilibrada e sem direção específica, indicando que a violência é explicada por um conjunto combinado de preditores. Pobreza e Desigualdade (22,92%) e Infraestrutura (21,98%) foram os fatores de maior contribuição para a melhoria do poder preditivo e a diminuição do erro médio do modelo. Educação (19,56%), Emprego (19,52%) e População (16,02%) também apresentaram importâncias significativas, mas com menor disparidade entre si.
O contraste entre os modelos paramétricos e o RFR pode ser explicado pela natureza das relações. Os modelos lineares e o RLMM-BC não conseguiram encontrar um efeito monotônico claro para a relação entre pobreza, desigualdade e violência, sugerindo que essa relação é extremamente complexa e não linear. O RFR, sendo um modelo não-paramétrico, é capaz de capturar essas interações não lineares e complexas, oferecendo uma compreensão mais abrangente dos fatores que influenciam a violência letal. Essa capacidade de capturar interações complexas e duradouras sublinha a necessidade de políticas públicas integradas que abordem emprego, urbanização e desigualdade de forma multifacetada.
Os resultados deste estudo validam a hipótese central de que a violência letal urbana pode ser modelada como uma função de indicadores socioeconômicos, com os modelos RLMM-BC e RFR demonstrando capacidade explicativa superior a 60% da variação da violência em 2010 e até 2016. Essa capacidade preditiva reforça a relevância desses indicadores para o estudo acadêmico e para a formulação de políticas públicas baseadas em evidências. A densidade populacional e o desemprego estão diretamente associados ao aumento da violência letal, enquanto a educação exerce um efeito redutor, e a infraestrutura, embora marginalmente, também se relaciona ao aumento, possivelmente devido à concentração em grandes centros urbanos.
4. Conclusão
Este estudo analisou a contribuição de indicadores socioeconômicos na explicação das taxas de mortes violentas intencionais em 282 municípios brasileiros, empregando uma abordagem que combinou Análise de Componentes Principais, regressão multinível e aprendizado de máquina. Verificou-se que a violência letal urbana pode ser modelada como uma função de fatores socioeconômicos, com os modelos de Regressão Multinível (RLMM-BC) e Random Forest Regressor (RFR) demonstrando capacidade explicativa superior a 60% da variação da violência em 2010 e até 2016. O modelo RLMM-BC indicou que a densidade populacional e o desemprego associaram-se positivamente ao aumento da violência letal, enquanto a educação exerceu um efeito redutor. A infraestrutura, embora marginalmente, também se relacionou ao aumento, possivelmente devido à sua concentração em grandes centros urbanos. Por sua vez, o RFR, ao capturar interações não lineares complexas, revelou uma importância mais equilibrada entre os fatores, destacando Pobreza e Desigualdade e Infraestrutura como os de maior contribuição para o poder preditivo.
A principal contribuição deste trabalho reside na validação empírica da relevância dos indicadores socioeconômicos para a compreensão da violência letal, fornecendo subsídios para a formulação de políticas públicas integradas que abordem emprego, urbanização e desigualdade de forma multifacetada. Contudo, as conclusões se restringem aos municípios com população superior a 100 mil habitantes, não sendo generalizáveis para localidades de menor porte. Observou-se, ainda, que a performance preditiva dos modelos, treinados com dados de 2010, apresentou degradação em anos mais recentes, especialmente a partir de 2019, o que sugere alterações nas dinâmicas da violência e nas condições socioeconômicas ao longo do tempo. Recomenda-se que a futura disponibilização dos dados do Censo de 2022 seja aproveitada para a realização de novas pesquisas, reavaliando os pesos dos fatores socioeconômicos para a década de 2020 e aprimorando a compreensão do fenômeno.
Referências Bibliográficas
Alves, L. G. A.; Ribeiro, H. V.; Rodrigues, F. A. 2018. Crime prediction through urban metrics and statistical learning. Physica A: Statistical Mechanics and its Applications 505: 435-443.
Cano, I.; Santos, N. 2001. Violência letal, renda e desigualdade no Brasil. 1ed. 7Letras, Rio de Janeiro, RJ, Brasil.
Cerqueira, D.; Bueno, S. (coord.). Atlas da violência 2024. Brasília: Ipea; FBSP. Disponível em: https://repositorio.ipea.gov.br/handle/11058/14031. Acesso em: 22 mar. 2025.
Coelho, D. S. C. 2024. Inteligência artificial em justiça e segurança pública: exemplos e recomendações para políticas públicas. Diest: Nota Técnica, 65. Disponível em: https://www.ipea.gov.br/atlasviolencia/arquivos/artigos/8191-pub-expressant-da-diest
65inteligencia-artificial-em-justica.pdf. Acesso em: 22 mar. 2025.
Fórum Brasileiro de Segurança Pública. 2024. 18º Anuário Brasileiro de Segurança Pública. São Paulo, SP, Brasil. Disponível em: https://publicacoes.forumseguranca.org.br/handle/123456789/253. Acesso em: 24 mar. 2025
Géron, A. 2023. Hands-On Machine Learning with Scikit-Learn, Keras, and Tensorflow: Concepts, Tools, and Techniques to Build Intelligent Systems. 3ed. O’Reilly. Sebastopol, CA, USA.
James, G.; Witten, D.; Hastie, T.; Tibishirani, R.; Taylor, J. 2023. An Introduction to Statistical Learning: with Applications in Python. 1ed. Springer, New York, NY, USA. Disponível em: https://www.statlearning.com/. Acesso em: 22 mar. 2025.
Januzzi, P. 2001. Indicadores Sociais no Brasil: conceitos, fontes de dados e aplicações para formulação e avaliação de políticas públicas e elaboração de estudos socioeconômicos. 3ed. Alínea, Campinas, SP, Brasil.
Kellstedt, P. M.; Whitten, G. D. 2018. The fundamentals of political science research. Cambridge University Press.
Lombroso, C., L ‘uomo delinquente. 1876. s/e, Roma, Itália.
Ludwig, J.; Mullainathan, S. 2021. In Fragile Algorithms and Fallible Decision-Makers: Lessons from the Justice System. Journal of Law & Economics 64(S1): 175-200.
Mandalapu, V.; Lavanya, E.; Vyas, P.; Roy, N. 2023. Crime Prediction Using Machine Learning and Deep Learning: A Systematic Review and Future Directions. IEEE Access 11: 10151873.
O’Neil, C. 2016. Weapons of Math Destruction: How Big Data Increases Inequality and Threatens Democracy. 1ed. Crown, New York, NY, USA.
Rodrigues, R. N. 2011 [1894]. As raças humanas e a responsabilidade penal no Brasil. CEPS, Rio de Janeiro, RJ, Brasil.
Silva, T. 2022. Racismo Algorítmico: inteligência artificial e discriminação nas redes digitais. SESC, São Paulo, SP, Brasil.
Shaw, C. R.; McKay, H. D. 1969. Juvenile Delinquency and Urban Areas: a study of rates of delinquency in relation to differential characteristics of local communities in american cities. 2ed. University of Chicago Press, Chicago, IL, USA.
GITHUB disponível em: https://github.com/lucastelso/fatores-violencia-letal
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

