
24 de agosto de 2026
Modelo Preditivo de Risco Reputacional Baseado em Textos Jornalísticos
Camila de Cassia Defensor Mascarenhas da Rosa; Gabriel Gomes de Oliveira
DOI: 10.22167/2675-6528-202601829
Artigo elaborado pela ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege voltada à síntese e redação.
Resumo
A reputação corporativa é um ativo intangível crítico, cuja volatilidade na era digital torna as organizações suscetíveis a crises por exposições midiáticas negativas. O estudo desenvolveu um modelo preditivo de risco reputacional para identificar se variáveis da cobertura de mídia, como volume, sentimento e léxico, atuam como precursores de danos severos. A metodologia fundamentou-se na coleta de dados via Web Scraping de notícias sobre eventos de risco ocorridos entre 2023 e 2025. O processamento utilizou Processamento de Linguagem Natural (NLP) para análise de sentimento e feature engineering. A modelagem consistiu em uma tarefa de classificação binária supervisionada, com o target de dano grave determinado por proxies quantificáveis, como impactos financeiros e penalidades regulatórias. Foram comparados os algoritmos Regressão Logística, Random Forest e XGBoost, além da implementação de um modelo Ensemble, em ambiente Python, validados pelas métricas AUC-ROC e F1-Score. Os resultados apontaram a superioridade da abordagem conjunta (Ensemble), que alcançou F1-Score de 0.878 e Recall de 85.4%, e a viabilidade de estimar a probabilidade de crises e estabelecer limiares de risco acionáveis. Comprovou-se a eficácia da integração entre NLP e Machine Learning para a mitigação proativa de riscos corporativos, oferecendo uma ferramenta de suporte à decisão para equipes de comunicação corporativa e gestão de riscos.
Palavras-chave: Análise de Sentimentos; Aprendizado de Máquina; Danos à reputação; Modelagem de Dados Históricos; Processamento de Linguagem Natural (PLN).
1. Introdução
A reputação corporativa é reconhecida como um ativo intangível de valor crítico para a sustentabilidade organizacional no século XXI. Ela representa o conjunto de percepções coletivas sobre os atributos centrais, distintivos e duradouros de uma empresa na mente de seus stakeholders (Fombrun, 1996; Barnett et al., 2006). Diferentemente de ativos tangíveis, a reputação é uma construção social complexa, emergente de interações prolongadas entre a organização e seus públicos, não podendo ser adquirida ou transferida instantaneamente (Hall, 1992; Deephouse e Carter, 2005).
A era digital, marcada pela globalização acelerada e pela onipresença das tecnologias de informação e comunicação a partir dos anos 1990, transformou profundamente a dinâmica de formação e destruição reputacional (Aula, 2010; Chun e Davies, 2020). O surgimento das redes sociais digitais, do jornalismo online em tempo real e do conteúdo gerado por usuários criou um ecossistema midiático fragmentado e de alta velocidade. Nesse ambiente, erros corporativos, más condutas ou percepções equivocadas podem ser amplificados e viralizados globalmente em poucas horas (Coombs e Holladay, 2015; Aula e Mantere, 2013). Estudos empíricos indicam que a velocidade de propagação de informações negativas é significativamente superior à de informações positivas, um fenômeno conhecido como “negativity bias” (Rozin e Royzman, 2001; Baumeister et al., 2001).
Nesse panorama, a cobertura jornalística desempenha um papel duplo: atua como mecanismo de “accountability”, fiscalizando condutas corporativas e protegendo interesses públicos, mas também como potencial amplificador de crises reputacionais, cuja severidade nem sempre se correlaciona diretamente com a gravidade dos eventos (Deephouse, 2000; Pollock e Rindova, 2003). Eventos negativos noticiados pela imprensa podem desencadear efeitos cascata (spillover effects), alterando a percepção de clientes, a confiança de investidores e a postura de reguladores (van Riel e Fombrun, 2007; Deephouse, 2000). Contudo, a gestão preditiva de risco reputacional, apesar de sua importância estratégica crescente, permanece um desafio complexo devido à natureza multidimensional, subjetiva e contextualmente influenciada da reputação (Lange et al., 2011; Rindova et al., 2005).
Abordagens tradicionais de monitoramento reputacional, baseadas em pesquisas periódicas, análises de clipping de mídia ou indicadores retrospectivos, apresentam limitações em termos de granularidade temporal, capacidade antecipatória e escalabilidade analítica (Walker, 2010; Sarstedt et al., 2013). Nos últimos anos, o avanço das técnicas de Processamento de Linguagem Natural (NLP) e algoritmos de Machine Learning (ML) supervisionado abriu novas fronteiras metodológicas. Essas técnicas permitem a análise automatizada de grandes volumes de textos não-estruturados, como notícias jornalísticas e postagens em redes sociais, para identificar padrões linguísticos e semânticos associados a diferentes níveis de risco reputacional (Loughran e McDonald, 2011; Tetlock, 2007; Garcia, 2013).
No domínio da análise de sentimento aplicada a textos corporativos e financeiros, pesquisas recentes com modelos de deep learning baseados em arquiteturas Transformer, como BERT (Bidirectional Encoder Representations from Transformers), e suas variantes adaptadas para línguas específicas, demonstram capacidade superior de capturar nuances semânticas, ironia e contextos complexos em comparação com abordagens lexicográficas tradicionais (Devlin et al., 2019; Liu et al., 2019). No contexto brasileiro, o desenvolvimento do BERTimbau, um modelo BERT pré-treinado em português, possibilitou avanços significativos na classificação de sentimento e análise de polaridade em domínios jornalísticos (Souza et al., 2020). Paralelamente, estudos têm evidenciado que características textuais de notícias, incluindo volume de cobertura, intensidade de sentimento negativo e presença de termos específicos relacionados a escândalos, possuem poder preditivo estatisticamente significativo sobre métricas de risco financeiro (Loughran e McDonald, 2016; Buehlmaier e Whited, 2018; Ke et al., 2019).
Apesar desses avanços, observa-se uma lacuna substancial na literatura nacional e internacional. A maioria dos estudos concentra-se em mercados financeiros desenvolvidos, predominantemente nos Estados Unidos, utilizando dados em língua inglesa e focando em impactos de curto prazo mensurados por indicadores quantitativos, negligenciando dimensões multi-stakeholder de dano reputacional e contextos de mercados emergentes com características institucionais e midiáticas distintas (Kaplan et al., 2012; Renneboog e Szilagyi, 2011). Adicionalmente, poucos trabalhos integram sistematicamente múltiplas dimensões de análise textual, como volume, sentimento e léxico específico, em frameworks preditivos unificados que possam ser operacionalizados por gestores corporativos como sistemas de alerta antecipado para crises reputacionais iminentes (Schweidel e Moe, 2014). A necessidade de ferramentas que permitam a proatividade na gestão de riscos corporativos, aprimorando a capacidade de resposta e a alocação eficiente de recursos, é premente no cenário atual.
Diante deste panorama, o presente trabalho justifica-se pela necessidade de aprimorar a capacidade das organizações de prever e mitigar proativamente crises reputacionais no contexto brasileiro, onde as particularidades da mídia e do ambiente de negócios demandam abordagens adaptadas. O objetivo deste estudo é desenvolver e validar um modelo preditivo de risco reputacional baseado em características de cobertura midiática jornalística, aplicado ao contexto brasileiro, utilizando técnicas avançadas de processamento de linguagem natural e aprendizado de máquina supervisionado.
2. Material e Métodos
A pesquisa caracterizou-se como um estudo aplicado de natureza quantitativa, focado no desenvolvimento de um modelo preditivo de risco reputacional. A abordagem metodológica centralizou-se na aplicação de Machine Learning supervisionado e processamento de linguagem natural para analisar textos jornalísticos. O objetivo principal foi prever a probabilidade de eventos noticiados causarem dano reputacional grave, aprimorando a gestão e o tempo de resposta corporativo. O estudo foi estruturado em quatro etapas consecutivas e interdependentes, desde a coleta de dados até a avaliação final do modelo.
O contexto da pesquisa envolveu a análise de cobertura midiática jornalística brasileira, com coleta de dados em fontes abertas da mídia e bases de dados de empresas para proxies de impacto. O período de cobertura compreendeu notícias publicadas entre janeiro de 2023 e dezembro de 2025, totalizando três anos. A unidade de análise consistiu em notícias jornalísticas sobre eventos corporativos de risco, coletadas sistematicamente. A modelagem e as análises foram executadas em ambiente de software Python, utilizando suas bibliotecas e recursos open-source.
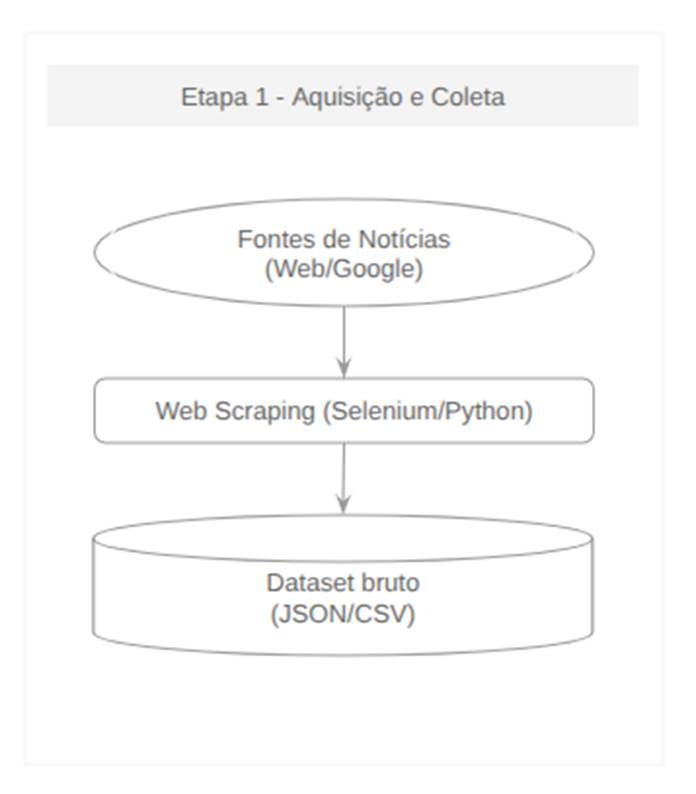
A primeira etapa metodológica focou na extração de dados, utilizando web scraping automatizado para coletar notícias. Empregou-se a biblioteca Selenium em conjunto com Python para extrair conteúdo textual de portais de notícias brasileiros de grande circulação, como G1, Folha de S.Paulo, Estado de S.Paulo e UOL. A seleção foi guiada por palavras-chave relacionadas a eventos corporativos de risco, como fraude empresarial e vazamento de dados. Cada notícia foi armazenada em formato estruturado JSON/CSV, contendo título, corpo do texto, data de publicação, fonte e URL original.
O fluxograma a seguir ilustra a sequência de procedimentos adotados na primeira etapa de extração de dados, desde as fontes de notícias até a geração do dataset bruto.
Figura 1. Fluxograma da etapa 1 da execução do projeto de pesquisa
Fonte: Dados originais da pesquisa
Esta representação visual detalha o processo de coleta sistemática de informações, evidenciando a transição das fontes de notícias para o formato de dados brutos, essencial para as fases subsequentes de processamento e análise.
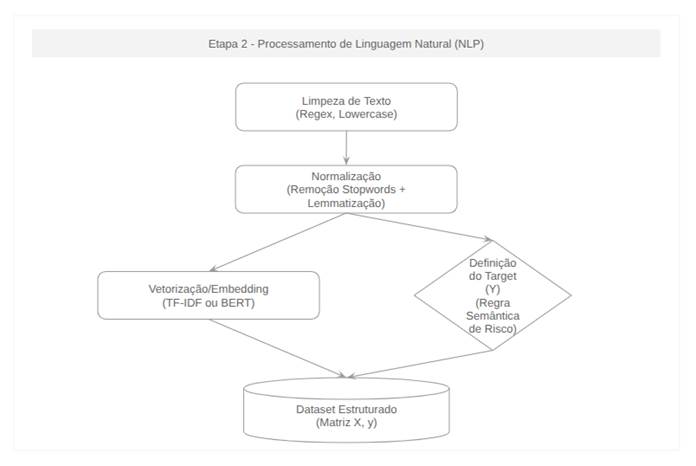
A segunda etapa consistiu no processamento de linguagem natural (NLP), iniciando com a limpeza textual. Aplicaram-se expressões regulares para remover tags HTML, caracteres especiais, números isolados, URLs e espaços redundantes, convertendo todo o texto para minúsculas. A normalização textual envolveu a remoção de 321 stopwords customizadas para o domínio jornalístico brasileiro e a lematização com o algoritmo spaCy (modelo pt_core_news_lg), reduzindo variações morfológicas. Posteriormente, o pipeline se bifurcou para vetorização e definição do target.
A Figura 2 apresenta o pipeline completo de processamento de linguagem natural, desde a limpeza e normalização do texto até a vetorização e a definição da variável target.
Figura 2. Fluxograma da etapa 2 da execução do projeto de pesquisa
Fonte: Dados originais da pesquisa
Este diagrama visualiza as transformações aplicadas aos dados textuais, destacando as operações sequenciais que preparam o conteúdo para a fase de modelagem preditiva, garantindo a uniformidade e a relevância das informações.
A vetorização do conteúdo textual foi realizada utilizando a técnica TF-IDF (Term Frequency-Inverse Document Frequency), gerando uma matriz esparsa com vocabulário limitado a 1.500 termos discriminativos, incluindo unigramas, bigramas e trigramas. Paralelamente, a definição da variável dependente (target) foi conduzida por rotulagem manual de 2.500 notícias por dois anotadores independentes, classificando a severidade do risco com base na natureza da transgressão, magnitude do impacto e extensão da cobertura midiática. Uma estratégia semi-supervisionada foi aplicada para pseudo-rotular as notícias restantes, resultando em um dataset final com rótulos binários (0/1).
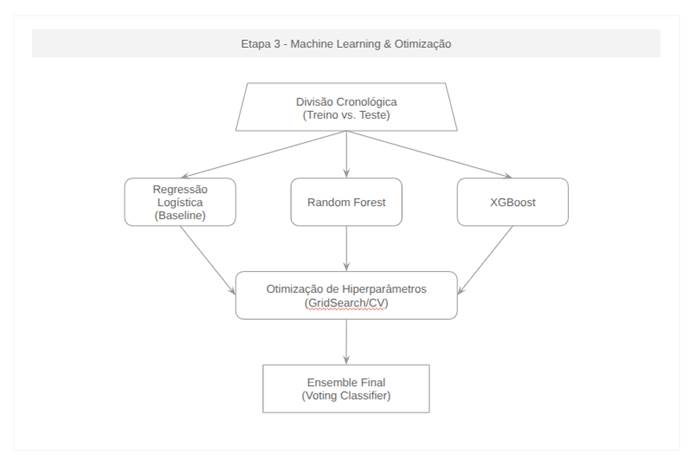
A terceira etapa envolveu o desenvolvimento, treinamento e otimização de modelos preditivos de classificação binária supervisionada. Adotou-se uma estratégia de validação temporal, dividindo o dataset em conjunto de treino (notícias de 2023-2024, 13.756 amostras) e conjunto de teste (notícias de 2025, 7.899 amostras), para simular uma aplicação prospectiva. Foram comparados quatro algoritmos: Regressão Logística, Random Forest, XGBoost e um modelo Ensemble via Voting Classifier. A otimização de hiperparâmetros para cada modelo foi realizada por busca em grade (GridSearchCV) com validação cruzada estratificada de cinco folds, utilizando F1-Score como métrica.
O fluxograma da Figura 3 detalha a arquitetura da etapa de Machine Learning e otimização, desde a divisão cronológica dos dados até a formação do modelo Ensemble final.
Figura 3. Fluxograma da etapa 3 da execução do projeto de pesquisa
Fonte: Dados originais da pesquisa
Esta ilustração demonstra visualmente o fluxo de trabalho para o treinamento e a combinação dos algoritmos de classificação, incluindo a otimização de seus parâmetros, um passo crucial para a robustez do modelo preditivo.
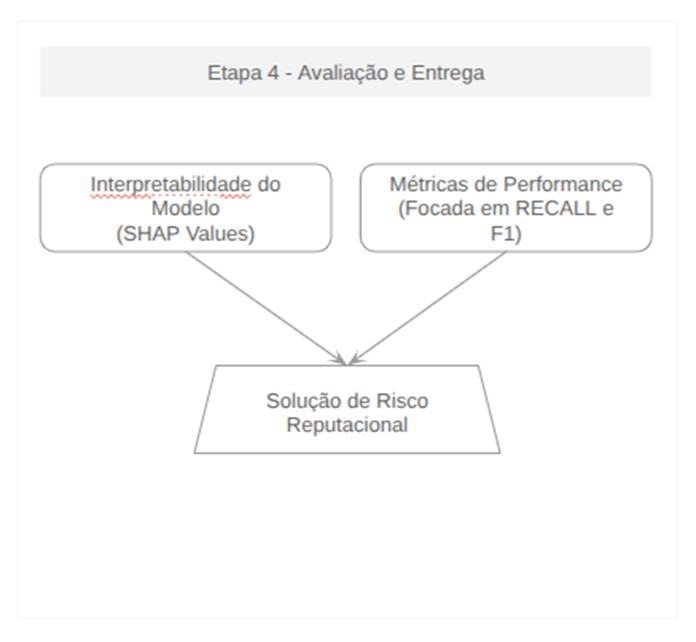
A etapa final consistiu na avaliação rigorosa dos modelos e na extração de insights. Para a interpretabilidade do modelo, aplicou-se a metodologia SHAP (SHapley Additive exPlanations), que quantifica a contribuição individual de cada feature para as predições. As métricas de performance focaram em Recall e F1-Score, priorizando a detecção de riscos. O produto final foi um sistema de scoring de risco que atribui uma probabilidade percentual de dano reputacional grave a cada nova notícia. Um threshold de decisão de 0,40 foi estabelecido para acionar alertas de risco, balanceando sensibilidade e especificidade.
A Figura 4 sintetiza a etapa final de avaliação e entrega, mostrando a integração da interpretabilidade do modelo com as métricas de performance para gerar a solução de risco reputacional.
Figura 4. Fluxograma da etapa 4 da execução do projeto de pesquisa
Fonte: Dados originais da pesquisa
Este diagrama finaliza a representação do processo metodológico, conectando a análise das contribuições das features e a avaliação do desempenho do modelo à entrega de uma solução prática para a gestão proativa do risco reputacional.
3. Resultados e Discussão
A análise dos resultados da pesquisa revelou insights cruciais sobre a capacidade de prever o risco reputacional com base em características da cobertura midiática jornalística. O estudo demonstrou a viabilidade de integrar técnicas de Processamento de Linguagem Natural (NLP) e algoritmos de Machine Learning (ML) para identificar padrões preditivos em textos jornalísticos brasileiros. Os achados são apresentados em blocos temáticos, abrangendo a caracterização do dataset, a análise de sentimento, a performance dos modelos preditivos, a identificação de palavras-chave preditoras de risco, a definição do limiar de risco e a validação temporal do modelo, culminando na proposta de uma solução de risco reputacional.
Caracterização do dataset
O dataset consolidado para a pesquisa compreendeu um total de 21.655 notícias jornalísticas, coletadas entre janeiro de 2023 e dezembro de 2025. Essas notícias foram extraídas de 2.628 fontes e veículos de mídia distintos no Brasil, fornecendo uma base robusta e diversificada para a análise. A distribuição da variável-alvo, que classifica os eventos como de risco grave (Y=1) ou normal (Y=0), indicou um desbalanceamento moderado, com 75,5% dos registros categorizados como risco e 24,5% como normais. Essa característica foi gerenciada por meio do ajuste de pesos de classe durante o treinamento dos modelos, garantindo que o desbalanceamento não viesse a comprometer a performance preditiva.
Tabela 1. Estatísticas descritivas do dataset
| Característica | Valor |
| Total de notícias | 21.655 |
| Período de cobertura | 2023-2025 |
| Notícias classificadas como Risco (1) | 16.358 (75,5%) |
| Notícias classificadas como Normal (0) | 5.297 (24,5%) |
| Número de fontes/veículos | 2.628 |
Fonte: Resultados originais da pesquisa
A Tabela 1 detalha as estatísticas descritivas do dataset, evidenciando o volume total de notícias, o período de cobertura e a distribuição das classificações de risco. A análise exploratória subsequente revelou que eventos de risco grave foram associados a um volume de cobertura midiática significativamente maior, sendo 0,9 vezes superior ao de eventos normais, com uma diferença estatisticamente significativa (p < 0,001) conforme o teste Mann-Whitney U. Este achado corrobora a teoria de Deephouse (2000), que postula a intensidade da cobertura jornalística como um recurso estratégico com impacto mensurável na reputação corporativa.
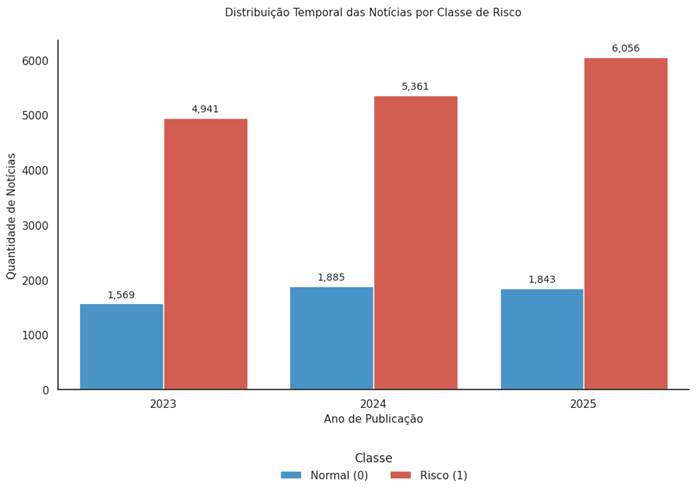
A distribuição temporal das notícias, conforme ilustrado na Figura 5, revelou um crescimento progressivo no volume de publicações ao longo do período analisado. Em 2023, foram registradas 6.510 notícias; em 2024, o volume aumentou para 7.246; e em 2025, atingiu 7.899 notícias no corpus total. Esse padrão de crescimento reflete uma tendência de intensificação do escrutínio midiático sobre condutas corporativas, um fenômeno já identificado por Aula e Mantere (2013), que destaca a crescente atenção da mídia a eventos corporativos e suas implicações reputacionais.
Figura 5. Distribuição temporal de notícias por ano (2023-2025)
Fonte: Resultados originais da pesquisa
Análise de sentimento
A análise de sentimento, realizada com o modelo BERTimbau, demonstrou uma diferença estatisticamente significativa (p < 0,001) entre os grupos de notícias. Eventos classificados como de risco apresentaram um sentimento médio de -0,93 (desvio-padrão = 0,17), indicando uma polaridade fortemente negativa. Em contraste, notícias de eventos normais obtiveram um sentimento médio de 0,50 (desvio-padrão = 0,31), sugerindo uma polaridade mais neutra a positiva. Essa diferença de magnitude, superior a 1,4 desvios-padrão combinados, fornece evidência empírica robusta de que a polaridade negativa do discurso jornalístico está consistentemente associada a uma maior probabilidade de dano reputacional.
A superioridade do BERTimbau na captura de nuances semânticas, negações, ironia e contextos complexos em textos jornalísticos em português brasileiro é consistente com achados de Devlin et al. (2019) e Souza et al. (2020), que destacam a capacidade dos modelos baseados em arquitetura Transformer. O desvio-padrão consideravelmente inferior nas notícias de risco (0,17) em comparação com as notícias normais (0,31) sugere que a cobertura de eventos de risco grave tende a ser mais homogeneamente negativa. Este resultado está alinhado com o conceito de “negativity bias” (Rozin e Royzman, 2001; Baumeister et al., 2001), que descreve a tendência de informações negativas terem um impacto maior e mais uniforme.
Performance dos modelos preditivos
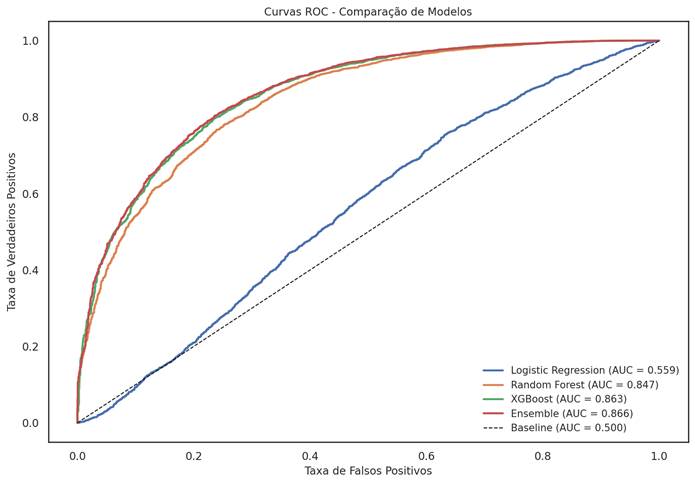
A comparação entre os quatro algoritmos de classificação implementados – Regressão Logística, Random Forest, XGBoost e Ensemble – revelou que o modelo Ensemble obteve a melhor performance global. Este modelo alcançou um F1-Score de 0,878, uma Accuracy de 0,818 e um AUC-ROC de 0,866, superando consistentemente os modelos individuais em todas as métricas avaliadas. O XGBoost apresentou um desempenho muito próximo ao do Ensemble, com F1-Score de 0,876 e AUC-ROC de 0,863, enquanto o Random Forest obteve F1-Score de 0,864 e AUC-ROC de 0,847. A Regressão Logística, por sua vez, demonstrou desempenho substancialmente inferior, com F1-Score de 0,190 e AUC-ROC de 0,559.
Tabela 2. Comparação de Performance entre Modelos
| Modelo | Accuracy | Precision | Recall | F1-Score | AUC-ROC |
| Ensemble | 0.8184 | 0.9036 | 0.8544 | 0.878 | 0.866 |
| XGBoost | 0.8157 | 0.9004 | 0.8540 | 0.876 | 0.863 |
| Random Forest | 0.7990 | 0.8971 | 0.8334 | 0.864 | 0.847 |
| Logistic Regression | 0.2905 | 0.7628 | 0.1083 | 0.189 | 0.559 |
Fonte: Resultados originais da pesquisa
A Tabela 2 ilustra a performance comparativa dos modelos, destacando a superioridade do Ensemble. O desempenho inferior da Regressão Logística, com um AUC-ROC próximo ao baseline aleatório (0,500), evidencia a inadequação de abordagens lineares para este problema, sugerindo que o espaço TF-IDF de 1.500 dimensões encerra relações não-lineares cruciais para a discriminação de risco reputacional. Este achado reforça a escolha metodológica de algoritmos baseados em árvores, que são mais aptos a capturar interações e não-linearidades entre as features textuais, essenciais para a performance preditiva observada.
As curvas ROC, apresentadas na Figura 6, confirmaram que os modelos baseados em árvores (Random Forest, XGBoost e Ensemble) exibiram um AUC superior a 0,84, indicando um elevado desempenho discriminativo. A superioridade consistente do Ensemble em todo o espectro de thresholds avaliados é comparável aos resultados de Loughran e McDonald (2016) e Ke et al. (2019) em estudos de análise de sentimento financeiro em mercados desenvolvidos, sugerindo a transferibilidade da integração entre NLP e Machine Learning supervisionado para o contexto brasileiro. A combinação de classificadores com diferentes vieses de erro, por meio de votação ponderada, permitiu explorar a complementaridade entre os algoritmos, reduzindo a variância preditiva total (Zavyalova et al., 2012).
Figura 6. Curvas ROC dos quatro modelos de classificação testados. Maior AUC indica melhor capacidade discriminativa
Fonte: Resultados originais da pesquisa
Palavras-chave preditoras de risco
A análise dos coeficientes da Regressão Logística identificou os termos textuais mais fortemente associados à predição de risco reputacional. Os termos “prejuízo” (beta = 5,51), “fraude” (beta = 4,82) e “determinou” (beta = 4,45) figuraram como os três preditores lexicais de maior magnitude. Outros termos relevantes incluíram “demissão”, “funcionários”, “relator”, “vezes” e “pagamento”. A análise SHAP complementou esses achados, revelando que a presença do termo “fraude” apresentou um valor médio de +0,42, o sentimento negativo (BERTimbau score < -0,7) obteve um valor de +0,38, e a densidade de palavras-chave de risco contribuiu com +0,33 para as predições do modelo Ensemble.
Esses resultados corroboram a teoria da “reputação baseada em caráter” de Mishina et al. (2012), que sugere que stakeholders atribuem peso desproporcional a eventos que questionam a integridade fundamental de uma organização, em comparação com falhas de competência técnica ou erros operacionais pontuais. Termos lexicais de alto risco, como “vazamento”, “condenado”, “investigação”, “multa”, “processo”, “prejuízo”, “falha” e “crime”, indicam que a dimensão moral do evento é um determinante primário do impacto reputacional duradouro. Do ponto de vista prático, a identificação desses termos viabiliza o desenvolvimento de dicionários customizados para configurar alertas em ferramentas de monitoramento de mídia, ampliando a sensibilidade de detecção sem necessidade de infraestrutura computacional complexa (Tetlock, 2007; Garcia, 2013).
Definição do limiar de risco e métricas operacionais
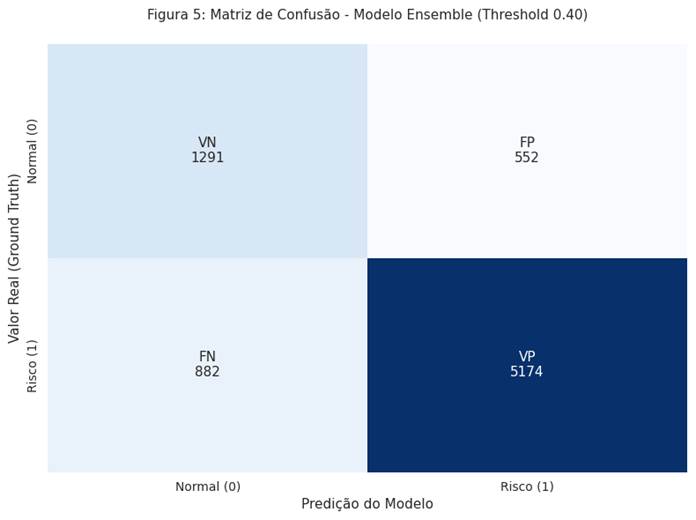
A análise do trade-off entre Precision e Recall em diferentes thresholds indicou que o ponto de corte de 0,40 oferece o equilíbrio mais adequado para aplicação em sistemas operacionais de monitoramento de risco reputacional. Neste threshold, o modelo classificou corretamente 5.174 Verdadeiros Positivos (VP), que são eventos de risco grave efetivamente identificados, e 1.291 Verdadeiros Negativos (VN), correspondentes a eventos normais corretamente descartados. Os erros do modelo distribuíram-se em 882 Falsos Negativos (FN), que são eventos de risco grave não detectados, e 552 Falsos Positivos (FP), que são alertas disparados para eventos que não representavam dano reputacional grave.
Figura 7. Matriz de confusão do modelo Ensemble no threshold de 0.40. VP = Verdadeiros Positivos, FP = Falsos Positivos, VN = Verdadeiros Negativos, FN = Falsos Negativos.
Fonte: Resultados originais da pesquisa
A partir desses valores, as métricas de performance operacionais foram derivadas. O Recall (Sensibilidade) foi de 85,4%, indicando que o modelo detectou corretamente 5.174 dos 6.056 eventos de risco grave no conjunto de teste. Os 882 casos não detectados (FN) representam 14,6% dos eventos críticos, que correspondem a crises reputacionais que passariam despercebidas sem triagem humana. No contexto da gestão de crises, este é o erro de maior custo organizacional, pois eventos não detectados em estágio inicial tendem a escalar sem intervenção tempestiva (Coombs, 2007).
A Precision foi de 90,3%, o que significa que dos 5.726 alertas emitidos pelo modelo (VP + FP), 90,3% corresponderam a riscos reais. Os 552 Falsos Positivos geram uma Taxa de Falsos Positivos de 29,9% sobre a classe normal (FP/VN+FP = 552/1.843), representando alertas que demandam triagem humana de segundo nível, mas não implicam custo reputacional direto à organização. Esta proporção é gerenciável em fluxos operacionais com equipes de monitoramento dedicadas. A Especificidade, de 70,1%, indica que o modelo identificou corretamente 1.291 dos 1.843 eventos normais, descartando-os sem gerar alarme. A escolha de priorizar a maximização do Recall em detrimento da Specificity fundamenta-se na assimetria de custos inerente à gestão de crises, onde o custo de um Falso Negativo supera substancialmente o de um Falso Positivo (Coombs, 2007; van Riel e Fombrun, 2007).
O Valor Preditivo Negativo (VPN) foi de 59,4%, indicando que, entre os 2.173 casos classificados como “não risco” pelo modelo (VN + FN), apenas 59,4% eram de fato eventos sem impacto grave. Este indicador reforça a necessidade de não utilizar o modelo de forma isolada para descartar eventos, mas sim como camada de priorização dentro de um sistema de monitoramento multifonte. A acurácia global do modelo foi de 81,8%, considerando todas as 7.899 classificações do conjunto de teste, demonstrando uma capacidade discriminativa consistente entre as classes e a eficácia geral do sistema em identificar e categorizar eventos de risco reputacional.
Validação temporal e robustez do modelo
A estratégia de validação temporal implementada, com treinamento exclusivo em dados de 2023-2024 e teste em dados de 2025, demonstrou que o modelo manteve performance consistente e estável no conjunto prospectivo. O F1-Score no conjunto de teste foi de 0,878, versus 0,898 no treino, representando uma diferença mínima de apenas 0,02 pontos. Este resultado é particularmente relevante, pois simula condições realistas de aplicação prospectiva do modelo em contexto organizacional, prevenindo o vazamento temporal de informação e fornecendo uma estimativa mais conservadora da performance real em produção.
A robustez temporal observada sugere a ausência de degradação significativa por concept drift, um fenômeno comum em domínios de análise textual jornalística, onde mudanças em vocabulário, estilo editorial e contexto político-econômico podem comprometer modelos treinados em períodos anteriores (Gama et al., 2014; Žliobaitė, 2010). A estabilidade dos padrões preditivos identificados, como volume de cobertura, sentimento negativo e presença de termos críticos como “fraude” e “prejuízo”, ao longo de três anos, reforça a viabilidade de operacionalização do modelo como um sistema de alerta contínuo, minimizando a necessidade de retreinamentos frequentes e alinhando-se às contribuições metodológicas de Schweidel e Moe (2014) sobre sistemas de monitoramento baseados em análise de mídia.
A análise qualitativa dos casos de falha revelou uma limitação estrutural relevante: o modelo apresentou taxa de detecção substancialmente inferior para eventos caracterizados como crises lentas (slow-burn crises), que se desenvolvem gradualmente com baixa visibilidade inicial na mídia, mas impacto reputacional cumulativo a longo prazo. Este padrão é consistente com os achados de Jin et al. (2014) e Schweidel e Moe (2014), que demonstraram que modelos baseados em volume de cobertura podem apresentar viés sistemático favorecendo eventos de alta saliência midiática imediata. Adicionalmente, eventos em setores ou empresas de menor porte, que recebem atenção jornalística proporcionalmente inferior, podem estar sub-representados no dataset de treinamento, criando pontos cegos preditivos.
Essas limitações indicam que o modelo desenvolvido deve ser compreendido como uma ferramenta complementar a sistemas de monitoramento multifonte, que incluam análise de redes sociais, monitoramento regulatório direto e canais internos de comunicação corporativa, conforme recomendado por Burke et al. (2011) e Sarstedt et al. (2013). A solução de risco reputacional proposta consiste em um sistema de scoring que atribui a cada nova notícia uma probabilidade percentual de dano reputacional grave, com um threshold de decisão de 40% para alertas. Este sistema possibilita monitoramento contínuo com alertas automáticos, análise retrospectiva via dashboard gerencial e priorização de resposta para alocação eficiente de recursos em casos de maior probabilidade de impacto duradouro.
Em síntese, o presente trabalho demonstrou a viabilidade técnica e científica do desenvolvimento de um modelo preditivo de risco reputacional baseado em características linguísticas e estruturais da cobertura jornalística no contexto brasileiro. A integração entre processamento de linguagem natural e aprendizado de máquina supervisionado mostrou-se uma abordagem eficaz para transformar dados textuais não estruturados em sinais preditivos acionáveis para a gestão proativa de crises corporativas. O modelo Ensemble, com sua capacidade preditiva superior e performance estável em dados cronologicamente posteriores, valida sua aplicabilidade prospectiva em cenários reais de monitoramento, evidenciando que a polaridade negativa do discurso jornalístico e a presença de termos lexicais específicos são preditores robustos de dano reputacional grave, indo além do simples volume de notícias.
4. Conclusão
O estudo buscou desenvolver e validar um modelo preditivo de risco reputacional baseado em características da cobertura midiática jornalística no contexto brasileiro, empregando técnicas avançadas de processamento de linguagem natural e aprendizado de máquina supervisionado. Verificou-se que o volume de cobertura midiática para eventos de risco grave foi significativamente superior, e a análise de sentimento, realizada com o modelo BERTimbau, identificou uma polaridade fortemente negativa associada a esses eventos, contrastando com a neutralidade observada em notícias de eventos normais. A comparação entre os algoritmos de classificação demonstrou a superioridade do modelo Ensemble, que alcançou um F1-Score de 0,878 e um Recall de 85,4%, indicando alta capacidade discriminativa. Termos lexicais como “prejuízo”, “fraude” e “determinou”, juntamente com o sentimento negativo, foram identificados como preditores robustos de dano reputacional. A validação temporal confirmou a estabilidade e a robustez do modelo em dados prospectivos, evidenciando sua aplicabilidade em cenários reais. Assim, comprovou-se a eficácia da integração entre NLP e Machine Learning para transformar dados textuais não estruturados em sinais preditivos acionáveis, oferecendo uma ferramenta de suporte à decisão para a gestão proativa de riscos corporativos.
Contudo, o modelo apresentou limitações na detecção de crises de desenvolvimento gradual e de eventos em empresas de menor porte com baixa visibilidade midiática inicial, sugerindo que sua aplicação deve ser complementar a sistemas de monitoramento multifonte, incluindo redes sociais e canais internos. Para estudos futuros, recomenda-se a expansão do dataset com a inclusão de fontes de redes sociais e a experimentação com arquiteturas de deep learning para capturar dependências temporais em narrativas jornalísticas. Sugere-se também a aplicação de validação externa em setores específicos e o desenvolvimento de interfaces de visualização interativa para facilitar a adoção organizacional do sistema proposto.
Referências Bibliográficas
Aula, P. (2010). Social media, reputation risk and ambient publicity management. Strategy and Leadership 38(6): 43-49.
Aula, P.; Mantere, S. 2013. Strategic Reputation Management: Towards a Company of Good. Routledge, New York, NY, USA.
Barnett, M.L.; Jermier, J.M.; Lafferty, B.A. (2006). Corporate reputation: The definitional landscape. Corporate Reputation Review 9(1): 26-38.
Chun, R.; Davies, G. (2020). The effect of merger and acquisition on corporate reputation: Capital One vs. Tesco. Journal of Strategic Marketing 28(5): 385-399.
Coombs, W.T.; Holladay, S.J. (2015). How publics react to crisis communication efforts: Comparing crisis response reactions across sub-arenas. Journal of Communication Management 19(1): 40-57.
Deephouse, D.L.; Carter, S.M. (2005). An examination of differences between organizational legitimacy and organizational reputation. Journal of Management Studies 42(2): 329-360.
Fombrun, C.J. (1996). Reputation: Realizing Value from the Corporate Image. Harvard Business School Press, Boston, MA, USA.
Hall, R. (1992). The strategic analysis of intangible resources. Strategic Management Journal 13(2): 135-144.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

