
24 de agosto de 2026
Integração de dados clínicos e transcriptômicos na previsão de sobrevida de pacientes de LMA
Caio Bezerra Machado; Vanilde de Castro
DOI: 10.22167/2675-6528-202601825
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A leucemia mielóide aguda constitui uma neoplasia hematológica de elevada letalidade, cujo prognóstico permanece limitado apesar dos avanços terapêuticos recentes. Este estudo objetivou quantificar o ganho de desempenho preditivo de modelos de aprendizado de máquina para sobrevida após a integração de dados clínicos e transcriptômicos. Conduziu-se uma análise experimental com dados secundários de 318 pacientes do banco público BeatAML2. Aplicaram-se modelos de Random Survival Forest e Gradient Boosting Survival. Dados clínicos foram previamente processados e comparados, enquanto dados transcriptômicos foram normalizados, filtrados e reduzidos por análise de componentes principais, com seleção de componentes associados à sobrevida por regressão de Cox. Inicialmente, modelos baseados apenas em dados clínicos apresentaram desempenho preditivo moderado. Após a incorporação de variáveis transcriptômicas, observou-se melhora consistente das métricas preditivas, além de maior estabilidade temporal das predições. Componentes principais associados a vias biológicas relevantes, como regulação do ciclo celular e oncogenes, demonstraram elevada importância preditiva. Concluiu-se que a integração de dados transcriptômicos promoveu ganho moderado na acurácia dos modelos, embora ainda insuficiente para aplicação clínica isolada, reforçando a necessidade de incorporação de variáveis dinâmicas e validação externa.
Palavras-chave: Aprendizado de Máquina; Estratificação de Risco Genético; Oncologia.
1. Introdução
Cancer representa um grupo complexo de doenças multifatoriais, caracterizadas por marcos biológicos comuns, como a reprogramação metabólica maligna e a indução da imortalidade replicativa em células que se tornam clones neoplásicos (Hanahan, 2022). Entre os diversos subtipos de câncer, as leucemias, que são tumores hematológicos de origem medular, foram responsáveis por aproximadamente 305 mil mortes globalmente em 2022 (Bray et al., 2024). Essas neoplasias podem ser classificadas em linfoides ou mieloides, dependendo do progenitor hematológico de origem, e em agudas ou crônicas, conforme o grau de maturação dos clones neoplásicos (Juliusson e Hough, 2016).
As leucemias, no total, correspondem a cerca de três por cento de todas as mortes por câncer no mundo (Bray et al., 2024). Dentre elas, a leucemia mieloide aguda (LMA) destaca-se pela sua elevada taxa de mortalidade, sendo responsável por aproximadamente onze mil óbitos anuais apenas nos Estados Unidos (Siegel et al., 2025). Apesar dos avanços terapêuticos recentes, a sobrevida global de pacientes com LMA tem apresentado aumentos discretos na última década (Dhakal et al., 2024; Salman et al., 2021). Contudo, o prognóstico permanece subótimo, especialmente devido à citotoxicidade associada à quimioterapia convencional e ao fato de o transplante de células-tronco hematopoiéticas ser o único tratamento curativo (Vakiti et al., 2024).
Atualmente, as diretrizes da European Leukemia Network (ELN), atualizadas em 2022, estabelecem a estratificação de risco para pacientes adultos com LMA com base em características citogenéticas e mutações em painéis de genes específicos (Döhner et al., 2022). Perfis de expressão gênica, apesar dos avanços nas técnicas de diagnóstico molecular, ainda não são considerados na determinação do prognóstico. No entanto, o barateamento de técnicas sofisticadas de sequenciamento de nova geração (NGS) tem expandido significativamente o volume de informações disponíveis para cada paciente (Ari e Arikan, 2016), impulsionando a medicina de precisão e tratamentos personalizados (Hodson, 2016).
A incorporação de grandes volumes de dados específicos do paciente no atendimento assistencial está, em geral, associada ao uso de estratégias da ciência de dados e à crescente popularização de ferramentas de inteligência artificial (IA) (Khosravi et al., 2024; Subrahmanya et al., 2021). Em particular, o aprendizado de máquina tem demonstrado alta acurácia em diversas aplicações médicas preditivas (An et al., 2023). A integração de dados multi-ômicos, provenientes de técnicas de NGS, na previsão de sobrevida de pacientes oncológicos já é uma realidade em outros subtipos tumorais, com resultados positivos (Pop et al., 2025).
Apesar do potencial, a quantificação do ganho real de informação obtido pela agregação de dados multi-ômicos na predição de sobrevida, e o custo-benefício associado a essas técnicas, pode ser obscura devido à multiplicidade de algoritmos e formas de análise disponíveis na literatura (Tran et al., 2025). Além disso, a aplicação da IA na saúde para auxiliar decisões médicas levanta questões éticas sobre a responsabilidade atribuída a essas ferramentas (MacIntyre et al., 2023). Nesse contexto, o uso de técnicas de aprendizado de máquina supervisionadas é preferível, pois oferece maior interpretabilidade dos resultados, permitindo uma análise crítica por equipes médicas (Allen et al., 2024).
Considerando a atual estratificação de prognóstico de pacientes com LMA, a exploração de informações genéticas obtidas por análise transcriptômica é subaproveitada, mas possui grande potencial para complementar as informações citogenéticas e mutacionais já empregadas, aprimorando a classificação individual dos pacientes. Assim, este trabalho objetivou quantificar o ganho de valor em métricas preditivas de sobrevida de modelos de ensemble de árvores de decisão, treinados com dados clínicos de pacientes com LMA, após a integração de dados de transcriptômica.
2. Material e Métodos
O estudo foi concebido como uma pesquisa experimental de abordagem quantitativa, focada em avaliar o ganho preditivo de modelos de aprendizado de máquina na sobrevida de pacientes com leucemia mieloide aguda (LMA). Utilizaram-se dados secundários de 318 pacientes do banco público BeatAML2 (https://biodev.github.io/BeatAML2/), coletados em oito centros nos EUA. Os dados foram de-identificados, dispensando submissão a comitê de ética, conforme a Resolução CNS nº 510 de abril de 2016 e a Common Rule (45 CFR 46) do United States Department of Health and Human Services (HHS, 2018).
A seleção de pacientes do BeatAML2 incluiu indivíduos com diagnóstico inicial de LMA, sem tratamento prévio, e com dados transcriptômicos e exômicos disponíveis. Foram considerados apenas pacientes submetidos a quimioterapia padrão de indução, excluindo-se casos com informações ausentes, tratamentos específicos, cuidados paliativos ou desfechos não relacionados à LMA. Entradas duplicadas foram removidas. O conjunto final de 318 pacientes foi dividido em 75% para treinamento e 25% para teste, com estratificação pela coluna de censura para manter proporções similares.
O pré-processamento dos dados clínicos, executado com Microsoft Excel 2024 e Python v. 3.13, envolveu a análise de 95 colunas. Informações de identificação, metodológicas e pós-tratamento foram descartadas, e colunas redundantes combinadas. O cariótipo foi estratificado em grupos de risco (Daneshbod et al., 2019). As distribuições das variáveis entre os grupos de treino e teste foram comparadas usando teste de qui-quadrado e V de Cramér (McHugh, 2013) para categóricas, e teste U de Mann-Whitney (Chicco et al., 2025) com delta de Cliff (Marfo e Okyere, 2019) para contínuas. Dados ausentes foram imputados pela mediana.
Variáveis categóricas foram dicotomizadas e o cariótipo transformado em ordinal. A efetividade da estratificação foi verificada por curvas de Kaplan-Meier (Lira et al., 2020) e teste de log-rank (Bland e Altman, 2004). Modelos de Random Survival Forest (RSF) e Gradient Boosting Survival (GBS) foram treinados com dados clínicos padronizados, utilizando a biblioteca scikit-survival v.0.25.0 (Pölsterl, 2020) para sobrevida censurada à direita. Hiperparâmetros foram otimizados pelo score integrado de Brier (Graf et al., 1999), e a eficiência avaliada pelo índice C de Harrell (Harrell et al., 1996) e ROC-AUC cumulativa em cinco anos (Lambert e Chevret, 2016). A importância de cada variável clínica foi determinada por permutação (Ishwaran et al., 2008).
As análises transcriptômicas forneceram dados de expressão gênica para 22.843 genes, inicialmente em RPKM (Bottomly et al., 2022). Estes foram normalizados por conditional quantile normalization (Hansen et al., 2012) e transformados para TPM em log2 (Wagner et al., 2012; Zhao et al., 2020). Genes ruidosos (Cockrum et al., 2020; Costa et al., 2022) e de baixa variância (Eisenberg e Levanon, 2013) foram filtrados usando a segunda derivada da curva de distribuição acumulada da mediana de TPMs (Christopoulos, 2016) e o coeficiente de variância interquartil. Aplicou-se PCA nos dados de treino (Jollife e Cadima, 2016), e os PCs resultantes foram submetidos a modelos univariados de Cox (ElHafeez, 2021) para identificar significância estatística na sobrevida. Uma análise de enriquecimento de conjunto de genes (GSEA) foi realizada para os PCs mais importantes (Subramanian, 2005).
Os PCs com significância estatística foram selecionados como novas variáveis para o treinamento dos modelos de ensemble. Estes PCs foram agregados aos dados clínicos para o treinamento final dos modelos de Random Survival Forest e Gradient Boosting Survival. A performance dos modelos foi reavaliada utilizando o score integrado de Brier e o índice C de Harrell. Este procedimento permitiu mensurar os ganhos advindos da agregação de informações gênicas, comparando a acurácia dos modelos antes e depois da inclusão dos dados transcriptômicos para a previsão de sobrevida.
3. Resultados e Discussão
Após a aplicação dos critérios de filtragem estabelecidos na metodologia, o conjunto de dados para análise foi composto por 318 observações únicas de pacientes. Destas, 238 foram designadas para o treinamento dos modelos e 80 para os testes. Em ambos os grupos, aproximadamente 53% das observações não apresentaram o evento de interesse (óbito), sendo classificadas como censuradas à direita. Este balanceamento entre os grupos de treino e teste é crucial para a robustez dos modelos preditivos, garantindo que a proporção de eventos seja similar e representativa em ambas as coortes.
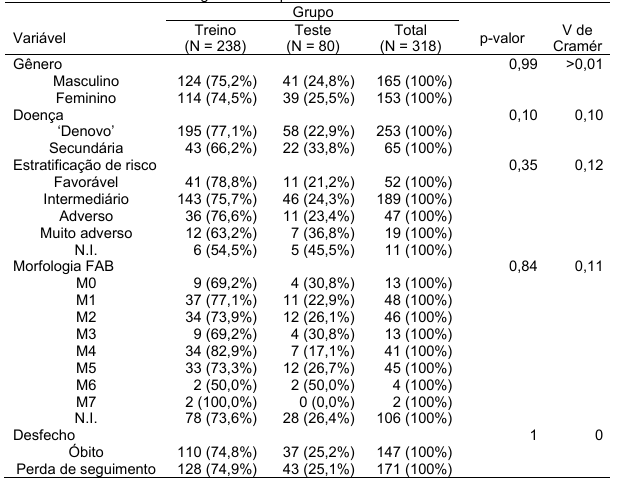
Inicialmente, foram selecionadas 35 variáveis clínicas de interesse para o treinamento dos modelos, abrangendo informações como gênero, idade, estratificação de risco, estadiamento da doença, parâmetros hematológicos e bioquímicos, e a morfologia das células de acordo com o padrão franco-americano-britânico (FAB). A sumarização dessas variáveis, tanto categóricas quanto contínuas, para os grupos de treino e teste, juntamente com os resultados dos testes de hipótese entre as distribuições dos grupos, é apresentada nas Tabelas 1 e 2. A análise descritiva dessas características é fundamental para compreender a composição da coorte estudada e a comparabilidade entre os subgrupos.
Tabela 1. Características categóricas dos pacientes do estudo
Nota: Os valores de cada célula de um determinado grupo representam o valor absoluto
daquela categoria e, entre parênteses, o valor de cada grupo relativo ao total; Franco
americano-britânico [FAB]; Não Informado [N.I.]
A Tabela 1 detalha as características categóricas dos pacientes, como gênero, tipo de doença (denovo ou secundária), estratificação de risco e morfologia FAB. Observou-se que as distribuições dessas variáveis entre os grupos de treino e teste não apresentaram diferenças estatisticamente significativas, com p-valores elevados e valores de V de Cramér próximos de zero. Isso indica uma boa homogeneidade entre os grupos, o que é essencial para evitar vieses no treinamento e avaliação dos modelos de aprendizado de máquina.
Tabela 2. Características contínuas dos pacientes do estudo
| Variável | Treino (N = 238) | Teste (N = 80) | Total (N = 318) | p-valor | δ de Cliff |
|---|---|---|---|---|---|
| Idade (anos) | 55,00 (39,00-64,00) | 61,00 (48,75-68,00) | 57,00 (41,00-65,00) | 0,02 | -0,17 |
| Hemoglobina (g/dL) | 8,20 (7,10-9,50) | 8,05 (6,90-9,15) | 8,10 (7,00-9,50) | 0,39 | 0,07 |
| Leucocitos (10⁹/L) | 26,88 (9,14-62,19) | 29,10 (8,94-68,85) | 27,26 (9,04-62,61) | 0,88 | -0,01 |
| Plaquetas (10⁹/L) | 42,00 (26,00-71,00) | 40,00 (29,00-89,75) | 40,00 (27,00-74,00) | 0,37 | -0,08 |
| Blastos na medula (%) | 75,00 (50,00-89,50) | 75,00 (47,00-88,50) | 75,00 (48,50-89,25) | 0,76 | 0,02 |
| Creatinina (mg/dL) | 0,84 (0,68-1,01) | 0,85 (0,69-1,15) | 0,84 (0,69-1,02) | 0,47 | -0,07 |
| LDH (U/L) | 505,50 (356,25-694,75) | 481,00 (279,00-1005,25) | 501,00 (349,00-819,50) | 0,93 | -0,01 |
Nota: Os valores de cada célula de um determinado grupo representam a mediana da variável
em questão e, entre parênteses, seu intervalo interquartil; Lactato desidrogenase [LDH]
A Tabela 2, por sua vez, apresenta as características contínuas, incluindo idade, hemoglobina, leucócitos e plaquetas, além de blastos na medula, creatinina e LDH. Embora o teste U de Mann-Whitney tenha indicado uma diferença estatisticamente significativa na distribuição de idade entre os grupos de treino e teste (p < 0,05), o valor de delta de Cliff de -0,17 sugere que essa diferença é pequena e pode ser influenciada pelo tamanho da amostra de teste. Para as demais variáveis contínuas, não houve associação significativa entre suas distribuições e os grupos, reforçando a comparabilidade das coortes.
Sobrevida Geral e Estratificada
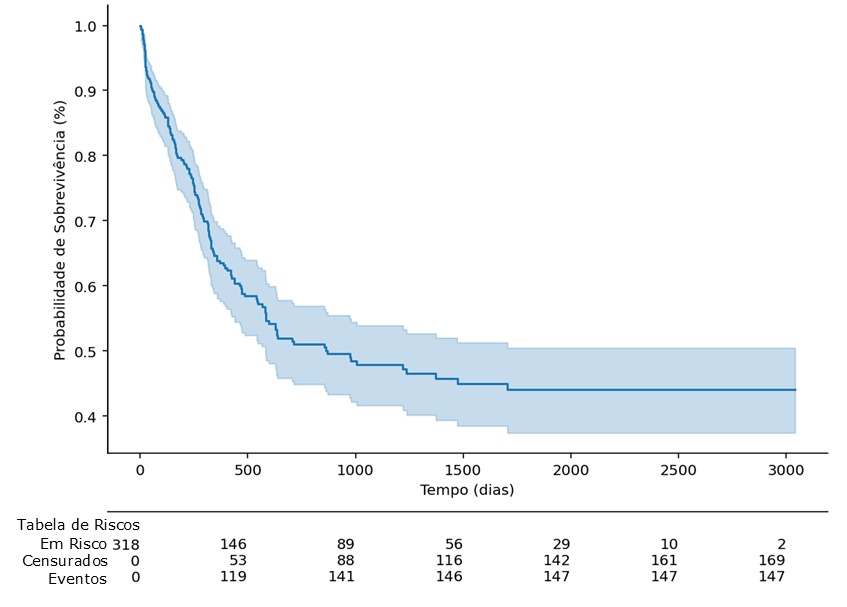
A análise da sobrevida global da coorte revelou uma mediana de 870 dias, com um intervalo de confiança de 95% que se estende de 581 dias até um limite superior não alcançado devido à escassez de eventos após a mediana. Este achado reflete a complexidade do prognóstico da leucemia mieloide aguda (LMA) e a necessidade de modelos preditivos mais precisos. A Figura 1 ilustra a curva de sobrevida geral, fornecendo uma representação visual da probabilidade de sobrevida ao longo do tempo para a população estudada.
Figura 1. Curva de sobrevida geral e tabela de riscos da coorte
Fonte: Resultados originais da pesquisa
A Figura 1, acompanhada da tabela de riscos, mostra a diminuição gradual da probabilidade de sobrevida ao longo dos dias, com uma queda mais acentuada nos primeiros 500 dias. A tabela de riscos complementa a curva, indicando o número de pacientes em risco, censurados e eventos ocorridos em diferentes intervalos de tempo. Esses dados são cruciais para entender a dinâmica da sobrevida na coorte e servem como base para a avaliação dos modelos preditivos.
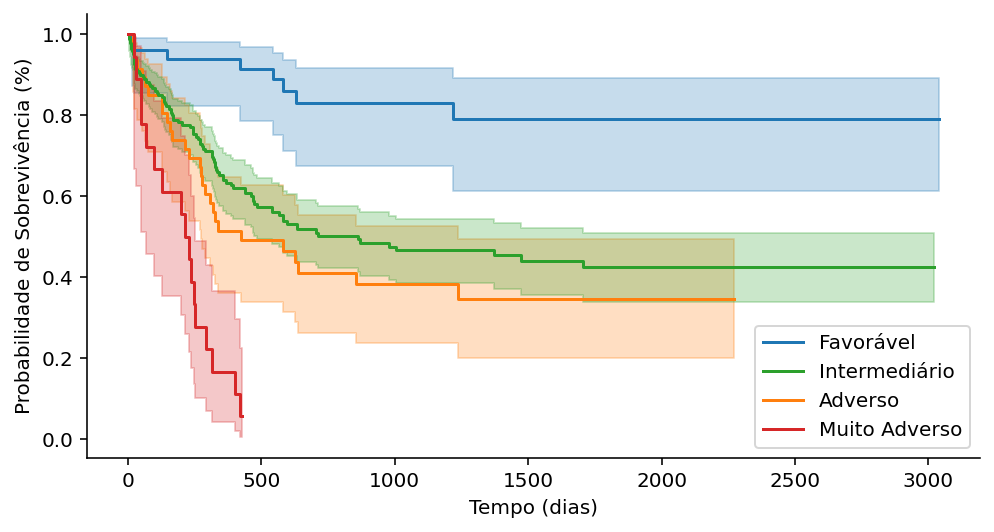
A estratificação da sobrevida dos pacientes foi realizada com base nas categorias de risco determinadas pelos cariótipos disponíveis, uma classificação desenvolvida neste trabalho. Os resultados dessa análise são apresentados na Figura 2. O teste de log-rank global entre as curvas de sobrevida estratificadas demonstrou significância estatística (χ² = 52,45; p-valor < 0,005), indicando que as categorias de risco por cariótipo são preditivas da sobrevida.
Figura 2. Curva de sobrevida geral por estratificação de risco
Fonte: Resultados originais da pesquisa
A Figura 2 ilustra as curvas de sobrevida para cada grupo de risco (favorável, intermediário, adverso e muito adverso), evidenciando as diferenças prognósticas. A Tabela 3 complementa essa análise, apresentando as comparações individuais entre pares de curvas e os p-valores ajustados pela correção de Bonferroni. Observou-se que, com exceção da comparação entre os grupos de risco intermediário e adverso, todas as outras comparações revelaram diferenças significativas na sobrevida, reforçando a validade da estratificação por cariótipo.
Tabela 3. Comparações de curvas de sobrevida par a par
| Grupo 1 | Grupo 2 | Teste x² | p-valor | p-ajustado |
|---|---|---|---|---|
| Favorável | Adverso | 18,82 | <0,001 | <0,001 |
| Favorável | Intermediário | 15,34 | <0,001 | <0,001 |
| Favorável | Muito Adverso | 57,42 | <0,001 | <0,001 |
| Intermediário | Adverso | 1,44 | 0,23 | 1 |
| Intermediário | Muito Adverso | 27,90 | <0,001 | <0,001 |
| Adverso | Muito Adverso | 12,41 | <0,001 | <0,005 |
Fonte: Resultados originais da pesquisa
A Tabela 3 confirma que a estratificação de risco por cariótipo é uma ferramenta importante para o prognóstico da LMA, com diferenças claras entre a maioria dos grupos. A ausência de significância entre os grupos intermediário e adverso pode ser atribuída a condutas terapêuticas não registradas no banco de dados, como transplantes de células-tronco hematopoiéticas, que podem homogeneizar a sobrevida nesses grupos. Em contraste, os grupos de prognóstico mais extremos (favorável e muito adverso) mantêm um prognóstico mais estável, independentemente das decisões clínicas, conforme sugerido por Daneshbod et al. (2019).
Treinamento de Modelos com Dados Clínicos
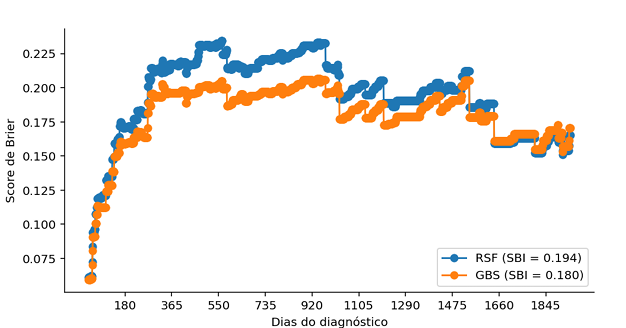
Após a otimização dos hiperparâmetros e a conferência das estatísticas descritivas, os modelos de Random Survival Forest (RSF) e Gradient Boosting Survival (GBS) foram empregados para prever a probabilidade de sobrevida na coorte de teste. A Figura 3 apresenta o score de Brier tempo-dependente, uma métrica que avalia a acurácia das probabilidades de sobrevida ao longo do tempo. O gráfico revela que ambos os modelos exibem menor erro preditivo em curtos e longos prazos, aproximadamente um e cinco anos, respectivamente, mas demonstram menor capacidade de discernimento em períodos intermediários.
Figura 3. Score de Brier tempo-dependente
Fonte: Resultados originais da pesquisa
A Figura 3 indica que o modelo GBS geralmente apresenta uma acurácia preditiva superior ou equivalente ao RSF, conforme evidenciado por um score de Brier integrado (SBI) de 0,180 para GBS em comparação com 0,194 para RSF. Essa diferença, embora discreta, sugere uma leve vantagem do GBS na previsão do risco de evento. A análise do score de Brier é fundamental para avaliar a calibração dos modelos, ou seja, quão bem as probabilidades preditas correspondem às probabilidades observadas.
A capacidade dos modelos de ranquear corretamente os pares de observações em termos de risco de sobrevida é ilustrada pela densidade de concordância, apresentada na Figura 4. Esta métrica avalia a capacidade de um modelo atribuir um risco maior à observação que efetivamente experimentou o evento de óbito primeiro, em comparação com outra observação. A diferença nos scores de risco entre os pares é utilizada para determinar a concordância.
Figura 4. Densidade de concordância dos modelos, representado pela diferença dos scores de risco de cada par de observações
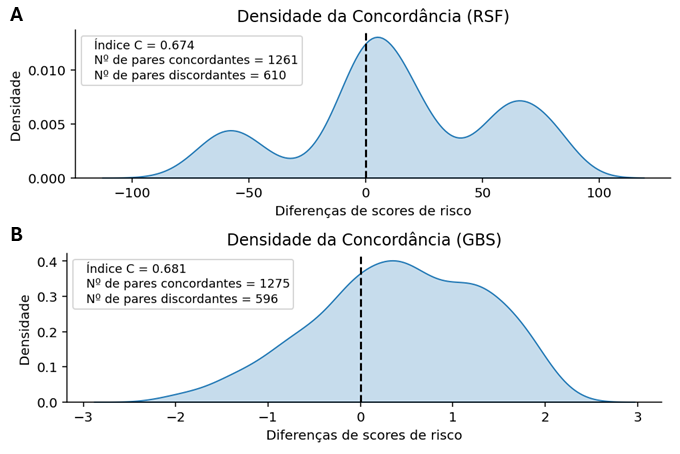
Nota: “Random Survival Forest” [RSF]; “Gradient Boosting Survival” [GBS]
A Figura 4 demonstra que os modelos RSF e GBS não exibem uma diferença substancial em sua eficiência de ranqueamento, com índices C de Harrell de 0,674 e 0,681, respectivamente. O índice C de Harrell é uma medida de discriminação que avalia a concordância entre o score de risco predito e o tempo para o evento. Valores próximos a 0,5 indicam desempenho aleatório, enquanto valores próximos a 1,0 indicam discriminação perfeita. Os resultados sugerem uma capacidade preditiva moderada para ambos os modelos baseados apenas em dados clínicos.
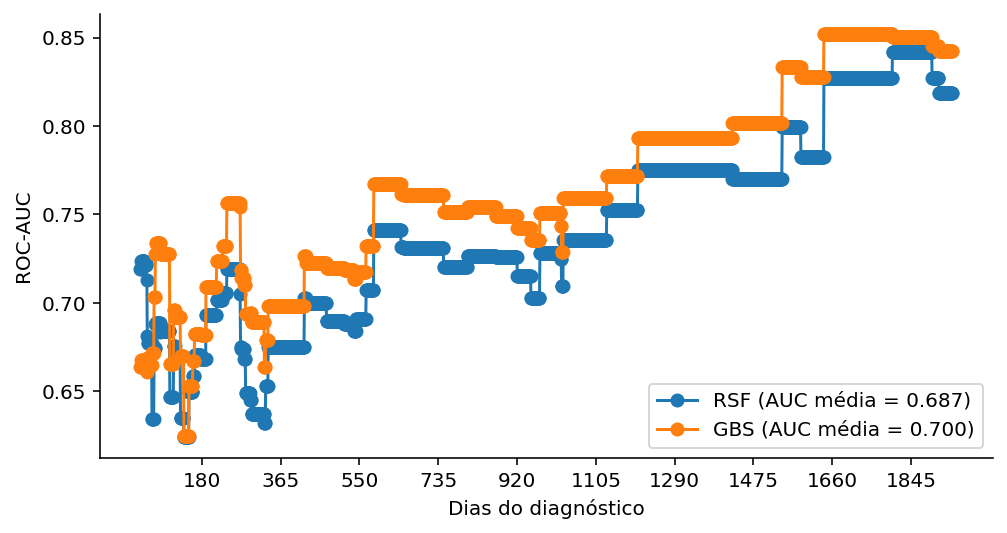
A eficiência dos modelos para ranquear corretamente os pares de observações ao longo do tempo é também representada pelo gráfico de ROC-AUC, conforme exibido na Figura 5. O ROC-AUC cumulativo é uma métrica que avalia a capacidade de discriminação do modelo em diferentes pontos de tempo. Similarmente às observações anteriores, o GBS demonstrou uma eficiência ligeiramente superior ao RSF, com AUCs médias de 0,700 e 0,687, respectivamente.
Figura 5. ROC-AUC tempo dependente
Fonte: Resultados originais da pesquisa
A Figura 5 revela que ambos os modelos apresentam um desempenho melhor a longo prazo, com um pico de eficiência observado a partir de aproximadamente quatro anos e meio após o diagnóstico. Essa tendência sugere que, embora a capacidade preditiva geral seja modesta, os modelos podem ser mais úteis para prognósticos de sobrevida em horizontes temporais mais estendidos. Os valores de ROC-AUC obtidos são comparáveis aos de outros modelos treinados com dados clínicos e informações de cariótipo, conforme apontado por Silveira et al. (2020), indicando a necessidade de aprimoramento.
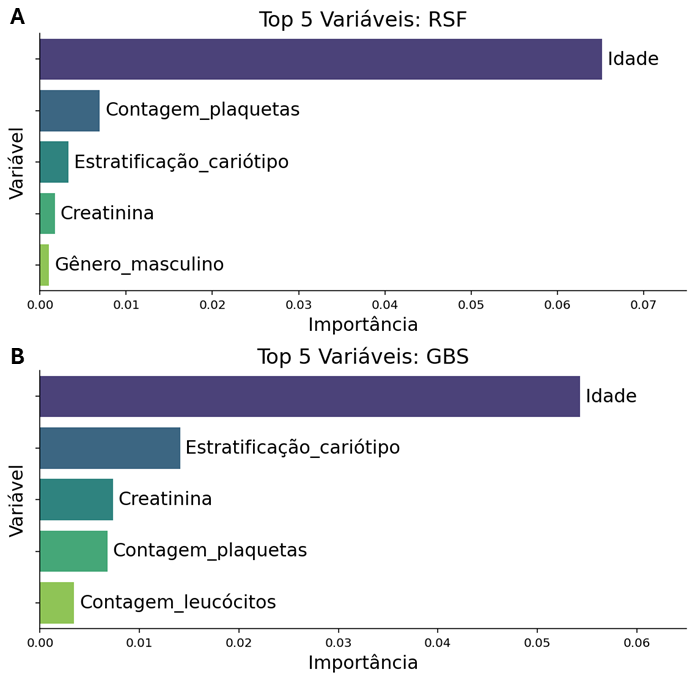
A investigação da importância de cada variável na eficiência preditiva dos modelos revelou quais dados clínicos são mais relevantes para a estratificação do prognóstico dos pacientes. A Figura 6 apresenta as cinco variáveis que exerceram maior influência nas decisões de cada modelo. Quatro dessas variáveis – idade, estratificação de risco por cariótipo, contagem de plaquetas e creatinina – foram compartilhadas entre os modelos RSF e GBS, destacando sua relevância consistente.
Figura 6. As cinco variáveis de maior importância para a eficiência de cada modelo
Fonte: Resultados originais da pesquisa
Conforme a Figura 6, a idade se destacou como a variável de maior importância em ambos os modelos, sublinhando seu papel crítico no prognóstico da LMA. A estratificação de risco por cariótipo também se mostrou consistentemente relevante, reforçando a importância dos fatores genéticos. A contagem de plaquetas e a creatinina completam o conjunto de variáveis clínicas mais influentes, indicando que uma combinação de fatores demográficos, genéticos e bioquímicos é essencial para uma predição mais acurada da sobrevida.
Agregação de Dados Moleculares
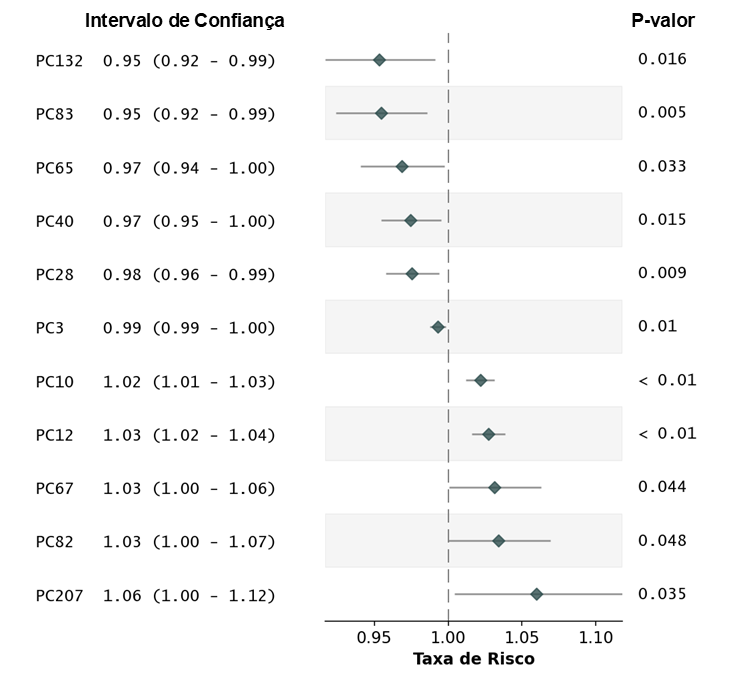
Após a filtragem de genes ruidosos, o conjunto de dados manteve 19.296 genes. Uma Análise de Componentes Principais (PCA) foi aplicada aos genes das observações de treino, resultando em 238 Componentes Principais (PCs). Modelos de riscos proporcionais de Cox foram então estimados de forma univariada para cada PC, buscando identificar aqueles com maior relação com a sobrevida. Os PCs que apresentaram significância estatística (p < 0,05) foram selecionados para a próxima etapa da análise, conforme detalhado na Figura 7.
Figura 7. Taxa de risco associada a cada PC na sobrevida de pacientes com LMA
Fonte: Resultados originais da pesquisa
A Figura 7 ilustra as taxas de risco associadas a cada PC, indicando que 11 PCs apresentaram influência significativa na sobrevida dos pacientes. Seis desses PCs demonstraram um efeito protetivo, com taxas de risco menores que um, sugerindo que valores mais altos desses PCs se correlacionam com uma sobrevida prolongada. Em contrapartida, cinco PCs apresentaram um efeito danoso, com taxas de risco maiores que um, indicando associação com pior sobrevida. As maiores significâncias estatísticas foram observadas nos PCs 10 e 12 (p < 0,01).
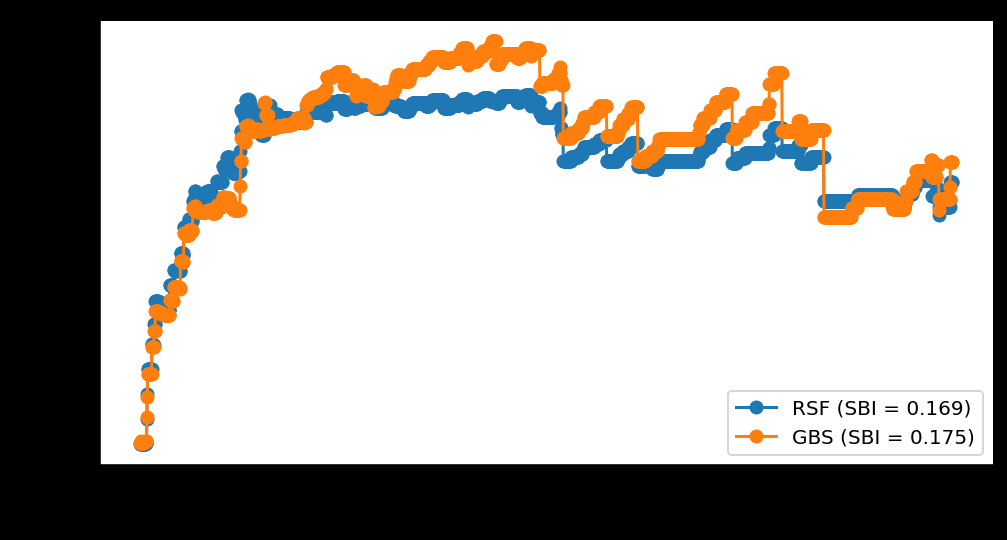
Os 11 PCs identificados foram então agregados aos dados clínicos e utilizados no treinamento dos modelos de ensemble. Após a otimização dos hiperparâmetros, observou-se uma diminuição no score integrado de Brier, principalmente para o modelo RSF, conforme ilustrado na Figura 8. Este resultado sugere que a incorporação de dados transcriptômicos contribui para uma melhor calibração dos modelos, tornando suas probabilidades de sobrevida mais alinhadas com os desfechos observados.
Figura 8. Score de Brier tempo-dependente para modelos com dados moleculares
Fonte: Resultados originais da pesquisa
A Figura 8 demonstra que, com a adição dos dados moleculares, o score de Brier integrado para o RSF diminuiu para 0,169, enquanto para o GBS foi de 0,175. Essa redução no score de Brier indica uma melhoria na acurácia das probabilidades de sobrevida preditas pelos modelos. A comparação com a Figura 3, que apresentava os scores de Brier para os modelos treinados apenas com dados clínicos, evidencia o ganho de desempenho proporcionado pela integração das informações transcriptômicas.
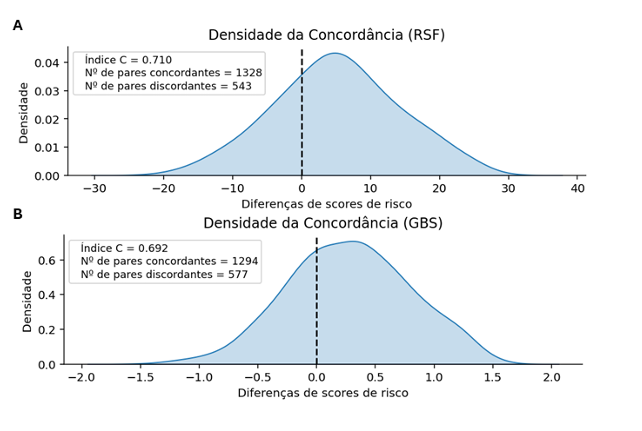
De maneira similar, os resultados do índice C de Harrell também demonstraram um ganho considerável com a utilização de dados transcriptômicos. O modelo RSF apresentou um aumento de 0,674 para 0,710, enquanto o GBS teve um ganho mais discreto, passando de 0,681 para 0,692. A Figura 9 ilustra a densidade de concordância dos modelos treinados com dados moleculares, refletindo essa melhoria na capacidade de discriminação.
Figura 9. Densidade de concordância dos modelos treinados com dados moleculares
Nota: “Random Survival Forest” [RSF]; “Gradient Boosting Survival” [GBS]
A Figura 9, ao comparar com a Figura 4, evidencia que a integração dos dados moleculares deslocou as distribuições das diferenças de scores de risco, indicando uma maior proporção de pares concordantes e, consequentemente, uma melhor capacidade de discriminação dos modelos. O aumento nos índices C de Harrell para ambos os modelos confirma que a inclusão dos PCs transcriptômicos aprimorou a habilidade dos algoritmos em ranquear corretamente os pacientes em termos de risco de sobrevida, tornando as predições mais robustas.
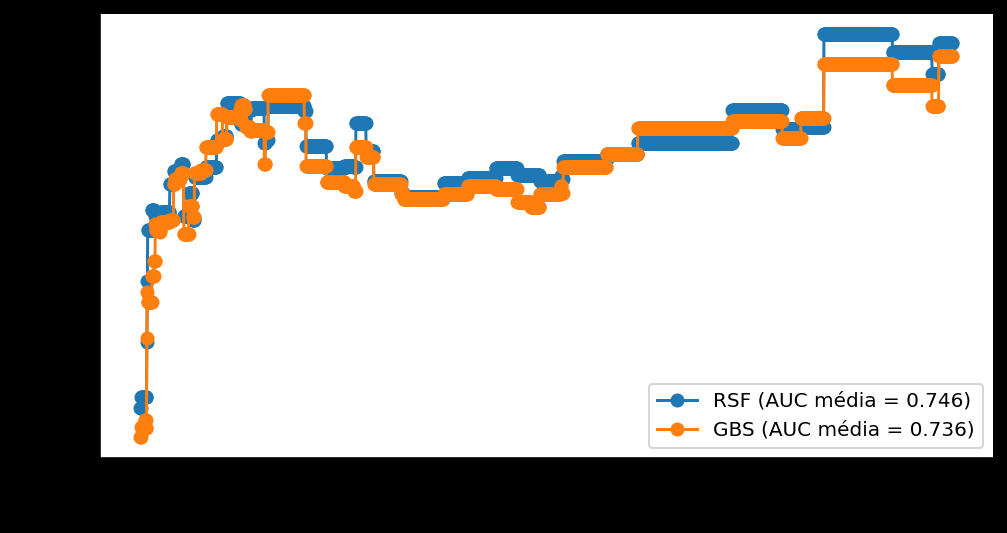
A tendência de ganho de desempenho também foi observada nas métricas de ROC-AUC média, com o modelo RSF subindo de 0,687 para 0,746 e o GBS de 0,700 para 0,736. A Figura 10 apresenta o ROC-AUC tempo-dependente para os modelos treinados com dados moleculares. A capacidade máxima de discriminação dos modelos permaneceu em torno do período de cinco anos após o diagnóstico, similar ao observado nos modelos anteriores, mas com maior estabilidade.
Figura 10. ROC-AUC tempo dependente em modelos treinados com dados moleculares
Fonte: Resultados originais da pesquisa
A Figura 10 demonstra que os novos modelos, com a inclusão de dados moleculares, exibem maior estabilidade em sua eficiência preditiva ao longo do tempo, mantendo-se consistentemente acima de 0,7 após os primeiros 180 dias. Isso representa uma melhoria significativa em relação aos modelos baseados apenas em dados clínicos, que apresentavam picos de eficiência mais tardios e menos consistentes. Os valores de AUC reportados estão em consonância com a literatura, onde um AUC de 0,7 é considerado um limiar para poder preditivo moderado (Tuerxun et al., 2025).
Interpretação dos PCs e enriquecimento gênico
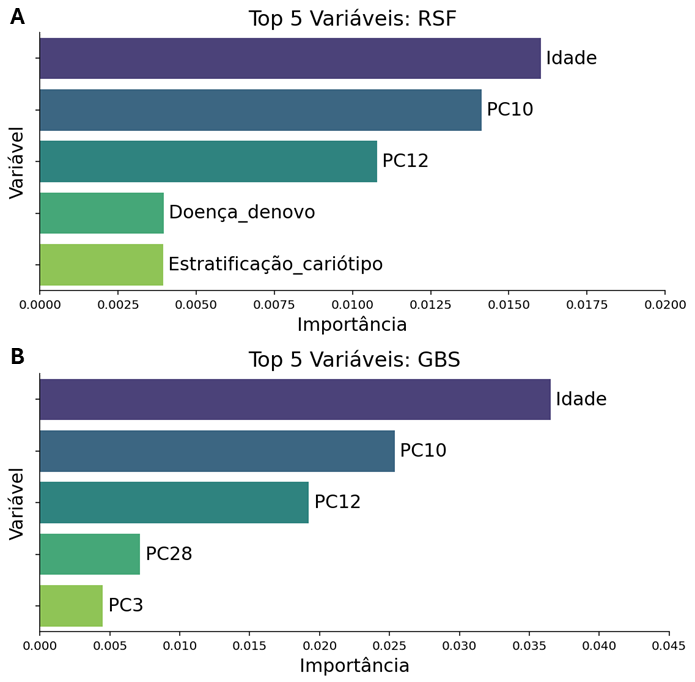
A Figura 11 define o ranque de importância das cinco variáveis de maior impacto para as métricas preditivas dos novos modelos de ensemble, que agora incluem os dados moleculares. Comparativamente aos modelos treinados apenas com dados clínicos, a idade dos pacientes continuou sendo o fator preditivo mais importante. No entanto, as variáveis PC10 e PC12, derivadas da análise transcriptômica, emergiram como os maiores contribuintes para o aumento do Índice C, superando variáveis clínicas como contagem de plaquetas, creatinina e estratificação de risco por cariótipo, que antes estavam entre as cinco mais importantes.
Figura 11. As cinco variáveis de maior importância para a eficiência de cada modelo treinado com dados moleculares
Nota: “Random Survival Forest” [RSF]; “Gradient Boosting Survival” [GBS]; “Principal
Component” [PC]
A Figura 11 destaca a proeminência dos PCs 10 e 12 na predição de sobrevida, indicando que a informação genética capturada por esses componentes é altamente relevante. É importante notar que esses PCs foram os mesmos que apresentaram maior significância estatística nas análises univariadas dos modelos de Cox, reforçando sua potencial correlação com a sobrevida de pacientes em um contexto clínico real. A consistência da relevância dessas variáveis entre diferentes modelos e conjuntos de dados sublinha a robustez de sua contribuição preditiva.
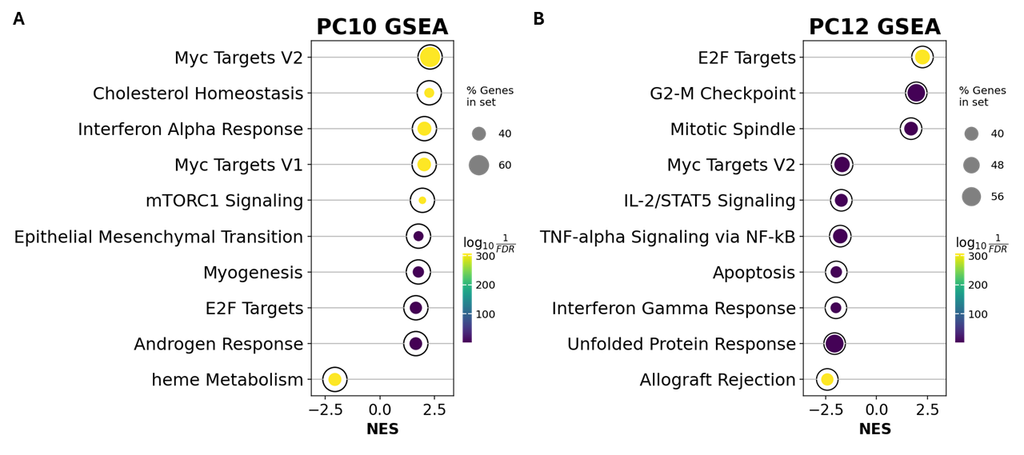
Uma análise de enriquecimento de conjunto de genes (GSEA) foi realizada para os PCs 10 e 12, com o objetivo de identificar vias metabólicas que estão mais ou menos ativadas pelos genes de maior contribuição. Essa abordagem permite uma compreensão mais aprofundada da reprogramação metabólica promovida pelos tumores e como isso se relaciona com o prognóstico. A Figura 12 ilustra as vias que apresentaram regulação estatisticamente significativa dentro dos PCs analisados, fornecendo insights sobre os mecanismos biológicos subjacentes.
Figura 12. Vias reguladas pelos PCs de maior relevância na predição de sobrevida
Fonte: Resultados originais da pesquisa
Nota: “Principal Component” [PC]; “Gene Set Enrichment Analysis” [GSEA]; “Normalized
Enrichment Score” [NES]; “False Discovery Rate” [FDR]
A Figura 12 revela que, entre as vias positivamente reguladas por ambos os componentes, a via de alvos de E2F se destaca. A família de genes E2F, que regula o ciclo celular e a transcrição de DNA, tem sua desregulação bem documentada em diversos tipos de câncer (Kent e Leone, 2019). As vias de alvos de MYC, proto-oncogenes ativados em tumores (Dhanasekaran et al., 2022), apresentaram padrões de ativação conflitantes, com PC10 associado à ativação e PC12 à supressão da via. Essa complexidade reflete a natureza multifacetada dos modelos cancerosos.
Outras vias importantes com forte associação à carcinogênese foram identificadas, incluindo a homeostase do colesterol (Luo, Yang e Song, 2020), a regulação do ciclo celular (Cheung et al., 2023) e a apoptose (Dang, 2012). A influência contrária de PC10 e PC12 em uma mesma via, apesar de ambos estarem correlacionados a uma pior sobrevida, ressalta a complexidade das redes metabólicas e a coexistência de diversas vias de morte e sobrevivência. Isso reforça a ideia de que a predição de sobrevida não deve se basear em genes ou vias isoladas, mas sim na integração de informações de redes celulares para tomadas de decisão mais informadas na prática clínica (Pop et al., 2025).
Em síntese, a pesquisa demonstrou que a integração de dados transcriptômicos promoveu um ganho moderado na acurácia preditiva dos modelos de Random Survival Forest e Gradient Boosting Survival para a sobrevida de pacientes com LMA. Embora os índices C de Harrell e ROC-AUC tenham melhorado consistentemente com a inclusão dos componentes principais derivados dos dados moleculares, a capacidade preditiva ainda requer cautela para aplicação clínica isolada. Os resultados corroboram a importância das análises moleculares, mas indicam a necessidade de incorporar variáveis dinâmicas e realizar validação externa para aprimorar a eficácia e robustez dos modelos preditivos.
4. Conclusão
Este estudo objetivou quantificar o ganho de desempenho preditivo de modelos de aprendizado de máquina para a sobrevida de pacientes com leucemia mielóide aguda após a integração de dados clínicos e transcriptômicos. Inicialmente, verificou-se que modelos treinados apenas com dados clínicos apresentaram um desempenho preditivo moderado, com índices C de Harrell entre 0,674 e 0,681 e uma área sob a curva ROC média próxima de 0,70. Após a incorporação de variáveis transcriptômicas, observou-se uma melhora consistente nas métricas preditivas, com o índice C de Harrell aumentando para até 0,710 e a área sob a curva ROC média para até 0,746. Além disso, as predições demonstraram maior estabilidade temporal. A idade dos pacientes permaneceu como o fator preditivo mais importante, mas os componentes principais 10 e 12, derivados da análise transcriptômica, emergiram como contribuintes significativos, superando algumas variáveis clínicas.
A integração de dados transcriptômicos, portanto, promoveu um ganho moderado na acurácia dos modelos, oferecendo uma contribuição valiosa ao complementar a estratificação de risco existente para a LMA com informações moleculares. A análise de enriquecimento de conjunto de genes revelou que os componentes principais mais relevantes estavam associados a vias biológicas cruciais na carcinogênese, como a regulação do ciclo celular e a homeostase do colesterol, aprofundando a compreensão dos mecanismos subjacentes ao prognóstico. Contudo, a capacidade preditiva dos modelos, embora aprimorada, ainda requer cautela para aplicação clínica isolada, sugerindo que a incorporação de variáveis dinâmicas e a validação externa são essenciais para aumentar a robustez e a eficácia. Estudos futuros poderiam explorar a utilidade desses modelos para predições binárias de sobrevida em pontos de tempo clinicamente relevantes, como um ou cinco anos após o diagnóstico, e buscar uma coorte de validação para confirmar essas hipóteses.
Referências Bibliográficas
Bray, F.; Laversanne, M.; Sung, H.; Ferlay, J.; Siegel, R.L.; Soerjomataram, I.; Jemal, A. 2024. Global cancer statistics 2022: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA: A Cancer Journal for Clinicians 74(3): 229-263.
Dhakal, P.; Lakhotia, R.; Bhatt, V.R.; Giri, S. 2024. Improved overall survival in acute myeloid leukemia over the last 15 years. Journal of Clinical Oncology 42(16): 6543-6543.
Hanahan, D. 2022. Hallmarks of cancer: new dimensions. Cancer Discovery 12(1): 31-46.
Juliusson, G.; Hough, R. 2016. Leukemia. Progress in Tumor Research 43: 87-100.
Salman, M.Y.; Rowe, J.M.; Weigert, N. 2021. Inhibition of FLT3: a prototype for molecular targeted therapy in acute myeloid leukemia. Engineering 7(10): 1354-1368.
Siegel, R.L.; Miller, K.D.; Wagle, N.S.; Jemal, A. 2025. Cancer statistics, 2025. CA: A Cancer Journal for Clinicians 75(1): 10-45.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

