
24 de agosto de 2026
Modelo de Machine Learning para Predição de Ocupação em Pronto Socorro de Hospital Público no Brasil
Bruno Takeshi Aoyama; Tiago Almeida de Oliveira
DOI: 10.22167/2675-6528-202601823
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A gestão da capacidade hospitalar, especialmente no contexto do pronto socorro, apresentou um desafio relevante para hospitais públicos devido à elevada variabilidade da demanda e às restrições de recursos, com impacto na eficiência operacional e na segurança do paciente. Este estudo teve como objetivo desenvolver e avaliar modelos de aprendizado de máquina para prever faixas de criticidade da ocupação do pronto socorro de um hospital público brasileiro, com horizonte de 24 horas. Dados de prontuário eletrônico, coletados entre janeiro de 2023 e dezembro de 2025 (1.096 observações), foram utilizados. Seis algoritmos supervisionados foram avaliados, e o desempenho foi medido por acurácia balanceada, F1-score macro, correlação de Spearman e análise direcional dos erros. A análise identificou uma mudança estrutural no padrão operacional a partir de agosto de 2024, associada à abertura de leitos, que gerou heterogeneidade entre os conjuntos de treinamento e teste e limitou o desempenho preditivo. Os resultados foram moderados, com acurácias balanceadas entre 0,479 e 0,627. O modelo TabPFN destacou-se com o melhor desempenho (acurácia balanceada de 0,627) e a menor taxa de subestimação da criticidade (11,42%). A análise de importância de variáveis revelou o percentual de ocupação diária como principal preditor. Concluiu-se que modelos de aprendizado de máquina podem apoiar a gestão do pronto socorro, desde que aplicados em contextos estáveis e atualizados periodicamente, sendo a identificação da mudança estrutural a principal contribuição do estudo.
Palavras-chave: Gestão hospitalar; Modelagem preditiva; Ocupação hospitalar; Planejamento de capacidade; Segurança do paciente.
1. Introdução
A gestão da capacidade hospitalar, particularmente nos departamentos de pronto socorro, constitui um desafio crítico para hospitais públicos. Essa dificuldade decorre da elevada variabilidade da demanda assistencial e das restrições estruturais de recursos, fatores que podem impactar significativamente a eficiência operacional e a segurança do paciente (Friebel & Juarez, 2020; Garcia-Vicuña et al., 2023; Keegan, 2010; Ravaghi et al., 2020). Em um cenário de crescente complexidade dos sistemas de saúde, a previsão precisa e o planejamento estratégico da capacidade hospitalar têm recebido atenção cada vez maior de pesquisadores e administradores (Garcia-Vicuña et al., 2023; Grøntved et al., 2024).
Historicamente, a determinação da capacidade ideal de leitos tem sido abordada por meio de modelos matemáticos e de simulação. Essas abordagens baseiam-se em suposições específicas sobre parâmetros clínicos e operacionais (Devapriya et al., 2015; Ravaghi et al., 2020). Contudo, embora forneçam importantes bases teóricas, sua aplicação prática frequentemente encontra limitações, especialmente em ambientes de alta variabilidade e incerteza, como os hospitais públicos e de emergência (Costa et al., 2003; Ravaghi et al., 2020). A natureza dinâmica do fluxo de pacientes e da disponibilidade de recursos muitas vezes torna os modelos estáticos ou excessivamente dependentes de suposições menos eficazes em cenários reais.
Com o avanço das tecnologias de informação e o crescimento exponencial dos dados clínicos e administrativos, os métodos de Machine Learning (ML) surgiram como alternativas promissoras para a previsão da ocupação hospitalar (Askar et al., 2024). Essas técnicas são capazes de aprender padrões complexos a partir de grandes volumes de dados, sem a necessidade de hipóteses rígidas sobre distribuições probabilísticas. Isso permite que capturem relações não lineares entre diversas variáveis assistenciais e operacionais, oferecendo uma abordagem mais adaptativa para a previsão em ambientes de saúde (Askar et al., 2024; Barbieri et al., 2020; Rajula et al., 2020).
Vários estudos internacionais recentes demonstram o potencial dessas abordagens em contextos hospitalares reais. Sun et al. (2022), por exemplo, desenvolveram modelos preditivos para estimar riscos clínicos, enfatizando a importância de um desenvolvimento de modelo individualizado para hospitais específicos, a fim de garantir a eficácia preditiva. De forma semelhante, Choi et al. (2022) aplicaram técnicas de aprendizado supervisionado para prever a mortalidade intra-hospitalar, evidenciando sua utilidade no prognóstico de pacientes críticos. Peck et al. (2012) também demonstraram que modelos de previsão de admissões em pronto socorro podem auxiliar no gerenciamento de leitos, no cuidado de pacientes e nos processos de alta hospitalar.
Apesar desses avanços internacionais, a aplicação sistemática de modelos de Machine Learning em hospitais públicos brasileiros ainda é incipiente. Um número significativo de instituições enfrenta desafios substanciais relacionados à integração de diversas bases de dados, à qualidade das informações disponíveis e à escassez de ferramentas analíticas voltadas especificamente para a gestão operacional (Coelho De Soarez et al., 2022; Coelho Neto & Chioro, 2021; Mussi et al., 2023). Essa lacuna ressalta a necessidade crítica de pesquisa e desenvolvimento adaptados às complexidades singulares do sistema público de saúde brasileiro.
Nesse contexto, a utilização estratégica de algoritmos de Machine Learning representa uma valiosa oportunidade para aprimorar os processos decisórios e otimizar o uso de recursos no Sistema Único de Saúde (SUS) (dos Santos et al., 2019; Jatobá et al., 2025). Isso se alinha a um movimento mais amplo de transformação digital e aplicação de inteligência artificial em processos de gestão (Panteli et al., 2025; Xu et al., 2025). Ao fortalecer o corpo de evidências sobre a aplicabilidade de métodos de Machine Learning em ambientes hospitalares públicos, este estudo contribui para a modernização da gestão em saúde no SUS, visando uma alocação de recursos mais segura e uma melhoria da segurança do paciente.
O presente estudo aborda o desafio de prever os níveis de criticidade da ocupação de pacientes no setor de pronto socorro de um hospital público brasileiro. Esta pesquisa tem como objetivo desenvolver e avaliar modelos de Machine Learning para prever faixas de criticidade da ocupação do pronto socorro de um hospital público brasileiro, com um horizonte de previsão de 24 horas.
2. Material e Métodos
A pesquisa caracterizou-se como um estudo exploratório, de abordagem quantitativa, configurado como estudo de caso único, sem intervenção direta nos processos assistenciais. O ambiente de estudo foi o pronto socorro de um hospital público geral em São Paulo, Brasil, que opera exclusivamente no Sistema Único de Saúde (SUS). Os dados secundários foram extraídos do sistema de prontuário eletrônico da instituição, abrangendo 1.096 observações diárias entre janeiro de 2023 e dezembro de 2025. A unidade de análise correspondeu a cada dia do calendário, com o desfecho sendo a quantidade de pacientes internados à meia-noite, para previsões com horizonte de 24 horas.
O tratamento inicial dos dados envolveu etapas de limpeza, padronização e transformação, sem identificação de duplicidades ou valores ausentes. Variáveis quantitativas foram normalizadas por z-score, e as categóricas explicativas codificadas apropriadamente (Géron, 2019). A variável desfecho, representando a ocupação do pronto socorro, foi definida em três categorias ordinais de criticidade (Ocupação Normal, Ocupação Alta e Ocupação Altíssima), com limiares estabelecidos pela diretoria hospitalar com base em critérios operacionais e assistenciais (Seveso et al., 2020). As variáveis preditoras contemplaram múltiplas dimensões do fluxo assistencial e do contexto operacional.
A divisão dos dados em conjuntos de treinamento, validação e teste foi realizada cronologicamente, reservando os 20% finais da série para teste e os 80% anteriores para treinamento e validação (75%/25%), a fim de simular condições reais de uso e evitar vazamento de dados (Kaufman et al., 2012). O desbalanceamento das classes de criticidade foi tratado com o parâmetro class_weight=’balanced’ ou ajuste equivalente (Lemaître et al., 2017). Foram avaliados seis algoritmos de Machine Learning supervisionado: Decision Tree, Random Forest, XGBoost, LightGBM, Multilayer Perceptron e TabPFN (Grinsztajn et al., 2022; Hollmann et al., n.d.; Klug et al., 2020; Rajkomar et al., 2018; Razavian et al., 2015). Os hiperparâmetros foram definidos por ajuste guiado por conhecimento prévio, priorizando a regularização para generalização.
A avaliação dos modelos utilizou métricas complementares para classificação ordinal, incluindo acurácia balanceada, F1-score macro e coeficiente de correlação de Spearman (Cardoso & Sousa, 2011; Géron, 2019; Grandini et al., 2020). As proporções de acertos, superestimação e subestimação também foram calculadas para analisar a direção dos erros. A importância das variáveis foi investigada pela técnica de Permutation Importance (Khan et al., 2025), agnóstica ao modelo. A seleção final do modelo baseou-se no desempenho global, na preservação da hierarquia ordinal das classes de criticidade e na minimização da subestimação, considerando o impacto na segurança do paciente.
Os aspectos éticos foram considerados, e o estudo, por utilizar bancos de dados agregados e sem identificação individual, foi dispensado de registro e análise por Comitê de Ética em Pesquisa (CEP) e pela Comissão Nacional de Ética em Pesquisa (CONEP). Contudo, foram obtidos termos de autorização e compromisso para uso das informações e dos dados, devidamente assinados pelo responsável técnico da instituição hospitalar, assegurando a confidencialidade e o uso apropriado das informações coletadas para a pesquisa.
3. Resultados e Discussão
A análise dos resultados da pesquisa permitiu uma compreensão aprofundada da aplicabilidade de modelos de aprendizado de máquina na predição da ocupação em pronto socorro, revelando tanto o potencial quanto os desafios inerentes a este tipo de implementação em um hospital público brasileiro. Os achados destacam a importância de considerar o contexto operacional e as características dos dados para a seleção e avaliação dos modelos, especialmente em ambientes dinâmicos como o setor de emergência. A identificação de uma mudança estrutural no padrão de ocupação, por exemplo, demonstrou ser um fator crítico que influenciou diretamente o desempenho preditivo, sublinhando a necessidade de abordagens adaptativas na gestão hospitalar.
Os modelos avaliados, embora apresentassem acurácias moderadas, forneceram insights valiosos sobre a dinâmica de ocupação e os preditores mais relevantes. A discussão dos erros de predição, com foco na subestimação da criticidade, revelou a importância de métricas orientadas à segurança do paciente, indo além das avaliações de desempenho global. Esses elementos, em conjunto, contribuem para um entendimento mais robusto de como a inteligência artificial pode ser empregada para otimizar o planejamento de capacidade e a alocação de recursos em sistemas de saúde, conforme o problema de pesquisa proposto.
Análise preliminar da distribuição temporal do desfecho
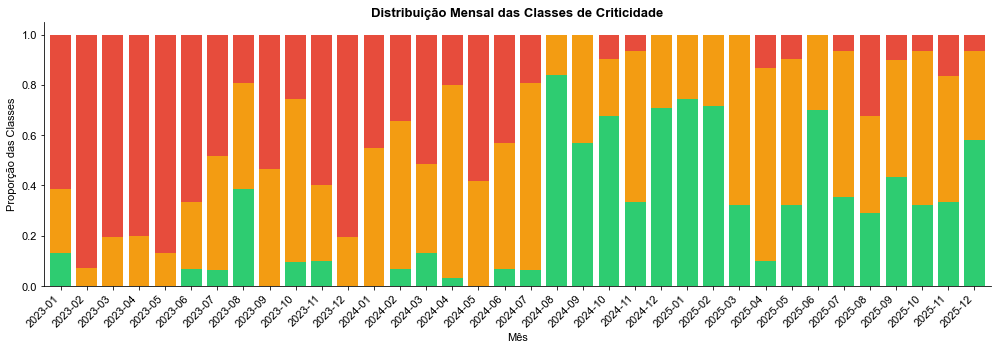
A análise exploratória da distribuição temporal das classes de criticidade da ocupação do pronto socorro revelou um achado empírico significativo: uma mudança estrutural no padrão operacional do hospital a partir de agosto de 2024. Até julho de 2024, a Classe 2, que representa a Ocupação Altíssima, predominava em vários meses, especialmente no segundo semestre de 2023 e início de 2024. Essa alta frequência indicava períodos de intensa pressão assistencial sobre a capacidade do pronto socorro, refletindo a complexidade da gestão de leitos em um ambiente de urgência e emergência.
A partir de agosto de 2024, observou-se uma redução abrupta e estável na frequência da Classe 2, que passou a representar menos de 15% dos dias nos meses subsequentes, com predomínio das Classes 0 (Ocupação Normal) e 1 (Ocupação Alta). Essa alteração, conforme discutido com a diretoria do hospital, foi associada à abertura de leitos adicionais em uma das unidades de internação, o que ampliou a capacidade instalada e redistribuiu o fluxo de pacientes que anteriormente permaneciam internados no pronto socorro. Tal fenômeno é crucial para a interpretação dos resultados preditivos, pois introduziu uma heterogeneidade substancial entre os conjuntos de treinamento e teste.
Figura 1. Distribuição mensal das classes de criticidade da ocupação do pronto socorro (jul. 2023 a dez 2025). Em verde está a classe 0, em amarelo está a classe 1 e em vermelho está a classe 2.
Fonte: Resultados originais da pesquisa
A Figura 1 ilustra claramente essa transição, mostrando a diminuição da proporção de dias na Classe 2 (vermelho) e o aumento das Classes 0 (verde) e 1 (amarelo) a partir de agosto de 2024. Essa não-estacionariedade da série temporal é um desafio reconhecido na literatura para a implantação de modelos preditivos em ambientes hospitalares reais, constituindo o principal fator limitante para o desempenho dos modelos neste estudo. A mudança estrutural impactou diretamente a validade preditiva dos modelos desenvolvidos em um regime operacional específico, reforçando a necessidade de monitoramento contínuo da estabilidade da distribuição do desfecho e de retreinamento periódico dos modelos em uso.
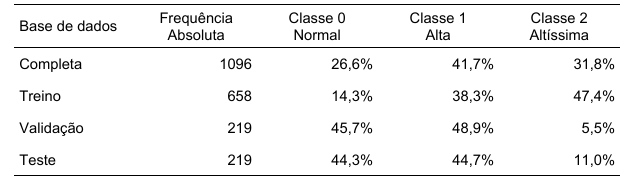
A distribuição das classes de criticidade na base completa e por conjunto de dados também evidenciou a extensão dessa heterogeneidade. Na base total, a Classe 2 representava 31,8% das observações, um valor próximo das demais classes. Contudo, no conjunto de treinamento, essa classe correspondia a 47,4% dos exemplos, refletindo sua concentração no período inicial da série. Em contraste, no conjunto de teste, a Classe 2 representava apenas 11,0% dos casos. Essa disparidade é fundamental para compreender as limitações e o desempenho dos modelos, uma vez que a capacidade de aprendizado foi baseada em uma distribuição de classes significativamente diferente daquela encontrada no período de avaliação.
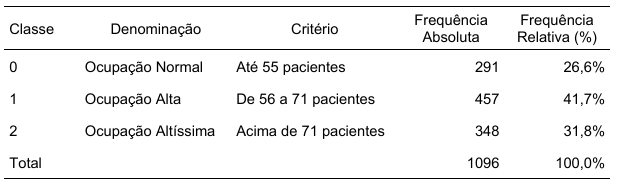
Tabela 1. Definição e distribuição das classes de criticidade da ocupação do pronto socorro
Fonte: Resultados originais da pesquisa.
A Tabela 1 detalha a definição das classes de criticidade, estabelecidas pela diretoria do hospital com base em critérios operacionais e assistenciais, e sua distribuição na base de dados completa. A Classe 0 (Ocupação Normal) abrange até 55 pacientes, a Classe 1 (Ocupação Alta) de 56 a 71 pacientes, e a Classe 2 (Ocupação Altíssima) acima de 71 pacientes. Essas categorias ordinais refletem níveis crescentes de pressão assistencial, sendo a Classe 2 um cenário de sobrecarga operacional com potencial impacto na segurança do paciente e no fluxo assistencial. Essa estrutura ordinal guiou as escolhas metodológicas, incluindo as métricas de avaliação e a interpretação dos erros de predição.
Tabela 2. Distribuição das classes de criticidade na base completa e por conjunto de dados
Fonte: Resultados originais da pesquisa.
A Tabela 2 demonstra a distribuição das classes de criticidade na base completa e nos conjuntos de treinamento, validação e teste. A Classe 2, que representava 31,8% na base completa, saltou para 47,4% no conjunto de treinamento e caiu drasticamente para 11,0% no conjunto de teste. Essa variação acentuada na representatividade da classe mais crítica entre os conjuntos de dados é um reflexo direto da mudança estrutural identificada, impactando a capacidade dos modelos de generalizar para o período mais recente e reforçando a natureza não-estacionária da série temporal.
Desempenho global dos modelos
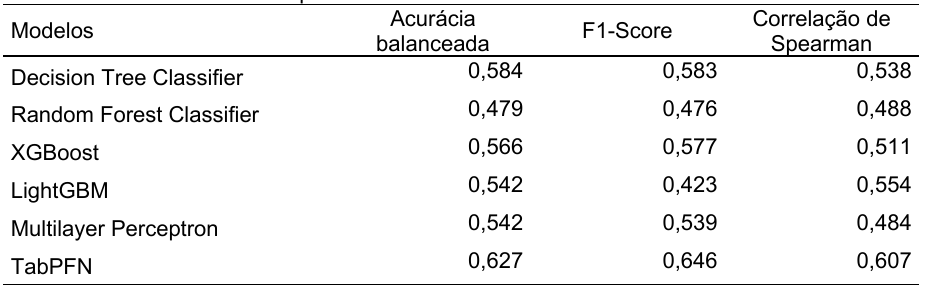
Foram avaliados seis algoritmos de aprendizado de máquina para prever a zona de criticidade da ocupação do pronto socorro com um horizonte de 24 horas, utilizando um total de 1.096 observações diárias. O desempenho global foi mensurado por meio da acurácia balanceada, do F1-score macro e da correlação de Spearman, conforme detalhado na Tabela 3. Essas métricas foram complementadas pela análise do percentual de acertos e do perfil direcional dos erros, apresentados na Tabela 4, para oferecer uma visão abrangente do comportamento de cada modelo.
Tabela 3. Métricas de desempenho dos modelos
Fonte: Resultados originais da pesquisa.
As acurácias balanceadas dos modelos variaram entre 0,479 e 0,627, valores que devem ser interpretados à luz da heterogeneidade entre os conjuntos de treinamento e teste previamente discutida. As correlações de Spearman, que oscilaram entre 0,484 e 0,607, indicam que os modelos conseguiram preservar, em diferentes graus, a ordenação das categorias de criticidade. Este é um aspecto crucial para a aplicação operacional, pois erros entre classes adjacentes têm um impacto assistencial menos severo do que erros entre classes extremas, garantindo que as previsões mantenham uma lógica hierárquica.
O TabPFN destacou-se como o modelo de melhor desempenho em todas as métricas avaliadas, registrando uma acurácia balanceada de 0,627, F1-score macro de 0,646 e correlação de Spearman de 0,607. Seu percentual de acertos foi de 69,86%. Esse resultado é consistente com as características arquiteturais do TabPFN, que, baseado em meta-aprendizado com prior sintético sobre datasets tabulares, demonstra maior robustez em cenários de dados limitados e distribuições variáveis entre treino e teste. A resiliência do TabPFN à mudança estrutural sugere que sua capacidade de generalização é menos dependente da distribuição específica das classes no conjunto de treinamento.
Tabela 4. Percentual de acertos dos modelos
| Modelos | Acurácia balanceada | F1-Score | Correlação de Spearman |
|---|---|---|---|
| Decision Tree Classifier | 0,584 | 0,583 | 0,538 |
| Random Forest Classifier | 0,479 | 0,476 | 0,488 |
| XGBoost | 0,566 | 0,577 | 0,511 |
| LightGBM | 0,542 | 0,423 | 0,554 |
| Multilayer Perceptron | 0,542 | 0,539 | 0,484 |
| TabPFN | 0,627 | 0,646 | 0,607 |
Fonte: Resultados originais da pesquisa.
O Random Forest Classifier apresentou o pior desempenho entre os seis modelos, com acurácia balanceada de 0,479 e uma taxa de subestimação de 29,68%. Esse resultado é explicado pela sensibilidade do algoritmo à distribuição de classes no treinamento. Tendo aprendido que a Classe 2 representava 47,4% dos exemplos no treino, o modelo tendeu a predizê-la com frequência desproporcional à sua real ocorrência no período de teste (11,0%), resultando em uma subestimação relativamente elevada. Isso evidencia que métricas globais de desempenho, sem análise direcional dos erros, podem ser enganosas neste contexto, justificando a adoção da acurácia balanceada como métrica principal.
Os modelos XGBoost, LightGBM e Multilayer Perceptron apresentaram desempenho intermediário, com acurácias balanceadas entre 0,542 e 0,566. A Decision Tree, por sua vez, mostrou um desempenho competitivo com acurácia balanceada de 0,584, superando modelos de maior complexidade computacional. Esse achado pode ser atribuído à sua estrutura mais simples, que reduz o risco de sobreajuste às particularidades da distribuição de classes do período de treinamento, tornando-a mais robusta em face da heterogeneidade dos dados. A análise comparativa ressalta a importância de considerar não apenas a acurácia, mas também a estabilidade e a capacidade de generalização dos modelos em cenários de dados reais e dinâmicos.
Análise de importância de variáveis
A análise de Permutation Importance revelou uma hierarquia consistente de importância entre os modelos avaliados, destacando preditores dominantes e grupos secundários com padrões clinicamente interpretáveis. Essa abordagem agnóstica ao modelo permitiu uma comparação direta da relevância das variáveis em uma escala comum, facilitando a interpretabilidade dos achados para gestores hospitalares. A consistência no ranking de importância entre algoritmos de naturezas distintas fortalece a validade dos resultados, reduzindo o risco de que as conclusões reflitam artefatos específicos de um algoritmo.
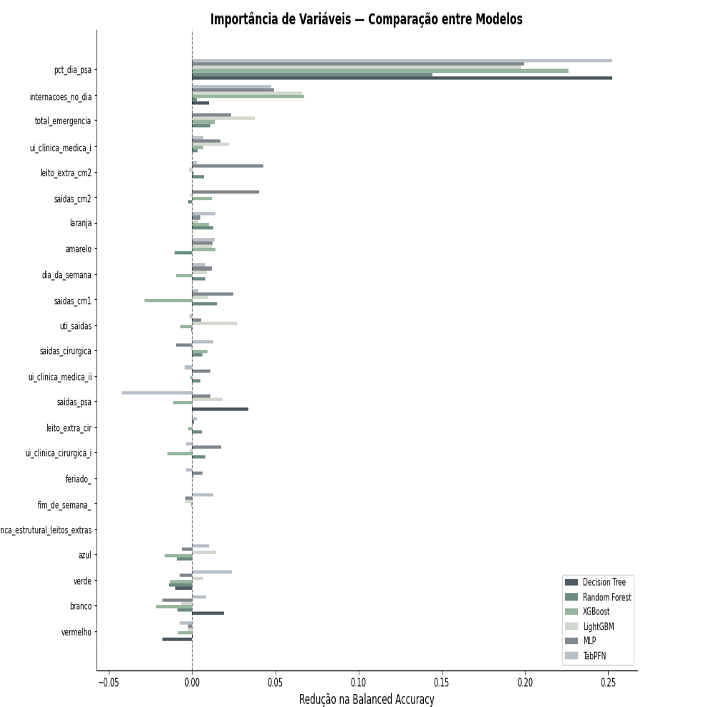
Figura 2. Importância de variáveis por Permutation Importance — comparação consolidada entre os seis modelos avaliados
Fonte: Resultados originais da pesquisa
A Figura 2 apresenta a importância das variáveis por Permutation Importance, consolidando a comparação entre os seis modelos. A variável pct_dia_psa, que representa o percentual de ocupação diária do pronto socorro, foi o preditor mais relevante em todos os modelos. Sua média geral de importância foi de 0,212, com valores individuais variando entre 0,145 (Random Forest) e 0,265 (TabPFN e Decision Tree). Essa consistência entre algoritmos de naturezas distintas confere alta confiabilidade ao resultado, indicando que o estado atual de ocupação do pronto socorro é o melhor preditor do estado nas próximas 24 horas, refletindo a inércia operacional característica de sistemas hospitalares.
Em segundo lugar, a variável internacoes_no_dia, que representa o total de internações originadas no pronto socorro no dia, apresentou uma média geral de importância de 0,041, com valores positivos em todos os modelos, variando entre 0,003 (Random Forest) e 0,067 (XGBoost e LightGBM). Essa variável captura a pressão de entrada no sistema: quanto maior o volume de novas internações, maior a tendência de elevação da ocupação no dia seguinte. Do ponto de vista da implantação operacional, esses achados indicam que a coleta e atualização em tempo real das variáveis de fluxo assistencial, especialmente a ocupação atual do pronto socorro e a disponibilidade de leitos nas unidades de internação, devem ser priorizadas para garantir a eficácia preditiva do modelo.
O terceiro grupo de preditores relevantes compreende variáveis de fluxo hospitalar sistêmico, como total_emergencia (média 0,014), ui_clinica_medica_i (0,009), leito_extra_cm2 (0,009) e saidas_cm2 (0,008). Esse conjunto de variáveis captura a capacidade das unidades de internação de absorver pacientes oriundos do pronto socorro, um gargalo sistêmico frequentemente subestimado em análises focadas exclusivamente no setor de emergência. A importância dessas variáveis, embora menor do que os dois preditores dominantes, é consistente entre os modelos e tem uma implicação gerencial direta: a ocupação do pronto socorro é um fenômeno sistêmico, não circunscrito apenas ao próprio setor de emergência.
As variáveis de classificação de risco Manchester — laranja (0,008), amarelo (0,007), azul (-0,001), verde (-0,002) e vermelho (-0,006) — apresentaram baixa importância, com valores negativos para três das cinco categorias. Isso indica que permutá-las não degrada, e em alguns casos melhora ligeiramente, o desempenho dos modelos. Esse resultado sugere que a composição de risco dos atendimentos do dia tem baixo poder preditivo sobre a ocupação do dia seguinte, o que é clinicamente plausível: a classificação de risco reflete a gravidade dos atendimentos ambulatoriais no momento da triagem, não necessariamente a demanda por internação nas 24 horas seguintes.
As variáveis de calendário, como dia_da_semana (0,005), fim_de_semana (0,001) e feriado (0,001), apresentaram importância marginal. Isso confirma que os padrões cíclicos semanais têm baixo poder preditivo neste hospital específico, possivelmente em razão do regime de porta aberta para urgências e emergências. A variável mudanca_estrutural_leitos_extras apresentou importância zero em todos os modelos, o que é um resultado esperado, dado que o modelo já captura a mudança estrutural implicitamente por meio das demais variáveis de fluxo, que refletem o novo regime operacional ao longo do tempo. A análise de importância de variáveis reforça a necessidade de focar em dados operacionais em tempo real para predições mais eficazes.
O desempenho dos modelos sob a ótica da gestão hospitalar
A interpretação dos resultados não pode se limitar às métricas agregadas de desempenho; é fundamental considerar o impacto operacional diferencial dos tipos de erro no contexto específico do pronto socorro. Em ambientes de urgência e emergência, a subestimação da criticidade representa o erro de maior risco assistencial. Prever uma ocupação menor do que a que efetivamente ocorrerá implica preparo insuficiente da instituição, com insuficiência de leitos disponíveis, atrasos na admissão de pacientes, sobrecarga das equipes assistenciais e comprometimento do fluxo interno. Esses fatores estão diretamente associados a desfechos clínicos desfavoráveis e riscos à segurança do paciente (Friebel & Juarez, 2020; Ravaghi et al., 2020).
A superestimação, embora implique mobilização preventiva desnecessária de recursos, produz efeitos menos deletérios do ponto de vista assistencial, sendo preferível em contextos de alta complexidade e variabilidade. Sob essa perspectiva, o TabPFN apresenta o perfil mais favorável entre os modelos avaliados. Além do melhor desempenho global, ele registra a menor taxa de subestimação (11,42%) e uma taxa de superestimação moderada (18,72%). Isso indica que o modelo antecipa cenários de maior criticidade com mais frequência do que os subestima, um comportamento desejável do ponto de vista da segurança assistencial.
O XGBoost, que foi o segundo melhor em acertos globais (64,38%), apresenta a segunda menor taxa de subestimação (15,07%), configurando-se como uma alternativa viável quando se busca equilíbrio entre acurácia global e um perfil conservador de erros. O Multilayer Perceptron, embora com acurácia balanceada modesta (0,542), registra a segunda menor taxa de subestimação entre todos os modelos (12,79%) e a maior taxa de superestimação (28,77%). Esse perfil ultraconservador pode ser adequado em contextos de alta aversão ao risco assistencial, desde que a instituição disponha de capacidade organizacional para responder a mobilizações preventivas frequentes.
O Random Forest e a Decision Tree apresentaram taxas de subestimação mais elevadas (29,68% e 22,83%, respectivamente), tornando-os menos recomendáveis para aplicação clínica direta neste cenário. É relevante destacar que essa análise direcional dos erros seria invisível com base apenas nas métricas tradicionais de acurácia, reforçando a relevância metodológica de incorporar a perspectiva operacional na avaliação de modelos preditivos em contextos hospitalares. Sob essa ótica, o TabPFN reúne as melhores características para aplicação neste cenário: maior acurácia global, menor subestimação e comportamento conservador moderado, compatível com as restrições operacionais de um hospital público de alta complexidade.
Análise das matrizes de confusão dos modelos TabPFN e XGBoost
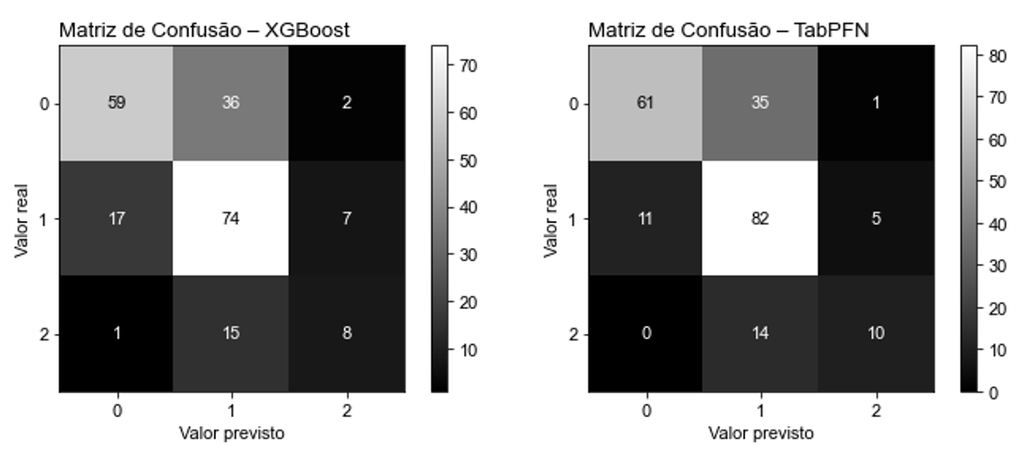
Considerando o desempenho global e o perfil direcional dos erros, os modelos TabPFN e XGBoost foram selecionados para uma análise detalhada das matrizes de confusão. O TabPFN foi escolhido por apresentar o melhor desempenho geral, enquanto o XGBoost representou o melhor modelo entre os algoritmos tradicionais, com maior acurácia balanceada e a segunda menor taxa de subestimação. A análise das matrizes de confusão evidencia padrões distintos entre os dois modelos, com implicações relevantes para sua aplicabilidade operacional, conforme ilustrado na Figura 3.
Figura 3. Matrizes de confusão dos modelos TabPFN (direita) e XGBoost (esquerda) no conjunto de teste
Fonte: Resultados originais da pesquisa
A Figura 3 apresenta as matrizes de confusão para os modelos TabPFN e XGBoost no conjunto de teste. O TabPFN demonstrou desempenho superior na identificação da Classe 1 (Ocupação Alta), com 82 acertos em 98 casos, resultando em uma taxa de acerto de 83,7%. Este é um resultado particularmente relevante, dado que essa classe representa 44,7% do conjunto de teste. Para a Classe 0 (Ocupação Normal), o modelo identificou corretamente 61 dos 97 casos (62,9%), classificando 35 como Classe 1 e apenas 1 como Classe 2. Para a Classe 2 (Ocupação Altíssima), o modelo acertou 10 dos 24 casos (41,7%), classificando 14 como Classe 1 e nenhum como Classe 0.
Esse último aspecto é clinicamente relevante: a ausência de subestimação severa, ou seja, a classificação de Ocupação Altíssima como Ocupação Normal, indica que o modelo não comete o erro de maior impacto assistencial. Todos os erros na Classe 2 restringiram-se à classe imediatamente adjacente, preservando a hierarquia ordinal do desfecho. Em comparação, o XGBoost apresentou um padrão similar na Classe 1, com 74 acertos em 98 casos (75,5%), mas desempenho inferior na Classe 0 (59 acertos em 97 casos, 60,8%) e na Classe 2 (8 acertos em 24 casos, 33,3%).
Para a Classe 2, o XGBoost classificou 15 casos como Classe 1 e apenas 1 como Classe 0, também preservando, em grande medida, a restrição de não cometer subestimações severas. Em comparação direta com o TabPFN, o XGBoost apresentou maior dispersão de erros na Classe 0, classificando 36 casos de Ocupação Normal como Ocupação Alta contra 35 do TabPFN, e 2 como Ocupação Altíssima contra apenas 1 do TabPFN. A dificuldade de ambos os modelos na identificação precisa da Classe 2 é esperada e diretamente explicada pela sua baixa representatividade no conjunto de teste (11,0% dos casos, equivalente a apenas 24 observações). Com tão poucos exemplos dessa classe para avaliação, qualquer estimativa de desempenho é inerentemente instável.
Esse achado reforça a recomendação de retreinamento periódico dos modelos à medida que novos dados do regime operacional atual se acumulem, permitindo representação mais equilibrada da Classe 2 no conjunto de treinamento e melhora esperada na sua identificação. Em síntese, o TabPFN demonstra superioridade não apenas nas métricas agregadas, mas também no padrão qualitativo dos erros: melhor identificação da classe mais frequente (Classe 1), ausência de subestimação severa na classe mais crítica (Classe 2) e maior concentração de acertos ao longo da diagonal principal. Esses atributos, combinados ao seu melhor desempenho global, fundamentam sua recomendação como modelo preferencial para apoio ao planejamento operacional do pronto socorro desta instituição.
Em suma, os resultados deste estudo evidenciam que, apesar da complexidade e da variabilidade inerentes ao ambiente de pronto socorro de um hospital público, modelos de aprendizado de máquina podem oferecer suporte valioso à gestão da capacidade. A identificação da mudança estrutural no padrão de ocupação e a análise direcional dos erros de predição foram cruciais para contextualizar o desempenho dos modelos e selecionar a abordagem mais adequada. O TabPFN, em particular, demonstrou maior robustez e um perfil de erros mais seguro, alinhando-se aos objetivos de otimização do planejamento assistencial e fortalecimento da segurança do paciente.
4. Conclusão
Este estudo avaliou a aplicabilidade de modelos de aprendizado de máquina na previsão da zona de criticidade da ocupação do pronto socorro de um hospital público geral, com horizonte de 24 horas. Verificou-se que, dos seis algoritmos supervisionados avaliados, o desempenho preditivo foi moderado, com acurácias balanceadas variando entre 0,479 e 0,627. O modelo TabPFN destacou-se com a melhor acurácia balanceada de 0,627 e a menor taxa de subestimação da criticidade, de 11,42%, um perfil de erro considerado mais seguro sob a ótica da gestão hospitalar. A análise de importância de variáveis identificou o percentual de ocupação diária do pronto socorro como o preditor mais relevante. Um achado empírico crucial foi a identificação de uma mudança estrutural no padrão operacional do hospital a partir de agosto de 2024, associada à abertura de leitos, que gerou heterogeneidade entre os conjuntos de treinamento e teste e limitou o desempenho preditivo dos modelos.
A principal contribuição deste estudo reside na identificação e análise da mudança estrutural no padrão de ocupação, evidenciando que a validade de modelos preditivos em saúde é intrinsecamente dependente da estabilidade do contexto operacional. Isso reforça a necessidade de monitoramento contínuo da distribuição do desfecho e de retreinamento periódico dos modelos diante de alterações na capacidade instalada. Como limitações, destaca-se a realização do estudo em um único hospital, o que restringe a generalização dos resultados, a heterogeneidade estrutural dos dados e o tamanho reduzido do conjunto de dados para classes menos frequentes. Sugere-se que estudos futuros explorem a aplicação em múltiplas instituições públicas, incorporem estratégias de retreinamento adaptativo, avaliem o desempenho em horizontes temporais mais longos e investiguem abordagens de aprendizado contínuo para atualização incremental dos modelos.
Referências Bibliográficas
Friebel, R., & Juarez, R. M. (2020). Spill Over Effects of Inpatient Bed Capacity on Accident and Emergency Performance in England. Health Policy, 124(11), 1182–1191. https://doi.org/10.1016/j.healthpol.2020.07.008
Garcia-Vicuña, D., López-Cheda, A., Jácome, M. A., & Mallor, F. (2023). Estimation of patient flow in hospitals using up-to-date data. Application to bed demand prediction during pandemic waves. PLoS ONE, 18(2 February). https://doi.org/10.1371/journal.pone.0282331
Keegan, A. D. (2010). Hospital bed occupancy: More than queuing for a bed. In Medical Journal of Australia (Vol. 193, Number 5, pp. 291–293). Australasian Medical Publishing Co. Ltd. https://doi.org/10.5694/j.1326-5377.2010.tb03910.x
Ravaghi, H., Alidoost, S., Mannion, R., & Bélorgeot, V. D. (2020). Models and methods for determining the optimal number of beds in hospitals and regions
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

