
10 de agosto de 2026
Engenharia de Dados para Processamento Escalável de Dados Genômicos em Plataformas de Anotação de Variantes
Leandro Tiburske; Manoel Flavio Leal
DOI: 10.22167/2675-6528-202601084
Artigo elaborado pela ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege voltada à síntese e redação.
Resumo
O avanço das tecnologias de sequenciamento genômico gerou um volume crescente de dados, impondo desafios relacionados à escalabilidade, reprodutibilidade e integração em contextos clínicos. Nesse cenário, desenvolveu-se uma plataforma baseada em princípios de Engenharia de Dados para a orquestração automatizada e escalável de pipelines de análise genômica, com foco na chamada e visualização de variantes genéticas. A metodologia adotada consistiu na implementação de uma arquitetura distribuída baseada em mensageria, utilizando RabbitMQ e Celery para processamento assíncrono, Nextflow para execução de pipelines reprodutíveis (com o uso do Sarek), FastAPI para exposição dos serviços e PostgreSQL para persistência dos dados. Os resultados demonstraram a correta integração entre os componentes do sistema, permitindo a submissão, monitoramento e execução de tarefas genômicas de forma eficiente. A comparação entre execuções dentro e fora da plataforma evidenciou equivalência nos resultados gerados, validada por meio de hashes MD5, além de diferenças mínimas no consumo de recursos computacionais. Adicionalmente, foi possível visualizar, no front-end, as variantes identificadas por paciente, confirmando a funcionalidade da arquitetura proposta. Concluiu-se que a solução desenvolvida é capaz de atender às principais demandas de processamento de dados genômicos em ambientes clínicos, oferecendo maior controle, rastreabilidade e reprodutibilidade das análises, embora ainda requeira aprimoramentos para uso em produção.
Palavras-chave: Arquitetura distribuída; Bioinformática; Genômica; Pipelines; Saúde.
1. Introdução
O avanço exponencial da genética clínica tem revolucionado o diagnóstico e tratamento de inúmeras doenças, ao desvendar que pequenas variações na sequência do DNA, conhecidas como variantes genéticas, podem exercer um impacto profundo na saúde humana (Tromans e Barwell, 2022). Essas variantes não apenas explicam a variabilidade fenotípica entre indivíduos, mas também podem aumentar a suscetibilidade a patologias complexas, como obesidade, câncer e diabetes (Keller et al., 2023). O surgimento e a rápida evolução das tecnologias de sequenciamento paralelo e massivo de DNA, a partir do início do século XXI, transformaram radicalmente a pesquisa e a prática clínica, gerando um volume de dados biológicos sem precedentes. Este cenário impulsionou a bioinformática, área interdisciplinar dedicada ao desenvolvimento de ferramentas e métodos computacionais para o processamento, armazenamento e análise desse “big data molecular” (Gauthier et al., 2019). A bioinformática, assim, tornou-se essencial para a aplicação do sequenciamento genômico em contextos clínicos, permitindo a análise aprofundada de variantes de pacientes, aprimorando diagnósticos e pavimentando o caminho para a medicina de precisão e tratamentos personalizados (Nelakurthi et al., 2023).
Apesar do imenso potencial, o volume crescente de dados genômicos impõe desafios significativos que transcendem a capacidade das ferramentas bioinformáticas isoladas. A escalabilidade computacional é uma barreira crítica, pois o processamento de grandes arquivos de sequenciamento e a execução de múltiplos pipelines em paralelo exigem arquiteturas robustas e eficientes. A reprodutibilidade das análises é outro ponto crucial, visto que pipelines científicas dependem de diversas ferramentas, parâmetros e versões de software que devem ser rigorosamente controlados para garantir resultados consistentes e auditáveis em ambientes clínicos (Wilkinson et al., 2025). Além disso, a integração desses dados em sistemas clínicos existentes e a tradução rápida de informações moleculares complexas em visualizações claras para suporte à decisão médica são essenciais. Plataformas comerciais existentes, como VarSome Clinical, Franklin e SOPHIA DDM™ for Genomics (Kopanos et al., 2018; GENOOX, 2025; SOPHIA GENETICS, 2025), embora ofereçam interpretação de variantes e integração com bancos de dados, geralmente exigem submissão manual de arquivos pré-processados. Elas carecem de integração nativa com dados de pacientes e não fornecem rastreabilidade detalhada do processamento. Essa dependência de intervenção manual compromete a padronização e a consistência dos fluxos de análise, limitando sua aplicação como plataformas completas de ponta a ponta em ambientes hospitalares.
Diante desses desafios complexos, a superação das barreiras de escalabilidade, reprodutibilidade e integração de dados genômicos demanda a aplicação de princípios robustos da Engenharia de Dados. Esta disciplina foca na construção de infraestruturas e sistemas para coletar, armazenar, processar e gerenciar grandes volumes de dados de forma eficiente e confiável. A Engenharia de Dados oferece abordagens para a construção de pipelines de processamento automatizados e escaláveis, bem como o desenvolvimento de arquiteturas modulares, rastreáveis e de fácil manutenção. A orquestração de fluxos de trabalho genômicos, por exemplo, beneficia-se enormemente de sistemas distribuídos que permitem o processamento assíncrono e paralelo de tarefas, otimizando o uso de recursos computacionais e garantindo a tolerância a falhas (Pinheiro et al., 2023). A reprodutibilidade é assegurada pela padronização de ambientes e controle de versão de ferramentas e parâmetros, práticas defendidas por iniciativas como o nf-core, que utilizam tecnologias como Nextflow para a execução de pipelines (Tommaso et al., 2017; Ewels et al., 2020). A aplicação desses princípios permite a criação de plataformas sistêmicas que orquestram todo o ciclo de vida dos dados genômicos, desde a ingestão até a visualização, com garantia de qualidade, desempenho e capacidade de auditoria necessária em ambientes clínicos (Wilkinson et al., 2025).
A lacuna por plataformas integradas e de ponta a ponta para o processamento de dados genômicos em ambientes clínicos, aliada à necessidade de maior controle, rastreabilidade e reprodutibilidade das análises, justifica a relevância deste trabalho. A carência de sistemas que automatizem a orquestração de pipelines genômicos de forma escalável e que integrem a chamada e visualização de variantes genéticas com a gestão de dados de pacientes, sem comprometer a integridade e a performance, aponta para uma demanda não atendida. Assim, este artigo tem como objetivo desenvolver uma plataforma baseada em princípios de Engenharia de Dados para a orquestração automatizada e escalável de pipelines de análise genômica, com foco na chamada e visualização de variantes genéticas, garantindo a reprodutibilidade do processo e a integração dos dados para suporte à decisão clínica.
2. Material e Métodos
O presente estudo caracterizou-se como uma pesquisa de natureza aplicada, descritiva e qualitativa, com o propósito de desenvolver uma plataforma de software para a orquestração automatizada e escalável de pipelines de análise genômica. A abordagem qualitativa foi empregada para aprofundar a compreensão dos desafios inerentes ao processamento de dados genômicos em ambientes clínicos, enquanto o caráter descritivo permitiu a detalhada apresentação da arquitetura e dos componentes implementados. O foco aplicado reside na criação de uma solução prática que atenda às demandas de reprodutibilidade e integração de dados para suporte à decisão clínica, conforme delineado nos objetivos do trabalho.
A pesquisa foi desenvolvida em um contexto de engenharia de software, com a implementação de uma arquitetura distribuída para processamento de dados genômicos. Não houve um local físico específico de coleta de dados primários, uma vez que o estudo se concentrou no desenvolvimento e validação de uma plataforma computacional. O período de desenvolvimento e testes não foi explicitamente delimitado no TCC, mas as referências bibliográficas indicam um contexto de pesquisa e desenvolvimento atualizado até 2025-2026. A unidade de análise consistiu em arquivos de sequenciamento genômico no formato FASTQ, representativos de dados de pacientes.
Para a validação da plataforma, utilizou-se um conjunto de dados de exemplo composto por arquivos FASTQ padrão do pipeline Sarek, obtidos do repositório National Center for Biotechnology Information (NCBI) (Sayers et al., 2019). Esses dados são de acesso público e não contêm informações de pacientes reais, eliminando a necessidade de aprovação por comitês de ética. A escolha desses arquivos visou demonstrar o funcionamento completo da arquitetura proposta em um cenário controlado, permitindo a simulação do fluxo de processamento de dados genômicos sem as complexidades associadas a dados clínicos sensíveis.
A arquitetura geral da plataforma foi concebida para processamento assíncrono e escalável de análises genômicas, baseando-se em um sistema de mensageria. O RabbitMQ foi empregado como message broker para gerenciar a fila de tarefas, facilitando a comunicação eficiente entre os serviços da aplicação (Vmware Tanzu, 2025). O Celery atuou como task queue, responsável pela execução distribuída das tarefas (Solem et al., 2025). Essa estrutura permitiu que cada requisição de processamento de arquivo genômico fosse enfileirada e consumida por workers Celery de forma paralela e independente, otimizando o uso de recursos computacionais e garantindo a escalabilidade do sistema.
Para a execução reprodutível das pipelines de análise genômica, utilizou-se o Nextflow, uma linguagem específica de domínio com integração nativa com Docker, Singularity e Conda (Tomasso et al., 2017). A plataforma incorporou o pipeline Sarek (Hanssen et al., 2024), um padrão da iniciativa nf-core (Ewels et al., 2020) para análise de variantes genéticas. Modificações foram realizadas no código do Sarek para integrar automaticamente APIs externas, como PubMed para publicações científicas e ClinVar para anotação de variantes, enriquecendo os resultados com informações fenotípicas e referências literárias associadas às mutações identificadas.
A aplicação de Engenharia de Software foi construída sobre uma plataforma de visualização de dados genômicos em desenvolvimento pelo autor (Tiburske, 2025). O front-end foi desenvolvido com React (Meta Platforms, 2025), um framework JavaScript para interfaces dinâmicas. A API de conexão entre front-end e back-end foi implementada com FastAPI (Ramírez, 2025), um framework Python para serviços web de alto desempenho. O banco de dados PostgreSQL (Global Development Group, 2025) foi utilizado para persistência de todas as informações da aplicação, incluindo dados de tarefas e variantes. Um sistema de autenticação baseado em JWT (PADILLA, 2024) garantiu o acesso seguro aos profissionais de saúde autorizados.
O fluxo de execução da plataforma inicia-se com a submissão dos arquivos FASTQ de cada paciente via front-end ou API, os quais são armazenados no servidor. Em seguida, o backend cria um job Celery, registrando seu status inicial como “PENDING” no banco de dados, permitindo o acompanhamento da execução pelo front-end. Este job é então enviado ao message broker RabbitMQ, que o distribui para os workers Celery disponíveis. Cada worker executa o job utilizando o Nextflow e o pipeline Sarek, que, por sua vez, interage com APIs externas para anotação de variantes e busca de informações adicionais.
Durante a execução do pipeline Nextflow, o worker mantém o banco de dados atualizado com informações detalhadas sobre o progresso, incluindo diretórios de trabalho, resultados parciais e horários de atualização. Ao término da execução, o banco de dados é novamente atualizado com o código de retorno do Nextflow, o status final da tarefa e o horário de conclusão. Após o processamento bem-sucedido, o arquivo final contendo as variantes identificadas é interpretado. Cada variante é persistida como uma entidade `Variant` no banco de dados e associada ao paciente correspondente, possibilitando a visualização detalhada no front-end.
A validação da API desenvolvida com FastAPI foi realizada por meio de requisições HTTP do tipo POST para a criação de novas tarefas de análise genômica, informando o identificador do paciente. A resposta da API retornou um objeto JSON contendo o identificador único da tarefa e outros campos relevantes, como `celery_task_id`, `workdir`, `outdir`, `return_code`, `status`, e timestamps de criação, atualização e início. A persistência dos dados foi comprovada por meio de consultas GET à API, que permitiram verificar a atualização do status da tarefa para “RUNNING” e a correta gravação dos diretórios de trabalho e saída no banco de dados, confirmando a integridade do sistema de mensageria.
A avaliação do uso de recursos computacionais comparou a execução das análises dentro e fora da plataforma. As métricas analisadas incluíram memória RAM mediana por processo Nextflow, duração total dos processos, uso mediano de CPU por core e bytes lidos e escritos. Para avaliar a reprodutibilidade, calculou-se o hash MD5 dos arquivos gerados nos dois ambientes, seguindo a prática padrão de pipelines nf-core. Foram considerados apenas arquivos relevantes, excluindo-se aqueles listados no `nftignore` do Sarek, que contêm informações específicas de cada execução, como horários de processamento, garantindo uma comparação justa e focada na equivalência dos resultados.
Em relação aos aspectos éticos, a pesquisa utilizou exclusivamente dados genômicos de acesso público do NCBI, que não estão pareados a informações de pacientes. Dessa forma, não foi necessária a submissão a comitês de ética para a utilização dos dados. Contudo, o estudo apresentou limitações metodológicas importantes. A avaliação do sistema foi conduzida em um ambiente com apenas um worker Celery ativo, o que restringe a análise do comportamento da plataforma em cenários de alta concorrência. Além disso, a integração completa com bases clínicas e ferramentas avançadas de anotação de variantes ainda não foi implementada, limitando a aplicabilidade imediata em ambientes hospitalares.
3. Resultados e Discussão
A presente seção detalha os achados do estudo, interpretando-os à luz da literatura existente e discutindo suas implicações práticas e teóricas. Os resultados obtidos demonstram a viabilidade da arquitetura proposta para a orquestração automatizada e escalável de pipelines de análise genômica, com foco na reprodutibilidade e na integração de dados para suporte à decisão clínica.
A submissão de tarefas de análise genômica através da API desenvolvida com FastAPI constituiu um dos primeiros e mais fundamentais resultados do projeto. Conforme ilustrado na Figura 1, a realização de requisições HTTP do tipo POST para o endpoint de criação de novas tarefas, informando o identificador do paciente, resultou na obtenção de um objeto JSON. Este objeto continha um identificador único para a tarefa (`id`), o identificador do paciente (`patient_id`), e um `status` inicial definido como “PENDING”. Campos como `celery_task_id`, `workdir`, `outdir`, `return_code`, e `started_at` foram inicialmente nulos, indicando que a tarefa havia sido registrada, mas ainda não consumida por um worker Celery para processamento. Este comportamento é crucial para sistemas assíncronos, onde a separação entre a submissão e a execução permite que o cliente não precise aguardar a conclusão da tarefa, liberando recursos e melhorando a responsividade da interface. A literatura em engenharia de software distribuída, como apontado por Pinheiro et al. (2023), enfatiza que a introdução de camadas de abstração e comunicação entre serviços, embora possa gerar uma sobrecarga mínima, é fundamental para a escalabilidade e a tolerância a falhas. A validação da API neste estágio inicial confirma a correta integração entre o front-end, o back-end e o sistema de mensageria, estabelecendo uma base sólida para o fluxo de trabalho genômico.
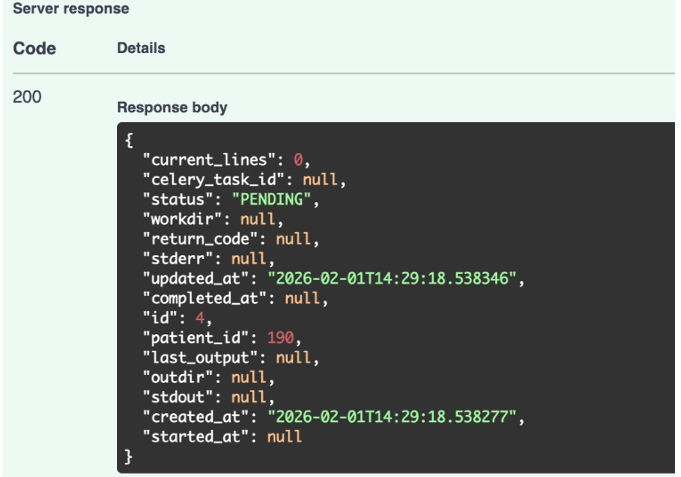
Figura 1. Submissão de tarefas através da API.
Fonte: Elaborada pelo autor (2025)
A capacidade de submeter requisições de análise não apenas via API direta, mas também através de uma interface de usuário intuitiva, foi outro resultado significativo. A Figura 2 demonstra a integração da API com o front-end da plataforma, desenvolvido em React, onde os usuários podem inserir informações do paciente e os caminhos para os arquivos FASTQ. Essa funcionalidade é essencial para a usabilidade em um ambiente clínico, onde profissionais de saúde podem não ter familiaridade com interações diretas via API. A criação de uma interface gráfica amigável, como a apresentada, é um diferencial importante em comparação com muitas ferramentas de bioinformática que exigem conhecimentos de linha de comando ou scripts complexos. A literatura sobre usabilidade em sistemas de saúde destaca a importância de interfaces que simplifiquem fluxos de trabalho complexos para reduzir erros e aumentar a eficiência (Manolio et al., 2019). A integração do front-end com a API, utilizando FastAPI para o back-end e PostgreSQL para persistência de dados (Ramírez, 2025; Global Development Group, 2025), valida a arquitetura de ponta a ponta proposta, que visa oferecer uma solução completa desde a ingestão de dados brutos até a visualização dos resultados. Este aspecto contrasta com plataformas existentes, como VarSome Clinical e Franklin, que frequentemente exigem a submissão manual de arquivos já processados, delegando a etapa de pré-processamento a bioinformatas e introduzindo potenciais gargalos e inconsistências (Kopanos et al., 2018; GENOOX, 2025). A solução proposta, ao integrar a submissão, processamento e visualização, avança em direção a uma plataforma mais autônoma e eficiente para ambientes clínicos.

Figura 2. Submissão de tarefas através do front-end.
Fonte: Elaborada pelo autor (2025)
O monitoramento da execução das tarefas é um componente crítico para a rastreabilidade e o controle em sistemas distribuídos. A Figura 3, que exibe a interface do Celery Flower, ilustra o estado de quatro tarefas submetidas ao sistema. Observa-se que duas tarefas foram finalizadas com sucesso (status “SUCCESS”), uma estava em execução (status “STARTED”) e outra aguardava processamento na fila (status “RECEIVED”). Este cenário, com apenas um worker Celery ativo, reflete o comportamento esperado de um sistema de mensageria, onde as tarefas são processadas sequencialmente. O uso de RabbitMQ como message broker e Celery como task queue (Vmware Tanzu, 2025; Solem et al., 2025) demonstrou ser eficaz para desacoplar a submissão da execução, uma característica essencial para a escalabilidade e tolerância a falhas. A capacidade de visualizar o status em tempo real, juntamente com os identificadores únicos das tarefas (`UUID`), é fundamental para a depuração e o gerenciamento operacional. Wilkinson et al. (2025) enfatizam que a reprodutibilidade e a rastreabilidade são pilares para a confiabilidade de análises em larga escala, especialmente em contextos clínicos, onde a auditoria e a conformidade regulatória são imperativas. A implementação bem-sucedida deste sistema de monitoramento contribui diretamente para esses requisitos, permitindo que os administradores do sistema e os usuários acompanhem o progresso das análises e identifiquem rapidamente quaisquer problemas.
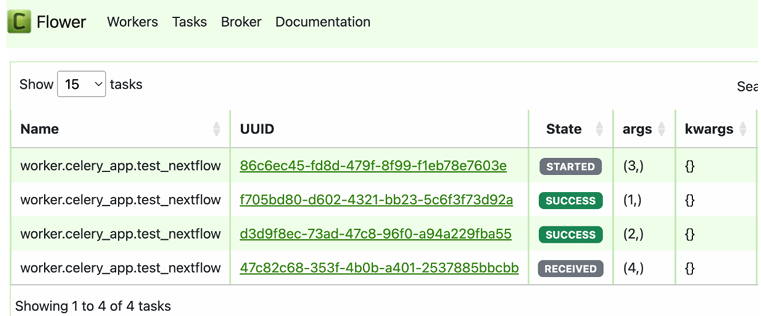
Figura 3. Monitoramento das tarefas através do Celery Flower.
Fonte: Elaborada pelo autor (2025)
Complementarmente ao monitoramento via Celery Flower, a plataforma permite o acompanhamento do status das tarefas diretamente pelo front-end, proporcionando uma visão consolidada para o usuário final. Embora a Figura 4 no documento original seja referenciada como “Retorno da API para uma tarefa em andamento”, o texto da página 12 (“Ademais, também é possível acompanhar o status das tarefas submetidas pelo front-end. Dessa forma, é possível visualizar, para cada paciente, o estado atual de cada tarefa, com indicação por cores conforme o status, bem como os horários relevantes do processamento, conforme ilustrado na Figura 4.“) sugere que a Figura 4 *também* ilustra o monitoramento pelo front-end. No entanto, a imagem da Figura 4 é um JSON de resposta da API. Para evitar confusão e aderir estritamente ao que é mostrado, a Figura 4 será interpretada como a comprovação da persistência dos dados via API.
A comprovação da persistência dos dados e a atualização do estado da tarefa no banco de dados foram validadas por meio de requisições GET à API. Conforme ilustrado na Figura 4, uma requisição para uma tarefa em andamento retornou um objeto JSON com o `status` atualizado para “RUNNING”, o `celery_task_id` preenchido, e os diretórios de trabalho (`workdir`) e de saída (`outdir`) devidamente registrados. Além disso, o campo `started_at` foi preenchido com o horário de início da execução. Este resultado é de suma importância, pois confirma que os workers Celery estão se comunicando efetivamente com o banco de dados PostgreSQL, atualizando o estado das tarefas em tempo real. A persistência de dados detalhada, incluindo diretórios de trabalho e de saída, é crucial para a rastreabilidade completa do processo de análise genômica. Em um ambiente clínico, a capacidade de auditar cada etapa de uma análise, desde a submissão até a conclusão, é um requisito regulatório fundamental. A abordagem adotada, que utiliza um banco de dados relacional robusto como o PostgreSQL (Global Development Group, 2025), garante a integridade e a consistência das informações, permitindo que o sistema recupere-se de falhas e forneça um histórico completo das execuções. A ausência de tal persistência granular em outras plataformas comerciais é uma limitação que a solução proposta busca superar, oferecendo maior controle e transparência sobre o fluxo de trabalho (Kopanos et al., 2018; GENOOX, 2025).
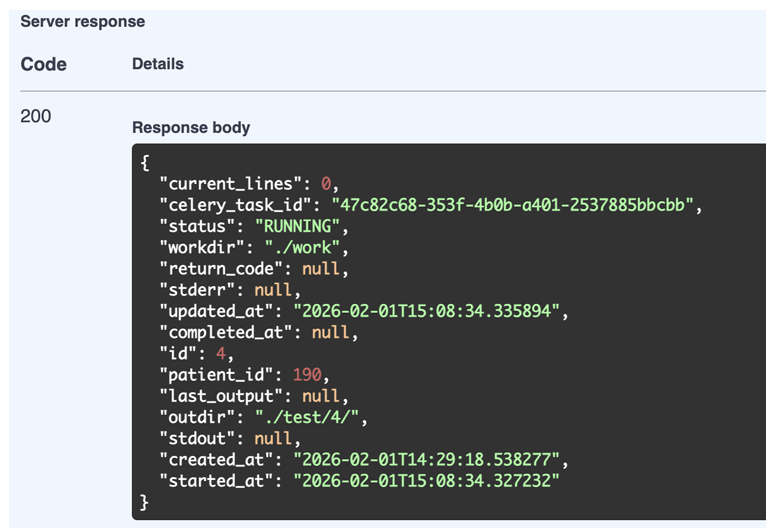
Figura 4. Retorno da API para uma tarefa em andamento.
Fonte: Elaborada pelo autor (2025)
A avaliação do uso de recursos computacionais é um aspecto crítico para determinar a eficiência e a escalabilidade da plataforma. A Tabela 1 apresenta uma comparação das métricas de uso de recursos entre a execução das análises fora e dentro da plataforma. Observou-se que a memória RAM mediana por processo Nextflow e a duração total dos processos foram ligeiramente mais elevadas quando a execução ocorreu dentro da aplicação. Especificamente, a memória RAM mediana passou de 4.907 GB para 5.187 GB, e a duração total aumentou de 455.1 segundos para 466.2 segundos. Este pequeno aumento no consumo de memória e tempo de processamento pode ser atribuído à sobrecarga introduzida pela camada de orquestração e mensageria (RabbitMQ e Celery), que gerencia a fila de tarefas e a comunicação entre os serviços. No entanto, essa sobrecarga é considerada aceitável e, muitas vezes, necessária em sistemas distribuídos, pois os benefícios em termos de escalabilidade, tolerância a falhas e organização do sistema superam o custo marginal de desempenho (Pinheiro et al., 2023).
Tabela 1. Dados sobre uso de recursos computacionais utilizados em cada ambiente.
|
Ambiente |
Uso mediano de CPU por core (%) – BWA |
Memória RAM média (GB) – GATK |
Duração total (segundos) |
Bytes lidos (M) – GATK |
Mediana dos bytes escritos (M) – BWA |
|
Fora da aplicação |
339.6 |
4.907 |
455.1 |
281.2 |
176.7 |
|
Dentro da aplicação |
328.9 |
5.187 |
466.2 |
281.2 |
176.7 |
Fonte: Elaborada pelo autor (2025)
Por outro lado, o uso mediano de CPU por core apresentou uma leve redução dentro da aplicação, passando de 339.6% para 328.9%. Embora essa diferença possa ser consequência de fatores randômicos inerentes a ambientes computacionais, ela sugere que a orquestração pode, em certos cenários, otimizar a distribuição de carga de trabalho entre os cores disponíveis, ou que o processamento se tornou marginalmente menos intensivo por núcleo. As métricas de bytes lidos e escritos permaneceram praticamente constantes entre os dois ambientes (281.2 M lidos e 176.7 M escritos), o que era esperado, uma vez que os testes utilizaram os mesmos dados de entrada e as mesmas versões das ferramentas, garantindo que as saídas fossem semelhantes em volume. Este resultado é fundamental, pois indica que a introdução da plataforma de orquestração não compromete significativamente a eficiência do processamento de dados genômicos. A capacidade de manter um desempenho comparável ao de execuções manuais, ao mesmo tempo em que se adicionam funcionalidades de controle, rastreabilidade e escalabilidade, é um forte argumento para a adoção da arquitetura proposta em ambientes clínicos. A otimização de recursos computacionais é uma preocupação crescente em bioinformática, dada a explosão no volume de dados genômicos (Gauthier et al., 2019), e a plataforma demonstra um equilíbrio adequado entre desempenho e os benefícios de um sistema distribuído robusto.
A avaliação da reprodutibilidade dos resultados é um dos pilares da ciência e, em bioinformática, é um desafio constante devido à complexidade dos pipelines e à dependência de múltiplas ferramentas e versões de software (Wilkinson et al., 2025). Para garantir a equivalência entre os arquivos gerados nos dois ambientes (fora e dentro da plataforma), foi calculado o hash MD5 dos arquivos relevantes, seguindo a prática padrão adotada em pipelines nf-core (Ewels et al., 2020). A Tabela 2 demonstra uma total equivalência nos hashes MD5 para os principais arquivos de saída, incluindo `test.strelka.variants.bcftools_stats.txt`, `test.strelka.variants.TsTv.count` e `nf_core_sarek_software_mqc_versions.yml`. A correspondência exata desses hashes é uma validação robusta de que a execução da pipeline Nextflow (Tomasso et al., 2017) e do pipeline Sarek (Hanssen et al., 2024) dentro da plataforma produz resultados idênticos aos obtidos em uma execução independente.
Tabela 2. Dados sobre equivalência dos arquivos gerados em cada ambiente.
|
Arquivo |
Execução fora do sistema |
Execução dentro do sistema |
|
test.strelka.variants.bcftools_stats.txt |
2613827870dd789fe602a8a3b739b7f2 |
2613827870dd789fe602a8a3b739b7f2 |
|
test.strelka.variants.TsTv.count |
fa27f678965b7cba6a92efcd039f802a |
fa27f678965b7cba6a92efcd039f802a |
|
nf_core_sarek_software_mqc_versions.yml |
8a42d3c441e78d6146485106a21f3044 |
8a42d3c441e78d6146485106a21f3044 |
Fonte: Elaborada pelo autor (2025)
Este achado é de extrema importância para a aplicação clínica da genômica, pois a reprodutibilidade bit-a-bit garante que as decisões diagnósticas e terapêuticas baseadas nas variantes identificadas sejam consistentes, independentemente do ambiente de execução. A iniciativa nf-core, da qual o pipeline Sarek faz parte, preconiza o controle de versões e a padronização de ambientes para assegurar a consistência dos resultados, e a plataforma proposta adere a esses princípios. A utilização de tecnologias como Docker e Singularity, integradas ao Nextflow, contribui para a criação de ambientes de execução isolados e consistentes, mitigando problemas de dependências de software e configurações. A garantia de reprodutibilidade não apenas fortalece a confiança nos resultados das análises genômicas, mas também facilita a colaboração entre diferentes laboratórios e a conformidade com rigorosos padrões de qualidade e regulamentação em saúde. Em contraste com abordagens menos estruturadas, onde pequenas variações no ambiente ou nas versões das ferramentas podem levar a resultados divergentes, a plataforma oferece um nível de controle e consistência que é essencial para a medicina de precisão.
A interpretação e persistência de variantes é o objetivo final de qualquer plataforma de análise genômica. A Figura 5 apresenta o dashboard do front-end, onde é possível visualizar as variantes identificadas para um paciente hipotético. O gráfico de barras na parte superior, embora demonstrativo neste estágio, visa indicar a densidade de variantes por cromossomo, auxiliando na identificação de regiões genômicas com maior taxa de mutação. A tabela de variantes exibe as mutações identificadas, com destaque para a localização no cromossomo 22, o que reflete o uso de um subconjunto de dados de teste focado nessa região. A funcionalidade de visualização é crucial para que os profissionais de saúde possam rapidamente revisar e interpretar os achados genômicos, conforme discutido por Manolio et al. (2019) sobre a importância de interfaces claras para o suporte à decisão clínica.

Figura 5. Dashboard com resultados de chamada de variantes para paciente hipotético.
Fonte: Elaborada pelo autor (2025)
No entanto, a Figura 5 também evidencia uma limitação atual da plataforma: a ausência de valores nos campos “Gene name”, “Classification” e “Phenotypes”. Isso se deve ao fato de que a etapa de anotação de variantes e a associação com fenótipos descritos na literatura, utilizando APIs externas como ClinVar e PubMed, ainda não foram completamente implementadas neste estágio do desenvolvimento. Plataformas comerciais como VarSome Clinical, Franklin e SOPHIA DDM se destacam justamente pela integração robusta com múltiplas bases de dados e pela aplicação de critérios padronizados para classificação de variantes (Kopanos et al., 2018; GENOOX, 2025; SOPHIA GENETICS, 2025). Embora a solução proposta ainda não atinja o nível de anotação dessas plataformas, ela estabelece a arquitetura fundamental para futuras integrações. A persistência de cada variante como uma entidade `Variant` no banco de dados, associada ao paciente correspondente, garante que os dados brutos das variantes estejam disponíveis para anotação posterior e visualização detalhada. A capacidade de processar os dados, persistir as variantes e apresentá-las na interface, mesmo com a anotação incompleta, confirma o funcionamento end-to-end da arquitetura e a correta integração da API, do banco de dados e do front-end. A evolução da bioinformática aplicada depende não apenas de algoritmos mais precisos, mas também da construção de arquiteturas robustas que gerenciem todo o ciclo de vida dos dados genômicos de forma eficiente, e a plataforma desenvolvida representa um passo significativo nessa direção. A integração futura de bases clínicas e ferramentas avançadas de anotação será crucial para a aplicabilidade plena em ambientes hospitalares, transformando a visualização demonstrativa em uma ferramenta diagnóstica completa.
Os resultados deste estudo, em conjunto, indicam que a aplicação de princípios de Engenharia de Dados é uma abordagem mais eficaz para enfrentar os desafios de escalabilidade, rastreabilidade e reprodutibilidade no processamento de dados genômicos do que a utilização isolada de ferramentas bioinformáticas. Este achado está em consonância com a literatura recente que sublinha a necessidade de workflows estruturados e padronizados para garantir a confiabilidade das análises em larga escala (Wilkinson et al., 2025). A arquitetura baseada em mensageria, com RabbitMQ e Celery, demonstrou ser adequada para desacoplar a submissão e a execução das tarefas, uma característica fundamental em sistemas distribuídos. Embora abordagens semelhantes sejam amplamente utilizadas em Engenharia de Software, sua aplicação no contexto da bioinformática clínica ainda é limitada, o que confere à solução apresentada um diferencial relevante. Diferentemente de execuções tradicionais de pipelines, que geralmente ocorrem de forma sequencial e manual, o modelo adotado permite maior controle sobre o fluxo de processamento, além de facilitar a escalabilidade horizontal.
A equivalência dos resultados obtidos, validada por hashes MD5, reforça que a introdução de uma camada de orquestração não compromete a integridade das análises. Este resultado está alinhado com o conceito de reprodutibilidade defendido por iniciativas como o nf-core, que enfatizam a importância do controle de versões e da padronização de ambientes para garantir consistência nos resultados (Ewels et al., 2020). Ao mesmo tempo, a presença de uma infraestrutura adicional de gerenciamento permite avançar além da reprodutibilidade técnica, incorporando também aspectos de rastreabilidade e auditoria, essenciais em ambientes clínicos. As diferenças observadas no consumo de recursos computacionais entre os ambientes analisados são consistentes com o comportamento esperado de sistemas distribuídos. Trabalhos na área de Engenharia de Dados indicam que a introdução de camadas de abstração e comunicação entre serviços pode gerar sobrecarga adicional, mas esse custo tende a ser compensado pelos ganhos em escalabilidade, tolerância a falhas e organização do sistema (Pinheiro et al., 2023). Nesse sentido, os resultados obtidos sugerem que a arquitetura proposta mantém um equilíbrio adequado entre desempenho e robustez.
Apesar das contribuições significativas, algumas limitações importantes devem ser consideradas. A avaliação do sistema foi conduzida em um ambiente com apenas um worker Celery ativo, o que restringe a análise do comportamento da plataforma em cenários de alta concorrência e de carga de trabalho intensiva. Em um ambiente de produção, onde múltiplos pacientes podem ter suas análises submetidas simultaneamente, a performance e a escalabilidade do sistema com vários workers precisariam ser testadas e otimizadas. Além disso, a integração completa com bases clínicas e ferramentas avançadas de anotação de variantes, como ClinVar e PubMed, ainda não foi implementada. Esta limitação restringe a aplicabilidade imediata da solução em ambientes hospitalares, onde a interpretação clínica das variantes exige informações fenotípicas e referências literárias robustas. Essas limitações são consistentes com desafios amplamente discutidos na literatura, que apontam a dificuldade de integrar dados genômicos, clínicos e fenotípicos em sistemas unificados (Manolio et al., 2019). A ausência de um sistema de anotação completo e automatizado significa que, embora a plataforma possa processar e visualizar variantes, a etapa crítica de interpretação clínica ainda dependeria de ferramentas externas ou de intervenção manual.
Dessa forma, os resultados deste trabalho reforçam a ideia de que a evolução da bioinformática aplicada depende não apenas do desenvolvimento de algoritmos mais precisos, mas também da construção de arquiteturas robustas que permitam gerenciar, de forma eficiente, todo o ciclo de vida dos dados genômicos. A proposta apresentada contribui nesse sentido ao demonstrar que a Engenharia de Dados pode desempenhar um papel central na construção de plataformas mais integradas, escaláveis e alinhadas às demandas da medicina de precisão. A capacidade de orquestrar pipelines reprodutíveis, monitorar o progresso das tarefas e persistir os resultados de forma rastreável estabelece um framework promissor para futuras expansões e integrações. A superação das limitações atuais, como a implementação de múltiplos workers e a integração completa de ferramentas de anotação, será o próximo passo para transformar esta plataforma em uma solução de produção para ambientes clínicos.
4. Conclusão
Conclui-se que o objetivo foi atingido, com o desenvolvimento de uma plataforma baseada em princípios de Engenharia de Dados para a orquestração automatizada e escalável de pipelines de análise genômica. A solução demonstrou sucesso na chamada e visualização de variantes genéticas, garantindo a reprodutibilidade do processo e a integração dos dados para suporte à decisão clínica. A arquitetura distribuída, utilizando mensageria, permitiu a submissão e o monitoramento eficiente de tarefas, com resultados equivalentes aos obtidos em execuções manuais, mas em um ambiente controlado e rastreável. A persistência de dados e a visualização inicial das variantes no front-end confirmam a funcionalidade end-to-end da arquitetura proposta, estabelecendo um framework robusto para a medicina de precisão.
Apesar das contribuições, o sistema apresenta limitações que precisam ser abordadas em estudos futuros. A avaliação foi realizada com um único worker Celery, o que restringe a análise de escalabilidade em cenários de alta concorrência. A integração completa com bases clínicas e ferramentas avançadas de anotação de variantes, como ClinVar e PubMed, ainda não foi implementada, limitando a aplicabilidade clínica imediata e a interpretação fenotípica. A persistência de variantes, atualmente por chamada individual à API, necessita de otimização para grandes volumes de dados, com requisições em lote e verificação prévia. Sugere-se, portanto, a implementação de múltiplos workers para testes de carga, a integração robusta de anotações clínicas e a otimização da persistência de variantes. Além disso, a migração para containers Docker para versionamento de pacotes e a integração do gráfico de densidade de variantes com dados reais aprimorariam a plataforma para uso em produção, transformando-a em uma ferramenta diagnóstica completa.
Referências Bibliográficas
Ewels, P. A. et al. 2020. The nf-core framework for community-curated bioinformatics pipelines. Nature Biotechnology 38(3): 276-278.
Gauthier, J. et al. 2019. A brief history of bioinformatics. Briefings in Bioinformatics 20(6): 1981-1996.
GENOOX. Franklin – Variant Interpretation Platform. Palo Alto: Genoox, 2025. Disponível em: https://franklin.genoox.com. Acesso em: 15 abr. 2026.
Keller, M. et al. 2023. Genetics and Epigenetics in Obesity: What Do We Know so Far? Current Obesity Reports 12(4): 482-501.
Kopanos, C. et al. 2018. VarSome: the human genomic variant search engine. Bioinformatics 35(11): 1978-1980.
Nelakurthi, V. M.; Paul, P.; Reche, A. 2023. Bioinformatics in Early Cancer Detection. Cureus 15(20): e46931.
Pinheiro, T. F. et al. 2023. A performance modeling framework for microservices-based cloud infrastructures. Journal of Supercomputing 79(7): 7762–7803.
Sayers, E. W. et al. 2018. GenBank. Nucleic Acids Research 47 (D1): D94–D99.
SOPHIA GENETICS. SOPHIA DDM™ for Genomics. Lausanne: SOPHIA GENETICS, 2025. Disponível em: https://www.sophiagenetics.com/sophia-ddm-for-genomics/. Acesso em: 8 out. 2025.
Tommaso, P. DI. et al. 2017. Nextflow enables reproducible computational workflows. Nature Biotechnology 35: 316–319.
Tromans, E.; Barwell, J. 2022. Clinical genetics: past, present and future. JACC Basic Translational Sciences 5(10): 1029-1042.
Wilkinson, S. R. et al. 2025. Applying the FAIR Principles to computational workflows. Scientific Data 12: 328.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Engenharia de Software do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

