
13 de octubre de 2026
Delineo: Adaptación de modelo de difusión para prototipado de interfaz de usuario guiado por boceto
Matheus Mendes Silva; Edilson José Rodrigues
DOI: 10.22167/2675-6528-202603291
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
La evolución de la inteligencia artificial y de las redes neuronales profundas ha revolucionado las interacciones humano-máquina, pero la prototipación de interfaces de usuario con modelos generativos enfrenta desafíos críticos en la preservación de la estructura espacial idealizada. Para solucionar esta divergencia, se adaptó un modelo de difusión latente condicionada, integrando una arquitectura de control a un modelo a gran escala ajustado específicamente para interfaces móviles. El enfoque utilizó bocetos de interfaces de usuario para guiar la inferencia de las imágenes. La viabilidad del método fue validada mediante evaluación cuantitativa automatizada y análisis cualitativo realizado con un grupo de expertos de la industria. Los resultados confirmaron que el método superó las capacidades del modelo original, pero la evaluación evidenció degradación estética y pérdida de elementos funcionales en la estructuración lógica de la interfaz. Se concluyó que, si bien la tecnología demuestra viabilidad técnica para optimizar la transición entre requisitos y la implementación de código, la automatización de procesos creativos aún demanda mejoras arquitectónicas para alcanzar el rigor visual exigido por la industria del desarrollo de software.
Palabras clave: adaptación de bajo rango; aprendizaje automático; difusión latente condicionada; redes neuronales profundas.
1. Introducción
El proceso de desarrollo de software atraviesa cambios constantes, evolucionando para satisfacer el ritmo acelerado de la industria. Una parte fundamental de este ciclo es la creación de prototipos de interfaz de usuario, que define el recorrido del cliente y permite la validación de los requisitos antes de la implementación (Al-Saqqa et al., 2020). Esta etapa presenta una gran apertura para la exploración de metodologías basadas en inteligencia artificial (IA), pudiendo potenciar el proceso creativo y el aumento de la productividad.
La industria moderna busca desarrollar sistemas inteligentes e interactivos, tanto máquina-a-máquina como humano-máquina, impulsando la automatización de tareas y procesos realizados por humanos (Ismail y Hassan, 2019). Siguiendo esta tendencia, las inversiones globales en IA han presentado un crecimiento notable, especialmente en países como Estados Unidos, China y Reino Unido. En el sector corporativo, la adopción también crece rápidamente: el 78% de las organizaciones reportaron el uso de IA, de acuerdo con el AI Index Report 2025 de la Universidad de Stanford (HAI, 2025). En este contexto, diversos estudios exploran la utilización de inteligencia artificial generativa (GenAI) para automatizar etapas del ciclo de desarrollo de software, incluyendo la creación de documentación, producción de código, automatización de pruebas, e incluso la creación de agentes para auxiliar en la revisión de código y en la elaboración de arquitectura de sistemas digitales (Beltramelli, 2018; He et al., 2025; Wan et al., 2025; Wang et al., 2024).
La mayor parte de los estudios publicados se centra en la producción de código, generado a partir de especificaciones textuales o imágenes de interfaz de usuario (UI), frecuentemente elaboradas por equipos dedicados al proceso de diseño. En contraste con los estudios supracitados, el presente trabajo se centra en la etapa de concepción visual de UI. Este proceso precede a ambas rutas de desarrollo, ya sea por codificación manual, ya sea por generación de código con herramientas automatizadas, sirviendo como cimiento para todo el desarrollo de software subsiguiente (Lauff et al., 2018). Sin embargo, la aplicación de estas tecnologías para la prototipación de interfaces de usuario, además de poco explorada, enfrenta desafíos críticos, dado que los modelos generativos frecuentemente fallan en respetar la estructura espacial idealizada.
Los modelos de redes neuronales profundas se utilizan ampliamente para actividades que requieren capacidad generativa. Los modelos de difusión latente (LDM), una de las variantes de modelos de texto a imagen (T2I), destacan por presentar un rendimiento comparable al estado del arte y una mayor eficiencia computacional (Rombach et al., 2022). Aunque los modelos T2I son herramientas potentes para la generación de imágenes, la entrada textual desempeña un papel fundamental en los resultados obtenidos, y esta arquitectura puede generar resultados imprecisos e inestables al no permitir un mayor control del usuario sobre las imágenes generadas, lo que resulta en una experiencia negativa para personas no especializadas (Liu y Chilton, 2022; Mou et al., 2024). Considerando la naturaleza visual de las interfaces, la automatización de la prototipación de UI exige arquitecturas de redes neuronales capaces de comprender y sintetizar diseños respetando jerarquías visuales complejas. En este contexto, la investigación se basa en metodologías de generación condicionada de imágenes, anclando el proceso de inferencia en una imagen de referencia (Couairon et al., 2023; Mou et al., 2024; Zhang et al., 2023; Zhao et al., 2023).
Ante lo expuesto, el presente trabajo tiene como objetivo adaptar modelos de difusión latente para la generación de prototipos de alta fidelidad a través de entrenamiento suplementario, utilizando tecnologías de código abierto y bases de datos puestas a disposición públicamente. La hipótesis es que los adaptadores desarrollados superen las capacidades del modelo base original, garantizando mayor calidad visual y fidelidad estructural al boceto de referencia.
2. Material y Métodos
Para la composición de la base de datos de entrenamiento, se utilizaron conjuntos de datos públicos puestos a disposición por trabajos relacionados, que contienen imágenes de UI de aplicaciones móviles. La delimitación del alcance al ecosistema móvil tuvo como objetivo simplificar las estructuras jerárquicas y optimizar el proceso de inferencia debido a las menores dimensiones de las pantallas, reduciendo el costo computacional relacionado con la complejidad de los cálculos matriciales.
Base de datos
La base de datos MUD aportó aproximadamente 7.200 imágenes, cada una asociada a un archivo con metadatos de la jerarquía de componentes, detallando clases, coordenadas espaciales y otros atributos descriptivos (Feng et al., 2024). Complementariamente, se seleccionaron aproximadamente 1.700 imágenes de UI de la base de datos VINS, que también proporciona metadatos de componentes visuales y coordenadas espaciales anotadas por humanos (Bunian et al., 2021). Finalmente, se incorporaron aproximadamente 3.500 imágenes de bocetos de UI de la base SWIRE, creada en colaboración con profesionales de diseño (Huang et al., 2019). Cada boceto de esta base hace referencia a las imágenes de UI de la base Rico (Deka et al., 2017), pero la base Rico fue evitada debido a inconsistencias en los metadatos espaciales (Feng et al., 2024).
Preprocesamiento de datos
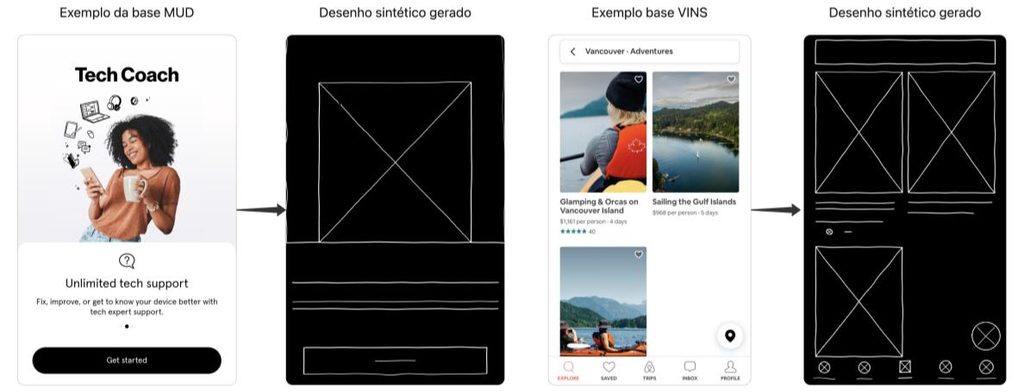
Se implementó una etapa de preprocesamiento para garantizar la consistencia de la base de entrenamiento. Inicialmente, se realizó un cribado de los metadatos para filtrar muestras con componentes no deseados (anuncios, “iframes”), texto en alfabeto no latino o capturas de pantalla en posición horizontal. La barra de notificación presente en las imágenes se recortó para evitar ruido y sesgos. Para enriquecer los datos, se generaron datos sintéticos para crear los bocetos correspondientes de las bases de datos compuestas únicamente por imágenes de UIs. La generación de las imágenes se realizó mediante scripts desarrollados en Python, adaptados a la estructura de los metadatos de cada base de datos. El algoritmo procesa los metadados de jerarquía de componentes de cada UI y utiliza la información de clase y coordenadas para dibujar la representación de los componentes relevantes utilizando la biblioteca de visión computacional OpenCV (Bradski, 2000). El resultado de este proceso son imágenes de fondo negro y trazos blancos que mantienen la proporción de aspecto de las imágenes de UI originales, con pequeñas distorsiones y ruidos aleatorios añadidos para diversidad, como se ilustra en la Figura 1.
Figura 1. Ejemplo de los resultados del preprocesamiento y la generación de un boceto sintético
Fuente: Datos originales de la investigación
A continuación, todas las imágenes se redimensionaron a la resolución objetivo de 720 píxeles de ancho por 1280 píxeles de alto, preservando la proporción original. Finalmente, se generaron las instrucciones textuales complementarias a los bocetos. Las imágenes fueron sometidas a la “application program interface” [API] del modelo multimodal “Gemini 2.0 Flash” (Google, 2025), a través de un script desarrollado en Python. Se elaboró un “system prompt” para estandarizar la descripción de los estilos y elementos visuales, así como para identificar y descartar muestras con ruido excesivo o baja calidad estética.
Hardware, infraestructura y herramientas
Para el desarrollo de los scripts de preprocesamiento, entrenamiento y evaluación cuantitativa, se adoptó el lenguaje de programación Python. La investigación se fundamentó en el ecosistema de software libre, utilizando bibliotecas de código abierto como Open CV (Bradski, 2000), PyTorch (Paszke et al., 2019), Diffusers (von Platen et al., 2022), Transformers (Wolf et al., 2020) y Accelerate (Gugger et al., 2020). La infraestructura computacional consistió en una unidad de procesamiento gráfico [GPU] NVIDIA A100, equipada con 80 GB de memoria de video de alto rendimiento, asignada a través de un servicio de computación en la nube. Los scripts desarrollados se encuentran disponibles en https://github.com/mendexjs/delineo.
Modelo de difusión base
Considerando el volumen de la base de datos y los recursos computacionales limitados, la estrategia adoptada consistió en un entrenamiento suplementario de un modelo con parámetros congelados. El LDM “Stable Diffusion” [SD] fue elegido como modelo base debido a su eficiencia computacional y amplia utilización en trabajos correlatos (Rombach et al., 2022). El SD ejecuta el proceso iterativo de remoción de ruido en un espacio latente de dimensión reducida, lo que disminuye el consumo de memoria durante la inferencia. La versión más reciente, SD 3, introdujo una arquitectura “multimodal diffusion transformer”, que utiliza pesos distintos para el procesamiento de las modalidades textual y visual, resultando en un desempeño superior en adherencia al prompt y generación de tipografía (Esser et al., 2024). Esta arquitectura añade el codificador de texto “Text-To-Text Transfer Transformer” [T5] (Raffel et al., 2020), mejorando la capacidad de comprensión de semántica y renderización de texto comparado al CLIP (Radford et al., 2021). Pruebas demostraron que el T5 mejora los resultados con instrucciones más largas y detalladas, aspecto relevante para la generación precisa de elementos de UI.
Arquitectura de control condicionado
Para mejorar los resultados de los LDM, Zhang et al. (2023) introdujeron “ControlNet”, una arquitectura que permite condicionar la generación de imágenes a través de información espacial adicional. Como módulo acoplado, “ControlNet” garantiza la estabilidad del entrenamiento, manteniendo inalterados los pesos y parámetros originales del modelo base, delegando la estructura espacial a la red de control y los detalles visuales al modelo de difusión. El entrenamiento completo de una arquitectura “ControlNet” requiere un gran volumen de datos y recursos computacionales. El presente estudio optó por la adaptación de una red “ControlNet canny edges” mediante entrenamiento suplementario, debido a la similitud visual entre imágenes de contornos y bocetos de UI. Para ello, se utilizó la base de datos de entrenamiento, que contiene aproximadamente 12.400 imágenes. La Tabla 1 presenta las configuraciones y los hiperparámetros utilizados en el entrenamiento.
Tabla 1. Configuración de entrenamiento e hiperparámetros de la red “ControlNet”
| Parámetro / Hiperparámetro | Valía | Descripción |
|---|---|---|
| Arquitectura del modelo | “Stable Diffusion 3.5 Large” | Modelo de difusión base |
| Arquitectura de control | “ControlNet Canny” | Módulo de control entrenado |
| Resolución de entrenamiento | 1024×1024 | Resolución para redimensionamiento |
| Precisión numérica | bf16 | Formato de precisión mixta |
| Optimizador | Adam de 8 bits | Versión cuantizada de AdamW para ahorrar VRAM |
| Tasa de aprendizaje | 10-5 | Tasa de aprendizaje fija |
| Tamaño de lote efectivo | 32 | Muestras acumuladas antes de la actualización de los pesos |
| Épocas de entrenamiento | 18 | Pasajes completos a través del conjunto de datos |
| “Gradient Checkpointing” | Activado | Optimización de memoria para entrenamiento de alta resolución |
Fuente: Datos originales de la investigación
Adaptador de bajo rango
Durante las pruebas preliminares, se observó que las imágenes generadas no presentaban consistencia estética y variaban en calidad visual. Para solucionar esto, se añadió al “pipeline” un adaptador de bajo rango [LoRA], responsable de inyectar matrices entrenables de descomposición de bajo rango. Este tipo de adaptación se utiliza para añadir matices estilísticos y características específicas a modelos generativos sin necesidad de un gran volumen de datos (Hu et al., 2022; Gandikota et al., 2024; Wu et al., 2024). Para el entrenamiento del LoRA, se recolectaron manualmente 156 imágenes de UIs modernas y de categorías distintas, extraídas de repositorios gratuitos especializados en diseño. La generación de las instrucciones textuales siguió el mismo proceso y “system prompt” aplicados en las bases de entrenamiento de la red “ControlNet”. El conjunto de datos pasó por un preprocesamiento para estandarizar el tamaño de las imágenes y reducir la discrepancia de representatividad de las categorías con menor número de muestras, aplicando una estrategia de sobremuestreo controlado, definiendo como objetivo de balanceo el percentil 75 del volumen de muestras entre las clases, con un límite estricto de cuatro repeticiones para muestras de categorías minoritarias. La Tabla 2 presenta las configuraciones y los hiperparámetros utilizados.
Tabla 2. Configuración e hiperparámetros para el entrenamiento del adaptador de bajo rango
| Parámetro / Hiperparámetro | Valía | Descripción |
|---|---|---|
| Arquitectura del modelo | “Stable Diffusion 3.5 Large” | Modelo de difusión base |
| Rango | 64 | Puesto de la matriz entrenable |
| Resolución de entrenamiento | 1024×1024 | Resolución para redimensionamiento |
| Precisión numérica | bf16 | Formato de precisión mixta |
| Tasa de aprendizaje | 10-4 | Tasa de aprendizaje de la red “Transformer” |
| Tasa de aprendizaje del codificador de texto | 10-5 | Tasa de aprendizaje utilizada en los codificadores de entrada textual |
| Tamaño de lote efectivo | 2 | Muestras acumuladas antes de la actualización de los pesos |
| Pasos de entrenamiento | 1000 | Límite de pasos para entrenamiento |
| Planificador de Tasa de Aprendizaje | “coseno” | Reduce la tasa de aprendizaje a lo largo del entrenamiento |
| Pasos de Calentamiento | 150 | Pasos para la transición de la tasa de aprendizaje de 0 hasta valor máximo |
| “Gradient Checkpointing” | Activado | Optimización de memoria para entrenamiento de alta resolución |
Fuente: Datos originales de la investigación
Evaluación cuantitativa
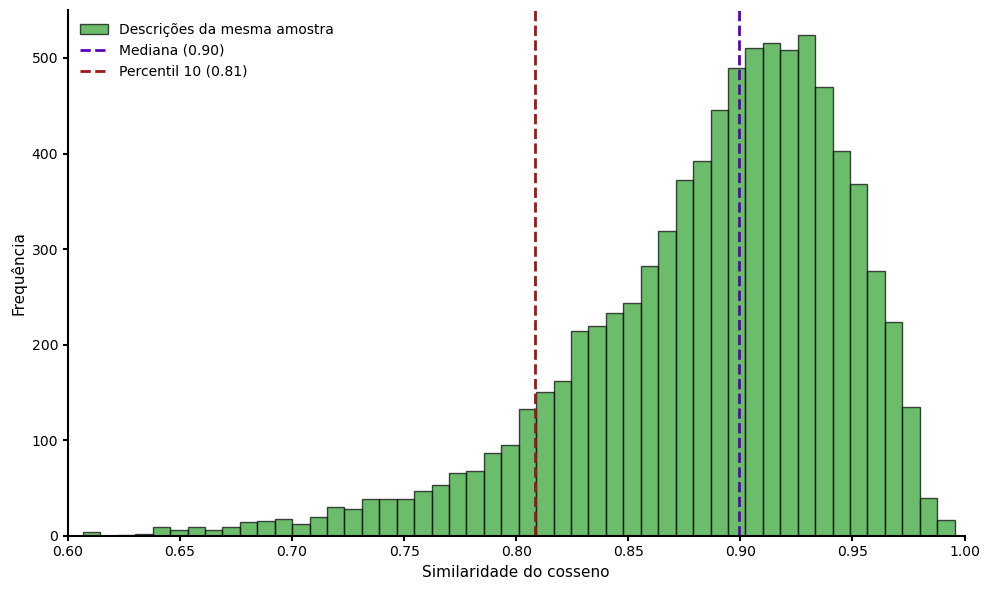
Debido a la especificidad del dominio de las interfaces de usuario, las métricas comúnmente utilizadas en la evaluación de modelos T2I (como CLIPScore y LPIPS) han demostrado ser limitadas (Hessel et al., 2021; Zhang et al., 2018). Se adoptó una estrategia de evaluación más compatible con los objetivos del estudio, comparando la instrucción textual original con una descripción textual de la imagen, generada por el mismo proceso utilizado en la construcción del conjunto de entrenamiento. Para ello, se utilizó la técnica “Sentence-BERT” [SBERT] (Reimers y Gurevych, 2019), que proyecta frases enteras en vectores densos para calcular la similitud semántica. Para adaptar la métrica al dominio de UIs, se establecieron límites empíricos mínimos y máximos. El límite máximo empírico (Tmax) se definió a partir de un experimento de variación, donde se generaron 20 leyendas distintas para 44 imágenes de UIs, y se computó la similitud del SBERT entre todos los pares posibles de leyendas. El 10° percentil de la distribución estadística de estas puntuaciones se adoptó como Tmax, como se ilustra en la Figura 2.
Figura 2. Histograma de la distribución de similitud (SBERT) para la definición del límite máximo empírico de consistencia
Fuente: Datos originales de la investigación
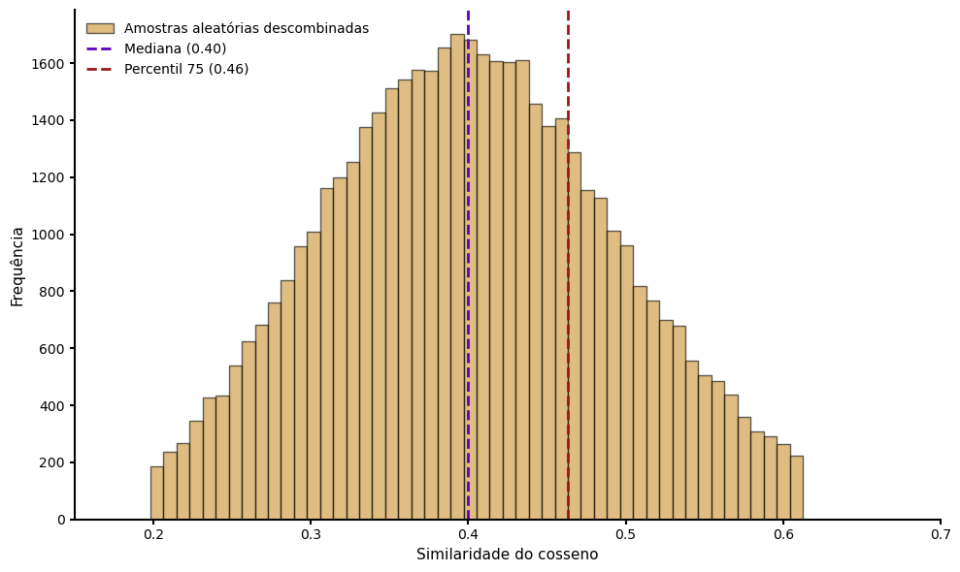
En contraste, el límite inferior empírico (Tmin) se estableció para definir un nivel mínimo de similitud derivado del ruido intrínseco al dominio. Para estimar este nivel, se utilizaron los subtítulos del conjunto de datos de entrenamiento de “ControlNet” para generar 50.000 pares aleatorios, permitiendo calcular la similitud residual del SBERT entre las descripciones de las UIs. La Figura 3 ilustra la distribución estadística obtenida, y el percentil 75 se definió como Tmin.
Figura 3. Histograma de la distribución de similitud (SBERT) entre pares aleatorios no combinados, utilizado para la definición del límite inferior empírico de similitud residual
Fuente: Datos originales de la investigación
La etapa final de la calibración consistió en estandarizar los resultados brutos de la métrica utilizando la técnica de escalamiento “Min-Max” unida a un mecanismo de limitación rígida. La Similitud Semántica Normalizada [SSN] se calculó mediante la fórmula (1):
SSN = min (1, max (0, (Sobs – Tmin) / (Tmax – Tmin))) (1)
donde: Sobs: es la similitud de coseno bruta observada; Tmin: es el límite inferior empírico; y Tmax: es el límite superior empírico. Esta función penaliza muestras ruidosas, poniendo a cero el resultado si el valor bruto es menor o igual al límite inferior, y asigna la nota máxima si alcanza o supera el techo empírico. Para la fase de evaluación, se utilizó un subconjunto independiente de 44 muestras, separado previamente del conjunto de entrenamiento. Para cada par de boceto e instrucción textual, se generaron diez imágenes utilizando “seeds” fijas, y la similitud entre la muestra generada y la respectiva instrucción de entrada se calculó para obtener una estimación media del rendimiento.
Evaluación cualitativa
Además del análisis cuantitativo, se realizó una evaluación por parte de profesionales del área para comprender matices subjetivos. Para ello, se elaboró un cuestionario estructurado, aplicado de forma anónima y en línea, compuesto por una sección de caracterización del perfil de los encuestados y seis bloques de evaluación de las muestras. La muestra de conveniencia estuvo compuesta por 20 profesionales de las áreas de “UI/UX design” y desarrollo “frontend” con residencia en Brasil o Estados Unidos y experiencia mínima de tres años en la industria del software. Se preguntó a los participantes sobre la calidad estética, la fidelidad estructural y la utilidad práctica de la herramienta, utilizando una escala Likert de cinco puntos para la evaluación (Likert, 1932). Para la selección de las muestras sometidas a evaluación cualitativa, se utilizó la métrica SSN como criterio de filtrado. La selección se realizó de forma intencional, considerando los resultados obtenidos por la métrica y la disponibilidad limitada de recursos humanos. El número reducido de especialistas y la selección no aleatoria de las muestras constituyen limitaciones metodológicas que deben considerarse en la interpretación de los resultados de la evaluación. Este enfoque cualitativo tuvo como objetivo validar la percepción de los profesionales en un contexto cercano al uso real, permitiendo evaluar el nivel de aceptación de la aplicación y su potencial para ayudar en el flujo de trabajo de profesionales de las áreas de desarrollo de UIs.
3. Resultados y Discusión
La evaluación de los resultados se llevó a cabo mediante un análisis cuantitativo de similitud semántica y una evaluación cualitativa con profesionales de la industria, seguida de una comparación con modelos de difusión existentes.
Similitud de los “embeddings” SBERT
La Similitud Semántica Normalizada (SSN) se calculó para 440 muestras de interfaces de usuario. La Tabla 3 consolida las métricas globales obtenidas en este experimento.
Tabla 3. Análisis estadístico de la similitud semántica normalizada entre “embeddings”
| Indicador | Valía |
|---|---|
| Media | 0,6181 |
| Desviación estándar | 0,4021 |
| percentil 10 | 0 |
| percentil 25 | 0 |
| La mediana | 0,7928 |
| Percentil 75° | 0,9843 |
| Percentil 90° | 1 |
Fuente: Resultados originales de la investigación
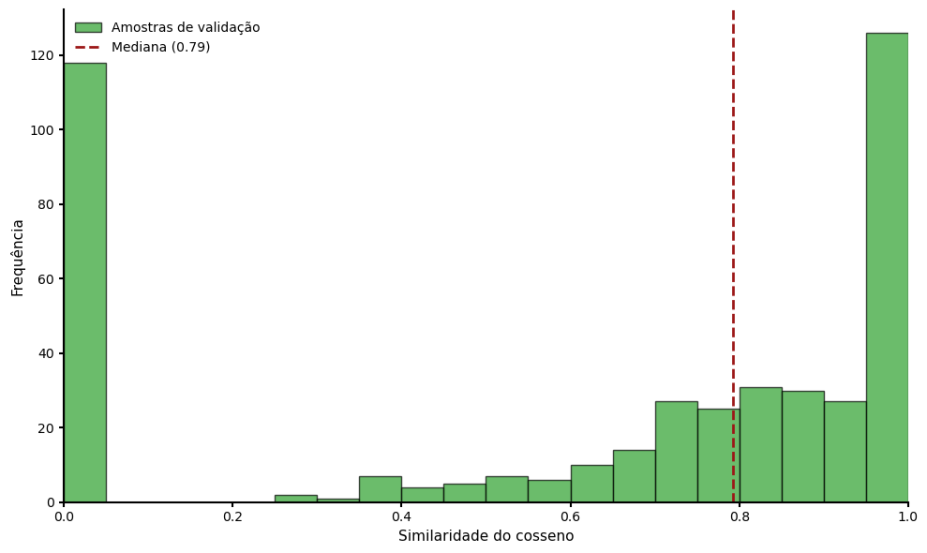
La Figura 4 ilustra la distribución de frecuencia de los resultados de la SSN.
Figura 4. Distribución de la SSN entre las instrucciones textuales originales y las descripciones extraídas de las muestras generadas
Fuente: Resultados originales de la investigación
El análisis cuantitativo de las 440 muestras de validación indicó que el modelo logra capturar la intención de la instrucción la mayoría de las veces, con una mediana global de 0,7928. Sin embargo, la media global de 0,6181 y la desviación estándar de 0,4021 resaltan la naturaleza estocástica del proceso de generación y la inconsistencia entre las UIs generadas, especialmente con diferentes niveles de complejidad. Se observó que una misma entrada puede generar desempeños opuestos dependiendo de la “seed” utilizada en la inferencia.
Los percentiles 10 y 25 registraron el valor mínimo de cero, lo que, debido al mecanismo de corte de la normalización SSN, indica que al menos el 25% de las pruebas de inferencia fallaron por presentar solo similitud artificial con las instrucciones textuales originales. Este comportamiento volátil y polarizado corrobora hallazgos en trabajos correlacionados (Avrahami et al., 2024; Ho et al., 2020; Xu et al., 2023), reforzando la importancia de generar múltiples imágenes y aplicar un filtro riguroso de adherencia semántica antes de la evaluación humana. Con base en este análisis, se seleccionaron manualmente seis muestras de alta fidelidad para la evaluación cualitativa.
Evaluación de los profesionales de la industria
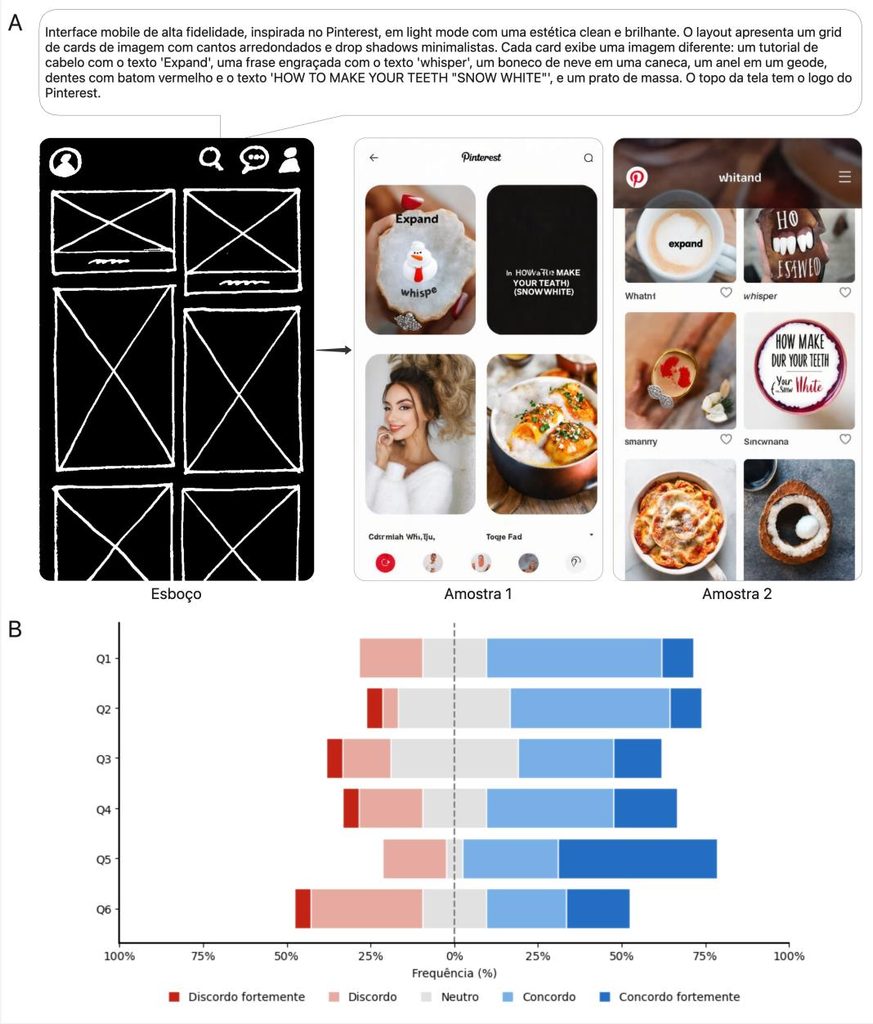
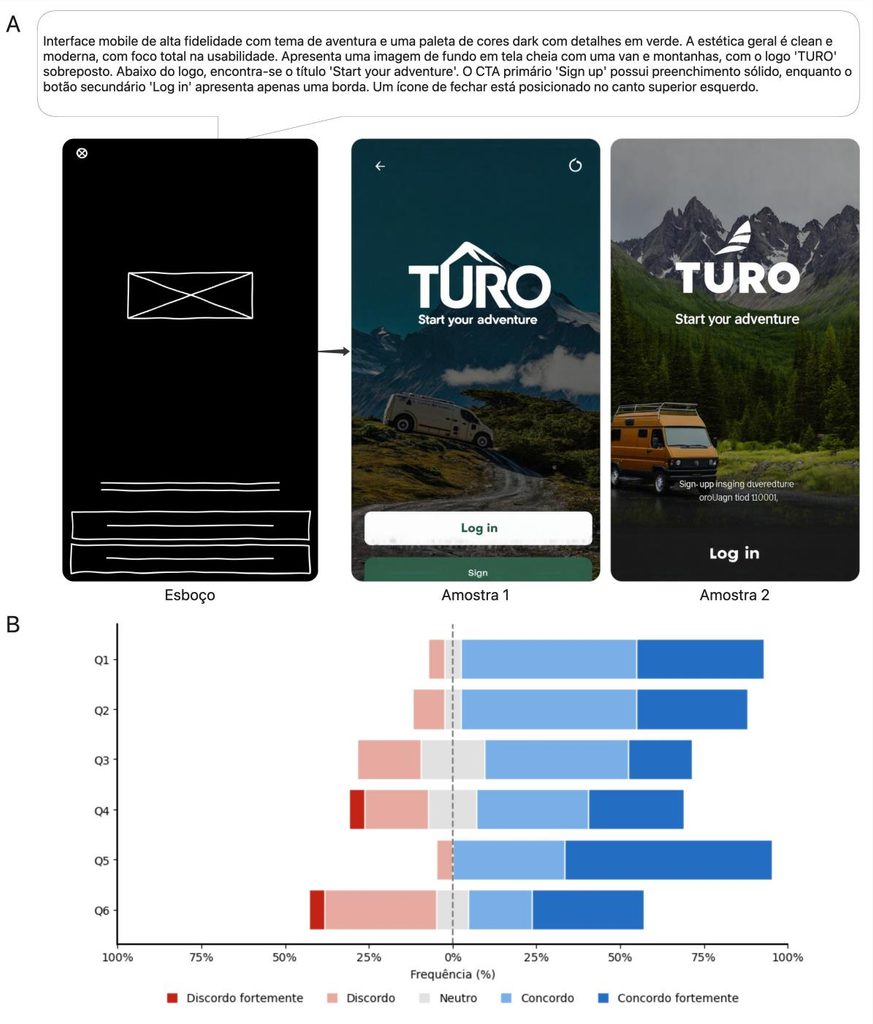
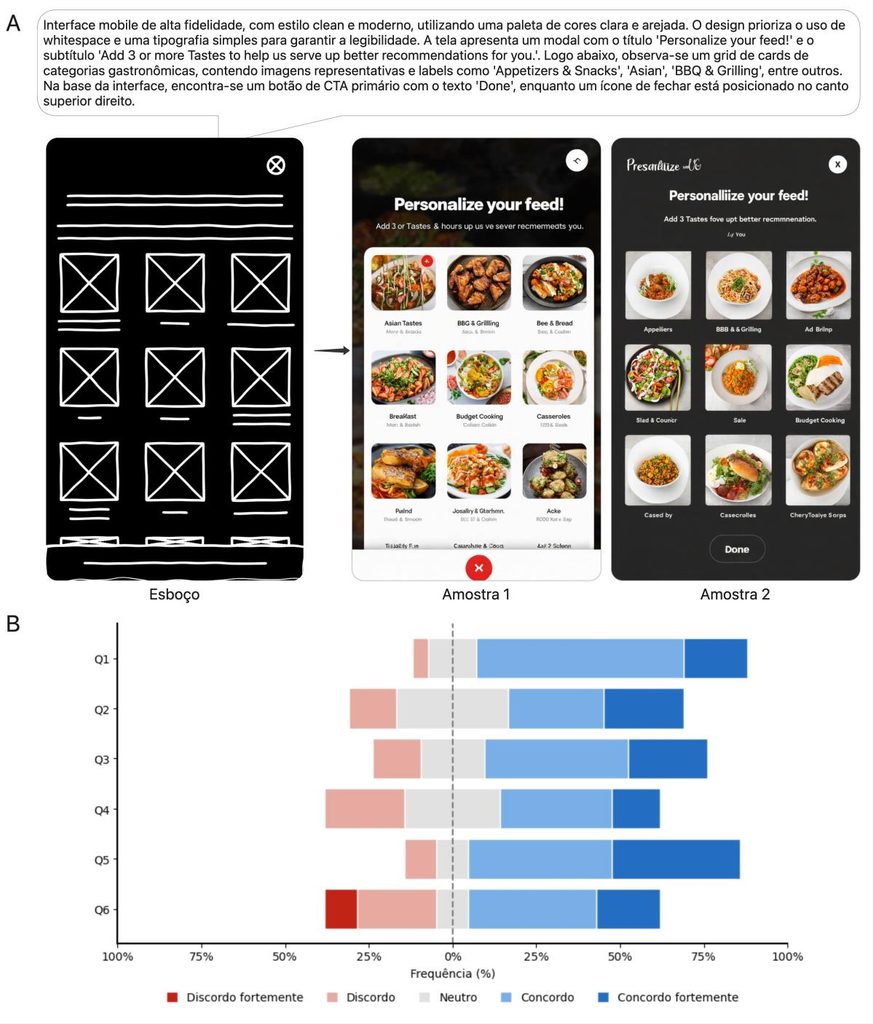
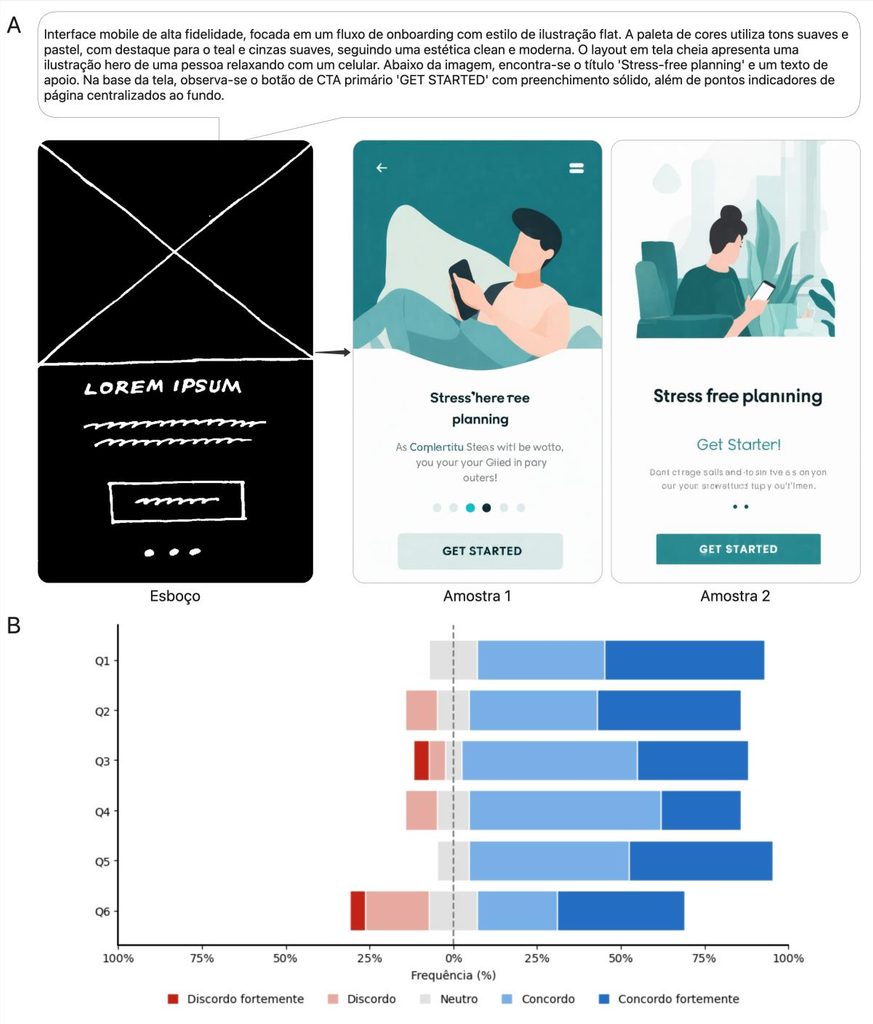
La evaluación cualitativa involucró a 20 profesionales (65% desarrolladores frontend, 35% diseñadores UI/UX), con el 70% en Brasil y el 30% en Estados Unidos. La mayoría (80%) utiliza IA diariamente, y el 85% ya ha aplicado soluciones de IA para la generación de mockups o prototipos de UI. Los participantes evaluaron seis criterios (Q1 a Q6) en una escala Likert de cinco puntos, agrupados en desempeño satisfactorio, poco satisfactorio o nada satisfactorio.
Las Figuras 5 a 10 presentan los resultados de la evaluación para las muestras seleccionadas.
Figura 5. Resultados de la evaluación de los profesionales para la primera muestra seleccionada
Fuente: Resultados originales de la investigación
Figura 6. Resultados de la evaluación de los profesionales para la segunda muestra seleccionada
Fuente: Resultados originales de la investigación
Figura 7. Resultados de la evaluación de los profesionales para la tercera muestra seleccionada
Fuente: Resultados originales de la investigación
Figura 8. Resultados de la evaluación de los profesionales para la cuarta muestra seleccionada
Fuente: Resultados originales de la investigación
Figura 9. Resultados de la evaluación de los profesionales para la quinta muestra seleccionada
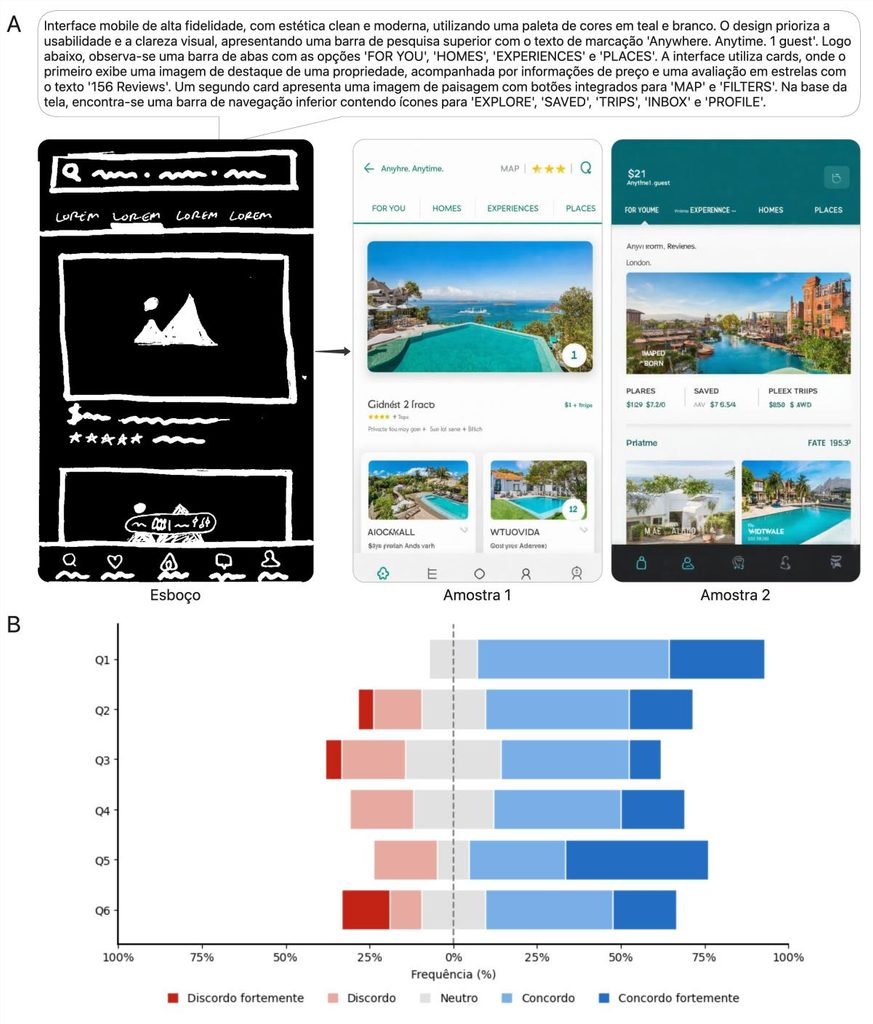
Fuente: Resultados originales de la investigación
Figura 10. Resultados de la evaluación de los profesionales para la sexta muestra seleccionada
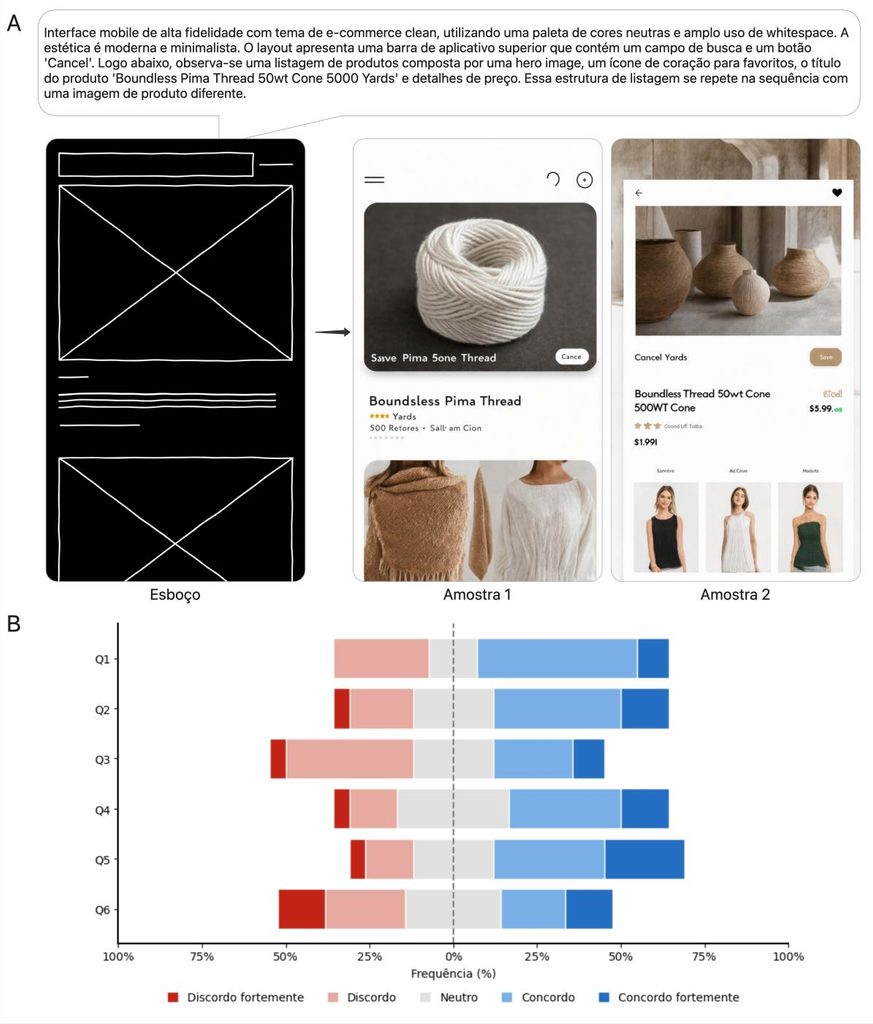
Fuente: Resultados originales de la investigación
Los datos consolidados para la afirmación Q1 (precisión de la UI al reflejar el contexto funcional) indicaron que el 77% de las muestras tuvieron un rendimiento satisfactorio. Este hallazgo sugiere que el modelo comprende el contexto funcional de las solicitudes en la mayoría de los escenarios. Sin embargo, la muestra de la Figura 10 presentó un 28,6% de desaprobación, lo que indica fallos de comprensión semántica en ciertos matices.
La afirmación Q2 (fidelidad estructural al esquema original) reveló que interfaces de baja complejidad, como las pantallas de inicio de sesión y onboarding (Figuras 6 y 8), alcanzaron un 85,7% y un 81% de aprobación, respectivamente. Esto demuestra que el modelo respetó los límites del esquema. En contraste, muestras más complejas obtuvieron entre un 52,4% y un 61,9% de satisfacción, sugiriendo que la adecuación de la estructura geométrica fue menos eficaz en escenarios de mayor complejidad.
La viabilidad técnica de las UIs generadas (Q5) recibió una recepción positiva, con una aprobación media del 78,6%. Este resultado indica que el pipeline generativo establece una arquitectura de componentes bien definida y una organización estructural lógica, lo que puede reducir la fricción en la implementación del código.
Por el contrario, los criterios Q3 (eficacia de la jerarquía visual) y Q4 (calidad estética general) presentaron los mayores índices de reprobación, con un 21,4% y un 19,8% de evaluaciones nada satisfactorias, respectivamente. La muestra de la Figura 10, por ejemplo, tuvo un 42,9% de reprobación para Q3, donde el modelo suprimió elementos críticos e introdujo artefactos textuales deformados, comprometiendo la integridad visual. Esta divergencia destaca que, aunque la estructura técnica pueda ser satisfactoria, los profesionales mantienen una alta exigencia estética, penalizando tipografías desordenadas u omisiones estructurales que perjudican la claridad comunicacional.
La evaluación de la calidad general (Q6) registró una media global del 50,8% de desempeño satisfactorio. La segmentación de las respuestas reveló polarización: los ingenieros frontend demostraron mayor tolerancia a anomalías visuales (61,9% de aprobación), valorando la agilidad en la estructuración inicial. Por su parte, los diseñadores UI/UX presentaron un índice de rechazo del 50%, con solo el 28,6% de evaluaciones satisfactorias, indicando mayor sensibilidad a la pérdida de fidelidad a los bocetos y a la degradación estética.
Comparativa con el estado del arte
Para comparar el Delineo con modelos multimodales de referencia, se realizaron pruebas de inferencia con las mismas muestras, utilizando el modelo Gemini 2.5-flash-image de Google (2025), el gpt-image-1.5 de OpenAI (2026) y el modelo base original Stable Diffusion 3.5 Large (Rombach et al., 2022). La Figura 11 ilustra este comparativo.
Figura 11. Comparativa del Delineo contra los modelos más potentes de la actualidad
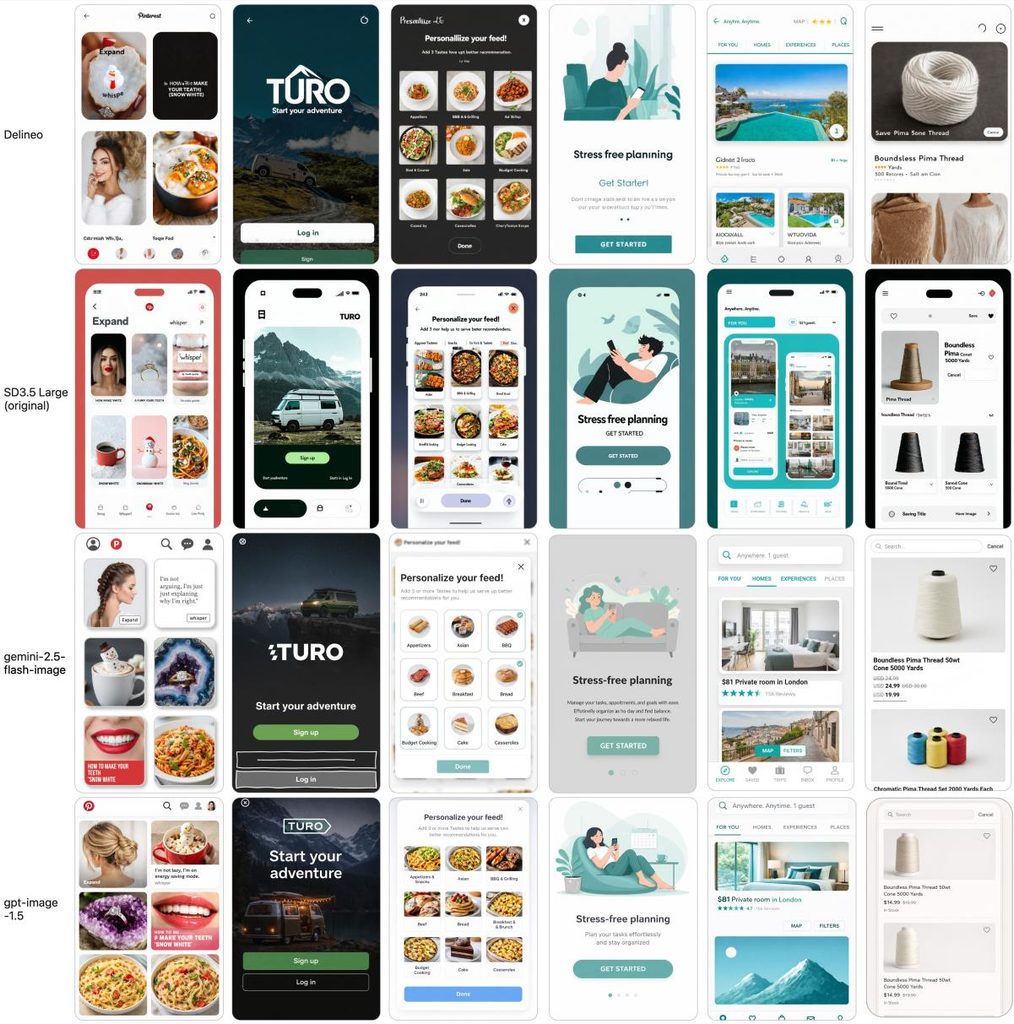
Fuente: Resultados originales de la investigación
El comparativo demuestra que los resultados generados por Delineo superan las capacidades del modelo base original en prototipado de UI. La capacidad de Delineo para la generación de la estructura es equiparable a la de los modelos más potentes del mercado. En términos estéticos, Delineo se muestra más cercano a los estándares de la industria, con un aspecto más moderno y profesional que los resultados de los otros modelos, lo que atestigua la eficiencia del adaptador de bajo rango (LoRA) como parte esencial del pipeline. Los modelos de Google y OpenAI, por otro lado, demostraron menor olvido de elementos solicitados y mayor capacidad de razonamiento, logrando elaborar contenido textual relevante y añadir elementos no especificados, pero comunes al contexto semántico de la UI.
Los resultados indican que la adaptación de un modelo de difusión latente condicionada para la prototipación de interfaces de usuario es técnicamente viable. El modelo Delineo superó el rendimiento del modelo base original, presentando capacidad para generar estructuras de UI con fidelidad al boceto y un nivel estético más alineado a los estándares de la industria en comparación con otros modelos de difusión. Sin embargo, la evaluación cualitativa reveló que, aunque la arquitectura de componentes está bien definida y la viabilidad técnica para la implementación es alta, aún persisten desafíos significativos en la generación de tipografía precisa y en el mantenimiento de la calidad estética y la jerarquía visual en UIs de alta complejidad. La polarización en las percepciones de los profesionales, especialmente entre desarrolladores frontend y diseñadores UI/UX, destaca la necesidad de mejoras arquitectónicas para cumplir con el rigor visual y la usabilidad exigidos por la industria del desarrollo de software.
4. Conclusión
El presente estudio tuvo como objetivo adaptar modelos de difusión latente para la generación de prototipos de alta fidelidad, utilizando entrenamiento suplementario y recursos de código abierto. Se verificó, mediante evaluación cuantitativa, que el modelo Delineo logró capturar la intención de las instrucciones textuales en la mayoría de las muestras, aunque demostró inconsistencia y fallas en la similitud semántica en escenarios de mayor complejidad. La evaluación cualitativa con expertos de la industria confirmó la viabilidad técnica del enfoque y la capacidad del modelo para generar estructuras de interfaz de usuario con fidelidad al boceto original para diseños más simples. Se observó que Delineo superó el rendimiento del modelo base original y presentó un nivel estético más alineado a los estándares de la industria en comparación con otros modelos de difusión, estableciendo una arquitectura de componentes bien definida que puede optimizar la transición entre requisitos visuales y la implementación de código.
Sin embargo, la investigación evidenció desafíos significativos, como la degradación estética, la pérdida de elementos funcionales en la estructuración lógica de la interfaz y la dificultad en la generación de tipografía precisa, especialmente en interfaces de alta complejidad. La naturaleza estocástica del proceso de generación y la polarización en las percepciones de los profesionales, con diseñadores UI/UX demostrando mayor sensibilidad a las fallas visuales, destacaron la necesidad de mejoras. Las limitaciones del estudio incluyeron el grupo reducido de especialistas en la evaluación cualitativa y la escasez de bases de datos públicas diversificadas. Se sugiere que estudios futuros se enfoquen en mejoras arquitectónicas para elevar el rigor visual y la usabilidad, además de explorar técnicas que demanden menor volumen de datos para el entrenamiento de nuevos modelos generativos, buscando equilibrar la agilidad técnica con la excelencia estética exigida por la industria de desarrollo de software.
Referencias Bibliográficas
Al-Saqqa, S.; Sawalha, S.; Abdel-Nabi, H. 2020. Agile software development: methodologies and trends. International Journal of Interactive Mobile Technologies 14(11): 246.
Avrahami, O.; Hertz, A.; Vinker, Y.; Arar, M.; Fruchter, S.; Fried, O.; Cohen-Or, D.; Lischinski, D. 2024. The chosen one: consistent characters in text-to-image diffusion models. In: Proceedings of SIGGRAPH ’24: Special Interest Group on Computer Graphics and Interactive Techniques Conference, 2024, Denver, CO, EUA. Anais… p. 1-12.
Beltramelli, T. 2018. Pix2code: generating code from a graphical user interface screenshot. In: Proceedings of the EICS ’18: ACM Symposium on Engineering Interactive Computing Systems, 2018, Paris, França. Anais… p. 1-6.
Bradski, G. 2000. The opencv library. Dr. Dobb’s Journal: Software Tools for the Professional Programmer 25(11): 120-123.
Bunian, S.; Li, K.; Jemmali, C.; Harteveld, C.; Fu, Y. El-Nasr, M.S. 2021. VINS: visual search for mobile user interface design. In: Proceedings of the Conference on Human Factors in Computing Systems, 2021, Yokohama, Japão. Anais… p. 1-14.
Couairon, G.; Careil, M.; Cord, M.; Lathuilière, S.; Verbeek, J. 2023. Zero-shot spatial layout conditioning for text-to-image diffusion models. In: Proceedings of the IEEE/CVF International Conference on Computer Vision, 2023, Paris, França. Anais… p. 1274-2183.
Deka, B.; Huang, Z.; Franzen, C.; Hibschman, J.; Afergan, D.; Li, Y.; Nichols, J.; Kumar, R. 2017. Rico: a mobile app dataset for building data-driven design applications. In: UIST ’17: Proceedings of the 30th Annual ACM Symposium on User Interface Software and Technology, 2017, Québec, Canadá. Anais… p. 845-854.
Esser, P.; Kulal, S.; Blattmann, A.; Entezari, R.; Müller, J.; Saini, H.; Levi, Y.; Lorenz, D.; Sauer, A.; Boesel, F.; Podell, D.; Dockhorn, T.; English, Z.; Lacey, Z.; Goodwin, A.; Marek, Y.; Rombach, R. 2024. Scaling rectified flow transformers for high-resolution image synthesis. In: Proceedings of the International Conference on Machine Learning, 2024, Vienna, Austria. Anais… p. 12606-12633.
Feng, S.; Ma, S.; Wang, H.; Kong, D.; Chen, C. 2024. MUD: towards a large-scale and noise-filtered UI dataset for modern style UI Modeling. In: Proceedings of the CHI Conference on Human Factors in Computing Systems, 2024, Honolulu, HI, EUA. Anais… p. 1-14.
Gandikota, R.; Materzyńska, J.; Zhou, T.; Torralba, A.; Bau, D. 2025. Concept Sliders: LoRA Adaptors for Precise Control in Diffusion Models. p. 172-188. In: Leonardis, A.; Ricci, E.; Roth, S.; Russakovsky, O.; Sattler, T.; Varol, G. Computer Vision – ECCV 2024: Lecture Notes in Computer Science. v.15098. Springer, Cham, Suiça.
Google. 2025. Gemini models. Disponível em https://ai.google.dev/gemini-api/docs/models. Acesso em 08 abr. 2026.
Gugger, S.; Debut, L.; Wolf, T.; Schmid, P.; Mueller, Z.; Mangrulkar, S.; Sun, M.; Bossan, B. 2022. Accelerate: training on any device with PyTorch. Disponível em https://github.com/huggingface/accelerate. Acesso em 07 fev. 2026.
He, J.; Treude, C.; Lo, D. 2025. LLM-based multi-agent systems for software engineering: literature review, vision, and the road ahead. ACM Transactions of Software Engineering and Methodology 34(5): 164-193.
Hessel, J.; Holtzman, A.; Forbes, M.; Bras, R. L.; Choi, Y. 2021. ClipScore: a reference-free evaluation metric for image captioning. In: Proceedings of the Conference on Empirical Methods in Natural Language Processing, 2021, Punta Cana, República Dominicana, Anais… p. 7514-7528.
Ho, J.; Jain, A.; Abbeel, P. 2020. Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems, 1(33): 6840-6851.
Hu, E. J.; Shen, Y.; Wallis, P.; Allen-Zhu, Z.; Li, Y.; Wang, S.; Wang, L.; Chen, W. 2022. Lora: low-rank adaptation of large language models. In: Proceedings of the International Conference on Learning Representations, 2022, virtual. Anais… p. 1-26.
Huang, F.; Canny, J. F.; Nichols, J. 2019. Swire: sketch-based user interface retrieval. In: Proceedings of the CHI Conference on Human Factors in Computing Systems, 2019, Glasgow, Escócia. Anais… p. 1-10.
Ismail, A.A.; Hassan, R. 2019. Technical competencies in digital technology towards industrial revolution 4.0. Journal of Technical Education and Training 11(3): 55-62.
Lauff, C. A.; Kotys-Schwartz, D.; Rentschler, M. E. 2018. What is a prototype? What are the roles of prototypes in companies?. Journal of Mechanical Design 140(6): 061102.
Likert, R. 1932. A technique for the measurement of attitudes. Archives of Psychology 22(140): 1-55.
Liu, V.; Chilton, L. B. 2022. Design guidelines for prompt engineering text-to-image generative models. In: Proceedings of the CHI Conference on Human Factors in Computing Systems, 2022, New Orleans, LA, EUA. Anais… p. 1-23.
Mou, C.; Wang, X.; Xie, L.; Wu, Y.; Zhang, J.; Qi, Z.; Shan, Y. 2024. T2i-adapter: learning adapters to dig out more controllable ability for text-to-image diffusion models. In: Proceedings of the AAAI Conference on Artificial Intelligence 38(5): 4296-4304.
OpenAI. 2026. Image generation. Disponível em https://developers.openai.com/api/docs/models/gpt-image-1.5. Acesso em 08 abr. 2026.
Paszke, A.; Gross, S.; Massa, F.; Lerer, A.; Bradbury, J.; Chanan, G.; Killeen. T.; Lin, Z.; Gimelshein, N.; Antiga, L.; Desmaison, A.; Köpf, A.; Yang, E.; DeVito, Z.; Raison, M.; Tejani, A.; Chilamkurthy, S.; Steiner, B.; Fang, L.; Bai, J.; Chintala, S. 2019. PyTorch: an imperative style, high-performance deep learning library. Advances in Neural Information Processing Systems 32: 8024-8035.
Radford, A.; Kim, J.W.; Hallacy, C.; Ramesh, A.; Goh, G.; Agarwal, S.; Sastry, G.; Askell, A.; Mishkin, P.; Clark, J.; Krueger, G.; Sutskever, I. 2021. Learning transferable visual models from natural language supervision. In: Proceedings of the International Conference on Machine Learning, 2021, virtual. Anais… 8748-8763.
Raffel, C.; Shazeer, N.; Roberts, A.; Lee, K.; Narang, S.; Matena, M.; Zhou, Y.; Li, W.; Liu, P.J. 2020. Exploring the Limits of transfer learning with a unified text-to-text transformer. Journal of Machine Learning Research 21(140): 1-67.
Reimers, N.; Gurevych, I. 2019. Sentence-bert: sentence embeddings using siamese bert-networks. In: Proceedings of the Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing, 2019, Hong Kong, China. Anais… 3982-3992.
Rombach, R.; Blattmann, A.; Lorenz, D.; Esser, P.; Ommer, B. 2022. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, New Orleans, LA, EUA. Anais… p. 10684-10695.
Stanford Institute for Human-Centered AI [HAI]. 2025. The AI Index 2025 annual report. Disponível em https://hai.stanford.edu/assets/files/hai_ai_index_report_2025.pdf. Acesso em 24 out. 2025.
von Platen, P.; Patil, S.; Lozhkov, A.; Cuenca, P.; Lambert, N.; Rasul, K.; Davaadorj, M.; Wolf, T. 2022. Diffusers: state-of-the-art diffusion models. Disponível em https://github.com/huggingface/diffusers. Acesso em 07 fev. 2026.
Wan, Y.; Wang, C.; Dong, Y.; Wang, W.; Li, S.; Huo, Y.; Lyu, M. 2025. Divide-and-conquer: generating UI code from screenshots. Proceedings of the ACM on Software Engineering 2(FSE): 2099-2122.
Wang, J.; Huang, Y.; Chen, C.; Liu, Z.; Wang, S.; Wang, Q. 2024. Software testing with large language models: survey, landscape, and vision. IEEE Transactions on Software Engineering 50(4): 911-936.
Wolf, T.; Debut, L.; Sanh, V.; Chaumond, J.; Delangue, C.; Moi, A.; Cistac, P.; Rault, T.; Louf, R.; Funtowicz, M.; Davison, J.; Shleifer, S.; von Platen, P.; Ma, C.; Jernite, Y.; Plu, J.; Xu, C.; Le Scao, T.; Gugger, S.; Drame, M.; Lhoest, Q.; Rush, A. M. 2020. Transformers: state-of-the-art natural language processing. In: Proceedings of the Conference on Empirical Methods in Natural Language Processing: System Demonstration: 38-45.
Wu, X.; Huang, S.; Wei, F. 2024. Mixture of LoRA experts. In: Proceedings of the International Conference on Learning Representations, 2024, Vienna, Austria. Anais… p. 1-17.
Xu, S.; Ma, Z.; Huang, Y.; Lee, H.; Chai, J. 2023. Cyclenet: rethinking cycle consistency in text-guided diffusion for image manipulation. Advances in Neural Information Processing Systems, 1(36), 10359-10384.
Zhang, L.; Rao, A.; Agrawala, M. 2023. Adding conditional control to text-to-image diffusion models. In: Proceedings of the IEEE/CVF International Conference on Computer Vision, 2023, Paris, França. Anais… p. 3836-3847.
Zhang, R.; Isola, P.; Efros, A. A.; Shechtman, E.; Wang, O. 2018. The unreasonable effectiveness of deep features as a perceptual metric. In: Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2018, San Francisco, CA, EUA. Anais… p. 586-595.
Zhao, S.; Chen, D.; Chen, Y.; Bao, J.; Hao, S.; Yuan, L.; Wong, K. 2023. Uni-ControlNet: all-in-one control to text-to-image diffusion models. Proceedings of the International Conference on Neural Information Processing Systems, 2023, New Orleans, LA, EUA. Anais… p. 11127-11150.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haz clic aquí y accede a la plataforma MBX Academy