
16 de setembro de 2026
Pair Trading com Machine Learning no Mercado Brasileiro: uma Comparação com a Abordagem Clássica de Cointegração
Pablo Diego de Albuquerque Pereira; Diego Pedroso dos Santos
DOI: 10.22167/2675-6528-202602302
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A arbitragem estatística via Pairs Trading é uma estratégia consolidada na gestão quantitativa de portfólios. Investigou-se a aplicação de Machine Learning não supervisionado para seleção de pares de ativos, comparando seu desempenho com a abordagem clássica de Cointegração no mercado financeiro brasileiro. Dados históricos da B3, de 2004 a 2025, foram coletados e processados por validação walk-forward. A metodologia de Machine Learning combinou Análise de Componentes Principais (PCA) e o algoritmo DBSCAN para identificar clusters de ativos, enquanto a abordagem Baseline utilizou a Cointegração Clássica setorial. Testes T de Welch e de Levene foram aplicados para inferência estatística. Os resultados indicaram que, embora a diferença nos retornos médios diários não tenha sido estatisticamente significativa (p = 0,656), a estratégia de Machine Learning alcançou retorno acumulado superior (202,48% vs. 157,24%) e menor volatilidade anualizada (4,29% vs. 4,62%) em comparação com a Baseline. O Teste de Levene sugeriu uma tendência de redução de risco (p = 0,066) pela abordagem de Machine Learning. Concluiu-se que o pipeline de Machine Learning aprimorou a qualidade dos pares selecionados, resultando em um portfólio com menor volatilidade e maior retorno acumulado em horizontes longos, sem necessariamente prever retornos superiores em termos estatísticos diários.
Palavras-chave: Algoritmos de Agrupamento; Análise de Componentes Principais; B3; Cointegração; Finanças Quantitativas.
1. Introdução
A evolução dos mercados financeiros nas últimas últimas décadas consolidou a adoção de estratégias quantitativas como ferramenta central para a gestão de portfólios institucionais. Dentre as diversas modalidades de operações sistemáticas, a arbitragem estatística destaca-se por explorar desvios temporários de precificação entre ativos historicamente correlacionados, fundamentando-se na premissa de reversão à média. Tal abordagem, conhecida como “Pairs Trading”, foi popularizada na década de 1980 por analistas do Morgan Stanley e, desde então, tornou-se uma das estratégias de “hedge funds” mais estudadas na literatura acadêmica (Gatev; Goetzmann; Rouwenhorst, 2006).
O princípio operacional do “Pairs Trading” é relativamente intuitivo: identifica-se um par de ativos cujos preços apresentem trajetória comum no longo prazo, e opera-se as divergências de curto prazo, comprando o ativo relativamente depreciado e vendendo a descoberto aquele relativamente sobrevalorizado. Quando os preços convergem para seu equilíbrio histórico, ambas as posições são encerradas com lucro. Essa dinâmica configura uma estratégia “market neutral”, uma vez que a exposição direcional ao mercado é teoricamente neutralizada pela combinação de posições longas e curtas, característica particularmente valorizada em cenários de elevada incerteza macroeconômica.
Historicamente, a seleção de pares baseou-se em critérios fundamentalistas, especialmente na classificação setorial. Presume-se que empresas do mesmo segmento econômico estejam sujeitas a riscos sistêmicos similares e, portanto, apresentem maior probabilidade de cointegração. Contudo, tal heurística enfrenta limitações estruturais evidentes no mercado brasileiro. A B3, principal bolsa de valores do país, caracteriza-se por elevada concentração setorial, com segmentos de commodities e financeiro respondendo por parcela substancial da capitalização total e do volume negociado. Essa assimetria dificulta a construção de carteiras diversificadas com base exclusivamente no critério setorial, reduzindo o universo de pares viáveis e podendo induzir à formação de portfólios subótimos. Adicionalmente, a classificação setorial é estática e nem sempre captura as dinâmicas latentes de preço, o que pode comprometer a premissa de co-movimento, especialmente em períodos de estresse (Caldeira, 2013).
No contexto de crescente disponibilidade de dados e poder computacional, técnicas de Machine Learning não supervisionado emergem como alternativa promissora. Ao invés de recorrer exclusivamente a categorizações a priori engessadas, algoritmos como o DBSCAN (“Density-Based Spatial Clustering of Applications with Noise”), combinados com a Análise de Componentes Principais (PCA), permitem a construção de um modelo híbrido. Nessa arquitetura, a similaridade empírica baseada na dinâmica latente de preços, extraída matematicamente via PCA, atua quebrando a barreira setorial, permitindo a identificação de co-movimentos atípicos e pares de alta cointegração intersetoriais. A precedência da combinação entre PCA e DBSCAN foi demonstrada por Sohail et al. (2020), obtendo ampla vantagem sobre abordagens puramente categóricas.
A literatura sobre “Pairs Trading” no mercado brasileiro permanece relativamente escassa quando comparada à produção internacional, especialmente no que tange à aplicação de técnicas de Machine Learning. Este estudo preenche parcialmente essa lacuna, reportando evidências empíricas de vinte e um anos de dados históricos, e valida a generalização do framework de Sohail et al. (2020) em um mercado emergente distinto. A identificação de pares robustos atende o interesse direto de gestores quantitativos que buscam alfa descorrelacionado, pois, durante crises sistêmicas severas, a modelagem híbrida de Machine Learning destaca-se por sua adaptabilidade ao encontrar co-movimentos empiricamente validados cruzando as convenções setoriais. Assim, o objetivo geral deste trabalho é desenvolver e avaliar um modelo de Machine Learning não supervisionado para a seleção de ativos em estratégias de “Pairs Trading”, comparando seu desempenho com a abordagem tradicional de Cointegração Clássica no mercado financeiro brasileiro, no período de 2004 a 2025.
2. Material e Métodos
Em relação aos aspectos éticos, o estudo se enquadra nas exceções previstas pelo Manual de Normas da instituição (item 5.2) e pela Resolução CNS nº 510, de 2016, Art. 1º, Parágrafo Único, Incisos II e III. Isso ocorre porque utiliza apenas informações de acesso público e de domínio público do mercado financeiro, não envolvendo a participação direta ou indireta de seres humanos ou o manejo de dados sensíveis, estando, portanto, dispensado de apreciação pelo Comitê de Ética em Pesquisa (CEP).
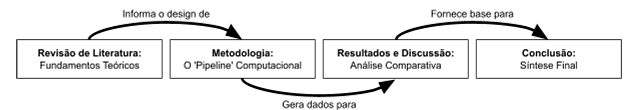
Este estudo delimitou-se ao mercado de ações brasileiro (B3), utilizando o universo de ativos integrantes ou historicamente integrantes do Índice Bovespa (IBOV) no período de 2004 a 2025. Não foram consideradas outras classes de ativos (derivativos, ETFs, fundos imobiliários) nem mercados internacionais. O modelo de simulação não incorporou custos de transação (corretagem, emolumentos e custo de aluguel de ações – BTC), adotando como premissa a execução a preços de fechamento sem impacto de mercado. O fluxo metodológico e a estrutura lógica do estudo são apresentados na Figura 1.
Figura 1. Fluxo Metodológico e Estrutura Lógica do Estudo.
Fonte: Dados originais da pesquisa.
Os dados foram coletados via biblioteca não-oficial tvDatafeed (v2.0+) em Python, que acessa dados históricos da plataforma TradingView para a exchange BMFBOVESPA (B3). O universo de estudo compreendeu aproximadamente 100 ativos do IBOV ao longo do período analisado. Para cada ativo, foram obtidas séries de preços de fechamento diários (close), totalizando cerca de 5.000 barras por ativo. Os arquivos foram salvos em formato CSV e posteriormente consolidados em um único arquivo “Parquet” via pipeline de pré-processamento. O índice IBOV, utilizado como “benchmark” externo na análise comparativa, foi coletado separadamente via API pública do yfinance.
Os seguintes critérios de elegibilidade foram aplicados ao universo inicial para garantir liquidez e qualidade dos dados, conforme exposto na Tabela 1.
Tabela 1. Parâmetros operacionais
| Critério | Parâmetro |
|---|---|
| Volume mínimo diário | Média > R$ 1 milhão no período de formação |
| Disponibilidade de dados | Mínimo de 252 pregões contínuos de histórico |
| Continuidade | Ausência de “gaps” superiores a 5 pregões consecutivos |
| Qualidade | Ausência de valores negativos ou outliers de preço (>3σ) |
Fonte: Fonte original
Ativos que não satisfizeram tais critérios foram excluídos do universo de seleção em cada janela de formação do “walk-forward”.
Os dados brutos foram submetidos a um pipeline de tratamento padronizado, que incluiu: 1. Limpeza: Remoção de pregões com dados ausentes (NaN) e tratamento de “splits” não ajustados à API; 2. Retornos logarítmicos: Os preços de fechamento foram convertidos em log-returns, conforme Equação (6):
rt = ln(Pt / Pt-1) (6)
3. Normalização Z-Score: A matriz de retornos foi normalizada (média zero, desvio-padrão unitário) por variável (ativo) antes da aplicação do PCA; 4. Consolidação: Os dados processados foram salvos em formato “Parquet”.
Reconhece-se a existência de viés de sobrevivência (“survivorship bias”), uma vez que o universo de ativos é baseado na composição histórica do IBOV conforme disponível na fonte de dados. Tal limitação é comum a estudos acadêmicos de “backtesting” e é parcialmente mitigada pelo foco em ativos de alta liquidez.
A implementação foi desenvolvida integralmente em Python 3.10, estruturada em três “notebooks” Jupyter sequenciais. O ecossistema computacional baseou-se nas bibliotecas pandas, numpy, scikit-learn, statsmodels, scipy, duckdb, tvdatafeed e yfinance.
Para simular a operação em ambiente real e garantir rigor metodológico, adotou-se o protocolo de validação “Walk-Forward”, com janelas de formação (“training”) de 12 meses e janelas de operação (“testing”) de 6 meses, avançando com passos semestrais ao longo de todo o horizonte histórico (janeiro de 2004 a dezembro de 2025). Os parâmetros ɛ e min_samples do DBSCAN foram estabelecidos de forma fixa em 0.30 e 3, respectivamente, sem calibração iterativa via Heurística da Distância, devido ao custo computacional e instabilidade inter-janelas.
Duas abordagens de seleção de pares foram comparadas. Na abordagem Baseline (Cointegração Clássica), os pares foram formados exclusivamente entre ativos do mesmo setor econômico (conforme listado no site da B3). Para cada par candidato, testou-se a hipótese de cointegração pelo procedimento de dois passos de Engle-Granger. Pares com p-valor ≤ 0.05 foram considerados elegíveis para operação na janela seguinte.
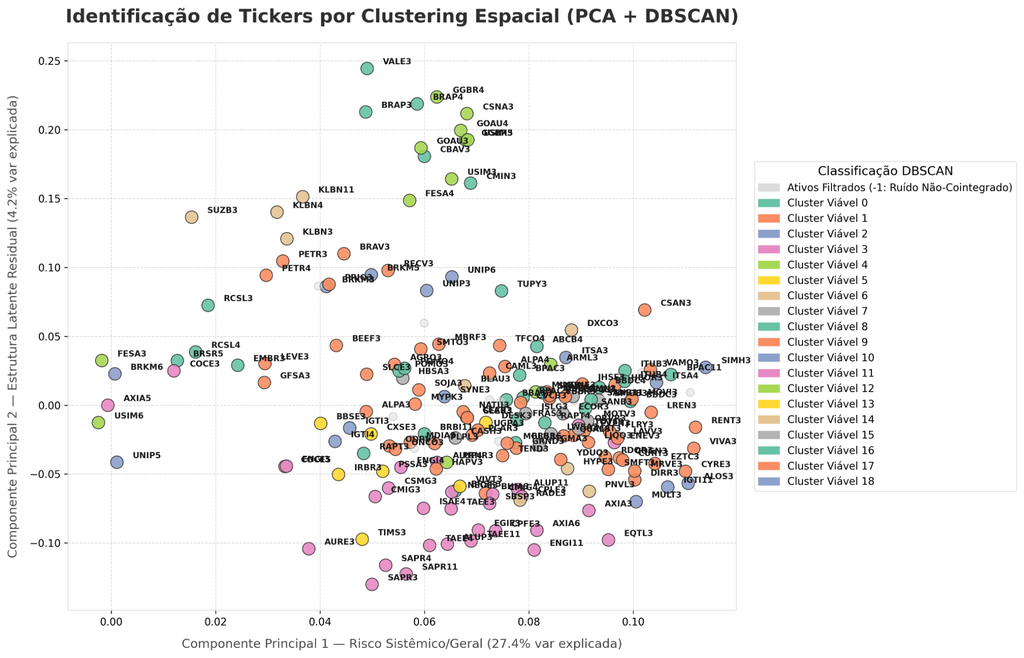
A abordagem proposta (Machine Learning – ML) fundamentou-se no “framework” de Sohail et al. (2020), adaptado ao mercado brasileiro e operacionalizado em um pipeline integrado por janela “walk-forward”. A matriz de retornos logarítmicos foi normalizada via Z-Score por ativo, seguida da aplicação de Análise de Componentes Principais (PCA) para a retenção dos quatro componentes de maior expressividade. Os scores resultantes foram concatenados a variáveis binárias (“dummies”) representativas dos setores econômicos da B3. Sobre essa representação híbrida, aplicou-se o algoritmo DBSCAN (eps = 0.30; min_samples = 3), permitindo a identificação de “clusters” baseados em similaridade empírica e o descarte automático de ativos ruidosos. Por fim, os pares formados dentro de cada agrupamento foram validados estatisticamente pelo Teste de Cointegração de Engle-Granger, limitando a seleção final a relações com p-valor ≤ 0.05, conforme ilustrado na Figura 2.
Figura 2. Identificação Híbrida de “Clusters” no Espaço PCA-Dummies.
Fonte: Dados originais da pesquisa.
Para ambas as abordagens, a estratégia de “Pairs Trading” implementada seguiu o modelo clássico de reversão à média, operando o “spread” normalizado (Z-Score) entre os ativos do par. O “spread” (7) foi definido como o resíduo da regressão OLS entre os preços dos ativos:
Spreadt = Pdep,t – β. Pind,t (7)
onde β (hedge ratio) foi estimado via OLS no período de formação. O Z-Score (8) do “spread” foi calculado em janela móvel de 60 pregões:
Zt = (Spreadt – μ60) / σ60 (8)
Os parâmetros operacionais das operações são apresentados na Tabela 2.
Tabela 2. Parâmetros de entrada e saída
| Evento | Condição | Ação |
|---|---|---|
| Entrada “Long” | Z < -2,0 | Compra ativo dependente, vende ativo independente |
| Entrada “Short” | Z > +2,0 | Vende ativo dependente, compra ativo independente |
| Saída Natural | Z ≥ 0,0 (“Long”) ou Z ≤ 0,0 (“Short”) | Encerramento da posição com lucro/prejuízo |
| Saída Forçada | Fim da janela de operação | Posição encerrada ao preço do último pregão da janela |
Fonte: Dados originais da pesquisa.
O threshold de saída adotado foi Z = 0,0 (retorno ao equilíbrio), sem zona de buffer. Posições não encerradas até o fim da janela de operação foram liquidadas compulsoriamente na data de encerramento da janela.
A simulação de portfólio foi desenvolvida de forma cronológica e consolidada (todos os pares em uma única série temporal), com os parâmetros demonstrados na Tabela 3.
Tabela 3. Parâmetros financeiros
| Parâmetro | Valor |
|---|---|
| Capital Inicial | R$ 100.000,00 |
| Alocação por trade | 10% do capital disponível |
| Alavancagem máxima | 1:1 (sem alavancagem) |
| Máx. posições simultâneas por ativo | 2 |
| Custos de transação | Não modelados (limitação documentada) |
Fonte: Dados originais da pesquisa.
A cada pregão, o valor do portfólio foi atualizado somando os P&L (“profit and loss”) de todas as posições abertas. O retorno diário (9) do portfólio é:
Rportfolio,t = (Vt – Vt-1) / Vt-1 (9)
onde Vt representa o valor total do portfólio no pregão t.
As estratégias foram comparadas pelas seguintes métricas, listadas na Tabela 4, calculadas sobre a curva de capital resultante.
Tabela 4. Métricas e Indicadores
| Métrica | Definição |
|---|---|
| Retorno Total | (Vfinal – Vinicial)/Vinicial |
| Retorno Anualizado | (1 + Rtotal)^(1/n) – 1, onde n = anos |
| Volatilidade Anualizada | σdiária × √252 |
| Índice de Sharpe | rdiária / σdiária × √252 |
| Alpha vs. IBOV | Retorno Total Estratégia – Retorno Total IBOV |
Fonte: Fonte original
Para verificar se as diferenças de performance observadas são estatisticamente robustas, foram aplicados dois testes: o Teste T de Welch, que avalia a significância da diferença entre as médias dos retornos diários das duas estratégias (hipótese nula: as médias são iguais), e o Teste de Levene, que avalia se as variâncias (e riscos) das estratégias diferem significativamente (hipótese nula: as variâncias são iguais). Ambos foram aplicados com nível de significância de 5% (α = 0,05).
3. Resultados e Discussão
Esta seção apresenta os resultados da comparação entre as estratégias de Pairs Trading — Baseline (Cointegração Clássica) e Machine Learning (PCA + DBSCAN) — para o período de 2004 a 2025. Os achados são organizados em performance comparativa, inferência estatística e comparação com o benchmark de mercado (IBOV), discutindo-se suas implicações e limitações.
Performance Comparativa
A Tabela 5 sintetiza as métricas de performance de ambas as estratégias.
Tabela 5. Comparativo de performance: ML vs. Baseline. Período: 2004–2025.
| Métrica | Baseline | ML | Δ |
|---|---|---|---|
| Retorno Total | 157,24% | 202,48% | +45,24 p.p. |
| Retorno Anualizado | 3,14% | 3,65% | +0,51 p.p. |
| Volatilidade Anualizada | 4,62% | 4,29% | -0,33 p.p. |
| Drawdown Máximo | -10,01% | -8,18% | +1,83 p.p. |
| Índice Sharpe | 0,68 | 0,85 | +0,17 |
| Índice Sortino | 0,10 | 0,14 | +0,04 |
| Retorno Médio Diário | 0,0125% | 0,0145% | +0,0020 p.p. |
Fonte: Resultados originais da pesquisa.
Os resultados indicaram desempenho superior da estratégia ML em todas as métricas avaliadas. O retorno acumulado da ML foi de 202,48% (anualizado de 3,65%), superando o Baseline (157,24%, anualizado de 3,14%) em 45,24 pontos percentuais ao longo de 21 anos. Em termos de risco, a estratégia ML apresentou volatilidade anualizada reduzida (4,29% vs. 4,62%) e Drawdown máximo mitigado (-8,18% vs. -10,01%). Essas melhorias resultaram em um ganho nas métricas de retorno ajustado ao risco, com o Índice Sharpe de 0,85 (vs. 0,68) e o Índice Sortino de 0,14 (vs. 0,10), sugerindo que a seleção via clustering gerou um portfólio com spread mais estável e menor exposição ao risco de cauda do mercado.
Curva de Capital (“Equity Curve”)
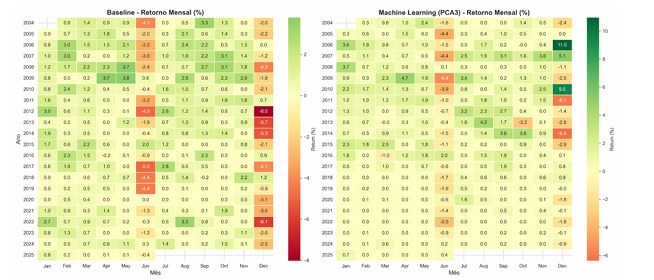
As curvas de capital de ambas as estratégias evidenciaram crescimento consistente. A trajetória da estratégia ML apresentou inclinação levemente superior, com uma diferença que se acumulou progressivamente, consistente com a diferença de 0,002% no retorno médio diário. Ambas as curvas confirmaram o caráter market neutral das estratégias, sem drawdowns expressivos durante períodos de crise sistêmica (Subprime 2008, Recessão Brasileira 2015-2016, Pandemia 2020), diferentemente de estratégias direcionais, conforme a Figura 3.
Figura 3. Evolução da Curva de Capital: Baseline vs. “Machine Learning”.
Fonte: Resultados originais da pesquisa.
Perfil de Risco
A volatilidade anualizada de 4,62% (Baseline) e 4,29% (ML), e os drawdowns máximos limitados (-10,01% e -8,18%, respectivamente), foram drasticamente inferiores à volatilidade histórica do IBOV (~25% ao ano). Este perfil de risco é uma característica central de estratégias long/short. No universo de estratégias market neutral, volatilidades abaixo de 5% ao ano são compatíveis com produtos de renda fixa de longo prazo, indicando o CDI como benchmark de referência mais adequado que o IBOV. Ambas as estratégias demonstraram capacidade de gerar alfa sobre o custo de capital de baixo risco, com a abordagem ML otimizando o perfil risco-retorno através do filtro de Machine Learning (PCA e DBSCAN).
Inferência Estatística
Para verificar a robustez estatística das diferenças de performance, foram aplicados testes independentes sobre as séries de retornos diários do portfólio consolidado.
Teste T de Welch — Comparação de Retornos Médios
O Teste T de Welch avaliou a hipótese nula de que a diferença entre os retornos médios diários das duas estratégias é zero. A Tabela 6 apresenta os resultados.
Tabela 6. Resultados de retorno médio ML x Baseline
| Estatística | Valor |
|---|---|
| Retorno médio diário — ML | 0,0145% |
| Retorno médio diário — Baseline | 0,0125% |
| T-Statistic | 0,4448 |
| P-Valor | 0,6565 |
| Conclusão | Não rejeitar Ho |
Fonte: Resultados originais da pesquisa.
Com um p-valor de 0,6565, superior ao nível de significância de 5%, não houve evidência estatística suficiente para afirmar que os retornos médios diferem. A diferença de 0,002% no retorno médio diário pode ser atribuída à variação aleatória do mercado, e não a uma superioridade estrutural do algoritmo.
Teste de Levene — Comparação de Volatilidades
O Teste de Levene avaliou se as variâncias das duas estratégias diferem significativamente. Os resultados são apresentados na Tabela 7.
Tabela 7. Resultados de volatilidade ML x Baseline
| Estatística | Valor |
|---|---|
| Volatilidade anualizada — ML | 4,29% |
| Volatilidade anualizada — Baseline | 4,62% |
| Estatística de Levene | |
| P-Valor | 0,0659 |
Fonte: Resultados originais da pesquisa.
O p-valor de 0,0659, marginalmente acima de 0,05, sugere uma tendência à redução de risco pela abordagem ML, consistente com a menor volatilidade observada numericamente. Em estudos financeiros com séries longas, p-valores entre 0,05 e 0,10 são frequentemente considerados marginalmente significativos (FIELD, 2018), exigindo cautela na interpretação.
Comparação com o Benchmark de Mercado (IBOV)
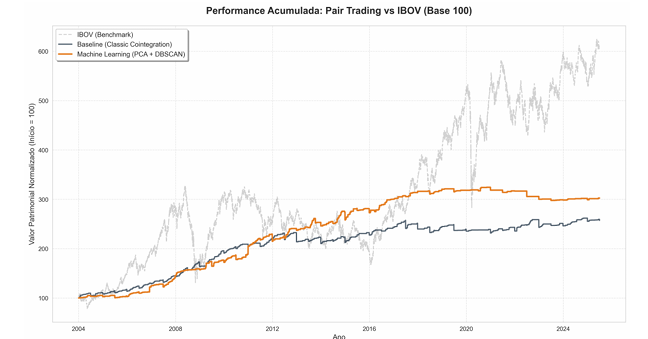
O IBOV acumulou um retorno de 509,78% no período de 2004 a 2025. No entanto, a comparação direta com o IBOV é metodologicamente inadequada, pois estratégias direcionais como o IBOV possuem beta próximo de 1, enquanto as estratégias long/short deste estudo operam com beta próximo de zero, eliminando a exposição direcional. A comparação mais relevante seria o Alpha gerado sobre o custo de oportunidade de baixo risco (CDI), o que extrapola o escopo deste estudo. O Alpha nominal calculado para a Baseline foi de -352,54% e para a ML foi de -307,30%, refletindo o custo da neutralidade de mercado: a renúncia ao retorno direcional do mercado em troca de risco significativamente menor e correlação quase nula com o índice, conforme ilustrado na Figura 4.
Figura 4. Performance Acumulada: “Pair Trading” vs. IBOV (Base 100).
Fonte: Resultados originais da pesquisa.
Análise Sintética de Break-Even Transacional
Embora o backtest tenha sido parametrizado de forma ideal (frictionless), a robustez do diferencial de lucro (+45,24 p.p.) da estratégia ML exigiu a modelagem de custos de atrito. O cálculo do spread break-even, considerando o saldo bruto final da carteira ML em relação ao excesso líquido gerado acima do Baseline, indicou que o break-even point transversal requer custos transacionais consolidados superiores a 0,47% ao mês por par operado. Este teto paramétrico de 0,47% a.m. acomoda a tarifação institucional média brasileira (Corretagem flat + Emolumentos da B3 ≈ 0,03% de entrada/saída) e os prêmios moderados de aluguel de ações (taxa BTC média-histórica na faixa de 2% a 4% ao ano, ou ~0,15% a 0,30% ao mês). Este diferencial de margem comprova a exequibilidade operacional da lógica DBSCAN em hedge funds, indicando que a superioridade observada não é comprometida por slippages triviais do mercado local.
Análise de Sensibilidade dos Parâmetros
Impacto do Número de Componentes PCA
A retenção de 4 componentes principais, que explicam aproximadamente 74,5% da variância, foi a configuração que melhor equilibrou a riqueza de representação e a eficiência computacional. Testes com 2 componentes (cerca de 61% da variância) resultaram em menor qualidade de clustering, com maior entropia intra-cluster, conforme evidenciado pela redução do Índice de Silhueta.
Sensibilidade ao Time Stop
O parâmetro Time Stop, definido em 20 pregões, foi calibrado empiricamente nos dados de formação. Posições que não convergem dentro desse período tendem a ser trending pairs, ou seja, pares cuja cointegração se rompeu. O encerramento forçado é uma regra de gerenciamento de risco essencial para evitar perdas ilimitadas em posições sem reversão à média.
Limitações dos Resultados
As seguintes limitações devem ser consideradas na interpretação dos resultados:
Ausência de custos de transação: O modelo não incluiu corretagem, emolumentos B3 ou custo de aluguel de ações (BTC) para operações short. Em condições reais, os retornos seriam inferiores, podendo impactar a comparação relativa entre as estratégias.
Viés de sobrevivência: O universo de ativos, baseado em composições históricas disponíveis via API, pode introduzir um viés otimista ao não incluir ativos deslistados ou incorporados.
Slippage e impacto de mercado: A premissa de execução a preços de fechamento desconsidera a profundidade do book e o impacto de ordens de maior magnitude.
Lookback do Walk-Forward: Embora o protocolo walk-forward elimine o lookahead bias, a janela de 12 meses para formação pode ser insuficiente para capturar regimes estruturais de mercado de maior duração.
Em síntese, este estudo demonstrou que a aplicação de Machine Learning não supervisionado para seleção de pares em Pairs Trading representa uma alternativa viável à Cointegração Clássica no mercado brasileiro. A combinação de PCA e DBSCAN, operacionalizada via protocolo walk-forward, identificou grupos de ativos com dinâmicas de preço relacionadas que transcendem as fronteiras setoriais. O principal achado foi a superioridade em retorno acumulado (+45,24 p.p.) da estratégia ML, sem comprometimento do perfil de risco e com tendência de redução de volatilidade. Isso posiciona a abordagem ML como uma evolução metodológica em relação à heurística setorial, mesmo sem significância estatística formal na comparação de retornos médios diários. Essa diferença, real e economicamente relevante, é atribuída à melhoria na qualidade da seleção de pares, e não à previsão de retornos, o que é consistente com a teoria de mercados eficientes.
4. Conclusão
Este estudo buscou desenvolver e avaliar um modelo de Machine Learning não supervisionado para a seleção de ativos em estratégias de Pairs Trading, comparando seu desempenho com a abordagem tradicional de Cointegração Clássica no mercado financeiro brasileiro, no período de 2004 a 2025. Verificou-se que a estratégia baseada em Machine Learning, que combinou Análise de Componentes Principais (PCA) e o algoritmo DBSCAN, gerou um retorno acumulado superior de 202,48% em comparação com 157,24% da abordagem Baseline. Observou-se também uma redução na volatilidade anualizada para 4,29% contra 4,62% da Baseline, e um drawdown máximo mitigado. Embora o Teste T de Welch não tenha indicado diferença estatisticamente significativa nos retornos médios diários (p = 0,656), o Teste de Levene sugeriu uma tendência à redução de risco (p = 0,066) pela abordagem de Machine Learning. Ambas as estratégias demonstraram um caráter market neutral, com volatilidades anuais significativamente inferiores às do IBOV. A principal contribuição prática reside na melhoria da qualidade dos pares selecionados, o que se traduziu em um portfólio com perfil de risco-retorno superior, entregando maior retorno com menor volatilidade ao longo de horizontes longos, sem necessariamente prever retornos superiores em termos estatísticos diários. Este achado reforça a aplicabilidade do framework em um mercado emergente como o brasileiro.
Contudo, a interpretação dos resultados deve considerar algumas limitações, como a ausência de custos de transação no modelo, o viés de sobrevivência dos ativos e a premissa de execução sem slippage ou impacto de mercado. Adicionalmente, a janela de lookback do protocolo walk-forward pode ser insuficiente para capturar regimes de mercado de maior duração, e o modelo não incorporou mecanismos de regime switching. Para estudos futuros, sugere-se a incorporação de custos reais de BTC, a aplicação de técnicas de Deep Learning para modelar não-linearidades e quebras de cointegração, o uso de Aprendizado por Reforço para calibração dinâmica de ordens, a avaliação da estratégia com dados intraday e a integração de filtros fundamentalistas em uma abordagem quantamental.
Referências Bibliográficas
Caldeira, J.F. 2013. Seleção de carteiras utilizando o modelo Fama-French-Carhart. Brazilian Review of Finance 11(2): 173-198.
Field, A. 2018. Discovering Statistics using IBM SPSS Statistics. 5ed. SAGE Publications, London, Inglaterra, UK.
Gatev, E.; Goetzmann, W.N.; Rouwenhorst, K.G. 2006. Pairs trading: performance of a relative-value arbitrage rule. The Review of Financial Studies 19(3): 797-827.
Resolução CNS nº 510, 2016 [Referência completa não encontrada no documento original]
Sohail, A.; et al. 2020. Pairs trading in the Chinese stock market: new evidence from DBSCAN clustering. International Journal of Finance & Economics 27(2): 1-20.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

