Inteligência Artificial
16 de outubro de 2026
Por que estudar se existe IA?
Quando respostas se tornam fáceis, aprender passa a significar mais do que chegar até elas
Por que eu preciso aprender isso se posso perguntar para uma inteligência artificial? Esse tipo de pergunta acompanha a educação há décadas. Por que aprender uma operação se existe calculadora? Por que memorizar uma informação se ela pode ser encontrada na internet? Cada nova tecnologia muda parte do que precisamos fazer sozinhos e nos obriga a discutir novamente o que vale a pena aprender.
A IA generativa amplia essa provocação, porque não automatiza apenas uma tarefa: ela pode pesquisar, resumir, explicar, traduzir, escrever, comparar argumentos e produzir respostas sobre diversos assuntos.
Usar IA já faz parte da rotina de estudantes. O Programa Internacional de Avaliação de Estudantes (PISA), coordenado pela Organização para a Cooperação e Desenvolvimento Econômico (OCDE), avalia jovens de 15 anos pela capacidade de mobilizar conhecimentos e habilidades em diferentes situações.
Em 2025, mais de 760 mil estudantes de 91 países e economias participaram. No Brasil, 48% relataram usar chatbots de IA pelo menos uma vez por semana para aprender. Cerca de 40% usam essas ferramentas para fazer pesquisas preliminares sobre novos temas, 31%, para resumir textos que precisavam lerm, e 27%, para elaborar rascunhos de trabalhos escritos. Os dados não dizem se esses estudantes aprendem mais ou menos, mas mostram que a discussão já não é sobre quando começarão a usar IA: eles já fazem isso.
Durante muito tempo, máquinas foram associadas principalmente à ampliação da força, da velocidade, do cálculo e do armazenamento. Agora, sistemas de IA também participam de atividades que associamos ao trabalho intelectual: formular argumentos, explicar conceitos, produzir textos e resolver problemas.
Isso não quer dizer que máquinas pensem como pessoas, mas que o resultado de uma atividade intelectual pode ser produzido sem que a pessoa que apresenta a resposta tenha realizado sozinha o processo que a produziu. A pergunta deixa de ser apenas o que a IA consegue fazer e passa a incluir o que chamamos de estudar quando parte desse processo pode ser delegada a ela.
Não seria a primeira vez que transferimos parte de nossas atividades mentais para uma tecnologia. Anotamos compromissos para não precisar lembrá-los, seguimos o GPS e consultamos buscadores para recuperar informações que não armazenamos.
Evan Risko e Sam Gilbert utilizam a expressão terceirização cognitiva para descrever o uso de ações e recursos externos que reduzem a demanda mental necessária para realizar uma tarefa. Andy Clark e David Chalmers já haviam proposto, em 1998, que elementos externos podem participar de nossos processos cognitivos.
A questão fica mais delicada quando confundimos uma ferramenta que amplia uma capacidade com o processo necessário para desenvolvê-la. No trabalho, terceirizar uma etapa pode ser exatamente o que torna uma atividade mais eficiente. Durante a aprendizagem, porém, a etapa terceirizada pode ser justamente aquilo que precisava ser praticado.
Escrever não serve apenas para registrar uma ideia pronta: escolher palavras, organizar uma sequência e revisar um argumento são atividades que organizam o pensamento. Resolver um problema não é apenas chegar ao resultado; envolve interpretar, escolher um caminho, testar hipóteses e compreender por que a resposta faz sentido.
Essa diferença aparece quando separamos duas coisas que frequentemente parecem iguais: desempenho e aprendizagem. Em uma revisão publicada em 2015, Nicholas Soderstrom e Robert Bjork chamaram atenção para o fato de que aquilo que uma pessoa consegue fazer durante uma atividade pode ser um indicador pouco confiável daquilo que permanecerá depois dela. É possível melhorar o desempenho durante a prática sem produzir uma mudança igualmente duradoura. Aprender envolve conseguir recuperar, aplicar ou transferir posteriormente aquilo que foi construído durante o processo.
A IA torna essa diferença especialmente visível. Em um experimento publicado em 2025 na Proceedings of the National Academy of Sciences (PNAS), pesquisadores acompanharam quase mil estudantes do ensino médio durante atividades de Matemática. Um grupo recebeu acesso a um modelo de IA genérico, chamado GPT Base. Outro utilizou o GPT Tutor, desenvolvido com orientações pedagógicas para fornecer pistas e conduzir o raciocínio sem simplesmente entregar a resposta. Um terceiro grupo realizava as atividades sem IA.
Enquanto a ferramenta estava disponível, os resultados pareciam confirmar seu potencial. O grupo com GPT Base teve desempenho 48% superior ao grupo de controle durante os exercícios, enquanto o GPT Tutor registrou uma melhora de 127%. Depois, a assistência foi retirada. No teste sem IA, os estudantes que haviam utilizado o GPT Base tiveram desempenho 17% inferior ao grupo que nunca teve acesso à ferramenta. Com o tutor, esse efeito negativo foi amplamente reduzido. Com a IA disponível, os estudantes pareciam saber mais; quando ela desaparecia, parte daquele desempenho também desaparecia.
Um comentário publicado no mesmo ano na Nature Reviews Psychology chama atenção justamente para essa confusão. Sistemas generativos podem melhorar aquilo que o estudante produz enquanto recebe assistência sem necessariamente provocar o processamento cognitivo e metacognitivo necessário para uma aprendizagem duradoura.
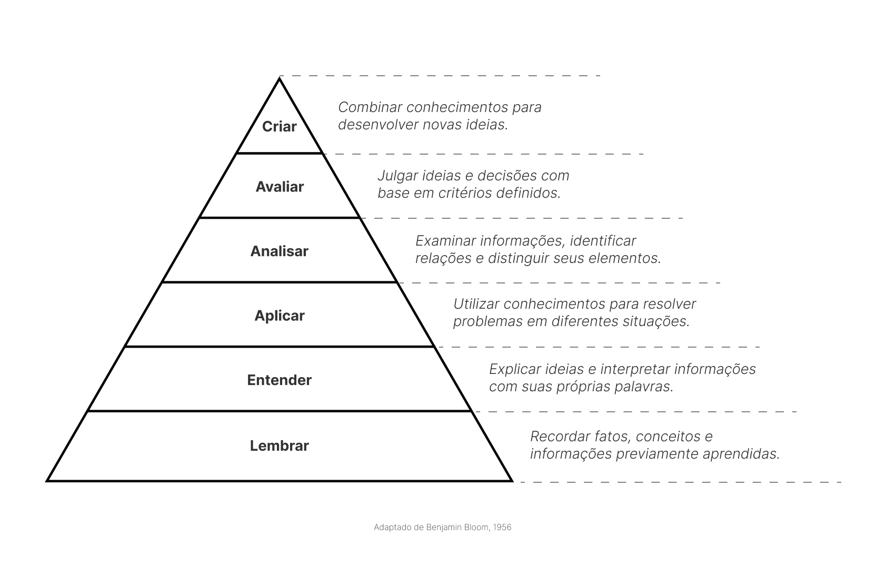
A Taxonomia de Bloom ajuda a ampliar essa leitura. Na revisão organizada por Lorin Anderson e David Krathwohl, os processos cognitivos associados aos objetivos educacionais incluem lembrar, compreender, aplicar, analisar, avaliar e criar. Mais do que uma sequência rígida, a taxonomia funciona aqui como um lembrete: chegar à resposta correta representa apenas uma parte do que significa aprender.
Essa distinção também muda a forma como podemos olhar para avaliações. Uma avaliação diagnóstica ajuda a tornar visível o ponto de partida de quem aprende: o que já consegue mobilizar, quais relações estabelece e onde existem lacunas. Em um contexto de assistência disponível o tempo todo, alguns momentos sem ela se tornam importantes não como punição ou resistência à tecnologia, mas para entender o que já foi internalizado e o que ainda depende da ferramenta.
Nem todo esforço durante o aprendizado é desperdício. Estudos sobre prática de recuperação mostram que tentar recuperar uma informação da memória ajuda a fortalecer a aprendizagem e pode desacelerar o esquecimento. Tentar lembrar antes de consultar, formular uma hipótese e reconstruir uma explicação com as próprias palavras criam oportunidades para consolidar conhecimento. O erro também pode ser produtivo quando permite comparar uma tentativa com o resultado e reorganizar o raciocínio. Há uma diferença importante entre não saber e descobrir que não se sabe.
Mas, se podemos consultar praticamente qualquer informação em segundos, por que ainda precisamos manter conhecimento na memória? A resposta exige abandonar a ideia de memória como simples depósito de fatos. Aquilo que já sabemos participa da forma como interpretamos o que encontramos e pensamos sobre novos problemas. A teoria da carga cognitiva ajuda a entender isso.
Nossa capacidade de lidar com várias informações ao mesmo tempo é limitada. Quando já conhecemos um assunto, parte desse conhecimento está organizada na memória e exige menos esforço para ser mobilizada. Por isso, saber algo previamente não serve apenas para lembrar: também facilita a compreensão de conteúdos mais complexos, porque aquilo que já sabemos funciona como base para construir novos conhecimentos.
Algo semelhante aparece na leitura. Uma revisão de 23 estudos com crianças do ensino fundamental, liderada por Reid Smith, encontrou relações entre conhecimento prévio e compreensão de textos. O efeito varia conforme o contexto, mas ajuda a desfazer uma ideia recorrente da era digital: a de que não precisamos saber, porque podemos pesquisar. Pesquisar também exige repertório. Precisamos conhecer termos para formular determinadas perguntas, compreender conceitos para comparar resultados e possuir alguma referência para perceber quando informações entram em contradição.
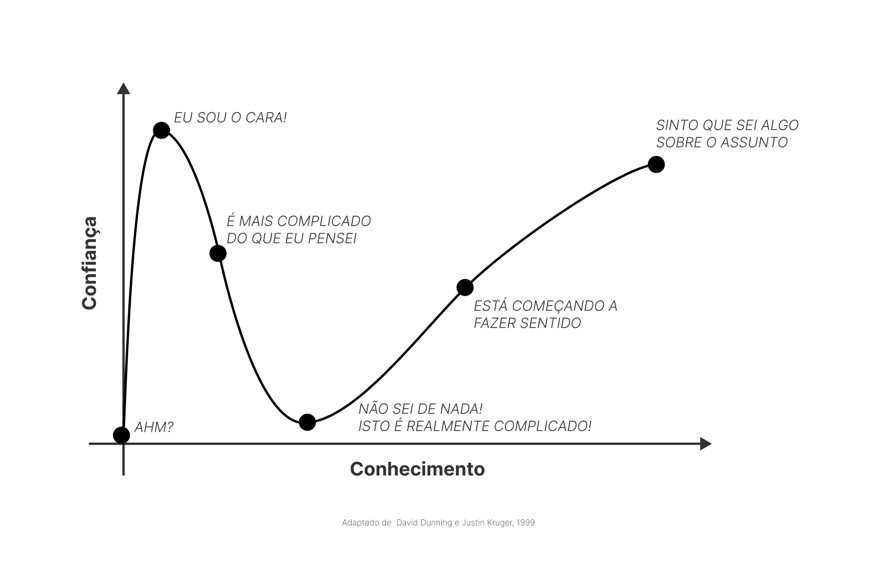
Com a IA, esse repertório ganha outra função. Uma resposta pode parecer clara e convincente mesmo quando está errada ou incompleta. Para avaliá-la, não basta saber usar a ferramenta: é preciso ter conhecimento suficiente para reconhecer o que faz sentido, o que precisa ser verificado e o que pode estar faltando. Isso lembra, em parte, uma interpretação popular do efeito Dunning‑Kruger: quando sabemos pouco sobre um assunto, também podemos ter menos critérios para perceber as próprias limitações.
Um estudo apresentado na CHI 2025 ajuda a ilustrar essa relação. Ao analisar 936 situações de uso de IA relatadas por 319 profissionais, os pesquisadores observaram que, quanto maior a confiança na IA, menor tendia a ser o esforço de pensamento crítico relatado. Já quem confiava mais no próprio conhecimento sobre a tarefa demonstrava maior envolvimento na avaliação das respostas. O estudo não prova causalidade, mas aponta para uma mudança importante: parte do trabalho intelectual deixa de se concentrar apenas na produção e passa também a envolver verificação, integração e supervisão do que a IA produz.
Durante muito tempo, uma justificativa simples para estudar poderia ser: “preciso aprender porque precisarei produzir a resposta”. Agora surge uma segunda razão: precisamos aprender também porque precisaremos julgar respostas produzidas por sistemas capazes de parecer convincentes. Quanto maior nossa capacidade de delegar, mais importante se torna decidir o que pode ser delegado, em que momento e sob quais critérios.
Ferramentas generativas também podem acelerar a aprendizagem. Um experimento publicado em 2025 com estudantes de Física em Harvard mostrou que um tutor de IA, desenvolvido com princípios pedagógicos, produziu ganhos maiores de aprendizagem em menos tempo do que a aula presencial analisada. Mais importante do que o resultado isolado é o que ele ajuda a mostrar: a IA não precisa funcionar apenas como atalho para chegar à resposta; também pode ajudar a organizar o processo de aprender.
Quando colocamos esse resultado ao lado do estudo da PNAS, a aparente contradição diminui. A mesma tecnologia pode reduzir parte do esforço necessário para aprender ou apoiar esse esforço de forma mais eficiente. A diferença não está apenas em usar ou não IA, mas no papel que ela assume durante o processo. Se a ferramenta simplesmente substitui etapas importantes do raciocínio, pode melhorar o desempenho sem necessariamente fortalecer a aprendizagem. Se ajuda a formular perguntas, testar hipóteses, receber feedback e avançar gradualmente, pode funcionar como apoio para aprender melhor.
Nesse cenário, a educação precisa olhar para a IA em três direções ao mesmo tempo: aprender com IA, usando esses sistemas como apoio; aprender sobre IA, compreendendo seus fundamentos, limites e vieses; e aprender para um mundo com IA, desenvolvendo repertório para agir em contextos nos quais esses sistemas farão parte de decisões, trabalhos e relações sociais. O Marco Referencial de Competências em IA para Estudantes, da UNESCO, segue direção semelhante ao reunir competências ligadas à ética, à compreensão técnica, à aplicação e à criação, sempre preservando a agência humana. Em 2026, a organização reforçou essa perspectiva ao colocar agência, equidade e propósito público da educação no centro de sua Digital Learning Week.
A IA também revela algo que sempre esteve presente, mas era mais fácil ignorar: informação, conhecimento e desempenho não são a mesma coisa. Ter informação disponível não significa compreendê-la. Produzir uma resposta correta não significa conseguir avaliá-la. Realizar uma tarefa com assistência também não garante que aquela capacidade permanecerá quando a assistência desaparecer.
Ao mesmo tempo, não faz sentido insistir em fazer manualmente tudo aquilo que uma tecnologia consegue realizar melhor ou mais rápido. Parte da história da tecnologia também é feita daquilo que deixamos de precisar fazer sozinhos. Como já discuti em outra coluna, tecnologias também funcionam como habilitadoras de novas possibilidades: elas não determinam um único caminho, mas ampliam aquilo que podemos imaginar e fazer. A questão educacional, portanto, não deveria ser proteger todas as atividades existentes da automação, mas compreender quais capacidades queremos desenvolver antes de decidir o que podemos delegar.
Estudamos para construir repertório suficiente para interpretar aquilo que encontramos, relacionar uma informação nova com outras que já conhecemos, formular perguntas que ainda não estavam dadas e perceber quando uma explicação não faz sentido. Estudamos para compreender antes de apenas reproduzir, avaliar antes de aceitar e criar a partir daquilo que conhecemos.
Talvez “por que estudar se existe IA?” seja um convite para repensar a função da educação. Quando respostas passam a estar disponíveis quase instantaneamente, precisamos compreender o que continua valendo a pena aprender. A IA tornou respostas abundantes. Isso não torna o aprendizado desnecessário; muda o valor do que significa saber.
| Para ter acesso às referências desse texto clique aqui |
Quem publicou esta coluna
Lucas Tangi