
16 de setembro de 2026
Modelos Multivariados Aplicados à Previsão de Atrasos no Transporte Rodoviário Regular Interestadual no Brasil
Paola Fernanda Silveira Monteiro; William Barbosa
DOI: 10.22167/2675-6528-202602304
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A integração do território brasileiro historicamente se baseou no modal rodoviário, essencial para a mobilidade nacional, mas sua eficiência é constantemente desafiada pela gestão do tempo, impactando o bem-estar social e a saúde financeira das transportadoras. Objetivou-se prever atrasos superiores a 30 minutos no transporte rodoviário regular interestadual no Brasil, utilizando modelos de Machine Learning. Para isso, empregaram-se 906.476 registros de viagens da ANTT de 2024. Aplicaram-se algoritmos como Regressão Logística, Random Forest e XGBoost, com técnicas de balanceamento de dados como UnderSampling, SMOTE e ADASYN. O Balanced Random Forest obteve a melhor performance preditiva, tratando a assimetria dos dados e apresentando baixo custo computacional, o que viabilizou sua aplicação em ambientes de produção real. A análise evidenciou que as regiões fora do eixo Sudeste/Sul exibiram uma taxa de atraso superior. Concluiu-se que o modelo pode ser empregado como um “Score” de Propensão ao Atraso, oferecendo uma ferramenta de inteligência competitiva para identificar itinerários críticos, otimizar recursos preventivos e mitigar riscos operacionais.
Palavras-chave: Balanced Random Forest; Eficiência Operacional; Machine Learning; Score de Propensão ao Atraso.
1. Introdução
O transporte rodoviário constitui o principal vetor de mobilidade no Brasil, sendo historicamente a espinha dorsal da integração territorial e responsável por 95% do transporte de passageiros em território nacional (CNT, 2023). Em 2023, o serviço regular interestadual movimentou mais de 43 milhões de passageiros, evidenciando um aumento de 2,3% em relação ao ano anterior e reforçando a relevância desse modal em um cenário de expansão econômica e urbanização (TRIIP, 2023). A eficiência do sistema de transportes é intrinsecamente ligada ao desenvolvimento econômico e social de um país, proporcionando a integração regional e o acesso a bens e serviços (Neto et al., 2017).
Apesar de sua predominância estratégica, o sistema rodoviário brasileiro enfrenta desafios estruturais e de eficiência, especialmente no que tange à gestão do tempo. A pontualidade e a integridade são atributos fundamentais para a eficácia do transporte público, impactando diretamente o bem-estar social e a percepção de qualidade do usuário (Lopes et al., 2021). Além da satisfação do passageiro, a mitigação de atrasos é crucial para a saúde financeira das operadoras, que operam com margens de lucro estreitas, entre 5,02% e 12%. Qualquer imprecisão pode gerar a mobilização desnecessária de reservas técnicas, resultando em custos adicionais com ociosidade da frota, consumo extraordinário de combustível e horas extras não planejadas (ANTT, 2020).
Nesse contexto, a ocorrência de atrasos superiores a 30 minutos representa um gargalo estratégico significativo para a eficiência do sistema, embora seja um evento relativamente raro, correspondendo a apenas 4,54% do total de viagens analisadas. Essa característica de raridade da variável resposta configura um severo desbalanceamento dos dados, impondo desafios específicos à modelagem preditiva, uma vez que algoritmos de classificação tendem a privilegiar a classe majoritária, o que pode comprometer a sensibilidade do sistema na detecção de eventos de atraso (He e Garcia, 2009). A raridade do atraso é uma característica intrínseca do sistema de transporte rodoviário, e não uma anomalia de coleta de dados, demandando abordagens metodológicas capazes de lidar com essa assimetria estrutural.
Diante da complexidade e do impacto dos atrasos, o presente estudo justifica-se pela necessidade de desenvolver ferramentas analíticas avançadas para aprimorar a gestão operacional do transporte rodoviário. A aplicação de modelos de Machine Learning, como Regressão Logística, Random Forest e Extreme Gradient Boosting, surge como uma abordagem promissora para identificar padrões e variáveis determinantes da pontualidade. A inovação reside na proposta de um “Score de Propensão ao Atraso”, que transforma a predição em uma ferramenta de inteligência competitiva, permitindo às transportadoras ranquear itinerários críticos e otimizar a alocação de recursos preventivos, mitigando riscos financeiros e elevando a qualidade percebida pelo usuário.
O presente estudo tem como objetivo estimar e comparar modelos para estimar a ocorrência de atrasos no transporte rodoviário interestadual regular de passageiros no Brasil, a partir de dados operacionais referentes ao período de janeiro a dezembro de 2024. Para tanto, são empregados algoritmos de classificação, como Regressão Logística, Random Forest e Extreme Gradient Boosting [XGBoost], visando identificar padrões e variáveis determinantes do desempenho operacional. A partir dessas estimativas, propõe-se a construção de um Escore de Propensão ao Atraso, permitindo o ranqueamento dos itinerários segundo o nível de criticidade. Essa abordagem busca contribuir para o aprimoramento da gestão operacional, a priorização de intervenções e a otimização da alocação de recursos no setor.
2. Material e Métodos
Esta pesquisa possui natureza exploratória, descritiva e aplicada, com abordagem quantitativa. O estudo emprega algoritmos de “Machine Learning” para classificar a ocorrência de atraso ou não atraso, focando na análise da influência de fatores contextuais e operacionais na pontualidade do sistema de transporte por meio de variáveis categóricas. Para lidar com o desbalanceamento natural entre as classes da variável resposta, foram aplicadas técnicas de balanceamento de dados, incluindo “UnderSampling”, “Synthetic Minority Over-sampling Technique“ [SMOTE], “Adaptive Synthetic Sampling” [ADASYN] e o “Balanced Random Forest”.
Para a análise, foram utilizados dados públicos da Agência Nacional de Transportes Terrestres (ANTT) referentes a viagens rodoviárias regulares interestaduais no Brasil, coletados de janeiro a dezembro de 2024. A base de dados, em formato “comma-separated values” [csv], contém informações operacionais de 906.476 registros de viagens realizadas em todo o território nacional. A Tabela 1 detalha as informações originais desta base.
Tabela 1. Dicionário da base de dados do relatório de viagens rodoviárias interestaduais regulares
| Colunas | Tipo | Formato |
|---|---|---|
| Placa | Alfanumérico | |
| nu_linha | Alfanumérico | |
| data_viagem_programada | Data | DD/MM/AAAA |
| hora_viagem_programada | Hora | HH:MM:SS |
| data_inicio_viagem | Data/Hora | DD/MM/AAAA HH:MM:SS |
| data_fim_viagem | Data/Hora | DD/MM/AAAA HH:MM:SS |
| Latitude | Numérico | |
| Longitude | Numérico | |
| Pdop | Numérico |
Fonte: Dados originais da pesquisa
Os campos “placa” e “nu_linha” identificam o veículo e o número da linha, respectivamente. As variáveis “data_viagem_programada” e “hora_viagem_programada” indicam a data e o horário previstos, enquanto “data_inicio_viagem” e “data_fim_viagem” registram os momentos efetivos de partida e chegada. “Latitude” e “Longitude” fornecem as coordenadas geográficas do ponto final, e “position dilution of precision” [pdop] expressa a precisão do posicionamento. Informações adicionais sobre o ano de fabricação e o tipo do veículo foram incorporadas por meio de cruzamento com uma segunda base de dados, utilizando as placas como chave de relacionamento. A estrutura das novas colunas pode ser consultada na Tabela 2.
Tabela 2. Dicionário da base de dados de veículos de viagens rodoviárias interestaduais regulares
| Colunas | Tipo | Formato |
|---|---|---|
| Placa | Alfanumérico | |
| Tipo de veículo | Alfanumérico | |
| Ano de fabricação | Data |
Fonte: Dados originais da pesquisa.
A preparação dos dados envolveu limpeza, tratamento de inconsistências e remoção de dados irrelevantes, como rotas internacionais e variáveis não focadas no estudo. Foi realizada a conversão e padronização para ordenação temporal dos registros. As análises foram conduzidas no ambiente de desenvolvimento Spyder, utilizando pacotes como pandas 2.3.3, numpy 1.26.4, scipy 1.16.3, matplotlib 3.8.0, seaborn 0.13.2, statsmodels 0.14.1, scikit-learn 1.2.2, xgboost 3.0.4, shap 0.46.0, imbalancedlearn 0.11.0, geopandas 1.0.1 e holidays 0.75 em Python 3.11. Os registros foram agrupados mensalmente (janeiro a dezembro de 2024), e os destinos foram classificados em regiões. A análise possui limitações, como a impossibilidade de calcular distâncias devido à ausência de pontos de origem e fim de linha, e a falta de informações diárias sobre as condições das rodovias.
O critério para classificar atrasos em viagens foi estabelecido com base no parâmetro proposto por Monsuur et al. (2021), considerando atrasos superiores a 30 minutos. O cálculo do atraso foi feito pela diferença, em minutos, entre a data e hora reais de saída e as programadas, com valores negativos ajustados para zero. A idade da frota foi calculada subtraindo o ano de fabricação do veículo pelo ano das viagens (2024).
As variáveis quantitativas foram transformadas em qualitativas (binárias). Para a variável resposta, atrasos superiores a 30 minutos receberam valor 1, e os demais, valor 0. Similarmente, a variável explicativa “veiculo_velho” foi definida como 1 para veículos com idade igual ou superior a 10 anos e 0 para os com menos de 10 anos. A variável “atraso” corresponde à diferença, em minutos, entre o horário programado e o horário real da viagem, com valores negativos ajustados para zero.
Para investigar e classificar os atrasos, foram adotados modelos preditivos multivariados capazes de capturar relações lineares e não lineares. Foram selecionados três algoritmos: Regressão Logística, Random Forest e Extreme Gradient Boosting (XGBoost). A escolha desses modelos se deu pela natureza da variável resposta e sua robustez em tarefas de classificação, além da flexibilidade para lidar com diferentes tipos de variáveis, incluindo contextos com multicolinearidade e interações complexas.
A Regressão Logística modela a relação entre uma variável de resposta binária e preditoras, utilizando uma função logística (sigmoide) para transformar a combinação linear dos preditores em probabilidade, com saída entre 0 e 1. A função é definida como:
p(X) = eβ0+β1X / (1+eβ0+β1X) (1)
Onde p(X) é a probabilidade da classe positiva estar presente, e β0 e β1 são os coeficientes do modelo. A transformação logística é apresentada como:
g(X) = ln[p(X)/(1-p(X))] = β0 + β1X (2)
Onde g(X) é o logaritmo da razão de chances [odds], p(X) a probabilidade de ocorrência do evento de interesse, 1-p(X) a probabilidade complementar, e β0 e β1 o valor de base e o coeficiente angular, respectivamente.
O “Random Forest” (Santos, 2020) é um método de aprendizado conjunto que constrói múltiplas árvores de decisão. Cada árvore é treinada independentemente usando uma amostra aleatória dos dados (“bootstrap”), e um subconjunto aleatório de variáveis é selecionado para cada divisão, promovendo diversidade e evitando o sobreajuste. As previsões são geradas pela combinação dos resultados individuais das árvores (votação majoritária para classificação).
O XGBoost (Barreto, 2023) é um algoritmo de aprendizado de máquina que utiliza o método de “boosting”, combinando sequencialmente múltiplas árvores de decisão para modelos preditivos precisos. Ele otimiza o desempenho do “gradient boosting” e aplica técnicas de regularização para prevenir o “overfitting”. A função objetivo é dada por:
Obj(θ) = Σi=1nl(yi, ŷi) + Σk=1K Ω(fk) (3)
Onde Obj(θ) é a função objetivo a ser otimizada, θ são os parâmetros do modelo, n é o número de amostras de treinamento, l(yi, ŷi) é a função de perda, e Ω(fk) é a função de penalidade ou regularização aplicada à árvore fk.
Para avaliar o desempenho dos modelos preditivos, os dados foram particionados em conjuntos de treino e teste. Foram utilizadas métricas apropriadas para problemas de classificação com forte desbalanceamento entre as classes, como F1-score, área sob a Curva ROC [AUC] e a estatística Kolmogorov-Smirnov [KS]. A acurácia não foi adotada como métrica principal. O F1-score é definido como:
F1-score = 2 * (Precision * Recall) / (Precision + Recall) (4)
Onde “Precision” e “Recall” são definidos por:
Precision = VP / (VP + FP) (5)
Recall = VP / (VP + FN) (6)
Sendo VP os Verdadeiros Positivos, FP os Falsos Positivos e FN os Falsos Negativos. A AUC é definida como:
AUC = ∫01 TVP(TFP-1(x))dx (7)
Onde TVP é a Taxa de Verdadeiros Positivos e TFP é a Taxa de Falsos Positivos. A estatística KS é definida como:
KS = max|F_positiva(x) – F_negativa(x)| (8)
Onde F_positiva(x) e F_negativa(x) representam o comportamento acumulado das probabilidades previstas para as classes atraso e não_atraso. Adicionalmente, o tempo de execução dos modelos foi registrado para avaliar a eficiência computacional.
O balanceamento de dados foi abordado para neutralizar a assimetria entre as classes ‘não atrasos’ e ‘atrasos’. As abordagens de amostragem implementadas e comparadas incluíram “UnderSampling” (redução da classe majoritária), “Synthetic Minority Over-sampling Technique“ [SMOTE] e “Adaptive Synthetic Sampling” [ADASYN] (criação de dados sintéticos por interpolação). O “Balanced Random Forest” mitiga o desbalanceamento internamente, realizando amostragem equilibrada para cada árvore do “ensemble” sem descartar permanentemente dados.
Para interpretar os “outputs” dos modelos, utilizou-se o Shapley Additive Explanations [SHAP], uma ferramenta de Inteligência Artificial Explicável [XAI] do tipo “post-hoc” (Lundberg e Lee, 2017). O SHAP calcula o impacto marginal de cada variável, permitindo identificar quais variáveis influenciam a probabilidade de atraso ou pontualidade, atuando como mecanismo de controle para auditoria e interpretação humana.
3. Resultados e Discussão
A análise dos dados de transporte rodoviário interestadual no Brasil, referentes a janeiro a dezembro de 2024, revelou uma concentração significativa de linhas na região Sudeste, refletindo sua alta densidade populacional e infraestrutura rodoviária. Essa centralidade é ilustrada pela distribuição das linhas em todo o território nacional, conforme a Figura 1.
Figura 1. Destinos do transporte rodoviário regular interestadual no Brasil segundo dados da ANTT (2024)
Fonte: Resultados originais da pesquisa
A distribuição das rodovias por região, segundo a Confederação Nacional do Transporte (CNT, 2024), mostra que a região Sul possui a maior densidade de rodovias pavimentadas (20,5 km/mil km²), enquanto a região Norte apresenta a menor (2,7 km/mil km²). Essa diferença na infraestrutura e nas características geográficas do Norte historicamente favorece outras modalidades de transporte, como a fluvial, e impõe desafios logísticos para a manutenção das rodovias, resultando em menor quantidade de linhas nessa região.
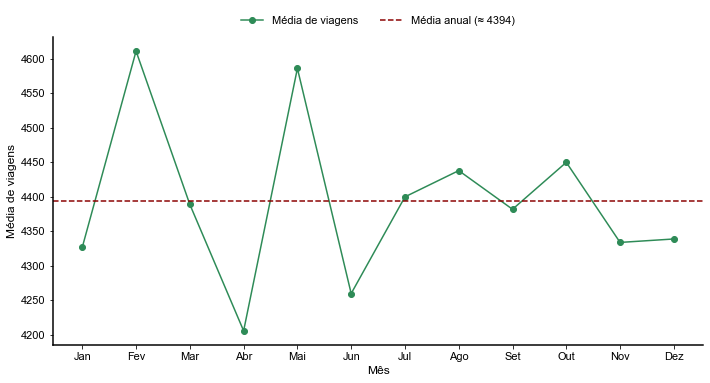
A média diária de viagens por mês em 2024, apresentada na Figura 2, indicou uma variação relativamente estável no volume de viagens rodoviárias interestaduais, oscilando entre 4.200 e 4.600 viagens diárias. Fevereiro registrou a maior média, impulsionado pelo feriado de Carnaval, que em 2024 ocorreu de 10 a 14 de fevereiro, gerando aumento na demanda. Abril, por sua vez, apresentou a menor média, possivelmente devido ao feriado prolongado da Semana Santa, que concentrou viagens em poucos dias e reduziu os dias efetivos de operação. Fatores como condições climáticas e período escolar também podem ter influenciado a frequência de viagens.
Figura 2. Média de viagens mensais em 2024
Fonte: Resultados originais da pesquisa
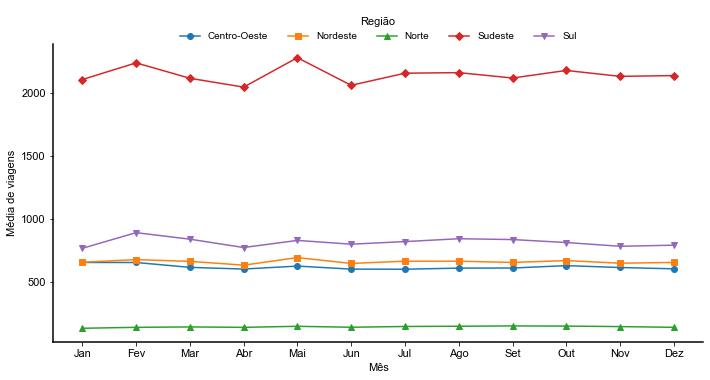
A Figura 3 evidencia padrões distintos de mobilidade entre as cinco regiões do Brasil. A região Sudeste consistentemente apresentou a maior média diária de viagens ao longo do ano, com picos em fevereiro e maio, indicando maior intensidade de atividades e demanda populacional. Em contraste, a região Norte manteve a menor média diária de viagens, em um patamar inferior às demais, atribuído a menor adensamento populacional, vastas extensões geográficas e infraestrutura de transporte diferenciada. As regiões Centro-Oeste, Nordeste e Sul apresentaram padrões intermediários, com o Sul destacando-se com média diária superior ao Centro-Oeste e Nordeste, mas ainda abaixo do Sudeste. As flutuações mensais em todas as regiões podem refletir sazonalidades relacionadas a períodos de férias, feriados ou eventos específicos.
Figura 3. Média de viagens por região em 2024
Fonte: Resultados originais da pesquisa
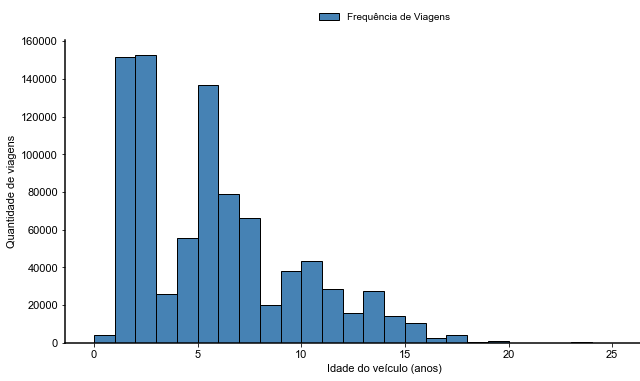
A frequência da quantidade de viagens em relação à idade dos veículos, em anos, é apresentada na Figura 4. Observou-se uma concentração significativa de viagens realizadas por veículos mais novos, com um pico proeminente na faixa de 1 a 2 anos de idade, sugerindo a intensa utilização de veículos recém-adquiridos ou com pouca rodagem. Esse achado está em conformidade com a Resolução nº 6.033/2023 da ANTT (Brasil, 2023), que estabelece um limite de 15 anos para a idade dos veículos no transporte rodoviário interestadual regular de passageiros.
Figura 4. Histograma da distribuição de viagens por idade da frota
Fonte: Resultados originais da pesquisa
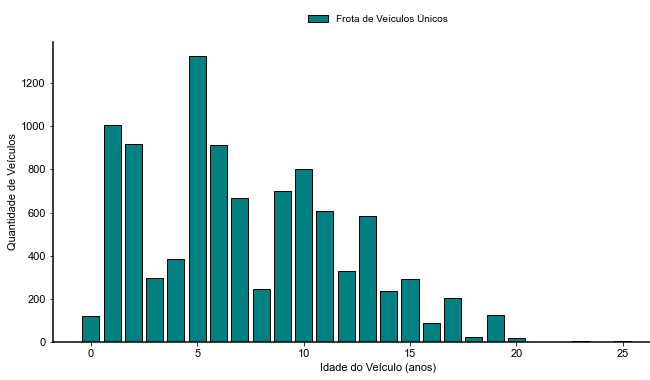
A Figura 5, que mostra a distribuição de veículos por idade, revela que a quantidade de veículos tende a diminuir gradualmente com o aumento da idade. Há uma queda acentuada após os 6 anos, e a contribuição de veículos com mais de 10 anos é consideravelmente menor, tornando-se marginal após os 20 anos e praticamente nula a partir dos 25 anos. Essa tendência é influenciada pelas exigências regulatórias que limitam a idade dos veículos e incentivam a renovação da frota (Brasil, 2023).
Figura 5. Histograma da distribuição de veículos por idade
Fonte: Resultados originais da pesquisa
A categorização das regiões em dois blocos (Sudeste/Sul e demais regiões) permitiu comparar as diferenças estruturais na propensão ao atraso. O bloco Sudeste/Sul concentrou 611.300 viagens, enquanto as demais regiões registraram 295.176. Em termos absolutos, o número de atrasos foi maior no Sudeste/Sul (24.932 ocorrências). No entanto, a taxa proporcional de atraso inverteu esse padrão: Sudeste/Sul apresentou 4,08%, enquanto as demais regiões registraram 5,49%. Isso indica que, apesar do maior volume operacional nas regiões mais dinâmicas, a probabilidade relativa de atraso é mais elevada nas demais regiões, sugerindo que intensidade operacional e propensão estrutural ao atraso não coincidem necessariamente. A Tabela 3 sintetiza esses resultados.
Tabela 3. Taxa de atraso por blocos regionais
| Bloco Regional | Total de Viagens | Total de Atrasos | Taxa de Atraso (%) |
|---|---|---|---|
| Sudeste + Sul | 611300 | 24932 | 4,08 |
| Demais regiões | 295176 | 16212 | 5,49 |
Fonte: Resultados originais da pesquisa
A análise da variável resposta revelou um desbalanceamento estrutural significativo: do total de 906.476 observações, 95,46% corresponderam a viagens pontuais, e apenas 4,54% a atrasos superiores a 30 minutos. Essa raridade dos eventos de atraso (aproximadamente 21 viagens pontuais para cada atraso) impõe desafios à modelagem preditiva, pois algoritmos de classificação tendem a privilegiar a classe majoritária (He e Garcia, 2009). A raridade do atraso é uma característica intrínseca do sistema de transporte rodoviário de passageiros, e não uma falha de coleta de dados. Assim, a modelagem preditiva deve incorporar o desbalanceamento como parte da realidade operacional, exigindo estratégias metodológicas específicas. Os modelos avaliados foram identificados conforme a Tabela 4.
Tabela 4. Siglas para identificação dos modelos
| Modelo | Identificação |
|---|---|
| UnderSampler + XGBoost | UXGB |
| SMOTE + XGBoost | SXGB |
| ADASYN + XGBoost | AXGB |
| Balanced Random Forest | BRF |
| Regressão Logística | RL |
Fonte: Resultados originais da pesquisa
A Regressão Logística (RL) foi utilizada para diagnosticar a influência das variáveis independentes sobre o atraso. Os coeficientes obtidos após o ajuste do modelo, detalhados na Tabela 5, indicam os fatores com maior peso estatístico. A variável `Duração (> 6h)` apresentou o maior coeficiente (β = 1,7242), sugerindo um impacto significativo no aumento da probabilidade de atrasos. As variáveis `Feriado`, `Fim de semana` e `Idade do veículo` também mostraram coeficientes positivos, enquanto a variável `Região (Sul/Sudeste)` apresentou coeficiente negativo (β = -0,3374), indicando uma redução na probabilidade de atrasos nessas localidades.
Tabela 5. Coeficientes estimados da regressão logística
| Variável | Coef (β) | OR | Erro-padrão | IC 95% | p-valor |
|---|---|---|---|---|---|
| Intercepto | -3,7792 | 0,0228 | 0,0115 | [0,0223;0,0234] | <0,001 |
| Região (Sul/Sudeste) | -0,3374 | 0,7136 | 0,0106 | [0,6990;0,7286] | <0,001 |
| Feriado | 0,3958 | 1,4855 | 0,0355 | [1,3857;1,5925] | <0,001 |
| Duração (> 6h) | 1,7242 | 5,6081 | 0,0116 | [5,4817;5,7374] | <0,001 |
| Idade do veículo | 0,3030 | 1,3539 | 0,0143 | [1,3165;1,3923] | <0,001 |
| Fim de semana | 0,3891 | 1,4757 | 0,0128 | [1,4390;1,5133] | <0,001 |
Fonte: Resultados originais da pesquisa
Para avaliar a qualidade preditiva dos modelos, foram utilizadas métricas de desempenho específicas para dados desbalanceados. As Tabelas 6 e 7 apresentam os resultados de Precision, Recall, F1-Score, AUC, KS e tempo de execução para os modelos nas bases de treino e teste.
Tabela 6. Resultados obtidos para os parâmetros Precision, Recall e F1-Score para os modelos nas bases de treino e teste
| Modelo | Precision Treino | Precision Teste | Recall Treino | Recall Teste | F1- Score Treino | F1- Score Teste |
|---|---|---|---|---|---|---|
| UXGB | 0,137758 | 0,140548 | 0,364575 | 0,371977 | 0,199960 | 0,204012 |
| SXGB | 0,137758 | 0,140548 | 0,364575 | 0,371977 | 0,199960 | 0,204012 |
| AXGB | 0,139528 | 0,142788 | 0,349841 | 0,358124 | 0,199492 | 0,204171 |
| BRF | 0,137758 | 0,140582 | 0,364575 | 0,371978 | 0,199960 | 0,204012 |
| RL | 0,108390 | 0,108719 | 0,771350 | 0,770811 | 0,190072 | 0,190561 |
Fonte: Resultados originais da pesquisa
Tabela 7. Resultados obtidos para os parâmetros Threshold, AUC, KS e Tempo para cada modelo
| Modelo | Threshold | AUC Treino | AUC Teste | KS Treino | KS Teste | Tempo (s) Execução |
|---|---|---|---|---|---|---|
| UXGB | 0.686461 | 0.754085 | 0.756171 | 0.469696 | 0.471007 | 4.356287 |
| SXGB | 0.702776 | 0.754266 | 0.756478 | 0.469729 | 0.470366 | 41.09609 |
| AXGB | 0.709190 | 0.753357 | 0.755952 | 0.469678 | 0.470551 | 151.81968 |
| BRF | 0.702845 | 0.754275 | 0.756448 | 0.469683 | 0.471103 | 23.02472 |
| RL | 0.421579 | 0.742444 | 0.740606 | 0.469665 | 0.470355 | 4.883683 |
Fonte: Resultados originais da pesquisa
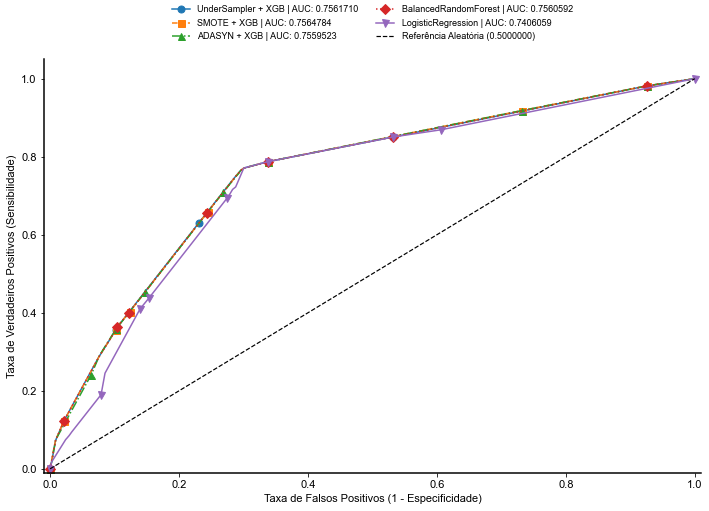
Os modelos baseados em XGBoost e Balanced Random Forest (BRF) apresentaram desempenho preditivo semelhante em termos de F1-Score, AUC e estatística KS. O BRF atingiu o maior valor de KS (0,4711) na base de teste, indicando uma capacidade superior em separar as distribuições de viagens com atraso e viagens no horário. O UXGB seguiu de perto com um KS de 0,4710, demonstrando a confiabilidade estatística de ambos para identificar padrões de irregularidade. O modelo AXGB, embora com desempenho preditivo similar, exigiu um tempo de processamento até 35 vezes superior ao UXGB e 7 vezes maior que o BRF, tornando-o menos viável operacionalmente.
A Regressão Logística foi descartada da etapa final de comparação devido ao seu desempenho inferior e limitações em capturar relações complexas, como observado nas Tabelas 6 e 7 e na Figura 6. A RL apresentou valores inferiores de F1-Score e AUC em comparação aos modelos baseados em árvores. Além disso, seu Recall elevado (0,7708) e baixa Precision (0,1087) indicaram que, embora identificasse muitos atrasos, também gerava um alto número de falsos positivos, reduzindo a confiabilidade das previsões. Modelos baseados em árvores, como o BRF, são mais flexíveis para modelar relações não lineares e interações complexas nos dados operacionais do transporte (HOSMER et al., 2013).
Figura 6. Curva ROC com todos os modelos
Fonte: Resultados originais da pesquisa
O Balanced Random Forest foi selecionado como modelo de referência, apesar do UXGB apresentar menor tempo de execução. A escolha se justifica porque o BRF trata o desbalanceamento internamente durante a construção das árvores, realizando amostragem balanceada em cada etapa do treinamento sem descartar permanentemente dados do conjunto original, preservando a variabilidade dos dados e a robustez do método. Em contraste, o undersampling do UXGB implica na remoção de observações da classe majoritária, o que pode resultar em perda de informação relevante.
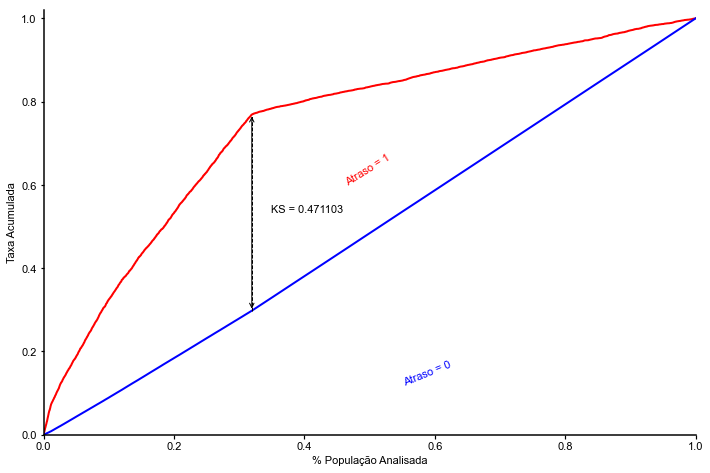
A confiabilidade operacional, especialmente a pontualidade, é crucial para a viabilidade econômica do serviço, dado que as margens de lucro no setor brasileiro são estreitas (5,02% a 12%, segundo a ANTP). Um alto índice de Falsos Positivos induziria a mobilização desnecessária de reservas técnicas, gerando custos com ociosidade da frota e combustível. A precisão do modelo BRF, portanto, atua como uma salvaguarda contra a erosão da rentabilidade e contribui para a otimização de custos e redução da incerteza do passageiro (Scháno et al., 2024; Eriksson et al., 2023; Van den Bergh et al., 2013; Diab, Wasfi e El-Geneidy, 2014). A Figura 7, que apresenta a curva KS do modelo BRF, demonstra a máxima separação entre as distribuições acumuladas de viagens pontuais e atrasadas, validando sua robustez para decisões gerenciais.
Figura 7. Curva KS obtido para o modelo Balanced Random Forest
Fonte: Resultados originais da pesquisa
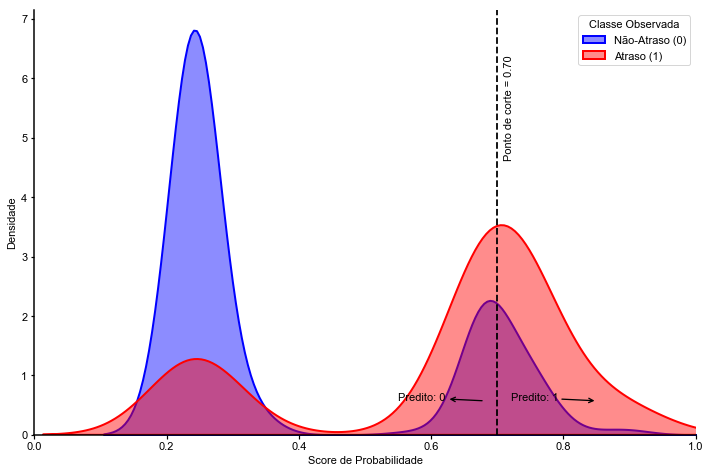
A precisão de 0,14, embora indique uma parcela significativa de alarmes falsos (86%), é inerente à natureza desbalanceada dos dados de transporte. O BRF, com sua capacidade superior de separação entre as classes (KS = 0,4711), atua como um filtro de risco, reduzindo o universo de viagens a serem monitoradas e permitindo que a gestão foque em grupos com maior probabilidade de atraso. A Figura 8 ilustra a distribuição das probabilidades previstas pelo modelo para as classes atraso e não atraso, mostrando que viagens sem atraso se concentram em probabilidades mais baixas, enquanto as com atraso se deslocam para valores mais elevados. O ponto de corte de 0,70 define a regra de decisão, classificando observações com probabilidade superior como atraso, e o modelo demonstra capacidade satisfatória de discriminação.
Figura 8. Distribuição de Scores e Ponto de Corte para o modelo Balanced Random Forest
Fonte: Resultados originais da pesquisa
Os dados consolidados na Tabela 8 mostram a capacidade do algoritmo BRF em estratificar o risco de atrasos por destino. A região Norte detém os maiores indicadores, com um escore médio de 0,432 e a maior taxa de ocorrência real (6,85%). Essa convergência valida a hipótese de que destinos com infraestrutura logística mais complexa e percursos de longa distância impõem maior propensão ao descumprimento do cronograma operacional. O escore médio é interpretado como um Índice de Vulnerabilidade: quanto mais próximo de 0,500, maior a probabilidade da viagem apresentar características de um atraso crítico, servindo como alerta preventivo.
Tabela 8. Score Médio e Taxa de Ocorrência de Atraso por Região
Fonte: Resultados originais da pesquisa
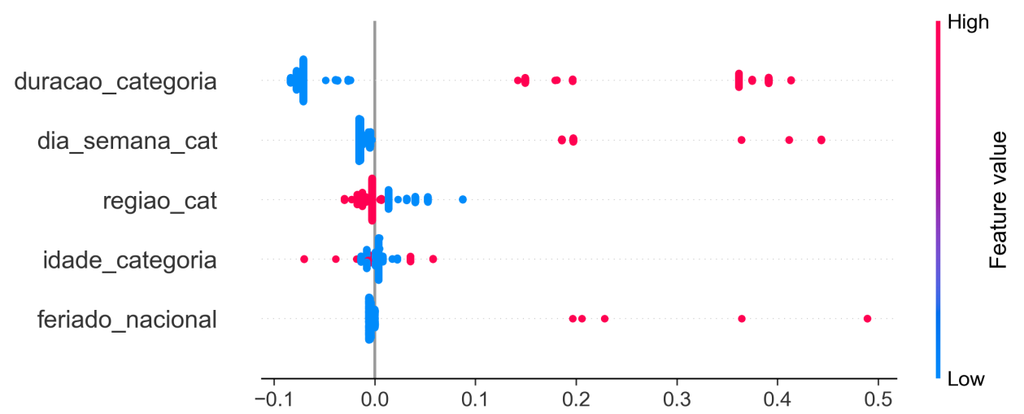
A análise de Shapley Additive Explanations (SHAP) foi utilizada para compreender a contribuição das variáveis explicativas nas previsões do algoritmo. A Figura 9 apresenta o gráfico de resumo dos valores SHAP para o modelo selecionado.
Figura 9. SHAP para o modelo Balanced Random Forest
Fonte: Resultados originais da pesquisa
Os valores SHAP indicam que variáveis operacionais, especialmente a `duracao_categoria`, exercem maior influência na previsão de atrasos, com trajetos longos aumentando significativamente essa probabilidade. O Anuário Estatístico TRIIP (ANTT, 2024) aponta que 57% das viagens em 2024 duraram entre 4 e 16 horas, evidenciando que grande parte da operação ocorre em janelas temporais com alta exposição a gargalos logísticos. A variável `dia_semana_cat` também contribui, sugerindo que a transição para o período de descanso semanal (sábados e domingos) acentua a propensão aos atrasos. O fluxo no transporte interestadual em 2024 concentrou-se nas sextas-feiras, marcando o início do ciclo de movimentação do final de semana. Embora o pico das partidas ocorra nesse dia, o modelo identificou que o risco de impontualidade se consolida de forma crítica aos sábados e domingos, sugerindo um efeito residual e cumulativo do tráfego. A variável `regiao_cat` apresenta impacto moderado, enquanto `idade_categoria` e `feriado_nacional` contribuem de forma relativamente menor.
Em síntese, o estudo demonstrou que, embora o sistema opere com alta pontualidade (>95%), a concentração de atrasos em regiões com menor infraestrutura e em períodos de maior sazonalidade cria gargalos operacionais. Apenas 4,54% das viagens apresentaram atrasos superiores a 30 minutos, um evento raro que justifica a adoção de métricas específicas para avaliação dos modelos. O modelo Balanced Random Forest (BRF) mostrou desempenho superior ao lidar com o desbalanceamento, alcançando um KS de 0,4711, o que reforça sua capacidade de discriminar eventos raros de atraso. A análise SHAP indicou que a duração da viagem e o dia da semana são as principais variáveis preditoras. A aplicação de um “Score” de Propensão ao Atraso, em vez de uma classificação binária, permite ranquear itinerários por nível de criticidade, otimizando a alocação de recursos e a antecipação de riscos operacionais, transformando dados operacionais em indicadores preditivos interpretáveis.
4. Conclusão
O presente estudo objetivou estimar e comparar modelos de Machine Learning para prever a ocorrência de atrasos superiores a 30 minutos no transporte rodoviário regular interestadual de passageiros no Brasil, utilizando uma vasta base de dados operacionais da ANTT referente ao ano de 2024. Verificou-se que, embora a pontualidade seja predominante, com apenas 4,54% das viagens registrando atrasos, as regiões fora do eixo Sudeste/Sul apresentaram uma taxa proporcional de atraso superior. Dentre os algoritmos avaliados, o Balanced Random Forest (BRF) demonstrou desempenho preditivo superior, especialmente ao lidar com o desbalanceamento intrínseco dos dados, alcançando um KS de 0,4711 e apresentando baixo custo computacional. A análise de Shapley Additive Explanations (SHAP) revelou que a duração da viagem e o dia da semana são as variáveis mais influentes na propensão a atrasos, com trajetos longos e os finais de semana acentuando essa probabilidade. A principal contribuição do trabalho reside na proposição de um “Score” de Propensão ao Atraso, que transforma a predição em uma ferramenta de inteligência competitiva, permitindo às transportadoras ranquear itinerários críticos e otimizar a alocação de recursos preventivos, mitigando riscos operacionais e financeiros.
Apesar dos achados relevantes, o estudo reconhece limitações, como o critério de 30 minutos para atraso, que possui caráter operacional e carece de um padrão formal consolidado na literatura, sugerindo a necessidade de trabalhos futuros para refinar essa definição. A complexidade computacional envolvida no tratamento e modelagem dos dados também aponta para a importância de recursos de processamento mais robustos em futuras explorações. Para estudos futuros, recomenda-se a expansão do escopo com a integração de dados exógenos, como condições de infraestrutura rodoviária, alertas de tráfego em tempo real, fatores climáticos, registros de fiscalizações e dados de telemetria da frota. Essa abordagem mais abrangente permitiria a evolução do “Score” para um “Digital Twin” da operação logística, capaz de se adaptar dinamicamente a mudanças no ambiente rodoviário e aprimorar ainda mais a gestão estratégica e a tomada de decisões no setor de transporte de passageiros.
Referências Bibliográficas
Antt. 2023. Anuário Estatístico do TRIIP 2023: Dados do Transporte Rodoviário Interestadual e Internacional. Brasília, DF, Brasil. Disponível em: < https://www.gov.br/antt/pt-br/assuntos/passageiros/anuario-estatistico-do-TRIIP >. Acesso em: 11 mar. 2025.
Antt. 2024. Anuário Estatístico do TRIIP 2024: Dados do Transporte Rodoviário Interestadual e Internacional. Brasília, DF, Brasil. Disponível em: < https://www.gov.br/antt/pt-br/assuntos/passageiros/anuario-estatistico-do-TRIIP >. Acesso em: 15 abr. 2025.
Barreto, J.S. 2025. Predição de síndrome respiratória aguda grave por meio de multiclassificação com algoritmos de machine learning. Monografia em Estatística. Universidade Estadual da Paraíba, Campina Grande, PB, Brasil. Disponível em: < https://dspace.bc.uepb.edu.br/jspui/bitstream/123456789/30153/9/TCC%20-%20Joseferson%20da%20Silva%20Barreto>. Acesso em: 27 mai. 2025.
Brasil. 2023. Resolução n° 6.033, de 21 de dezembro de 2023. Dispõe sobre o Marco Regulatório do Transporte Rodoviário Coletivo Interestadual e Internacional de Passageiros. Diário Oficial da União, Brasília, DF, Brasil, 22 dez. 2023. Seção 1, p. 182. Disponível em: https://nttlegis.antt.gov.br/action/ActionDatalegis.php?acao=detalharAto&numeroAto=00006033&valorAno=2023. Acesso em: 14 abr. 2026.
Confederação Nacional do Transporte [CNT]. 2023. Pesquisa CNT de Rodovias 2023. CNT SEST SENAT, ITL, Brasília, DF, Brasil. Disponível em: < https://static.poder360.com.br/2023/11/pesquisa-cnt-rodovia-2023.pdf >. Acesso em: 24 mar. 2025.
Confederação Nacional do Transporte [CNT]. 2024. Pesquisa CNT de Rodovias 2024. CNT, SEST SENAT, ITL, Brasília, DF, Brasil. Disponível em: < https://cnt.org.br >. Acesso em: 29 jul. 2025.
Diab, E.; Wasfi, R.; El-Geneidy, A. 2014. Extraboard team sizing: an
Eriksson, E.L.; Lidestam, H.; Winslött Hiselius, L. 2023. Effects on operating costs of adjusting bus departure times during peak-hour traffic in Sweden. Research in Transportation Economics 100(1): 101327. Disponível em: . Acesso em: 28 ago. 2025.
He, H.; Garcia, E.A. 2009. Learning from imbalanced data. IEEE Transactions on Knowledge and Data Engineering 21(9): 1263-1284. Disponível em: < https://ieeexplore.ieee.org/document/5128907 >. Acesso em: 28 fev. 2026.
Hosmer, D.W.; Lemeshow, S.; Sturdivant, R.X. 2013. Applied Logistic Regression. 3ed. Wiley, Hoboken, NJ, USA. Disponível em: < https://doi.org/10.1002/9781118548387 >. Acesso em: 08 mar. 2026.
Lopes, D.; Diniz, H.; Balbino, L.; Pretti, L.; Freitas, L.; Vieira, T.; Gonçalves, W. 2021. Proposta de indicador padronizado de pontualidade para o transporte de passageiros no modal rodoviário. Fundação Dom Cabral, Vitória, ES, Brasil. Disponível em: < https://repositorio.itl.org.br/jspui/bitstream/123456789/535/3/Proposta%20de%20indicador%20padronizado%20de%20pontualidade%20para%20o%20transporte%20de%20passageiros%20no%20modal%20rodovi%C3%A1rio.pdf >. Acesso em: 12 mar. 2025.
Lundberg, S.M.; Lee, S.I. 2017. A Unified Approach to Interpreting Model Predictions. In: International Conference on Neural Information Processing Systems, 2017, Long Beach, CA, USA. Anais… p. 4765-4774. Disponível em: < https://arxiv.org/abs/1705.07874 >. Acesso em: 07 abr. 2026.
Monsuur, F.; Enoch, M.; Quddus, M.; Meek, S. 2021. Modelling the impact of rail delays on passenger satisfaction. Transportation Research Part A: Policy and Practice 152(C): 19-35. Disponível em: < https://doi.org/10.1016/j.tra.2021.08.002 >. Acesso em: 21 jul. 2025.
Neto, T.O.; Nogueira, R.J.B. 2017. Transporte rodoviário de passageiros no Brasil. Revista Transporte y Territorio 16(1): 229-250. Disponível em: < https://dialnet.unirioja.es/descarga/articulo/6175452.pdf >. Acesso em: 11 mar. 2025.
Santos, G.C. 2020. Algoritmos de Machine Learning para previsão da B3. Dissertação de Mestrado em Engenharia Elétrica. Universidade Federal de Uberlândia, Uberlândia, MG, Brasil. Disponível em: < https://doi.org/10.14393/ufu.di.2020.640 >. Acesso em: 23 mai. 2025.
Scháno, M.; Dvořáčková, A.; Smíšek, O. 2024. Assessing time and financial costs of bus delays in the Ústí nad Labem Region, Czech Republic. Acta Polytechnica CTU Proceedings 51(1): 94-108. Acesso em: 23 mai. 2025.
Van den Bergh, J.; Beliën, J.; De Bruecker, P.; Demeulemeester, E.; De Boeck, L. 2013. Personnel scheduling: A literature review. European Journal of Operational Research 226(3): 367-385. Disponível em: < https://doi.org/10.1016/j.ejor.2012.11.029 >. Acesso em: 13 abr. 2026.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

