
16 de setembro de 2026
Modelos Analíticos para Inteligência Comercial em Consultoria de Serviços
Mariana Briamonte da Silveira; Anna Carolina Martins
DOI: 10.22167/2675-6528-202602273
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
Um modelo preditivo de classificação, baseado em regressão logística, foi desenvolvido e validado para estimar a probabilidade de conversão de novos negócios em uma consultoria de serviços brasileira. O objetivo foi identificar os fatores determinantes para o fechamento de contratos, como fonte da demanda, setor da empresa e valor do projeto, visando complementar a tomada de decisão empírica com uma abordagem orientada por dados. Para isso, analisaram-se dados históricos de Customer Relationship Management (CRM) entre os anos de 2022 e 2025. O modelo foi avaliado por métricas de desempenho como Acurácia, AUC e Precisão, para garantir sua aplicabilidade como ferramenta de suporte à liderança na priorização de esforços comerciais. Os resultados indicaram que estratégias baseadas na carteira de clientes, como up-selling e next-selling, apresentaram associação positiva relevante com a conversão. Oportunidades de maior valor e determinados setores demonstraram menor probabilidade de fechamento. Embora o modelo tenha apresentado capacidade preditiva moderada, demonstrou potencial ao traduzir dados históricos em direcionadores práticos de ação. Evidenciaram-se, contudo, limitações relacionadas à qualidade e granularidade dos dados e à complexidade do fenômeno analisado, reforçando a necessidade de seu uso como complemento ao julgamento gerencial e abrindo espaço para evoluções futuras.
Palavras-chave: Data-driven; Inteligência comercial; Regressão logística.
1. Introdução
Independente do setor de atuação, a ciência de dados tem se mostrado uma esfera do conhecimento necessária para empresas que querem manter ou aumentar sua relevância e competitividade no mercado. O uso de abordagens analíticas permite guiar o lançamento de novos produtos, otimizar preço, trazer eficiência para a operação, gerar previsibilidade de vendas, dentre outras vantagens (Pinheiro, 2024).
Essas abordagens analíticas tornaram-se cada vez mais robustas ao passo que a internet e a geração de dados evoluíram nos anos 2000. Neste contexto, as empresas começaram a cruzar informações internas e externas em grandes volumes e velocidades, buscando identificar padrões e antecipar comportamentos de consumo. Esse movimento é formalizado quando Laney (2001) descreve o conceito de Big Data a partir de três dimensões, conhecidas como os “3 Vs”: volume, velocidade e variedade. Assim, mais do que um volume massivo de dados, o Big Data representa uma mudança de paradigma: a necessidade de novas tecnologias para apoiar a tomada de decisão baseada em dados e aumentar a eficiência organizacional. Dessa forma, o uso do Machine Learning (ML) foi um acelerador, já que tornou os sistemas computacionais capazes de aprender a partir de dados, ajustando seus próprios parâmetros e melhorando o desempenho em tarefas específicas (Mitchell, 1997).
Alinhado à mudança de paradigma em direção à tomada de decisão baseada em dados, este estudo aplica tais conceitos ao contexto de uma consultoria de médio porte localizada no Brasil. Historicamente, a elevada variabilidade da demanda, associada à baixa padronização de processos, levou as lideranças da organização a formular hipóteses sobre a limitação de seus dados internos, atribuindo-lhes baixo poder explicativo sobre o desempenho comercial, por exemplo, a probabilidade de conversão dos negócios.
Como consequência do subaproveitamento desses dados, observa-se uma alocação ineficiente dos recursos comerciais, com priorização de esforços, setores ou ofertas que apresentam menor probabilidade real de fechamento. Soma-se a esse cenário o fato de que os dados da consultoria não se encontram historicamente estruturados, o que dificulta análises mais robustas e a extração de insights relevantes.
É importante dizer que, apesar dos dados terem pouca relevância no processo de tomada de decisão da consultoria no cenário atual, os esforços comerciais empreendidos com base na observação empírica do mercado trazem retorno, mesmo que com pouca previsibilidade. Dessa forma, este trabalho não tem o intuito de sugerir uma completa mudança na forma como a consultoria toma suas decisões comerciais, mas tem a pretensão de testar a hipótese de que há modelos baseados em dados que podem aumentar a previsão de fechamento de negócios e trazer mais conforto ou urgência para o time, direcionando esforço e escolha das estratégias comerciais.
O tema é relevante, pois há um desafio recorrente da liderança da empresa para explicar ao Conselho o seu contexto comercial, defender ampliação do time e investimentos em novos negócios, por exemplo. Em grande parte dos fóruns em que se debate a questão comercial, metas e previsão de vendas, não há clareza do porquê as vendas aumentaram ou diminuíram, como elas vão se comportar no próximo semestre, e se elas poderiam estar ainda melhores ou piores que a situação atual.
Para a modelagem preditiva, escolheu-se como modelo a regressão logística. Segundo James et al. (2021), este é um método estatístico que também integra o campo do Machine Learning supervisionado, pois aprende padrões a partir de dados rotulados e utiliza essas relações para prever o desfecho de novos casos. O modelo calcula a probabilidade de ocorrência de um evento por meio de uma função logística, que transforma uma combinação linear de variáveis em um valor entre zero e um.
A regressão logística se destaca por sua capacidade de gerar probabilidades bem calibradas e por seu elevado grau de interpretabilidade (James et al., 2021). Essa característica é particularmente relevante em contextos empresariais com bases de dados de menor volume, onde a compreensão dos fatores que influenciam o desfecho das negociações é tão importante quanto a acurácia do modelo. Diferentemente de modelos considerados “caixa-preta”, a regressão logística permite maior transparência analítica, possibilitando à liderança identificar não apenas a probabilidade de conversão, mas também os principais drivers do sucesso comercial.
Por fim, este estudo busca não apenas aplicar uma técnica estatística de previsão, mas também entender o valor estratégico da análise de dados na gestão comercial da consultoria de serviços. Ao traduzir informações históricas do CRM em probabilidades e padrões interpretáveis, pretende-se construir uma base analítica que apoie decisões mais assertivas sobre prospecção, priorização e negociação de oportunidades. Mais do que um exercício técnico, este estudo representa um passo concreto na consolidação de uma cultura orientada por dados dentro da organização, contribuindo para reduzir incertezas, direcionar estratégias e ampliar o potencial competitivo da empresa. Assim, este trabalho tem como objetivo desenvolver e validar um modelo preditivo de classificação, baseado em regressão logística, para estimar a probabilidade de conversão de novos negócios em uma consultoria de serviços brasileira.
2. Material e Métodos
O presente trabalho caracteriza-se como um estudo aplicado, utilizando dados reais provenientes do processo comercial de uma empresa de consultoria de serviços de médio porte localizada no Brasil. A pesquisa adota uma abordagem exploratória e descritiva inicial para a compreensão dos dados, evoluindo para análises preditivas e prescritivas fundamentadas em métodos quantitativos.
A coleta de dados foi realizada a partir de registros secundários do Customer Relationship Management (CRM) da consultoria, disponibilizados para o projeto. Após tratamento inicial, a base de dados continha 12 variáveis, com registros de janeiro de 2022 a novembro de 2025, totalizando cerca de 569 linhas. As variáveis disponíveis para análise, com suas descrições e indicação de uso, são apresentadas na Tabela 1.
Tabela 1 – Variáveis disponíveis para análise
| Nome | Tipo | Descrição | Considerada na análise |
|---|---|---|---|
| ID do Negócio | Numérica | Chave-primária relacionada a abertura de uma demanda | Sim |
| Nome da Empresa | Categórica Nominal | Nome da empresa que está cotando um serviço com a consultoria | Não |
| Oferta | Categórica Nominal | Categorização daquela demanda em alguma oferta específica da consultoria, podendo ser: (1) Alocação de Recurso; (2) Análise ou Gestão de Portfólio; (3) Benchmark ou Pesquisa de Mercado; (4) Capacitação, Palestras e Workshops; (5) CVB; (6) Design Estratégico; (7) Diagnóstico de Inovação; (8) Estratégia de Inovação ou Fomento; (9) Estratégia Digital / IA; (10) Estratégia Tecnológica; (11) Execução de Projetos; (12) Indefinido; (13) Planejamento Estratégico; (14) Plataforma de Gestão; (15) Prêmios de Inovação; (16) Programas de Inovação | Sim |
| Data de Criação | Temporal Numérica Contínua | Data em que o deal¹ foi registrado (aberto) no CRM | Sim |
| Data de Ganho | Temporal Numérica Contínua | Data em que o deal foi dado como ganho no CRM | Não |
| Valor | Numérica Contínua | Valor negociado para a contratação do projeto em questão (em reais – R$) | Sim |
| Status | Categórica Nominal | Identificação se o negócio está (1) aberto, (2) ganho ou (3) perdido | Sim |
| Etapa | Categórica Ordinal | Etapa em que o negócio estava no funil em determinado momento, podendo ser: (1) Entendimento da Demanda; (2) Elaboração da Proposta; (3) Revisão / Negociação; (4) Contratação / Entrega; (5) Entregue para Operação; (6) Stand By (quando a oportunidade não foi dada como perdida, mas postergada para o futuro) | Não |
| Fonte da Demanda | Categórica Nominal | Múltipla escolha, define qual a origem da demanda do deal em até nove possibilidade: (1) Ações de Marketing; (2) Cross-selling; (3) Espontâneo; (4) Eventos Próprios; (5) Eventos Terceiros; (6) Indefinido; (7) Indicação; (8) Next-selling; (9) Resgate de contatos; (10) Up-selling | Sim |
| Motivo de Perda | Categórica Nominal | Identificação do motivo do projeto não ter sido ganho. Dentre as razões mapeadas, há: (1) Cliente não retorna contato; (2) Demanda não identificada; (3) Inadequação da abordagem; (4) NA (no caso de negócios ganhos); (5) Outra oportunidade em andamento; (6) Outros; (7) Preço; (8) Projeto não será mais executado; (9) Resolveram fazer internamente | Sim |
| Líder responsável | Categórica Nominal | Líder da empresa estudada, responsável por negociar o projeto em questão. Por motivos de confidencialidade, caso haja necessidade de citá-los, eles serão mencionados como: Alfa, Beta, Gama, Delta, Épsilon, Zeta, Eta, Teta, Iota e Sem definição. | Não |
| Setor da Empresa | Categórica Nominal | Categorias que representam o setor que a empresa contratante é classificada, podendo ser: (1) Agronegócio; (2) Água, Saneamento e Serviços Ambientais; (3) Alimentos, Bebidas e Ingredientes; (4) Automotivo; (5) Bancos ou Serviços Financeiros; (6) Bens de Capital; (7) Construção, Engenharia e Mobiliário; (8) Cosméticos, Higiene Pessoal, e Limpeza Doméstica; (9) Educação; (10) Eletroeletrônica; (11) Energia Elétrica; (13) Farmacêutica e Ciências da Vida; (13) Governo, Associações e ICTs; (14) Materiais de Construção; (15) Mídia e Publicidade; (16) Mineração, Metalurgia e Siderurgia; (17) Outros Setores; (18) Papel e Celulose; (19) Petróleo, Gás e Petroquímica; (20) Química; (21) Seguros e Planos de Saúde; (22) Serviços Médicos; (23) Serviços ou Facilities; (24) Tecnologia da Informação; (25) Telecomunicações; (26) Terceiro Setor; (27) Transporte e Logística | Sim |
Fonte: Elaboração própria
Notas: Por se tratar de dados internos já existentes, não houve necessidade de aplicação de questionários ou entrevistas, dispensando também a submissão ao Comitê de Ética em Pesquisa; “Deal” é a tradução livre de “negócio”, e é a forma mais comum como a empresa se refere a uma nova oportunidade comercial.
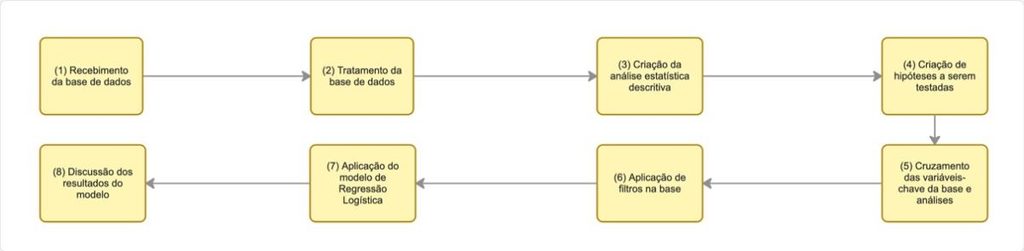
O trabalho seguiu um processo de ETL (Extract, Transform, Load) para preparar os dados para a modelagem, conforme ilustrado na Figura 1.
Figura 1 – Passo a passo do trabalho
Fonte: Elaboração própria
De forma detalhada, o processo de ETL incluiu:
- Recebimento da base de dados do CRM com cerca de 18 variáveis e 1000 linhas.
- Tratamento da base de dados, com remoção de duplicidades, tratamento de valores ausentes (missing values) e correção de inconsistências tipográficas, resultando em 12 variáveis principais e aproximadamente 900 linhas.
- Exclusão de negócios com valor de projeto zerado, reduzindo a base para cerca de 600 linhas.
- Criação de análise estatística descritiva e extração de outliers, resultando em 581 linhas.
- Identificação das variáveis-chave para o modelo, conforme indicado na Tabela 1.
- Exclusão dos negócios com status “Aberto”, pois o modelo utiliza apenas status “Ganho” ou “Perdido” para criar a probabilidade de fechamento, resultando em 548 observações.
As análises iniciais foram descritivas e exploratórias, utilizando medidas de tendência central (média e mediana) e de dispersão (mínimo, máximo, variância e desvio padrão). Tabelas e gráficos (histogramas, gráficos de dispersão, barras e linhas) foram empregados para visualizar a distribuição dos dados e as relações entre variáveis numéricas e categóricas.
Para a modelagem preditiva, optou-se pela regressão logística, um método estatístico de Machine Learning supervisionado que estima a probabilidade de ocorrência de eventos binários. O modelo calcula a probabilidade de sucesso (pi) por meio da função logística (ou sigmoide), expressa pela Equação 1:
pi = 1 / (1 + e-(βo + β1×1,i + β2×2,i + … + βkxk,i)) (1)
Onde pi representa a probabilidade prevista de sucesso; βo é o intercepto; β1, β2, …, βk são os coeficientes estimados para cada variável independente; x1,i, x2,i, …, xk,i são as variáveis independentes; e é a base do logaritmo natural.
Variáveis categóricas nominais, como “Fonte da Demanda” ou “Oferta”, foram transformadas em variáveis binárias (dummies) com uma categoria de referência. Variáveis numéricas contínuas, como “Valor”, foram usadas em sua forma original, podendo ser transformadas pelo logaritmo natural (ln) em caso de assimetria. Variáveis ordinais, como “Etapa”, mantiveram sua ordem natural.
A influência de cada variável foi comparada por meio do cálculo de odds ratios (OR), que indicam o quanto uma variável aumenta ou reduz as chances de fechamento de um negócio, utilizando a Equação 2:
OR = eβi (2)
Onde OR representa a mudança na chance de fechamento quando a variável aumenta uma unidade ou muda de categoria; βi representa o impacto da variável específica; e é a base do logaritmo natural. Se OR > 1, a variável aumenta as chances de sucesso; se OR < 1, reduz as chances; se OR = 1, não há efeito.
A regressão logística foi escolhida por sua robustez em amostras pequenas, interpretação direta dos resultados e fornecimento de probabilidades calibradas, características adequadas à base de dados da consultoria e ao contexto de volume limitado de registros, mitigando o risco de overfitting.
Para garantir a generalização do modelo e mitigar o overfitting, o conjunto de 548 observações foi dividido aleatoriamente em subconjuntos de treino (70%) e teste (30%). O subconjunto de treino foi utilizado para estimar os coeficientes, e o de teste para validar as métricas de desempenho. As variáveis selecionadas para compor o modelo foram: Oferta, Fonte de demanda, Valor, Setor e Mês de criação. A variável dependente foi o Status (ganho ou perdido), excluindo observações com status “Aberto”. A categoria “Terceiro Setor” foi agrupada em “Outros Setores” devido a uma única observação. O modelo foi estimado utilizando a função `glm` com família binomial e função de ligação `logit`. As categorias de referência adotadas foram: novembro (mês de criação), eventos próprios (fonte da demanda), programas de inovação (tipo de oferta) e energia elétrica (setor do cliente).
A validação da regressão logística foi realizada por meio de métricas como Acurácia, Área sob a Curva ROC (AUC), Precisão, Erro Padrão e p-valor. A Acurácia mede a proporção total de previsões corretas (negócios ganhos e perdidos corretamente classificados) em relação ao total de observações. A Precisão indica a proporção de negócios previstos como “ganhos” que realmente se confirmaram como ganhos. A Área sob a Curva ROC (AUC) avalia a capacidade geral do modelo em distinguir casos positivos e negativos, independentemente do ponto de corte adotado para a classificação. O Erro Padrão mede a variabilidade ou incerteza associada ao coeficiente estimado. O p-valor indica a significância estatística do coeficiente, representando a probabilidade de observar um efeito igual ou mais extremo caso o coeficiente verdadeiro seja zero.
3. Resultados e Discussão
Análise descritiva
A análise descritiva dos dados revelou as principais medidas estatísticas da base. A Tabela 2 sintetiza esses resultados, incluindo média, mediana, desvio padrão, valores mínimo e máximo, e quartis.
Tabela 2 – Estatística Descritiva da base
| Medida | Valor |
|---|---|
| Média | R$ 195.502,35 |
| Mediana | R$ 124.500,00 |
| Desvio padrão | R$ 499.578,59 |
| Mínimo | R$ 4.000,00 |
| Máximo | R$ 11.450.000,00 |
| 1° Quartil | R$ 49.600,00 |
| 2° Quartil | R$ 124.500,00 |
| 3° Quartil | R$ 244.500,00 |
| 4° Quartil | R$ 11.450.000,00 |
| IQR | R$ 194.900,00 |
| Lim inf | R$ 4.000,00 |
Fonte: Resultados originais da pesquisa
Observou-se que a média de R$ 195.502,35 foi superior à mediana de R$ 124.500,00, indicando uma distribuição assimétrica à direita, influenciada por valores extremos, como o máximo de R$ 11.450.000,00. Para identificar possíveis outliers, utilizou-se o intervalo interquartil (IQR) de R$ 194.900,00, uma medida robusta para caracterizar a variabilidade central dos dados. Com base nos limites inferior (R$ 4.000,00) e superior (R$ 536.850,00), foram removidas amostras com valores acima do limite superior, resultando em uma base de 581 observações.
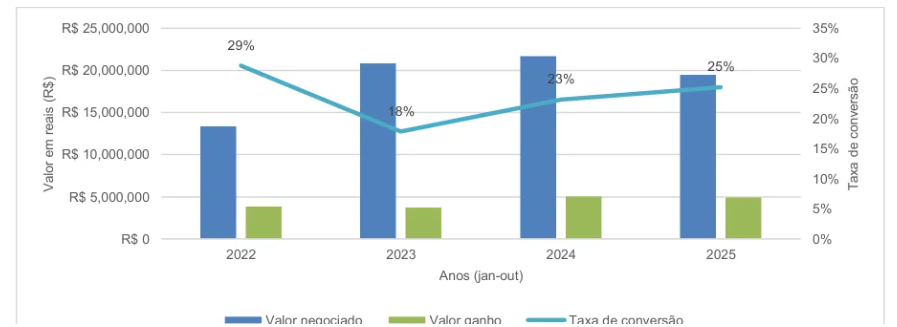
A consultoria negocia valores anuais que variam entre R$ 13 e R$ 21 milhões, com uma taxa média de conversão de 24% e faturamento médio de R$ 4,3 milhões anuais. A Figura 2 ilustra essa dinâmica, mostrando que 2024 foi o melhor ano em volume de negociação e valor ganho, embora a taxa de conversão não tenha mantido o nível de 2022. As análises anuais consideraram o período de janeiro a outubro, devido a limitações de dados para novembro e dezembro de 2025.
Figura 2 – Valor negociado (R$), vendido ou ganho (R$) e taxa de conversão (%)
Fonte: Resultados originais da pesquisa
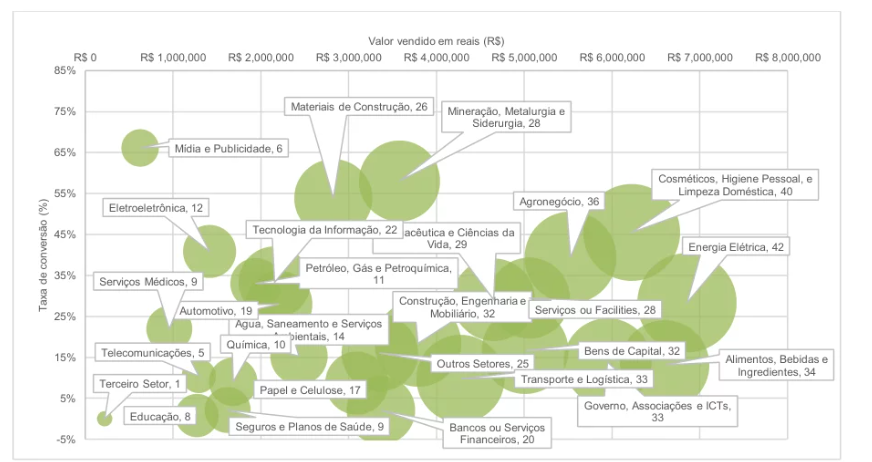
Em relação às interações por setor, a Figura 3 indica que Energia Elétrica (42 oportunidades), Cosmético, Higiene Pessoal e Limpeza Doméstica (40), e Agronegócio (36) foram os setores com maior número de interações. Terceiro Setor (1), Telecomunicações (5) e Mídia e Publicidade (6) apresentaram menor interação. Financeiramente, Energia Elétrica liderou com R$ 6.854.092 negociados, seguida por Alimentos, Bebidas e Ingredientes (R$ 6.600.290) e Cosméticos, Higiene Pessoal e Limpeza Doméstica (R$ 6.223.890).
Figura 3 – Interações, valor ganho e taxa de conversão por setor
Fonte: Resultados originais da pesquisa
As taxas de conversão não seguiram o mesmo padrão de volume financeiro. Mídia e Publicidade teve uma alta taxa de 66%, seguida por Mineração, Metalurgia e Siderurgia (58%) e Materiais de Construção (54%). Com exceção do setor de Química, os setores de serviços (Terceiro Setor, Educação, Seguros e Planos de Saúde, Bancos ou Serviços Financeiros) apresentaram as menores taxas de conversão, sugerindo maior dificuldade em atuar com empresas de serviços em comparação com as industriais.
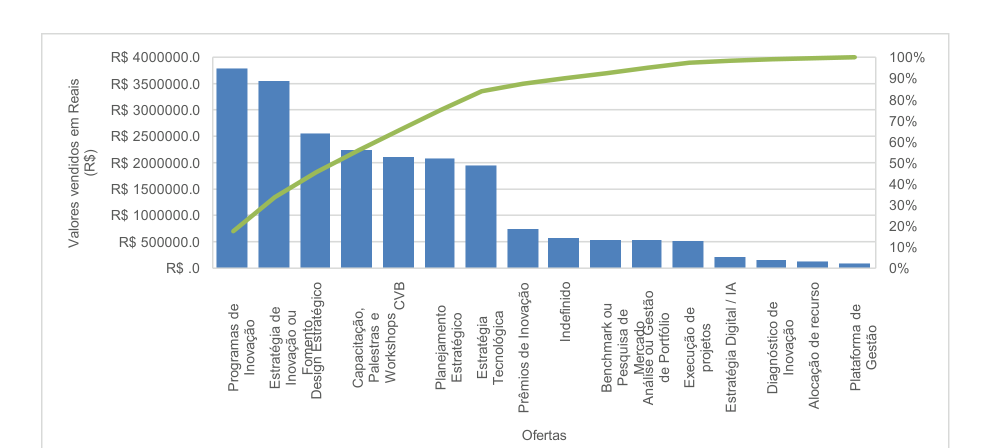
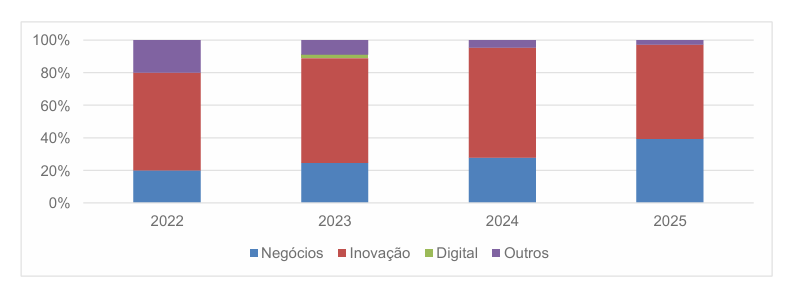
O Diagrama de Pareto na Figura 4 mostra que seis ofertas foram responsáveis por 80% do faturamento total da consultoria: Programa de Inovação (17%), Estratégia de Inovação ou Fomento (16%), Design Estratégico (12%), Capacitação, Palestras e Workshops (10%), CVB (10%) e Planejamento Estratégico (10%). As ofertas de Estratégia de Inovação ou Fomento e Programas de Inovação representaram o maior volume de negociação em reais, com 22% e 21% do montante total, respectivamente. Os projetos de “inovação” foram o “carro chefe” da consultoria, com a categoria “negócios” em segundo lugar e “digital” com pouca representatividade.
Figura 4 – Valores vendidos em Reais (R$) por Oferta
Fonte: Resultados originais da pesquisa
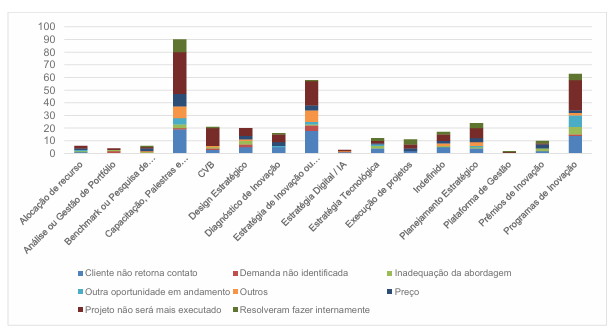
Apesar de “Programas de Inovação” e “Estratégia de Inovação ou Fomento” terem a maior participação no faturamento, a Figura 5 indica que também registraram muitas perdas, principalmente pela desistência de executar o projeto por parte da empresa compradora, o que representa um risco para a receita. A oferta de “Capacitação, Palestras e Workshops” também apresentou o maior número de negociações perdidas, com clientes desistindo do contato ou não retornando.
Figura 5 – Número de projetos perdidos considerando Oferta e Motivo de Perda
Fonte: Resultados originais da pesquisa
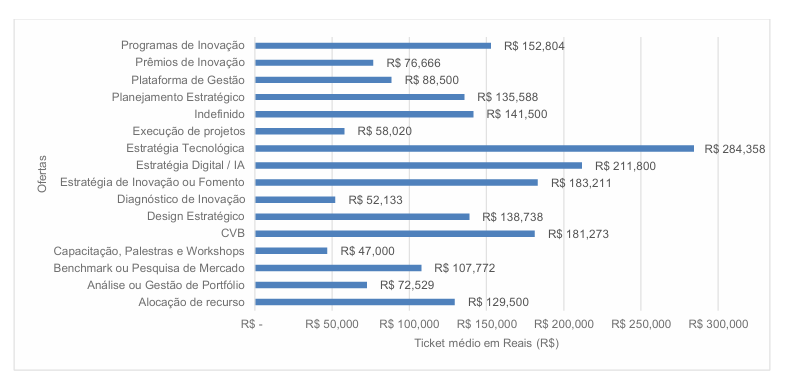
O principal motivo de perda de contratos foi “Projeto não será mais executado”. As perdas por preço foram distribuídas entre as ofertas, com mais casos em Capacitação, Palestras e Workshops (10), sugerindo uma oportunidade para revisão de preços. A estratégia de impulsionar a oferta de “Capacitação, Palestras e Workshops” pode ser interessante, conforme a Figura 6, pois representa uma porta de entrada com ticket médio baixo (cerca de R$ 47.000,00), mas com potencial para projetos de maior valor agregado.
Figura 6 – Ticket médio realizado em Reais (R$) por Oferta
Fonte: Resultados originais da pesquisa
A Figura 7 mostra uma variação na composição dos projetos vendidos ao longo dos últimos quatro anos. As ofertas classificadas como “Outros” tiveram uma redução de 20% em 2022 para 3% em 2025. As ofertas “Digital” apareceram em 2023 (cerca de 2% dos projetos) mas não nos anos seguintes. As ofertas de inovação mantiveram sua relevância, representando cerca de 60% dos projetos vendidos, enquanto as ofertas categorizadas como “Negócios” saltaram de 20% para 40%.
Figura 7 – Vendas de projetos por categoria de oferta
Fonte: Resultados originais da pesquisa
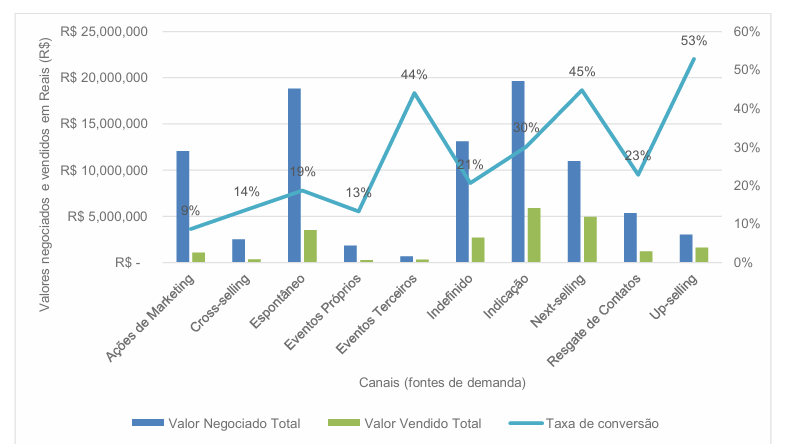
A taxa de conversão média do período foi de 24%. A Figura 8 destaca que “Ações de Marketing”, “Eventos Próprios”, “Cross-selling” e “Espontâneo” converteram pouco em faturamento. Por outro lado, “Up-selling”, “Next-selling” e “Eventos Terceiros” foram canais fundamentais para a conversão de negócios. Isso sugere que estratégias de up-selling e next-selling possuem maior eficácia de conversão do que canais de prospecção fria, confirmando a hipótese de que estratégias baseadas na carteira de clientes são mais eficazes.
Figura 8 – Valor negociado e vendido em Reais (R$) por Canal e Taxa de Conversão (%)
Fonte: Resultados originais da pesquisa
Aplicação do modelo
Para determinar o impacto isolado de cada fator na probabilidade de ganho, aplicou-se a regressão logística binária. O modelo utilizou as variáveis Oferta, Fonte de demanda, Valor, Setor e Mês de criação, com o Status (ganho ou perdido) como variável dependente. As variáveis categóricas foram tratadas por codificação em dummies, e as categorias de referência foram: novembro (mês de criação), eventos próprios (fonte da demanda), programas de inovação (tipo de oferta) e energia elétrica (setor do cliente).
O modelo apresentou os seguintes resultados de desempenho, conforme a Tabela 3:
Tabela 3 – Resultados da primeira aplicação da Regressão Logística
| Métrica | Valor | Interpretação |
|---|---|---|
| Acurácia | 0,7117 | Proporção total de previsões corretas do modelo (ganho e perdido) |
| No Information Rate | 0,6626 | Baseline |
| P-Valor | 0.1060 | Testa se o modelo é estatisticamente melhor que o baseline |
| Sensibilidade | 0,4727 | Capacidade de identificar corretamente oportunidades ganhas |
| Especificidade | 0,8333 | Capacidade de identificar corretamente oportunidades perdidas |
| Valor Preditivo Positivo (precisão) | 0,5909 | Proporção de previsões de “ganho” corretas |
| Valor Preditivo Negativo | 0,7563 | Proporção de previsões de “perdido” corretas |
| AUC (ROC) | 0,6601 | Capacidade geral de discriminação do modelo |
| Balanced Accuracy | 0,6530 | Média entre sensibilidade e especificidade |
| Kappa | 0,3219 | Grau de concordância além do acaso |
Fonte: Resultados originais do trabalho
O modelo alcançou uma acurácia de aproximadamente 71%, superior ao baseline (No Information Rate de 66%), indicando um ganho preditivo. Contudo, o p-valor de 0,106 sugere que essa diferença não é estatisticamente significativa ao nível de 5%, demandando cautela na interpretação. A sensibilidade do modelo foi de 47%, indicando que menos da metade das oportunidades ganhas foram corretamente identificadas, o que pode subestimar oportunidades de alta conversão. Em contraste, a especificidade foi de 83%, mostrando bom desempenho na identificação de oportunidades perdidas.
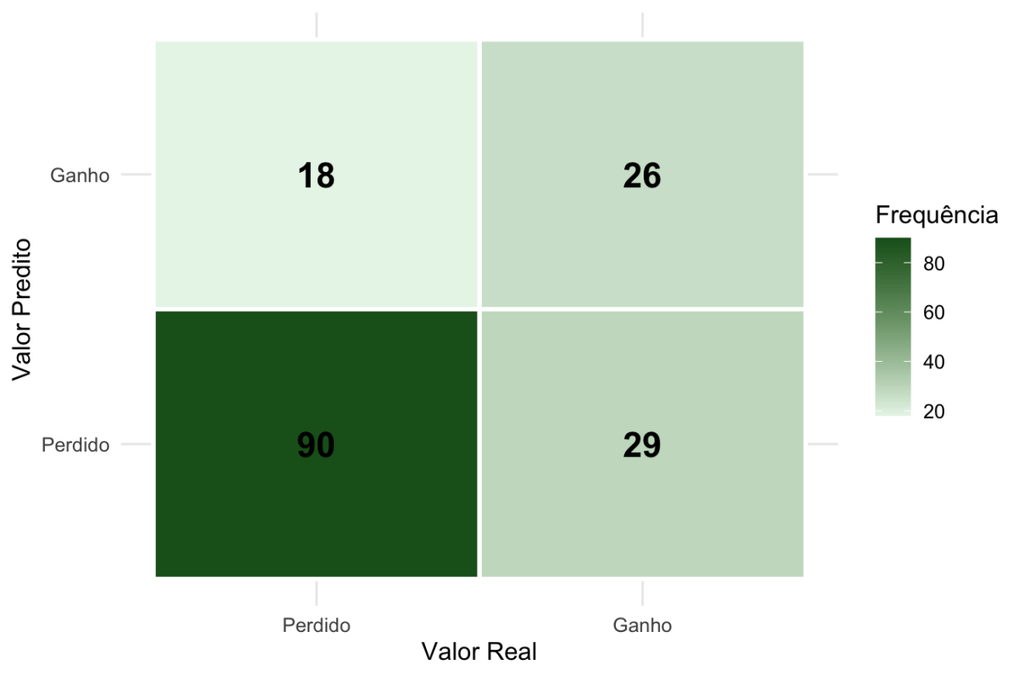
A precisão do modelo foi de 59%, o que significa que pouco mais da metade das oportunidades classificadas como “ganho” se concretizaram. Isso aponta para uma proporção relevante de falsos positivos, que podem levar a decisões comerciais baseadas em expectativas superestimadas. A matriz de confusão na Figura 9 ilustra essa dificuldade do modelo em prever corretamente os ganhos.
Figura 9 – Matriz de confusão
Fonte: Resultados originais da pesquisa
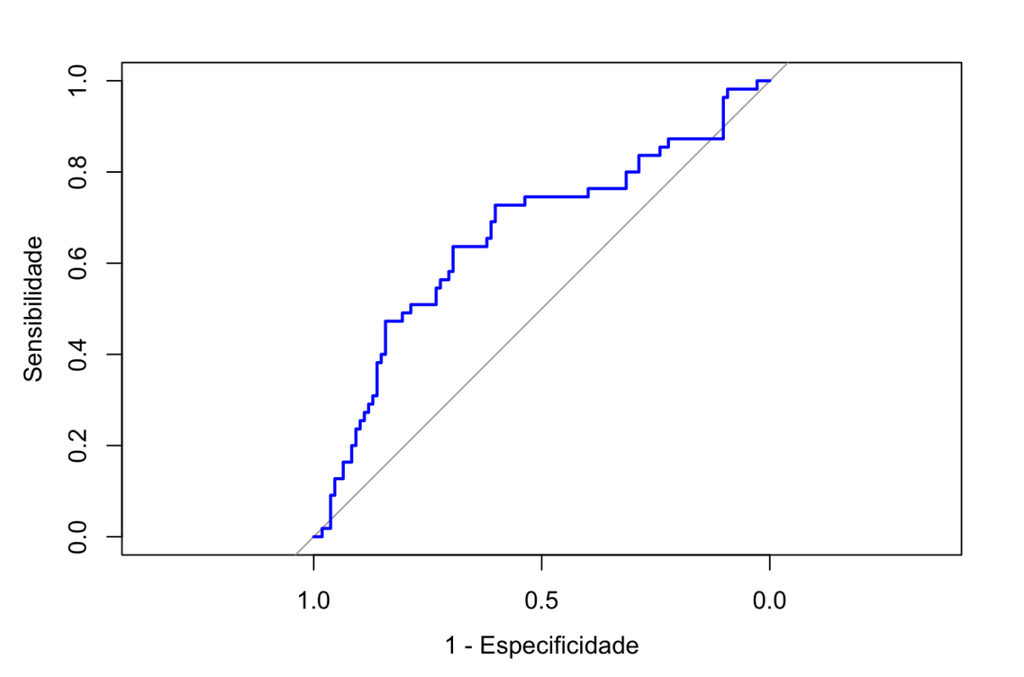
A área sob a curva ROC (AUC) foi de aproximadamente 0,66, como mostra a Figura 10, indicando uma capacidade discriminatória moderada. Isso significa que o modelo consegue distinguir, em certa medida, oportunidades de ganho e perda, mas ainda não atinge um desempenho robusto para aplicações preditivas críticas. Esse cenário é reforçado pela acurácia balanceada de 65,3% e o coeficiente Kappa de 0,32. Do ponto de vista de negócio, a taxa relevante de falsos negativos (oportunidades classificadas como “perdidas” que seriam “ganhas”) pode levar a negligenciar oportunidades com potencial real de conversão, resultando em perda de receita.
Figura 10 – Área sob a curva ROC (AUC)
Fonte: Resultados originais da pesquisa
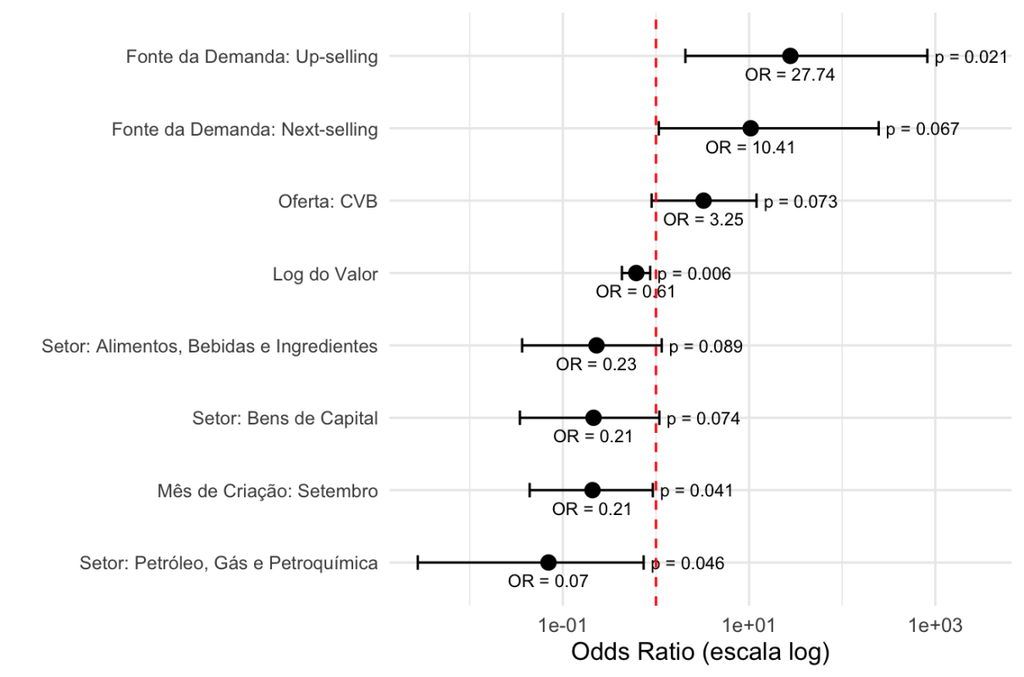
Apesar das limitações, alguns padrões relevantes foram extraídos. A Figura 11, um Forest Plot dos Odds Ratios, evidencia o efeito das variáveis explicativas com maior significância estatística (p valor < 0,1) sobre a probabilidade de “ganho” comercial.
Figura 11 – Forest Plot dos Odds Ratios de categorias com p valor máximo de 0,1
Fonte: Resultados originais da pesquisa
A variável “Fonte da demanda” apresentou os efeitos mais relevantes sobre a probabilidade de ganho, especialmente para estratégias comerciais relacionadas à base de clientes. O up-selling teve um odds ratio de aproximadamente 27,7 (p < 0,05), indicando que oportunidades via up-selling têm uma chance 27 vezes maior de fechar negócio do que via Eventos Próprios. O next-selling também mostrou um efeito positivo relevante (odds ratio ≈ 10,4), com significância marginal (p < 0,1). Negócios por “Indicação” apresentaram odds ratio de aproximadamente 5,42, mas sem relevância estatística (p-valor > 18%). Esses achados sugerem que estratégias baseadas em relacionamento com clientes existentes são significativamente mais eficazes do que abordagens tradicionais de prospecção, embora estas últimas sejam necessárias para atrair novos clientes no início do funil.
Em relação às variáveis de oferta, a oferta “CVB” mostrou um efeito positivo marginalmente significativo (p < 0,1), sugerindo maior chance de conversão. No entanto, outras categorias apresentaram coeficientes extremos ou próximos de zero, com erros padrão altos, indicando possíveis problemas de separação perfeita devido à limitação de dados ou desfecho uniforme. Ao analisar a oferta de CVB com os motivos de perda, a maior parte dos negócios perdidos foi porque o projeto não seria mais executado (cerca de 67% das vezes). Isso sugere a necessidade de aprofundamento para entender os cancelamentos e, possivelmente, ajudar o cliente a criar um business case para suportar a aprovação.
Algumas variáveis apresentaram Odds Ratios inferiores a 1, indicando impacto negativo na probabilidade de conversão. O log do valor da oportunidade sugere que negócios de maior valor tendem a ter menor probabilidade de fechamento, possivelmente devido à maior complexidade e ciclos de venda mais longos, o que está alinhado com a hipótese de que propostas com valores maiores têm menores chances de serem fechadas. Esse trade-off entre ticket médio e probabilidade de conversão é essencial para uma gestão eficaz do pipeline comercial.
Quanto aos setores, a maioria não apresentou significância estatística, com exceção de Petróleo, Gás e Petroquímica, que teve um efeito negativo significativo (odds ratio ≈ 0,07), indicando menor probabilidade de conversão em comparação ao setor de Energia Elétrica. Isso pode refletir características específicas desses mercados, como rigor técnico ou concorrência. Outros setores, como “Alimentos, Bebidas e Ingredientes” e “Bens de Capital”, apresentaram efeitos negativos com significância marginal. Assim, a hipótese de que setores como Agronegócio e Energia Elétrica teriam maiores chances de sucesso não foi completamente validada, pois a maioria dos setores apresentou baixa relevância estatística.
A variável mês de criação apresentou poucos efeitos relevantes, com o mês de setembro destacando-se com efeito negativo significativo (odds ratio ≈ 0,21), indicando menor probabilidade de conversão em relação a novembro. Dessa forma, a hipótese sobre períodos mais promissores para fechar negócios não foi totalmente validada com os dados disponíveis.
Em síntese, o modelo proposto permitiu identificar padrões relevantes associados à conversão de oportunidades comerciais, com destaque para o papel da fonte da demanda, especialmente em estratégias de up-selling e next-selling. Os resultados reforçam a importância do relacionamento com a base de clientes como alavanca central de geração de receita, ao mesmo tempo em que evidenciam limitações associadas a oportunidades de maior valor e a determinados setores de atuação. Oportunidades de maior valor ou provenientes de setores com menor propensão à conversão podem demandar abordagens diferenciadas, como maior qualificação prévia ou customização de propostas. Gerencialmente, os achados sugerem uma abordagem comercial mais segmentada, priorizando a expansão de clientes existentes para retorno no curto prazo, e mantendo iniciativas de prospecção para a sustentabilidade do pipeline no longo prazo. O modelo também evidencia a importância de aprimorar a qualidade e granularidade dos dados comerciais, especialmente em categorias com baixa representatividade, para reduzir problemas estatísticos e aumentar a robustez das inferências. Embora o modelo apresente capacidade preditiva moderada, seus resultados já permitem orientar decisões comerciais de forma mais embasada, contribuindo para a alocação eficiente de recursos e para o aumento da efetividade das estratégias de vendas.
4. Conclusão
O presente estudo buscou desenvolver e validar um modelo preditivo de classificação, baseado em regressão logística, para estimar a probabilidade de conversão de novos negócios em uma consultoria de serviços brasileira. Verificou-se que a aplicação do modelo permitiu identificar padrões relevantes associados ao sucesso comercial, destacando-se a fonte da demanda como um fator determinante. Observou-se que estratégias baseadas na carteira de clientes, como up-selling e next-selling, apresentaram uma associação positiva significativa com a conversão de negócios, indicando maior eficácia em comparação com canais de prospecção fria. Em contrapartida, identificou-se que oportunidades de maior valor e aquelas provenientes de certos setores, como Petróleo, Gás e Petroquímica, tendem a ter menor probabilidade de fechamento. Esses achados oferecem uma contribuição gerencial ao traduzir dados históricos do CRM em direcionadores práticos, auxiliando a liderança na priorização de esforços comerciais e na formulação de estratégias de vendas mais segmentadas e eficazes.
Embora o modelo tenha demonstrado capacidade preditiva moderada, com acurácia de aproximadamente 71% e AUC de 0,66, e superado o baseline, notou-se uma limitação na sensibilidade, que resultou em uma taxa relevante de falsos negativos, subestimando oportunidades de alta conversão. As limitações do estudo incluem a qualidade e granularidade dos dados históricos, bem como a complexidade inerente ao fenômeno da conversão de negócios, o que impede inferir causalidade direta. Recomenda-se que o modelo seja utilizado como um complemento ao julgamento gerencial, e não como substituto. Para estudos futuros, sugere-se a exploração de novas variáveis, a aplicação de técnicas de modelagem mais avançadas e a incorporação de um volume maior de dados, visando aprimorar o desempenho preditivo e ampliar a aplicabilidade prática do modelo na gestão comercial da consultoria.
Referências Bibliográficas
James, G.; Witten, D.; Hastie, T.; Tibshirani, R. An Introduction to Statistical Learning: with Applications in R. 2. ed. New York: Springer, 2021. Disponível em: https://www.casact.org/sites/default/files/2022-12/James-G.-et-al.-2nd-edition-Springer-2021.pdf. Acesso em 10 out. 2025.
Laney, Doug. 3D Data Management: Controlling Data Volume, Velocity and Variety. META Group Research Note, 2001. Disponível em: https://blogs.gartner.com/doug-laney. Acesso em: 10 out. 2025.
Mitchell, Tom M. Machine Learning. New York: McGraw-Hill, 1997. Disponível em: https://www.cs.cmu.edu/~tom/files/MachineLearningTomMitchell.pdf. Acesso em: 10 out. 2025.
Pinheiro, C. (2024). A relevância da ciência de dados nos negócios disponível em https://mittechreview.com.br/ciencia-de-dados-nos-negocios/?srsltid=AfmBOoq9oCqoh1zwb5cB19sAMdfMRs-6SRTnIc497h1ZFhmeOqHH8Xvb. Acesso em 11 out. 2025.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

