
15 de setembro de 2026
Detecção de Fraudes em Cartões de Crédito Utilizando Redes Neurais em Ambientes de Dados Desbalanceados
Jefferson de Oliveira Ferreira; Lauro Marques Vicari
DOI: 10.22167/2675-6528-202602232
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A crescente digitalização do sistema financeiro tornou a fraude em transações de cartões de crédito um obstáculo crítico para a estabilidade institucional e a confiança dos clientes. Este estudo comparou uma arquitetura de Rede Neural Multilayer Perceptron (MLP) com um modelo de Regressão Logística, utilizado como baseline, para detecção de fraudes em um cenário de desbalanceamento extremo de dados. Utilizou-se um dataset de transações reais de cartão de crédito, aplicando técnicas de sobreamostragem sintética (SMOTE) e a função de perda Focal Loss para mitigar o viés da classe majoritária. A MLP foi implementada com quatro camadas densas, e a Regressão Logística serviu como referência. Os experimentos revelaram que a Rede Neural superou o modelo logístico em métricas de negócio, alcançando um Recall de 0,8553 e um F1-Score de 0,8483. Notavelmente, a MLP reduziu os bloqueios indevidos (Falsos Positivos) em 23,08% em comparação com a Regressão Logística, apresentando-se como uma solução mais equilibrada entre eficiência operacional e experiência do usuário. Contudo, ambos os modelos enfrentaram dificuldades em identificar fraudes de alto valor devido ao mimetismo comportamental dos infratores. Concluiu-se que as Redes Neurais constituem uma escolha estratégica superior para instituições que buscam escalabilidade e menor atrito operacional, embora necessitem de regras de negócio complementares para fraudes de alto valor.
Palavras-chave: Cartão de Crédito; Ciência de Dados; Detecção de Fraude; Redes Neurais; Regressão Logística.
1. Introdução
O ecossistema de pagamentos no Brasil passou por uma transformação estrutural significativa na última década, impulsionada pela ampla digitalização dos serviços financeiros e pela consolidação do comércio eletrônico. Nesse cenário, o cartão de crédito consolidou-se como o principal vetor de transações, registrando volumes financeiros sem precedentes, conforme apontado pela ABECS (2024). A migração para modalidades de “Cartão Não Presente” (CNP) trouxe consigo um desafio considerável para as operadoras, que enfrentam o refinamento das fraudes digitais, operando em regimes de escala e velocidade que superam os mecanismos de defesa convencionais.
No contexto nacional, o estelionato digital evoluiu para o paradigma do “crime como serviço” (“Fraud-as-a-Service”). Dados do Indicador do Serasa Experian (2025) revelam que aproximadamente 25% das tentativas de fraude detectadas no Brasil estão relacionadas a bancos e emissores, com uma ocorrência a cada 4,2 segundos. O Mapa da Fraude da ClearSale (2025) indica que o “ticket” médio das transações fraudulentas (R$ 1.083,00) é significativamente superior ao das transações legítimas (R$ 549,00). Esse cenário compromete a viabilidade do varejo devido ao “chargeback”, processo em que o lojista absorve o prejuízo integral, além de gerar sanções junto às adquirentes.
Historicamente, a detecção de fraudes dependia de barreiras tradicionais, como regras estáticas e extensas revisões manuais conduzidas por analistas humanos. Contudo, essas abordagens perderam efetividade à medida que o volume de dados transacionais cresceu exponencialmente e a sofisticação dos criminosos aumentou. Os fraudadores passaram a mimetizar o comportamento de consumo de clientes legítimos para burlar parâmetros previamente fixados, tornando o custo operacional de manter grandes equipes de revisão manual insustentável.
Para superar essa lógica inflexível, as organizações passaram a implementar arquiteturas de inteligência artificial capazes de processar múltiplas variáveis de forma dinâmica. No entanto, a transição para modelos preditivos esbarra em desafios inerentes à natureza dos dados financeiros, como o desvio de conceito (“Concept Drift”), fenômeno estatístico no qual as propriedades e os padrões de ataque mudam rapidamente ao longo do tempo (Dal Pozzolo, 2015). A natureza dinâmica das transações exige algoritmos que aprendam continuamente e técnicas robustas para lidar com o desbalanceamento histórico extremo, onde a fraude é sempre um evento raro em um vasto oceano de dados lícitos.
Pesquisas correlatas evidenciam a superioridade analítica de modelos não lineares para superar os desafios inerentes aos dados financeiros. Gouvêa et al. (2013) demonstraram que arquiteturas neurais possuem aptidão superior para decifrar correlações complexas e otimizar a mitigação de perdas. Jordan e Mitchell (2015) destacam o aprendizado de máquina como um avanço fundamental para a segurança cibernética, permitindo a predição proativa de ameaças. Aggarwal (2018) e Schmidhuber (2015) explicam que o “Deep Learning” se destaca por extrair padrões latentes e não lineares de forma hierárquica, utilizando múltiplas camadas de abstração. Essa flexibilidade é crucial para a calibração precisa de funções de perda e limiares de decisão, permitindo que a instituição priorize métricas estratégicas de segurança, como a sensibilidade (“Recall”), mitigando a queda de precisão que penaliza modelos tradicionais. Uma classificação errônea que resulte em um falso positivo, como o bloqueio indevido de um cartão, provoca atritos operacionais imediatos, perda de receita direta, aumento da taxa de evasão de clientes e danos à reputação da instituição, superando o valor nominal do estorno que o algoritmo tentou evitar.
Dessa forma, o objetivo geral do presente artigo é desenvolver e implementar um modelo preditivo de detecção de fraudes ancorado em uma arquitetura de Redes Neurais Artificiais do tipo “Multilayer Perceptron” (MLP), e compará-lo diretamente com um modelo tradicional de Regressão Logística (utilizado como “baseline”). A pesquisa busca validar a eficácia técnica e operacional de ambas as abordagens em um “dataset” experimental representativo, avaliando qual algoritmo entrega a melhor solução para o enfrentamento de dados desbalanceados e para o equilíbrio estratégico entre segurança e experiência do consumidor.
2. Material e Métodos
Para este projeto, optou-se por uma abordagem prática e baseada em dados (quantitativa). O objetivo foi estruturar um processo de detecção de fraudes utilizando redes neurais profundas e técnicas específicas para lidar com a escassez de observações de fraude. O código foi desenvolvido em Python, empregando as bibliotecas Pandas para manipulação de dados e TensorFlow e Keras para modelagem.
Fonte de Dados e Ambiente de Desenvolvimento
O estudo utilizou um “dataset” de transações financeiras reais de cartões de crédito, obtido do repositório “Kaggle”, disponibilizado pelo Machine Learning Group da Université Libre de Bruxelles e fundamentado nos estudos de Dal Pozzolo (2015). A base de dados compreende 284.807 operações de clientes europeus ao longo de dois dias. O conjunto apresentava um desbalanceamento extremo, com apenas 492 operações classificadas como fraudes, representando 0,172% do volume total.
As variáveis originais não foram reveladas devido a normativas de confidencialidade bancária. Em seu lugar, foram fornecidos 28 componentes principais (“features” V1 a V28) gerados por uma transformação PCA (“Principal Component Analysis”), mantendo-se em formato bruto apenas as variáveis numéricas Tempo (“Time”) e Valor (“Amount”). A presença de 28 componentes para representar as variáveis originais indica que a técnica PCA foi empregada primariamente como um mecanismo criptográfico, o que impõe uma fragilidade metodológica pela ausência de metadados sobre os preditores originais, limitando a explicabilidade do modelo.
Análise Exploratória e Pré-processamento de Dados
Realizou-se uma Análise Exploratória de Dados (EDA) utilizando a biblioteca Pandas, confirmando a integridade do conjunto e a ausência de valores ausentes. O desequilíbrio severo dos dados (0,172% de fraudes) exigiu uma estratégia de modelagem que fosse além do convencional, pois algoritmos enviesados tenderiam a ignorar a classe minoritária. Para uma análise robusta em cenários de desequilíbrio extremo, métricas como precisão e “recall” foram consideradas essenciais.
Para mitigar o viés dos dados, empregou-se a técnica de reamostragem “oversampling” SMOTE (“Synthetic Minority Over-sampling Technique”). O SMOTE atua de forma sintética, identificando vizinhos próximos da classe minoritária e criando novos exemplos para equilibrar a distribuição das classes. Essa técnica foi aplicada exclusivamente sobre o conjunto de treinamento, após a separação dos dados de teste, para evitar “data leakage”. Antes do SMOTE, o conjunto de treinamento continha 199.020 amostras legítimas e 344 fraudulentas. Após o rebalanceamento, a base de treino foi equalizada para 50% de cada classe, totalizando 398.040 observações.
Tabela 1. Distribuição das classes no conjunto de treinamento pré e pós-SMOTE.
| Etapa de processamento | Transações legítimas (classe 0) | Transações fraudulentas (classe 1) | Total de amostras |
|---|---|---|---|
| Original (pré-SMOTE) | 199.020 | 344 | 199.364 |
| Balanceado (pós_SMOTE) | 199.020 | 199.020 | 398.040 |
Fonte: Dados originais da pesquisa
A disparidade entre as variáveis “Time” e “Amount” e a presença de “outliers” foram tratadas com o “StandardScaler”, que redimensiona os dados para uma escala comum, centralizando a média em zero e ajustando o desvio padrão para a unidade, conforme a Equação (1):
Z = (χ – μ) / σ (1)
onde x representa o valor original, μ a média da amostra e σ o desvio padrão. Essa padronização garante que o algoritmo processe todas as “features” com a mesma importância hierárquica.
A base de dados foi subdividida em três conjuntos: Treino (70%), Validação (15%) e Teste (15%). O conjunto de treino foi usado para a convergência dos pesos sinápticos, o de validação para monitorar o desempenho e ajustar hiperparâmetros, e o de teste, mantido isolado, para a avaliação definitiva da performance do modelo em um cenário real. Uma partição estratificada (“stratified split”) foi utilizada para preservar a proporção original de 0,172% de fraudes em todas as subamostras (Treino, Validação e Teste), garantindo a confiabilidade do modelo em condições reais.
Arquitetura e Funcionamento do Modelo Neural
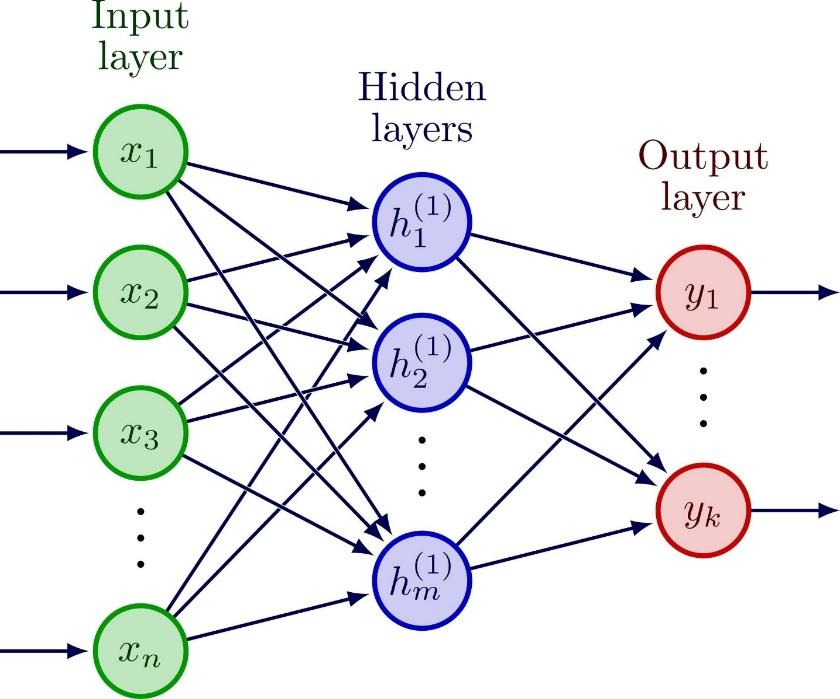
Foi implementada uma Rede Neural do tipo “Multilayer Perceptron” (MLP) com quatro camadas densas: uma camada de entrada com 30 neurônios, três camadas ocultas (com 128, 64 e 32 neurônios, respectivamente) e uma camada de saída, conforme figura 1.
Figura 1. Representação esquemática da arquitetura da Rede Neural MLP Proposta
Fonte: Dados originais da pesquisa
Cada neurônio funciona como um nó que recebe sinais de entrada, aplica pesos e gera uma ativação. As camadas densas são totalmente conectadas, permitindo ao modelo aprender combinações globais e padrões complexos. O funcionamento interno de cada neurônio baseia-se em uma transformação linear seguida de uma ativação não-linear. A soma ponderada das entradas (x) e os pesos (w), somando-se o viés (b), é calculada por:
z = (x .w) + b (2)
Nas camadas ocultas, aplicou-se a função ReLU (“Rectified Linear Unit”) para aprender padrões complexos e não lineares, acelerando a convergência do modelo:
f(z) = max(0, z) (3)
Para prevenir o “overfitting”, as camadas ocultas utilizaram a Regularização L2 (λ = 0.0001), que adiciona uma penalidade à função de perda proporcional ao quadrado dos pesos. Na camada de saída, utilizou-se a função Sigmoide, que comprime o resultado em uma probabilidade entre 0 e 1:
σ(z) = 1 / (1 + e^(-z)) (4)
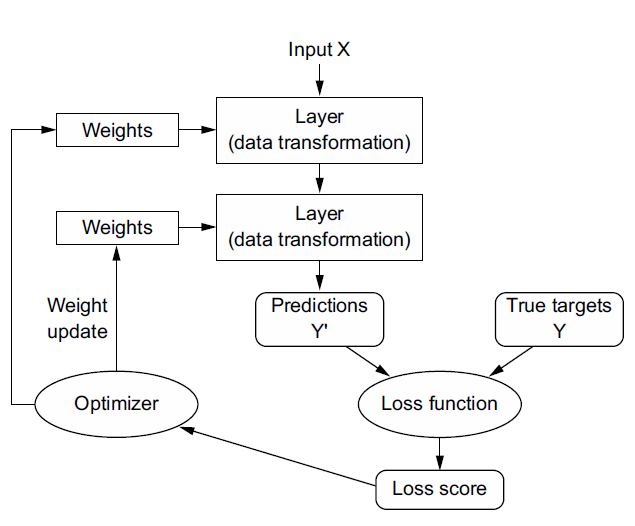
O processo de aprendizado fundamenta-se na utilização do erro gerado na saída como guia para a recalibragem dos pesos internos, por meio do algoritmo de “backpropagation” (retropropagação). Esse ciclo iterativo, conhecido como “training loop”, busca minimizar a função de custo progressivamente, confrontando as predições do modelo com os alvos reais (“labels”) para ajustar a rede com base na descida do gradiente.
Figura 2. Processo de aprendizagem da rede neural
Fonte: Chollet (2011)
Experimentação e ajuste de hiperparâmetros
A configuração final da rede neural (128, 64 e 32 neurônios) resultou de um processo iterativo de experimentação. A Tabela 2 apresenta as métricas de sensibilidade (“Recall”) de diferentes arquiteturas sob as mesmas condições de treinamento e um limiar de “Abordagem de Negócio” (máximo de 50 Falsos Positivos).
Tabela 2. Métricas de sensibilidade (“Recall”) para diferentes arquiteturas.
| Arquitetura inicial | Recall Estatístico | Recall Negócio | Diagnóstico |
|---|---|---|---|
| 256 neurônios | 86,49% | 81,08% | Sobreajuste / Memorização de ruído |
| 16 neurônios | 86,49% | 81,08% | Subajuste / Baixa capacidade de separação |
| 128 neurônios | 86,49% | 85,14% | Ponto ótimo de generalização |
Fonte: Dados originais da pesquisa
A arquitetura intermediária selecionada (128, 64, 32 neurônios) provou ser a mais robusta, elevando o Recall de negócio para 85,14% e maximizando a identificação de transações fraudulentas sem comprometer a estabilidade do aprendizado. O algoritmo Adam (“Adaptive Moment Estimation”) foi escolhido como otimizador devido à sua alta eficiência em cenários com dados esparsos e espaços de perda complexos, calculando taxas de aprendizado adaptativas para cada peso individualmente e garantindo uma convergência mais rápida e estável. A técnica de “Early Stopping” foi incorporada para monitorar a perda no conjunto de validação (val_loss) e interromper o treinamento quando o ganho de performance estagnasse, combatendo o “overfitting”.
Otimização
A técnica “Focal Loss” foi implementada como função de custo, substituindo a entropia cruzada binária padrão. Essa métrica é projetada para lidar com o desequilíbrio extremo de classes, concentrando o aprendizado nos exemplos “difíceis” (fraudes raras) e penalizando a influência das transações legítimas. A função é definida por:
FL(pt) = −αt(1 − pt)γlog(pt) (5)
onde (pt) é a probabilidade estimada para a classe verdadeira, αt é o fator de balanceamento e γ (“focusing parameter”) modula a perda de exemplos já bem classificados. Neste estudo, adotou-se γ = 2 e α = 0.25, definidos estaticamente com base na literatura para dados desbalanceados. O erro foi minimizado através da retropropagação, guiada pelo otimizador Adam.
Um diferencial metodológico foi a flexibilização do limite de classificação. Uma rotina de busca sistemática (“Threshold Moving”) foi aplicada para identificar o ponto de operação ótimo do modelo, alinhado a critérios de negócio e apetite ao risco, e não apenas à maximização estatística. O limiar foi ajustado para manter o volume de fraudes não detectadas (Falsos Negativos) abaixo de 14 casos no conjunto de teste, priorizando a contenção do prejuízo direto e minimizando os Falsos Positivos.
Modelos de referência e fundamentação comparativa
Para validação, a arquitetura MLP foi comparada com a Regressão Logística, adotada como “baseline” devido ao seu histórico em sistemas de “credit scoring” e prevenção à fraude. A Regressão Logística tenta separar as classes por meio de uma combinação linear das variáveis, mapeada para um intervalo probabilístico pela função sigmoide:
P(y = 1|x) = 1 / (1 + e^(-(β0+β1×1+…+βnxn))) (6)
onde P(y = 1|x) é a probabilidade de transação fraudulenta, β0 é o intercepto e βi são os coeficientes ajustados para cada variável xi. A comparação visou verificar se a complexidade da Rede Neural resultaria em ganho real no “Recall” e na redução de Falsos Positivos, e se o modelo avançado extrairia informações latentes ignoradas por modelos lineares. Para equidade, a Regressão Logística também foi submetida à rotina de busca de limiar (“Threshold Moving”) para atingir o mesmo rigor de segurança estipulado para o modelo principal, permitindo uma comparação pareada do custo operacional.
Uso de IA no desenvolvimento do trabalho
Durante a preparação do trabalho, Gemini (Google) e ChatGPT (OpenAI) foram utilizados para auxiliar na busca de literatura, alinhamento da metodologia, revisão, formatação e tradução do resumo. O conteúdo foi revisado e editado pelo autor, que assume total responsabilidade.
3. Resultados e Discussão
Essa seção apresenta os resultados obtidos pela arquitetura de Rede Neural frente ao modelo de baseline (Regressão Logística). A discussão não se limita ao rigor estatístico, mas busca traduzir as métricas de desempenho em impacto de negócio, avaliando o equilíbrio entre segurança e operabilidade.
Análise descritiva dos dados
Inicialmente, analisou-se a distribuição dos valores das transações (Figura 3). Para viabilizar a visualização das densidades e mitigar o efeito de outliers extremos, optou-se por um recorte de transações de até $2.000, faixa que compreende aproximadamente 99.76% da base total de dados. Observou-se que tanto transações legítimas quanto fraudulentas concentram-se em valores baixos, porém, as fraudes apresentam um adensamento ligeiramente superior em microtransações, possivelmente indicando testes de cartões.
Figura 3. Densidade probabilística dos Valores
Fonte: Resultados originais da pesquisa
Ao converter o tempo original para um ciclo de 24 horas (Figura 4), notou-se que as transações legítimas seguem o ritmo comercial padrão. Em contraste, as fraudes mantêm uma densidade relevante durante a madrugada (entre 2h e 6h), período de menor vigilância ativa pelo usuário, o que caracteriza o fator temporal como um forte indicador de anomalia. O aumento proporcional de investidas em horários de menor volume transacional sugere uma tentativa de exploração de janelas com menor sensibilidade de monitoramento. Portanto, a inclusão dessa feature oferece à rede neural uma dimensão contextual valiosa para diferenciar o comportamento típico do atípico.
Figura 4. Densidade das transações por hora
Fonte: Resultados originais da pesquisa
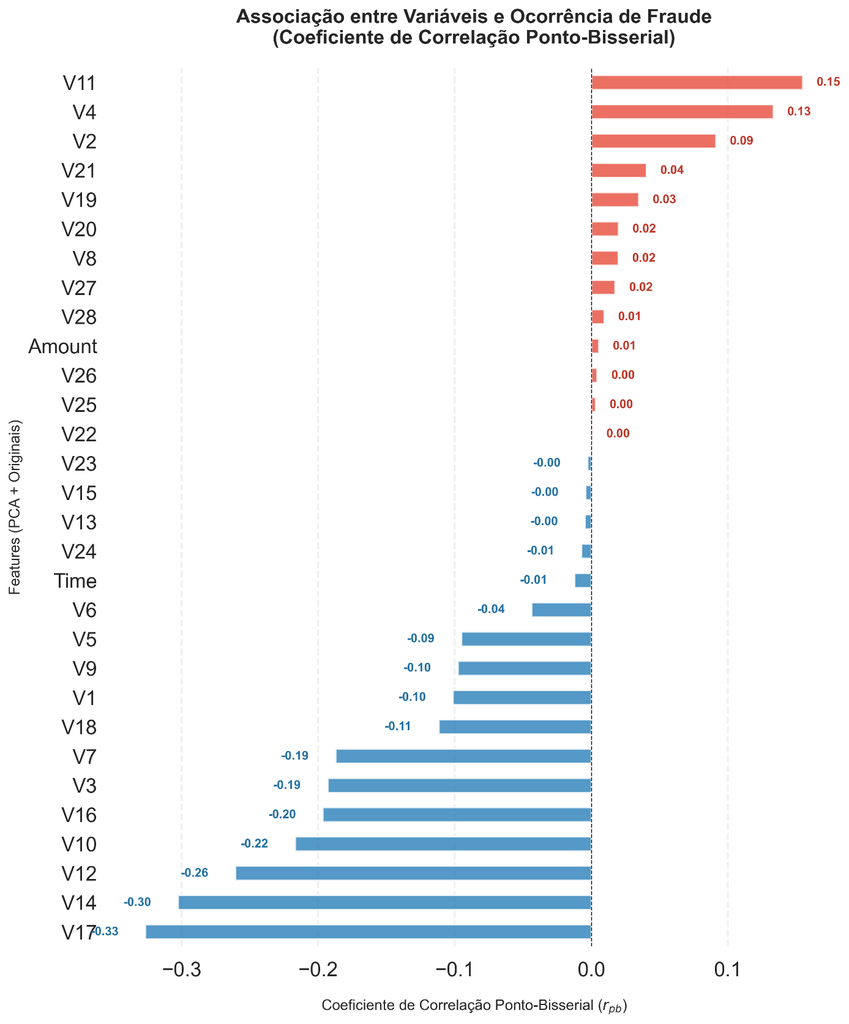
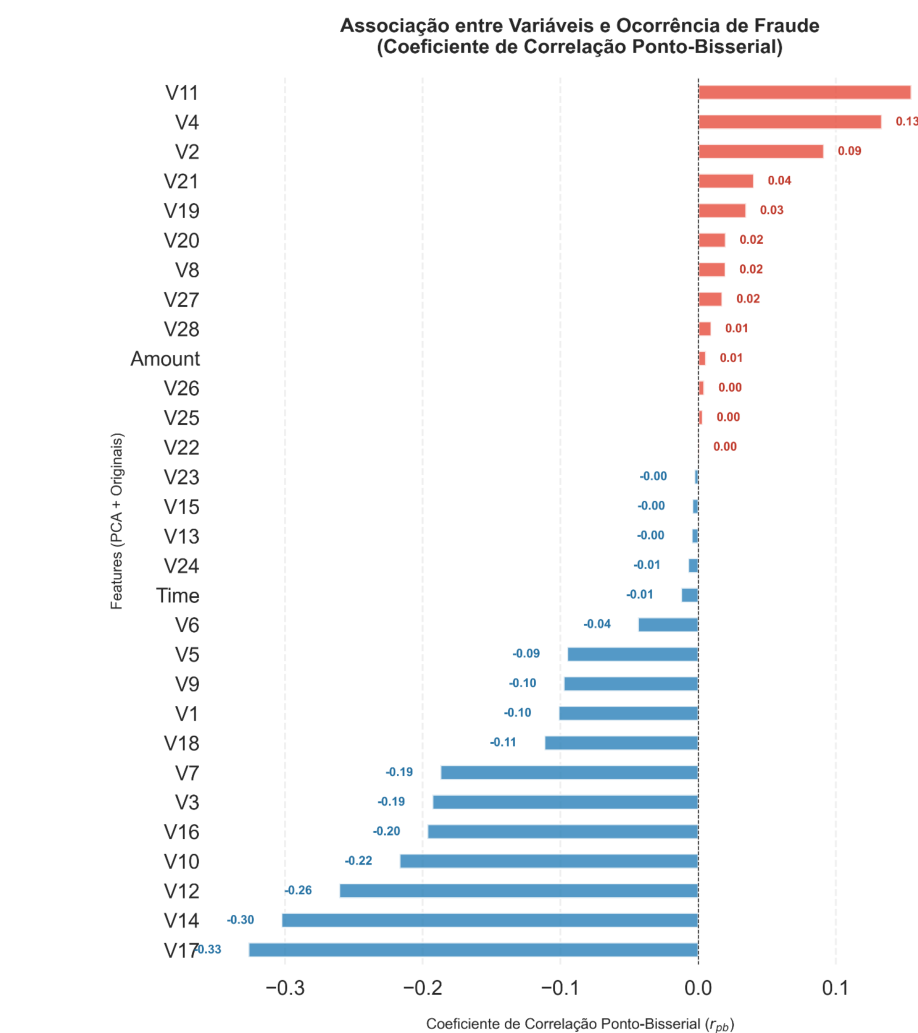
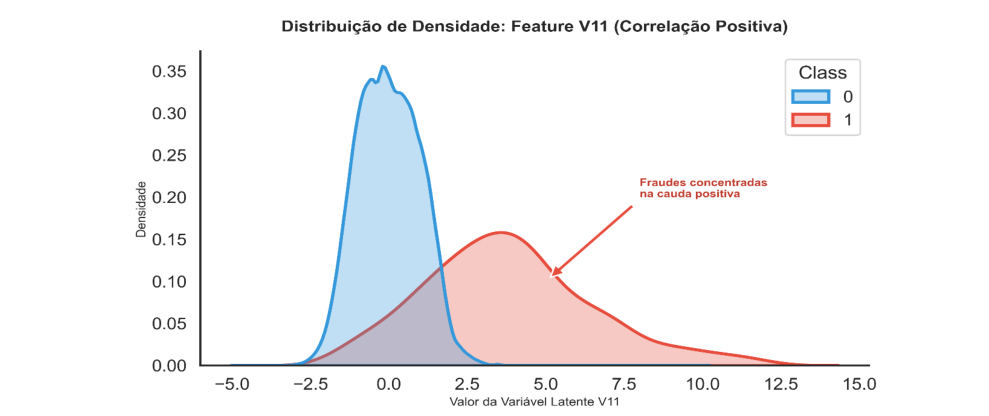
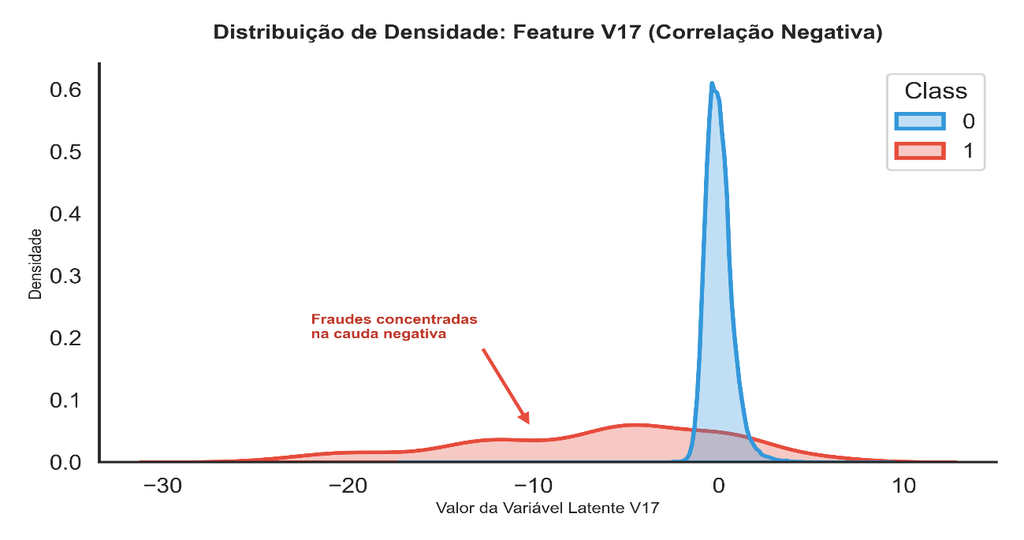
Dando continuidade à análise de relevância, a Figura 5 apresenta a associação entre as variáveis latentes (V1 a V28) e a ocorrência de fraudes, utilizando o coeficiente de correlação ponto-bisserial. O mapeamento revelou que variáveis como V17 (negativa) e V11 (positiva) são os principais indicadores de fraude. Variáveis como V17, V14 e V12 exibem associações negativas mais acentuadas, indicando que valores menores nessas dimensões aumentam a probabilidade de transação fraudulenta. Por outro lado, V11 e V4 apresentam as maiores associações positivas, funcionando como indicadores de risco conforme seus valores aumentam. As distribuições de densidade das variáveis de maior impacto foram examinadas individualmente, confirmando visualmente a separação entre as classes.
Figura 5. Correlação entre as variáveis
Fonte: Resultados originais da pesquisa
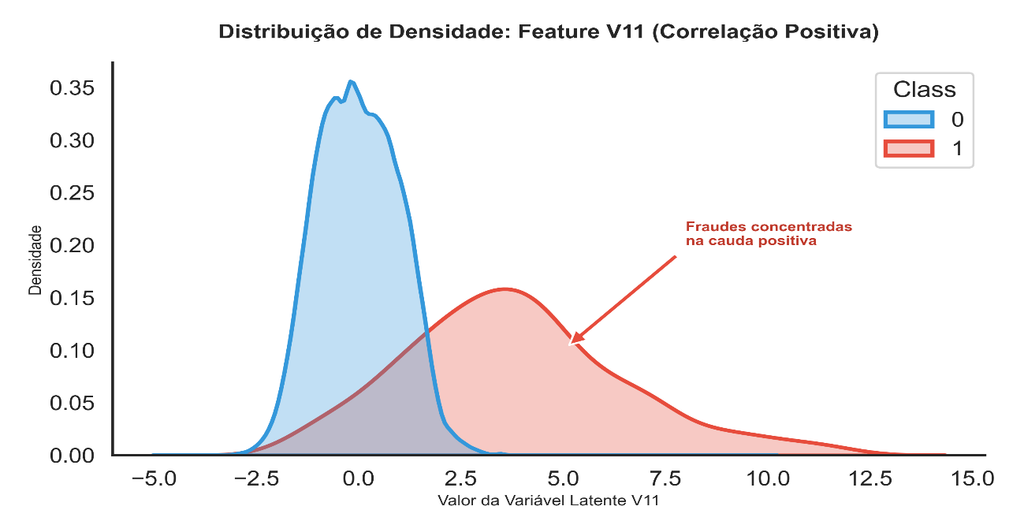
Na Figura 6, observa-se o comportamento da variável V11 (correlação positiva), onde é nítido o deslocamento da massa de dados das fraudes (em vermelho) para a direita da curva das transações normais, ratificando V11 como um preditor robusto. De forma análoga, a Figura 7 detalha a variável V17 (correlação negativa), onde a densidade de fraudes se concentra severamente na cauda esquerda (valores negativos), conforme previsto pelo coeficiente ponto-bisserial. O diferencial da Rede Neural MLP reside na capacidade de processar essas polaridades de forma multivariada, capturando padrões de fraude complexos que escapam a métricas de associação linear simples.
Figura 6. Distribuição de densidade V11
Fonte: Resultados originais da pesquisa
Figura 7. Distribuição de densidade V17
Fonte: Resultados originais da pesquisa
Monitoramento de Métricas e Identificação de “Overfitting”
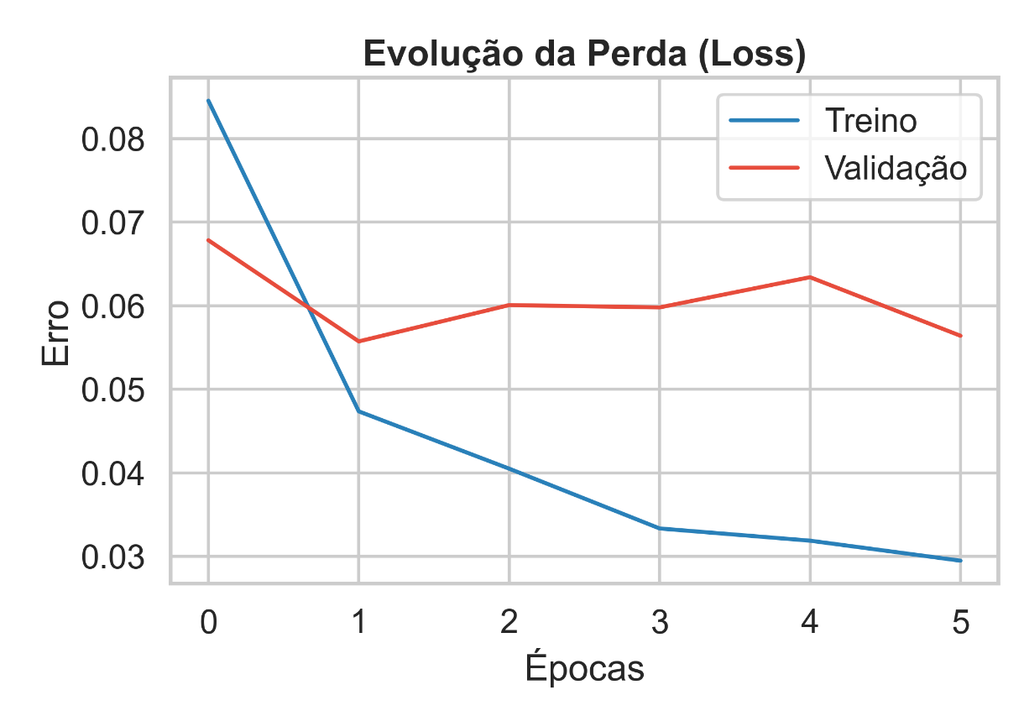
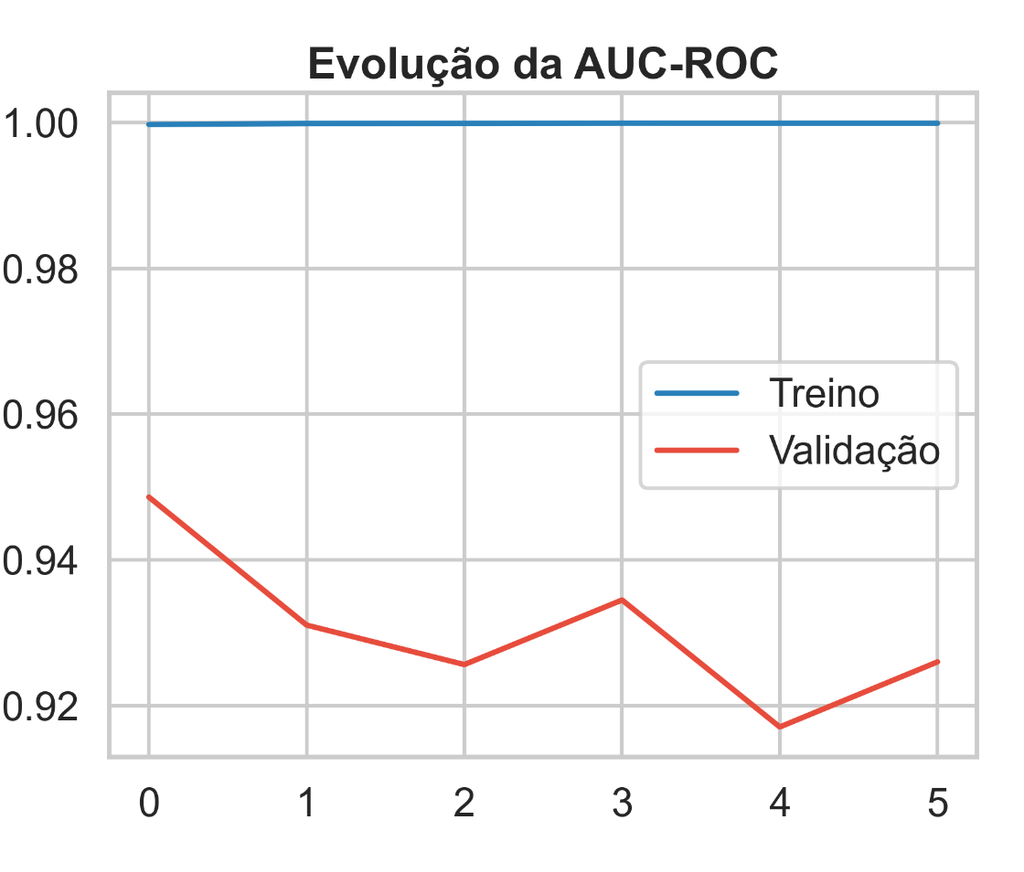
A avaliação do desempenho da rede neural iniciou-se pelo monitoramento das curvas de aprendizado ao longo das épocas de treinamento, conforme detalhado nas Figuras 8 e 9. Os resultados revelaram um cenário clássico de overfitting precoce. No gráfico de Perda (Loss), observou-se que, enquanto o erro de treinamento decresceu de forma constante, a curva de validação apresentou uma inflexão ascendente e instável após a primeira época, indicando que o modelo começou a se ajustar excessivamente ao ruído da base de treino. Esse comportamento foi corroborado pela evolução da métrica AUC-ROC, onde o modelo atingiu rapidamente a pontuação máxima (AUC-ROC = 1,00) no conjunto de treinamento, mas falhou em manter a estabilidade nos dados de validação, oscilando entre 0,91 e 0,94. Essa disparidade entre as curvas confirmou que, apesar das técnicas de regularização L2, a rede tendeu à memorização dos padrões históricos em detrimento da generalização. Portanto, a interrupção do treinamento via Early Stopping mostrou-se fundamental para preservar a utilidade prática do artefato, acionando a parada na 6ª época para garantir que o modelo interrompesse o aprendizado em seu ponto de maior equilíbrio.
Figura 8. Evolução da perda (loss)
Fonte: Resultados originais da pesquisa
Figura 9. Evolução da AUC (area under curve) durante o treinamento
Fonte: Resultados originais da pesquisa
Análise comparativa de métricas de desempenho
Para validar a eficácia da arquitetura proposta, realizou-se um confronto direto entre a Rede Neural MLP e o baseline de Regressão Logística. Embora o modelo logístico tenha apresentado um desempenho sólido para padrões transacionais evidentes, a Rede Neural demonstrou uma superioridade refinada ao capturar nuances não lineares que escapam à regressão tradicional. A Tabela 3 consolida essa disparidade técnica.
Tabela 3. Comparação de métricas
| Métrica | Regressão Logística | Rede Neural (MLP) | Variação (%) | Variação (p.p) |
|---|---|---|---|---|
| “Recall” (sensibilidade) | 0,8378 | 0,8514 | 1,60 | + 1,36 |
| Precisão | 0,6596 | 0,7079 | 6,82 | + 4,83 |
| F1-Score (Equilíbrio) | 0,7381 | 0,7730 | 4,51 | + 3,49 |
| AUC-ROC (Global) | 0,9658 | 0,9584 | -0,77 | – 0,74 |
| Fraudes Perdidas (FN) | 12 | 11 | -9,09 | – 1 |
| Bloqueios Indevidos (FP) | 32 | 26 | -23,08 | – 6 |
Fonte: Resultados originais da pesquisa
O dado mais relevante para a operação financeira é o Recall de 0,8514 alcançado pela Rede Neural. No contexto de meios de pagamento, o Recall é a métrica soberana, pois reflete a capacidade do sistema em minimizar os Falsos Negativos. A redução de 9,09% nas fraudes perdidas (de 12 para 11 casos no teste) representa uma economia direta em custos de chargeback. Paralelamente, a queda expressiva de 23,08% nos bloqueios indevidos (Falsos Positivos) é um ganho crítico de experiência do usuário, evitando o atrito desnecessário com clientes legítimos.
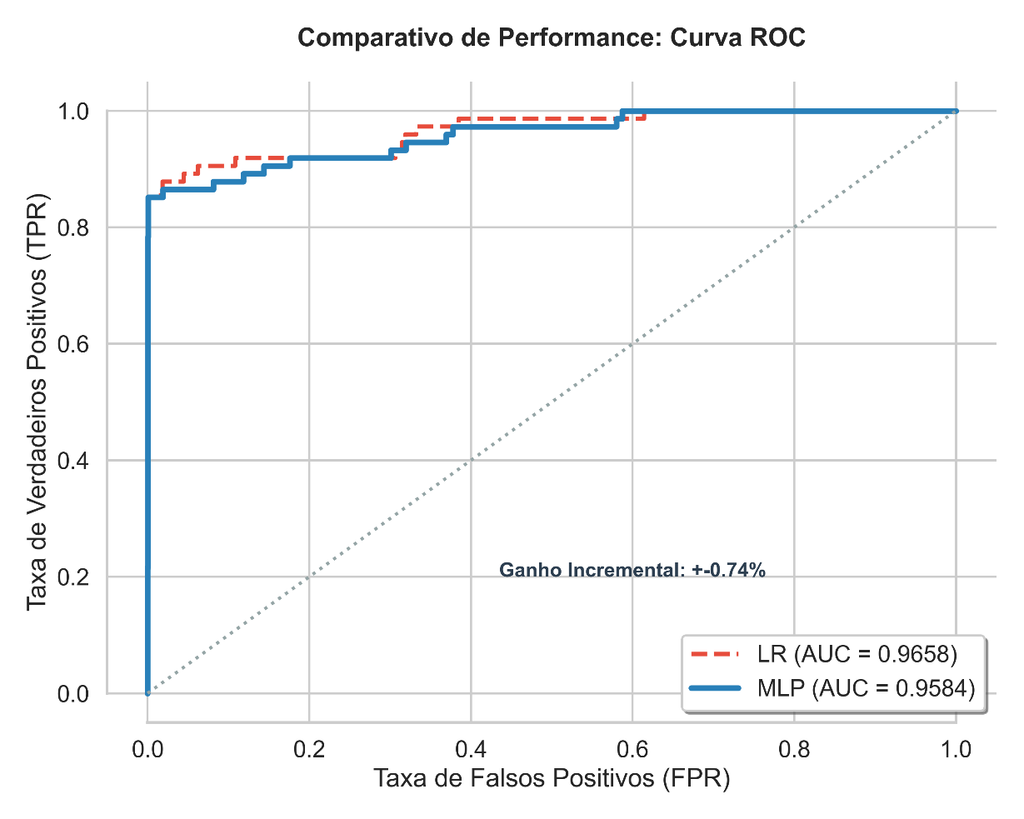
A capacidade de separação entre as classes é visualizada no comparativo das Curvas ROC (Figura 10). Ambas as trajetórias exibem uma proximidade ideal ao canto superior esquerdo do gráfico, atestando a alta qualidade dos modelos desenvolvidos. Embora a Regressão Logística ostente uma métrica AUC-ROC global ligeiramente superior (0,9658), esse valor reflete uma média teórica de performance englobando todos os possíveis limiares de decisão, incluindo pontos de corte extremos que jamais seriam adotados em um cenário real. Na região de interesse prático do negócio, onde se busca maximizar a detecção de fraudes com o menor impacto possível em bloqueios indevidos, a trajetória da Rede Neural mostra-se equivalente e, em certos intervalos, mais estável. Essa estabilidade significa que o modelo consegue sustentar uma alta taxa de acertos sem sofrer um aumento desproporcional e abrupto na geração de falsos alarmes, confirmando que a arquitetura baseada em Deep Learning é altamente competitiva e robusta para decodificar a complexidade das variáveis latentes no ecossistema de cartões de crédito.
Figura 10. Comparativo de Curvas ROC: Regressão Logística vs. Rede Neural MLP
Fonte: Resultados originais da pesquisa
Desempenho operacional e otimização do limiar
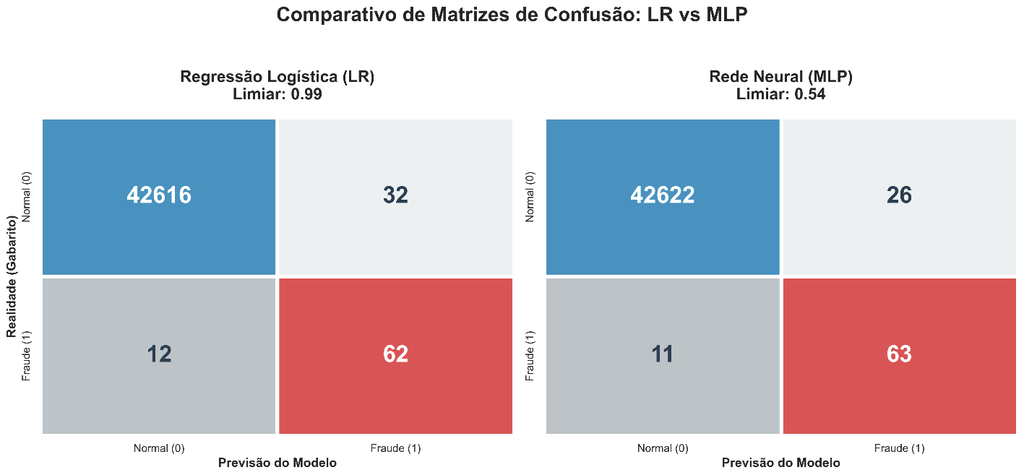
Para avaliar o modelo simulando o ambiente de produção, aplicou-se a matriz de confusão na base de teste, garantindo a imparcialidade das predições. Em cenários de desbalanceamento extremo, a análise dessa matriz é indispensável para quantificar o volume exato de acertos (Verdadeiros Positivos) frente ao risco financeiro crítico das fraudes não detectadas (Falsos Negativos). A elevada capacidade de separação das classes evidencia o sucesso da abordagem híbrida adotada. O algoritmo SMOTE interveio no pré-processamento, mitigando o déficit da base ao sintetizar novas amostras para a classe minoritária. Em contrapartida, a Focal Loss atuou diretamente no treinamento da rede neural, calibrando a função de custo para priorizar as fraudes fronteiriças e de difícil classificação. Essa dupla estratégia viabilizou a construção de uma fronteira de decisão robusta. O resultado visual dessa estratégia pode ser observado na Figura 11, que apresenta o comparativo das matrizes de confusão. Notou-se que a MLP obteve uma redução importante nos Falsos Positivos em comparação ao baseline logístico, mantendo um nível de segurança equivalente na detecção de fraudes reais.
Figura 11. Matrizes de confusão – Conjunto de teste
Fonte: Resultados originais da pesquisa
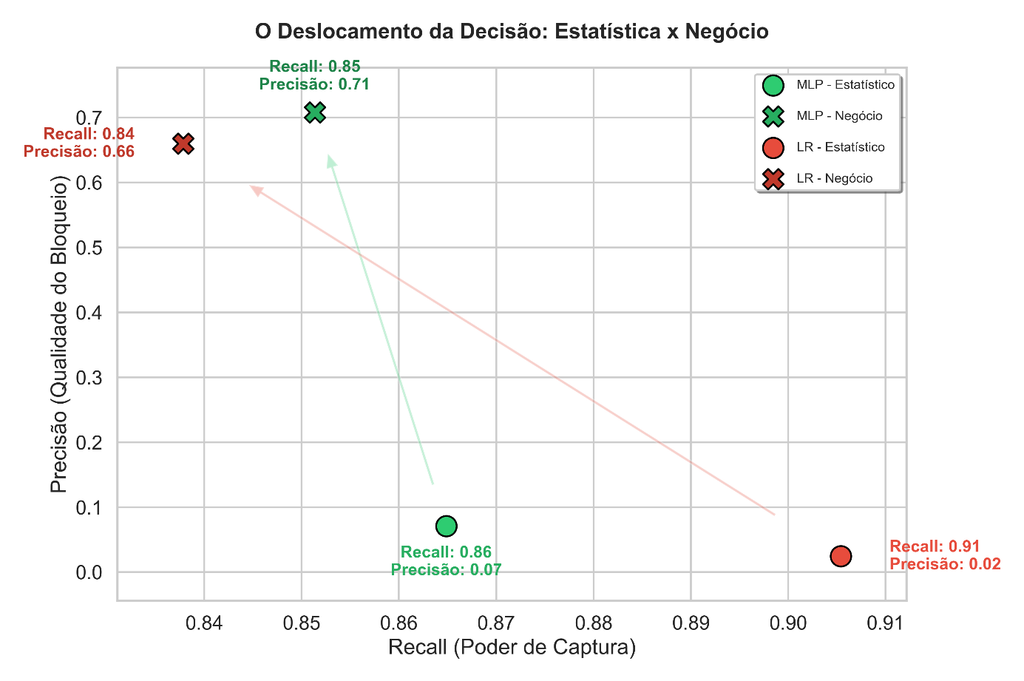
Um ponto central desta etapa foi a rejeição do limiar estatístico padrão de 0,5. Conforme ilustrado na Figura 12, a calibração estratégica do trade-off entre Precisão e Sensibilidade (Recall) permitiu identificar o ponto de operação ideal para o cenário real. Essa decisão priorizou a sustentabilidade operacional, estabelecendo um teto rigoroso para o volume de Falsos Positivos para evitar bloqueios indevidos de clientes, em troca de uma manutenção rigorosa da captura de fraudes de alto impacto. A Figura 12 ilustra o dilema fundamental entre Precisão (Qualidade do Bloqueio) e Recall (Poder de Captura) nas abordagens estatística e de negócio. Na abordagem puramente estatística, ambos os modelos buscam o máximo de captura (Recall), resultando em alta detecção de fraudes (LR = 0,91; MLP = 0,86), mas com uma precisão inaceitavelmente baixa (LR = 0,02; MLP = 0,07), gerando um volume insustentável de falsos positivos. Ao adotar uma visão de negócio, os limiares de decisão são ajustados para balancear a captura de fraudes com o custo operacional e a experiência do cliente. A análise do gráfico revela a superioridade operacional do modelo de Redes Neurais [MLP]. Enquanto o modelo de Regressão Logística [LR] sofre um trade-off severo para atingir uma Precisão operacional de 0,66, sacrificando o Recall significativamente (caindo para 0,84), o modelo MLP demonstra uma eficiência notável. O deslocamento da MLP para a estratégia de negócio alcança uma Precisão superior (0,71) com perda quase nula de Recall (caindo apenas de 0,86 para 0,85). Essa característica prova que o modelo MLP é mais robusto e capaz de encontrar pontos de operação otimizados, maximizando a captura de fraude com atrito operacional mínimo. Esse ganho duplo valida a hipótese de que a capacidade da Rede Neural de processar padrões não lineares através de suas camadas ocultas permite uma separação mais refinada no espaço de decisão, superando as limitações intrínsecas dos modelos lineares em dados bancários complexos.
Figura 12. O Deslocamento da Decisão: Estatística x Negócio
Fonte: Resultados originais da pesquisa
Análise estatística dos erros e disparidade de valores
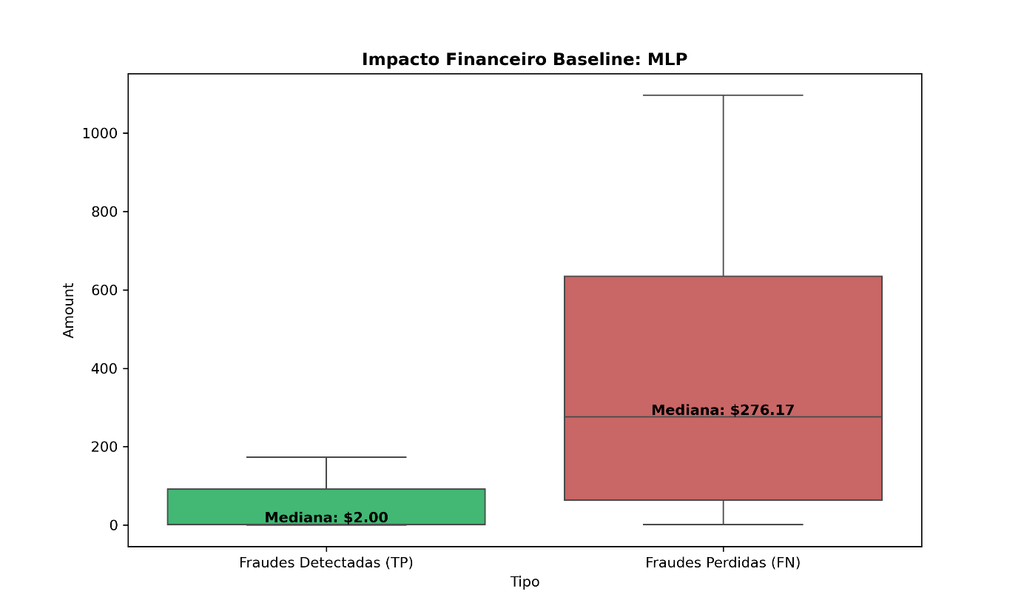
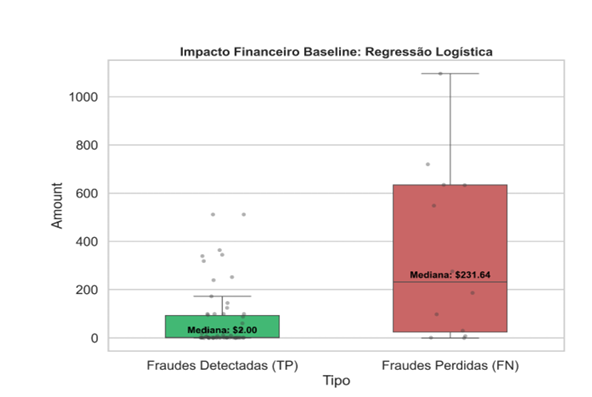
Para aprofundar a discussão sobre a eficácia do modelo, realizou-se uma análise comparativa entre as fraudes detectadas e as que o modelo não conseguiu identificar. A reversão da padronização matemática permitiu observar os valores reais das transações em suas grandezas originais. A análise revelou um padrão comportamental crítico, conforme Figuras 13 e 14. Em ambos os modelos, as fraudes perdidas (Falsos Negativos) apresentaram uma mediana de valor significativamente superior àquelas detectadas com sucesso. Na Regressão Logística, as detecções ocorreram majoritariamente em transações de baixo valor (mediana de $2,00), enquanto as falhas concentraram-se em operações com mediana de $231,64. Na Rede Neural, o fenômeno foi análogo: o modelo foi eficaz em capturar fraudes de pequeno valor, mas encontrou maior dificuldade em transações com mediana de $276,17. Esse cenário levanta um alerta para a aplicabilidade do modelo: as fraudes que geram os maiores prejuízos financeiros estão conseguindo burlar a malha de detecção devido ao mimetismo comportamental de criminosos que imitam o consumo de clientes legítimos de alto ticket. Não há uma diferença financeira significativa entre as arquiteturas no que tange à captura dos grandes fraudadores, pois ambos os algoritmos deixam essas transações passarem. O verdadeiro trade-off entre as metodologias reside na eficiência operacional com a base de clientes, onde a Rede Neural (MLP) atua de forma mais limpa, gerando 18,7% menos bloqueios indevidos em relação ao baseline.
Figura 13. Impacto Financeiro Baseline: MLP
Fonte: Resultados originais da pesquisa
Figura 13. Impacto Financeiro Baseline: Regressão Logística
Fonte: Resultados originais da pesquisa
A presente investigação demonstrou que a arquitetura de Redes Neurais do tipo Multilayer Perceptron (MLP) oferece ganhos reais sobre a tradicional Regressão Logística na detecção de fraudes em cartões de crédito, especialmente em ambientes de dados desbalanceados. A implementação estratégica do oversampling sintético (SMOTE) em conjunto com a função de perda Focal Loss otimizou a resistência do modelo ao viés da classe majoritária, resultando em elevados patamares de F1-Score e Precisão, além de uma estabilidade de treinamento que minimiza oscilações na capacidade de generalização. A MLP apresentou uma redução de 18,7% nos Falsos Positivos em comparação à Regressão Logística, traduzindo-se em maior eficiência operacional e melhor experiência do usuário. Contudo, a análise dos erros revelou que as fraudes de maior valor nominal ainda conseguem transpor a barreira da rede neural devido ao mimetismo comportamental dos criminosos, indicando que a capacidade de prever a probabilidade matemática de um evento deve ser complementada por mecanismos que ponderem o risco financeiro absoluto envolvido.
4. Conclusão
O presente estudo buscou desenvolver e comparar um modelo preditivo de detecção de fraudes em transações de cartão de crédito, utilizando uma arquitetura de Rede Neural Multilayer Perceptron (MLP) frente a um baseline de Regressão Logística, com foco no tratamento de dados desbalanceados e no equilíbrio estratégico entre segurança e experiência do usuário. Verificou-se que a MLP demonstrou superioridade em métricas de negócio, alcançando um Recall de 0,8514 e uma redução de 23,08% nos bloqueios indevidos (Falsos Positivos) em comparação com a Regressão Logística. A aplicação estratégica de técnicas de sobreamostragem sintética (SMOTE) e da função de perda Focal Loss foi fundamental para mitigar o viés da classe majoritária e otimizar a resistência do modelo. Essa abordagem resultou em elevados patamares de F1-Score e Precisão, além de uma estabilidade de treinamento que minimizou oscilações na capacidade de generalização. A Rede Neural, portanto, constitui uma escolha estratégica superior para instituições financeiras que visam escalabilidade e menor atrito operacional, sem comprometer a segurança.
Contudo, a análise dos erros revelou que ambos os modelos enfrentaram dificuldades em identificar fraudes de alto valor nominal, atribuídas ao mimetismo comportamental dos criminosos, que conseguem burlar a malha de detecção. Essa limitação indica a necessidade de complementar a capacidade preditiva matemática com mecanismos que ponderem o risco financeiro absoluto envolvido. Adicionalmente, o uso de um dataset estático restringiu a visão sobre o caráter dinâmico e temporal das fraudes, e a transformação PCA impôs uma fragilidade na explicabilidade causal das variáveis originais. Como desdobramentos futuros, sugere-se a implementação de regras de negócio secundárias focadas na contenção de anomalias de alto valor e a transição para arquiteturas recorrentes, como LSTMs ou RNNs, capazes de interpretar o histórico do portador do cartão como uma sequência lógica e cronológica, aprimorando a detecção em cenários de “Concept Drift”.
Referências Bibliográficas
ABECS. 2025. Balanço do setor de meios eletrônicos de pagamento: resultados 2024. Associação Brasileira das Empresas de Cartões de Crédito e Serviços, São Paulo, SP, Brasil. Disponível em: Acesso em: 05 fev. 2026.
Aggarwal, C.C. 2018. Neural Networks and Deep Learning. Springer, Cham, Suíça. Disponível em: . Acesso em: 12 out. 2025.
Cholet, F. 2021. Deep learning with python. 2ed. Manning, New York, EUA.
ClearSale. 2025. Mapa da Fraude. Disponível em: Acesso em: 10 jan. 2026.
Dal Pozzolo, A. 2015. Adaptive Machine learning for credit card fraud detection. Tese, Ph.D. em Ciência da Computação, Université Libre de Bruxelles. Disponível em < http://di.ulb.ac.be/map/adalpozz/pdf/Dalpozzolo2015PhD.pdf>
Gouvêa, M.A.; Gonçalves, E.B.; Mantovani, D.M.N. 2013. Análise de risco de crédito com aplicação de regressão logística e redes neurais. Contabilidade Vista & Revista 24(4): 96-123. Disponível em: < https://www.redalyc.org/pdf/1970/197033497006.pdf > Acesso em: 12 out. 2025.
Jordan, M.I.; Mitchell, T.M. 2015. Machine learning: Trends, perspectives, and prospects. Science 349(6245): 255-260. Disponível em: Acesso em: 12 out. 2025.
Schmidhuber, J. 2015. Deep learning in neural networks: An overview. Neural Networks 61(1): 85-117. Disponível em: . Acesso em: 15 out. 2025.
Serasa Experian. 2025. Recorde: Quase 7 milhões de tentativas de fraude foram registradas no 1º trimestre de 2025; setor bancário é principal alvo. Disponível em: Acesso em 10. jan. 2026.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

