
16 de setembro de 2026
Avaliação de Metodologias de Recuperação Aumentada por Geração (Rag) na Construção de Agentes Generativos
Matheus Pinheiro Leopoldino; Anna Carolina Martins
DOI: 10.22167/2675-6528-202602280
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
O avanço recente dos modelos de linguagem de grande porte impulsionou o uso de agentes generativos em contextos corporativos, mas limitações de fidelidade factual e dependência de conhecimento genérico persistiram. Arquiteturas de Recuperação Aumentada por Geração (RAG) emergiram como solução para integrar bases de conhecimento externas. O estudo avaliou comparativamente diferentes metodologias de RAG aplicadas à construção de agentes generativos voltados ao atendimento automatizado de perguntas frequentes. Para isso, cinco arquiteturas distintas de RAG – clássico, com re-ranker, multi-hop, hierárquico e baseado em agentes – foram implementadas sobre uma base de conhecimento comum e avaliadas sob condições controladas. A avaliação considerou métricas de fidelidade ao contexto, relevância da resposta, latência e uso de tokens, utilizando julgamentos automatizados por meio da abordagem LLM-as-a-judge. Os resultados evidenciaram trade-offs estruturais entre qualidade das respostas, custo computacional e tempo de resposta, indicando a ausência de uma abordagem universalmente superior. Notavelmente, o método hierárquico ofereceu o melhor compromisso entre desempenho e custo computacional. Como contribuição, a pesquisa ofereceu uma análise comparativa sistemática que apoia decisões técnicas e arquiteturais no desenho de agentes generativos baseados em RAG para aplicações empresariais.
Palavras-chave: Arquitetura; LLM; LLM-as-a-Judge; Recuperação.
1. Introdução
A evolução dos Large Language Models (LLMs) tem transformado a interação humana com sistemas computacionais, impulsionando o desenvolvimento de agentes generativos em diversos contextos, notadamente no ambiente corporativo. Esses agentes são projetados para simular a interação textual humana e executar comportamentos direcionados a objetivos específicos, utilizando ferramentas complementares que lhes conferem autonomia (Park et al., 2023). Essa capacidade tem gerado valor significativo para empresas e indivíduos (Godbole et al., 2024; Yu et al., 2025; Manda, 2025; Borishetty et al., 2025).
No setor de atendimento ao cliente, a implementação de agentes generativos baseados em LLMs tem sido adotada como uma alternativa eficaz para otimizar operações. Um estudo de caso em uma empresa com cinco mil funcionários demonstrou uma redução de 37,5% no número de solicitações de suporte após a introdução de uma solução de atendimento baseada em inteligência artificial generativa (Al-Osaimi et al., 2025). Essa aplicação visa diminuir os transbordos para equipes humanas de nível um, ao mesmo tempo em que eleva a qualidade e a consistência das respostas fornecidas aos usuários.
Contudo, apesar do potencial, os LLMs enfrentam desafios significativos, especialmente em domínios específicos. Um dos principais problemas reside na fidelidade factual das respostas e na dependência de conhecimento genérico obtido durante o pré-treinamento, o que pode resultar em informações desatualizadas ou imprecisas para contextos de negócio que exigem conhecimento interno específico (Genesis, 2025). Essa limitação impede que os modelos forneçam respostas precisas para perguntas que demandam dados corporativos ou especializados.
Para superar essas deficiências, as arquiteturas de Recuperação Aumentada por Geração (RAG) emergem como uma solução promissora. A RAG combina mecanismos de busca com modelos generativos, permitindo a integração de bases de conhecimento externas ao processo de geração de respostas. Essa abordagem melhora a ancoragem factual das respostas e facilita a adaptação a bases de conhecimento específicas, o que é crucial em ambientes de suporte com alto volume de perguntas que dependem de uma base de conhecimento interna pré-estabelecida (Gupta et al., 2024; Genesis, 2025).
Apesar da eficácia da RAG, a construção desses sistemas envolve a escolha entre diversas estratégias, cada uma com seus próprios trade-offs em termos de precisão, latência e custo computacional (Genesis e Keane, 2025; Brontes et al., 2025). A proliferação de novas técnicas e a escassez de avaliações comparativas sistemáticas dificultam a tomada de decisões arquiteturais fundamentadas para a construção de agentes generativos. Essa lacuna no arcabouço científico impede a seleção da metodologia mais adequada para diferentes cenários de aplicação.
Diante desse cenário, a presente pesquisa justifica-se pela necessidade de uma análise comparativa sistemática que possa subsidiar decisões técnicas e arquiteturais no desenho de agentes generativos baseados em RAG para aplicações empresariais. Com isso, o objetivo do trabalho é avaliar a performance de diferentes metodologias de RAG aplicadas à construção de agentes generativos voltados para atendimento automatizado de perguntas frequentes, comparando-as a partir das métricas faithfulness, latência na geração das respostas, uso de tokens, answer relevancy e context relevancy, buscando encontrar metodologias que ofereçam um melhor custo-benefício quanto à robustez técnica, custo operacional e qualidade das respostas finais.
2. Material e Métodos
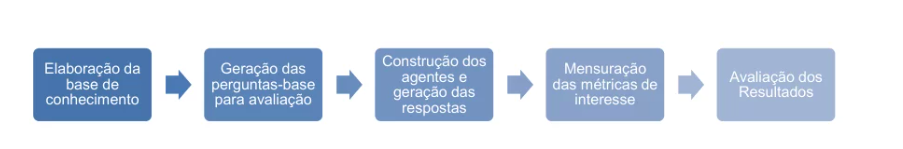
A pesquisa adotada é de natureza aplicada e exploratória, visando compreender o funcionamento de diferentes metodologias de Recuperação Aumentada por Geração (RAG) através da construção de um algoritmo. O estudo foi dividido em quatro fases principais, conforme ilustrado na Figura 1, com etapas realizadas múltiplas vezes para comparar as metodologias de RAG.
Figura 1. Etapas do processo metodológico para avaliação de múltiplas metodologias de RAG.
Fonte: Resultados originais da pesquisa
A execução da pesquisa utilizou um ambiente computacional configurado em Python, empregando bibliotecas como CrewAI para a construção de agentes generativos e reprodutibilidade dos experimentos. As bibliotecas utilizadas e seus papéis estão detalhados na Tabela 1.
Tabela 1. Bibliotecas utilizadas no estudo
| Biblioteca | Versão | Papel no estudo |
|---|---|---|
| openai | 1.0.0 | Interface com modelos (LLM e “embeddings”) providos pela OpenAI via API. |
| anthropic | 0.34.0 | Interface com modelos de LLM providos pela Anthropic via API. |
| crewai | 0.28.0 | “Framework” agêntico utilizado. |
| faiss-cpu | 1.7.4 | Indexação e busca vetorial dos “embeddings” da base de conhecimento. |
| numpy | 1.24 | Manipulação e armazenamento dos vetores numéricos gerados pelo modelo de “embeddings”. |
| pandas | 2.0 | Leitura, organização e armazenamento dos dados experimentais. |
Fonte: Resultados originais da pesquisa
O estudo, que lida com dados não estruturados (textos), realizou análises qualitativas escaladas por meio de modelos de linguagem, utilizados tanto na geração quanto na avaliação automatizada das respostas.
A base de conhecimento foi construída a partir do Manual de Instruções e Normas para Trabalhos de Conclusão de Curso da ESALQ/USP, em formato PDF. Deste documento, 200 trechos textuais foram extraídos e segmentados utilizando o modelo multimodal openai-gpt-5.2, via plataforma “web”, com instruções padronizadas para identificar unidades textuais semanticamente coerentes e mitigar vieses. O “prompt” incluía um padrão de retorno combinado de pergunta e resposta.
Após a extração, os trechos foram reclassificados por um LLM em categorias induzidas de forma não supervisionada, como Conceito, Processo, Avaliação, Orientação, Projeto de pesquisa, Metodologia, Ética, Formatação, Referências, Figuras/tabelas, Análise, Conclusão, Resultados preliminares, TCC final, Defesa, Submissão, Elementos pré-textuais, Elementos pós-textuais, Apêndices, Citações, Pós-defesa, Provas, Reconhecimento e Recursos.
O conteúdo da base de conhecimento foi transformado em vetores numéricos (“snippets”) usando o modelo text-embedding-3-small da OpenAI. Esses vetores foram convertidos para “float32” e organizados em um “array” NumPy.
Um índice vetorial foi construído com FAISS, utilizando a estrutura IndexFlatL2 para similaridade por distância euclidiana (L2). O índice foi populado com os “embeddings” gerados e persistido em disco, mantendo o mapeamento entre posição no índice e registro textual.
A recuperação vetorial base, comum a todas as metodologias avaliadas, foi implementada de forma determinística. As consultas eram convertidas para vetores numéricos pelo mesmo modelo e buscadas no índice FAISS, retornando os 5 melhores resultados (“snippets”) por “Busca de Vizinhos Mais Próximos” (“Nearest Neighbor Search”).
Para avaliar as metodologias RAG, 200 perguntas foram geradas pelo modelo gemini-3-flash (via plataforma “web”), diferente do modelo de criação da base de conhecimento para evitar vieses. As perguntas foram divididas igualmente em quatro grupos, conforme a Tabela 2, para avaliar diferentes níveis de dependência do mecanismo de recuperação.
Tabela 2. Classificações de perguntas criadas para avaliação
| Classificação | Definição | Exemplo |
|---|---|---|
| Totalmente relacionadas – “single-snippet” | Perguntas cuja resposta pode ser obtida integralmente a partir de um único trecho recuperado da base de conhecimento. | O TCC pode ser realizado em grupo? |
| Totalmente relacionadas – “multi-snippet” | Perguntas cuja resposta exige a combinação de dois ou mais trechos recuperados da base de conhecimento. | Qual o peso do TCC na média final e como a reprovação nele afeta a obtenção do título? |
| Parcialmente relacionadas | Perguntas relacionadas ao conteúdo da base, mas que demandam conhecimento adicional não presente nos trechos recuperados. | Existe um limite de vezes que posso trocar de orientador? |
| Não relacionadas | Perguntas sem relação com o conteúdo da base de conhecimento, não passíveis de resposta a partir do sistema RAG. | Como aprender a tocar violão sozinho pela internet? |
Fonte: Resultados originais da pesquisa
Múltiplos agentes foram construídos usando o “framework” CrewAI para implementar e comparar cinco estratégias de RAG: Clássico, Re-ranqueamento, Multihop, Hierárquico e Agêntico, conforme detalhado na Tabela 3. Para comparabilidade, parâmetros como temperatura (0), número máximo de trechos recuperados (5) e modelo de linguagem (openai-gpt-40-mini) foram mantidos constantes, assim como “prompts” equivalentes.
Tabela 3. Estratégias de RAG para geração de respostas utilizadas
| Estratégia | Definição |
|---|---|
| Clássico | Trechos relevantes são recuperados por busca vetorial e fornecidos diretamente como contexto para um modelo de linguagem gerar a resposta. |
| Re-ranqueamento | Trechos inicialmente recuperados por busca vetorial passam por uma etapa adicional de reavaliação semântica para selecionar os contextos mais relevantes antes da geração da resposta. |
| Multihop | Sistema realiza múltiplas etapas de recuperação, formulando perguntas intermediárias sucessivas para reunir informações complementares antes de produzir a resposta final. |
| Hierárquico | Organiza a base de conhecimento em níveis temáticos e restringe a busca vetorial aos grupos de tópicos mais relevantes para a pergunta, refinando o escopo da recuperação. |
| Agêntico | Múltiplos agentes especializados cooperam entre si, distribuindo tarefas como refinamento da pergunta, recuperação de contexto e síntese da resposta em um fluxo colaborativo de raciocínio. |
Fonte: Resultados originais da pesquisa
A abordagem RAG Clássico integrou diretamente a recuperação vetorial com o modelo de geração. Trechos semanticamente próximos foram selecionados, organizados em blocos de contexto e concatenados para o modelo de linguagem gerar a resposta. Um agente único orquestrou a busca vetorial e a geração da resposta.
No RAG com Re-ranqueamento, uma etapa intermediária foi adicionada. Após a busca vetorial inicial, os trechos foram submetidos a uma reavaliação semântica por um modelo de linguagem (“cross-encoder”) para selecionar os três mais pertinentes, que compuseram o contexto final. Um agente único gerenciava a busca e o re-ranqueamento.
O RAG “multi-hop” utilizou um mecanismo iterativo de recuperação. O modelo de linguagem analisava os trechos recuperados e, se necessário, formulava perguntas intermediárias para obter informações complementares. Este processo podia ser repetido por até 3 interações, construindo um contexto progressivo a partir de informações dispersas.
A abordagem Hierárquica estruturou a base de conhecimento em grupos temáticos. Para cada pergunta, um modelo de linguagem classificava o tópico mais provável, restringindo a busca vetorial aos trechos desse grupo temático. Os trechos resultantes eram então organizados e fornecidos ao modelo gerador.
O RAG baseado em Agentes expandiu a arquitetura para um sistema multiagente no “framework” CrewAI. Agentes especializados assumiram papéis como reformular a pergunta original, buscar e selecionar trechos relevantes, e sintetizar a resposta final. A interação sequencial e coordenada entre agentes simulou um fluxo colaborativo de raciocínio.
Durante a execução, dados como contexto enviado, estimativa de “tokens” e latência foram armazenados. As etapas de decisão, recuperação e re-ranqueamento foram rastreadas por “logs” de “debug” para garantir transparência e reprodutibilidade. Os fluxos agênticos foram executados isoladamente, com mecanismos de liberação de memória para evitar “state leakage”.
A avaliação das metodologias considerou cinco métricas principais: “faithfulness” (fidelidade da resposta ao contexto), “answer relevancy” (adequação da resposta à pergunta), “context relevancy” (qualidade dos trechos recuperados), latência (tempo de processamento) e uso de “tokens” (consumo computacional). As três primeiras métricas avaliam a qualidade semântica e informacional, enquanto as duas últimas refletem desempenho e custo.
As métricas de qualidade (“faithfulness”, “answer relevancy”, “context relevancy”) foram calculadas pela abordagem “LLM-as-a-judge”, utilizando o modelo claude-haiku-4-5-20251001, configurado com temperatura zero para julgamentos determinísticos e reprodutíveis, a fim de reduzir vieses. Os “prompts” de avaliação definiram critérios explícitos para escores normalizados entre 0 e 1, acompanhados de justificativas textuais.
As métricas operacionais de latência e uso de “tokens” foram medidas diretamente pelo “runner” de execução, utilizando “timestamps” do relógio do sistema para latência e o consumo de “tokens” como “proxy” de custo computacional. Um mecanismo de “retry” foi implementado para chamadas ao avaliador, com até três tentativas adicionais e “backoff” exponencial (1, 2 e 4 segundos) em caso de erros transitórios.
3. Resultados e Discussão
Os resultados para a métrica de faithfulness indicaram uma degradação progressiva na fidelidade das respostas à medida que a complexidade das perguntas aumentava. Perguntas totalmente relacionadas e suportadas por um único snippet apresentaram os maiores níveis de aderência factual, seguidas por aquelas que exigiam múltiplos snippets, perguntas parcialmente relacionadas e, por fim, perguntas não relacionadas. Este padrão, detalhado na Tabela 4, sugere que, conforme as tarefas demandam maior capacidade de integração semântica ou inferência além do conhecimento explicitamente disponível, a probabilidade de desvios factuais nas respostas geradas pelos sistemas avaliados aumenta. Embora muitos cenários tenham mostrado valores consistentes entre o primeiro (Q1) e o terceiro quartil (Q3), cenários com alta variação e onde as respostas eram passíveis de serem geradas a partir da base de conhecimento disponível podem representar riscos para implementação corporativa e devem ser analisados caso a caso.
Tabela 4. Resultados para a métrica LLM-as-a-judge “faithfulness”
| Métod. RAG | Grupo | Média | Q1 | Mediana | Q3 |
|---|---|---|---|---|---|
| Agêntico | Não relacionadas | 0.7 | 0.3 | 1.0 | 1.0 |
| Clássico | Não relacionadas | 1.0 | 1.0 | 1.0 | 1.0 |
| Hierárquico | Não relacionadas | 1.0 | 1.0 | 1.0 | 1.0 |
| Multihop | Não relacionadas | 0.5 | 0.0 | 0.5 | 1.0 |
| Re-ranqueamento | Não relacionadas | 1.0 | 1.0 | 1.0 | 1.0 |
| Agêntico | Parcialmente relacionadas | 0.8 | 0.5 | 1.0 | 1.0 |
| Clássico | Parcialmente relacionadas | 0.9 | 0.6 | 1.0 | 1.0 |
| Hierárquico | Parcialmente relacionadas | 0.9 | 1.0 | 1.0 | 1.0 |
| Multihop | Parcialmente relacionadas | 0.8 | 0.5 | 1.0 | 1.0 |
| Re-ranqueamento | Parcialmente relacionadas | 0.8 | 0.5 | 1.0 | 1.0 |
| Agêntico | “multi-snippet” | 0.7 | 0.5 | 0.5 | 1.0 |
| Clássico | “multi-snippet” | 0.7 | 0.5 | 0.5 | 1.0 |
| Hierárquico | “multi-snippet” | 0.8 | 0.5 | 0.8 | 1.0 |
| Multihop | “multi-snippet” | 0.6 | 0.5 | 0.5 | 0.5 |
| Re-ranqueamento | “multi-snippet” | 0.7 | 0.5 | 0.5 | 1.0 |
| Agêntico | “single-snippet” | 1.0 | 1.0 | 1.0 | 1.0 |
| Clássico | “single-snippet” | 1.0 | 1.0 | 1.0 | 1.0 |
| Hierárquico | “single-snippet” | 0.9 | 1.0 | 1.0 | 1.0 |
| Multihop | “single-snippet” | 1.0 | 1.0 | 1.0 | 1.0 |
| Re-ranqueamento | “single-snippet” | 1.0 | 1.0 | 1.0 | 1.0 |
Fonte: Resultados originais da pesquisa.
Este padrão de degradação da fidelidade foi consistente entre as diferentes metodologias de RAG, mas com intensidades variadas. Abordagens mais complexas, como as metodologias agêntica e multihop, mostraram maior propensão à alucinação. Na abordagem multihop, isso pode ser atribuído ao encadeamento sucessivo de consultas e respostas intermediárias, que tende a introduzir ruído adicional e aumentar a chance de geração de conteúdo não estritamente fundamentado. A metodologia agêntica, por sua vez, exibiu maior variabilidade nos escores de faithfulness, possivelmente devido à autonomia dos agentes e à divisão de responsabilidades cognitivas, o que pode levar a respostas mais elaboradas mesmo com embasamento parcial ou inexistente. É crucial avaliar os casos de alucinação considerando o risco associado ao caso de uso, distinguindo entre respostas sem relação lógica de conteúdo e aquelas que, embora não embasadas na base interna, podem ser corretas pelo conhecimento de mundo. O estudo observou o segundo tipo de alucinação. Em contraste, a abordagem hierárquica demonstrou maior robustez na métrica de faithfulness, o que se associa ao forte mecanismo de restrição contextual imposto pela organização hierárquica dos documentos, limitando a exposição a contextos marginais.
A análise conjunta das métricas de faithfulness e answer relevancy, apresentada na Tabela 5, revelou um trade-off significativo entre fidelidade factual e utilidade percebida das respostas. Metodologias com maior propensão à alucinação frequentemente exibiram escores mais altos de relevância da resposta. Isso sugere que a liberdade de extrapolar além do conhecimento explicitamente recuperado, embora aumente o risco de imprecisão, pode gerar respostas mais úteis, especialmente quando a base de conhecimento não contém informações diretamente aplicáveis à questão proposta. Este achado ressalta a importância da manutenção das bases de conhecimento em sistemas de RAG e indica uma relação inversamente proporcional entre a cobertura da base e a necessidade de conhecimento externo por parte dos agentes de recuperação.
Tabela 5. Resultados para a métrica LLM-as-a-judge “answer relevancy”
| Métod. RAG | Grupo | Média | Q1 | Mediana | Q3 |
|---|---|---|---|---|---|
| Agêntico | Não relacionadas | 0,5 | 0,0 | 0,3 | 1,0 |
| Clássico | Não relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Hierárquico | Não relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Multihop | Não relacionadas | 0,7 | 0,1 | 1,0 | 1,0 |
| Re-ranqueamento | Não relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Agêntico | Parcialmente relacionadas | 0,5 | 0,5 | 0,5 | 0,5 |
| Clássico | Parcialmente relacionadas | 0,6 | 0,5 | 0,5 | 0,9 |
| Hierárquico | Parcialmente relacionadas | 0,5 | 0,5 | 0,5 | 0,5 |
| Multihop | Parcialmente relacionadas | 0,4 | 0,1 | 0,5 | 0,5 |
| Re-ranqueamento | Parcialmente relacionadas | 0,6 | 0,5 | 0,5 | 0,9 |
| Agêntico | “multi-snippet” | 0,9 | 0,6 | 1,0 | 1,0 |
| Clássico | “multi-snippet” | 0,8 | 0,6 | 0,8 | 0,9 |
| Hierárquico | “multi-snippet” | 0,8 | 0,8 | 0,9 | 1,0 |
| Multihop | “multi-snippet” | 0,9 | 1,0 | 1,0 | 1,0 |
| Re-ranqueamento | “multi-snippet” | 0,8 | 0,8 | 0,9 | 1,0 |
| Agêntico | “single-snippet” | 1,0 | 1,0 | 1,0 | 1,0 |
| Clássico | “single-snippet” | 1,0 | 1,0 | 1,0 | 1,0 |
| Hierárquico | “single-snippet” | 0,9 | 1,0 | 1,0 | 1,0 |
| Multihop | “single-snippet” | 1,0 | 1,0 | 1,0 | 1,0 |
| Re-ranqueamento | “single-snippet” | 1,0 | 1,0 | 1,0 | 1,0 |
Fonte: Resultados originais da pesquisa.
O efeito de maior relevância com menor fidelidade foi notável no conjunto de perguntas não relacionadas, onde a abordagem multihop apresentou uma proporção significativa de respostas úteis, mesmo sem suporte factual direto da base de conhecimento. Nesses casos, a alta answer relevancy resultou do uso de conhecimentos gerais ou inferências implícitas do modelo. Isso demonstra que utilidade percebida e fidelidade factual são dimensões complementares, não necessariamente alinhadas. A métrica de context relevancy, apresentada na Tabela 6, revelou um comportamento distinto das métricas anteriores. Embora tenha havido uma degradação progressiva da relevância dos trechos recuperados com o aumento da complexidade das perguntas, não se observaram diferenças significativas entre as metodologias avaliadas. Isso sugere que os mecanismos de recuperação, nas implementações estudadas, convergiram para conjuntos de contexto semanticamente semelhantes, independentemente da arquitetura de RAG utilizada.
Tabela 6. Resultados para a métrica LLM-as-a-judge “context relevancy”
| Métod. RAG | Grupo | Média | Q1 | Mediana | Q3 |
|---|---|---|---|---|---|
| Agêntico | Não relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Clássico | Não relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Hierárquico | Não relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Multihop | Não relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Re-ranqueamento | Não relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Agêntico | Parcialmente relacionadas | 0,3 | 0,0 | 0,3 | 0,5 |
| Clássico | Parcialmente relacionadas | 0,3 | 0,0 | 0,3 | 0,5 |
| Hierárquico | Parcialmente relacionadas | 0,3 | 0,0 | 0,3 | 0,5 |
| Multihop | Parcialmente relacionadas | 0,3 | 0,0 | 0,3 | 0,5 |
| Re-ranqueamento | Parcialmente relacionadas | 0,3 | 0,0 | 0,3 | 0,5 |
| Agêntico | “multi-snippet” | 0,6 | 0,5 | 0,5 | 0,8 |
| Clássico | “multi-snippet” | 0,6 | 0,5 | 0,5 | 0,8 |
| Hierárquico | “multi-snippet” | 0,6 | 0,5 | 0,5 | 0,8 |
| Multihop | “multi-snippet” | 0,6 | 0,5 | 0,6 | 0,8 |
| Re-ranqueamento | “multi-snippet” | 0,6 | 0,5 | 0,5 | 0,8 |
| Agêntico | “single-snippet” | 0,9 | 0,9 | 1,0 | 1,0 |
| Clássico | “single-snippet” | 0,9 | 0,9 | 1,0 | 1,0 |
| Hierárquico | “single-snippet” | 0,9 | 0,9 | 1,0 | 1,0 |
| Multihop | “single-snippet” | 0,9 | 0,9 | 1,0 | 1,0 |
| Re-ranqueamento | “single-snippet” | 0,9 | 0,9 | 1,0 | 1,0 |
Fonte: Resultados originais da pesquisa.
A ausência de diferenciação relevante na métrica de context relevancy não implica que todas as metodologias sejam igualmente eficazes em termos de recuperação de contexto, mas sugere que as estratégias aplicadas podem não ter sido suficientemente distintas ou necessárias para produzir separações mensuráveis. Três fatores podem ter contribuído para este cenário: a estrutura da base de conhecimento, que era um manual de normas altamente delimitado, favorecendo recuperações precisas; a natureza das perguntas geradas, que, mesmo sendo de outro modelo de linguagem, mantinham alta relação semântica com a base para perguntas totalmente relacionadas; e o gargalo no top-K de cinco snippets recuperados, que pode ter limitado a capacidade de aprofundamento de técnicas como multihop e re-ranqueamento, focadas em bases de conhecimento extensas. Este resultado sugere a necessidade de futuras investigações com técnicas mais sofisticadas de geração de perguntas e recuperação.
Em relação à latência, os resultados, detalhados na Tabela 7, refletiram a complexidade computacional inerente a cada metodologia. O método clássico demonstrou os menores tempos de resposta devido à sua simplicidade arquitetural e ao menor número de etapas, sendo ideal para perguntas simples onde a latência é um fator crítico. Por outro lado, metodologias mais elaboradas, como o re-ranqueamento, apresentaram latências substancialmente superiores, mesmo para perguntas de baixa complexidade. Isso indica que o custo computacional adicional introduzido por etapas intermediárias pode não ser compensado em todos os cenários, sugerindo a adequação de diferentes metodologias de RAG para tipos específicos de perguntas e a possibilidade de pipelines híbridos em ambientes produtivos.
Tabela 7. Resultados para a métrica de latência na geração da resposta
| Métod. RAG | Grupo | Média | Q1 | Mediana | Q3 |
|---|---|---|---|---|---|
| Agêntico | Não relacionadas | 10,3 | 7,7 | 8,4 | 12,4 |
| Clássico | Não relacionadas | 3,2 | 2,5 | 2,6 | 3,7 |
| Hierárquico | Não relacionadas | 4,2 | 3,5 | 3,9 | 5,0 |
| Multihop | Não relacionadas | 9,3 | 6,3 | 8,5 | 12,5 |
| Re-ranqueamento | Não relacionadas | 17,0 | 8,8 | 14,2 | 15,3 |
| Agêntico | Parcialmente relacionadas | 7,0 | 5,7 | 6,6 | 7,3 |
| Clássico | Parcialmente relacionadas | 3,1 | 2,5 | 2,7 | 3,2 |
| Hierárquico | Parcialmente relacionadas | 4,3 | 3,3 | 4,0 | 4,9 |
| Multihop | Parcialmente relacionadas | 6,4 | 5,8 | 6,1 | 6,4 |
| Re-ranqueamento | Parcialmente relacionadas | 10,3 | 8,0 | 8,6 | 9,0 |
| Agêntico | “multi-snippet” | 8,4 | 7,8 | 8,3 | 8,9 |
| Clássico | “multi-snippet” | 5,5 | 3,2 | 3,8 | 4,2 |
| Hierárquico | “multi-snippet” | 4,2 | 3,9 | 4,1 | 4,7 |
| Multihop | “multi-snippet” | 8,3 | 7,8 | 8,2 | 8,8 |
| Re-ranqueamento | “multi-snippet” | 9,5 | 8,7 | 9,6 | 10,0 |
| Agêntico | “single-snippet” | 5,9 | 5,3 | 5,4 | 6,0 |
| Clássico | “single-snippet” | 2,8 | 2,6 | 2,8 | 3,0 |
| Hierárquico | “single-snippet” | 3,7 | 3,2 | 3,4 | 4,2 |
| Multihop | “single-snippet” | 5,5 | 5,3 | 5,4 | 5,5 |
| Re-ranqueamento | “single-snippet” | 8,1 | 7,6 | 8,0 | 8,5 |
Fonte: Resultados originais da pesquisa.
A análise do consumo de tokens no prompt, apresentada na Tabela 8, revelou que as abordagens multihop e agêntica consumiram aproximadamente o dobro de tokens em comparação com as demais metodologias. Esse consumo elevado reflete a necessidade de manter históricos de interação mais extensos, múltiplos contextos intermediários ou instruções adicionais ao longo do processo de geração. Embora associado à maior flexibilidade cognitiva dessas abordagens, esse aumento no custo operacional impõe limitações de escalabilidade e viabilidade econômica, especialmente em aplicações de larga escala onde latência e custo por requisição são fatores críticos de decisão arquitetural.
Tabela 8. Resultados para a métrica de consumo de tokens no prompt
| Métod. RAG | Grupo | Média | Q1 | Mediana | Q3 |
|---|---|---|---|---|---|
| Agêntico | Não relacionadas | 2065 | 1089 | 2010 | 2510 |
| Clássico | Não relacionadas | 783 | 585 | 590 | 1039 |
| Hierárquico | Não relacionadas | 785 | 688 | 702 | 716 |
| Multihop | Não relacionadas | 2290 | 1216 | 1257 | 3013 |
| Re-ranqueamento | Não relacionadas | 3596 | 718 | 1517 | 1580 |
| Agêntico | Parcialmente relacionadas | 1002 | 912 | 931 | 1007 |
| Clássico | Parcialmente relacionadas | 667 | 593 | 603 | 609 |
| Hierárquico | Parcialmente relacionadas | 778 | 694 | 712 | 725 |
| Multihop | Parcialmente relacionadas | 1247 | 1234 | 1249 | 1258 |
| Re-ranqueamento | Parcialmente relacionadas | 903 | 719 | 730 | 750 |
| Agêntico | “multi-snippet” | 1028 | 995 | 1028 | 1057 |
| Clássico | “multi-snippet” | 1851 | 620 | 629 | 647 |
| Hierárquico | “multi-snippet” | 728 | 705 | 739 | 765 |
| Multihop | “multi-snippet” | 1287 | 1255 | 1301 | 1310 |
| Re-ranqueamento | “multi-snippet” | 765 | 756 | 761 | 768 |
| Agêntico | “single-snippet” | 936 | 891 | 914 | 961 |
| Clássico | “single-snippet” | 597 | 589 | 592 | 597 |
| Hierárquico | “single-snippet” | 729 | 602 | 666 | 726 |
| Multihop | “single-snippet” | 1273 | 1234 | 1261 | 1295 |
| Re-ranqueamento | “single-snippet” | 724 | 715 | 718 | 728 |
Fonte: Resultados originais da pesquisa.
A Figura 1 apresenta uma análise consolidada das métricas, revelando as diferenças no equilíbrio entre qualidade das respostas e eficiência computacional entre os métodos avaliados. O método Hierárquico demonstrou o desempenho mais equilibrado, combinando altos níveis de faithfulness com valores relativamente elevados de answer relevancy e boa eficiência nas métricas de consumo de tokens. O método Clássico destacou-se pela baixa latência, mantendo níveis competitivos de fidelidade e consumo de tokens, o que o torna uma alternativa eficiente quando o tempo de resposta é um fator crítico. O método Agêntico obteve bom desempenho em qualidade de resposta, particularmente em answer relevancy, porém apresentou penalidades nas métricas de custo computacional, como latência e consumo de tokens. O método multihop mostrou desempenho semelhante ao Agêntico em relevância da resposta, mas com menor eficiência computacional geral. Por fim, o método de Re-ranqueamento apresentou resultados mais modestos no conjunto das métricas analisadas, sobretudo em latência e relevância da resposta. Considerando simultaneamente qualidade e eficiência, os resultados consolidados do estudo sugerem que o método Hierárquico oferece o melhor compromisso entre desempenho e custo computacional no contexto avaliado.
Figura 1. Análise comparativa das métricas entre os diferentes métodos
Fonte: Resultados originais da pesquisa.
Os resultados deste estudo indicaram que não há uma metodologia de RAG universalmente superior em todas as dimensões analisadas. As diferentes arquiteturas avaliadas apresentaram comportamentos distintos nas métricas de faithfulness, answer relevancy, context relevancy, latência e consumo de tokens, revelando a existência de trade-offs estruturais entre fidelidade factual, utilidade percebida, custo computacional e desempenho operacional, especialmente quando avaliadas pela perspectiva de diferentes estilos de perguntas. Abordagens mais flexíveis, como multihop e agêntica, tenderam a produzir respostas mais relevantes, especialmente para perguntas nas quais a base de conhecimento não oferecia suporte direto, o que pode ser útil quando a cobertura de conhecimento ainda não está consolidada. Contudo, esse ganho em answer relevancy ocorreu à custa de maior propensão à extrapolação não ancorada no contexto recuperado, manifestando-se em aumento do risco de alucinação factual, maior latência e consumo significativamente superior de tokens. Em contraste, metodologias mais restritivas, como a abordagem hierárquica e o método clássico, demonstraram maior controle sobre a fidelidade factual e melhor desempenho operacional, ainda que com menor capacidade de extrapolação em perguntas complexas ou pouco relacionadas. Esses achados reforçam que as métricas de qualidade em sistemas de RAG não devem ser analisadas isoladamente, mas sim como dimensões complementares que refletem objetivos distintos de projeto. A adoção de sistemas de RAG em ambientes produtivos deve ponderar acurácia, utilidade, custo, latência e robustez contra a alucinação, com a tolerância à extrapolação sendo avaliada conforme o contexto de negócio. Arquiteturas híbridas, capazes de selecionar dinamicamente a metodologia mais adequada ao tipo de pergunta, podem ser um caminho promissor para equilibrar esses trade-offs.
4. Conclusão
O presente estudo avaliou comparativamente a performance de diferentes metodologias de Recuperação Aumentada por Geração (RAG) na construção de agentes generativos para atendimento automatizado de perguntas frequentes. Verificou-se que não existe uma abordagem universalmente superior, mas sim trade-offs estruturais entre a qualidade das respostas, o custo computacional e o desempenho operacional. Observou-se que a fidelidade factual das respostas degradou-se com o aumento da complexidade das perguntas, sendo mais acentuada em metodologias como a agêntica e a multi-hop, que também apresentaram maior propensão à alucinação. Em contrapartida, notou-se que a relevância da resposta, especialmente para perguntas sem suporte direto na base de conhecimento, frequentemente se elevou à custa da fidelidade. A metodologia hierárquica demonstrou o melhor compromisso entre desempenho e custo computacional, enquanto o método clássico destacou-se pela baixa latência, sendo eficiente para perguntas mais simples. A principal contribuição da pesquisa reside na oferta de uma análise comparativa sistemática que subsidia decisões técnicas e arquiteturais no desenho de agentes generativos baseados em RAG para aplicações empresariais.
Apesar dos achados, a análise da relevância do contexto não revelou diferenças significativas entre as metodologias, um resultado que pode ter sido influenciado pela natureza altamente delimitada da base de conhecimento, pela alta relação semântica das perguntas geradas e pelo gargalo imposto pelo limite de cinco snippets recuperados. Tais fatores sugerem que as estratégias de recuperação podem não ter sido suficientemente testadas em sua capacidade de diferenciação. Para futuras investigações, recomenda-se a exploração de técnicas mais sofisticadas de geração de perguntas e recuperação, como o re-ranqueamento semântico profundo e a expansão adaptativa de consultas. Sugere-se também a avaliação de estratégias adaptativas que considerem o nível de confiança do sistema e a cobertura da base de conhecimento, visando ampliar a capacidade de generalização e a confiabilidade dos agentes generativos baseados em RAG. A implementação de arquiteturas híbridas, capazes de selecionar dinamicamente a metodologia mais adequada ao tipo de pergunta, emerge como um caminho promissor para equilibrar os trade-offs identificados entre acurácia, utilidade, custo, latência e robustez contra a alucinação em ambientes produtivos.
Referências Bibliográficas
Al-Osaimi, M; Altuwayrah, A.; Khan, H.; Rahman, Abdul. 2025. Transforming Support Efficiency in Exploration: A Combined GenAI Models Solution for improved Application Support. Disponível em: https://doi.org/10.2118/227054-MS. Acesso em: 25 out. 2025.
Genesis, J. 2025. Retrieval-Augmented Text Generation: Methods, Challenges, and Applications. Disponível em:
Park, J. S.; O’Brien, J. C.; Cai, C. J.; Morris, M. R.; Liang, P.; Bernstein, M. S. 2023. Generative Agents: Interactive Simulacra of Human Behavior. Disponível em: . Acesso em: 30 abr. 2025.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

