
20 de agosto de 2026
Aplicação de Visualização de Dados e Aprendizado de Máquina na Compreensão do “Turnover” Corporativo
Antonio Angelo da Costa Pereira; Fernando Celso de Campos
DOI: 10.22167/2675-6528-202601681
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A rotatividade de colaboradores representa um desafio significativo para as organizações, impactando custos e produtividade. O objetivo foi desenvolver um painel interativo de visualização de dados, integrado a técnicas de aprendizado de máquina, para monitorar e analisar indicadores de turnover corporativo, identificar padrões e validar predições de desligamento, apoiando a gestão de talentos. Realizou-se uma pesquisa aplicada e quantitativa, configurada como um estudo de caso simulado, utilizando um conjunto de dados público de recursos humanos. As etapas metodológicas incluíram a compreensão e preparação dos dados, o desenvolvimento e validação de modelos preditivos de classificação binária em Python, e a integração dos resultados em um dashboard no MS-Power BI. Avaliaram-se algoritmos como Regressão Logística, Random Forest e XGBoost, sendo o Random Forest selecionado por seu desempenho superior na métrica de Recall. Os resultados demonstraram que a solução desenvolvida permitiu consolidar informações do quadro funcional, identificando padrões relevantes como a maior concentração de desligamentos em faixas salariais mais baixas e associados a níveis reduzidos de satisfação. Além disso, o sistema gerou probabilidades individuais de desligamento de forma consistente. Concluiu-se que a integração de aprendizado de máquina e visualização de dados oferece um instrumento estratégico valioso para antecipar riscos e orientar políticas de retenção de talentos, fortalecendo a tomada de decisão na gestão de pessoas.
Palavras-chave: Aprendizado de Máquina; Gestão de Pessoas; People Analytics; Retenção de Talentos; Visualização de Dados.
1. Introdução
Nas organizações contemporâneas, o desempenho sustentável e a capacidade de inovação dependem intrinsecamente da qualidade, dedicação e comprometimento do capital humano em todos os níveis hierárquicos. A gestão de recursos humanos, nesse contexto, assume um papel estratégico fundamental, sendo um pilar para a criação de valor e a obtenção de vantagem competitiva, conforme ressalta Armstrong (2014). Profissionais qualificados, engajados e motivados são essenciais para o sucesso organizacional a longo prazo.
Contudo, a rotatividade de colaboradores, comumente denominada “turnover”, emerge como um dos principais desafios enfrentados pelas empresas. A saída frequente de profissionais acarreta impactos negativos significativos, que se manifestam na redução da produtividade, na elevação dos custos operacionais associados a recrutamento e treinamento, e na interrupção da continuidade do conhecimento organizacional. A compreensão e a gestão proativa desse fenômeno são, portanto, cruciais para a sustentabilidade e competitividade das organizações.
Diante da crescente complexidade organizacional e do volume de dados disponíveis sobre os colaboradores, o uso de “People Analytics” tem se consolidado como uma ferramenta estratégica indispensável. Essa abordagem analítica permite transformar grandes volumes de informações em “insights” práticos, apoiando a tomada de decisão em relação ao capital humano (Starbuck, 2023). Por meio da aplicação de técnicas avançadas de análise de dados, é possível identificar padrões de comportamento, prever riscos de desligamento e formular ações de retenção mais eficazes.
Nesse cenário, as ferramentas de visualização de dados desempenham um papel essencial no acompanhamento e na interpretação dos indicadores de rotatividade. “Dashboards” interativos, como os desenvolvidos em plataformas como o MS-Power BI, permitem não apenas monitorar o volume de desligamentos, mas também explorar padrões e tendências associados a fatores como tempo de permanência, setor de atuação e desempenho individual. Tais instrumentos funcionam como extensões cognitivas, ampliando a capacidade de análise e controle sobre grandes volumes de dados (Toasa et al., 2018).
A comunicação eficaz de informações complexas, especialmente no ambiente corporativo, é aprimorada pelo uso de técnicas de “data storytelling”. Essa abordagem integra elementos narrativos às visualizações de dados, tornando-os mais memoráveis e compreensíveis (Ren et al., 2023). Ao transformar indicadores abstratos em histórias significativas, o “data storytelling” facilita a interpretação de padrões e a identificação de causas subjacentes relacionadas ao “turnover”, promovendo maior engajamento e empatia entre os “stakeholders”.
Paralelamente, o “Machine Learning” tem se destacado como uma abordagem promissora na predição do “turnover” de colaboradores. Modelos preditivos, como a Regressão Logística e o LightGBM, permitem que as organizações identifiquem antecipadamente funcionários com maior propensão à saída, possibilitando a adoção de estratégias preventivas e direcionadas de retenção. Além da previsão, a análise de modelos explicáveis e causais amplia a compreensão sobre as variáveis que realmente influenciam o desligamento, fornecendo subsídios valiosos para o desenvolvimento de políticas de retenção mais eficazes (Lazzari et al., 2022).
O avanço das técnicas de “Machine Learning” é impulsionado pela consolidação do ecossistema Python, que se estabeleceu como a principal linguagem para ciência de dados e inteligência artificial. Sua versatilidade e a vasta comunidade científica resultaram na criação de bibliotecas robustas, como NumPy, Pandas e Scikit-learn, que viabilizam desde a manipulação e preparação de grandes volumes de dados até a implementação de modelos preditivos complexos (Raschka et al., 2020). O uso do Python, portanto, não apenas otimiza a eficiência no processamento e análise, mas também torna o desenvolvimento de soluções de “Machine Learning” mais acessível, reproduzível e interpretável.
Apesar do reconhecimento da importância do capital humano e da disponibilidade de tecnologias avançadas, muitas organizações ainda enfrentam dificuldades em integrar efetivamente a análise de dados, a visualização interativa e o aprendizado de máquina para uma compreensão profunda e proativa do “turnover”. Existe uma lacuna na aplicação prática dessas ferramentas de forma conjunta e estratégica para transformar dados brutos em conhecimento acionável, que apoie decisões de retenção de talentos e gestão de pessoas. Assim, este trabalho justifica-se pela necessidade de oferecer uma solução integrada que permita às empresas transformar informações em conhecimento estratégico, auxiliando na tomada de decisões voltadas à retenção de talentos e à melhoria do desempenho global. Diante desse contexto, este trabalho tem como objetivo desenvolver um painel interativo (ou “dashboard”) de visualização de dados que permita monitorar e analisar os indicadores relacionados ao “turnover corporativo”, integrando técnicas de “Machine Learning” para identificar padrões e validar predições de desligamento, de modo a apoiar a tomada de decisão estratégica voltada à retenção de talentos e à gestão eficiente de pessoas.
2. Material e Métodos
A pesquisa adotou abordagem aplicada e quantitativa, configurada como estudo de caso simulado, para compreender e predizer o turnover corporativo. Utilizou-se o “HR Dataset”, um conjunto de dados público da plataforma Kaggle, com 14.999 registros e 10 variáveis. Estas descreviam satisfação, desempenho, tempo de empresa, departamento e salário de funcionários de uma organização fictícia. A variável-alvo “left” indicava se o colaborador havia deixado a empresa (1) ou permanecido (0). O desenvolvimento do trabalho foi estruturado em cinco etapas sequenciais: definição e compreensão do dataset; preparação e tratamento dos dados; elaboração e validação de modelos preditivos de machine learning; integração dos resultados no MS-Power BI; e construção e análise do dashboard final.
Etapa (i) – Definição e compreensão do dataset
Nesta fase, o “HR Dataset” foi analisado para entender sua estrutura. Variáveis como “satisfaction_level” e “last_evaluation” eram float64; “number_project” e “time_spend_company” eram int64; “Department” e “Salary” eram object. A variável “left” foi definida como dependente para a predição do turnover. Essa compreensão inicial foi crucial para as etapas subsequentes de pré-processamento e modelagem.
Etapa (ii) – Preparação e tratamento dos dados
A preparação dos dados iniciou-se com análise exploratória. Constatou-se a ausência de valores ausentes ou inconsistências, dispensando imputação. Avaliou-se a distribuição da variável-alvo “left”, revelando desbalanceamento: 76,19% de permanências (classe 0) e 23,81% de desligamentos (classe 1). Esse desbalanceamento foi considerado na seleção de algoritmos preditivos.
O pré-processamento foi realizado em Python, utilizando bibliotecas como NumPy, Pandas e Scikit-learn. Os dados foram particionados em conjuntos de treinamento (70%) e teste (30%) usando train_test_split, com estratificação da variável-alvo. Variáveis categóricas foram codificadas via One-Hot Encoding para evitar multicolinearidade. O ColumnTransformer foi empregado para transformações simultâneas, prevenindo vazamento de dados (Adeusi et al., 2024).
Etapa (iii) – Elaboração e validação do modelo preditivo de turnover
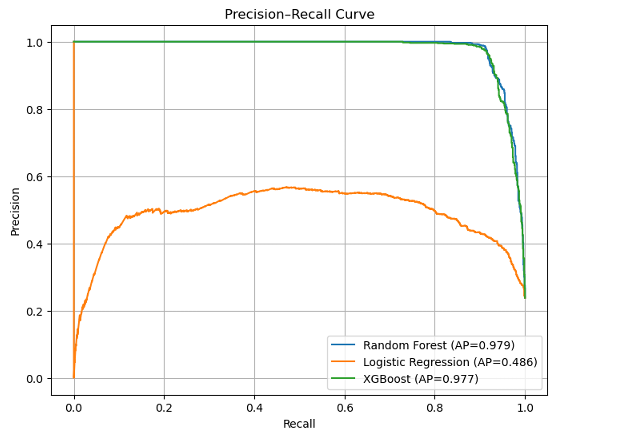
Nesta etapa, desenvolveram-se e avaliaram-se algoritmos de machine learning para estimar a probabilidade de desligamento. Foram testados Regressão Logística, Random Forest e XGBoost, implementados em Python. A avaliação do desempenho baseou-se em métricas como precision, recall, F1-score e accuracy. A análise comparativa foi aprofundada por meio das curvas Precision-Recall e do valor de Average Precision (AP), conforme a Figura 1 (Saito e Rehmsmeier, 2015).
Figura 1. Gráfico Precision-Recall
Fonte: Resultados originais da pesquisa
A Figura 1 ilustra as curvas Precision-Recall para os modelos avaliados, fornecendo uma visão do desempenho em cenários de dados desbalanceados. Essa visualização foi crucial para selecionar o Random Forest como modelo final, priorizando o Recall para a classe positiva (turnover), devido ao seu desempenho competitivo e robustez (Lazzari et al., 2022). O modelo foi aplicado exclusivamente a funcionários ativos, filtrando o dataset e removendo a variável dependente para evitar vazamento de informação.
Etapa (iv) – Integração dos resultados no MS-Power BI
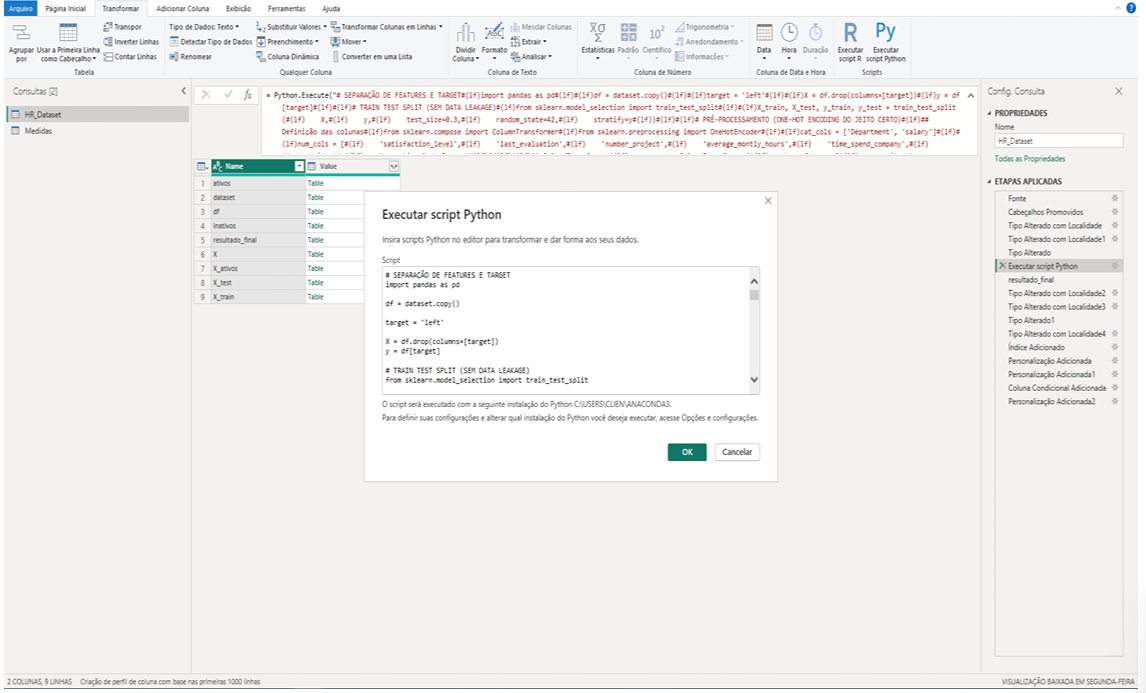
A integração dos resultados preditivos no ambiente MS-Power BI foi realizada para consolidar informações do dataset e probabilidades de desligamento. Os dados foram importados para o Power BI. O processo de transformação e integração foi conduzido no Power Query, onde um script Python foi incorporado para operacionalizar o pipeline do modelo Random Forest, conforme ilustrado na Figura 2. Essa abordagem híbrida permitiu a automação e a reprodutibilidade do processo analítico, garantindo que as estimativas de probabilidade de desligamento fossem geradas exclusivamente para os funcionários ativos.
Figura 2. Aplicação do pipeline do modelo Random Forest no Power Query
Fonte: Resultados originais da pesquisa
A Figura 2 demonstra a interface do Power Query com o script Python integrado, evidenciando como o modelo Random Forest foi operacionalizado para gerar as probabilidades de desligamento. Após a obtenção dessas probabilidades individuais, os registros dos colaboradores ativos foram integrados aos dados dos funcionários desligados, formando uma base de dados consolidada. Nessa base final, as probabilidades de turnover permaneceram associadas apenas aos funcionários ativos, assegurando a coerência metodológica e a consistência das informações integradas ao ambiente de visualização, sem antecipar resultados ou achados empíricos.
Etapa (v) – Construção e análise do dashboard final
Nesta etapa, desenvolveu-se um painel analítico interativo, ou dashboard, estruturado em duas páginas principais: “Visão Geral” e “Probabilidades de Turnover”. O objetivo foi proporcionar uma análise descritiva e preditiva integrada, facilitando a compreensão dos fatores associados à rotatividade de colaboradores. Na página “Visão Geral”, foram configurados segmentadores de dados para Departamento, Faixa Salarial e Situação do Funcionário, permitindo a filtragem dinâmica das informações. Na página “Probabilidades de Turnover”, foi disposta uma tabela com os registros dos colaboradores ativos e suas probabilidades de saída, além de um boxplot para análise da distribuição dessas probabilidades.
A pesquisa, embora robusta em sua abordagem, apresentou limitações metodológicas inerentes ao uso de um conjunto de dados público e simulado, o que restringe a generalização dos resultados para ambientes organizacionais reais. A análise foi circunscrita às variáveis disponíveis no dataset, não permitindo a incorporação de fatores subjetivos, como clima organizacional ou motivações individuais, que poderiam influenciar o turnover. Tais aspectos impõem cautela na interpretação e aplicação dos achados, sugerindo que estudos futuros validem a abordagem com bases de dados reais e variáveis comportamentais.
3. Resultados e Discussão
A seção de Resultados e Discussão aborda os achados da pesquisa, desde a preparação dos dados até a construção e análise do painel interativo. São apresentados os resultados do desempenho dos modelos preditivos, a geração das probabilidades de desligamento e a consolidação dessas informações em um ambiente de visualização. O objetivo é proporcionar uma visão integrada dos aspectos descritivos e preditivos relacionados ao turnover corporativo, conforme a estrutura metodológica definida no estudo. Essa abordagem permite uma compreensão aprofundada dos fatores que influenciam a rotatividade de colaboradores.
Etapa (i) – Definição e compreensão do “dataset”
A importação e análise inicial do conjunto de dados foram realizadas utilizando a linguagem de programação Python no ambiente Jupyter Notebook. O dataset, denominado “HR Dataset” e disponível publicamente, revelou-se composto por 14.999 registros e 10 colunas, correspondendo às variáveis analisadas. Essa etapa inicial foi crucial para verificar a estrutura e a aderência dos dados aos objetivos do estudo, garantindo a consistência para as fases subsequentes da pesquisa. A rastreabilidade das operações foi facilitada pelo uso do Jupyter Notebook.
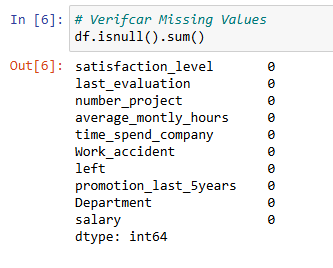
A validação dos tipos de dados identificou que as variáveis “satisfaction_level” e “last_evaluation” eram do tipo float64, enquanto “number_project”, “average_montly_hours”, “time_spend_company”, “work_accident”, “left” e “promotion_last_5years” eram int64. As variáveis “Department” e “salary” foram classificadas como object. Essa categorização é fundamental para a aplicação correta das técnicas de pré-processamento e modelagem, assegurando a compatibilidade dos dados com os algoritmos de aprendizado de máquina. A Figura 3 ilustra essa validação dos tipos de dados.
Figura 3. Validação dos tipos dos dados
Fonte: Resultados originais da pesquisa
Os resultados obtidos nesta etapa confirmam que o conjunto de dados possui características apropriadas para a continuidade das análises, especialmente no que tange à integridade estrutural e à compatibilidade com técnicas de análise estatística e aprendizado de máquina. Contudo, a ausência de identificadores únicos, como matrícula ou ID do colaborador, foi notada como uma limitação. Esse aspecto pode restringir análises mais detalhadas em nível individual, exigindo estratégias alternativas para a rastreabilidade dos registros ao longo do processo analítico, o que deve ser considerado na interpretação dos resultados.
Etapa (ii) – Preparação e tratamento dos dados
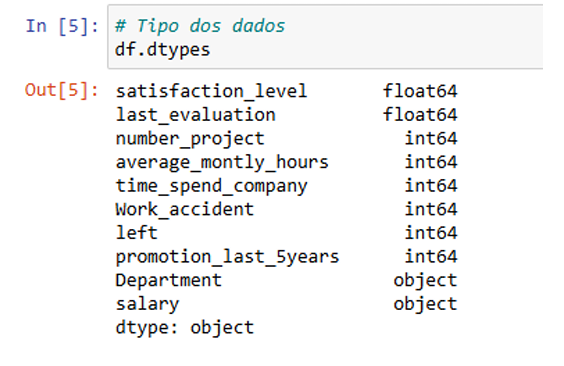
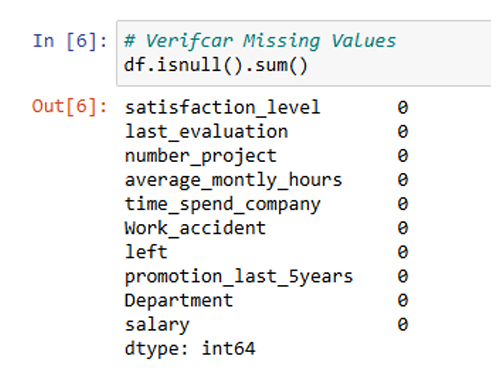
A etapa de preparação e tratamento dos dados iniciou-se com a verificação da ausência de valores ausentes em todas as variáveis do dataset, confirmando a consistência e a completude do conjunto de dados. A inexistência de valores faltantes é um aspecto positivo, pois elimina a necessidade de técnicas de imputação que poderiam introduzir vieses. A Figura 4 demonstra a validação dos valores faltantes, indicando que todas as variáveis apresentavam zero valores ausentes, o que contribui para a robustez das análises subsequentes.
Figura 4. Validação dos valores faltantes
Fonte: Resultados originais da pesquisa
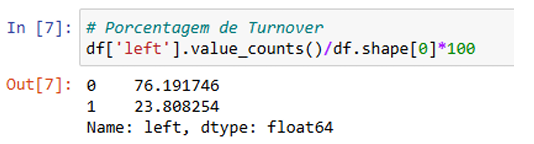
Em seguida, procedeu-se à análise da distribuição da variável alvo “left”, que indica se o colaborador deixou a empresa. Foi identificado um desbalanceamento entre as classes, com aproximadamente 76,19% dos registros associados à permanência (classe 0) e 23,81% ao desligamento (classe 1). A Figura 5 ilustra essa distribuição percentual, evidenciando a predominância da classe majoritária. Esse desbalanceamento é um fator crítico para a modelagem preditiva, pois pode afetar o desempenho dos algoritmos de classificação, especialmente na identificação da classe minoritária.
Figura 5. Validação das porcentagens em relação a variável alvo
Fonte: Resultados originais da pesquisa
A identificação do desbalanceamento entre as classes é um aspecto crucial para a modelagem preditiva, uma vez que a classe 1 (colaboradores que deixaram a organização) representa o evento de maior interesse analítico. É fundamental que o modelo apresente sensibilidade adequada para sua detecção. Conforme Adeusi et al. (2024) destacam, bases de dados de recursos humanos frequentemente exibem desbalanceamento, o que demanda o uso de métricas como Recall e curvas Precision-Recall, em detrimento da acurácia isolada, para uma avaliação mais precisa do desempenho do modelo.
Após a verificação inicial, a variável alvo foi separada das variáveis explicativas, e o dataset foi particionado em conjuntos de treinamento e teste, com proporção de 70% e 30%, respectivamente. A estratificação da variável alvo foi aplicada para preservar a distribuição original das classes em ambos os subconjuntos. As variáveis categóricas, como “Department” e “salary”, foram codificadas utilizando a técnica One-Hot Encoding, com o parâmetro drop=’first’ para evitar multicolinearidade e handle_unknown=’ignore’ para robustez.
O pré-processamento foi realizado por meio do ColumnTransformer, permitindo a aplicação simultânea de diferentes transformações conforme o tipo de variável. O método fit_transform foi utilizado no conjunto de treinamento e transform no conjunto de teste, garantindo que os parâmetros de transformação fossem aprendidos exclusivamente nos dados de treino, evitando o vazamento de informação. Por fim, uma etapa de seleção de variáveis baseada na variância confirmou que nenhuma variável foi removida, pois todas apresentaram variabilidade superior ao limiar estabelecido.
Etapa (iii) – Elaboração e validação do modelo preditivo de “turnover”
Nesta etapa, foram desenvolvidos e avaliados três modelos de classificação supervisionada para estimar a probabilidade de desligamento dos colaboradores: Random Forest, Regressão Logística e XGBoost. Os modelos foram implementados utilizando a linguagem Python e bibliotecas especializadas de aprendizado de máquina, sendo treinados com 70% dos dados e avaliados com os 30% restantes. O objetivo foi identificar o algoritmo que melhor se ajustava ao problema de predição de turnover, considerando as variáveis explicativas tratadas.
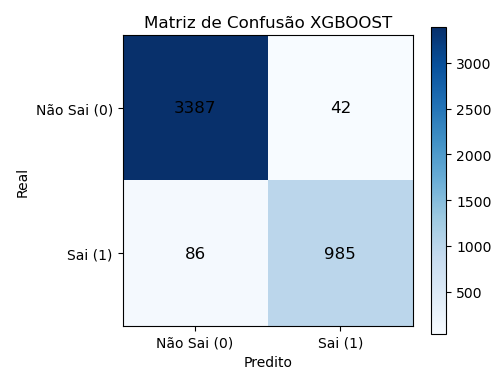
A avaliação de desempenho dos modelos foi conduzida com base em métricas como precision, recall, f1-score e accuracy, além da análise das respectivas matrizes de confusão. A Figura 6 apresenta a matriz de confusão para o modelo Random Forest, mostrando o número de verdadeiros positivos e falsos positivos. Os resultados obtidos nas validações permitiram comparar o desempenho entre os diferentes modelos e selecionar aquele que apresentou o melhor equilíbrio entre sensibilidade e precisão na detecção de colaboradores propensos ao desligamento.
Figura 6. Matriz de confusão do modelo Random Forest
Fonte: Resultados originais da pesquisa
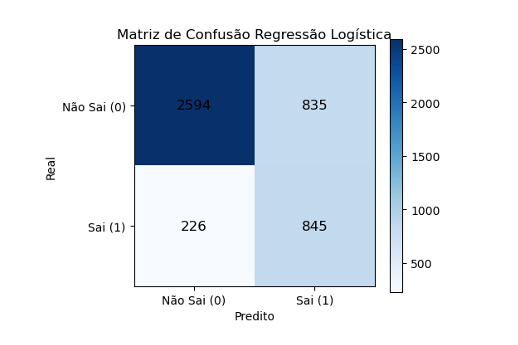
A matriz de confusão do modelo de Regressão Logística, exibida na Figura 7, demonstrou um desempenho inferior em comparação aos modelos baseados em árvores. Embora a Regressão Logística seja valorizada por sua simplicidade e interpretabilidade, sua capacidade de lidar com dados desbalanceados e capturar relações complexas foi superada pelos algoritmos mais robustos. Essa diferença de desempenho ressalta a importância da escolha do modelo adequado para o contexto específico do problema de predição de turnover, especialmente em cenários com desbalanceamento de classes.
Figura 7. Matriz de confusão do modelo Regressão Logística
Fonte: Resultados originais da pesquisa
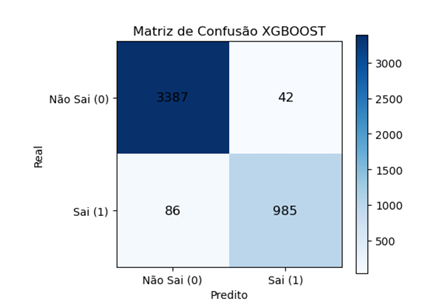
O modelo XGBoost, por sua vez, apresentou uma matriz de confusão, conforme a Figura 8, com valores próximos aos do Random Forest, indicando um desempenho competitivo. O XGBoost é amplamente reconhecido por seu elevado desempenho em tarefas preditivas e capacidade de capturar interações complexas entre variáveis. A análise comparativa entre os modelos foi aprofundada por meio das curvas Precision-Recall e do valor de Average Precision, permitindo uma avaliação mais adequada do desempenho em um contexto de distribuição assimétrica das classes.
Figura 8. Matriz de confusão do modelo XGBoost
Fonte: Resultados originais da pesquisa
O Gráfico Precision-Recall, apresentado na Figura 9, revelou um comportamento semelhante entre os modelos Random Forest e XGBoost, ambos com valores de Average Precision elevados e superiores ao desempenho da Regressão Logística. Considerando o Recall como critério prioritário para a classe positiva (turnover), o Random Forest foi selecionado como modelo final. Essa escolha se justificou por seu desempenho competitivo, simplicidade de implementação e maior robustez frente à distribuição assimétrica das classes no conjunto de dados analisado.
Figura 9. Gráfico “Precision-Recall”
Fonte: Resultados originais da pesquisa
A interpretação dos resultados evidencia que os modelos baseados em árvores, como o Random Forest, possuem maior capacidade de capturar relações complexas entre variáveis explicativas, o que justifica seu desempenho superior. Esse achado é consistente com a literatura, que aponta a influência de múltiplos fatores demográficos, econômicos e psicológicos na intenção de turnover, favorecendo modelos mais flexíveis para predição (Lazzari et al., 2022). Após a definição do modelo final, ele foi aplicado exclusivamente ao subconjunto de funcionários ativos, filtrando os dados para manter apenas os colaboradores que não apresentaram desligamento.
Etapa (iv) – Integração dos resultados no MS-Power BI®
A integração dos resultados no MS-Power BI® envolveu a consolidação das informações originais do conjunto de dados e os resultados preditivos obtidos pelos modelos de Machine Learning. O dataset original, contendo as variáveis independentes e a variável dependente “left”, foi carregado via arquivo CSV. Em seguida, os dados gerados pelo modelo preditivo, incluindo as probabilidades de desligamento dos colaboradores ativos, também foram importados para o ambiente do Power BI.
A integração do modelo Random Forest ao Power BI foi realizada por meio de um script Python incorporado ao Power Query, conforme ilustrado na Figura 10. Esse pipeline permitiu a atribuição de uma métrica contínua de risco de turnover para cada registro, gerando as probabilidades individuais de saída. Essa abordagem híbrida integra recursos de ciência de dados diretamente ao fluxo de transformação de dados do Power BI, promovendo maior automação e reprodutibilidade do processo analítico.
Figura 10. Aplicação do “pipeline” do modelo “Random Forest” no Power Query.
Fonte: Resultados originais da pesquisa
A aplicação do modelo foi estruturada para que as estimativas de probabilidade de desligamento fossem geradas exclusivamente para os funcionários ativos. Após a obtenção das probabilidades individuais de saída, os registros correspondentes aos colaboradores ativos foram integrados aos dados dos funcionários desligados, resultando em uma base de dados consolidada que reúne todos os colaboradores da organização. Nessa base final, as probabilidades de turnover permaneceram associadas apenas aos funcionários ativos, assegurando a coerência metodológica e a consistência das informações integradas ao ambiente de visualização.
Etapa (v) – Construção e análise do “dashboard” final
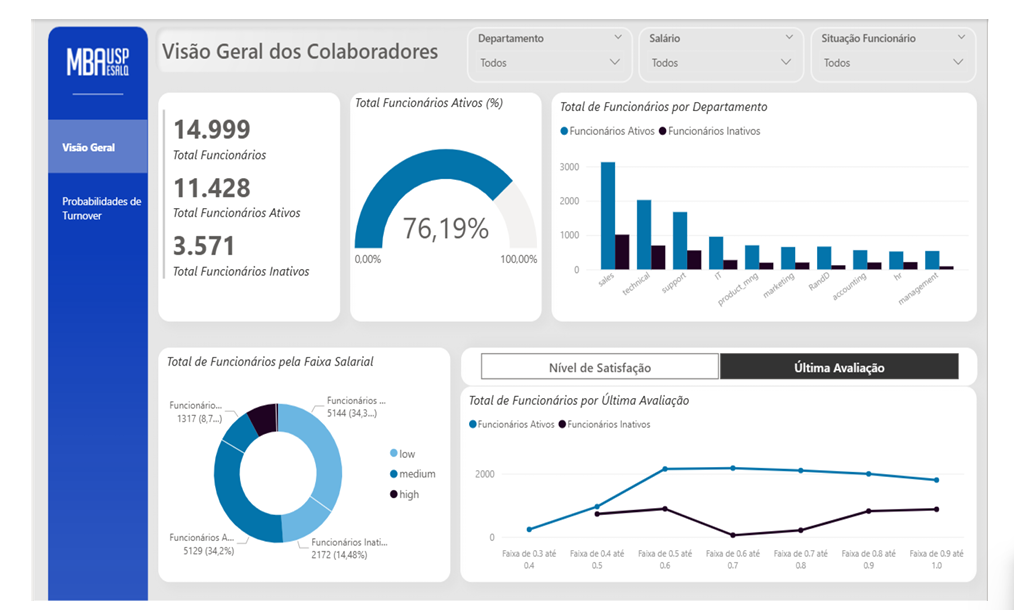
O painel analítico final foi desenvolvido com uma estrutura de duas páginas principais: Visão Geral e Probabilidades de Turnover, acessíveis por um menu vertical. Essa organização teve como objetivo apresentar, de forma integrada, uma visão consolidada do quadro funcional e os resultados preditivos associados à probabilidade de desligamento dos colaboradores. A página Visão Geral dos Colaboradores, acessada pela primeira opção do menu, oferece uma visualização completa das informações descritivas, conforme ilustrado na Figura 11.
Figura 11. Primeira página do painel
Fonte: Resultados originais da pesquisa
Na linha superior do cabeçalho da página Visão Geral, foram disponibilizados segmentadores de dados para Departamento, Faixa Salarial e Situação do Funcionário, permitindo a filtragem dinâmica das informações. Todos os elementos visuais da página foram configurados para responder de forma integrada a esses segmentadores, possibilitando a obtenção de insights decorrentes da segmentação dos dados e uma visualização mais específica. No quadrante superior esquerdo, cartões de linha múltipla apresentaram os totais de funcionários, ativos e inativos, acompanhados de um indicador de percentual de colaboradores ativos.
A Figura 11 revela que, do total de 14.999 colaboradores, 11.428 estavam ativos (76,19%) e 3.571 inativos (23,81%) no momento da análise. Esse índice de desligamento acumulado é significativo, reforçando a relevância de iniciativas analíticas para antecipar o desligamento voluntário. No quadrante superior direito, um gráfico de colunas agrupadas e linhas apresentou a distribuição do total de funcionários por departamento, com distinção entre colaboradores ativos e inativos. Os departamentos de “sales” e “technical” concentraram os maiores volumes absolutos de colaboradores, tanto ativos quanto inativos.
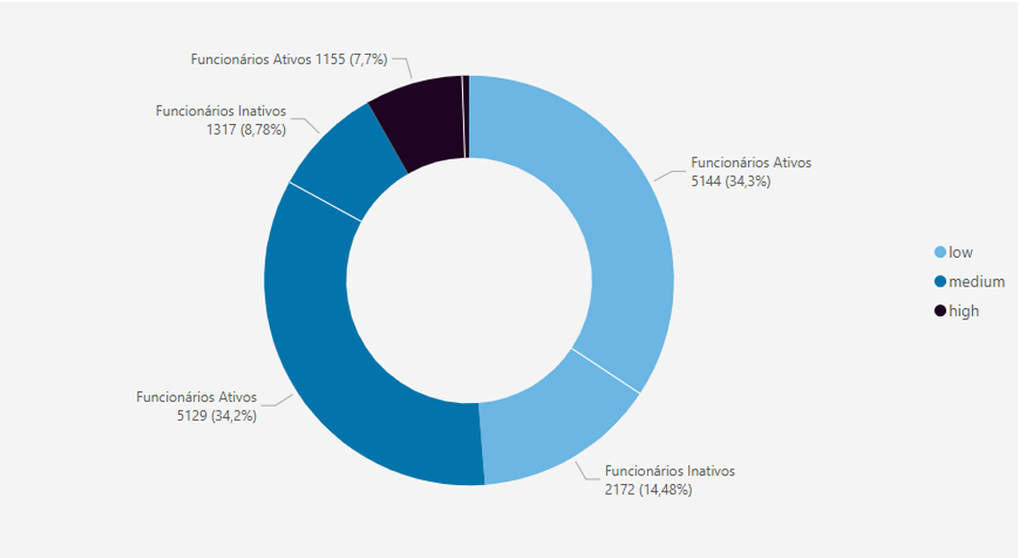
Essa concentração de desligamentos em departamentos específicos, como “sales” e “technical”, sugere a necessidade de atenção prioritária no desenvolvimento de políticas de retenção nessas áreas. Observou-se que o percentual de funcionários inativos em relação aos ativos tendeu a se manter relativamente homogêneo entre os diferentes setores, indicando que o turnover é um fenômeno generalizado, mas com maior volume em certas áreas. A Figura 12 apresenta a distribuição dos colaboradores por faixa salarial, segmentada em “low”, “medium” e “high”.
Figura 12. Gráfico Total de Funcionários por Faixa Salarial
Fonte: Resultados originais da pesquisa
O gráfico de rosca na Figura 12 demonstra que os níveis salariais influenciam a proporção de colaboradores inativos em relação aos ativos. A maior concentração de desligamentos ocorreu nas faixas salariais mais baixas, com 34,3% dos inativos na faixa “low” e 34,2% na faixa “medium”, enquanto a faixa “high” representou 8,7%. Esse padrão é consistente com a literatura, que aponta a remuneração como um dos principais determinantes da intenção de desligamento (Al-Suraihi et al., 2021), indicando que a oferta de uma remuneração adequada pode ser um instrumento de retenção.
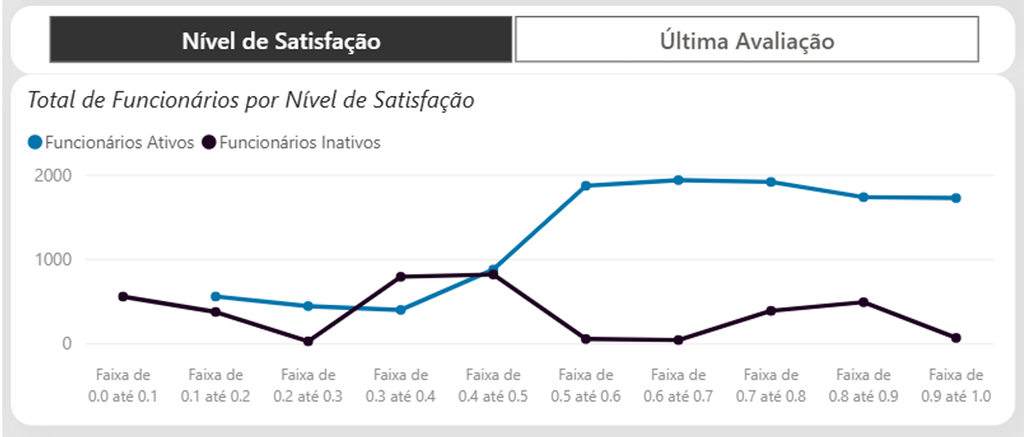
No quadrante inferior direito da Figura 11, um gráfico de linhas múltiplas representou o total de funcionários por nível de satisfação e última avaliação, distinguindo ativos e inativos. A Figura 13 detalha o gráfico de linhas para o nível de satisfação, mostrando que colaboradores com níveis de satisfação mais baixos (entre 0,3 e 0,5) apresentaram maior proporção de desligamentos. Esse achado sugere uma relação inversa entre o nível de satisfação e a probabilidade de saída, indicando que a insatisfação é um fator de risco significativo para o turnover.
Figura 13. Gráfico Total de Funcionários por Nível de Satisfação
Fonte: Resultados originais da pesquisa
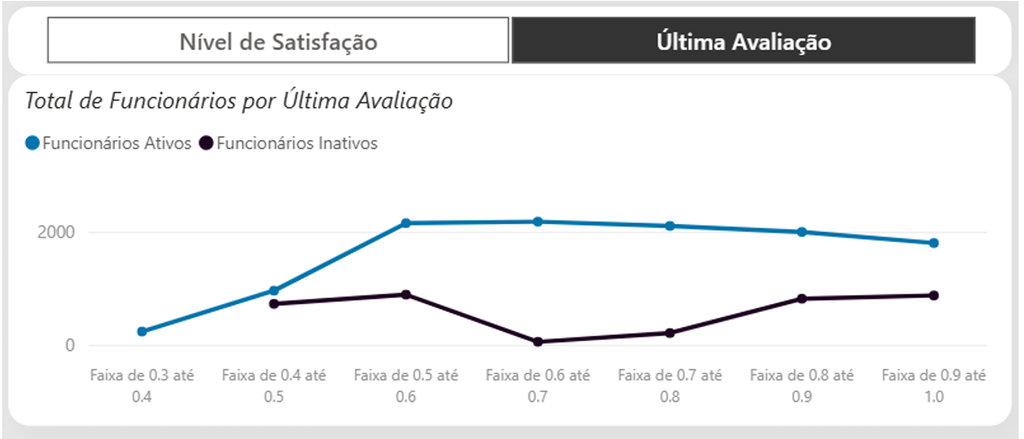
A Figura 14, que detalha o gráfico de linhas para a última avaliação, exibe um padrão semelhante ao nível de satisfação. Colaboradores com avaliações de desempenho mais baixas também mostraram maior propensão ao desligamento. Essa correlação entre desempenho e turnover é um indicador importante para a gestão de talentos, sugerindo que intervenções focadas na melhoria do desempenho e no reconhecimento podem contribuir para a retenção. A análise combinada desses fatores permite uma visão mais holística dos motivadores de desligamento.
Figura 14. Gráfico Total de Funcionários por Última Avaliação
Fonte: Resultados originais da pesquisa
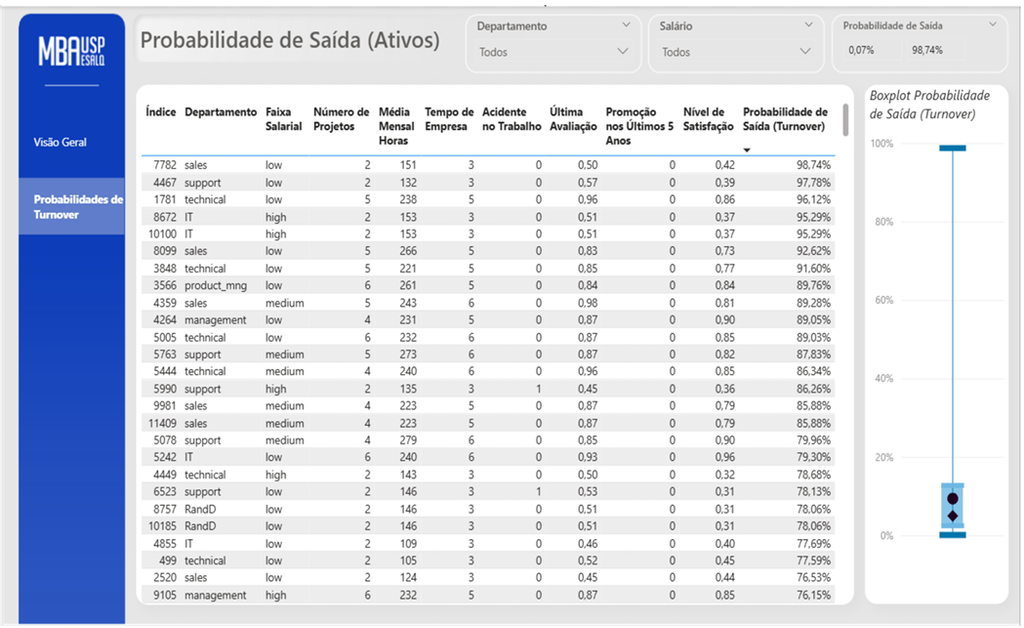
A segunda página do dashboard, “Probabilidades de Turnover”, é acessada pela segunda opção do menu vertical e sua visualização completa encontra-se ilustrada na Figura 15. Essa página foi configurada com um filtro aplicado exclusivamente para mostrar somente os funcionários ativos, apresentando apenas os registros para os quais foram estimadas as probabilidades individuais de desligamento. Na linha superior do cabeçalho, foram disponibilizados segmentadores de dados referentes a Departamento, Faixa Salarial e Probabilidade de Saída, configurados para filtragem dinâmica dos elementos visuais.
Figura 15. Segunda página do painel
Fonte: Resultados originais da pesquisa
À esquerda da página, uma tabela foi disposta contendo os registros dos seguintes campos: Índice, Departamento, Faixa Salarial, Número de Projetos, Média Mensal de Horas, Tempo de Empresa, Acidente no Trabalho, Última Avaliação, Promoção nos Últimos 5 Anos, Nível de Satisfação e Probabilidade de Saída. Essa tabela permite identificar colaboradores ou áreas com maior risco de saída de forma individualizada. À direita, foi configurado um boxplot das Probabilidades de Saída, um recurso não nativo do MS-Power BI® construído por meio da combinação de um gráfico de colunas empilhadas e linha.
O boxplot foi implementado utilizando o Percentil 25 como base e o Intervalo Interquartil como altura para o corpo, enquanto o Máximo, percentil 75, média, mediana, percentil 25 e mínimo foram empregados como marcadores visuais no eixo Y das linhas. Os whiskers foram definidos pelas medidas de Máximo e Mínimo. Essa abordagem permite uma análise robusta da dispersão e assimetria dos dados, superando a limitação de métricas isoladas e garantindo maior portabilidade e compatibilidade do painel em diferentes ambientes corporativos.
A observação indica que as probabilidades de saída dos colaboradores ativos apresentam distribuição assimétrica, com mediana e média situadas em valores relativamente baixos (média de 9,35% e mediana de 4,94%). No entanto, os valores de máximo alcançam 98,74%, e os de percentil 75 situam-se em patamar ligeiramente superior à mediana. Essa assimetria sugere que a maior parte dos colaboradores ativos possui probabilidade de desligamento reduzida, porém uma parcela expressiva apresenta risco elevado, o que justifica a abordagem preditiva individual adotada neste trabalho.
Em síntese, a solução desenvolvida permitiu consolidar informações do quadro funcional, identificando padrões relevantes como a maior concentração de desligamentos em faixas salariais mais baixas e a associação com níveis reduzidos de satisfação e desempenho. A integração de aprendizado de máquina e visualização de dados oferece um instrumento estratégico valioso para antecipar riscos e orientar políticas de retenção de talentos, fortalecendo a tomada de decisão na gestão de pessoas e respondendo diretamente ao objetivo do estudo.
4. Conclusão
O presente estudo buscou desenvolver um painel interativo de visualização de dados, integrando técnicas de aprendizado de máquina, para monitorar e analisar indicadores de turnover corporativo, identificar padrões e validar predições de desligamento, apoiando a gestão de talentos. Verificou-se que a solução proposta permitiu consolidar informações do quadro funcional, revelando padrões relevantes como a maior concentração de desligamentos em faixas salariais mais baixas e a associação com níveis reduzidos de satisfação e desempenho. O modelo Random Forest foi selecionado por seu desempenho superior na predição, gerando probabilidades individuais de desligamento de forma consistente para os colaboradores ativos. Essa integração de aprendizado de máquina e visualização de dados oferece um instrumento estratégico valioso para antecipar riscos e orientar políticas de retenção de talentos, fortalecendo a tomada de decisão na gestão de pessoas.
Contudo, a abordagem apresentou limitações, como o uso de um conjunto de dados público e simulado, a restrição a variáveis previamente disponíveis e a impossibilidade de incorporar fatores subjetivos, o que exige cautela na generalização dos resultados para ambientes organizacionais reais. Para estudos futuros, sugere-se a validação da metodologia com bases de dados reais de diferentes contextos, a incorporação de variáveis comportamentais e indicadores de engajamento, e a aplicação de técnicas de explicabilidade de modelos, visando enriquecer as análises e fortalecer a tomada de decisão estratégica em gestão de pessoas.
Referências Bibliográficas
Adeusi, K. B.; Amajuoyi, P.; Benjami, L. B. 2024. Utilizing machine learning to predict employee turnover in high stress sectors. International Journal of Management & Entrepreneurship Research 6 (5): 1702-1732. Disponível em: < https://doi.org/10.51594/ijmer.v6i5.1143 >. Acesso em: 29 out. 2025.
Al-Suraihi, W.A.; Samikon, S.A.; Al-Suraihi, A.H.A.; Ibrahim, I. 2021. Employee turnover: causes, importance and retention strategies. European Journal of Business and Management Research 6(3): 1-10.
Armstrong, M.; Taylor, S. 2014. Armstrong’s handbook of human resource management practice. 13ed. Kogan Page, London, United Kingdom.
Lazzari, M.; Alvarez, J. M.; Ruggieri, S. 2022. Predicting and explaining employee turnover intention. International Journal of Data Science and Analytics 14: 279-292. Disponível em: < https://doi.org/10.1007/s41060-022-00329-w >. Acesso em: 29 out. 2025.
Raschka, S.; Patterson, J.; Nolet, C. 2020. Machine learning in Python: main developments and technology trends in data science, machine learning, and artificial intelligence. Information 11 (4): 193. Disponível em: < https://doi.org/10.3390/info11040193 >. Acesso em: 01 nov. 2025.
Ren, P.; Wang, Y.; Zhao, F. 2023. Re-understanding of data storytelling tools from a narrative perspective. Visual Intelligence 1: 11. Disponível em: < https://doi.org/10.1007/s44267-023-00011-0 >. Acesso em: 01 nov. 2025.
Saito, T.; Rehmsmeier, M. 2015. The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets. PLoS ONE 10 (3): e0118432. Disponível em: < https://doi.org/10.1371/journal.pone.0118432 >. Acesso em: 29 out. 2025.
Starbuck, C. 2023. The fundamentals of people analytics with applications in R. Springer Nature Switze, St. Louis, MO, USA. Disponível em: < https://doi.org/10.1007/978-3-031-28674-2 >. Acesso em: 29 out. 2025.
Toasa, R.; Maximiano, M.; Reis, C.; Guevara, D. 2018. Data Visualization Techniques for real time information – A Custom and Dynamic Dashboard for Analyzing Surveys’ Results. In: IBERIAN CONFERENCE ON INFORMATION SYSTEMS AND TECHNOLOGIES (CISTI), 13., 2018, Porto, Portugal.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

