
16 de setembro de 2026
Aplicação de Aprendizado de Máquina na Análise e Classificação de Dados Paleomagnéticos do Cráton São Francisco
Oscar Andres Lazcano Patroni; João Vitor Matos Gonçalves
DOI: 10.22167/2675-6528-202602300
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
Dados paleomagnéticos são cruciais para reconstruções paleogeográficas, contudo, a dispersão direcional e as remagnetizações dificultam a obtenção de médias confiáveis. Avaliou-se o potencial de técnicas de aprendizado de máquina não supervisionado na análise e interpretação de dados paleomagnéticos do Cráton São Francisco, com foco nas formações Tonalito Itarerú e Sienito Itiúba, visando aprimorar a determinação de direções médias. Compararam-se os algoritmos DBSCAN, K-means e Gaussian Mixture Model (GMM), utilizando o método do cotovelo, AIC e BIC para seleção de parâmetros. O DBSCAN destacou-se na detecção de regiões densas e outliers, embora sensível aos hiperparâmetros. O K-means forneceu uma segmentação inicial, mas sem definição clara do número ótimo de grupos. O GMM demonstrou maior flexibilidade e atribuição probabilística, com diferenças pouco expressivas entre modelos. Os métodos produziram resultados complementares, revelando padrões direcionais plausíveis. Concluiu-se que a integração entre aprendizado de máquina, estatística clássica e interpretação geológica é uma abordagem promissora para análise exploratória paleomagnética, sendo recomendável ampliar as bases de dados e adotar abordagens de estatística direcional.
Palavras-chave: Análise Exploratória de Dados; Aprendizado de Máquina; Clusterização; DBSCAN; K-means.
1. Introdução
Dados paleomagnéticos constituem a principal fonte de informação para reconstruções paleogeográficas. Isso ocorre porque o paleomagnetismo é a única ferramenta geofísica capaz de ancorar a posição das placas tectônicas em relação ao eixo de rotação da Terra ao longo do tempo geológico (Butler, 1992; Tauxe, 2010; Torsvik et al., 2008). Reconstruções paleogeográficas precisas são essenciais não apenas para compreender processos geodinâmicos, mas também para estudos sobre a dinâmica climática do passado (Donnadieu et al., 2006), a distribuição paleobiogeográfica de fósseis (Middlemiss, 1979) e a posição absoluta de massas continentais e oceânicas, fundamentais para restringir modelos numéricos paleoclimáticos (Herold et al., 2008; Hollis et al., 2019).
As direções paleomagnéticas formam a base dos estudos paleomagnéticos, e as abordagens estatísticas para sua análise têm evoluído significativamente nas últimas duas décadas, com avanços que abrangem desde a análise de direções individuais até o estudo de agrupamentos direcionais (Heslop e Roberts, 2016; Tauxe et al., 2004; Vaes et al., 2021; Heslop et al., 2023). Contudo, a utilidade desses dados depende da capacidade de determinar com precisão a idade da remanência magnética. Embora testes de campo clássicos, como os de contato cozido, de conglomerado e de dobra, possam identificar remagnetizações, os mecanismos responsáveis nem sempre são bem compreendidos. Essa incerteza dificulta a determinação da idade, tornando os dados em bancos de dados paleomagnéticos globais (GPMDB; Pisarevsky et al., 2022) praticamente inutilizáveis para reconstruções paleogeográficas sem a correta identificação de suas origens e idades.
A determinação de direções por meio dos métodos de desmagnetização alternada (AF) e térmica (TD) tem se mostrado eficaz na separação das componentes de magnetização da magnetização remanente natural (MRN) e na obtenção de direções consistentes. No entanto, em alguns casos, as direções médias calculadas para sítios específicos das formações Tonalito Itarerú e Sienito Itiúba, ambas localizadas na região nordeste do Cráton São Francisco, no estado da Bahia, não apresentam a mesma coerência. A determinação dessas direções médias pode ser particularmente desafiadora, mesmo com a consolidação dos métodos paleomagnéticos.
Uma alternativa ainda pouco explorada para superar essas limitações é o uso de ferramentas de aprendizagem estatística, capazes de identificar padrões complexos e não lineares em grandes conjuntos de dados. O aprendizado de máquina (machine learning) é um subcampo da inteligência artificial que emprega métodos matemáticos e estatísticos para que sistemas computacionais aprendam padrões a partir de dados, melhorando o desempenho em tarefas específicas sem programação explícita (Bishop, 2006; Hastie et al., 2009; Murphy, 2012). Em geociências, o aprendizado de máquina tem sido aplicado para tratar e interpretar grandes volumes de dados, incluindo dados geofísicos, geoquímicos e paleomagnéticos (Gwirtz et al., 2022; Dallanave, 2024; Gallo et al., 2025). Especificamente, a aprendizagem não supervisionada busca identificar estruturas internas, padrões ou agrupamentos naturais em dados sem rótulos, sendo útil para análises exploratórias e clusterização de dados paleomagnéticos. Apesar do potencial promissor, os desafios na aquisição de dados em paleomagnetismo dificultam a geração de bases de dados extensas e de alta qualidade, mantendo o potencial do aprendizado de máquina amplamente inexplorado neste campo.
Diante desse cenário, a integração de abordagens inovadoras, como o aprendizado de máquina, com a estatística clássica e a interpretação geológica, surge como uma estratégia promissora para aprimorar a análise exploratória paleomagnética e a confiabilidade dos dados utilizados em reconstruções paleogeográficas. O presente trabalho tem como objetivo investigar o uso de técnicas de aprendizado de máquina mediante o uso de métodos não supervisionados na análise e interpretação de dados paleomagnéticos, com foco na melhoria da determinação de direções médias em formações geológicas do Cráton São Francisco, especificamente nas unidades Tonalito Itarerú e Sienito Itiúba, localizadas no estado da Bahia.
2. Material e Métodos
Paleomagnetismo
Foram extraídos 253 testemunhos cilíndricos orientados de 26 locais do plúton de Itareru, utilizando uma perfuratriz portátil a gasolina equipada com brocas diamantadas de 25,4 mm de diâmetro. Desses locais, 14 sítios correspondem a fácies granodioríticas, 8 a fácies tonalíticas e 4 a unidades do embasamento. Pelo menos oito testemunhos orientados foram coletados por local, com orientação realizada por um dispositivo Pomeroy (ASC Scientific, EUA), acoplado a bússolas Brunton e solar. De modo análogo, foram coletados 348 espécimes de 45 sítios do Sienito Itiúba, provenientes de três conjuntos litológicos distintos: (i) sienitos predominantemente leucocráticos e hipersolvus, contendo diopsídio, hornblenda e biotita; (ii) camadas de apatita-diopsídio; e (iii) diques de granito alcalino.
Os testemunhos foram cortados em espécimes de 22,0 × 25,4 mm, obtendo-se pelo menos dois ou três espécimes por testemunho. Para o Tonalito Itareru, 770 espécimes foram obtidos, dos quais 253 foram selecionados para análises paleomagnéticas. Para o Sienito Itiúba, 1460 espécimes foram obtidos, com 222 utilizados para análise.
Os espécimes foram submetidos a tratamentos térmicos e desmagnetização por campo magnético alternado (AF) em etapas sucessivas para isolar a magnetização remanente característica. A desmagnetização por campo alternado foi conduzida com pulsos de 2,0 mT, 2,5 mT, 5 mT ou 10 mT, até cerca de 100 mT, utilizando um desmagnetizador AF Molspin ou um desmagnetizador AF AD-D2000T (ASC Scientific, EUA). A desmagnetização térmica foi realizada em um forno de câmara dupla ASC TD-60, com incrementos de 100 °C (entre 100 °C e 500 °C) e de 25 °C (acima de 500 °C). As medidas de magnetização remanente foram obtidas com um magnetômetro rotacional Agico JR-6A (AGICO, República Tcheca). Todos os procedimentos laboratoriais foram conduzidos no Laboratório de Anisotropias de Susceptibilidade Magnética e Magnetismo de Rochas da Universidade de São Paulo (LAMS-IGc-USP).
A direção de magnetização de cada espécime foi determinada pelo método de análise de componentes principais (Kirschvink, 1980), utilizando ajustes por mínimos quadrados para retas e planos, e fornecendo o desvio angular máximo (MAD) como medida de incerteza. As direções de magnetização em cada etapa de desmagnetização foram analisadas por meio de projeções ortogonais em diagramas de Zijderveld (1967) utilizando o software Agico Remasoft 3.0 (Chadima e Hrouda, 2007).
Após a determinação das direções individuais, calculou-se a média vetorial para obter a direção média de magnetização do sítio, correspondente à Magnetização Remanente Característica (ChRM). As direções de magnetização foram tratadas estatisticamente com base na estatística de Fisher (1953), que descreve a distribuição angular das direções em torno da média. O parâmetro de precisão (k) foi estimado pela equação (1):
k = (N-1) / (N-R)
onde N é o número de direções e R é o módulo do vetor resultante da soma vetorial dessas direções. O limite de confiança a95 foi aproximado pela equação (2):
a95 = 140 / sqrt(kN)
Polo Geomagnético Virtual
O Polo Geomagnético Virtual (PGV) foi calculado com base nas coordenadas geográficas do sítio amostrado e na direção média de magnetização remanente característica (ChRM). A análise estatística dos PGVs foi realizada com base na estatística de Fisher (1953), permitindo a determinação de polos médios e de seus respectivos parâmetros de precisão e limites de confiança (A95).
Aprendizado de Máquina
Em aplicações nas geociências, o aprendizado de máquina tem sido utilizado para o tratamento e interpretação de grandes volumes de dados, incluindo dados paleomagnéticos. Neste projeto, buscou-se desenvolver um modelo estatístico para classificar e agrupar os conjuntos de dados paleomagnéticos disponíveis para o Sienito Itiúba e Tonalito Itarerú. Para essa finalidade, foi adotado o algoritmo de clusterização DBSCAN (Ester et al., 1996) como principal método de análise. Complementarmente, o desempenho do DBSCAN foi comparado com outros algoritmos de aprendizado não supervisionado, incluindo k-means e Gaussian Mixture Model (GMM).
Agrupamento Espacial Baseado em Densidade de Aplicações com Ruído – DBSCAN
O DBSCAN é um algoritmo de aprendizado não supervisionado fundamentado na densidade local das observações, capaz de identificar agrupamentos em conjuntos de dados com número de grupos desconhecido e presença de outliers. Seu funcionamento depende de dois hiperparâmetros: o raio de vizinhança ɛ (épsilon) e o número mínimo de observações vizinhas (min_samples). A vizinhança ɛ de um ponto xᵢ é definida como o conjunto de observações xⱼ cuja distância d(xᵢ, xⱼ) é menor ou igual a ɛ, conforme a equação (3):
Nɛ(xᵢ) = {xⱼ ∈ X | d(xᵢ, xⱼ) ≤ ɛ}
Com base nesses critérios, o algoritmo distingue pontos centrais (possuem pelo menos min_samples vizinhos dentro do raio ɛ), pontos de borda (não satisfazem o critério de densidade, mas pertencem à vizinhança de um ponto central) e pontos de ruído (não pertencem a nenhuma região densa). A escolha do parâmetro ɛ é crítica e foi estimada a partir do ponto de inflexão da curva do gráfico de distâncias ao (k)-ésimo vizinho (k-distance plot), procedimento conhecido como método do cotovelo (elbow method), onde ɛ ≈ arg max (d²y / dx²). O parâmetro min_samples foi escolhido em função da dimensionalidade dos dados, com valores entre 4 e 6 frequentemente adotados como referência inicial.
3. Resultados e Discussão
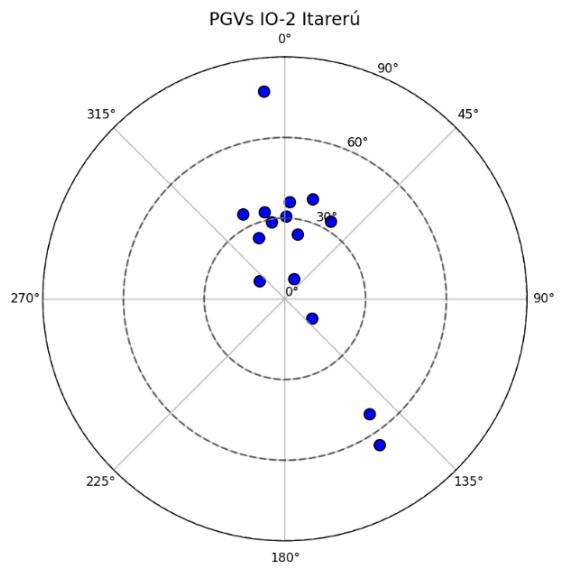
A aplicação dos algoritmos de clusterização aos dados paleomagnéticos do sítio IO-2 do Tonalito Itareru permitiu identificar padrões de agrupamento com diferentes níveis de consistência e sensibilidade aos parâmetros adotados. As direções dos Polos Geomagnéticos Virtuais do sítio IO-2, Itarerú, são apresentadas na Figura 1.
Figura 1. Direções dos Polos Geomagnéticos Virtuais do sítio IO2, Itarerú.
Fonte: Resultados originais da pesquisa.
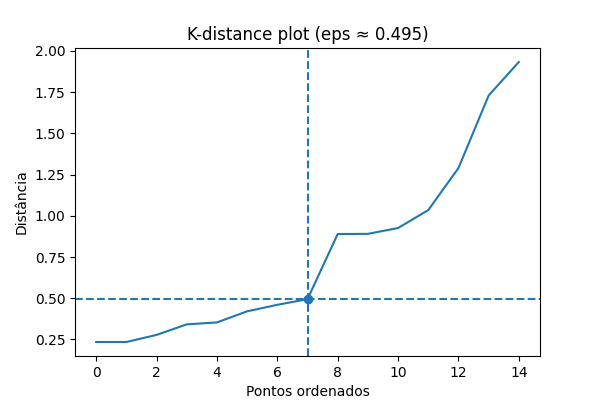
A utilização do DBSCAN, com o parâmetro ɛ estimado a partir do gráfico de k-distância (Figura 2), resultou na identificação de agrupamentos associados a regiões de maior densidade no espaço de atributos. Este método mostrou-se eficaz na separação de pontos potencialmente discrepantes, classificados como ruído, o que é particularmente relevante em dados paleomagnéticos sujeitos a remagnetizações ou incertezas experimentais. Contudo, a quantidade de pontos classificados como ruído revelou sensibilidade à escolha de ɛ e min_samples, refletindo a limitação imposta pelo reduzido número de observações disponíveis.
Figura 2. Distribuição das distâncias ao k-ésimo vizinho em função dos pontos ordenados (k-distance plot), utilizada para a determinação do parâmetro ɛ no algoritmo DBSCAN. O ponto de inflexão da curva (método do cotovelo), estimado por análise de curvatura, indica a transição entre regiões densas e dispersas do conjunto de dados.
Fonte: Resultados originais da pesquisa.
Para o K-means, a aplicação do método do cotovelo (Figura 3) indicou valores plausíveis para o número de clusters, embora a curva de inércia não tenha apresentado um ponto de inflexão fortemente definido. Isso sugere que a estrutura de agrupamento dos dados não é claramente particionada em conjuntos bem separados sob a métrica euclidiana adotada. Apesar disso, o K-means forneceu uma segmentação inicial dos dados, útil como referência comparativa, mas limitada pela suposição de clusters aproximadamente esféricos e pela ausência de tratamento explícito de outliers.
Figura 3. Variação da inércia intra-cluster em função do número de clusters (k) para o algoritmo K-means. O ponto de inflexão da curva (método do cotovelo) indica a estimativa do número ótimo de agrupamentos.
Fonte: Resultados originais da pesquisa.
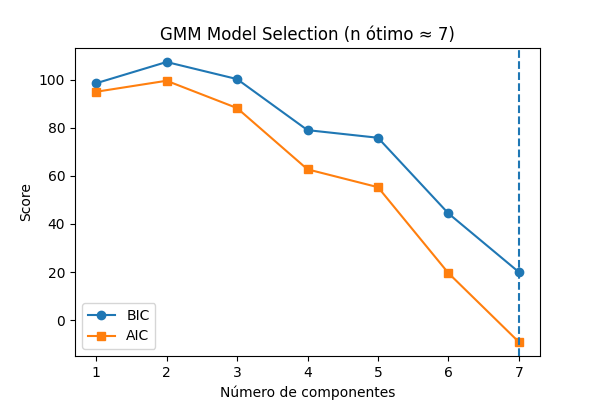
No caso do Gaussian Mixture Model (GMM), a análise baseada nos critérios AIC e BIC indicou soluções com diferentes números de componentes (Figura 4), sendo o BIC mais conservador na escolha do modelo. Os resultados evidenciaram a capacidade do GMM de ajustar distribuições com maior flexibilidade geométrica, permitindo a identificação de agrupamentos com variâncias e orientações distintas. A atribuição probabilística de pertencimento aos clusters forneceu uma medida adicional de incerteza associada a cada observação. Contudo, devido ao tamanho reduzido do conjunto de dados, as diferenças entre os valores de AIC e BIC para diferentes modelos foram relativamente pequenas, o que limitou a robustez da seleção do número ótimo de componentes.
Figura 4. Comparação dos critérios de informação de Akaike (AIC) e Bayesiano (BIC) em função do número de componentes do modelo de misturas gaussianas (GMM). O mínimo das curvas indica o modelo mais adequado considerando o compromisso entre ajuste e complexidade.
Fonte: Resultados originais da pesquisa.
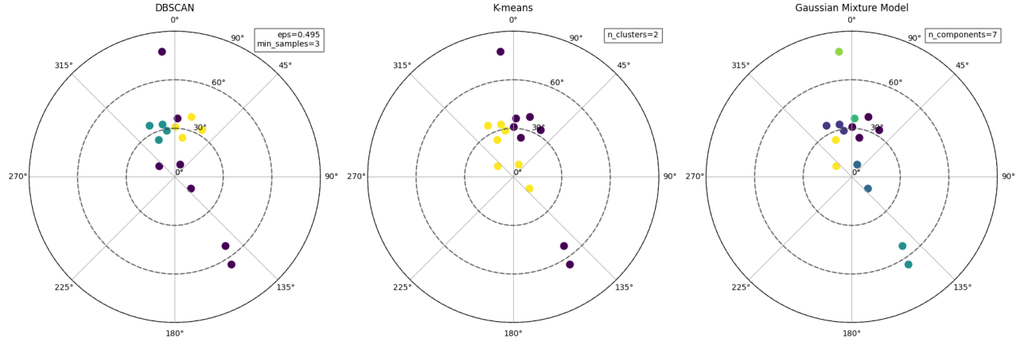
O comparativo dos resultados para os algoritmos DBSCAN, K-means e GMM, e os respectivos clusters formados, é apresentado na Figura 5. De modo geral, os três métodos apresentaram resultados complementares. O DBSCAN destacou-se na identificação de regiões densas e na detecção de possíveis outliers; o K-means forneceu uma segmentação simples e de fácil interpretação; e o GMM apresentou maior capacidade de adaptação à estrutura dos dados. Entretanto, nenhum dos métodos, isoladamente, foi capaz de fornecer uma solução inequívoca, refletindo tanto a complexidade dos dados paleomagnéticos quanto as limitações estatísticas associadas ao tamanho da amostra.
Figura 5. Comparativo dos resultados para os algoritmos DBSCAN, K-means e GMM e respectivamente os clusters formados.
Fonte: Resultados originais da pesquisa.
A análise visual dos estereogramas mostrou-se essencial para a validação dos resultados, permitindo verificar a coerência geométrica dos agrupamentos identificados. Em diversos casos, observou-se que os clusters definidos pelos algoritmos correspondiam a concentrações direcionais plausíveis, embora com sobreposição parcial, o que pode indicar a presença de múltiplos eventos de magnetização ou dispersão natural dos dados.
Os resultados obtidos demonstram que a aplicação de técnicas de machine learning não supervisionado em dados paleomagnéticos constitui uma abordagem promissora para a identificação de padrões direcionais e para o suporte à determinação de direções médias. A utilização combinada de DBSCAN, K-means e Gaussian Mixture Model, aliada a critérios quantitativos como o método do cotovelo e os critérios AIC/BIC, permitiu explorar diferentes aspectos da estrutura dos dados, evidenciando a complementaridade dessas abordagens.
Contudo, a análise também evidenciou limitações importantes. O tamanho reduzido do conjunto de dados (n ≈ 15) comprometeu a estabilidade das estimativas de parâmetros e dificultou a identificação robusta do número de clusters ou componentes. Adicionalmente, a dependência dos resultados em relação à escolha dos hiperparâmetros, particularmente no caso do DBSCAN, reforça a necessidade de abordagens cuidadosas e da utilização de múltiplos critérios de validação.
Outro aspecto relevante é a natureza direcional dos dados paleomagnéticos. A utilização de métricas euclidianas em um espaço transformado constitui uma aproximação que pode introduzir distorções na avaliação de similaridade entre direções. Nesse sentido, métodos baseados em estatística direcional, como aqueles fundamentados na distribuição de Fisher ou em misturas de distribuições esféricas, apresentam maior consistência física e devem ser considerados em desenvolvimentos futuros.
Dessa forma, os métodos de clusterização analisados são ferramentas úteis para análise exploratória e podem contribuir para a identificação de populações paleomagnéticas distintas, especialmente quando utilizados de forma integrada. Contudo, sua aplicação deve ser acompanhada de validação visual (por meio de estereogramas), análise estatística clássica e interpretação geológica, de modo a garantir a confiabilidade dos resultados. A integração entre machine learning e estatística paleomagnética tradicional representa um caminho promissor para o avanço das interpretações paleogeográficas e para o aprimoramento da análise de dados paleomagnéticos.
4. Conclusão
O presente estudo investigou o potencial de técnicas de aprendizado de máquina não supervisionado na análise e interpretação de dados paleomagnéticos do Cráton São Francisco, com foco nas formações Tonalito Itarerú e Sienito Itiúba, buscando aprimorar a determinação de direções médias. Verificou-se que os algoritmos DBSCAN, K-means e Gaussian Mixture Model (GMM) produziram resultados complementares. O DBSCAN destacou-se na identificação de regiões densas e na detecção de possíveis outliers, embora sua sensibilidade aos hiperparâmetros tenha sido notada. O K-means forneceu uma segmentação inicial dos dados, enquanto o GMM demonstrou maior flexibilidade e capacidade de atribuição probabilística aos agrupamentos. A análise visual dos estereogramas confirmou a coerência geométrica dos agrupamentos identificados, revelando padrões direcionais plausíveis. Concluiu-se que a integração entre aprendizado de máquina, estatística clássica e interpretação geológica representa uma abordagem promissora para a análise exploratória paleomagnética, contribuindo para a confiabilidade dos dados utilizados em reconstruções paleogeográficas.
Entretanto, a pesquisa enfrentou limitações importantes, como o tamanho reduzido do conjunto de dados, que comprometeu a estabilidade das estimativas de parâmetros e dificultou a identificação robusta do número de clusters. A dependência dos resultados em relação à escolha dos hiperparâmetros, especialmente no DBSCAN, reforça a necessidade de abordagens cuidadosas e de múltiplos critérios de validação. Adicionalmente, a utilização de métricas euclidianas em um espaço transformado para dados direcionais pode introduzir distorções na avaliação de similaridade. Para estudos futuros, recomenda-se a ampliação do conjunto de dados, a incorporação de métricas de validação adicionais e o desenvolvimento de abordagens específicas baseadas em estatística direcional, como aquelas fundamentadas na distribuição de Fisher ou em misturas de distribuições esféricas, para maior consistência física. A integração contínua entre aprendizado de máquina e estatística paleomagnética tradicional é um caminho promissor para o avanço das interpretações paleogeográficas e o aprimoramento da análise de dados paleomagnéticos.
Referências Bibliográficas
Bishop, C. M., & Nasrabadi, N. M. (2006). Pattern recognition and machine learning (Vol. 4, No. 4, p. 738). New York: springer.
Butler, R. B., 1992. Paleomagnetism: Magnetic domains to geologic terranes. http://geography.lancs.ac.uk/cemp/resources/Butler_book/contents.htm
Chadima, M. & Hrouda, F. Remasoft 3.0 Paleomagnetic Data Browser and Analyzer. https://www.agico.com/text/software/remasoft/remasoft.php. (2007).
Dallanave, Edoardo. “Assessing the reliability of paleomagnetic datasets using the R package PmagDiR.” Scientific Reports 14.1 (2024): 1666.
Donnadieu, Y., Pierrehumbert, R., Jacob, R., & Fluteau, F. (2006). Modelling the primary control of paleogeography on Cretaceous climate. Earth and Planetary Science Letters, 248(1-2), 426-437.
Ester, M., Kriegel, H. P., Sander, J., & Xu, X. (1996, August). A density-based algorithm for discovering clusters in large spatial databases with noise. In kdd (Vol. 96, No. 34, pp. 226-231).
Fisher, R. A., 1953. Dispersion on a sphere. Proceedings of the Royal Society of London, 217, 295-305
Gallo, L. C., Domeier, M., Antonio, P. Y., Sapienza, F., Rapalini, A., Font, E., … & Warren, L. (2025). Unraveling remagnetization sources using statistical learning. Earth and Planetary Science Letters, 662, 119390.
Gwirtz, K., Davis, T., Morzfeld, M., Constable, C., Fournier, A., & Hulot, G. (2022). Can machine learning reveal precursors of reversals of the geomagnetic axial dipole field?. Geophysical Journal International, 231(1), 520-535.
Hastie, T., Tibshirani, R., & Friedman, J. (2009). An introduction to statistical learning.
Herold, N., Seton, M., Müller, R. D., You, Y., & Huber, M. (2008). Middle Miocene tectonic boundary conditions for use in climate models. Geochemistry, Geophysics, Geosystems, 9(10).
Heslop, D., & Roberts, A. P. (2016). Estimation and propagation of uncertainties associated with paleomagnetic directions. Journal of Geophysical Research: Solid Earth, 121(4), 2274-2289.
Heslop, D., Scealy, J. L., Wood, A. T. A., Tauxe, L. & Roberts, A. P. A Bootstrap common mean direction test. J. Geophys. Res. Solid Earth 128, 1–12 (2023)
Hollis, C. J., Dunkley Jones, T., Anagnostou, E., Bijl, P. K., Cramwinckel, M. J., Cui, Y., … & Lunt, D. J. (2019). The DeepMIP contribution to PMIP4: Methodologies for selection, compilation and analysis of latest Paleocene and early Eocene climate proxy data, incorporating version 0.1 of the DeepMIP database. Geoscientific Model Development, 12(7), 3149-3206.
Kirschvink, J. L., 1980. The least-squares line and plane and the analysis of palaeomagnetic data. Geophysical Journal of the Royal Astronomical Society, 62, 699-718
Middlemiss, F. A. (1979). Paleobiogeography. In Paleontology (pp. 515-523). Springer, Berlin, Heidelberg.
Murphy, K. P. (2012). Machine learning: a probabilistic perspective. MIT press.
Pisarevsky, S. A., Li, Z. X., Tetley, M. G., Liu, Y., & Beardmore, J. P. (2022). An updated internet-based global paleomagnetic database. Earth-Science Reviews, 235, 104258.
Tauxe, L., & Kent, D. V. (2004). A simplified statistical model for the geomagnetic field and the detection of shallow bias in paleomagnetic inclinations: was the ancient magnetic field dipolar?.
Torsvik, T. H., Müller, R. D., Van der Voo, R., Steinberger, B., & Gaina, C. (2008). Global plate motion frames: toward a unified model. Reviews of geophysics, 46(3).
Vaes, B., Li, S., Langereis, C. G., & van Hinsbergen, D. J. (2021). Reliability of palaeomagnetic poles from sedimentary rocks. Geophysical Journal International, 225(2), 1281-1303.
Zijderveld, J. D. A., 1967. Demagnetization of rocks: Analysis of results. In D. W. Collinson, K. M. Creer, e S. K. Runcorn (Eds.), Methods in Paleomagnetism (pp. 254-286).
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

