
16 de setembro de 2026
A Predominância da Rentabilidade e das Relações Não Lineares na Avaliação de Empresas na B3
Nicolas Edouard Srour; José Erasmo Silva
DOI: 10.22167/2675-6528-202602299
Artigo derivado de Trabalho de Conclusão de Curso (TCC), com conteúdo baseado no trabalho original do aluno e adaptado ao formato editorial da Revista E&S com apoio da ferramenta ResumeAI, solução de inteligência artificial desenvolvida pelo Instituto Pecege para síntese e organização textual.
Resumo
A avaliação de empresas por múltiplos de mercado desempenhou papel relevante na análise financeira, especialmente em mercados emergentes, onde a relação entre fundamentos contábeis e preços de mercado nem sempre se apresentou linear. Investigou-se a capacidade de modelos de aprendizado de máquina explicarem a relação Preço sobre Valor Patrimonial (P/VP) de empresas brasileiras listadas na B3, a partir de informações contábeis, macroeconômicas e setoriais, integrando a interpretabilidade via Explanações Aditivas de Shapley (SHAP). Para isso, construiu-se uma base em painel com 4.646 observações trimestrais de 251 empresas, no período de 2020 a 2025. Estimaram-se três modelos de ensemble baseados em árvores de decisão (Random Forest, LightGBM e XGBoost), utilizando indicadores de rentabilidade, liquidez, alavancagem, eficiência operacional, taxa Selic, setor de atividade e o logaritmo do ativo total. Os modelos foram avaliados por validação temporal com janelas expansíveis e teste fora da amostra. Os resultados indicaram que os modelos de boosting superaram o Random Forest, evidenciando que a relação entre fundamentos contábeis e valuation não foi adequadamente descrita por uma estrutura puramente linear. A análise de importância das variáveis revelou que o lucro por ação, o retorno sobre ativos e o retorno sobre o patrimônio líquido ocuparam posições centrais na explicação do P/VP. Contudo, o lucro por ação exibiu comportamento não linear e sinal distinto da interpretação financeira imediata. Concluiu-se que o aprendizado de máquina, aliado a técnicas de interpretabilidade, contribuiu significativamente para a análise de valuation, ao capturar relações complexas entre variáveis contábeis e a precificação de mercado.
Palavras-chave: Aprendizado de máquina; Indicadores financeiros; Interpretabilidade; Mercado acionário; Valuation.
1. Introdução
Todo ativo, seja financeiro ou real, possui um valor inerente. O desafio central para o sucesso em investimentos e gestão de capital não é apenas estimar esse valor, mas compreender e quantificar suas fontes (Damodaran, 2012). Embora os princípios básicos da avaliação corporativa sejam consistentes, a aplicação deve ser adaptada para levar em conta as incertezas e dinâmicas de mercados específicos. No Brasil, o mercado de ações se desenvolveu vigorosamente, tornando-se uma fonte de financiamento para empresas e uma via para a diversificação de portfólios para investidores (Tavares e Silva, 2012). Dado o papel significativo do mercado de capitais no desenvolvimento econômico nacional (Ghashami e Kamyar, 2021), o sucesso de um investidor depende de sua capacidade de tomar decisões de alocação de ativos para maximizar os retornos (Ambrozini et al., 2019).
A abordagem tradicional de avaliação de empresas é a Análise Fundamentalista, técnica que utiliza dados financeiros e contábeis para identificar oportunidades de investimento (Ambrozini et al., 2019). Métricas como Preço sobre Lucro e Retorno sobre o Patrimônio Líquido são amplamente aceitas como impulsionadores de valor (Fernandes et al., 2019). No entanto, em um cenário de rápidas mudanças e maior abertura de mercado, tais modelos convencionais podem não capturar a totalidade dos fatores exigidos pelos investidores contemporâneos (Lima et al., 2011). Esse cenário reflete um debate acadêmico sobre a noção de valor intrínseco. Acadêmicos clássicos criticaram a dependência do valor contábil, argumentando que os preços de mercado são determinados principalmente pelo poder aquisitivo e pelos dividendos e não por medidas contábeis de ativos (Graham et al., 1962). Outros autores ainda desaconselham assumir um relacionamento linear entre o valor patrimonial e o valor econômico do patrimônio, afirmando que os dados contábeis históricos fornecem poucos benefícios para fins de avaliação (Copeland e Weston, 1988; Brigham, 1982). Apesar dessas limitações teóricas, o índice Preço sobre Valor Patrimonial (P/VP) continua sendo uma métrica amplamente utilizada. Ele captura a diferença entre o valor contábil do patrimônio líquido e o preço de mercado, onde um índice acima de um indica que os investidores pagam um prêmio sobre o valor contábil, e abaixo de um sugere um desconto. Entender por que os investidores pagam mais ou menos do que o valor contábil é fundamental, pois fornece insights sobre quais indicadores fundamentais justificam a precificação de mercado, sendo o Retorno sobre o Patrimônio Líquido a variável mais importante que justifica o índice P/VP (Damodaran, 2012).
Observa-se que a relação entre o preço de mercado e os fundamentos não é trivial e exige análise de causa e efeito. A abordagem fundamentalista clássica frequentemente assume relações lineares e estáveis entre as variáveis. Essa premissa é constantemente desafiada pela complexidade do mercado acionário brasileiro, que se caracteriza por ser dinâmico, não linear e altamente sensível a fatores políticos e macroeconômicos. Tal cenário demanda modelos de investimento em constante atualização (Silva et al., 2023).
Essa necessidade impulsionou a adoção do Aprendizado de Máquina para a construção de portfólios robustos (Silva, 2020). Por serem capazes de capturar relações não lineares complexas, esses modelos apresentam um poder preditivo superior para as oscilações de preços, auxiliando na mitigação de riscos (Ji et al., 2022; Kolani, 2022). Entretanto, a maioria dos estudos focados em algoritmos sofisticados de Aprendizado de Máquina prioriza a precisão estatística em detrimento da explicabilidade, resultando em modelos de “caixa-preta” opacos (Ahmed, 2024). Essa falta de interpretabilidade pode limitar a capacidade dos analistas de validar os resultados, aumentando a incerteza e podendo levar a decisões equivocadas.
Diante dessa lacuna, o presente estudo busca integrar a capacidade preditiva do Aprendizado de Máquina à interpretabilidade, usando o índice P/VP como variável-alvo para investigar quais indicadores influenciam a precificação de mercado. Para isso, aplicam-se métodos de Inteligência Artificial Explicável (XAI), especificamente as Explanações Aditivas de Shapley (SHAP), a fim de quantificar e hierarquizar a contribuição de cada fator contábil e macroeconômico. Dessa forma, o trabalho conecta o debate teórico clássico sobre valor contábil às técnicas modernas de ciência de dados, fornecendo evidências empíricas e orientação prática para a análise de avaliação no contexto brasileiro. Assim, este estudo teve como objetivo avaliar se modelos de aprendizado de máquina podem ajudar a explicar a relação Preço sobre Valor Patrimonial de empresas brasileiras listadas em bolsa.
2. Material e Métodos
Classificação e delineamento da pesquisa
O estudo foi classificado como descritivo-explicativo (Gil, 2017), seguindo um caminho que começou com o mapeamento de dados e terminou com a interpretação causal. O aspecto descritivo envolveu o registro e a análise sistemáticos de indicadores financeiros de empresas listadas na B3, a partir de relatórios oficiais da Comissão de Valores Mobiliários (CVM). O cerne da investigação foi explicativo, concentrando-se na identificação das variáveis que impulsionam o fenômeno. Para isso, utilizou-se o SHAP para decompor as previsões de aprendizado de máquina, visando quantificar como fundamentos específicos, como o ROE, moldam a relação Preço/Valor Patrimonial no mercado brasileiro.
Fontes, coleta e preparação dos dados
O conjunto de dados foi construído combinando informações contábeis e macroeconômicas de diversas fontes. Os dados das demonstrações financeiras (Formulário de Informações Trimestrais – ITR e Demonstrações Financeiras Padronizadas – DFP) foram obtidos da Comissão de Valores Mobiliários (CVM) em formato CSV. As cotações diárias das ações foram coletadas separadamente da B3, utilizando os arquivos históricos do COTAHIST, que exigiram um código de análise específico devido ao seu formato de largura fixa. Informações sobre liquidez de ações foram obtidas do site Fundamentus, e um processo de compatibilização de identificadores entre Fundamentus, B3 e CVM foi realizado usando a solicitação interna da página de empresas listadas da B3 (formato JSON).
A taxa Selic, do Banco Central, foi incluída para representar o ambiente macrofinanceiro. A amostra foi restrita ao período de 2020 a 2025 devido à disponibilidade de dados sobre o número total de ações em circulação a partir de 2020. Empresas sem liquidez de ações foram excluídas da amostra.
A preparação dos dados envolveu a leitura e concatenação dos arquivos ITR e DFP, mantendo apenas as observações da ordem fiscal mais recente e as demonstrações contábeis padrão obrigatórias. Tratamentos específicos foram aplicados para valores acumulados na DRE e DVA, e para o cálculo da dívida total. A etapa final consistiu no alinhamento dos dados contábeis com os dados de mercado: para índices que exigiam preço contemporâneo, utilizou-se o preço de fechamento próximo à data da demonstração; para a variável P/VP, empregou-se o preço médio da ação no mês subsequente à divulgação. Após esses procedimentos, obteve-se um dataframe consolidado com 4.646 observações de 251 empresas brasileiras, adequado para a aplicação dos modelos de ML.
Definição das variáveis e engenharia de atributos
A etapa de engenharia de atributos consistiu na conversão de divulgações contábeis brutas em indicadores financeiros, uma vez que os arquivos da CVM não os fornecem prontos para uso. A variável dependente foi a relação Preço/Valor Patrimonial (P/VP), calculada relacionando o preço médio das ações no mês seguinte à divulgação do relatório financeiro ao valor patrimonial contábil da empresa.
As variáveis explicativas foram selecionadas para capturar dimensões de desempenho e situação financeira, abrangendo liquidez, rentabilidade, alavancagem, desempenho operacional e múltiplos de mercado. Além dos indicadores financeiros, foram incluídas a taxa Selic (variável macroeconômica) e o setor de atividade da empresa (para considerar diferenças estruturais). A maioria das variáveis explicativas foi construída em forma relativa (índices ou medidas proporcionais) para melhorar a comparabilidade entre empresas de diferentes portes. O logaritmo natural do ativo total foi explicitamente incorporado como variável de tamanho. A Tabela 1 detalha os indicadores financeiros utilizados.
Tabela 1. Indicadores financeiros na tabela final
| Indicador | Abreviação | Descrição |
|---|---|---|
| Preço sobre Valor Patrimonial | P/VP | De acordo com Braga (2009), o indicador conferiu uma medida de comparação entre o valor patrimonial da organização e o valor de mercado atribuído à companhia. |
| Liquidez Corrente | LC | Gitman (2010) aponta que o índice de liquidez corrente mede a capacidade da empresa de cumprir suas obrigações de curto prazo. |
| Retorno sobre capital próprio | ROE | Esse indicador descreve o retorno obtido sobre o investimento dos acionistas (Gitman, 2010). |
| Dívida Líquida sobre Patrimônio Líquido | DL/PL | Klem (2022) indica que o DL/PL demostra o volume de dívida que uma empresa utilizou para financiar seus ativos em relação ao patrimônio dos acionistas. |
| Retorno sobre Ativo | ROA | Esse indicador mede a capacidade da empresa de gerar resultados a partir dos recursos totais sob seu controle (CFA Institute, 2024). |
| Lucro por Ação | LPA | Esse indicador representa a parcela do lucro atribuível a cada ação ordinária em circulação ao longo do período (IFRS Foundation, 2023). |
| Margem EBITDA | Esse indicador expressa a proporção da receita que é convertida em resultado operacional antes de juros, tributos, depreciação e amortização (B3, 2025). | |
| Margem Líquida | Esse indicador demonstra a parcela da receita que efetivamente se converte em lucro líquido ao final do período (CFA Institute, 2024). | |
| Giro do Ativo | Esse indicador mede a eficiência com que a empresa utiliza seus ativos para gerar receita (CFA Institute, 2024). | |
| Ativo Total | Esse indicador corresponde ao total de recursos econômicos controlados pela entidade e reconhecidos em seu balanço patrimonial (IFRS Foundation, 2021). |
Fonte: Resultados originais da pesquisa
A escolha de variáveis relativas foi também uma decisão metodológica, pois os algoritmos de aprendizado em conjunto baseados em árvores, embora menos sensíveis à escala, se beneficiam de indicadores que se concentram em diferenças economicamente significativas, separando o efeito do tamanho da empresa do desempenho financeiro.
Modelos de aprendizado de máquina
Para modelar a relação entre fundamentos financeiros e preço de mercado, foram utilizadas técnicas de aprendizado de máquina baseadas em métodos de “ensemble” com árvores de decisão. Foram empregados os algoritmos Random Forest, XGBoost e LightGBM.
O Random Forest, um método de “bagging” (bootstrap aggregating), treina múltiplos modelos a partir de diferentes amostras dos dados originais e combina suas previsões para reduzir a variância e aumentar a estabilidade (Ji et al., 2022; Kolani, 2022).
XGBoost e LightGBM são algoritmos baseados em “boosting”, que constroem modelos sequencialmente, corrigindo os erros das árvores anteriores para aprimorar o desempenho preditivo (Silva e Sátiro, 2024). O XGBoost é uma implementação escalável de “gradient boosting” (Zhang e Gong, 2020; Mo et al., 2020). O LightGBM, também baseado em “gradient boosting”, foi projetado para alta eficiência, utilizando estratégias como “Gradient-based One-Side Sampling” (GOSS) e “Exclusive Feature Bundling” (EFB), e uma abordagem baseada em histogramas para maior velocidade e precisão preditiva (Ke et al., 2017; Wang et al., 2022).
A utilização conjunta desses modelos possibilitou comparar diferentes formas de construção de modelos “ensemble” e avaliar seu desempenho com base em métricas adotadas na literatura (Silva e Sátiro, 2024).
Técnica de explicabilidade
Devido à complexidade e à falta de transparência dos modelos de aprendizado de máquina, utilizou-se a Inteligência Artificial Explicável (XAI) para melhorar a interpretabilidade (Hosain et al., 2024; Meske et al., 2022). O método SHapley Additive exPlanations (SHAP) foi empregado, baseado na teoria dos jogos cooperativos (Shapley, 1953), para atribuir um valor de contribuição a cada característica, refletindo seu impacto marginal na previsão do modelo (Parsa et al., 2020; Mizdrakovic et al., 2024).
O SHAP oferece explicações localmente precisas e globalmente consistentes, permitindo decompor as previsões do modelo em contribuições individuais das características. Isso possibilitou examinar a importância relativa, direção e magnitude do efeito de cada variável na avaliação financeira (Mizdrakovic et al., 2024). Os resultados do SHAP foram visualizados por meio de gráficos de importância de variáveis e gráficos “beeswarm”, facilitando a compreensão de como cada variável influencia as previsões geradas e os principais fatores que afetam a variável alvo (P/VP) (Mizdrakovic et al., 2024; Hosain et al., 2024).
3. Resultados e Discussão
Caracterização da amostra e evidências preliminares
O conjunto de dados final compreendeu 4.646 observações de 251 empresas brasileiras listadas em bolsa, no período de 2020 a 2025. A variável dependente foi a relação P/VP, calculada utilizando os preços de mercado observados após a divulgação das informações contábeis correspondentes. Essa escolha temporal preservou a natureza preditiva do exercício e reduziu a possibilidade de contaminação por informações futuras.
O conjunto final de características combinou indicadores contábeis, um controle macroeconômico representado pela taxa Selic, uma variável para o tamanho da empresa medida pelo logaritmo natural do ativo total e um identificador setorial. Como esperado em uma ampla amostra de empresas, os dados apresentaram heterogeneidade entre as observações, com perfis financeiros distintos entre empresas de diferentes setores, escalas e estruturas operacionais e de capital.
A Tabela 2 apresenta os indicadores financeiros utilizados no estudo, com suas respectivas abreviações e descrições, conforme definidos no TCC original.
Tabela 2. Indicadores financeiros na tabela final
| Modelo | R² (teste) | RMSE (teste) | MAE (teste) | Gap de overfitting |
|---|---|---|---|---|
| XGBoost | 0,644 | 1,228 | 0,669 | 0,326 |
| LightGBM | 0,574 | 1,348 | 0,742 | 0,367 |
| Random Forest | 0,427 | 1,570 | 0,848 | 0,262 |
Fonte: Resultados originais da pesquisa
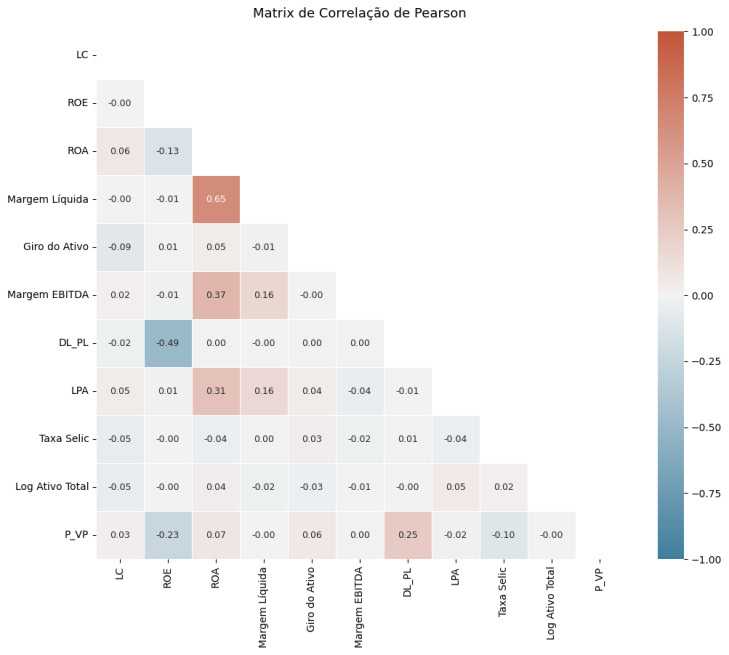
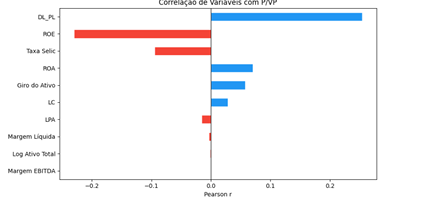
A Figura 1 apresenta a matriz de correlação de Pearson para o conjunto final de características, enquanto a Figura 2 mostra a correlação entre cada variável explicativa e a relação P/VP. A estrutura linear dos dados é relativamente fraca. Entre as variáveis explicativas, a relação Dívida Líquida sobre Patrimônio Líquido (DL/PL) apresentou a correlação de Pearson positiva mais forte com P/VP, enquanto o Retorno sobre o Patrimônio Líquido (ROE) apresentou a associação linear negativa mais forte. Em contrapartida, variáveis como Lucro por Ação (LPA) e Retorno sobre Ativo (ROA), que posteriormente se mostram centrais na análise não linear, não apresentaram a maior correlação com a variável alvo. Essa diferença já sugere que a correlação por si só pode não resumir adequadamente a relevância preditiva das variáveis.
Figura 1. Matriz de Correlação de Pearson do Conjunto Final de Características
Fonte: Resultados originais da pesquisa
Figura 2. Correlação de Pearson entre cada característica e P/VP
Fonte: Resultados originais da pesquisa
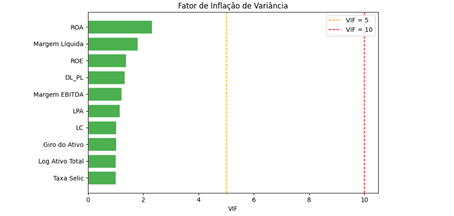
A Figura 3 apresenta o fator de inflação da variância (VIF) para a especificação final. Todas as variáveis retidas permaneceram bem abaixo dos limiares convencionais usados para diagnosticar multicolinearidade problemática. Esse resultado é importante porque indica que o conjunto final de características preserva dimensões econômicas distintas sem redundância linear, ou seja, as variáveis explicativas não parecem ser simples réplicas lineares umas das outras.
Figura 3. Fator de Inflação da Variância do Conjunto de Características Final
Fonte: Resultados originais da pesquisa
Do ponto de vista metodológico, esses resultados iniciais são relevantes porque indicam que o problema não é direto. Se a relação entre fundamentos e avaliação de mercado fosse linear, as correlações aos pares provavelmente forneceriam uma classificação muito mais clara das variáveis. O fato de isso não ocorrer está alinhado com a literatura que demonstra que os métodos de aprendizado de máquina se tornam especialmente úteis em finanças quando as relações preditor-resposta envolvem não linearidades e interações que as ferramentas lineares padrão não representam bem (Gu et al., 2020).
Desempenho preditivo dos modelos
Para avaliar o desempenho preditivo, este estudo adotou uma estratégia de validação temporal. Os modelos foram treinados utilizando observações até 2024 e avaliados na amostra de 2025. Além disso, um procedimento de validação cruzada com janela expansiva foi utilizado para avaliar o desempenho fora da amostra ao longo de vários anos. Essa escolha foi feita por estar mais próxima das condições reais de previsão, pois o modelo é sempre estimado utilizando informações passadas e testado em observações futuras.
A Tabela 3 resume os resultados da validação cruzada com janela expansível. Os resultados mostram uma classificação clara: o XGBoost obteve o melhor desempenho médio, seguido pelo LightGBM, enquanto o Random Forest ficou abaixo de ambos os modelos baseados em boosting. Esse resultado está em linha com evidências empíricas que apontam a superioridade de métodos de boosting e redes neurais em problemas de precificação de ativos, especialmente em contextos com grande número de variáveis e relações complexas (Gu et al., 2020). Dessa forma, os resultados deste estudo confirmam que abordagens baseadas em aprendizado de máquina oferecem ganhos relevantes em relação a modelos tradicionais de regressão.
Tabela 3. Validação cruzada com janelas expansíveis (média das 4 janelas temporais)
| Modelo | R² (treino) | R² (teste) | RMSE (teste) | MAE (teste) |
|---|---|---|---|---|
| Random Forest | 0,697 | 0,368 | 1,578 | 0,787 |
| LightGBM | 0,912 | 0,468 | 1,448 | 0,745 |
| XGBoost | 0,933 | 0,469 | 1,447 | 0,717 |
Fonte: Resultados originais da pesquisa
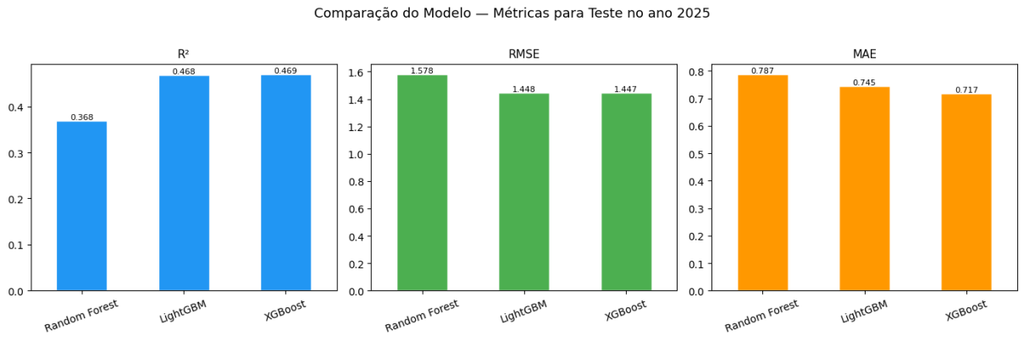
A Tabela 4 e a Figura 4 apresentam os resultados finais de validação cruzada para 2025. Nesse ano de teste, o XGBoost e o LightGBM obtiveram desempenho preditivo semelhante, e ambos superaram o Random Forest. A proximidade entre os dois modelos de boosting sugere que o principal sinal empírico não foi impulsionado por uma única implementação, mas sim pela capacidade geral dos ensembles de árvores baseados em boosting de modelar relações complexas com mais flexibilidade do que o benchmark de bagging. Esse resultado está alinhado com a literatura, que aponta que métodos de boosting tendem a apresentar desempenho superior em problemas com elevada complexidade e não linearidade, uma vez que são capazes de corrigir iterativamente os erros dos modelos anteriores e capturar interações mais sofisticadas entre variáveis (Chen e Guestrin, 2016; Ke et al., 2017).
Tabela 4. Desempenho final dos modelos (treino até 2024; teste = 2025)
| Posição | Variável | Random Forest | LightGBM | XGBoost | Pos. média |
|---|---|---|---|---|---|
| 1 | LPA | 1 | 1 | 1 | 1,0 |
| 2 | ROA | 2 | 2 | 2 | 2,0 |
| 3-5 | DL/PL | 5 | 3 | 5 | 4,3 |
| 3-5 | Selic | 3 | 6 | 4 | 4,3 |
| 3-5 | ROE | 6 | 5 | 3 | 4,7 |
| 6-7 | Asset Turnover | 4 | 7 | 6 | 5,7 |
| 6-7 | SETOR_ATIV | 8 | 4 | 7 | 6,3 |
| 8 | Log Ativo Total | 9 | 8 | 8 | 8,3 |
| 9 | Margem Líquida | 7 | 9 | 10 | 8,7 |
| 10 | LC | 10 | 10 | 9 | 9,7 |
| 11 | Margem EBITDA | 11 | 11 | 11 | 11,0 |
Fonte: Resultados originais da pesquisa
Figura 4. Desempenho dos modelos de ML no conjunto de testes (2025)
Fonte: Resultados originais da pesquisa
Ao mesmo tempo, os resultados de desempenho devem ser interpretados com cautela. O R² de treinamento dos modelos de boosting permaneceu significativamente acima do R² de teste, o que sugere algum grau de sobreajuste (overfitting) mesmo após a regularização e a parada antecipada. Além disso, o ano de validação de 2025 parece ter sido mais difícil de prever do que a média das validações cruzadas. Uma possível explicação é que o ambiente macrofinanceiro naquele ano tornou a avaliação transversal mais difícil de explicar com os preditores disponíveis. Essa interpretação é economicamente plausível, uma vez que os múltiplos de avaliação refletem tanto as expectativas sobre os fluxos de caixa futuros quanto as taxas de desconto aplicadas a eles, de modo que mudanças no ambiente de taxas de juros podem modificar a forma como os fundamentos contábeis se traduzem em preços de mercado observados (Campbell e Shiller, 1988).
Análise SHAP e classificação das variáveis explicativas
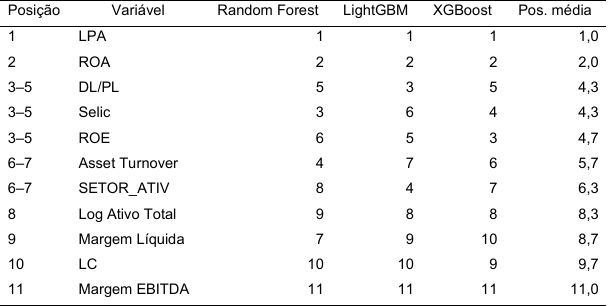
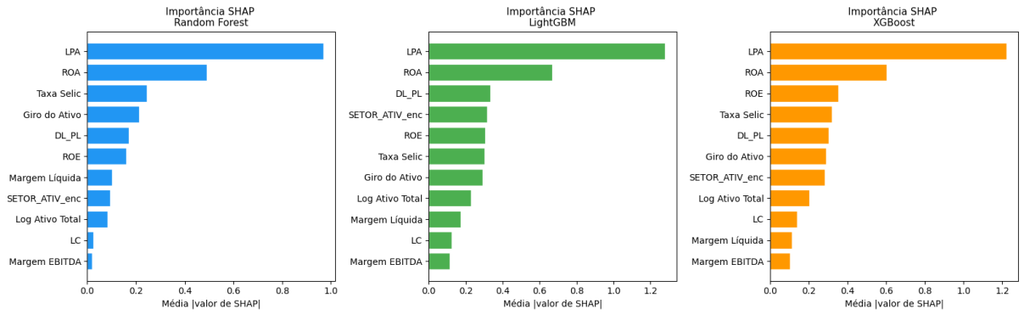
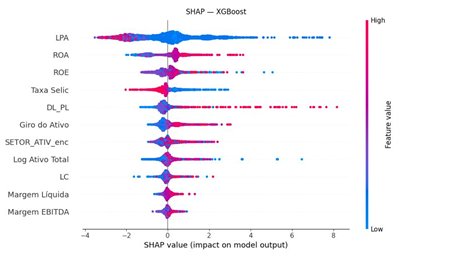
A Tabela 5 resume a classificação SHAP nos três modelos, enquanto a Figura 5 apresenta os valores médios absolutos de SHAP correspondentes. O LPA aparece como a variável mais importante em todos os três algoritmos, enquanto o ROA ocupa consistentemente a segunda posição. Uma segunda camada de variáveis inclui ROE, DL/PL, Selic, Giro do Ativo e o indicador setorial, com alguma variação entre os modelos. Em contrapartida, a liquidez corrente, a margem líquida e a margem EBITDA apresentam uma contribuição marginal relativamente baixa quando o conjunto de características mais amplo é considerado.
Tabela 5. Ranking de importância das variáveis por modelo (SHAP)
Fonte: Resultados originais da pesquisa
Figura 5. Importância das características SHAP
Fonte: Resultados originais da pesquisa
A dominância do LPA, juntamente com a relevância do ROA e do ROE, indica que variáveis relacionadas à rentabilidade constituem a principal dimensão explicativa da relação P/VP. Esse resultado está alinhado com a literatura clássica de precificação de ativos, que atribui papel central à rentabilidade na explicação dos retornos e múltiplos de mercado (Fama e French, 2015). No entanto, o presente estudo avança ao demonstrar que essa relação não se manifesta de forma estritamente linear, sendo melhor capturada por modelos baseados em aprendizado de máquina.
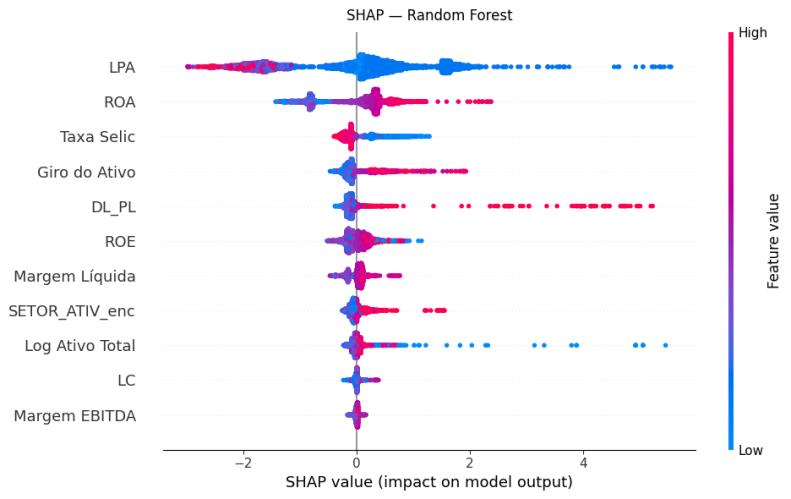
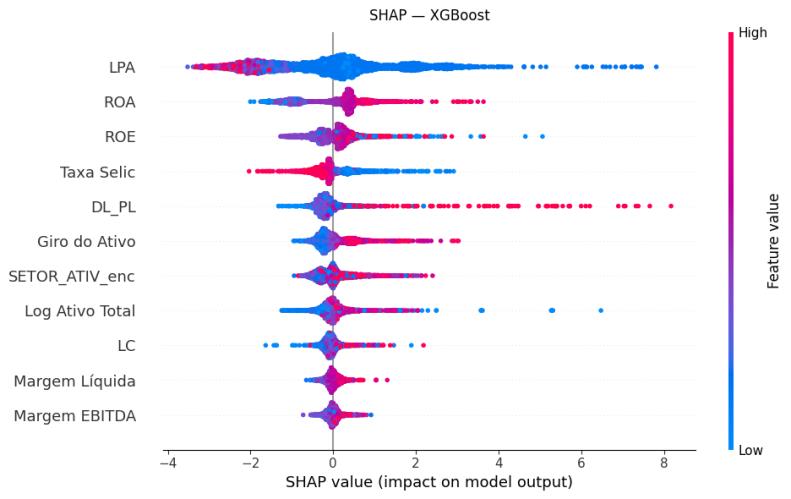
A Figura 6, Figura 7 e Figura 8 fornecem informações adicionais por meio dos gráficos de dispersão SHAP. Essas figuras mostram que as principais características não atuam de forma puramente linear. No caso do LPA, a contribuição para o resultado do modelo é forte e amplamente dispersa entre as observações, mas seu padrão direcional é diferente do esperado. Valores mais baixos de LPA tendem a estar associados a valores SHAP positivos, enquanto valores mais altos tendem a estar associados a valores SHAP negativos. Em outras palavras, dentro da estrutura aprendida pelos modelos, lucros por ação mais baixos estão associados a um aumento na relação P/VP prevista, enquanto lucros por ação mais altos estão associados a uma redução na relação P/VP prevista. Esse resultado contrasta com a interpretação tradicional da análise fundamentalista, na qual maiores lucros por ação estariam diretamente associados a maiores múltiplos de valuation. No entanto, a literatura sugere que os preços de mercado refletem expectativas futuras e não apenas resultados correntes, o que pode explicar esse comportamento não linear (Kelly e Xiu, 2023).
Figura 6. Gráfico de dispersão SHAP para Random Forest
Fonte: Resultados originais da pesquisa
Figura 7. Gráfico de dispersão SHAP para LightGBM
Fonte: Resultados originais da pesquisa
Figura 8. Gráfico de dispersão SHAP para XGBoost
Fonte: Resultados originais da pesquisa
Os padrões de ROA e ROE também sugerem não linearidade e dependência contextual. Suas distribuições SHAP são assimétricas e não uniformes, indicando que sua contribuição depende não apenas de seu nível, mas também da configuração mais ampla das características da empresa. O ponto crucial é que os modelos não estão simplesmente aprendendo que “mais lucratividade é sempre melhor” em um sentido linear e uniforme. Em vez disso, estão aprendendo uma estrutura de valoração mais complexa, na qual o efeito marginal de cada variável depende do contexto em que aparece. Esse resultado está alinhado com a literatura, que mostra que modelos de machine learning capturam interações e relações não lineares entre variáveis (Gu et al., 2020). Além disso, a própria estrutura do SHAP evidencia contribuições condicionais, dependentes do contexto de cada observação (Lundberg e Lee, 2017).
Correlação linear versus importância não linear
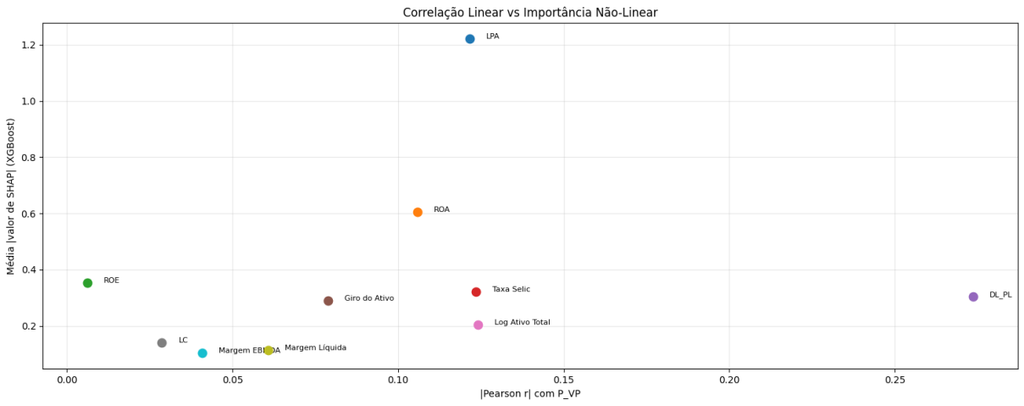
Uma das descobertas do estudo é o contraste entre a correlação linear e a importância não linear. A Figura 9 compara diretamente a correlação de Pearson absoluta de cada característica com o valor médio do SHAP obtido pelo XGBoost.
Figura 9. Correlação Linear vs. Importância Não-Linear
Fonte: Resultados originais da pesquisa
Sob uma perspectiva linear aos pares, DL/PL aparece como a variável mais fortemente associada, enquanto LPA não se destaca em sua relação com o alvo. No entanto, a análise SHAP produz o resultado oposto: LPA é o preditor dominante, enquanto ROA e ROE também ganham importância em relação à sua classificação linear. Esse achado é consistente com o estudo de Gu et al. (2020), que demonstra que modelos não lineares capturam interações complexas entre variáveis que são ignoradas por abordagens lineares tradicionais. O estudo mostra que os ganhos preditivos desses modelos decorrem justamente da capacidade de modelar relações não lineares e interações entre preditores, o que reforça os resultados encontrados neste trabalho. Os modelos não lineares, portanto, contribuem não apenas melhorando o desempenho preditivo, mas também refinando a interpretação substantiva de quais características da empresa são mais importantes para a avaliação de mercado. Essa conclusão está de acordo com a literatura que argumenta que os ganhos da aprendizagem de máquina em finanças decorrem, em grande parte, de sua capacidade de acomodar interações preditivas não lineares que são ignoradas pelos modelos convencionais (Gu et al., 2020; Ye et al., 2024).
Interpretação econômica dos principais fatores determinantes
Os resultados empíricos indicam que a variação na relação P/VP é explicada principalmente por informações relacionadas à rentabilidade, embora nem sempre na direção sugerida pela intuição financeira simples. A posição de liderança do lucro por ação, seguido pelo retorno sobre ativos e, em seguida, por uma segunda camada composta por endividamento/patrimônio líquido, índice Selic e retorno sobre o patrimônio líquido, mostra que o processo de avaliação capturado pelos modelos depende principalmente de medidas relacionadas à geração de lucros, estrutura de capital e condições macrofinanceiras das empresas. Fama e French (2015) mostram que a rentabilidade constitui um dos principais determinantes da precificação de ativos, o que é consistente com a predominância das variáveis relacionadas à geração de lucros observada neste estudo.
Essa distinção é importante. Variáveis como ROA e ROE resumem o desempenho econômico em termos proporcionais, enquanto o LPA captura os lucros no nível da ação. No entanto, no presente caso, o papel do LPA não pode ser interpretado como um simples sinal positivo de avaliação. Embora seja o preditor mais importante em todos os três modelos, os diagramas SHAP indicam um padrão direcional inverso: valores mais baixos de LPA tendem a estar associados a contribuições positivas para a previsão da relação P/VP, enquanto valores mais altos tendem a estar associados a contribuições negativas. Isso sugere que a informação contida na LPA não se limita à força dos lucros atuais. Em vez disso, parece capturar uma distinção mais ampla entre empresas com lucros atuais mais fortes e empresas que negociam com múltiplos contábeis mais altos devido a outros atributos, como expectativas de crescimento, posicionamento setorial, maturidade do negócio ou componentes de valor intangível não totalmente refletidos na lucratividade contábil atual. Campbell e Shiller (1988) demonstram que os preços de mercado refletem expectativas sobre fluxos de caixa futuros, enquanto Damodaran (2012) argumenta que múltiplos de valuation incorporam crescimento esperado e risco, o que ajuda a explicar o comportamento não linear do LPA observado neste estudo.
O papel do ROA é mais direto. Como a segunda variável mais importante em todos os modelos, o ROA sugere que o mercado atribui peso à capacidade da empresa de gerar lucros a partir de sua base de ativos. Nesse sentido, o ROA parece capturar uma dimensão de eficiência que permanece relevante mesmo após o controle do lucro por ação, da alavancagem e das condições macroeconômicas. Penman (2013) associa o retorno sobre ativos à eficiência econômica e à geração de valor, reforçando a interpretação do ROA como um dos principais fatores explicativos da relação P/VP.
A contribuição do ROE também é relevante, embora menos estável no ranking do que a LPA e o ROA. Sua posição entre as três variáveis intermediárias sugere que o retorno sobre o patrimônio líquido ainda importa para a avaliação, mas de uma forma mais condicional e dependente do modelo. Isso está em consonância com a ideia de que o mercado não precifica o ROE de forma uniforme entre as empresas, visto que o mesmo nível de ROE pode refletir combinações subjacentes muito diferentes de rentabilidade, alavancagem e estrutura de negócios. Damodaran (2012) destaca que o ROE pode refletir diferentes combinações de rentabilidade, risco e estrutura de capital, o que ajuda a explicar por que seu efeito não se manifesta de forma uniforme entre as empresas.
O papel da alavancagem, medida pela relação entre DL/PL, também é mais complexo do que a correlação linear isoladamente sugere. Embora a DL/PL tenha apresentado a correlação mais forte com a relação P/VP, sua classificação no SHAP permaneceu abaixo da das principais variáveis relacionadas à rentabilidade. Isso indica que a alavancagem é relevante, mas não em um sentido unidirecional simples. Em vez disso, sua contribuição parece depender da configuração mais ampla das características da empresa, incluindo rentabilidade, tamanho e setor, ou seja, a alavancagem parece importar mais como parte de uma estrutura de avaliação conjunta do que como um fator explicativo isolado. Modigliani e Miller (1958) mostram que a estrutura de capital influencia o valor da firma sob determinadas condições, enquanto Myers (1984) argumenta que a alavancagem interage com risco e oportunidades de investimento, o que é consistente com o comportamento condicional observado neste estudo.
Esse resultado está alinhado com a teoria de precificação de ativos, segundo a qual os preços refletem expectativas descontadas de fluxos de caixa futuros, sendo sensíveis às taxas de juros (Kelly e Xiu, 2023). Nesse sentido, a relevância da Selic no ranking SHAP reforça a ideia de que a avaliação de mercado é moldada não apenas por informações contábeis específicas da empresa, mas também pelo ambiente macrofinanceiro em que as empresas são precificadas.
Por fim, o Giro do Ativo aparece em uma posição intermediária, abaixo das principais variáveis de rentabilidade, alavancagem e macroeconômicas, mas ainda com uma contribuição não desprezível. Isso sugere que a eficiência operacional no uso de ativos contém informações adicionais para explicar o índice P/VP, embora seu papel seja claramente secundário em relação aos principais preditores.
Em conjunto, esses resultados sugerem que os modelos estão aprendendo uma estrutura de avaliação na qual as variáveis relacionadas à rentabilidade dominam, mas seus efeitos não são puramente lineares ou uniformes. O caso do LPA é especialmente importante nesse sentido: é o preditor mais relevante, mas sua contribuição direcional indica que a relação de mercado capturada pelos modelos reflete mais do que um simples prêmio por lucros correntes mais altos. Em vez disso, os modelos parecem incorporar uma distinção mais ampla entre empresas com lucros atuais fortes e empresas que obtêm múltiplos de avaliação mais altos devido a outras características que o mercado valoriza.
Discussão dos resultados com base na literatura
Primeiramente, os resultados reforçam a ideia de que variáveis relacionadas à rentabilidade ocupam posição central na explicação da avaliação de mercado, embora nem sempre na direção sugerida pela intuição financeira mais imediata. A relevância consistente de LPA, ROA e ROE indica que a capacidade das empresas de gerar resultados permanece como uma dimensão fundamental para explicar a variação entre valor de mercado e valor contábil. No entanto, os resultados também mostram que essa relação não é puramente linear nem uniforme. Em especial, o comportamento do LPA nos gráficos SHAP sugere que sua contribuição para a predição do P/VP depende de uma estrutura de avaliação mais complexa, possivelmente associada à interação entre lucratividade corrente, expectativas de crescimento, maturidade da firma e características setoriais. Ainda assim, em termos agregados, a centralidade dessas variáveis permanece compatível com a literatura que destaca a rentabilidade como uma dimensão importante da precificação de mercado (Fama e French, 2015).
Em segundo lugar, os resultados fortalecem a argumentação metodológica para a modelagem não linear na análise de demonstrações financeiras. A discrepância entre a correlação de Pearson e a importância do SHAP indica que grande parte do sinal economicamente significativo opera por meio de formas e interações não lineares. Isso está em consonância com a literatura que demonstra que os métodos de aprendizado de máquina em finanças geram ganhos quando conseguem capturar estruturas que os modelos lineares não representam bem (Gu et al., 2020).
Em terceiro lugar, as evidências confirmam que os fundamentos da empresa e as condições macrofinanceiras moldam conjuntamente os múltiplos de avaliação. O papel da Selic demonstra que as informações contábeis por si só não são suficientes para explicar a avaliação de mercado; o ambiente mais amplo da taxa de desconto também é relevante. Este resultado é consistente com a teoria de avaliação padrão e com a literatura empírica sobre relações de precificação entre características da empresa e resultados de mercado (Fama e French, 2015).
Limitações dos resultados
Uma primeira limitação refere-se ao recorte temporal da amostra, que compreende o período de 2020 a 2025. Embora esse intervalo inclua variações macroeconômicas relevantes, como mudanças na taxa de juros e diferentes condições de mercado, ele ainda representa um horizonte relativamente curto para um estudo de natureza estrutural sobre valuation. Além disso, esse período é marcado por eventos atípicos, como os efeitos da pandemia de COVID-19, o que pode limitar a generalização dos resultados para outros contextos históricos.
Uma segunda limitação está relacionada à construção da base de dados. A integração entre diferentes fontes exigiu etapas de tratamento, filtragem e compatibilização de identificadores, o que pode introduzir erros residuais ou perdas de informação. Além disso, a exclusão de empresas com baixa liquidez ou com dados incompletos pode gerar viés de seleção, favorecendo empresas maiores, mais consolidadas e com maior cobertura de mercado, o que pode afetar a representatividade da amostra.
Outra limitação importante diz respeito à natureza dos dados contábeis utilizados. As demonstrações financeiras refletem informações históricas e estão sujeitas a diferentes práticas contábeis, revisões e possíveis distorções. Embora tenham sido realizados tratamentos para garantir consistência, os indicadores derivados dessas informações podem não capturar completamente aspectos econômicos mais amplos, como qualidade da governança, ativos intangíveis, posicionamento competitivo ou expectativas de crescimento futuro, que são frequentemente relevantes para a precificação de mercado (Penman, 2013).
Adicionalmente, a escolha das variáveis explicativas, embora baseada na literatura e na disponibilidade de dados, não é exaustiva. Variáveis potencialmente relevantes, como métricas de mercado, indicadores de governança corporativa, cobertura de analistas, estrutura de propriedade e expectativas de crescimento, não foram incluídas. Como consequência, parte da variação observada na relação P/VP pode estar associada a fatores não capturados pelo modelo.
Do ponto de vista metodológico, os modelos utilizados apresentam elevada capacidade preditiva, mas também risco de sobreajuste (overfitting), especialmente em contextos com múltiplas variáveis e interações complexas (Hastie et al., 2009). Embora tenham sido adotadas estratégias como validação temporal e teste fora da amostra, os resultados indicam diferenças relevantes entre desempenho em treino e teste, sugerindo que parte do padrão aprendido pode não se generalizar completamente para novos dados.
Outra limitação importante está relacionada à interpretação dos resultados via SHAP. Embora o método permita decompor as previsões em contribuições individuais das variáveis, essas contribuições são de natureza associativa e não causal (Lundberg e Lee, 2017). Ou seja, os resultados indicam quais variáveis são relevantes para a previsão do modelo, mas não permitem afirmar que alterações nessas variáveis causariam mudanças diretas na avaliação de mercado. Essa distinção é particularmente importante em contextos financeiros, nos quais múltiplos fatores interagem de forma simultânea.
Além disso, a abordagem adotada trata as observações principalmente como instâncias independentes para fins preditivos, não explorando de forma explícita a estrutura de dados em painel. Diferentemente de modelos econométricos tradicionais, que permitem controlar efeitos fixos e heterogeneidade não observada entre empresas e ao longo do tempo, os modelos de aprendizado de máquina utilizados não incorporam diretamente essas estruturas, o que pode limitar a interpretação dos resultados em termos de dinâmica temporal ou diferenças estruturais entre firmas.
Por fim, a variável dependente utilizada (P/VP) representa apenas uma das possíveis métricas de valuation. Embora amplamente utilizada, ela possui limitações conhecidas, especialmente em setores intensivos em ativos intangíveis ou em empresas com estruturas contábeis específicas. Damodaran (2012) destaca que múltiplos baseados em valor contábil podem não capturar adequadamente o valor econômico de empresas com forte presença de ativos intangíveis, o que pode afetar a interpretação dos resultados. Dessa forma, os resultados devem ser interpretados como válidos dentro do contexto dessa métrica específica, não sendo necessariamente generalizáveis para outros múltiplos de mercado.
Em síntese, os resultados deste estudo indicaram que modelos de aprendizado de máquina, particularmente os baseados em boosting, apresentaram desempenho superior na explicação da relação Preço sobre Valor Patrimonial de empresas brasileiras, superando o Random Forest. Observou-se que a relação entre os fundamentos contábeis e a avaliação de mercado não é estritamente linear, sendo melhor capturada por interações complexas. Variáveis de rentabilidade, como lucro por ação, retorno sobre ativos e retorno sobre o patrimônio líquido, emergiram como os principais fatores explicativos, embora seus efeitos se mostrem contextuais e não uniformes, como evidenciado pelo comportamento não linear do lucro por ação. A análise SHAP revelou uma hierarquia de importância das variáveis distinta da correlação linear, reforçando a capacidade dos modelos não lineares de capturar padrões mais sofisticados. Adicionalmente, a taxa Selic e o setor de atividade também contribuíram para a compreensão da precificação, sugerindo que o ambiente macrofinanceiro e as características setoriais são relevantes. Esses achados demonstram o potencial do aprendizado de máquina, combinado com técnicas de interpretabilidade, para oferecer insights mais transparentes sobre a dinâmica de avaliação no mercado acionário brasileiro.
4. Conclusão
Este estudo teve como objetivo avaliar a capacidade de modelos de aprendizado de máquina em explicar a relação Preço sobre Valor Patrimonial (P/VP) de empresas brasileiras listadas na B3. Verificou-se que os modelos de ensemble baseados em boosting, como XGBoost e LightGBM, apresentaram desempenho superior na explicação do P/VP em comparação com o Random Forest, indicando que a relação entre fundamentos contábeis e a avaliação de mercado não se manifesta de forma estritamente linear. A análise de interpretabilidade via Explanações Aditivas de Shapley (SHAP) revelou que variáveis de rentabilidade, como lucro por ação (LPA), retorno sobre ativos (ROA) e retorno sobre o patrimônio líquido (ROE), ocuparam posições centrais na explicação do P/VP. Contudo, observou-se que o LPA exibiu um comportamento não linear e direcional distinto da interpretação financeira tradicional, sugerindo que o mercado incorpora uma estrutura de valoração mais complexa, que vai além dos lucros correntes. Adicionalmente, a taxa Selic e o setor de atividade também contribuíram significativamente para a compreensão da precificação. A principal contribuição do estudo reside na demonstração de que o aprendizado de máquina, aliado a técnicas de interpretabilidade, oferece insights mais transparentes e aprofundados sobre a dinâmica de avaliação no mercado acionário brasileiro, ao capturar relações complexas e não lineares que abordagens tradicionais frequentemente ignoram.
Apesar dos achados relevantes, o estudo possui limitações que merecem consideração. O recorte temporal da amostra (2020-2025), marcado por eventos atípicos como a pandemia de COVID-19, e a exclusão de empresas com baixa liquidez, podem afetar a generalização dos resultados. A natureza histórica dos dados contábeis e a não inclusão de variáveis como métricas de mercado ou indicadores de governança corporativa representam outras restrições. Do ponto de vista metodológico, embora os modelos apresentem alta capacidade preditiva, notou-se um risco de sobreajuste, e as contribuições SHAP são de natureza associativa, não causal, além de não explorarem explicitamente a estrutura de dados em painel. A variável P/VP, embora amplamente utilizada, possui limitações em setores com muitos ativos intangíveis. Para estudos futuros, sugere-se a expansão do horizonte temporal da amostra, a inclusão de um conjunto mais abrangente de variáveis explicativas, como ativos intangíveis e expectativas de crescimento, e a exploração de modelos que incorporem explicitamente a estrutura de dados em painel. Recomenda-se também a aplicação dessa metodologia a outras métricas de valuation para verificar a robustez dos resultados e aprofundar a compreensão da precificação de ativos em diferentes contextos.
Referências Bibliográficas
Damodaran, A. 2012. Investment Valuation: Tools and Techniques for Determining the Value of Any Asset. 3ed. John Wiley & Sons, Hoboken, NJ, USA.
Ghashami, F.; Kamyar, K. 2021. Performance evaluation of ANFIS and GA-ANFIS for predicting stock market indices. International Journal of Economics and Finance 13(7): 1-6.
Jacques, K.S.; Cunha, M.F.; Fernandes, V.D.C.; Queiroz, L.M. 2021. Qual é o valor da empresa? O caso de valuation da empresa Magazine Luiza. Revista Ambiente Contábil 13(1): 359-377.
Lima, M.V.A.; Lima, M.A.; Pereira, M.F. 2011.
Moutinho, R.A.; Ambrozini, M.A.; Magnani, V.M. 2019. Análise do impacto do fluxo de caixa livre sobre o retorno acionário das companhias de capital aberto no mercado acionário brasileiro. Revista Mineira de Contabilidade 20(2): 55-69.
Tavares, A.L.; Silva, C.A.T. 2012. A análise financeira fundamentalista na previsão de melhores e piores alternativas de investimento. Revista Universo Contábil 8(1): 37-52.
Artigo oriundo de Trabalho de Conclusão de Curso da Especialização em Data Science e Analytics do MBA USP/Esalq
Para saber mais sobre o curso, clique aqui e acesse a plataforma MBX Academy

