
09 de septiembre de 2026
Segmentación de Mercado: Aplicación de Técnicas de Clusterización para Orientar Iniciativas de Marketing
Artur de Menezes Venâncio Martins; Fernando Celso de Campos
DOI: 10.22167/2675-6528-202602128
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
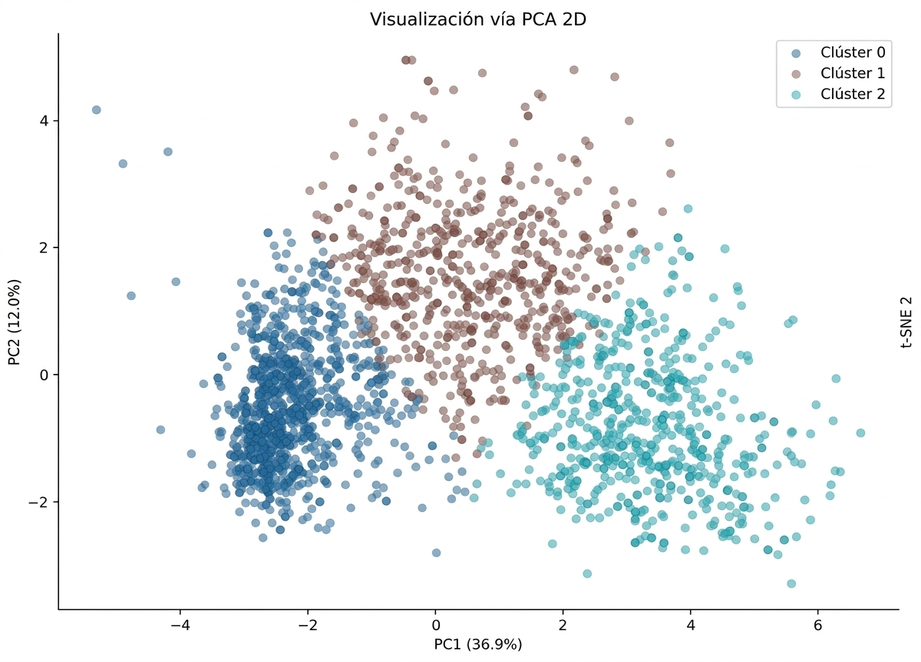
La segmentación de mercado es una práctica fundamental para dirigir estrategias de marketing eficaces. El trabajo tuvo como objetivo elaborar un protocolo de análisis de datos para dirigir estrategias de marketing, utilizando segmentación de consumidores mediante aprendizaje automático no supervisado, basándose en variables demográficas y conductuales. Para ello, se implementó el algoritmo K-Means, tras un preprocesamiento del conjunto de datos que incluyó tratamiento de variables, exclusión de datos faltantes, escalado, estandarización y reducción de dimensionalidad por Análisis de Componentes Principales (PCA). La determinación del número óptimo de agrupaciones se realizó por los métodos del codo y de la silueta. El análisis resultó en la creación de tres clústeres de consumidores, validados por visualización 2D vía PCA y t-SNE, que demostraron robustez y consistencia. Se identificaron tres perfiles: Clientes Económicos (más jóvenes, menor renta y consumo, más hijos), Clientes Moderados (mayores, renta y consumo equilibrados) y Clientes Élite (alta renta, alto consumo de productos sofisticados, menos hijos). Se concluyó que las técnicas de clusterización son eficaces para identificar perfiles de consumidores basándose en características sociodemográficas, comportamiento de consumo y estructura familiar, pudiendo optimizar el rendimiento y alcance de iniciativas de marketing.
Palabras clave: Análisis de agrupamiento; Aprendizaje automático; Comportamiento del consumidor; Factores sociodemográficos; K-Means.
1. Introducción
La segmentación de mercado, un concepto fundamental en marketing, consiste en visualizar un mercado heterogéneo como un conjunto de mercados más pequeños y homogéneos (Smith, 1956). Esta práctica es esencial para el desarrollo de productos, la definición de ofertas y la planificación publicitaria (Kotler, 1999; Shirole et al., 2021). La segmentación es el punto de partida para la evaluación de estrategias de marketing, reconociendo la diversidad de intereses, deseos y necesidades de los clientes (Toledo, 1972).
Tradicionalmente, la segmentación puede abordarse mediante variables demográficas, geográficas, psicográficas y de comportamiento (Kotler y Keller, 2012). Sin embargo, en un escenario de inversiones masivas en marketing, como los billones de dólares estimados para publicidad en línea y fuera de línea en 2024 (DataReportal, 2025), un producto genérico no puede satisfacer las necesidades de todos los clientes (Lopes, 2005). La ausencia de una segmentación precisa puede llevar a esfuerzos de marketing ineficientes y desperdicios presupuestarios (Cortez et al., 2021; Dolnikar et al., 2013).
En este contexto, la Ciencia de Datos ofrece enfoques avanzados para la segmentación de mercado, utilizando técnicas de aprendizaje automático no supervisado, como el análisis de agrupamiento (Favero y Belfiore, 2023). Estas técnicas buscan agrupar observaciones en conjuntos internamente homogéneos y heterogéneos entre sí, permitiendo la identificación de perfiles de consumidores con características y comportamientos similares.
Entre los métodos de agrupamiento, el algoritmo K-Means destaca por su popularidad y eficacia. Es una técnica exploratoria y no jerárquica, donde el número de agrupamientos (K) es definido previamente por el investigador. Su eficiencia computacional, capacidad de manejar grandes volúmenes de datos y facilidad de aplicación lo hacen ampliamente utilizado en entornos corporativos para la segmentación de mercado (Sarkar et al., 2024; Maryani et al., 2018; Prabhas et al., 2023). La implementación de K-Means requiere un preprocesamiento del conjunto de datos, que involucra tratamiento de variables, exclusión de datos faltantes, escalado, estandarización y reducción de dimensionalidad, utilizando frecuentemente el Análisis de Componentes Principales (PCA). La determinación del número óptimo de agrupamientos se verifica mediante métodos como el codo y la silueta.
La identificación de patrones de consumo y perfiles de clientes es un recurso fundamental para el marketing, ya que permite el desarrollo de programas más eficaces (Boyd et al., 1998) y la personalización de campañas, evitando la ineficacia de enfoques genéricos. La adopción de un protocolo de análisis de datos basado en aprendizaje automático para la segmentación de mercado no solo optimiza la orientación de productos, sino que también revela características latentes de los consumidores que serían difíciles de observar en grandes conjuntos de datos sin un análisis técnico en profundidad (Yoseph et al., 2020; Osei et al., 2021). Este enfoque contribuye a la toma de decisiones más robustas, reproducibles y dirigidas, resultando en campañas más eficientes y asertivas, con ganancias operativas en la reducción del tiempo de análisis y escalabilidad para grandes volúmenes de datos.
Ante la necesidad de optimizar las estrategias de marketing a través de una comprensión profunda del comportamiento del consumidor, este trabajo tuvo como objetivo elaborar un protocolo de análisis de datos basado en la evaluación de variables demográficas y conductuales para dirigir estrategias de marketing, utilizando la segmentación de consumidores a través de aprendizaje automático no supervisado.
2. Material y Métodos
El enfoque metodológico empleado en este trabajo consistió en cuatro etapas principales: obtención y descripción de la base de datos, análisis y preparación de los datos, desarrollo del algoritmo y análisis de los clústeres. El estudio utilizó datos públicos extraídos del sitio web Kaggle, accesibles en https://www.kaggle.com/datasets/vishakhdapat/customer-segmentation-clustering. El conjunto de datos comprendía 2.240 registros de clientes y 29 variables, cuyas descripciones se detallan en la Tabla 1.
Tabla 1. Descripción de las variables de la base de datos
| Nombre de la Variable | Descripción |
|---|---|
| ID | Identificador único para cada individuo de la base de datos |
| Año_Nacimiento | Año de nacimiento de cada individuo |
| Educación | Máximo nivel de educación alcanzado por el individuo |
| Estado Civil | Estado civil del individuo |
| Ingresos | Renta anual del individuo |
| Kidhome | Número de niños en el hogar |
| Teenhome | Número de adolescentes en el hogar |
| Dt_Customer | Fecha en la que el cliente fue registrado en la base de datos de la empresa |
| Recencia | Número de días desde la última compra o interacción |
| MntWines | Gasto en vinos |
| MntFruits | Valor gastado en frutas |
| MntMeatProducts | Gasto en carnes |
| MntFishProducts | Gasto en peces |
| MntSweetProducts | Valor gastado en dulces |
| MntGoldProds | Gasto en productos especiales |
| NumDealsPurchases | Número de compras realizadas con descuento |
| NumWebCompras | Número de compras realizadas por el sitio web de la empresa |
| NumCatalogPurchases | Número de compras realizadas por medio de catálogos |
| NumComprasTienda | Número de compras realizadas en tiendas físicas |
| Número de Visitas Web al Mes | Número de visitas al sitio web de la empresa en un mes |
| AcceptedCmp1 | Indicador binario (1 = sí, 0 = no) si el individuo aceptó la primera campaña de marketing |
| AcceptedCmp2 | Indicador binario (1 = sí, 0 = no) si el individuo aceptó la segunda campaña de marketing |
| AcceptedCmp3 | Indicador binario (1 = sí, 0 = no) si el individuo aceptó la tercera campaña de marketing |
| AcceptedCmp4 | Indicador binario (1 = sí, 0 = no) si el individuo aceptó la cuarta campaña de marketing |
| AcceptedCmp5 | Indicador binario (1 = sí, 0 = no) si el individuo aceptó la quinta campaña de marketing |
| Quejarse | Indicador binario (1 = sí, 0 = no) si el individuo presentó una queja |
| Z_CostContact | Costo constante asociado al contacto con un cliente |
| Z_Revenue | Una tasa constante asociada con una respuesta exitosa de la campaña |
| Respuesta | Indicador binario (1 = sí, 0 = no) si el individuo respondió a la campaña de marketing |
| Z_Revenue | Una tasa constante asociada con una respuesta exitosa de la campaña |
| Respuesta | Indicador binario (1 = sí, 0 = no) si el individuo respondió a la campaña de marketing |
Fuente: Datos originales de la investigación
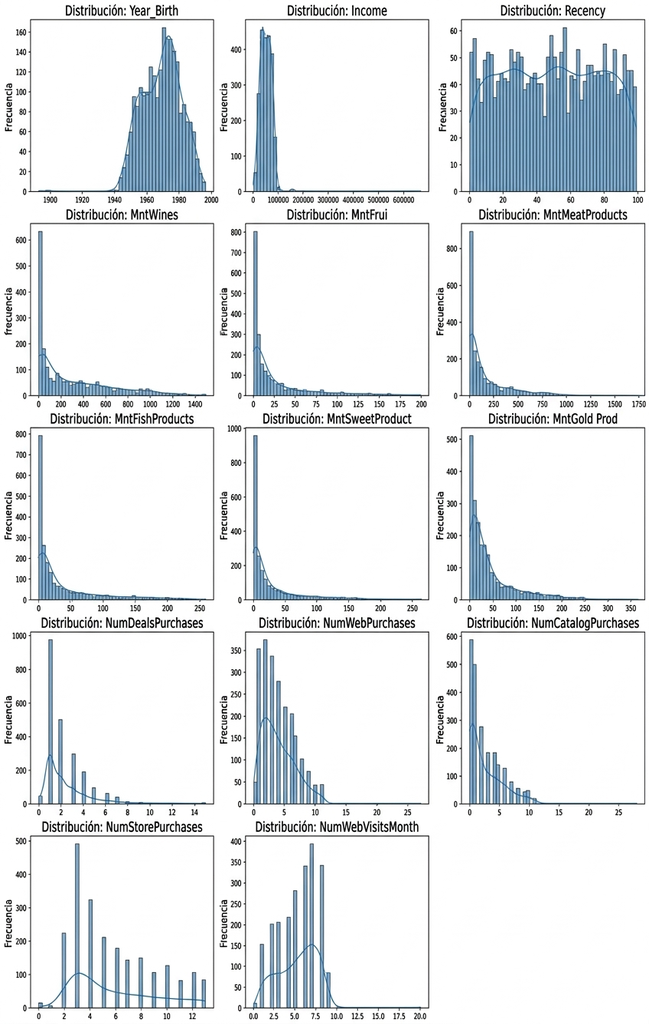
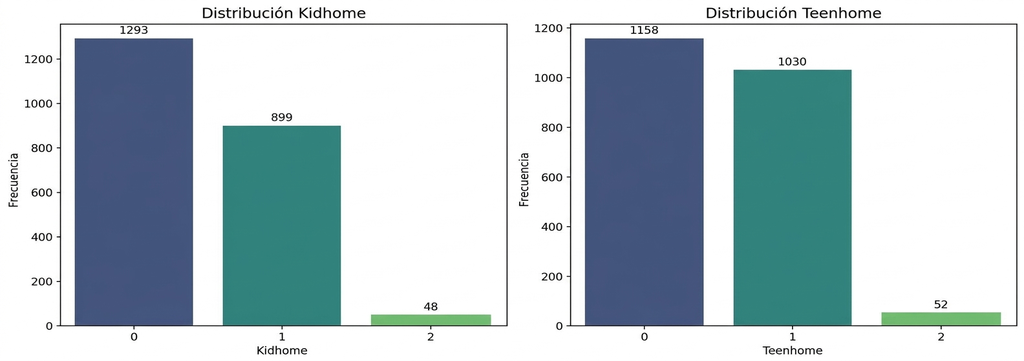
En la etapa de análisis y preparación de los datos, se realizó un análisis exploratorio para identificar la estructura y distribución de las variables, así como la presencia de valores atípicos, valores faltantes o inconsistencias. Las variables numéricas continuas, como “Income”, “Recency” y “MntWines”, se analizaron en cuanto a su distribución y necesidad de normalización, con la visualización de histogramas y estimación de densidad (Figura 1). Las variables numéricas discretas, como “Kidhome” y “Teenhome”, se analizaron por la distribución de frecuencia, presentada en gráfico de barras (Figura 2).
Figura 1: Histograma con la distribución de las variables numéricas continuas
Fuente: Datos originales de la investigación
Figura 2: Frecuencia de niños y adolescentes en casa
Fuente: Datos originales de la investigación
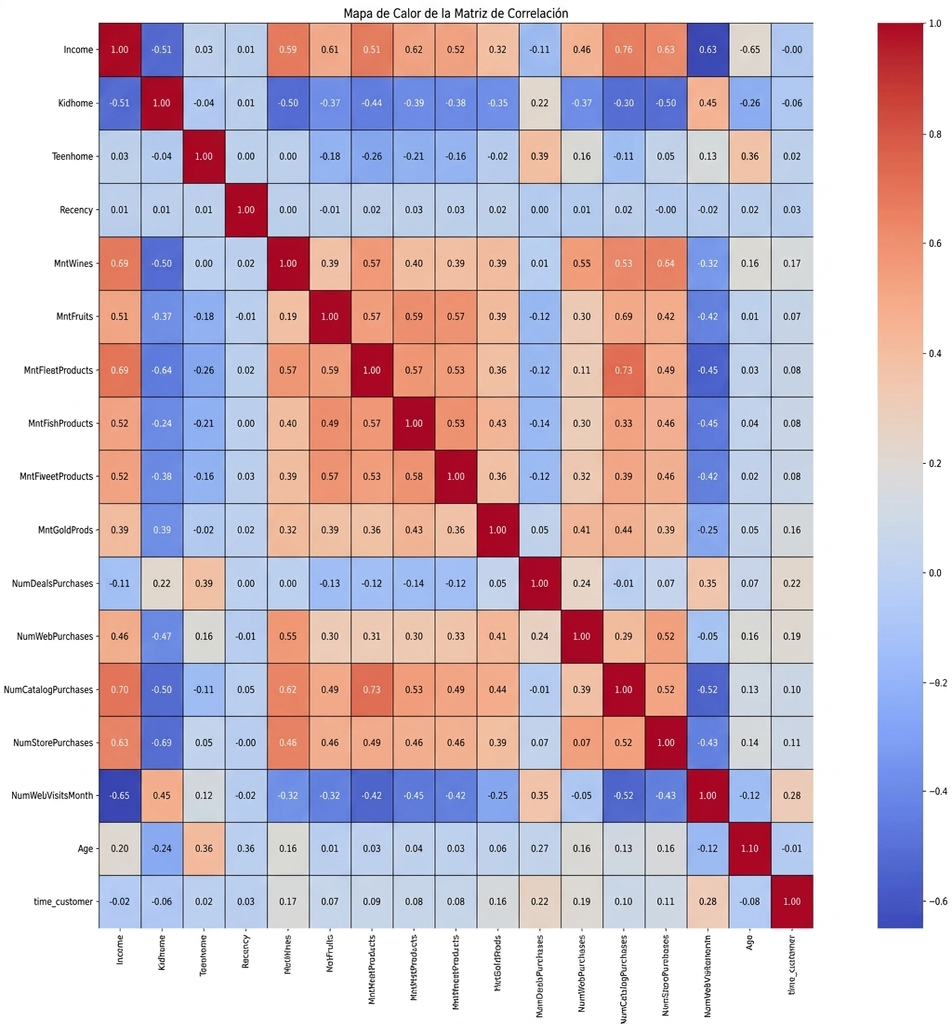
El preprocesamiento de los datos se realizó utilizando el lenguaje de programación Python y las bibliotecas Pandas, Numpy, Matplotlib y Seaborn. Se excluyeron 24 observaciones con valores faltantes para la variable “Income”. Las variables “AcceptedCmp1” a “AcceptedCmp5”, “Z_CostContact”, “Z_Revenue”, “Response” y “Complain” se eliminaron por no agregar información relevante para la segmentación. Se identificaron y eliminaron valores atípicos de las variables “Income” (1 individuo) y “Year_Birth” (3 individuos). La variable “Year_Birth” se transformó en “Age” (restando el año de nacimiento de 2014, año de referencia del último registro de cliente) y la variable “Dt_Customer” se convirtió en “time_customer” (días transcurridos desde la fecha más reciente), eliminándose las variables originales. Las variables categóricas también se eliminaron para garantizar la compatibilidad con la estandarización y la formación de los clústeres. Las 17 variables numéricas restantes, que incluían información conductual y demográfica, se escalaron mediante el método Z-score (“Standard Scaler”). Se realizó un análisis de correlación entre estas variables para identificar redundancias (Figura 3). La idoneidad de los datos para la reducción de dimensionalidad se confirmó mediante las pruebas Kaiser-Meyer-Olkin (KMO = 0.882; p < 0.05) y de Esfericidad de Bartlett (p = 0.0000).
Figura 3. Mapa de Calor de la matriz de correlación entre las variables del conjunto de datos
Fuente: Datos originales de la investigación
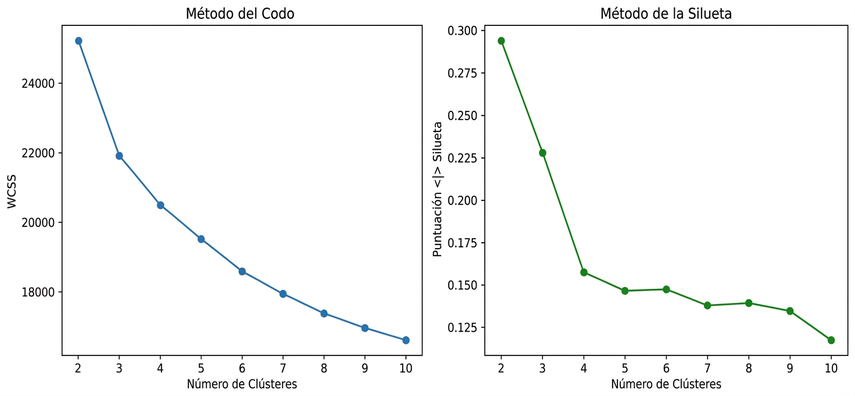
En el desarrollo del algoritmo, se aplicó el Análisis de Componentes Principales (PCA), que redujo las 17 variables a 14 componentes, manteniendo el 96,28% de la varianza explicada de la estructura original de los datos. Para predeterminar el número óptimo de agrupaciones, se utilizaron el método del codo (“Elbow”) para medir la inercia intraclúster y el método de silueta (“Silhouette Score”) para evaluar la calidad de la separación de los grupos. Las pruebas indicaron 3 y 2 clústeres, respectivamente (Figura 4), y se optó por 3 clústeres para permitir una identificación más detallada de los perfiles conductuales sin generar una separación artificial.
Figura 4. Comprobación del número óptimo de “clusters” – “Elbow” (azul) y “Silhouette” (verde)
Fuente: Datos originales de la investigación
Para el análisis de los clústeres formados, se evaluó la influencia de cada variable en la formación del agrupamiento mediante el Análisis de Varianza (ANOVA) aplicado a los datos no estandarizados. El valor F (“F-value”) se utilizó como indicativo de la discriminación de las variables entre los clústeres, y el tamaño del efecto (η²) para cuantificar la magnitud de esta diferencia.
3. Resultados y Discusión
El análisis del conjunto de datos reveló la viabilidad de segmentar clientes e identificar comportamientos específicos que pueden ayudar en la orientación de campañas de marketing. Este estudio demostró la aplicación de técnicas de aprendizaje automático no supervisado, con enfoque en el algoritmo K-Means, para agrupar consumidores basándose en características demográficas y comportamentales. Las etapas de preprocesamiento, reducción dimensional y validación fueron cruciales para la construcción de perfiles de consumo distintos y consistentes, proporcionando una base sólida para la interpretación de los hallazgos.
La etapa inicial de análisis y preparación de datos implicó la exploración de los datos brutos para identificar su estructura, distribución de variables y la presencia de valores atípicos o inconsistencias. Variables numéricas continuas como “Income”, “Recency” y “MntWines” fueron examinadas en cuanto a su distribución y necesidad de normalización. La visualización de estas distribuciones, como se ilustra en los histogramas de la Figura 5, permitió comprender la magnitud diferenciada de cada categoría y la presencia de colas largas, lo que indica la necesidad de estandarización antes de la aplicación de los algoritmos de clusterización.
Figura 5. Visualización 2D del “clustering” usando el Análisis de Componente Principal (PCA)
Fuente: Datos originales de la investigación
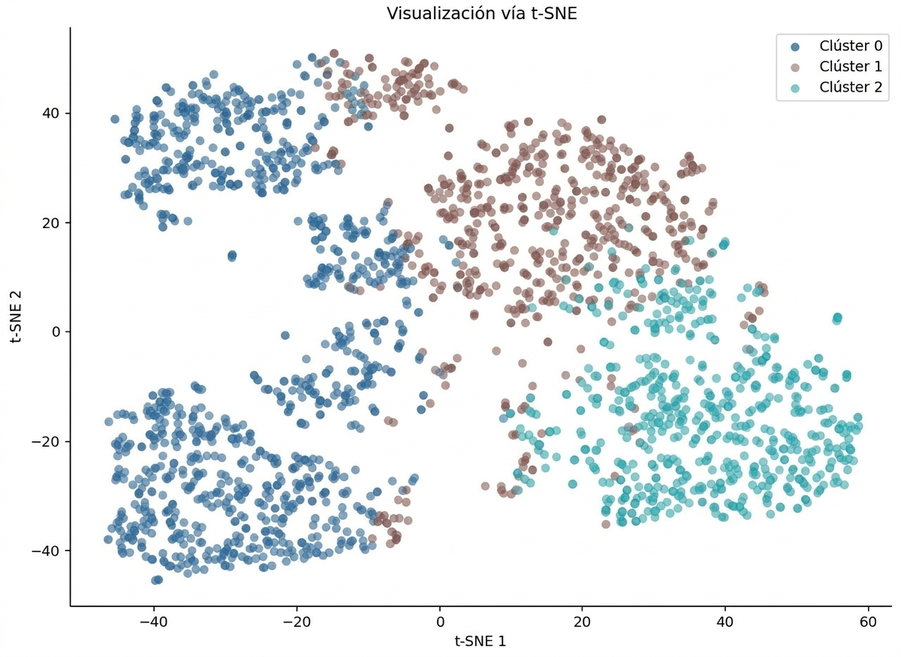
Complementario al PCA, se realizó una segunda representación 2D de los datos con el “t Distributed Stochastic Neighbor Embedding” (t-SNE) con el objetivo de observar la preservación de la relación entre los puntos locales y verificar la consistencia de la segmentación
propuesta por el “K-Means” y clústeres más definidos, teniendo información sobre la diversidad dentro de los grupos más grandes (Figura 6).
Figura 6. Visualización del agrupamiento usando la técnica “t-Distributed Stochastic Neighbor Embedding” (t-SNE)
Fuente: Datos originales de la investigación
Análisis del perfil de los clústeres y de la estrategia de segmentación
En este trabajo, el dataset original fue tratado para identificar perfiles de consumidores a partir de patrones de consumo y estructura familiar. Tras etapas de tratamiento, escalado, reducción dimensional, elección del número de grupos, aplicación del K-Means y análisis estadístico, se identificaron tres agrupaciones principales: cluster 0, denominado Clientes Económicos; cluster 1, Clientes Moderados; y cluster 2, Clientes Élite.
El análisis reforzó la relevancia de la segmentación para el marketing, especialmente en contextos de retail, e-commerce y librerías, donde el K-Means se utiliza ampliamente para apoyar la orientación de campañas (Farhan et al., 2024; Tabianan et al., 2022). Las etapas de preprocesamiento contribuyeron a una separación más coherente de los grupos, aspecto también observado en estudios sobre optimización de clusterings y uso de enfoques híbridos asociados al K-Means (Juhari et al., 2022; Mulyono et al., 2023; Wang, 2025).
Aunque la agrupación utilizó solo K-Means, la separación de los clústeres basada en el comportamiento de compra, los ingresos y la estructura familiar resultó coherente con la literatura. Los estudios indican que los ingresos, el gasto en alimentos, el consumo de artículos de mayor valor y la interacción a través de canales de compra son variables relevantes para caracterizar perfiles de consumidores e identificar segmentos de mayor valor económico, como clientes premium (Reutterer y Dan, 2019; Tavor et al., 2023; Song, 2025; Thach y Olsen, 2015).
Además del K-Means, el estudio asoció PCA y t-SNE para apoyar la visualización de los agrupamientos y refinar la identificación de posibles subgrupos. Estas estrategias contribuyen a mapear tendencias de consumo menos evidentes, favoreciendo una lectura más detallada de los patrones de comportamiento, como también se observó en investigaciones orientadas al e-commerce y al marketing digital (Khan et al., 2023).
La literatura muestra que la segmentación basada en aprendizaje automático puede apoyar campañas más dirigidas, reducir el desperdicio presupuestario y mejorar la idoneidad de productos y servicios para audiencias distintas (Clarke et al., 2024; Dolnikar et al., 2013; Cortez et al., 2021). Estudios en sectores como banca, moda y minorista también indican una asociación entre segmentación, satisfacción del cliente, rentabilidad y aumento de las ventas (Francis Osei et al., 2021; Nurpazi et al., 2024; Fahed Yoseph et al., 2020).
En este contexto, el protocolo propuesto favorece mejoras analíticas y estratégicas al permitir el procesamiento automatizado de grandes volúmenes de datos, la identificación de patrones de consumo y la definición de grupos más precisos. La comparación presentada en la Tabla 2 sintetiza las ganancias esperadas en cuatro dimensiones: precisión de la segmentación, personalización de las campañas, reducción del tiempo de análisis y escalabilidad del proceso.
Tabla 2. Comparación de los principales parámetros para la aplicación del modelo propuesto
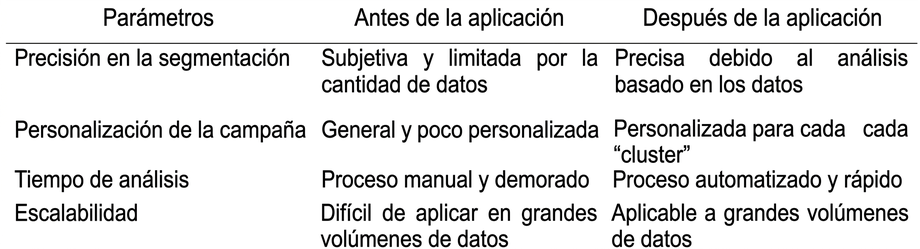
Por lo tanto, la implementación del protocolo de agrupación contribuye a que el desarrollo de campañas sea más eficiente y dirigido. Al segmentar clientes por perfiles socioeconómicos, comportamentales, de género y edad, el modelo apoya decisiones de marketing basadas en datos y posibilita una mayor personalización de las estrategias para cada clúster.
4. Conclusión
El presente estudio buscó elaborar un protocolo de análisis de datos para dirigir estrategias de marketing, utilizando segmentación de consumidores por medio de aprendizaje automático no supervisado, con base en variables demográficas y comportamentales. Para ello, se implementó el algoritmo K-Means, tras un preprocesamiento riguroso del conjunto de datos que incluyó tratamiento de variables, exclusión de datos faltantes, escalado, estandarización y reducción de dimensionalidad por Análisis de Componentes Principales. Se verificó la formación de tres agrupamientos de consumidores, cuya robustez y consistencia fueron validadas por técnicas de visualización bidimensional. Se identificó el perfil de los Clientes Económicos, caracterizados por ser más jóvenes, con menor renta y consumo, y mayor número de hijos. Los Clientes Moderados presentaron edad más elevada, renta y consumo equilibrados. Por su parte, los Clientes Élite se destacaron por la alta renta, elevado consumo de productos sofisticados y menor número de hijos. La renta fue el atributo con mayor poder discriminatorio entre los clusters, seguida por los gastos con carne y el número de compras por catálogo. La principal contribución de este trabajo reside en la demostración de que la aplicación de un protocolo de análisis de datos basado en aprendizaje automático optimiza significativamente el desempeño y el alcance de las iniciativas de marketing, al permitir una segmentación de mercado más precisa y personalizada.
El protocolo de análisis implementado demostró mejoras significativas en comparación con enfoques tradicionales, al mejorar la precisión en la segmentación, permitir la personalización de campañas, reducir el tiempo de análisis y conferir escalabilidad para grandes volúmenes de datos. Este enfoque basado en datos permite que las estrategias de marketing sean más asertivas y eficientes, evitando desperdicios presupuestarios. Sin embargo, se reconoce como limitación de este estudio el uso de una única base de datos. Para futuras investigaciones, se sugiere la aplicación de este protocolo de análisis en conjuntos de datos de casos reales, con la inclusión de la medición de la respuesta de la campaña y de los ingresos generados para el cliente, a fin de validar aún más su eficacia y aplicabilidad en diferentes contextos de mercado.
Referencias Bibliográficas
Cortez, R.; Clarke, A.; Freytag, P.. 2021. B2B market segmentation: a systematic review and research Journal of Business
https://doi.org/10.1016/j.jbusres.2020.12.070.
DataReportal. 2025. Digital 2025: Global Overview Report. Disponível em: https://datareportal.com/reports/digital-2025-global-overview-report. Acesso em: 09 mar. 2025.
Kotler, P.. 1999. Marketing para o século XXI: como criar, conquistar e dominar mercados. São Paulo: Futura, 1999.
Kotler, P.; Keller, K. L.. 2012. Administração de Marketing. 14ed. Pearson Education do Brasil. São Paulo, SP, Brasil.
Lopes, I.J. 2005. A Segmentação de Mercado como Estratégia de Marketing. Geo Cities. Disponível em: http://www.geocities.com/Eureka/2471/segmerca.html. Acesso em: 23 mar. 2025.
Shirole R, Salokhe L., Jadhav S. 2021. Customer Segmentation using RFM Model and “K-Means” Clustering. International Journal of Scientific Research in Science and Technology 8 (3), 591-597.
Smith, W.R. 1956. Product Differentiation and Market Segmentation as Alternative Marketing Strategies. Journal of Marketing, 21(1), 3-8.
Toledo, G. L. 1972. Segmentação de mercado e estratégia de marketing. Tese de Doutorado em Administração de Empresas. Faculdade de Economia, Administração e Contabilidade, Universidade de São Paulo, SP, Brasil.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haga clic aquí y acceda a la plataforma MBX Academy