
15 de septiembre de 2026
Previsión de la Potencia Radiativa de Incendios Forestales en Brasil
João Pedro Granzotto Campos; Lauro Marques Vicari
DOI: 10.22167/2675-6528-202602238
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
Este estudio investigó los determinantes climáticos y de uso del suelo que impulsan la intensidad de los incendios, medida por la Potencia Radiativa del Fuego (FRP). La investigación combinó inferencia estadística clásica, a través de un modelo econométrico de datos de panel con Efectos Fijos, y modelado predictivo avanzado utilizando el algoritmo Random Forest. Los resultados del modelo econométrico revelaron que el índice de deforestación ejerció el mayor impacto positivo y estructural en la intensidad del fuego, mientras que las áreas de agricultura, pastoreo y silvicultura no presentaron significancia estadística. El modelo Random Forest, optimizado vía Grid Search con validación cruzada, explicó el 36,26% de la varianza predictiva del fenómeno. Presentó un Error Medio Absoluto (MAE) de 0,62 en escala logarítmica, indicando robustez en las predicciones. El análisis de interpretabilidad con valores SHAP confirmó el protagonismo de la dinámica atmosférica, con la humedad relativa del aire como principal factor de mitigación de incendios y la temperatura máxima y el número de días sin lluvia como mayores catalizadores. Se concluyó que los incendios de alta severidad resultan de la superposición de extremos macroclimáticos combinados a la disponibilidad de combustible oriundo de la deforestación reciente.
Palabras clave: Econometría de Panel; Machine Learning; Potencia Radiativa del Fuego; Random Forest; Valores SHAP.
1. Introducción
Las quemas y los incendios forestales representan un desafío ambiental y socioeconómico significativo para Brasil, con impactos anuales sobre extensas áreas de sus biomas. Datos del Instituto Nacional de Investigaciones Espaciales (INPE) indican que, en 2024, se registraron 278.299 focos de incendio en el país, un aumento del 46,5% en relación con el año anterior. La Amazonía y el Cerrado figuran como los biomas más afectados (CNN Brasil, 2025). Este escenario es influenciado por una combinación de factores, como períodos de sequía prolongada, prácticas inadecuadas de manejo del suelo y la deforestación, que pueden aumentar la vulnerabilidad de los bosques a la propagación del fuego (Nobre et al., 2016).
Las consecuencias de un incendio forestal abarcan severas alteraciones en el ecosistema. En el medio físico, se observa la erosión, la reducción de la materia orgánica del suelo y la liberación de carbono a la atmósfera. En el medio biótico, los impactos se manifiestan en la muerte de animales y la destrucción de sus hábitats, afectando todo el proceso de sucesión ecológica (Guimarães et al., 2014).
En este contexto, la cuantificación de la intensidad y la energía liberada por un incendio es crucial para su monitoreo y manejo eficaz. Una de las métricas ampliamente utilizadas para este fin es la Potencia Radiativa del Fuego (FRP), definida como la tasa de energía radiativa emitida por un incendio, medida en Watts (Wooster et al., 2005). La medición de la FRP, realizada por sensores de satélite, tiene una correlación directa con la tasa de consumo de biomasa por el fuego, permitiendo evaluar la intensidad de un incendio y estimar la cantidad de biomasa consumida y, consecuentemente, las emisiones de contaminantes a la atmósfera (Roberts et al., 2005).
La aplicación de la FRP en la gestión de incendios es diversa. La información sobre la intensidad del fuego puede ser utilizada en la asignación de recursos de combate, permitiendo que los equipos prioricen los frentes de fuego con mayor liberación de energía. El análisis de la FRP también puede ser empleado en la evaluación de daños potenciales a la vegetación, en el soporte a planes de evacuación de áreas de riesgo y en la formulación de políticas de prevención y manejo del fuego. La previsibilidad de quemas e incendios es, por lo tanto, fundamental para la acción del poder público, visando la mitigación de los daños y acciones preventivas (Viganó et al., 2017).
La estimación de la FRP es una tarea compleja, ya que depende de múltiples variables dinámicas, como las condiciones meteorológicas (temperatura, humedad, viento), las características de la vegetación (tipo, densidad, humedad del combustible) y la topografía (Wooster et al., 2005; Roberts et al., 2005; Viganó et al., 2017). En este escenario, las técnicas de aprendizaje automático (machine learning) presentan un potencial significativo para el desarrollo de modelos predictivos, diseñados para identificar patrones y relaciones en grandes conjuntos de datos (Juvanhol et al., 2023). Estos modelos pueden ser utilizados para analizar el comportamiento de los incendios forestales y permitir una previsibilidad del riesgo y el impacto de las variables sobre los eventos, incluyendo modelos de regresión, redes neuronales y árboles de decisión (Viganó et al., 2017; Juvanhol et al., 2023).
La aplicación de estas técnicas, específicamente para la predicción de la FRP, es un campo de investigación en desarrollo. Al entrenar algoritmos con datos históricos de focos de incendio, variables meteorológicas y otra información geoespacial, se busca desarrollar modelos predictivos robustos. Aunque existen estudios basados en aprendizaje automático enfocados en regiones específicas de América Latina, la presente investigación se diferencia al actuar en la extensión del territorio brasileño.
La problemática que este trabajo busca abordar es la posibilidad de estimar la intensidad de un incendio, representada por la FRP, a través de un conjunto de variables descriptivas y modelos de aprendizaje automático. La investigación se basa en la necesidad de desarrollar herramientas cuantitativas para la gestión de quemas en Brasil, aplicando la ciencia de datos para el análisis de un relevante desafío ambiental del país, esperando proporcionar una herramienta de apoyo a la decisión para los órganos de gestión ambiental y defensa civil. El objetivo general es el desarrollo de un modelo de aprendizaje automático para estimar la Potencia Radiativa del Fuego (FRP) de focos de incendio en Brasil, a partir de datos del Instituto Nacional de Investigaciones Espaciales (INPE) y de variables ambientales complementarias, identificando las variables de mayor importancia para la determinación de la FRP.
2. Material y Métodos
El estudio adoptó un enfoque cuantitativo y explicativo, con un diseño centrado en la implementación de algoritmos de machine learning. La instrumentación se basó en investigación documental, utilizando registros oficiales del INPE como fuente de datos.
Recopilación de datos
La recopilación de datos se realizó entre 2019 y 2023, utilizando el catálogo de focos de incendio del INPE como base principal. Esta base proporcionó información sobre latitud, longitud, fecha, satélite, estado, municipio, bioma, número de días sin lluvia, riesgo de incendio y Potencia Radiativa del Fogo (FRP).
Para enriquecer el análisis, se incorporaron bases de datos auxiliares. El proyecto PRODES (Base auxiliar 1) aportó datos anualizados de deforestación e hidrografía por municipio y bioma. La base del IBGE (Base auxiliar 1.1) se utilizó para fusionar datos, conteniendo identificadores y nombres de municipios y estados. MapBiomas (Base auxiliar 2) proporcionó información anualizada sobre cobertura del suelo, incluyendo áreas de agricultura, pastizal y silvicultura por estado, municipio, bioma y año.
Se recopilaron datos meteorológicos diarios a través de la API de NASA Power (Base auxiliar 3), que abarcan latitud, longitud, año, fecha, temperatura media y máxima, humedad relativa, velocidad del viento, precipitación y humedad del suelo. Para optimizar la recopilación, las coordenadas de latitud y longitud de la base principal se redondearon en intervalos de 0,5°, agrupando las localidades en una cuadrícula de aproximadamente 55 km.
Estructuración de los Datos
La estructuración de los datos implicó la fusión de las bases auxiliares con la base principal. Inicialmente, las claves de fusión se estandarizaron en tipo de datos. La base principal tuvo la columna “Fecha” convertida a formato de fecha, latitud y longitud redondeadas a 0,5°, y se crearon columnas de año y mes. Las bases auxiliares 1, 1.1 y 2 se conectaron a la base principal utilizando uniones internas basadas en columnas como año, bioma, municipio, estado e ID del municipio. La base auxiliar 3 se conectó a la base principal mediante latitud (redondeada), longitud (redondeada) y fecha.
Debido a las diferentes granularidades, la base principal (foco de incendio individual) se combinó con las bases auxiliares 1 y 2 (resolución macroespacial por municipio y bioma) y con la base auxiliar 3 (mayor precisión espacio-temporal por fecha y coordenadas).
Preprocesamiento y Preparación de Datos
La etapa de preprocesamiento y preparación de datos incluyó el tratamiento de datos faltantes, eliminando observaciones con valores nulos o códigos de error (-999) en las variables “número de días sin lluvia”, “riesgo de fuego” y FRP. Se realizó ingeniería de atributos, creando índices de Deforestación, Hidrografía, Pastizal, Agricultura y Silvicultura, calculados como la razón entre el área específica y el área total del bioma en el municipio.
La variable dependiente, FRP, que presentaba una distribución asimétrica, fue transformada utilizando el logaritmo natural para mitigar la varianza y la influencia de valores extremos, según la ecuación:
ln(FRP) = ln (FRPit + 1)
donde se añadió la constante 1 para evitar la indefinición en valores nulos o cercanos a cero (Shumway y Stoffer, 2017; Wooldridge, 2010).
Se limpiaron o limitaron datos inválidos, como la ocupación del suelo superior al área total o porcentajes superiores al 100%. El filtrado de datos seleccionó solo registros del satélite AQUA M-T, siguiendo la recomendación del INPE (2025). Finalmente, los datos se agregaron en formato de panel, utilizando una clave primaria de municipio, estado y bioma, para capturar la dinámica histórica y las variaciones climáticas. Las variables se agregaron por media aritmética (para FRP transformado y no transformado, precipitación, riesgo de incendio, índices de deforestación, pastos, silvicultura, agricultura, velocidad del viento, humedad relativa, temperatura media, humedad del suelo e hidrografía), por máximo (para días sin lluvia y temperatura máxima del día), y por suma y conteo (para FRP no transformado y focos).
El resultado de la estructuración de los datos consistió en dos bases: una en formato de panel (agregada por municipio, bioma, año y mes) para el modelo econométrico, y otra a nivel de eventos (resolución original de foco de incendio individual) para el análisis exploratorio y el modelo Random Forest.
Análisis exploratorio de los datos
El análisis exploratorio de los datos buscó comprender la estructura de las variables, patrones de distribución y validar premisas para la modelización. Incluyó estadísticas descriptivas (media, desviación estándar, mediana), análisis temporal y de estacionalidad de la cantidad de focos de incendio, distribución de la variable dependiente tras transformación logarítmica y análisis de correlación entre los datos.
Correlación entre variables
La multicolinealidad entre las variables explicativas fue evaluada por la Prueba de Inflación de la Varianza (VIF), calculada como VIFi = 1 / (1-R²), donde R² es el coeficiente de determinación de la regresión de la variable predictora i contra las demás (Hair et al., 2009). Para mitigar este problema, las variables “temperatura media” y “humedad del suelo” fueron eliminadas, manteniendo “temperatura máxima” y “humedad relativa”. También se aplicó una matriz de correlación de Pearson para identificar patrones de asociación entre las variables climáticas y la intensidad del fuego.
Desarrollo y Entrenamiento de los Modelos Predictivos
Para la predicción de la intensidad de las quemas (logaritmo de la FRP), se utilizó un enfoque híbrido, combinando modelos econométricos basados en panel con un algoritmo de machine learning supervisado. Los datos se dividieron en 80% para entrenamiento y 20% para prueba y validación. La implementación se realizó en Python, utilizando las bibliotecas Pandas para manipulación de datos, Scikit-learn para machine learning y Linearmodels para análisis en panel.
Regresión con Datos de Panel (Efectos Fijos)
Para la regresión, se utilizó un modelo de Datos de Panel con Efectos Fijos, que considera la estructura longitudinal y transversal de los datos (Wooldridge, 2010). La elección del estimador de Efectos Fijos se justificó por la prueba de Hausman, que evalúa la consistencia de los estimadores. La estadística de la prueba se calcula por m = q’V(9)¯¹9, donde ĝ es la diferencia entre los coeficientes (Fijos – Aleatorios) y V(ĝ) es la varianza de esa diferencia. El rechazo de la hipótesis nula de la prueba de Hausman (Hausman, 1978) indicó la preferencia por el modelo de Efectos Fijos. La ecuación general del modelo es:
Yit = β₀ + β₁Xit + … + βkXkit + αi + Uit
donde Yit es el logaritmo del FRP en el municipio i en el mes t, Xit son las variables explicativas (Precipitación, Riesgo de Fuego, etc.), β son los coeficientes, αi es el efecto fijo de cada municipio y Uit es el término de error (Wooldridge, 2010).
Árboles de decisión y Random Forest Regressor
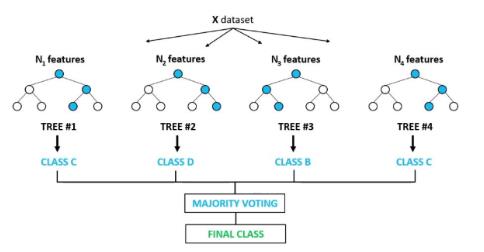
El modelo de Random Forest se empleó como algoritmo de machine learning supervisado para regresión, debido a su robustez y capacidad para modelar interacciones no lineales. Este algoritmo de ensemble construye un “bosque” de árboles de decisión, donde la predicción final es la media de los resultados de los árboles individuales (Breiman, 2001). La arquitectura de Random Forest se basa en Bagging (Bootstrap Aggregating), que crea múltiples muestras de entrenamiento aleatorias con reemplazo para entrenar cada árbol, y Selección Aleatoria de Features, donde un subconjunto aleatorio de variables explicativas se considera en cada división del nodo del árbol. El proceso se ilustra en la Figura 1.
Figura 1. Diagrama del modelo “Random Forest”
Fuente: David (2020)
Optimización de hiperparámetros (“Grid Search”)
La optimización de los hiperparámetros del modelo Random Forest se realizó utilizando la técnica de Grid Search con validación cruzada, con el objetivo de maximizar la capacidad predictiva y mitigar el sobreajuste (Kuhn y Johnson, 2013). Los hiperparámetros optimizados incluyeron: número de estimadores (cantidad de árboles), profundidad máxima (límite de crecimiento de los árboles), features máximas (número de variables explicativas sorteadas por nodo), muestras mínimas para el nodo (mínimo de observaciones para subdivisión) y muestras mínimas para la hoja (mínimo de eventos en nodo final).
La mejor combinación de hiperparámetros se definió basándose en el estimador MAE y la validación cruzada de 3 partes, lo que resultó en una profundidad máxima de 25, features máximas con Raíz Cuadrada, muestras mínimas para el nodo de 2, muestras mínimas para la hoja de 1 y 300 estimadores.
Evaluación de los modelos
La evaluación del rendimiento predictivo de los modelos se realizó en la muestra de prueba (20% de los datos). Las métricas estadísticas utilizadas para la selección del mejor modelo fueron el Coeficiente de Determinación (R²), la Raíz del Error Cuadrático Medio (RMSE) y el Error Absoluto Medio (MAE), todas reflejando la precisión en la escala logarítmica de la variable dependiente (ln(FRP + 1)).
El R² cuantifica la proporción de la variabilidad de la variable dependiente explicada por el modelo, calculado como:
R² = SSR/SST = 1 – SSRes/SST
donde SSR es la Suma de Cuadrados de la Regresión, SST es la Suma de Cuadrados Total y SSRes es la Suma de Cuadrados de los Residuos (Montgomery, Peck y Vining, 2012).
El RMSE mide la magnitud promedio de los errores de predicción, representando la desviación estándar de los residuos, calculada por:
RMSE = sqrt( (1/n) * sum( (yi – y_hat_i)^2 ) )
donde n es el número de observaciones, yi es el valor real y y_hat_i es el valor predicho (Hastie, Tibshirani y Friedman, 2009).
El MAE mide la magnitud promedio de las diferencias absolutas entre las predicciones y los valores reales, y se calcula mediante:
MAE = (1/n) * sum( |yi – y_hat_i| )
El MAE es menos sensible a outliers que el RMSE (Hastie, Tibshirani y Friedman, 2009).
Análisis de Importancia de las Variables e inferencia
Para comprender los determinantes de la intensidad del fuego, se realizó un análisis interpretativo de las variables predictoras, utilizando técnicas específicas para cada modelo.
Interpretación en el Modelo Econométrico (Panel)
En el modelo econométrico de Regresión con Datos de Panel, la importancia de las variables fue evaluada por la significancia estadística y la magnitud de los coeficientes, utilizando la Prueba t de Student (Wooldridge, 2020). Los coeficientes fueron interpretados en términos de elasticidad o semi-elasticidad, indicando el impacto marginal y la dirección de la relación (+/-) con la FRP.
Se aplicaron pruebas de diagnóstico para validar las inferencias estadísticas. La normalidad de los residuos se evaluó mediante la prueba de Jarque-Bera (Jarque y Bera, 1980), y la varianza constante mediante la prueba de Breusch-Pagan (Breusch y Pagan, 1979). Para corregir la heterocedasticidad diagnosticada, la estimación final del modelo utilizó Errores Estándar Robustos Agrupados (Wooldridge, 2020).
Interpretación en el Modelo de “Machine Learning” (“Random Forest”)
En el algoritmo Random Forest, la importancia de las variables se midió mediante la métrica de reducción media de la varianza, que calcula la suma total de la reducción del error proporcionada por cada variable a lo largo de los árboles del bosque (Hastie, Tibshirani y Friedman, 2009). Para complementar, se incorporó el análisis de Valores SHAP (Shapley, 1953; Lundberg y Lee, 2017) para cuantificar la contribución marginal de cada variable en la predicción individual e identificar la direccionalidad de los efectos (positivos o negativos).
3. Resultados y Discusión
Análisis de la Distribución y Tratamiento de la Variable Objetivo (FRP)
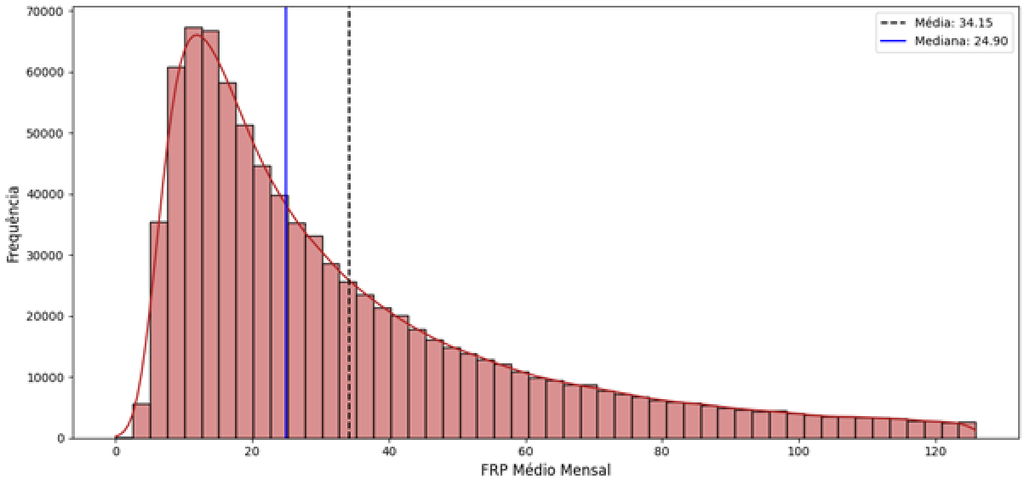
El análisis inicial de la variable Potencia Radiativa del Fuego (FRP) confirmó una alta asimetría en la distribución, con la mayoría de los registros concentrándose en valores bajos de energía. Una pequeña cantidad de eventos extremos, caracterizados por incendios de gran magnitud, desplazaba la media y elevaba la varianza, como se ilustra en la Figura 2.
Figura 2. Distribución de la Intensidad Media (FRP)
Fuente: resultados originales de la investigación
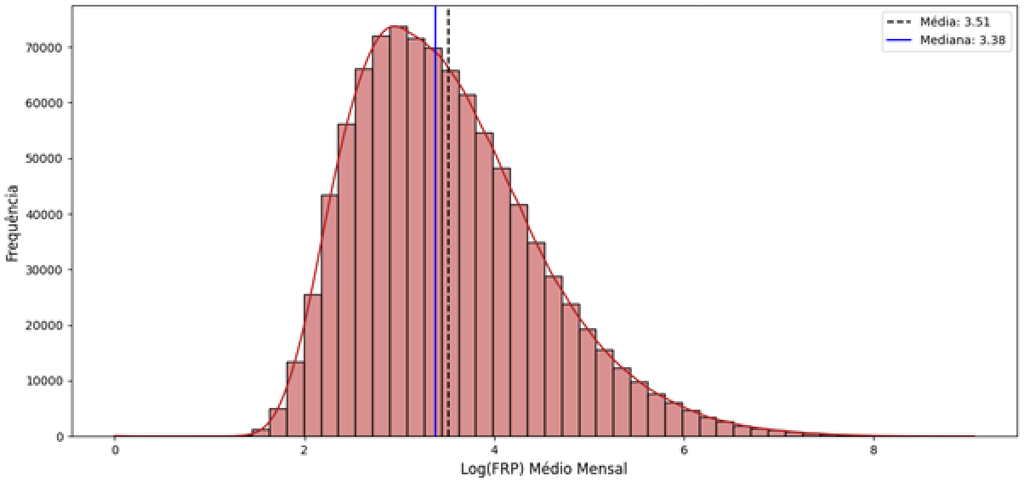
Para mitigar esta asimetría y estabilizar la varianza, se aplicó la transformación logarítmica natural (ln(FRP + 1)). Este enfoque demostró ser eficaz al reducir significativamente la amplitud de variación y la influencia desproporcionada de valores extremos, permitiendo la inclusión de observaciones de alta magnitud en el modelo sin necesidad de exclusión, como muestra la Figura 3.
Figura 3. Distribución de la Intensidad Media (Log FRP)
Fuente: resultados originales de la investigación
Correlaciones entre variables
La prueba de Inflación de la Varianza (VIF) indicó valores altos para la temperatura media y máxima, y moderados para la humedad relativa, la deforestación y la humedad del suelo. Para evitar la multicolinealidad, se eliminaron las variables de temperatura media y humedad del suelo, manteniendo la temperatura máxima y la humedad relativa para preservar información crucial sobre el pico de temperatura y las condiciones climáticas a corto plazo.
Tabla 1. Tabla VIF para variables
| Nombre de la variable | Unidad de medida | Clase | Descripción |
|---|---|---|---|
| Latitud | Grado | Decimal | Latitud en la que ocurrió el foco |
| Longitud | Grado | Decimal | Longitud en la que ocurrió el foco |
| Datos | Datos | Fecha/Hora | Fecha de registro Satélite que realizó el registro del foco |
| Satélite | Rotunda | Escrito | Nombre del Satélite que realizó el registro del foco |
| Condición | Rotunda | Escrito | Nombre del estado brasileño |
| Municipio | Rotunda | Escrito | Nombre del municipio |
| Ecosistema | Rotunda | Escrito | Nombre del bioma |
| Número de días sin lluvia | Días | Entero | Número de días sin lluvia hasta la detección del foco |
| Riesgo de incendio | Sin dimensiones | Decimal | Valor del Riesgo de Incendio previsto para el día de la detección del foco. |
| Potencia radiativa del fuego | MW | Decimal | La potencia del fuego detectado |
Fuente: resultados originales de la investigación
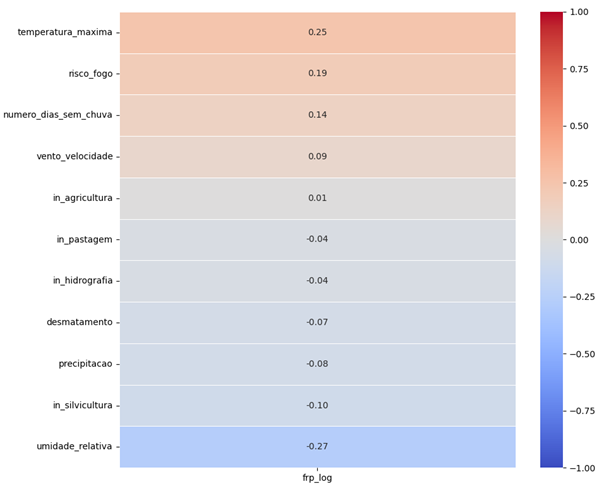
La matriz de correlación de Pearson reveló patrones de asociación entre las variables climáticas y la intensidad del fuego. Se observó que la Temperatura Máxima (0,25), el Riesgo de Fuego (0,19) y el Número de días sin lluvia (0,14) presentaron las mayores correlaciones positivas con la variable objetivo, sugiriendo que la severidad energética de un incendio está directamente ligada al pico de temperatura, al riesgo de incendio y al período de sequía. En contraste, la Humedad relativa (-0,27) demostró una correlación negativa, indicando ser un factor que contribuye a la disminución de la intensidad de los incendios, según la Figura 4.
Figura 4. Matriz de Correlación de Pearson
Fuente: resultados originales de la investigación
Dinámica temporal
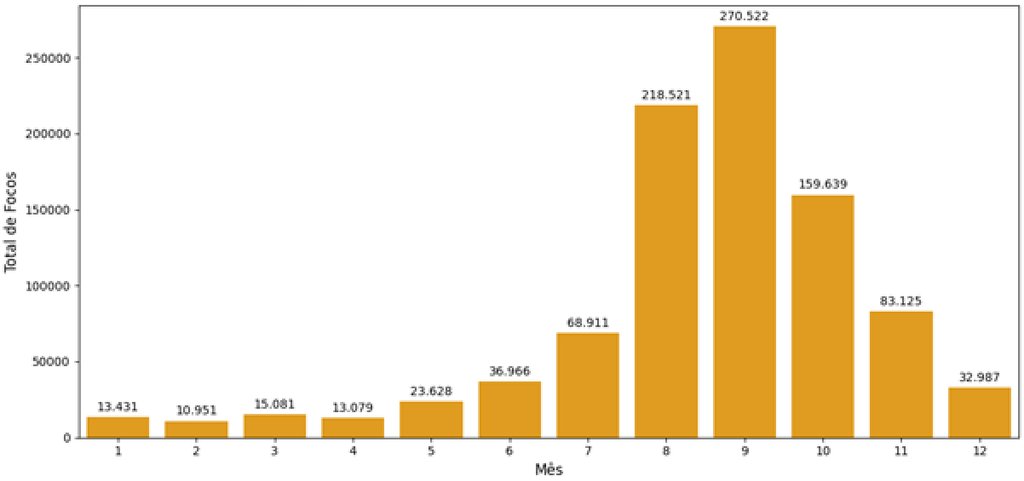
El análisis temporal identificó una estacionalidad expresiva en la ocurrencia de focos de incendio. Los niveles más bajos se observaron entre enero y abril, con un aumento a partir de mayo, alcanzando el pico en septiembre y disminuyendo a continuación. El período de agosto a octubre concentró la mayor parte de los focos, reforzando la relevancia del mes como una variable predictiva para el modelo Random Forest, como se ilustra en la Figura 5.
Figura 5. Estacionalidad: Distribución Total de Focos por Mes
Fuente: resultados originales de la investigación
Modelo Econométrico de Datos en Panel
La estimación del modelo econométrico de Efectos Fijos, que controló características no observables e invariantes en el tiempo, explicó el 18,41% (Rwithin= 0.1841) de la variabilidad interna de la intensidad del fuego (log FRP) en los paneles a lo largo del tiempo. Los coeficientes del modelo representan tasas de crecimiento porcentual, indicando el aumento porcentual en la FRP por cada unidad de aumento de la variable.
El análisis de los coeficientes, presentado en la Tabla 2, reveló que la dinámica atmosférica ejerce una influencia estadísticamente significativa (p < 0.01) sobre la intensidad del fuego. La temperatura máxima (0.0261) y la velocidad media del viento (0.0469) presentaron coeficientes positivos, indicando que picos de calor y vientos fuertes elevan la intensidad del fuego. La humedad relativa, por su parte, demostró una relación negativa (-0.0089) con la intensidad de las llamas. Esta dinámica corrobora estudios que señalan la combinación de factores térmicos, vientos fuertes y baja humedad como un ambiente propicio para la intensificación de incendios forestales (Nobre et al., 2016).
El coeficiente de deforestación (1.3612) fue el de mayor magnitud y significancia estadística (p < 0.01). Em contraste, os coeficientes para as áreas de pastagem, silvicultura e agricultura não apresentaram significância estatística (p > 0.05). Este hallazgo sugiere que la quema de “limpieza” en áreas de deforestación reciente consume combustibles pesados, liberando mayores cantidades de energía, mientras que las quemadas de manejo en pastos o agricultura, que consumen combustibles finos, liberan energía radiativa rápidamente, sin generar alteraciones estadísticas estructurales en el orden de magnitud del FRP municipal (Roberts et al., 2005). La prueba t de Student confirmó que todas las variables, con excepción de pastos, silvicultura y agricultura, contribuyen de hecho al FRP.
Tabla 2. Resultados de la estimación del modelo de efectos fijos (PanelOLS) para el Log de FRP
| Nombre de la variable | Unidad de medida | Clase | Descripción |
|---|---|---|---|
| Año | Año | Entero | Año registrado |
| Id del Municipio | Rotunda | Entero | Código identificador del municipio |
| Ecosistema | Rotunda | Escrito | Nombre del bioma |
| Superficie total | Km² | Decimal | Área total del bioma en el municipio |
| Desbrozado | Km² | Decimal | Área deforestada del bioma en el municipio |
| Hidrografía | Km² | Decimal | Área de hidrografía del bioma en el municipio |
Fuente: resultados originales de la investigación
Modelo Random Forest
El modelo Random Forest se elaboró utilizando el log del FRP como variable dependiente y un conjunto de características que incluyeron temperatura máxima, humedad relativa, velocidad del viento, precipitación, número de días sin lluvia, riesgo de incendio, deforestación, índices de pastoreo, silvicultura, agricultura, hidrografía y mes. La optimización de los hiperparámetros se realizó mediante Grid Search con validación cruzada, según las opciones presentadas en la Tabla 3.
Tabla 3. Cuadrícula de hiperparámetros utilizada en la “Grid Search”
| Nombre de la variable | Unidad de medida | Clase | Descripción |
|---|---|---|---|
| Id del Municipio | Rotunda | Entero | Código identificador del municipio |
| Nombre | Rotunda | Escrito | Nombre del municipio |
| Condición | Rotunda | Escrito | Nombre del estado brasileño |
Fuente: resultados originales de la investigación
El modelo con mejor rendimiento, tras la optimización, resultó en un poder explicativo R² de 0.3626, con un Error Absoluto Medio (MAE) de 0.62 y una Raíz del Error Cuadrático Medio (RMSE) de 0.79 en la base de pruebas. El error se refleja en unidades logarítmicas. Al volver a la escala original, el MAE indica que las predicciones del modelo se desvían, en promedio, por un factor de aproximadamente 1.8, siendo capaces de anticipar el orden de magnitud del incendio. La proximidad entre los valores de RMSE y MAE sugiere la ausencia de valores atípicos extremos y sistémicos en las predicciones, lo que indica consistencia predictiva en torno a la media del error (Chai y Draxler, 2014). Aunque el R² es relativamente bajo, capturar más de un tercio de la varianza en sistemas ecológicos complejos y no controlados puede indicar que el modelo ha mapeado impulsores estructurales (Moller y Jennions, 2002).
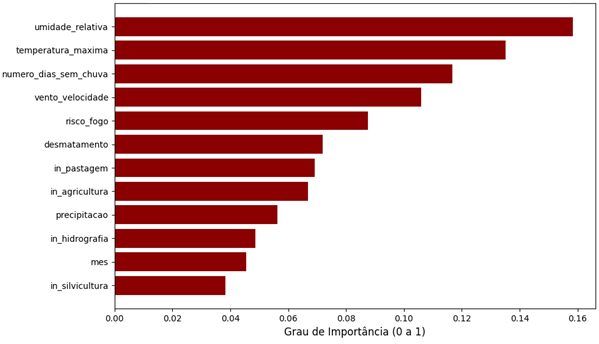
Las principales variables que impactan la intensidad del fuego, según el grado de importancia del modelo Random Forest, fueron la humedad relativa, la temperatura máxima y el número de días sin lluvia, como muestra la Figura 6.
Figura 6. Variables con mayor impacto en la intensidad del fuego
Fuente: resultados originales de la investigación
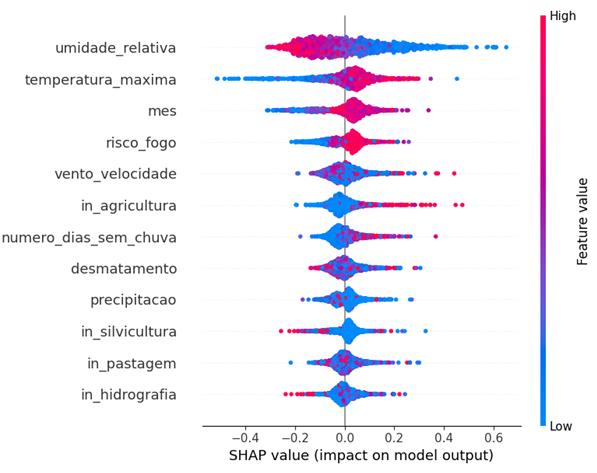
El análisis de Valores SHAP complementó la comprensión de la direccionalidad de estos impactos. La humedad relativa demostró ser un fuerte factor de disminución de la intensidad del fuego, mientras que la temperatura máxima y el número de días sin lluvia presentaron una contribución positiva al aumento de la intensidad, conforme a la Figura 7. Valores más cercanos al rojo indican alto valor en la variable y impacto positivo en la FRP, mientras que valores azules indican bajo valor en la variable e impacto negativo.
Figura 7. Valores SHAP de las variables del modelo
Fuente: resultados originales de la investigación
La identificación de estos principales vectores de incendios de alta intensidad posibilita la planificación de estrategias preventivas y la asignación anticipada de recursos de contingencia. El modelado desarrollado permite prever el orden de magnitud de los eventos, contribuyendo a una movilización más ágil y eficaz en el combate de incendios de grandes proporciones.
En resumen, los resultados de ambos modelos indicaron la influencia de las condiciones de sequía, viento y temperatura en la intensidad del fuego, además del impacto significativo de la deforestación. Estos hallazgos demuestran que los incendios de alta severidad resultan de la superposición de extremos macroclimáticos y de la disponibilidad de combustible proveniente de la deforestación reciente. Con acceso a información y modelos predictivos, es posible actuar en la prevención y control de estos fenómenos.
4. Conclusión
Este estudio buscó desarrollar un modelo de aprendizaje automático para estimar la Potencia Radiativa del Fuego (FRP) de focos de incendio en Brasil, a partir de datos del Instituto Nacional de Investigaciones Espaciales (INPE) y de variables ambientales complementarias, identificando los factores más importantes para su determinación. Se verificó, por medio de un modelo econométrico de datos en panel, que el índice de deforestación ejerció el mayor impacto positivo y estructural en la intensidad del fuego, mientras que las áreas de agricultura, pastoreo y silvicultura no presentaron significancia estadística. Complementariamente, el modelado predictivo con el algoritmo Random Forest demostró que las condiciones climáticas poseen un impacto significativo en la propagación e intensidad del fuego. La humedad relativa del aire fue identificada como el principal factor de mitigación, al paso que la temperatura máxima y el número de días sin lluvia actuaron como los mayores catalizadores. Los resultados de ambos modelos convergieron al indicar que los incendios de alta severidad resultan de la superposición de extremos macroclimáticos combinados a la disponibilidad de combustible oriundo de la deforestación reciente.
La principal contribución de este trabajo reside en la oferta de una herramienta cuantitativa de apoyo a la decisión para órganos de gestión ambiental y defensa civil, permitiendo la predicción del orden de magnitud de los eventos de incendio y, consecuentemente, una movilización más ágil y eficaz en el combate a focos de grandes proporciones. La identificación de los principales vectores de incendios de alta intensidad viabiliza la planificación de estrategias preventivas y la asignación anticipada de recursos de contingencia. Sin embargo, una limitación del estudio provino de la disponibilidad de recursos, que impidió la ampliación de la cantidad de variables y el aumento de los años considerados para el análisis. Se sugiere, para estudios futuros, la exploración de un conjunto más abarcador de variables y una serie histórica extendida, lo que podría refinar aún más la capacidad predictiva y explicativa de los modelos.
Referencias Bibliográficas
Breiman, L. 2001. Random Forests. Machine Learning 45(1): 5-32.
CNN Brasil. 2025. Brasil registrou 278,3 mil focos de incêndio em 2024, diz Inpe. Disponível em: https://www.cnnbrasil.com.br/nacional/brasil-registrou-2783-mil-focos-de-incendio-em-2024-diz-inpe/. Acesso em: 28 set. 2025.
David, Davis. Random forest classifier tutorial: how to use tree-based algorithms for machine learning. freeCodeCamp, 6 ago. 2020. Disponível em: https://www.freecodecamp.org/news/how-to-use-the-tree-based-algorithm-for-machine-learning/. Acesso em: 14 abr. 2026.
Guimarães, P. P.; Souza, S. M.; Fiedler, N. C.; Silva, A. G. 2014. Análise dos Impactos Ambientais de um Incêndio Florestal. Agrarian Academy 1(1): 38-60.
Hair Jr., J. F.; Black, W. C.; Babin, B. J.; Anderson, R. E.; Tatham, R. L. 2009. Análise Multivariada de Dados. 6. ed. Bookman, Porto Alegre, RS, Brasil.
Hausman, Jerry A. Specification tests in econometrics. Econometrica, v. 46, n. 6, p. 1251-1271, 1978.
INPE (Instituto Nacional de Pesquisas Espaciais). Programa Queimadas: Monitoramento dos Focos Ativos por Satélite. Disponível em: http://terrabrasilis.dpi.inpe.br/queimadas/portal/pages/secao_informacoes/faq/. Acesso em: 26 jan. 2026.
Juvanhol, R. S.; Fiedler, N. C.; Santos, A. R.; Peluzio T. M. O.; Silva W. B.; Pinheiro C. J. G; Sousa H. C. P. 2023. Use of machine learning as a tool for determining fire management units in the brazilian atlantic forest. Anais da Academia Brasileira de Ciências 95(2): e20201039.
Kuhn, M.; Johnson, K. Applied Predictive Modeling. Nova York: Springer, 2013.
Montgomery, D. C.; Peck, E. A.; Vining, G. G. 2012. Introduction to Linear Regression Analysis. 5. ed. Wiley, Hoboken, NJ, USA.
Nobre, C. A.; Sampaio, G.; Borma, L. S.; Castilla-Rubio, J. C.; Silva, J. S.; Cardoso, M. 2016. Land-use and climate change risks in the Amazon and the need of a novel sustainable development paradigm. Proceedings of the National Academy of Sciences 113(39): 10759-10768.
Roberts, G.; Wooster, M. J.; Perry, G. L. W.; Kaufman Y. J. 2005. Retrieval of biomass combustion rates and totals from fire radiative power observations: FRP derivation and calibration relationships between biomass consumption and fire radiative energy release. Journal of Geophysical Research: Atmospheres 110(D24311).
Shumway, R. H.; Stoffer, D. S. Time Series Analysis and Its Applications: With R Examples. 4. ed. Cham: Springer, 2017
Viganó, H. H. G.; Souza, C. C.; Cristaldo, M. F.; Jesus, L. 2017. Redes Neurais Artificiais na Previsão de Queimadas e Incêndios no Pantanal. Revista Brasileira de Geografia Física 10(5): 1355-1367.
Wooldridge, J. M. Econometric Analysis of Cross Section and Panel Data. 2. ed. Cambridge: MIT Press, 2010.
Wooster, M. J.; Roberts, G.; Perry, G. L.; Drake, N.; Rebelo, L. M.; Dipotso, F. 2005. Retrieval of fire radiative energy from MODIS: Application to southern African savanna fires using geostationary SEVIRI imagery. Journal of Geophysical Research: Atmospheres 110(D21111).
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haz clic aquí y accede a la plataforma MBX Academy