
10 de septiembre de 2026
Precios Hedónicos de Bienes Raíces en la Gran Florianópolis: Uso y Comparación de Modelos de “Machine Learning”
Gabriel Galvan de Cesaro; Lilian Cristina Da Silveira
DOI: 10.22167/2675-6528-202602220
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
El mercado inmobiliario de la Gran Florianópolis ha experimentado una valorización acelerada, impulsada por el crecimiento poblacional y la demanda turística y de inversión. Este estudio analizó los determinantes del valor de inmuebles residenciales y comparó el desempeño predictivo de modelos de aprendizaje automático, específicamente Random Forest y Gradient Boosting (XGBoost), con una regresión por Mínimos Cuadrados Ordinarios (MCO). Los datos se recopilaron mediante web scraping de dos portales inmobiliarios en marzo de 2026, abarcando los municipios de Florianópolis, São José, Palhoça y Biguaçu, resultando en 8.056 observaciones válidas después de la limpieza. Se evaluó el desempeño de los modelos a través de las métricas R², RMSE y MAPE. El XGBoost presentó el mejor desempeño predictivo general (R² = 0,742, RMSE = R$ 927.113), mientras que el Random Forest obtuvo el menor error relativo (MAPE = 25,69%). Los principales determinantes del precio identificados fueron el área construida, la región de ubicación y el número de baños. Un análisis complementario por segmento de mercado reveló que el MCO dependió de los valores extremos para sostener su ajuste, mientras que los modelos ensemble mantuvieron un desempeño estable. Se concluyó que los métodos de aprendizaje automático son más robustos para la fijación de precios hedónica en mercados inmobiliarios heterogéneos, especialmente en presencia de inmuebles atípicos.
Palabras clave: Ensemble; Inmobiliario; Regresión; Residencial; Web Scraping.
1. Introducción
El mercado inmobiliario en la Gran Florianópolis ha experimentado una valorización acelerada, impulsada por el crecimiento poblacional y la presión de la demanda turística y de inversión. Florianópolis, a pesar de ser la 21ª capital en población absoluta, registró el tercer mayor crecimiento relativo entre 2010 y 2022, con un aumento del 27,5% en su población (IBGE, 2022). Esta dinámica se refleja en los precios de los inmuebles, que tuvieron un incremento acelerado de alrededor del nueve por ciento entre enero y diciembre de 2024 (FIPE, 2024).
Las ciudades vecinas, como São José, Palhoça y Biguaçu, también presentaron un crecimiento poblacional relativo en la misma proporción que la capital (IBGE, 2022). Sin embargo, sus precios por metro cuadrado son inferiores; São José, por ejemplo, cerró 2024 con un valor un 32% inferior a la media de Florianópolis (FIPE, 2024), configurando alternativas de vivienda más accesibles para los trabajadores de la isla catarinense. En este escenario, la compra de una propiedad es frecuentemente la mayor transacción financiera para la mayoría de las personas (Pedersen et al., 2013), haciendo crucial la comprensión de los mecanismos de fijación de precios del mercado.
Saber cómo el mercado valora activos similares permite al comprador identificar oportunidades y evitar propiedades sobrevaloradas. Para el vendedor, una estimación precisa del valor de mercado puede optimizar el retorno de la inversión y agilizar la venta, evitando la infravaloración o la sobrevaloración del bien (Moro, 2017). Uno de los métodos establecidos para la estimación del precio de una propiedad es la fijación de precios hedónica, que, según Fávero (2003), utiliza modelos de regresión para definir los precios basándose en las características de las residencias.
El término hedónico deriva del hedonismo, indicando que el placer o la satisfacción del consumidor dependen de los atributos del bien adquirido (Fávero et al., 2008). Rosen (1974) describe los precios hedónicos como precios implícitos de atributos, determinados por las características y precios asociados a diferentes productos. Así, la fijación de precios hedónica postula que el precio final es la suma de los precios de los atributos, evidenciando la contribución individual de cada característica del inmueble.
Ante la complejidad y la rápida valorización del mercado inmobiliario en la Gran Florianópolis, resulta relevante mejorar las herramientas de fijación de precios. Este estudio busca contribuir al avance de la literatura académica estimando el valor de inmuebles residenciales en la región de la Gran Florianópolis (comprendiendo los municipios de Florianópolis, São José, Palhoça y Biguaçu) a partir de datos recopilados mediante web scraping de plataformas de anuncios inmobiliarios en línea. Para ello, el rendimiento de una regresión por Mínimos Cuadrados Ordinarios (MCO), utilizada como modelo de referencia, se compara con el de algoritmos de aprendizaje automático, específicamente Random Forest (Breiman, 2001) y Gradient Boosting a través de XGBoost (Chen y Guestrin, 2016).
2. Material y Métodos
Todas las etapas de recolección de datos, procesamiento y modelado se implementaron en Python 3.12, ejecutado en un entorno Windows 11. Las bibliotecas utilizadas incluyeron “Requests” y “BeautifulSoup” para la recolección de datos, “Pandas” para manipulación, “Statsmodels” y “Scikit-learn” para regresión hedónica y “random forest”, “XGBoost” para “gradient boosting” y SHAP para la interpretación de los modelos.
Los datos se obtuvieron mediante “web scraping” de dos portales inmobiliarios locales en la región de la Gran Florianópolis (Florianópolis, São José, Palhoça y Biguaçu) en marzo de 2026, abarcando exclusivamente inmuebles residenciales anunciados para la venta. La elección de datos de anuncios en línea se debió a la indisponibilidad de registros oficiales de venta, y la opción por inmobiliarias locales se realizó debido a las políticas de privacidad de portales multi-inmobiliarios que prohíben la recopilación automatizada.
La recopilación de datos para el portal de la Inmobiliaria A utilizó una API REST interna que devolvía datos en formato JSON, consumida directamente por un “scraper” en Python con la biblioteca Requests. Para el portal de la Inmobiliaria B, que no poseía API pública, el proceso se dividió en dos etapas: solicitud de páginas de listado con “Requests” y “BeautifulSoup” para atributos básicos, y visita a cada página individual de inmueble con un navegador “Chromium” controlado por la biblioteca “Playwright” para extracción de variables complementarias cargadas dinámicamente vía JavaScript. Al final, las bases de datos se consolidaron en un único archivo CSV, totalizando 8.156 registros antes de la limpieza.
Los datos brutos consolidados se sometieron a un proceso de limpieza para eliminar registros con errores de registro, valores irreales o información insuficiente. Inicialmente, 15 tipos de propiedades se estandarizaron en dos subdivisiones: “apartamento” o “casa”. Las propiedades sin plaza de garaje se trataron como 0. Se descartaron los registros con número de habitaciones o baños ausentes, valor de venta inferior a R$ 90.000, área construida inferior a 10m², más de 9 habitaciones, más de 12 plazas de garaje o tamaño superior a 1000 m².
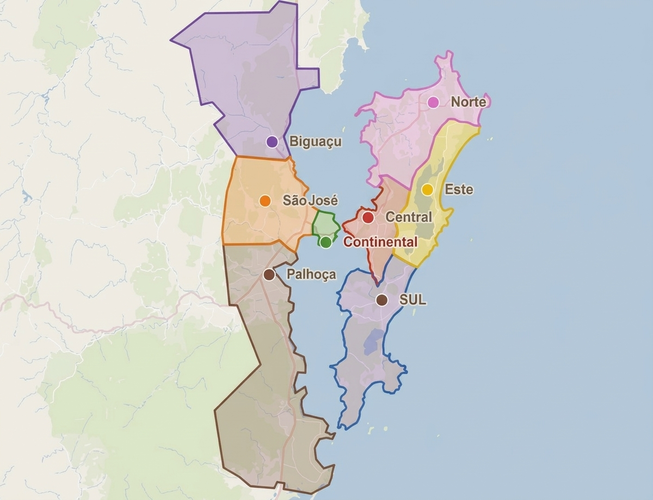
Los campos de barrio y ciudad pasaron por normalización, y se creó un nuevo campo “región”. Para Florianópolis, los barrios fueron clasificados en regiones Central, Continental, Leste, Norte y Sul, conforme a la Ley Complementaria N. 739 (FLORIANÓPOLIS, 2023). Para los demás municipios (Biguaçu, Palhoça y São José), el campo “región” fue completado con el propio nombre de la ciudad, conforme a la representación simplificada en la Figura 1.
Figura 1. Regiones consideradas para el estudio
Fuente: Elaboración propia, con base en Google Maps
Las comodidades recopiladas en formato de texto libre se convirtieron en siete variables binarias: piscina, balcón, barbacoa, inmueble_amueblado, ascensor, gimnasio y salón de fiestas, mediante la búsqueda de términos predefinidos. Después de todas las etapas de limpieza, el conjunto de datos final contó con 8.056 observaciones válidas y las variables presentadas en la Tabla 1.
Tabla 1. Variables de la base de datos
| Nombre | Descripción | Clase |
|---|---|---|
| inmobiliaria | Nombre de la inmobiliaria | Clasificación |
| clase | Tipo de propiedad | Clasificación |
| calle | Vía pública | Teórico |
| barrio | Barrio del inmueble | Teórico |
| ciudad | Ciudad del inmueble | Clasificación |
| tamaño_m2 | Tamaño en m² | Cuantitativa continua |
| habitaciones | Número de habitaciones | Cuantitativa discreta |
| baños | Número de baños | Cuantitativa discreta |
| vacantes | Número de plazas de aparcamiento | Cuantitativa discreta |
| valor | Precio del inmueble en R$ | Cuantitativa continua |
| región | Región del inmueble | Clasificación |
| alberca | Presencia de piscina | Binaria/Lógica |
| balcón | Presencia de balcón/terraza | Binaria/Lógica |
| parrilla | Presencia de barbacoa | Binaria/Lógica |
| inmueble_amueblado | Inmueble amueblado | Binaria/Lógica |
| ascensor | Presencia de ascensor | Binaria/Lógica |
| erudición | Presencia de academia | Binaria/Lógica |
| salón de fiestas | Presencia de salón de fiestas | Binaria/Lógica |
Fuente: Resultados originales de la investigación
El primer modelo estimado fue una regresión lineal por Mínimos Cuadrados Ordinarios (MQO), utilizado como modelo de referencia. La variable dependiente, “valor” (precio de la propiedad en reales), fue transformada a la escala logarítmica, procedimiento equivalente a la transformación Box-Cox con parámetro λ=0, buscando la normalización de la distribución. La especificación final del modelo fue validada por el procedimiento “stepwise” con criterio de eliminación cuando p-valor > 0,05, removiendo la variable “imovel_mobiliado”.
Los modelos de aprendizaje automático adoptados fueron “Random Forest” (Breiman, 2001) y “Gradient Boosting” por medio de la implementación “XGBoost” (Chen y Guestrin, 2016). Para los modelos de aprendizaje automático, la base de datos se dividió en conjunto de entrenamiento (80% de las observaciones, n = 6.444) y conjunto de prueba (20% de las observaciones, n = 1.612). La selección de hiperparámetros se realizó por RandomizedSearchCV, utilizando validación cruzada “k-fold” con k = 5 en el conjunto de entrenamiento y RMSE como criterio de optimización. Se muestrearon 40 combinaciones de hiperparámetros, presentadas en la Tabla 2.
Tabla 2. Hiperparámetros seleccionados por RandomizedSearchCV
| Hiperparámetro | Descripción | Random Forest | XGBoost |
|---|---|---|---|
| n_estimators | Número de árboles | 300 | 200 |
| profundidad_maxima | Profundidad máxima de cada árbol | 30 | 6 |
| máximo de características | Fracción de variables evaluadas en cada división | 0,5 | |
| min_muestras_división | Mínimo de muestras para dividir un nodo | 5 | |
| min_samples_leaf | Mínimo de muestras en cada hoja | 2 | |
| tasa_de_aprendizaje | Tasa de aprendizaje (peso de cada árbol) | 0,05 | |
| submuestra | Fracción de observaciones utilizadas por los árboles | 0,6 | |
| colsample_bytree | Fracción de variables usadas por árbol | 0,8 | |
| gamma | Ganancia mínima para realizar una división | 0,1 | |
| min_child_weight | Peso mínimo en cada nodo | 1 |
Fuente: Resultados originales de la investigación
Los tres modelos fueron evaluados en el conjunto de prueba por las métricas R², RMSE, MAE y MAPE, todas calculadas en la escala original en reales, revirtiendo la transformación logarítmica con la función exponencial antes del cálculo.
El análisis de los Factores de Inflación de Varianza (VIF) de la especificación inicial de MCO reveló multicolinealidad severa entre `log_tamaño_m2` (VIF = 63,97) y `habitaciones` (VIF = 17,60), reconocida como limitación del Modelo A, seleccionado tras probar tres especificaciones para abordar esta cuestión. El modelo MCO se estimó con errores estándar robustos HC3. La heterocedasticidad fue detectada por la prueba de Breusch-Pagan y corregida mediante la aplicación de errores estándar robustos HC3 por precaución metodológica.
3. Resultados y Discusión
Análisis Exploratorio
Después de las etapas de recolección y saneamiento, la base de datos final contó con 8.056 observaciones de inmuebles residenciales anunciados para la venta en la región de la Gran Florianópolis. Las estadísticas descriptivas de las variables numéricas del estudio se presentan en la Tabla 3.
Tabla 3. Estadísticas descriptivas de las variables numéricas
| Variable | media | mediana | desviación estándar | mín. | máx. |
|---|---|---|---|---|---|
| tamaño_m2 (m²) | 143,05 | 106,0 | 111,3 | 11,0 | 1000,0 |
| habitaciones | 2,73 | 3 | 1,09 | 1 | 9 |
| baños | 2,54 | 2 | 1,37 | 1 | 12 |
| vacantes | 1,68 | 1 | 1,19 | 0,0 | 12 |
| importe (R$) | 1.655.513 | 1.100.000 | 1.959.595 | 90.000 | 50.000.000 |
| _precio_m2 (R$/m²) | 11.895 | 10.328 | 7095 | 490,2 | 138.183,3 |
Fuente: Resultados originales de la investigación
La elevada desviación estándar observada para tamaño_m2 (111,3 m²) y valor (R$ 1.959.595) refleja la heterogeneidad de la base de datos, que reúne tipos de inmuebles y regiones con características muy distintas. A efectos exploratorios, el precio por metro cuadrado (R$/m²) se utilizó para comparar el valor de inmuebles de diferentes tamaños en condiciones más homogéneas, revelando diferencias de valorización entre regiones y tipos que el análisis del valor absoluto podría enmascarar. Esta variable se utiliza exclusivamente en el análisis exploratorio, mientras que la modelización adopta log(valor) como variable dependiente y log(tamaño_m2) como una de las variables predictoras.
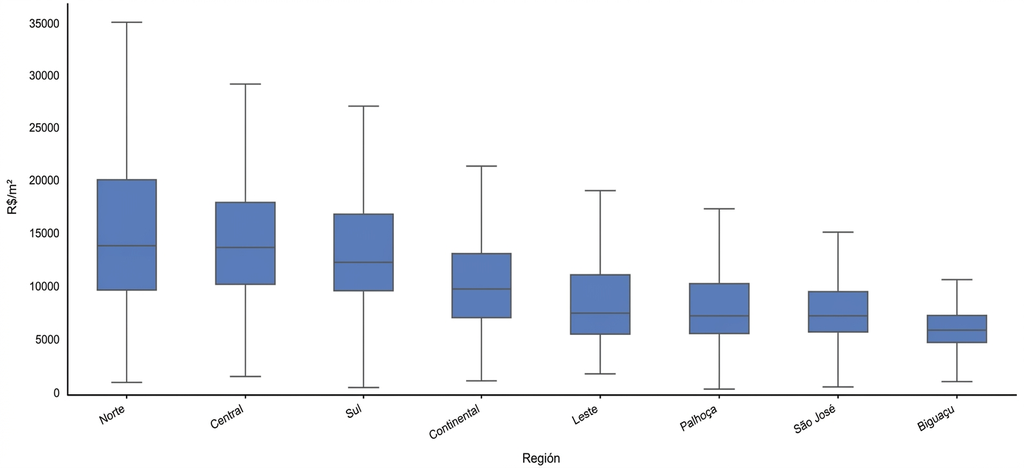
El precio mediano por metro cuadrado por región, según la Figura 2, revela diferencias expresivas dentro del municipio de Florianópolis. Las regiones Norte y Sur presentan los valores medianos más altos, seguidas por la región Central, mientras que los municipios de la Gran Florianópolis (São José, Palhoça y Biguaçu) presentan precios por metro cuadrado sistemáticamente inferiores. La diferencia entre la región más valorada y la menos valorada es de aproximadamente 130%. Este gradiente es consistente con los datos del índice FipeZap y refleja el patrón documentado en la literatura de que la proximidad a la costa y a lugares de interés son determinantes relevantes del valor hedónico de las propiedades en ciudades costeras (Dantas et al., 2007). Este resultado también anticipa las primas regionales estimadas por el modelo hedónico.
Figura 2. Precio por m² por región con outliers extremos ocultos
Fuente: Datos originales de la investigación
El análisis por barrio dentro de la región Norte revela que la dispersión del precio por metro cuadrado persiste incluso en la región más valorizada. Jurerê presenta un costo mediano de R$ 24.000/m², mientras que Vargem Grande registra R$ 8.000/m², una diferencia del 200%. Esto indica que la variable de región captura parte de la heterogeneidad de precios, pero no la totalidad, ya que barrios de alto nivel concentran atributos de valorización no enteramente observables en los anuncios, como calidad de acabados y estándar constructivo.
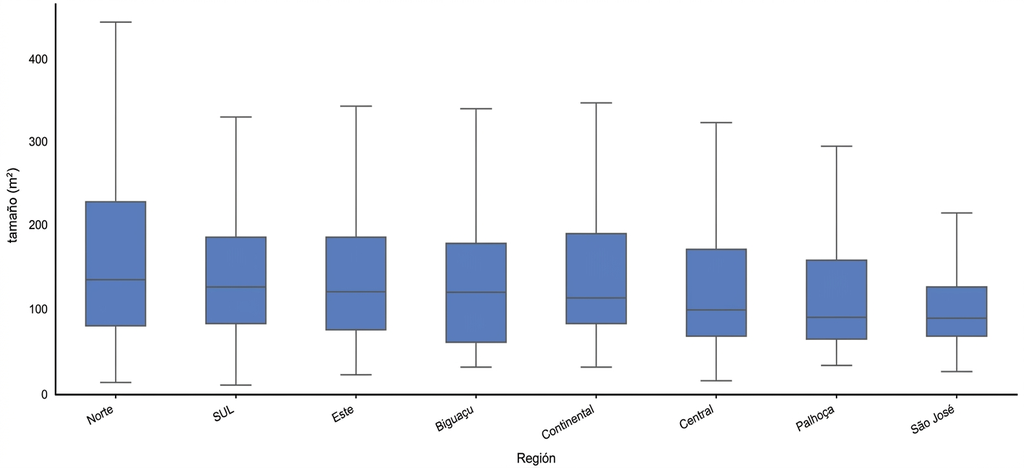
La comparación del tamaño de las propiedades por región, presentada en la Figura 3, revela que la región Norte también lidera en tamaño mediano y presenta la mayor desviación estándar. Esta dispersión se explica por la coexistencia, dentro de la misma región, de barrios de alto nivel (como Jurerê y Jurerê Internacional, con propiedades de gran tamaño) y barrios con un perfil más popular (como Vargem Grande), donde las propiedades son significativamente más pequeñas.
Figura 3. Tamaño en m² por región con valores atípicos extremos ocultos
Fuente: Datos originales de la investigación
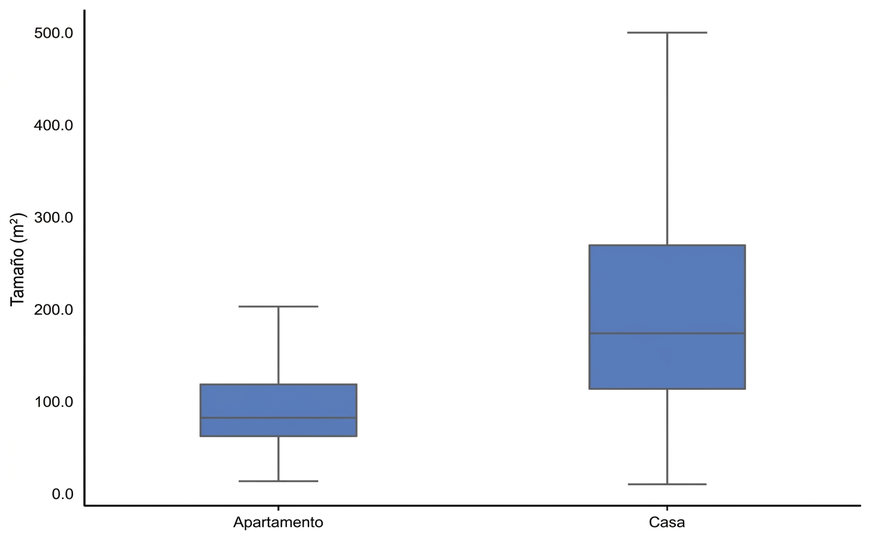
La Figura 4 descompone esta variación por tipo de inmueble y evidencia que las casas presentan un tamaño mediano considerablemente mayor que los apartamentos, con una dispersión igualmente más elevada. Este resultado sugiere que parte de la desviación estándar observada en la variable tamaño_m2 se debe a la composición heterogénea de la muestra entre los dos tipos, reforzando la necesidad de controlar simultáneamente por tipo y región en los modelos estimados, lo que se hace mediante variables dummy incluidas en la especificación hedónica.
Figura 4. Tamaño en m² por tipo de inmueble con valores atípicos extremos ocultos
Fuente: Datos originales de la investigación
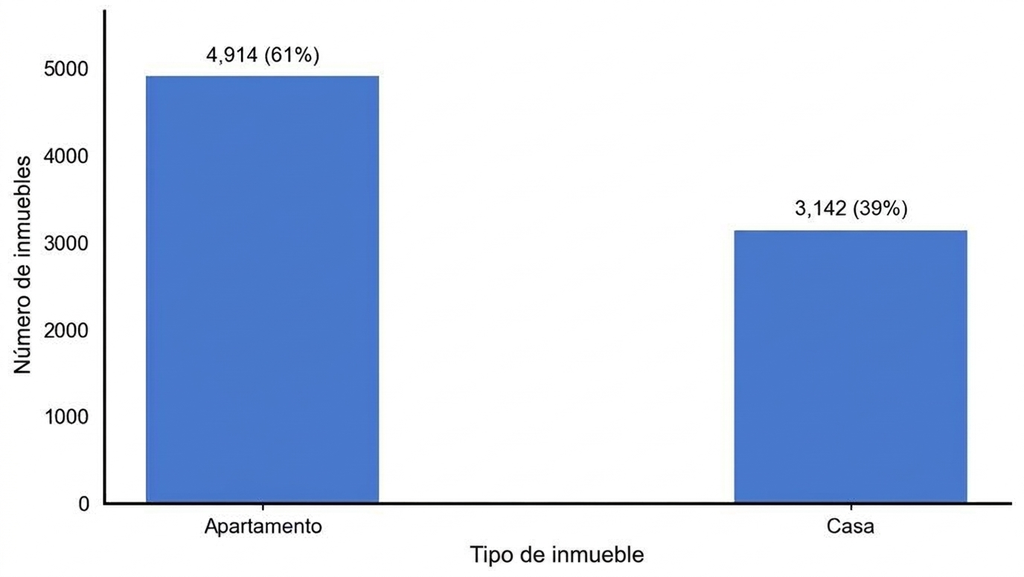
La distribución por tipo de inmueble reveló predominancia de apartamentos (61%) sobre casas (39%), conforme la Figura 5. Esta discrepancia en relación con el estudio del IBGE (IBGE, 2022) para Florianópolis (56,01% de casas y 43,99% de apartamentos) es esperada, ya que la base de datos captura inmuebles activamente anunciados para la venta en portales digitales, donde los apartamentos tienen mayor representación, reflejando el flujo de mercado y no el stock total de domicilios.
Figura 5. Conteo por tipo de propiedad
Fuente: Datos originales de la investigación
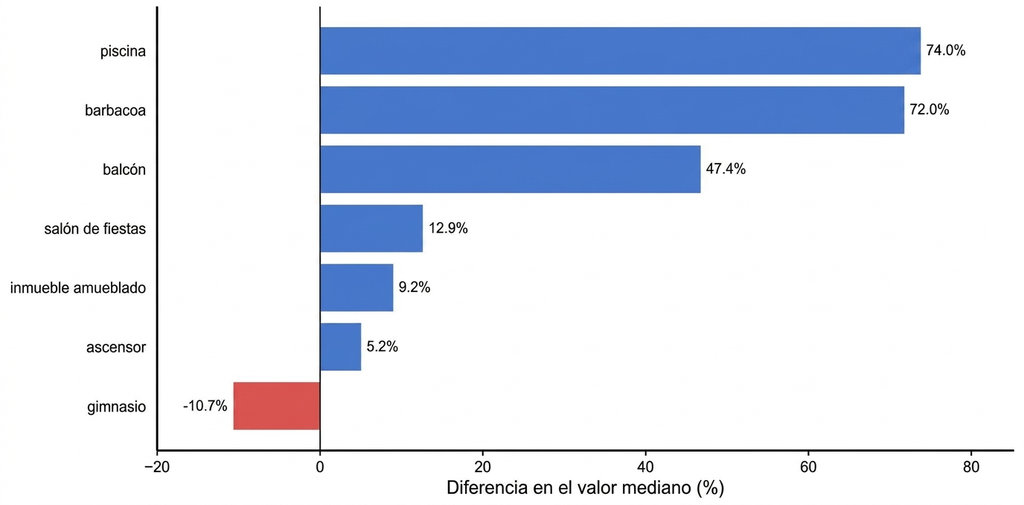
Entre las amenidades recolectadas, la barbacoa es la más prevalente en la muestra (69,8%), seguida por el salón de fiestas (39,9%) y la piscina (39,7%). La Figura 6 presenta la diferencia porcentual entre el valor mediano de las propiedades que poseen cada amenidad y el valor mediano de las que no la poseen, sin control por otras variables.
Figura 6. Diferencia en el valor mediano entre inmuebles con y sin amenidades
Fuente: Datos originales de la investigación
La piscina (+74,0%) y la barbacoa (+72,0%) registran los mayores impactos positivos sobre el valor mediano, seguidas por el balcón (+47,4%), mientras que el gimnasio presenta un resultado negativo (-10,7%). Este último no indica un efecto de devaluación, sino que refleja un efecto de confusión, ya que los gimnasios son más frecuentes en condominios de gama media, que pueden estar ubicados en regiones menos valorizadas. Esta limitación del análisis bruto se corrige mediante el modelo de regresión, que estima el efecto de cada atributo controlando simultáneamente por las demás variables.
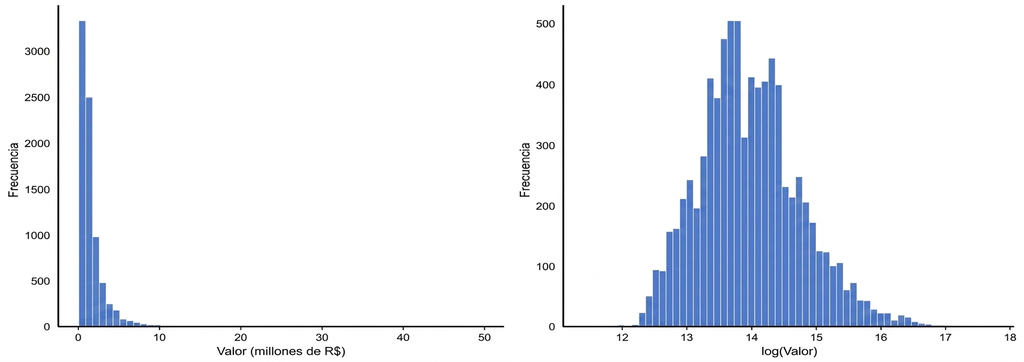
La regresión por MCO asume que los residuos del modelo siguen una distribución aproximadamente normal. En datos inmobiliarios, el valor de las propiedades típicamente no sigue el patrón de distribución normal, presentando asimetría positiva acentuada debido a la presencia de pocas propiedades de altísimo valor. La transformación logarítmica es un enfoque común en la literatura hedónica para abordar este problema (Rosen, 1974; Malpezzi, 2003), comprimiendo la cola derecha, reduciendo la asimetría y estabilizando la varianza de los residuos.
La Figura 7 presenta la distribución del valor de la propiedad antes y después de la transformación logarítmica. El valor original presentó una asimetría de 6,58, caracterizando una distribución con cola derecha larga. Después de la transformación, la asimetría se redujo a 0,46, aproximando sustancialmente la distribución a la simetría.
Figura 7. Distribución del valor de la propiedad antes y después de la transformación logarítmica
Fuente: Datos originales de la investigación
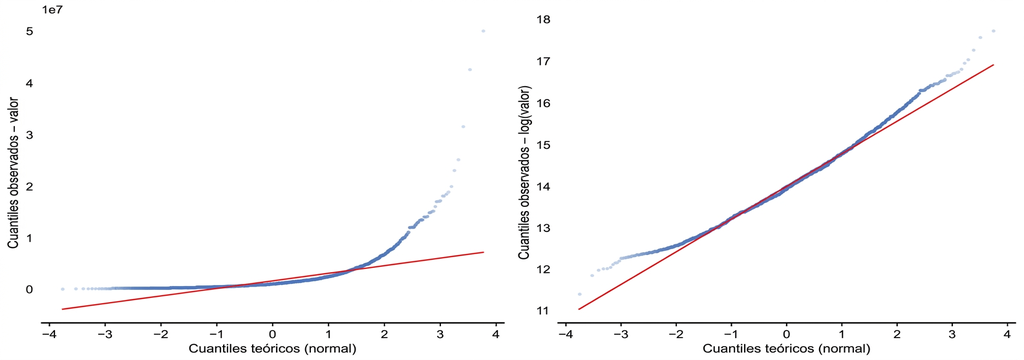
La normalidad fue evaluada por la prueba de Shapiro-Francia, que rechazó la normalidad tanto para el valor original como para el log(valor), un resultado esperado en muestras de gran tamaño (Field, 2018). Los QQ-plots (gráficos de cuantiles teóricos versus observados) de la Figura 8 muestran que la transformación logarítmica redujo marcadamente la asimetría de la variable dependiente, aproximando su distribución a la normalidad. Esta condición favorece el cumplimiento de la premisa de normalidad de los residuos, verificada formalmente en la sección de diagnósticos del modelo MCO.
Figura 8. QQ-plots de la variable dependiente antes y después de la transformación logarítmica
Fuente: Datos originales de la investigación
El predictor tamaño_m2 presentó una asimetría de 2,35, también elevada, habiendo sido igualmente transformado a log(tamaño_m2). Las variables categóricas región y tipo fueron codificadas como variables dummy, teniendo Biguaçu y Apartamento como categorías de referencia, respectivamente.
El análisis de correlación de Spearman entre las variables numéricas y el valor de la propiedad indicó que tamaño_m2 presenta la mayor correlación (p = 0,733, p < 0,001), seguido por baños (p = 0,690), habitaciones (p = 0,580) y plazas (p = 0,556). Este ordenamiento es consistente con el análisis de Sirmans et al. (2005), que identificó el área construida y el número de baños como los atributos más frecuentemente significativos y de mayor magnitud en modelos hedónicos residenciales.
Regresión por Mínimos Cuadrados Ordinarios
El análisis de los Factores de Inflación de Varianza (VIF) de la especificación inicial reveló multicolinealidad severa entre log_tamaño_m2 (VIF = 63,97) y habitaciones (VIF = 17,60), indicando que las dos variables capturan dimensiones superpuestas del inmueble. La multicolinealidad no sesga los coeficientes, pero infla sus errores estándar, reduciendo el poder de las pruebas de hipótesis (Fávero y Belfiore, 2024). Para evaluar alternativas, se probaron tres especificaciones para lidiar con la multicolinealidad. El Modelo A (especificación original, con log_tamaño_m2 y habitaciones separadas) fue seleccionado por presentar el menor AIC (7.337) y el mayor R² ajustado (0,7636) entre las tres especificaciones, según se presenta en la Tabla 4. Los Modelos B (sin habitaciones) y C (sustituyendo tamaño y habitaciones por m²/habitación) presentaron AIC superiores y R² ajustado ligeramente menor, siendo descartados. La multicolinealidad entre log_tamaño_m2 y habitaciones es reconocida como limitación del Modelo A y reportada por el análisis de VIF.
Tabla 4. Resultado del análisis de VIF
| Plantilla | número de predictores | R² ajustado | AIC | VIF máximo |
|---|---|---|---|---|
| A (versión original) | 19 | 0,7636 | 7337 | 63,97 |
| B (sin habitaciones) | 18 | 0,7635 | 7358 | 51,30 |
| C (m²/habitación) | 18 | 0,7143 | 8881 | 41,51 |
Fuente: Resultados originales de la investigación
El modelo estimado por MQO con errores estándar robustos HC3 presentó un R² de 0,764, lo que indica que las variables incluidas explican el 76,4% de la variación en el logaritmo del precio de las propiedades. Este resultado se encuentra dentro del rango típico reportado en la literatura (Sirmans et al., 2005). La estadística F rechazó la hipótesis nula de que todos los coeficientes son conjuntamente iguales a cero (F = 1.168, p < 0,001), confirmando la significancia global del modelo. La Tabla 5 presenta los coeficientes estimados.
Tabla 5. Coeficientes del modelo MQO
| Variable | El Coeficiente (β) | Desviación Estándar | valor p |
|---|---|---|---|
| Intercepto | 9,7961 | 0,0510 | 0,0000 |
| región_central | 0,6431 | 0,0291 | 0,0000 |
| región_continental | 0,3921 | 0,0308 | 0,0000 |
| región_este | 0,3571 | 0,0308 | 0,0000 |
| región_norte | 0,7475 | 0,0296 | 0,0000 |
| región_palhoça | 0,2228 | 0,0299 | 0,0000 |
| región_sur | 0,7189 | 0,0301 | 0,0000 |
| región_san_josé | 0,1994 | 0,0295 | 0,0000 |
| tipo de casa | -0,1905 | 0,0141 | 0,0000 |
| log_tamaño_m2 | 0,6803 | 0,0119 | 0,0000 |
| habitaciones | -0,0296 | 0,0062 | 0,0000 |
| baños | 0,1303 | 0,0048 | 0,0000 |
| vacantes | 0,0625 | 0,0045 | 0,0000 |
| alberca | 0,1826 | 0,0097 | 0,0000 |
| balcón | 0,0489 | 0,0099 | 0,0000 |
| parrilla | 0,0291 | 0,0103 | 0,0046 |
| ascensor | 0,1234 | 0,0127 | 0,0000 |
| erudición | 0,0299 | 0,0144 | 0,0373 |
| salón de fiestas | 0,0435 | 0,0117 | 0,0207 |
Fuente: Resultados originales de la investigación
La variable imovel_mobiliado fue eliminada por el procedimiento stepwise (p = 0,054) y no integra el modelo final. Los demás coeficientes permanecieron inalterados.
Las variables regionales, teniendo a Biguaçu como categoría de referencia, revelan premios de localización expresivos. Al convertir los coeficientes a variación porcentual exacta, las propiedades en la región Norte de Florianópolis valen aproximadamente un 111% más que las propiedades equivalentes en Biguaçu, seguidas por la región Sur (+105%) y Central (+90%). La magnitud de estos premios regionales, que llegan a superar el 100%, es expresiva y sugiere que la variable de localización es el principal determinante del valor inmobiliario en la Gran Florianópolis, superponiéndose a las características físicas de la propiedad.
Entre las variables físicas de la propiedad, la cantidad de baños presenta el mayor coeficiente positivo (β = 0,130), lo que implica un aumento de aproximadamente el 13,9% en el valor por cada baño adicional, controlando por las demás variables. Este es un resultado consistente con el rango del 10% al 12% documentado por Sirmans et al. (2005) para mercados norteamericanos. Las plazas de garaje contribuyen con un aumento del 6,4% por unidad adicional (β = 0,063). El coeficiente de tipo_casa (β = -0,190) indica que las casas valen aproximadamente un 17,4% menos que los apartamentos equivalentes en tamaño, región y amenidades, lo que refleja la mayor valorización relativa de los apartamentos en el mercado anunciado en línea, concentrado en regiones urbanas densas donde este tipo predomina. Entre las amenidades, la piscina registra la mayor prima implícita (+20,0%), seguida por el ascensor (+13,1%), salón de fiestas (+4,4%), gimnasio (+3,0%) y barbacoa (+2,9%), resultado consistente con la revisión de Sirmans et al. (2005), que identificó piscina y garaje como las amenidades con mayor frecuencia de coeficientes positivos y significativos en los estudios hedónicos residenciales.
El coeficiente negativo de habitaciones (-0,030), controlando por el tamaño, encuentra un paralelo en la literatura: Sirmans, Macpherson y Zietz (2005) observaron que el signo de las habitaciones tiende a volverse negativo o no significativo cuando el área construida se incluye simultáneamente en el modelo, ya que las dos variables capturan dimensiones superpuestas del inmueble. Este resultado se interpreta como una penalización por habitaciones pequeñas: partiendo de un tamaño fijo de un inmueble, una mayor cantidad de habitaciones implica una menor área promedio por estancia. La Tabla 6 presenta los VIF del modelo, confirmando multicolinealidad severa entre log_tamaño_m2 (VIF = 63,97) y habitaciones (VIF = 17,60), reconocida como limitación.
Tabla 6. Factores de Inflación de Varianza (VIF) del modelo seleccionado
| Variable | VIF |
|---|---|
| log_tamaño_m2 | 63,97 |
| habitaciones | 17,60 |
| baños | 10,32 |
| vacantes | 4,67 |
| parrilla | 4,02 |
| tipo de casa | 3,98 |
| región_central | 3,71 |
| ascensor | 3,46 |
| salón de fiestas | 2,98 |
| región_norte | 2,65 |
| región_san_josé | 2,29 |
| alberca | 2,10 |
| región_sur | 2,09 |
| región_continental | 2,03 |
| región_palhoça | 2,01 |
| balcón | 1,92 |
| región_este | 1,83 |
| erudición | 1,28 |
Fuente: Resultados originales de la investigación
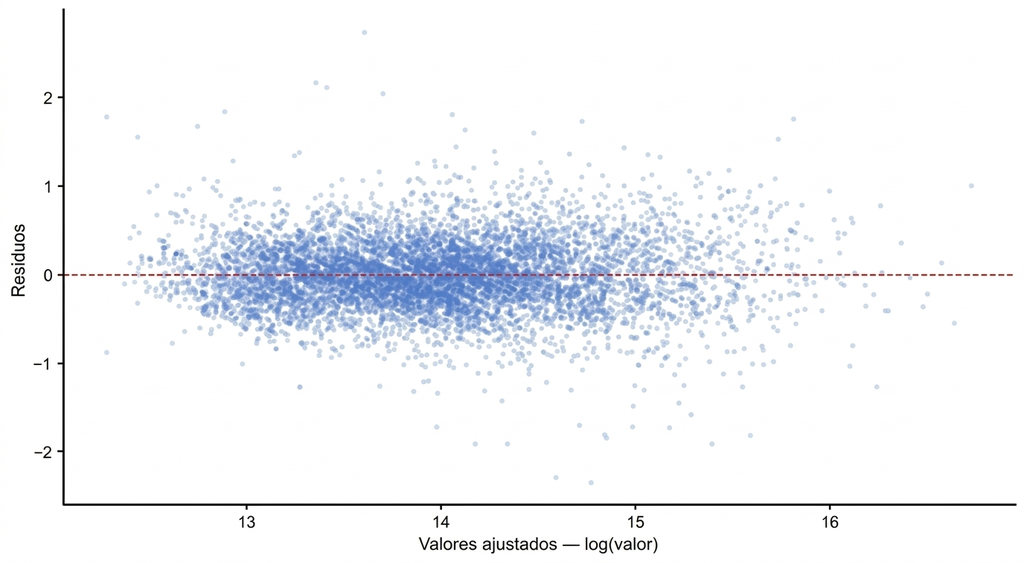
La heterocedasticidad detectada por la prueba de Breusch-Pagan (LM = 490,15, p < 0,001) es esperada en modelos hedónicos, documentada en relación tanto a la edad como al valor de los inmuebles (Goodman y Thibodeau, 1995; Malpezzi, 2003). La corrección por los errores estándar robustos HC3 no altera los coeficientes estimados, solo los errores estándar y los intervalos de confianza, preservando la validez de la inferencia. El gráfico de residuos versus valores ajustados, presentado en la Figura 9, no evidencia un patrón visual de heterocedasticidad acentuado, lo que es común en muestras grandes donde la prueba de Breusch-Pagan detecta desviaciones estadísticamente significativas, pero de pequeña magnitud práctica. La corrección por los errores estándar robustos HC3 se aplicó por precaución metodológica, preservando la validez de la inferencia.
Figura 9. Residuos versus valores ajustados
Fuente: Datos originales de la investigación
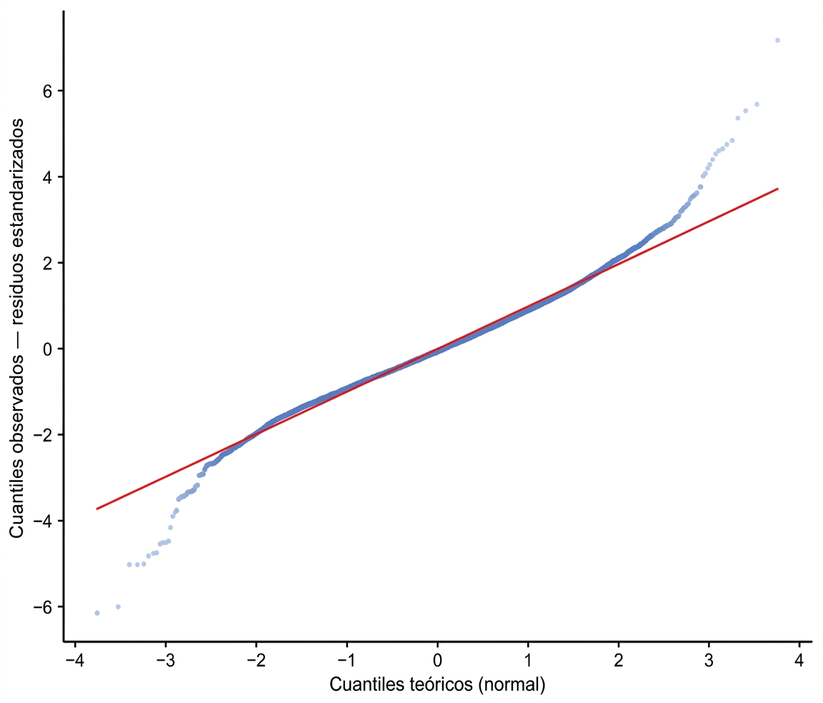
La curtosis excesiva de los residuos (2,28) indica colas más pesadas que la distribución normal, lo que sugiere un rendimiento menos preciso en los extremos de la distribución de precios. Este resultado se verifica en el QQ-plot de los residuos estandarizados de la Figura 10, donde los puntos en los extremos se alejan de la línea de referencia, y motivó el análisis complementario por segmento de mercado presentado en la siguiente sección.
Figura 10. QQ-Plot (Quantile-Quantile Plot) de los residuos estandarizados
Fuente: Datos originales de la investigación
Modelos de machine learning
La Tabla 7 presenta las métricas de rendimiento de los tres modelos en el conjunto de prueba, calculadas en la escala original en reales después de revertir la transformación logarítmica. A efectos de comparación equivalente con los modelos de aprendizaje automático, el MQO se reevaluó sobre el mismo conjunto de prueba del 20% de las observaciones, obteniendo un R² = 0,717. El valor inferior al R² de 0,764, presentado en la sección anterior, es una diferencia esperada, dado que aquel se calculó sobre las 8.056 observaciones utilizadas en el ajuste, mientras que este se refiere a datos que el modelo no había visto durante el entrenamiento.
Tabla 7. Comparativa de métricas entre modelos para conjunto de prueba
| Plantilla | R² Prueba | RMSE (BRL) | MAPE |
|---|---|---|---|
| OLS | 0,7168 | 971.153 | 29,17% |
| Random Forest | 0,7339 | 941.302 | 25,69% |
| XGBoost | 0,7419 | 927.113 | 26,27% |
Fuente: Resultados originales de la investigación
Los modelos ensemble superaron al MQO en todas las métricas evaluadas. El XGBoost presentó el mejor rendimiento en R² (0,742) y RMSE (R$ 927.113), mientras que el Random Forest obtuvo el menor MAPE (25,69%), indicando un menor error relativo en los inmuebles de valor intermedio. El RMSE de R$ 927.113 representa aproximadamente el 84% del valor mediano de los inmuebles de la muestra (R$ 1.100.000), reflejando la heterogeneidad estructural del mercado discutida en el análisis exploratorio, y no una falla de los modelos.
El patrón observado, con XGBoost ligeramente superior en métricas globales y Random Forest más preciso en error relativo, refleja las diferencias estructurales entre los dos algoritmos: el XGBoost, al construir árboles secuencialmente con enfoque en la reducción del residuo acumulado, tiende a minimizar el error cuadrático global, mientras que el Random Forest, al agregar árboles independientes entrenados en muestras distintas, presenta menor varianza en las predicciones individuales (Breiman, 2001; Chen y Guestrin, 2016). El MAPE residual del 25% al 29% es consistente con lo reportado en estudios hedónicos brasileños con datos de anuncios (Kappel y Teodoro, 2021). La varianza no explicada por los modelos es inherente a la naturaleza de los datos, ya que características determinantes del valor individual, como el estado de conservación, la calidad del acabado, la orientación solar y el piso, no se reportan sistemáticamente en los anuncios y, por lo tanto, no pueden incluirse en los modelos (Malpezzi, 2003; Campos, 2017).
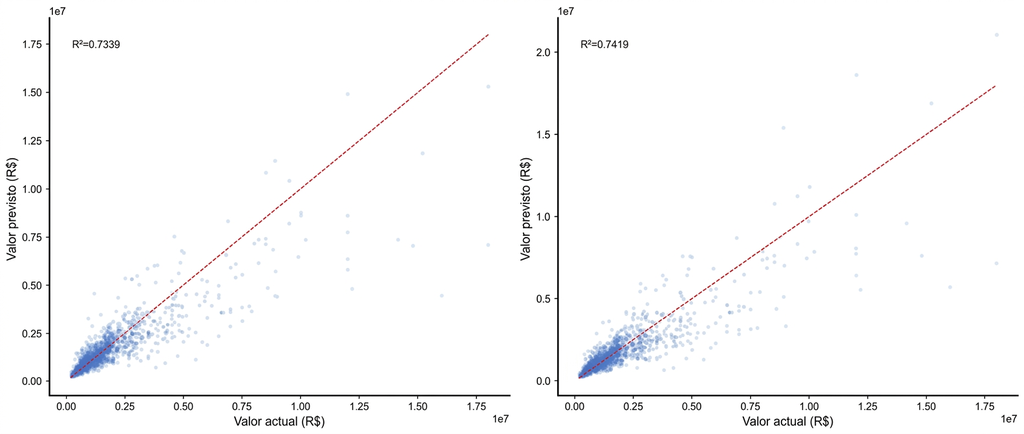
La Figura 11 presenta los valores reales versus predichos para Random Forest y XGBoost en el conjunto de prueba. En ambos modelos, los puntos se concentran cerca de la diagonal en las propiedades de valor intermedio, con mayor dispersión en los extremos de la distribución, un patrón consistente con el MAPE elevado y con la curtosis de los residuos observada en el MQO, y que motivó el análisis complementario por segmento de mercado presentado en la siguiente sección.
Figura 11. Valores reales versus predichos para Random Forest y XGBoost en el conjunto de prueba
Fuente: Datos originales de la investigación
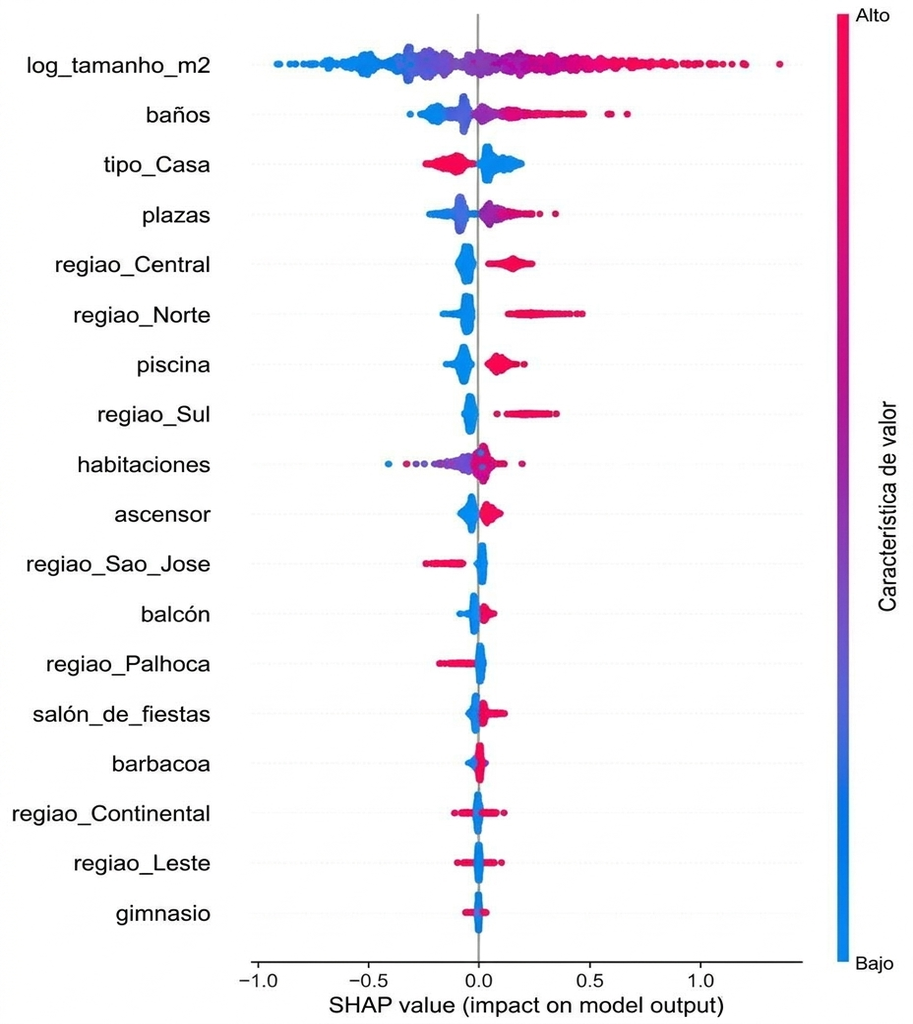
La interpretación de los modelos ensemble se realizó mediante valores SHAP (SHapley Additive exPlanations), un método basado en la teoría de juegos cooperativos que asigna a cada variable su contribución marginal media a la predicción de cada observación (Lundberg y Lee, 2017). Los valores SHAP se calcularon sobre una muestra aleatoria de 1.000 observaciones del conjunto de prueba, aplicados al XGBoost por ser el modelo de mejor rendimiento general.
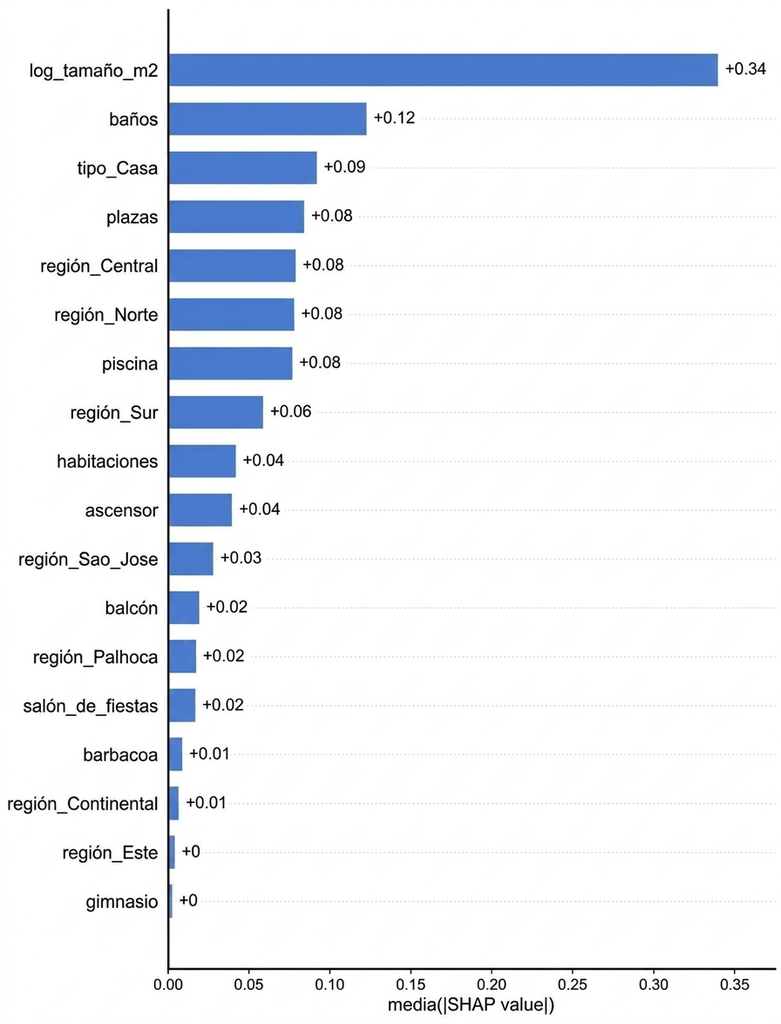
La Figura 12 presenta el ranking de importancia media absoluta de las variables y la Figura 13 presenta el beeswarm plot, donde cada punto representa una observación, el eje horizontal indica la magnitud y dirección del efecto de cada variable sobre la predicción, y el color indica el valor de la variable (rojo = alto, azul = bajo).
Figura 12. Importancia media absoluta de las variables — Valores SHAP (XGBoost)
Fuente: Datos originales de la investigación
Figura 13. Impacto de las variables sobre el precio predicho — Valores SHAP (XGBoost)
Fuente: Datos originales de la investigación
La variable con mayor importancia SHAP fue log_tamanho_m2, seguida por las variables regionales, confirmando que el tamaño y la ubicación son los principales determinantes del valor inmobiliario en la Gran Florianópolis. El beeswarm confirma que las propiedades más grandes tienen valores SHAP más altos para la variable de tamaño, es decir, cuanto más grande es la propiedad, mayor es su contribución a elevar el precio predicho. Este patrón es consistente con la elasticidad estimada por el MQO, pero el XGBoost captura esta relación de manera más flexible, sin restringirla a una proporción fija entre tamaño y precio. Las variables regionales presentan efectos de alta magnitud, reflejando el fuerte componente geográfico en la determinación del precio inmobiliario, un resultado ampliamente documentado en la literatura hedónica desde Rosen (1974). La comparación entre la ordenación de importancia de los coeficientes del MQO y los valores SHAP del XGBoost revela convergencia, ya que en ambos métodos, el tamaño, la ubicación y el número de baños figuran entre los principales determinantes del valor.
Análisis por segmento de mercado
Como análisis complementario, los tres modelos fueron reestimados en un recorte de la base de datos limitado al intervalo cerrado entre el percentil 5 y el percentil 95 de la distribución de valores (R$ 350.000 a R$ 4.712.500), correspondiente a 7.268 observaciones (90,2% del total). El objetivo fue verificar si el desempeño predictivo de los modelos mejora cuando los inmuebles en los extremos de la distribución (cuyo valor está determinado por factores no capturados por las variables disponibles, como alto estándar o alguna irregularidad) son excluidos del alcance. La Tabla 8 presenta la comparación entre los dos recortes.
Tabla 8. Rendimiento de los modelos: base de datos completa vs segmento [p5-p95]
| Plantilla | Cortar | R² | RMSE | MAPE |
|---|---|---|---|---|
| OLS | Íntegro | 0,7168 | 971.153 | 29,17% |
| OLS | Seccionado | 0,5809 | 600.663 | 27,27% |
| Random Forest | Íntegro | 0,7339 | 941.302 | 25,69% |
| Random Forest | Seccionado | 0,7165 | 494.002 | 23,78% |
| XGBoost | Íntegro | 0,7419 | 927.113 | 26,27% |
| XGBoost | Seccionado | 0,7213 | 489.794 | 23,69% |
Fuente: Resultados originales de la investigación
El resultado más relevante de este análisis es la caída acentuada del R² del MCO al remover los extremos (de 0,717 a 0,581, reducción de 13,6 puntos porcentuales), en contraste con la estabilidad de los modelos ensemble, cuyo R² cayó solo 1,7 y 2,1 puntos porcentuales para Random Forest y XGBoost, respectivamente. Este patrón tiene una explicación estadística: el R² se define como la proporción de la varianza total explicada por el modelo, y los inmuebles en los extremos de la distribución amplían esta varianza total. Al removerlos, la varianza total cae sustancialmente, y el MCO, por ser un modelo global que estima coeficientes únicos para toda la muestra, pierde tanto la varianza que sustentaba su R² como las observaciones influyentes que calibraban sus coeficientes. Los modelos de árbol, por realizar particionamiento local de los datos, son estructuralmente independientes de esta influencia, resultado consistente con la robustez documentada de métodos ensemble a observaciones influyentes (Breiman, 2001).
La mejora del MAPE en el segmento fue más modesta para todos los modelos (entre 1,9 y 2,6 puntos porcentuales), lo que indica que la varianza no explicada se distribuye por toda la gama de precios y no se concentra en los extremos. Esta información sugiere que la limitación predictiva de los modelos es estructural, determinada por la ausencia de variables relevantes en los datos del anuncio (como el estado de conservación, la calidad del acabado y el piso), y no puede simplificarse mediante recortes muestrales o elecciones metodológicas alternativas. Este resultado refuerza la recomendación del uso de modelos ensemble para la fijación de precios hedónica en mercados heterogéneos, donde la presencia de inmuebles atípicos es inevitable y el rendimiento del MQO puede ser sobreestimado cuando se evalúa en la muestra completa.
En resumen, este estudio analizó la eficiencia de técnicas de aprendizaje automático en la fijación de precios hedónica de inmuebles residenciales en la Gran Florianópolis. El modelo XGBoost presentó el mejor rendimiento predictivo general, con R² de 0,742 y RMSE de R$ 927.113, superando al Random Forest y al MQO. El Random Forest obtuvo el menor error relativo (MAPE = 25,69%), indicando mayor precisión en los inmuebles de valor intermedio. Los atributos más relevantes en la formación de precios, tanto por los coeficientes del MQO como por los valores SHAP del XGBoost, fueron el área del inmueble, la región de ubicación y el número de baños. Las primas regionales implícitas fueron expresivas, con inmuebles en la región Norte de Florianópolis valiendo un 111% más que inmuebles equivalentes en Biguaçu, y los de la región Sur, un 105% más. Entre las amenidades, piscina (+20%) y ascensor (+13%) presentaron las mayores primas implícitas. El análisis por segmento de mercado demostró que el MQO depende de los inmuebles en los extremos de la distribución para sostener su ajuste global, mientras que los modelos de árbol mantuvieron un rendimiento estable, evidenciando la superioridad de los métodos ensemble para aplicaciones de fijación de precios en mercados heterogéneos. Sin embargo, los datos provienen de anuncios en línea, reflejando el precio pedido y no el precio efectivamente transaccionado, lo que puede introducir un sesgo de sobreestimación. Variables relevantes para la determinación del precio no están disponibles en los anuncios (como estado de conservación, piso, orientación solar, vista y calidad de los acabados), lo que limita el poder predictivo de los modelos y explica el MAPE residual de aproximadamente 25%. La muestra corresponde a un recorte temporal único (marzo de 2026), no permitiendo análisis de tendencias o estacionalidad del mercado.
4. Conclusión
El estudio tuvo como objetivo analizar la eficiencia de las técnicas de aprendizaje automático en la fijación de precios hedónica de propiedades residenciales en la región de Gran Florianópolis, utilizando datos recopilados mediante web scraping de portales inmobiliarios en línea. Se encontró que XGBoost presentó el mejor rendimiento predictivo general, con un R² de 0,742 y un RMSE de R$ 927.113, mientras que Random Forest obtuvo el menor error relativo, con un MAPE de 25,69%, superando al MQO en todas las métricas evaluadas. Los principales determinantes del precio identificados fueron el área construida de la propiedad, la región de ubicación y el número de baños, con premios regionales expresivos, como el de la región Norte de Florianópolis, que valía un 111% más que propiedades equivalentes en Biguaçu. Entre las amenidades, piscina y ascensor registraron los mayores premios implícitos. La principal contribución del estudio reside en la demostración de la robustez y superioridad de los métodos ensemble para la fijación de precios hedónica en mercados inmobiliarios heterogéneos, donde la presencia de propiedades atípicas es común, ofreciendo una herramienta más precisa para compradores, vendedores e inversores.
Sin embargo, el estudio presenta limitaciones inherentes a la naturaleza de los datos, que provienen de anuncios en línea y reflejan el precio solicitado, no el transaccionado, lo que puede introducir un sesgo de sobreestimación. El modelo MCO, por su parte, presentó multicolinealidad severa entre el área construida y el número de habitaciones, lo que restringe la interpretación individual de estas variables. Variables relevantes para la determinación del precio, como el estado de conservación, el piso, la orientación solar y la calidad de los acabados, no estaban disponibles en los anuncios, limitando el poder predictivo de los modelos y explicando el MAPE residual de aproximadamente 25%. La muestra correspondió a un recorte temporal único en marzo de 2026, impidiendo el análisis de tendencias o estacionalidad. Para estudios futuros, se sugiere la incorporación de variables espaciales explícitas, como la distancia a polos de empleo y playas, la utilización de datos de transacción efectiva y la recopilación de datos en un período temporal más amplio para modelar la dinámica de precios y el impacto de ciclos económicos.
Referencias Bibliográficas
Breiman, Leo. 2001. Random Forests. Machine Learning 45(1): 5-32.
Campos, R. B. A. 2017. O mercado imobiliário residencial no município de São Paulo: uma abordagem de preços hedônicos espacial. Nova Economia 27(1): 303–337.
Chen, Tianqi; Guestrin, Carlos. 2016. XGBoost: A Scalable Tree Boosting System. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining
Dantas, Rubens Alves; Magalhães, André Matos; Vergolino, José Raimundo de Oliveira. 2007. Avaliação de imóveis: a importância dos vizinhos no caso de Recife. Revista de Economia Aplicada, Ribeirão Preto, v. 11, n. 2, p. 231-251, abr./jun
Field, Andy. 2018. Discovering Statistics Using IBM SPSS Statistics. 5ª ed. Londres: SAGE Publications.
Florianópolis. 2023. Lei Complementar N. 739, de 04 de maio de 2023. Altera a Lei Complementar N. 482, de 2014 (Plano diretor de Florianópolis) e consolida seu processo de revisão. Art. 210. Disponível em: https://www.cmf.sc.gov.br/proposicoes/Leis-Complementares/2023/1/0/89810. Acesso em 20 mar. 2026.
Fundação Instituto de Pesquisas Econômicas [FIPE] – Índice Fipezap venda residencial, informe de 12/2024. Disponível em https://downloads.fipe.org.br/indices/fipezap/fipezap-202412-residencial-venda-publico.pdf. Acesso em 20 mar. 2026.
Fávero, L. P. 2003. Modelos de preços hedônicos aplicados a imóveis residenciais em lançamento no município de São Paulo. Working Paper n. 03/002. FEA-USP, São Paulo.
Fávero, L. P.; Belfiore, P.; Lima, G. A. S. 2008. Modelos de precificação hedônica de imóveis residenciais na região metropolitana de São Paulo: uma abordagem sob as perspectivas da demanda e da oferta. Estudos Econômicos (São Paulo) 38(1).
Fávero, L.P.; Belfiore, P. 2024. Manual de Análise de Dados: estatística e Machine Learning com EXCEL®, SPSS®, STATA®, R® e Python®. 2ed. LTC, Rio de Janeiro, RJ, Brasil
Goodman, Allen C.; Thibodeau, Thomas G. 1995. Age-related heteroskedasticity in hedonic house price equations. Journal of Housing Research 6(1): 25–42.
Instituto Brasileiro de Geografia e Estatística [IBGE]. 2023. Panorama do Censo 2022. Disponível em https://censo2022.ibge.gov.br/panorama/. Acesso em 20 mar. 2026.
Kappel, M. A. A.; Teodoro, L. A. 2021. Modelo Hedônico para Estimação do Valor de Imóveis: Aplicação em Nova Friburgo-RJ. VETOR — Revista de Ciências Exatas e Engenharias 30(1): 28-37.
Lundberg, Scott M.; Lee, Su-In. 2017. A unified approach to interpreting model predictions. Advances in Neural Information Processing Systems 30: 4765–4774.
Malpezzi, Stephen. 2003. Hedonic pricing models: a selective and applied review. In: O’Sullivan, Tony; Gibb, Kenneth (Eds.). Housing Economics and Public Policy: Essays in Honor of Duncan Maclennan. Oxford: Blackwell Science, p. 67-89
Moro, Matheus Fernando. 2017. Modelo híbrido de séries temporais para previsão de demanda do mercado imobiliário de São Paulo. Tese (Doutorado).
Pedersen, Anne Marie B.; Weissensteiner, Alex; Poulsen, Rolf. 2013. Financial planning for young households. Annals of Operations Research 205: 55–76
Rosen, S. 1974. Hedonic prices and implicit markets: product differentiation in pure competition. Journal of Political Economy 82(1): 34–55.
Sirmans, G. Stacy; Macpherson, David A.; Zietz, Emily N. 2005. The composition of hedonic pricing models. Journal of Real Estate Literature 13(1): 1–44.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haz clic aquí y accede a la plataforma MBX Academy