
Tecnología
23 de octubre de 2025
Optimización de las acciones de auditoría fiscal mediante la clasificación de empresas utilizando aprendizaje automático
Autores: Giovana Amorim Zanato y Cláudio Tucci Junior
DOI: 10.22167/2675-6528-2024082
E&S 2025, 6: e2024082
La auditoría fiscal es un elemento central de la recaudación tributaria y el cumplimiento en el sector público, garantiza la aplicación correcta de las normas y ejerce un papel estratégico al viabilizar políticas públicas a través de los ingresos recaudados[1]. Con la transición del Impuesto sobre Circulación de Mercancías y Prestación de Servicios (ICMS) al Impuesto sobre Bienes y Servicios (IBS)[2], prevista para 2026, crece la relevancia de métodos de ciencia de datos y aprendizaje automático como herramientas para identificar riesgos de evasión fiscal, proporcionan reducción de costos, mayor transparencia y detección de valores atípicos al comparar el comportamiento de un contribuyente con el de su población de referencia[3].
Estudios previos sobre el uso de aprendizaje automático en auditoría fiscal han demostrado su eficacia en la detección de fraudes tributarias. Ruzgas y Kizauskiene[4] desarrollaron un estudio con varios modelos para la detección de delitos fiscales y demostraron que la técnica de minería de datos identifica la evasión fiscal y extrae conocimiento oculto aplicable a la reducción de las pérdidas de ingresos derivadas de la evasión.
Silva y Rigitano[5] realizaron un estudio de caso de fraude financiero con redes bayesianas en datos de contribuyentes de São Paulo, Brasil. Wahab y Bakar[6] aplicaron un conjunto de algoritmos de aprendizaje automático para clasificar el impuesto sobre la renta en el Inland Revenue Board de Malasia y verificaron la eficacia de diferentes algoritmos de machine learning en la selección de auditorías. Shi y Dong[7] estudiaron un modelo de red neuronal de gráfico heterogéneo para apoyar la detección de evasión fiscal. Estos trabajos evidencian el potencial del aprendizaje automático para mejorar la precisión y la eficiencia de las auditorías fiscales.
El informe de la Organización para la Cooperación y el Desarrollo Económicos (OCDE) (Auditorías fiscales en un entorno cambiante) enfatiza que las auditorías fiscales deben concebirse como instrumentos de cumplimiento tributario y de monitoreo basado en riesgos, capaces de identificar potenciales inconformidades de forma preventiva, reforzar el cumplimiento voluntario de las obligaciones tributarias y fortalecer la legitimidad y la transparencia del sistema tributario [8].
En este contexto, este estudio utiliza datos de propiedad de la Secretaría de Economía del Estado de Goiás, con registros históricos de auditorías e información declarada por los contribuyentes para comparar diferentes técnicas de aprendizaje automático con el objetivo de clasificar empresas con mayor riesgo de incumplimiento fiscal en relación con el ICMS.
Por lo tanto, este estudio tiene como objetivo aplicar y comparar modelos de aprendizaje automático para clasificar empresas, con el fin de dirigir de manera más eficaz las acciones de auditoría fiscal, reducir costos, aumentar la transparencia y fortalecer la lucha contra la competencia desleal.
Esta investigación adopta un enfoque cuantitativo, basado en datos numéricos de declaraciones fiscales y registros de auditoría, sometidos a técnicas estadísticas y de aprendizaje automático, y tiene un carácter descriptivo al analizar patrones de comportamiento de los contribuyentes y comparar el rendimiento de diferentes modelos predictivos para priorizar las acciones de auditoría fiscal[9].
Según Alpaydin[10], el aprendizaje automático es el área de la inteligencia artificial que desarrolla métodos para que las computadoras identifiquen patrones a partir de datos y realicen predicciones sin programación explícita. Un modelo de aprendizaje automático es la representación matemática construida a partir de datos, capaz de identificar patrones y generar predicciones o clasificaciones en nuevas situaciones[11].
La variable objetivo, que representa el resultado que el modelo busca predecir, es cuantitativa e indica el valor financiero, en reales, calculado a partir de auditorías fiscales realizadas por los auditores fiscales de la Secretaría de Economía del Estado de Goiás, entre 2019 y 2023, para 448 empresas minoristas de tamaño mediano y grande. Esta variable, denominada TRIBUTAVEL_AUTO en la base de datos utilizada, representa el valor de ICMS evadido por el contribuyente en el ejercicio fiscal analizado (Cuadro 1) que representa el valor que el modelo en cuestión pretende predecir para aquellos contribuyentes aún no auditados.
Tabla 1. Datos de la multa¹
| Nombre de la variable | Descripción |
| Período del hecho generador autuado | Mes y año de referencia del hecho generador notificado |
| Tributável_auto | Valor nominal del Impuesto sobre la Circulación de Mercancías y Servicios (ICMS) liquidado |
Nota. ¹El acta de infracción es el documento formal que instruye el proceso administrativo tributario.
Las variables explicativas sirven de parámetro para estimar el valor probable de ICMS evadido. La selección de las variables explicativas consideró criterios teóricos y de relevancia práctica para la apuración del ICMS, privilegiando información directamente relacionada con el comportamiento fiscal de los contribuyentes y las especificidades sectoriales. Se evitó incluir variables redundantes o altamente correlacionadas, como el “ICMS recaudado”, para reducir la multicolinealidad y preservar la interpretabilidad del modelo. Se reconoce, sin embargo, la posibilidad de sesgo de selección derivado de la propia base de datos, que refleja solo contribuyentes con EFDs completas y consistentes. Para mitigar este riesgo, se adoptaron verificaciones de integridad y coherencia de la información utilizada.
La determinación del contribuyente, representada en el registro E110 de la Escrituración Fiscal Digital (EFD)[12,13], consolida toda la actividad fiscal mensual del contribuyente y, según se detalla en el Cuadro 2, se seleccionaron variables constantes en este registro durante los períodos auditados.
Tabla 2. Determinación mensual del Contribuyente informada en la Escrituración Fiscal Digital (EFD)
| Nombre de la variable | Campo en la EFD | Descripción |
| Débito | VL_TOT_DEBITOS | Valor total de los débitos por salidas y prestaciones con débito del impuesto |
| Ajuste_débito_doc | VL_AJ_DEBITOS | Valor total de los ajustes a débito resultantes de documento fiscal |
| Ajuste_débito | VL_TOT_AJ_DEBITOS | Valor total de los ajustes a débito |
| Reembolso_crédito | EXTORNO DE CRÉDITOS | Valor total de reversiones de créditos |
| Crédito | VL_TOT_CREDITOS | Valor total de los créditos por entradas y adquisiciones con crédito del impuesto |
| Ajuste_crédito_doc | VL_TOT_AJ_CREDITOS | Valor total de los ajustes a crédito resultantes de documento fiscal |
| Ajuste_crédito | VL_AJ_CREDITOS | Valor total de los ajustes a crédito |
| Reembolso_débito | VL_ESTORNO_DEBITO | Valor total de los estornos de débitos |
| Saldo acreedor anterior | VL_SLD_CREDOR_ANT | Saldo acreedor del período anterior transferido al período de referencia |
| Saldo_calculado | VL_SLD_APURADO | Saldo deudor determinado |
| Deducción | VL_TOT_DED | Valor total de las deducciones |
| Icms_recaudar | VL_ICMS_RECOLHER | Valor total del Impuesto sobre la Circulación de Mercancías y Servicios (ICMS) a ser pagado a las arcas públicas |
| Saldo_acreedor_t | VL_SLD_ACREEDOR _TRASLADAR | Valor total del saldo acreedor que, cuando exista, será transportado al período siguiente |
| Salida_apur | DEB_ESP | Valores recogidos o a recoger, extra-cálculo |
Nota. Datos del registro E110, del bloque E, de la Escrituración Fiscal Digital (EFD)[13].
La carga tributaria del sector en el que opera la empresa (Cuadro 3), también forma parte de la lista de variables explicativas, ya que aporta particularidades fiscales de cada sector minorista que impactan de manera relevante el resultado del modelo.
Tabla 3. Carga tributaria del sector
| Nombre de la variable | Descripción |
| Ct_sector | Carga tributaria del sector, calculada por la selección de las facturas de operaciones de salida por tipo de actividad comercial y por la división del sumatorio del Impuesto sobre Circulación de Mercancías y Servicios (ICMS) por el sumatorio de los valores nominales de los productos |
Nota: Se utilizaron datos de totalizadores de operaciones de salidas constantes en el registro C190 de la Escrituración Fiscal Digital (EFD)[13].
Todos los datos necesarios para el trabajo están almacenados en las bases de datos de la Secretaría de Economía del Estado de Goiás. La extracción, la selección y el saneamiento de los datos se realizaron con el software SAS Enterprise Guide v.9.2 (Statistical Analysis Sistema, Cary, NC, USA), por medio de la creación de flujos para la generación de los archivos de salida en formato CSV.
El desarrollo de los algoritmos se realizó en el programa R, con las bibliotecas tidyverse, rgl, jtools, Rmisc, caret, neuralnet aplicadas en el procesamiento y análisis de los datos. Los datos trabajados no presentan identificación del contribuyente y los valores están totalizados para imposibilitar su identificación, en consonancia con las normas específicas de secreto fiscal.
En el caso en estudio, no se incluyeron empresas en conformidad fiscal debido a la imposibilidad de determinación, ya que una empresa distribuida para auditoría presenta algún indicio de irregularidad. Por el contrario, no es posible afirmar que las empresas no distribuidas para auditoría estén en plena regularidad fiscal en cuanto a la liquidación del ICMS.
Entre las técnicas de aprendizaje automático disponibles, se seleccionaron para estudio comparativo los modelos de regresión lineal multivariada, random forest y redes neuronales artificiales. El modelo que presente el mejor rendimiento, según las métricas específicas de evaluación, se aplicará sobre la base de los demás contribuyentes, con el fin de estimar el valor potencial de ICMS omitido a partir de las variables proporcionadas y apoyar la priorización de las acciones de fiscalización.
El estudio se inició con el desarrollo de la técnica de regresión lineal multivariada con el fin de comprender el comportamiento del fenómeno en cuestión a partir de las variables explicativas. Con los datos históricos de resultados de auditorías fiscales, se esperaba que el modelo proporcionara la estimación de ICMS recaudado, es decir, el valor de ICMS omitido y no recaudado a las arcas públicas estatales, conforme a la liquidación mensual y la carga tributaria del sector del contribuyente analizado.
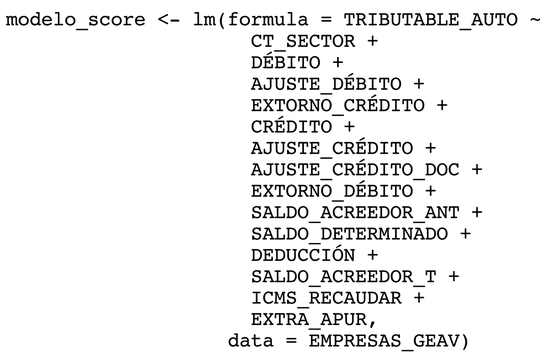
La normalización de las variables y la ejecución inicial del modelo, a través del comando lm (Figura 1), revelaron la presencia de parámetros sin significancia estadística, lo que indicó la necesidad de refinamiento. Para incluir en el modelo final solo variables con influencia estadísticamente significativa sobre el resultado, se aplicó el procedimiento stepwise[14], que evalúa y remueve gradualmente las variables sin contribución relevante.
Fuente: Datos originales de la investigación.
A continuación, se aplicó la transformación de Box-Cox[15], técnica matemática que ajusta las variables para aproximar su distribución a la normalidad, lo que fortalece la validez y la confiabilidad del modelo. Los resultados se describen en el Cuadro 4.
Tabla 4. Resultado de la estimación del modelo después de la transformación de Box-Cox y el procedimiento stepwise
| Nombre de la Variable | Apreciado | Estándar | Error | valor t | Pr(>|t|) |
| (Intercepto (modelo de regresión)) | 0,05591 | 0,01297 | 4,312 | 2e-05 | *** |
| CT_SECTOR | -0,05005 | 0,02213 | -2,262 | 0,02419 | * |
| DÉBITO | -4,18415 | 1,86388 | -2,245 | 0,02528 | * |
| AJUSTE_DÉBITO | -0,19378 | 0,08748 | -2,215 | 0,02727 | * |
| REEMBOLSO_CREDITO | -0,13765 | 0,05635 | -2,443 | 0,01498 | * |
| CRÉDITO | 2,65803 | 1,13202 | 2,348 | 0,01932 | * |
| AJUSTE_CRÉDITO | 0,79261 | 0,29350 | 2,701 | 0,00719 | ** |
| REVERSIÓN_DÉBITO | 1,02801 | 0,07873 | 13,057 | <2e-16 | *** |
| SALDO_CALCULADO | 0,94823 | 0,45529 | 2,083 | 0,03787 | * |
| DEDUCCIÓN | 0,12780 | 0,05925 | 2,157 | 0,03155 | * |
| EXTRA_APUR | -0,21454 | 0,06758 | -3,175 | 0,00161 | ** |
Nota. Error residual estándar: 0,07244 en 434 grados de libertad; R-cuadrado: 0,437; R-cuadrado ajustado: 0,424; estadística F: 33,69 en 10 y 434 GL; p-value: < 2,2e-16; Pr(>t): niveles de significancia: ***: entre 0 y 0,001; **: entre 0,001 y 0,01; *: entre 0,01 y 0,05.
Tras generar el modelo, se aplicó la prueba de Shapiro-Francia, una prueba simple y robusta para
verificar la normalidad de los residuos. Según se presenta en el Cuadro 5, el modelo en estudio presentó un P-value = 2,2e-16, lo que evidencia incompatibilidad con una distribución normal, y el modelo no resultó adecuado para el estudio en cuestión[14].
Tabla 5. Prueba de normalidad Shapiro-Francia
| dato: step_modelo_bc_SCORE$residuals |
| W = 0,51394, valor p < 2,2e-16 |
Tras el análisis inicial, se constató que el modelo de regresión lineal no era adecuado para el estudio, ya que los datos presentaban características de no linealidad. Ante esto, se seleccionó el random forest, un algoritmo de aprendizaje automático reconocido por su robustez. Esta técnica combina el poder de múltiples árboles de decisión y presenta eficacia en el tratamiento de relaciones complejas y no lineales en los datos. Además de aumentar la precisión del modelo, el enfoque minimiza el riesgo de overfitting (ajuste excesivo a los datos) y garantiza que las conclusiones sean más confiables y generalizables a otros escenarios[16].
La primera etapa de la aplicación de la técnica, después de la carga de los datos, es la separación de la base en entrenamiento, validación y prueba. La base de entrenamiento se utiliza para ajustar los parámetros del modelo y para que aprenda patrones a partir de los datos. En relación con la base de validación, se utiliza durante el entrenamiento para definir hiperparámetros, comparar modelos y evitar el sobreajuste. Y la base de prueba se aplica solamente después del entrenamiento y la validación, proporciona una forma independiente de medir el rendimiento del modelo en datos inéditos, lo que permite evaluar su capacidad de generalización. En el modelo en estudio, la base de entrenamiento comprendió el 60% de los datos, la base de validación el 20% y la base de prueba el 20% restante.
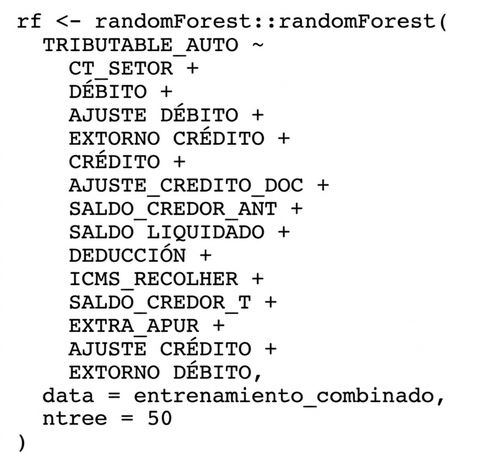
Se probaron varias combinaciones de variables y configuraciones de parámetros. Los mejores resultados ocurrieron cuando la variable AJ_DEBITO_DOC fue desconsiderada, ya que resultó irrelevante para el modelo. La configuración de parámetro que presentó el mayor R2 (proporción de la variabilidad de la variable objetivo explicada por el modelo) en la base de prueba utilizó la base de validación incorporada a la base de entrenamiento, con el propósito de ampliar el conjunto de entrenamiento.
El modelo fue entrenado con 50 árboles (ntree = 50), según el algoritmo representado en la Figura 2.
Fuente: Datos originales de la investigación.
El R2 obtenido en la base de prueba fue del 61%, con un error cuadrático medio (Mean of Squared Error – MSE) = 2.496516e+14 y un porcentaje de variabilidad explicada del 15.12%, según se presenta en los Cuadros 6 y 7.
Tabla 6. Evaluación del modelo con el uso de la técnica de random forest
| Fundamento | MSE¹ | R2² |
| Entrenamiento | 5,816345e+13 | 0,8022467 |
| Prueba | 2,239706e+14 | 0,6133123 |
Nota: ¹MSE: Mean Squared Error – error cuadrático medio. ²R²: coeficiente de determinación.
Tabla 7. Características de la variable creada con algoritmo de random forest
| Tipo de bosque aleatorio | Regresión |
| Número de árboles | 50 |
| Número de variables probadas en cada división | 4 |
| Media de residuos cuadrados | 2,496516e+14 |
| Porcentaje de explicabilidad de la variable (%) | 15,12 |
El análisis de las variables en la base de prueba, a la luz del contexto específico del problema, indica que el R2 del 61% puede considerarse moderadamente bueno, es decir, el 61% de la variabilidad de la variable TRIBUTAVEL_AUTO es explicada por el modelo. Sin embargo, al observar un porcentaje de explicabilidad de las variables del 15, 12 y un MSE de 2,239706e+14, se concluye que el modelo no presenta una capacidad predictiva adecuada y puede no constituir una solución satisfactoria para el problema. A partir de esta evaluación, se identificó la necesidad de analizar el problema con la técnica de redes neuronales artificiales.
Las redes neuronales artificiales se inspiraron en el funcionamiento del cerebro humano. Estos sistemas computacionales están compuestos por unidades interconectadas, denominadas neuronas artificiales, que procesan información y aprenden patrones complejos a partir de los datos. La estructura de las redes neuronales consiste en capas de neuronas, en las cuales cada neurona realiza operaciones matemáticas para transformar los datos de entrada en salidas útiles. La principal característica de las redes neuronales es la habilidad de aprendizaje, con la mejora constante del rendimiento del modelo, cuyo entrenamiento ocurre a través de un proceso iterativo de ajustes de los pesos entre los nodos, con técnicas como el descenso del gradiente. [17]
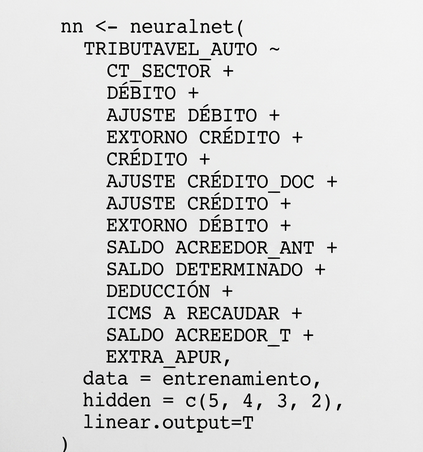
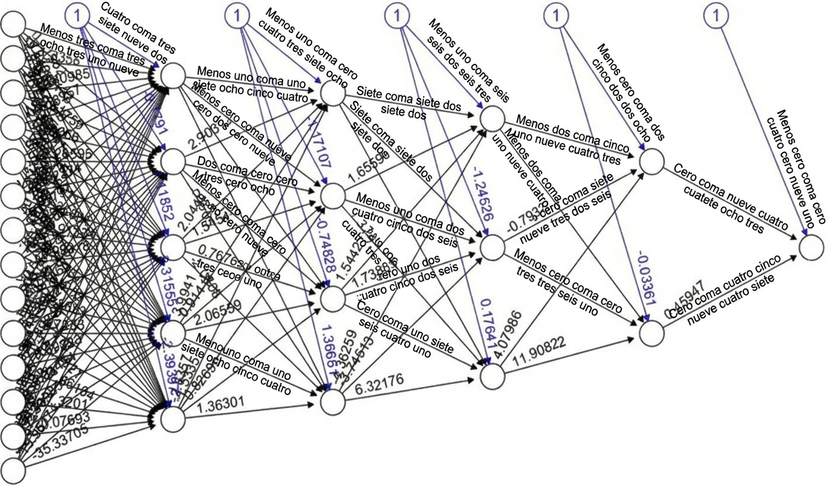
El primer paso en la aplicación del modelo de redes neuronales en el caso de estudio consistió en la normalización de las variables, seguida de la división de la base en 70% para entrenamiento y 30% para prueba. El siguiente paso fue la ejecución del algoritmo de redes neuronales, demostrado en la Figura 3. Se probaron varias combinaciones de variables explicativas e hiperparámetros. Al igual que en el modelo de random forest, los mejores resultados ocurrieron cuando la variable AJ_DEBITO_DOC fue desconsiderada, ya que resultó irrelevante para el modelo. La combinación de hiperparámetros que presentó mejor desempeño incluye cuatro capas intermedias: la primera con cinco neuronas, la segunda con cuatro, la tercera con tres y la cuarta con dos, según la arquitectura del modelo presentada en la Figura 4, y la utilización de una función de activación en la salida.
Fuente: Datos originales de la investigación.
Fuente: Datos originales de la investigación.
El modelo presentó un MSE de 0,007816 en la base de prueba, como se presenta en el Cuadro 8. Él
proporciona una medida de la precisión general del modelo de redes neuronales en relación con los datos de prueba. Cuanto menor sea el valor del MSE, más cercanas estarán las predicciones a los valores reales[11]. Dado que el MSE se calculó sobre datos de prueba independientes, el modelo demuestra una buena capacidad de generalización, lo que permite su aplicación en otras bases de contribuyentes minoristas y la identificación de aquellos con potenciales indicios de evasión fiscal.
Tabla 8. Datos de evaluación del modelo con la utilización de la técnica de redes neuronales
| Fundamento | MSE¹ | R2² |
| Entrenamiento | 0,002264842 | 0,704415 |
| Prueba | 0,007816353 | 0,3610342 |
Nota: Nota: ¹MSE: Mean Squared Error – error cuadrático medio. ²R2: coeficiente de determinación.
El gráfico presentado en la Figura 5 fue generado a partir del modelo de redes neuronales artificiales y muestra,
en rojo, los valores reales de omisión de ICMS, es decir, los valores de ICMS imputados en acciones fiscales, y, en azul, los valores de ICMS omitidos previstos por el modelo en la base de prueba.
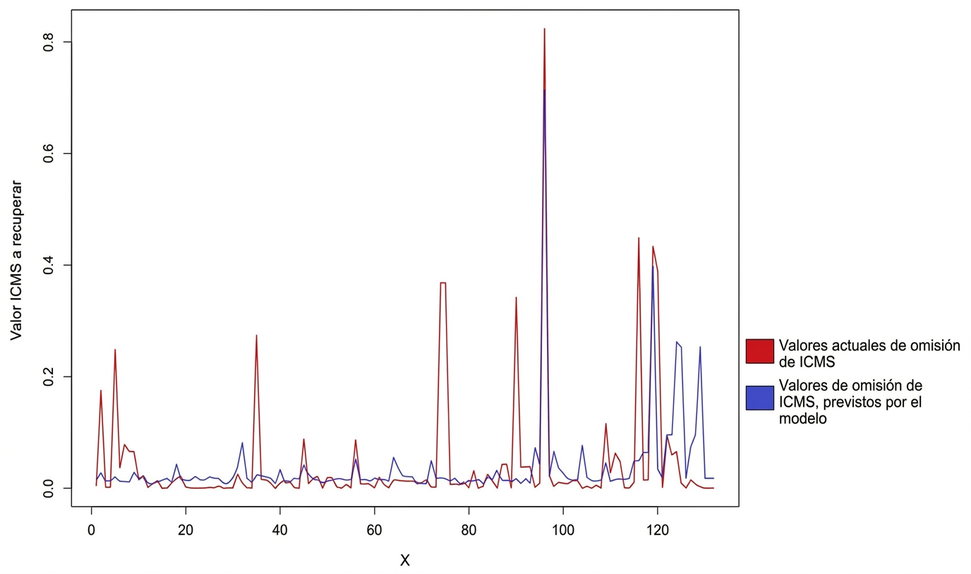
Fuente: Datos originales de la investigación.
Nota. Gráfico generado en el software R a partir del modelo generado en el mismo software.
Los resultados de este estudio corroboran los hallazgos de investigaciones anteriores, que indican que los modelos de redes neuronales son eficaces en la detección de patrones complejos y no lineales en datos fiscales[18]. Aunque el modelo de random forest ha presentado un R² superior, el bajo MSE de la red neuronal destaca su capacidad de proporcionar predicciones más precisas.
El enfoque metodológico de este estudio —que combinó regresión lineal multivariada, random forest y redes neuronales— contribuyó no solo a evaluar diferentes niveles de complejidad estadística, sino también a generar interpretaciones prácticas relevantes para la gestión fiscal. La comprensión de las relaciones entre las variables permitió identificar patrones asociados a la probabilidad de evasión, proporcionando subsidios para el direccionamiento más eficiente de las auditorías y para el uso más racional de los recursos de fiscalización.
La comparación entre los modelos también evidenció el potencial de las técnicas de aprendizaje automático para aumentar la precisión de las predicciones, lo que puede resultar en una reducción de costos operativos y un impacto positivo en la recaudación, al concentrar esfuerzos en contribuyentes con mayor riesgo fiscal. De esta forma, los resultados obtenidos extrapolan el campo metodológico y ofrecen herramientas concretas de apoyo a la decisión en la administración tributaria.
El análisis en profundidad del ICMS y la identificación de patrones de evasión fiscal ofrecen subsidios importantes para la futura gestión del IBS, dado que ambos comparten características estructurales: inciden, en esencia, sobre la circulación de mercancías y servicios, poseen naturaleza de tributos indirectos, cuya carga se transfiere al consumidor final, y adoptan la no acumulación, con acreditamiento del impuesto pagado en las etapas anteriores de la cadena. El IBS presenta, sin embargo, una ventaja significativa en relación con la amplitud de la base de incidencia, que abarcará no solo las operaciones sujetas actualmente al ICMS, sino también otros servicios, locaciones y actividades financieras[2].
Además, su regulación será más uniforme, a diferencia del ICMS, cuya disciplina normativa está fragmentada entre los estados. En este escenario, los conjuntos de datos disponibles para análisis fiscales tienden a ser sustancialmente mayores y más consistentes. Este factor favorece la aplicación de modelos de aprendizaje automático con menor susceptibilidad a ruidos y mayor capacidad de identificación robusta de relaciones complejas.
El estudio cumplió su objetivo de investigar cómo modelos de inteligencia artificial, específicamente redes neuronales, pueden ser aplicados para identificar patrones de evasión fiscal y proporcionar subsidios a la gestión tributaria. A pesar de algunas limitaciones, como la restricción a 15 variables específicas y la dependencia de datos de sectores seleccionados, que en el ámbito estatal, específicamente en el Estado de Goiás, constituyen una población restringida para el estudio y que puede incluso ser un limitador a la generalización de los resultados, fue posible desarrollar un modelo con alto nivel de previsibilidad para los valores observados.
Al identificar patrones complejos de evasión, el modelo propuesto puede adaptarse al nuevo sistema tributario brasileño, de modo a auxiliar en el desarrollo de mecanismos más robustos de auditoría y conformidad. Investigaciones futuras pueden explorar bases de datos más amplias, incluir variables adicionales y evaluar la aplicación del modelo en diferentes sectores, con el fin de aprimorar la precisión y la eficacia de las estrategias de fiscalización en el contexto de la reforma tributaria.
REFERENCIAS
[1] Santos, C. 2015. Auditoria Fiscal e Tributária. 3ed. São Paulo, SP: IOB.
[2] Brasil. 1988. Constituição da República Federativa do Brasil. Brasília, DF: emenda constitucional n. 132. Disponível em: http://www.planalto.gov.br/ccivil_03/constituicao/constituicao.htm . Acesso em: 15 set. 2025
[3] Alexopoulos, A.; Kotsogiannis, C.; Dellaportas, P.; Olhede, S. C.; Gyoshev, S.; Pavkov, T. 2025. A network approach to detect Value Added Tax fraud. Department of Economics, AUEB, Greece. Disponível em: https://arxiv.org/pdf/2106.14005 . Acesso em: 15 set. 2025.
[4] Ruzgas, T.; Kižauskienė, L.; Lukauskas, M.; Sinkevičius, E.; Frolovaitė, M.; Arnastauskaite, J. 2023. Tax Fraud Reduction Using Analytics in an East European Country. MDPI (Multidisciplinary Digital Publishing Institute). Disponível em: https://www.mdpi.com/2075-1680/12/3/288 . Acesso em: 15 set. 2025.
[5] Silva, L. S.; Rigitano, H. C.; Carvalho, R. N.; Souza, J. C. F. 2016. Bayesian Networks on Income Tax Audit Selection – A Case Study of Brazilian Tax Administration. Brasília, DF. Disponível em: https://ceur-ws.org/Vol-1663/bmaw2016_paper_3.pdf . Acesso em: 15 set. 2025.
[6] Wahab, R. A. S. R.; Bakar, A. A. 2021. Digital Economy Tax Compliance Model in Malaysia using Machine Learning Approach. Disponível em: https://www.ukm.my/jsm/pdf_files/SM-PDF-50-7-2021/20.pdf . Acesso em: 15 set. 2025.
[7] Shi, B.; Dong, B. 2023. An edge feature aware heterogeneous graph neural network model to tax evasion detection. Artigo. Expert System with Applications: An International Journal. Disponível em: https://dl.acm.org/doi/10.1016/j.eswa.2022.118903 . Acesso em: 15 set. 2025.
[8] Organização para a Cooperação e Desenvolvimento Econômico (OECD). 2017.. Tax Changing Tax Compliance Enviroment and the Role of Audit. 2017 OCDE – Organização para a Cooperação e Desenvolvimento Econômico. Paris. Disponível em: https://www.oecd.org/en/publications/the-changing-tax-compliance-environment-and-the-role-of-audit_9789264282186-en.html . Acesso em: 15 set. 2025.
[9] Creswell, J. W. 2022 Research design: qualitative, quantitative, and mixed methods approaches. 6ed. Thousand Oaks, CA, EUA: Sage.
[10] Alpaydin, E. 2020. Introduction to Machine Learning. 4ed. Cambridge, MA, USA: The MIT Press.
[11] Hastie, T.; Tibshirani, R.; Friedman, J. 2009. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. 2ed. New York: Springer.
[12] Brasil. 2007. Decreto n. 6.022, de 22 de janeiro de 2007. Institui o Sistema Público de Escrituração Digital – Sped. Receita Federal do Brasil, Brasília, DF. Disponível em: http://www.planalto.gov.br/ccivil_03/_ato2007-2010/2007/Decreto/D6022.htm. Acesso em: 15 set. 2025.
[13] Sistema Público de Escrituração Digital.2023. Guia prático da escrituração fiscal digital – EFD ICMS/IPI. v.3.1.5. Disponível em: http://sped.rfb.gov.br/arquivo/show/7273. Acesso em: 15 set. 2025.
[14] Fávero, L. P.; Belfiore, P. 2022. Análise de dados: estatística e modelagem multivariada com Excel, SPSS e Stata. Rio de Janeiro: LTC.
[15] Box, G. E. P.; Cox, D. R. 1964. An Analysis of Transformations.Journal of the Royal Statistical Society. Series B. 26(2). 211-252.
[16] Angshuman, P.; Dipti, P. M.; Prasun, D.; Abhinandan, G.; Appa, R. C.; Saurabh, K. 2018. Random Forest aprimorado para classificação. IEEE Transactions on Image Processing, 27. Disponível em: https://ieeexplore.ieee.org/document/8357563 . Acesso em: 15 set. 2025.
[17] Hardesty, L. 2017. Explained: Neural networks: Ballyhooed artificial-inteligence technique known as “deep learming” revives 70-years-old idea. MIT News. Disponível em: https://news.mit.edu/2017/explained-neural-networks-deep-learning-0414. Acesso em: 15 set. 2025.
[18] Pérez López, C.; Delgado Rodríguez, M.J.; Lucas Santos, S. 2019. Tax Fraud Detection through Neural Networks: An Application Using a Sample of Personal Income Taxpayers. Future Internet. 11(4), p. 86. doi:10.3390/fi11040086. Disponível em: https://www.mdpi.com/1999-5903/11/4/86 . Acesso em: 15 set. 2025.
COMO CITAR
Zanato, G.A.; Tucci Jr, C. Otimização das ações de auditoria fiscal através do ranqueamento de empresas utilizando aprendizado de máquina. Revista E&S. 2025; 6: e2024082.
SOBRE LOS AUTORES
Giovana Amorim Zanato – Especialista en Ciencia de Datos y Analítica. Auditora Fiscal de la Secretaría de Ingresos Estatales. Secretaría de Economía del Estado de Goiás. Avenida Vereador José Monteiro, 2233, Setor Vila Nova, 74653-900, Goiânia, Goiás, Brasil.
 Doctor en Ciencias Sociales. Profesor orientador. Avenida Paulista, 1159, Conjuntos 612 y 613, Cerqueira César, São Paulo, SP, Brasil.