
16 de septiembre de 2026
Modelos Multivariados Aplicados a la Predicción de Retrasos en el Transporte Carretero Regular Interestatal en Brasil
Paola Fernanda Silveira Monteiro; William Barbosa
DOI: 10.22167/2675-6528-202602304
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
La integración del territorio brasileño se ha basado históricamente en el modo de transporte por carretera, esencial para la movilidad nacional, pero su eficiencia se ve constantemente desafiada por la gestión del tiempo, lo que repercute en el bienestar social y la salud financiera de las empresas de transporte. El objetivo fue predecir retrasos superiores a 30 minutos en el transporte regular por carretera entre estados en Brasil, utilizando modelos de Machine Learning. Para ello, se emplearon 906.476 registros de viajes de la ANTT de 2024. Se aplicaron algoritmos como Regresión Logística, Random Forest y XGBoost, con técnicas de balanceo de datos como UnderSampling, SMOTE y ADASYN. El Balanced Random Forest obtuvo el mejor rendimiento predictivo, tratando la asimetría de los datos y presentando un bajo coste computacional, lo que posibilitó su aplicación en entornos de producción real. El análisis evidenció que las regiones fuera del eje Sudeste/Sur mostraron una tasa de retraso superior. Se concluyó que el modelo puede emplearse como un “Score” de Propensión al Retraso, ofreciendo una herramienta de inteligencia competitiva para identificar itinerarios críticos, optimizar recursos preventivos y mitigar riesgos operativos.
Palabras clave: Balanced Random Forest; Eficiencia Operacional; Machine Learning; Score de Propensión al Retraso.
1. Introducción
El transporte por carretera constituye el principal vector de movilidad en Brasil, siendo históricamente la columna vertebral de la integración territorial y responsable del 95% del transporte de pasajeros en territorio nacional (CNT, 2023). En 2023, el servicio regular interestatal movió más de 43 millones de pasajeros, evidenciando un aumento del 2,3% en relación con el año anterior y reforzando la relevancia de este modal en un escenario de expansión económica y urbanización (TRIIP, 2023). La eficiencia del sistema de transportes está intrínsecamente ligada al desarrollo económico y social de un país, proporcionando la integración regional y el acceso a bienes y servicios (Neto et al., 2017).
A pesar de su predominancia estratégica, el sistema vial brasileño enfrenta desafíos estructurales y de eficiencia, especialmente en lo que respecta a la gestión del tiempo. La puntualidad y la integridad son atributos fundamentales para la eficacia del transporte público, impactando directamente el bienestar social y la percepción de calidad del usuario (Lopes et al., 2021). Además de la satisfacción del pasajero, la mitigación de retrasos es crucial para la salud financiera de las operadoras, que operan con márgenes de beneficio estrechos, entre el 5,02% y el 12%. Cualquier imprecisión puede generar la movilización innecesaria de reservas técnicas, resultando en costos adicionales por inactividad de la flota, consumo extraordinario de combustible y horas extras no planificadas (ANTT, 2020).
En este contexto, la ocurrencia de retrasos superiores a 30 minutos representa un cuello de botella estratégico significativo para la eficiencia del sistema, aunque es un evento relativamente raro, correspondiente a solo el 4,54% del total de viajes analizados. Esta característica de rareza de la variable respuesta configura un severo desbalanceo de los datos, imponiendo desafíos específicos a la modelización predictiva, ya que los algoritmos de clasificación tienden a privilegiar la clase mayoritaria, lo que puede comprometer la sensibilidad del sistema en la detección de eventos de retraso (He y Garcia, 2009). La rareza del retraso es una característica intrínseca del sistema de transporte por carretera, y no una anomalía de recolección de datos, demandando enfoques metodológicos capaces de lidiar con esta asimetría estructural.
Ante la complejidad y el impacto de los retrasos, el presente estudio se justifica por la necesidad de desarrollar herramientas analíticas avanzadas para mejorar la gestión operativa del transporte por carretera. La aplicación de modelos de Machine Learning, como Regresión Logística, Random Forest y Extreme Gradient Boosting, surge como un enfoque prometedor para identificar patrones y variables determinantes de la puntualidad. La innovación reside en la propuesta de un “Score de Propensión al Retraso”, que transforma la predicción en una herramienta de inteligencia competitiva, permitiendo a las transportadoras clasificar itinerarios críticos y optimizar la asignación de recursos preventivos, mitigando riesgos financieros y elevando la calidad percibida por el usuario.
El presente estudio tiene como objetivo estimar y comparar modelos para estimar la ocurrencia de retrasos en el transporte por carretera interestatal regular de pasajeros en Brasil, a partir de datos operativos referentes al período de enero a diciembre de 2024. Para ello, se emplean algoritmos de clasificación, como Regresión Logística, Random Forest y Extreme Gradient Boosting [XGBoost], con el fin de identificar patrones y variables determinantes del desempeño operativo. A partir de estas estimaciones, se propone la construcción de un Puntaje de Propensión al Retraso, permitiendo la clasificación de los itinerarios según el nivel de criticidad. Este enfoque busca contribuir a la mejora de la gestión operativa, la priorización de intervenciones y la optimización de la asignación de recursos en el sector.
2. Material y Métodos
Esta investigación tiene naturaleza exploratoria, descriptiva y aplicada, con enfoque cuantitativo. El estudio emplea algoritmos de “Machine Learning” para clasificar la ocurrencia de retraso o no retraso, enfocándose en el análisis de la influencia de factores contextuales y operacionales en la puntualidad del sistema de transporte a través de variables categóricas. Para lidiar con el desbalanceo natural entre las clases de la variable respuesta, se aplicaron técnicas de balanceo de datos, incluyendo “UnderSampling”, “Synthetic Minority Over-sampling Technique“ [SMOTE], “Adaptive Synthetic Sampling” [ADASYN] y el “Balanced Random Forest”.
Para el análisis, se utilizaron datos públicos de la Agencia Nacional de Transportes Terrestres (ANTT) referentes a viajes por carretera regulares interestatales en Brasil, recopilados de enero a diciembre de 2024. La base de datos, en formato “comma-separated values” [csv], contiene información operativa de 906.476 registros de viajes realizados en todo el territorio nacional. La Tabla 1 detalla la información original de esta base.
Tabla 1. Diccionario de la base de datos del informe de viajes por carretera interestatales regulares
| Columnas | Clase | Disposición |
|---|---|---|
| Lámina | Alfanumérico | |
| nueva_linea | Alfanumérico | |
| fecha_viaje_programada | Datos | DD/MM/YYYY |
| hora_viaje_programado | Tiempo | HH:MM:SS |
| fecha_inicio_viaje | Fecha/Hora | DD/MM/YYYY HH:MM:SS |
| fecha_fin_viaje | Fecha/Hora | DD/MM/YYYY HH:MM:SS |
| Latitud | Cuantitativo | |
| Longitud | Cuantitativo | |
| Pdop | Cuantitativo |
Fuente: Datos originales de la investigación
Los campos “placa” y “nu_linha” identifican el vehículo y el número de línea, respectivamente. Las variables “data_viagem_programada” y “hora_viagem_programada” indican la fecha y la hora previstas, mientras que “data_inicio_viagem” y “data_fim_viagem” registran los momentos efectivos de partida y llegada. “Latitude” y “Longitude” proporcionan las coordenadas geográficas del punto final, y “position dilution of precision” [pdop] expresa la precisión del posicionamiento. La información adicional sobre el año de fabricación y el tipo de vehículo se incorporó mediante el cruce con una segunda base de datos, utilizando las placas como clave de relación. La estructura de las nuevas columnas se puede consultar en la Tabla 2.
Tabla 2. Diccionario de la base de datos de vehículos de viajes por carretera interestatales regulares
| Columnas | Clase | Disposición |
|---|---|---|
| Lámina | Alfanumérico | |
| Tipo de vehículo | Alfanumérico | |
| Año de fabricación | Datos |
Fuente: Datos originales de la investigación.
La preparación de los datos implicó limpieza, tratamiento de inconsistencias y eliminación de datos irrelevantes, como rutas internacionales y variables no enfocadas en el estudio. Se realizó la conversión y estandarización para la ordenación temporal de los registros. Los análisis se llevaron a cabo en el entorno de desarrollo Spyder, utilizando paquetes como pandas 2.3.3, numpy 1.26.4, scipy 1.16.3, matplotlib 3.8.0, seaborn 0.13.2, statsmodels 0.14.1, scikit-learn 1.2.2, xgboost 3.0.4, shap 0.46.0, imbalancedlearn 0.11.0, geopandas 1.0.1 y holidays 0.75 en Python 3.11. Los registros se agruparon mensualmente (enero a diciembre de 2024), y los destinos se clasificaron en regiones. El análisis tiene limitaciones, como la imposibilidad de calcular distancias debido a la ausencia de puntos de origen y fin de línea, y la falta de información diaria sobre las condiciones de las carreteras.
El criterio para clasificar los retrasos en los viajes se estableció basándose en el parámetro propuesto por Monsuur et al. (2021), considerando retrasos superiores a 30 minutos. El cálculo del retraso se realizó por la diferencia, en minutos, entre la fecha y hora reales de salida y las programadas, con valores negativos ajustados a cero. La edad de la flota se calculó restando el año de fabricación del vehículo al año de los viajes (2024).
Las variables cuantitativas se transformaron en cualitativas (binarias). Para la variable respuesta, los retrasos superiores a 30 minutos recibieron el valor 1, y los demás, el valor 0. De manera similar, la variable explicativa “vehículo_viejo” se definió como 1 para vehículos con una antigüedad igual o superior a 10 años y 0 para los de menos de 10 años. La variable “retraso” corresponde a la diferencia, en minutos, entre la hora programada y la hora real del viaje, con valores negativos ajustados a cero.
Para investigar y clasificar los retrasos, se adoptaron modelos predictivos multivariados capaces de capturar relaciones lineales y no lineales. Se seleccionaron tres algoritmos: Regresión Logística, Random Forest y Extreme Gradient Boosting (XGBoost). La elección de estos modelos se debió a la naturaleza de la variable respuesta y su robustez en tareas de clasificación, además de la flexibilidad para manejar diferentes tipos de variables, incluyendo contextos con multicolinealidad e interacciones complejas.
La Regresión Logística modela la relación entre una variable de respuesta binaria y predictoras, utilizando una función logística (sigmoide) para transformar la combinación lineal de las predictoras en probabilidad, con salida entre 0 y 1. La función se define como:
p(X) = eβ0+β1X / (1+eβ0+β1X) (1)
Donde p(X) es la probabilidad de que la clase positiva esté presente, y β0 y β1 son los coeficientes del modelo. La transformación logística se presenta como:
g(X) = ln[p(X)/(1-p(X))] = β0 + β1X (2)
Donde g(X) es el logaritmo de la razón de probabilidades [odds], p(X) la probabilidad de ocurrencia del evento de interés, 1-p(X) la probabilidad complementaria, y β0 y β1 el valor base y el coeficiente angular, respectivamente.
El “Random Forest” (Santos, 2020) es un método de aprendizaje conjunto que construye múltiples árboles de decisión. Cada árbol se entrena de forma independiente utilizando una muestra aleatoria de los datos (“bootstrap”), y se selecciona un subconjunto aleatorio de variables para cada división, promoviendo la diversidad y evitando el sobreajuste. Las predicciones se generan combinando los resultados individuales de los árboles (votación mayoritaria para clasificación).
XGBoost (Barreto, 2023) es un algoritmo de aprendizaje automático que utiliza el método de “boosting”, combinando secuencialmente múltiples árboles de decisión para modelos predictivos precisos. Optimiza el rendimiento del “gradient boosting” y aplica técnicas de regularización para prevenir el “overfitting”. La función objetivo se da por:
FO(θ) = Σi=1nl(yi, ŷi) + Σk=1K Ω(fk) (3)
Donde Obj(θ) es la función objetivo a optimizar, θ son los parámetros del modelo, n es el número de muestras de entrenamiento, l(yi, ŷi) es la función de pérdida, y Ω(fk) es la función de penalización o regularización aplicada al árbol fk.
Para evaluar el rendimiento de los modelos predictivos, los datos se dividieron en conjuntos de entrenamiento y prueba. Se utilizaron métricas apropiadas para problemas de clasificación con un fuerte desequilibrio entre clases, como F1-score, área bajo la curva ROC [AUC] y la estadística Kolmogorov-Smirnov [KS]. La precisión no se adoptó como métrica principal. El F1-score se define como:
F1-score = 2 * (Precisión * Recall) / (Precisión + Recall) (4)
Donde “Precisión” y “Recall” se definen por:
Precisión = VP / (VP + FP) (5)
Recordar = VP / (VP + FN) (6)
Siendo VP los Verdaderos Positivos, FP los Falsos Positivos y FN los Falsos Negativos. El AUC se define como:
AUC = ∫01 TVP(TFP-1(x))dx (7)
Donde TVP es la Tasa de Verdaderos Positivos y TFP es la Tasa de Falsos Positivos. La estadística KS se define como:
KS = máx|F_positiva(x) – F_negativa(x)| (8)
Donde F_positiva(x) y F_negativa(x) representan el comportamiento acumulado de las probabilidades predichas para las clases retraso y no_retraso. Adicionalmente, el tiempo de ejecución de los modelos fue registrado para evaluar la eficiencia computacional.
El balanceo de datos se abordó para neutralizar la asimetría entre las clases ‘no retrasos’ y ‘retrasos’. Los enfoques de muestreo implementados y comparados incluyeron “UnderSampling” (reducción de la clase mayoritaria), “Synthetic Minority Over-sampling Technique“ [SMOTE] y “Adaptive Synthetic Sampling” [ADASYN] (creación de datos sintéticos por interpolación). El “Balanced Random Forest” mitiga el desbalanceo internamente, realizando muestreo equilibrado para cada árbol del “ensemble” sin descartar permanentemente datos.
Para interpretar los “outputs” de los modelos, se utilizó Shapley Additive Explanations [SHAP], una herramienta de Inteligencia Artificial Explicable [XAI] del tipo “post-hoc” (Lundberg y Lee, 2017). El SHAP calcula el impacto marginal de cada variable, permitiendo identificar qué variables influyen en la probabilidad de retraso o puntualidad, actuando como mecanismo de control para auditoría e interpretación humana.
3. Resultados y Discusión
El análisis de los datos de transporte por carretera interestatal en Brasil, correspondientes a enero a diciembre de 2024, reveló una concentración significativa de rutas en la región Sudeste, lo que refleja su alta densidad de población e infraestructura vial. Esta centralidad se ilustra mediante la distribución de las rutas en todo el territorio nacional, según la Figura 1.
Figura 1. Destinos del transporte por carretera regular interestatal en Brasil según datos de la ANTT (2024)
Fuente: Resultados originales de la investigación
La distribución de las carreteras por región, según la Confederación Nacional del Transporte (CNT, 2024), muestra que la región Sur posee la mayor densidad de carreteras pavimentadas (20,5 km/mil km²), mientras que la región Norte presenta la menor (2,7 km/mil km²). Esta diferencia en la infraestructura y en las características geográficas del Norte históricamente favorece otras modalidades de transporte, como el fluvial, e impone desafíos logísticos para el mantenimiento de las carreteras, resultando en una menor cantidad de líneas en esta región.
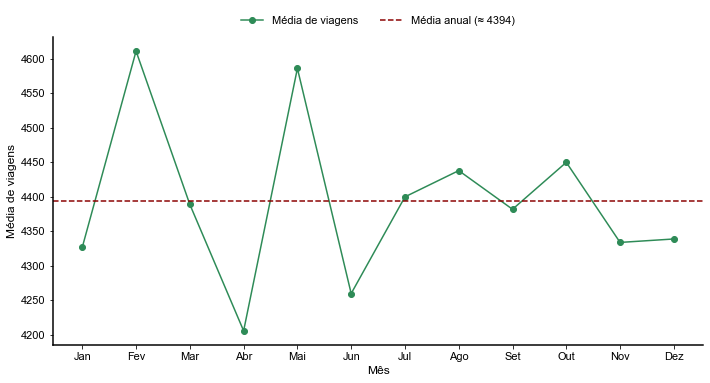
La media diaria de viajes por mes en 2024, presentada en la Figura 2, indicó una variación relativamente estable en el volumen de viajes por carretera interestatales, oscilando entre 4.200 y 4.600 viajes diarios. Febrero registró la mayor media, impulsado por el feriado de Carnaval, que en 2024 ocurrió del 10 al 14 de febrero, generando un aumento en la demanda. Abril, por su parte, presentó la menor media, posiblemente debido al feriado prolongado de Semana Santa, que concentró viajes en pocos días y redujo los días efectivos de operación. Factores como las condiciones climáticas y el período escolar también pudieron haber influido en la frecuencia de los viajes.
Figura 2. Media de viajes mensuales en 2024
Fuente: Resultados originales de la investigación
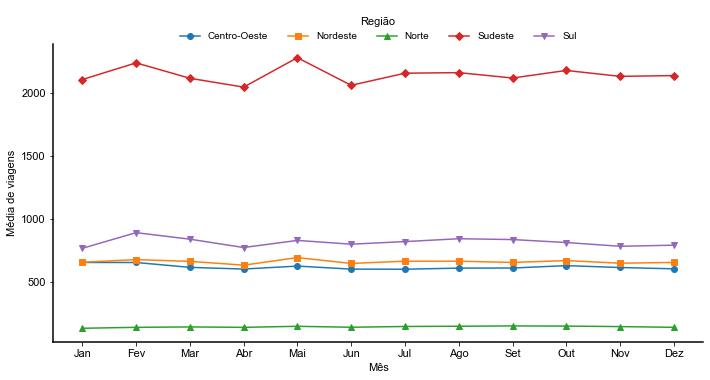
La Figura 3 evidencia patrones distintos de movilidad entre las cinco regiones de Brasil. La región Sureste consistentemente presentó la mayor media diaria de viajes a lo largo del año, con picos en febrero y mayo, indicando mayor intensidad de actividades y demanda poblacional. En contraste, la región Norte mantuvo la menor media diaria de viajes, en un patamar inferior a las demás, atribuido a menor densidad poblacional, vastas extensiones geográficas e infraestructura de transporte diferenciada. Las regiones Centro-Oeste, Nordeste y Sur presentaron patrones intermedios, destacándose el Sur con una media diaria superior al Centro-Oeste y Nordeste, pero aún por debajo del Sureste. Las fluctuaciones mensuales en todas las regiones pueden reflejar estacionalidades relacionadas a períodos de vacaciones, feriados o eventos específicos.
Figura 3. Media de viajes por región en 2024
Fuente: Resultados originales de la investigación
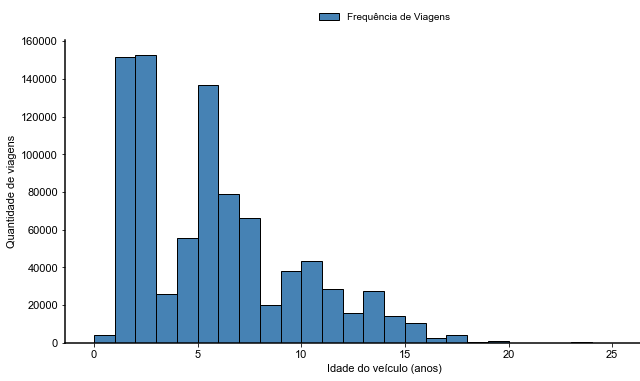
La frecuencia de la cantidad de viajes en relación con la edad de los vehículos, en años, se presenta en la Figura 4. Se observó una concentración significativa de viajes realizados por vehículos más nuevos, con un pico prominente en el rango de 1 a 2 años de edad, lo que sugiere la intensa utilización de vehículos recién adquiridos o con poco rodaje. Este hallazgo está en conformidad con la Resolución nº 6.033/2023 de la ANTT (Brasil, 2023), que establece un límite de 15 años para la edad de los vehículos en el transporte por carretera interestatal regular de pasajeros.
Figura 4. Histograma de la distribución de viajes por edad de la flota
Fuente: Resultados originales de la investigación
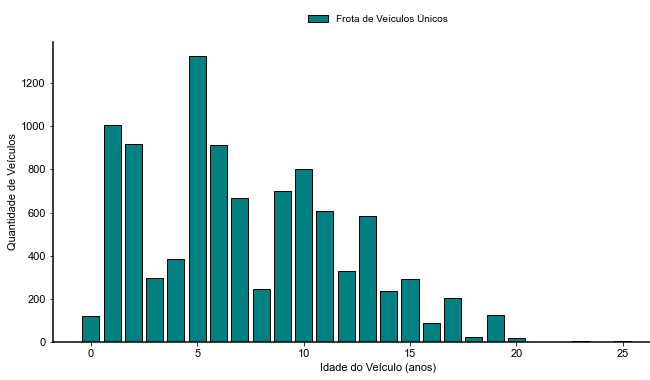
La Figura 5, que muestra la distribución de vehículos por edad, revela que la cantidad de vehículos tiende a disminuir gradualmente con el aumento de la edad. Hay una caída pronunciada después de los 6 años, y la contribución de vehículos con más de 10 años es considerablemente menor, volviéndose marginal después de los 20 años y prácticamente nula a partir de los 25 años. Esta tendencia está influenciada por las exigencias regulatorias que limitan la edad de los vehículos y fomentan la renovación de la flota (Brasil, 2023).
Figura 5. Histograma de la distribución de vehículos por edad
Fuente: Resultados originales de la investigación
La categorización de las regiones en dos bloques (Sudeste/Sur y demás regiones) permitió comparar las diferencias estructurales en la propensión al retraso. El bloque Sudeste/Sur concentró 611.300 viajes, mientras que las demás regiones registraron 295.176. En términos absolutos, el número de retrasos fue mayor en el Sudeste/Sur (24.932 ocurrencias). Sin embargo, la tasa proporcional de retraso invirtió este patrón: Sudeste/Sur presentó un 4,08%, mientras que las demás regiones registraron un 5,49%. Esto indica que, a pesar del mayor volumen operativo en las regiones más dinámicas, la probabilidad relativa de retraso es más elevada en las demás regiones, sugiriendo que la intensidad operativa y la propensión estructural al retraso no coinciden necesariamente. La Tabla 3 resume estos resultados.
Tabla 3. Tasa de retraso por bloques regionales
| Bloque Regional | Total de Viajes | Total de Retrasos | Retraso (%) |
|---|---|---|---|
| Sureste + Sur | 611300 | 24932 | 4,08 |
| Otras regiones | 295176 | 16212 | 5,49 |
Fuente: Resultados originales de la investigación
El análisis de la variable respuesta reveló un desbalanceo estructural significativo: del total de 906.476 observaciones, el 95,46% correspondió a viajes puntuales y solo el 4,54% a retrasos superiores a 30 minutos. Esta rareza de los eventos de retraso (aproximadamente 21 viajes puntuales por cada retraso) impone desafíos a la modelización predictiva, ya que los algoritmos de clasificación tienden a privilegiar la clase mayoritaria (He y Garcia, 2009). La rareza del retraso es una característica intrínseca del sistema de transporte por carretera de pasajeros, y no una falla en la recolección de datos. Así, la modelización predictiva debe incorporar el desbalanceo como parte de la realidad operativa, exigiendo estrategias metodológicas específicas. Los modelos evaluados fueron identificados según la Tabla 4.
Tabla 4. Siglas para la identificación de los modelos
| Patrón | Identificación |
|---|---|
| UnderSampler + XGBoost | UXGB |
| SMOTE + XGBoost | SXGB |
| ADASYN + XGBoost | AXGB |
| Bosque Aleatorio Balanceado | BRF |
| Regresión Logística | RL |
Fuente: Resultados originales de la investigación
La Regresión Logística (RL) se utilizó para diagnosticar la influencia de las variables independientes sobre el retraso. Los coeficientes obtenidos tras el ajuste del modelo, detallados en la Tabla 5, indican los factores con mayor peso estadístico. La variable `Duración (> 6h)` presentó el mayor coeficiente (β = 1,7242), sugiriendo un impacto significativo en el aumento de la probabilidad de retrasos. Las variables `Feriado`, `Fin de semana` y `Edad del vehículo` también mostraron coeficientes positivos, mientras que la variable `Región (Sur/Sudeste)` presentó un coeficiente negativo (β = -0,3374), indicando una reducción en la probabilidad de retrasos en estas localidades.
Tabla 5. Coeficientes estimados de la regresión logística
| Variable | Coef. (β) | O | Error estándar | IC 95% | valor p |
|---|---|---|---|---|---|
| Punto de corte | -3,7792 | 0,0228 | 0,0115 | [0,0223;0,0234] | <0,001 |
| Región (Sur/Sudeste) | -0,3374 | 0,7136 | 0,0106 | [0,6990;0,7286] | <0,001 |
| Día festivo | 0,3958 | 1,4855 | 0,0355 | [1,3857;1,5925] | <0,001 |
| Duración (> 6h) | 1,7242 | 5,6081 | 0,0116 | [5,4817;5,7374] | <0,001 |
| Edad del vehículo | 0,3030 | 1,3539 | 0,0143 | [1,3165;1,3923] | <0,001 |
| Fin de semana | 0,3891 | 1,4757 | 0,0128 | [1,4390;1,5133] | <0,001 |
Fuente: Resultados originales de la investigación
Para evaluar la calidad predictiva de los modelos, se utilizaron métricas de desempeño específicas para datos desbalanceados. Las Tablas 6 y 7 presentan los resultados de Precisión, Recall, F1-Score, AUC, KS y tiempo de ejecución para los modelos en las bases de entrenamiento y prueba.
Tabla 6. Resultados obtenidos para los parámetros Precision, Recall y F1-Score para los modelos en las bases de entrenamiento y prueba
| Patrón | Entrenamiento de Precisión | Prueba de Precisión | Entrenamiento de recuerdo | Prueba de recuerdo | F1- Puntuación Entrenamiento | Puntuación F1 Prueba |
|---|---|---|---|---|---|---|
| UXGB | 0,137758 | 0,140548 | 0,364575 | 0,371977 | 0,199960 | 0,204012 |
| SXGB | 0,137758 | 0,140548 | 0,364575 | 0,371977 | 0,199960 | 0,204012 |
| AXGB | 0,139528 | 0,142788 | 0,349841 | 0,358124 | 0,199492 | 0,204171 |
| BRF | 0,137758 | 0,140582 | 0,364575 | 0,371978 | 0,199960 | 0,204012 |
| RL | 0,108390 | 0,108719 | 0,771350 | 0,770811 | 0,190072 | 0,190561 |
Fuente: Resultados originales de la investigación
Tabla 7. Resultados obtenidos para los parámetros Umbral, AUC, KS y Tiempo para cada modelo
| Patrón | Umbral | AUC Entrenamiento | Prueba de AUC | KS Entrenamiento | KS Prueba | Tiempo (s) Ejecución |
|---|---|---|---|---|---|---|
| UXGB | 0.686461 | 0.754085 | 0.756171 | 0.469696 | 0.471007 | 4.356287 |
| SXGB | 0.702776 | 0.754266 | 0.756478 | 0.469729 | 0.470366 | 41.09609 |
| AXGB | 0.709190 | 0.753357 | 0.755952 | 0.469678 | 0.470551 | 151.81968 |
| BRF | 0.702845 | 0.754275 | 0.756448 | 0.469683 | 0.471103 | 23.02472 |
| RL | 0.421579 | 0.742444 | 0.740606 | 0.469665 | 0.470355 | 4.883683 |
Fuente: Resultados originales de la investigación
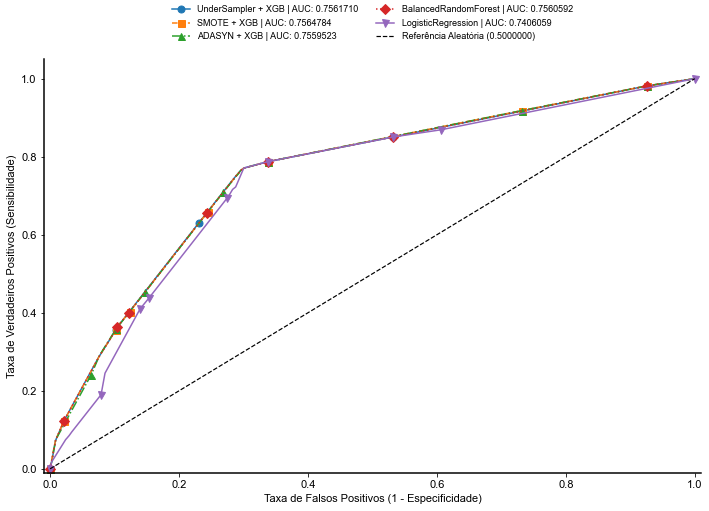
Los modelos basados en XGBoost y Balanced Random Forest (BRF) presentaron un rendimiento predictivo similar en términos de F1-Score, AUC y estadística KS. El BRF alcanzó el valor de KS más alto (0,4711) en la base de prueba, indicando una capacidad superior para separar las distribuciones de viajes con retraso y viajes a tiempo. El UXGB siguió de cerca con un KS de 0,4710, demostrando la confiabilidad estadística de ambos para identificar patrones de irregularidad. El modelo AXGB, aunque con un rendimiento predictivo similar, requirió un tiempo de procesamiento hasta 35 veces superior al UXGB y 7 veces mayor que el BRF, haciéndolo menos viable operacionalmente.
La Regresión Logística fue descartada de la etapa final de comparación debido a su rendimiento inferior y limitaciones para capturar relaciones complejas, como se observa en las Tablas 6 y 7 y en la Figura 6. La RL presentó valores inferiores de F1-Score y AUC en comparación con los modelos basados en árboles. Además, su Recall elevado (0,7708) y baja Precision (0,1087) indicaron que, si bien identificaba muchos retrasos, también generaba un alto número de falsos positivos, reduciendo la confiabilidad de las predicciones. Los modelos basados en árboles, como el BRF, son más flexibles para modelar relaciones no lineales e interacciones complejas en los datos operacionales del transporte (HOSMER et al., 2013).
Figura 6. Curva ROC con todos los modelos
Fuente: Resultados originales de la investigación
El Balanced Random Forest fue seleccionado como modelo de referencia, a pesar de que UXGB presenta un menor tiempo de ejecución. La elección se justifica porque el BRF trata el desbalanceo internamente durante la construcción de los árboles, realizando un muestreo balanceado en cada etapa del entrenamiento sin descartar permanentemente datos del conjunto original, preservando la variabilidad de los datos y la robustez del método. En contraste, el undersampling del UXGB implica la remoción de observaciones de la clase mayoritaria, lo que puede resultar en pérdida de información relevante.
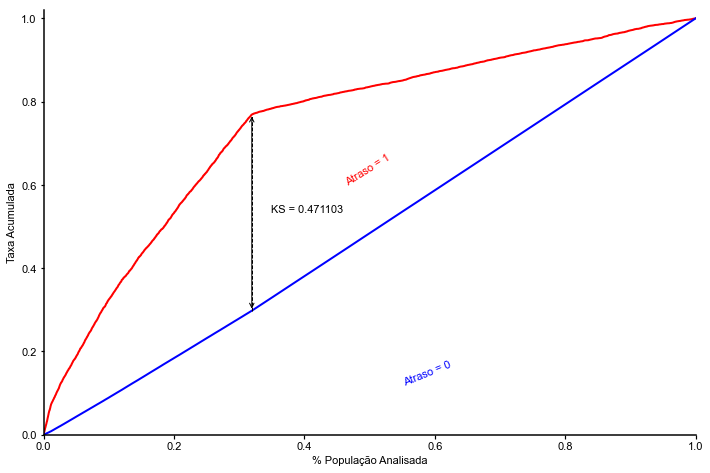
La confiabilidad operativa, especialmente la puntualidad, es crucial para la viabilidad económica del servicio, dado que los márgenes de beneficio en el sector brasileño son estrechos (5,02% a 12%, según la ANTP). Un alto índice de Falsos Positivos induciría la movilización innecesaria de reservas técnicas, generando costos por inactividad de la flota y combustible. La precisión del modelo BRF, por lo tanto, actúa como una salvaguarda contra la erosión de la rentabilidad y contribuye a la optimización de costos y a la reducción de la incertidumbre del pasajero (Scháno et al., 2024; Eriksson et al., 2023; Van den Bergh et al., 2013; Diab, Wasfi y El-Geneidy, 2014). La Figura 7, que presenta la curva KS del modelo BRF, demuestra la máxima separación entre las distribuciones acumuladas de viajes puntuales y atrasados, validando su robustez para decisiones gerenciales.
Figura 7. Curva KS obtenida para el modelo Balanced Random Forest
Fuente: Resultados originales de la investigación
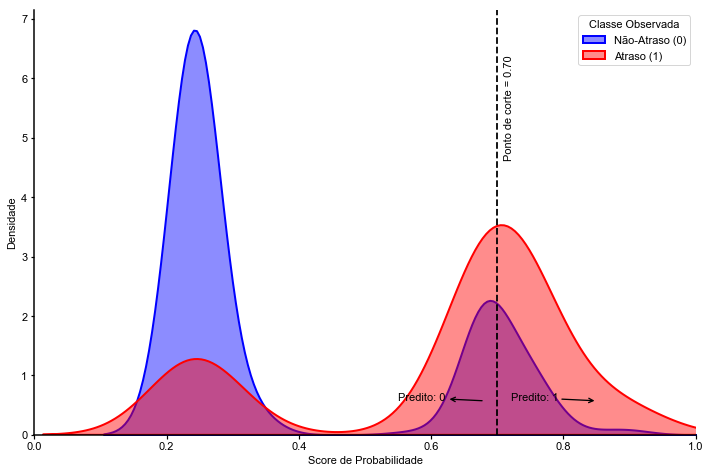
La precisión de 0,14, aunque indica una proporción significativa de falsas alarmas (86%), es inherente a la naturaleza desequilibrada de los datos de transporte. El BRF, con su capacidad superior de separación entre clases (KS = 0,4711), actúa como un filtro de riesgo, reduciendo el universo de viajes a monitorear y permitiendo que la gestión se centre en grupos con mayor probabilidad de retraso. La Figura 8 ilustra la distribución de las probabilidades predichas por el modelo para las clases de retraso y no retraso, mostrando que los viajes sin retraso se concentran en probabilidades más bajas, mientras que los que tienen retraso se desplazan hacia valores más altos. El punto de corte de 0,70 define la regla de decisión, clasificando las observaciones con probabilidad superior como retraso, y el modelo demuestra una capacidad de discriminación satisfactoria.
Figura 8. Distribución de Scores y Punto de Corte para el modelo Balanced Random Forest
Fuente: Resultados originales de la investigación
Los datos consolidados en la Tabla 8 muestran la capacidad del algoritmo BRF para estratificar el riesgo de retrasos por destino. La región Norte ostenta los mayores indicadores, con una puntuación media de 0,432 y la mayor tasa de ocurrencia real (6,85%). Esta convergencia valida la hipótesis de que destinos con infraestructura logística más compleja y recorridos de larga distancia imponen una mayor propensión al incumplimiento del cronograma operativo. La puntuación media se interpreta como un Índice de Vulnerabilidad: cuanto más se acerca a 0,500, mayor es la probabilidad de que el viaje presente características de un retraso crítico, sirviendo como alerta preventiva.
Tabla 8. Puntuación Media y Tasa de Ocurrencia de Retraso por Región
Fuente: Resultados originales de la investigación
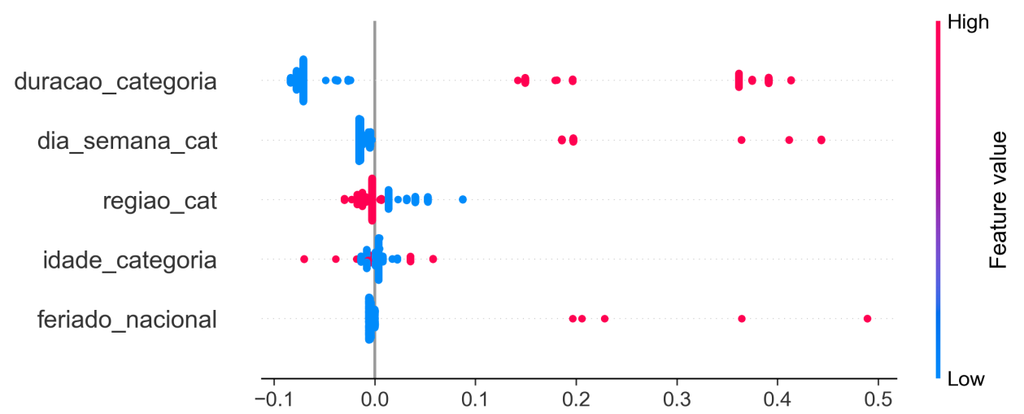
El análisis de Shapley Additive Explanations (SHAP) se utilizó para comprender la contribución de las variables explicativas en las predicciones del algoritmo. La Figura 9 presenta el gráfico de resumen de los valores SHAP para el modelo seleccionado.
Figura 9. SHAP para el modelo Balanced Random Forest
Fuente: Resultados originales de la investigación
Los valores SHAP indican que variables operacionales, especialmente `duracao_categoria`, ejercen mayor influencia en la predicción de retrasos, con trayectos largos aumentando significativamente esta probabilidad. El Anuario Estadístico TRIIP (ANTT, 2024) señala que el 57% de los viajes en 2024 duraron entre 4 y 16 horas, evidenciando que gran parte de la operación ocurre en ventanas temporales con alta exposición a cuellos de botella logísticos. La variable `dia_semana_cat` también contribuye, sugiriendo que la transición al período de descanso semanal (sábados y domingos) acentúa la propensión a los retrasos. El flujo en el transporte interestatal en 2024 se concentró en los viernes, marcando el inicio del ciclo de movimiento del fin de semana. Aunque el pico de las partidas ocurre en este día, el modelo identificó que el riesgo de impuntualidad se consolida de forma crítica los sábados y domingos, sugiriendo un efecto residual y acumulativo del tráfico. La variable `regiao_cat` presenta un impacto moderado, mientras que `idade_categoria` y `feriado_nacional` contribuyen de forma relativamente menor.
En resumen, el estudio demostró que, si bien el sistema opera con alta puntualidad (>95%), la concentración de retrasos en regiones con menor infraestructura y en períodos de mayor estacionalidad crea cuellos de botella operativos. Solo el 4,54% de los viajes presentaron retrasos superiores a 30 minutos, un evento raro que justifica la adopción de métricas específicas para la evaluación de los modelos. El modelo Balanced Random Forest (BRF) mostró un rendimiento superior al lidiar con el desequilibrio, alcanzando un KS de 0,4711, lo que refuerza su capacidad de discriminar eventos raros de retraso. El análisis SHAP indicó que la duración del viaje y el día de la semana son las principales variables predictoras. La aplicación de un “Score” de Propensión al Retraso, en lugar de una clasificación binaria, permite clasificar itinerarios por nivel de criticidad, optimizando la asignación de recursos y la anticipación de riesgos operativos, transformando datos operativos en indicadores predictivos interpretables.
4. Conclusión
El presente estudio tuvo como objetivo estimar y comparar modelos de Machine Learning para predecir la ocurrencia de retrasos superiores a 30 minutos en el transporte por carretera regular interestatal de pasajeros en Brasil, utilizando una vasta base de datos operativos de la ANTT correspondiente al año 2024. Se observó que, aunque la puntualidad es predominante, con solo el 4,54% de los viajes registrando retrasos, las regiones fuera del eje Sudeste/Sur presentaron una tasa proporcional de retraso superior. Entre los algoritmos evaluados, el Balanced Random Forest (BRF) demostró un rendimiento predictivo superior, especialmente al lidiar con el desbalanceo intrínseco de los datos, alcanzando un KS de 0,4711 y presentando bajo costo computacional. El análisis de Shapley Additive Explanations (SHAP) reveló que la duración del viaje y el día de la semana son las variables más influyentes en la propensión a retrasos, con trayectos largos y los fines de semana acentuando esta probabilidad. La principal contribución del trabajo reside en la proposición de un “Score” de Propensión al Retraso, que transforma la predicción en una herramienta de inteligencia competitiva, permitiendo a las transportadoras clasificar itinerarios críticos y optimizar la asignación de recursos preventivos, mitigando riesgos operativos y financieros.
A pesar de los hallazgos relevantes, el estudio reconoce limitaciones, como el criterio de 30 minutos para el retraso, que tiene un carácter operativo y carece de un estándar formal consolidado en la literatura, lo que sugiere la necesidad de trabajos futuros para refinar esta definición. La complejidad computacional involucrada en el tratamiento y modelado de los datos también apunta a la importancia de recursos de procesamiento más robustos en futuras exploraciones. Para estudios futuros, se recomienda la expansión del alcance con la integración de datos exógenos, como condiciones de infraestructura vial, alertas de tráfico en tiempo real, factores climáticos, registros de fiscalizaciones y datos de telemetría de la flota. Este enfoque más amplio permitiría la evolución del “Score” a un “Digital Twin” de la operación logística, capaz de adaptarse dinámicamente a los cambios en el entorno vial y mejorar aún más la gestión estratégica y la toma de decisiones en el sector del transporte de pasajeros.
Referencias Bibliográficas
Antt. 2023. Anuário Estatístico do TRIIP 2023: Dados do Transporte Rodoviário Interestadual e Internacional. Brasília, DF, Brasil. Disponível em: < https://www.gov.br/antt/pt-br/assuntos/passageiros/anuario-estatistico-do-TRIIP >. Acesso em: 11 mar. 2025.
Antt. 2024. Anuário Estatístico do TRIIP 2024: Dados do Transporte Rodoviário Interestadual e Internacional. Brasília, DF, Brasil. Disponível em: < https://www.gov.br/antt/pt-br/assuntos/passageiros/anuario-estatistico-do-TRIIP >. Acesso em: 15 abr. 2025.
Barreto, J.S. 2025. Predição de síndrome respiratória aguda grave por meio de multiclassificação com algoritmos de machine learning. Monografia em Estatística. Universidade Estadual da Paraíba, Campina Grande, PB, Brasil. Disponível em: < https://dspace.bc.uepb.edu.br/jspui/bitstream/123456789/30153/9/TCC%20-%20Joseferson%20da%20Silva%20Barreto>. Acesso em: 27 mai. 2025.
Brasil. 2023. Resolução n° 6.033, de 21 de dezembro de 2023. Dispõe sobre o Marco Regulatório do Transporte Rodoviário Coletivo Interestadual e Internacional de Passageiros. Diário Oficial da União, Brasília, DF, Brasil, 22 dez. 2023. Seção 1, p. 182. Disponível em: https://nttlegis.antt.gov.br/action/ActionDatalegis.php?acao=detalharAto&numeroAto=00006033&valorAno=2023. Acesso em: 14 abr. 2026.
Confederação Nacional do Transporte [CNT]. 2023. Pesquisa CNT de Rodovias 2023. CNT SEST SENAT, ITL, Brasília, DF, Brasil. Disponível em: < https://static.poder360.com.br/2023/11/pesquisa-cnt-rodovia-2023.pdf >. Acesso em: 24 mar. 2025.
Confederação Nacional do Transporte [CNT]. 2024. Pesquisa CNT de Rodovias 2024. CNT, SEST SENAT, ITL, Brasília, DF, Brasil. Disponível em: < https://cnt.org.br >. Acesso em: 29 jul. 2025.
Diab, E.; Wasfi, R.; El-Geneidy, A. 2014. Extraboard team sizing: an
Eriksson, E.L.; Lidestam, H.; Winslött Hiselius, L. 2023. Effects on operating costs of adjusting bus departure times during peak-hour traffic in Sweden. Research in Transportation Economics 100(1): 101327. Disponível em: . Acesso em: 28 ago. 2025.
He, H.; Garcia, E.A. 2009. Learning from imbalanced data. IEEE Transactions on Knowledge and Data Engineering 21(9): 1263-1284. Disponível em: < https://ieeexplore.ieee.org/document/5128907 >. Acesso em: 28 fev. 2026.
Hosmer, D.W.; Lemeshow, S.; Sturdivant, R.X. 2013. Applied Logistic Regression. 3ed. Wiley, Hoboken, NJ, USA. Disponível em: < https://doi.org/10.1002/9781118548387 >. Acesso em: 08 mar. 2026.
Lopes, D.; Diniz, H.; Balbino, L.; Pretti, L.; Freitas, L.; Vieira, T.; Gonçalves, W. 2021. Proposta de indicador padronizado de pontualidade para o transporte de passageiros no modal rodoviário. Fundação Dom Cabral, Vitória, ES, Brasil. Disponível em: < https://repositorio.itl.org.br/jspui/bitstream/123456789/535/3/Proposta%20de%20indicador%20padronizado%20de%20pontualidade%20para%20o%20transporte%20de%20passageiros%20no%20modal%20rodovi%C3%A1rio.pdf >. Acesso em: 12 mar. 2025.
Lundberg, S.M.; Lee, S.I. 2017. A Unified Approach to Interpreting Model Predictions. In: International Conference on Neural Information Processing Systems, 2017, Long Beach, CA, USA. Anais… p. 4765-4774. Disponível em: < https://arxiv.org/abs/1705.07874 >. Acesso em: 07 abr. 2026.
Monsuur, F.; Enoch, M.; Quddus, M.; Meek, S. 2021. Modelling the impact of rail delays on passenger satisfaction. Transportation Research Part A: Policy and Practice 152(C): 19-35. Disponível em: < https://doi.org/10.1016/j.tra.2021.08.002 >. Acesso em: 21 jul. 2025.
Neto, T.O.; Nogueira, R.J.B. 2017. Transporte rodoviário de passageiros no Brasil. Revista Transporte y Territorio 16(1): 229-250. Disponível em: < https://dialnet.unirioja.es/descarga/articulo/6175452.pdf >. Acesso em: 11 mar. 2025.
Santos, G.C. 2020. Algoritmos de Machine Learning para previsão da B3. Dissertação de Mestrado em Engenharia Elétrica. Universidade Federal de Uberlândia, Uberlândia, MG, Brasil. Disponível em: < https://doi.org/10.14393/ufu.di.2020.640 >. Acesso em: 23 mai. 2025.
Scháno, M.; Dvořáčková, A.; Smíšek, O. 2024. Assessing time and financial costs of bus delays in the Ústí nad Labem Region, Czech Republic. Acta Polytechnica CTU Proceedings 51(1): 94-108. Acesso em: 23 mai. 2025.
Van den Bergh, J.; Beliën, J.; De Bruecker, P.; Demeulemeester, E.; De Boeck, L. 2013. Personnel scheduling: A literature review. European Journal of Operational Research 226(3): 367-385. Disponível em: < https://doi.org/10.1016/j.ejor.2012.11.029 >. Acesso em: 13 abr. 2026.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haga clic aquí y acceda a la plataforma MBX Academy