
16 de septiembre de 2026
Modelos Analíticos para Inteligencia Comercial en Consultoría de Servicios
Mariana Briamonte da Silveira; Anna Carolina Martins
DOI: 10.22167/2675-6528-202602273
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
Se desarrolló y validó un modelo predictivo de clasificación, basado en regresión logística, para estimar la probabilidad de conversión de nuevos negocios en una consultoría de servicios brasileña. El objetivo fue identificar los factores determinantes para el cierre de contratos, como fuente de la demanda, sector de la empresa y valor del proyecto, con el fin de complementar la toma de decisiones empírica con un enfoque basado en datos. Para ello, se analizaron datos históricos de Customer Relationship Management (CRM) entre los años 2022 y 2025. El modelo fue evaluado por métricas de desempeño como Precisión (Acurácia), AUC y Precisión (Precisão), para garantizar su aplicabilidad como herramienta de apoyo al liderazgo en la priorización de esfuerzos comerciales. Los resultados indicaron que estrategias basadas en la cartera de clientes, como up-selling y next-selling, presentaron una asociación positiva relevante con la conversión. Oportunidades de mayor valor y determinados sectores demostraron menor probabilidad de cierre. Aunque el modelo presentó una capacidad predictiva moderada, demostró potencial al traducir datos históricos en impulsores prácticos de acción. Se evidenciaron, sin embargo, limitaciones relacionadas con la calidad y granularidad de los datos y con la complejidad del fenómeno analizado, reforzando la necesidad de su uso como complemento al juicio gerencial y abriendo espacio para evoluciones futuras.
Palabras clave: Data-driven; Inteligencia comercial; Regresión logística.
1. Introducción
Independientemente del sector de actuación, la ciencia de datos ha demostrado ser una esfera de conocimiento necesaria para las empresas que desean mantener o aumentar su relevancia y competitividad en el mercado. El uso de enfoques analíticos permite guiar el lanzamiento de nuevos productos, optimizar precios, aportar eficiencia a la operación, generar previsibilidad de ventas, entre otras ventajas (Pinheiro, 2024).
Estos enfoques analíticos se volvieron cada vez más robustos a medida que Internet y la generación de datos evolucionaron en la década de 2000. En este contexto, las empresas comenzaron a cruzar información interna y externa en grandes volúmenes y a gran velocidad, buscando identificar patrones y anticipar comportamientos de consumo. Este movimiento se formaliza cuando Laney (2001) describe el concepto de Big data a partir de tres dimensiones, conocidas como los “3 Vs”: volumen, velocidad y variedad. Así, más que un volumen masivo de datos, el Big data representa un cambio de paradigma: la necesidad de nuevas tecnologías para apoyar la toma de decisiones basada en datos y aumentar la eficiencia organizacional. De esta forma, el uso del Machine Learning (ML) fue un acelerador, ya que hizo que los sistemas computacionales fueran capaces de aprender a partir de datos, ajustando sus propios parámetros y mejorando el rendimiento en tareas específicas (Mitchell, 1997).
Alineado al cambio de paradigma hacia la toma de decisiones basada en datos, este estudio aplica tales conceptos al contexto de una consultoría de tamaño mediano ubicada en Brasil. Históricamente, la alta variabilidad de la demanda, asociada a la baja estandarización de procesos, llevó a los líderes de la organización a formular hipótesis sobre la limitación de sus datos internos, atribuyéndoles bajo poder explicativo sobre el desempeño comercial, por ejemplo, la probabilidad de conversión de los negocios.
Como consecuencia del subaprovechamiento de estos datos, se observa una asignación ineficiente de los recursos comerciales, con priorización de esfuerzos, sectores u ofertas que presentan una menor probabilidad real de cierre. A este escenario se suma el hecho de que los datos de la consultoría no se encuentran históricamente estructurados, lo que dificulta análisis más robustos y la extracción de insights relevantes.
Es importante decir que, a pesar de que los datos tienen poca relevancia en el proceso de toma de decisiones de la consultoría en el escenario actual, los esfuerzos comerciales emprendidos con base en la observación empírica del mercado traen retorno, aunque con poca previsibilidad. De esta forma, este trabajo no tiene el propósito de sugerir un cambio completo en la forma en que la consultoría toma sus decisiones comerciales, pero tiene la pretensión de probar la hipótesis de que existen modelos basados en datos que pueden aumentar la previsión de cierre de negocios y traer más comodidad o urgencia al equipo, dirigiendo el esfuerzo y la elección de las estrategias comerciales.
El tema es relevante, ya que existe un desafío recurrente para la dirección de la empresa de explicar al Consejo su contexto comercial, defender la ampliación del equipo e inversiones en nuevos negocios, por ejemplo. En gran parte de los foros donde se debate la cuestión comercial, metas y previsión de ventas, no hay claridad sobre por qué las ventas aumentaron o disminuyeron, cómo se comportarán en el próximo semestre, y si podrían estar aún mejores o peores que la situación actual.
Para la modelización predictiva, se eligió como modelo la regresión logística. Según James et al. (2021), este es un método estadístico que también integra el campo del Machine Learning supervisado, ya que aprende patrones a partir de datos etiquetados y utiliza estas relaciones para predecir el desenlace de nuevos casos. El modelo calcula la probabilidad de ocurrencia de un evento mediante una función logística, que transforma una combinación lineal de variables en un valor entre cero y uno.
La Regresión Logística destaca por su capacidad de generar probabilidades bien calibradas y por su alto grado de interpretabilidad (James et al., 2021). Esta característica es particularmente relevante en contextos empresariales con bases de datos de menor volumen, donde la comprensión de los factores que influyen en el desenlace de las negociaciones es tan importante como la precisión del modelo. A diferencia de modelos considerados “caja negra”, la Regresión Logística permite una mayor transparencia analítica, posibilitando a la dirección identificar no solo la probabilidad de conversión, sino también los principales impulsores del éxito comercial.
Finalmente, este estudio busca no solo aplicar una técnica estadística de pronóstico, sino también comprender el valor estratégico del análisis de datos en la gestión comercial de la consultoría de servicios. Al traducir información histórica del CRM en probabilidades y patrones interpretables, se pretende construir una base analítica que apoye decisiones más asertivas sobre prospección, priorización y negociación de oportunidades. Más que un ejercicio técnico, este estudio representa un paso concreto en la consolidación de una cultura orientada por datos dentro de la organización, contribuyendo a reducir incertidumbres, dirigir estrategias y ampliar el potencial competitivo de la empresa. Así, este trabajo tiene como objetivo desarrollar y validar un modelo predictivo de clasificación, basado en regresión logística, para estimar la probabilidad de conversión de nuevos negocios en una consultoría de servicios brasileña.
2. Material y Métodos
El presente trabajo se caracteriza como un estudio aplicado, utilizando datos reales provenientes del proceso comercial de una empresa de consultoría de servicios de tamaño mediano ubicada en Brasil. La investigación adopta un enfoque exploratorio y descriptivo inicial para la comprensión de los datos, evolucionando hacia análisis predictivos y prescriptivos fundamentados en métodos cuantitativos.
La recopilación de datos se realizó a partir de registros secundarios del Customer Relationship Management (CRM) de la consultoría, puestos a disposición para el proyecto. Tras un tratamiento inicial, la base de datos contenía 12 variables, con registros de enero de 2022 a noviembre de 2025, totalizando aproximadamente 569 filas. Las variables disponibles para el análisis, con sus descripciones e indicación de uso, se presentan en la Tabla 1.
Tabla 1 – Variables disponibles para análisis
| Nombre | Clase | Descripción | Considerada en el análisis |
|---|---|---|---|
| ID del Negocio | Cuantitativa | Clave primaria relacionada con la apertura de una demanda | Sí |
| Nombre de la Empresa | De tipo categórico nominal | Nombre de la empresa que está cotizando un servicio con la consultoría | No |
| Ofrecimiento | De tipo categórico nominal | Clasificación de esa demanda en una oferta específica de consultoría, que puede ser: (1) Asignación de Recursos; (2) Análisis o Gestión de Portafolio; (3) Benchmark o Investigación de Mercado; (4) Capacitación, Conferencias y Talleres; (5) CVB; (6) Diseño Estratégico; (7) Diagnóstico de Innovación; (8) Estrategia de Innovación o Fomento; (9) Estrategia Digital / IA; (10) Estrategia Tecnológica; (11) Ejecución de Proyectos; (12) Indefinido; (13) Planificación Estratégica; (14) Plataforma de Gestión; (15) Premios de Innovación; (16) Programas de Innovación | Sí |
| Fecha de Creación | Numérica Continua Temporal | Fecha en que el deal¹ fue registrado (abierto) en el CRM | Sí |
| Fecha de Ganancia | Numérica Continua Temporal | Fecha en que el acuerdo se dio por ganado en el CRM | No |
| Importancia | Numérica Continua | Valor negociado para la contratación del proyecto en cuestión (en reales – R$) | Sí |
| Estado | De tipo categórico nominal | Identificación de si el negocio está (1) abierto, (2) ganado o (3) perdido | Sí |
| Fase | Categórica Ordinal | Etapa en la que el negocio se encontraba en el embudo en un momento dado, pudiendo ser: (1) Comprensión de la Demanda; (2) Elaboración de la Propuesta; (3) Revisión / Negociación; (4) Contratación / Entrega; (5) Entregado a Operación; (6) Stand By (cuando la oportunidad no se dio por perdida, sino pospuesta para el futuro) | No |
| Fuente de la Demanda | De tipo categórico nominal | Opción múltiple, define el origen de la demanda de la operación en hasta nueve posibilidades: (1) Acciones de Marketing; (2) Cross-selling; (3) Espontáneo; (4) Eventos Propios; (5) Eventos de Terceros; (6) Indefinido; (7) Indicación; (8) Next-selling; (9) Recuperación de contactos; (10) Up-selling | Sí |
| Motivo de Pérdida | De tipo categórico nominal | Identificación del motivo por el cual el proyecto no fue ganado. Entre las razones identificadas se encuentran: (1) El cliente no devuelve el contacto; (2) Demanda no identificada; (3) Inadecuación del enfoque; (4) NA (en caso de negocios ganados); (5) Otra oportunidad en curso; (6) Otros; (7) Precio; (8) El proyecto ya no se ejecutará; (9) Decidieron hacerlo internamente | Sí |
| Líder responsable | De tipo categórico nominal | Líder de la empresa estudiada, responsable de negociar el proyecto en cuestión. Por motivos de confidencialidad, en caso de que sea necesario citarlos, se mencionarán como: Alfa, Beta, Gama, Delta, Épsilon, Zeta, Eta, Teta, Iota y Sin definición. | No |
| Sector de la Empresa | De tipo categórico nominal | Categorías que representan el sector en el que se clasifica la empresa contratante, pudiendo ser: (1) Agroindustria; (2) Agua, Saneamiento y Servicios Ambientales; (3) Alimentos, Bebidas e Ingredientes; (4) Automotriz; (5) Bancos o Servicios Financieros; (6) Bienes de Capital; (7) Construcción, Ingeniería y Mobiliario; (8) Cosméticos, Higiene Personal y Limpieza Doméstica; (9) Educación; (10) Electroelectrónica; (11) Energía Eléctrica; (13) Farmacéutica y Ciencias de la Vida; (13) Gobierno, Asociaciones y TIC; (14) Materiales de Construcción; (15) Medios y Publicidad; (16) Minería, Metalurgia y Siderurgia; (17) Otros Sectores; (18) Papel y Celulosa; (19) Petróleo, Gas y Petroquímica; (20) Química; (21) Seguros y Planes de Salud; (22) Servicios Médicos; (23) Servicios o Facilities; (24) Tecnología de la Información; (25) Telecomunicaciones; (26) Tercer Sector; (27) Transporte y Logística | Sí |
Fuente: Elaboración propia
Notas: Al tratarse de datos internos ya existentes, no fue necesario aplicar cuestionarios ni entrevistas, dispensando también la sumisión al Comité de Ética en Investigación; “Deal” es la traducción libre de “negocio”, y es la forma más común en que la empresa se refiere a una nueva oportunidad comercial.
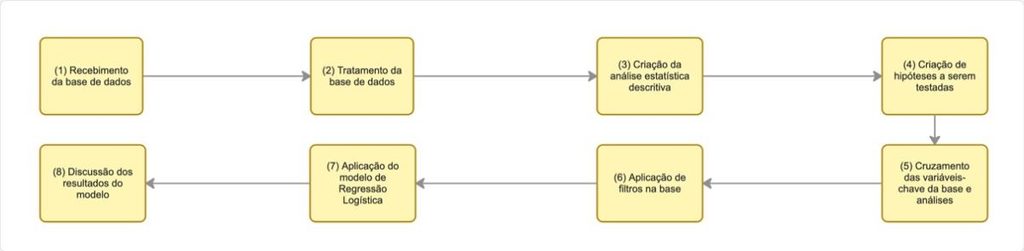
El trabajo siguió un proceso de ETL (Extract, Transform, Load) para preparar los datos para el modelado, como se ilustra en la Figura 1.
Figura 1 – Paso a paso del trabajo
Fuente: Elaboración propia
De forma detallada, el proceso de ETL incluyó:
- Recepción de la base de datos del CRM con aproximadamente 18 variables y 1000 filas.
- Tratamiento de la base de datos, con eliminación de duplicados, tratamiento de valores ausentes (missing values) y corrección de inconsistencias tipográficas, resultando en 12 variables principales y aproximadamente 900 filas.
- Exclusión de negocios con valor de proyecto cero, reduciendo la base a unas 600 líneas.
- Creación de análisis estadístico descriptivo y extracción de valores atípicos, resultando en 581 líneas.
- Identificación de las variables clave para el modelo, según se indica en la Tabla 1.
- Exclusión de los negocios con estado “Abierto”, ya que el modelo solo utiliza los estados “Ganado” o “Perdido” para crear la probabilidad de cierre, lo que resulta en 548 observaciones.
Los análisis iniciales fueron descriptivos y exploratorios, utilizando medidas de tendencia central (media y mediana) y de dispersión (mínimo, máximo, varianza y desviación estándar). Se emplearon tablas y gráficos (histogramas, diagramas de dispersión, de barras y de líneas) para visualizar la distribución de los datos y las relaciones entre variables numéricas y categóricas.
Para la modelización predictiva, se optó por la regresión logística, un método estadístico de Machine Learning supervisado que estima la probabilidad de ocurrencia de eventos binarios. El modelo calcula la probabilidad de éxito (pi) mediante la función logística (o sigmoide), expresada por la Ecuación 1:
pi = 1 / (1 + e-(βo + β1×1,i + β2×2,i + … + βkxk,i)) (1)
Donde pi representa la probabilidad prevista de éxito; βo es la intersección; β1, β2, …, βk son los coeficientes estimados para cada variable independiente; x1,i, x2,i, …, xk,i son las variables independientes; y e es la base del logaritmo natural.
Las variables categóricas nominales, como “Fuente de la Demanda” u “Oferta”, se transformaron en variables binarias (dummies) con una categoría de referencia. Las variables numéricas continuas, como “Valor”, se usaron en su forma original, pudiendo ser transformadas por el logaritmo natural (ln) en caso de asimetría. Las variables ordinales, como “Etapa”, mantuvieron su orden natural.
La influencia de cada variable se comparó mediante el cálculo de odds ratios (OR), que indican cuánto aumenta o reduce una variable las posibilidades de cierre de un negocio, utilizando la Ecuación 2:
OR = eβi (2)
Donde OR representa el cambio en la probabilidad de cierre cuando la variable aumenta una unidad o cambia de categoría; βi representa el impacto de la variable específica; y es la base del logaritmo natural. Si OR > 1, la variable aumenta las probabilidades de éxito; si OR < 1, reduce las probabilidades; si OR = 1, no hay efecto.
La regresión logística fue elegida por su robustez en muestras pequeñas, interpretación directa de los resultados y provisión de probabilidades calibradas, características adecuadas a la base de datos de la consultoría y al contexto de volumen limitado de registros, mitigando el riesgo de sobreajuste.
Para garantizar la generalización del modelo y mitigar el sobreajuste, el conjunto de 548 observaciones se dividió aleatoriamente en subconjuntos de entrenamiento (70%) y prueba (30%). El subconjunto de entrenamiento se utilizó para estimar los coeficientes, y el de prueba para validar las métricas de rendimiento. Las variables seleccionadas para componer el modelo fueron: Oferta, Fuente de demanda, Valor, Sector y Mes de creación. La variable dependiente fue el Estado (ganado o perdido), excluyendo observaciones con estado “Abierto”. La categoría “Tercer Sector” se agrupó en “Otros Sectores” debido a una única observación. El modelo se estimó utilizando la función `glm` con familia binomial y función de enlace `logit`. Las categorías de referencia adoptadas fueron: noviembre (mes de creación), eventos propios (fuente de la demanda), programas de innovación (tipo de oferta) y energía eléctrica (sector del cliente).
La validación de la regresión logística se realizó mediante métricas como Precisión, Área bajo la Curva ROC (AUC), Exactitud, Error Estándar y valor p. La Precisión mide la proporción total de predicciones correctas (negocios ganados y perdidos clasificados correctamente) en relación con el total de observaciones. La Exactitud indica la proporción de negocios predichos como “ganados” que realmente se confirmaron como ganados. El Área bajo la Curva ROC (AUC) evalúa la capacidad general del modelo para distinguir casos positivos y negativos, independientemente del punto de corte adoptado para la clasificación. El Error Estándar mide la variabilidad o incertidumbre asociada al coeficiente estimado. El valor p indica la significancia estadística del coeficiente, representando la probabilidad de observar un efecto igual o más extremo en caso de que el coeficiente verdadero sea cero.
3. Resultados y Discusión
Análisis descriptivo
El análisis descriptivo de los datos reveló las principales medidas estadísticas de la base. La Tabla 2 resume estos resultados, incluyendo media, mediana, desviación estándar, valores mínimo y máximo, y cuartiles.
Tabla 2 – Estadística Descriptiva de la base
| Disposición | Importancia |
|---|---|
| Media | R$ 195.502,35 |
| Mediana | R$ 124.500,00 |
| Desviación estándar | 499.578,59 € |
| Menor | € 4.000,00 |
| Superior | R$ 11.450.000,00 |
| 1° Cuartil | R$ 49.600,00 |
| 2º Cuartil | R$ 124.500,00 |
| 3er Cuartil | R$ 244.500,00 |
| 4º Cuartil | R$ 11.450.000,00 |
| IQR | R$ 194.900,00 |
| Lím inf | € 4.000,00 |
Fuente: Resultados originales de la investigación
Se observó que la media de R$ 195.502,35 fue superior a la mediana de R$ 124.500,00, lo que indica una distribución asimétrica a la derecha, influenciada por valores extremos, como el máximo de R$ 11.450.000,00. Para identificar posibles valores atípicos, se utilizó el rango intercuartílico (IQR) de R$ 194.900,00, una medida robusta para caracterizar la variabilidad central de los datos. Con base en los límites inferior (R$ 4.000,00) y superior (R$ 536.850,00), se eliminaron muestras con valores por encima del límite superior, resultando en una base de 581 observaciones.
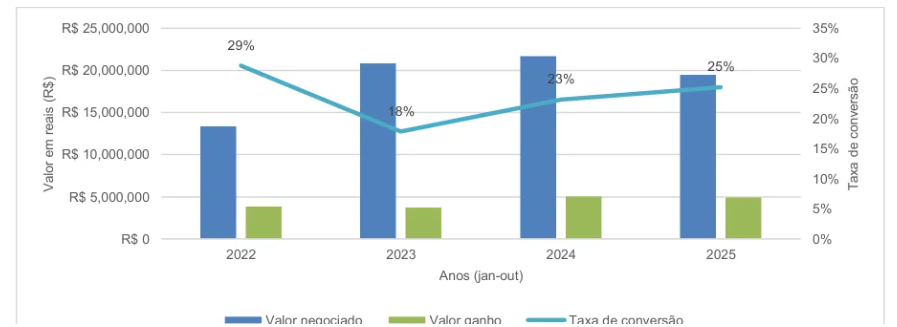
La consultoría negocia valores anuales que varían entre R$ 13 y R$ 21 millones, con una tasa de conversión promedio del 24% y una facturación promedio de R$ 4,3 millones anuales. La Figura 2 ilustra esta dinámica, mostrando que 2024 fue el mejor año en volumen de negociación y valor ganado, aunque la tasa de conversión no mantuvo el nivel de 2022. Los análisis anuales consideraron el período de enero a octubre, debido a limitaciones de datos para noviembre y diciembre de 2025.
Figura 2 – Valor negociado (R$), vendido o ganado (R$) y tasa de conversión (%)
Fuente: Resultados originales de la investigación
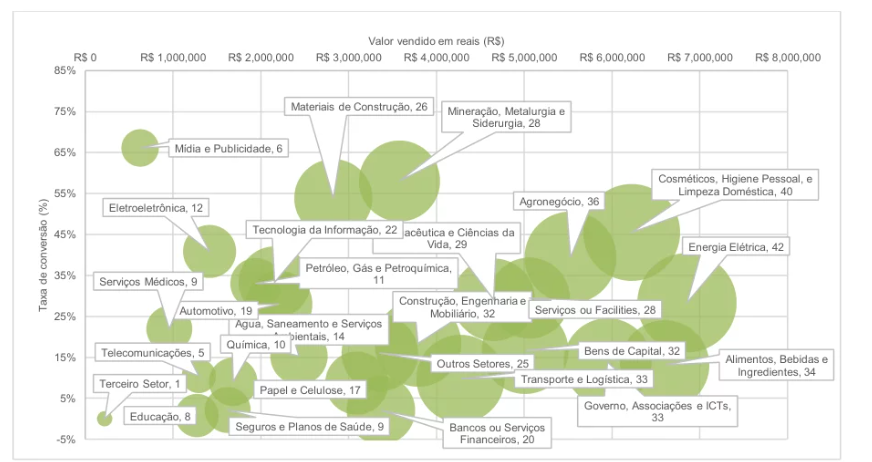
En relación con las interacciones por sector, la Figura 3 indica que Energía Eléctrica (42 oportunidades), Cosméticos, Higiene Personal y Limpieza Doméstica (40), y Agronegocio (36) fueron los sectores con mayor número de interacciones. El Tercer Sector (1), Telecomunicaciones (5) y Medios y Publicidad (6) presentaron menor interacción. Financieramente, Energía Eléctrica lideró con R$ 6.854.092 negociados, seguida por Alimentos, Bebidas e Ingredientes (R$ 6.600.290) y Cosméticos, Higiene Personal y Limpieza Doméstica (R$ 6.223.890).
Figura 3 – Interacciones, valor ganado y tasa de conversión por sector
Fuente: Resultados originales de la investigación
Las tasas de conversión no siguieron el mismo patrón de volumen financiero. Medios y Publicidad tuvo una alta tasa del 66%, seguida por Minería, Metalurgia y Siderurgia (58%) y Materiales de Construcción (54%). Con excepción del sector de Química, los sectores de servicios (Tercer Sector, Educación, Seguros y Planes de Salud, Bancos o Servicios Financieros) presentaron las menores tasas de conversión, sugiriendo mayor dificultad en actuar con empresas de servicios en comparación con las industriales.
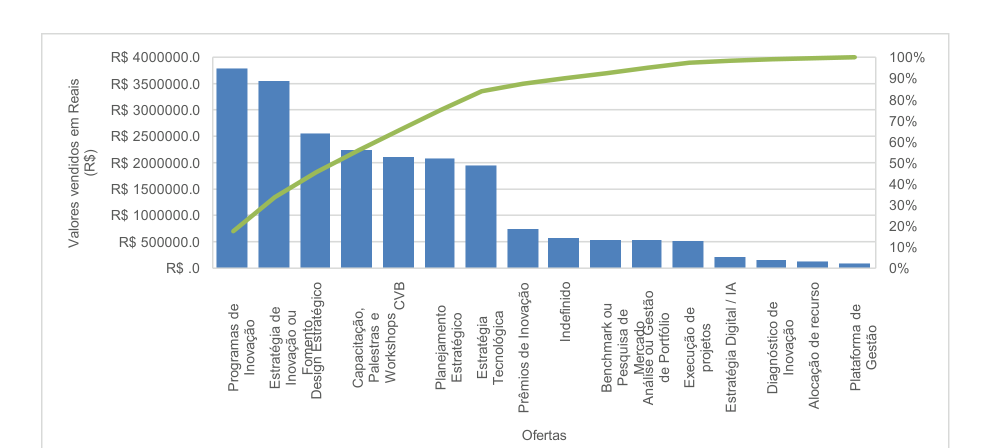
El Diagrama de Pareto en la Figura 4 muestra que seis ofertas fueron responsables del 80% de la facturación total de la consultoría: Programa de Innovación (17%), Estrategia de Innovación o Fomento (16%), Diseño Estratégico (12%), Capacitación, Conferencias y Talleres (10%), CVB (10%) y Planificación Estratégica (10%). Las ofertas de Estrategia de Innovación o Fomento y Programas de Innovación representaron el mayor volumen de negociación en reales, con el 22% y el 21% del monto total, respectivamente. Los proyectos de “innovación” fueron el “caballo de batalla” de la consultoría, con la categoría “negocios” en segundo lugar y “digital” con poca representatividad.
Figura 4 – Valores vendidos en Reales (R$) por Oferta
Fuente: Resultados originales de la investigación
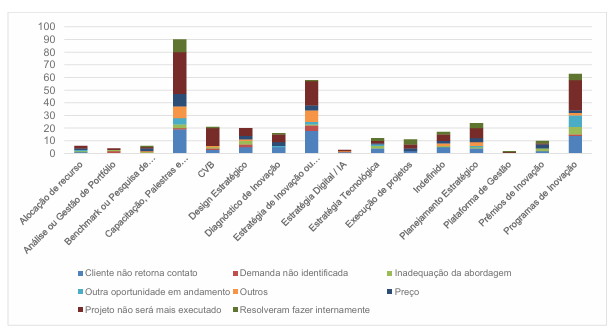
A pesar de que “Programas de Innovación” y “Estrategia de Innovación o Fomento” tienen la mayor participación en la facturación, la Figura 5 indica que también registraron muchas pérdidas, principalmente por la desistencia de ejecutar el proyecto por parte de la empresa compradora, lo que representa un riesgo para los ingresos. La oferta de “Capacitación, Conferencias y Talleres” también presentó el mayor número de negociaciones perdidas, con clientes desistiendo del contacto o no regresando.
Figura 5 – Número de proyectos perdidos considerando Oferta y Motivo de Pérdida
Fuente: Resultados originales de la investigación
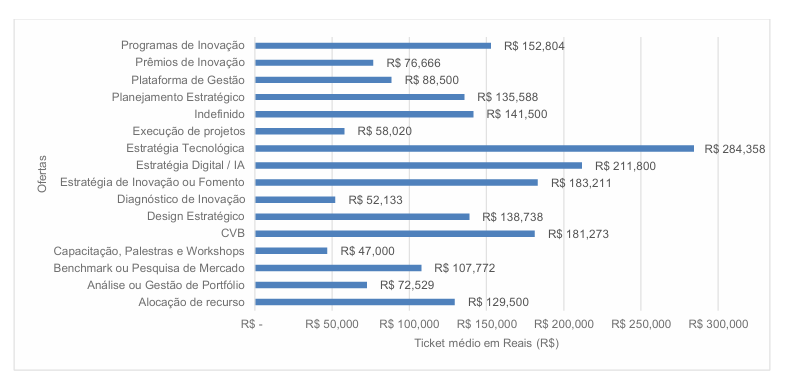
El principal motivo de pérdida de contratos fue “El proyecto ya no se ejecutará”. Las pérdidas por precio se distribuyeron entre las ofertas, con más casos en Capacitación, Conferencias y Talleres (10), lo que sugiere una oportunidad para la revisión de precios. La estrategia de impulsar la oferta de “Capacitación, Conferencias y Talleres” puede ser interesante, según la Figura 6, ya que representa una puerta de entrada con un ticket promedio bajo (alrededor de R$ 47.000,00), pero con potencial para proyectos de mayor valor agregado.
Figura 6 – Ticket promedio realizado en Reales (R$) por Oferta
Fuente: Resultados originales de la investigación
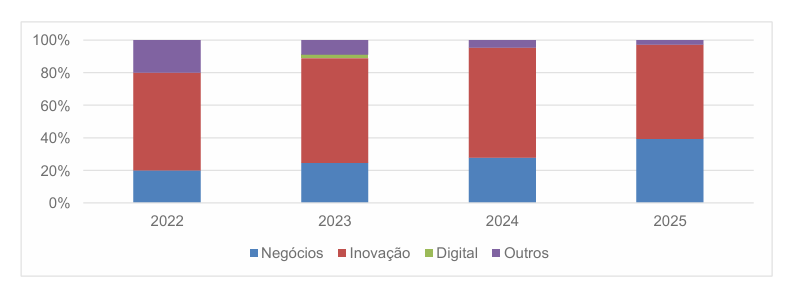
La Figura 7 muestra una variación en la composición de los proyectos vendidos a lo largo de los últimos cuatro años. Las ofertas clasificadas como “Otros” tuvieron una reducción del 20% en 2022 al 3% en 2025. Las ofertas “Digital” aparecieron en 2023 (alrededor del 2% de los proyectos) pero no en los años siguientes. Las ofertas de innovación mantuvieron su relevancia, representando alrededor del 60% de los proyectos vendidos, mientras que las ofertas categorizadas como “Negocios” saltaron del 20% al 40%.
Figura 7 – Ventas de proyectos por categoría de oferta
Fuente: Resultados originales de la investigación
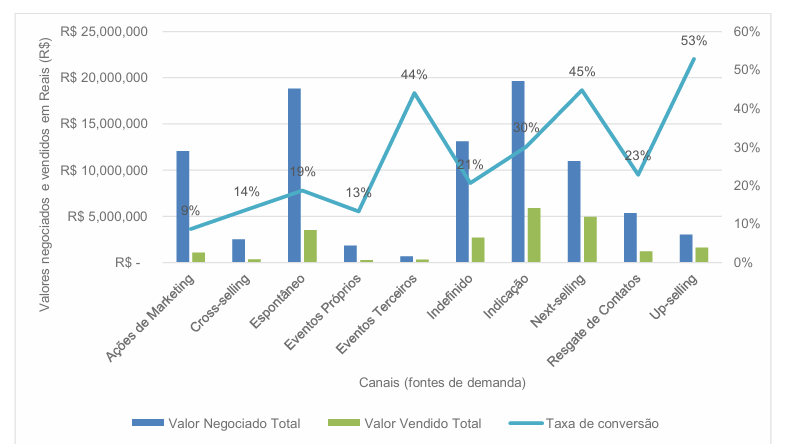
La tasa de conversión promedio del período fue del 24%. La Figura 8 destaca que “Acciones de Marketing”, “Eventos Propios”, “Cross-selling” y “Espontáneo” convirtieron poco en facturación. Por otro lado, “Up-selling”, “Next-selling” y “Eventos de Terceros” fueron canales fundamentales para la conversión de negocios. Esto sugiere que las estrategias de up-selling y next-selling poseen mayor eficacia de conversión que los canales de prospección en frío, confirmando la hipótesis de que las estrategias basadas en la cartera de clientes son más eficaces.
Figura 8 – Valor negociado y vendido en Reales (R$) por Canal y Tasa de Conversión (%)
Fuente: Resultados originales de la investigación
Aplicación del modelo
Para determinar el impacto aislado de cada factor en la probabilidad de ganancia, se aplicó la regresión logística binaria. El modelo utilizó las variables Oferta, Fuente de demanda, Valor, Sector y Mes de creación, con el Estado (ganado o perdido) como variable dependiente. Las variables categóricas fueron tratadas por codificación en dummies, y las categorías de referencia fueron: noviembre (mes de creación), eventos propios (fuente de la demanda), programas de innovación (tipo de oferta) y energía eléctrica (sector del cliente).
El modelo presentó los siguientes resultados de rendimiento, según la Tabla 3:
Tabla 3 – Resultados de la primera aplicación de la Regresión Logística
| Medida | Importancia | Interpretación |
|---|---|---|
| Precisión/ Exactitud | 0,7117 | Proporción total de predicciones correctas del modelo (ganadas y perdidas) |
| Tasa de información nula | 0,6626 | Línea base |
| Valor-p | 0.1060 | Prueba si el modelo es estadísticamente mejor que el baseline |
| Sensibilidad | 0,4727 | Capacidad de identificar correctamente oportunidades ganadas |
| Especificidad | 0,8333 | Capacidad de identificar correctamente oportunidades perdidas |
| Valor Predictivo Positivo (precisión) | 0,5909 | Proporción de predicciones de “ganancia” correctas |
| Valor Predictivo Negativo | 0,7563 | Proporción de predicciones de “perdido” correctas |
| AUC (ROC) | 0,6601 | Capacidad general de discriminación del modelo |
| Precisión Equilibrada | 0,6530 | Media entre sensibilidad y especificidad |
| Kappa | 0,3219 | Grado de concordancia más allá del azar |
Fuente: Resultados originales del trabajo
El modelo alcanzó una precisión de aproximadamente 71%, superior al baseline (No Information Rate de 66%), lo que indica una ganancia predictiva. Sin embargo, el p-valor de 0,106 sugiere que esta diferencia no es estadísticamente significativa al nivel del 5%, lo que exige cautela en la interpretación. La sensibilidad del modelo fue del 47%, lo que indica que menos de la mitad de las oportunidades ganadas fueron identificadas correctamente, lo que puede subestimar oportunidades de alta conversión. En contraste, la especificidad fue del 83%, mostrando un buen desempeño en la identificación de oportunidades perdidas.
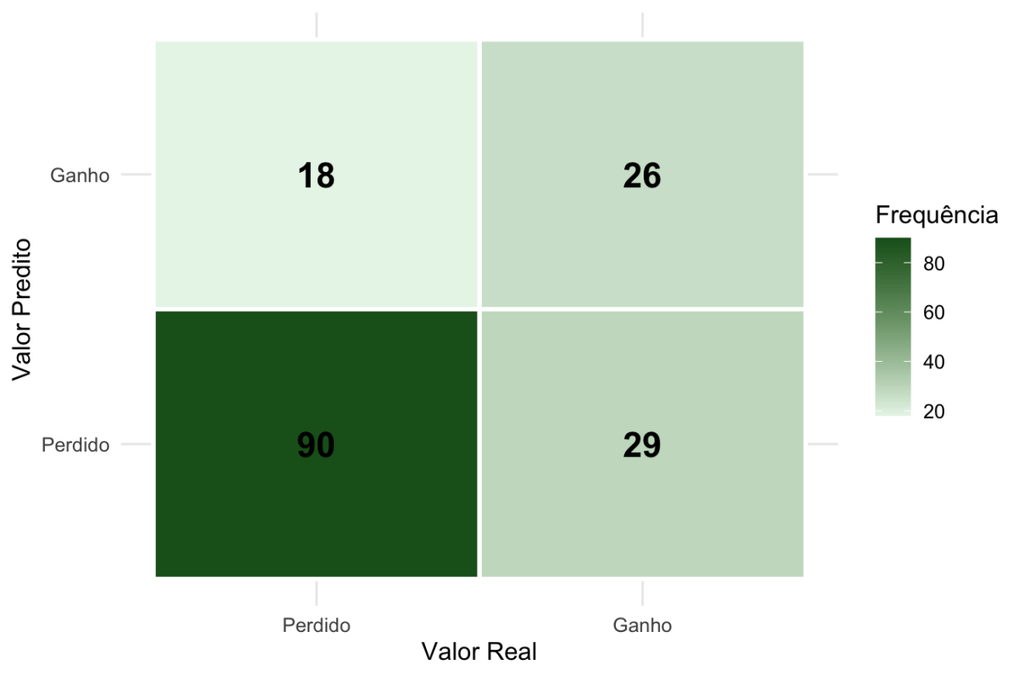
La precisión del modelo fue del 59%, lo que significa que poco más de la mitad de las oportunidades clasificadas como “ganadas” se concretaron. Esto apunta a una proporción relevante de falsos positivos, que pueden llevar a decisiones comerciales basadas en expectativas sobreestimadas. La matriz de confusión en la Figura 9 ilustra esta dificultad del modelo para predecir correctamente las ganancias.
Figura 9 – Matriz de confusión
Fuente: Resultados originales de la investigación
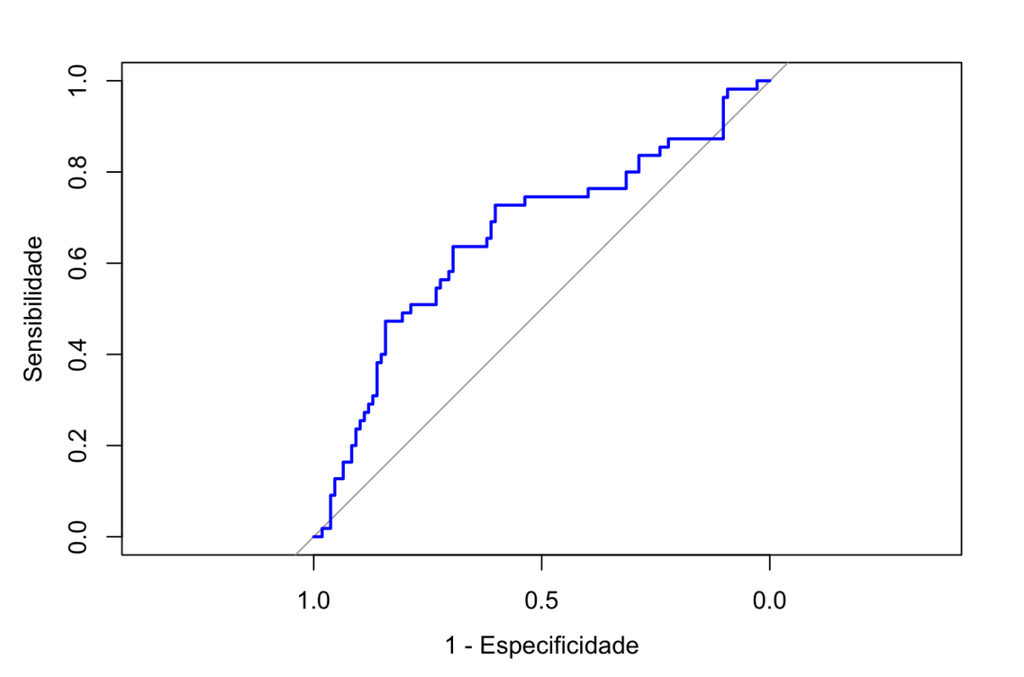
El área bajo la curva ROC (AUC) fue de aproximadamente 0,66, como muestra la Figura 10, indicando una capacidad discriminatoria moderada. Esto significa que el modelo puede distinguir, hasta cierto punto, oportunidades de ganancia y pérdida, pero aún no alcanza un rendimiento robusto para aplicaciones predictivas críticas. Este escenario se ve reforzado por la precisión balanceada del 65,3% y el coeficiente Kappa de 0,32. Desde el punto de vista del negocio, la tasa relevante de falsos negativos (oportunidades clasificadas como “perdidas” que serían “ganadas”) puede llevar a descuidar oportunidades con potencial real de conversión, resultando en pérdida de ingresos.
Figura 10 – Área bajo la curva ROC (AUC)
Fuente: Resultados originales de la investigación
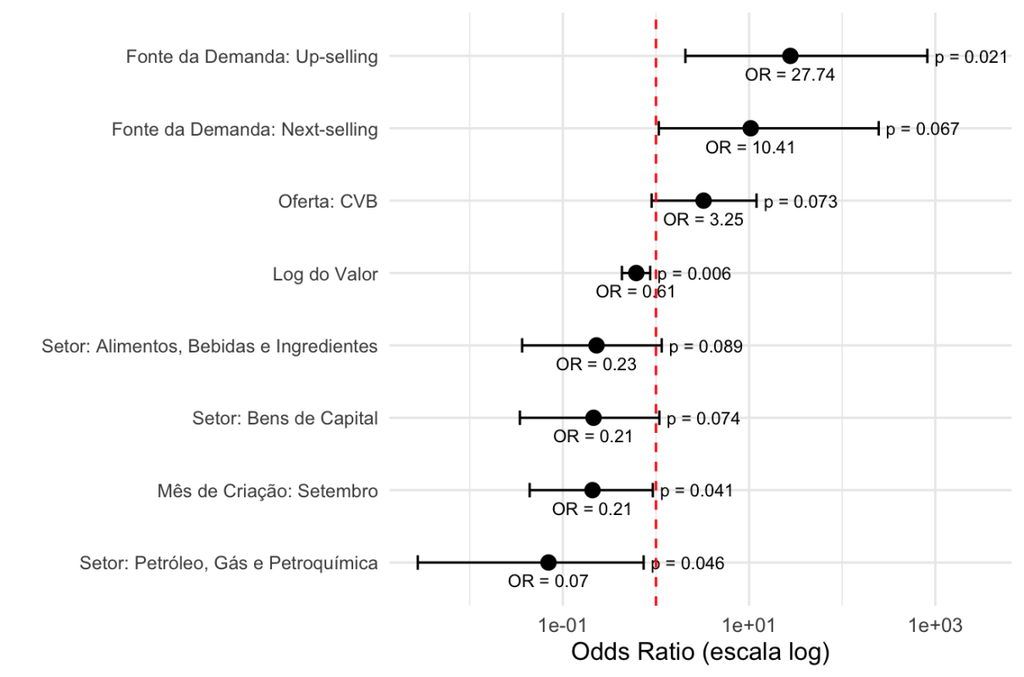
A pesar de las limitaciones, se extrajeron algunos patrones relevantes. La Figura 11, un Forest Plot de los Odds Ratios, evidencia el efecto de las variables explicativas con mayor significancia estadística (valor p < 0,1) sobre la probabilidad de “ganancia” comercial.
Figura 11 – Forest Plot de los Odds Ratios de categorías con valor p máximo de 0,1
Fuente: Resultados originales de la investigación
La variable “Fuente de la demanda” presentó los efectos más relevantes sobre la probabilidad de ganancia, especialmente para estrategias comerciales relacionadas con la base de clientes. El up-selling tuvo un odds ratio de aproximadamente 27,7 (p < 0,05), indicando que oportunidades via up-selling têm uma chance 27 vezes maior de fechar negócio do que via Eventos Próprios. O next-selling também mostrou um efeito positivo relevante (odds ratio ≈ 10,4), com significância marginal (p < 0,1). Negócios por “Indicação” apresentaram odds ratio de aproximadamente 5,42, mas sem relevância estatística (p-valor > 18%). Estos hallazgos sugieren que las estrategias basadas en la relación con clientes existentes son significativamente más eficaces que los enfoques tradicionales de prospección, aunque estos últimos son necesarios para atraer nuevos clientes al inicio del embudo.
En relación con las variables de oferta, la oferta “CVB” mostró un efecto positivo marginalmente significativo (p < 0,1), sugiriendo una mayor probabilidad de conversión. Sin embargo, otras categorías presentaron coeficientes extremos o cercanos a cero, con errores estándar altos, indicando posibles problemas de separación perfecta debido a la limitación de datos o un resultado uniforme. Al analizar la oferta de CVB con los motivos de pérdida, la mayor parte de los negocios perdidos fue porque el proyecto ya no se ejecutaría (alrededor del 67% de las veces). Esto sugiere la necesidad de profundizar para entender las cancelaciones y, posiblemente, ayudar al cliente a crear un caso de negocio para respaldar la aprobación.
Algunas variables presentaron Odds Ratios inferiores a 1, indicando un impacto negativo en la probabilidad de conversión. El log del valor de la oportunidad sugiere que los negocios de mayor valor tienden a tener menor probabilidad de cierre, posiblemente debido a una mayor complejidad y ciclos de venta más largos, lo que está alineado con la hipótesis de que las propuestas con valores mayores tienen menores chances de ser cerradas. Este trade-off entre ticket promedio y probabilidad de conversión es esencial para una gestión eficaz del pipeline comercial.
En cuanto a los sectores, la mayoría no presentó significancia estadística, con excepción de Petróleo, Gas y Petroquímica, que tuvo un efecto negativo significativo (odds ratio ≈ 0,07), indicando menor probabilidad de conversión en comparación con el sector de Energía Eléctrica. Esto puede reflejar características específicas de estos mercados, como rigor técnico o competencia. Otros sectores, como “Alimentos, Bebidas e Ingredientes” y “Bienes de Capital”, presentaron efectos negativos con significancia marginal. Así, la hipótesis de que sectores como Agronegocio y Energía Eléctrica tendrían mayores chances de éxito no fue completamente validada, ya que la mayoría de los sectores presentó baja relevancia estadística.
La variable mes de creación presentó pocos efectos relevantes, destacándose el mes de septiembre con un efecto negativo significativo (odds ratio ≈ 0,21), lo que indica una menor probabilidad de conversión en relación con noviembre. De esta forma, la hipótesis sobre períodos más prometedores para cerrar negocios no se validó completamente con los datos disponibles.
En resumen, el modelo propuesto permitió identificar patrones relevantes asociados a la conversión de oportunidades comerciales, destacando el papel de la fuente de la demanda, especialmente en estrategias de up-selling y next-selling. Los resultados refuerzan la importancia de la relación con la base de clientes como palanca central de generación de ingresos, al mismo tiempo que evidencian limitaciones asociadas a oportunidades de mayor valor y a determinados sectores de actuación. Oportunidades de mayor valor o provenientes de sectores con menor propensión a la conversión pueden demandar enfoques diferenciados, como mayor cualificación previa o personalización de propuestas. Gerencialmente, los hallazgos sugieren un enfoque comercial más segmentado, priorizando la expansión de clientes existentes para retorno en el corto plazo, y manteniendo iniciativas de prospección para la sostenibilidad del pipeline en el largo plazo. El modelo también evidencia la importancia de mejorar la calidad y granularidad de los datos comerciales, especialmente en categorías con baja representatividad, para reducir problemas estadísticos y aumentar la robustez de las inferencias. Aunque el modelo presenta una capacidad predictiva moderada, sus resultados ya permiten orientar decisiones comerciales de forma más fundamentada, contribuyendo a la asignación eficiente de recursos y al aumento de la efectividad de las estrategias de ventas.
4. Conclusión
El presente estudio buscó desarrollar y validar un modelo predictivo de clasificación, basado en regresión logística, para estimar la probabilidad de conversión de nuevos negocios en una consultoría de servicios brasileña. Se verificó que la aplicación del modelo permitió identificar patrones relevantes asociados al éxito comercial, destacándose la fuente de la demanda como un factor determinante. Se observó que estrategias basadas en la cartera de clientes, como up-selling y next-selling, presentaron una asociación positiva significativa con la conversión de negocios, indicando mayor eficacia en comparación con canales de prospección fría. En contrapartida, se identificó que oportunidades de mayor valor y aquellas provenientes de ciertos sectores, como Petróleo, Gas y Petroquímica, tienden a tener menor probabilidad de cierre. Estos hallazgos ofrecen una contribución gerencial al traducir datos históricos del CRM en directores prácticos, auxiliando al liderazgo en la priorización de esfuerzos comerciales y en la formulación de estrategias de ventas más segmentadas y eficaces.
Aunque el modelo demostró una capacidad predictiva moderada, con una precisión de aproximadamente 71% y un AUC de 0,66, y superó la línea de base, se observó una limitación en la sensibilidad, lo que resultó en una tasa relevante de falsos negativos, subestimando oportunidades de alta conversión. Las limitaciones del estudio incluyen la calidad y granularidad de los datos históricos, así como la complejidad inherente al fenómeno de la conversión de negocios, lo que impide inferir causalidad directa. Se recomienda que el modelo se utilice como un complemento al juicio gerencial, y no como un sustituto. Para estudios futuros, se sugiere la exploración de nuevas variables, la aplicación de técnicas de modelado más avanzadas y la incorporación de un mayor volumen de datos, con el objetivo de mejorar el rendimiento predictivo y ampliar la aplicabilidad práctica del modelo en la gestión comercial de la consultoría.
Referencias Bibliográficas
James, G.; Witten, D.; Hastie, T.; Tibshirani, R. An Introduction to Statistical Learning: with Applications in R. 2. ed. New York: Springer, 2021. Disponível em: https://www.casact.org/sites/default/files/2022-12/James-G.-et-al.-2nd-edition-Springer-2021.pdf. Acesso em 10 out. 2025.
Laney, Doug. 3D Data Management: Controlling Data Volume, Velocity and Variety. META Group Research Note, 2001. Disponível em: https://blogs.gartner.com/doug-laney. Acesso em: 10 out. 2025.
Mitchell, Tom M. Machine Learning. New York: McGraw-Hill, 1997. Disponível em: https://www.cs.cmu.edu/~tom/files/MachineLearningTomMitchell.pdf. Acesso em: 10 out. 2025.
Pinheiro, C. (2024). A relevância da ciência de dados nos negócios disponível em https://mittechreview.com.br/ciencia-de-dados-nos-negocios/?srsltid=AfmBOoq9oCqoh1zwb5cB19sAMdfMRs-6SRTnIc497h1ZFhmeOqHH8Xvb. Acesso em 11 out. 2025.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haz clic aquí y accede a la plataforma MBX Academy