
10 de septiembre de 2026
Modelado Multinivel en la Estimación de la Productividad de la Caña de Azúcar (Saccharum Spp.) en Unidades Productoras en la Región Sureste de Mato Grosso do Sul
Ferdinando Yoshio Agapito Urasaki; Luiz Gustavo Antônio de Souza
DOI: 10.22167/2675-6528-202602215
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
La estimación de la productividad es esencial para la planificación agrícola, pero la estructura de agrupamiento de los datos agronómicos frecuentemente viola el supuesto de independencia de los modelos clásicos de regresión. Se evaluó la precisión de modelos multinivel con clasificación cruzada en la predicción del rendimiento agrícola de la caña de azúcar en la región sureste de Mato Grosso do Sul, abarcando las cosechas de 2019/2020 a 2023/2024. El estudio analizó 29.674 observaciones, organizadas sobre 10.336 parcelas y 30 variedades. Se integraron predictores biofísicos y agrometeorológicos, aplicándose la estrategia “Step-Up” para la construcción de la estructura multinivel y la descomposición de la varianza. Los resultados evidenciaron que el enfoque particionó adecuadamente la varianza espacial, genética y temporal, cuantificando con éxito la interacción genotipo-ambiente. El ajuste final con inclinaciones aleatorias (M7) explicó el 81,1% de la varianza total y alcanzó una Raíz del Error Cuadrático Medio (RMSE) de 10,24 t ha⁻¹. La diferencia del 9,8% medida entre el Pseudo-R² marginal y el condicional demostró la relevante ganancia explicativa generada por la clasificación cruzada. El desempeño predictivo se equiparó a la exactitud reportada por algoritmos de Machine Learning, manteniendo el rigor paramétrico y la interpretabilidad de los predictores agronómicos. Se concluyó que la modelización multinivel consistió en una herramienta analítica robusta y transparente para la estimación de productividad y la planificación del sector sucroenergético.
Palabras clave: Agrometeorología; Caña de azúcar; Clasificación cruzada; Modelado multinivel; Rendimiento agrícola.
1. Introducción
La caña de azúcar (Saccharum spp.) se destaca como una de las principales materias primas agrícolas de Brasil, junto con la soja y el maíz. Juntas, estas culturas ocupan aproximadamente el 6,9% del territorio nacional y más del 70% del área agrícola cultivada (EPE, 2024b). Además de la producción de azúcar, el cultivo es fundamental para la generación de etanol y para el aprovechamiento de subproductos, como la vinaza en la fertirrigación y el bagazo en la cogeneración de energía eléctrica (Avilez et al., 2018; EPE, 2024b). Este aprovechamiento se refleja en la matriz energética brasileña, donde la biomasa de la caña de azúcar y sus derivados representan el 16,8% de la oferta interna, siendo el segundo mayor recurso energético del país, superado solo por el petróleo (EPE, 2024a).
En este contexto, la región sureste de Mato Grosso do Sul se configura como un polo estratégico para la producción de caña de azúcar, impulsada por su elevada densidad bioenergética (BIOSUL, 2024) y por condiciones edafoclimáticas favorables (Manzatto et al., 2009). Para garantizar la eficiencia operacional de las unidades productoras, la exactitud en la estimación de la productividad, medida en toneladas de caña de azúcar por hectárea (TCH), es crucial. Dicha precisión es determinante para la planificación de la cosecha y para la optimización logística, asegurando el suministro continuo a la planta industrial (Silva A.S. et al., 2022).
El potencial productivo de la caña de azúcar puede alcanzar 400 t ha⁻¹ al año, debido a su alta eficiencia fotosintética. Sin embargo, el rendimiento está condicionado por una compleja interacción de factores ambientales y operacionales, destacando la disponibilidad hídrica y nutricional (Silva et al., 2012). Como cultivo semiperenne, con un ciclo medio de cinco cortes, la caña de azúcar presenta cuatro fases fenológicas distintas (brotación, perfilamiento, crecimiento vegetativo y maduración), cada una con demandas hídricas específicas. Las fases iniciales son particularmente sensibles al estrés hídrico, y el crecimiento vegetativo es el período más crítico, mientras que una restricción hídrica moderada en la maduración favorece la acumulación de sacarosa (Avilez et al., 2018). La demanda hídrica total varía entre 1.500 y 2.500 mm, y la temperatura óptima se sitúa entre 25 y 33 °C (Almeida et al., 2008). Eventos extremos, como heladas, también pueden comprometer significativamente la producción, con una severidad proporcional a la intensidad y duración del fenómeno (Fiorentin et al., 2016).
Con el objetivo de cuantificar el impacto de estos factores agrometeorológicos y viabilizar la predicción de cosechas, el modelado de la productividad de la caña de azúcar ha sido ampliamente explorado. Métodos como la regresión lineal múltiple se han utilizado para estimar la productividad anual basándose en variables como irrigación, precipitación y temperatura del aire (Silva A.S. et al., 2022), o para correlacionar la producción de biomasa con índices de vegetación (Silva M.G.S. et al., 2022). Scarpari (2002) también propuso la predicción de la productividad agrícola integrando datos de precipitación y grados-día.
A pesar de los avances representados por estos modelos, la regresión lineal múltiple frecuentemente viola el supuesto de independencia de las observaciones, lo que puede llevar a estimaciones de error incorrectas e intervalos de confianza optimistas (Gelman y Hill, 2006). En el contexto agrícola, la productividad no es un evento aislado, sino el resultado de interdependencias estructurales complejas. Por ejemplo, variaciones climáticas en una cosecha afectan múltiples áreas simultáneamente, la variedad establece potenciales biológicos comunes entre parcelas, y la sucesión de ciclos en una misma parcela induce autocorrelación temporal.
Para abordar adecuadamente estas interdependencias, el modelado multinivel surge como una alternativa analítica más robusta en comparación con la regresión clásica. En datos agrícolas, la organización de las observaciones rara vez sigue una estructura jerárquica estricta, ya que los factores de agrupación como la variedad y la cosecha a menudo se cruzan a lo largo del tiempo sobre las parcelas, configurando una estructura de clasificación cruzada. Este enfoque permite aislar la varianza intrínseca a cada contexto (espacial, genético y temporal), corrigiendo la subestimación de los errores estándar, un problema común en modelos que ignoran esta complejidad (Gelman y Hill, 2006). Así, este estudio se justifica por la necesidad de una herramienta analítica que no solo prediga la productividad con precisión, sino que también preserve el rigor paramétrico y la interpretabilidad de los predictores agronómicos.
Bajo esta premisa, se objetivó evaluar la precisión de modelos multinivel con clasificación cruzada en la predicción de la productividad de la caña de azúcar en unidades productoras en la región sureste de Mato Grosso do Sul, abarcando la serie histórica de las cosechas de 2019/2020 a 2023/2024. Específicamente, se buscó descomponer la varianza total para cuantificar la influencia de los componentes de talhão, variedad y cosecha en la explicación de la variabilidad productiva, así como determinar la contribución relativa de los predictores biofísicos y agrometeorológicos sobre la varianza del TCH.
2. Material y Métodos
El estudio se llevó a cabo en la región sureste de Mato Grosso do Sul, abarcando los municipios de Angélica, Deodápolis, Glória de Dourados, Ivinhema, Jateí, Naviraí, Nova Andradina y Novo Horizonte do Sul. La elección de esta región se justificó por su relevancia estratégica y por la robustez de las series históricas de datos agronómicos, fundamentales para el ajuste de modelos de predicción de productividad a nivel local.
La base de datos se estructuró a partir de la integración de registros operativos, datos de teledetección multiespectral y variables ambientales exógenas, categorizadas como:
- Agronómicos: Registros de unidades de producción sucroenergética, incluyendo caracterización edáfica, fechas de siembra y cosecha, material genético (variedad), número de corte, productividad agrícola (TCH) y geometría de las parcelas.
- Variables Ambientales y Espectrales:
- Teledetección: Imágenes del satélite Sentinel-2 (MSI), procesadas en Nivel 2A, con resolución espacial de 10 m y 20 m y revisita de cinco días, para la extracción de 11 índices espectrales.
- Precipitación: Estimaciones del grupo Climate Hazards Group InfraRed Precipitation with Station Data (CHIRPS), con resolución temporal diaria y espacial de 0,05° (~5,5 km).
- Topografía: Modelo Digital de Elevación (MDE) derivado de la Shuttle Radar Topography Mission (SRTM), con resolución espacial de 1 arco-segundo (~30 m).
- Meteorología: Datos de reanálisis de la colección ERA5-Land, con resolución espacial de 0,1° (~11 km) y temporal diaria, para extracción de temperatura del aire (mínima, media y máxima), temperatura del punto de rocío, componentes vectoriales del viento y radiación solar de onda corta.
El flujo de trabajo se delineó en once pasos: (i) limpieza y ingeniería de atributos agronómicos; (ii) procesamiento geométrico para estadística zonal; (iii) recolección mensual de índices espectrales; (iv) recolección mensual de variables agrometeorológicas; (v) estructuración de series temporales espectrales y agrometeorológicas; (vi) tratamiento de lagunas de los índices espectrales; (vii) sincronización de ciclos y ajuste de las fechas de manejo; (viii) consolidación de métricas e integración temporal; (ix) selección de variables y reducción de dimensionalidad; (x) especificación del modelo multinivel y (xi) validación y evaluación de desempeño de los modelos.
Todo el procesamiento se implementó en lenguaje Python (versión 3.12), utilizando las bibliotecas Pandas, GeoPandas y NumPy. La integración y el procesamiento en la nube de los índices espectrales y variables agrometeorológicas se operaron a través de la API de Google Earth Engine (biblioteca ee) y Geemap. Para la modelización multinivel, se utilizó la biblioteca Pymer4, que proporciona una interfaz con los algoritmos del paquete lme4 del lenguaje R.
El tratamiento de los datos agronómicos brutos (225.992 registros) se inició con la eliminación de observaciones con datos ausentes de productividad, número de corte y ambiente de producción, restringiendo el muestreo a las modalidades de producción propia y de asociación. Se aseguró la consistencia temporal y la paridad de área, eliminando parcelas con siembras multivarietales. El recorte analítico abarcó las cosechas 2019/2020 a 2023/2024, del primer al séptimo corte, y las 30 variedades de mayor representatividad. Los valores atípicos (outliers) de productividad se identificaron por el método del Rango Intercuartílico (IQR), con un multiplicador de 1,5, estratificado por número de corte y ambiente de producción. Se validó la consistencia entre atributos alfanuméricos y vectoriales, descartándose registros con divergencia absoluta superior a 0,025 ha. La base de datos resultante totalizó 32.033 registros.
Para el refinamiento del muestreo, se seleccionaron parcelas con un área superior a 1,0 ha. Las geometrías originales se redefinieron mediante una retracción espacial de 20 m para mitigar el efecto de borde, asegurando que solo se procesaran los píxeles internos. Los 30.953 registros resultantes sirvieron como base vectorial para estadísticas zonales en la plataforma Google Earth Engine (GEE).
Para la colección mensual de índices espectrales, se preseleccionaron imágenes del Sentinel-2 con una cobertura de nubes inferior al 20%, aplicando un filtro booleano basado en la capa de clasificación de escena (SCL) generada por el algoritmo Sen2Cor. Los datos se organizaron en composiciones mensuales, utilizando la mediana de cada píxel para eliminar ruidos atmosféricos. Se calcularon 11 índices espectrales derivados de diferentes bandas, según se detalla en la Tabla 1.
Tabla 1. Relación de índices espectrales y respectivas formulaciones.
| Índice | Acrónimo | Ecuación | Referencia |
|---|---|---|---|
| índice de vegetación por diferencia normalizada | NDVI | (PNIR – PR) / (PNIR + PR) | Rouse et al. (1974) |
| índice de vegetación por diferencia normalizada verde | GNDVI | (PNIR – PG) / (PNIR + PG) | Gitelson et al. (1996) |
| índice de vegetación ajustado al suelo | SAVI | (PNIR – PR / (PNIR + PR + L)) * (1 + L) | Huete (1988) |
| índice de vegetación ajustado al suelo modificado 2 | MSAVI2 | (2PNIR + 1 – sqrt((2PNIR + 1)^2 – 8(PNIR – PR))) / 2 | Qi et al. (1994) |
| índice de vegetación realzado | EVI | 2.5 * (PNIR – PR / (PNIR + 6PR – 7.5PB + 1)) | Huete et al. (2002) |
| índice de agua por diferencia normalizada | NDWI | (PNIR – PSWIR1) / (PNIR + PSWIR1) | Gao (1996) |
| índice de borde del rojo por diferencia normalizada | NDRE | (PRE2 – PRE1) / (PRE2 + PRE1) | Barnes et al. (2000) |
| índice de clorofila del borde rojo | CIre | (PRE3 – 1) / PRE1 | Gitelson et al. (2005) |
| índice de clorofila del borde del rojo invertido | IRECI | (PRE3 – PR) / (PRE1/PRE2) | Frampton et al. (2013) |
| índice de área foliar del sentinel-2 | SeLI | (PNIR – PRE1) / (PNIR + PRE1) | Pasqualotto et al. (2019) |
| índice de vegetación de amplio rango dinámico | WDRVI | (PNIR – PR) / (aPNIR + PR) | Gitelson (2004) |
Fuente: Datos originales de la investigación. Nota: α = 0,1; L = 0,5. Bandas Sentinel-2: B2 (B), B3 (G), B4 (R), B5 (RE1), B6 (RE2), B7 (RE3), B8 (NIR), B11 (SWIR1).
La colección mensual de variables agrometeorológicas utilizó datos de reanálisis y estimaciones satelitales (CHIRPS y ERA5-Land) para garantizar la continuidad temporal y la cobertura espacial. Los indicadores se estructuraron en cinco ejes: oferta hídrica (precipitación – P), régimen térmico (temperaturas mínima, media y máxima – Tmin, Tmed, Tmax), disponibilidad energética (radiación solar incidente de onda corta – Rs), demanda evaporativa (evapotranspiración de referencia – ET0) y estrés atmosférico (déficit de presión de vapor – VPD). La acumulación térmica se cuantificó por grados-día diarios (GDD) con Tbase de 18 °C y T corte de 35 °C. La ET0 se estimó mediante el método de Penman-Monteith. Tras el cálculo diario, las series matriciales se agregaron en composiciones mensuales, utilizando el reductor de suma para variables de flujo (P, ET0, GDD y Rs) y la media para variables de estado (Tmin, Tmed, Tmax y VPD). El conjunto de indicadores y métodos de agregación se presenta en la Tabla 2.
Tabla 2. Indicadores agrometeorológicos y métodos de agregación.
| Índice | Acrónimo | Unidad | Representación | Agregación | Referencia |
|---|---|---|---|---|---|
| precipitación | P | mm | suministro hídrico pluvial | suma | CHIRPS |
| temperatura más baja | Tmin | °C | límite térmico inferior | media | ERA5-Land |
| temperatura media | Tmed | °C | estado térmico medio | media | ERA5-Land |
| temperatura más alta | Tmax | °C | límite térmico superior | media | ERA5-Land |
| radiación solar de onda corta | Rs | MJ · m⁻² | oferta energética solar | suma | ERA5-Land |
| evapotranspiración de referencia | ET₀ | mm | demanda potencial de agua | suma | Allen et al. (1998) |
| grados-día acumulados | GDA | °C | acumulación térmica fenológica | suma | Villa Nova et al. (1972) |
| déficit de presión de vapor | VPD | kPa | estrés higrométrico | media | ERA5-Land |
Fuente: Datos originales de la investigación.
Para la sistematización de las series temporales, los datos matriciales mensuales de las colecciones de índices espectrales y de variables agrometeorológicas se integraron a las geometrías de las parcelas vía estadística zonal en la plataforma GEE. Los valores medios en la parcela se computaron con un reductor aritmético, con una escala espacial de salida de 20 m, convirtiendo los datos matriciales en atributos tabulares.
Las brechas internas de los índices espectrales se trataron mediante interpolación lineal. Para los extremos de las series, donde la interpolación no era viable, se aplicó la imputación por persistencia (“forward fill” y “backward fill”), propagando el último valor válido observado. Las series se extendieron con una ventana temporal de 100 días anteriores y posteriores a los límites de cada ciclo para prevenir distorsiones matemáticas.
Las series temporales de los índices espectrales se suavizaron con el filtro polinomial Savitzky-Golay (polinomio de segundo orden, ventana móvil de cinco observaciones). Los límites del ciclo se ajustaron basándose en la respuesta espectral del NDVI suavizado, utilizando la detección de mínimos locales dentro de una ventana de tolerancia de 90 días alrededor de las fechas operacionales registradas.
Con los límites de los ciclos ajustados, las series temporales mensuales se agregaron en ventanas cronológicas fijas: F1 (30 a 120 días después del inicio del ciclo) y F2 (120 a 270 días). Para los 11 índices espectrales, se calculó la integral temporal (AUC) por la regla trapezoidal. Las variables agrometeorológicas de flujo (P, ET0, GDD y Rs) se integraron por suma, y las variables de estado (Tmin, Tmed, Tmax y VPD) por la media aritmética. Cada atributo fue identificado por una nomenclatura específica. Este enfoque resultó en un conjunto de 38 características biofísicas y agrometeorológicas en 29.674 observaciones.
Para la selección de variables y reducción de dimensionalidad, se utilizó el método de Máxima Relevancia y Mínima Redundancia (mRMR), que prioriza variables con mayor dependencia estadística en relación a la variable objetivo y menor redundancia. Tras la clasificación, se seleccionaron las 10 variables de mayor relevancia. A continuación, para mitigar la multicolinealidad, se realizó el diagnóstico mediante el Factor de Inflación de la Varianza (VIF), excluyendo iterativamente variables con VIF superior a cinco, lo que resultó en un conjunto de seis variables. Las variables cuantitativas fueron centradas en la media general.
La construcción del modelo multinivel adoptó la estrategia “Step-Up”, que consiste en la adición de complejidad paramétrica creciente. El procedimiento estadístico se inició con la estimación de modelos incondicionales para particionar la varianza total de la productividad (TCH) asociada a los contextos espacial (parcela), genético (variedad) y temporal (campaña).
El modelo M0 estableció la línea base de la varianza, incluyendo solo el intercepto aleatorio para el talhão:
Y_i = beta_0 + u_t[i] + e_i (1)
Donde: Y_i: productividad (TCH) en la observación i; beta_0: intercepto fijo global; u_t[i]: efecto aleatorio del talhão; e_i: error residual.
Los modelos M1 y M2 probaron, independientemente, la inclusión de los componentes de varianza asociados a la variedad y a la cosecha, respectivamente:
M1: Intercepto Aleatorio para Lote y Variedad
Y_i = beta_0 + u_t[i] + v_v[i] + e_i (2)
Donde: v_v[i]: efecto aleatorio de la variedad.
M2: Intercepto Aleatorio para Lote y Cosecha
Y_i = beta_0 + u_t[i] + w_s[i] + e_i (3)
Donde: w_s[i]: efecto aleatorio de la cosecha.
En el modelo M3, los interceptos aleatorios de talud, variedad y cosecha se incorporaron simultáneamente, consolidando la estructura de clasificación cruzada:
M3: de Validación cruzada
Y_i = beta_0 + u_t[i] + v_v[i] + w_s[i] + e_i (4)
La estimación de los parámetros y componentes de varianza se realizó mediante el método de Máxima Verosimilitud Restringida (REML). Para evaluar la ganancia de ajuste estadístico, se utilizaron el Criterio de Información Bayesiano (BIC) y la Prueba de Razón de Verosimilitud (LRT), con reajustes por Máxima Verosimilitud (ML) para la comparación de modelos con diferentes estructuras de efectos fijos.
Consolidados los componentes de varianza en el M3, se añadieron las variables categóricas de efecto fijo. El modelo M4 incorporó el número de corte y el ambiente de producción:
M4: Condicional con Control Agronómico
Y_i = beta_0 + beta_1 cohorte_i + beta_2 entorno_t[i] + u_t[i] + v_v[i] + w_s[i] + e_i (5)
Donde: corte_i: número de corte; ambiente_t[i]: ambiente de producción del talhão t; beta_1, beta_2: coeficientes de efectos fijos.
A continuación, el modelo M5 incorporó la edad del cultivo (en días) como covariable, centrada en la media general:
M5: Condicional con Control de Edad
Y_i = beta_0 + beta_1 cohorte_i + beta_2 entorno_t[i] + beta_3 edad_cent_i + u_t[i] + v_v[i] + w_s[i] + e_i (6)
Donde: edad_cent_i: edad de la caña de azúcar centralizada; beta_3: coeficiente de inclinación para la edad.
La integración de las variables biofísicas y agrometeorológicas previamente seleccionadas se realizó a través del procedimiento “Forward Stepwise” en el modelo M6:
M6: Condicional con Efectos Fijos
Y_i = beta_0 + beta_1 corte_i + beta_2 ambiente_t[i] + beta_3 edad_cent_i + Sum(lambda_q Z_q,i) desde q=1 hasta Q + u_t[i] + v_v[i] + w_s[i] + e_i (7)
Donde: Z_q,i: valor del q-ésimo predictor biofísico o agrometeorológico; lambda_q: coeficiente fijo parcial.
Finalmente, para evaluar variaciones en la sensibilidad de un contexto en respuesta a variables específicas, se probaron efectos aleatorios de pendiente en el M6, priorizando variables de estrés higrométrico (VPD), acumulación térmica (GDA) y estado nutricional (NDRE y Clre), en las ventanas F1 y F2. El modelado siguió la estrategia “Forward Stepwise” para cada variable candidata, especificando un modelo base e incorporándola como efecto aleatorio de pendiente para la comparación del criterio de información. La validación exigió una reducción del BIC, ausencia de fallos en la convergencia y VPC de la pendiente de al menos el 1% de la varianza total. El modelo M7 incluyó pendientes aleatorias:
M7: Inclinaciones Aleatorias (Interacción Genotipo × Ambiente)
Y_i = beta_0 + beta_1 corte_i + beta_2 ambiente_t[i] + beta_3 edad_cent_i + Sum(lambda_q Z_q,i) desde q=1 hasta Q + u_t[i] + v_0,v[i] + Sum(v_p,v[i] X_p,i) desde p=1 hasta P + w_s[i] + e_i (8)
Donde: v_0,v[i]: intercepto aleatorio de la variedad v; X_p,i: valor del p-ésimo predictor sometido al efecto aleatorio; v_p,v[i]: efecto aleatorio de inclinación de la variedad sobre el predictor X_p.
Para la validación y evaluación del desempeño de los modelos, se adoptaron dos métricas de exactitud predictiva: Error Absoluto Medio (MAE) y Raíz del Error Cuadrático Medio (RMSE). La ganancia explicativa se midió por la proporción de varianza retenida, utilizando el Pseudo-R² Marginal (R²m), que representa la varianza explicada por los efectos fijos, y el Pseudo-R² Condicional (R²c), que representa la varianza total explicada por el modelo completo (efectos fijos combinados con los componentes aleatorios).
3. Resultados y Discusión
Descomposición de la Varianza: M0 a M3
El análisis inicial, utilizando el modelo nulo (M0), reveló que el 21,83% de la variabilidad de la productividad de la caña de azúcar (TCH) estaba asociada a la localización espacial (parcela), validando la necesidad del enfoque multinivel, según se detalla en la Tabla 3.
Tabla 3. Evolución del ajuste estadístico de los modelos en la etapa incondicional (M0 a M3).
| Patrón | σ² (parcela) | σ² (variedad) | σ² (cosecha) | σ² (residuos) | BIC | ΔBIC |
|---|---|---|---|---|---|---|
| M0 | 131,00 | 468,99 | 272.658 | |||
| M1 | 95,20 | 166,90 | 441,85 | 269.967 | 2.691 | |
| M2 | 169,87 | 58,87 | 395,48 | 269.755 | 2.903 | |
| M3 | 182,73 | 303,13 | 94,86 | 318,25 | 265.139 | 7.519 |
Fuente: Datos originales de la investigación. Nota: N=29.674 observaciones. Estructura de agrupación: parcela (n = 10.336), variedad (n = 30) y cosecha (n = 5). ΔBIC calculado en relación con el modelo nulo (M0).
La inclusión de la variedad en el modelo M1 resultó en una reducción del 27,3% en la varianza del lote, lo que indica un sesgo de posicionamiento varietal. Por otro lado, la inserción independiente de la cosecha en el modelo M2 aumentó la varianza del lote en un 29,7%, lo que sugiere que la fluctuación temporal puede enmascarar la heterogeneidad espacial intrínseca. En el modelo M3, con clasificación cruzada, la variedad emergió como el principal componente de varianza de la productividad (33,72%), superando al lote (20,33%) y a la cosecha (10,55%). Esta estructura fue ratificada por la reducción del BIC, de 272.659 en M0 a 265.134, con una varianza residual de 318,25 (t ha⁻¹)².
Variables de Control Agronómico: M4 y M5
La inserción de los controles agronómicos de número de corte y ambiente de producción en el modelo M4 redujo la varianza de la variedad de 303,13 a 51,14 (t ha⁻¹)², corrigiendo un sesgo de variable omitida y demostrando que la variabilidad productiva atribuida a la variedad en el modelo incondicional era, en parte, consecuencia de estos factores (Tabla 4).
Tabla 4. Evolución del ajuste estadístico de los modelos en la etapa condicional (M4 a M5).
| Patrón | σ²t (parcela) | σ²v (variedad) | σ²s (cosecha) | σ²e (residuos) | BIC | ΔBIC |
|---|---|---|---|---|---|---|
| M3 | 182,73 | 303,13 | 94,86 | 318,25 | 265.139 | 7.519 |
| M4 | 80,83 | 51,14 | 41,25 | 212,81 | 250.926 | 14.213 |
| M5 | 92,53 | 48,85 | 31,89 | 177,27 | 247.267 | 3.659 |
Fuente: Datos originales de la investigación. Nota: ΔBIC calculado en relación con el modelo anterior.
La adición de la edad del cultivo en el modelo M5 redujo la varianza residual a 177,27 (t ha⁻¹)² y reveló un efecto de supresión sobre la varianza intrínseca del lote, que aumentó a 92,53 (t ha⁻¹ )². Ambas adiciones (M4 y M5) fueron validadas por sucesivas reducciones en el BIC.
Selección de Variables y Reducción de Dimensionalidad
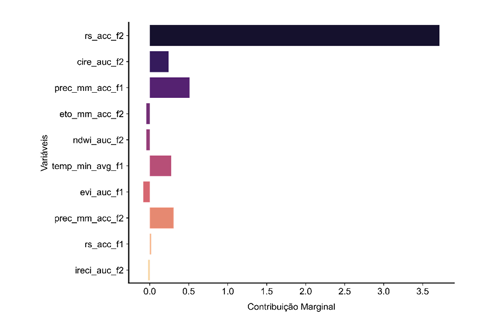
La clasificación de las 38 características biofísicas y agrometeorológicas mediante mRMR (Figura 1) indicó la radiación solar en la ventana F2 como la de mayor relevancia informacional. Sin embargo, la evaluación de VIF reveló multicolinealidad severa entre las 10 variables preseleccionadas, con la radiación solar en F2 presentando un VIF de 84,36. Después de cuatro rondas de exclusión, se seleccionaron seis variables remanentes de baja colinealidad: IRECI en F2 (VIF = 1,28), EVI en F1 (VIF = 1,65), radiación solar en F1 (VIF = 1,87), precipitación en F1 (VIF = 2,10) y en F2 (VIF = 2,88), y evapotranspiración de referencia en F2 (VIF = 2,92).
Figura 1. Ranking de las diez variables preseleccionadas vía mRMR
Fuente: Datos originales de la investigación.
Efectos Fijos: M6
La inserción de las seis variables seleccionadas en el modelo M5, centradas en la media general, se realizó mediante el procedimiento Forward Stepwise (Tabla 5). El índice biofísico IRECI (F2) fue el que más contribuyó, promoviendo una reducción de 9.829 puntos en el BIC. Las adiciones subsecuentes resultaron en reducciones marginales decrecientes, culminando con la precipitación (F1). En total, las inclusiones redujeron el BIC de 247.267 a 235.774, resultando en el modelo M6.
Tabla 5. Inclusión iterativa de variables biofísicas y agrometeorológicas mediante el procedimiento Forward Stepwise (M6).
| Paso | Variable Añadida | Log-Verosimilitud | LRT | BIC | ΔBIC |
|---|---|---|---|---|---|
| M5 | -123.551 | < 0,001 | 247.267 | ||
| 1 | ireci_auc_f2_cent | – 118.632 | < 0,001 | 237.438 | 9.829 |
| 2 | rs_acc_f1_cent | – 118.354 | < 0,001 | 236.893 | 545 |
| 3 | evi_auc_f1_cent | – 117.927 | < 0,001 | 236.050 | 843 |
| 4 | prec_mm_acc_f2_cent | – 117.853 | < 0,001 | 235.911 | 139 |
| 5 | eto_mm_acc_f2_cent | – 117.799 | < 0,001 | 235.815 | 96 |
| 6 | prec_mm_f1_cent | – 117.774 | < 0,001 | 235.774 | 41 |
Fuente: Datos originales de la investigación. Nota: ΔBIC calculado en relación con el paso iterativo inmediatamente anterior. El sufijo _cent indica que la variable fue centralizada en la media general.
Esta estructuración resultó en la mayor ganancia explicativa del estudio (Tabla 6). La inclusión simultánea de los predictores biofísicos y agrometeorológicos redujo la varianza residual en un 26,1% y la varianza de la cosecha en un 90,7%. Este decrecimiento indicó que la fluctuación interanual de la productividad fue casi íntegramente explicada por los predictores de efecto fijo, restringiendo el efecto aleatorio de la cosecha al 1,43% de la varianza total del modelo. Este comportamiento corrobora la premisa de que la variabilidad temporal de la productividad está predominantemente gobernada por las condiciones agrometeorológicas y por la respuesta biofísica del cultivo en cada ciclo (Marin et al., 2008; Silva, M.G.S. et al., 2022).
Tabla 6. Evolución del ajuste estadístico del modelo en la adición de efectos fijos (M6).
| Patrón | σ²t (parcela) | σ²v (variedad) | σ²s (cosecha) | σ²e (residuos) | BIC | ΔBIC |
|---|---|---|---|---|---|---|
| M5 | 92,53 | 48,85 | 31,89 | 177,27 | 247.267 | 3.659 |
| M6 | 42,40 | 29,66 | 2,95 | 130,91 | 235.774 | 11.493 |
Fuente: Datos originales de la investigación. Nota: ΔBIC calculado en relación con el modelo anterior.
Inclinaciones Aleatorias: M7
La etapa final de estructuración evaluó la sensibilidad del cultivo a variables específicas mediante la inclusión de inclinaciones aleatorias para el contexto de la variedad. La estrategia Forward Stepwise identificó el índice NDRE en F1 y el déficit de presión de vapor en F2 como las dos variables que cumplieron los criterios de validación (Tabla 7).
Tabla 7. Resumen de las iteraciones válidas para la inclusión de inclinaciones aleatorias.
| Ronda | Preditor bajo Efecto Aleatorio | Efecto Fijo Sustituido | ΔBIC | VPC (%) |
|---|---|---|---|---|
| 1 | vpd_kpa_avg_f1_cent | eto_mm_acc_f2_cent | 82 | 2,37 |
| 1 | vpd_kpa_avg_f2_cent | eto_mm_acc_f2_cent | 282 | 4,46 |
| 1 | ndre_auc_f1_cent | evi_auc_f1_cent | 378 | 3,22 |
| 1 | ndre_auc_f2_cent | ireci_auc_f2_cent | 157 | 3,74 |
| 2 | vpd_kpa_avg_f1_cent | eto_mm_acc_f2_cent | 121 | 1,99 |
| 2 | vpd_kpa_avg_f2_cent | eto_mm_acc_f2_cent | 223 | 4,06 |
Fuente: Datos originales de la investigación. Nota: ΔBIC calculado en relación con el modelo base respectivo. Tabla solo con los predictores evaluados que superaron los criterios de validación.
En el ámbito de los efectos fijos, la inserción de estas nuevas pendientes requirió la eliminación previa del EVI (F1), la evapotranspiración de referencia (F2) y la precipitación (F1) debido a la multicolinealidad y la pérdida de significancia estadística (p = 0,062). El análisis de los efectos aleatorios del modelo M7 evidenció la interacción genotipo-ambiente. Las pendientes del NDRE en F1 y del déficit de presión de vapor en F2 retuvieron, respectivamente, el 2,41% y el 4,06% de la varianza total. Estos predictores actuaron como indicadores cuantitativos de la heterogeneidad genética, con la dinámica del NDRE en F1 reflejando el cierre del dosel y la eficiencia inicial de absorción de nitrógeno (Shendryk et al., 2020), y la sensibilidad al déficit de presión de vapor en F2 señalando la tolerancia al estrés higrométrico (Inman-Bamber y Smith, 2005). El modelado de esta interacción redujo la varianza residual a 125,79 (t ha⁻¹)² y atenuó la varianza de la cosecha a 1,85 (t ha⁻¹)², representando el 0,86% de la varianza total (Tabla 8).
Tabla 8. Evolución del ajuste estadístico del modelo en la adición de efectos aleatorios de pendiente (M7).
| Patrón | σ²t (parcela) | σ²v (variedad) | σ²v0 | σ²v1 | sigma al cuadrado v dos | σ²w (cosecha) | σ²e (residuos) | BIC | ΔBIC |
|---|---|---|---|---|---|---|---|---|---|
| M6 | 42,40 | 29,66 | 2,95 | 130,91 | 235.774 | 11.493 | |||
| M7 | 45,94 | 31,00 | 5,20 | 8,74 | 1,85 | 125,79 | 235.032 | 742 |
Fuente: Datos originales de la investigación. Nota: ΔBIC calculado en relación con el modelo anterior. σ²v0: varianza del intercepto aleatorio de la variedad; σ²v1: varianza de la pendiente aleatoria del NDRE (F1); σ²v2: varianza de la pendiente aleatoria del VPD (F2).
Validación y Evaluación del Desempeño de los Modelos
Para cuantificar la evolución del poder predictivo, el modelo M3 sirvió como línea de base comparativa (Tabla 9). Su Pseudo-R² Condicional (R²c) indicó que los contextos de talhão, variedad y cosecha explicaron el 45,7% de la varianza total de la productividad, con MAE de 12,63 t ha⁻¹ y RMSE de 15,88 t ha⁻¹.
Tabla 9. Métricas de evaluación de desempeño predictivo y criterios de información de los modelos multinivel ajustados para la estimación de TCH.
| Patrón | BIC | LRT | R²m | R²c | MAE (t ha⁻¹) | RMSE (t ha⁻¹) |
|---|---|---|---|---|---|---|
| M3: de Validación cruzada | 265.139 | < 0,001 | 0,000 | 0,457 | 12,63 | 15,88 |
| M4: con Control Agronómico | 250.926 | < 0,001 | 0,475 | 0,664 | 10,33 | 13,26 |
| M5: con Control de Edad | 247.267 | < 0,001 | 0,521 | 0,730 | 9,25 | 11,91 |
| M6: con Efectos Fijos | 235.774 | < 0,001 | 0,709 | 0,802 | 7,89 | 10,48 |
| M7: con Inclinación Aleatoria | 235.033 | < 0,001 | 0,713 | 0,811 | 7,72 | 10,24 |
Fuente: Datos originales de la investigación
La adición de los controles agronómicos y la edad del cultivo (M4 y M5) incrementó la capacidad explicativa marginal. El M5 capturó el 52,1% de la varianza a través de sus efectos fijos (R²m), elevando la explicación global (R²c) al 73,0% y reduciendo el RMSE a 11,91 t ha⁻¹. La mayor ganancia marginal ocurrió en el M6, con la inclusión de las variables biofísicas y agrometeorológicas, que elevó la varianza explicada por los efectos fijos (R²m) al 70,9% y redujo el MAE a 7,89 t ha⁻¹.
La inclusión de inclinaciones aleatorias en el modelo M7 consolidó la interacción genotipo-ambiente, validada por el LRT (p < 0,001) y con el menor BIC (235.033). El modelo definitivo alcanzó MAE de 7,72 t ha⁻¹ y RMSE de 10,24 t ha⁻¹, con una explicación global (R²c) del 81,1%. La diferencia del 9,8% entre el R²c y el R²m (0,713) representó la variabilidad atribuida a los contextos de parcela, variedad y cosecha, justificando el enfoque multinivel (Gelman y Hill, 2006).
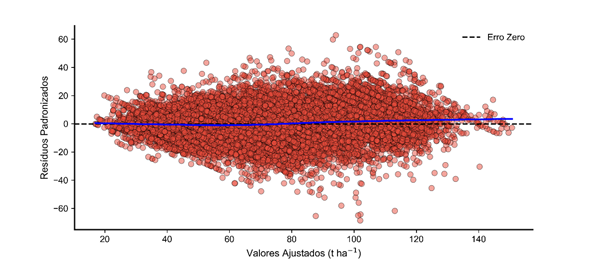
La verificación de los supuestos de homocedasticidad y linealidad del modelo M7, mediante análisis gráfico, mostró que la dispersión de los residuos estandarizados no evidenció patrones severos de embudo (Figura 2), validando la constancia de la varianza. La línea de tendencia no paramétrica se mantuvo cercana a cero, atestiguando la ausencia de sesgo sistemático en las predicciones (Zuur et al., 2009).
Figura 2. Dispersión de los residuos estandarizados en función de los valores ajustados para el diagnóstico de homocedasticidad del modelo M7.
Fuente: Datos originales de la investigación.
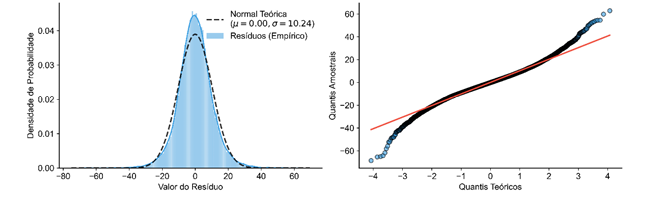
La distribución de los residuos mostró adherencia a los cuantiles teóricos en la porción central (Figura 3), aunque con desviaciones en las colas (leptocurtosis). Tales desviaciones no invalidan la inferencia estadística en modelos multinivel, dada la robustez asintótica garantizada por el Teorema del Límite Central frente al tamaño expresivo de la muestra (Zuur et al., 2009).
Figura 3. Distribución de densidad de probabilidad y gráfico de cuantiles-cuantiles para la verificación de la normalidad de los residuos del modelo M7.
Fuente: Datos originales de la investigación.
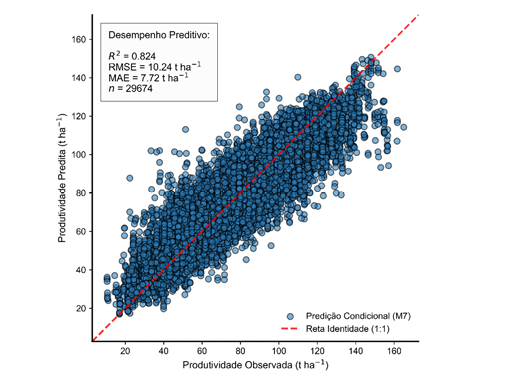
En la evaluación del rendimiento predictivo, la dispersión de las estimaciones (Figura 4) validó la capacidad explicativa del modelo, presentando alta adherencia a la recta de identidad. Las métricas globales de error (MAE = 7,72 t ha⁻¹ y RMSE = 10,24 t ha⁻¹) y el coeficiente de determinación (R²predictivo = 0,824) atestiguaron la adecuación práctica del modelo.
Figura 4. Relación entre la productividad de caña de azúcar (TCH) observada y los valores predichos por el modelo M7.
Fuente: Datos originales de la investigación.
En comparación con técnicas de Machine Learning, los resultados obtenidos se equipararon a los de algoritmos de Random Forest, que registraron RMSE entre 11,70 y 15,56 t ha⁻¹ y MAE de 4,57 a 7,53 t ha⁻¹ (Amaro, 2023; Bocca y Rodrigues, 2016). El enfoque multinivel presentó precisión predictiva equivalente, con la ventaja inferencial de permitir la interpretación directa de los parámetros agronómicos, cuantificando la partición de varianza y explicitando la interacción genotipo-ambiente.
La extracción de los coeficientes de efectos fijos reveló la magnitud estimada de los impactos de manejo, ambiente, clima y estado biofísico (Tabla 10). El intercepto global se situó en 98,06 ± 1,35 t ha⁻¹, representando la productividad media basal teórica de un cañaveral en primer corte (caña-planta), en el ambiente de mayor potencial (ambiente A), bajo predictores continuos centralizados en sus respectivas medias globales.
Tabla 10. Estimaciones de parámetros de efectos fijos del modelo M7 para la predicción de la productividad (TCH).
| Parámetro | Media Global | Estimación ± EP | IC (95%) | t | valor p |
|---|---|---|---|---|---|
| productividad media basal | 98,06 ± 1,35 | 95,41; 100,70 | 72,73 | < 0,001 | |
| Controles de Gestión | |||||
| Segunda fase | -8,99 ± 0,29 | -9,55; -8,42 | -31,11 | < 0,001 | |
| 3er corte | -18,82 ± 0,30 | -19,40; -18,25 | -63,87 | < 0,001 | |
| Cuarto corte | -23,60 ± 0,31 | -24,21; -22,99 | -76,19 | < 0,001 | |
| 5ª etapa | -25,00 ± 0,34 | -25,67; -24,32 | -72,62 | < 0,001 | |
| Sexta tanda | -26,91 ± 0,42 | -27,73; -26,09 | -64,44 | < 0,001 | |
| 7ª cohorte | -28,94 ± 0,65 | -30,22; -27,66 | -44,42 | < 0,001 | |
| entorno B | -4,22 ± 0,57 | -5,35; -3,10 | -7,35 | <0,001 | |
| ambiente C | -9,69 ± 0,58 | -10,83; -8,55 | -16,61 | < 0,001 | |
| ambiente D | -12,27 ± 0,59 | -13,43; -11,12 | -20,81 | < 0,001 | |
| entorno E | -15,32 ± 0,63 | -16,56; -14,08 | -24,18 | < 0,001 | |
| Predictores Continuos | |||||
| edad (días) | 387 | 0,079 ± 0,001 | 0,076; 0,081 | 62,69 | < 0,001 |
| NDRE (F1) | 25,73 | 0,464 ± 0,053 | 0,360; 0,568 | 8,74 | < 0,001 |
| IRECI (F2) | 94,66 | 0,292 ± 0,004 | 0,286; 0,299 | 82,67 | < 0,001 |
| déficit de presión de vapor (F2) | 1,32 | -11,40 ± 2,75 | -16,79; -6,00 | -4,14 | < 0,001 |
| precipitación (F2) | 527,79 | 0,007 ± 0,001 | 0,006; 0,008 | 10,08 | < 0,001 |
| radiación solar (F1) | 1.899,53 | -0,015 ± 0,001 | -0,015; -0,014 | -35,35 | < 0,001 |
Fuente: Datos originales de la investigación. Nota: EP = Error Estándar; IC = Intervalo de Confianza; t = Estadística t; Variables continuas centradas en la media general.
La sucesión de los ciclos evidenció un descenso no lineal en la productividad, con el segundo corte resultando en una reducción estimada de 8,99 ± 0,29 t ha⁻¹, y el séptimo corte en una penalización de 28,94 ± 0,65 t ha⁻¹. La transición del ambiente A al E (restrictivo) restó 15,32 ± 0,63 t ha⁻¹ a la productividad media basal. En cuanto a la edad del cultivo, el modelo estimó una ganancia de 0,079 ± 0,001 t ha⁻¹ por cada día adicional, indicando que un incremento de 1 t ha⁻¹ demanda aproximadamente 13 días en el ciclo.
En el ámbito biofísico, el NDRE (F1) presentó un coeficiente de 0,464 ± 0,053 t ha⁻¹, validando su relación con la eficiencia inicial de absorción de nitrógeno (Shendryk et al., 2020) y la velocidad de cierre del dosel (Dong et al., 2019). El IRECI (F2) corroboró la predicción del crecimiento vegetativo con un coeficiente de 0,292 ± 0,004 t ha⁻¹, ratificando la capacidad de la banda Red-Edge para cuantificar la biomasa con resistencia a la saturación óptica en doseles densos (Dong et al., 2019). Para este predictor, la ganancia unitaria de productividad está asociada a un aumento medio de 0,023 en el índice durante la ventana F2.
Entre las variables agroclimatológicas, el déficit de presión de vapor (F2) destacó como factor restrictivo, con un coeficiente de -11,40 ± 2,75 t ha⁻¹, indicando que el estrés higrométrico restringe la asimilación de carbono (Inman-Bamber y Smith, 2005). En oposición, la precipitación (F2) presentó un coeficiente de 0,007 ± 0,001 t ha⁻¹, sugiriendo que un volumen suplementario de 143 mm (28,6 mm mes⁻¹) es necesario para el mismo incremento productivo. La radiación solar en F1 presentó un coeficiente negativo de -0,015 ± 0,001 t ha⁻¹, confirmando su función como proxy para el estrés termohídrico de días excesivamente limpios, que aceleran la deshidratación (Inman-Bamber y Smith, 2005).
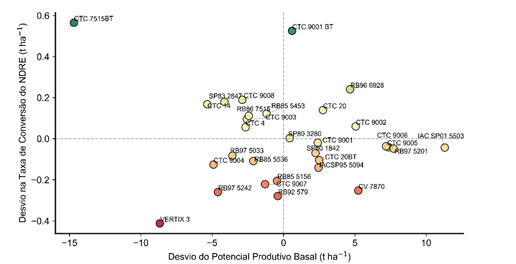
Las inclinaciones aleatorias evidenciaron la heterogeneidad varietal. La variedad IAC SP01 5503 presentó la mayor desviación positiva de intercepto (11,31 t ha⁻¹), elevando su nivel de referencia a 109,37 t ha⁻¹ bajo condiciones de referencia. En contrapartida, la CTC 7515BT registró una desviación negativa severa (-14,69 t ha⁻¹), indicando un menor techo productivo basal. La Figura 5 ilustra la relación entre el potencial productivo basal y la respuesta varietal al NDRE en la F1.
Figura 5. Relación entre el potencial productivo basal y la respuesta varietal al NDRE en la F1.
Fuente: Datos originales de la investigación.
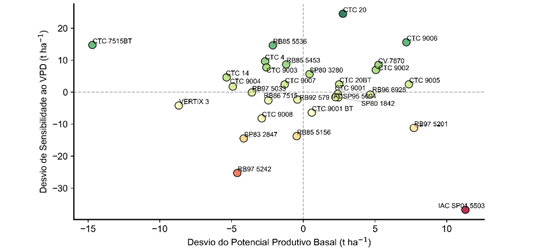
Durante la ventana de alto crecimiento vegetativo (F2), la evaluación del déficit de presión de vapor mapeó el perfil de vulnerabilidad al estrés higrométrico. La IAC SP01 5503 demostró una sensibilidad extrema, con un BLUP de -36,74 t ha⁻¹, lo que resultó en una penalización de 48,14 t ha⁻¹ por cada 1 kPa de incremento en este déficit (Figura 6), lo que sugiere su inadecuación para áreas con deficiencia hídrica. En contraste, genotipos como la CTC 20 exhibieron alta rusticidad fisiológica, con una pendiente aleatoria fuertemente positiva (24,49 t ha⁻¹), anulando la penalización global impuesta por el estrés termohidrico y justificando su asignación estratégica en ambientes más restrictivos.
Figura 6. Relación entre el potencial productivo basal y la sensibilidad varietal a la déficit de presión de vapor en la F2.
Fuente: Datos originales de la investigación.
En resumen, el modelado multinivel con clasificación cruzada demostró ser un enfoque robusto para la predicción de la productividad de la caña de azúcar, permitiendo la descomposición de la varianza en componentes espaciales, genéticos y temporales. La integración de predictores biofísicos y agrometeorológicos capturó la dinámica fenológica del cultivo, y el modelo final alcanzó una exactitud predictiva comparable a algoritmos de Machine Learning, manteniendo la interpretabilidad de los coeficientes agronómicos. Los resultados indicaron la influencia significativa del número de corte, el ambiente de producción, la edad del cultivo y variables biofísicas y agrometeorológicas en la productividad, además de evidenciar la heterogeneidad varietal en la respuesta a factores como el NDRE y el déficit de presión de vapor.
4. Conclusión
El modelado multinivel con clasificación cruzada demostró ser un enfoque analítico robusto y metodológicamente adecuado para la predicción de la productividad de la caña de azúcar en la región sureste de Mato Grosso do Sul, abarcando las cosechas de 2019/2020 a 2023/2024. Se verificó que el enfoque particionó adecuadamente la varianza espacial, genética y temporal, cuantificando con éxito la interacción genotipo-ambiente. El ajuste final con inclinaciones aleatorias (M7) explicó el 81,1% de la varianza total y alcanzó una Raíz del Error Cuadrático Medio de 10,24 t ha⁻¹. La diferencia del 9,8% entre el Pseudo-R² marginal y el condicional evidenció la relevante ganancia explicativa generada por la clasificación cruzada, equiparando su desempeño predictivo a la exactitud reportada por algoritmos de Machine Learning. Este enfoque, sin embargo, mantuvo el rigor paramétrico y la interpretabilidad de los predictores agronómicos, como el número de corte, ambiente de producción, edad del cultivo, índices biofísicos (NDRE e IRECI) y variables agrometeorológicas (déficit de presión de vapor, precipitación y radiación solar). La principal contribución reside en la oferta de una herramienta analítica transparente y robusta para la estimación de productividad y la planificación del sector sucroenergético, permitiendo la comprensión detallada de la influencia de factores contextuales y la heterogeneidad varietal.
A pesar de la robustez probada, el estudio presenta limitaciones inherentes al alcance de los modelos empíricos. La extrapolación de las inferencias se limita a la cartera varietal y a las condiciones edafoclimáticas específicas del área de estudio. Se observaron desviaciones en la distribución de los residuos en las colas extremas, lo que indica la ocurrencia de anomalías fenológicas, variables agrometeorológicas omitidas o interacciones complejas que la estructura lineal paramétrica no pudo absorber en su totalidad. Para desarrollos futuros, se sugiere la expansión del dominio muestral, la incorporación de estructuras de autocorrelación espacial para capturar la dependencia entre parcelas cercanas y la transición a Modelos Aditivos Generalizados Mixtos (GAMM). Estas iniciativas permitirán refinar el mapeo de extremos climáticos y consolidar la técnica como una valiosa herramienta de inteligencia analítica en el sector sucroenergético.
Referencias Bibliográficas
Associação de Produtores de Bioenergia de Mato Grosso do Sul [BIOSUL]. 2024. Mapa da Bioenergia de Mato Grosso do Sul. Disponível em: . Acesso em: 20 mar. 2025.
Avilez, A.Μ.Α.; Hernandez, F.B.T.; Bispo, R.C.; Giovanelli, L.B. 2018. Necessidade hídrica da cana-de-açúcar no Noroeste Paulista. Irriga 1(1): 171-188.
Empresa de Pesquisa Energética [EPE]. 2024a. Balanço Energético Nacional 2024: Ano base 2023. EPE, Rio de Janeiro, RJ, Brasil.
Empresa de Pesquisa Energética [EPE]. 2024b. Nota técnica: Análise de conjuntura dos biocombustíveis – ano 2023. EPE, Rio de Janeiro, RJ, Brasil.
Manzatto, C.V.; Assad, E.D.; Bacca, J.F.M.; Zaroni, M.J.; Pereira, S.E.M. 2009. Zoneamento agroecológico da cana-de-açúcar: expandir a produção, preservar a vida, garantir o futuro.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haga clic aquí y acceda a la plataforma MBX Academy