
15 de septiembre de 2026
Métodos No Supervisados Aplicados a Levaduras Industriales Productoras de Etanol de Primera y Segunda Generaciones
Luciana Souto Mofatto; Cleverson Henrique de Freitas
DOI: 10.22167/2675-6528-202602264
Artículo derivado de Trabajo de Conclusión de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
La comprensión de los mecanismos moleculares en la producción de etanol es crucial para la optimización industrial, dada su consolidación como alternativa sostenible. El estudio evaluó los perfiles transcriptómicos de levaduras industriales Saccharomyces cerevisiae “Pedra-2” en la producción de etanol de primera (1G) y segunda generación (2G), en diferentes tiempos de fermentación, utilizando métodos no supervisados. Se emplearon datos públicos de RNA-seq, sometidos a control de calidad, preprocesamiento, alineamiento genómico y cuantificación de transcritos en TPM. Los análisis incluyeron correlación de Pearson, Análisis de Componentes Principales (PCA), Análisis Factorial de Datos Mixtos (FAMD) y clusterización jerárquica. Los resultados revelaron una clara separación entre los perfiles de expresión génica de 1G y 2G, siendo el tipo de fermentación el principal factor de variabilidad. Las muestras 1G exhibieron mayor organización temporal y estabilidad, mientras que las 2G mostraron mayor heterogeneidad y complejidad metabólica. Se identificaron diferencias en las vías metabólicas asociadas al flujo de carbono, con predominancia de la glicólisis en 1G y mayor participación de las vías de la pentosa fosfato y del ciclo del ácido tricarboxílico en 2G. Se concluyó que los métodos no supervisados fueron eficaces en la identificación de patrones biológicos relevantes, contribuyendo a la comprensión de las diferencias metabólicas entre los procesos y ofreciendo soporte para estrategias de optimización en la producción de etanol.
Palabras clave: Aprendizaje automático; Bioinformática; Expresión génica; Fermentación; Transcriptoma.
1. Introducción
La creciente demanda de fuentes de energía renovables ha impulsado la producción de etanol como alternativa sostenible a los combustibles fósiles (Goldemberg, 2008). Brasil se destaca como uno de los mayores productores mundiales, utilizando la caña de azúcar como principal materia prima debido a su alto rendimiento y viabilidad económica (Basso et al., 2011; Renewable Fuels Association, 2024; Wheals et al., 1999). Programas gubernamentales e inversiones en investigación y desarrollo, como el Proálcool, el programa BIOEN de la FAPESP y el Laboratorio Nacional de Biorrenovables (LNBR), han sido fundamentales para el avance y la consolidación del sector (Leite et al., 2009; Roman, 2010).
La producción de etanol se produce por fermentación de azúcares, proceso en el cual las levaduras convierten la glucosa en etanol y dióxido de carbono (Basso et al., 2011). La especie Saccharomyces cerevisiae se emplea ampliamente en fermentaciones industriales debido a características como alta viabilidad celular, capacidad de conservación genética, tolerancia a altas concentraciones de etanol y carbohidratos, y resistencia a múltiples ciclos de fermentación y variaciones de temperatura (Dequin, 2001). Cepas industriales brasileñas, como “Pedra-2” y “CAT-1”, son ejemplos de cepas que exhiben estas cualidades (Argueso et al., 2009; Basso et al., 2008; Della-Bianca et al., 2013).
El etanol se clasifica en generaciones, siendo el de primera generación (1G) obtenido de la fermentación de la sacarosa presente en el jugo de caña. Este es un proceso consolidado, de alta productividad y que no requiere pretratamiento de la materia prima. Sin embargo, la producción de etanol 1G enfrenta desafíos como la estacionalidad de la caña de azúcar y la competencia con la producción de azúcar. El mejoramiento genético de la caña y la optimización de los procesos industriales son estrategias adoptadas para mitigar estas limitaciones (Goldemberg, 2008; Leite et al., 2009).
En contraste, el etanol de segunda generación (2G) surge como una alternativa prometedora, utilizando residuos lignocelulósicos, como bagazo y paja de caña, para aumentar el aprovechamiento de la biomasa y la sostenibilidad del sector (Lynd et al., 2005). Este proceso involucra la conversión de celulosa y hemicelulosa en azúcares fermentables por hidrólisis enzimática o ácida. Sin embargo, la Saccharomyces cerevisiae no metaboliza naturalmente pentosas, azúcares abundantes en la hemicelulosa, lo que limita la eficiencia del proceso fermentativo 2G (Matsushika et al., 2009).
Para superar las limitaciones del etanol de segunda generación (2G), la ingeniería metabólica se ha utilizado para modificar genéticamente levaduras, permitiendo el consumo de hexosas y pentosas (xilosa, arabinosa) y, por lo tanto, posibilitando la producción de etanol 2G (Matsushika et al., 2009). Las estrategias incluyen la introducción de vías metabólicas reductivas/oxidativas y de isomerización, así como la combinación de genes de microorganismos como Escherichia coli y Pichia stipitis (Karhumaa et al., 2007). La sobreexpresión de transportadores de azúcar también mejora la captación y el metabolismo de pentosas, aumentando la productividad (Basso et al., 2011). Además, la ingeniería evolutiva mejora características como la tolerancia al etanol, a altas temperaturas y a compuestos tóxicos, seleccionando cepas más robustas para reducir costos y aumentar la eficiencia (Della-Bianca et al., 2013; Basso et al., 2011; Leite et al., 2009).
La bioinformática desempeña un papel crucial en la ingeniería de levaduras, ayudando en el análisis genómico y la identificación de genes relacionados con la fermentación. Las técnicas de secuenciación de ADN y ARN, junto con la modelización computacional, permiten una comprensión profunda de la fisiología microbiana y optimizan las modificaciones genéticas (Abreu-Cavalheiro y Monteiro, 2014; Buschke et al., 2013). La secuenciación de ARN es particularmente importante para detectar cambios en la expresión génica bajo diferentes condiciones. Estudios anteriores ya han empleado esta técnica para evaluar perfiles génicos de levaduras industriales durante la producción de bioetanol 1G y 2G (Carvalho-Netto et al., 2015; Carvalho et al., 2021).
Junto con la bioinformática, el aprendizaje automático se ha aplicado ampliamente en la predicción estructural de proteínas, el análisis de sus interacciones y la evaluación de la expresión génica. Como parte de la inteligencia artificial, el aprendizaje automático utiliza modelos estadísticos y algoritmos que “aprenden” a partir de datos (Yousef y Allmer, 2023). En el contexto de la expresión génica, se implementan metodologías de aprendizaje automático para predecir variaciones en los niveles de expresión, como la aplicación de redes bayesianas basadas en el algoritmo de agrupamiento k-means para identificar patrones (Al Taweraqi y King, 2022).
A pesar de los avances significativos, persisten desafíos como la complejidad de los procesos de hidrólisis y fermentación, los altos costos de las enzimas y la necesidad de una mayor eficiencia en la conversión de pentosas (Della-Bianca et al., 2013). La integración de la ingeniería metabólica y evolutiva, junto con la bioinformática y el aprendizaje automático, representa un enfoque prometedor para superar estas limitaciones (Karhumaa et al., 2007). En este contexto, el presente trabajo tiene como objetivo realizar análisis, a partir de métodos no supervisados, para evaluar los diferentes perfiles transcripcionales y variaciones en la expresión génica, a partir de datos ya publicados (Carvalho-Netto et al., 2015; Carvalho et al., 2021), de levaduras Saccharomyces cerevisiae “Pedra-2” en condiciones de fermentación de etanol 1G y 2G, a escala industrial.
2. Material y Métodos
Recopilación de datos
Los datos de transcriptoma se obtuvieron en formato FASTQ del repositorio “Sequence Read Archives Database” [SRA] (2009) (https://www.ncbi.nlm.nih.gov/sra/). Estos datos, provenientes de secuenciación de Nueva Generación de lecturas cortas (del inglés “short reads”) generados por equipos “Illumina” (Cock et al., 2010), contienen secuencias de nucleótidos y notas de calidad.
Para las levaduras industriales Saccharomyces cerevisiae [PE-2] de primera generación [1G], los datos fueron recolectados en 2009, directamente de los tanques de fermentación de una destilería en Maracaí, São Paulo, Brasil, conforme el artículo de Carvalho-Netto et al. (2015) (“BioProject number” “PRJNA172193”). Las muestras de “Typical fermentation” fueron obtenidas en los tiempos de 1h, 4h, 7h, 10h, 12h y 15 horas de fermentación.
Para las levaduras que fermentan etanol 2G, los datos se obtuvieron del artículo de Carvalho et al. (2021) (“BioProject number” “PRJNA667443”), identificados como “Fermentación industrial”. Las muestras se recolectaron en diciembre de 2016, directamente del tanque de fermentación de una planta en São Miguel dos Campos, Alagoas, Brasil, en los tiempos de 7h, 12h, 16h y 24 horas de fermentación. La producción de etanol [2G] utilizó un hidrolizado lignocelulósico, obtenido de pretratamiento hidrotérmico sobre paja de caña de azúcar. La Tabla 1 detalla la identificación, tipo de fermentación, réplica y descripción de los experimentos.
Tabla 1. Descripción de las variables de transcriptoma referentes a las levaduras industriales sometidas a diferentes tiempos de fermentación, para la producción de etanol de primera [1G] y segunda [2G] generaciones
| ID | Tipo de fermentación (1G / 2G) | Respuesta | Descripción |
|---|---|---|---|
| TF1_1G_1h | 1G | Exclusiva | Levaduras industriales (fermentación tradicional [TF]), recolectadas en el período de 1 hora. |
| TF2_1G_4h | 1G | Exclusiva | Levaduras industriales (fermentación tradicional [TF]), recolectadas en tina en el período de 4 horas |
| TF3_1G_7h | 1G | Exclusiva | Levaduras industriales (fermentación tradicional [TF]), recolectadas en el período de 7 horas |
| TF4_1G_10h | 1G | Exclusiva | Levaduras industriales (fermentación tradicional [TF]), recolectadas en el período de 10 horas |
| TF5_1G_12h | 1G | Exclusiva | Levaduras industriales (fermentación tradicional [TF]), recolectadas en el período de 12 horas |
| TF6_1G_15h | 1G | Exclusiva | Levaduras industriales (fermentación tradicional [TF]), recolectadas en el período de 15 horas |
| F1_2G_7h | 2G | 1 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el tonel en el período de 7 horas |
| F5_2G_7h | 2G | 2 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 7 horas |
| F6_2G_7h | 2G | 3 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 7 horas |
| F1_2G_12h | 2G | 1 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 12 horas |
| F5_2G_12h | 2G | 2 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 12 horas |
| F6_2G_12h | 2G | 3 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 12 horas |
| F1_2G_16h | 2G | 1 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 16 horas |
| F5_2G_16h | 2G | 2 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 16 horas |
| F6_2G_16h | 2G | 3 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 16 horas |
| F1_2G_24h | 2G | 1 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 24 horas |
| F5_2G_24h | 2G | 2 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 24 horas |
| F6_2G_24h | 2G | 3 | Levaduras industriales (fermentación de bagazo de caña [F]), recolectadas en el período de 24 horas |
Fuente: Resultados originales de la investigación
Tratamiento de los datos
Los datos se sometieron a un análisis de calidad con el software “FastQC” v0.11.4 (Andrews, 2010). Las secuencias de adaptadores de secuenciación “Illumina” se eliminaron utilizando “Trimmomatic” v0.39 (Bolger et al., 2014).
Para la cuantificación de los transcritos, los datos fueron alineados contra las secuencias de genes de la levadura de laboratorio Saccharomyces cerevisiae S288c del “Saccharomyces Genome Database” [SGD] (2007) (https://www.yeastgenome.org/), y 23 genes específicos de “Pedra-2” [PE-2] (Argueso et al., 2009), totalizando 5.938 genes. La cuantificación se realizó mediante el software “Kallisto” v0.44 (Bray et al., 2016), con los parámetros “-k 31 -b 100”. Para “reads single-end” (levaduras industriales de etanol [1G]), se utilizaron los parámetros “-I 150 -s 0.01”. Se generó una tabla final con todos los datos en Transcritos por millón [TPM] para los análisis no supervisados.
La normalización [TPM] se calcula dividiendo el recuento de “reads” por la longitud del “gen” (en “kilobases”) para obtener “reads” por “kilobase” [RPK], y luego dividiendo todos los valores de [RPK] por 1.000.000. Esta normalización considera la longitud del “gen” y la profundidad de la secuenciación, resultando en la misma suma de [TPM] para cada muestra (Zhao et al., 2021).
Análisis de datos no supervisados
Para comparar los datos de expresión entre levaduras industriales de fermentación [1G] y [2G], se utilizaron metodologías de datos no supervisados para identificar organización, patrones, similitudes y diferencias. Los métodos incluyeron Correlación de Pearson, Análisis de Componentes Principales [PCA], Análisis Factorial de Datos Mixtos [FAMD] (Pagès, 2004) y clusterización jerárquica aglomerativa.
El análisis de correlación de Pearson, con matriz de correlación y mapa de calor, fue generado por scripts en Python, utilizando los paquetes “pandas”, “numpy”, “pingouin” y “plotly.graph_objects”.
Para el Análisis de Componentes Principales [PCA], se utilizaron scripts en Python con los paquetes “pandas”, “numpy”, “factor_analyzer” y “matplotlib”. Se realizó la Prueba de Esfericidad de Bartlett y la cantidad de componentes principales se evaluó mediante el Criterio de Kaiser. La Tabla 2 presenta los componentes principales, autovalores y varianzas.
Tabla 2. Componentes principales, autovalores, varianza y varianza acumulada obtenidos a partir de los datos de expresión de los transcriptomas de levaduras industriales en diferentes tiempos de fermentación, para la producción de etanol de primera [1G] y segunda [2G] generaciones
| Componentes Principales | Valor propio | Varianza Explicada | Varianza Acumulada |
|---|---|---|---|
| Componente número 1 | 11,9689 | 66,49% | 66,49% |
| Elemento 2 | 2,8776 | 15,99% | 82,48% |
| Sección 3 | 1,3445 | 7,47% | 89,95% |
| Componente número 4 | 1,0451 | 5,81% | 95,76% |
Fuente: Resultados originales de la investigación
El Análisis Factorial de Datos Mixtos [FAMD] se realizó con scripts en el lenguaje R, utilizando las bibliotecas “ggplot2″, “dplyr”, “FactoMineR”, “factoextra”, “gridExtra” y “ggrepel”.
Para la clusterización jerárquica aglomerativa, se emplearon scripts en Python con los paquetes “pandas”, “numpy”, “matplotlib”, “scipy.stats” y “scipy”. Se utilizó el método de encadenamiento “complete linkage”, aplicando la distancia euclidiana a todos los datos de transcriptoma y a genes específicos de vías del flujo de carbono que afectan el metabolismo de la levadura. Las vías metabólicas analizadas fueron: vía glucolítica [GP], ruta del glicerol [GR], vía de la pentosa fosfato [PPP] y el ciclo del ácido tricarboxílico [TCA]. La Tabla 3 enumera los genes relacionados con estas vías.
Tabla 3. Genes relacionados con las vías metabólicas del flujo de carbono en las levaduras industriales
| Vía Metabólica | Genes | ID de Genes | Descripción del Gen |
|---|---|---|---|
| Vía Glucolítica [GP] | GLK1 | YCL040W | Glicoquinasa |
| Vía Glucolítica [GP] | HXK1 | YFR053C | Isoenzima 1 de la hexoquinasa |
| Vía Glucolítica [GP] | PGI1 | YBR196C | Enzima glicolítica fosfoglucosa isomerasa |
| Vía Glucolítica [GP] | FBP1 | YLR377C | Fructosa-1,6-bisfosfatasa |
| Vía Glucolítica [GP] | PFK1 | YGR240C | Subunidad alfa de la fosfofructoquinasa heterooctamérica |
| Vía Glucolítica [GP] | FBA1 | YKL060C | Fructosa 1,6-bisfosfato aldolasa |
| Vía Glucolítica [GP] | TPI1 | YDR050C | Triosa fosfato isomerasa |
| Vía Glucolítica [GP] | TDH1 | YJL052W | Gliceraldehído-3-fosfato deshidrogenasa (GAPDH), isoenzima 1 |
| Vía Glucolítica [GP] | PGK1 | YCR012W | 3-fosfoglicerato quinasa |
| Vía Glucolítica [GP] | PGM1 | YKL127W | Fosfoglucomutasa, isoforma menor |
| Vía Glucolítica [GP] | ENO1 | YGR254W | Enolasa I |
| Vía Glucolítica [GP] | PYK2 | YOR347C | Piruvato quinasa |
| Vía Glucolítica [GP] | PDC1 | YLR044C | Piruvato descarboxilasa |
| Vía Glucolítica [GP] | ALD4 | YOR374W | Aldehído deshidrogenasa mitocondrial |
| Vía Glucolítica [GP] | ALD5 | YER073W | Aldehído deshidrogenasa mitocondrial |
| Vía Glucolítica [GP] | ADH1 | YOL086C | Alcohol deshidrogenasa |
| Ruta del Glicerol [GR] | GPD1 | YDL022W | Glicerol-3-fosfato deshidrogenasa dependiente de NAD |
| Ruta del Glicerol [GR] | GPD2 | YOL059W | Glicerol-3-fosfato deshidrogenasa dependiente de NAD |
| Ruta del Glicerol [GR] | GPP1 | YIL053W | Glicerol-1-fosfatasa |
| Ruta del Glicerol [GR] | GUT1 | YHL032C | Glicerol quinasa |
| Vía de las Pentosas Fosfato [PPP] | ZWF1 | YNL241C | Glucosa-6-fosfato deshidrogenasa (G6PD) |
| Vía de las Pentosas Fosfato [PPP] | GND1 | YHR183W | 6-fosfogluconato deshidrogenasa (descarboxilante) |
| Vía de las Pentosas Fosfato [PPP] | GND2 | YGR256W | 6-fosfogluconato deshidrogenasa (descarboxilante) |
| Vía de las Pentosas Fosfato [PPP] | RPE1 | YJL121C | D-ribulosa-5-fosfato 3-epimerasa |
| Vía de las Pentosas Fosfato [PPP] | RKI1 | YOR095C | Ribosa-5-fosfato cetoisomerasa |
| Vía de las Pentosas Fosfato [PPP] | TKL1 | YPR074C | Transcetolasa |
| Vía de las Pentosas Fosfato [PPP] | TAL1 | YLR354C | Transaldolasa |
| Ciclo del ácido tricarboxílico [TCA] | PDA1 | YER178W | Subunidad alfa E1 de la piruvato deshidrogenasa (PDH) |
| Ciclo del ácido tricarboxílico [TCA] | PDB1 | YBR221C | Subunidad beta E1 de la piruvato deshidrogenasa (PDH) |
| Ciclo del ácido tricarboxílico [TCA] | LAT1 | YNL071W | Componente de dihidrolipoamida acetiltransferasa (E2) del PDC |
| Ciclo del ácido tricarboxílico [TCA] | PYC1 | YGL062W | Isoforma de piruvato carboxilasa |
| Ciclo del ácido tricarboxílico [TCA] | CIT1 | YNR001C | Citrato sintasa mitocondrial |
| Ciclo del ácido tricarboxílico [TCA] | ADH1 | YOL086C | Alcohol deshidrogenasa |
| Ciclo del ácido tricarboxílico [TCA] | ADP1 | YCR011C | Permeasa dependiente de ATP putativa de la familia de transportadores ABC. |
| Ciclo del ácido tricarboxílico [TCA] | KGD1 | YIL125W | Subunidad de la alfa-cetoglutarato deshidrogenasa mitocondrial compleja |
| Ciclo del ácido tricarboxílico [TCA] | KGD2 | YDR148C | Di-hidrolipoil transsuccinilasa |
| Ciclo del ácido tricarboxílico [TCA] | LSC1 | YOR142W | Subunidad alfa de la succinil-CoA ligasa |
| Ciclo del ácido tricarboxílico [TCA] | LSC2 | YGR244C | Subunidad beta de la succinil-CoA ligasa |
| Ciclo del ácido tricarboxílico [TCA] | SDH1 | YKL148C | Subunidad flavoproteína de la succinato deshidrogenasa |
| Ciclo del ácido tricarboxílico [TCA] | FUM1 | YPL262W | Fumarasas |
| Ciclo del ácido tricarboxílico [TCA] | MDH1 | YKL085W | Malato deshidrogenasa mitocondrial |
| Ciclo del ácido tricarboxílico [TCA] | ACO1 | YLR304C | Aconitasa |
Fuente: Traducido de Saccharomyces Genome Database [SGD] (2007)
3. Resultados y Discusión
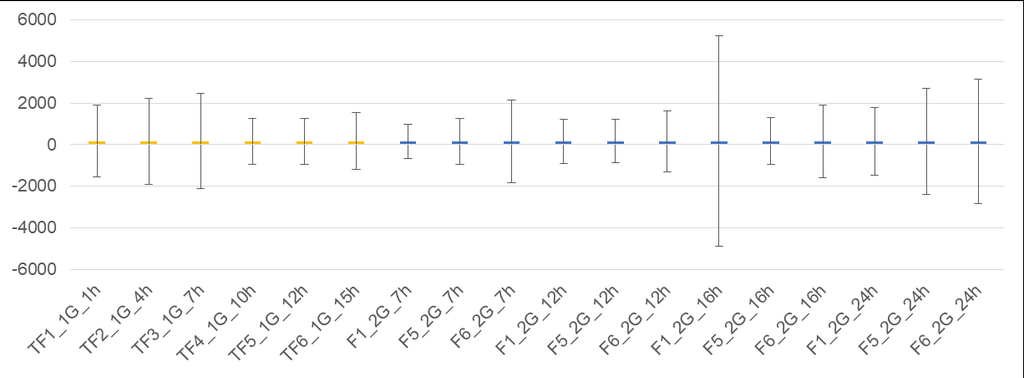
El análisis estadístico descriptivo de los datos reveló que las medias de expresión génica para todas las muestras de levadura de primera generación (1G) y segunda generación (2G) estuvieron cerca de 168,41. Las desviaciones estándar para las muestras 1G variaron entre 1.108,82 y 2.297,97, mientras que para las muestras 2G, la variación fue de 829,04 a 5.064,89. Los valores del cuartil 1 (25%) para 1G estuvieron entre 6,37 y 13,4, y para 2G, entre 3,69 y 8,03. Los valores máximos para 1G variaron de 43.948 a 131.443, y para 2G, de 22.028,60 a 291.908. La uniformidad de las medias en todas las muestras indica que la normalización de los datos por Transcritos por millón (TPM) fue adecuada, validando la comparabilidad de los datos de 1G (Carvalho-Netto et al., 2015) y 2G (Carvalho et al., 2021) (Zhao et al., 2021).
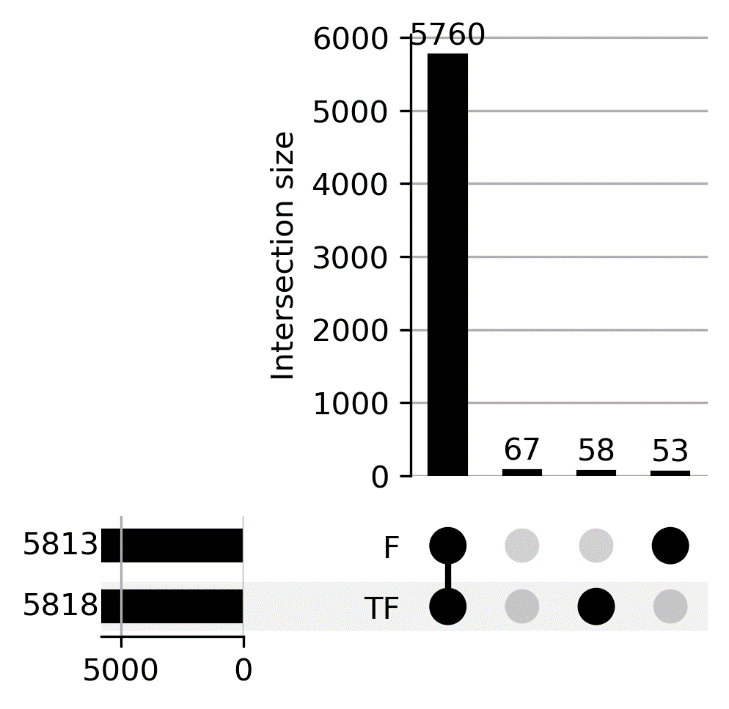
Para identificar los genes expresados, se generó un gráfico upset (Diagrama de Venn) (Figura 1). De los 5.938 genes encontrados, 5.760 fueron comunes a los dos grupos de fermentación (1G y 2G), 58 fueron exclusivos del grupo 1G, 53 exclusivos del grupo 2G y 67 estuvieron ausentes en ambos. La presencia de un gran número de genes comunes sugiere que la maquinaria básica de supervivencia y fermentación de la Saccharomyces cerevisiae se mantiene, a pesar de las diferencias en los sustratos (caldo de caña para 1G e hidrolizado lignocelulósico para 2G) y de las dinámicas temporales y de estrés metabólico.
Figura 1. Diagrama de Venn (“upset”) que contiene la cantidad de genes expresados en el transcriptoma de levaduras industriales en diferentes tiempos de fermentación, para la producción de etanol de primera [1G] (muestras TF) y segunda [2G] generaciones (muestras F)
Fuente: Resultados originales de la investigación
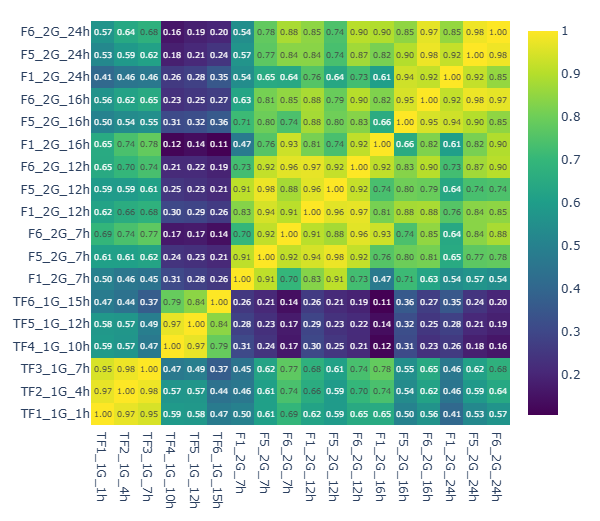
El análisis de correlación de Pearson (Figura 2) reveló agrupaciones distintas en los perfiles génicos. Las muestras de levadura 1G formaron dos grupos: uno con 1h, 4h y 7h de fermentación (coeficiente de correlación r > 0,95) y otro con 10h, 12h y 15h (r > 0,79). En las muestras 2G, las réplicas de 16h y 24h presentaron una correlación más baja con la muestra F1_2G_7h (r < 0,70 y 0,54, respectivamente). La muestra F1_2G_24h también mostró correlaciones más bajas con las muestras de 7h (r < 0,65) y 16h (r < 0,76). Todas las correlaciones fueron estadísticamente significativas (p < 0,05).
Figura 2. Mapa de calor referente a los métodos de correlación de Pearson sobre todos los genes obtenidos en los datos de transcriptoma de las fermentaciones [1G] (muestras [TF]) y [2G] (muestras [F]), en diferentes períodos de recolección Todas las correlaciones fueron significantes (valor p < 0,05)
Fuente: Resultados originales de la investigación
Se aplicó el Análisis de Componentes Principales (PCA) para reducir la dimensionalidad de los datos y analizar la varianza. La Prueba de Esfericidad de Bartlett (chi-cuadrado = 312.811,59, p < 0,05) indicó la adecuación de la matriz de correlación. Se extrajeron cuatro componentes principales (CPs) con autovalores mayores que 1, explicando el 95,76% de la varianza total de los datos. El Componente 1 explicó el 66,49% de la varianza, seguido por el Componente 2 con el 15,99%, el Componente 3 con el 7,47% y el Componente 4 con el 5,81%.
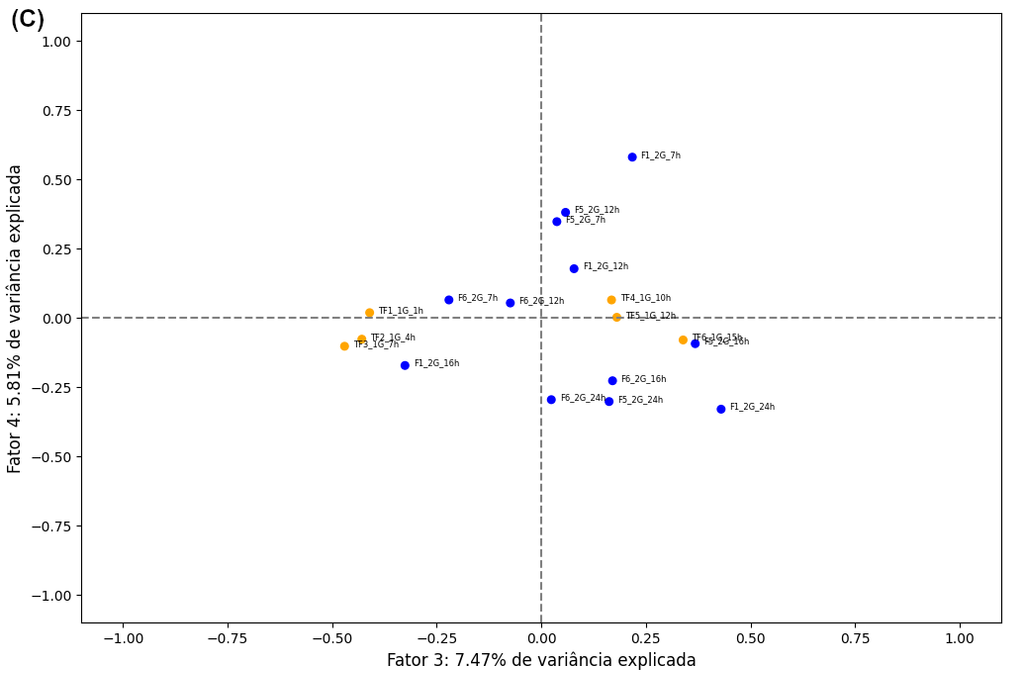
Los gráficos de cargas factoriales (Figura 3) del PCA mostraron agrupaciones distintas, con una clara separación entre las muestras de levaduras 1G y 2G, especialmente en la Figura 3A, donde el PC1 explica la mayor parte de la varianza (66,49%). Este hallazgo indica que el tipo de fermentación es el principal factor de diferenciación transcripcional entre las muestras.
Figura 3. “Loading plots” obtenidos a partir de las cargas factoriales de los datos de transcriptomas de levaduras industriales sometidas a fermentaciones de etanol de primera [1G] y segunda [2G] generaciones. (A) Factor 1 (PC1) x Factor 2 (PC2); (B) Factor 2 (PC2) x Factor 3 (PC3); y (C) Factor 3 (PC3) x Factor 4 (PC4)
Fuente: Resultados originales de la investigación Nota: Puntos en naranja: 1G; puntos en azul: 2G
Clustering jerárquico por “complete linkage”
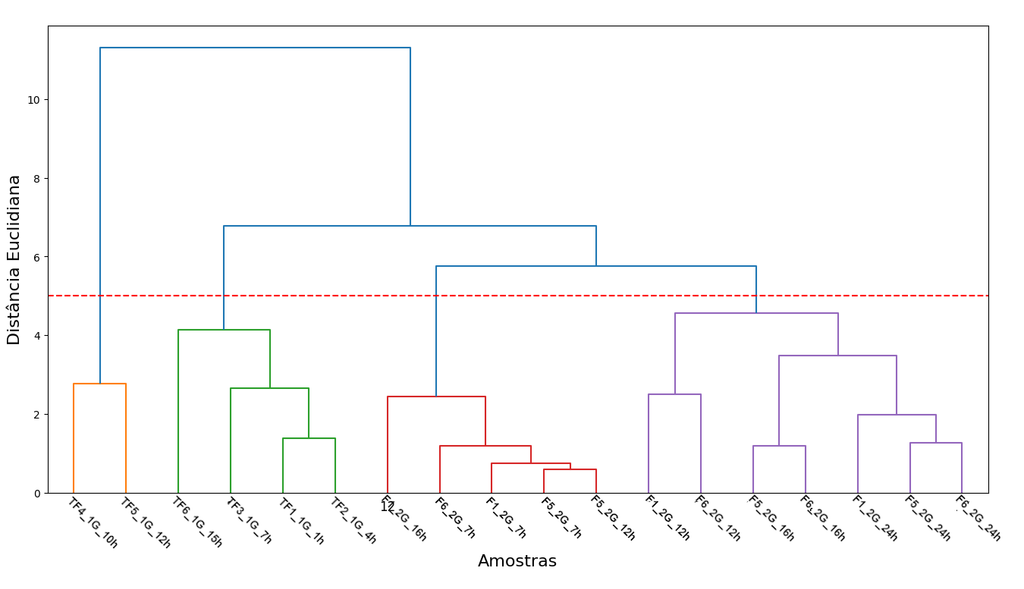
La clusterización jerárquica aglomerativa, utilizando el método “complete linkage” y distancia euclidiana, agrupó las muestras de levaduras industriales conforme al tipo de producción de etanol (Figura 4), resultando en cinco grupos distintos con un corte en la distancia euclidiana de 60. Las muestras 1G fueron agrupadas en función del tiempo de fermentación (tiempos finales a la izquierda e iniciales a la derecha del dendrograma), mientras que las muestras 2G no siguieron un patrón temporal claro, presentando mayor heterogeneidad transcriptómica.
Figura 4. Dendrograma generado a partir de la clusterización jerárquica por “Complete Linkage” de datos de transcriptoma de todos los 5.938 genes de levaduras industriales sometidas a diferentes tiempos de fermentaciones para producción de etanol de primera [1G] (muestras [TF]) y segunda [2G] (muestras [F])
Fuente: Resultados originales de la investigación
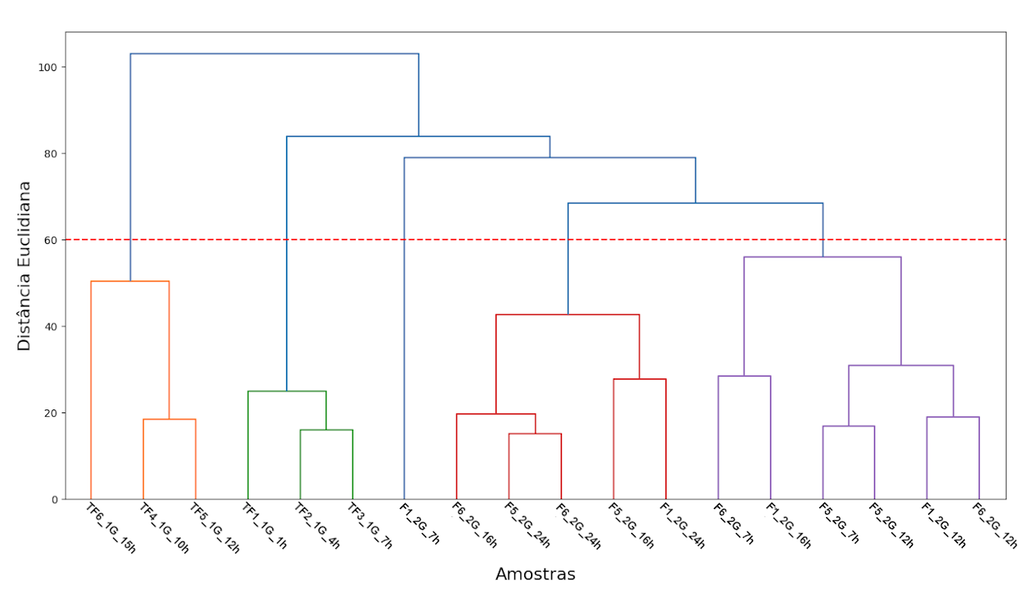
El análisis de los genes específicos de la vía glucolítica (GP) (Tabla 5) también separó las levaduras por tipo de etanol (Figura 5), con dos grupos principales definidos por un corte en la distancia euclidiana de 6. Las muestras 1G se agruparon por tiempo de fermentación (iniciales: 1h, 4h, 7h, 10h; finales: 12h, 15h). Las muestras 2G, por su parte, se distribuyeron en tres subgrupos conforme el tiempo de fermentación, siendo uno exclusivo para 7h y los demás agrupando 12h, 16h y 24h.
Tabla 5. Genes relacionados con las vías metabólicas del flujo de carbono en levaduras industriales
Fuente: Traducido de Saccharomyces Genome Database [SGD] (2007)
Figura 5. Dendrograma generado a partir de la clusterización jerárquica por “Complete Linkage” de datos de transcriptomas de los genes específicos de la Vía Glicolítica [GP] de levaduras industriales sometidas a diferentes tiempos de fermentaciones para producción de etanol de primera [1G] (muestras TF) y segunda [2G] (muestras F)
Fuente: Resultados originales de la investigación
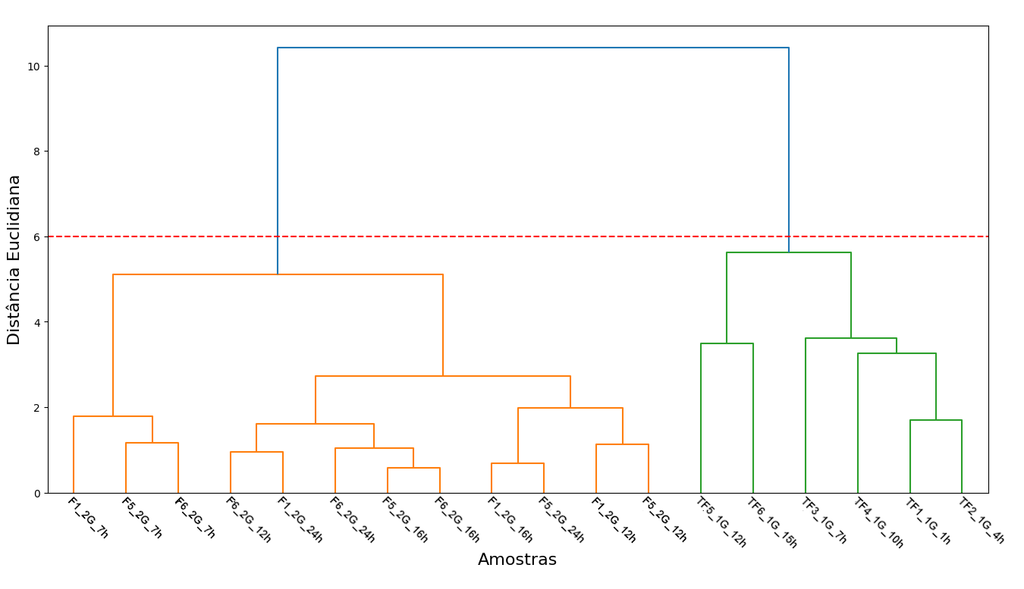
Para los genes de la ruta del glicerol (GR) (Tabla 5), el agrupamiento jerárquico (Figura 6) formó tres agrupaciones con un corte en la distancia euclidiana de 3. Dos grupos correspondieron a las levaduras 1G, separadas por tiempo de fermentación (1h, 4h, 10h en un grupo; 12h, 15h en otro). El tercer grupo estuvo compuesto por las muestras 2G. Notablemente, la muestra TF2_1G_7h (1G, 7h) se agrupó con las levaduras 2G en el mismo tiempo (7h), sugiriendo un comportamiento transcriptómico distinto.
Figura 6. Dendrograma generado a partir de la clusterización jerárquica por “Complete Linkage” de datos de transcriptomas de los genes específicos de la Ruta del Glicerol [GR] de levaduras industriales sometidas a diferentes tiempos de fermentaciones para producción de etanol de primera [1G] (muestras TF) y segunda [2G] (muestras F)
Fuente: Resultados originales de la investigación
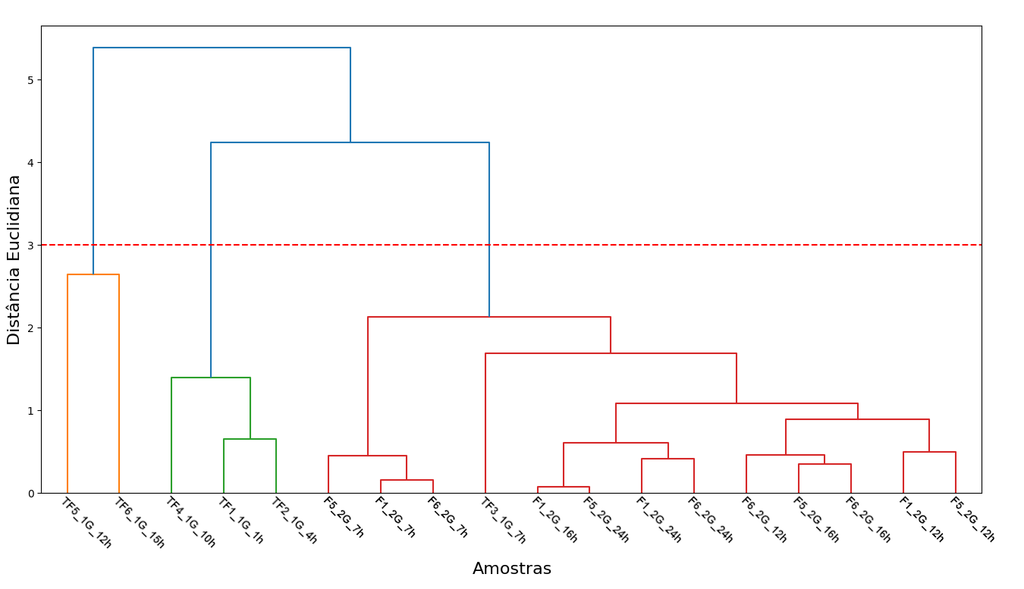
En el análisis de los genes de la vía de las pentosas fosfato (PPP) (Tabla 5), la clusterización jerárquica (Figura 7) resultó en cuatro grupos distintos con un corte en la distancia euclidiana de 3. El primer grupo incluyó muestras 2G de 7h y 12h. El segundo y tercer grupos representaron las levaduras 1G, agrupadas por tiempo de fermentación (tiempos finales: 10h, 12h, 15h; y tiempos iniciales: 1h, 4h, 7h). El último grupo reunió muestras 2G en los tiempos finales de fermentación (12h, 16h, 24h).
Figura 7. Dendrograma generado a partir de la clusterización jerárquica por “Complete Linkage” de datos de transcriptomas de los genes específicos de la Vía de la Pentosa Fosfato [PPP] de levaduras industriales sometidas a diferentes tiempos de fermentaciones para producción de etanol de primera [1G] (muestras TF) y segunda [2G] (muestras F)
Fuente: Resultados originales de la investigación
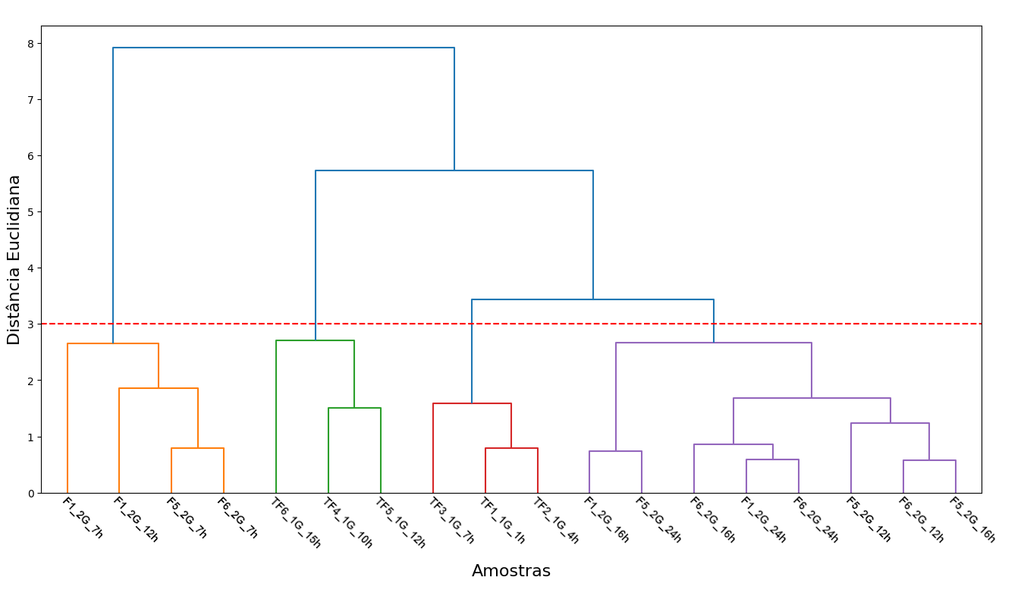
Finalmente, la clusterización jerárquica basada en los genes del ciclo del ácido tricarboxílico (TCA) (Tabla 5) (Figura 8) también mostró la separación de las levaduras por tipo de etanol (1G y 2G). Con un corte en la distancia euclidiana de 5, se definieron cuatro grupos principales. Las muestras 1G formaron dos subgrupos (10h y 12h en uno; 1h, 4h, 7h y 15h en otro). Las muestras 2G también formaron dos subgrupos (todas las muestras de 7h, una muestra aislada de 12h y otra de 16h en uno; y las demás muestras de 12h, 16h y 24h en otro).
Figura 8. Dendrograma generado a partir de la clusterización jerárquica por “Complete Linkage” de datos de transcriptomas de los genes específicos del ciclo del ácido tricarboxílico [TCA] de levaduras industriales sometidas a diferentes tiempos de fermentaciones para producción de etanol de primera [1G] (muestras TF) y segunda [2G] (muestras F)
Fuente: Resultados originales de la investigación
Análisis Factorial de Datos Mixtos [FAMD]
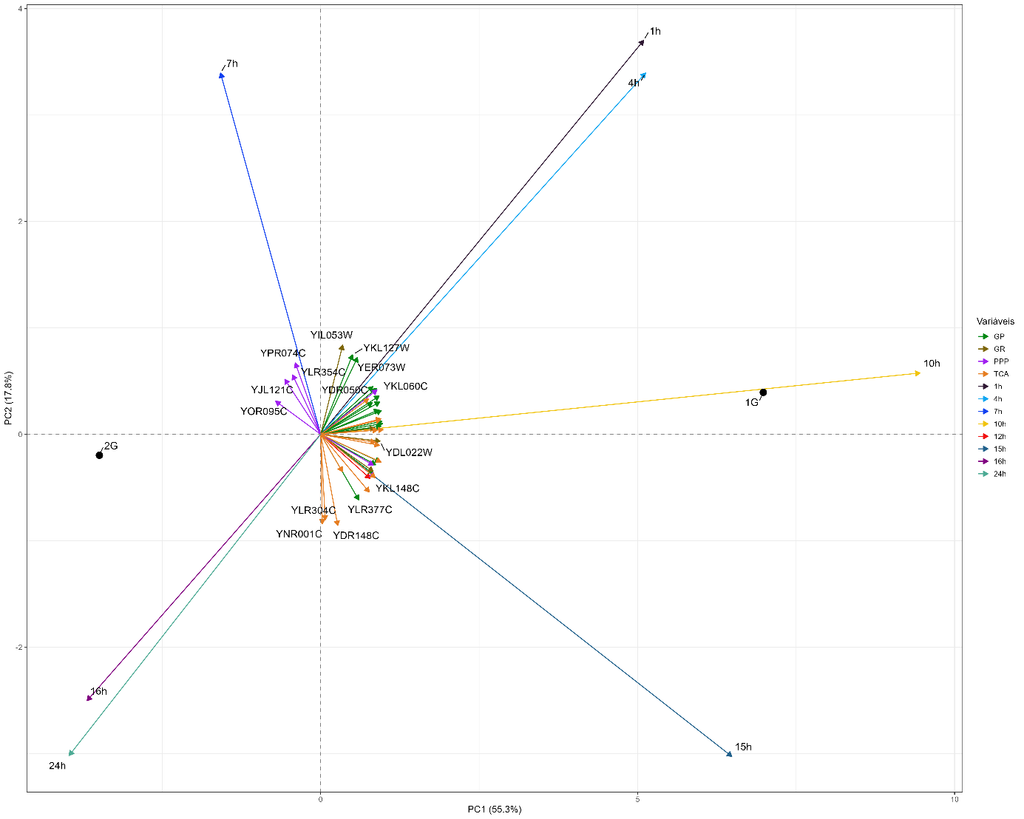
El Análisis Factorial de Datos Mixtos (FAMD) integró variables cuantitativas (expresión génica) y cualitativas (tiempos y tipos de fermentación), permitiendo identificar patrones de asociación. Las dos primeras componentes principales (PC1 y PC2) explicaron el 73,1% de la varianza total (PC1: 55,3%; PC2: 17,8%), indicando una buena representación de los datos (Figura 9). Se observó una fuerte separación entre las muestras a lo largo de la PC1, con 1G en el extremo positivo y 2G en el extremo negativo, confirmando que el tipo de fermentación es la principal fuente de variación.
Figura 9. Biplot obtenido por análisis factorial de datos mixtos [FAMD] a partir de transcriptomas de levaduras industriales, considerando las dimensiones 1 y 2
Fuente: Resultados originales de la investigación Nota: En este gráfico se tuvieron en cuenta variables como vías metabólicas asociadas a los genes, tiempos y tipos de fermentaciones para la producción de etanol de primera [1G] y segunda [2G]. Abreviaturas: [GP]: vía glucolítica, [GR]: ruta del glicerol, [PPP]: vía de la pentosa fosfato, [TCA]: ciclo del ácido tricarboxílico
Los componentes PC3 y PC4 (Figura 10) explicaron el 12% de la varianza total (PC3: 7%; PC4: 5%), con 1G en el extremo negativo de PC3 y 2G en el positivo, indicando una contribución secundaria a la estructura global de los datos. En cuanto a los tiempos de fermentación, se observaron agrupaciones distintas: 1h y 4h correlacionadas positivamente con PC2; 10h alineado con PC1 positivo y 1G; 15h con fuerte contribución en PC1 y componente negativo en PC2; y 16h y 24h con orientaciones opuestas a 1G, más cercanas a 2G. El tiempo de 7h mostró un comportamiento intermedio, contribuyendo principalmente a PC2.
Figura 10. Biplot obtenido por análisis factorial de datos mixtos [FAMD] a partir de transcriptomas de levaduras industriales, considerando las dimensiones 3 y 4
Fuente: Resultados originales de la investigación Nota: En este gráfico se tuvieron en cuenta variables como vías metabólicas asociadas a los genes, tiempos y tipos de fermentaciones para la producción de etanol de primera [1G] y segunda [2G]. Abreviaturas: [GP]: vía glucolítica, [GR]: ruta del glicerol, [PPP]: vía de la pentosa fosfato, [TCA]: ciclo del ácido tricarboxílico
Los análisis por vías metabólicas asociadas al flujo de carbono (Tabla 5) revelaron patrones distintos. Genes de la vía glucolítica (GP), como PFK1 (YGR240C), FBA1 (YKL060C), TPI1 (YDR050C), PGK1 (YJL052W) y PGI1 (YCR012W), se asociaron a los tiempos iniciales y tardíos de fermentación 1G, así como genes de la fermentación alcohólica (PDC1 (YLR044C) y ENO1 (YGR254W)). Genes de la ruta del glicerol (GR), como GPD1 (YDL022W) y GPD2 (YOL059W), se asociaron a tiempos avanzados de 1G, sugiriendo su papel en el ajuste metabólico. Por otro lado, genes de la vía de la pentosa-fosfato (PPP), como ZWF1 (YNL241C), GND2 (YGR256W) y RPE1 (YHR183W), correspondieron a la fermentación 2G. Genes del ciclo del ácido tricarboxílico (TCA), incluyendo CIT1 (YNR001C), SDH1 (YKL148C), IDH1 (YPL262W) y ACO1 (YLR304C), se correlacionaron con tiempos tardíos de 2G. Estos resultados indican que la variación de la expresión génica está fuertemente asociada a las diferencias entre las fermentaciones 1G y 2G, así como a la progresión temporal.
Este trabajo comparó los perfiles de expresión génica de levaduras industriales en fermentaciones de primera (1G) y segunda (2G) generación en diferentes tiempos, utilizando métodos no supervisados. Los resultados evidenciaron una clara separación entre los perfiles de expresión génica asociados a los procesos 1G y 2G, atribuida a las diferencias metabólicas entre las levaduras bajo estas condiciones de fermentación. El tipo de sustrato y las condiciones del proceso ejercen influencia sobre el comportamiento molecular de las levaduras. La fermentación 1G presentó patrones más organizados a lo largo del tiempo, mientras que la fermentación 2G exhibió mayor variabilidad y complejidad metabólica, lo que refleja los desafíos de utilizar biomasa lignocelulósica. Los análisis también indicaron diferencias relevantes entre las vías metabólicas asociadas al flujo de carbono, con la vía de la glucólisis más asociada a la 1G y las vías de la pentosa fosfato y del ciclo del ácido tricarboxílico más involucradas en la 2G. Los métodos no supervisados fueron eficaces en la identificación de patrones biológicos relevantes, permitiendo la distinción entre los perfiles moleculares de las fermentaciones 1G y 2G y demostrando potencial como herramientas analíticas para el mejoramiento biotecnológico de la producción de etanol. Es importante notar que los datos de transcriptoma provinieron de diferentes estudios, lo que puede introducir “batch effects” debido a variaciones en las tecnologías de secuenciación y en el número de réplicas biológicas entre las muestras de 1G (2009) y 2G (2016).
4. Conclusión
El presente estudio evaluó los perfiles transcriptómicos de levaduras industriales Saccharomyces cerevisiae “Pedra-2” en la producción de etanol de primera y segunda generación, en diferentes tiempos de fermentación, por medio de métodos no supervisados. Se verificó una clara separación entre los perfiles de expresión génica asociados a los procesos de primera y segunda generación, siendo el tipo de fermentación el principal factor de variabilidad. Se observó que las muestras de primera generación exhibieron mayor organización temporal y estabilidad, mientras que las de segunda generación demostraron mayor heterogeneidad y complejidad metabólica, reflejando los desafíos de la utilización de biomasa lignocelulósica. Se identificaron diferencias en las vías metabólicas asociadas al flujo de carbono, con predominancia de la glucólisis en la fermentación de primera generación y mayor participación de las vías de la pentosa fosfato y del ciclo del ácido tricarboxílico en la de segunda generación. La principal contribución reside en la demostración de la eficacia de los métodos no supervisados para identificar patrones biológicos relevantes, profundizando el entendimiento de las distinciones metabólicas entre los procesos y proporcionando subsidios para estrategias de optimización en la producción de etanol.
Sin embargo, es importante considerar las limitaciones derivadas del origen de los datos de transcriptoma, provenientes de diferentes estudios, lo que puede introducir “efectos de lote” debido a variaciones en las tecnologías de secuenciación y en el número de réplicas biológicas. Además, la naturaleza exploratoria de los métodos no supervisados impide inferencias causales directas. Para estudios futuros, se sugiere la incorporación de enfoques supervisados, una mayor estandarización experimental y validación con nuevos conjuntos de datos. Tales iniciativas pueden profundizar la comprensión de los mecanismos moleculares involucrados y ampliar el potencial de aplicación de estos resultados en contextos industriales, contribuyendo a la mejora biotecnológica de la producción de etanol.
Referencias Bibliográficas
Basso, LC.; De Amorim, H. V.; De Oliveira, A. J.; Lopes, M. L. 2011. Yeast selection for fuel ethanol production in Brazil. FEMS Yeast Research 11(2): 151-164.
Goldemberg, J. 2008. The Brazilian biofuels industry. Biotechnology for Biofuels 1-6.
Leite, R.C.C.; Leal, M.R.L.V.; Cortez, L.A.B.; Griffin, W. M.; Scandiffio, M.I.G. (2009). Can Brazil replace 5% of the 2025 gasoline world demand with ethanol? Energy 34(5): 655-661.
Renewable Fuels Association [RFA]. 2024. Market & Statistics – Annual Ethanol Production – 2024. Disponível em: . Acesso em: 10 mar. 2025.
Roman, C. 2010. Portal Ecodebate – Brasil busca liderança na produção de biocombustível.
Wheals, Α.Ε.; Basso, L.C; Alves, D.M.; Amorim, H.V. 1999. Fuel ethanol after 25 years. Trends Biotechnology 17(12):482-487.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haz clic aquí y accede a la plataforma MBX Academy