
15 de septiembre de 2026
Entre lo Artificial y lo Humano: Identificación de Textos Humanizados en el Enem por Features Lingüísticas
Lucas Lopes Ribeiro; Ana Julia Righetto
DOI: 10.22167/2675-6528-202602261
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
El creciente uso de modelos de lenguaje en la producción de textos académicos ha hecho relevante el desarrollo de métodos para identificar la autoría de producciones textuales, especialmente ante herramientas de humanización que enmascaran el origen sintético. El objetivo fue investigar la viabilidad de la detección de textos generados por inteligencia artificial, incluso después de la reescritura automática, a través de atributos lingüísticos interpretables. Para ello, se construyó un corpus de redacciones disertativo-argumentativas en el estándar del ENEM, abarcando textos humanos, generados por modelo de lenguaje y versiones humanizadas por herramienta de paráfrasis. Se extrajeron métricas estilométricas de diversidad léxica, complejidad sintáctica, legibilidad y previsibilidad textual, empleadas en el modelado de un problema de clasificación binaria supervisada. Se entrenaron tres algoritmos de aprendizaje automático (Regresión Logística, Random Forest y XGBoost) y se evaluaron por validación interna, en un conjunto independiente de datos y en comparación con una herramienta comercial. Los modelos presentaron un rendimiento elevado en la distinción entre textos humanos y sintéticos, manteniendo consistencia incluso con textos humanizados, mientras que la herramienta comercial demostró mayor dificultad. Se concluyó que el enfoque basado en atributos estilométricos se mostró eficaz y robusto para la detección de autoría textual en el contexto analizado.
Palabras clave: Análisis lingüístico; Aprendizaje automático; Detección de autoría textual; Humanización de texto; Procesamiento del lenguaje natural.
1. Introducción
La Inteligencia Artificial (IA) es un campo de estudio enfocado en la construcción de sistemas capaces de percibir, razonar y actuar sobre el mundo (Nilsson, 1998). Entre sus subcampos, destaca el Procesamiento del Lenguaje Natural (PLN), responsable de permitir que las máquinas comprendan y produzcan lenguaje humano. El avance reciente de los grandes modelos de lenguaje (LLMs), como el GPT-3 (Brown et al., 2020), ha revolucionado la forma en que los textos se generan automáticamente, haciendo que la escritura producida por IA sea cada vez más fluida, coherente y difícil de distinguir de la humana. Con esto, surgieron no solo detectores de textos artificiales, sino también herramientas llamadas “humanizadores”, que reescriben textos de IA mediante paráfrasis y alteraciones estilísticas para dificultar su identificación (Masrour et al., 2025).
Al profundizar en la literatura, la detección de textos generados por inteligencia artificial se ha convertido en una línea de investigación muy activa. Sin embargo, trabajos evidencian que detectores bien fundamentados pueden perder eficacia cuando los textos son modificados, y los detectores comerciales o de investigación presentan falsos positivos o negativos elevados, especialmente en textos académicos (Weber-Wulff et al., 2023). En cuanto a las herramientas de humanización, estudios como el de Masrour et al. (2025) analizaron diecinueve herramientas comerciales y mostraron que estas reducen significativamente la precisión de detectores consolidados, reforzando la necesidad de métodos más robustos, especialmente en contextos educativos, donde los textos artificialmente modificados pueden afectar el aprendizaje.
Teniendo en cuenta estos estudios mencionados, a pesar de presentar avances significativos, comparten algunas limitaciones: muchos se centran en escenarios generales, como noticias o textos en línea, y no en textos escolares o géneros como los ensayos del ENEM. Además, hay escasez de investigaciones que exploren características lingüísticas explicables, como sintaxis, cohesión, conectores y variación léxica como parte central del modelo. Un ejemplo reciente es el trabajo de Yadagiri et al. (2024), que propone la detección de textos generados por IA a partir de características lingüísticas y estilísticas, como diversidad léxica, legibilidad y uso de voz pasiva, demostrando que esta información puede mejorar tanto la precisión como la interpretación de los resultados. El uso de estas características puede ofrecer dos ventajas principales: mejorar la interpretabilidad y transparencia del modelo, y capturar marcas más sutiles dejadas por procesos de reescritura o humanización, que los detectores puramente probabilísticos o basados en perplejidad pueden pasar por alto.
Teniendo esto en cuenta, en el contexto educativo, la discusión sobre el uso de herramientas de inteligencia artificial en la escritura se vuelve cada vez más relevante. Según el Centro Regional de Estudios para el Desarrollo de la Sociedad de la Información (Cetic, 2023), siete de cada diez estudiantes de secundaria ya utilizan recursos de IA generativa en actividades escolares, y Brasil figura como el tercer país que más utiliza ChatGPT, con más de 140 millones de mensajes intercambiados diariamente (CNN Brasil, 2024). Aunque estas herramientas pueden ayudar en la elaboración de textos, su uso indiscriminado puede comprometer el desarrollo de competencias esenciales, como argumentación, cohesión y creatividad (Costa; Von Rondon, 2024).
Ante este escenario, el presente trabajo se justifica por la necesidad de desarrollar métodos eficaces para la identificación de textos producidos por inteligencia artificial, incluso después de procesos de humanización, en el ámbito educativo. El presente trabajo tuvo como objetivo desarrollar un modelo de clasificación capaz de identificar textos generados por inteligencia artificial, incluso después de la aplicación de herramientas de humanización, con enfoque en redacciones disertativo-argumentativas en el estándar del Examen Nacional de Enseñanza Media (ENEM).
2. Material y Métodos
La investigación adoptó un enfoque experimental de naturaleza aplicada, con elementos cuasi-experimentales. Se buscó analizar empíricamente las diferencias entre textos producidos bajo condiciones de generación textual humana, artificial y humanizada, centrándose en características lingüísticas medibles. Los datos fueron procesados bajo control y repetibilidad, siendo que los textos humanos preexistentes no tuvieron control sobre variables externas, mientras que las producciones artificiales fueron generadas bajo condiciones controladas por modelos de lenguaje y prompts definidos, y herramientas de humanización.
El corpus estuvo constituido por 1.800 redacciones disertativo-argumentativas en el estándar ENEM, divididas en tres categorías de 600 textos cada una: (i) redacciones humanas, producidas por estudiantes de secundaria entre enero de 2020 y diciembre de 2022, con una extensión mínima de 150 palabras y una nota superior a 700 puntos, cedidas por una startup brasileña de tecnología educativa; (ii) redacciones artificiales, generadas por el modelo de lenguaje GPT-4o mini (OpenAI) a partir de los mismos temas de las redacciones humanas y prompts estandarizados para simular instrucciones del ENEM; y (iii) redacciones humanizadas, obtenidas por la reescritura automática de las versiones artificiales por la herramienta de paráfrasis QuillBot (modo Standard), con el objetivo de suavizar rasgos de la escritura sintética. Cada conjunto de datos fue organizado en hojas de cálculo tabulares, con columnas para ID, texto completo, propuesta de escritura, tema y, para redacciones humanas, nota atribuida; para artificiales, modelo de IA; y para humanizadas, herramienta de humanización.
El procesamiento computacional de los textos se realizó en lenguaje Python, utilizando la biblioteca spaCy (Honnibal & Montani, 2017) para la segmentación de oraciones, etiquetado morfosintáctico (POS Tagging) y análisis de dependencias; la biblioteca Transformers (Wolf et al., 2020) para el modelo GPT-2 utilizado en el cálculo de perplejidad; y Pandas (McKinney, 2010) para la estructuración tabular del corpus. Se adoptó un enfoque conservador de preprocesamiento, limitándose a la tokenización para preservar marcas estilométricas.
Para la caracterización cuantitativa de los estilos de escritura, se extrajeron 26 características lingüísticas, organizadas en cuatro dimensiones analíticas principales: a) Diversidad Léxica y Repetición (Type-Token Ratio – TTR, Hapax Legomena, Entropía de Shannon); b) Complejidad y Legibilidad (índices de Flesch y Gunning Fog adaptados al portugués (Martins et al., 1996), tamaño medio de frases y líneas, complejidad sintáctica profunda); c) Análisis Morfosintáctico (distribución de clases de palabras vía POS Tagging); d) Estructura Argumentativa y Cohesión (conectivos adversativos y conclusivos, Razón Lógica Conclusiva, incidencia de voz pasiva analítica); e) Ritmo y Previsibilidad (Burstiness, perplejidad con GPT-2 Small Portuguese).
El problema se modeló formalmente como una tarea de clasificación binaria supervisada. Las tres categorías originales del corpus se recodificaron en dos clases mutuamente excluyentes: Humano (0) y Artificial/Humanizado (1), agrupando los escritos generados por GPT-4o mini y las versiones reescritas por QuillBot. Esta decisión metodológica tuvo como objetivo distinguir la autoría genuinamente humana de cualquier forma de producción sintética. La selección del vector de atributos final se orientó por un análisis exploratorio comparativo, lo que resultó en un conjunto definitivo de 10 características estilométricas de alto poder de separabilidad, que incluyeron Perplejidad, Burstiness, Diversidad Léxica (TTR), Índice de Legibilidad de Flesch, Proporción de Voz Pasiva, Proporción Lógica Conclusiva y densidades sintácticas de Adjetivos, Adverbios, Pronombres y Conjunciones Subordinativas. Las variables sin un poder discriminatorio robusto fueron excluidas. La realización de esta etapa previamente a la división entre entrenamiento y prueba puede introducir un sesgo de selección de atributos (feature selection bias), lo cual se consideró en la interpretación de los resultados.
Para la conducción de los experimentos de validación interna, el corpus completo de 1.800 redacciones fue dividido por holdout. Se destinaron 1.500 instancias para entrenamiento y optimización de los modelos, y 300 instancias para el conjunto de prueba interno. La división se realizó con muestreo estratificado, por medio del parámetro `stratify` de la función `train_test_split` de la biblioteca Scikit-Learn, resultando en 100 redacciones humanas y 200 redacciones sintéticas (100 artificiales y 100 humanizadas) en el conjunto de prueba. La semilla aleatoria `random_state=42` fue fijada para garantizar la reproducibilidad.
Se entrenaron tres algoritmos supervisados: Regresión Logística, Random Forest y XGBoost. La Regresión Logística, adoptada como línea base lineal, tuvo los datos de entrenamiento estandarizados con `StandardScaler` de la biblioteca Scikit-Learn y se instanció con `max_iter=2000` y `random_state=42`. El Random Forest se configuró con 100 árboles de decisión (`n_estimators=100`), balanceo automático de clases (`class_weight=’balanced’`) y `random_state=42`. El XGBoost se configuró con 100 estimadores (`n_estimators=100`), tasa de aprendizaje de 0,1 (`learning_rate=0.1`), profundidad máxima de los árboles igual a 5 (`max_depth=5`), métrica de evaluación interna `eval_metric=’logloss’` y `random_state=42`. Al término del entrenamiento, los modelos y el `StandardScaler` ajustado se serializaron y persistieron en disco por medio de la biblioteca `joblib`.
La validación externa se realizó aplicando los modelos entrenados a un nuevo conjunto de datos independiente, compuesto por 300 redacciones inéditas, que no integraron el corpus original. Este conjunto externo se construyó siguiendo los mismos criterios metodológicos del corpus principal: 100 redacciones humanas (nota superior a 700 en el estándar ENEM), 100 redacciones generadas por el modelo GPT-4o mini a partir de nuevos temas y prompts, y 100 redacciones humanizadas mediante la herramienta QuillBot (modo Standard) aplicadas sobre los textos sintéticos. Los modelos se cargaron y aplicaron directamente, sin ajuste ni recalibración, con el `StandardScaler` utilizado para la Regresión Logística.
La evaluación del rendimiento de los modelos se realizó mediante un conjunto estandarizado de métricas de clasificación binaria (Sokolova & Lapalme, 2009; Fawcett, 2006): Precisión Global, Precisión, Revocación (Recall) y Puntuación F1. Complementariamente, se procedió al análisis de las Matrices de Confusión para examinar los patrones de error, distinguiendo falsos positivos (texto humano clasificado como sintético) y falsos negativos (texto sintético, incluidos los humanizados, clasificado como humano).
Para contextualizar el rendimiento de los modelos, se realizó una evaluación comparativa con GPTZero, una herramienta comercial para la detección de textos generados por modelos de lenguaje. La evaluación se llevó a cabo sobre el mismo conjunto de 300 redacciones de la validación externa. Cada redacción se sometió individualmente a la interfaz web de GPTZero y las clasificaciones se registraron manualmente. Las salidas de GPTZero se convirtieron a una tarea de clasificación binaria (textos humanos vs. textos sintéticos, incluidos los humanizados) y se calcularon las mismas métricas de evaluación. Esta evaluación se realizó a partir de una única muestra y mediante interacción manual con la herramienta, lo que puede introducir limitaciones en cuanto a la reproducibilidad y estandarización del proceso.
3. Resultados y Discusión
Esta sección presenta y discute los resultados obtenidos a lo largo de la investigación, estructurándose en dos frentes analíticos principales. La primera parte se dedica al análisis exploratorio de datos, detallando las métricas estilométricas evaluadas y los resultados de las pruebas estadísticas que fundamentaron la selección de los atributos más pertinentes para el problema de clasificación binaria. La segunda parte se concentra en la evaluación del desempeño predictivo de las arquitecturas de aprendizaje automático entrenadas, incluyendo validación interna y externa, y el benchmarking realizado contra una herramienta comercial.
Análisis exploratorio y selección de las características estilométricas
La etapa inicial de análisis de los datos consistió en la validación del vector de atributos (features) mediante un análisis exploratorio comparativo entre las tres categorías de texto: humano, artificial y humanizado. El objetivo fue verificar la existencia de patrones estadísticos que permitieran la distinción entre la producción humana genuina y los textos generados por modelos de lenguaje, así como evaluar el impacto de las herramientas de ofuscación (humanización) sobre estas métricas.
Los gráficos generados revelaron comportamientos distintos entre las clases, especialmente en lo que respecta a la estructura profunda y a la variabilidad léxica de los textos. Se observó que ciertas métricas presentaron una separación clara entre la autoría humana y la artificial, mientras que otras demostraron la limitación de las herramientas de humanización para alterar la “firma digital” de los modelos base.
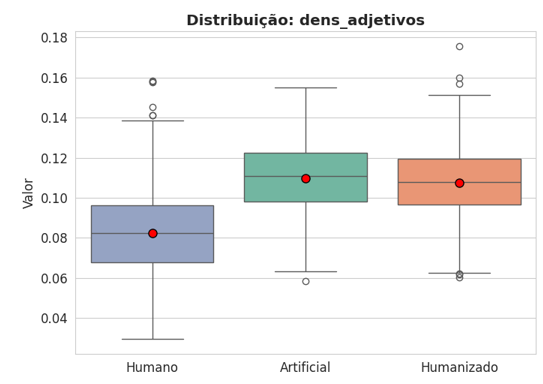
El análisis de la densidad de adjetivos, presentado en la Figura 1, reveló una de las distinciones más marcadas entre las clases de autoría. Se observó, a través del diagrama de caja (boxplot), que los escritos de autoría humana presentan una mediana de adjetivación significativamente inferior, con 0,08 en comparación con los textos generados por inteligencia artificial y humanizados, con aproximadamente 0,11.
Figura 1. Análisis de adjetivos – boxplot.
Fuente: Resultados originales de la investigación
Este resultado sugiere que la densidad de adjetivos constituye un fuerte marcador estilométrico para la detección de autoría sintética, ya que los modelos generativos tienden a utilizar adjetivos en exceso para emular asertividad y formalidad, distanciándose de la sobriedad característica de la escritura estudiantil natural.
El análisis de la diversidad léxica, operacionalizado por el Type-Token Ratio (TTR) (Figura 2), reveló un divisor estadístico robusto entre las categorías. Mientras que el grupo humano presentó una mediana de 0,59, con un rango intercuartílico que se extiende hasta 0,62, las producciones artificiales (IA y Humanizada) demostraron un techo de diversidad significativamente inferior, con medianas situadas ambas en 0,52. Esta reducción de aproximadamente el 13% en la riqueza de vocabulario de las IAs sugiere una dependencia de un núcleo léxico restringido, característica que las herramientas de humanización no lograron mitigar, manteniendo las producciones sintéticas estadísticamente segregadas de la variabilidad natural de los estudiantes.
Figura 2. Análisis de TTR – boxplot
Fuente: Resultados originales de la investigación
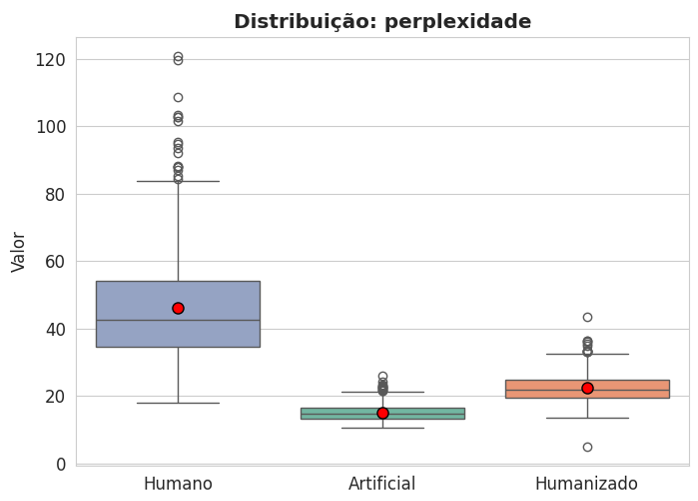
En cuanto a la perplejidad, esta métrica, proveniente de la Teoría de la Información, mide el grado de “sorpresa” de un modelo de lenguaje al procesar una secuencia. Se observó (Figura 3) que el grupo humano presenta el mayor nivel de entropía, con una mediana de 42,48, lo que evidencia la naturaleza no lineal y menos predecible de la escritura estudiantil. En contraste, las producciones de la IA registraron solo 14,78, reflejando la tendencia de los modelos generativos a seleccionar tokens de alta probabilidad estadística, resultando en textos mecánicamente “esperados”. La versión humanizada presentó una mediana de 22,03, indicando que la paráfrasis introduce variaciones léxicas que elevan la perplejidad, pero aún falla en alcanzar los niveles de complejidad informacional de la autoría humana.
Figura 3. Análisis de perplejidad – boxplot
Fuente: Resultados originales de la investigación
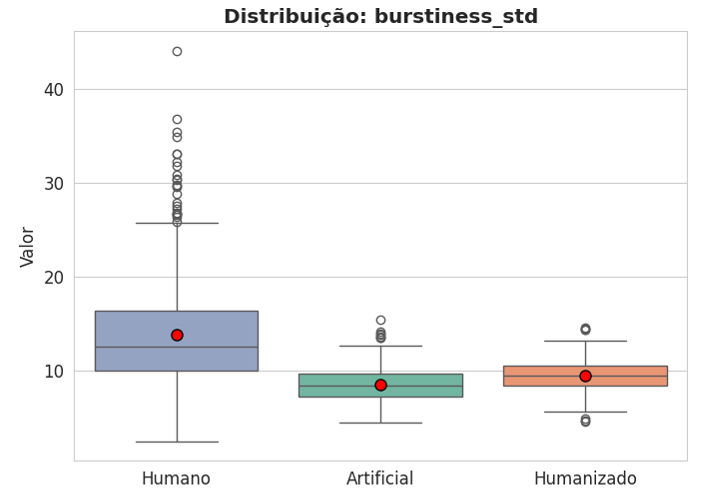
En cuanto al Burstiness (Figura 4), el ritmo de escritura, operacionalizado por la desviación estándar del tamaño de las oraciones, reveló la monotonía sintáctica de la máquina. La mediana del grupo humano 12,58 destaca por su amplia variabilidad, lo que indica que los estudiantes alternan dinámicamente entre oraciones cortas y cláusulas subordinadas largas. En las producciones artificiales y humanizadas, las medianas fueron de 8,50 y 9,53, respectivamente. Esta compresión en los valores de Burstiness indica que la IA tiende a generar párrafos con estructuras de longitud casi uniforme para garantizar la cohesión, lo que resulta en un ritmo de lectura estandarizado que la herramienta de paráfrasis no logra hacer orgánico.
Figura 4. Análisis de Burstiness- BoxPlot
Fuente: Resultados originales de la investigación
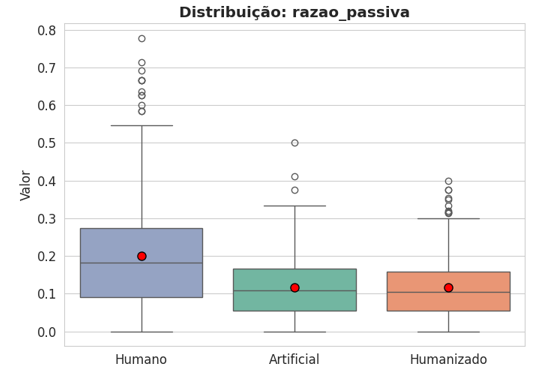
La incidencia de la voz pasiva analítica actuó como un inesperado indicador de autoría humana en el contexto del ENEM. La mediana observada (Figura 5) en el grupo humano fue de 0,18, valor sustancialmente superior a los 0,11 del grupo artificial y 0,10 del humanizado. Este hallazgo sugiere que, en la búsqueda por atender a las competencias del examen que exigen impersonalidad, el alumno humano hace un uso intensivo y, a veces, exagerado de la voz pasiva. Las IAs, al ser optimizadas para claridad y legibilidad (voz activa), fallan en emular este comportamiento estilístico específico del género textual investigado, creando una brecha estadística utilizable para la detección.
Figura 5. Análisis de voz pasiva – boxplot
Fuente: Resultados originales de la investigación
En relación con el Índice de Flesch, esta métrica evalúa la complejidad de un texto basándose en la extensión de las palabras y oraciones, donde puntuaciones más bajas indican textos más densos y complejos. Se observó (Figura 6) que las redacciones humanas presentan una mediana de 39,84, situándose en una zona de lectura “difícil”, pero aún superior a los niveles registrados por las producciones artificiales. El grupo Artificial presentó una mediana de 30,12, y el grupo Humanizado 31,28, lo que los sitúa en la categoría de lectura “muy difícil”. Esta diferencia de casi 10 puntos sugiere que la inteligencia artificial genera textos significativamente más densos y con palabras más largas (polisílabos) que el estudiante promedio. Además, la variabilidad del grupo humano es notable: la desviación estándar de 10,08 para humanos, contra solo 6,03 para la IA, demuestra que mientras los estudiantes exhiben diferentes niveles de competencia y estilos de escritura, la IA mantiene una “densidad estandarizada” y excesivamente compleja, que la humanización falla en suavizar de forma eficaz.
Figura 6. Análisis de índice de flesch – boxplot
Fuente: Resultados originales de la investigación
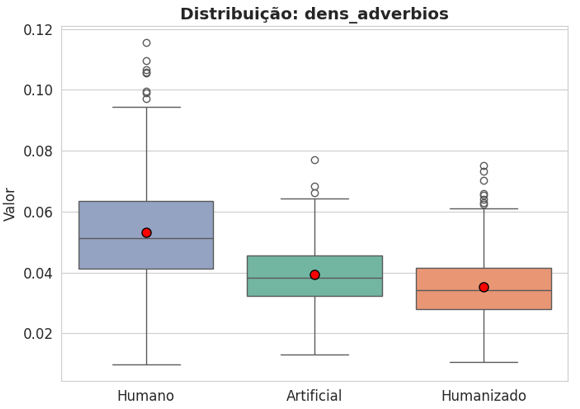
El análisis de la densidad de adverbios (Figura 7) reveló un comportamiento inverso al observado en la adjetivación (Figura 1), consolidándose como un marcador de autoría humana. Los estudiantes presentaron una mediana de 0,051, valor significativamente superior a los 0,038 registrados por el grupo artificial. Este hallazgo sugiere que la escritura humana es más rica en adjuntos adverbiales que confieren matices de modo, tiempo e intensidad a la argumentación. Notablemente, el proceso de humanización resultó en un declive adicional de esta métrica a 0,034, indicando que la paráfrasis automatizada tiende a neutralizar el texto, eliminando marcadores circunstanciales que son esenciales para la fluidez y la subjetividad del discurso humano.
Figura 7. Análisis de adverbios – boxplot
Fuente: Resultados originales de la investigación
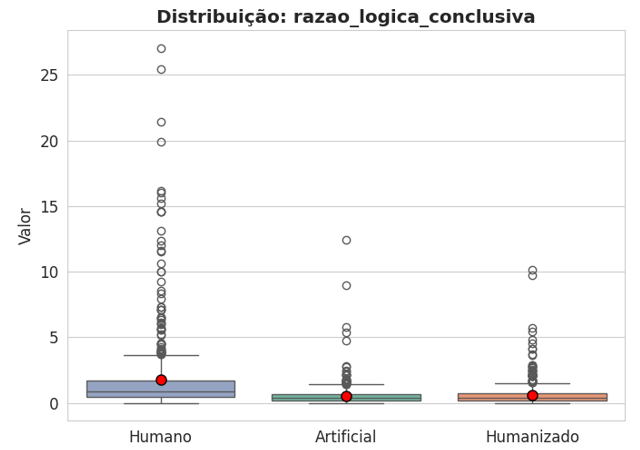
En cuanto al análisis de la razón de lógica conclusiva (Figura 8), esta métrica, que calcula la proporción entre conectivos conclusivos y adversativos, reveló una discrepancia entre los grupos. Mientras que los estudiantes humanos presentaron una mediana de 0,87, los textos de IA y humanizados registraron valores de 0,40 y 0,41, respectivamente. Este dato indica que la redacción humana utiliza casi el doble de estructuras de cierre lógico en relación con las oposiciones dialécticas, sugiriendo una progresión argumentativa más dirigida a la conclusión, mientras que la IA mantiene un equilibrio artificial que resulta en una argumentación más neutra y menos asertiva.
Figura 8. Análisis de razón lógica concluyente – boxplot
Fuente: Resultados originales de la investigación
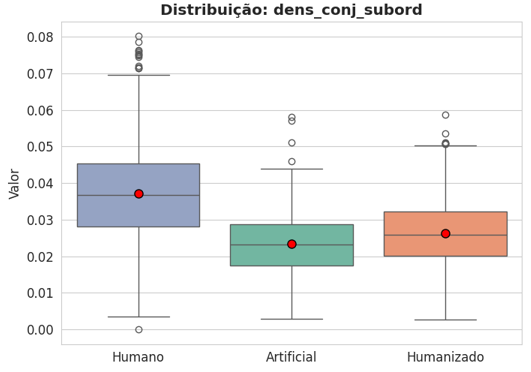
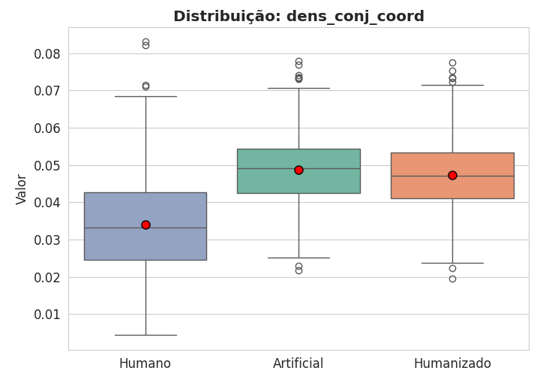
El análisis de las conjunciones (Figura 9 y Figura 10) reveló una profunda diferencia estructural en la arquitectura de las frases. El grupo humano utilizó significativamente más conjunciones subordinadas (mediana de 0,036) que la IA (0,023) y el grupo humanizado (0,025). En contrapartida, la IA demostró una preferencia por conjunciones coordinadas (mediana de 0,049 frente a 0,033 del humano). Esta inversión demuestra que la escritura humana es inherentemente más compleja y anidada, mientras que los modelos de lenguaje generan estructuras más lineales e independientes, facilitando la lectura, pero perdiendo la densidad sintáctica típica de la enseñanza secundaria.
Figura 9. Análisis de conjunciones subordinadas – boxplot
Fuente: Resultados originales de la investigación
Figura 10. Análisis de conjunciones coordinantes – boxplot
Fuente: Resultados originales de la investigación
Las demás métricas lingüísticas extraídas no presentaron variaciones estadísticas robustas ni poder discriminatorio satisfactorio para la distinción entre las clases estudiadas, justificando su exclusión del vector de atributos final. De esta forma, el análisis exploratorio consolidó un vector definitivo compuesto por 10 características estilométricas de alto poder de separabilidad, que formaron la base de datos exclusiva para la modelización predictiva. Este conjunto final abarca las siguientes métricas: Perplejidad, Burstiness, Diversidad Léxica (TTR), Índice de Legibilidad de Flesch, Proporción de Voz Pasiva y Proporción Lógica Conclusiva, además de las densidades sintácticas de Adjetivos, Adverbios, Pronombres y Conjunciones Subordinativas.
Desempeño en la validación interna y establecimiento de línea base
Una vez definido el vector final compuesto por diez características estilométricas seleccionadas, se procedió a la etapa de modelado predictivo, con el entrenamiento de tres algoritmos supervisados: Regresión Logística, Random Forest y XGBoost. La validación interna se llevó a cabo sobre una muestra de prueba compuesta por 300 redacciones, particionada mediante holdout estratificado. Los resultados indicaron un elevado rendimiento predictivo. Conforme se observa en la Tabla 1, la Regresión Logística, adoptada como baseline lineal, alcanzó una precisión global del 100% (1,00), con precisión, revocación y F1-Score cercanos a 1,00 para ambas clases. Los modelos basados en árboles, Random Forest y XGBoost, también presentaron un elevado rendimiento, con una precisión global de aproximadamente el 99% y métricas equilibradas entre las clases Humano y Artificial/Humanizado.
Tabla 1. Rendimiento predictivo de los modelos en la Validación Interna
| Patrón | Clase | Precisión | Revocación (Recall) | F1-Score | Precisión Global |
|---|---|---|---|---|---|
| Regresión Logística | Ser humano (0) | 1 | 0,99 | 0,99 | 1 |
| Sintético/Obscurecido (1) | 1 | 1 | 1 | ||
| Random Forest | Ser humano (0) | 0,98 | 0,99 | 0,99 | 0,99 |
| Sintético/Obscurecido (1) | 0,99 | 0,99 | 0,99 | ||
| XGBoost | Ser humano (0) | 0,98 | 0,98 | 0,98 | 0,99 |
| Sintético/Obscurecido (1) | 0,99 | 0,99 | 0,99 |
Fuente: Resultados originales de la investigación.
Estos resultados sugieren que el conjunto de atributos estilométricos seleccionados posee una capacidad de discriminación relevante entre las clases en el contexto de la muestra analizada. El rendimiento de la Regresión Logística, en particular, indica que parte de esta separación puede ser capturada por fronteras de decisión lineales en el espacio de atributos. Sin embargo, es importante considerar que la selección de las características se realizó previamente a la división entre entrenamiento y prueba, lo que puede introducir sesgos en la estimación del rendimiento interno.
Desempeño en la Validación Externa y la Falla Estructural de la Humanización
La validación externa se llevó a cabo con el objetivo de evaluar la capacidad de generalización de los modelos en datos no utilizados en ninguna etapa anterior del proceso. Para ello, se construyó un conjunto compuesto por 300 redacciones inéditas, siendo 100 humanas, 100 generadas por IA y 100 humanizadas a través de QuillBot. Los resultados obtenidos se mantuvieron elevados, aunque ligeramente inferiores a los observados en la validación interna. Según la Tabla 2, los modelos Random Forest y XGBoost alcanzaron una precisión global de aproximadamente 99,33%, mientras que la Regresión Logística presentó una precisión de 99,67%. Las métricas de precisión, revocación y F1-Score se mantuvieron equilibradas entre las clases, lo que indica consistencia en el rendimiento de los clasificadores.
Tabla 2. Rendimiento predictivo de los modelos en la Validación Externa
| Patrón | Clase | Precisión | Revocación (Recall) | F1-Score | Precisión Global |
|---|---|---|---|---|---|
| Regresión Logística | Ser humano (0) | 1 | 0,99 | 0,99 | 0,9967 |
| Regresión Logística | Sintético/Obscurecido (1) | 1 | 1 | 1 | 0,9967 |
| Random Forest | Ser humano (0) | 0,99 | 0,99 | 0,99 | 0,9933 |
| Random Forest | Sintético/Obscurecido (1) | 0,99 | 0,99 | 0,99 | 0,9933 |
| XGBoost | Ser humano (0) | 0,99 | 0,99 | 0,99 | 0,9933 |
| XGBoost | Sintético/Obscurecido (1) | 0,99 | 0,99 | 0,99 | 0,9933 |
Fuente: Resultados originales de la investigación.
Se destaca que la Regresión Logística presentó una revocación igual a 1.00 para la clase Artificial/Humanizado, lo que indica que, en el conjunto evaluado, todos los textos sintéticos, incluyendo aquellos sometidos al proceso de humanización, fueron correctamente identificados. Aunque este resultado es expresivo, su interpretación debe ser contextualizada: se trata de un desempeño observado en un conjunto específico de datos, limitado a un único modelo generador (GPT-40 mini) y a una única herramienta de paráfrasis (QuillBot, modo Standard). La proximidad entre los resultados de las validaciones interna y externa sugiere que los modelos no sufrieron una degradación significativa de desempeño al ser aplicados en datos inéditos. Este comportamiento indica que, al menos en el contexto experimental adoptado, los clasificadores fueron capaces de capturar patrones relativamente estables entre las clases.
Generalización y Mitigación del Sesgo de Selección de Atributos
La consistencia observada entre los resultados de las validaciones interna y externa sugiere que el conjunto de atributos estilométricos seleccionados captura aspectos relevantes de la diferenciación entre textos humanos y sintéticos en el contexto analizado. Métricas como perplejidad, diversidad léxica, burstiness e indicadores morfosin tácticos demostraron ser útiles para representar patrones estructurales y estilísticos asociados a las diferentes formas de producción textual. Sin embargo, es importante resaltar que la selección de estas características se basó en el análisis del conjunto completo de datos original, lo que puede introducir un sesgo en la selección de atributos. La utilización de un conjunto externo para la validación contribuye a mitigar parcialmente este efecto, pero no lo elimina por completo. De esta forma, los resultados deben interpretarse como evidencia inicial de la utilidad de estas métricas, y no como prueba definitiva de su generalización a otros contextos. Además, el corpus utilizado se compone exclusivamente de redacciones del género disertativo-argumentativo al estilo ENEM, lo que implica que los patrones identificados pueden estar asociados, en parte, a las características específicas de este género textual.
Benchmarking con Herramienta Comercial y la Especialización de Dominio
La comparación con la herramienta GPTZero se realizó sobre el mismo conjunto de 300 redacciones utilizado en la validación externa, permitiendo un análisis comparativo directo entre los modelos. En general, los clasificadores desarrollados en este estudio presentaron un desempeño superior al de la herramienta comercial, conforme se señala en la Tabla 3. En términos de patrón de error, se observa que los modelos propuestos cometieron predominantemente falsos positivos y, en menor grado, falsos negativos, manteniendo un desempeño equilibrado entre las clases. En contrapartida, GPTZero presentó un comportamiento distinto: no registró falsos positivos, pero concentró sus errores en falsos negativos.
Tabla 3. Rendimiento predictivo y análisis de errores en la evaluación comparativa
| Patrón | Precisión Global | Precisión | Revocación (Recall) | F1-Score | Falso Positivo (Error Humano) | Falso Negativo (Error IA/Humanizado) |
|---|---|---|---|---|---|---|
| Regresión Logística | 0.9967 | 0.995 | 1 | 0.9975 | 1 | 0 |
| Random Forest | 0.9933 | 0.995 | 0.995 | 0.995 | 1 | 1 |
| XGBoost | 0.9933 | 0.995 | 0.995 | 0.995 | 1 | 1 |
| GPTZero | 0.9833 | 1 | 0.975 | 0.9873 | 0 | 5 |
Fuente: Resultados originales de la investigación.
El análisis de estos casos revela un aspecto particularmente relevante: los errores de GPTZero están mayoritariamente asociados a textos que han pasado por un proceso de humanización vía QuillBot. Esto indica que la herramienta presenta mayor dificultad para identificar como sintéticos textos que han sufrido alteraciones en la superficie léxica y estructural mediante paráfrasis automatizada. En contraste, los modelos desarrollados en este estudio se mostraron más consistentes en la detección de este tipo de texto, incluso después del proceso de humanización. Este resultado sugiere que la utilización de características estilométricas puede contribuir a la captura de patrones más globales de la escritura, menos sensibles a modificaciones superficiales. Aun así, esta comparación debe ser interpretada con cautela. GPTZero está diseñado para operar en múltiples dominios textuales, mientras que el modelo propuesto fue desarrollado en un contexto específico: redacciones disertativo-argumentativas al estilo ENEM. Además, la evaluación se realizó en una única muestra, lo que limita la generalización de los resultados.
Análisis de la Matriz de Confusión
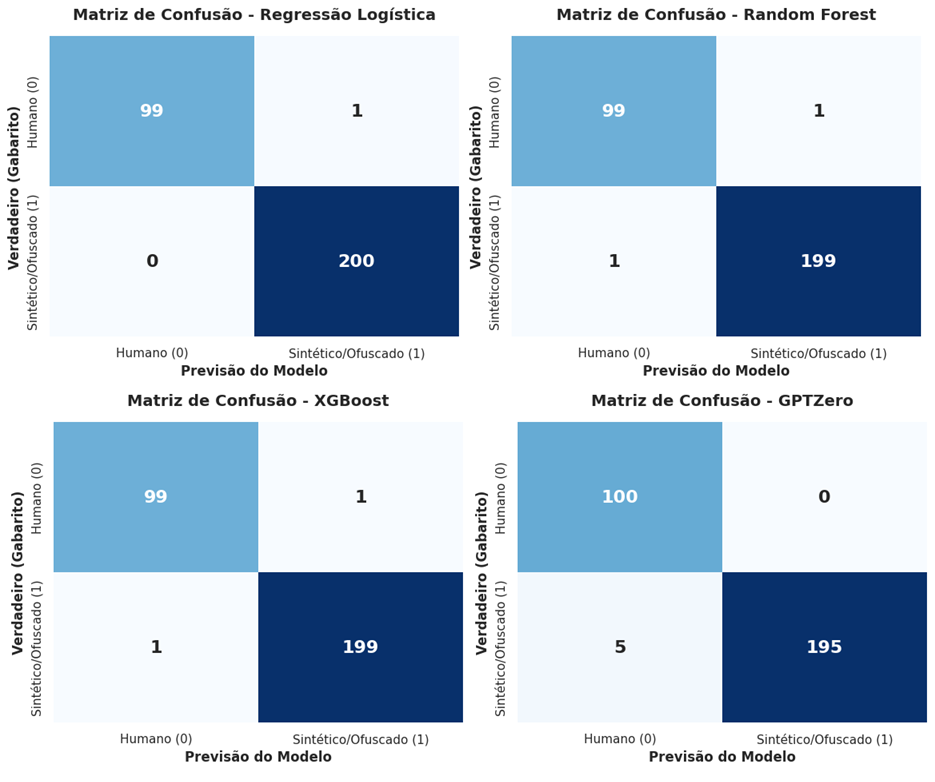
El análisis de las matrices de confusión se realizó con el objetivo de examinar no solo el rendimiento agregado de los modelos, sino también la naturaleza de los errores cometidos, distinguiendo entre falsos positivos y falsos negativos. En el contexto de esta investigación, se define como falso positivo el caso en que un texto humano se clasifica como sintético, y como falso negativo el caso en que un texto sintético —incluyendo textos humanizados— se clasifica como humano. Estas dos categorías de error tienen implicaciones distintas: mientras que los falsos positivos pueden llevar a la clasificación indebida de producciones humanas como artificiales, los falsos negativos indican fallos en la detección de textos generados por inteligencia artificial.
En la validación externa, se observó una baja incidencia de errores en los modelos desarrollados, como se puede observar en la Figura 11. La Regresión Logística presentó un único falso positivo y ningún falso negativo, mientras que los modelos Random Forest y XGBoost presentaron un falso positivo y un falso negativo cada uno. Estos resultados indican que, en el conjunto analizado, los clasificadores fueron capaces de mantener un rendimiento consistente tanto en la identificación de textos humanos como sintéticos.
Figura 11. Matriz de confusión de los modelos
Fuente: Resultados originales de la investigación.
En contraste, la herramienta GPTZero presentó un mayor número de falsos negativos, totalizando cinco ocurrencias. El análisis de estos casos revela un patrón consistente: todos los errores corresponden a textos sintéticos que previamente fueron sometidos a procesos de humanización a través de QuillBot y que fueron clasificados como humanos por la herramienta. En el caso de GPTZero, la recurrencia de falsos negativos en textos humanizados sugiere que este tipo de transformación puede impactar la capacidad de detección de la herramienta, al menos en el conjunto analizado. Este resultado no permite generalizaciones amplias, pero apunta a la relevancia de considerar escenarios de humanización en la evaluación de sistemas de detección de autoría. De modo general, el análisis de las matrices de confusión complementa las métricas agregadas al evidenciar que, a pesar del alto desempeño global, existen casos específicos en los que la distinción entre textos humanos y sintéticos se vuelve menos nítida, especialmente cuando se aplican intervenciones de reescritura.
Parcimonia e interpretabilidad del modelo
Uno de los hallazgos de este estudio se refiere al rendimiento de la Regresión Logística en comparación con modelos más complejos. A pesar de ser un clasificador lineal, con bajo costo computacional y alta interpretabilidad, su rendimiento fue comparable y, en algunos casos, ligeramente superior al de modelos basados en árboles. Este resultado sugiere que, para el problema investigado, un conjunto reducido de características estilométricas puede ser suficiente para capturar patrones relevantes de distinción entre textos humanos y sintéticos. En contextos educativos, esta característica es particularmente importante, ya que la transparencia de las decisiones automatizadas puede ser un requisito relevante. Aun así, este hallazgo debe interpretarse con cautela. El rendimiento de modelos simples depende directamente de la calidad de las características y del dominio analizado, no siendo posible generalizar esta observación a otros contextos o tipos de datos.
Los resultados obtenidos indican que el enfoque basado en características estilométricas fue eficaz para discriminar textos humanos de textos sintéticos en el contexto analizado. El uso de métricas lingüísticas estructurales demostró ser suficiente para capturar diferencias relevantes entre los patrones de escritura, permitiendo la construcción de modelos con alto rendimiento predictivo. Adicionalmente, se verificó que los textos sometidos a procesos de humanización automática permanecen, en cierta medida, distinguibles de los textos genuinamente humanos cuando se analizan desde la perspectiva de características estilométricas. Este resultado refuerza la relevancia del análisis estructural del lenguaje como alternativa a la dependencia exclusiva de modelos complejos y poco interpretables. La elección de modelos supervisados de menor complejidad también resultó adecuada para el problema, evidenciando que enfoques más simples, cuando están bien fundamentados teóricamente, pueden alcanzar un rendimiento competitivo.
En este sentido, se destaca la importancia de la interpretabilidad de los modelos en el contexto educativo, especialmente en aplicaciones que involucran la toma de decisiones automatizada sobre producciones textuales. A pesar de los resultados obtenidos, deben considerarse algunas limitaciones, como el dominio específico de textos disertativo-argumentativos del ENEM y la utilización de herramientas específicas para la generación y humanización, lo que restringe la generalización de los hallazgos. Investigaciones futuras podrían explorar la aplicación de estas mismas características en otros dominios para evaluar su robustez, así como la ampliación del corpus para incluir diferentes géneros textuales, niveles de competencia y herramientas de generación y reescritura, además de la investigación de enfoques híbridos que combinen atributos lingüísticos interpretables con representaciones más complejas. Este trabajo contribuye al demostrar que el análisis estilométrico constituye un enfoque prometedor para la detección de autoría en textos, ofreciendo una alternativa interpretable y potencialmente aplicable en contextos educativos reales.
4. Conclusión
El presente trabajo tuvo como objetivo desarrollar un modelo de clasificación capaz de identificar textos generados por inteligencia artificial, incluso después de la aplicación de herramientas de humanización, con enfoque en redacciones disertativo-argumentativas en el estándar del Examen Nacional de Enseñanza Media (ENEM). Se verificó que el enfoque basado en atributos estilométricos fue eficaz para discriminar textos humanos de textos sintéticos. Métricas lingüísticas estructurales, como densidad de adjetivos, diversidad léxica (TTR), perplejidad y Burstiness, revelaron patrones distintivos entre la escritura humana y la artificial, incluso después de la reescritura por herramientas de humanización. Los modelos de aprendizaje automático entrenados, incluyendo Regresión Logística, Random Forest y XGBoost, demostraron alto rendimiento predictivo en la detección de estos textos, superando una herramienta comercial en escenarios de humanización. La principal contribución reside en la demostración de que el análisis estilométrico ofrece una alternativa robusta e interpretable para la detección de autoría textual, esencial para el contexto educacional.
A pesar de los resultados prometedores, el estudio presentó algunas limitaciones. La investigación se llevó a cabo en un dominio específico de redacciones discursivo-argumentativas del ENEM, lo que restringe la generalización de los hallazgos a otros géneros textuales. Además, la generación de textos sintéticos y humanizados utilizó herramientas específicas (GPT-40 mini y QuillBot), no abarcando la diversidad de modelos y estrategias de humanización existentes. Se sugiere, para estudios futuros, la ampliación del corpus para incluir diferentes géneros textuales y niveles de competencia, así como la investigación de otras herramientas de generación y reescritura. Se recomienda también explorar enfoques híbridos que combinen atributos lingüísticos interpretables con representaciones más complejas, con el fin de mejorar la robustez y la aplicabilidad de los modelos en escenarios más amplios.
Referencias Bibliográficas
BROWN, T. et al. Language Models Are Few-Shot Learners. Advances in Neural Information Processing Systems, v. 33, p. 1877-1901, 2020. Disponível em: https://arxiv.org/abs/2005.14165. Acesso em: 21 set. 2025.
MASROUR, E.; EMI, B. N.; SPERO, M. DAMAGE: Detecting Adversarially Modified Al Generated Text. In: Proceedings of the 1st Workshop on GenAl Content Detection (GenAIDetect), Abu Dhabi, 2025. Disponível em: https://arxiv.org/abs/2501.03437. Acesso em: 21 set. 2025.
NILSSON, N. J. Artificial Intelligence: A New Synthesis. San Francisco: Morgan Kaufmann, 1998.
WEBER-WULFF, D. et al. Testing of Detection Tools for Al-Generated Text. International Journal for Educational Integrity, v. 19, art. 26, 2023. Disponível em: https://edintegrity.biomedcentral.com/articles/10.1007/s40979-023-00146-z. Acesso em: 22 set. 2025.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haz clic aquí y accede a la plataforma MBX Academy