
16 de septiembre de 2026
Evaluación de Metodologías de Recuperación Aumentada por Generación (Rag) en la Construcción de Agentes Generativos
Matheus Pinheiro Leopoldino; Anna Carolina Martins
DOI: 10.22167/2675-6528-202602280
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
El avance reciente de los modelos de lenguaje de gran tamaño ha impulsado el uso de agentes generativos en contextos corporativos, pero persistieron limitaciones de fidelidad factual y dependencia de conocimiento genérico. Las arquitecturas de Generación Aumentada por Recuperación (RAG) surgieron como solución para integrar bases de conocimiento externas. El estudio evaluó comparativamente diferentes metodologías de RAG aplicadas a la construcción de agentes generativos orientados a la atención automatizada de preguntas frecuentes. Para ello, se implementaron cinco arquitecturas distintas de RAG –clásica, con re-ranker, multi-hop, jerárquica y basada en agentes– sobre una base de conocimiento común y se evaluaron bajo condiciones controladas. La evaluación consideró métricas de fidelidad al contexto, relevancia de la respuesta, latencia y uso de tokens, utilizando juicios automatizados mediante el enfoque LLM-as-a-judge. Los resultados evidenciaron trade-offs estructurales entre calidad de las respuestas, costo computacional y tiempo de respuesta, indicando la ausencia de un enfoque universalmente superior. Notablemente, el método jerárquico ofreció el mejor compromiso entre rendimiento y costo computacional. Como contribución, la investigación ofreció un análisis comparativo sistemático que apoya decisiones técnicas y arquitectónicas en el diseño de agentes generativos basados en RAG para aplicaciones empresariales.
Palabras clave: Arquitectura; LLM; LLM-as-a-Judge; Recuperación.
1. Introducción
La evolución de los Modelos de Lenguaje Grandes (LLMs) ha transformado la interacción humana con sistemas computacionales, impulsando el desarrollo de agentes generativos en diversos contextos, notablemente en el entorno corporativo. Estos agentes están diseñados para simular la interacción textual humana y ejecutar comportamientos dirigidos a objetivos específicos, utilizando herramientas complementarias que les confieren autonomía (Park et al., 2023). Esta capacidad ha generado un valor significativo para empresas e individuos (Godbole et al., 2024; Yu et al., 2025; Manda, 2025; Borishetty et al., 2025).
En el sector de atención al cliente, la implementación de agentes generativos basados en LLMs ha sido adoptada como una alternativa eficaz para optimizar operaciones. Un estudio de caso en una empresa con cinco mil empleados demostró una reducción del 37,5% en el número de solicitudes de soporte tras la introducción de una solución de atención basada en inteligencia artificial generativa (Al-Osaimi et al., 2025). Esta aplicación tiene como objetivo disminuir los trasbordos a equipos humanos de nivel uno, al mismo tiempo que eleva la calidad y la consistencia de las respuestas proporcionadas a los usuarios.
Sin embargo, a pesar del potencial, los LLM enfrentan desafíos significativos, especialmente en dominios específicos. Uno de los principales problemas reside en la fidelidad factual de las respuestas y en la dependencia de conocimiento genérico obtenido durante el preentrenamiento, lo que puede resultar en información desactualizada o imprecisa para contextos de negocio que exigen conocimiento interno específico (Genesis, 2025). Esta limitación impide que los modelos proporcionen respuestas precisas a preguntas que demandan datos corporativos o especializados.
Para superar estas deficiencias, las arquitecturas de Recuperación Aumentada por Generación (RAG) emergen como una solución prometedora. La RAG combina mecanismos de búsqueda con modelos generativos, permitiendo la integración de bases de conocimiento externas al proceso de generación de respuestas. Este enfoque mejora el anclaje factual de las respuestas y facilita la adaptación a bases de conocimiento específicas, lo cual es crucial en entornos de soporte con alto volumen de preguntas que dependen de una base de conocimiento interna preestablecida (Gupta et al., 2024; Genesis, 2025).
A pesar de la eficacia de RAG, la construcción de estos sistemas implica la elección entre diversas estrategias, cada una con sus propios compromisos en términos de precisión, latencia y costo computacional (Genesis y Keane, 2025; Brontes et al., 2025). La proliferación de nuevas técnicas y la escasez de evaluaciones comparativas sistemáticas dificultan la toma de decisiones arquitectónicas fundamentadas para la construcción de agentes generativos. Esta brecha en el marco científico impide la selección de la metodología más adecuada para diferentes escenarios de aplicación.
Ante este escenario, la presente investigación se justifica por la necesidad de un análisis comparativo sistemático que pueda respaldar decisiones técnicas y arquitectónicas en el diseño de agentes generativos basados en RAG para aplicaciones empresariales. Con ello, el objetivo del trabajo es evaluar el rendimiento de diferentes metodologías de RAG aplicadas a la construcción de agentes generativos orientados a la atención automatizada de preguntas frecuentes, comparándolas a partir de las métricas faithfulness, latencia en la generación de las respuestas, uso de tokens, answer relevancy y context relevancy, buscando encontrar metodologías que ofrezcan un mejor costo-beneficio en cuanto a robustez técnica, costo operacional y calidad de las respuestas finales.
2. Material y Métodos
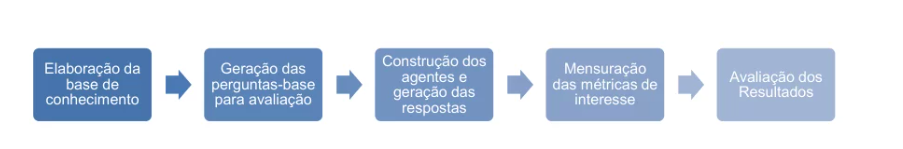
La investigación adoptada es de naturaleza aplicada y exploratoria, con el objetivo de comprender el funcionamiento de diferentes metodologías de Recuperación Aumentada por Generación (RAG) a través de la construcción de un algoritmo. El estudio se dividió en cuatro fases principales, como se ilustra en la Figura 1, con etapas realizadas múltiples veces para comparar las metodologías de RAG.
Figura 1. Pasos del proceso metodológico para la evaluación de múltiples metodologías de RAG.
Fuente: Resultados originales de la investigación
La ejecución de la investigación utilizó un entorno computacional configurado en Python, empleando bibliotecas como CrewAI para la construcción de agentes generativos y la reproducibilidad de los experimentos. Las bibliotecas utilizadas y sus roles se detallan en la Tabla 1.
Tabla 1. Bibliotecas utilizadas en el estudio
| Biblioteca | Versión | Papel en el estudio |
|---|---|---|
| openai | 1.0.0 | Interfaz con modelos (LLM y “embeddings”) provistos por OpenAI vía API. |
| antrópico | 0.34.0 | Interfaz con modelos de LLM provistos por Anthropic vía API. |
| crewai | 0.28.0 | Marco” agêntico utilizado. |
| faiss-cpu | 1.7.4 | Indexación y búsqueda vectorial de los “embeddings” de la base de conocimiento. |
| numpy | 1.24 | Manipulación y almacenamiento de los vectores numéricos generados por el modelo de “embeddings”. |
| pandas | 2.0 | Lectura, organización y almacenamiento de los datos experimentales. |
Fuente: Resultados originales de la investigación
El estudio, que maneja datos no estructurados (textos), realizó análisis cualitativos escalados a través de modelos de lenguaje, utilizados tanto en la generación como en la evaluación automatizada de las respuestas.
La base de conocimiento se construyó a partir del Manual de Instrucciones y Normas para Trabajos de Conclusión de Curso de la ESALQ/USP, en formato PDF. De este documento, se extrajeron y segmentaron 200 fragmentos textuales utilizando el modelo multimodal openai-gpt-5.2, a través de la plataforma “web”, con instrucciones estandarizadas para identificar unidades textuales semánticamente coherentes y mitigar sesgos. El “prompt” incluía un patrón de retorno combinado de pregunta y respuesta.
Después de la extracción, los fragmentos fueron reclasificados por un LLM en categorías inducidas de forma no supervisada, como Concepto, Proceso, Evaluación, Orientación, Proyecto de investigación, Metodología, Ética, Formato, Referencias, Figuras/tablas, Análisis, Conclusión, Resultados preliminares, TFG final, Defensa, Envío, Elementos pre-textuales, Elementos post-textuales, Apéndices, Citas, Post-defensa, Pruebas, Reconocimiento y Recursos.
El contenido de la base de conocimiento se transformó en vectores numéricos (“snippets”) utilizando el modelo text-embedding-3-small de OpenAI. Estos vectores se convirtieron a “float32” y se organizaron en un “array” de NumPy.
Se construyó un índice vectorial con FAISS, utilizando la estructura IndexFlatL2 para la similitud por distancia euclidiana (L2). El índice se pobló con los “embeddings” generados y se persistió en disco, manteniendo el mapeo entre la posición en el índice y el registro textual.
La recuperación vectorial base, común a todas las metodologías evaluadas, se implementó de forma determinista. Las consultas se convertían en vectores numéricos por el mismo modelo y se buscaban en el índice FAISS, devolviendo los 5 mejores resultados (“snippets”) por “Búsqueda de Vecinos Más Cercanos” (“Nearest Neighbor Search”).
Para evaluar las metodologías RAG, se generaron 200 preguntas con el modelo gemini-3-flash (a través de la plataforma “web”), a diferencia del modelo de creación de la base de conocimiento para evitar sesgos. Las preguntas se dividieron equitativamente en cuatro grupos, según la Tabla 2, para evaluar diferentes niveles de dependencia del mecanismo de recuperación.
Tabla 2. Clasificaciones de preguntas creadas para evaluación
| Clasificación | Definición | Ejemplo |
|---|---|---|
| Completamente relacionadas – “single-snippet” | Preguntas cuya respuesta puede ser obtenida íntegramente a partir de un único fragmento recuperado de la base de conocimiento. | ¿El TCC se puede realizar en grupo? |
| Completamente relacionadas – “multi-snippet” | Preguntas cuya respuesta exige la combinación de dos o más fragmentos recuperados de la base de conocimiento. | ¿Cuál es el peso del TCC en la media final y cómo la reprobación en él afecta la obtención del título? |
| Vinculadas parcialmente | Preguntas relacionadas con el contenido de la base, pero que requieren conocimiento adicional no presente en los fragmentos recuperados. | ¿Existe un límite de veces que puedo cambiar de orientador? |
| No relacionadas | Preguntas no relacionadas con el contenido de la base de conocimiento, no susceptibles de ser respondidas por el sistema RAG. | ¿Cómo aprender a tocar guitarra solo por internet? |
Fuente: Resultados originales de la investigación
Se construyeron múltiples agentes utilizando el “framework” CrewAI para implementar y comparar cinco estrategias de RAG: Clásica, Re-ranking, Multihop, Jerárquica y Agente, como se detalla en la Tabla 3. Para la comparabilidad, se mantuvieron constantes parámetros como la temperatura (0), el número máximo de fragmentos recuperados (5) y el modelo de lenguaje (openai-gpt-40-mini), así como “prompts” equivalentes.
Tabla 3. Estrategias de RAG para la generación de respuestas utilizadas
| Estrategia | Definición |
|---|---|
| Clásico | Se recuperan fragmentos relevantes mediante búsqueda vectorial y se proporcionan directamente como contexto para que un modelo de lenguaje genere la respuesta. |
| Reclasificación | Los fragmentos recuperados inicialmente por búsqueda vectorial pasan por una etapa adicional de reevaluación semántica para seleccionar los contextos más relevantes antes de la generación de la respuesta. |
| Multisalto | El sistema realiza múltiples etapas de recuperación, formulando preguntas intermedias sucesivas para recopilar información complementaria antes de producir la respuesta final. |
| Jerárquico | Organiza la base de conocimiento en niveles temáticos y restringe la búsqueda vectorial a los grupos de tópicos más relevantes para la pregunta, refinando el alcance de la recuperación. |
| Agéntico | Múltiples agentes especializados cooperan entre sí, distribuyendo tareas como el refinamiento de la pregunta, la recuperación de contexto y la síntesis de la respuesta en un flujo colaborativo de razonamiento. |
Fuente: Resultados originales de la investigación
El enfoque RAG Clásico integró directamente la recuperación vectorial con el modelo de generación. Se seleccionaron fragmentos semánticamente cercanos, se organizaron en bloques de contexto y se concatenaron para que el modelo de lenguaje generara la respuesta. Un único agente orquestó la búsqueda vectorial y la generación de la respuesta.
En RAG con Re-ranking, se agregó un paso intermedio. Después de la búsqueda vectorial inicial, los fragmentos se sometieron a una reevaluación semántica por un modelo de lenguaje (“cross-encoder”) para seleccionar los tres más pertinentes, que compusieron el contexto final. Un único agente gestionaba la búsqueda y el re-ranking.
El RAG “multi-hop” utilizó un mecanismo iterativo de recuperación. El modelo de lenguaje analizaba los fragmentos recuperados y, si era necesario, formulaba preguntas intermedias para obtener información complementaria. Este proceso podía repetirse hasta 3 interacciones, construyendo un contexto progresivo a partir de información dispersa.
El enfoque Jerárquico estructuró la base de conocimiento en grupos temáticos. Para cada pregunta, un modelo de lenguaje clasificaba el tema más probable, restringiendo la búsqueda vectorial a los fragmentos de ese grupo temático. Los fragmentos resultantes se organizaban y se proporcionaban al modelo generador.
El RAG basado en Agentes expandió la arquitectura a un sistema multiagente en el “framework” CrewAI. Agentes especializados asumieron roles como reformular la pregunta original, buscar y seleccionar fragmentos relevantes, y sintetizar la respuesta final. La interacción secuencial y coordinada entre agentes simuló un flujo colaborativo de razonamiento.
Durante la ejecución, se almacenaron datos como el contexto enviado, la estimación de “tokens” y la latencia. Las etapas de decisión, recuperación y reordenamiento fueron rastreadas por “logs” de “debug” para garantizar transparencia y reproducibilidad. Los flujos de agentes se ejecutaron de forma aislada, con mecanismos de liberación de memoria para evitar “state leakage”.
La evaluación de las metodologías consideró cinco métricas principales: “faithfulness” (fidelidad de la respuesta al contexto), “answer relevancy” (adecuación de la respuesta a la pregunta), “context relevancy” (calidad de los fragmentos recuperados), latencia (tiempo de procesamiento) y uso de “tokens” (consumo computacional). Las tres primeras métricas evalúan la calidad semántica e informacional, mientras que las dos últimas reflejan rendimiento y costo.
Las métricas de calidad (“faithfulness”, “answer relevancy”, “context relevancy”) se calcularon mediante el enfoque “LLM-as-a-judge”, utilizando el modelo claude-haiku-4-5-20251001, configurado con temperatura cero para juicios determinísticos y reproducibles, a fin de reducir sesgos. Los “prompts” de evaluación definieron criterios explícitos para puntuaciones normalizadas entre 0 y 1, acompañados de justificaciones textuales.
Las métricas operacionales de latencia y uso de “tokens” fueron medidas directamente por el “runner” de ejecución, utilizando “timestamps” del reloj del sistema para latencia y el consumo de “tokens” como “proxy” de costo computacional. Se implementó un mecanismo de “retry” para llamadas al evaluador, con hasta tres intentos adicionales y “backoff” exponencial (1, 2 y 4 segundos) en caso de errores transitorios.
3. Resultados y Discusión
Los resultados para la métrica de fidelidad indicaron una degradación progresiva en la fidelidad de las respuestas a medida que aumentaba la complejidad de las preguntas. Las preguntas totalmente relacionadas y respaldadas por un único fragmento presentaron los mayores niveles de adherencia factual, seguidas por aquellas que requerían múltiples fragmentos, preguntas parcialmente relacionadas y, por último, preguntas no relacionadas. Este patrón, detallado en la Tabla 4, sugiere que, a medida que las tareas demandan mayor capacidad de integración semántica o inferencia más allá del conocimiento explícitamente disponible, aumenta la probabilidad de desviaciones factuales en las respuestas generadas por los sistemas evaluados. Aunque muchos escenarios mostraron valores consistentes entre el primer (Q1) y el tercer cuartil (Q3), escenarios con alta variación y donde las respuestas podían ser generadas a partir de la base de conocimiento disponible pueden representar riesgos para la implementación corporativa y deben ser analizados caso por caso.
Tabla 4. Resultados para la métrica LLM-as-a-judge “faithfulness”
| Método RAG | Agrupación | Media | Q1 | La mediana | T3 |
|---|---|---|---|---|---|
| Agéntico | No relacionadas | 0.7 | 0.3 | 1.0 | 1.0 |
| Clásico | No relacionadas | 1.0 | 1.0 | 1.0 | 1.0 |
| Jerárquico | No relacionadas | 1.0 | 1.0 | 1.0 | 1.0 |
| Multisalto | No relacionadas | 0.5 | 0.0 | 0.5 | 1.0 |
| Reclasificación | No relacionadas | 1.0 | 1.0 | 1.0 | 1.0 |
| Agéntico | Vinculadas parcialmente | 0.8 | 0.5 | 1.0 | 1.0 |
| Clásico | Vinculadas parcialmente | 0.9 | 0.6 | 1.0 | 1.0 |
| Jerárquico | Vinculadas parcialmente | 0.9 | 1.0 | 1.0 | 1.0 |
| Multisalto | Vinculadas parcialmente | 0.8 | 0.5 | 1.0 | 1.0 |
| Reclasificación | Vinculadas parcialmente | 0.8 | 0.5 | 1.0 | 1.0 |
| Agéntico | “multi-fragmento” | 0.7 | 0.5 | 0.5 | 1.0 |
| Clásico | “multi-fragmento” | 0.7 | 0.5 | 0.5 | 1.0 |
| Jerárquico | “multi-fragmento” | 0.8 | 0.5 | 0.8 | 1.0 |
| Multisalto | “multi-fragmento” | 0.6 | 0.5 | 0.5 | 0.5 |
| Reclasificación | “multi-fragmento” | 0.7 | 0.5 | 0.5 | 1.0 |
| Agéntico | “fragmento-único” | 1.0 | 1.0 | 1.0 | 1.0 |
| Clásico | “fragmento-único” | 1.0 | 1.0 | 1.0 | 1.0 |
| Jerárquico | “fragmento-único” | 0.9 | 1.0 | 1.0 | 1.0 |
| Multisalto | “fragmento-único” | 1.0 | 1.0 | 1.0 | 1.0 |
| Reclasificación | “fragmento-único” | 1.0 | 1.0 | 1.0 | 1.0 |
Fuente: Resultados originales de la investigación.
Este patrón de degradación de la fidelidad fue consistente entre las diferentes metodologías de RAG, pero con intensidades variadas. Los enfoques más complejos, como las metodologías agéntica y multihop, mostraron una mayor propensión a la alucinación. En el enfoque multihop, esto puede atribuirse al encadenamiento sucesivo de consultas y respuestas intermediarias, que tiende a introducir ruido adicional y aumentar la probabilidad de generación de contenido no estrictamente fundamentado. La metodología agéntica, por su parte, exhibió una mayor variabilidad en las puntuaciones de fidelidad, posiblemente debido a la autonomía de los agentes y a la división de responsabilidades cognitivas, lo que puede llevar a respuestas más elaboradas incluso con fundamentación parcial o inexistente. Es crucial evaluar los casos de alucinación considerando el riesgo asociado al caso de uso, distinguiendo entre respuestas sin relación lógica de contenido y aquellas que, aunque no fundamentadas en la base interna, pueden ser correctas por el conocimiento del mundo. El estudio observó el segundo tipo de alucinación. En contraste, el enfoque jerárquico demostró una mayor robustez en la métrica de fidelidad, lo que se asocia al fuerte mecanismo de restricción contextual impuesto por la organización jerárquica de los documentos, limitando la exposición a contextos marginales.
El análisis conjunto de las métricas de fidelidad y relevancia de la respuesta, presentado en la Tabla 5, reveló un compromiso significativo entre la fidelidad factual y la utilidad percibida de las respuestas. Las metodologías con mayor propensión a la alucinación a menudo exhibieron puntuaciones más altas de relevancia de la respuesta. Esto sugiere que la libertad de extrapolar más allá del conocimiento recuperado explícitamente, aunque aumenta el riesgo de imprecisión, puede generar respuestas más útiles, especialmente cuando la base de conocimiento no contiene información directamente aplicable a la pregunta propuesta. Este hallazgo subraya la importancia del mantenimiento de las bases de conocimiento en los sistemas RAG e indica una relación inversamente proporcional entre la cobertura de la base y la necesidad de conocimiento externo por parte de los agentes de recuperación.
Tabla 5. Resultados para la métrica LLM-as-a-judge “answer relevancy”
| Método RAG | Agrupación | Media | Q1 | La mediana | T3 |
|---|---|---|---|---|---|
| Agéntico | No relacionadas | 0,5 | 0,0 | 0,3 | 1,0 |
| Clásico | No relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Jerárquico | No relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Multisalto | No relacionadas | 0,7 | 0,1 | 1,0 | 1,0 |
| Reclasificación | No relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Agéntico | Vinculadas parcialmente | 0,5 | 0,5 | 0,5 | 0,5 |
| Clásico | Vinculadas parcialmente | 0,6 | 0,5 | 0,5 | 0,9 |
| Jerárquico | Vinculadas parcialmente | 0,5 | 0,5 | 0,5 | 0,5 |
| Multisalto | Vinculadas parcialmente | 0,4 | 0,1 | 0,5 | 0,5 |
| Reclasificación | Vinculadas parcialmente | 0,6 | 0,5 | 0,5 | 0,9 |
| Agéntico | “multi-fragmento” | 0,9 | 0,6 | 1,0 | 1,0 |
| Clásico | “multi-fragmento” | 0,8 | 0,6 | 0,8 | 0,9 |
| Jerárquico | “multi-fragmento” | 0,8 | 0,8 | 0,9 | 1,0 |
| Multisalto | “multi-fragmento” | 0,9 | 1,0 | 1,0 | 1,0 |
| Reclasificación | “multi-fragmento” | 0,8 | 0,8 | 0,9 | 1,0 |
| Agéntico | “fragmento-único” | 1,0 | 1,0 | 1,0 | 1,0 |
| Clásico | “fragmento-único” | 1,0 | 1,0 | 1,0 | 1,0 |
| Jerárquico | “fragmento-único” | 0,9 | 1,0 | 1,0 | 1,0 |
| Multisalto | “fragmento-único” | 1,0 | 1,0 | 1,0 | 1,0 |
| Reclasificación | “fragmento-único” | 1,0 | 1,0 | 1,0 | 1,0 |
Fuente: Resultados originales de la investigación.
El efecto de mayor relevancia con menor fidelidad fue notable en el conjunto de preguntas no relacionadas, donde el enfoque multihop presentó una proporción significativa de respuestas útiles, incluso sin soporte factual directo de la base de conocimiento. En estos casos, la alta relevancia de la respuesta resultó del uso de conocimientos generales o inferencias implícitas del modelo. Esto demuestra que la utilidad percibida y la fidelidad factual son dimensiones complementarias, no necesariamente alineadas. La métrica de relevancia del contexto, presentada en la Tabla 6, reveló un comportamiento distinto de las métricas anteriores. Aunque hubo una degradación progresiva de la relevancia de los fragmentos recuperados con el aumento de la complejidad de las preguntas, no se observaron diferencias significativas entre las metodologías evaluadas. Esto sugiere que los mecanismos de recuperación, en las implementaciones estudiadas, convergieron a conjuntos de contexto semánticamente similares, independientemente de la arquitectura de RAG utilizada.
Tabla 6. Resultados para la métrica LLM-as-a-judge “context relevancy”
| Método RAG | Agrupación | Media | Q1 | La mediana | T3 |
|---|---|---|---|---|---|
| Agéntico | No relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Clásico | No relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Jerárquico | No relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Multisalto | No relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Reclasificación | No relacionadas | 0,0 | 0,0 | 0,0 | 0,0 |
| Agéntico | Vinculadas parcialmente | 0,3 | 0,0 | 0,3 | 0,5 |
| Clásico | Vinculadas parcialmente | 0,3 | 0,0 | 0,3 | 0,5 |
| Jerárquico | Vinculadas parcialmente | 0,3 | 0,0 | 0,3 | 0,5 |
| Multisalto | Vinculadas parcialmente | 0,3 | 0,0 | 0,3 | 0,5 |
| Reclasificación | Vinculadas parcialmente | 0,3 | 0,0 | 0,3 | 0,5 |
| Agéntico | “multi-fragmento” | 0,6 | 0,5 | 0,5 | 0,8 |
| Clásico | “multi-fragmento” | 0,6 | 0,5 | 0,5 | 0,8 |
| Jerárquico | “multi-fragmento” | 0,6 | 0,5 | 0,5 | 0,8 |
| Multisalto | “multi-fragmento” | 0,6 | 0,5 | 0,6 | 0,8 |
| Reclasificación | “multi-fragmento” | 0,6 | 0,5 | 0,5 | 0,8 |
| Agéntico | “fragmento-único” | 0,9 | 0,9 | 1,0 | 1,0 |
| Clásico | “fragmento-único” | 0,9 | 0,9 | 1,0 | 1,0 |
| Jerárquico | “fragmento-único” | 0,9 | 0,9 | 1,0 | 1,0 |
| Multisalto | “fragmento-único” | 0,9 | 0,9 | 1,0 | 1,0 |
| Reclasificación | “fragmento-único” | 0,9 | 0,9 | 1,0 | 1,0 |
Fuente: Resultados originales de la investigación.
La ausencia de una diferenciación relevante en la métrica de relevancia contextual no implica que todas las metodologías sean igualmente eficaces en términos de recuperación de contexto, sino que sugiere que las estrategias aplicadas pueden no haber sido suficientemente distintas o necesarias para producir separaciones medibles. Tres factores pueden haber contribuido a este escenario: la estructura de la base de conocimiento, que era un manual de normas altamente delimitado, favoreciendo recuperaciones precisas; la naturaleza de las preguntas generadas, que, a pesar de provenir de otro modelo de lenguaje, mantenían una alta relación semántica con la base para preguntas totalmente relacionadas; y el cuello de botella en el top-K de cinco fragmentos recuperados, que pudo haber limitado la capacidad de profundización de técnicas como multihop y re-ranking, enfocadas en bases de conocimiento extensas. Este resultado sugiere la necesidad de futuras investigaciones con técnicas más sofisticadas de generación de preguntas y recuperación.
En cuanto a la latencia, los resultados, detallados en la Tabla 7, reflejaron la complejidad computacional inherente a cada metodología. El método clásico demostró los menores tiempos de respuesta debido a su simplicidad arquitectónica y al menor número de pasos, siendo ideal para preguntas simples donde la latencia es un factor crítico. Por otro lado, metodologías más elaboradas, como el re-ranking, presentaron latencias sustancialmente superiores, incluso para preguntas de baja complejidad. Esto indica que el costo computacional adicional introducido por pasos intermedios puede no ser compensado en todos los escenarios, sugiriendo la adecuación de diferentes metodologías de RAG para tipos específicos de preguntas y la posibilidad de pipelines híbridos en entornos productivos.
Tabla 7. Resultados para la métrica de latencia en la generación de la respuesta
| Método RAG | Agrupación | Media | Q1 | La mediana | T3 |
|---|---|---|---|---|---|
| Agéntico | No relacionadas | 10,3 | 7,7 | 8,4 | 12,4 |
| Clásico | No relacionadas | 3,2 | 2,5 | 2,6 | 3,7 |
| Jerárquico | No relacionadas | 4,2 | 3,5 | 3,9 | 5,0 |
| Multisalto | No relacionadas | 9,3 | 6,3 | 8,5 | 12,5 |
| Reclasificación | No relacionadas | 17,0 | 8,8 | 14,2 | 15,3 |
| Agéntico | Vinculadas parcialmente | 7,0 | 5,7 | 6,6 | 7,3 |
| Clásico | Vinculadas parcialmente | 3,1 | 2,5 | 2,7 | 3,2 |
| Jerárquico | Vinculadas parcialmente | 4,3 | 3,3 | 4,0 | 4,9 |
| Multisalto | Vinculadas parcialmente | 6,4 | 5,8 | 6,1 | 6,4 |
| Reclasificación | Vinculadas parcialmente | 10,3 | 8,0 | 8,6 | 9,0 |
| Agéntico | “multi-fragmento” | 8,4 | 7,8 | 8,3 | 8,9 |
| Clásico | “multi-fragmento” | 5,5 | 3,2 | 3,8 | 4,2 |
| Jerárquico | “multi-fragmento” | 4,2 | 3,9 | 4,1 | 4,7 |
| Multisalto | “multi-fragmento” | 8,3 | 7,8 | 8,2 | 8,8 |
| Reclasificación | “multi-fragmento” | 9,5 | 8,7 | 9,6 | 10,0 |
| Agéntico | “fragmento-único” | 5,9 | 5,3 | 5,4 | 6,0 |
| Clásico | “fragmento-único” | 2,8 | 2,6 | 2,8 | 3,0 |
| Jerárquico | “fragmento-único” | 3,7 | 3,2 | 3,4 | 4,2 |
| Multisalto | “fragmento-único” | 5,5 | 5,3 | 5,4 | 5,5 |
| Reclasificación | “fragmento-único” | 8,1 | 7,6 | 8,0 | 8,5 |
Fuente: Resultados originales de la investigación.
El análisis del consumo de tokens en el prompt, presentado en la Tabla 8, reveló que los enfoques multihop y agéntico consumieron aproximadamente el doble de tokens en comparación con las demás metodologías. Este elevado consumo refleja la necesidad de mantener historiales de interacción más extensos, múltiples contextos intermedios o instrucciones adicionales a lo largo del proceso de generación. Aunque asociado a una mayor flexibilidad cognitiva de estos enfoques, este aumento en el costo operativo impone limitaciones de escalabilidad y viabilidad económica, especialmente en aplicaciones de gran escala donde la latencia y el costo por solicitud son factores críticos de decisión arquitectónica.
Tabla 8. Resultados para la métrica de consumo de tokens en el prompt
| Método RAG | Agrupación | Media | Q1 | La mediana | T3 |
|---|---|---|---|---|---|
| Agéntico | No relacionadas | 2065 | 1089 | 2010 | 2510 |
| Clásico | No relacionadas | 783 | 585 | 590 | 1039 |
| Jerárquico | No relacionadas | 785 | 688 | 702 | 716 |
| Multisalto | No relacionadas | 2290 | 1216 | 1257 | 3013 |
| Reclasificación | No relacionadas | 3596 | 718 | 1517 | 1580 |
| Agéntico | Vinculadas parcialmente | 1002 | 912 | 931 | 1007 |
| Clásico | Vinculadas parcialmente | 667 | 593 | 603 | 609 |
| Jerárquico | Vinculadas parcialmente | 778 | 694 | 712 | 725 |
| Multisalto | Vinculadas parcialmente | 1247 | 1234 | 1249 | 1258 |
| Reclasificación | Vinculadas parcialmente | 903 | 719 | 730 | 750 |
| Agéntico | “multi-fragmento” | 1028 | 995 | 1028 | 1057 |
| Clásico | “multi-fragmento” | 1851 | 620 | 629 | 647 |
| Jerárquico | “multi-fragmento” | 728 | 705 | 739 | 765 |
| Multisalto | “multi-fragmento” | 1287 | 1255 | 1301 | 1310 |
| Reclasificación | “multi-fragmento” | 765 | 756 | 761 | 768 |
| Agéntico | “fragmento-único” | 936 | 891 | 914 | 961 |
| Clásico | “fragmento-único” | 597 | 589 | 592 | 597 |
| Jerárquico | “fragmento-único” | 729 | 602 | 666 | 726 |
| Multisalto | “fragmento-único” | 1273 | 1234 | 1261 | 1295 |
| Reclasificación | “fragmento-único” | 724 | 715 | 718 | 728 |
Fuente: Resultados originales de la investigación.
La Figura 1 presenta un análisis consolidado de las métricas, revelando las diferencias en el equilibrio entre la calidad de las respuestas y la eficiencia computacional entre los métodos evaluados. El método Jerárquico demostró el rendimiento más equilibrado, combinando altos niveles de faithfulness con valores relativamente elevados de answer relevancy y buena eficiencia en las métricas de consumo de tokens. El método Clásico destacó por su baja latencia, manteniendo niveles competitivos de fidelidad y consumo de tokens, lo que lo convierte en una alternativa eficiente cuando el tiempo de respuesta es un factor crítico. El método Agéntico obtuvo un buen rendimiento en la calidad de respuesta, particularmente en answer relevancy, pero presentó penalizaciones en las métricas de costo computacional, como latencia y consumo de tokens. El método multihop mostró un rendimiento similar al Agéntico en relevancia de la respuesta, pero con menor eficiencia computacional general. Finalmente, el método de Re-ranking presentó resultados más modestos en el conjunto de las métricas analizadas, sobre todo en latencia y relevancia de la respuesta. Considerando simultáneamente calidad y eficiencia, los resultados consolidados del estudio sugieren que el método Jerárquico ofrece el mejor compromiso entre rendimiento y costo computacional en el contexto evaluado.
Figura 1. Análisis comparativo de las métricas entre los diferentes métodos
Fuente: Resultados originales de la investigación.
Los resultados de este estudio indicaron que no existe una metodología de RAG universalmente superior en todas las dimensiones analizadas. Las diferentes arquitecturas evaluadas presentaron comportamientos distintos en las métricas de fidelidad, relevancia de la respuesta, relevancia del contexto, latencia y consumo de tokens, revelando la existencia de compensaciones estructurales entre fidelidad factual, utilidad percibida, costo computacional y rendimiento operativo, especialmente cuando se evalúan desde la perspectiva de diferentes estilos de preguntas. Los enfoques más flexibles, como multihop y agéntico, tendieron a producir respuestas más relevantes, especialmente para preguntas en las que la base de conocimiento no ofrecía soporte directo, lo que puede ser útil cuando la cobertura del conocimiento aún no está consolidada. Sin embargo, esta ganancia en relevancia de la respuesta se produjo a costa de una mayor propensión a la extrapolación no anclada en el contexto recuperado, manifestándose en un mayor riesgo de alucinación factual, mayor latencia y un consumo significativamente superior de tokens. En contraste, las metodologías más restrictivas, como el enfoque jerárquico y el método clásico, demostraron un mayor control sobre la fidelidad factual y un mejor rendimiento operativo, aunque con menor capacidad de extrapolación en preguntas complejas o poco relacionadas. Estos hallazgos refuerzan que las métricas de calidad en los sistemas de RAG no deben analizarse de forma aislada, sino como dimensiones complementarias que reflejan objetivos de diseño distintos. La adopción de sistemas de RAG en entornos productivos debe ponderar la precisión, utilidad, costo, latencia y robustez contra la alucinación, evaluando la tolerancia a la extrapolación según el contexto de negocio. Las arquitecturas híbridas, capaces de seleccionar dinámicamente la metodología más adecuada al tipo de pregunta, pueden ser un camino prometedor para equilibrar estas compensaciones.
4. Conclusión
El presente estudio evaluó comparativamente el rendimiento de diferentes metodologías de Recuperación Aumentada por Generación (RAG) en la construcción de agentes generativos para la atención automatizada de preguntas frecuentes. Se observó que no existe un enfoque universalmente superior, sino compensaciones estructurales entre la calidad de las respuestas, el costo computacional y el rendimiento operativo. Se observó que la fidelidad factual de las respuestas se degradó con el aumento de la complejidad de las preguntas, siendo más acentuada en metodologías como la agéntica y la multi-hop, que también presentaron mayor propensión a la alucinación. En contrapartida, se notó que la relevancia de la respuesta, especialmente para preguntas sin soporte directo en la base de conocimiento, frecuentemente se elevó a costa de la fidelidad. La metodología jerárquica demostró el mejor compromiso entre rendimiento y costo computacional, mientras que el método clásico se destacó por su baja latencia, siendo eficiente para preguntas más simples. La principal contribución de la investigación reside en la oferta de un análisis comparativo sistemático que subsidia decisiones técnicas y arquitectónicas en el diseño de agentes generativos basados en RAG para aplicaciones empresariales.
A pesar de los hallazgos, el análisis de la relevancia del contexto no reveló diferencias significativas entre las metodologías, un resultado que pudo haber sido influenciado por la naturaleza altamente delimitada de la base de conocimiento, la alta relación semántica de las preguntas generadas y el cuello de botella impuesto por el límite de cinco fragmentos recuperados. Tales factores sugieren que las estrategias de recuperación pueden no haber sido suficientemente probadas en su capacidad de diferenciación. Para futuras investigaciones, se recomienda la exploración de técnicas más sofisticadas de generación de preguntas y recuperación, como el re-ranking semántico profundo y la expansión adaptativa de consultas. Se sugiere también la evaluación de estrategias adaptativas que consideren el nivel de confianza del sistema y la cobertura de la base de conocimiento, con el objetivo de ampliar la capacidad de generalización y la confiabilidad de los agentes generativos basados en RAG. La implementación de arquitecturas híbridas, capaces de seleccionar dinámicamente la metodología más adecuada al tipo de pregunta, emerge como un camino prometedor para equilibrar los trade-offs identificados entre precisión, utilidad, costo, latencia y robustez contra la alucinación en entornos productivos.
Referencias Bibliográficas
Al-Osaimi, M; Altuwayrah, A.; Khan, H.; Rahman, Abdul. 2025. Transforming Support Efficiency in Exploration: A Combined GenAI Models Solution for improved Application Support. Disponível em: https://doi.org/10.2118/227054-MS. Acesso em: 25 out. 2025.
Genesis, J. 2025. Retrieval-Augmented Text Generation: Methods, Challenges, and Applications. Disponível em:
Park, J. S.; O’Brien, J. C.; Cai, C. J.; Morris, M. R.; Liang, P.; Bernstein, M. S. 2023. Generative Agents: Interactive Simulacra of Human Behavior. Disponível em: . Acesso em: 30 abr. 2025.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haga clic aquí y acceda a la plataforma MBX Academy