
16 de septiembre de 2026
Aplicación de Aprendizaje Automático en el Análisis y Clasificación de Datos Paleomagnéticos del Cráton São Francisco
Oscar Andres Lazcano Patroni; João Vitor Matos Gonçalves
DOI: 10.22167/2675-6528-202602300
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
Los datos paleomagnéticos son cruciales para las reconstrucciones paleogeográficas; sin embargo, la dispersión direccional y las remagnetizaciones dificultan la obtención de promedios fiables. Se evaluó el potencial de las técnicas de aprendizaje automático no supervisado en el análisis e interpretación de datos paleomagnéticos del Cratón São Francisco, con enfoque en las formaciones Tonalito Itarerú y Sienito Itiúba, con el objetivo de mejorar la determinación de direcciones medias. Se compararon los algoritmos DBSCAN, K-means y Gaussian Mixture Model (GMM), utilizando el método del codo, AIC y BIC para la selección de parámetros. El DBSCAN destacó en la detección de regiones densas y valores atípicos, aunque sensible a los hiperparámetros. El K-means proporcionó una segmentación inicial, pero sin una definición clara del número óptimo de grupos. El GMM demostró mayor flexibilidad y asignación probabilística, con diferencias poco expresivas entre modelos. Los métodos produjeron resultados complementarios, revelando patrones direccionales plausibles. Se concluyó que la integración entre aprendizaje automático, estadística clásica e interpretación geológica es un enfoque prometedor para el análisis exploratorio paleomagnético, siendo recomendable ampliar las bases de datos y adoptar enfoques de estadística direccional.
Palabras clave: Análisis Exploratorio de Datos; Aprendizaje Automático; Clusterización; DBSCAN; K-means.
1. Introducción
Los datos paleomagnéticos constituyen la principal fuente de información para las reconstrucciones paleogeográficas. Esto se debe a que el paleomagnetismo es la única herramienta geofísica capaz de anclar la posición de las placas tectónicas en relación con el eje de rotación de la Tierra a lo largo del tiempo geológico (Butler, 1992; Tauxe, 2010; Torsvik et al., 2008). Las reconstrucciones paleogeográficas precisas son esenciales no solo para comprender los procesos geodinámicos, sino también para estudios sobre la dinámica climática del pasado (Donnadieu et al., 2006), la distribución paleobiogeográfica de fósiles (Middlemiss, 1979) y la posición absoluta de masas continentales y oceánicas, fundamentales para restringir modelos numéricos paleoclimáticos (Herold et al., 2008; Hollis et al., 2019).
Las direcciones paleomagnéticas forman la base de los estudios paleomagnéticos, y los enfoques estadísticos para su análisis han evolucionado significativamente en las últimas dos décadas, con avances que van desde el análisis de direcciones individuales hasta el estudio de agrupaciones direccionales (Heslop y Roberts, 2016; Tauxe et al., 2004; Vaes et al., 2021; Heslop et al., 2023). Sin embargo, la utilidad de estos datos depende de la capacidad de determinar con precisión la edad de la remanencia magnética. Aunque las pruebas de campo clásicas, como las de contacto cocido, de conglomerado y de pliegue, pueden identificar remagnetizaciones, los mecanismos responsables no siempre se comprenden bien. Esta incertidumbre dificulta la determinación de la edad, haciendo que los datos en bases de datos paleomagnéticas globales (GPMDB; Pisarevsky et al., 2022) sean prácticamente inútiles para reconstrucciones paleogeográficas sin la correcta identificación de sus orígenes y edades.
La determinación de direcciones mediante los métodos de desmagnetización alternada (AF) y térmica (TD) ha demostrado ser eficaz en la separación de las componentes de magnetización de la magnetización remanente natural (MRN) y en la obtención de direcciones consistentes. Sin embargo, en algunos casos, las direcciones medias calculadas para sitios específicos de las formaciones Tonalito Itarerú y Sienito Itiúba, ambas ubicadas en la región noreste del Cráton São Francisco, en el estado de Bahía, no presentan la misma coherencia. La determinación de estas direcciones medias puede ser particularmente desafiante, incluso con la consolidación de los métodos paleomagnéticos.
Una alternativa aún poco explorada para superar estas limitaciones es el uso de herramientas de aprendizaje estadístico, capaces de identificar patrones complejos y no lineales en grandes conjuntos de datos. El aprendizaje automático (machine learning) es un subcampo de la inteligencia artificial que emplea métodos matemáticos y estadísticos para que los sistemas computacionales aprendan patrones a partir de datos, mejorando el rendimiento en tareas específicas sin programación explícita (Bishop, 2006; Hastie et al., 2009; Murphy, 2012). En geociencias, el aprendizaje automático se ha aplicado para tratar e interpretar grandes volúmenes de datos, incluyendo datos geofísicos, geoquímicos y paleomagnéticos (Gwirtz et al., 2022; Dallanave, 2024; Gallo et al., 2025). Específicamente, el aprendizaje no supervisado busca identificar estructuras internas, patrones o agrupaciones naturales en datos sin etiquetas, siendo útil para análisis exploratorios y clusterización de datos paleomagnéticos. A pesar del potencial prometedor, los desafíos en la adquisición de datos en paleomagnetismo dificultan la generación de bases de datos extensas y de alta calidad, manteniendo el potencial del aprendizaje automático ampliamente inexplorado en este campo.
Ante este escenario, la integración de enfoques innovadores, como el aprendizaje automático, con la estadística clásica y la interpretación geológica, surge como una estrategia prometedora para mejorar el análisis exploratorio paleomagnético y la fiabilidad de los datos utilizados en reconstrucciones paleogeográficas. El presente trabajo tiene como objetivo investigar el uso de técnicas de aprendizaje automático mediante el uso de métodos no supervisados en el análisis e interpretación de datos paleomagnéticos, con foco en la mejora de la determinación de direcciones medias en formaciones geológicas del Cráton São Francisco, específicamente en las unidades Tonalito Itarerú y Sienito Itiúba, localizadas en el estado de Bahía.
2. Material y Métodos
Paleomagnetismo
Se extrajeron 253 testigos cilíndricos orientados de 26 localidades del plutón de Itareru, utilizando una perforadora portátil a gasolina equipada con brocas de diamante de 25,4 mm de diámetro. De estas localidades, 14 sitios corresponden a facies granodioríticas, 8 a facies tonalíticas y 4 a unidades del basamento. Se recolectaron al menos ocho testigos orientados por sitio, con la orientación realizada por un dispositivo Pomeroy (ASC Scientific, EE. UU.), acoplado a brújulas Brunton y solar. De manera análoga, se recolectaron 348 especímenes de 45 sitios del Sienito Itiúba, provenientes de tres conjuntos litológicos distintos: (i) sienitas predominantemente leucocráticas e hipersolvus, que contienen diópsido, hornblenda y biotita; (ii) capas de apatita-diópsido; y (iii) diques de granito alcalino.
Los testigos se cortaron en especímenes de 22,0 × 25,4 mm, obteniéndose al menos dos o tres especímenes por testigo. Para el Tonalito Itareru, se obtuvieron 770 especímenes, de los cuales 253 fueron seleccionados para análisis paleomagnéticos. Para el Sienito Itiúba, se obtuvieron 1460 especímenes, con 222 utilizados para análisis.
Los especímenes fueron sometidos a tratamientos térmicos y desmagnetización por campo magnético alterno (AF) en etapas sucesivas para aislar la magnetización remanente característica. La desmagnetización por campo alterno se realizó con pulsos de 2,0 mT, 2,5 mT, 5 mT o 10 mT, hasta aproximadamente 100 mT, utilizando un desmagnetizador AF Molspin o un desmagnetizador AF AD-D2000T (ASC Scientific, EE. UU.). La desmagnetización térmica se llevó a cabo en un horno de cámara doble ASC TD-60, con incrementos de 100 °C (entre 100 °C y 500 °C) y de 25 °C (por encima de 500 °C). Las mediciones de magnetización remanente se obtuvieron con un magnetómetro rotacional Agico JR-6A (AGICO, República Checa). Todos los procedimientos de laboratorio se realizaron en el Laboratorio de Anisotropías de Susceptibilidad Magnética y Magnetismo de Rocas de la Universidad de São Paulo (LAMS-IGc-USP).
La dirección de magnetización de cada espécimen se determinó mediante el método de análisis de componentes principales (Kirschvink, 1980), utilizando ajustes por mínimos cuadrados para rectas y planos, y proporcionando la desviación angular máxima (MAD) como medida de incertidumbre. Las direcciones de magnetización en cada etapa de desmagnetización se analizaron mediante proyecciones ortogonales en diagramas de Zijderveld (1967) utilizando el software Agico Remasoft 3.0 (Chadima y Hrouda, 2007).
Tras la determinación de las direcciones individuales, se calculó la media vectorial para obtener la dirección media de magnetización del sitio, correspondiente a la Magnetización Remanente Característica (ChRM). Las direcciones de magnetización fueron tratadas estadísticamente basándose en la estadística de Fisher (1953), que describe la distribución angular de las direcciones en torno a la media. El parámetro de precisión (k) se estimó mediante la ecuación (1):
k = (N-1) / (N-R)
donde N es el número de direcciones y R es el módulo del vector resultante de la suma vectorial de estas direcciones. El límite de confianza a95 fue aproximado por la ecuación (2):
a95 = 140 / raíz cuadrada(kN)
El Polo Geomagnético Virtual
El Polo Geomagnético Virtual (PGV) se calculó con base en las coordenadas geográficas del sitio muestreado y en la dirección media de magnetización remanente característica (ChRM). El análisis estadístico de los PGVs se realizó con base en la estadística de Fisher (1953), permitiendo la determinación de polos medios y de sus respectivos parámetros de precisión y límites de confianza (A95).
Machine Learning
En aplicaciones en geociencias, el aprendizaje automático se ha utilizado para el tratamiento e interpretación de grandes volúmenes de datos, incluidos datos paleomagnéticos. En este proyecto, se buscó desarrollar un modelo estadístico para clasificar y agrupar los conjuntos de datos paleomagnéticos disponibles para el Sienito Itiúba y Tonalito Itarerú. Para ello, se adoptó el algoritmo de clusterización DBSCAN (Ester et al., 1996) como principal método de análisis. Complementariamente, el rendimiento del DBSCAN se comparó con otros algoritmos de aprendizaje no supervisado, incluyendo k-means y Gaussian Mixture Model (GMM).
Agrupamiento Espacial Basado en Densidad de Aplicaciones con Ruido – DBSCAN
El DBSCAN es un algoritmo de aprendizaje no supervisado fundamentado en la densidad local de las observaciones, capaz de identificar agrupaciones en conjuntos de datos con un número de grupos desconocido y presencia de outliers. Su funcionamiento depende de dos hiperparámetros: el radio de vecindad ɛ (épsilon) y el número mínimo de observaciones vecinas (min_samples). La vecindad ɛ de un punto xᵢ se define como el conjunto de observaciones xⱼ cuya distancia d(xᵢ, xⱼ) es menor o igual a ɛ, según la ecuación (3):
Nɛ(xᵢ) = {xⱼ ∈ X | d(xᵢ, xⱼ) ≤ ɛ}
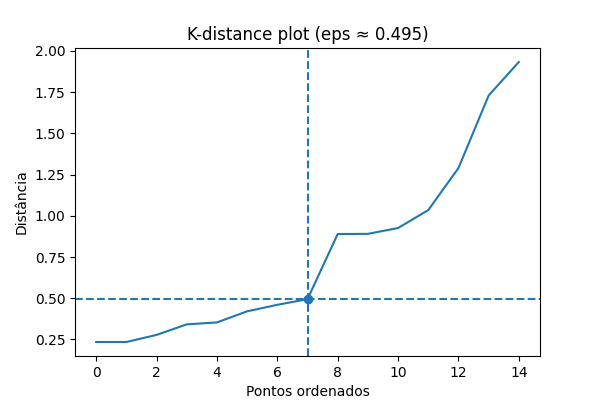
Con base en estos criterios, el algoritmo distingue puntos centrales (poseen al menos min_samples vecinos dentro del radio ɛ), puntos de borde (no satisfacen el criterio de densidad, pero pertenecen a la vecindad de un punto central) y puntos de ruido (no pertenecen a ninguna región densa). La elección del parámetro ɛ es crítica y fue estimada a partir del punto de inflexión de la curva del gráfico de distancias al (k)-ésimo vecino (k-distance plot), procedimiento conocido como método del codo (elbow method), donde ɛ ≈ arg max (d²y / dx²). El parámetro min_samples fue elegido en función de la dimensionalidad de los datos, con valores entre 4 y 6 frecuentemente adoptados como referencia inicial.
3. Resultados y Discusión
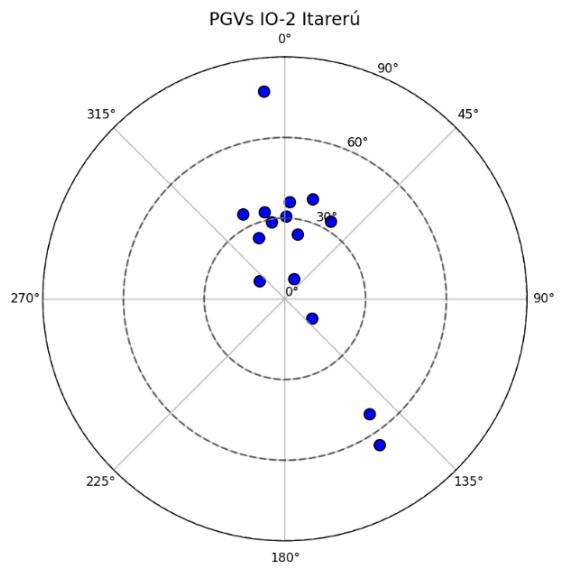
La aplicación de los algoritmos de clusterización a los datos paleomagnéticos del sitio IO-2 del Tonalito Itareru permitió identificar patrones de agrupamiento con diferentes niveles de consistencia y sensibilidad a los parámetros adoptados. Las direcciones de los Polos Geomagnéticos Virtuales del sitio IO-2, Itarerú, se presentan en la Figura 1.
Figura 1. Direcciones de los Polos Geomagnéticos Virtuales del sitio IO2, Itarerú.
Fuente: Resultados originales de la investigación.
La utilización del DBSCAN, con el parámetro ɛ estimado a partir del gráfico de k-distancia (Figura 2), resultó en la identificación de agrupaciones asociadas a regiones de mayor densidad en el espacio de atributos. Este método demostró ser eficaz en la separación de puntos potencialmente discrepantes, clasificados como ruido, lo que es particularmente relevante en datos paleomagnéticos sujetos a remagnetizaciones o incertidumbres experimentales. Sin embargo, la cantidad de puntos clasificados como ruido reveló sensibilidad a la elección de ɛ y min_samples, reflejando la limitación impuesta por el reducido número de observaciones disponibles.
Figura 2. Distribución de las distancias al k-ésimo vecino en función de los puntos ordenados (k-distance plot), utilizada para la determinación del parámetro ɛ en el algoritmo DBSCAN. El punto de inflexión de la curva (método del codo), estimado por análisis de curvatura, indica la transición entre regiones densas y dispersas del conjunto de datos.
Fuente: Resultados originales de la investigación.
Para el K-means, la aplicación del método del codo (Figura 3) indicó valores plausibles para el número de clústeres, aunque la curva de inercia no presentó un punto de inflexión fuertemente definido. Esto sugiere que la estructura de agrupamiento de los datos no está claramente particionada en conjuntos bien separados bajo la métrica euclidiana adoptada. A pesar de ello, el K-means proporcionó una segmentación inicial de los datos, útil como referencia comparativa, pero limitada por la suposición de clústeres aproximadamente esféricos y por la ausencia de tratamiento explícito de valores atípicos.
Figura 3. Variación de la inercia intraclúster en función del número de clústeres (k) para el algoritmo K-means. El punto de inflexión de la curva (método del codo) indica la estimación del número óptimo de agrupaciones.
Fuente: Resultados originales de la investigación.
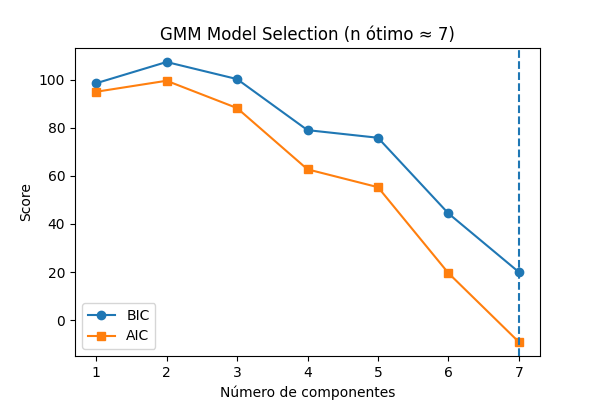
En el caso del Modelo de Mezcla Gaussiana (GMM), el análisis basado en los criterios AIC y BIC indicó soluciones con diferentes números de componentes (Figura 4), siendo el BIC más conservador en la elección del modelo. Los resultados evidenciaron la capacidad del GMM para ajustar distribuciones con mayor flexibilidad geométrica, permitiendo la identificación de agrupaciones con varianzas y orientaciones distintas. La asignación probabilística de pertenencia a los clusters proporcionó una medida adicional de incertidumbre asociada a cada observación. Sin embargo, debido al tamaño reducido del conjunto de datos, las diferencias entre los valores de AIC y BIC para diferentes modelos fueron relativamente pequeñas, lo que limitó la robustez de la selección del número óptimo de componentes.
Figura 4. Comparación de los criterios de información de Akaike (AIC) y Bayesiano (BIC) en función del número de componentes del modelo de mezclas gaussianas (GMM). El mínimo de las curvas indica el modelo más adecuado considerando el compromiso entre ajuste y complejidad.
Fuente: Resultados originales de la investigación.
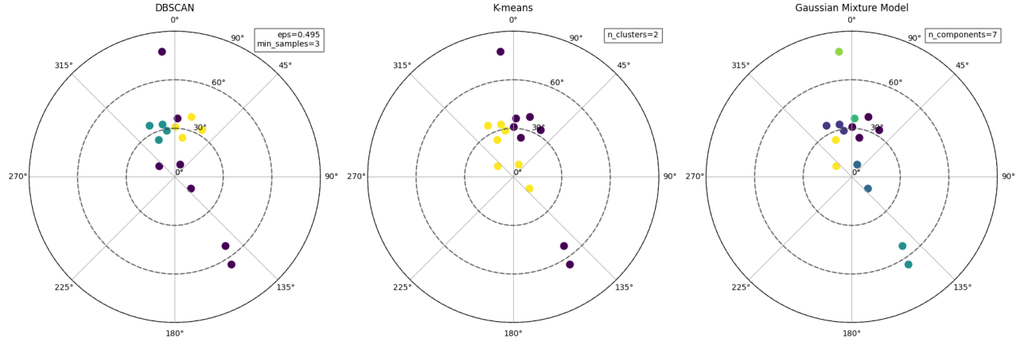
El comparativo de los resultados para los algoritmos DBSCAN, K-means y GMM, y los respectivos clusters formados, se presenta en la Figura 5. En general, los tres métodos presentaron resultados complementarios. El DBSCAN se destacó en la identificación de regiones densas y en la detección de posibles outliers; el K-means proporcionó una segmentación simple y de fácil interpretación; y el GMM presentó mayor capacidad de adaptación a la estructura de los datos. Sin embargo, ninguno de los métodos, aisladamente, fue capaz de proporcionar una solución inequívoca, reflejando tanto la complejidad de los datos paleomagnéticos como las limitaciones estadísticas asociadas al tamaño de la muestra.
Figura 5. Comparación de los resultados para los algoritmos DBSCAN, K-means y GMM y respectivamente los clusters formados.
Fuente: Resultados originales de la investigación.
El análisis visual de los estereogramas resultó esencial para la validación de los resultados, permitiendo verificar la coherencia geométrica de los agrupamientos identificados. En diversos casos, se observó que los clusters definidos por los algoritmos correspondían a concentraciones direccionales plausibles, aunque con superposición parcial, lo que puede indicar la presencia de múltiples eventos de magnetización o dispersión natural de los datos.
Los resultados obtenidos demuestran que la aplicación de técnicas de machine learning no supervisado en datos paleomagnéticos constituye un enfoque prometedor para la identificación de patrones direccionales y para el soporte a la determinación de direcciones medias. La utilización combinada de DBSCAN, K-means y Gaussian Mixture Model, aliada a criterios cuantitativos como el método del codo y los criterios AIC/BIC, permitió explorar diferentes aspectos de la estructura de los datos, evidenciando la complementariedad de estos enfoques.
Sin embargo, el análisis también evidenció limitaciones importantes. El tamaño reducido del conjunto de datos (n ≈ 15) comprometió la estabilidad de las estimaciones de parámetros y dificultó la identificación robusta del número de clusters o componentes. Adicionalmente, la dependencia de los resultados en relación con la elección de los hiperparámetros, particularmente en el caso del DBSCAN, refuerza la necesidad de enfoques cuidadosos y de la utilización de múltiples criterios de validación.
Otro aspecto relevante es la naturaleza direccional de los datos paleomagnéticos. El uso de métricas euclidianas en un espacio transformado constituye una aproximación que puede introducir distorsiones en la evaluación de la similitud entre direcciones. En este sentido, los métodos basados en estadística direccional, como aquellos fundamentados en la distribución de Fisher o en mezclas de distribuciones esféricas, presentan mayor consistencia física y deben ser considerados en desarrollos futuros.
De esta forma, los métodos de clusterización analizados son herramientas útiles para el análisis exploratorio y pueden contribuir a la identificación de poblaciones paleomagnéticas distintas, especialmente cuando se utilizan de forma integrada. Sin embargo, su aplicación debe ir acompañada de validación visual (mediante estereogramas), análisis estadístico clásico e interpretación geológica, a fin de garantizar la fiabilidad de los resultados. La integración entre machine learning y estadística paleomagnética tradicional representa un camino prometedor para el avance de las interpretaciones paleogeográficas y para la mejora del análisis de datos paleomagnéticos.
4. Conclusión
El presente estudio investigó el potencial de técnicas de aprendizaje automático no supervisado en el análisis e interpretación de datos paleomagnéticos del Cráton São Francisco, con foco en las formaciones Tonalito Itarerú y Sienito Itiúba, buscando mejorar la determinación de direcciones medias. Se verificó que los algoritmos DBSCAN, K-means y Gaussian Mixture Model (GMM) produjeron resultados complementarios. El DBSCAN se destacó en la identificación de regiones densas y en la detección de posibles valores atípicos, aunque se notó su sensibilidad a los hiperparámetros. El K-means proporcionó una segmentación inicial de los datos, mientras que el GMM demostró mayor flexibilidad y capacidad de asignación probabilística a los agrupamientos. El análisis visual de los estereogramas confirmó la coherencia geométrica de los agrupamientos identificados, revelando patrones direccionales plausibles. Se concluyó que la integración entre aprendizaje automático, estadística clásica e interpretación geológica representa un enfoque prometedor para el análisis exploratorio paleomagnético, contribuyendo a la fiabilidad de los datos utilizados en reconstrucciones paleogeográficas.
Sin embargo, la investigación enfrentó limitaciones importantes, como el tamaño reducido del conjunto de datos, que comprometió la estabilidad de las estimaciones de parámetros y dificultó la identificación robusta del número de clústeres. La dependencia de los resultados con respecto a la elección de los hiperparámetros, especialmente en DBSCAN, refuerza la necesidad de enfoques cuidadosos y de múltiples criterios de validación. Adicionalmente, la utilización de métricas euclidianas en un espacio transformado para datos direccionales puede introducir distorsiones en la evaluación de la similitud. Para estudios futuros, se recomienda la ampliación del conjunto de datos, la incorporación de métricas de validación adicionales y el desarrollo de enfoques específicos basados en estadística direccional, como aquellos fundamentados en la distribución de Fisher o en mezclas de distribuciones esféricas, para una mayor consistencia física. La integración continua entre aprendizaje automático y estadística paleomagnética tradicional es un camino prometedor para el avance de las interpretaciones paleogeográficas y la mejora del análisis de datos paleomagnéticos.
Referencias Bibliográficas
Bishop, C. M., & Nasrabadi, N. M. (2006). Pattern recognition and machine learning (Vol. 4, No. 4, p. 738). New York: springer.
Butler, R. B., 1992. Paleomagnetism: Magnetic domains to geologic terranes. http://geography.lancs.ac.uk/cemp/resources/Butler_book/contents.htm
Chadima, M. & Hrouda, F. Remasoft 3.0 Paleomagnetic Data Browser and Analyzer. https://www.agico.com/text/software/remasoft/remasoft.php. (2007).
Dallanave, Edoardo. “Assessing the reliability of paleomagnetic datasets using the R package PmagDiR.” Scientific Reports 14.1 (2024): 1666.
Donnadieu, Y., Pierrehumbert, R., Jacob, R., & Fluteau, F. (2006). Modelling the primary control of paleogeography on Cretaceous climate. Earth and Planetary Science Letters, 248(1-2), 426-437.
Ester, M., Kriegel, H. P., Sander, J., & Xu, X. (1996, August). A density-based algorithm for discovering clusters in large spatial databases with noise. In kdd (Vol. 96, No. 34, pp. 226-231).
Fisher, R. A., 1953. Dispersion on a sphere. Proceedings of the Royal Society of London, 217, 295-305
Gallo, L. C., Domeier, M., Antonio, P. Y., Sapienza, F., Rapalini, A., Font, E., … & Warren, L. (2025). Unraveling remagnetization sources using statistical learning. Earth and Planetary Science Letters, 662, 119390.
Gwirtz, K., Davis, T., Morzfeld, M., Constable, C., Fournier, A., & Hulot, G. (2022). Can machine learning reveal precursors of reversals of the geomagnetic axial dipole field?. Geophysical Journal International, 231(1), 520-535.
Hastie, T., Tibshirani, R., & Friedman, J. (2009). An introduction to statistical learning.
Herold, N., Seton, M., Müller, R. D., You, Y., & Huber, M. (2008). Middle Miocene tectonic boundary conditions for use in climate models. Geochemistry, Geophysics, Geosystems, 9(10).
Heslop, D., & Roberts, A. P. (2016). Estimation and propagation of uncertainties associated with paleomagnetic directions. Journal of Geophysical Research: Solid Earth, 121(4), 2274-2289.
Heslop, D., Scealy, J. L., Wood, A. T. A., Tauxe, L. & Roberts, A. P. A Bootstrap common mean direction test. J. Geophys. Res. Solid Earth 128, 1–12 (2023)
Hollis, C. J., Dunkley Jones, T., Anagnostou, E., Bijl, P. K., Cramwinckel, M. J., Cui, Y., … & Lunt, D. J. (2019). The DeepMIP contribution to PMIP4: Methodologies for selection, compilation and analysis of latest Paleocene and early Eocene climate proxy data, incorporating version 0.1 of the DeepMIP database. Geoscientific Model Development, 12(7), 3149-3206.
Kirschvink, J. L., 1980. The least-squares line and plane and the analysis of palaeomagnetic data. Geophysical Journal of the Royal Astronomical Society, 62, 699-718
Middlemiss, F. A. (1979). Paleobiogeography. In Paleontology (pp. 515-523). Springer, Berlin, Heidelberg.
Murphy, K. P. (2012). Machine learning: a probabilistic perspective. MIT press.
Pisarevsky, S. A., Li, Z. X., Tetley, M. G., Liu, Y., & Beardmore, J. P. (2022). An updated internet-based global paleomagnetic database. Earth-Science Reviews, 235, 104258.
Tauxe, L., & Kent, D. V. (2004). A simplified statistical model for the geomagnetic field and the detection of shallow bias in paleomagnetic inclinations: was the ancient magnetic field dipolar?.
Torsvik, T. H., Müller, R. D., Van der Voo, R., Steinberger, B., & Gaina, C. (2008). Global plate motion frames: toward a unified model. Reviews of geophysics, 46(3).
Vaes, B., Li, S., Langereis, C. G., & van Hinsbergen, D. J. (2021). Reliability of palaeomagnetic poles from sedimentary rocks. Geophysical Journal International, 225(2), 1281-1303.
Zijderveld, J. D. A., 1967. Demagnetization of rocks: Analysis of results. In D. W. Collinson, K. M. Creer, e S. K. Runcorn (Eds.), Methods in Paleomagnetism (pp. 254-286).
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haz clic aquí y accede a la plataforma MBX Academy