
09 de septiembre de 2026
Análisis de Componentes Principales y Agrupación de Datos Censales en la Identificación de Asentamientos Precarios
Carolina Horta Cattaneo; Jéssica Eloá Poletto
DOI: 10.22167/2675-6528-202602130
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
La identificación de asentamientos precarios en áreas metropolitanas brasileñas aún depende, en gran medida, de enfoques cualitativos y clasificaciones institucionales, frecuentemente subjetivas y temporalmente desfasadas. Este estudio evaluó la aplicación combinada del Análisis de Componentes Principales (PCA) y el algoritmo K-Means para segmentar sectores censales urbanos del Censo Demográfico de 2010, comparando los resultados con la clasificación oficial de Agrupaciones Subnormales (AGSN) del Instituto Brasileño de Geografía y Estadística (IBGE). Se utilizaron datos de 33 regiones metropolitanas que contenían AGSN. Se probaron cuatro configuraciones metodológicas, combinando dos conjuntos de variables (uno amplio y otro enfocado en vulnerabilidad) con k=4 y k=5 agrupaciones. Las variables incluyeron infraestructura urbana, saneamiento, características domiciliarias y perfiles socioeconómicos y raciales, y fueron sometidas a la transformación de Yeo-Johnson y estandarización. La correspondencia de las agrupaciones con la clasificación oficial fue evaluada por el Adjusted Rand Index (ARI). Los resultados revelaron baja correspondencia en la mayoría de las regiones, con índices de ARI predominantemente inferiores a 0,03. Se observaron desempeños más elevados en Belém, Campinas y Aracaju. A pesar de la baja correspondencia con la clasificación oficial, el enfoque demostró capacidad para identificar gradientes de vulnerabilidad urbana de forma sistemática y replicable. Esto ofrece potencial para subsidiar la priorización territorial en políticas públicas, sin, sin embargo, sustituir las clasificaciones institucionales establecidas.
Palabras clave: Agrupamiento; Aprendizaje automático no supervisado; Asentamientos precarios; Sectores censales; Vulnerabilidad urbana.
1. Introducción
La rápida urbanización en Brasil ha generado desafíos significativos para la gestión territorial, incluida la expansión continua de asentamientos precarios en áreas metropolitanas. Desde el Censo de 1950, el Instituto Brasileño de Geografía y Estadística (IBGE) se ha dedicado a la caracterización e identificación de estos territorios (IBGE, 2023), que muestran una expansión constante a lo largo de las últimas décadas (IPEA, 2016). Las tipologías utilizadas para esta clasificación han sido revisadas, incluso en investigaciones recientes (MCID, 2024), pero estos asentamientos persisten con características recurrentes, lo que exige acciones gubernamentales estratégicas para mejorar las condiciones de vida de sus habitantes. Actualmente, tanto el IBGE como el Ministerio de Ciudades (MCID) emplean criterios específicos para clasificar estas áreas, considerando aspectos como las condiciones de vivienda, el acceso a servicios esenciales y la regularización de la propiedad (MCID, 2023).
A pesar de los esfuerzos institucionales, la identificación de estos asentamientos aún enfrenta desafíos metodológicos relevantes. Los enfoques tradicionales a menudo dependen de clasificaciones cualitativas e institucionales, que son susceptibles a la subjetividad y al desfase temporal. Existe una brecha en la aplicación de métodos cuantitativos robustos que puedan complementar los análisis existentes, ofreciendo una visión más sistemática y replicable de los patrones de vulnerabilidad urbana.
En este contexto, las metodologías basadas en estadística multivariante y aprendizaje automático no supervisado presentan un potencial considerable para mejorar la identificación de patrones espaciales y socioeconómicos subyacentes en los datos censales. El Análisis de Componentes Principales (PCA) es un método ampliamente empleado para la reducción de dimensionalidad, que preserva la variabilidad original de los datos y permite la identificación de patrones latentes entre las variables (Fávero y Belfiore, 2017). Esta técnica es crucial para sintetizar información compleja de grandes conjuntos de datos.
La clusterización, a su vez, con técnicas como el algoritmo K-Means, demuestra eficacia en la segmentación de datos espaciales, agrupando elementos con características similares (Fávero y Belfiore, 2017). La combinación de PCA y K-Means se ha aplicado en estudios urbanos complejos. Kubrusly y Saboia (2006) utilizaron análisis estadístico multivariado para examinar la población empleada en regiones metropolitanas. Carvalho (2015) empleó métodos multivariados para la simulación del paisaje urbano. Más recientemente, Carmo y Costa (2021) aplicaron PCA para tipologías urbanas, y Bortoletto et al. (2017) usaron PCA y clusterización para evaluar la vulnerabilidad socioambiental. En el campo de los datos geoespaciales censales, Krishnan (2023) y Rey et al. (2023) presentaron aplicaciones de K-Means y agrupamiento jerárquico en datos socioeconómicos, evaluando el rendimiento por métricas como los coeficientes de Silhouette y Davies-Bouldin.
La brecha en la identificación sistemática y replicable de asentamientos precarios, junto con la necesidad de herramientas complementarias a las clasificaciones institucionales, justifica la exploración de enfoques cuantitativos. Así, el presente estudio buscó evaluar la aplicación de algoritmos no supervisados de aprendizaje automático, específicamente PCA y K-Means, para la segmentación de sectores censales urbanos del Censo Demográfico de 2010, verificando la correspondencia de los agrupamientos obtenidos con la clasificación oficial del IBGE para asentamientos precarios y explorando el potencial del enfoque como herramienta de priorización territorial para análisis e intervenciones más profundas.
2. Material y Métodos
El estudio utilizó un enfoque cuantitativo, basado en la aplicación de algoritmos de aprendizaje automático no supervisados, específicamente Análisis de Componentes Principales (PCA) y K-Means, para segmentar sectores censales urbanos. La investigación se realizó con datos del Censo Demográfico de 2010, comparando los agrupamientos obtenidos con la clasificación oficial de Agrupaciones Subnormales (AGSN) del Instituto Brasileño de Geografía y Estadística (IBGE).
El conjunto de datos se construyó a partir de fuentes secundarias de acceso público del IBGE, combinando tablas de resultados del Censo Demográfico de 2010 agregadas por sector censal, la malla de sectores censales del mismo año y la base de AGSN de Áreas de Interés Social de 2019. La integración de estas fuentes se realizó mediante unión espacial y tabular, resultando en un GeoDataFrame con información socioespacial y la clasificación de AGSN para cada sector censal urbano de las regiones metropolitanas brasileñas. Las tablas del Censo 2010 se obtuvieron del servidor FTP del IBGE en archivos CSV temáticos (Domicilio01, DomicilioRenda, Entorno01, Pessoa01 y Pessoa03). La malla de sectores censales se obtuvo del servidor FTP del IBGE en formato “shapefile” y se exportó como geopackage [GPKG]. La delimitación de las regiones metropolitanas se obtuvo de un “shapefile” del Centro de Estudios de la Metrópoli [CEM/USP], convertido a GPKG vía QGIS. La base de AGSN, en formato GeoJSON, se utilizó para marcar sectores cuyos centroides se localizan dentro de los polígonos de aglomerados subnormales, generando la variable binaria de referencia.
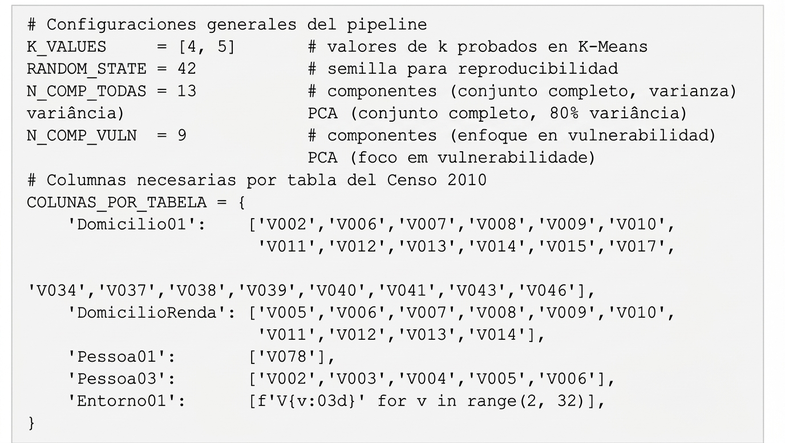
El pipeline de preparación de datos se desarrolló en Python, utilizando las bibliotecas geopandas, pandas, numpy y pyogrio. Los pasos incluyeron: (1) descarga automatizada de los “shapefiles” de sectores por UF; (2) extracción y lectura selectiva de los CSV temáticos, filtrando sectores de regiones metropolitanas y columnas necesarias; (3) unión tabular entre datos del “shapefile” y CSV por código de sector; y (4) unión espacial entre centroides de los sectores y polígonos de AGSN para el marcado de la variable de referencia. El resultado se exportó en formato GPKG. La configuración general del pipeline y el mapeo de columnas se detallan en la Figura 1.
Figura 1. Código 1 – configuraciones generales y mapeo de columnas por tabla del Censo 2010
Fuente: Datos originales de la investigación
Después de la integración, los datos se filtraron para incluir exclusivamente sectores urbanos (Situacao_setor = 1) y se excluyeron sectores con ausencia total de información del entorno. Los valores nulos residuales en las variables domiciliarias se sustituyeron por cero.
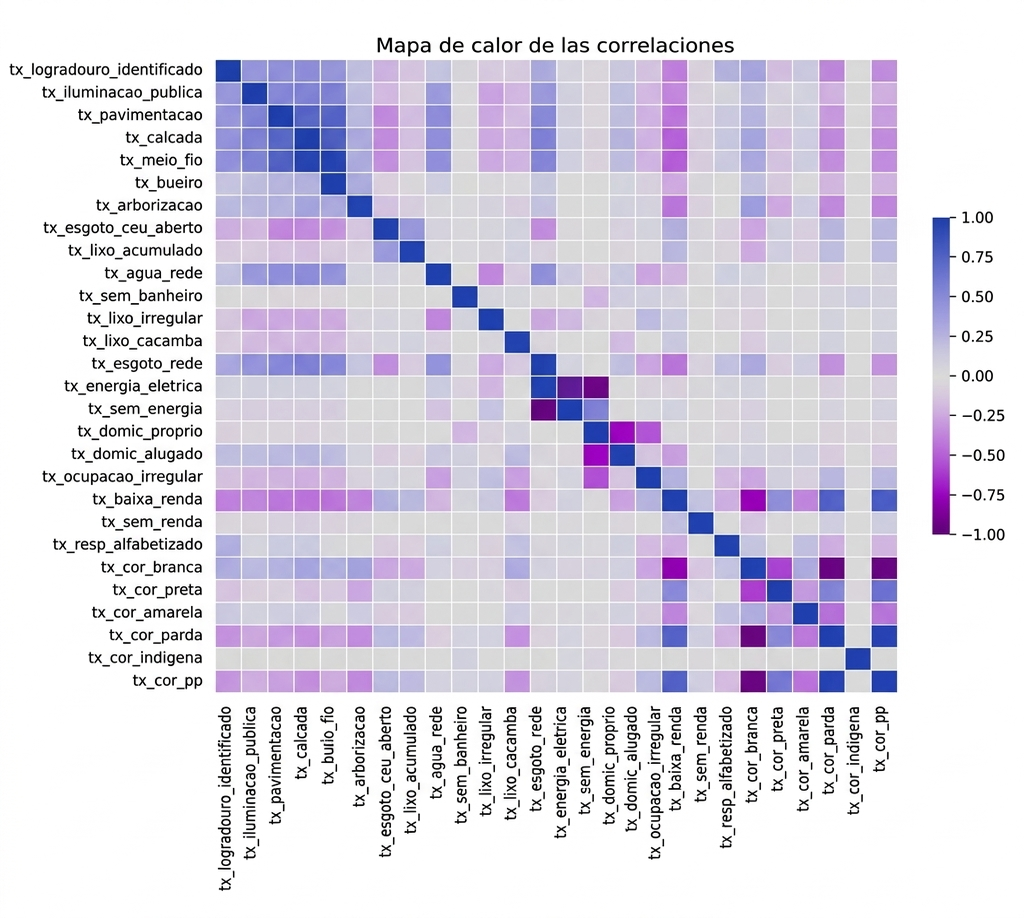
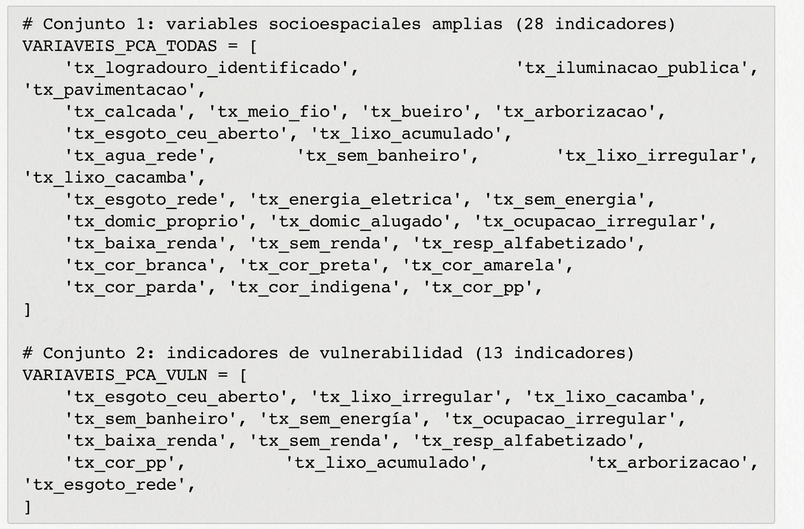
Para la construcción de los indicadores, se realizó un análisis de correlación exploratoria en la Región Metropolitana de São Paulo (RMSP) para calibración metodológica. Los patrones de correlación se ilustran en la Figura 2. Se calcularon indicadores proporcionales para cada sector censal, dividiendo recuentos absolutos por totales de hogares, ingresos o personas. Los indicadores se organizaron en cuatro categorías temáticas: infraestructura urbana, saneamiento y recolección, características de los hogares y perfil socioeconómico y racial. Se definieron dos conjuntos de variables para el PCA: el primero, “todas las variables”, con 28 indicadores socioespaciales amplios; y el segundo, “enfoque en vulnerabilidades”, con 13 indicadores asociados a la precariedad habitacional y la exclusión social. La definición de estos conjuntos se presenta en la Figura 3.
Figura 2. Correlación entre indicadores socioespaciales de la Región Metropolitana de São Paulo
Fuente: Datos originales de la investigación
Figura 3. Código 2 – definición de los dos conjuntos de variables para la PCA
Fuente: Datos originales de la investigación
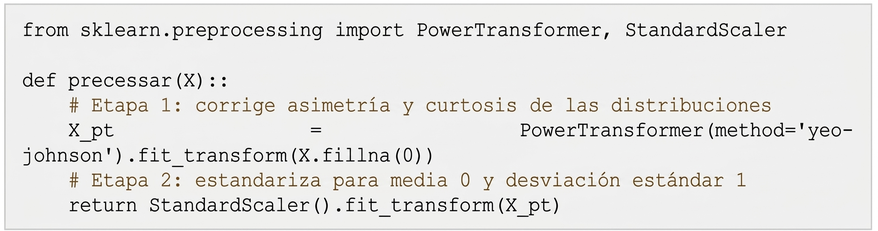
Antes de la aplicación de los algoritmos, los datos se preprocesaron en dos etapas: (1) transformación de Yeo-Johnson (clase PowerTransformer de la biblioteca scikit-learn) para reducir la asimetría y la curtosis; y (2) estandarización con StandardScaler para obtener variables con media cero y desviación estándar unitaria. La función de preprocesamiento se ilustra en la Figura 4.
Figura 4. Código 3 – función de preprocesamiento: transformación Yeo-Johnson seguida de estandarización
Fuente: Datos originales de la investigación
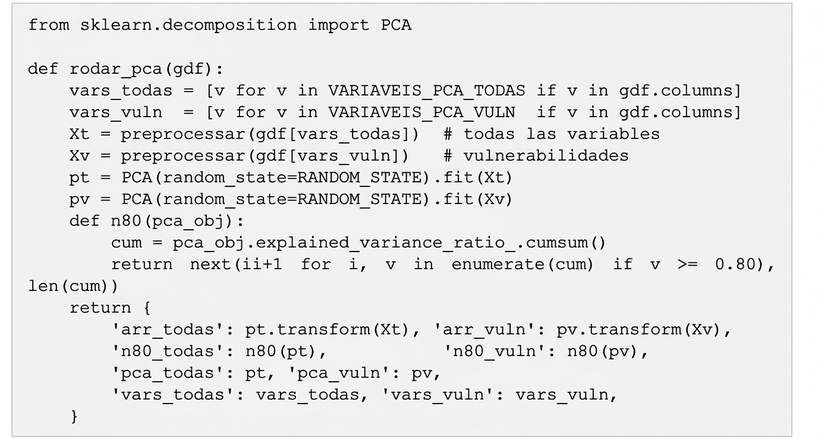
El Análisis de Componentes Principales (PCA) se aplicó por separado a cada conjunto de variables, utilizando la clase PCA de la biblioteca scikit-learn. El número de componentes retenidos se definió por el criterio del 80% de varianza explicada acumulada: 13 componentes para el conjunto completo de variables y 9 para el conjunto de vulnerabilidades (Apéndice A). Se exportaron las proyecciones en los dos primeros componentes principales. La aplicación de la PCA se detalla en la Figura 5.
Figura 5. Código 4 – aplicación de PCA para los dos conjuntos de variables, con criterio del 80% de varianza acumulada
Fuente: Datos originales de la investigación
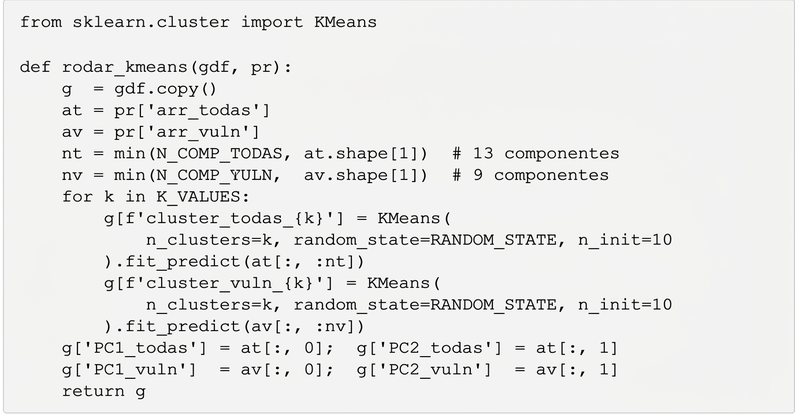
La agrupación se realizó con el algoritmo K-Means, implementado por la biblioteca scikit-learn. Se probaron dos valores de k (4 y 5 agrupaciones) para cada tipo de PCA, lo que resultó en cuatro configuraciones por región metropolitana: todas_k4, todas_k5, vuln_k4 y vuln_k5. La definición de los valores de k se guió por el análisis de inercia total y el coeficiente de silueta, aplicados en la RMSP. El algoritmo se inicializó con n_init=10 inicializaciones aleatorias y random_state fijo para la reproducibilidad. La entrada para K-Means fue la proyección de los datos en los primeros componentes principales seleccionados (13 para el conjunto completo y 9 para el conjunto de vulnerabilidades). La aplicación de K-Means se muestra en la Figura 6.
Figura 6. Código 5 – aplicación del K-Means para las cuatro configuraciones (tipo de PCA × k)
Fuente: Datos originales de la investigación
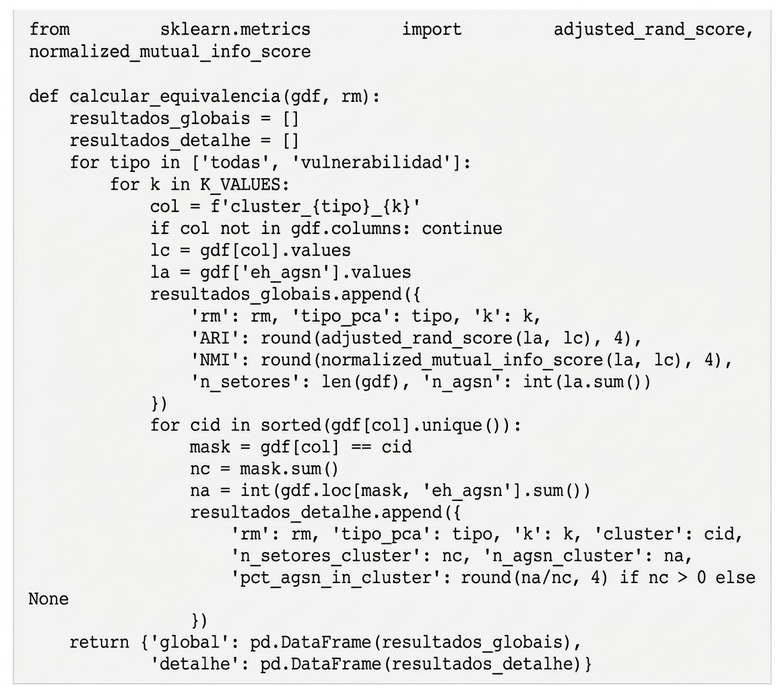
La correspondencia entre las agrupaciones generadas y la clasificación oficial de AGSN fue evaluada por el Adjusted Rand Index (ARI), implementado por la función adjusted_rand_score de la biblioteca scikit-learn. El ARI mide la similitud entre dos conjuntos de etiquetas discretas, ajustando el “Rand Index” por el azar esperado. La Normalized Mutual Information (NMI) se calculó como métrica complementaria. Para cada región metropolitana y configuración, se registraron el ARI, el NMI, el número total de sectores y el número de sectores clasificados como AGSN, además del detalle por clúster. Para cada región metropolitana y cada
configuración, se registraron el ARI, el NMI, el número total de sectores y el número de sectores clasificados como AGSN, además del detalle por clúster con la proporción de sectores AGSN en cada agrupación (Figura 7).
Figura 7. Código 6 – cálculo de ARI y NMI por configuración, con detalle por “cluster”
Fuente: Datos originales de la investigación
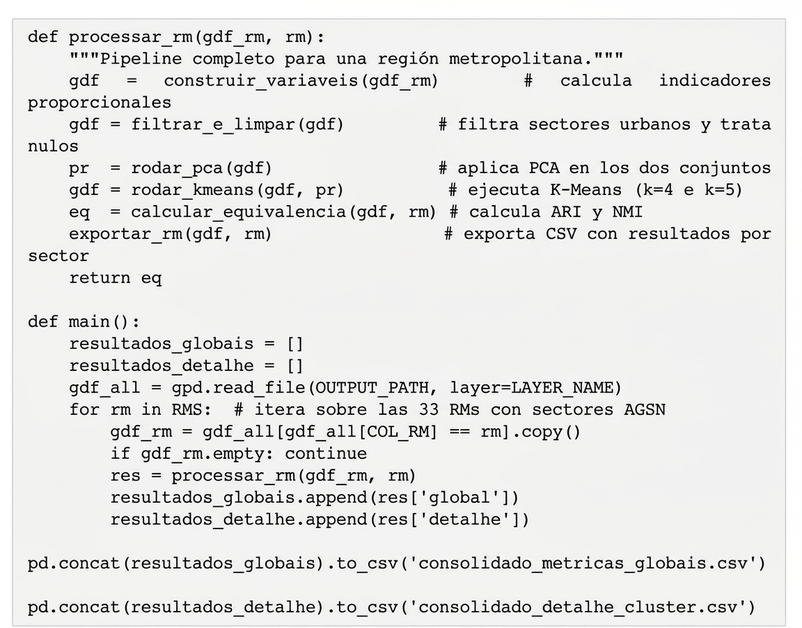
El estudio se desarrolló y validó inicialmente en la Región Metropolitana de São Paulo. En una segunda etapa, el pipeline se amplió a las 33 regiones metropolitanas brasileñas con presencia de sectores clasificados como AGSN. Para posibilitar el procesamiento a escala nacional, el pipeline se estructuró de forma modular, procesando cada región metropolitana de forma independiente a través de una función que encapsula todas las etapas: construcción de los indicadores, filtrado y limpieza de los datos, aplicación del PCA, ejecución del K-Means, cálculo de las métricas y exportación de los resultados. Los resultados se consolidaron en archivos CSV. La función principal del pipeline se ilustra en la Figura 8.
Figura 8. Código 7 – función principal del “pipeline”: procesamiento modular por región metropolitana
Fuente: Datos originales de la investigación
3. Resultados y Discusión
El análisis se llevó a cabo para las 33 regiones metropolitanas brasileñas que presentaban sectores clasificados como Aglomerados Subnormales (AGSN) según la base de datos del IBGE de 2019. Para cada región, se probaron cuatro configuraciones metodológicas, combinando dos tipos de Análisis de Componentes Principales (PCA) – uno con todas las variables sociodemográficas y otro centrado en indicadores de vulnerabilidad – y dos valores para el algoritmo K-Means (k=4 y k=5). La correspondencia entre los agrupamientos generados y la clasificación oficial del IBGE se evaluó mediante el Índice Rand Ajustado (ARI), una métrica que varía entre -1 y 1, donde valores cercanos a cero indican una concordancia equivalente al azar.
En el primer componente principal (PC1) del conjunto completo de variables, destacaron indicadores asociados a la precariedad urbana y a las desigualdades raciales, como la proporción de hogares con bajos ingresos, la proporción de personas negras o pardas y la infraestructura deficiente. Estos factores presentaron una correlación inversa con variables que reflejan una mayor infraestructura consolidada, como pavimentación y aceras, lo que sugiere que PC1 representa un gradiente de desigualdad territorial. El segundo componente (PC2) reflejó diferencias en el tipo de tenencia del hogar y en el acceso a la infraestructura, distinguiendo áreas regulares de ocupaciones informales, según se detalla en el Apéndice A del TCC original.
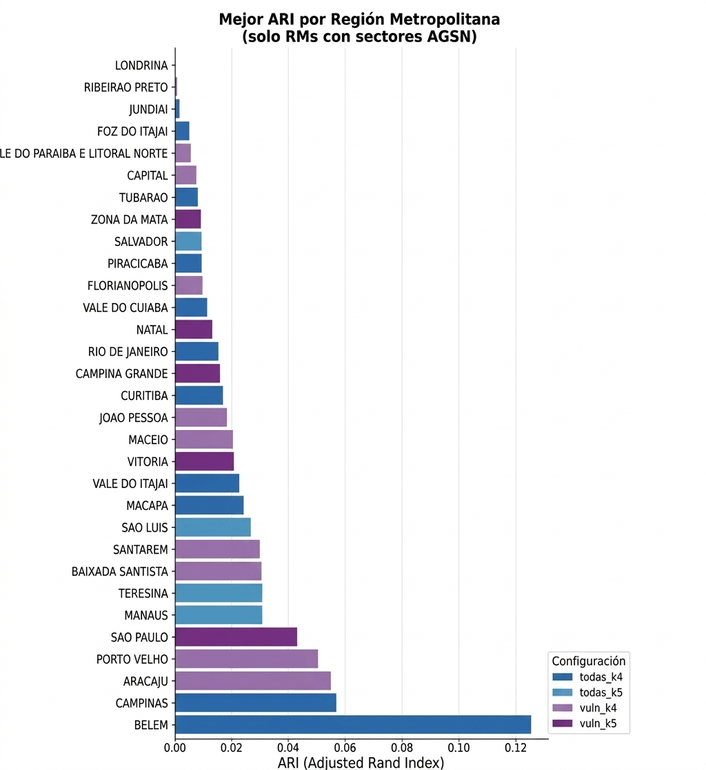
La Figura 9 presenta el mejor ARI obtenido entre las cuatro configuraciones probadas para cada región metropolitana, ordenadas de forma creciente. Se observa que la gran mayoría de las regiones concentra valores cercanos a cero, destacando Belém (ARI = 0,125), Campinas (ARI = 0,057) y Aracaju (ARI = 0,055), que presentaron los desempeños más elevados.
Figura 9. Mejor ARI por región metropolitana (solo RMs con sectores AGSN)
Fuente: Resultados originales de la investigación
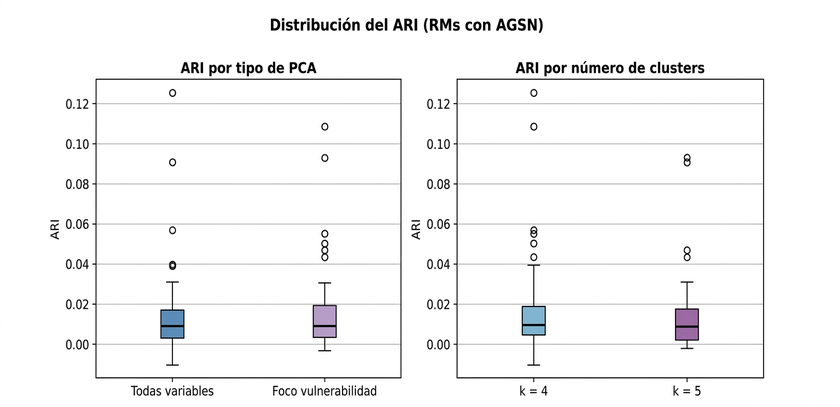
La Figura 10 complementa este análisis mediante “boxplots” comparativos, que muestran la distribución del ARI por separado según el tipo de PCA y el número de “clusters”. En ambos paneles, la dispersión se reduce y los valores medianos se sitúan cerca de cero, lo que indica que ni la elección del conjunto de variables ni la definición del número de agrupaciones produjeron un impacto sistemático expresivo sobre la correspondencia con la clasificación oficial. La ausencia de diferencias relevantes entre las configuraciones refuerza que el rendimiento del modelo está más condicionado a las características socioespaciales de cada región metropolitana que a los parámetros metodológicos adoptados.
Figura 10. Distribución del ARI por tipo de PCA y por número de clústeres (RMs con AGSN)
Fuente: Resultados originales de la investigación
Rendimiento por región metropolitana y configuración
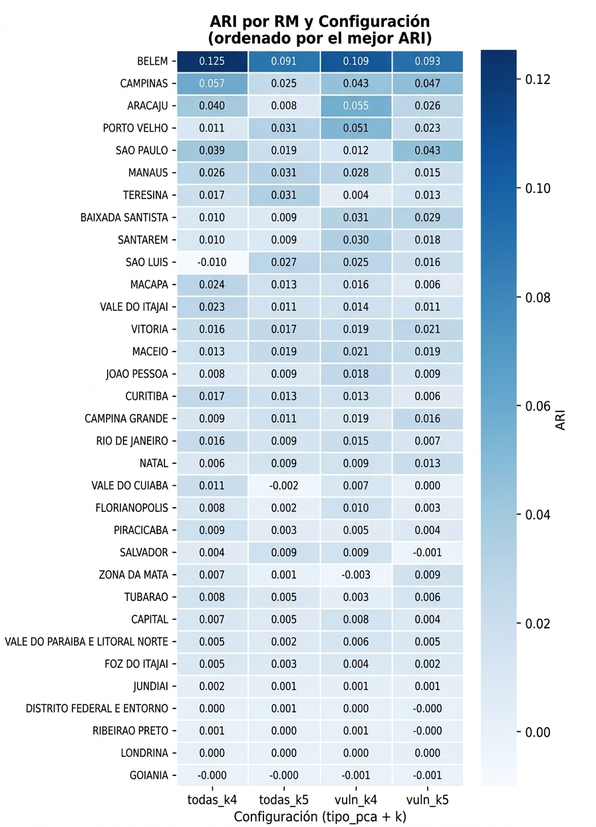
La distribución del ARI por región metropolitana reveló una jerarquía clara de desempeño (Figura 11). Belém presentó el mayor valor de ARI entre todas las regiones y configuraciones analizadas (ARI = 0,125, configuración todas_k4), destacándose de forma expresiva en relación a las demás.
Figura 11. ARI por región metropolitana y configuración metodológica (ordenado por el mejor ARI)
Fuente: Resultados originales de la investigación
El análisis de la relación entre el ARI y la proporción de sectores AGSN en la región metropolitana indicó una tendencia positiva (Figura 12). Las regiones con mayor participación de AGSN en el conjunto de sectores urbanos tendieron a presentar valores más elevados de ARI. Esta asociación sugiere que, cuando los sectores precarios representan una parte expresiva del universo analizado, sus características socioespaciales generan mayor variabilidad sistemática, favoreciendo la identificación de los agrupamientos por los algoritmos. Belém, con cerca del 50% de los sectores urbanos clasificados como AGSN, fue el caso más expresivo, lo que ayuda a explicar su desempeño superior. Entre las demás regiones, destacaron Campinas (ARI = 0,057, todas_k4) y Aracaju (ARI = 0,055, vuln_k4).
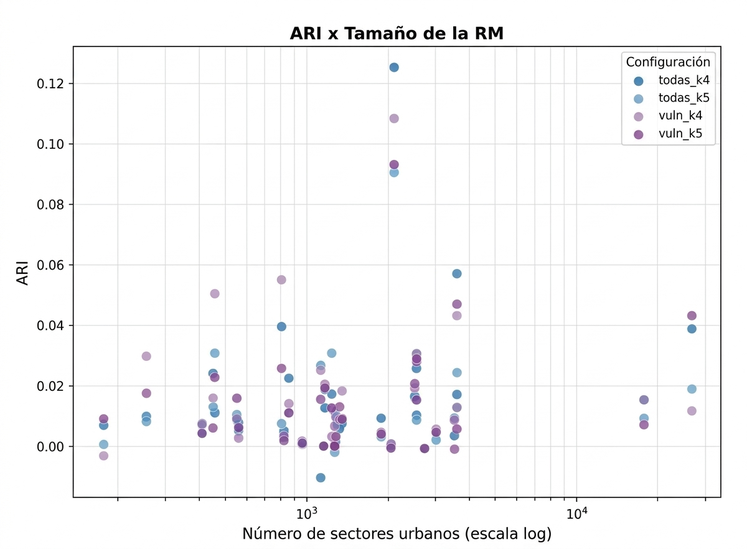
Por otro lado, no se identificó una relación clara entre el número de sectores censales urbanos y el rendimiento del modelo (Figura 13). Este resultado indica que el volumen de datos, de forma aislada, no determina la calidad de los agrupamientos. El rendimiento parece estar más asociado a la estructura interna de la variabilidad socioespacial de cada región, especialmente al grado de diferenciación entre sectores precarios y no precarios en el conjunto de variables censales, que a la escala del análisis.
Figura 12. Relación entre ARI y proporción de sectores AGSN por región metropolitana
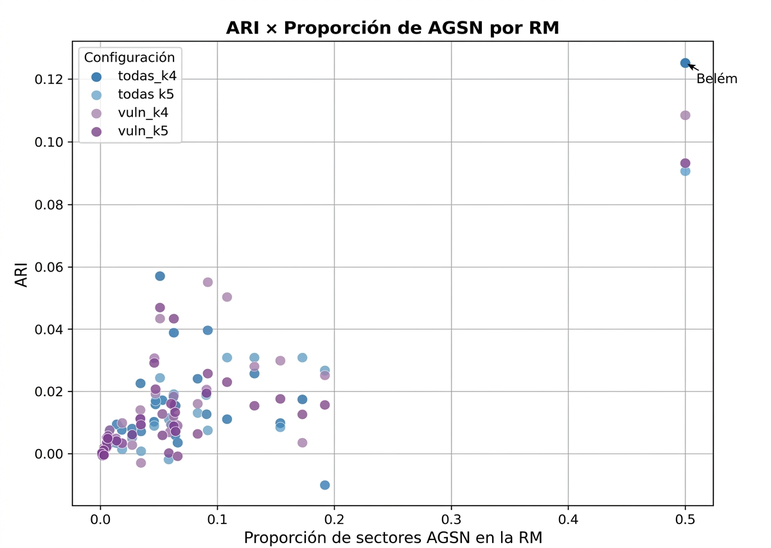
Figura 13. Relación entre ARI y número de sectores censales urbanos de la región metropolitana (escala logarítmica)
Análisis Espacial: el caso de Belém
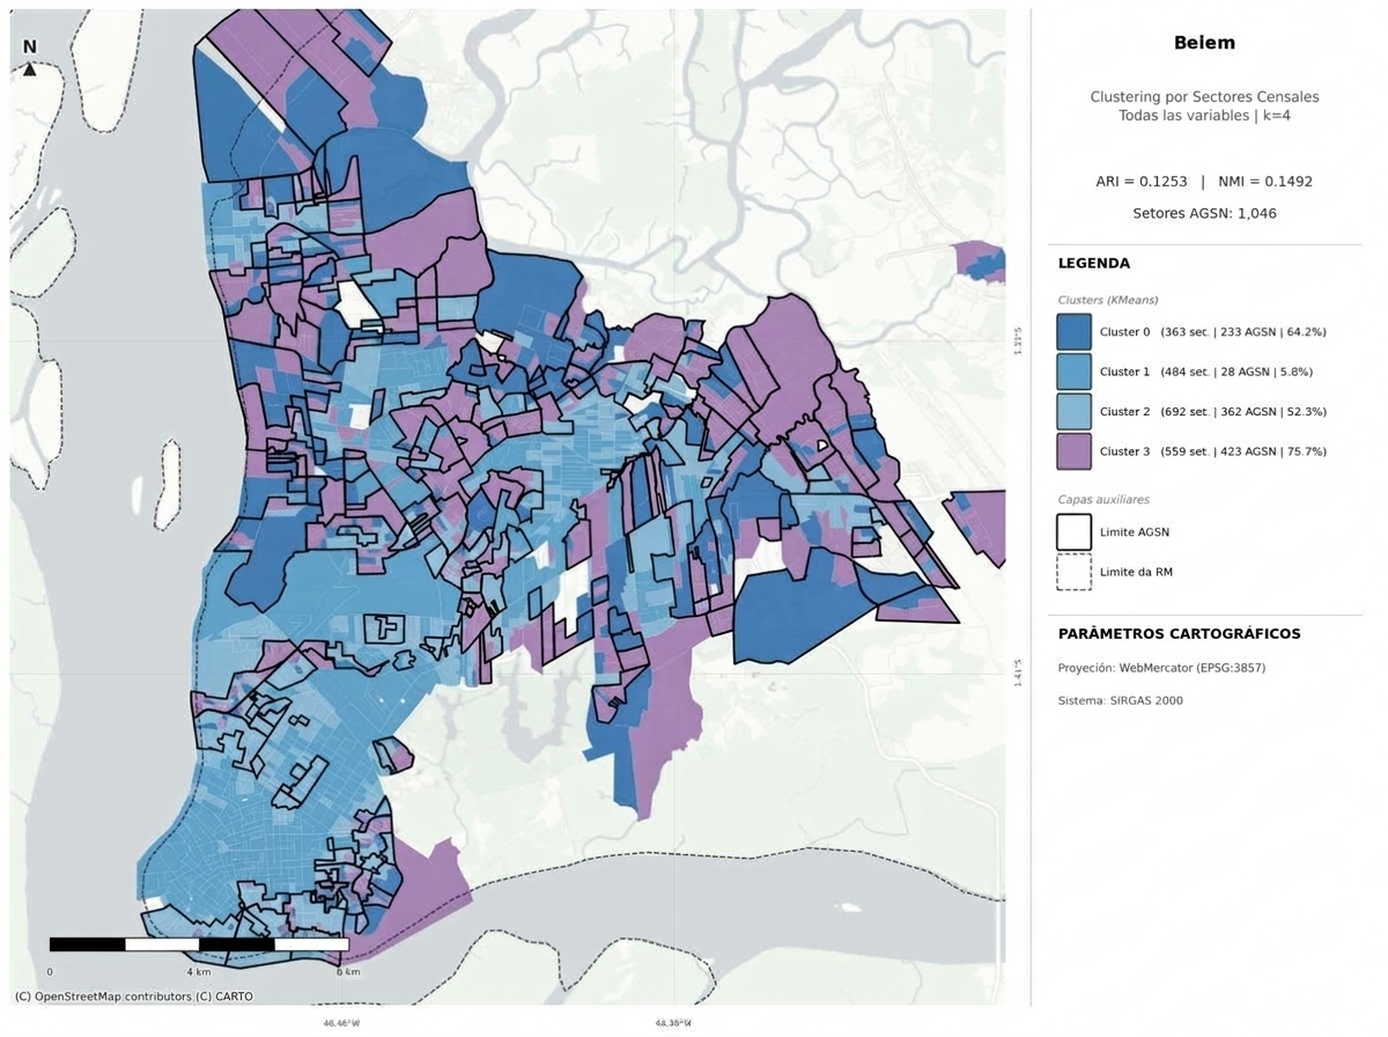
Para profundizar la interpretación de los resultados, Belém fue seleccionada por presentar el mejor desempeño métrico y un contexto urbano favorable a la aplicación de la metodología. En la configuración todas_k4 (ARI = 0,125), la segmentación territorial produjo un patrón interpretable y territorialmente coherente. El clúster 3, compuesto por 559 sectores, concentró el 75,7% de sus sectores en AGSN, mientras que el clúster 1, con 484 sectores, presentó solo un 5,8% de superposición con esta clasificación. Esta polarización refleja la estructura urbana de la región, marcada por la coexistencia de áreas con elevada infraestructura y sectores de precariedad habitacional intensa.
Figura 14. Distribución espacial de los “clusters” en Belém, todas las variables, k=4 (ARI = 0,125)
Fuente: Resultados originales de la investigación; IBGE y Censo Demográfico (2010); IBGE y AGSN (2019)
La distribución espacial de los agrupamientos revela una estructura territorial coherente con el proceso de urbanización de Belém, marcado por la ocupación de áreas de bajadas y zonas ribereñas asociadas a la precariedad habitacional, características recurrentes de las ciudades amazónicas (Castro, 2008). El clúster 3, con mayor concentración de sectores AGSN, se organiza predominantemente en las porciones oeste y sur de la región metropolitana, coincidiendo con las áreas de bajadas y ocupaciones ribereñas históricamente asociadas a la precariedad habitacional. El clúster 2, con un 52,3% de superposición con los AGSN, ocupa una posición intermedia y aparece de forma dispersa a lo largo del tejido urbano, sugiriendo la presencia de gradientes de vulnerabilidad que permean diferentes porciones del territorio.
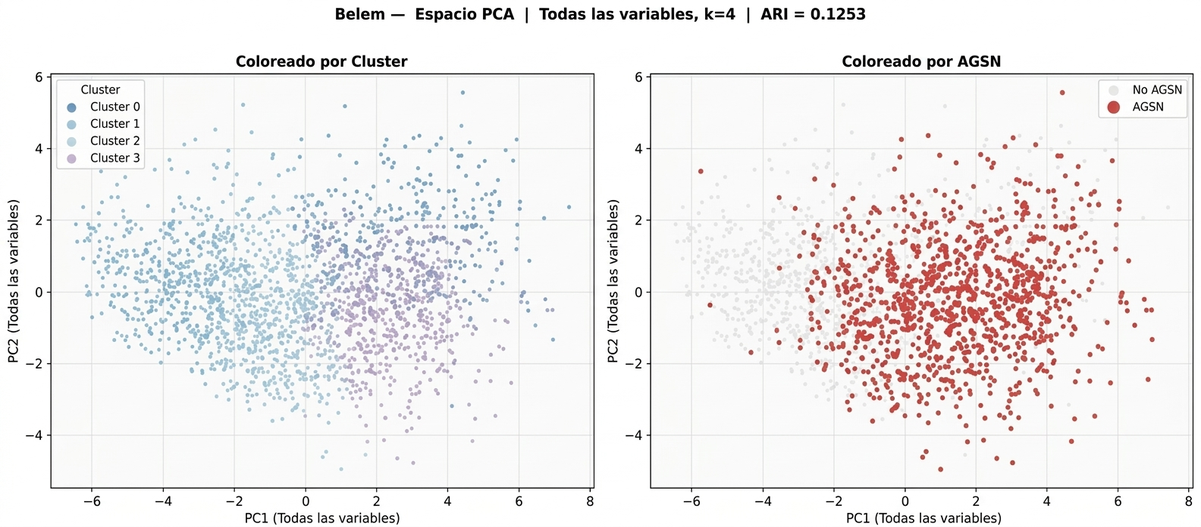
El clúster 1, con una menor proporción de AGSN, se concentra en las áreas centrales y en los sectores con mayor infraestructura consolidada, evidenciando el patrón de segregación socioespacial característico de las metrópolis amazónicas. Esta organización espacial refuerza la capacidad del enfoque en capturar estructuras territoriales reales, aun operando exclusivamente a partir de variables censales agregadas. La proyección de los sectores en el espacio de los dos primeros componentes principales (PC1 y PC2) evidencia la separación entre los grupos, conforme a la Figura 15.
Figura 15 Distribución de los sectores en el espacio PCA en Belém, coloreado por “cluster” (izquierda) y por clasificación AGSN (derecha)
Fuente: Resultados originales de la investigación
4. Conclusión
El presente estudio evaluó la aplicación combinada del Análisis de Componentes Principales (PCA) y el algoritmo K-Means para segmentar sectores censales urbanos del Censo Demográfico de 2010, buscando verificar la correspondencia de los agrupamientos obtenidos con la clasificación oficial de Aglomerados Subnormales (AGSN) del IBGE y explorar el potencial del enfoque como herramienta de priorización territorial. Se verificó que, en la mayoría de las 33 regiones metropolitanas analizadas, la correspondencia entre los agrupamientos generados y la clasificación oficial fue modesta, con valores de Adjusted Rand Index (ARI) predominantemente inferiores a 0,03. Se observaron desempeños más elevados en Belém, Campinas y Aracaju, y se constató que regiones con mayor proporción de AGSN tendieron a presentar ARI más altos. El análisis espacial demostró que los clusters más vulnerables, identificados por la metodología, se organizaron de forma coherente con los patrones de segregación socioespacial y precariedad habitacional de las metrópolis brasileñas, con los sectores AGSN concentrándose en regiones bien definidas en el espacio estadístico de la PCA. Este enfoque, por lo tanto, demostró capacidad para identificar gradientes de vulnerabilidad urbana de manera sistemática y replicable, ofreciendo una contribución práctica relevante como instrumento de selección territorial a escala metropolitana, capaz de orientar la asignación de esfuerzos para investigaciones más profundas y subsidiar políticas públicas.
Los resultados obtenidos deben interpretarse considerando algunas limitaciones. La clasificación de AGSN, basada en criterios urbanísticos y topológicos, no coincide necesariamente con los perfiles socioespaciales captados por las variables censales, lo que impone un límite intrínseco a la comparación y sugiere que la metodología puede identificar territorios vulnerables aún no formalmente reconocidos. Además, el algoritmo K-Means, sensible a la estructura de covarianza de los datos, puede no capturar la heterogeneidad interna de los agrupamientos en regiones de gran tamaño, indicando que métodos alternativos podrían explorarse en estudios futuros. La base de datos del Censo 2010 también presentó limitaciones de completitud en variables de entorno. Para el perfeccionamiento de la investigación, se sugiere la replicación de la metodología con los datos del Censo Demográfico de 2022, que ofrecerá una base más completa y actualizada. Se recomienda, además, la incorporación de variables complementarias, como datos de imágenes de satélite de alta resolución, indicadores ambientales de teledetección e información sobre legislación urbana, con el fin de enriquecer el conjunto de atributos y aumentar la sensibilidad del modelo en la identificación de patrones de vulnerabilidad urbana.
Referencias Bibliográficas
Bortoletto, K.C.; Freitas, M.I.C.; Rossetti, L.A.F.G.; Freitas, A.C.; Oliveira, R.B.N. 2017. Análise da vulnerabilidade socioambiental e do uso do solo urbano da área insular de Santos – SP. Revista Brasileira de Cartografia 69(4): 769-790.
Carmo, M.B.S.; Costa, S.M.F. 2021. Tipologias urbanas para as pequenas cidades do delta do Rio Amazonas: uma proposição de categorização. Revista Política e Planejamento Regional 8(3): 440-459.
Carvalho, G.A. 2015. Comparação de métodos de análise multivariada na seleção de variáveis explicativas para modelos de simulação da paisagem urbana. Tese de Doutorado em Geografia. Universidade Federal de Minas Gerais, Belo Horizonte, MG, Brasil. Disponível em: . Acesso em: 12 mar. 2025.
Castro, E.M.R. 2008. Urbanização, Pluralidade e Singularidades das Cidades Amazônicas. 1ed. NAEA/UFPA, Belém, PA, Brasil.
Fávero, L.P.; Belfiore, P.P. 2017. Análise de componentes principais (PCA). p. 379-436. In: Fávero, L.P.; Belfiore, P.P. Manual de Análise de Dados: estatística e modelagem multivariada com Excel, SPSS e Stata. 1ed. Elsevier, Rio de Janeiro, RJ, Brasil.
Instituto Brasileiro de Geografia e Estatística [IBGE]. 2010. Dados de aglomerados subnormais e do universo do Censo Demográfico 2010. Disponível em: . Acesso em: 12 mar. 2025.
Instituto Brasileiro de Geografia e Estatística [IBGE]. 2022. Dados do Censo Demográfico 2022. Disponível em: . Acesso em: 12 mar. 2025.
Instituto Brasileiro de Geografia e Estatística [IBGE]. 2023. Favelas e comunidades urbanas: IBGE muda denominação dos aglomerados subnormais. Agência de Notícias IBGE, 13 out. 2023. Disponível em: . Acesso em: 10 mar. 2025.
Instituto de Pesquisa Econômica Aplicada [IPEA]. 2016. Caracterização e tipologia de assentamentos precários. Disponível em: . Acesso em: 09 mar. 2025.
Krishnan, R. 2023. Applied Geospatial Data Science with Python. 1ed. Packt Publishing, Birmingham, Reino Unido.
Kubrusly, L.S.; Saboia, J. 2006. Uma análise multivariada da população ocupada nas regiões metropolitanas brasileiras. Ensaios FEE 27(2): 411-436.
Ministério das Cidades [MCID]. 2023. Guia para o mapeamento e caracterização de assentamentos precários. Disponível em: . Acesso em: 05 mar. 2025.
Ministério das Cidades [MCID]. 2024. Favelas e comunidades urbanas: IBGE retoma termo histórico para censos e pesquisas. Disponível em: . Acesso em: 08 mar. 2025.
Rey, S.J.; Arribas-Bel, D.; Wolf, L.J. 2023. Geographic Data Science with Python. 1ed. Chapman and Hall/CRC, Londres, Reino Unido.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haz clic aquí y accede a la plataforma MBX Academy