
16 de septiembre de 2026
La Predominancia de la Rentabilidad y de las Relaciones No Lineales en la Evaluación de Empresas en la B3
Nicolas Edouard Srour; José Erasmo Silva
DOI: 10.22167/2675-6528-202602299
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
La valoración de empresas por múltiplos de mercado ha desempeñado un papel relevante en el análisis financiero, especialmente en mercados emergentes, donde la relación entre fundamentos contables y precios de mercado no siempre se ha presentado lineal. Se investigó la capacidad de modelos de aprendizaje automático para explicar la relación Precio sobre Valor Patrimonial (P/VP) de empresas brasileñas listadas en la B3, a partir de información contable, macroeconómica y sectorial, integrando la interpretabilidad a través de Explicaciones Aditivas de Shapley (SHAP). Para ello, se construyó una base de datos en panel con 4.646 observaciones trimestrales de 251 empresas, en el período de 2020 a 2025. Se estimaron tres modelos de ensemble basados en árboles de decisión (Random Forest, LightGBM y XGBoost), utilizando indicadores de rentabilidad, liquidez, apalancamiento, eficiencia operativa, tasa Selic, sector de actividad y el logaritmo del activo total. Los modelos fueron evaluados por validación temporal con ventanas expansibles y prueba fuera de la muestra. Los resultados indicaron que los modelos de boosting superaron al Random Forest, evidenciando que la relación entre fundamentos contables y valoración no fue adecuadamente descrita por una estructura puramente lineal. El análisis de importancia de las variables reveló que el beneficio por acción, el retorno sobre activos y el retorno sobre el patrimonio neto ocuparon posiciones centrales en la explicación del P/VP. Sin embargo, el beneficio por acción exhibió un comportamiento no lineal y una señal distinta de la interpretación financiera inmediata. Se concluyó que el aprendizaje automático, aliado a técnicas de interpretabilidad, contribuyó significativamente al análisis de valoración, al capturar relaciones complejas entre variables contables y la fijación de precios de mercado.
Palabras clave: Aprendizaje automático; Indicadores financieros; Interpretabilidad; Mercado de valores; Valoración.
1. Introducción
Todo activo, ya sea financiero o real, posee un valor inherente. El desafío central para el éxito en inversiones y gestión de capital no es solo estimar este valor, sino comprender y cuantificar sus fuentes (Damodaran, 2012). Aunque los principios básicos de la valoración corporativa son consistentes, la aplicación debe adaptarse para tener en cuenta las incertidumbres y dinámicas de mercados específicos. En Brasil, el mercado de acciones se desarrolló vigorosamente, convirtiéndose en una fuente de financiación para empresas y una vía para la diversificación de carteras para inversores (Tavares y Silva, 2012). Dado el papel significativo del mercado de capitales en el desarrollo económico nacional (Ghashami y Kamyar, 2021), el éxito de un inversor depende de su capacidad para tomar decisiones de asignación de activos para maximizar los retornos (Ambrozini et al., 2019).
El enfoque tradicional para la valoración de empresas es el Análisis Fundamentalista, una técnica que utiliza datos financieros y contables para identificar oportunidades de inversión (Ambrozini et al., 2019). Métricas como el Precio sobre Beneficio y el Retorno sobre el Patrimonio Neto son ampliamente aceptadas como impulsores de valor (Fernandes et al., 2019). Sin embargo, en un escenario de rápidos cambios y mayor apertura de mercado, estos modelos convencionales pueden no capturar la totalidad de los factores exigidos por los inversores contemporáneos (Lima et al., 2011). Este escenario refleja un debate académico sobre la noción de valor intrínseco. Académicos clásicos criticaron la dependencia del valor contable, argumentando que los precios de mercado están determinados principalmente por el poder adquisitivo y los dividendos, y no por medidas contables de activos (Graham et al., 1962). Otros autores incluso desaconsejan asumir una relación lineal entre el valor patrimonial y el valor económico del patrimonio, afirmando que los datos contables históricos proporcionan pocos beneficios para fines de valoración (Copeland y Weston, 1988; Brigham, 1982). A pesar de estas limitaciones teóricas, el índice Precio sobre Valor Patrimonial (P/VP) sigue siendo una métrica ampliamente utilizada. Captura la diferencia entre el valor contable del patrimonio neto y el precio de mercado, donde un índice superior a uno indica que los inversores pagan una prima sobre el valor contable, y por debajo de uno sugiere un descuento. Comprender por qué los inversores pagan más o menos que el valor contable es fundamental, ya que proporciona información sobre qué indicadores fundamentales justifican la fijación de precios de mercado, siendo el Retorno sobre el Patrimonio Neto la variable más importante que justifica el índice P/VP (Damodaran, 2012).
Se observa que la relación entre el precio de mercado y los fundamentos no es trivial y exige un análisis de causa y efecto. El enfoque fundamentalista clásico asume frecuentemente relaciones lineales y estables entre las variables. Esta premisa es constantemente desafiada por la complejidad del mercado accionario brasileño, que se caracteriza por ser dinámico, no lineal y altamente sensible a factores políticos y macroeconómicos. Tal escenario demanda modelos de inversión en constante actualización (Silva et al., 2023).
Esta necesidad impulsó la adopción del Aprendizaje Automático para la construcción de portafolios robustos (Silva, 2020). Al ser capaces de capturar relaciones no lineales complejas, estos modelos presentan un poder predictivo superior para las oscilaciones de precios, auxiliando en la mitigación de riesgos (Ji et al., 2022; Kolani, 2022). Sin embargo, la mayoría de los estudios enfocados en algoritmos sofisticados de Aprendizaje Automático priorizan la precisión estadística en detrimento de la explicabilidad, resultando en modelos de “caja negra” opacos (Ahmed, 2024). Esta falta de interpretabilidad puede limitar la capacidad de los analistas para validar los resultados, aumentando la incertidumbre y pudiendo llevar a decisiones equivocadas.
Ante esta brecha, el presente estudio busca integrar la capacidad predictiva del Aprendizaje Automático a la interpretabilidad, utilizando el índice P/VP como variable objetivo para investigar qué indicadores influyen en la fijación de precios de mercado. Para ello, se aplican métodos de Inteligencia Artificial Explicable (XAI), específicamente las Explicaciones Aditivas de Shapley (SHAP), con el fin de cuantificar y jerarquizar la contribución de cada factor contable y macroeconómico. De esta manera, el trabajo conecta el debate teórico clásico sobre valor contable con las técnicas modernas de ciencia de datos, proporcionando evidencia empírica y orientación práctica para el análisis de valoración en el contexto brasileño. Así, este estudio tuvo como objetivo evaluar si los modelos de aprendizaje automático pueden ayudar a explicar la relación Precio sobre Valor Patrimonial de empresas brasileñas cotizadas en bolsa.
2. Material y Métodos
Clasificación y diseño de la investigación
El estudio se clasificó como descriptivo-explicativo (Gil, 2017), siguiendo un camino que comenzó con el mapeo de datos y terminó con la interpretación causal. El aspecto descriptivo implicó el registro y análisis sistemáticos de indicadores financieros de empresas cotizadas en la B3, a partir de informes oficiales de la Comisión de Valores Mobiliarios (CVM). El núcleo de la investigación fue explicativo, centrándose en la identificación de las variables que impulsan el fenómeno. Para ello, se utilizó SHAP para descomponer las predicciones de aprendizaje automático, con el objetivo de cuantificar cómo fundamentos específicos, como el ROE, moldean la relación Precio/Valor Patrimonial en el mercado brasileño.
Fuentes, recolección y preparación de los datos
El conjunto de datos se construyó combinando información contable y macroeconómica de diversas fuentes. Los datos de los estados financieros (Formulario de Información Trimestral – ITR y Estados Financieros Estandarizados – DFP) se obtuvieron de la Comisión de Valores Mobiliarios (CVM) en formato CSV. Las cotizaciones diarias de las acciones se recopilaron por separado de B3, utilizando los archivos históricos de COTAHIST, que requirieron un código de análisis específico debido a su formato de ancho fijo. La información sobre liquidez de acciones se obtuvo del sitio web Fundamentus, y se realizó un proceso de compatibilización de identificadores entre Fundamentus, B3 y CVM utilizando la solicitud interna de la página de empresas listadas de B3 (formato JSON).
La tasa Selic, del Banco Central, se incluyó para representar el entorno macrofinanciero. La muestra se restringió al período de 2020 a 2025 debido a la disponibilidad de datos sobre el número total de acciones en circulación a partir de 2020. Se excluyeron de la muestra las empresas sin liquidez de acciones.
La preparación de los datos implicó la lectura y concatenación de los archivos ITR y DFP, manteniendo solo las observaciones del orden fiscal más reciente y los estados financieros estándar obligatorios. Se aplicaron tratamientos específicos para valores acumulados en el DRE y DVA, y para el cálculo de la deuda total. La etapa final consistió en la alineación de los datos contables con los datos de mercado: para índices que requerían precio contemporáneo, se utilizó el precio de cierre cercano a la fecha del estado; para la variable P/VP, se empleó el precio medio de la acción en el mes siguiente a la divulgación. Después de estos procedimientos, se obtuvo un dataframe consolidado con 4.646 observaciones de 251 empresas brasileñas, adecuado para la aplicación de los modelos de ML.
Definición de las variables y ingeniería de atributos
La etapa de ingeniería de atributos consistió en la conversión de divulgaciones contables brutas en indicadores financieros, ya que los archivos de la CVM no los proporcionan listos para usar. La variable dependiente fue la relación Precio/Valor Patrimonial (P/VP), calculada relacionando el precio promedio de las acciones en el mes siguiente a la divulgación del informe financiero al valor patrimonial contable de la empresa.
Las variables explicativas fueron seleccionadas para capturar dimensiones de desempeño y situación financiera, abarcando liquidez, rentabilidad, apalancamiento, desempeño operativo y múltiplos de mercado. Además de los indicadores financieros, se incluyeron la tasa Selic (variable macroeconómica) y el sector de actividad de la empresa (para considerar diferencias estructurales). La mayoría de las variables explicativas fueron construidas en forma relativa (índices o medidas proporcionales) para mejorar la comparabilidad entre empresas de diferentes tamaños. El logaritmo natural del activo total fue explícitamente incorporado como variable de tamaño. La Tabla 1 detalla los indicadores financieros utilizados.
Tabla 1. Indicadores financieros en la tabla final
| Indicador | Abreviatura | Descripción |
|---|---|---|
| Precio sobre Valor Patrimonial | P/VP | Según Braga (2009), el indicador proporcionó una medida de comparación entre el valor patrimonial de la organización y el valor de mercado atribuido a la compañía. |
| Liquidez Corriente | LC | Gitman (2010) señala que el índice de liquidez corriente mide la capacidad de la empresa para cumplir con sus obligaciones a corto plazo. |
| Retorno sobre capital propio | ROE | Este indicador describe el retorno obtenido sobre la inversión de los accionistas (Gitman, 2010). |
| Deuda Neta sobre Patrimonio Neto | DL/PL | Klem (2022) indica que el DL/PL demuestra el volumen de deuda que una empresa ha utilizado para financiar sus activos en relación con el patrimonio de los accionistas. |
| Retorno sobre Activo | ROA | Este indicador mide la capacidad de la empresa de generar resultados a partir de los recursos totales bajo su control (CFA Institute, 2024). |
| Beneficio por Acción | LPA | Este indicador representa la parte de las ganancias atribuibles a cada acción ordinaria en circulación durante el período (IFRS Foundation, 2023). |
| Margen EBITDA | Este indicador expresa la proporción de los ingresos que se convierte en resultado operativo antes de intereses, impuestos, depreciación y amortización (B3, 2025). | |
| Margen Neto | Este indicador demuestra la parte de los ingresos que efectivamente se convierte en beneficio neto al final del período (CFA Institute, 2024). | |
| Giro del Activo | Este indicador mide la eficiencia con la que la empresa utiliza sus activos para generar ingresos (CFA Institute, 2024). | |
| Activo Total | Este indicador corresponde al total de recursos económicos controlados por la entidad y reconocidos en su balance general (IFRS Foundation, 2021). |
Fuente: Resultados originales de la investigación
La elección de variables relativas fue también una decisión metodológica, ya que los algoritmos de aprendizaje en conjunto basados en árboles, aunque menos sensibles a la escala, se benefician de indicadores que se centran en diferencias económicamente significativas, separando el efecto del tamaño de la empresa del rendimiento financiero.
Modelos de machine learning
Para modelar la relación entre fundamentos financieros y precio de mercado, se utilizaron técnicas de aprendizaje automático basadas en métodos de “ensemble” con árboles de decisión. Se emplearon los algoritmos Random Forest, XGBoost y LightGBM.
El Random Forest, un método de “bagging” (bootstrap aggregating), entrena múltiples modelos a partir de diferentes muestras de los datos originales y combina sus predicciones para reducir la varianza y aumentar la estabilidad (Ji et al., 2022; Kolani, 2022).
XGBoost y LightGBM son algoritmos basados en “boosting”, que construyen modelos secuencialmente, corrigiendo los errores de los árboles anteriores para mejorar el rendimiento predictivo (Silva y Sátiro, 2024). XGBoost es una implementación escalable de “gradient boosting” (Zhang y Gong, 2020; Mo et al., 2020). LightGBM, también basado en “gradient boosting”, fue diseñado para alta eficiencia, utilizando estrategias como “Gradient-based One-Side Sampling” (GOSS) y “Exclusive Feature Bundling” (EFB), y un enfoque basado en histogramas para mayor velocidad y precisión predictiva (Ke et al., 2017; Wang et al., 2022).
La utilización conjunta de estos modelos permitió comparar diferentes formas de construcción de modelos “ensemble” y evaluar su desempeño basándose en métricas adoptadas en la literatura (Silva y Sátiro, 2024).
Técnica de explicabilidad
Debido a la complejidad y la falta de transparencia de los modelos de aprendizaje automático, se utilizó la Inteligencia Artificial Explicable (XAI) para mejorar la interpretabilidad (Hosain et al., 2024; Meske et al., 2022). Se empleó el método SHapley Additive exPlanations (SHAP), basado en la teoría de juegos cooperativos (Shapley, 1953), para asignar un valor de contribución a cada característica, reflejando su impacto marginal en la predicción del modelo (Parsa et al., 2020; Mizdrakovic et al., 2024).
SHAP ofrece explicaciones localmente precisas y globalmente consistentes, lo que permite descomponer las predicciones del modelo en contribuciones individuales de las características. Esto permitió examinar la importancia relativa, la dirección y la magnitud del efecto de cada variable en la evaluación financiera (Mizdrakovic et al., 2024). Los resultados de SHAP se visualizaron mediante gráficos de importancia de variables y gráficos “beeswarm”, lo que facilitó la comprensión de cómo cada variable influye en las predicciones generadas y los principales factores que afectan a la variable objetivo (P/VP) (Mizdrakovic et al., 2024; Hosain et al., 2024).
3. Resultados y Discusión
Caracterización de la muestra y evidencias preliminares
El conjunto de datos final comprendió 4.646 observaciones de 251 empresas brasileñas cotizadas en bolsa, en el período de 2020 a 2025. La variable dependiente fue la relación P/VP, calculada utilizando los precios de mercado observados tras la divulgación de la información contable correspondiente. Esta elección temporal preservó la naturaleza predictiva del ejercicio y redujo la posibilidad de contaminación por información futura.
El conjunto final de características combinó indicadores contables, un control macroeconómico representado por la tasa Selic, una variable para el tamaño de la empresa medida por el logaritmo natural del activo total y un identificador sectorial. Como se esperaba en una amplia muestra de empresas, los datos presentaron heterogeneidad entre las observaciones, con perfiles financieros distintos entre empresas de diferentes sectores, escalas y estructuras operativas y de capital.
La Tabla 2 presenta los indicadores financieros utilizados en el estudio, con sus respectivas abreviaturas y descripciones, según se definen en el TCC original.
Tabla 2. Indicadores financieros en la tabla final
| Modelo | R² (prueba) | RMSE (prueba) | MAE (prueba) | Brecha de sobreajuste |
|---|---|---|---|---|
| XGBoost | 0,644 | 1,228 | 0,669 | 0,326 |
| LightGBM | 0,574 | 1,348 | 0,742 | 0,367 |
| Random Forest | 0,427 | 1,570 | 0,848 | 0,262 |
Fuente: Resultados originales de la investigación
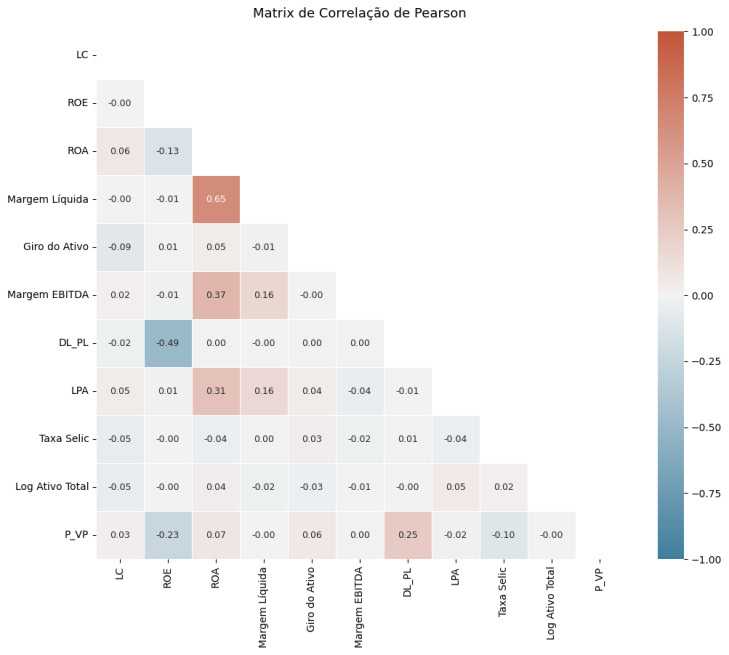
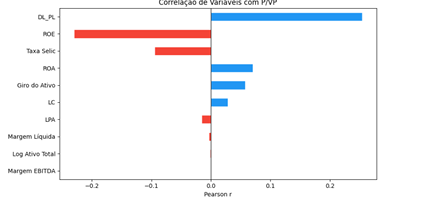
La Figura 1 presenta la matriz de correlación de Pearson para el conjunto final de características, mientras que la Figura 2 muestra la correlación entre cada variable explicativa y la relación P/VP. La estructura lineal de los datos es relativamente débil. Entre las variables explicativas, la relación Deuda Neta sobre Patrimonio Neto (DL/PL) presentó la correlación de Pearson positiva más fuerte con P/VP, mientras que el Retorno sobre el Patrimonio Neto (ROE) presentó la asociación lineal negativa más fuerte. En contrapartida, variables como Beneficio por Acción (BPA) y Retorno sobre Activo (ROA), que posteriormente se muestran centrales en el análisis no lineal, no presentaron la mayor correlación con la variable objetivo. Esta diferencia ya sugiere que la correlación por sí sola puede no resumir adecuadamente la relevancia predictiva de las variables.
Figura 1. Matriz de Correlación de Pearson del Conjunto Final de Características
Fuente: Resultados originales de la investigación
Figura 2. Correlación de Pearson entre cada característica y P/VP
Fuente: Resultados originales de la investigación
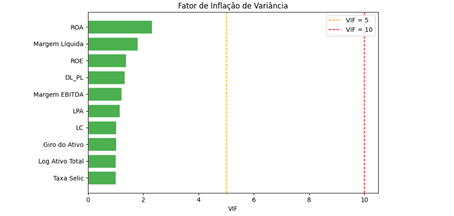
La Figura 3 muestra el factor de inflación de la varianza (VIF) para la especificación final. Todas las variables retenidas se mantuvieron muy por debajo de los umbrales convencionales utilizados para diagnosticar multicolinealidad problemática. Este resultado es importante porque indica que el conjunto final de características preserva dimensiones económicas distintas sin redundancia lineal, es decir, las variables explicativas no parecen ser réplicas lineales simples unas de otras.
Figura 3. Factor de Inflación de la Varianza del Conjunto de Características Final
Fuente: Resultados originales de la investigación
Desde el punto de vista metodológico, estos resultados iniciales son relevantes porque indican que el problema no es directo. Si la relación entre fundamentos y evaluación de mercado fuera lineal, las correlaciones por pares probablemente proporcionarían una clasificación mucho más clara de las variables. El hecho de que esto no ocurra está alineado con la literatura que demuestra que los métodos de aprendizaje automático se vuelven especialmente útiles en finanzas cuando las relaciones entre predictores y respuestas implican no linealidades e interacciones que las herramientas lineales estándar no representan bien (Gu et al., 2020).
Rendimiento predictivo de los modelos
Para evaluar el rendimiento predictivo, este estudio adoptó una estrategia de validación temporal. Los modelos se entrenaron utilizando observaciones hasta 2024 y se evaluaron en la muestra de 2025. Además, se utilizó un procedimiento de validación cruzada con ventana expansiva para evaluar el rendimiento fuera de la muestra a lo largo de varios años. Esta elección se hizo por estar más cercana a las condiciones reales de predicción, ya que el modelo siempre se estima utilizando información pasada y se prueba en observaciones futuras.
La Tabla 3 resume los resultados de la validación cruzada con ventana expansible. Los resultados muestran una clasificación clara: XGBoost obtuvo el mejor rendimiento promedio, seguido por LightGBM, mientras que Random Forest quedó por debajo de ambos modelos basados en boosting. Este resultado está en línea con la evidencia empírica que señala la superioridad de los métodos de boosting y las redes neuronales en problemas de fijación de precios de activos, especialmente en contextos con un gran número de variables y relaciones complejas (Gu et al., 2020). De esta manera, los resultados de este estudio confirman que los enfoques basados en aprendizaje automático ofrecen ganancias relevantes en relación con los modelos de regresión tradicionales.
Tabla 3. Validación cruzada con ventanas expansibles (media de las 4 ventanas temporales)
| Modelo | R² (entrenamiento) | R² (prueba) | RMSE (prueba) | MAE (prueba) |
|---|---|---|---|---|
| Random Forest | 0,697 | 0,368 | 1,578 | 0,787 |
| LightGBM | 0,912 | 0,468 | 1,448 | 0,745 |
| XGBoost | 0,933 | 0,469 | 1,447 | 0,717 |
Fuente: Resultados originales de la investigación
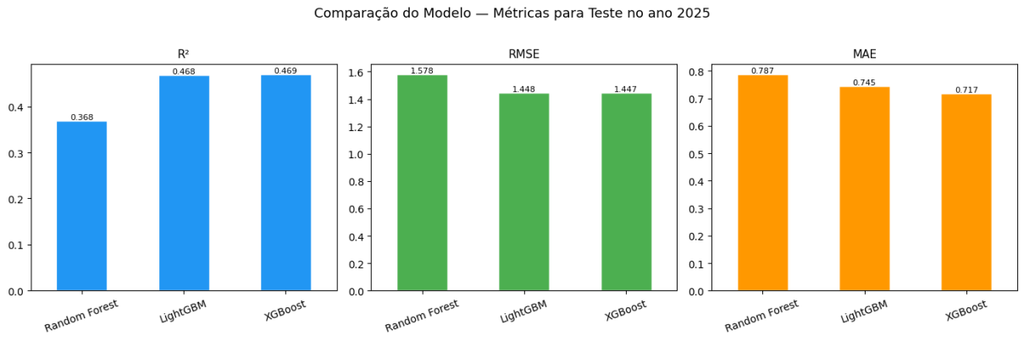
La Tabla 4 y la Figura 4 presentan los resultados finales de validación cruzada para 2025. En este año de prueba, XGBoost y LightGBM obtuvieron un rendimiento predictivo similar, y ambos superaron a Random Forest. La proximidad entre los dos modelos de boosting sugiere que la señal empírica principal no fue impulsada por una única implementación, sino por la capacidad general de los ensembles de árboles basados en boosting para modelar relaciones complejas con mayor flexibilidad que el benchmark de bagging. Este resultado está alineado con la literatura, que señala que los métodos de boosting tienden a presentar un rendimiento superior en problemas con elevada complejidad y no linealidad, ya que son capaces de corregir iterativamente los errores de los modelos anteriores y capturar interacciones más sofisticadas entre variables (Chen y Guestrin, 2016; Ke et al., 2017).
Tabla 4. Rendimiento final de los modelos (entrenamiento hasta 2024; prueba = 2025)
| Posición | Variable | Random Forest | LightGBM | XGBoost | Pos. media |
|---|---|---|---|---|---|
| 1 | LPA | 1 | 1 | 1 | 1,0 |
| 2 | ROA | 2 | 2 | 2 | 2,0 |
| 3-5 | DL/PL | 5 | 3 | 5 | 4,3 |
| 3-5 | Selic | 3 | 6 | 4 | 4,3 |
| 3-5 | ROE | 6 | 5 | 3 | 4,7 |
| 6-7 | Rotación de Activos | 4 | 7 | 6 | 5,7 |
| 6-7 | SECTOR_ACTIV | 8 | 4 | 7 | 6,3 |
| 8 | Log Activo Total | 9 | 8 | 8 | 8,3 |
| 9 | Margen Neto | 7 | 9 | 10 | 8,7 |
| 10 | LC | 10 | 10 | 9 | 9,7 |
| 11 | Margen EBITDA | 11 | 11 | 11 | 11,0 |
Fuente: Resultados originales de la investigación
Figura 4. Rendimiento de los modelos de ML en el conjunto de pruebas (2025)
Fuente: Resultados originales de la investigación
Al mismo tiempo, los resultados de rendimiento deben interpretarse con cautela. El R² de entrenamiento de los modelos de boosting se mantuvo significativamente por encima del R² de prueba, lo que sugiere cierto grado de sobreajuste (overfitting) incluso después de la regularización y la parada anticipada. Además, el año de validación de 2025 parece haber sido más difícil de predecir que la media de las validaciones cruzadas. Una posible explicación es que el entorno macrofinanciero de ese año hizo que la evaluación transversal fuera más difícil de explicar con los predictores disponibles. Esta interpretación es económicamente plausible, dado que los múltiplos de valoración reflejan tanto las expectativas sobre los flujos de caja futuros como las tasas de descuento aplicadas a ellos, de modo que los cambios en el entorno de las tasas de interés pueden modificar la forma en que los fundamentos contables se traducen en precios de mercado observados (Campbell y Shiller, 1988).
Análisis SHAP y clasificación de las variables explicativas
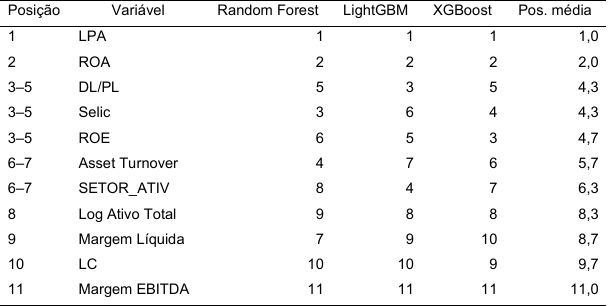
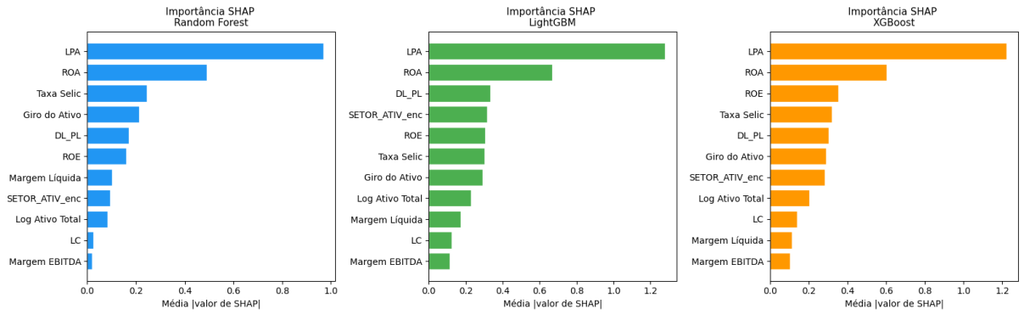
La Tabla 5 resume la clasificación SHAP en los tres modelos, mientras que la Figura 5 presenta los valores medios absolutos de SHAP correspondientes. El LPA aparece como la variable más importante en los tres algoritmos, mientras que el ROA ocupa consistentemente la segunda posición. Una segunda capa de variables incluye ROE, DL/PL, Selic, Giro del Activo y el indicador sectorial, con alguna variación entre los modelos. En contrapartida, la liquidez corriente, el margen neto y el margen EBITDA presentan una contribución marginal relativamente baja cuando se considera el conjunto de características más amplio.
Tabla 5. Ranking de importancia de las variables por modelo (SHAP)
Fuente: Resultados originales de la investigación
Figura 5. Importancia de las características SHAP
Fuente: Resultados originales de la investigación
La dominancia del LPA, junto con la relevancia del ROA y del ROE, indica que variables relacionadas con la rentabilidad constituyen la principal dimensión explicativa de la relación P/VP. Este resultado está alineado con la literatura clásica de fijación de precios de activos, que atribuye un papel central a la rentabilidad en la explicación de los retornos y múltiplos de mercado (Fama y French, 2015). Sin embargo, el presente estudio avanza al demostrar que esta relación no se manifiesta de forma estrictamente lineal, siendo mejor capturada por modelos basados en aprendizaje automático.
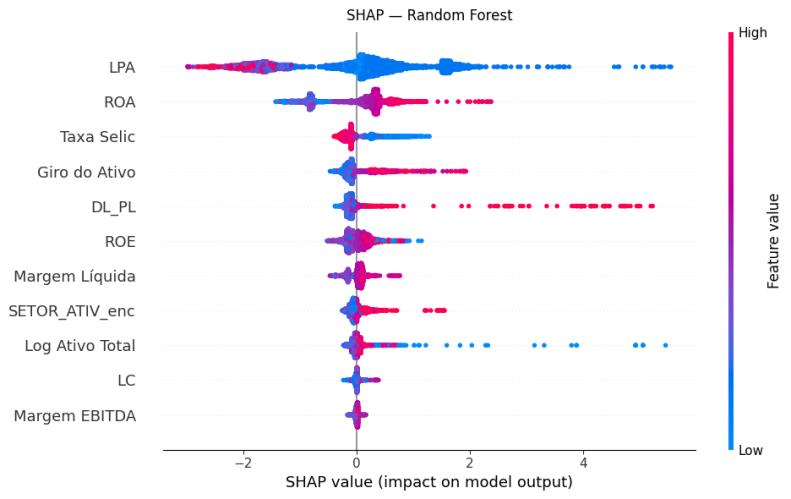
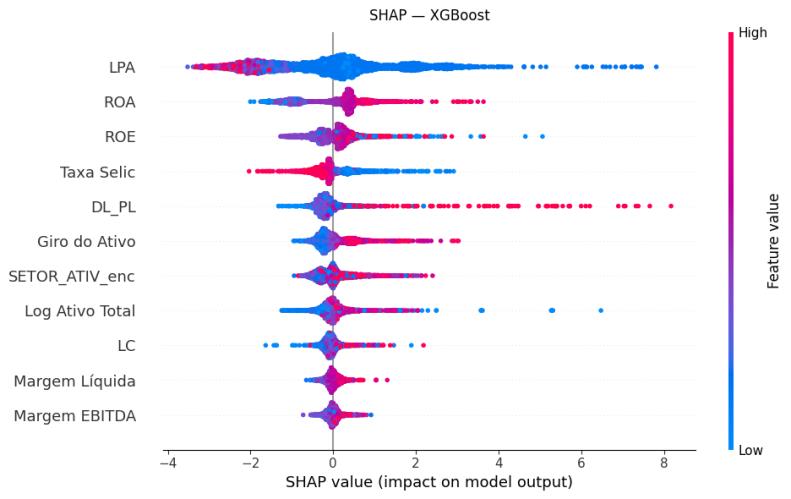
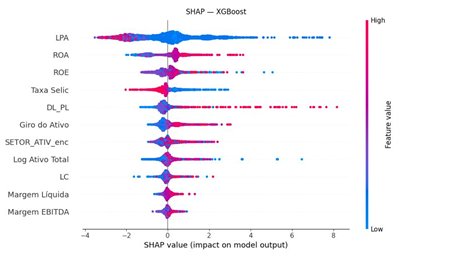
La Figura 6, la Figura 7 y la Figura 8 proporcionan información adicional a través de los gráficos de dispersión SHAP. Estas figuras muestran que las características principales no actúan de forma puramente lineal. En el caso del LPA, la contribución al resultado del modelo es fuerte y ampliamente dispersa entre las observaciones, pero su patrón direccional es diferente al esperado. Los valores más bajos de LPA tienden a asociarse con valores SHAP positivos, mientras que los valores más altos tienden a asociarse con valores SHAP negativos. En otras palabras, dentro del marco aprendido por los modelos, los beneficios por acción más bajos se asocian con un aumento en la relación P/VP prevista, mientras que los beneficios por acción más altos se asocian con una reducción en la relación P/VP prevista. Este resultado contrasta con la interpretación tradicional del análisis fundamentalista, en la que mayores beneficios por acción estarían directamente asociados a mayores múltiplos de valoración. Sin embargo, la literatura sugiere que los precios de mercado reflejan expectativas futuras y no solo resultados actuales, lo que puede explicar este comportamiento no lineal (Kelly y Xiu, 2023).
Figura 6. Gráfico de dispersión SHAP para Random Forest
Fuente: Resultados originales de la investigación
Figura 7. Gráfico de dispersión SHAP para LightGBM
Fuente: Resultados originales de la investigación
Figura 8. Gráfico de dispersión SHAP para XGBoost
Fuente: Resultados originales de la investigación
Los patrones de ROA y ROE también sugieren no linealidad y dependencia contextual. Sus distribuciones SHAP son asimétricas y no uniformes, lo que indica que su contribución depende no solo de su nivel, sino también de la configuración más amplia de las características de la empresa. El punto crucial es que los modelos no están simplemente aprendiendo que “más rentabilidad es siempre mejor” en un sentido lineal y uniforme. En cambio, están aprendiendo una estructura de valoración más compleja, en la que el efecto marginal de cada variable depende del contexto en el que aparece. Este resultado está alineado con la literatura, que muestra que los modelos de machine learning capturan interacciones y relaciones no lineales entre variables (Gu et al., 2020). Además, la propia estructura de SHAP evidencia contribuciones condicionales, dependientes del contexto de cada observación (Lundberg y Lee, 2017).
Correlación lineal versus importancia no lineal
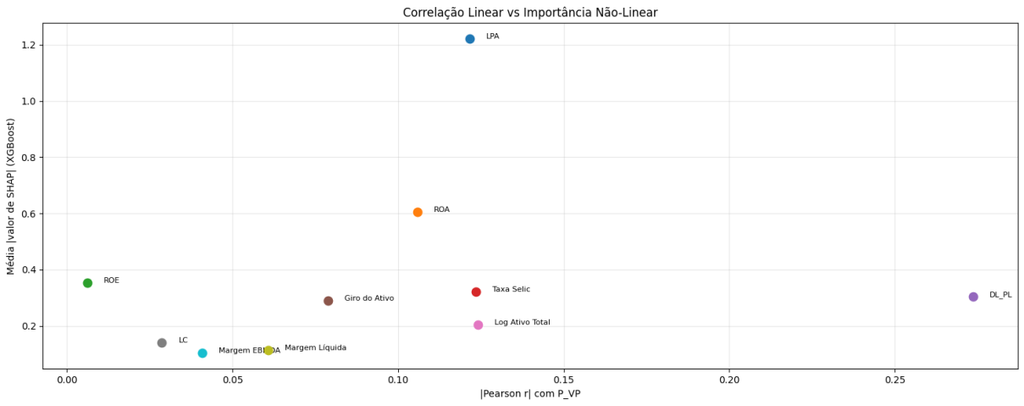
Uno de los hallazgos del estudio es el contraste entre la correlación lineal y la importancia no lineal. La Figura 9 compara directamente la correlación absoluta de Pearson de cada característica con el valor medio de SHAP obtenido por XGBoost.
Figura 9. Correlación Lineal vs. Importancia No Lineal
Fuente: Resultados originales de la investigación
Desde una perspectiva lineal por pares, DL/PL aparece como la variable más fuertemente asociada, mientras que LPA no destaca en su relación con el objetivo. Sin embargo, el análisis SHAP produce el resultado opuesto: LPA es el predictor dominante, mientras que ROA y ROE también ganan importancia en relación con su clasificación lineal. Este hallazgo es consistente con el estudio de Gu et al. (2020), que demuestra que los modelos no lineales capturan interacciones complejas entre variables que son ignoradas por enfoques lineales tradicionales. El estudio muestra que las ganancias predictivas de estos modelos provienen precisamente de la capacidad de modelar relaciones no lineales e interacciones entre predictores, lo que refuerza los resultados encontrados en este trabajo. Los modelos no lineales, por lo tanto, contribuyen no solo mejorando el rendimiento predictivo, sino también refinando la interpretación sustantiva de qué características de la empresa son más importantes para la evaluación de mercado. Esta conclusión está de acuerdo con la literatura que argumenta que las ganancias del aprendizaje automático en finanzas provienen, en gran medida, de su capacidad para acomodar interacciones predictivas no lineales que son ignoradas por los modelos convencionales (Gu et al., 2020; Ye et al., 2024).
Interpretación económica de los principales factores determinantes
Los resultados empíricos indican que la variación en la relación P/VP es explicada principalmente por información relacionada con la rentabilidad, aunque no siempre en la dirección sugerida por la intuición financiera simple. La posición de liderazgo de la ganancia por acción, seguida por el retorno sobre activos y, a continuación, por una segunda capa compuesta por endeudamiento/patrimonio neto, índice Selic y retorno sobre el patrimonio neto, muestra que el proceso de valoración capturado por los modelos depende principalmente de medidas relacionadas con la generación de beneficios, la estructura de capital y las condiciones macrofinancieras de las empresas. Fama y French (2015) muestran que la rentabilidad constituye uno de los principales determinantes de la fijación de precios de los activos, lo que es consistente con el predominio de las variables relacionadas con la generación de beneficios observado en este estudio.
Esta distinción es importante. Variables como ROA y ROE resumen el rendimiento económico en términos proporcionales, mientras que el BPA captura las ganancias a nivel de acción. Sin embargo, en el caso presente, el papel del BPA no puede interpretarse como una simple señal positiva de valoración. Aunque es el predictor más importante en los tres modelos, los diagramas SHAP indican un patrón direccional inverso: los valores más bajos de BPA tienden a asociarse con contribuciones positivas a la predicción de la relación P/VP, mientras que los valores más altos tienden a asociarse con contribuciones negativas. Esto sugiere que la información contenida en el BPA no se limita a la fuerza de las ganancias actuales. En cambio, parece capturar una distinción más amplia entre empresas con ganancias actuales más fuertes y empresas que cotizan con múltiplos contables más altos debido a otros atributos, como expectativas de crecimiento, posicionamiento sectorial, madurez del negocio o componentes de valor intangible no totalmente reflejados en la rentabilidad contable actual. Campbell y Shiller (1988) demuestran que los precios de mercado reflejan las expectativas sobre los flujos de caja futuros, mientras que Damodaran (2012) argumenta que los múltiplos de valoración incorporan el crecimiento esperado y el riesgo, lo que ayuda a explicar el comportamiento no lineal del BPA observado en este estudio.
El papel del ROA es más directo. Como la segunda variable más importante en todos los modelos, el ROA sugiere que el mercado otorga peso a la capacidad de la empresa para generar beneficios a partir de su base de activos. En este sentido, el ROA parece capturar una dimensión de eficiencia que sigue siendo relevante incluso después de controlar el beneficio por acción, el apalancamiento y las condiciones macroeconómicas. Penman (2013) asocia el retorno sobre activos con la eficiencia económica y la generación de valor, reforzando la interpretación del ROA como uno de los principales factores explicativos de la relación P/VP.
La contribución del ROE también es relevante, aunque menos estable en el ranking que el LPA y el ROA. Su posición entre las tres variables intermedias sugiere que el retorno sobre el patrimonio neto todavía importa para la evaluación, pero de una forma más condicional y dependiente del modelo. Esto está en consonancia con la idea de que el mercado no precifica el ROE de forma uniforme entre las empresas, dado que el mismo nivel de ROE puede reflejar combinaciones subyacentes muy diferentes de rentabilidad, apalancamiento y estructura de negocios. Damodaran (2012) destaca que el ROE puede reflejar diferentes combinaciones de rentabilidad, riesgo y estructura de capital, lo que ayuda a explicar por qué su efecto no se manifiesta de forma uniforme entre las empresas.
El papel del apalancamiento, medido por la relación entre DL/PL, también es más complejo de lo que sugiere la correlación lineal aislada. Aunque la DL/PL presentó la correlación más fuerte con la relación P/VP, su clasificación en SHAP se mantuvo por debajo de las principales variables relacionadas con la rentabilidad. Esto indica que el apalancamiento es relevante, pero no en un sentido unidireccional simple. En cambio, su contribución parece depender de la configuración más amplia de las características de la empresa, incluyendo la rentabilidad, el tamaño y el sector, es decir, el apalancamiento parece importar más como parte de una estructura de evaluación conjunta que como un factor explicativo aislado. Modigliani y Miller (1958) demuestran que la estructura de capital influye en el valor de la firma bajo ciertas condiciones, mientras que Myers (1984) argumenta que el apalancamiento interactúa con el riesgo y las oportunidades de inversión, lo cual es consistente con el comportamiento condicional observado en este estudio.
Este resultado está alineado con la teoría de fijación de precios de activos, según la cual los precios reflejan expectativas descontadas de flujos de caja futuros, siendo sensibles a las tasas de interés (Kelly y Xiu, 2023). En este sentido, la relevancia de la Selic en el ranking SHAP refuerza la idea de que la evaluación de mercado está moldeada no solo por información contable específica de la empresa, sino también por el entorno macrofinanciero en el que se fijan los precios de las empresas.
Finalmente, el Giro del Activo aparece en una posición intermedia, por debajo de las principales variables de rentabilidad, apalancamiento y macroeconómicas, pero aún con una contribución no despreciable. Esto sugiere que la eficiencia operativa en el uso de activos contiene información adicional para explicar el índice P/VP, aunque su papel sea claramente secundario en relación con los principales predictores.
En conjunto, estos resultados sugieren que los modelos están aprendiendo una estructura de valoración en la que las variables relacionadas con la rentabilidad dominan, pero sus efectos no son puramente lineales ni uniformes. El caso del LPA es especialmente importante en este sentido: es el predictor más relevante, pero su contribución direccional indica que la relación de mercado capturada por los modelos refleja más que una simple prima por beneficios actuales más altos. En cambio, los modelos parecen incorporar una distinción más amplia entre empresas con beneficios actuales sólidos y empresas que obtienen múltiplos de valoración más altos debido a otras características que el mercado valora.
Discusión de los resultados con base en la literatura
En primer lugar, los resultados refuerzan la idea de que las variables relacionadas con la rentabilidad ocupan una posición central en la explicación de la valoración de mercado, aunque no siempre en la dirección sugerida por la intuición financiera más inmediata. La relevancia consistente de LPA, ROA y ROE indica que la capacidad de las empresas para generar resultados sigue siendo una dimensión fundamental para explicar la variación entre valor de mercado y valor contable. Sin embargo, los resultados también muestran que esta relación no es puramente lineal ni uniforme. En particular, el comportamiento del LPA en los gráficos SHAP sugiere que su contribución a la predicción del P/VP depende de una estructura de valoración más compleja, posiblemente asociada a la interacción entre rentabilidad corriente, expectativas de crecimiento, madurez de la firma y características sectoriales. Aun así, en términos agregados, la centralidad de estas variables permanece compatible con la literatura que destaca la rentabilidad como una dimensión importante de la fijación de precios de mercado (Fama y French, 2015).
En segundo lugar, los resultados refuerzan la argumentación metodológica para la modelización no lineal en el análisis de estados financieros. La discrepancia entre la correlación de Pearson y la importancia de SHAP indica que gran parte de la señal económicamente significativa opera a través de formas e interacciones no lineales. Esto está en consonancia con la literatura que demuestra que los métodos de aprendizaje automático en finanzas generan ganancias cuando logran capturar estructuras que los modelos lineales no representan bien (Gu et al., 2020).
En tercer lugar, la evidencia confirma que los fundamentos de la empresa y las condiciones macrofinancieras dan forma conjuntamente a los múltiplos de valoración. El papel de la Selic demuestra que la información contable por sí sola no es suficiente para explicar la valoración de mercado; el entorno más amplio de la tasa de descuento también es relevante. Este resultado es consistente con la teoría de valoración estándar y con la literatura empírica sobre las relaciones de fijación de precios entre las características de la empresa y los resultados del mercado (Fama y French, 2015).
Limitaciones de los resultados
Una primera limitación se refiere al recorte temporal de la muestra, que comprende el período de 2020 a 2025. Aunque este intervalo incluye variaciones macroeconómicas relevantes, como cambios en la tasa de interés y diferentes condiciones de mercado, aún representa un horizonte relativamente corto para un estudio de naturaleza estructural sobre valoración. Además, este período está marcado por eventos atípicos, como los efectos de la pandemia de COVID-19, lo que puede limitar la generalización de los resultados a otros contextos históricos.
Una segunda limitación está relacionada con la construcción de la base de datos. La integración entre diferentes fuentes exigió etapas de tratamiento, filtrado y compatibilización de identificadores, lo que puede introducir errores residuales o pérdidas de información. Además, la exclusión de empresas con baja liquidez o con datos incompletos puede generar sesgo de selección, favoreciendo a empresas mayores, más consolidadas y con mayor cobertura de mercado, lo que puede afectar la representatividad de la muestra.
Otra limitación importante se refiere a la naturaleza de los datos contables utilizados. Los estados financieros reflejan información histórica y están sujetos a diferentes prácticas contables, revisiones y posibles distorsiones. Aunque se han realizado tratamientos para garantizar la consistencia, los indicadores derivados de esta información pueden no capturar completamente aspectos económicos más amplios, como la calidad de la gobernanza, los activos intangibles, el posicionamiento competitivo o las expectativas de crecimiento futuro, que son frecuentemente relevantes para la fijación de precios de mercado (Penman, 2013).
Adicionalmente, la elección de las variables explicativas, aunque basada en la literatura y la disponibilidad de datos, no es exhaustiva. Variables potencialmente relevantes, como métricas de mercado, indicadores de gobierno corporativo, cobertura de analistas, estructura de propiedad y expectativas de crecimiento, no fueron incluidas. Como consecuencia, parte de la variación observada en la relación P/VP puede estar asociada a factores no capturados por el modelo.
Desde el punto de vista metodológico, los modelos utilizados presentan una alta capacidad predictiva, pero también riesgo de sobreajuste (overfitting), especialmente en contextos con múltiples variables e interacciones complejas (Hastie et al., 2009). Aunque se adoptaron estrategias como la validación temporal y la prueba fuera de la muestra, los resultados indican diferencias relevantes entre el rendimiento en entrenamiento y prueba, lo que sugiere que parte del patrón aprendido puede no generalizarse completamente a nuevos datos.
Otra limitación importante está relacionada con la interpretación de los resultados a través de SHAP. Aunque el método permite descomponer las predicciones en contribuciones individuales de las variables, estas contribuciones son de naturaleza asociativa y no causal (Lundberg y Lee, 2017). Es decir, los resultados indican qué variables son relevantes para la predicción del modelo, pero no permiten afirmar que cambios en estas variables causarían cambios directos en la evaluación de mercado. Esta distinción es particularmente importante en contextos financieros, en los cuales múltiples factores interactúan de forma simultánea.
Además, el enfoque adoptado trata las observaciones principalmente como instancias independientes a efectos predictivos, sin explorar explícitamente la estructura de datos de panel. A diferencia de los modelos econométricos tradicionales, que permiten controlar efectos fijos y heterogeneidad no observada entre empresas y a lo largo del tiempo, los modelos de aprendizaje automático utilizados no incorporan directamente estas estructuras, lo que puede limitar la interpretación de los resultados en términos de dinámica temporal o diferencias estructurales entre firmas.
Finalmente, la variable dependiente utilizada (P/VP) representa solo una de las posibles métricas de valoración. Aunque ampliamente utilizada, tiene limitaciones conocidas, especialmente en sectores intensivos en activos intangibles o en empresas con estructuras contables específicas. Damodaran (2012) destaca que los múltiplos basados en valor contable pueden no capturar adecuadamente el valor económico de empresas con fuerte presencia de activos intangibles, lo que puede afectar la interpretación de los resultados. De esta forma, los resultados deben interpretarse como válidos dentro del contexto de esta métrica específica, no siendo necesariamente generalizables a otros múltiplos de mercado.
En resumen, los resultados de este estudio indicaron que los modelos de aprendizaje automático, particularmente los basados en boosting, presentaron un rendimiento superior en la explicación de la relación Precio sobre Valor Patrimonial de empresas brasileñas, superando al Random Forest. Se observó que la relación entre los fundamentos contables y la valoración de mercado no es estrictamente lineal, siendo mejor capturada por interacciones complejas. Variables de rentabilidad, como beneficio por acción, retorno sobre activos y retorno sobre el patrimonio neto, emergieron como los principales factores explicativos, aunque sus efectos se muestran contextuales y no uniformes, como se evidenció por el comportamiento no lineal del beneficio por acción. El análisis SHAP reveló una jerarquía de importancia de las variables distinta de la correlación lineal, reforzando la capacidad de los modelos no lineales para capturar patrones más sofisticados. Adicionalmente, la tasa Selic y el sector de actividad también contribuyeron a la comprensión de la fijación de precios, sugiriendo que el entorno macrofinanciero y las características sectoriales son relevantes. Estos hallazgos demuestran el potencial del aprendizaje automático, combinado con técnicas de interpretabilidad, para ofrecer perspectivas más transparentes sobre la dinámica de valoración en el mercado de valores brasileño.
4. Conclusión
Este estudio tuvo como objetivo evaluar la capacidad de los modelos de aprendizaje automático para explicar la relación Precio sobre Valor Patrimonial (P/VP) de empresas brasileñas cotizadas en B3. Se observó que los modelos de ensemble basados en boosting, como XGBoost y LightGBM, presentaron un rendimiento superior en la explicación del P/VP en comparación con Random Forest, lo que indica que la relación entre los fundamentos contables y la valoración de mercado no se manifiesta de forma estrictamente lineal. El análisis de interpretabilidad a través de Explicaciones Aditivas de Shapley (SHAP) reveló que las variables de rentabilidad, como el beneficio por acción (BPA), el retorno sobre activos (ROA) y el retorno sobre el patrimonio neto (ROE), ocuparon posiciones centrales en la explicación del P/VP. Sin embargo, se observó que el BPA exhibió un comportamiento no lineal y direccional distinto de la interpretación financiera tradicional, lo que sugiere que el mercado incorpora una estructura de valoración más compleja, que va más allá de los beneficios actuales. Adicionalmente, la tasa Selic y el sector de actividad también contribuyeron significativamente a la comprensión de la fijación de precios. La principal contribución del estudio reside en la demostración de que el aprendizaje automático, aliado a técnicas de interpretabilidad, ofrece perspectivas más transparentes y profundas sobre la dinámica de valoración en el mercado de valores brasileño, al capturar relaciones complejas y no lineales que los enfoques tradicionales frecuentemente ignoran.
A pesar de los hallazgos relevantes, el estudio tiene limitaciones que merecen consideración. El recorte temporal de la muestra (2020-2025), marcado por eventos atípicos como la pandemia de COVID-19, y la exclusión de empresas con baja liquidez, pueden afectar la generalización de los resultados. La naturaleza histórica de los datos contables y la no inclusión de variables como métricas de mercado o indicadores de gobernanza corporativa representan otras restricciones. Desde el punto de vista metodológico, aunque los modelos presentan alta capacidad predictiva, se notó un riesgo de sobreajuste, y las contribuciones SHAP son de naturaleza asociativa, no causal, además de no explorar explícitamente la estructura de datos en panel. La variable P/VP, aunque ampliamente utilizada, tiene limitaciones en sectores con muchos activos intangibles. Para estudios futuros, se sugiere la expansión del horizonte temporal de la muestra, la inclusión de un conjunto más amplio de variables explicativas, como activos intangibles y expectativas de crecimiento, y la exploración de modelos que incorporen explícitamente la estructura de datos en panel. Se recomienda también la aplicación de esta metodología a otras métricas de valoración para verificar la robustez de los resultados y profundizar la comprensión de la fijación de precios de activos en diferentes contextos.
Referencias Bibliográficas
Damodaran, A. 2012. Investment Valuation: Tools and Techniques for Determining the Value of Any Asset. 3ed. John Wiley & Sons, Hoboken, NJ, USA.
Ghashami, F.; Kamyar, K. 2021. Performance evaluation of ANFIS and GA-ANFIS for predicting stock market indices. International Journal of Economics and Finance 13(7): 1-6.
Jacques, K.S.; Cunha, M.F.; Fernandes, V.D.C.; Queiroz, L.M. 2021. Qual é o valor da empresa? O caso de valuation da empresa Magazine Luiza. Revista Ambiente Contábil 13(1): 359-377.
Lima, M.V.A.; Lima, M.A.; Pereira, M.F. 2011.
Moutinho, R.A.; Ambrozini, M.A.; Magnani, V.M. 2019. Análise do impacto do fluxo de caixa livre sobre o retorno acionário das companhias de capital aberto no mercado acionário brasileiro. Revista Mineira de Contabilidade 20(2): 55-69.
Tavares, A.L.; Silva, C.A.T. 2012. A análise financeira fundamentalista na previsão de melhores e piores alternativas de investimento. Revista Universo Contábil 8(1): 37-52.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haga clic aquí y acceda a la plataforma MBX Academy