La importancia de la organización de los datos en la era de la IA

Columna

Inteligencia Artificial

22 de octubre de 2025

La importancia de la organización de los datos en la era de la IA

Porque la calidad y el contexto de los datos son un factor diferencial competitivo en la era de la IA
Hoy, la inteligencia artificial ocupa el centro de las conversaciones estratégicas en las organizaciones. Más que una percepción individual, su presencia constante en eventos, capacitaciones y reuniones corporativas está confirmada por datos. El Artificial Intelligence Index Report 2025, publicado por la Universidad de Stanford —considerado el informe más confiable y completo sobre IA en el mundo— confirma el aumento expresivo de la relevancia del tema. En su 8ª edición, el documento muestra que la adopción de la tecnología creció de forma acelerada, y las inversiones privadas superaron la marca de 252 mil millones de dólares a nivel mundial. La inteligencia artificial dejó de ser un recurso experimental para convertirse en parte estructural de las decisiones, de los productos y de las estrategias.

Este avance es evidente en el siguiente gráfico, que muestra que el 78% de las organizaciones ya utilizan IA en al menos una función, mientras que el 71% ha adoptado soluciones de IA generativa. El salto entre 2023 y 2024 evidencia la aceleración de la adopción de estas tecnologías, que, además de automatizar procesos, ahora interactúan de forma natural y crean.
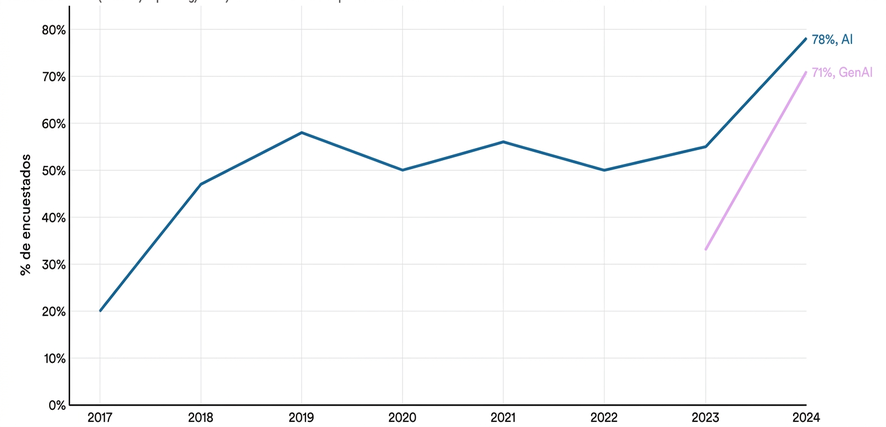
Participantes que afirman que su organización utiliza IA en al menos una función, 2017–2024
Fuente: Encuesta de McKinsey & Company, 2024.

A pesar de la popularidad del tema, muchas empresas aún no están preparando sus entornos internos para extraer lo mejor de la tecnología. Mirar a este escenario con pragmatismo, invirtiendo en estructura, organización y claridad sobre los datos que alimentan los modelos, puede representar un diferencial competitivo real en los próximos años. Es esencial desarrollar alfabetización en IA: comprender los fundamentos de la tecnología para participar de las decisiones con criticidad. Este texto no busca cubrir todos los aspectos de la inteligencia artificial, sino que se concentra en una etapa muchas veces descuidada: la calidad de los inputs, especialmente de los datos.

De forma simplificada, los modelos de IA son algoritmos estadísticos que procesan probabilidades basándose en grandes volúmenes de datos. En el caso de los LLM (Large Language Models), como los que están detrás de herramientas populares como ChatGPT o Gemini, estamos hablando de miles de millones — o incluso billones — de parámetros alimentados por bases masivas. Comprender esta escala es desafiante: un modelo de 8 mil millones de parámetros se considera pequeño, mientras que DeepSeek, con 80 mil millones, ya se clasifica como grande (y hay modelos mucho más grandes).

Pero modelos más grandes no significan necesariamente modelos mejores. El tamaño está ligado a la capacidad de cubrir más contextos, no a la calidad intrínseca de las respuestas. Un modelo entrenado con miles de millones de datos puede saber tanto sobre recetas como sobre programación, pero eso no garantiza precisión en cada dominio. Es justamente ahí donde reside tanto el potencial como el desafío: la calidad de los datos utilizados define, en última instancia, la calidad de las respuestas que estos modelos son capaces de entregar.

Imagine entrenar un modelo solo con datos de gastronomía, dejando fuera información sobre programación. Puede volverse extremadamente preciso en recetas, pero incapaz de responder sobre códigos y viceversa. Esta selectividad revela lo que se vuelve cada vez más relevante: modelos alimentados con datos contextualizados, curados y estructurados.
Gran parte de las llamadas “alucinaciones” generadas por modelos ocurre justamente por la influencia directa de los inputs en el resultado. Sam Altman, CEO de OpenAI, afirmó recientemente: “La gente tiene un grado muy alto de confianza en ChatGPT, lo cual es interesante, porque la IA tiene alucinaciones. Debería ser la tecnología en la que menos confías.” La confianza excesiva, sumada a la baja comprensión sobre el funcionamiento de los modelos, aumenta el riesgo de errores estratégicos y decisiones basadas en respuestas superficiales.

Se habla mucho de ingeniería de prompts — la disciplina de formular comandos de texto para obtener respuestas más asertivas. Pero, antes del prompt, es la calidad y la preparación de los datos lo que determina la eficiencia del modelo. Es en este contexto que ganan fuerza los SLM (Small Language Models), modelos más pequeños y específicos, entrenados con bases segmentadas. En lugar de intentar cubrir todos los contextos, están diseñados para actuar con profundidad en dominios delimitados.

Lucas de Oliveira y Felipe Silva, especialistas en tecnología y machine learning, destacan que, además de presentar mayor precisión, estos modelos también son energéticamente más eficientes. Un ejemplo es el Phi-3-mini, un modelo de 3.800 millones de parámetros que alcanzó un rendimiento equivalente al PaLM (540B) en pruebas de MMLU, un salto de eficiencia de 142 veces.

Sin embargo, utilizar modelos genéricos, sin entrenamiento contextual o base propietaria, aumenta el riesgo de resultados inconsistentes e incluso de exposición de información sensible. El simple acto de enviar archivos, hojas de cálculo o textos confidenciales a herramientas públicas de IA ya representa un riesgo a la privacidad y a la seguridad de los datos, ya que esta información puede ser incorporada a los procesos de entrenamiento de grandes modelos.

Hablo sobre la importancia de la alfabetización en IA porque, cuando abordamos el tema, surgen diferentes capas de discusión. Un término recurrente en estas conversaciones es el tuning — o, de forma simplificada, el entrenamiento de modelos. Este proceso consiste en proporcionar datos para que el modelo aprenda y se adapte a determinado contexto. La cantidad y la calidad de esta información influyen directamente en el resultado: es posible ofrecer un volumen reducido de datos y obtener un modelo pequeño y especializado, o trabajar con una masa gigantesca y crear modelos amplios y generalistas. En esencia, el entrenamiento es la forma de organizar y dirigir el comportamiento de un modelo para un contexto específico — como el ejemplo citado de la IA especialista en gastronomía y sin contexto de programación.

Cada organización posee datos únicos sobre sus operaciones, clientes y mercados. Tratar esta información de forma sistemática — organizándola de modo estructurado y estandarizado — crea un conjunto de datos equilibrados que facilitan estrategias de uso, ya sea en modelos estadísticos tradicionales, ya sea en algoritmos de predicción e inteligencias artificiales orientadas a la creación de escenarios y planes estratégicos.

Estos conjuntos de datos estructurados se denominan datasets: colecciones organizadas de información listas para el análisis. A partir de datasets internos, es posible construir soluciones capaces de actuar como agentes de apoyo contextualizados, alineados a la realidad y al lenguaje de cada negocio. Más que una inversión técnica, se trata de un cambio cultural: preparar personas, procesos y flujos para lidiar con datos de manera estratégica y consciente.

En este sentido, documentar bien nunca ha sido tan importante. Registros de reuniones, actas, trazabilidad de tareas y estandarización de procesos forman una base de conocimiento que, en el futuro, puede alimentar modelos internos de IA con contexto y precisión. Las organizaciones que ya poseían esta cultura tienen ventaja: sus datos están más igualados y, por lo tanto, pueden ser utilizados. Aquellas que no mantenían este cuidado necesitan actuar ahora —aunque sea de forma reactiva—, creando el hábito de registrar y organizar desde ya. La buena noticia es que las propias herramientas de IA pueden ayudar en este proceso.

Las plataformas de videoconferencia ya ofrecen recursos de transcripción automática; los modelos generativos ayudan a aplicar patrones en anotaciones e informes; y otras herramientas son capaces de resumir grandes volúmenes de información. El uso de estas IA auxilia en la preparación de datasets para el entrenamiento de nuevos modelos — o simplemente proporciona contexto adicional para prompts, aumentando la exactitud de los resultados.

Los modelos predictivos, cuando están bien estructurados, ayudan a anticipar riesgos y oportunidades. Pero para que esto ocurra, se necesita algo aún más fundamental: buenos inputs y personas con conocimientos de IA. Trabajar en un mundo post-IA generativa no se trata solo de crear buenos prompts o dominar herramientas. Se trata de entender que los modelos reflejan los datos que reciben: si la entrada es confusa, sesgada o desorganizada, la salida también lo será. En esencia, la inteligencia artificial es una tecnología de traducción de información, y su uso exige responsabilidad y sentido crítico sobre los datos que alimentan el sistema.

Por eso, organizar la información de forma consciente, estructurada y ética es quizás el mayor desafío — y la mayor ventaja competitiva — de las organizaciones en los próximos años. La asertividad de los modelos nace de la calidad de los inputs. Y la madurez digital se medirá, cada vez más, por la capacidad de comprender, proteger y valorar los propios datos. Los datos abiertos y externos están disponibles para todos, pero los que las organizaciones generan y tienen el privilegio de acceder serán su verdadero diferencial. Un dato puede existir, pero solo se vuelve valioso cuando está organizado y listo para ser procesado.

Para tener acceso a las referencias de este texto haga clic aquí.

Quién publicó esta columna

Lucas Tangi
Lucas é Design Manager no Pecege, formado em tecnologia e especialista em gestão de equipes criativas. Com ampla experiência liderando equipes de design, é também palestrante, professor e consultor. Já participou de projetos em consultorias de tecnologia, venture builders, ODS e na amazônia brasileira. Entusiasta e pesquisador de futuros, dedica-se à inovação e à criação de soluções com alto impacto social e econômico.

También te puede interesar

05 de octubre de 2026

Predicción de la morosidad de los planes de pago de deudas tributarias

El fraccionamiento de deudas tributarias constituye un instrumento relevante de recuperación fiscal, permitiendo a los contribuyentes regularizar sus obligaciones de forma fraccionada, al mismo tiempo que expone a la administración tributaria al riesgo de cancelación por incumplimiento. El objetivo fue desarrollar y evaluar modelos de machine learning para la predicción de cancelación de fraccionamientos de ICMS, con el fin de respaldar estrategias proactivas de cobro. Se utilizó una base de datos de fraccionamientos históricos de la Secretaría de Economía del Estado de Goiás. Se entrenaron y compararon los algoritmos Árbol de Decisión, Random Forest y XGBoost, con optimización de hiperparámetros vía GridSearchCV y evaluación por matrices de confusión y curvas ROC. El XGBoost presentó un rendimiento superior, con AUC de 0,869 en el modelo que incluyó la variable Cantidad de Cuotas y 0,778 sin ella, evidenciando la centralidad de esta característica. Aplicado a la cartera activa de R$ 2,752 mil millones, el modelo identificó que el 92,9% del valor total presentó riesgo de cancelación igual o superior al 50%, con R$ 1,488 mil millones concentrados en fraccionamientos de riesgo extremo, resultado consistente con el comportamiento histórico de cancelaciones en las fases iniciales de los acuerdos. Los resultados demostraron que la adopción de modelos predictivos en la gestión de fraccionamientos tributarios posibilita la transición de una postura reactiva a un enfoque preventivo, con potencial de ampliar sustancialmente la recuperación fiscal.

Palabras clave: Administración tributaria; Aprendizaje automático; Clasificación binaria; Recuperación fiscal; XGBoost.

05 de octubre de 2026

Sistema interactivo para la generación y comparación de modelos predictivos de concesiones mensuales de crédito rural

La capacidad de predecir el volumen futuro de concesiones de crédito rural es esencial para la asignación eficiente de recursos y la definición de metas de desembolso. El trabajo tuvo como objetivo desarrollar una plataforma interactiva web para generar, analizar y comparar modelos predictivos de series temporales de concesiones de crédito rural, abarcando el período de marzo de 2011 a enero de 2026. Se confrontaron técnicas de econometría (ARIMA, SARIMA, SARIMAX) y regresión lineal con métodos de machine learning (Random Forest, XGBoost). La metodología incluyó la recolección de datos mensuales de concesiones de crédito rural, variables macroeconómicas e indicadores de commodities agrícolas, seguida de análisis exploratorio y desarrollo de la plataforma en arquitectura cliente-servidor con Python y tecnologías web. La aplicación de la plataforma a la predicción de crédito rural en tres escenarios (total, persona física y persona jurídica), evaluada por validación cruzada temporal, reveló que ninguna técnica se mostró universalmente superior. Los modelos de regresión lineal con rezago estacional presentaron los resultados más consistentes a lo largo de todos los folds, manteniendo un desempeño estable incluso en períodos de cambio de nivel, en los cuales los algoritmos de árbol de decisión registraron una fuerte degradación. El escenario de persona jurídica presentó baja predictibilidad en todos los modelos. Los resultados demostraron que la plataforma cumplió su objetivo, revelando que la complejidad algorítmica no garantiza superioridad predictiva y que la elección del modelo debe guiarse por las características de la serie y por el contexto de aplicación.

Palabras clave: Agronegocio; Forecasting; Machine learning; Modelado predictivo; Series temporales.

05 de octubre de 2026

Festivales de música como plataforma de engagement de marcas con consumidores de la generación Z

Los festivales de música se han consolidado como ecosistemas complejos de experiencia, en los que la convergencia entre entretenimiento físico y narrativas digitales redefine las estrategias de posicionamiento de marca. En el escenario pospandemia, el sector de eventos presentó una recuperación expresiva, estableciéndose como plataforma estratégica para el compromiso con la Generación Z, público que prioriza la autenticidad y la vivencia de experiencias compartidas en detrimento de formatos de publicidad tradicional. El estudio tuvo como objetivo analizar de qué forma las activaciones de marca en estos entornos impactaron el compromiso de los consumidores nacidos entre 1995 y 2010. La metodología se caracterizó por una investigación cuantitativa y descriptiva, realizada mediante la aplicación de un cuestionario estructurado que obtuvo la participación de 163 encuestados. Los resultados demostraron que las estrategias de marketing de experiencia, especialmente aquellas que integraron atributos estéticos y potencial de compartición digital, presentaron las mayores medias de percepción positiva. Se verificó que la confianza en la marca se fortaleció tras interacciones físicas exitosas, revelando una simbiosis entre el ambiente emocional del evento y el viaje digital del joven. En contraste, la percepción de autenticidad mediada por influenciadores digitales obtuvo el menor índice de concordancia. Se concluyó que el compromiso de la Generación Z fue potenciado por estrategias híbridas que permitieron al consumidor asumir el papel de protagonista en la construcción de la narrativa de la marca, priorizando la autenticidad de la vivencia directa.

Palabras clave: Comportamiento del consumidor; Consumo cultural; Estrategias transmedia; Influenciadores digitales; Marketing de experiencia.

Cumplimiento Y Esg

05 de octubre de 2026

Cumplimiento para mitigar y prevenir robos en obras de construcción: Programa de integridad aplicado a la construcción civil

Los robos en obras representan un desafío significativo para la construcción civil, generando impactos financieros, operativos y reputacionales. En este contexto, los programas de integridad y compliance han surgido como herramientas de gestión para fortalecer la gobernanza y mitigar riesgos. El estudio tuvo como objetivo proponer un programa de conformidad aplicado a la construcción civil, enfocado en la prevención y mitigación de robos en obras. Se adoptó un enfoque cualitativo, con apoyo cuantitativo, desarrollado en dos etapas. En primer lugar, se realizó una investigación de campo entre febrero y marzo de 2026, aplicando un cuestionario electrónico a profesionales del sector. A continuación, se elaboró un estudio de caso ficticio, basado en experiencias profesionales del autor, integrando los resultados de la investigación a prácticas de gestión de riesgos y gobernanza. Los resultados evidenciaron la importancia de la implementación de programas de compliance en el sector e indicaron que la combinación de mecanismos de control, procesos estructurados, capacitación de equipos, canales de denuncia, monitoreo continuo y fortalecimiento de la cultura ética puede reducir vulnerabilidades. Se concluyó que la adopción de prácticas de integridad amplía la capacidad preventiva de las organizaciones y mejora la gobernanza y la gestión de riesgos en el sector.

Palabras clave: Compliance; Construcción civil; Robos; Gestión de riesgos; Gobernanza corporativa.

05 de octubre de 2026

Panel multiseñal para la optimización de la priorización de vulnerabilidades en ciberseguridad

La creciente proliferación de vulnerabilidades cibernéticas ha hecho inadecuada la priorización basada exclusivamente en métricas estáticas de severidad. Se desarrolló y evaluó un panel analítico multiseñal para optimizar la priorización de vulnerabilidades cibernéticas, integrando Common Vulnerability Scoring System (CVSS), Exploit Prediction Scoring System (EPSS), criterios derivados del Stakeholder-Specific Vulnerability Categorization (SSVC) y el catálogo Known Exploited Vulnerabilities (KEV) como variable objetivo supervisada. Se consolidaron 137.854 registros de vulnerabilidades del NVD (2022–2025), con 607 KEVs confirmados (0,44%), caracterizando un problema de clasificación con clase fuertemente desbalanceada. Se entrenó un modelo Random Forest supervisado con diez variables no circulares y se evaluó por métricas adecuadas al desbalanceamiento. El modelo alcanzó AUC-ROC de 0,9869 y AUC-PR de 0,4959, superando al EPSS aislado en ambas métricas (AUC-ROC=0,9383 y AUC-PR=0,3231). El análisis de discrepancias con el enfoque determinista del SSVC reveló que el 83,4% de las vulnerabilidades fueron sobrepriorizadas. De los 4.584 CVEs clasificados como P0, 4.029 representaron vulnerabilidades de alto riesgo inminente no confirmadas como explotadas, señaladas por el modelo. Se concluyó que el enfoque multiseñal va más allá de la consulta al catálogo KEV, identificando vulnerabilidades con alto potencial de explotación futura y orientando la priorización proactiva de remediación.

Palabras clave: Predicción de exploits; Gestión de riesgos; Gestión de vulnerabilidades; Known Exploited Vulnerabilities (KEV); Random Forest.

Neurociencia Y Aprendizaje En La Educación

05 de octubre de 2026

Meditación: una herramienta que colabora con el profesor en el aula

El estudio tuvo como objetivo investigar las prácticas meditativas, sus beneficios, limitaciones y posibilidades de aplicación en el contexto escolar, con enfoque científico y en publicaciones existentes, con el fin de ampliar estrategias de promoción de la salud mental y el bienestar de estudiantes y profesores. Se realizó una investigación exploratoria y descriptiva, de enfoque cualitativo, fundamentada en una revisión bibliográfica de artículos científicos, libros y documentos publicados en los últimos diez años, y en relatos de experiencia de la investigadora. La metodología incluyó la definición científica de meditación y el análisis de estudios sobre meditación y atención plena en entornos escolares, incorporando contribuciones de la neurociencia, pero evitando reduccionismos biológicos del aprendizaje. Como resultado principal, se elaboró un Manual de Prácticas Meditativas para Profesores, concebido como material de apoyo pedagógico complementario. Los hallazgos indicaron que la meditación puede contribuir a la reducción de síntomas de estrés, ansiedad y depresión, además de favorecer la atención, la autorreflexión, la empatia y la convivencia. Se concluyó que el manual ofrece orientaciones sencillas y adaptables para el aula, siendo una herramienta complementaria que no sustituye intervenciones pedagógicas o políticas públicas. La sostenibilidad de estas prácticas requiere articulación con el proyecto pedagógico, apoyo institucional y formación docente, integrando neurociencia, pedagogía y experiencia práctica para una educación más atenta a las dimensiones cognitivas, emocionales, sociales y existenciales de los alumnos.

Palabras clave: Entorno escolar; Atención plena; Meditación; Neurociencia; Salud mental.