
15 de septiembre de 2026
Segmentación de Clientes Financieros por Clusterización y Aprendizaje No Supervisado
Luciana Martins Esteves; Henrique Raymundo Gioia
DOI: 10.22167/2675-6528-202602263
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
La creciente disponibilidad de datos en el sector financiero ha hecho relevante el uso de técnicas analíticas para la segmentación y el apoyo a la toma de decisiones. El estudio tuvo como objetivo aplicar técnicas de clusterización a una base de clientes, con el fin de identificar grupos homogéneos e interpretar perfiles distintos basándose en variables financieras, conductuales y de registro. Metodológicamente, la investigación se clasificó como aplicada, descriptiva y cuantitativa, llevada a cabo como estudio de caso con 750 registros. Inicialmente, los datos fueron preparados, tratados y estandarizados. A continuación, se aplicó el algoritmo K-Means, probando diferentes valores de k y utilizando métricas internas de validación (WCSS, silhouette, Calinski-Harabasz y Davies-Bouldin). También se realizó una comparación con métodos jerárquicos y un análisis estadístico complementario por ANOVA. Los resultados mostraron que, aunque la solución con dos clusters presentó un mejor rendimiento estadístico en parte de las métricas, la configuración con tres grupos tuvo una mayor capacidad interpretativa y analítica. Los clusters identificados distinguieron clientes con mayor vulnerabilidad financiera, perfil intermedio y mayor valor económico, con diferencias relevantes en ingresos, endeudamiento, utilización del crédito, inversión y reserva de emergencia. Se concluyó que la clusterización fue eficaz para segmentar la base analizada y demostró potencial para apoyar la interpretación de perfiles y la toma de decisiones orientada por datos.
Palabras clave: aprendizaje no supervisado; ciencia de datos; clusterización; K-Means; segmentación de clientes.
1. Introducción
La creciente digitalización del sector financiero ha ampliado significativamente la generación, el almacenamiento y el uso estratégico de datos de clientes. En el contexto bancario contemporáneo, la competitividad ha dejado de depender únicamente de la oferta de productos estandarizados y ha pasado a exigir una mayor capacidad analítica para comprender perfiles, comportamientos y necesidades específicas de los consumidores.
En Brasil, este movimiento ha sido intensificado por la expansión de los canales digitales, la maduración del Open Finance y el uso creciente de inteligencia artificial y análisis predictivos para la personalización de productos y servicios. La Federación Brasileña de Bancos (FEBRABAN, 2025) señala que la personalización se impulsa, entre otros factores, por el uso de datos compartidos vía Open Finance y por análisis basados en inteligencia artificial. El Banco Central de Brasil (BCB, 2023) destaca que el ecosistema de Open Finance busca ampliar el acceso a servicios financieros más adecuados al perfil y a la necesidad de cada cliente. En este escenario, el uso de métodos analíticos capaces de transformar grandes volúmenes de datos en conocimiento aplicable se ha vuelto relevante tanto para la diferenciación competitiva como para la mejora de la experiencia del cliente.
Desde el punto de vista teórico, la clusterización ocupa una posición importante en la Ciencia de Datos y en la minería de datos por permitir la identificación de estructuras latentes en bases sin rótulos previos. Jain, Murty y Flynn (1999) definen la clusterización como la clasificación no supervisada de patrones en grupos, resaltando su utilidad como etapa de análisis exploratorio de datos. En la misma dirección, Han, Kamber y Pei (2012) tratan la clusterización como una de las técnicas centrales de minería de datos para el descubrimiento de patrones, la organización de bases complejas y el apoyo a la generación de conocimiento a partir de los datos.
Desde una perspectiva más amplia del aprendizaje estadístico, Hastie, Tibshirani y Friedman (2009), así como James et al. (2021), sitúan los métodos no supervisados como herramientas apropiadas cuando el interés del investigador está menos en predecir una variable de respuesta y más en comprender la estructura interna de los datos, identificar similitudes y describir perfiles basados en múltiples atributos observados. Así, la clusterización se muestra especialmente pertinente cuando el problema de investigación involucra heterogeneidad de clientes, diversidad comportamental y necesidad de segmentación orientada por evidencia, y no solo por criterios intuitivos o administrativos.
En el sector bancario y financiero, la literatura reciente ha reforzado la utilidad de la segmentación analítica de clientes con fines de personalización, retención, diseño de ofertas y priorización comercial. Estudios recientes muestran que algoritmos de clusterización, especialmente el K-Means, se han empleado para agrupar clientes a partir de atributos financieros, transaccionales y conductuales, permitiendo distinguir patrones de consumo, riesgo y valor económico. En un trabajo reciente, Yan et al. (2025) demostraron que enfoques de clusterización aplicados al contexto bancario pueden apoyar estrategias de marketing más precisas, mientras que Nofal (2024) mostró que la combinación entre características transaccionales y técnicas de aprendizaje automático posibilita identificar clientes de mayor valor en bases bancarias reales.
Estos resultados dialogan con la literatura aplicada más amplia, que reconoce la segmentación como instrumento para convertir datos brutos en perfiles accionables, con potencial para orientar decisiones más precisas. A pesar de ello, la calidad de la segmentación depende de elecciones metodológicas consistentes, como la selección de variables, la estandarización de los datos, la definición del número de clústeres y la validación de la solución encontrada, lo que exige rigor técnico y justificación teórica para que los resultados no sean interpretados como simples agrupaciones arbitrarias.
La relevancia de este trabajo se deriva, por lo tanto, de dos aspectos complementarios. En el plano práctico, la investigación responde a la creciente necesidad de segmentar clientes de forma más precisa en entornos financieros marcados por la competencia, la digitalización y la personalización intensiva. En el plano académico, el estudio contribuye al aplicar fundamentos de Ciencia de Datos a un problema concreto de segmentación, articulando técnicas de clusterización con métricas de validación e interpretación analítica de los grupos formados. De esta forma, se evita una lectura meramente descriptiva o institucional del fenómeno y se refuerza un enfoque metodológicamente fundamentado, apoyado en la literatura de minería de datos, aprendizaje no supervisado y aplicaciones financieras. En este sentido, el objetivo de este trabajo fue aplicar técnicas de clusterización a una base de clientes del sector financiero, con el fin de identificar segmentos con características homogéneas y estadísticamente distinguibles, capaces de subsidiar la interpretación de perfiles y apoyar decisiones orientadas por datos.
2. Material y Métodos
La investigación se clasificó como aplicada, descriptiva y cuantitativa. En cuanto a su finalidad, buscó generar conocimiento con utilidad práctica para la comprensión y segmentación de clientes a partir de datos financieros y conductuales. En relación con los objetivos, procuró identificar, analizar y describir patrones presentes en la base de datos, evidenciando diferencias entre los grupos formados. Desde la perspectiva del abordaje del problema, fue cuantitativa, involucrando el uso de datos numéricos, métricas estadísticas y técnicas computacionales. En términos de procedimientos técnicos, el trabajo asumió características de estudio de caso, desarrollado a partir de una base específica analizada en profundidad.
La base de datos utilizada se compuso de 750 registros de clientes y 26 columnas, contemplando variables de naturaleza financiera, comportamental y de registro, además de las etiquetas de clúster generadas. Se trató de una base anonimizada, oriunda del entorno analítico de una institución del sector financiero actuante en Brasil, sin identificación nominal de la organización, de los clientes o de informaciones sensibles individualizadas. Las variables analizadas abarcaron indicadores de renta, patrimonio, saldo en cuenta, límite de tarjeta, inversión mensual, utilización de crédito, porcentaje de atraso, tasa de endeudamiento, reserva de emergencia, tiempo de relación, canal de interacción predominante y encuadramiento en segmentos previamente identificados. La elección de estas variables se justificó por su adherencia al problema de investigación, exigiendo atributos capaces de discriminar diferentes perfiles de clientes en términos de valor económico, exposición al riesgo, intensidad de uso de productos financieros y patrón de relación con la institución. La base final incorporó las etiquetas generadas por los métodos de agrupamiento aplicados, incluyendo K-Means y enfoques jerárquicos.
La etapa de preparación y tratamiento de los datos tuvo como objetivo garantizar la calidad, consistencia y adecuación de la base para la aplicación de las técnicas de clusterización. Inicialmente, se realizó la inspección para identificar inconsistencias, como registros duplicados (eliminados) y valores ausentes (tratados según la naturaleza de la variable, con imputación simple o mantenimiento). A continuación, se realizaron ajustes de tipificación de las variables (numéricas, categóricas y temporales). También se llevó a cabo un análisis exploratorio para comprender la distribución de las variables e identificar posibles valores atípicos (outliers), que se mantuvieron cuando representaban características reales de los clientes y se eliminaron solo si eran inconsistencias o errores. Las variables categóricas relevantes se mantuvieron para la interpretación de los clusters. La base se estructuró en un formato adecuado para la aplicación de los algoritmos de clusterización.
La estandarización de las variables se realizó mediante la puntuación z, una técnica que transforma las variables a una misma escala con media igual a cero y desviación estándar igual a uno. Este procedimiento se aplicó exclusivamente a las variables numéricas utilizadas en la etapa de modelado, con el objetivo de garantizar que todos los atributos contribuyeran de manera equilibrada a la formación de los grupos, evitando que variables con una escala numérica mayor ejercieran una influencia desproporcionada.
La etapa de clusterización se realizó para identificar grupos homogéneos de clientes, utilizando el algoritmo K-Means. El K-Means divide un conjunto de datos en k grupos, buscando mayor similaridad interna y disimilaridad externa, medida por la distancia euclidiana. El proceso implica la definición de k, selección aleatoria de centroides iniciales, asignación de observaciones al centroide más cercano, y recálculo iterativo de los centroides hasta la convergencia. El objetivo del algoritmo es minimizar la suma de las distancias cuadráticas entre los puntos y los centroides de sus respectivos clusters (WCSS), representada por la Ecuación 1:
WCSS = Σ₁=1* Σ(x ∈ Ci) ||x – μ₁||²
(Ec. 1)
Donde Ci representa el conjunto de puntos pertenecientes al clúster i, x representa cada observación del grupo y μ¡ corresponde al centroide de ese clúster. El algoritmo se aplicó a la base previamente tratada y estandarizada, justificándose por su capacidad para manejar bases de tamaño moderado y múltiples variables numéricas.
La definición del número de clusters (k) y la validación de la calidad de los agrupamientos fueron etapas esenciales. Se probaron diferentes valores de k, variando de 2 a 10, utilizando métricas internas de validación: Within-Cluster Sum of Squares (WCSS), puntuación de silueta, índice de Calinski-Harabasz e índice de Davies-Bouldin. El análisis conjunto de estas métricas indicó un mejor rendimiento estadístico para la configuración con dos clusters (k = 2). Sin embargo, se optó por la adopción de tres clusters (k = 3) en el análisis final, fundamentada en la mayor capacidad de interpretación y segmentación de los perfiles de clientes. Adicionalmente, se analizó la curva de inercia (método del codo), que demostró una reducción significativa de la variabilidad hasta un determinado punto.
Para comparar la estructura de los grupos y evaluar la robustez de la segmentación, se probaron enfoques jerárquicos de agrupamiento, incluyendo single linkage, complete linkage y average linkage. Para comparar los agrupamientos generados, se utilizó el Adjusted Rand Index (ARI), que evalúa el grado de concordancia entre dos soluciones de clusterización. Los resultados mostraron que los métodos jerárquicos complete linkage y average linkage presentaron una alta concordancia entre sí, mientras que el single linkage presentó baja estabilidad. En comparación, el K-Means produjo grupos más equilibrados en términos de distribución de observaciones y mostró concordancia moderada con los enfoques jerárquicos más robustos.
Tras la definición y validación de los agrupamientos, se realizó el análisis de los perfiles de los clústeres para interpretar sus características predominantes. El análisis se llevó a cabo a partir de las medias de las variables numéricas en cada clúster, considerando indicadores financieros, conductuales y de relación. Variables categóricas, como canal predominante de interacción y clasificación en segmentos, también fueron consideradas para enriquecer la interpretación. Los clústeres fueron descritos de forma interpretativa, sintetizando los principales rasgos de cada grupo y comparando las diferencias que los distinguen entre sí.
Con el objetivo de verificar si los clústeres identificados presentaban diferencias estadísticamente significativas, se aplicó el ANOVA a las variables numéricas consideradas en el estudio. El ANOVA se aplicó a las principales variables financieras y de comportamiento de la base, como renta mensual, saldo en cuenta, inversión, utilización de crédito, porcentaje de atraso y tasa de endeudamiento. Además de la significancia estadística (valor p), se consideró la magnitud del efecto por medio del eta cuadrado parcial (η²). Los resultados del ANOVA indicaron que la mayor parte de las variables analizadas presentaron diferencias estadísticamente significativas entre los clústeres, con valores de p inferiores al nivel de significancia adoptado, y diversas variables presentaron elevados valores de eta cuadrado parcial.
La ejecución del pipeline analítico se realizó con el lenguaje de programación Python. Para el tratamiento y manipulación de los datos, se utilizaron las bibliotecas Pandas y NumPy. El análisis exploratorio y la visualización de los datos, incluyendo el análisis de la curva de inercia, se llevaron a cabo con el apoyo de la biblioteca Matplotlib. Para la aplicación de las técnicas de clusterización (K-Means y métodos jerárquicos) y validación de los agrupamientos (silhouette score, índice de Calinski-Harabasz e índice de Davies-Bouldin), se utilizó la biblioteca Scikit-learn. El análisis estadístico, incluyendo el ANOVA, se realizó con el soporte de bibliotecas especializadas en estadística computacional. El entorno de desarrollo utilizado se basó en notebooks interactivos.
3. Resultados y Discusión
La aplicación de técnicas de clusterización a la base de clientes evidenció la capacidad de transformar datos heterogéneos en grupos analíticamente distintos e interpretables, alineándose a la literatura de minería de datos y aprendizaje no supervisado. La calidad de la segmentación dependió de la combinación entre cohesión interna, separación entre grupos y utilidad sustantiva de los resultados (Jain, 2010; Han, Kamber y Pei, 2012; Hair et al., 2019). La discusión se organizó para examinar la definición del número de clusters, la comparación entre métodos, el equilibrio de la partición final y la interpretación de los perfiles identificados.
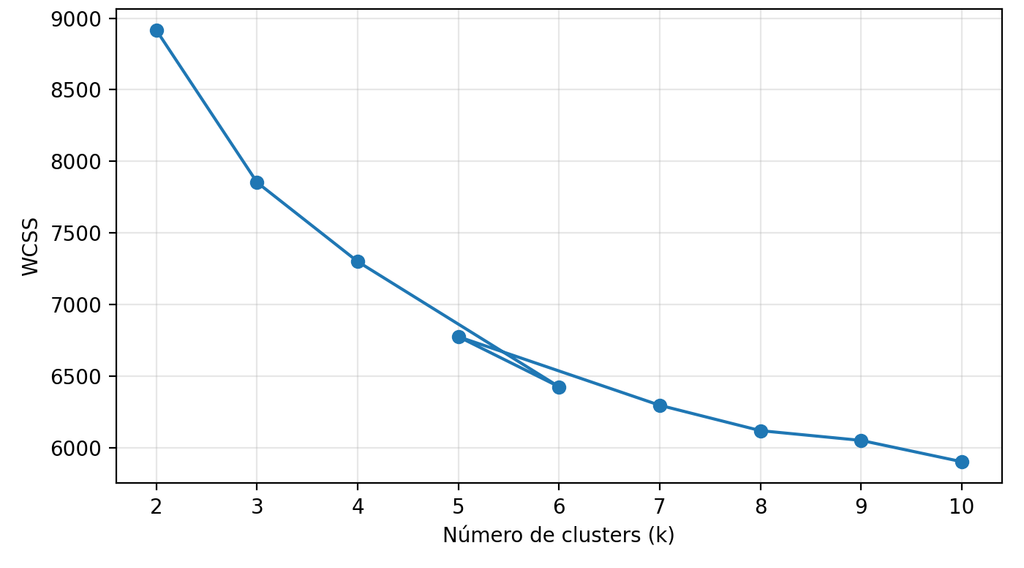
La curva de inercia se utilizó para evaluar la reducción de la variabilidad intra-clúster a medida que aumentaba el número de grupos. La Figura 1 ilustra este comportamiento.
Figura 1. Curva de inercia del K-Means
Fuente: Resultados originales de la investigación
La Figura 1 demostró una caída pronunciada de la inercia entre k=2 y k=4, seguida de una reducción progresivamente menor para valores superiores. Este patrón, compatible con el método del codo, sugirió que las mayores ganancias de compactación ocurrieron en las primeras particiones. Esto indica que soluciones con pocos grupos ya capturan una porción relevante de la estructura interna de la base, pero el análisis conjunto con métricas adicionales y la interpretabilidad de los segmentos generados son indispensables.
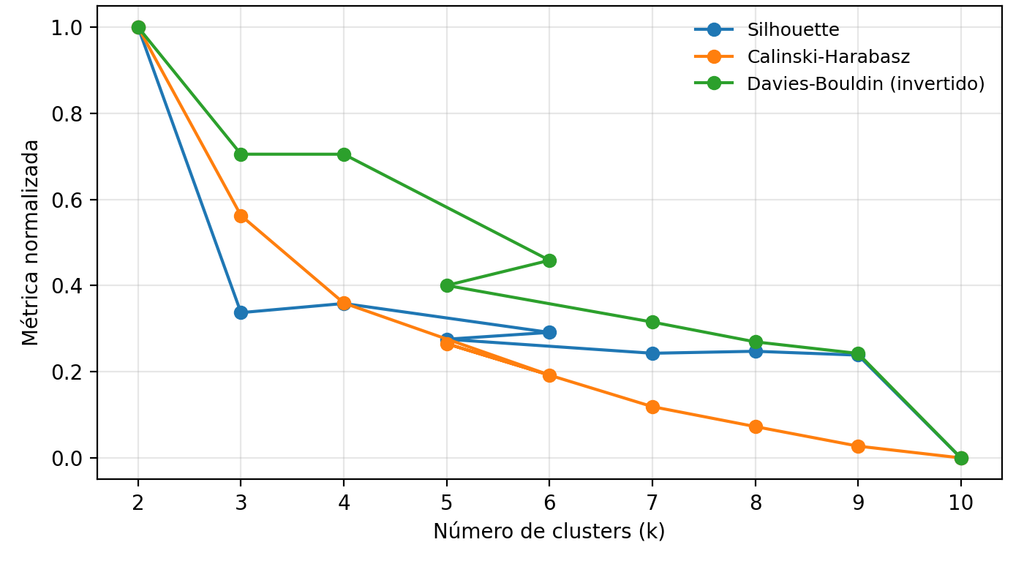
La comparación normalizada de las métricas internas de validación, presentada en la Figura 2, permitió confrontar diferentes criterios de calidad para la elección del número de clústeres.
Figura 2. Comparación normalizada de las métricas internas de validación
Fuente: Resultados originales de la investigación
La Figura 2 indicó que k=2 presentó el mejor rendimiento relativo en las métricas de silueta, Calinski-Harabasz y Davies-Bouldin (invertido), señalando un mayor equilibrio entre la cohesión interna y la separación entre grupos. Sin embargo, se optó por profundizar el análisis con k=3, una decisión metodológicamente defendible que consideró la mayor capacidad de interpretación y segmentación de los perfiles de clientes, conforme a la literatura que recomienda considerar la utilidad analítica y práctica de los agrupamientos (Han, Kamber y Pei, 2012).
Para comparar la consistencia estructural de los agrupamientos obtenidos por técnicas distintas, la Tabla 1 presenta los valores del Adjusted Rand Index (ARI) entre las soluciones del K-Means y de los métodos jerárquicos.
Tabla 1. Comparación entre métodos de agrupamiento por el Adjusted Rand Index
| Comparación | ARI | Lectura |
|---|---|---|
| kmeans x hier_single | -0.000 | Baja |
| kmeans vs. hier_complete | 0.452 | Mediana |
| kmeans vs. hier_average | 0.581 | Mediana |
| hier_single x hier_complete | 0.007 | Baja |
| hier_single vs. hier_average | 0.009 | Baja |
| hier_completa x hier_promedio | 0.886 | Inscripción |
Fuente: Resultados originales de la investigación
La Tabla 1 evidenció que la mayor convergencia ocurrió entre complete linkage y average linkage, con un ARI elevado, mientras que el single linkage presentó baja adherencia a las demás soluciones. Este resultado confirmó la limitación del single linkage en bases con mayor variabilidad. El K-Means, por su parte, presentó concordancia moderada con los enfoques jerárquicos más robustos, sugiriendo que la partición final preservó coherencia estructural sin perder equilibrio e interpretabilidad.
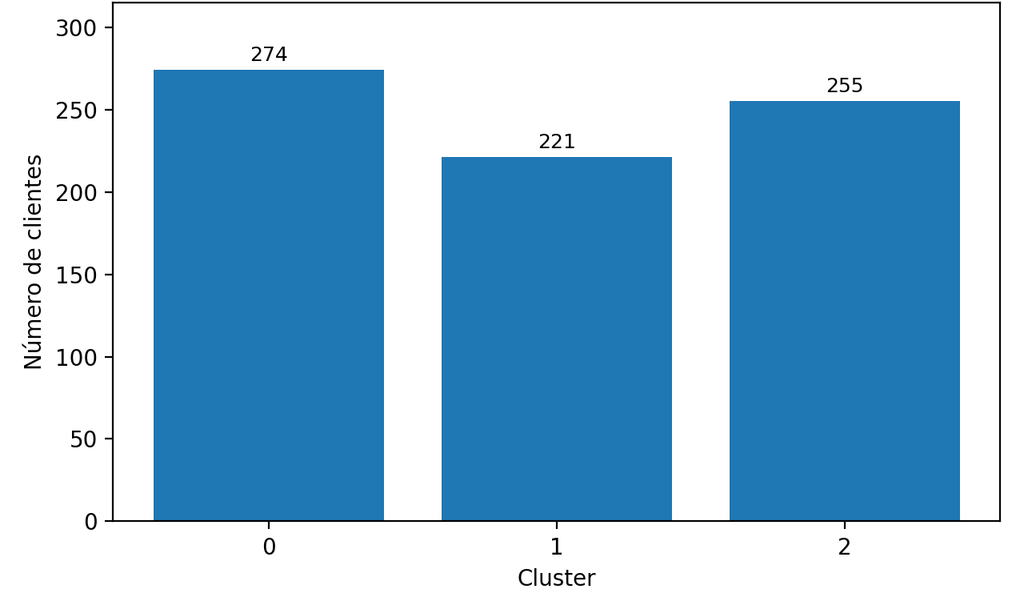
La distribución final de los clientes en la solución adoptada se puede observar en la Figura 3, que permite verificar si los grupos formados se mantuvieron representativos y operativamente útiles.
Figura 3. Distribución de los clientes por clúster en K-Means
Fuente: Resultados originales de la investigación
La Figura 3 mostró una partición relativamente equilibrada, con 274 clientes en el Clúster 0, 221 en el Clúster 1 y 255 en el Clúster 2. Este equilibrio es relevante desde el punto de vista analítico, ya que reduce el riesgo de que un clúster residual comprometa la lectura sustantiva de los resultados, garantizando masa crítica suficiente para sustentar interpretaciones consistentes.
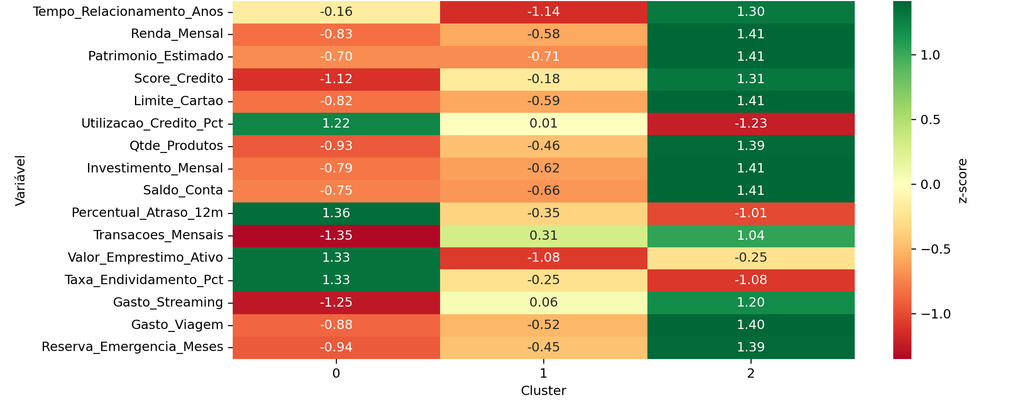
La Figura 4 profundiza la lectura de los agrupamientos al presentar el perfil estandarizado de los clusters en las variables más relevantes del modelo.
Figura 4. Perfil estandarizado de los clusters K-Means
Fuente: Resultados originales de la investigación
La Figura 4 evidenció tres estructuras bastante distintas. El Clúster 0 concentró valores estandarizados más elevados en utilización del crédito, atraso y endeudamiento, combinados con niveles inferiores de renta, patrimonio, inversión y reserva de emergencia, caracterizando un perfil de mayor vulnerabilidad financiera. El Clúster 1 presentó un comportamiento más intermedio, con menor tiempo de relación e indicadores generalmente moderados, sugiriendo un segmento de transición. Por su parte, el Clúster 2 reunió los mayores niveles relativos de renta, patrimonio, límite de tarjeta, inversión, saldo en cuenta y reserva de emergencia, además de menor atraso y menor utilización del crédito, configurando el grupo de mayor valor económico y menor sensibilidad al riesgo.
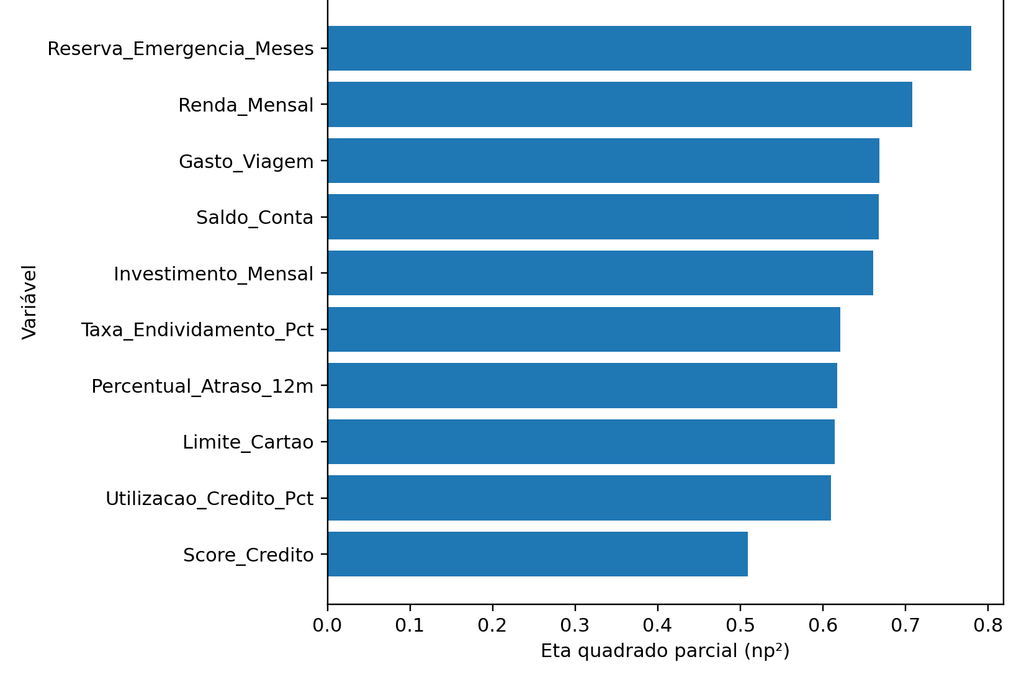
Para verificar qué atributos contribuyeron más a la separación estadística entre los grupos, la Figura 5 presenta las principales variables discriminantes según la magnitud del eta cuadrado parcial en el ANOVA.
Figura 5. Principales variables discriminantes entre los clusters
Fuente: Resultados originales de la investigación
La Figura 5 demostró que reserva de emergencia, ingreso mensual, gasto en viaje, saldo en cuenta, inversión mensual, tasa de endeudamiento, porcentaje de retraso, límite de la tarjeta, utilización del crédito y puntaje de crédito fueron los atributos con mayor poder discriminante entre los clusters. Este resultado refuerza que la segmentación no se formó por ruido estadístico, sino por diferencias estructurales asociadas a la capacidad financiera, liquidez, patrón de consumo y riesgo de crédito. La predominancia de estas variables fortalece la validez interna de la solución, confirmando que los grupos se definieron por dimensiones sustancialmente coherentes con el problema estudiado.
En conjunto, los resultados mostraron coherencia entre la preparación de los datos, el modelado, la validación y la interpretación de los agrupamientos. Aunque las métricas internas indicaron un mejor ajuste estadístico para k=2, la elección de k=3 reveló un mayor poder de discriminación analítica y una mayor utilidad práctica, lo que es compatible con estudios aplicados de Ciencia de Datos cuando la decisión metodológica se explicita de forma transparente. El análisis de la base sustenta que la clusterización fue capaz de convertir una base financiera compleja en segmentos útiles para la interpretación de perfiles de clientes y el apoyo a la decisión orientada por datos.
La ejecución del pipeline analítico se realizó con la ayuda del lenguaje de programación Python, utilizando bibliotecas como Pandas y NumPy para el tratamiento de datos, Matplotlib para el análisis exploratorio y Scikit-learn para la clusterización (K-Means y métodos jerárquicos) y validación. El análisis estadístico, incluyendo el ANOVA, también fue soportado por bibliotecas especializadas. El entorno de notebooks interactivos facilitó la organización y reproducibilidad de los análisis (VanderPlas, 2016).
El análisis de los resultados obtenidos a partir de la aplicación del pipeline de clusterización evidenció que la segmentación de la base de clientes fue capaz de identificar patrones consistentes y estadísticamente relevantes, en consonancia con el objetivo del estudio de identificar grupos homogéneos e interpretables por medio de técnicas de aprendizaje no supervisado. Las diferencias observadas entre los clusters fueron estadísticamente significativas, con variables como renta mensual, reserva de emergencia, inversión y tasa de endeudamiento presentando un elevado poder discriminante, lo que refuerza que las agrupaciones reflejan diferencias reales en la estructura de los datos (Hair et al., 2019). La segmentación obtenida no solo atendió al propósito analítico de la investigación, sino que también evidenció potencial de aplicación práctica, al permitir la diferenciación de estrategias conforme al perfil de los grupos identificados.
4. Conclusión
La presente investigación buscó aplicar técnicas de clusterización a una base de clientes del sector financiero, con el propósito de identificar segmentos homogéneos y estadísticamente distinguibles, capaces de subsidiar la interpretación de perfiles y apoyar decisiones orientadas por datos. Se verificó que la clusterización fue eficaz para segmentar la base analizada, revelando tres perfiles distintos de clientes. El primer grupo se caracterizó por mayor vulnerabilidad financiera, con elevados niveles de utilización del crédito, atraso y endeudamiento, y menores niveles de renta, patrimonio, inversión y reserva de emergencia. El segundo grupo presentó un perfil intermedio, mientras que el tercero reunió a clientes de mayor valor económico, con indicadores superiores de renta, patrimonio, inversión y reserva de emergencia, y menor sensibilidad al riesgo. El análisis estadístico confirmó que variables como renta mensual, reserva de emergencia, inversión y tasa de endeudamiento fueron los principales atributos discriminantes entre los grupos, reforzando la validez interna de la segmentación. Este enfoque demostró el potencial de las técnicas de aprendizaje no supervisado para transformar datos complejos en conocimiento estructurado, ofreciendo una contribución práctica relevante para la diferenciación de estrategias y la toma de decisiones en el sector financiero.
Sin embargo, deben reconocerse algunas limitaciones del estudio. El análisis se realizó basándose en una única base de datos y un recorte específico de variables, lo que restringe la generalización de los resultados a otros contextos o poblaciones. Aunque la solución con tres clusters se adoptó por su mayor utilidad interpretativa, las métricas internas señalaron un mejor desempeño estadístico para una configuración con dos grupos, indicando que la elección final involucró un criterio de utilidad analítica. Se sugiere, para estudios futuros, la ampliación de la base analítica con nuevas variables, como indicadores de comportamiento transaccional y relación digital, a fin de profundizar la capacidad discriminante de los modelos. Se recomienda también probar otros enfoques de clusterización, como DBSCAN o Gaussian Mixture Models, y explorar la integración entre clusterización y modelos supervisados para la predicción de riesgo o propensión de compra, ampliando la aplicabilidad de la Ciencia de Datos en entornos financieros.
Referencias Bibliográficas
Banco Central do Brasil [BCB]. (2023). Open Finance no Brasil. https://www.bcb.gov.br/estabilidadefinanceira/openfinance
Federação Brasileira de Bancos [FEBRABRAN]. (2025). Pesquisa Febraban de Tecnologia Bancária 2025. https://cmsarquivos.febraban.org.br
Han, J., Kamber, M., & Pei, J. (2012). Data mining: Concepts and techniques (3rd ed.). Morgan Kaufmann.
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer.
Jain, A. K., Murty, M. N., & Flynn, P. J. (1999). Data clustering: A review. ACM Computing Surveys, 31(3), 264-323.
James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An introduction to statistical learning: With applications in Python (2nd ed.). Springer.
Nofal, S. (2024). Identifying highly-valued
Yan, X., Li, Y., Nie, F., & Li, R. (2025). Bank customer segmentation and marketing strategies based on improved DBSCAN algorithm. Applied Sciences, 15(6), 3138.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haga clic aquí y acceda a la plataforma MBX Academy