
15 de septiembre de 2026
Detección de Fraudes en Tarjetas de Crédito Utilizando Redes Neuronales en Entornos de Datos Desbalanceados
Jefferson de Oliveira Ferreira; Lauro Marques Vicari
DOI: 10.22167/2675-6528-202602232
Artículo derivado de Trabajo de Fin de Curso (TCC), con contenido basado en el trabajo original del estudiante y adaptado al formato editorial de la Revista E&S con el apoyo de la herramienta ResumeAI, una solución de inteligencia artificial desarrollada por el Instituto Pecege para la síntesis y organización textual.
Resumen
La creciente digitalización del sistema financiero ha convertido el fraude en transacciones de tarjetas de crédito en un obstáculo crítico para la estabilidad institucional y la confianza de los clientes. Este estudio comparó una arquitectura de Red Neuronal Multilayer Perceptron (MLP) con un modelo de Regresión Logística, utilizado como línea de base, para la detección de fraudes en un escenario de desequilibrio extremo de datos. Se utilizó un conjunto de datos de transacciones reales de tarjetas de crédito, aplicando técnicas de sobremuestreo sintético (SMOTE) y la función de pérdida Focal Loss para mitigar el sesgo de la clase mayoritaria. La MLP se implementó con cuatro capas densas, y la Regresión Logística sirvió como referencia. Los experimentos revelaron que la Red Neuronal superó al modelo logístico en métricas de negocio, alcanzando un Recall de 0,8553 y un F1-Score de 0,8483. Notablemente, la MLP redujo los bloqueos indebidos (Falsos Positivos) en un 23,08% en comparación con la Regresión Logística, presentándose como una solución más equilibrada entre eficiencia operativa y experiencia del usuario. Sin embargo, ambos modelos enfrentaron dificultades para identificar fraudes de alto valor debido al mimetismo conductual de los infractores. Se concluyó que las Redes Neuronales constituyen una opción estratégica superior para las instituciones que buscan escalabilidad y menor fricción operativa, aunque necesiten reglas de negocio complementarias para fraudes de alto valor.
Palabras clave: Tarjeta de Crédito; Ciencia de datos; Detección de Fraude; Redes Neuronales; Regresión Logística.
1. Introducción
El ecosistema de pagos en Brasil ha experimentado una transformación estructural significativa en la última década, impulsada por la amplia digitalización de los servicios financieros y la consolidación del comercio electrónico. En este escenario, la tarjeta de crédito se ha consolidado como el principal vector de transacciones, registrando volúmenes financieros sin precedentes, según lo señalado por la ABECS (2024). La migración a modalidades de “Tarjeta No Presente” (CNP) ha traído consigo un desafío considerable para los operadores, que se enfrentan al refinamiento de los fraudes digitales, operando en regímenes de escala y velocidad que superan los mecanismos de defensa convencionales.
En el contexto nacional, la estafa digital ha evolucionado hacia el paradigma del “fraude como servicio” (“Fraud-as-a-Service”). Datos del Indicador de Serasa Experian (2025) revelan que aproximadamente el 25% de los intentos de fraude detectados en Brasil están relacionados con bancos y emisores, con una ocurrencia cada 4,2 segundos. El Mapa de Fraude de ClearSale (2025) indica que el “ticket” promedio de las transacciones fraudulentas (R$ 1.083,00) es significativamente superior al de las transacciones legítimas (R$ 549,00). Este escenario compromete la viabilidad del comercio minorista debido al “chargeback”, proceso en el que el comerciante asume la pérdida total, además de generar sanciones por parte de las adquirentes.
Históricamente, la detección de fraudes dependía de barreras tradicionales, como reglas estáticas y extensas revisiones manuales realizadas por analistas humanos. Sin embargo, estos enfoques perdieron efectividad a medida que el volumen de datos transaccionales creció exponencialmente y aumentó la sofisticación de los delincuentes. Los defraudadores comenzaron a imitar el comportamiento de consumo de clientes legítimos para eludir parámetros previamente fijados, haciendo que el costo operativo de mantener grandes equipos de revisión manual fuera insostenible.
Para superar esta lógica inflexible, las organizaciones comenzaron a implementar arquitecturas de inteligencia artificial capaces de procesar múltiples variables de forma dinámica. Sin embargo, la transición a modelos predictivos tropieza con desafíos inherentes a la naturaleza de los datos financieros, como el desvío de concepto (“Concept Drift”), fenómeno estadístico en el cual las propiedades y los patrones de ataque cambian rápidamente a lo largo del tiempo (Dal Pozzolo, 2015). La naturaleza dinámica de las transacciones exige algoritmos que aprendan continuamente y técnicas robustas para lidiar con el desbalanceo histórico extremo, donde el fraude es siempre un evento raro en un vasto océano de datos lícitos.
Investigaciones correlacionadas evidencian la superioridad analítica de modelos no lineales para superar los desafíos inherentes a los datos financieros. Gouvêa et al. (2013) demostraron que las arquitecturas neuronales poseen aptitud superior para descifrar correlaciones complejas y optimizar la mitigación de pérdidas. Jordan y Mitchell (2015) destacan el aprendizaje automático como un avance fundamental para la ciberseguridad, permitiendo la predicción proactiva de amenazas. Aggarwal (2018) y Schmidhuber (2015) explican que el “Deep Learning” se destaca por extraer patrones latentes y no lineales de forma jerárquica, utilizando múltiples capas de abstracción. Esta flexibilidad es crucial para la calibración precisa de funciones de pérdida y umbrales de decisión, permitiendo que la institución priorice métricas estratégicas de seguridad, como la sensibilidad (“Recall”), mitigando la caída de precisión que penaliza a los modelos tradicionales. Una clasificación errónea que resulte en un falso positivo, como el bloqueo indebido de una tarjeta, provoca fricciones operativas inmediatas, pérdida de ingresos directos, aumento de la tasa de evasión de clientes y daños a la reputación de la institución, superando el valor nominal del estorno que el algoritmo intentó evitar.
De esta forma, el objetivo general del presente artículo es desarrollar e implementar un modelo predictivo de detección de fraudes anclado en una arquitectura de Redes Neuronales Artificiales del tipo “Multilayer Perceptron” (MLP), y compararlo directamente con un modelo tradicional de Regresión Logística (utilizado como “baseline”). La investigación busca validar la eficacia técnica y operativa de ambos enfoques en un “dataset” experimental representativo, evaluando qué algoritmo entrega la mejor solución para el enfrentamiento de datos desbalanceados y para el equilibrio estratégico entre seguridad y experiencia del consumidor.
2. Material y Métodos
Para este proyecto, se optó por un enfoque práctico y basado en datos (cuantitativo). El objetivo fue estructurar un proceso de detección de fraudes utilizando redes neuronales profundas y técnicas específicas para lidiar con la escasez de observaciones de fraude. El código se desarrolló en Python, empleando las bibliotecas Pandas para manipulación de datos y TensorFlow y Keras para modelado.
Fuente de Datos y Entorno de Desarrollo
El estudio utilizó un “dataset” de transacciones financieras reales de tarjetas de crédito, obtenido del repositorio “Kaggle”, proporcionado por el Machine Learning Group de la Université Libre de Bruxelles y fundamentado en los estudios de Dal Pozzolo (2015). La base de datos comprende 284.807 operaciones de clientes europeos a lo largo de dos días. El conjunto presentaba un desbalanceo extremo, con solo 492 operaciones clasificadas como fraudes, representando el 0,172% del volumen total.
Las variables originales no fueron reveladas debido a normativas de confidencialidad bancaria. En su lugar, se proporcionaron 28 componentes principales (“features” V1 a V28) generados por una transformación PCA (“Principal Component Analysis”), manteniéndose en formato bruto solo las variables numéricas Tiempo (“Time”) y Valor (“Amount”). La presencia de 28 componentes para representar las variables originales indica que la técnica PCA se empleó primariamente como un mecanismo criptográfico, lo que impone una fragilidad metodológica por la ausencia de metadatos sobre los predictores originales, limitando la explicabilidad del modelo.
Análisis Exploratorio y Preprocesamiento de Datos
Se realizó un Análisis Exploratorio de Datos (AED) utilizando la biblioteca Pandas, confirmando la integridad del conjunto y la ausencia de valores faltantes. El severo desequilibrio de los datos (0,172% de fraudes) exigió una estrategia de modelado que fuera más allá de lo convencional, ya que los algoritmos sesgados tenderían a ignorar la clase minoritaria. Para un análisis robusto en escenarios de desequilibrio extremo, métricas como precisión y “recall” se consideraron esenciales.
Para mitigar el sesgo de los datos, se empleó la técnica de remuestreo “oversampling” SMOTE (“Synthetic Minority Over-sampling Technique”). El SMOTE actúa de forma sintética, identificando vecinos cercanos de la clase minoritaria y creando nuevos ejemplos para equilibrar la distribución de las clases. Esta técnica se aplicó exclusivamente sobre el conjunto de entrenamiento, tras la separación de los datos de prueba, para evitar “data leakage”. Antes del SMOTE, el conjunto de entrenamiento contenía 199.020 muestras legítimas y 344 fraudulentas. Tras el reequilibrio, la base de entrenamiento se igualó al 50% de cada clase, totalizando 398.040 observaciones.
Tabla 1. Distribución de las clases en el conjunto de entrenamiento pre y post-SMOTE.
| Etapa de procesamiento | Transacciones legítimas (clase 0) | Transacciones fraudulentas (clase 1) | Total de muestras |
|---|---|---|---|
| Original (pre-SMOTE) | 199.020 | 344 | 199.364 |
| Balanceado (post_SMOTE) | 199.020 | 199.020 | 398.040 |
Fuente: Datos originales de la investigación
La disparidad entre las variables “Time” y “Amount” y la presencia de “outliers” fueron tratadas con el “StandardScaler”, que redimensiona los datos a una escala común, centrando la media en cero y ajustando la desviación estándar a la unidad, según la Ecuación (1):
Z = (χ – μ) / σ (1)
donde x representa el valor original, μ la media de la muestra y σ la desviación estándar. Esta estandarización asegura que el algoritmo procese todas las “características” con la misma importancia jerárquica.
La base de datos se subdividió en tres conjuntos: Entrenamiento (70%), Validación (15%) y Prueba (15%). El conjunto de entrenamiento se utilizó para la convergencia de los pesos sinápticos, el de validación para monitorear el rendimiento y ajustar hiperparámetros, y el de prueba, mantenido aislado, para la evaluación definitiva del rendimiento del modelo en un escenario real. Se utilizó una partición estratificada (“stratified split”) para preservar la proporción original del 0,172% de fraudes en todas las submuestras (Entrenamiento, Validación y Prueba), garantizando la confiabilidad del modelo en condiciones reales.
Arquitectura y Funcionamiento del Modelo Neuronal
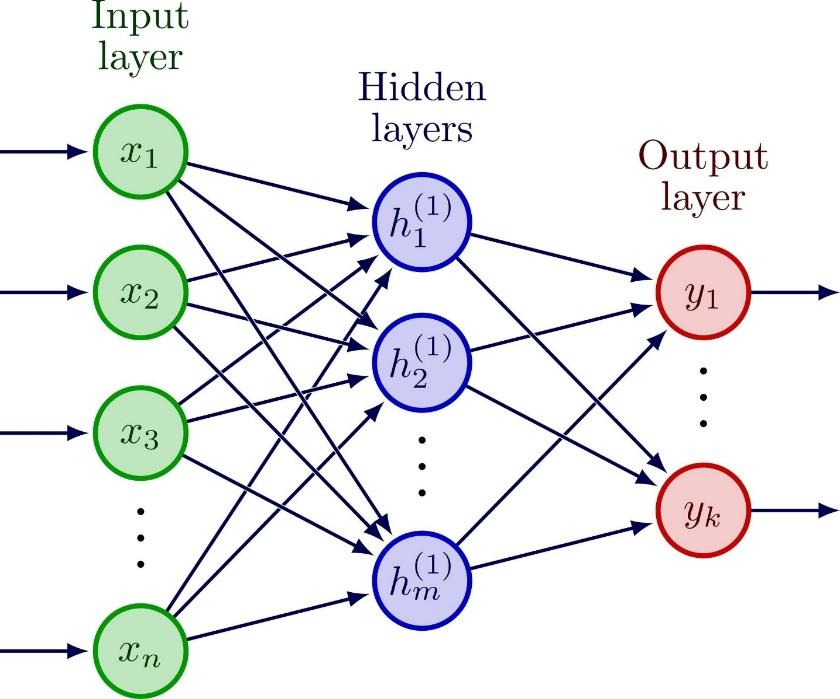
Se implementó una Red Neuronal del tipo “Multilayer Perceptron” (MLP) con cuatro capas densas: una capa de entrada con 30 neuronas, tres capas ocultas (con 128, 64 y 32 neuronas, respectivamente) y una capa de salida, según figura 1.
Figura 1. Representación esquemática de la arquitectura de la Red Neuronal MLP Propuesta
Fuente: Datos originales de la investigación
Cada neurona funciona como un nodo que recibe señales de entrada, aplica pesos y genera una activación. Las capas densas están totalmente conectadas, permitiendo al modelo aprender combinaciones globales y patrones complejos. El funcionamiento interno de cada neurona se basa en una transformación lineal seguida de una activación no lineal. La suma ponderada de las entradas (x) y los pesos (w), sumándose el sesgo (b), se calcula por:
z = (x .w) + b (2)
En las capas ocultas, se aplicó la función ReLU (“Rectified Linear Unit”) para aprender patrones complejos y no lineales, acelerando la convergencia del modelo:
f(z) = max(0, z) (3)
Para prevenir el “overfitting”, las capas ocultas utilizaron la Regularización L2 (λ = 0.0001), que añade una penalización a la función de pérdida proporcional al cuadrado de los pesos. En la capa de salida, se utilizó la función Sigmoide, que comprime el resultado en una probabilidad entre 0 y 1:
σ(z) = 1 / (1 + e^(-z)) (4)
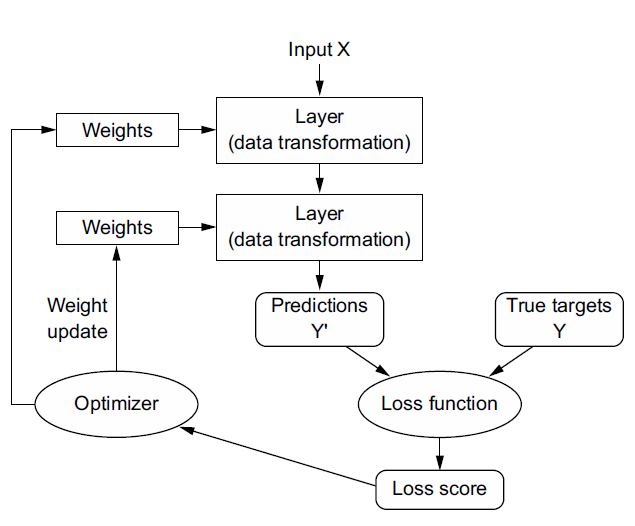
El proceso de aprendizaje se basa en la utilización del error generado en la salida como guía para la recalibración de los pesos internos, mediante el algoritmo de “backpropagation” (retropropagación). Este ciclo iterativo, conocido como “training loop”, busca minimizar la función de costo progresivamente, confrontando las predicciones del modelo con los objetivos reales (“labels”) para ajustar la red basándose en el descenso del gradiente.
Figura 2. Proceso de aprendizaje de la red neuronal
Fuente: Chollet (2011)
Experimentación y ajuste de hiperparámetros
La configuración final de la red neuronal (128, 64 y 32 neuronas) resultó de un proceso iterativo de experimentación. La Tabla 2 presenta las métricas de sensibilidad (“Recall”) de diferentes arquitecturas bajo las mismas condiciones de entrenamiento y un umbral de “Enfoque de Negocio” (máximo de 50 Falsos Positivos).
Tabla 2. Métricas de sensibilidad (“Recall”) para diferentes arquitecturas.
| Arquitectura inicial | Recordatorio Estadístico | Recordar Negocio | Diagnóstico |
|---|---|---|---|
| 256 neuronas | 86,49% | 81,08% | Sobreajuste / Memorización de ruido |
| 16 neuronas | 86,49% | 81,08% | Subajuste / Baja capacidad de separación |
| 128 neuronas | 86,49% | 85,14% | Punto óptimo de generalización |
Fuente: Datos originales de la investigación
La arquitectura intermedia seleccionada (128, 64, 32 neuronas) demostró ser la más robusta, elevando el Recall de negocio al 85,14% y maximizando la identificación de transacciones fraudulentas sin comprometer la estabilidad del aprendizaje. El algoritmo Adam (“Adaptive Moment Estimation”) fue elegido como optimizador debido a su alta eficiencia en escenarios con datos dispersos y espacios de pérdida complejos, calculando tasas de aprendizaje adaptativas para cada peso individualmente y garantizando una convergencia más rápida y estable. La técnica de “Early Stopping” fue incorporada para monitorear la pérdida en el conjunto de validación (val_loss) y detener el entrenamiento cuando la ganancia de rendimiento se estancara, combatiendo el “overfitting”.
Optimización
La técnica “Focal Loss” se implementó como función de pérdida, reemplazando la entropía cruzada binaria estándar. Esta métrica está diseñada para manejar el desequilibrio extremo de clases, enfocando el aprendizaje en los ejemplos “difíciles” (fraudes raros) y penalizando la influencia de las transacciones legítimas. La función se define por:
FL(pt) = −αt(1 − pt)γlog(pt) (5)
donde (pt) es la probabilidad estimada para la clase verdadera, αt es el factor de balanceo y γ (“parámetro de enfoque”) modula la pérdida de ejemplos ya bien clasificados. En este estudio, se adoptó γ = 2 y α = 0.25, definidos estáticamente con base en la literatura para datos desbalanceados. El error fue minimizado a través de la retropropagación, guiada por el optimizador Adam.
Una diferencia metodológica fue la flexibilización del límite de clasificación. Se aplicó una rutina de búsqueda sistemática (“Threshold Moving”) para identificar el punto de operación óptimo del modelo, alineado a criterios de negocio y apetito al riesgo, y no solo a la maximización estadística. El umbral se ajustó para mantener el volumen de fraudes no detectadas (Falsos Negativos) por debajo de 14 casos en el conjunto de prueba, priorizando la contención del perjuicio directo y minimizando los Falsos Positivos.
Modelos de referencia y fundamentación comparativa
Para validación, la arquitectura MLP se comparó con la Regresión Logística, adoptada como “baseline” debido a su historial en sistemas de “credit scoring” y prevención de fraude. La Regresión Logística intenta separar las clases mediante una combinación lineal de las variables, mapeada a un intervalo probabilístico por la función sigmoide:
P(y = 1|x) = 1 / (1 + e^(-(β0+β1×1+…+βnxn))) (6)
donde P(y = 1|x) es la probabilidad de transacción fraudulenta, β0 es el intercepto y βi son los coeficientes ajustados para cada variable xi. La comparación tuvo como objetivo verificar si la complejidad de la Red Neuronal resultaría en una ganancia real en el “Recall” y en la reducción de Falsos Positivos, y si el modelo avanzado extraería información latente ignorada por modelos lineales. Por equidad, la Regresión Logística también fue sometida a la rutina de búsqueda de umbral (“Threshold Moving”) para alcanzar el mismo rigor de seguridad estipulado para el modelo principal, permitiendo una comparación pareada del costo operacional.
Uso de IA en el desarrollo del trabajo
Durante la preparación del trabajo, Gemini (Google) y ChatGPT (OpenAI) se utilizaron para ayudar en la búsqueda de literatura, alineación de la metodología, revisión, formato y traducción del resumen. El contenido fue revisado y editado por el autor, quien asume toda la responsabilidad.
3. Resultados y Discusión
Esta sección presenta los resultados obtenidos por la arquitectura de Red Neuronal frente al modelo de referencia (Regresión Logística). La discusión no se limita al rigor estadístico, sino que busca traducir las métricas de rendimiento en impacto de negocio, evaluando el equilibrio entre seguridad y operabilidad.
Análisis descriptivo de los datos
Inicialmente, se analizó la distribución de los valores de las transacciones (Figura 3). Para permitir la visualización de las densidades y mitigar el efecto de valores atípicos extremos, se optó por un recorte de transacciones de hasta $2.000, un rango que comprende aproximadamente el 99.76% de la base total de datos. Se observó que tanto las transacciones legítimas como las fraudulentas se concentran en valores bajos, sin embargo, los fraudes presentan una mayor concentración en microtransacciones, lo que posiblemente indica pruebas de tarjetas.
Figura 3. Densidad probabilística de los Valores
Fuente: Resultados originales de la investigación
Al convertir el tiempo original a un ciclo de 24 horas (Figura 4), se observó que las transacciones legítimas siguen el ritmo comercial estándar. En contraste, las fraudes mantienen una densidad relevante durante la madrugada (entre las 2h y las 6h), período de menor vigilancia activa por parte del usuario, lo que caracteriza el factor temporal como un fuerte indicador de anomalía. El aumento proporcional de ataques en horarios de menor volumen transaccional sugiere un intento de explotación de ventanas con menor sensibilidad de monitoreo. Por lo tanto, la inclusión de esta característica ofrece a la red neuronal una dimensión contextual valiosa para diferenciar el comportamiento típico del atípico.
Figura 4. Densidad de las transacciones por hora
Fuente: Resultados originales de la investigación
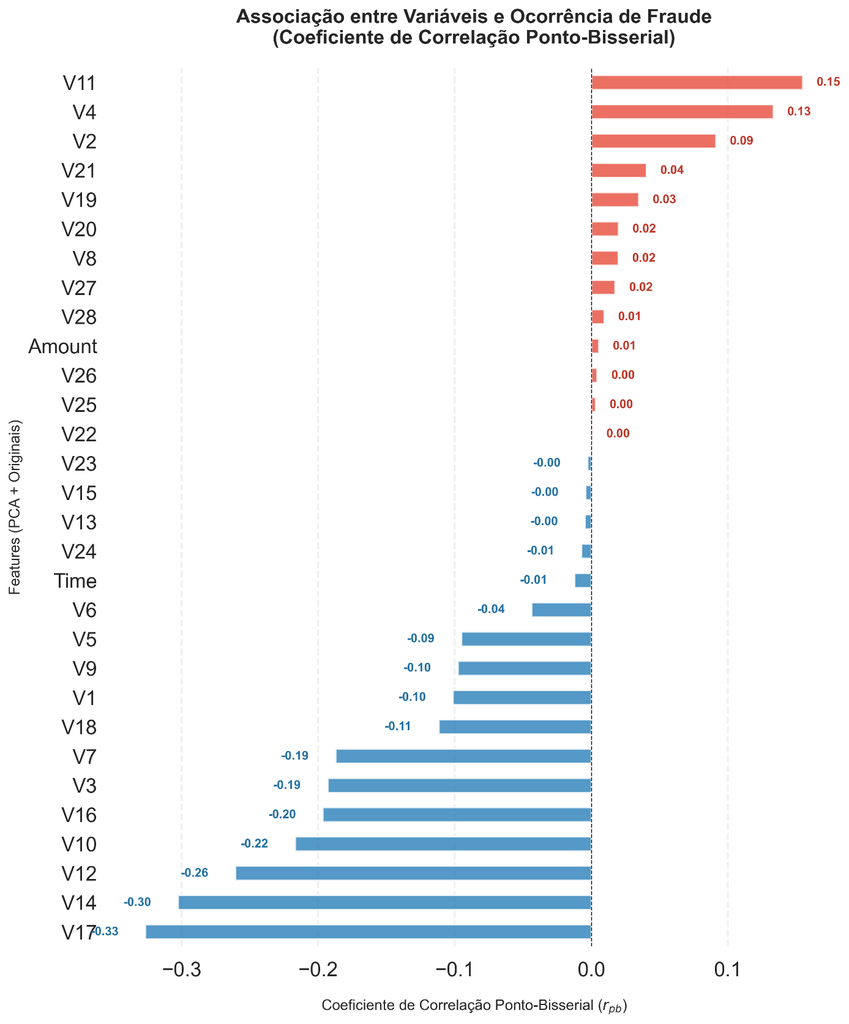
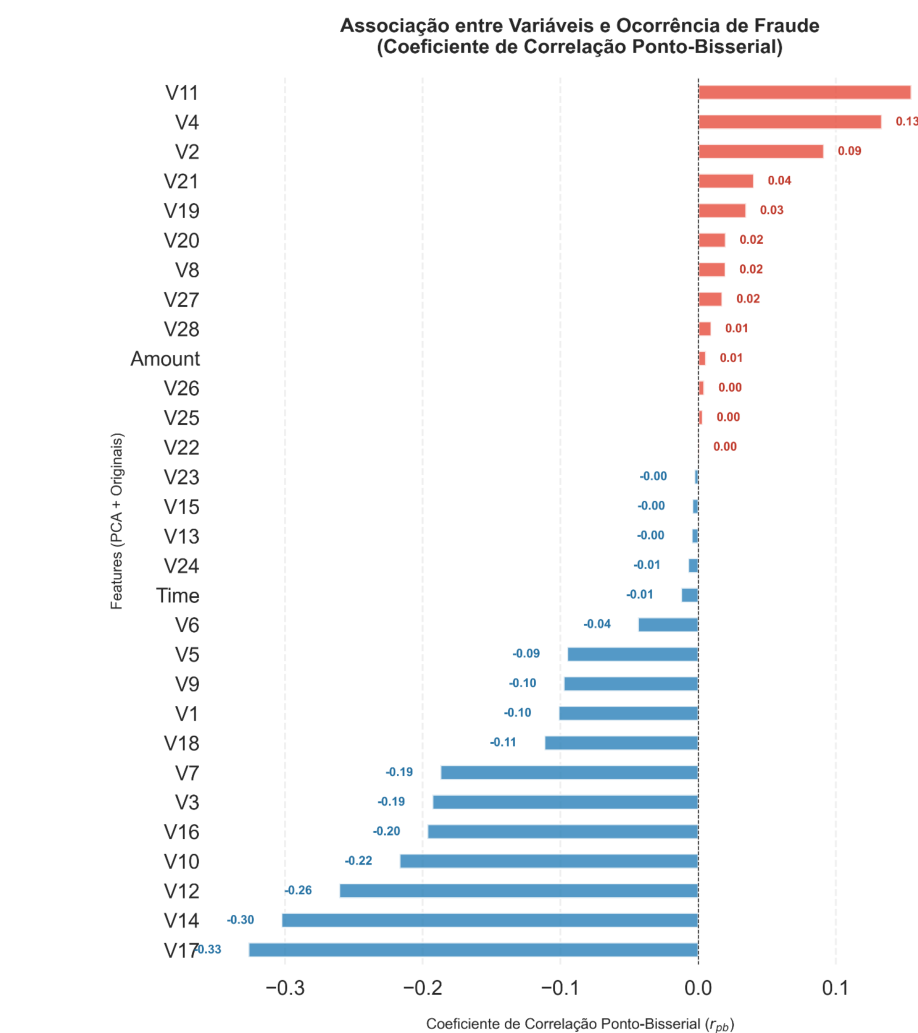
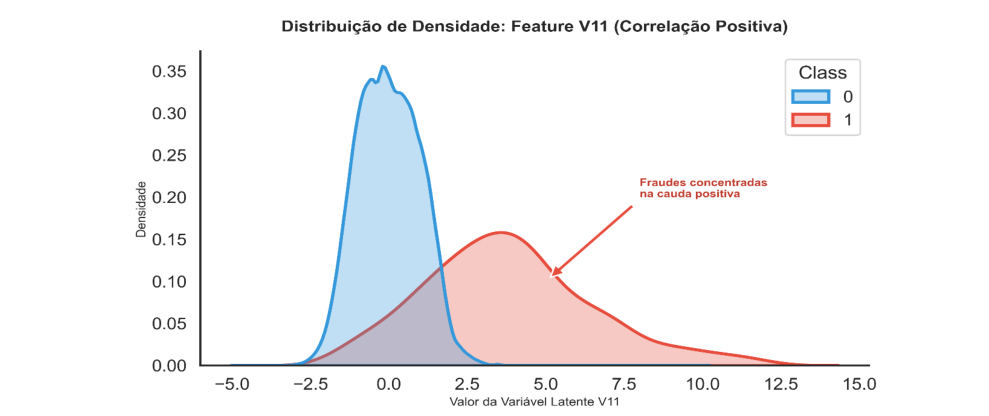
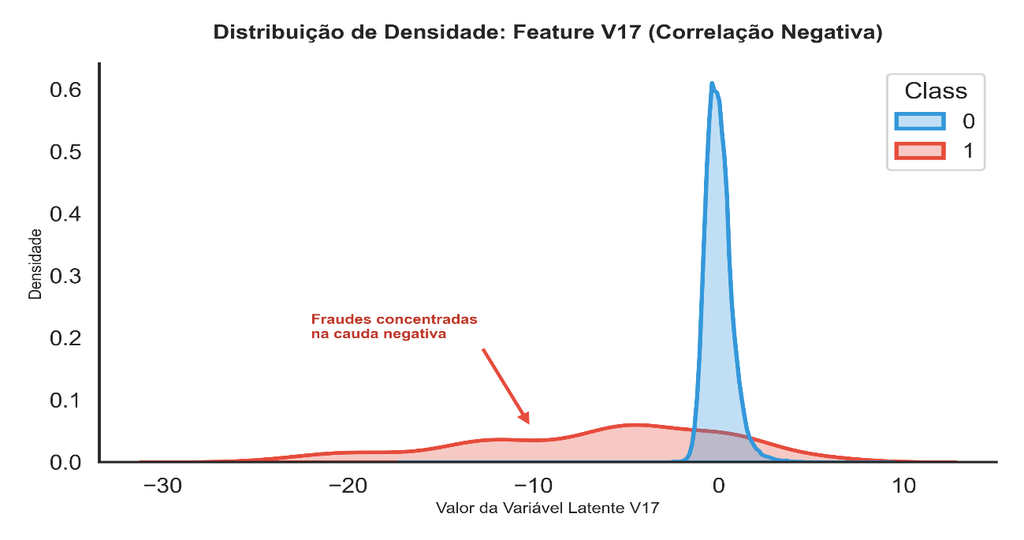
Continuando el análisis de relevancia, la Figura 5 presenta la asociación entre las variables latentes (V1 a V28) y la ocurrencia de fraudes, utilizando el coeficiente de correlación punto-biserial. El mapeo reveló que variables como V17 (negativa) y V11 (positiva) son los principales indicadores de fraude. Variables como V17, V14 y V12 exhiben asociaciones negativas más acentuadas, indicando que valores menores en estas dimensiones aumentan la probabilidad de transacción fraudulenta. Por otro lado, V11 y V4 presentan las mayores asociaciones positivas, funcionando como indicadores de riesgo a medida que sus valores aumentan. Las distribuciones de densidad de las variables de mayor impacto fueron examinadas individualmente, confirmando visualmente la separación entre las clases.
Figura 5. Correlación entre las variables
Fuente: Resultados originales de la investigación
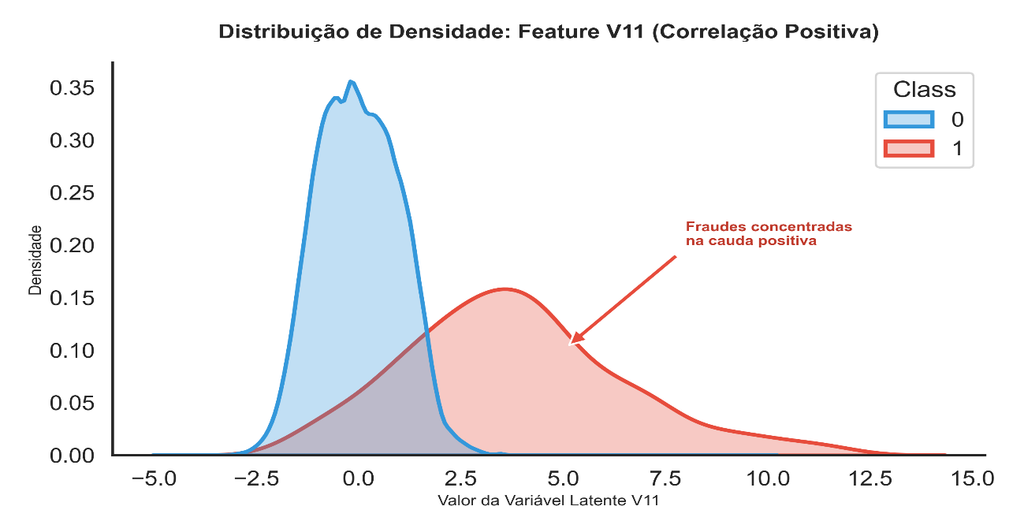
En la Figura 6, se observa el comportamiento de la variable V11 (correlación positiva), donde es nítido el desplazamiento de la masa de datos de los fraudes (en rojo) hacia la derecha de la curva de las transacciones normales, ratificando V11 como un predictor robusto. De forma análoga, la Figura 7 detalla la variable V17 (correlación negativa), donde la densidad de fraudes se concentra severamente en la cola izquierda (valores negativos), conforme lo predicho por el coeficiente punto-biseral. El diferencial de la Red Neuronal MLP reside en la capacidad de procesar estas polaridades de forma multivariada, capturando patrones de fraude complejos que escapan a métricas de asociación lineal simples.
Figura 6. Distribución de densidad V11
Fuente: Resultados originales de la investigación
Figura 7. Distribución de densidad V17
Fuente: Resultados originales de la investigación
Monitorización de Métricas e Identificación de “Overfitting”
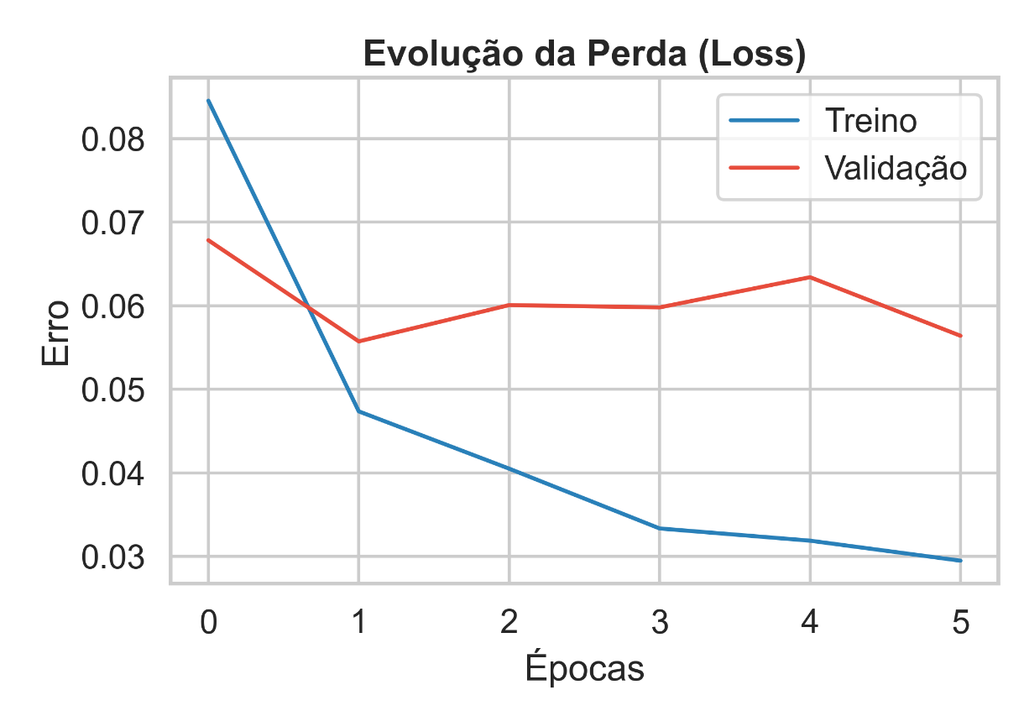
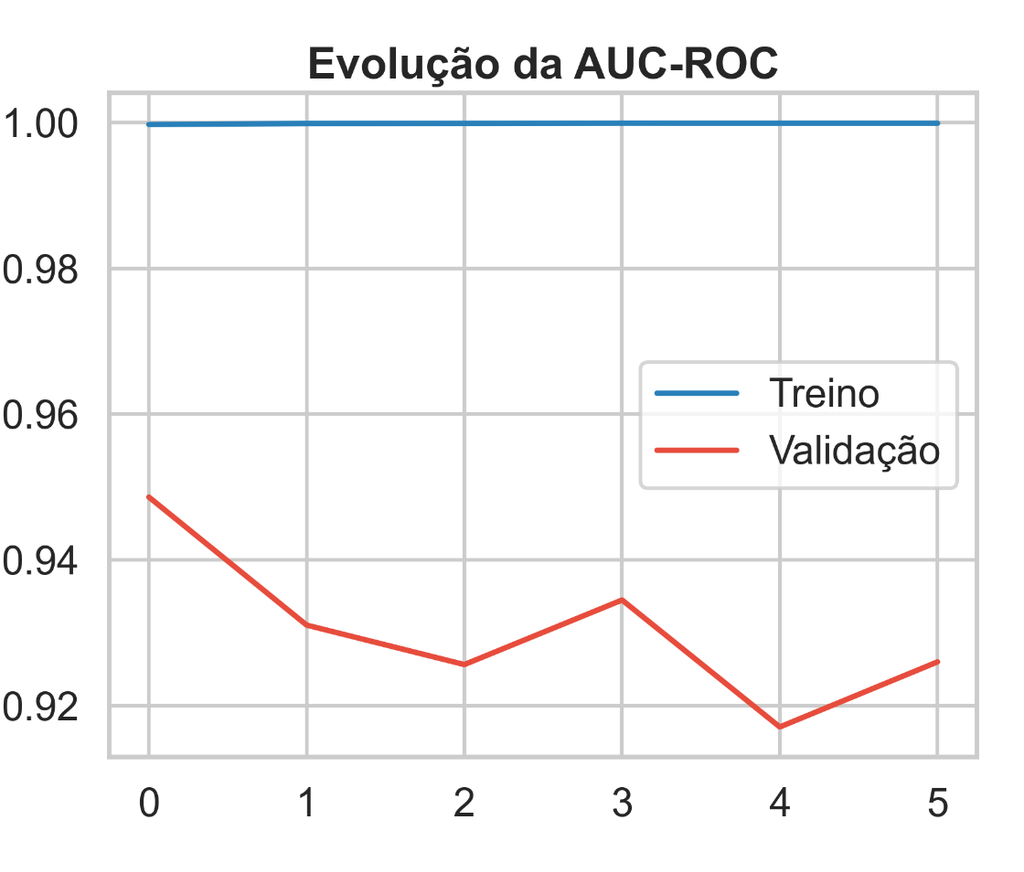
La evaluación del rendimiento de la red neuronal se inició con el monitoreo de las curvas de aprendizaje a lo largo de las épocas de entrenamiento, según se detalla en las Figuras 8 y 9. Los resultados revelaron un escenario clásico de sobreajuste (overfitting) precoz. En el gráfico de Pérdida (Loss), se observó que, mientras el error de entrenamiento decreció de forma constante, la curva de validación presentó una inflexión ascendente e inestable después de la primera época, indicando que el modelo comenzó a ajustarse excesivamente al ruido de la base de entrenamiento. Este comportamiento fue corroborado por la evolución de la métrica AUC-ROC, donde el modelo alcanzó rápidamente la puntuación máxima (AUC-ROC = 1,00) en el conjunto de entrenamiento, pero falló en mantener la estabilidad en los datos de validación, oscilando entre 0,91 y 0,94. Esta disparidad entre las curvas confirmó que, a pesar de las técnicas de regularización L2, la red tendió a la memorización de los patrones históricos en detrimento de la generalización. Por lo tanto, la interrupción del entrenamiento mediante Early Stopping demostró ser fundamental para preservar la utilidad práctica del artefacto, activando la parada en la 6ª época para garantizar que el modelo interrumpiera el aprendizaje en su punto de mayor equilibrio.
Figura 8. Evolución de la pérdida (loss)
Fuente: Resultados originales de la investigación
Figura 9. Evolución del AUC (área bajo la curva) durante el entrenamiento
Fuente: Resultados originales de la investigación
Análisis comparativo de métricas de rendimiento
Para validar la eficacia de la arquitectura propuesta, se realizó una confrontación directa entre la Red Neuronal MLP y el baseline de Regresión Logística. Aunque el modelo logístico presentó un desempeño sólido para patrones transaccionales evidentes, la Red Neuronal demostró una superioridad refinada al capturar matices no lineales que escapan a la regresión tradicional. La Tabla 3 consolida esta disparidad técnica.
Tabla 3. Comparación de métricas
| Medida | Regresión Logística | Red Neuronal (MLP) | Variación (%) | Variación (p.p) |
|---|---|---|---|---|
| “Sensibilidad” (sensibilidad) | 0,8378 | 0,8514 | 1,60 | + 1,36 |
| Precisión | 0,6596 | 0,7079 | 6,82 | + 4,83 |
| F1-Score (Equilibrio) | 0,7381 | 0,7730 | 4,51 | + 3,49 |
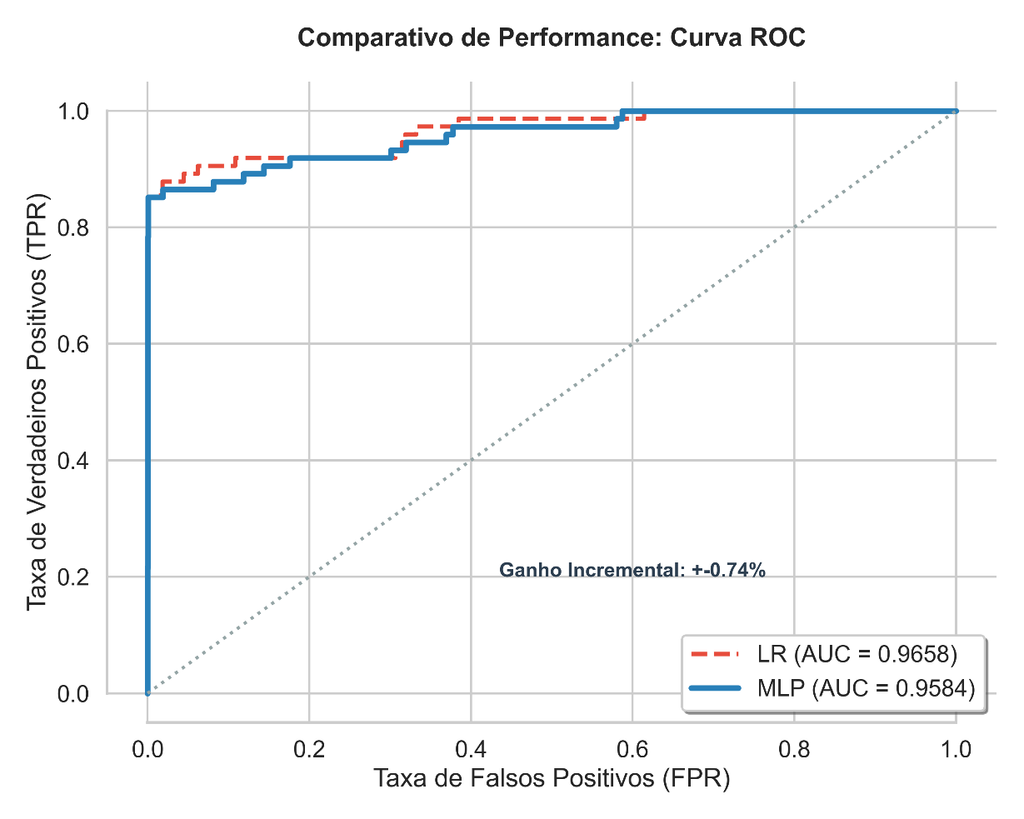
| AUC-ROC (Mundial) | 0,9658 | 0,9584 | -0,77 | – 0,74 |
| Fraudes no detectadas (FN) | 12 | 11 | -9,09 | – 1 |
| Bloqueos Indebidos (FP) | 32 | 26 | -23,08 | – 6 |
Fuente: Resultados originales de la investigación
El dato más relevante para la operación financiera es el Recall de 0,8514 alcanzado por la Red Neuronal. En el contexto de medios de pago, el Recall es la métrica soberana, pues refleja la capacidad del sistema en minimizar los Falsos Negativos. La reducción del 9,09% en los fraudes perdidos (de 12 a 11 casos en la prueba) representa una economía directa en costos de chargeback. Paralelamente, la caída expresiva del 23,08% en los bloqueos indebidos (Falsos Positivos) es una ganancia crítica de experiencia del usuario, evitando la fricción innecesaria con clientes legítimos.
La capacidad de separación entre las clases se visualiza en el comparativo de las Curvas ROC (Figura 10). Ambas trayectorias exhiben una proximidad ideal a la esquina superior izquierda del gráfico, atestiguando la alta calidad de los modelos desarrollados. Aunque la Regresión Logística ostenta una métrica AUC-ROC global ligeramente superior (0,9658), este valor refleja una media teórica de rendimiento que abarca todos los posibles umbrales de decisión, incluyendo puntos de corte extremos que jamás se adoptarían en un escenario real. En la región de interés práctico del negocio, donde se busca maximizar la detección de fraudes con el menor impacto posible en bloqueos indebidos, la trayectoria de la Red Neuronal se muestra equivalente y, en ciertos intervalos, más estable. Esta estabilidad significa que el modelo consigue sostener una alta tasa de aciertos sin sufrir un aumento desproporcional y abrupto en la generación de falsas alarmas, confirmando que la arquitectura basada en Deep Learning es altamente competitiva y robusta para decodificar la complejidad de las variables latentes en el ecosistema de tarjetas de crédito.
Figura 10. Comparativa de Curvas ROC: Regresión Logística vs. Red Neuronal MLP
Fuente: Resultados originales de la investigación
Rendimiento operativo y optimización del umbral
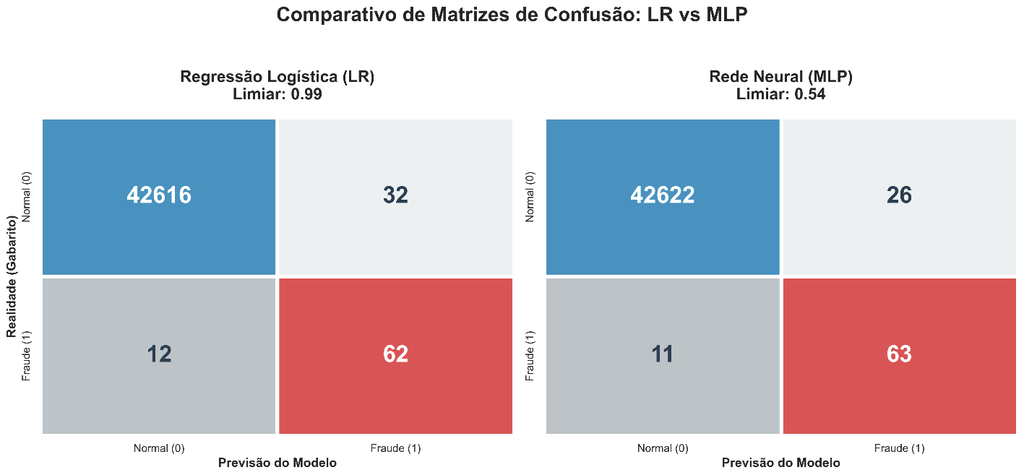
Para evaluar el modelo simulando el entorno de producción, se aplicó la matriz de confusión a la base de datos de prueba, garantizando la imparcialidad de las predicciones. En escenarios de desbalanceo extremo, el análisis de esta matriz es indispensable para cuantificar el volumen exacto de aciertos (Verdaderos Positivos) frente al riesgo financiero crítico de los fraudes no detectados (Falsos Negativos). La elevada capacidad de separación de las clases evidencia el éxito del enfoque híbrido adoptado. El algoritmo SMOTE intervino en el preprocesamiento, mitigando el déficit de la base al sintetizar nuevas muestras para la clase minoritaria. Por el contrario, la Focal Loss actuó directamente en el entrenamiento de la red neuronal, calibrando la función de coste para priorizar los fraudes fronterizos y de difícil clasificación. Esta doble estrategia posibilitó la construcción de una frontera de decisión robusta. El resultado visual de esta estrategia puede observarse en la Figura 11, que presenta el comparativo de las matrices de confusión. Se notó que la MLP obtuvo una reducción importante en los Falsos Positivos en comparación con el baseline logístico, manteniendo un nivel de seguridad equivalente en la detección de fraudes reales.
Figura 11. Matrices de confusión – Conjunto de prueba
Fuente: Resultados originales de la investigación
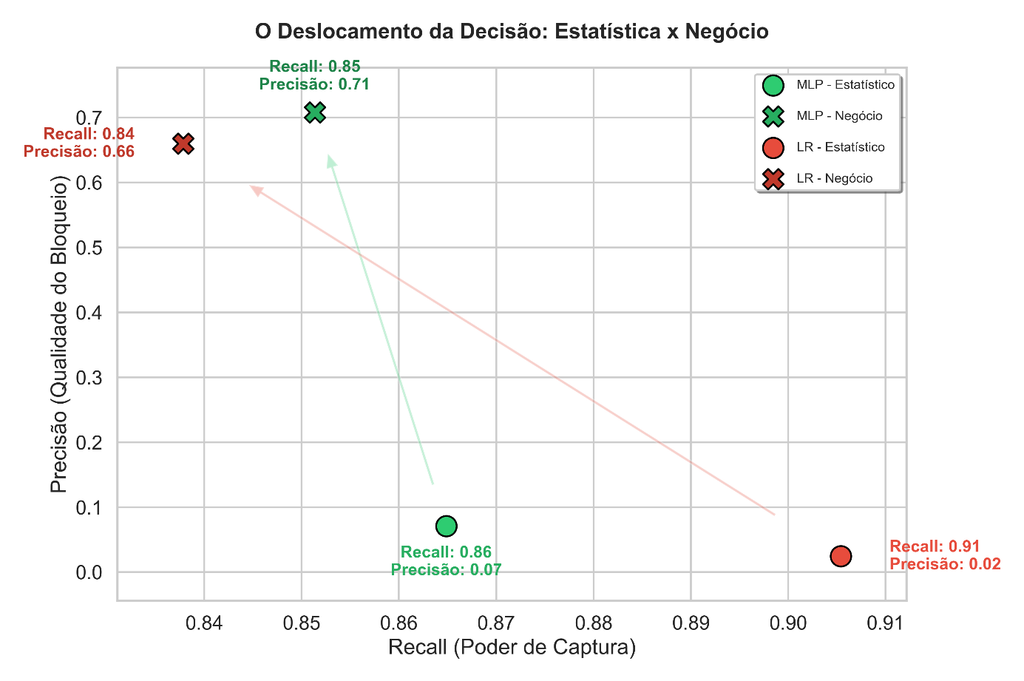
Un punto central de esta etapa fue el rechazo del umbral estadístico estándar de 0,5. Como se ilustra en la Figura 12, la calibración estratégica del trade-off entre Precisión y Sensibilidad (Recall) permitió identificar el punto de operación ideal para el escenario real. Esta decisión priorizó la sostenibilidad operativa, estableciendo un techo riguroso para el volumen de Falsos Positivos para evitar bloqueos indebidos de clientes, a cambio de un mantenimiento riguroso de la captura de fraudes de alto impacto. La Figura 12 ilustra el dilema fundamental entre Precisión (Calidad del Bloqueo) y Recall (Poder de Captura) en los enfoques estadístico y de negocio. En el enfoque puramente estadístico, ambos modelos buscan la máxima captura (Recall), resultando en alta detección de fraudes (LR = 0,91; MLP = 0,86), pero con una precisión inaceptablemente baja (LR = 0,02; MLP = 0,07), generando un volumen insostenible de falsos positivos. Al adoptar una visión de negocio, los umbrales de decisión se ajustan para balancear la captura de fraudes con el costo operativo y la experiencia del cliente. El análisis del gráfico revela la superioridad operativa del modelo de Redes Neuronales [MLP]. Mientras que el modelo de Regresión Logística [LR] sufre un trade-off severo para alcanzar una Precisión operativa de 0,66, sacrificando el Recall significativamente (cayendo a 0,84), el modelo MLP demuestra una eficiencia notable. El desplazamiento de la MLP hacia la estrategia de negocio alcanza una Precisión superior (0,71) con una pérdida casi nula de Recall (cayendo solo de 0,86 a 0,85). Esta característica prueba que el modelo MLP es más robusto y capaz de encontrar puntos de operación optimizados, maximizando la captura de fraude con un atrito operativo mínimo. Esta doble ganancia valida la hipótesis de que la capacidad de la Red Neuronal de procesar patrones no lineales a través de sus capas ocultas permite una separación más refinada en el espacio de decisión, superando las limitaciones intrínsecas de los modelos lineales en datos bancarios complejos.
Figura 12. El Desplazamiento de la Decisión: Estadística x Negocio
Fuente: Resultados originales de la investigación
Análisis estadístico de los errores y disparidad de valores
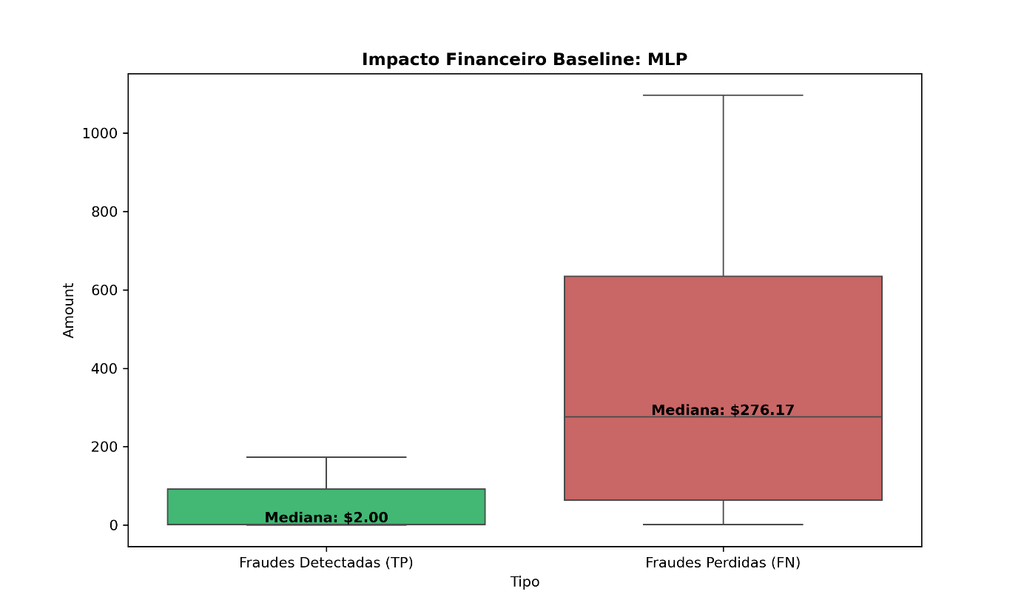
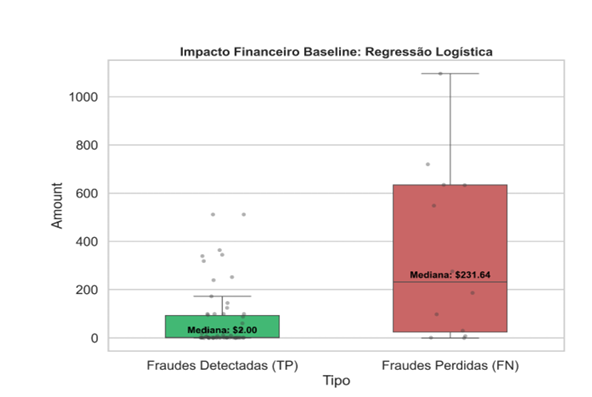
Para profundizar la discusión sobre la eficacia del modelo, se realizó un análisis comparativo entre los fraudes detectados y aquellos que el modelo no logró identificar. La reversión de la estandarización matemática permitió observar los valores reales de las transacciones en sus magnitudes originales. El análisis reveló un patrón de comportamiento crítico, según las Figuras 13 y 14. En ambos modelos, los fraudes perdidos (Falsos Negativos) presentaron una mediana de valor significativamente superior a aquellos detectados con éxito. En la Regresión Logística, las detecciones ocurrieron mayoritariamente en transacciones de bajo valor (mediana de $2,00), mientras que las fallas se concentraron en operaciones con una mediana de $231,64. En la Red Neuronal, el fenómeno fue análogo: el modelo fue eficaz en capturar fraudes de pequeño valor, pero encontró mayor dificultad en transacciones con una mediana de $276,17. Este escenario plantea una alerta sobre la aplicabilidad del modelo: los fraudes que generan las mayores pérdidas financieras están logrando evadir la red de detección debido al mimetismo conductual de los delincuentes que imitan el consumo de clientes legítimos de alto valor. No hay una diferencia financiera significativa entre las arquitecturas en cuanto a la captura de los grandes defraudadores, ya que ambos algoritmos dejan pasar estas transacciones. El verdadero trade-off entre las metodologías reside en la eficiencia operativa con la base de clientes, donde la Red Neuronal (MLP) actúa de forma más limpia, generando un 18,7% menos de bloqueos indebidos en relación con el baseline.
Figura 13. Impacto Financiero Baseline: MLP
Fuente: Resultados originales de la investigación
Figura 13. Impacto Financiero Baseline: Regresión Logística
Fuente: Resultados originales de la investigación
La presente investigación demostró que la arquitectura de Redes Neuronales del tipo Multilayer Perceptron (MLP) ofrece ganancias reales sobre la tradicional Regresión Logística en la detección de fraudes en tarjetas de crédito, especialmente en entornos de datos desbalanceados. La implementación estratégica del oversampling sintético (SMOTE) en conjunto con la función de pérdida Focal Loss optimizó la resistencia del modelo al sesgo de la clase mayoritaria, resultando en elevados niveles de F1-Score y Precisión, además de una estabilidad de entrenamiento que minimiza oscilaciones en la capacidad de generalización. La MLP presentó una reducción del 18,7% en los Falsos Positivos en comparación a la Regresión Logística, traduciéndose en mayor eficiencia operacional y mejor experiencia del usuario. Sin embargo, el análisis de los errores reveló que los fraudes de mayor valor nominal aún logran traspasar la barrera de la red neuronal debido al mimetismo comportamental de los criminales, indicando que la capacidad de predecir la probabilidad matemática de un evento debe ser complementada por mecanismos que ponderen el riesgo financiero absoluto involucrado.
4. Conclusión
El presente estudio buscó desarrollar y comparar un modelo predictivo de detección de fraudes en transacciones de tarjetas de crédito, utilizando una arquitectura de Red Neuronal Multilayer Perceptron (MLP) frente a un baseline de Regresión Logística, con foco en el tratamiento de datos desbalanceados y en el equilibrio estratégico entre seguridad y experiencia del usuario. Se verificó que la MLP demostró superioridad en métricas de negocio, alcanzando un Recall de 0,8514 y una reducción del 23,08% en los bloqueos indebidos (Falsos Positivos) en comparación con la Regresión Logística. La aplicación estratégica de técnicas de sobremuestreo sintético (SMOTE) y de la función de pérdida Focal Loss fue fundamental para mitigar el sesgo de la clase mayoritaria y optimizar la resistencia del modelo. Este enfoque resultó en elevados niveles de F1-Score y Precisión, además de una estabilidad de entrenamiento que minimizó oscilaciones en la capacidad de generalización. La Red Neuronal, por lo tanto, constituye una elección estratégica superior para instituciones financieras que buscan escalabilidad y menor fricción operativa, sin comprometer la seguridad.
Sin embargo, el análisis de los errores reveló que ambos modelos enfrentaron dificultades para identificar fraudes de alto valor nominal, atribuidas al mimetismo conductual de los delincuentes, que logran eludir la red de detección. Esta limitación indica la necesidad de complementar la capacidad predictiva matemática con mecanismos que ponderen el riesgo financiero absoluto involucrado. Adicionalmente, el uso de un dataset estático restringió la visión sobre el carácter dinámico y temporal de los fraudes, y la transformación PCA impuso una fragilidad en la explicabilidad causal de las variables originales. Como desarrollos futuros, se sugiere la implementación de reglas de negocio secundarias enfocadas en la contención de anomalías de alto valor y la transición a arquitecturas recurrentes, como LSTMs o RNNs, capaces de interpretar el historial del portador de la tarjeta como una secuencia lógica y cronológica, mejorando la detección en escenarios de “Concept Drift”.
Referencias Bibliograficas
ABECS. 2025. Balanço do setor de meios eletrônicos de pagamento: resultados 2024. Associação Brasileira das Empresas de Cartões de Crédito e Serviços, São Paulo, SP, Brasil. Disponível em: Acesso em: 05 fev. 2026.
Aggarwal, C.C. 2018. Neural Networks and Deep Learning. Springer, Cham, Suíça. Disponível em: . Acesso em: 12 out. 2025.
Cholet, F. 2021. Deep learning with python. 2ed. Manning, New York, EUA.
ClearSale. 2025. Mapa da Fraude. Disponível em: Acesso em: 10 jan. 2026.
Dal Pozzolo, A. 2015. Adaptive Machine learning for credit card fraud detection. Tese, Ph.D. em Ciência da Computação, Université Libre de Bruxelles. Disponível em < http://di.ulb.ac.be/map/adalpozz/pdf/Dalpozzolo2015PhD.pdf>
Gouvêa, M.A.; Gonçalves, E.B.; Mantovani, D.M.N. 2013. Análise de risco de crédito com aplicação de regressão logística e redes neurais. Contabilidade Vista & Revista 24(4): 96-123. Disponível em: < https://www.redalyc.org/pdf/1970/197033497006.pdf > Acesso em: 12 out. 2025.
Jordan, M.I.; Mitchell, T.M. 2015. Machine learning: Trends, perspectives, and prospects. Science 349(6245): 255-260. Disponível em: Acesso em: 12 out. 2025.
Schmidhuber, J. 2015. Deep learning in neural networks: An overview. Neural Networks 61(1): 85-117. Disponível em: . Acesso em: 15 out. 2025.
Serasa Experian. 2025. Récord: Casi 7 millones de intentos de fraude se registraron en el primer trimestre de 2025; el sector bancario es el principal objetivo. Disponible en: Acceso el 10 de enero de 2026.
Artículo originario del Trabajo de Conclusión de Curso de la Especialización en Data Science y Analytics del MBA USP/Esalq
Para saber más sobre el curso, haga clic aquí y acceda a la plataforma MBX Academy