
10 de agosto de 2026
Sistema Inteligente de Gestión de Ventas con Recomendaciones
Luana Quinaglia Maistro; Vinicius Santos Andrade
DOI: 10.22167/2675-6528-202601105
Artículo elaborado por la herramienta ResumeAI, solución de inteligencia artificial desarrollada por el Instituto Pecege orientada a la síntesis y redacción.
Resumen
La gestión eficiente de ventas e inventario demostró ser crucial para la competitividad empresarial en mercados dinámicos y orientados por datos. Se desarrolló Nexsell, un Sistema Inteligente de Gestión de Ventas con funcionalidades de recomendaciones personalizadas, con el objetivo de integrar el control operativo y la inteligencia de datos en una solución accesible para pequeñas y medianas empresas. El sistema fue arquitectado basándose en los principios de Clean Architecture y Domain-Driven Design, utilizando .NET 8, PostgreSQL y Entity Framework Core en el backend, y React 19 con TypeScript en el frontend. Se implementaron seis módulos funcionales completos, incluyendo registro de productos, gestión de clientes, registro de ventas, control de inventario, recomendaciones inteligentes e informes gerenciales interactivos. Las recomendaciones personalizadas se proporcionaron a través de Recombee, una plataforma externa, basándose en el historial de compras y el perfil de los clientes. Se validó el sistema mediante 212 pruebas unitarias en xUnit y pruebas de integración automatizadas, que evaluaron la calidad de las sugerencias generadas por el algoritmo con las métricas Precision@K y Recall@K en 55 escenarios simulados. Los resultados demostraron la integración exitosa de funcionalidades operativas tradicionales con un módulo de recomendaciones inteligentes, presentando una Precision@5 media de 19,3% y un Recall@5 medio de 48,2%, consistentes con lo esperado para catálogos de pequeño tamaño. La arquitectura adoptada garantizó la mantenibilidad, testeabilidad y resiliencia a fallos externos, contribuyendo a una solución robusta y adaptable a las necesidades del mercado.
Palabras clave: Arquitectura de software; Automatización; Arquitectura limpia; Diseño guiado por el dominio; Filtrado colaborativo.
1. Introducción
La transformación digital ha redefinido profundamente el panorama empresarial, exigiendo de las organizaciones una adaptación continua y la adopción de estrategias innovadoras para mantener la competitividad. En este escenario, la gestión eficiente de ventas e inventario ha emergido como un pilar fundamental para el éxito, especialmente en mercados dinámicos y crecientemente orientados por datos. La capacidad de procesar y analizar grandes volúmenes de información para optimizar operaciones y predecir tendencias de consumo se ha convertido en un diferencial estratégico. Laudon y Laudon (2023) enfatizan que los sistemas de información bien estructurados han dejado de ser un lujo para convertirse en una necesidad imperativa, ya que las empresas que no logran controlar sus operaciones y basar decisiones en datos corren el riesgo de perder relevancia. Sin embargo, las pequeñas y medianas empresas (PYMES) frecuentemente enfrentan desafíos significativos en la implementación de soluciones integradas, a menudo dependiendo de herramientas desconectadas o procesos manuales que limitan severamente su capacidad de análisis y crecimiento.
Paralelamente a esta evolución, la inteligencia artificial (IA) ha revolucionado la experiencia de compra y la gestión comercial. Entre sus diversas aplicaciones, los sistemas de recomendación se destacan como una de las vertientes más exitosas del *machine learning*, según apuntan Ricci, Rokach y Shapira (2015). Estos sistemas son capaces de analizar el comportamiento de los consumidores, como el historial de compras y las preferencias, para sugerir productos relevantes de forma personalizada. La eficacia de este enfoque está ampliamente comprobada por gigantes del mercado como Amazon y Netflix, que utilizan algoritmos sofisticados de filtrado colaborativo y basado en contenido para elevar significativamente las tasas de conversión, aumentar el valor medio de las ventas y mejorar la satisfacción del cliente. La personalización de la experiencia de compra, antes restringida a grandes corporaciones con vastos recursos tecnológicos, se ha convertido en un factor decisivo para involucrar a los clientes e impulsar el crecimiento del negocio a cualquier escala.
A pesar del potencial transformador de la inteligencia artificial, la implementación de sistemas inteligentes e integrados sigue siendo un desafío considerable para las pequeñas y medianas empresas. Los altos costos de desarrollo, la complejidad de la integración con infraestructuras existentes y la escasez de conocimiento técnico especializado a menudo hacen inviable la adopción de estas tecnologías avanzadas. En este contexto, la ingeniería de software moderna busca soluciones que equilibren funcionalidad, facilidad de uso y viabilidad económica, como preconiza Sommerville (2011), especialmente al desarrollar sistemas para organizaciones con recursos limitados. La necesidad de sistemas que no solo sean funcionales, sino también adaptables y escalables, resalta la importancia de decisiones arquitectónicas bien fundamentadas. Richards y Ford (2020) argumentan que la arquitectura de software trasciende la mera elección de tecnologías, involucrando decisiones estratégicas sobre cómo estructurar sistemas para cumplir con los requisitos de negocio, garantizando adaptabilidad a los cambios futuros y resiliencia a fallos. Principios como Clean Architecture y Domain-Driven Design (DDD) son cruciales para construir sistemas robustos y mantenibles. El DDD, según lo propuesto por Evans (2003), se centra en el modelado del dominio de negocio, utilizando conceptos como entidades y objetos de valor para encapsular reglas de negocio y garantizar la integridad de los datos, un enfoque que Vernon (2013) detalla como esencial para la lógica de validación. La Clean Architecture, por su parte, promueve la separación de preocupaciones en capas, aislando las reglas de negocio de la infraestructura y la interfaz de usuario, lo que facilita la testeabilidad, la mantenibilidad y la escalabilidad del sistema a lo largo del tiempo, características esenciales para sistemas que necesitan evolucionar e integrarse con servicios externos de forma confiable.
Ante la brecha existente entre la necesidad de las pequeñas y medianas empresas por una gestión de ventas y stock eficiente y la complejidad de implementar soluciones tecnológicas avanzadas, este trabajo se justifica por la creciente demanda de democratización de herramientas inteligentes y por la oportunidad de aplicar conceptos de ingeniería de software de vanguardia, arquitectura de sistemas e inteligencia artificial en un contexto práctico y relevante para el mercado. Así, el objetivo de este artículo es presentar el desarrollo de un sistema inteligente de gestión de ventas que integre funcionalidades operativas tradicionales con recursos de recomendaciones personalizadas, ofreciendo una solución accesible y robusta para pequeñas y medianas empresas optimicen sus operaciones y mejoren la experiencia del cliente a través de sugerencias basadas en su historial de compras.
2. Material y Métodos
La investigación se caracterizó como aplicada, con el objetivo de solucionar un problema práctico del mercado, según la clasificación de Gil (2002). Sus objetivos fueron exploratorios y descriptivos, buscando comprender los desafíos de gestión comercial en pequeñas empresas y desarrollar una solución tecnológica funcional. El enfoque metodológico adoptado fue la investigación aplicada con desarrollo de prueba de concepto, centrándose en la construcción y validación técnica de un sistema inteligente de gestión de ventas. Este proceso se llevó a cabo en ciclos iterativos, con evaluación continua de los resultados, siguiendo principios de metodología ágil, sin involucrar la participación directa de usuarios finales en un entorno operativo real.
El contexto del estudio abarcó el escenario de pequeñas y medianas empresas que buscan optimizar la gestión de ventas e inventario a través de tecnologías avanzadas. El lugar de desarrollo fue el entorno de investigación y desarrollo, sin un lugar físico específico de aplicación en campo. El período de ejecución de la investigación no estuvo explícitamente delimitado, pero el desarrollo del sistema ocurrió en ciclos iterativos, reflejando un enfoque continuo. La unidad de análisis principal fue el sistema Nexsell, un software de gestión de ventas con funcionalidades de recomendación, evaluado en cuanto a su arquitectura, implementación y rendimiento técnico.
Para la validación del sistema, no se utilizó una población o muestra de usuarios reales, sino un estudio de caso con simulación de operaciones comerciales. Los datos empleados fueron sintéticos, elaborados con base en patrones reales de negocio para garantizar relevancia. Se crearon escenarios específicos que contemplaron cinco perfiles distintos de clientes y sus respectivos patrones de compra. Este enfoque permitió evaluar la calidad de las recomendaciones generadas por el sistema en condiciones controladas, sin necesidad de interacción con un entorno de producción real o datos sensibles de clientes.
La unidad de análisis para la validación de las recomendaciones consistió en 50 productos sintéticos, distribuidos equitativamente en cinco categorías: Informática, Electrónicos, Libros, Deportes y Hogar. Para cada uno de los cinco perfiles de consumo modelados (Programador, Gamer, Lector, Deportista y HomeOffice), se instanciaron once clientes simulados, totalizando 55 escenarios de evaluación. Estos escenarios fueron cruciales para probar la capacidad del algoritmo de recomendación en diferentes contextos de preferencia e historial de compras, garantizando un análisis exhaustivo del comportamiento del sistema.
El sistema Nexsell fue desarrollado siguiendo los principios de Domain-Driven Design (DDD) y Clean Architecture (Richards; Ford, 2020), que guiaron las decisiones arquitectónicas y tácticas de modelado. El backend fue implementado en .NET 8, utilizando PostgreSQL como base de datos y Entity Framework Core para acceso a datos. La lógica de negocio fue expuesta por medio de una API REST, organizada en cuatro capas (Domain, Application, Infrastructure y API) y documentada con Swagger/OpenAPI, facilitando la integración y el consumo de los servicios por otras aplicaciones.
El frontend del sistema se construyó como una aplicación web en React 19 con TypeScript, utilizando Ant Design para componentes de interfaz, Zustand para la gestión de estado y Axios para las solicitudes HTTP. La herramienta Vite se empleó para la compilación y el desarrollo, optimizando la velocidad. El sistema contempló seis módulos principales: registro y control de productos, gestión de clientes, registro de ventas, control de inventario, recomendaciones inteligentes e informes gerenciales. Una biblioteca TypeScript compartida, que contiene Value Objects y casos de uso, se publicó a través de GitHub Packages para su reutilización.
La funcionalidad de gestión de clientes se integró a la API ViaCEP para el autocompletado de direcciones, mejorando la experiencia del usuario y la precisión de los datos. El módulo de recomendaciones inteligentes se hizo posible gracias a la integración con Recombee, una plataforma especializada en sistemas de recomendación. Esta elección permitió centrarse en la aplicación práctica de la inteligencia artificial, delegando la complejidad del desarrollo de algoritmos de *machine learning* al servicio externo. Los datos de interacción, como el historial de compras, se enviaron a Recombee vía API para generar sugerencias personalizadas.
El desarrollo del sistema siguió una pipeline de cuatro etapas principales. Inicialmente, se realizó el análisis y modelado, con levantamiento de requisitos y definición de la arquitectura. Luego, ocurrió la implementación, con la creación de funcionalidades y la aplicación de pruebas automatizadas a cada nueva funcionalidad. La tercera etapa involucró la integración con el servicio Recombee, configurando el envío de eventos de compra y el consumo de las recomendaciones. Finalmente, se procedió a la validación final, con simulaciones de escenarios y recolección de métricas de calidad para evaluar el desempeño del sistema.
La estrategia de pruebas se estructuró en tres niveles complementarios, según lo recomendado por Sommerville (2011), para garantizar la calidad del software. Se realizaron pruebas unitarias de dominio, cubriendo entidades y objetos de valor, totalizando 154 pruebas. Adicionalmente, se ejecutaron 58 pruebas unitarias de aplicación para validar los servicios de la capa de aplicación, utilizando el framework xUnit y la biblioteca Moq para la creación de dobles. Estas pruebas verificaron comportamientos, transiciones de estado, reglas de negocio y casos de fallo esperados, asegurando la robustez interna del sistema.
Se elaboraron y ejecutaron pruebas de integración automatizadas en el proyecto Teste.Integration, utilizando el framework xUnit, directamente contra la API de Recombee. La calidad de las recomendaciones se midió a través de las métricas Precision@K y Recall@K, ampliamente reconocidas en la literatura de sistemas de recomendación (Ricci, Rokach y Shapira, 2015). Para cada uno de los 55 escenarios de evaluación, se aplicó la técnica de *train/test split*, donde se usaron cuatro compras para entrenamiento y dos se retuvieron como *ground truth* para evaluación, con K=5 para las métricas.
La comunicación con Recombee ocurrió en tres momentos clave del flujo de negocio. Al registrar o actualizar un producto, el servicio RecomendacaoService sincronizó automáticamente el ítem, enviando propiedades como nombre, categoría y precio, que componen el esquema de datos de Recombee. Al confirmar una venta, el sistema registró automáticamente un evento AddPurchase para cada ítem vendido, proporcionando el principal insumo para el algoritmo de filtrado colaborativo. La visualización de un ítem por el cliente también generó interacciones, contribuyendo al aprendizaje del algoritmo.
No se aplicaron procedimientos éticos formales, ya que la investigación implicó el desarrollo de un sistema y su validación con datos sintéticos, sin la participación directa de seres humanos ni la recopilación de datos personales. La principal limitación metodológica identificada fue el uso de datos sintéticos para la evaluación de las recomendaciones. Si bien este enfoque fue suficiente para validar la integración técnica y el funcionamiento del algoritmo, no sustituye una evaluación con datos reales de operación en un entorno de producción, lo que podría ofrecer *insights* adicionales sobre el rendimiento en condiciones de uso real.
3. Resultados y Discusión
El desarrollo del sistema Nexsell, objeto central de este trabajo, se basó en una arquitectura robusta y principios modernos de ingeniería de software, con el objetivo no solo de la funcionalidad, sino también de la mantenibilidad, escalabilidad y extensibilidad. La elección del Domain-Driven Design (DDD) y la Clean Architecture, según lo recomendado por Evans (2003) y Richards y Ford (2020), respectivamente, resultó fundamental para la organización del código en cuatro capas distintas: Dominio, Aplicación, Infraestructura y API. Esta separación de responsabilidades es un pilar para sistemas complejos, garantizando que las reglas de negocio permanezcan aisladas de los detalles tecnológicos, lo que facilita la evolución y la adaptación a nuevas demandas del mercado.
La capa de Dominio, por ejemplo, concentró las entidades de negocio esenciales, como Cliente, Producto, Inventario, Venta, ArtículoVenta y Usuario. Cada una de estas entidades fue modelada con un encapsulamiento riguroso, utilizando *setters* privados y métodos de dominio que aseguran la integridad de los datos y el cumplimiento de las invariantes de negocio. Este enfoque está en consonancia con la filosofía del DDD, que enfatiza el modelado de un dominio rico y expresivo. Además, objetos de valor como CPF, CNPJ, Documento, Contacto y Dirección fueron implementados como tipos inmutables con validación integrada. Esta práctica, defendida por Vernon (2013), garantiza que la lógica de validación resida en el propio tipo, evitando la dispersión de reglas de validación por toda la aplicación y promoviendo la consistencia de los datos desde su creación. La inmutabilidad de estos objetos de valor contribuye a la robustez del sistema, previniendo alteraciones indeseadas después de su inicialización.
La capa de Infraestructura fue responsable de la persistencia de los datos, empleando Entity Framework Core 8 y aplicando los patrones Repository y Unit of Work. Estos patrones son cruciales para abstraer las operaciones de acceso a datos, permitiendo que la lógica de negocio en la capa de Dominio no necesite conocer los detalles específicos de la base de datos. Durante el desarrollo, se utilizó SQLite por su simplicidad de configuración, ideal para entornos de prototipado y pruebas. Sin embargo, la migración a PostgreSQL en un entorno de producción, facilitada por el propio Entity Framework Core, demostró la flexibilidad de la arquitectura. La capacidad de aplicar migraciones automáticamente al inicio de la aplicación eliminó la necesidad de *scripts* manuales, reduciendo la posibilidad de errores y agilizando el *deploy*. Esta adaptabilidad a diferentes sistemas de bases de datos, sin impacto en las reglas de negocio, es un testimonio de la eficacia de la Arquitectura Limpia (Clean Architecture) para desacoplar las preocupaciones técnicas de las reglas de negocio. El modelo de datos resultante, dividido en dominios de clientes y comercial, se ilustra mediante diagramas de entidades que detallan las relaciones y atributos.

Figura 1. Diagrama de entidades del dominio de clientes
Fuente: Resultados originales de la investigación
La Figura 1, que presenta el diagrama de entidades del dominio de clientes, detalla la estructura de datos para la gestión de información crucial sobre los consumidores. Se observa la entidad `Clientes` como el núcleo, conteniendo atributos como `Id`, `Nome`, `DocumentoNumero`, `DocumentoTipo` y `Ativo`, además de `DataCadastro`. Esta entidad se relaciona con `ClienteEnderecos` y `ClienteContatos`, permitiendo el registro de múltiples direcciones y contactos para un mismo cliente. El modelado de `ClienteEnderecos` con campos como `CEP`, `Logradouro`, `Numero`, `Complemento`, `Bairro`, `Cidade` y `UF` refleja la necesidad de datos geográficos detallados para operaciones comerciales y logísticas. La integración con la API ViaCEP, mencionada en la metodología, optimiza el llenado de estos campos, reduciendo errores y mejorando la experiencia del usuario, lo que es un diferencial práctico para pequeñas empresas que buscan eficiencia. La entidad `ClienteContatos`, a su vez, permite almacenar `Telefone`, `Celular` y `Email`, ofreciendo múltiples canales de comunicación con el cliente. Esta granularidad en el modelado de datos de clientes es esencial para un sistema de gestión de ventas que apunta a la personalización y al relacionamiento duradero, como defendido por Laudon y Laudon (2023), quienes enfatizan la importancia de sistemas de información bien estructurados para la competitividad empresarial.

Figura 2. Diagrama de entidades del dominio comercial
Fuente: Resultados originales de la investigación
La Figura 2, que ilustra el dominio comercial, complementa la visión del sistema al presentar las entidades `Productos`, `Estoques`, `Vendas`, `ItensVenda` y `Usuarios`. La entidad `Productos` incluye `Id`, `Codigo`, `Nome`, `Descricao`, `PrecoUnitario`, `Categoria`, `Ativo` y `DataCadastro`, proporcionando una base sólida para el catálogo de productos. La integración automática con Recombee para la sincronización de productos, como se detalla a continuación, garantiza que las recomendaciones se basen siempre en datos actualizados. La entidad `Estoques` gestiona la `Quantidade`, `QuantidadeMinima` y `Localizacao` de cada producto, permitiendo un control preciso del inventario y la generación de alertas para niveles bajos de stock, una funcionalidad crítica para evitar pérdidas de ventas y optimizar la gestión de capital de trabajo en pequeñas empresas. Las `Vendas` se registran con `Id`, `ClienteId`, `DataVenda`, `Status`, `FormaPagamento` y `Observacao`, mientras que `ItensVenda` detalla cada producto incluido en una venta, con `ProdutoId`, `ProdutoNome`, `Quantidade` y `PrecoUnitario`. Esta estructura permite el seguimiento completo del ciclo de ventas, desde la creación hasta la confirmación y la cancelación, con la baja automática de stock y el envío de eventos de compra a Recombee, demostrando la interconexión y la automatización de los procesos de negocio. La entidad `Usuarios` gestiona el acceso al sistema con `Id`, `Nome`, `Email`, `SenhaHash` y `Role`, implementando un control de acceso basado en perfiles, esencial para la seguridad y la gobernanza del sistema.
La capa API, implementada en ASP.NET Core 8, expone la lógica de negocio a través de una interfaz RESTful. Este enfoque es ampliamente reconocido por su flexibilidad y compatibilidad con diversas aplicaciones cliente. Los *endpoints* se distribuyeron entre los módulos de Autenticación, Clientes, Productos, Inventario, Ventas, Recomendaciones e Informes. La documentación interactiva de la API, generada automáticamente con Swagger/OpenAPI, facilitó el consumo y las pruebas de los *endpoints*. La OpenAPI Specification (OPENAPI INITIATIVE, 2015) es un estándar que permite la creación automatizada de SDKs, agilizando la integración entre *frontend* y *backend* y reduciendo la carga de trabajo de desarrollo. Esta conformidad con estándares abiertos es un indicativo de la madurez del proyecto y de su capacidad de integración con ecosistemas externos.
La separación en capas, según la Arquitectura Limpia, es un resultado arquitectónico de gran valor. Richards y Ford (2020) describen la mantenibilidad, extensibilidad y testeabilidad como características arquitectónicas esenciales. Nexsell, al aislar responsabilidades, garantiza que las modificaciones en una capa no afecten a las otras, facilitando el mantenimiento. La extensibilidad se ve favorecida por el uso de interfaces e inyección de dependencias, permitiendo la fácil sustitución de componentes. La testeabilidad se hace posible por el desacoplamiento entre las capas, posibilitando la escritura de pruebas unitarias y de integración eficaces.
El *frontend* del sistema se construyó como una aplicación web en React 19 con TypeScript, utilizando Ant Design para componentes de interfaz, Zustand para la gestión de estado y Axios para las solicitudes HTTP. La elección de React (REACT, 2013) se debe a su madurez y vasta comunidad, que garantizan un ecosistema robusto y en constante evolución. Ant Design (DEVOGRAPHICS, 2024), por su parte, es una biblioteca de componentes ampliamente utilizada en aplicaciones corporativas, que ofrece más de 50 componentes responsivos y facilita el mantenimiento de la consistencia visual. Zustand fue seleccionado por su simplicidad en la gestión de estado global, abstraiendo detalles de implementación y ofreciendo flexibilidad organizacional. La biblioteca Axios, aunque existen alternativas nativas como Fetch API, fue preferida por sus facilitadores, como el tratamiento automático de *status codes*, la capacidad de tratar errores HTTP como excepciones y la facilidad de uso de *interceptors*, que reducen el código repetitivo y estandarizan el comportamiento de las solicitudes. La herramienta Vite optimizó el proceso de *build* y desarrollo, contribuyendo a la agilidad en la entrega. Una biblioteca TypeScript compartida, que contiene *Value Objects* y casos de uso, fue publicada a través de GitHub Packages, promoviendo la reutilización de código y reforzando la adaptabilidad de la aplicación, permitiendo que el *frontend* evolucione independientemente de la lógica de dominio invariante.
El sistema Nexsell contempló seis módulos principales, cada uno con un conjunto de funcionalidades diseñadas para optimizar la gestión comercial de pequeñas empresas. La Tabla 1 detalla estos módulos y sus principales funcionalidades.
Tabla 1. Módulos implementados y sus funcionalidades principales
|
Unidad |
Características |
|
Clientes |
Registro con CPF/CNPJ, contactos y direcciones múltiples, activación e inactividad |
|
Productos |
Registro por código, categoría y precio, sincronización automática con Recombee |
|
Inventario |
Control de cantidad, alertas de stock por debajo del mínimo, entradas y salidas (En el frontend, integrado con la pantalla de productos) |
|
Ventas |
Creación, adición y eliminación de artículos, confirmación con baja automática de stock, cancelación |
|
Recomendaciones |
Integración con Recombee, sugerencias personalizadas por cliente (En el frontend integrado junto con la pantalla de clientes) |
|
Informes |
Resumen de ventas por período, productos más vendidos, clientes que más compraron y posición del stock |
Fuente: Resultados originales de la investigación
La Tabla 1 presenta un resumen conciso de los módulos implementados y sus funcionalidades, demostrando la amplitud del sistema Nexsell. El módulo de `Clientes` ofrece registro completo con CPF/CNPJ, múltiples contactos y direcciones, además de activación e inactivación, lo cual es crucial para mantener una base de datos de clientes actualizada y precisa, soportando estrategias de segmentación y relación. El módulo de `Productos` permite el registro por código, categoría y precio, y se destaca por la sincronización automática con Recombee, garantizando que el sistema de recomendaciones opere con información de producto siempre actualizada. El `Inventario` proporciona control de cantidad, alertas para stock por debajo del mínimo y registro de entradas y salidas, una funcionalidad vital para la gestión de inventario y para evitar roturas o excesos de stock. El módulo de `Ventas` abarca la creación, adición y eliminación de artículos, confirmación con baja automática de stock y cancelación, automatizando procesos operativos y reduciendo la intervención manual. Las `Recomendaciones Inteligentes` se integran con Recombee para proporcionar sugerencias personalizadas por cliente, un recurso de inteligencia artificial que puede impulsar las ventas y la satisfacción del cliente. Finalmente, los `Informes Gerenciales` ofrecen un resumen de ventas por período, productos más vendidos, clientes que más compraron y la posición del inventario, proporcionando *insights* estratégicos para la toma de decisiones. La implementación de estos módulos demuestra el éxito en integrar funcionalidades operativas tradicionales con recursos avanzados de inteligencia artificial, respondiendo a la problemática de gestión de ventas e inventario en pequeñas empresas.
La interfaz REST expone los *endpoints* distribuidos en los módulos, según se detalla en la Tabla 2. La implementación de estos *endpoints* sigue las mejores prácticas de diseño de APIs, garantizando una comunicación eficiente y segura entre el *frontend* y el *backend*.
Tabla 2. Endpoints implementados por módulo
|
Procedimiento |
Ruta |
Descripción |
|
Posgrado |
/api/auth/login |
Autentica al usuario y devuelve un token JWT |
|
Posgrado |
/api/auth/usuarios |
Crea un nuevo usuario del sistema (solo Admin) |
|
OBTENER |
/api/clientes |
Lista todos los clientes |
|
OBTENER |
/api/clientes/{id} |
Devuelve un cliente por ID |
|
OBTENER |
/api/usuarios/archivo/{documento} |
Busca un cliente por el CPF o CNPJ |
|
OBTENER |
/api/clientes/activos |
Lista solo los clientes activos |
|
OBTENER |
/api/clientes/buscar?nombre={nome} |
Busca clientes por nombre |
|
Posgrado |
/api/clientes |
Registra un nuevo cliente |
|
opción de venta |
/api/clientes/{id} |
Actualiza los datos de un cliente |
|
PARCHE |
/api/clientes/{id}/activar |
Reactivar un cliente inactivo |
|
PARCHE |
/api/clientes/{id}/inactivar |
Inactiva un cliente activo |
|
Posgrado |
/api/clientes/{id}/contactos |
Añade un contacto secundario al cliente |
|
Posgrado |
/api/clientes/{id}/direcciones |
Añade una dirección secundaria al cliente |
|
OBTENER |
/api/productos |
Lista todos los productos |
|
OBTENER |
/api/productos/{id} |
Retorna un producto por ID |
|
OBTENER |
/api/productos/codigo/{codigo} |
Busca un producto por el código interno |
|
OBTENER |
/api/productos/activos |
Lista solo los productos activos |
|
OBTENER |
/api/productos/categoria/{categoria} |
Listar productos por categoría |
|
OBTENER |
/api/productos/buscar?nombre={nome} |
Busca productos por el nombre |
|
Posgrado |
/api/productos |
Registra un nuevo producto |
|
opción de venta |
/api/productos/{id} |
Actualiza los datos de un producto |
|
PARCHE |
/api/productos/{id}/activar |
Reactivar un producto inactivo |
|
PARCHE |
/api/productos/{id}/inactivar |
Inactiva un producto activo |
|
PARCHE |
/api/productos/{id}/stock/add |
Añade cantidad al stock del producto |
|
PARCHE |
/api/productos/{id}/stock/remover |
Eliminar cantidad del stock del producto |
|
OBTENER |
/api/stock |
Enumera el inventario de todos los productos |
|
OBTENER |
/api/stock/{id} |
Devuelve un registro de inventario por ID |
|
OBTENER |
/api/stock/product/{produtold} |
Devuelve el stock de un producto específico |
|
OBTENER |
/api/stock/low |
Listar productos con stock por debajo del mínimo |
|
OBTENER |
/api/stock/available/{produtold}/{quantidade} |
Verifica disponibilidad de stock |
|
Posgrado |
/api/stock |
Crea el registro de inventario de un producto |
|
opción de venta |
/api/stock/{id} |
Actualiza cantidad mínima y ubicación |
|
Posgrado |
/api/inventario/entrada |
Registra entrada de mercancía |
|
Posgrado |
/api/inventario/salida |
Registra salida de mercancía |
|
OBTENER |
/api/ventas |
Listar todas las ventas |
|
OBTENER |
/api/ventas/{id} |
Devuelve una venta por ID |
|
OBTENER |
/api/ventas/cliente/{clienteld} |
Listar todas las ventas de un cliente |
|
OBTENER |
/api/ventas/status/{status} |
Filtrar ventas por estado |
|
OBTENER |
/api/ventas/período?fechaInicio={data}&fechaFin={data} |
Lista ventas por período |
|
OBTENER |
/api/ventas/total?fechaInicio={data}&fechaFin={data} |
Devuelve el valor total de ventas en el período |
|
Posgrado |
/api/ventas |
Crear una nueva venta |
|
Posgrado |
/api/ventas/{id}/ítems |
Añadir un artículo a la venta |
|
ELIMINAR |
/api/ventas/{id}/ítems/{itemId} |
Eliminar un artículo de la venta |
|
PARCHE |
/api/ventas/{id}/items/{itemId}/cantidad |
Actualiza la cantidad de un artículo |
|
Posgrado |
/api/ventas/{id}/confirmar |
Confirma la venta y baja el stock |
|
Posgrado |
/api/ventas/{id}/cancelar |
Cancela la venta |
|
OBTENER |
/api/recomendaciones/cliente/{clienteld} |
Devuelve productos recomendados para un cliente |
|
OBTENER |
/api/recomendaciones/cliente/{clienteId}/completo |
Devuelve el cliente con sus recomendaciones |
|
OBTENER |
/api/recomendaciones/todos |
Devuelve todos los clientes con sus recomendaciones |
|
OBTENER |
/api/informes/ventas/total-órdenes?fechaInicio={data}&fechaFin={data} |
Total de pedidos en el período |
|
OBTENER |
/api/informes/ventas/valor-total?fechaInicio={data}&fechaFin={data} |
Valor total vendido en el período |
|
OBTENER |
/api/informes/ventas/ticket-promedio?fechaInicio={data}&fechaFin={data} |
Ticket promedio en el período |
|
OBTENER |
/api/informes/ventas/por-producto?fechaInicio={data}&fechaFin={data} |
Productos más vendidos en el período |
|
OBTENER |
/api/reportes/ventas/por-cliente?fechaInicio={data}&fechaFin={data} |
Clientes que más compraron en el período |
|
OBTENER |
/api/relatorios/vendas/por-categoria?dataInicio={data}&dataFim={data} |
Categorías más vendidas en el período |
|
OBTENER |
/api/informes/inventario |
Posición actual del inventario |
Fuente: Resultados originales de la investigación
La Tabla 2 detalla los *endpoints* implementados, revelando la granularidad y la organización de la API REST. Cada *endpoint* se describe por el método HTTP (POST, GET, PUT, PATCH, DELETE), su ruta y una breve descripción de la funcionalidad. Por ejemplo, `/api/auth/login` y `/api/auth/usuarios` gestionan la autenticación y el registro de usuarios, respectivamente, con el primero devolviendo un token JWT para sesiones seguras. Los *endpoints* de `/api/clientes` permiten operaciones CRUD completas, incluyendo búsqueda por ID, documento, nombre, estado (activos), y la adición de contactos y direcciones secundarias, evidenciando la robustez de la gestión de clientes. Similarmente, `/api/productos` ofrece funcionalidades para listar, buscar, registrar, actualizar e inactivar productos, además de gestionar el stock directamente (`/api/productos/{id}/estoque/adicionar`, `/api/productos/{id}/estoque/remover`). Los *endpoints* de `/api/estoque` proporcionan visibilidad sobre el inventario, incluyendo productos con bajo stock y verificación de disponibilidad. El módulo de ventas, accesible vía `/api/vendas`, permite la creación, gestión de ítems, confirmación y cancelación de ventas, con la baja automática de stock. Los *endpoints* de `/api/recomendacoes` son cruciales para el módulo de inteligencia artificial, permitiendo la recuperación de sugerencias personalizadas para clientes específicos o todos los clientes. Por último, `/api/relatorios` ofrece *endpoints* para obtener datos agregados de ventas (total de pedidos, valor total, ticket promedio, productos más vendidos, clientes que más compraron, ventas por categoría) y la posición actual del stock, proporcionando la base para las visualizaciones gerenciales. Esta estructura de *endpoints* demuestra la capacidad del sistema de soportar todas las operaciones de negocio de forma programática y eficiente, facilitando la integración con el *frontend* y futuras extensiones.
El módulo de Ventas merece destaque por su integración entre capas y servicios. Al confirmar una venta, el sistema verifica automáticamente la disponibilidad de stock para cada artículo, realiza la baja de las cantidades y, a continuación, envía los eventos de compra al Recombee para alimentar el modelo de recomendaciones. Esta integración se produce de forma resiliente, donde una eventual falla en la comunicación con Recombee no impide la confirmación de la venta, garantizando que el sistema central de negocio no se vea afectado por dependencias externas. Este enfoque está alineado con los principios de tolerancia a fallos discutidos por Richards y Ford (2020), que enfatizan la importancia de diseñar sistemas que puedan seguir operando incluso en presencia de fallos parciales. La automatización de la baja de stock y el envío de eventos de compra en tiempo real son cruciales para la eficiencia operativa y para la precisión de las recomendaciones, respectivamente.
De la misma manera, el módulo de Productos sincroniza automáticamente los datos con Recombee al crear o actualizar un producto. Esta sincronización garantiza que el catálogo del sistema de recomendación esté siempre actualizado, sin requerir acción manual del operador. La consistencia de los datos entre el sistema de gestión y el servicio de recomendación es vital para la relevancia y la calidad de las sugerencias ofrecidas a los clientes, impactando directamente la experiencia de compra y las tasas de conversión.
La seguridad de la información se abordó con la implementación de autenticación basada en JSON Web Tokens (JWT), un estándar ampliamente adoptado en las APIs REST modernas por su naturaleza *stateless* y compatibilidad con aplicaciones distribuidas. La comunicación entre el *frontend* y la API se realiza exclusivamente vía HTTPS, con los tokens JWT transmitidos en la cabecera Authorization de cada solicitud autenticada. El sistema utiliza el paquete Microsoft.AspNetCore.Authentication.JwtBearer para la validación de los tokens y el IPasswordHasher del propio ecosistema ASP.NET Core para el *hashing* de contraseñas, con el algoritmo PBKDF2, garantizando seguridad adecuada sin dependencia de bibliotecas externas. Todos los *endpoints*, con excepción del login, requieren un token JWT válido, y el *endpoint* de creación de usuarios está restringido al *role* Admin, impidiendo que usuarios comunes creen nuevas cuentas. Un usuario administrador por defecto se crea automáticamente en la primera inicialización del sistema, posibilitando el acceso inicial sin necesidad de *scripts* manuales. Los tokens generados tienen una validez de 8 horas e incluyen las *claims* de identificación, correo electrónico, nombre y *role* del usuario. Esta implementación de seguridad es robusta y sigue las mejores prácticas de la industria, protegiendo los datos y el acceso al sistema.
La estrategia de pruebas se estructuró en tres niveles complementarios, según lo recomendado por Sommerville (2011), para garantizar la calidad del software. Se realizaron pruebas unitarias de dominio, cubriendo entidades y objetos de valor, totalizando 154 pruebas. Estas pruebas validaron comportamientos como la creación e inmutabilidad de los objetos de valor (CPF, CNPJ, Documento, Contacto, Dirección), las transiciones de estado de las entidades (activación, inactivación, confirmación y cancelación de ventas), las reglas de negocio que protegen las invariantes del dominio y los casos de fallo esperados. Las 154 pruebas fueron aprobadas, confirmando la robustez de la lógica de negocio.
Adicionalmente, se ejecutaron 58 pruebas unitarias de aplicación para validar los servicios de la capa de aplicación, utilizando el *framework* xUnit y la biblioteca Moq para la creación de *mocks*. Los servicios probados fueron ClienteService, ProductoService, EstoqueService, VendaService y RecomendacaoService. Estas pruebas verificaron escenarios como el rechazo de documentos duplicados en el registro de clientes, la propagación correcta de errores de dominio (como stock insuficiente al confirmar una venta), el comportamiento ante fallos en la integración con Recombee y la correcta devolución de cantidades al stock en la cancelación de una venta previamente confirmada. Las 58 pruebas fueron aprobadas, garantizando la integridad y el comportamiento esperado de los servicios de aplicación. La distribución de estas pruebas por servicio se presenta en la Tabla 3.
Tabla 3. Distribución de las pruebas unitarias por servicio
|
Servicio |
Cantidad de Pruebas |
|
ServicioCliente |
11 |
|
ServicioProducto |
11 |
|
InventarioServicio |
14 |
|
VentaService |
17 |
|
RecomendacaoService |
5 |
|
Suma |
58 |
Fuente: Resultados originales de la investigación
La Tabla 3, que detalla la distribución de las pruebas unitarias por servicio, ofrece una visión cuantitativa de la cobertura de pruebas en la capa de aplicación. Se observa que `VendaService` posee el mayor número de pruebas (17), lo cual es esperado, dada la complejidad y criticidad de las operaciones de venta, que involucran múltiples reglas de negocio e interacciones con otras capas y servicios (como inventario y recomendaciones). `EstoqueService` también presenta un número significativo de pruebas (14), reflejando la importancia del control de inventario para la operación del negocio. `ClienteService` y `ProdutoService` poseen 11 pruebas cada uno, cubriendo las funcionalidades CRUD y validaciones específicas de cada entidad. `RecomendacaoService`, con 5 pruebas, se enfoca en la validación de la integración con Recombee y en el manejo de escenarios de fallo, dado que la lógica compleja de recomendación se delega al servicio externo. El total de 58 pruebas unitarias en la capa de aplicación, sumadas a las 154 pruebas de dominio, totalizando 212 pruebas unitarias, demuestra un compromiso con la calidad del software y la aplicación rigurosa de prácticas de ingeniería de software, como defiende Sommerville (2011). Esta cobertura integral de pruebas es un resultado crucial para la confiabilidad y mantenibilidad del sistema Nexsell.
Se desarrollaron y ejecutaron pruebas de integración automatizadas en el proyecto Teste.Integration, utilizando el *framework* xUnit, directamente contra la API de Recombee. La calidad de las recomendaciones se midió a través de las métricas Precision@K y Recall@K, ampliamente reconocidas en la literatura de sistemas de recomendación (Ricci, Rokach y Shapira, 2015). Para cada uno de los 55 escenarios de evaluación, se aplicó la técnica de *train/test split*, donde se utilizaron cuatro compras para entrenamiento y dos se retuvieron como *ground truth* para evaluación, con K=5 para las métricas. Esta metodología permitió simular el comportamiento de clientes reales y evaluar la capacidad del algoritmo de recomendación en diferentes contextos de preferencia e historial de compras.
Los resultados obtenidos de la integración con Recombee y la evaluación de las recomendaciones se presentan en la Tabla 4.
Tabla 4. Precisión@5 y Recall@5 por perfil de cliente
|
Reseña |
N |
Precisión@5 |
Recordar@5 |
|
Deportista |
11 |
34,50% |
86,4% |
|
Videojugador |
11 |
12,70% |
31,8% |
|
Teletrabajo |
11 |
7,3% |
18,2% |
|
Lector |
11 |
34,5% |
86,4% |
|
Desarrollador |
11 |
7,3% |
18,2% |
Fuente: Resultados originales de la investigación
La Tabla 4 presenta los resultados de las métricas Precision@5 y Recall@5 para cada uno de los cinco perfiles de cliente simulados, además de un total general. Estos datos son fundamentales para comprender el rendimiento del sistema de recomendación en diferentes contextos de consumo. El perfil `Deportista` y `Lector` demostraron los mejores resultados, con Precision@5 de 34,5% y Recall@5 de 86,4%. Estos valores son notablemente cercanos al techo teórico de 40% para Precision@5 y 100% para Recall@5 en el escenario evaluado (con 2 ítems de *ground truth* y K=5), indicando una alta asertividad del algoritmo para perfiles con comportamiento de compra homogéneo dentro de una única categoría. Este hallazgo corrobora la literatura que apunta la eficacia de la filtración colaborativa en identificar patrones de similitud entre usuarios con preferencias bien definidas (Ricci, Rokach y Shapira, 2015).
En contraste, los perfiles `Programador` y `HomeOffice` registraron los menores desempeños, con Precision@5 de 7,3% y Recall@5 de 18,2%. Esta diferencia significativa se explica por el comportamiento de compra heterogéneo de estos perfiles, donde los ítems de *ground truth* pertenecían a categorías distintas. Los algoritmos de filtrado colaborativo, aunque potentes, tienden a tener mayor dificultad en acertar recomendaciones cuando los intereses del usuario son muy diversificados o distribuidos por categorías poco relacionadas, como observado por Ricci, Rokach y Shapira (2015). En estos casos, el algoritmo puede tender a concentrarse en una de las categorías, recuperando solo uno de los ítems relevantes en la mayoría de los escenarios.
El perfil `Gamer` presentó un rendimiento intermedio, con Precision@5 del 12,7% y Recall@5 del 31,8%. Este resultado puede atribuirse a la superposición de dos categorías (Informática y Electrónica) en el historial de compras, lo que, aunque menos homogéneo que los perfiles `Lector` y `Deportista`, es menos disperso que los perfiles `Programador` y `HomeOffice`. El algoritmo demostró mayor asertividad en los artículos de Informática que en los artículos de Electrónica para este perfil, resultando en aciertos parciales en la mayoría de los escenarios.
La media general de Precision@5 del 19,3% y Recall@5 del 48,2% posiciona el sistema dentro del rango de rendimiento esperado para la configuración de datos utilizada y para catálogos de pequeño tamaño. Estos resultados demuestran que el Sistema de recomendación, incluso con datos sintéticos, es capaz de generar sugerencias relevantes, con un rendimiento que varía según la complejidad de los patrones de consumo. La Figura 3 presenta estos mismos resultados en formato gráfico, facilitando la comparación visual entre los perfiles.
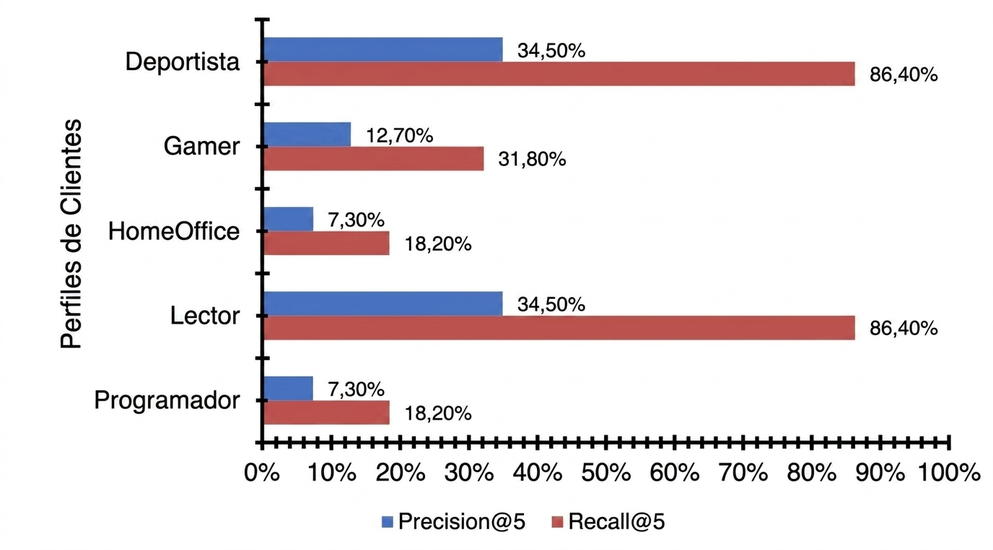
Figura 3. Comparativa de Precisión@5 y Recall@5 por perfil de cliente en los 55 escenarios de prueba de integración con Recombee
Fuente: Resultados originales de la investigación
La Figura 3 ofrece una representación visual clara y concisa de los resultados presentados en la Tabla 4, permitiendo una rápida comparación del rendimiento de las métricas Precision@5 y Recall@5 entre los diferentes perfiles de clientes. El gráfico de barras horizontales destaca visualmente la superioridad de los perfiles `Deportista` y `Lector` en ambas métricas, con las barras de Precision@5 y Recall@5 alcanzando longitudes significativamente mayores en comparación con los otros perfiles. Esta visualización refuerza la conclusión de que la homogeneidad del comportamiento de compra del cliente impacta directamente la eficacia del sistema de recomendación. Los perfiles `Gamer` muestran un rendimiento intermedio, con barras de longitud moderada, mientras que `HomeOffice` y `Programador` exhiben las barras más cortas, ilustrando gráficamente la dificultad del algoritmo para lidiar con intereses más heterogéneos. La representación gráfica facilita la identificación de los puntos fuertes y débiles del sistema de recomendación en diferentes escenarios, siendo una herramienta valiosa para la interpretación de los resultados y para la comunicación de los hallazgos. La claridad visual es esencial para que gerentes y desarrolladores comprendan rápidamente dónde el sistema funciona mejor y dónde hay espacio para optimización, por ejemplo, a través de estrategias de diversificación de recomendaciones para perfiles con intereses amplios.
La ejecución automatizada de los 55 escenarios de prueba con el cálculo de las métricas por perfil se puede verificar en la Figura 4, que muestra la salida de la prueba de integración.

Figura 4. Salida de la prueba de integración que muestra las métricas Precision@5 y Recall@5 calculadas para los 55 escenarios evaluados por perfil de cliente
Fuente: Resultados originales de la investigación
La Figura 4 presenta la salida textual de la prueba de integración, que valida el proceso de sincronización de datos con Recombee y la evaluación de las recomendaciones. La secuencia de mensajes “[0/4] Asegurando esquema de propiedades en Recombee… OK Esquema verificado (nombre, categoría, precio).”, “[1/4] Registrando productos en Recombee (secuencial)… OK 50 productos registrados.”, “[2/4] Enviando interacciones de entrenamiento (secuencial)… OK 220 interacciones (55 clientes × 4 compras).”, “[3/4] Esperando procesamiento de Recombee (3 s)…”, y “[4/4] Obteniendo y evaluando recomendaciones… OK 55 escenarios evaluados.” demuestra el flujo completo y exitoso de la ejecución de las pruebas. Esta salida confirma que el sistema realizó todas las etapas necesarias para la validación del módulo de recomendaciones, desde la verificación del esquema de datos hasta el registro de productos, el envío de interacciones de entrenamiento y, finalmente, la obtención y evaluación de las recomendaciones para los 55 escenarios. La sección “MÉTRICAS POR PERFIL” en la Figura 4 replica los datos de la Tabla 4, proporcionando una prueba directa de la computación de estas métricas durante la ejecución de la prueba. La línea “TOTAL 55 19,3% 48,2%” resume el rendimiento general, corroborando los resultados agregados. Esta evidencia de la ejecución automatizada de las pruebas es crucial para la credibilidad de los resultados, ya que muestra que el proceso de evaluación es replicable y consistente, un pilar de la ingeniería de software moderna (Sommerville, 2011).
La validación de los umbrales mínimos establecidos (Precision@5 ≥ 5% y Recall@5 ≥ 10%), confirmada por el *framework* xUnit, se presenta en la Figura 5.

Figura 5. Resultado final de la ejecución de las pruebas de integración, confirmando la aprobación en los umbrales mínimos establecidos
Fuente: Resultados originales de la investigación
La Figura 5 muestra el resultado final de la ejecución de las pruebas de integración, proporcionando una confirmación explícita de que el sistema cumplió con los criterios mínimos de rendimiento establecidos. El mensaje “Ejecución de Prueba Exitosa. Total de pruebas: 1 Aprobadas: 1 Tiempo total: 1,2245 Minutos Prueba.Integration prueba net8.0 éxito (74,4s)” indica que la prueba de integración principal se completó con éxito, sin fallos. La línea “Resumen de la prueba: total: 1; fallidas: 0; exitosas: 1; ignoradas: 0; duración: 74,3s” refuerza la aprobación total. Esta validación formal, realizada por un *framework* de pruebas, es un resultado crítico que atestigua la funcionalidad y la calidad del módulo de recomendaciones. La aprobación en los umbrales mínimos de Precision@5 (≥ 5%) y Recall@5 (≥ 10%) demuestra que el sistema es capaz de generar recomendaciones con un nivel aceptable de relevancia, incluso en los escenarios más desafiantes. Aunque los umbrales son relativamente bajos, sirven como base para garantizar que el algoritmo esté funcionando correctamente y que la integración técnica con Recombee haya sido exitosa. Para las pequeñas empresas, tener un sistema que genera recomendaciones, aunque sea con un rendimiento variable, ya representa un avance significativo en comparación con la ausencia de tal funcionalidad, abriendo puertas a la personalización de la experiencia del cliente y al potencial aumento de las ventas.
Los resultados demuestran un rendimiento satisfactorio para sistemas de recomendación aplicados a catálogos de pequeño tamaño. Ricci, Rokach y Shapira (2015) destacan que el rendimiento de sistemas de recomendación varía significativamente según el volumen de interacciones disponibles por usuario, lo que explica la diferencia de rendimiento observada entre los perfiles evaluados. Los perfiles con comportamiento homogéneo (Lector y Deportista) alcanzaron Precision@5 de 34,5% y Recall@5 de 86,4%, valores cercanos al techo teórico de 40% para el escenario evaluado. En estos casos, el algoritmo de filtrado colaborativo identificó con precisión la similitud entre los usuarios y concentró las recomendaciones en los ítems correctos. En la mayoría de los escenarios de estos perfiles, ambos ítems de *ground truth* fueron recuperados entre las cinco primeras sugerencias, alcanzando Recall@5 = 100% individualmente. Esto sugiere que para empresas con un nicho de mercado bien definido o clientes con patrones de compra consistentes, el sistema Nexsell puede ofrecer recomendaciones altamente eficaces, impulsando la venta cruzada y la satisfacción del cliente.
El perfil Gamer obtuvo un Recall@5 del 31,8%, un rendimiento intermedio explicado por la superposición de dos categorías en el historial de compras. El algoritmo demostró mayor asertividad en los artículos de Informática que en los artículos de Electrónica, lo que resultó en aciertos parciales en la mayoría de los escenarios. Esto indica que, para clientes con intereses en categorías adyacentes, el sistema aún puede generar recomendaciones relevantes, pero con una precisión ligeramente menor. Para optimizar el rendimiento en estos casos, futuras mejoras podrían explorar la ponderación de categorías o la incorporación de más atributos de artículo para refinar el filtrado basado en contenido.
Los perfiles Programador y HomeOffice registraron el menor Recall@5 (18,2% cada uno). En estos perfiles, los dos ítems de *ground truth* pertenecían a categorías distintas, exigiendo que el sistema acertara en ambas simultáneamente. Las recomendaciones de Recombee tendieron a concentrarse en una de las categorías, recuperando solo uno de los dos ítems relevantes en la mayoría de los casos. Este comportamiento es consistente con la literatura, que indica mayor dificultad para algoritmos de filtrado colaborativo cuando el usuario posee intereses heterogéneos entre categorías poco relacionadas (Ricci, Rokach y Shapira, 2015). Para empresas con clientes de intereses muy diversificados, la implicación práctica es que el sistema puede necesitar más datos de interacción o estrategias de recomendación híbridas para mejorar la diversidad y la relevancia de las sugerencias. La media general de Precision@5 de 19,3% y Recall@5 de 48,2% posiciona el sistema dentro del rango de rendimiento esperado para la configuración de datos utilizada, confirmando la viabilidad de la solución para catálogos de pequeño tamaño.
Además de las pruebas automatizadas, el módulo de recomendaciones fue validado funcionalmente a través del *endpoint* GET `/api/recomendaciones/cliente/{clienteId}/completo` de la API REST. Este *endpoint* devuelve los productos recomendados enriquecidos con los datos de registro del sistema, incluyendo nombre del producto, categoría y precio unitario. La respuesta del *endpoint* para un cliente específico, como se ilustra en la Figura 6, confirma que el flujo completo de integración está operativo: las compras registradas en el sistema se envían automáticamente a Recombee, que procesa el historial y devuelve sugerencias personalizadas en tiempo real.

Figura 6. Respuesta del endpoint de recomendaciones de la API REST devolviendo productos personalizados para un cliente basándose en su historial de compras.
Fuente: Resultados originales de la investigación.
La Figura 6 muestra la respuesta JSON del *endpoint* `/api/recomendaciones/cliente/{clienteId}/completo`, demostrando la validación funcional del módulo de recomendaciones inteligentes. El cuerpo de la respuesta muestra una lista de objetos JSON bajo la clave “recomendaciones”, donde cada objeto representa un producto sugerido. Para cada producto, se retornan el `productoId`, `productoNome`, `categoria` y `precoUnitario`. Por ejemplo, la primera recomendación es un “Mouse Inalámbrico Logitech MX Master” de la categoría “Periféricos” con precio unitario de 599.9. Otras recomendaciones incluyen un “Notebook Dell XPS” de la categoría “Informática” y un “Teclado Mecánico Logitech” también de “Periféricos”. Esta estructura de datos enriquecida es crucial para el *frontend*, ya que permite mostrar las recomendaciones de forma completa y útil para el cliente, sin la necesidad de realizar llamadas adicionales al *backend* para obtener detalles del producto. La presencia de diferentes categorías en las recomendaciones (Periféricos, Informática) sugiere que el algoritmo está considerando una variedad de productos, aunque la diversificación puede ser un desafío para perfiles heterogéneos, como se discutió anteriormente. La validación funcional del *endpoint* es un resultado práctico que confirma la capacidad del sistema de entregar sugerencias personalizadas en tiempo real, un recurso de inteligencia artificial que puede transformar la experiencia de compra en pequeñas empresas, haciéndolas más competitivas al ofrecer un servicio similar al de grandes *e-commerces*.
En resumen, el sistema Nexsell representa una solución tecnológica que integra control operativo e inteligencia de datos de forma accesible para pequeñas empresas. La adopción de principios de Domain-Driven Design y Clean Architecture, junto con una estrategia de pruebas integral, garantizó la construcción de un sistema robusto, mantenible y extensible. La integración con servicios externos como ViaCEP y Recombee demostró la capacidad del sistema de aprovechar tecnologías avanzadas sin incurrir en la complejidad de desarrollarlas desde cero. Los resultados de la evaluación del módulo de recomendaciones, aunque con datos sintéticos, confirmaron la eficacia del algoritmo en identificar patrones de consumo y generar sugerencias relevantes, especialmente para perfiles de clientes con intereses homogéneos. La resiliencia frente a fallos externos, garantizada por el aislamiento de las integraciones, es un resultado arquitectónico crucial que protege las operaciones centrales del negocio.
La principal limitación metodológica identificada fue el uso de datos sintéticos para la evaluación de las recomendaciones. Aunque este enfoque fue suficiente para validar la integración técnica y el funcionamiento del algoritmo, no sustituye una evaluación con datos reales de operación en un entorno de producción. Los datos reales podrían ofrecer *insights* adicionales sobre el rendimiento en condiciones de uso real, incluyendo la interacción de los usuarios con las recomendaciones y el impacto en las métricas de negocio. Como trabajos futuros, se sugiere la validación del sistema con datos reales de operación en entorno de producción, la expansión del módulo de informes con indicadores de rendimiento de las recomendaciones (por ejemplo, tasa de clics, tasa de conversión de las recomendaciones) y la evaluación del impacto de las sugerencias en el comportamiento de compra de los clientes a lo largo del tiempo. Estos pasos futuros serían cruciales para refinar el sistema y maximizar su valor para las pequeñas y medianas empresas.
4. Conclusión
Se concluye que el objetivo se alcanzó, presentando el desarrollo de Nexsell, un sistema inteligente de gestión de ventas que integra funcionalidades operativas tradicionales con recursos de recomendaciones personalizadas. La solución demostró ser accesible y robusta, optimizando las operaciones y mejorando la experiencia del cliente en pequeñas y medianas empresas a través de sugerencias basadas en su historial de compras. La arquitectura adoptada, basada en Domain-Driven Design y Clean Architecture, garantizó la construcción de un sistema mantenible, extensible y resiliente, con integraciones exitosas a servicios externos como ViaCEP y Recombee. Las pruebas automatizadas confirmaron la robustez de la lógica de negocio y la eficacia de la integración. El módulo de recomendaciones, incluso con datos sintéticos, presentó una Precision@5 media de 19,3% y Recall@5 de 48,2%, con un rendimiento superior para perfiles de clientes con comportamiento de compra homogéneo, validando la capacidad del sistema para generar sugerencias relevantes e impulsar ventas.
La principal limitación metodológica de este trabajo reside en la utilización de datos sintéticos para la evaluación de las recomendaciones. Aunque este enfoque ha sido crucial para validar la integración técnica y el funcionamiento del algoritmo, no refleja plenamente el rendimiento en un entorno de producción con datos reales, lo que podría ofrecer *insights* más profundos sobre la interacción de los usuarios y el impacto en las métricas de negocio. Como estudios futuros, se sugiere la validación del sistema con datos reales de operación, la expansión del módulo de informes para incluir indicadores de rendimiento de las recomendaciones, como tasa de clics y conversión, y la evaluación del impacto de las sugerencias en el comportamiento de compra de los clientes a lo largo del tiempo. Estos próximos pasos son esenciales para la mejora continua de Nexsell y la maximización de su valor para el mercado.
Referencias Bibliográficas
EVANS, E. Domain-Driven Design: Tackling Complexity in the Heart of Software. Boston: Addison-Wesley, 2003.
GIL, A. C. Como elaborar projetos de pesquisa. 4. ed. São Paulo: Atlas, 2002.
LAUDON, K. C.; LAUDON, J. P. Sistemas de Informação Gerenciais: Administrando a Empresa Digital. 17. ed. São Paulo: Pearson; Porto Alegre: Bookman, 2023.
OPENAPI INITIATIVE. A Short History of the OpenAPI Initiative and the OpenAPI Specification. 2015. Disponível em: https://www.openapis
RICCI, F.; ROKACH, L.; SHAPIRA, B. Recommender Systems Handbook. 2. ed. New York: Springer, 2015.
RICHARDS, M.; FORD, N. Fundamentos de Arquitetura de Software: Uma Abordagem de Engenharia. São Paulo: Novatec Editora, 2020.
SOMMERVILLE, I. Engenharia de Software. 9. ed. São Paulo: Pearson Prentice Hall, 2011.
VERNON, V. Implementing Domain-Driven Design. Boston: Addison-Wesley, 2013.
Artículo originado del Trabajo de Conclusión de Curso de la Especialización en Ingeniería de Software del MBA USP/Esalq
Para saber más sobre el curso, haga clic aquí y acceda a la plataforma MBX Academy