
29 de noviembre de 2024
Aplicación de un modelo de machine learning para predecir la deserción escolar
DOI: 10.22167/2675-6528-20240030
E&S 2024, 5: e202400030
Tibério Morais Silva Júnior e José Erasmo Silva
En un modelo ideal de formación académica, todos los estudiantes matriculados en instituciones de enseñanza alcanzarían el objetivo de finalizar el curso en el plazo establecido. Sin embargo, en la realidad, diversas intercurrencias surgen en el proceso educacional, como el abandono y la desistência. Tales fenómenos son frecuentemente categorizados por investigadores como evasión[1].
A pesar de esta asociación, algunos estudiosos sobre el tema, como Tinto[2], afirman que existe un desalineamiento sobre lo que realmente podría definirse como evasión, sugiriendo que: 1) no hay consenso sobre la definición del término evasión; 2) que esta definición puede, incluso, ser alterada en función de los contextos individual, institucional o estatal.
Según Silva et al.[1], la deserción escolar presenta consecuencias negativas tanto para el estudiante como para la institución educativa. Desde el punto de vista del alumno, la deserción no solo pospone su formación, sino que también resulta en pérdidas financieras y de tiempo, recursos que podrían ser dirigidos a otras actividades. Para la institución, la deserción compromete su eficiencia, ya que la plaza y los recursos —tanto físicos como tecnológicos— previamente asignados para determinado número de alumnos pasan a ser subutilizados.
Glavam y Cruz[3] resaltan que la deserción trae consigo trastornos significativos para los educandos, las instituciones de enseñanza y las empresas que buscan mano de obra especializada. Para las instituciones educativas, la deserción impacta directamente la salud financiera, ya que, al planificar un curso, los costos asociados se proyectan con base en el número de matrículas.
La deserción resulta en una disminución de los ingresos previstos, pudiendo culminar en déficits financieros al término del curso. En el contexto empresarial, la deserción amplía la carencia de profesionales cualificados, elevando costos y plazos de entrega de productos. Además, la deserción compromete la calidad de vida de los estudiantes, reflejándose en empleos precarios y salarios reducidos, y reverbera en las familias, que frecuentemente cuentan con estos ingresos para hacer frente a sus gastos mensuales.
La deserción en cursos de educación profesional es un tema que, a pesar de su relevancia, presenta una notable escasez de trabajos publicados. Esta modalidad de enseñanza, con sus características peculiares, frecuentemente involucra a alumnos que, paralelamente, están matriculados en otras instituciones de enseñanza o tienen compromisos laborales, limitando así su dedicación al curso profesionalizante. Tales particularidades refuerzan la importancia de este trabajo y la elección de la institución definida como objeto de estudio, una entidad que es referencia en formación de aprendices y cualificación profesional. La institución es privada, pero sin fines de lucro, y fue fundada en 1947 en Bahía y, posteriormente, en Vitória da Conquista.
Para profundizar el entendimiento sobre las causas de la evasión, muchos investigadores recurren a técnicas avanzadas de machine learning, que visan identificar las variables más influyentes en el fenómeno de la evasión, posibilitando, así, la implantación de medidas de prevención. Por ejemplo, Primão[4] y Chung y Lee[5] investigaron, respectivamente, la evasión en diferentes contextos educacionales utilizando técnicas como Árbol de Decisión, Redes Neuronales Artificiales y XGBoost. Silva et al.[1] por su parte, se enfocaron en cursos de graduación a distancia en Brasil, empleando el modelo de Regresión Logística Binaria.
De esta forma, la combinación de un análisis en profundidad de las características de los cursos profesionalizantes con técnicas avanzadas de análisis de datos puede ofrecer información importante sobre la deserción y potenciales estrategias de mitigación.
Dado el contexto, el objetivo de este estudio es aplicar un modelo de machine learning, específicamente Regresión Logística Binaria, para predecir la deserción escolar. De esta forma, será posible no solo anticipar acciones para minimizar la deserción, sino también analizar los factores asociados a ella en los cursos de educación profesional ofrecidos por la institución estudiada, en Vitória da Conquista (BA). La muestra empleada en este estudio fue proporcionada por la gerencia de tecnología de la Información de la institución. La base de datos proporcionada está en formato .xlsx, conteniendo 2.599 observaciones y 21 variables. Los datos personales de los alumnos, como CPF, nombre, filiación, entre otros, fueron omitidos. La base de datos se compone de información recopilada durante el proceso de matrícula en los cursos de educación profesional presencial ofrecidos por la entidad entre 2019 y 2023. Las variables que componen esta base de datos se presentan en la Tabla 1.
Tabla 1. Variables utilizadas en el estudio
| Variable | Descripción |
| Fecha de Nacimiento | Fecha de nacimiento (fecha) |
| PoseeDiscapacidad | Indicador binario de deficiencia (categórico) |
| NombreDiscapacidad | Nombre de la deficiencia, si procede (categórica) |
| Posición en la familia | Posición en la familia (dependiente o no) |
| CantidadDePersonasEnElGrupoFamiliar | Cantidad de personas en la familia (numérica) |
| RentaFamiliarBruta | Renta bruta familiar (numérica) |
| RentaPerCápita | Renta per cápita (numérica) |
| TieneVínculoLaboral | Indicador binario de vínculo laboral (categórica) |
| PorQueNoFunciona | Motivo de no trabajar (8 categorías) |
| ActividadEconomica | Actividad económica en la que trabaja (46 categorías) |
| TipoDeVínculo | Tipo de vínculo (7 categorías) |
| TipoDeInstituciónDeEnseñanzaFundamental | Tipo pública o privada (categórica) |
| TipoDeInstituciónDeEnseñanzaMedia | Tipo pública o privada (categórica) |
| MatriculadoEnEducacionBasica | Indicador binario de matrícula (categórica) |
| EgresadoEnElProgramaDeAprendizaje | Egresado sí o no (categórica) |
| EgresadoEnEducacionBasica | Egresado sí o no (categórica) |
| Estado de Matrícula | Variable dependiente (inicialmente 8 categorías) |
| Ciudad | Ciudad (34 categorías) |
| Escolaridad | Escolaridad (categórica) |
| NombreClase | Nombre de la clase / curso (categórica) |
| PeríodoDeLaCohorteEnMeses | Tiempo en meses del curso (numérico) |
Al analizar inicialmente la variable “estado matrícula”, se identifica la presencia de ocho categorías que describen la situación del alumno en relación con el curso. Estas son: aprobado, desistente, en proceso, evadido, matrícula cancelada, matriculado, reprobado y transferencia interna del mismo título. El estado “aprobado” se atribuye al alumno que asistió al curso con un porcentaje de faltas menor o igual al 25% del total de clases y fue aprobado en las evaluaciones de habilidades y competencias. “Desistente” y “matrícula cancelada” se refieren a los alumnos que se matricularon pero no asistieron a ninguna clase. El término “evadido” se utiliza cuando el alumno se matricula, asiste al menos a una clase, pero no da continuidad al curso. “Reprobado” es el estado para aquellos que no obtuvieron aprobación en las evaluaciones o tuvieron un índice de faltas superior al 25% del total de clases. Los estados “matriculado” y “en proceso” indican que el alumno aún tiene matrícula activa en el curso o ya lo concluyó, estando en fase de cierre administrativo. Por último, “transferencia interna del mismo título” es la categoría para alumnos que solicitaron cambio a otra turma del mismo curso.
A pesar de la falta de consenso en la literatura sobre la definición exacta del término deserción, para este trabajo, siguiendo las directrices de la gestión de la institución estudiada, se consideró desertor al estudiante que registró al menos una presencia durante el curso y, por algún motivo, interrumpió su asistencia. Así, cualquier estudiante con el estado “desertor” en la variable “estado matrícula” se entiende como desertor. Para analizar la base de datos y estimar la probabilidad de deserción, se utilizó el Modelo de Regresión Logística Binaria, insertado en el conjunto de modelos lineales generalizados en que la variable dependiente es cualitativa binaria, con un máximo de dos categorías. Según Fávero y Belfiore[6], en este modelo la variable dependiente (deserción) sigue una distribución de Bernoulli, cuya probabilidad de ocurrencia de un evento es , y la probabilidad de ocurrencia de un no evento es . Este objetiva estimar la probabilidad de ocurrencia de un evento definido por Y, que se muestra en forma cualitativa dicotómica, siendo que Y = 1 representa la ocurrencia del evento, y Y = 0, la ocurrencia del no evento. El vector de variables explicativas de este modelo puede definirse conforme la ec.(1):
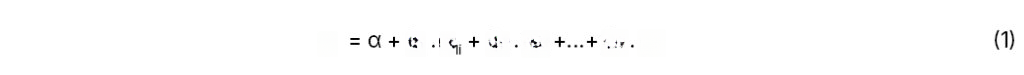
donde Z se denomina logit, α es una constante, βj (1, 2, …, k) son los parámetros estimados de la variable explicativa Xj (métricas o variables dummy) y el subíndice i representa cada observación de la base de datos. En el mismo contexto, el autor describe que la probabilidad estimada de que un determinado evento ocurra puede ser definida por la ec.(2).
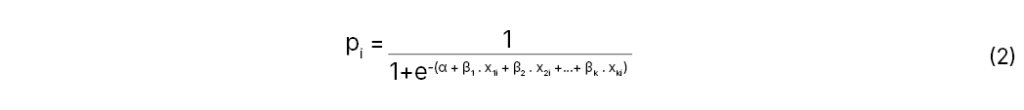
Al analizar la variable dependiente (dicotómica) en un modelo de regresión logística binaria, se hace evidente que la estimación de los parámetros de la ecuación de probabilidad no puede realizarse de la misma forma que en las técnicas convencionales de regresión lineal, ya que estas últimas estiman sus parámetros por el método de Mínimos Cuadrados Ordinarios (MCO). La diferencia surge porque, al estudiar la probabilidad de ocurrencia de un evento con una variable respuesta cualitativa, el modelo no puede calcular la media ni la varianza. Así, no logra minimizar la suma de los términos de error sin una ponderación arbitraria. Por lo tanto, para estimar los parámetros de una ecuación de probabilidad en el modelo de regresión logística, se utiliza el logaritmo de la función de verosimilitud (log likelihood function). Para esta función, valores que se aproximan a cero indican una mayor capacidad de acierto del modelo[6].
Por medio de la Tabla 2 es posible observar que la categoría “aprobado” representó una gran parte del total de ocurrencias.
Tabla 2. Frecuencia de las categorías de la variable Estado de la Matrícula
| Estado de la Matrícula | Observaciones | Porcentaje (%) |
| Aprobado | 1450 | 55,79 |
| Inscripción cancelada | 112 | 4,31 |
| Reprobado | 202 | 7,77 |
| En proceso | 397 | 15,28 |
| Inscrito | 92 | 3,54 |
| Renunciante | 99 | 3,81 |
| Fugado | 215 | 8,27 |
| Transferencia interna mismo título | 32 | 1,23 |
| Suma | 2599 | 100 |
Si se suman a las otras categorías que representan la ocurrencia del no evento (alumnos que no desertaron) y se comparan con el total de ocurrencias del evento (deserción), es posible notar que estos datos se presentan desequilibrados. A pesar de que los datos desequilibrados no son un problema para la regresión logística binaria, es necesario tener esto en cuenta en la interpretación de los resultados. Analizando el tipo de vínculo profesional, es posible percibir que la mayoría de los alumnos que completaron la matrícula no informaron los datos referentes a esta variable. Entre los que eligieron alguna categoría, destaca la información “empleado con contrato registrado” (Tabla 3).
Tabla 3. Frecuencia de las categorías de la variable “tipo de vínculo”
| Tipo de enlace | Observaciones | Porcentaje (%) |
| Autónomo | 150 | 5,77 |
| Empleado con contrato de trabajo | 798 | 30,70 |
| Empleado sin contrato de trabajo | 120 | 4,62 |
| Funcionario público | 32 | 1,23 |
| No informado | 1404 | 54,02 |
| Otros | 93 | 3,58 |
| Profesional liberal | 2 | 0,08 |
| Total de ventas | 2599 | 100 |
Al analizar el nivel de escolaridad de los alumnos, se entiende que muchos aún no habían concluido la educación superior, tratándose de una muestra formada en su mayoría por estudiantes que habían concluido o continuaban cursando la educación secundaria (Tabla 4).
Tabla 4. Frecuencia de las categorías de la variable “escolaridad”
| Escolaridad | Observaciones | Porcentaje (%) |
| Educación primaria completa | 92 | 3,54 |
| Educación primaria en curso | 66 | 2,54 |
| Educación primaria incompleta | 62 | 2,39 |
| Educación secundaria completa | 1302 | 50,10 |
| Educación secundaria en curso | 617 | 23,74 |
| Educación secundaria incompleta | 149 | 5,73 |
| Graduación completa | 97 | 3,73 |
| Grado en curso | 64 | 2,46 |
| Grado incompleto | 27 | 1,04 |
| Técnico de nivel medio completo | 18 | 0,69 |
| Técnico de nivel medio cursando | 43 | 1,65 |
| Técnico de nivel medio incompleto | 6 | 0,23 |
| No rellenado | 56 | 2,15 |
| Total de ventas | 2599 | 100 |
Los cursos de aprendizaje profesional, frecuentemente referidos como Programa Joven Aprendiz, predominan en términos de número de matrículas, destacándose como los principales atractivos para los alumnos (Tabla 5). Notablemente, los cursos de Asistente Administrativo y Diseño de Cejas son excepciones, siendo los únicos de esta categoría en presentar un elevado número de matrículas.
Tabla 5. Frecuencia de las categorías de la variable NomeTurma
| NombreClase (curso) | Observaciones | Porcentaje (%) |
| Administración de pequeñas empresas | 10 | 0,38 |
| Administrador de base de datos | 19 | 0,73 |
| Sastrería femenina | 6 | 0,23 |
| Aprendizaje profesional comercial en servicios Administrativos | 226 | 8,70 |
| Aprendizaje profesional comercial en servicios de supermercados | 63 | 2,42 |
| Aprendizaje profesional de cualificación en servicios administrativos | 595 | 22,89 |
| Aprendizaje profesional de cualificación en servicios de supermercados | 219 | 8,43 |
| Asistente administrativo | 291 | 11,20 |
| Actualización en corte y cepillo | 11 | 0,42 |
| Actualización profesional para camarera(o) | 1 | 0,04 |
| Ayudante de cocina | 16 | 0,62 |
| Pasteles artísticos | 48 | 1,85 |
| Peluquero | 8 | 0,31 |
| Coloración, decoloración, reflejos y mechas | 10 | 0,38 |
| Conductor en turismo – cultura, ecoturismo y rutas | 30 | 1,15 |
| Pastelero | 11 | 0,42 |
| Costurero | 110 | 4,23 |
| Cocinero | 3 | 0,12 |
| Cuidador de ancianos | 61 | 2,35 |
| Desarrollo de liderazgos | 21 | 0,81 |
| Diseño de cejas | 246 | 9,47 |
| Formación de precio de venta | 16 | 0,62 |
| Gestión financiera para microempresa | 15 | 0,58 |
| Manicura y pedicura | 148 | 5,69 |
| Maquillador | 14 | 0,54 |
| Marketing digital | 47 | 1,81 |
| Modelado básico para vestimenta | 2 | 0,08 |
| Modelado y confección de ropa infantil | 6 | 0,23 |
| Preparación de pasteles tradicionales | 12 | 0,46 |
| Vendedor de salgados | 82 | 3,16 |
| Técnicas de organización de unidades habitacionales en fechas conmemorativas | 6 | 0,23 |
| Técnicas de costura y acabado | 19 | 0,73 |
| Técnicas de depilación | 25 | 0,96 |
| Técnico en computación gráfica | 18 | 0,69 |
| Técnico en estética | 29 | 1,12 |
| Técnico en eventos | 31 | 1,19 |
| Técnico en logística | 31 | 1,19 |
| Técnico en masoterapia | 23 | 0,88 |
| Técnico en podología | 16 | 0,62 |
| Tendencia en peinados | 12 | 0,46 |
| Uñas de fibra | 22 | 0,85 |
| Uñas de gel | 16 | 0,62 |
| Uñas decoradas en 3D | 4 | 0,15 |
| Suma | 2599 | 100 |
En un análisis más detallado de los orígenes geográficos de los estudiantes matriculados en los cursos de la institución estudiada, se identificó la presencia de estudiantes provenientes de 34 ciudades diferentes. La región Sudoeste de Bahía destacó, especialmente la ciudad de Vitória da Conquista que, por sí sola, representaba 1.417 de estas matrículas.
Tabla 6. Frecuencia de las categorías de la variable Ciudad
| Ciudad | Observaciones | Porcentaje (%) |
| Anagé | 5 | 0,19 |
| Aracatu | 108 | 4,1 |
| Barra da Estiva | 14 | 0,54 |
| Barra do Choça | 3 | 0,12 |
| Belo Campo | 66 | 2,54 |
| Brumado | 238 | 9,16 |
| Caatiba | 1 | 0,04 |
| Candiba | 183 | 7,04 |
| Ceraima | 1 | 0,04 |
| Cruz das Almas | 1 | 0,04 |
| Érico Cardoso | 3 | 0,12 |
| Forestal | 1 | 0,04 |
| Gongogi | 24 | 0,92 |
| Guanambi | 210 | 8,08 |
| Ibicoara | 1 | 0,04 |
| Igaporã | 75 | 2,89 |
| Iguá | 6 | 0,23 |
| Ituaçu | 13 | 0,50 |
| Jaicós | 2 | 0,08 |
| Jequié | 198 | 7,62 |
| Macaúbas | 5 | 0,19 |
| Materia prima | 2 | 0,08 |
| Palmas de Monte Alto | 2 | 0,08 |
| Paramirim | 1 | 0,04 |
| Pilares | 3 | 0,12 |
| Pindaí | 1 | 0,04 |
| Planalto | 2 | 0,08 |
| Pradoso Presidente Jânio Quadros | 7 | 0,27 |
| Salvador | 3 | 0,12 |
| Sebastião Laranjeiras | 1 | 0,04 |
| Tanhaçu | 1 | 0,04 |
| Taperoá | 1 | 0,04 |
| Vitória da Conquista | 1417 | 54,52 |
| Total de ventas | 2599 | 100 |
Para representar la ocurrencia o no del evento, se creó la variable dependiente dicotómica “evasión”, que contiene la “Y” para representar la existencia del evento y la “N” para el no evento (Tabla 7).
Tabla 7. Variable dependiente “abandono ‘N’ (no) o ‘Y’ (sí)”
| N | Y |
| 2384 (91,72%) | 215 (8,27%) |
Tras el análisis de la base de datos, se verificó la existencia de 155 observaciones sin los datos completos para la modelización y, por lo tanto, se optó por excluirlas, quedando 2.444. Además, cabe destacar que todas las variables categóricas fueron transformadas en dummy. Según Fávero y Belfiore[6], para evitar el error de ponderación arbitraria con variables cualitativas en modelos de regresión logística binaria, se deben utilizar la técnica de variables dummy.
El modelo denominado “modelo_evasao” se desarrolló para representar la regresión logística implementada utilizando la función glm en RStudio – un entorno de desarrollo integrado gratuito para el lenguaje de programación R. En este modelo, se determinó “evasión” como la variable respuesta, especificándose también el parámetro “family” como “binomial”. La Tabla 8 presenta los resultados de este modelo, destacando los parámetros estimados (“Estimate”) y la significancia estadística de las variables después del procedimiento “stepwise”.
Tabla 8. Resultados del modelo GLM para la predicción y análisis de los factores asociados a la deserción escolar
| Variables | Estimación | Error Estándar | valor z | Pr(>|z|) | Fma. |
| (Intercepto) | -3,0847 | 0,2814 | -10,961 | <0,00002 | *** |
| actividad_economica_no_informada | -0,7009 | 0,2156 | -3,251 | 0,001149 | ** |
| actividad_economica_servicios_combinados_de_escritorio | 1,2985 | 0,3721 | 3,489 | 0,000484 | *** |
| aprendizaje_profesional_de_calificación_en_servicios_administrativos | 1,6137 | 0,2456 | 6,57 | 5,02E-11 | *** |
| aprendizaje_profesional_de_calificación_en_servicios_de_supermercados | 1,3105 | 0,3241 | 4,044 | 5,26E-05 | *** |
| asistente_administrativo | 1,2894 | 0,2998 | 4,301 | 1,70E-05 | *** |
| cuidador de ancianos | 1,7612 | 0,4499 | 3,915 | 9,05E-05 | *** |
| Maquillador | 2,4863 | 0,6818 | 3,646 | 0,000266 | *** |
| técnico_de_eventos | 2,5269 | 0,475 | 5,32 | 1,04E-07 | *** |
| técnico_en_logística | 2,5535 | 0,4745 | 5,381 | 7,41E-08 | *** |
| técnico_en_masoterapia | 2,2275 | 0,5859 | 3,802 | 0,000144 | *** |
Nota: *** Significativo al nivel de 0,001; ** significativo al nivel de 0,01, * significativo al nivel de 0,05
Tras el modelado estadístico utilizando regresión logística binaria, se observó que las variables “actividadeeconomica_nao_informado” y “actividadeeconomica_servicos_combinados_de_escrito” son estadísticamente significativas (Tabla 8). La variable “actividadeeconomica_nao_informado”, con coeficiente negativo, indica una menor probabilidad de evasión en comparación con la categoría de referencia “actividadeeconomica_atividade_medica_ambulatorial”. En contraste, la variable “actividadeeconomica_servicos_combinados_de_escrito”, con coeficiente positivo, sugiere una mayor probabilidad de evasión entre los alumnos que ejercen esta actividad económica.
Además, las demás variables significantes están relacionadas al nombre del curso. Por ejemplo, la categoría “tecnico_em_logistica” presenta una probabilidad 2,5535 veces mayor de deserción comparada al curso de “administração_de_pequenas_empresas”, que fue utilizado como referencia. Esto indica que el tipo de curso elegido por el alumno puede ser un factor determinante en su probabilidad de desertar.
Se optó por excluir variables que no demostraron significancia estadística, siguiendo el procedimiento de “stepwise”. Esta decisión se tomó para enfocar en las variables que realmente influyen en la predicción de la deserción escolar, alineándose al objetivo predictivo del estudio. Sin embargo, es relevante mencionar que la inclusión de variables no significantes, aunque no predictivas, puede proporcionar una visión más abarcadora de las influencias potenciales en el fenómeno de la deserción, dependiendo del propósito del análisis[6].
Después del análisis de los coeficientes, es importante analizar las métricas que validan el poder predictivo del modelo. Este análisis se realizó mediante la curva characteristic operating receiver [ROC], la curva de sensibilidad y la curva de especificidad, además de la matriz de clasificación.
Al calcular la sensibilidad y la especificidad, es esencial determinar el punto de corte, o cutoff, que se utilizará para clasificar las observaciones basándose en el cálculo de sus probabilidades. Esto es particularmente relevante cuando se introduce una nueva observación en la muestra y se desea predecir la probabilidad de que esa observación sea clasificada como un evento o no. La clasificación ocurre al comparar el valor estimado de la probabilidad pi de la nueva observación con el valor del cutoff. Si pi es mayor que el cutoff, la observación será categorizada como evento; si pi es menor que el cutoff, será categorizada como no evento. El cutoff permite evaluar la precisión del modelo con las observaciones de la muestra, asegurando que esta precisión se mantenga al predecir la ocurrencia de un evento en nuevas observaciones.
A partir de la Figura 1 es posible analizar las curvas de sensibilidad y especificidad. Su análisis revela un punto óptimo de corte aproximadamente igual a 0,12, lo que representa un equilibrio entre sensibilidad y especificidad. Es notable que la curva de especificidad presenta una alta tasa de aciertos para casi todos los valores de corte, mientras que la curva de sensibilidad exhibe un comportamiento opuesto, con la tasa de acierto disminuyendo significativamente para puntos de corte superiores a 0,15. Se percibe además que el modelo está bien calibrado para predecir el no evento (no evasión). Sin embargo, su eficacia en la predicción de la evasión es menos consistente. Esto sugiere que, para valores más elevados de corte, el modelo tiende a cometer más errores al predecir la evasión. Este comportamiento puede impactar negativamente la eficiencia general del modelo. Así, para mejorar la capacidad del modelo en predecir la evasión, puede ser beneficioso considerar la inclusión de nuevas variables explicativas, así como utilizar una muestra mayor.
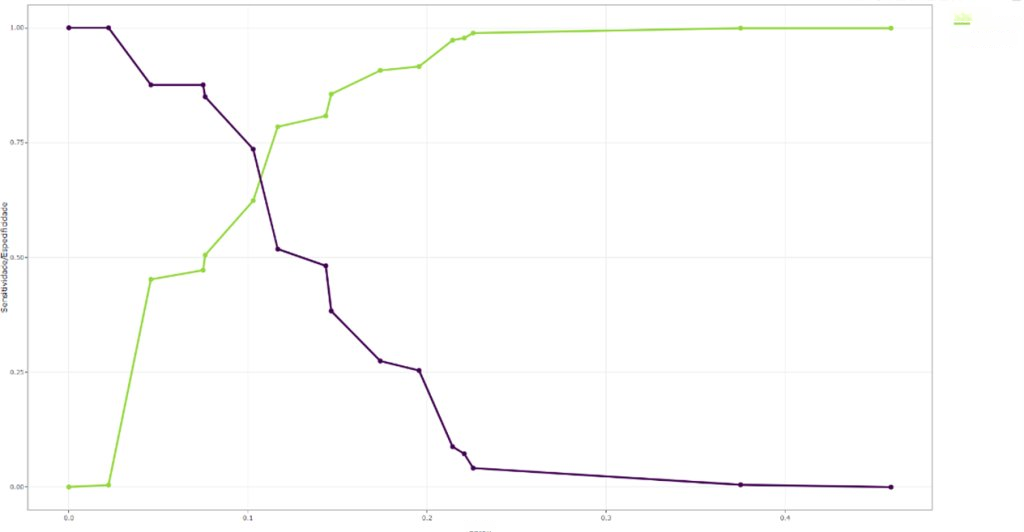
Fuente: Resultados originales de la investigación.
Para visualizar y obtener una mayor comprensión sobre el comportamiento predictivo de este modelo, se generó una matriz de clasificación para un cutoff igual a 0,10. Una vez más, se percibe la capacidad predictiva de este modelo en relación con la predicción del no evento, con 1.404 aciertos y solo 847 errores. Sin embargo, la matriz confirma la necesidad de ajustar este modelo cuando el objetivo principal de su utilización sea evaluar la ocurrencia del evento, la evasión.
Tabla 9. Matriz de Confusión
| Opción | Verdadero | Falso |
| Verdadero | 142 | 847 |
| Erróneo | 51 | 1.404 |
La sensibilidad, la especificidad y la precisión (tasa de aciertos global del modelo) se pueden obtener a partir de la información de la matriz de clasificación, en RStudio (Tabla 10).
Tabla 10. Estadísticas Matriz de Confusión
| Precisión/ Exactitud | Valor p de la prueba de McNemar | Sensibilidad | Especificidad |
| 0.6326 | < 2 y – 16 | 0.73575 | 0.62372 |
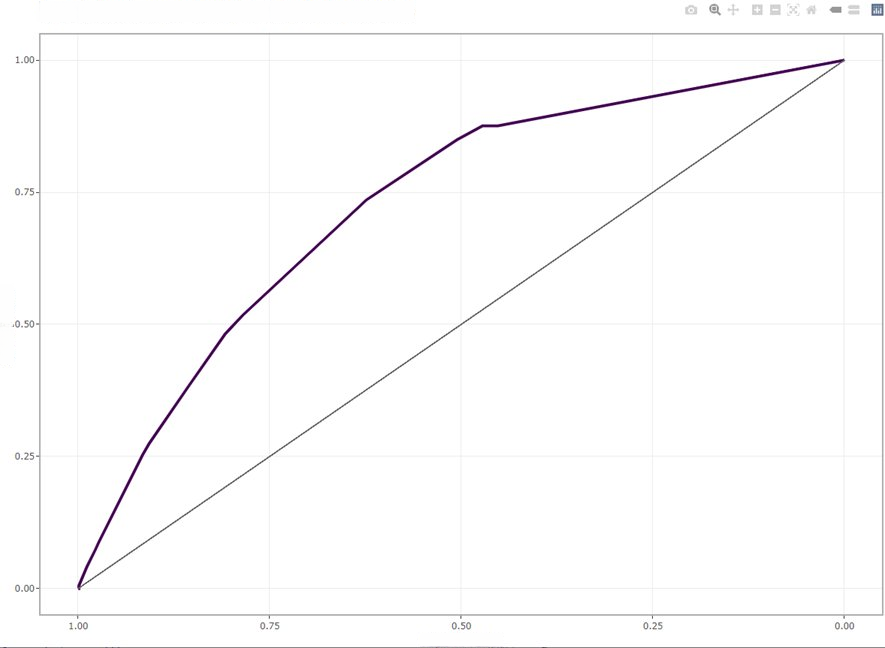
Finalmente, la Figura 2 muestra la gráfica de la curva ROC. Representa el valor de la sensibilidad contra 1-especificidad para el modelo utilizado en este trabajo. Observando el valor del área bajo la curva igual a 0,728, se percibe que este modelo se mostró razonablemente al considerar todos los puntos de corte. De esta forma, para un mejor desempeño de este modelo en relación a la capacidad de predecir la ocurrencia del evento evasión, se puede sugerir la inclusión de nuevas variables explicativas en el modelo y la predicción de la evasión utilizando un modelo multinivel.
Fuente: Resultados originales de la investigación.
Este estudio utilizó datos referentes a las situaciones de matrícula de los alumnos y sus respectivas características. Se empleó un modelo de regresión logística binaria para evaluar la significancia estadística de estas variables y la capacidad predictiva del modelo. Se observó que ciertas variables, tanto relacionadas con el tipo de actividad económica ejercida por el alumno como con el curso en sí, poseen una correlación negativa o positiva con la deserción. Esto sugiere que políticas internas pueden ser estratégicamente dirigidas a estos factores específicos.
Para evaluar la capacidad predictiva del modelo, se utilizaron métricas como sensibilidad, especificidad, curva de sensibilidad, curva de especificidad y curva ROC. Con un ajuste de corte en 0,10, el modelo alcanzó una precisión de 0,6326, una sensibilidad de 0,73575, una especificidad de 0,62372 y un área bajo la curva ROC de 0,72. El modelo demostró ser eficaz en la predicción de no eventos, pero menos preciso en la predicción de evasión. Este comportamiento se debe en parte al desequilibrio de la base de datos. La diversidad de categorías en la variable “EstadoMatrícula” y la ambigüedad de algunas de ellas plantearon desafíos en el análisis. En un escenario con una organización más clara de esta variable, es posible que se obtenga un resultado estadístico más robusto. Además, el número limitado de observaciones puede haber impactado negativamente la evaluación del modelo.
Los resultados presentados indican que las actividades económicas y los tipos de curso son factores críticos en la determinación de la deserción escolar. Este conocimiento permite que los gestores de la institución investigada desarrollen estrategias dirigidas, como ofrecer soporte adicional a los alumnos matriculados en cursos con mayor riesgo de deserción, o crear programas de orientación para estudiantes cuyas actividades económicas indican mayor probabilidad de abandono.
Variables such as date of birth, employment status, education level, family income, among others, that did not show statistical significance in the final model, can be investigated in future studies using a larger sample. With a more robust dataset, it is possible that the influence of these variables on school dropout becomes more evident, providing additional insights into the factors affecting students’ decisions to continue or abandon their courses.
Este estudio demostró que la aplicación de un modelo de regresión logística binaria puede no solo predecir la deserción escolar con razonable precisión, sino también identificar los principales factores que contribuyen a este fenómeno en los cursos de educación profesional ofrecidos por la institución que fue objeto de la investigación. Al anticipar estas tendencias, la institución tiene la oportunidad de implementar acciones preventivas específicas, reduciendo potencialmente la tasa de deserción y mejorando los resultados educativos.
Para futuras investigaciones, se sugiere realizar un estudio comparativo entre el modelo de regresión logística binaria, el modelo logístico multinomial y el XGBoost, con el fin de evaluar qué enfoque ofrece un mejor rendimiento en la predicción del abandono escolar.
Referencias
[1]Silva, F.C.; Cabral, T.L.O.; Pacheco, A.S.V. 2020. Dropout or permanence? Predictive models for higher education management. Education Policy Analysis Archives 28(149). <https://doi.org/10.14507/epaa.28.5387>.
[2]Tinto, V. 1989. Definir la desercion: Una cuestion de perspectiva. Revista de la Educación Superior. Disponível em: <http://publicaciones.anuies.mx/pdfs/revista/Revista71_S1A3ES.pdf>. Acesso em: 06 jan. 2023.
[3]Glavam, R.B.; Cruz, H.A. 2013. Estudo da Evasão Escolar dos Cursos Profissionalizantes em uma Unidade do Serviço Nacional de Aprendizagem Industrial de Santa Catarina-SENAI. X Simpósio de Excelência em Gestão e Tecnologia. Disponível em:
<https://www.aedb.br/seget/arquivos/artigos13/31818288.pdf>. Acesso em: 06 jan. 2023.
[4]Primão, A.P. 2022. Uso de algoritmos de machine learning para prever a evasão escolar no ensino superior: um estudo no Instituto Federal de Santa Catarina. Dissertação (mestrado profissional) – Universidade Federal de Santa Catarina, Centro Sócio-Econômico, Programa de Pós-Graduação em Administração Universitária, Florianópolis. Disponível em:<https://repositorio.ufsc.br/handle/123456789/238320>. Acesso em: 06 jan. 2023.
[5]Chung, J.Y.; Lee, S. 2019. The Machine Learning-Based Dropout Early Warning System for Improving the Performance of Dropout Prediction. Appl. Sci 9(15) <https://doi.org/10.3390/app9153093>.
[6]Fávero, L.P.; Belfiore, P. 2022. Manual de análisis de datos. LTC, Río de Janeiro, RJ, Brasil.
Cómo citar
Silva Júnior T.M.; Silva J.E.; Aplicación de un modelo de machine learning para predecir la deserción escolar. Revista E&S. 2024; 5: e20240030.
Sobre los autores
Tibério Morais Silva Júnior – Especialista en Data Science y Analítica. Rua Bruno Bacelar, 261, Alto Maron, CEP: 45005-306 – Vitória da Conquista/BA, Brasil
 José Erasmo Silva – Profesor Director MBA Data Science e Analytics – Universidade Federal da Bahia – Programa de Postgrado en Contabilidad – PPGCONT– Avenida Reitor Miguel Calmon, s/n Canela – CEP: 40231-300 – Salvador/BA, Brasil