
09 de febrero de 2024
Una comparación entre estrategias de inversión utilizando redes neuronales, métodos estadísticos y momentum
DOI: 10.22167/2675-6528-2023116
E&S 2024, 5: e2023116
Helcio Haruo Sasaki; Murilo Henrique Tank Fortunato
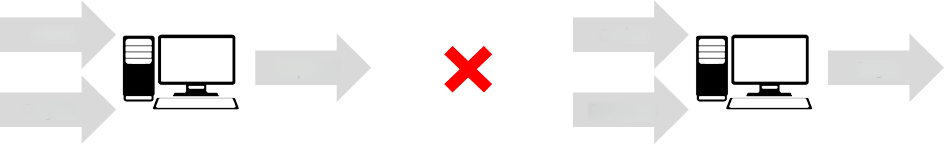
La inteligencia artificial (IA) nació a mediados del siglo XX y provocó dos “olas” en el mercado. La primera comenzó en 1950, con Alan Turing[1] como principal exponente, prevaleciendo hasta mediados de 1980, en medio de los avances de la ciencia de la computación. Uno de los íconos de esta generación fue el desarrollo del juego de ajedrez para computadoras. Una segunda ola surgió entre las décadas de 1990 y 2000, cuando hubo una inversión en la regla de programación clásica. Hasta entonces era necesario programar explícitamente todas las posibilidades para obtener las respuestas. Ya en el “machine learning”, el objetivo pasa a ser entrenar a la máquina para el aprendizaje, de forma que ella descubra la regla, conforme se ilustra en la Figura 1.
Figura 1. Representación del modelo de “machine learning” antes y después
Fuente: Elaborado por los autores.
Actualmente ya existen diversas aplicaciones prácticas para productos que utilizan el “machine learning”, como los asistentes personales, las herramientas de marketing asertivo de las redes sociales, los modelos de predicción de diagnóstico mejorados y, más recientemente, los coches con dirección autónoma (con destaque para el de la empresa Tesla), el AlphaGo (IA de DeepMind que derrota humanos en el juego Go) y el ChatGPT (IA capaz de crear contenido), de OpenAI[2].
Últimamente el mercado financiero ha comenzado a incorporar estas herramientas, que tienen un enorme potencial para el descubrimiento de nuevas aplicaciones, como el uso de “machine learning” para estimar el precio del café a través de la red “convolutional neural network”[3]. El objetivo de este trabajo fue implementar técnicas de “machine learning” para generar alfa en las inversiones, es decir, realizar una gestión activa obteniendo retornos por encima del “benchmark”. Es importante mencionar que, en términos de precisión, mientras la máquina logra niveles elevados de acierto en un modelo de clasificación de imágenes, en el mercado financiero el nivel de predicciones correctas es más modesto. Robert Mercer, uno de los fundadores de la gigante de la gestión de inversiones Renaissance Technologies, dijo una vez: “estamos seguros el 50,75% de las veces, pero estamos 100% seguros en el 50,75% de las veces”[4].
Se estructuró una cartera cuyos recursos se distribuyeron equitativamente en cuatro posibles inversiones. La actualización fue mensual y sintetizó un historial de 20 años. No se consideraron costos de corretaje, costos de ejecución, impuesto a la renta ni la posibilidad de posición vendida en el activo (apuesta por el retorno negativo de los activos), ya que no es de fácil implementación para inversores personas físicas.
a) Dólar
El precio de referencia del real frente al dólar se midió por la cotización media de tres fondos existentes (Santander Fundo Cambial, Itaú Fundo Cambial y Bradesco Fundo Cambial). Utilizar solo la variación cambiaria no refleja correctamente la rentabilidad, ya que existe una remuneración sobre el efectivo en dólares.
b) Acciones del Ibovespa
Índice con las principales empresas negociadas en la Bolsa de valores, como: Petrobras, Vale, Itaú, Bradesco, Santander, Banco do Brasil, B3, WEG y Ambev.
c) Inversión con intereses preestablecidos a dos años
Tasa media interpolada para el plazo de dos años, basada en los vértices de depósitos interbancarios negociados diariamente en la Bolsa de Valores (B3). La elección de un plazo genérico evitó la necesidad de considerar el efecto de decaimiento del plazo del papel. En este análisis se consideró el retorno de inversión basado en el valor financiero (PU):
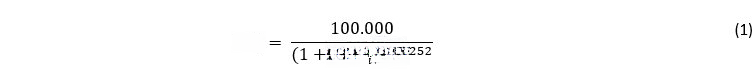
en que: PUi es el valor presente de los 100 mil invertidos; i representa la fecha de referencia; dui representa los días hábiles entre i y el plazo genérico de vencimiento; y taxai representa la tasa preestablecida negociada en el día i.
d) Inversión con intereses preestablecidos a cinco años
Tasa promedio interpolada a cinco años, basada en los vértices de depósitos interbancarios negociados diariamente en la Bolsa de Valores. También se consideró el rendimiento basado en el valor financiero (PU).
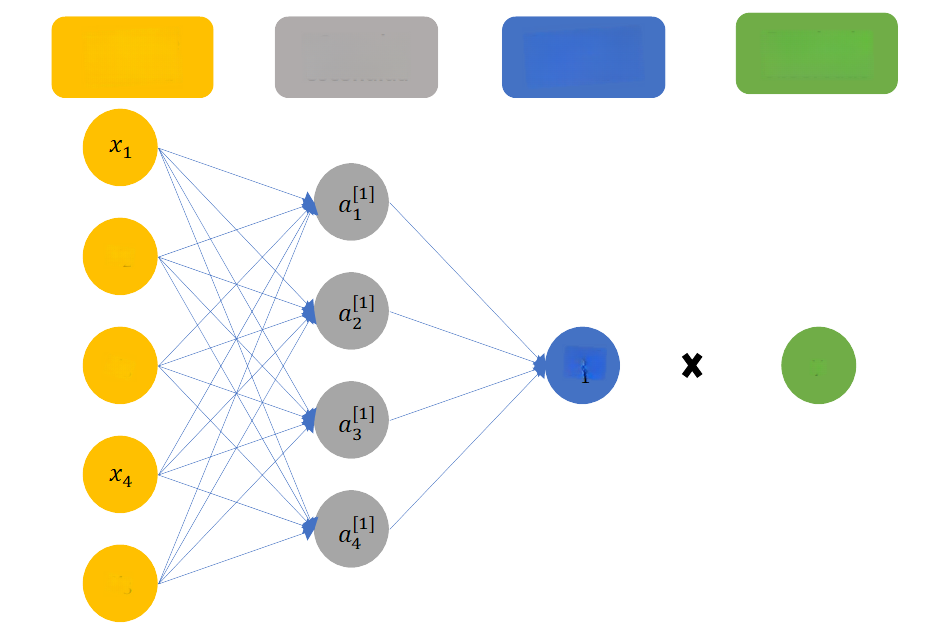
Los lenguajes de programación —como R, Java Script y, principalmente, Python— poseen diversos paquetes de redes neuronales, como Keras y TensorFlow. Según Chollet[5], estas herramientas tienen la ventaja de ser como bloques de construcción, donde es posible encajar capas de funciones de “deep learning” y utilizar el “pipeline” para ordenar el flujo de información dentro de la estructura. Sin embargo, para ganar sensibilidad del racional y de los resultados, se creó una red neuronal desde cero, detallada en la Figura 2[6]:
Figura 2. Diagrama de la red neuronal propuesta
Fuente: Elaborado por los autores.
En este ejemplo existen cinco datos de entrada, una capa oculta (o capa intermedia) y una capa de salida (o capa de “output”) que contiene el resultado estimado. La referencia sobrescrita entre corchetes ([j]) representa la capa de cada neurona; en este caso, varía solo entre 1 (capa “hidden layer”) y 2 (capa “output layer”). La referencia subscrita “i” representa la neurona contenida en una determinada capa. En este caso la capa oculta cuenta con cuatro neuronas, y la capa de salida contiene solo una neurona.
La neurona Zi[j] puede ser descrita genéricamente como el resultado del “input” ponderado por el peso w –(“weight”) sumado al sesgo b[j] (“bias”):
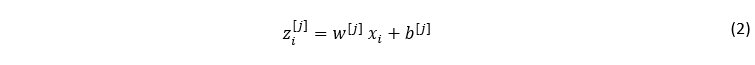
En cada una de las capas, hay una función de activación cuyo objetivo es “activar” o “desactivar” la neurona. Este paso es importante para reducir el riesgo de no convergencia del error, como se describe en Murray, Abrol y Tanner[7] y Ovalle[8], lo que haría que el modelo fuera incapaz de encontrar una solución.
En la capa oculta se utilizó la función de activación tangente hiperbólica tanh, utilizando w[1] para ponderar los datos de entrada sumado el sesgo b[1]. De esta forma, la neurona de la capa intermedia intenta estimar el retorno del activo entre alza (+1) o caída (-1):
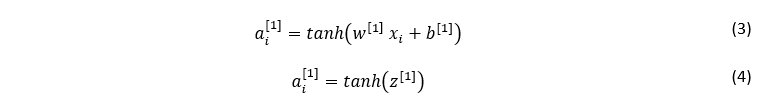
En la capa de salida ai[2] se utilizó la función de activación sigmoide σ. De este modo, la capa de salida pondera el resultado de la capa anterior ai[1] por el peso w[2] y añade el sesgo b[2], definiendo así si era interesante (+1) o no (0) invertir en el activo:
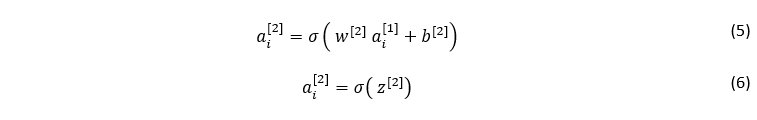
Para el cálculo del error, se utilizó la ecuación “binary cross entropy”[9]:
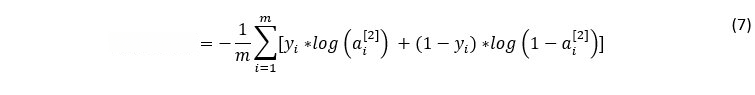
en que: error total representa la sumatoria de la diferencia entre el valor estimado y el valor realizado; m representa el tamaño de la muestra; ai[2] representa el valor estimado resultado de la “capa de salida”; y Yi representa la variable observada.
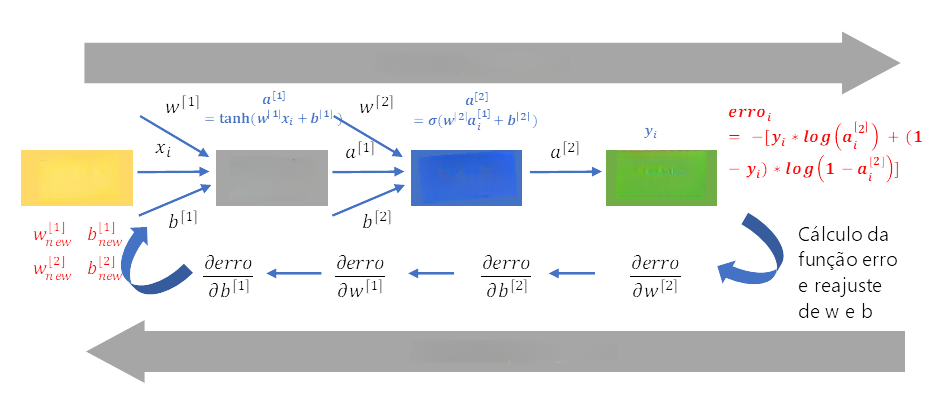
Inicialmente, en la capa de entrada, los valores de w[1] y b[1] son valores aleatorios. El resultado de la multiplicación de los “inputs” por el peso w[1] se suma al sesgo b[1], y el resultado final pasa por una función de activación logística. La información fluye hacia la capa intermedia, donde el resultado anterior se multiplica por el nuevo peso w[2] y se suma al sesgo b[2], los cuales inicialmente también son valores aleatorios. Este flujo de información se llama “forward propagation”.
La belleza de la red neuronal es que, basándose en la diferencia entre el valor estimado y el valor realizado, se realiza una nueva estimación, con ajuste marginal de los parámetros w[j] y b[j] para minimizar la desviación en la próxima iteración. Esto se asemeja al proceso de aprendizaje por ensayo y error, que en las redes neuronales se llama “propagación hacia atrás”[10].
Figura 3. Flujo de la información dentro de una red neuronal
Fuente: Elaborado por los autores.
Los parámetros de corrección descritos en la “propagación hacia atrás” de la Figura 3 se obtuvieron a través del método de optimización de descenso de gradiente, en el que la corrección del peso se define por:
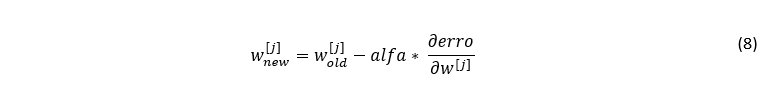
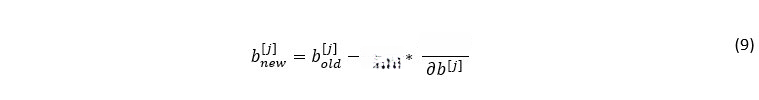
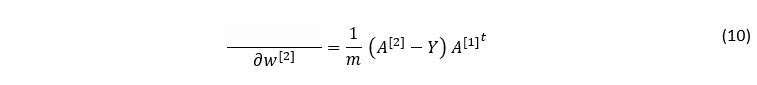
en que: A[2] representa el valor esperado en la capa de salida en matriz; Y representa los resultados realizados en forma matricial; y A[2]t representa el resultado de la capa intermedia en matriz transpuesta.
A continuación se calculó la derivada parcial de la sensibilidad del error con respecto al sesgo de la capa de “output”, b[2], representada matricialmente por la media de la desviación:
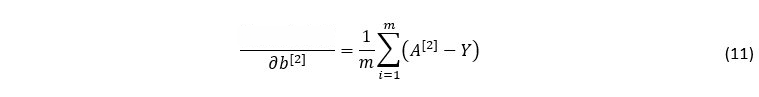
Hasta aquí se calcularon las correcciones para el peso y para el sesgo de la capa de salida. El siguiente paso fue calcular el ajuste del peso y del sesgo para la capa oculta. La sensibilidad del error en relación con el peso en la capa intermedia, w[1], se calculó de la siguiente manera:
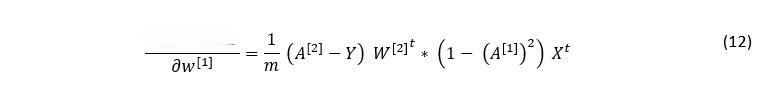
en que: W[2]t representa los pesos de la capa final en matriz transpuesta; y Xt representa los datos de “input” en matriz transpuesta.
A continuación se calculó la derivada parcial del error con respecto al sesgo en la capa intermedia, b[1]:
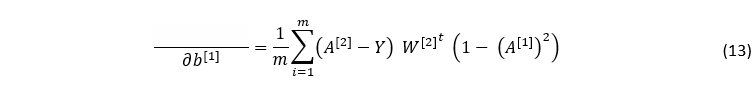
en que: W[2]t representa los pesos de la capa final en matriz transpuesta.
Las fórmulas matriciales (10) y (11) de la capa de salida y las ecuaciones (12) y (13) de la capa intermedia fueron codificadas en Python.
Todas las estrategias utilizaron 20 años de historial mensual, en el período de enero de 2002 hasta diciembre de 2022.
a) Estrategia “long-only” (estrategia pasiva)
Los recursos se dividieron equitativamente entre cuatro activos: bolsa, dólar, intereses a dos años e intereses a cinco años, sin ninguna modificación durante el período de análisis.
b) Impulso
El impulso representa la tendencia de que el aumento de los precios se perpetúe en los próximos períodos, de la misma manera que la caída en general va precedida por nuevas correcciones. En este sentido, los ganadores del Nobel de economía de 2008, Fama y French[12], afirmaron que el impulso es una “premier market anomaly”, es decir, una estrategia que genera retornos por encima de la media. Trabajos posteriores confirmaron esta anomalía, incluso en los mercados de países emergentes[11].
Antonacci[13] fue más allá y propuso una estrategia simple pero eficaz sobre el momentum de los activos: si el retorno de un activo es superior a la tasa libre de riesgo, se aplica en ese activo para el próximo período. En caso de que el retorno sea inferior, se aplica en el activo libre de riesgo.
c) Momentum de 21 períodos
Se aplicó la misma lógica de la estrategia descrita en el ítem anterior, pero se utilizó una media móvil de los retornos de los últimos 21 meses, plazo elegido por ser común en análisis técnicos.
d) Regresión lineal [“ordinary least squares (OLS)”]
En esta estrategia se calcularon los coeficientes de la regresión lineal retardada en un período, según ejemplo para el retorno del dólar:
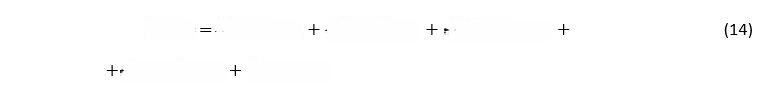
donde: USDM representa el retorno del dólar en el período M; USDM-1: es el retorno del dólar en el período M-1; IBOVM-1 es el retorno del Ibovespa en el período M-1; PRE2YM-1 representa el retorno de la inversión en tasas de interés pre-fijadas a dos años en el período M-1; PRE5YM-1 es el retorno de la inversión en tasas de interés pre-fijadas a cinco años en el período M-1; CDIM-1 es el retorno del Certificado de Depósito Interbancario (CDI) en el período M-1; y βs representan los coeficientes de la regresión.
Como se detalla a continuación, el modelo de redes neuronales utiliza el 80% de los datos para el entrenamiento. Para mantener la igualdad en relación con el tamaño de la muestra, se utilizó el mismo corte de datos para estimar los coeficientes de la regresión lineal. De esta forma, para un determinado mes “M”, el 80% de las observaciones anteriores (17 meses) se utilizaron para estimar los coeficientes de la regresión; el 20% restante de las observaciones (cuatro meses), como muestra para prueba.
Si la estimación del retorno del próximo período fuera positiva, los recursos se aplicarían en ese activo para el mes siguiente. De lo contrario, los recursos se aplicarían en el activo libre de riesgo CDI.
e) Regresión logística
De la misma manera que sucedió con la regresión lineal, se estimaron los coeficientes de la regresión logística basándose en una ventana móvil de 21 períodos: el 80% de las observaciones de la muestra se utilizaron para determinar los coeficientes de la regresión, y el 20% restante como prueba. Para definir si el retorno siguiente sería de alza (1) o de baja (0), se utilizó el corte de 0,50 como límite.
Red neuronal
Se implementó, como se detalla en la Figura 2, una capa oculta de cuatro neuronas con activación de tangente hiperbólica y una neurona en la capa de “salida” con activación logística.
La ventana móvil contenía el retorno de los últimos 21 meses; el 80% de las observaciones anteriores (17 meses) se utilizaron para estimar los parámetros de “weight” y “bias”, y el 20% restante para la prueba. La tasa de aprendizaje fue de 0,50, con 1.000 iteraciones (“epochs”).
Si el retorno esperado fuera positivo, el modelo aplicaría los recursos en ese activo para el próximo mes. Si el retorno esperado fuera negativo, el modelo aplicaría los recursos en el CDI.
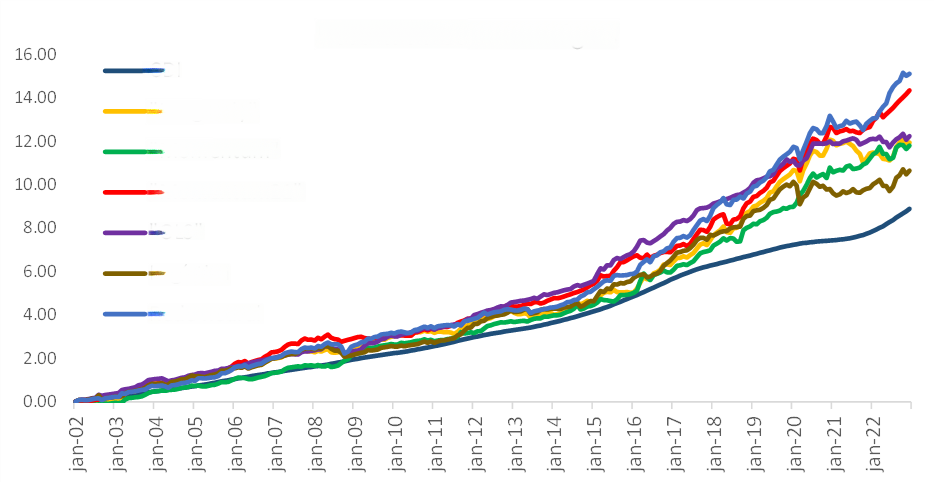
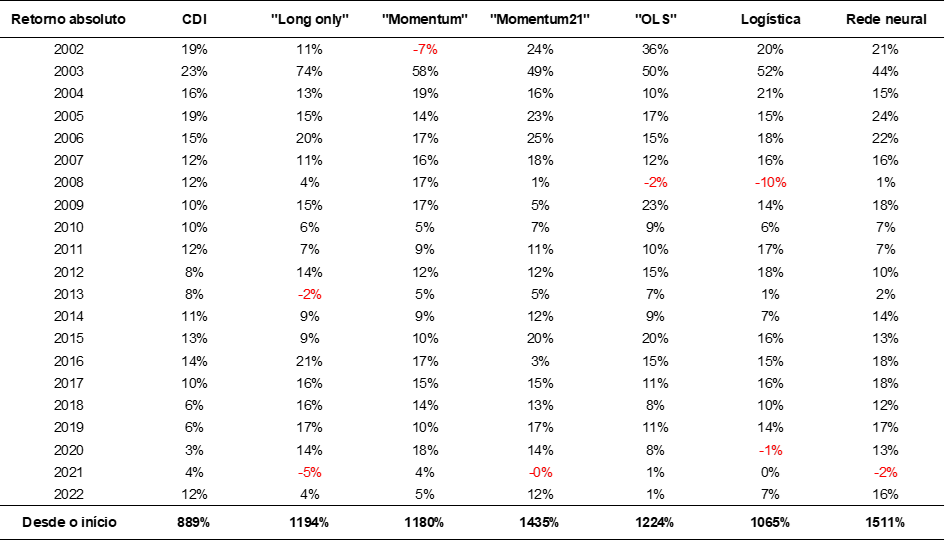
La Figura 4 demuestra el resultado acumulado de 20 años de las seis estrategias de inversión y el “benchmark”, que es el CDI acumulado en el período. En la Tabla 1 constan los resultados detallados por año y estrategia.
Figura 4. Resultado mensual acumulado de las 6 estrategias y el CDI acumulado
Fuente: Elaborado por los autores.
Tabla 1. Resultado anual de las diferentes estrategias
Fuente: Elaborado por los autores.
Con el objetivo de elegir la mejor estrategia, se evaluaron ocho criterios: retorno total absoluto; “sharpe ratio” (retorno ajustado a la volatilidad); “máximo drawdown” (pérdida máxima mensual); volatilidad (desviación estándar); número de años negativos; número de meses negativos; “sortino ratio” (retorno ajustado a la volatilidad de pérdidas); y número de años por encima del CDI.
Tabla 2. Medidas de evaluación de las diferentes estrategias

Fuente: Elaborado por los autores.
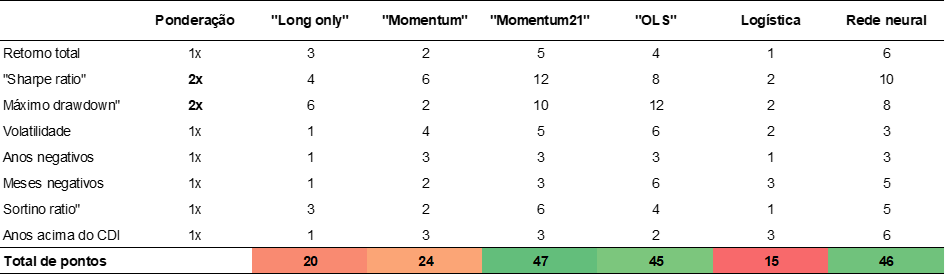
Para cada criterio se asignaron puntuaciones de 1 a 6, siendo 6 la mejor y 1 la peor. Para los indicadores “sharpe ratio” y “máximo drawdown”, hubo ponderación de peso doble, debido a su importancia para la evaluación de inversión.
Tabla 3. Ranking de la mejor estrategia (cuanto mayor la puntuación, mejor)
Fuente: Elaborado por los autores.
A pesar de que la estrategia de redes neuronales tiene el mejor rendimiento, con un retorno del 1.511% en 20 años, el modelo que obtuvo la mejor puntuación fue el momentum con 21 períodos, con un rendimiento superior en ítems como “sharpe ratio”, “máximo drawdown”, “sortino ratio” y volatilidad.
En la construcción de la estrategia de red neuronal, se notó variabilidad en los resultados dependiendo de los “inputs” utilizados, como tasa de aprendizaje, cantidad de neuronas y número de simulaciones. Posiblemente por la falta de convergencia del modelo o “over-fitting” de los datos[14]. La Tabla 5 contiene la sensibilidad del resultado.
Tabla 5. Medidas de riesgo de las diferentes estrategias de redes neuronales

Fuente: Elaborado por los autores.
El segundo punto negativo de las redes neuronales fue la falta de sensibilidad sobre cómo las variables de entrada afectan el resultado. En el caso de una regresión, la sensibilidad de cómo las variables explicativas afectan el resultado puede ser observada por los coeficientes de la regresión, y, en el caso de la estrategia de momentum, la sensibilidad puede ser visualizada por la simple media de los últimos retornos.
De cualquier manera, todos los modelos pueden incurrir en errores causados por la falta de liquidez del activo, sorpresas en la divulgación de indicadores, por ejemplo, e incluso por el uso más intenso de algoritmos que operan en el mercado financiero, ya que el “algo trading” (“robots”) puede aumentar el nivel de ruido en los precios: si un activo sube indebidamente por la baja liquidez, por ejemplo, el ordenador puede notar la subida del precio y enviar una orden de compra, lo que puede desplazar aún más el precio del activo.
Sin embargo, quizás el principal factor de distorsión de los precios sea el sesgo conductual de los inversores, que tiende a presentar oscilaciones entre los extremos de codicia y miedo[15], lo que favoreció la estrategia de momentum. La estrategia de inversión de red neuronal con solo una capa intermedia y una capa de salida, a su vez, presentó un resultado bastante interesante y superó la rentabilidad absoluta de las demás estrategias. No obstante, al considerar otras métricas de desempeño, como retorno ajustado al riesgo y volatilidad, la estrategia momentum con 21 períodos fue la asignación ganadora en el período observado de 20 años. Esta simple estrategia también poseyó dos ventajas en relación con la red neuronal:
I. simplicidad del modelo de decisión, ya que la elección fue del activo con rentabilidad superior a la del CDI en el promedio de los últimos 21 meses, ante la caja negra de los resultados de “machine learning”, que, al no poder ser reconstituidos, demandan confianza en el “output” del modelo;
II. facilidad en la interpretación y previsibilidad del criterio de decisión (un activo que esté subiendo debe mantener su tendencia), frente a la falta de sensibilidad de cómo cada variable influye en la decisión del modelo de redes neuronales.
Es importante añadir que los resultados de las redes neuronales presentaron cierta inestabilidad en las simulaciones dependiendo de los parámetros utilizados, lo que genera inseguridad con respecto a la estabilidad del modelo.
Finalmente, como este campo del conocimiento es reciente, es importante observar atentamente las mejoras en los modelos de redes neuronales. Al mismo tiempo, también es necesaria humildad para reconocer que puede haber limitaciones de los modelos de “machine learning”, en particular en el mercado financiero, dado que el comportamiento de los inversores a veces puede parecer más errático que racional, alternando entre momentos de euforia y de pánico.
Referencias
[1] Turing A. Computing Machinery and Intelligence. MIND A Quartely review of Psycholology and Philosophy. 1950; 59(236): 433-460. Disponível em: https://psycnet.apa.org/doi/10.1093/mind/LIX.236.433. Acesso em: 29 set. 2023.
[2] Harari Y. ‘Sapiens’ author says AI is an alien threat that could wipe us out: ‘Instead of coming from outer space, it’s coming from California. Fortune. 2023. Disponível em: https://fortune.com/2023/09/12/sapiens-author-yuval-noah-harari-ai-alien-threat-wipe-out-humanity-elon-musk-steve-wozniak-risk-cogx-festival/. Acesso em: 29 set. 2023.
[3] Santos J.A.A. Previsão do preço do café arábica: uma aplicação de redes neurais CNN-BLSTM. Research, Society and Development. 2022; 11(3): 1-11. DOI: https://doi.org/10.33448/rsd-v11i3.26101.
[4] Zuckerman G. O Homem que decifrou o Mercado. Rio de Janeiro (RJ): Alta Books; 2020.
[5] Chollet, F. Deep Learning with Python. Shelter Island (NY): Manning; 2018. 384 p.
[6] Verma A. Shallow Neural Net from Scratch Using R. RPubs. 2020. Disponível em: https://rpubs.com/theairbend3r/bin-classification-small-nnet-scratch-r. Acesso em: 29 set. 2023.
[7] Murray M.; Abrol V.; Tanner J. Activation Function Design For Deep Networks: Linearity And Effective Initialisation. Applied and Computational Harmonic Analysis. 2021; 59: 117-154. Disponível em: https://arxiv.org/pdf/2105.07741.pdf. Acesso em: 29 set. 2023.
[8] Ovalle D. The purpose of activation functions in the neural network. Medium. 2020. Disponível em: https://medium.com/@1087/the-purpose-of-activation-functions-in-the-neural-network-be08f81b7c32. Acesso em: 29 set. 2023.
[9] Yathish V. Loss Functions and Their Use In Neural Networks. Medium. 2022. Disponível em: https://towardsdatascience.com/loss-functions-and-their-use-in-neural-networks-a470e703f1e9. Acesso em: 29 set. 2023.
[10] Patel J. Derivation of Backpropagation in Neural Network. Youtube. 2021. Disponível em: https://www.youtube.com/watch?v=URJ9pP1aURo&t=190s. Acesso em: 29 set. 2023.
[11] Blitz D.; Hanauer M.; Vidojevic M. The idiosyncratic momentum anomaly. International Review of Economics & Finance. 2020; 69: 932-957. Disponível em: https://www.sciencedirect.com/science/article/abs/pii/S1059056020300927. Acesso em: 29 set. 2023.
[12] Fama, E.F.; French, K.R. Dissecting Anomalies. The Journal of Finance, 2008. Disponível em: https://doi.org/10.1111/j.1540-6261.2008.01371. Acesso em 29 set. 2023.
[13] Antonacci G. Dual Momentum Investing. Nova York (NY): Mc Graw Hill Education; 2015. 256 p.
[14] Dixon M.; Klabjan D.; Bang J.H. Classification-based financial markets prediction using deep neural networks. Journal Algorithmic Finance. 2017; 6(3-4): 67-77. Disponível em: https://content.iospress.com/articles/algorithmic-finance/af176. Acesso em: 29 set. 2023.
[15] Kindleberger C.P.; Aliber, R.Z. Manias, Panics, and Crashes: A History of Financial Crises. Palgrave MacMillan 7th Edition. 2015.
Como citar
Sasaki H.H.; Fortunato M.H.T. Uma comparação entre estratégias de investimento utilizando redes neurais, métodos estatísticos e momentum. Revista E&S. 2024; 5: e2023116.
Sobre os autores
Helcio Haruo Sasaki, Banco Santander, Avenida Juscelino Kubitschek, 2235 – Vila Olímpia – CEP 04543-011 – São Paulo/SP, Brasil.
Murilo Henrique Tank Fortunato , Instituto de Pesquisa e Educação Continuada em Economia e Gestão de Empresas – Pecege – Rua Cezira Giovanoni Moretti, 580 – Santa Rosa – CEP 13414-157 – Piracicaba/SP, Brasil.
Enlace de descarga: PDF