
Inteligencia Artificial
Modelado
Phyton
Series Temporales
09 de agosto de 2024
Mejores prácticas y errores comunes en el modelado de series temporales
DOI: 10.22167/2675-6528-20240028
E&S 2024, 5: e20240028
José Erasmo Silva
Una serie temporal es un conjunto de datos ordenados cronológicamente. Algunos ejemplos son niveles diarios de polución en São Paulo, temperaturas mensuales en Cananeia, índices diarios de Bolsas de Valores, lluvia anual en Fortaleza, media anual de manchas solares, mareas en el puerto de Santos, entre otros[1].
La previsión de series temporales es un campo en crecimiento e importante en áreas que van desde la economía hasta la ingeniería. Sin embargo, la aplicación de técnicas predictivas a menudo enfrenta desafíos derivados de metodologías inadecuadas, que pueden conducir a resultados engañosos. Este artículo revisó críticas comunes en la literatura científica, como las discutidas por Hewamalage et al.[2] y Zemkoho[3], quienes destacaron los errores frecuentes en la evaluación de modelos de series temporales y las implicaciones prácticas de tales errores en los campos de la investigación y la gestión.
Un error común en la implementación de la predicción de series temporales es la selección inadecuada de métricas de evaluación, lo que no solo distorsiona la visión de la eficacia del modelo, sino que también conduce a decisiones subóptimas. Por ejemplo, Hewamalage et al.[2] critican el uso excesivo del error cuadrático medio (MSE) y del error medio absoluto (MAE) sin tener en cuenta características específicas de los datos, como la estacionalidad y la no estacionariedad. La Figura 1 ilustra esto, mostrando que las predicciones basadas en la media de los datos de entrenamiento pueden ser inadecuadas. Se observa que la predicción (línea discontinua) es una línea horizontal constante que refleja la media de los datos de entrenamiento. Este enfoque ignora por completo las tendencias y la estacionalidad presentes en los datos. Usar métricas como MSE y MAE sin considerar estas características puede llevar a evaluaciones engañosas. Aunque estos indicadores pueden ser adecuados en algunos casos, no logran captar la dinámica compleja de las series temporales, tales como tendencias y estacionalidad. Métricas de evaluación mal elegidas pueden resultar en predicciones que parecen satisfactorias en términos de error medio, pero que en realidad no logran reflejar la realidad subyacente de los datos temporales.
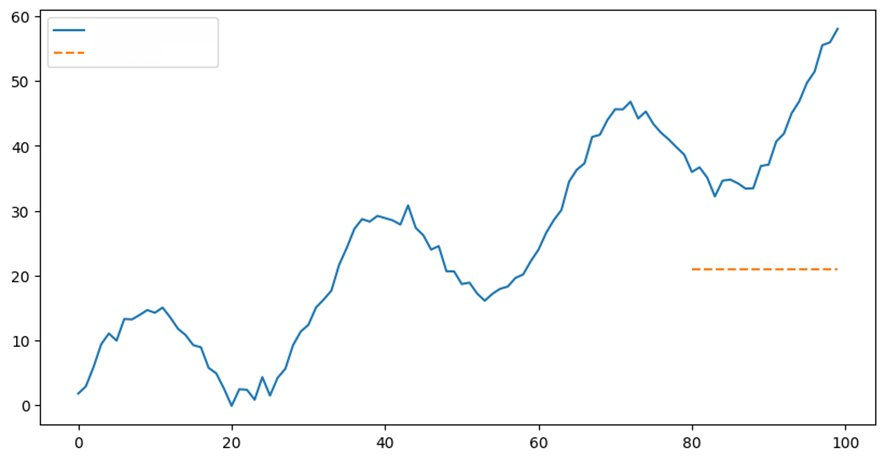
Fuente: Resultados originales de la investigación.
Nota: MSE: 490,0026905230682, MAE: 20,511124321687145.
Otro error común destacado en la literatura involucra el tratamiento inadecuado de la dependencia del tiempo en modelos predictivos. Muchos analistas no consideran que las observaciones en una serie temporal están correlacionadas, lo que contradice los supuestos básicos de muchos métodos estadísticos tradicionales. Como explicó Zemkoho[3], ignorar la autocorrelación entre períodos consecutivos puede llevar a la subestimación de la incertidumbre y a predicciones que no reflejan la verdadera dinámica de los datos. Esta supervisión es particularmente importante en modelos como el autorregresivo integrado de medias móviles (ARIMA) y la suavización exponencial, en los cuales la suposición de independencia puede invalidar las predicciones y comprometer la integridad de las conclusiones obtenidas. La Figura 2 muestra que las predicciones generadas por el modelo de suavización exponencial (línea discontinua) no logran capturar las tendencias y la estacionalidad presentes en los datos originales. La predicción intenta capturar una media móvil de los datos, pero no sigue la verdadera dinámica de la serie temporal. Esto resulta en predicciones que no reflejan totalmente las fluctuaciones y la dinámica de los datos reales.
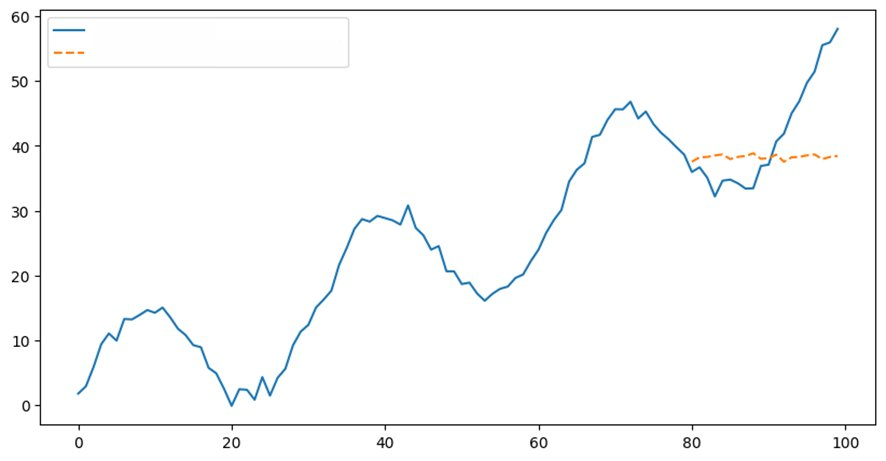
Fuente: Resultados originales de la investigación.
Basándonos en la discusión sobre la importancia de considerar la dependencia del tiempo al modelar series temporales, es igualmente importante abordar otro concepto fundamental en el análisis de series temporales: la estacionariedad. Como enfatizó Zemkoho[3], la suposición de que una serie temporal es estacionaria —es decir, que sus propiedades estadísticas, como la media y la varianza, no cambian a lo largo del tiempo— es crucial para la aplicación de muchos modelos estadísticos. Sin embargo, muchas series reales presentan tendencias o estacionalidad, lo que viola esta suposición. La falla en probar y ajustar la no estacionariedad puede resultar en un modelo que parece adecuado, pero que en realidad no logra captar la dinámica subyacente de los datos, resultando en predicciones imprecisas y potencialmente costosas.
Una vez identificada la no estacionariedad mediante las pruebas apropiadas, técnicas como las transformaciones diferenciales y logarítmicas se utilizan frecuentemente para estabilizar la varianza y hacer que la media sea constante a lo largo del tiempo, es decir, estas técnicas se utilizan para preparar datos para modelos que asumen estacionariedad, como los modelos ARIMA. Sin embargo, la elección del grado de diferenciación o tipo de transformación debe ajustarse cuidadosamente para evitar la sobrediferenciación, que puede introducir ruido y causar la pérdida de información importante de la señal original. Por lo tanto, se recomienda determinar el número apropiado de diferencias para garantizar la adecuación del modelo sin comprometer la integridad de los datos mediante la validación cruzada y el uso de criterios de información, como el criterio de información de Akaike (AIC).
La implementación de técnicas de transformación diferencial y logarítmica es crucial para manejar la no estacionariedad de las series temporales y puede lograrse utilizando bibliotecas como pandas y statsmodels que se ejecutan en Python. Por ejemplo, la función adfuller() en el módulo statsmodels.tsa.stattools permite ejecutar pruebas de Dickey-Fuller aumentadas (ADF) directamente en sus datos mientras utiliza las bibliotecas numpy o pandas para simplificar transformaciones como las logarítmicas a través de operaciones vectoriales. En resumen, estas herramientas no solo facilitan el trabajo, sino que también ayudan a mejorar la calidad del análisis de series temporales.
Interpretar los resultados de las pruebas de estacionariedad y aplicar las transformaciones correctas son desafíos que exigen un profundo conocimiento del trasfondo técnico y de los datos. Incluso al utilizar herramientas avanzadas, como el lenguaje Python, es preciso estar atento a posibles trampas, como la interpretación incorrecta de p-valores o la aplicación innecesaria de diferenciación, que pueden comprometer la calidad de las predicciones. Para mitigar estos riesgos, se recomienda un enfoque de modelado iterativo, en el que cada paso se valida utilizando la visualización de datos y el ajuste fino de métricas de rendimiento, como por ejemplo el AIC. Esto garantiza que los cambios realmente mejoren el poder predictivo del modelo sin introducir sesgos o ajustes excesivos.
El gráfico de la Figura 3 muestra los datos originales de una serie temporal (línea azul) con tendencias y estacionalidad, comparados con los datos diferenciados (línea naranja) y transformados logarítmicamente (línea verde). Los resultados de la prueba ADF en los datos originales indicaron que la serie no era estacionaria (estadística ADF de 0,292 y p-valor de 0,977). Después de la diferenciación, la serie se volvió estacionaria (estadística ADF de -6,094 y p-valor de 1,02e-07). Transformar la serie para que sea estacionaria es un paso necesario para muchas técnicas de modelado de series temporales. Sin embargo, estas transformaciones deben realizarse cuidadosamente para garantizar que los datos estén adecuadamente preparados para el modelado posterior.
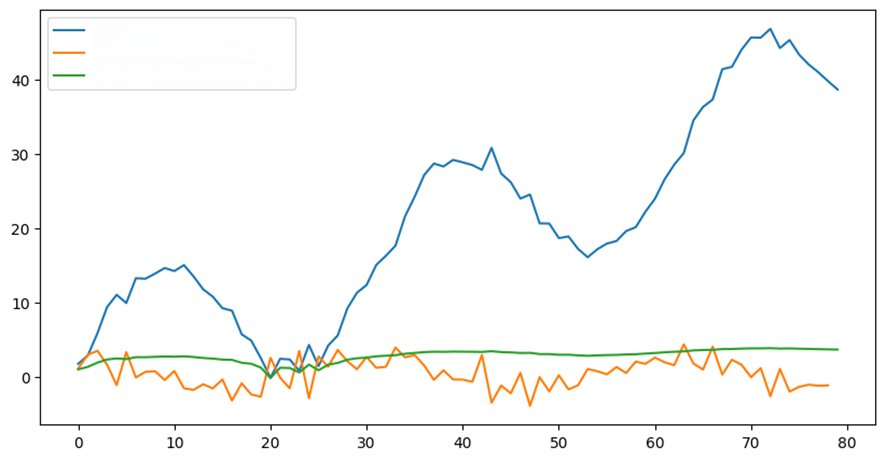
Fuente: Resultados originales de la investigación.
Nota: Estadística ADF: 0,29240217494006726; p-valor: 0,976993204902754; estadística ADF tras la diferenciación: -6,093854884454573; p-valor tras la diferenciación: 1,0211713068650123e-07.
Hewamalage et al.[2] enfatizan que, si bien estas pruebas son útiles, también es importante comprender sus limitaciones e interpretar correctamente sus resultados. Por ejemplo, advierten contra la dependencia excesiva de los resultados de pruebas automatizadas de estacionariedad, que pueden no captar matices importantes en la estructura temporal de los datos. En otras palabras, si bien estas pruebas pueden proporcionar una indicación útil de estacionariedad, no sustituyen una comprensión profunda y un análisis cuidadoso de los datos.
Vale la pena señalar que la implementación eficaz de modelos de series temporales en escenarios del mundo real requiere más que un ajuste preciso; también requiere una comprensión clara del contexto en el que se aplican las predicciones. En sectores como el financiero, el minorista y el energético, los modelos robustos pueden marcar la diferencia entre ganancias y pérdidas significativas. Por lo tanto, además de la precisión, los modelos también deben ser adaptables y sensibles a los cambios económicos, estacionales y regulatorios. Se recomienda la colaboración continua entre analistas de datos y expertos en el dominio para garantizar que las predicciones no solo sean precisas, sino también relevantes y aplicables a las decisiones estratégicas que enfrentan.
El desarrollo de técnicas de modelado de series temporales ha llevado a avances significativos, especialmente a la integración de métodos de aprendizaje automático. Los enfoques híbridos que combinan técnicas estadísticas tradicionales con métodos de aprendizaje automático han demostrado ser particularmente efectivos. Por ejemplo, los modelos ARIMA se pueden usar para capturar patrones lineales en los datos, mientras que las redes neuronales se utilizan para modelar componentes no lineales. Esta combinación puede mejorar significativamente los resultados de pronóstico en comparación con el uso de un solo método[4].
Recientemente, la eficacia de los modelos híbridos se demostró en la competencia M4 de pronóstico de series temporales, organizada por Spyros Makridakis y el International Institute of Forecasters (IIF). La competencia M4, parte de una serie de competencias iniciadas en 1982 por Makridakis, involucró el pronóstico de 100.000 series temporales utilizando 61 métodos diferentes, destacando la importancia de este enfoque [5],[6]. Actualmente, la M4 ha sido sucedida por la M5, continuando la tradición de evaluar y mejorar métodos de pronóstico. Sin embargo, es importante destacar que la precisión de estas predicciones depende de la elección adecuada de las métricas de evaluación y de la implementación correcta de las técnicas de validación, como la validación cruzada, por ejemplo[7].
Además, la combinación de diferentes arquitecturas de redes — como redes neuronales recurrentes (RNN), long short-term memory (LSTM) y redes neuronales convolucionales (CNN) — ha mostrado un rendimiento interesante en varias aplicaciones al capturar patrones complejos y no lineales presentes en los datos[2].
El avance continuo de las tecnologías emergentes, como el aprendizaje automático y la inteligencia artificial, promete no solo aumentar la precisión de las predicciones, sino también automatizar y optimizar los procesos de análisis de datos a escala. En el futuro, se espera que los modelos predictivos se integren aún más con los sistemas de toma de decisiones en tiempo real, proporcionando información instantánea y democratizando el acceso al análisis de datos.
Referencias
[1] Morettin P.A.; Toloi C.M.C. Análise de séries temporais: Modelos lineares univariados. 3ed. São Paulo: Blucher; 2018.
[2] Hewamalage H.; Ackermann K.; Bergmeir C. Forecast evaluation for data scientists: common pitfalls and best practices. Data Mining and Knowledge Discovery. 2023; 37(2): 788-832. https://doi.org/10.1007/s10618-022-00894-5.
[3] Zemkoho A. A basic time series forecasting course with Python. Operations Research Forum. 2023; 4(2): 1-43. https://doi.org/10.1007/s43069-022-00179-z.
[4] Zhang G.P. Time series forecasting using a hybrid ARIMA and neural network model. Neurocomputing. 2003; 50: 159-175. https://doi.org/https://doi.org/10.1016/S0925-2312(01)00702-0.
[5] Smyl S. A hybrid method of exponential smoothing and recurrent neural networks for time series forecasting. International Journal of Forecasting. 2020; 36(1): 75-85. https://doi.org/10.1016/j.ijforecast.2019.03.017.
[6] Makridakis S.; Spiliotis E.; Assimakopoulos V. The M4 Competition: 100,000 time series and 61 forecasting methods. International Journal of Forecasting. 2020; 36(1): 54-74. https://doi.org/10.1016/j.ijforecast.2019.04.014.
[7] Bergmeir C.; Benítez J.M. On the use of cross-validation for time series predictor evaluation. Information Sciences. 2012; 191: 192-213. https://doi.org/10.1016/j.ins.2011.12.028.
Cómo citar:
Silva J.E. Mejores prácticas y errores comunes en el modelado de series temporales. Revista E&S. 2024; 5: e20240028.
Sobre el autor
José Erasmo Silva  – Profesor Orientador MBA Data Science e Analytics – Universidade Federal da Bahia – Programa de Pós-graduação em Contabilidade – PPGCONT– Avenida Reitor Miguel Calmon, s/n Canela – CEP: 40231-300 – Salvador/BA, Brasil