
Analista
Científico
Conjunto De Datos
Ingeniero
Habilidades
Mercado Laboral
Profesionales
Vacantes
22 de enero de 2025
Las habilidades en análisis de datos más demandadas en el mercado laboral
DOI: 10.22167/2675-6528-20240033
E&S 2025, 6: e20240033
Déborah Lima Scalioni e Renato Máximo Sátiro
Debido a la transformación digital, impulsada por la llegada de la pandemia, las empresas generan enormes cantidades de datos todos los días. En este contexto, ha aumentado la competitividad entre las empresas en la búsqueda de profesionales de análisis de datos que posean las habilidades necesarias en el área. Los empleos de ingeniero de datos y científico de datos se encuentran entre las ocupaciones más buscadas en 2020, con tasas de crecimiento anual del 78% y 75%, respectivamente[1]. Estos profesionales son responsables de construir toda la infraestructura de datos e implementar métodos para capturar, procesar y realizar análisis preventivos y predictivos dentro de la organización. La manipulación correcta de grandes volúmenes de datos puede generar poderosos insights para la empresa, guiándola hacia las mejores tomas de decisiones[1].
Sin embargo, este crecimiento sustancial del área, asociado a su multidisciplinariedad, generó una confusión en relación a cuáles son las habilidades esperadas de estos profesionales, y en relación a definiciones básicas de herramientas, métodos y funciones. Tales equívocos acaban por generar altos costos para empleadores y profesionales, que necesitan lidiar con la falta de claridad en las descripciones de los cargos en los procesos selectivos[2].
En este sentido, se observa que los empleadores buscan profesionales que combinen habilidades prácticas y cognitivas en análisis de datos, computación y negocios, con competencias sociales y características de personalidad específicas. La demanda de estas habilidades varía según el nivel del puesto y las responsabilidades involucradas. Sin embargo, muchos ejecutivos reconocen que los candidatos rara vez poseen todas las competencias deseadas, lo que los obliga a invertir en capacitación adicional para preparar adecuadamente a estos profesionales para las funciones[3]. Es decir, se observa que la búsqueda de las organizaciones por profesionales con habilidades técnicas y conductuales se debe a que son fundamentales en el proceso de transformación digital, ya que proporcionan información que fundamenta la toma de decisiones rápida y asertiva que garantizan que las empresas se mantengan competitivas en el mercado.
Al abordar esta temática, Dubey y Gunasekaran[4] enumeraron algunos ejemplos de cuáles son estas competencias. Las llamadas hard skills son las habilidades técnicas que pueden ser aprendidas, como estadística, previsión, optimización, finanzas, contabilidad financiera, marketing; mientras que las soft skills son habilidades que están más ligadas a la personalidad, como liderazgo, trabajo en equipo, escucha, aprendizaje, actitud positiva, comunicación, relación interpersonal, paciencia y pasión.
En las áreas de análisis y ciencia de datos existe una pluralidad de posibilidades de actuación y de cargos para estos profesionales, tales como: Analista de Datos, Ingeniero de Datos, Cientista de Datos, Arquitecto de Datos, Ingeniero de Big Data, Especialista en Machine Learning, etc. Hay diversos caminos posibles y diversas habilidades, que pueden coincidir o no. Para el contexto de este trabajo fue necesario acotar este amplio universo y, para ello, se utilizaron como referencia frameworks que listaron y categorizaron los conocimientos en datos utilizados para elaborar la lista a partir de la cual se desarrollaron análisis aquí[1],[5].
Otro punto también considerado fue que la era digital y el distanciamiento social, provocados por la COVID-19, expandieron el uso de herramientas en línea en los procesos de reclutamiento y selección, ya que esta modalidad se convirtió en el principal medio de atracción de candidatos para la mayoría de las empresas. Entre los principales impulsores de esta adopción se encuentran: la facilidad para los candidatos, la velocidad del proceso, la escalabilidad y el alcance. Además, poder reaccionar más rápidamente a los competidores, atrayendo candidatos por delante de la competencia, puede ser otro diferencial competitivo para las organizaciones[6].
Debido a la relevancia de las herramientas digitales en el mercado laboral, este trabajo tuvo como objetivo analizar el proceso descrito y proporcionar información concreta a profesionales y empresas sobre las habilidades más relevantes para las vacantes del mercado laboral de datos, con mayor enfoque en los cargos de analista de datos (data analyst), ingeniero de datos (data engineer) y científico de datos (data scientist), que actualmente son las posiciones más buscadas por las empresas brasileñas. Debido a su amplio uso y posición de referencia como red profesional, se optó por utilizar LinkedIn como fuente de datos para el desarrollo de este análisis.
La metodología utilizada se dividió en cuatro etapas. En el primer momento se realizó la extracción de datos mediante el proceso de web scraping. A continuación, se realizó un análisis descriptivo de los datos recopilados; en esta etapa se seleccionaron y categorizaron las principales habilidades buscadas en el área, con el fin de verificar las características de las vacantes publicadas. En el tercer momento, se midió la asociación entre las habilidades en cuestión. Finalmente, se utilizaron técnicas de text mining para comprender el contexto y extraer información significativa de los campos textuales, determinando las palabras y frases más utilizadas.
| Procedimiento | Descripción |
| Extracción de datos web | Extracción automatizada de datos de sitios web para recopilar información sobre las vacantes publicadas, incluyendo campos textuales y otra información. |
| Análisis descriptivo | Selección y categorización de las principales habilidades buscadas en las vacantes, verificando características relevantes y patrones en los datos recopilados. |
| Medida de asociación | Evaluación de las relaciones entre las habilidades identificadas, con el fin de entender cómo están conectadas o frecuentemente asociadas. |
| Minería de texto | Análisis de los campos textuales para identificar las palabras y frases más utilizadas, entendiendo el contexto y extrayendo información significativa. |
Extracción de datos web
El web scraping es una técnica utilizada para extraer datos de internet y almacenarlos para su posterior uso o análisis[7]. Ha sido ampliamente utilizada para la recopilación de grandes volúmenes de datos, especialmente debido a la gran cantidad de datos generados en línea diariamente. En este trabajo se optó por utilizarla debido a que es una técnica de fácil personalización y automatización y, para implementarla, se utilizó la biblioteca Selenium y el lenguaje Python.
La investigación realizada en la sección de vacantes de la plataforma LinkedIn se llevó a cabo en seis búsquedas distintas, utilizando las palabras clave “analista de datos”, “data analyst”, “ingeniero de datos”, “data engineer”, “cientista de datos” y “data scientist”, y definiendo el filtro de ubicación como Brasil. El propósito de usar estos criterios fue abarcar el máximo de vacantes posibles del área de datos, incluso aquellas publicadas en otro idioma, bastante comunes en algunas empresas multinacionales.
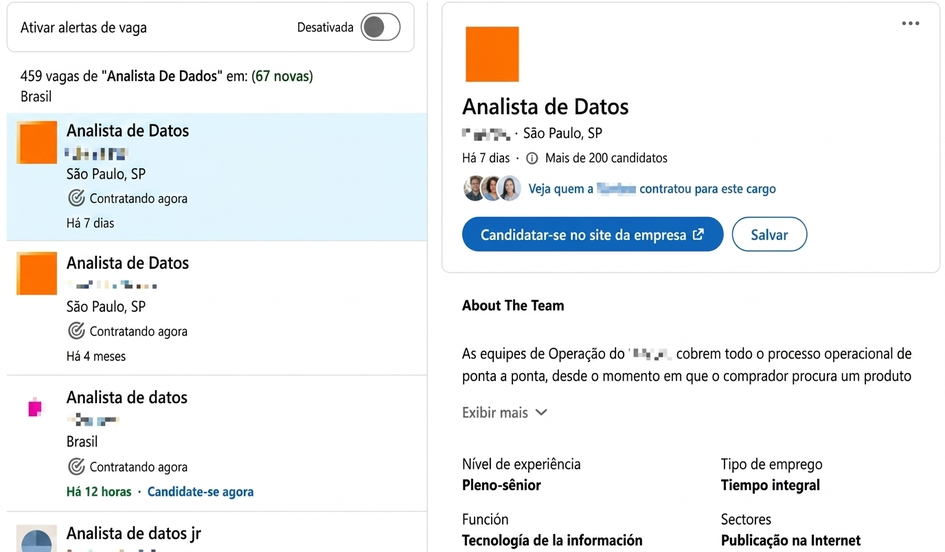
La página de anuncios de vacantes de la plataforma muestra más resultados a medida que el usuario se desplaza hacia abajo en el navegador, sin embargo, después de seis repeticiones de este proceso, la carga deja de ser automática y, para acceder a más resultados, el usuario necesita hacer clic en el botón ‘ver más vacantes’. Basándose en esta dinámica y con el fin de optimizar el proceso de recolección de datos, se creó un loop que simulaba la interacción del usuario con la plataforma, considerando el total de vacantes y la cantidad de nuevas vacantes mostradas por clic. Tras la recolección de todas las vacantes disponibles, se generó un segundo loop utilizando la tag de la lista lateral (‘li’) para capturar la información más relevante de cada vacante — como título, enlace, empresa, ubicación y fecha. Para la demás información, como descripción de la vacante, nivel de experiencia, tipo de empleo, función y sector, fue necesario hacer clic en el título de cada vacante para obtener el detalle en una pestaña a la derecha de la pantalla (Figura 1).
Fuente: LinkedIn
Después de la recolección, los datos fueron estructurados en dataframes, combinados en un conjunto único y sometidos al proceso de limpieza y remoción de duplicados. Al final de este proceso, se obtuvo un conjunto de datos compuesto por 2498 publicaciones únicas.
Análisis de datos
El análisis descriptivo es una técnica utilizada para sintetizar y agrupar datos o realizar comparaciones entre grupos de datos[8]. Dada la naturaleza cualitativa de los datos recopilados en LinkedIn, se utilizó esta técnica por ser la más adecuada para la comprensión de las características en las distribuciones, permitiendo la identificación de agrupaciones numéricas como porcentajes, índices y promedios.
El análisis de los datos abarcó la exploración de diversas variables, tales como ubicación, tipo, nivel de antigüedad, sector, empresa y el tipo de contrato. Además, como el objetivo también era identificar las particularidades de cada función dentro del área de datos, se creó una clasificación denominada “posición”. Con el fin de identificar las particularidades de cada una, así como del área como un todo, se realizaron diversos análisis comparativos entre las posiciones, tanto por separado como en conjunto.
Como herramientas descriptivas para la representación de los datos se utilizaron gráficos y tablas que presentan la información de forma clara y fácilmente interpretable.
Asociación entre las habilidades
Inicialmente, fue necesario delimitar el alcance de la investigación. Para ello, y basándose en las referencias consultadas, se seleccionaron las principales competencias técnicas y conductuales requeridas para profesionales del área de datos. Con el fin de facilitar el análisis, estas habilidades fueron agrupadas y categorizadas de la siguiente manera:
- Base de Datos: ETL, ELT, SQL, SQL Server, Oracle, Postgres, MySQL, NoSQL, Cassandra, MongoDB, Data Warehouse.
- Panel e Informes: Power BI, Tableau, Qlik, Business Objects, Excel, D3, Matplotlib, plotly.
- Big Data: Hadoop, Spark, Hive, Pig, HBase.
- Programación: Python, Scala, C/C++, C#, Java, .NET, HTML, PHP, Javascript.
- Estadística: R, SAS, SPSS, Stata, MATLAB, Regresión, Probabilidad.
- Nube: Nube, AWS, Azure, GCP.
- Conductuales: Liderazgo, comunicación, relación, presentación, organización.
Para medir la asociación entre las habilidades seleccionadas, se utilizó un algoritmo para identificar la presencia de cada término en el campo de descripción de las vacantes publicadas. En algunos casos, se consideraron diferentes versiones de cada término (por ejemplo: Power BI, PowerBI y PBI; Data Warehouse y DW), y también las traducciones para vacantes publicadas en inglés (por ejemplo: comunicación y communication). El dataframe devuelto por el algoritmo estuvo compuesto por columnas binarias y se analizó utilizando el “Phi Coefficient” — también conocido como “Matthews Correlation Coefficient” (MCC) —, una técnica ampliamente utilizada en diferentes áreas para la medición de la asociación entre variables binarias[9].
Minería de texto
La minería de texto, o text mining, es el proceso de extraer información relevante de fuentes de datos no estructuradas, como textos, para identificar palabras clave y patrones. Esta técnica transforma textos en variables numéricas, permitiendo su análisis con métodos estadísticos. En el presente caso, se utilizó el análisis de n-grams, que detecta secuencias de palabras recurrentes en un texto, para explorar de forma más detallada los campos textuales “título” y “descripción”[9].
A partir de la categorización de competencias y la aplicación de las técnicas mencionadas, se presentaron las principales características de las vacantes en el mercado laboral de datos, con un enfoque principal en verificar cuáles eran las habilidades más solicitadas y si existían diferencias entre las competencias buscadas en los diferentes cargos de analistas, ingenieros y científicos de datos. Además, a través de técnicas de análisis de texto, el análisis permitió identificar las relaciones entre las diferentes habilidades y las combinaciones más frecuentes de palabras. Los resultados obtenidos podrán ayudar a estudiantes y profesionales tanto para orientar sus decisiones educativas como para proporcionar una base para una búsqueda más asertiva de vacantes de trabajo.
Análisis descriptivo
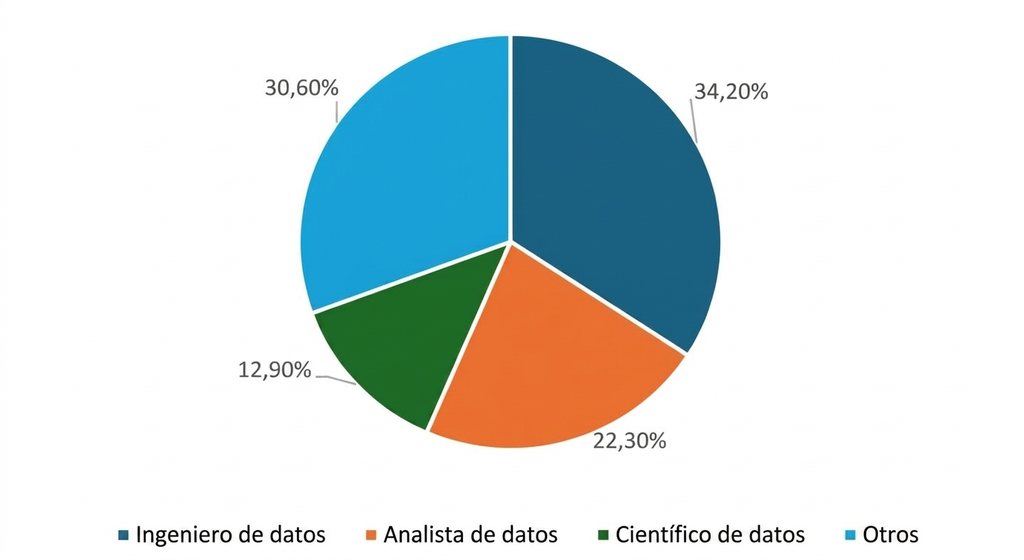
A través del análisis descriptivo de los datos se buscó comprender y sintetizar sus principales características. El análisis de los títulos de las oportunidades presentó una gran pluralidad de términos. Para la creación del campo posición, fueron necesarios algunos tratamientos de estos datos, tales como: eliminación de caracteres especiales, conversión a mayúsculas y al portugués, además de estandarización de los términos de nivel de senioridad. De esta forma, se verificó que el 34,2% de las oportunidades se dirigían a ingenieros de datos, el 22,3% a analistas de datos y el 12,9% a científicos de datos. Las demás oportunidades se clasificaron en la categoría “otro”, que abarcó ingenieros de software, ingenieros de machine learning y analistas de negocios (Figura 2).
Fuente: Resultados originales de la investigación
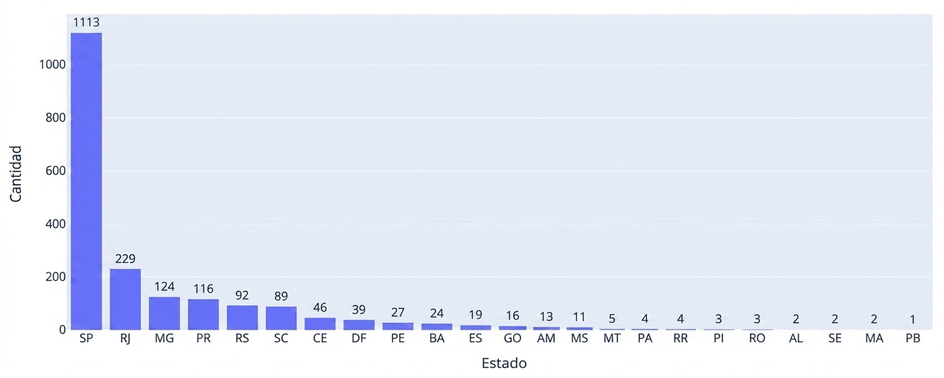
Dado que es una información que podría elaborarse en diferentes niveles (ciudad, estado o incluso país), también fue necesario un tratamiento de la columna de ubicación, separándola en los niveles de ciudad y estado. Se observó que la mayor disponibilidad de vacantes de datos se encontraba en el estado de São Paulo, con el 50,7% (Figura 3). Sin embargo, 209 vacantes estaban clasificadas a nivel de país y por eso no aparecieron en el gráfico de distribución estatal, factor que se debe a que muchas vacantes del área son remotas.
Fuente: Resultados originales de la investigación
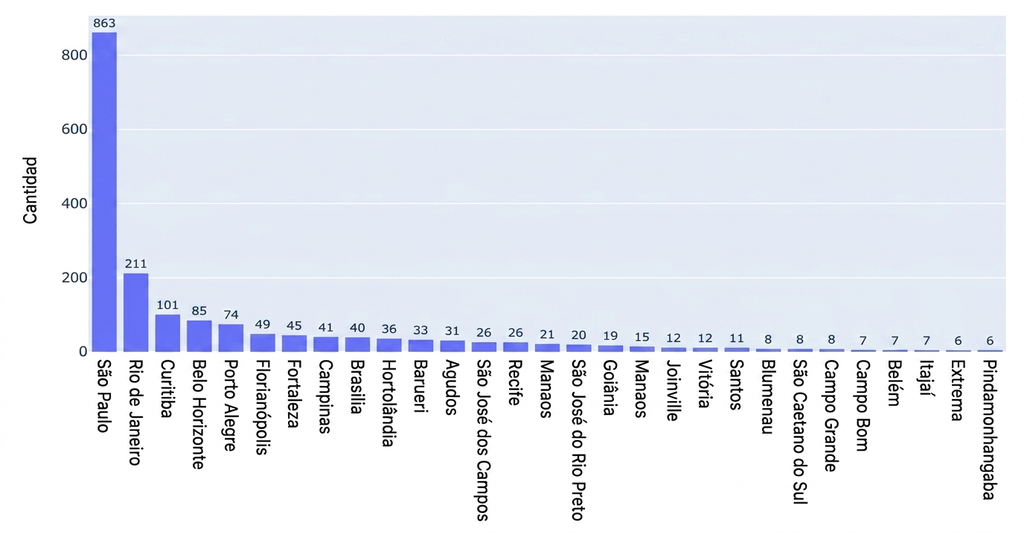
En el gráfico de distribución de vacantes por municipios, se desconsideraron 447 vacantes que no fueron clasificadas a nivel de ciudad. Se observó que São Paulo lideraba entre las 20 ciudades con más oportunidades en el área de datos (Figura 4).
Fuente: Resultados originales de la investigación
Al analizar el nivel de antigüedad de las vacantes, se observó que la información referente al cargo a menudo no se completa o se completa incorrectamente en las vacantes de la plataforma. Esto se puede observar, por ejemplo, en vacantes clasificadas como de nivel Asistente, pero con un título o descripción que especifica un cargo de nivel intermedio o senior. Para minimizar este problema, se generó el campo “position level” para verificar si el nivel de antigüedad estaba especificado en el título o descripción de la vacante y, cuando no, si se hacía uso del campo proporcionado por la propia herramienta. Incluso con el tratamiento empleado, una cantidad considerable de vacantes aún permaneció con el nivel de antigüedad nulo o señalado incorrectamente.
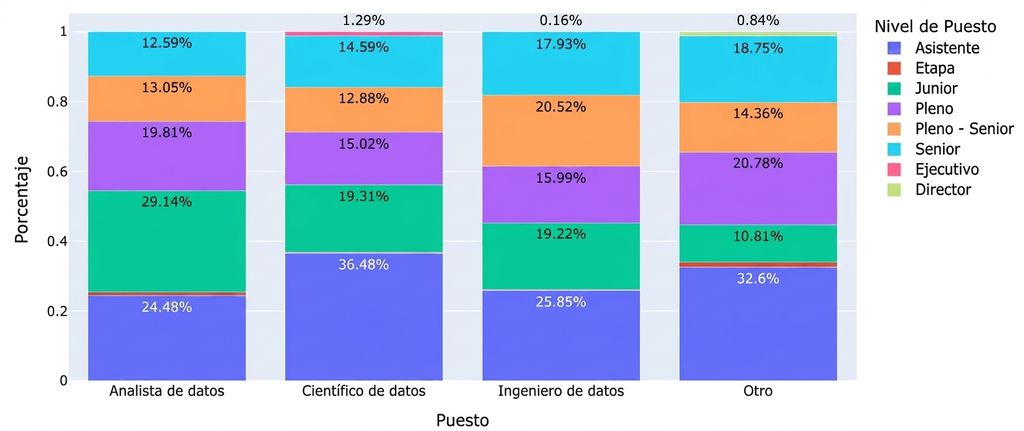
Desconsiderando los datos nulos, se analizó la distribución de los niveles de senioridad para las vacantes disponibles (Figura 5). Se observó que el nivel junior es más significativamente representativo para la función de análisis de datos (29,14%) que para las demás. En contrapartida, los niveles pleno-senior y senior se concentraron en las vacantes destinadas a ingenieros de datos (38,45%), mientras que las vacantes para analistas y científicos de datos quedaron en una posición intermedia (entre 15% y 17%) para los niveles senior. Una de las hipótesis planteadas es que el análisis de datos es una puerta de entrada al área, mientras que la ingeniería de datos es una función que exige más conocimiento técnico, llevando a las empresas a buscar profesionales más seniors. Es importante destacar que la categoría “otro” presentó un número significativo de vacantes en niveles elevados por asignar cargos con una senioridad alta, como tech lead o ingenieros de machine learning.
Fuente: Resultados originales de la encuesta
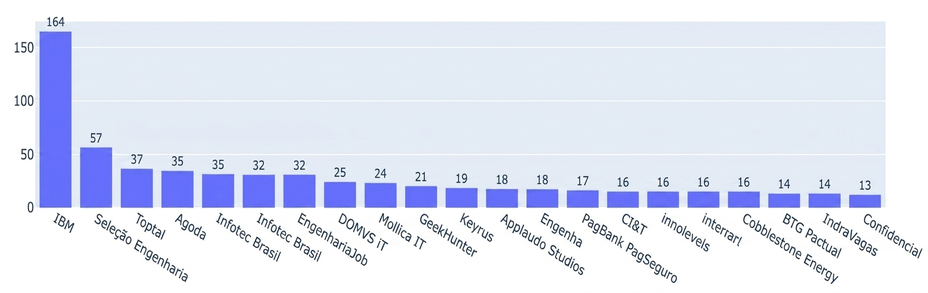
En el análisis de la distribución de puestos de trabajo por empresas del mercado de datos, IBM destacó con el mayor número de ofertas de empleo, con más del doble de vacantes publicadas por la segunda clasificada (Figura 6).
Fuente: Resultados originales de la investigación
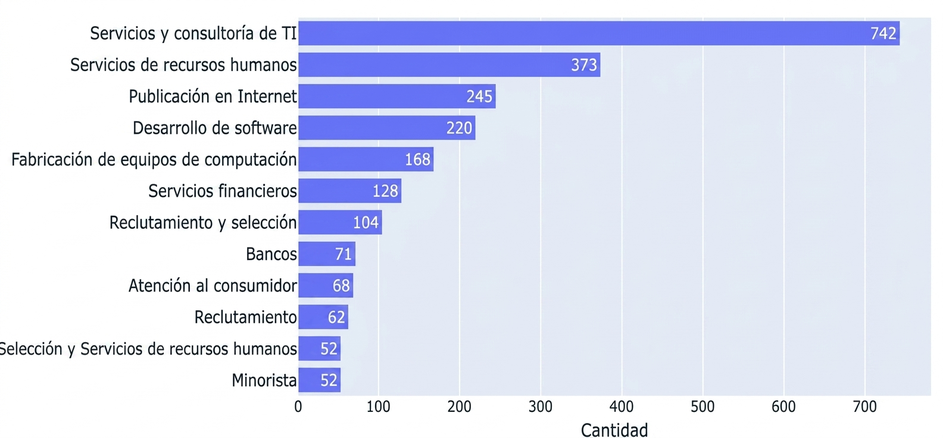
En cuanto a los sectores, los que presentaron mayor número de vacantes abiertas fueron el sector de servicios y consultoría de TI y las empresas de recursos humanos (Figura 7). Estos datos evidencian el crecimiento que las consultorías de TI vienen presentando en los últimos años. Además, también destaca el papel de las empresas de recursos humanos, que son contratadas por compañías de diversos segmentos para buscar profesionales cualificados en el mercado.
Fuente: Resultados originales de la investigación
En cuanto al tipo de trabajo y función, estos no generaron información relevante para el análisis. Sin embargo, al analizar las categorías creadas, los resultados observados correspondieron a lo esperado y las categorías de “Programación y Base de Datos” fueron las más buscadas, con al menos una de las habilidades listadas en ellas presente en más del 65% de las vacantes. Las categorías “Cloud”, “Dashboards e Informes”, “Habilidades conductuales” y “Big Data” también tuvieron una presencia significativa, con valores cercanos al 50% (Tabla 2).
| Categoría | Cantidad | En porcentaje (%) |
| Programación | 1785 | 71.46 |
| Base de datos | 1669 | 66.81 |
| Nube | 1259 | 50.40 |
| Conductual | 1235 | 49.44 |
| Cuadros de mando e Informes | 1198 | 47,96 |
| Big Data | 694 | 27.78 |
| Estadística | 579 | 23.18 |
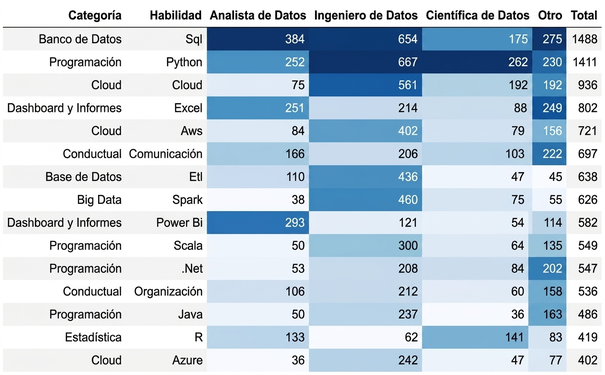
Observando la distribución de habilidades individualmente, se observa que las cinco más buscadas fueron: SQL, Python, Cloud, Excel y AWS (Tabla 3). Se pudo notar que SQL y Python tuvieron una presencia significativa para todas las funciones, pero sus posiciones variaron de acuerdo con cada función. Se percibió que analista de datos fue la única en la que Python no apareció en primer lugar, quedando detrás de SQL y Power BI; mientras que para ingeniero y científico de datos, Python lideró y SQL apareció en la secuencia. Otro punto a destacar es que las habilidades Cloud, AWS, ETL, Spark, Scala, Java y Azure estuvieron más presentes para la función ingeniero de datos, Power BI para el analista de datos y R para científico y analista de datos. Curiosamente, comunicación y organización, dos competencias conductuales, estuvieron entre las 15 competencias más buscadas, sugiriendo que las empresas buscan profesionales que, además del conocimiento técnico, logren comunicarse bien y sean organizados.
Fuente: Resultados originales de la investigación
A continuación, buscando comprender la ocurrencia de más competencias específicas de cada cargo, se calculó la representatividad de cada habilidad dentro de cada posición, y para ello, fueron necesarios pesos diferentes, pues la cantidad de vacantes retornadas en las encuestas fue diferente para cada posición.
En la posición de analista de datos, Power BI se destacó en relación a las demás, con 61,95% contra 16,64%, 19,65% y 1,75% en las posiciones de ingeniero, científico y otros, respectivamente (Tabla 4). Otras dos herramientas de visualización de datos que también aparecieron fueron Tableau y Qlik.
| Habilidad | Analista_% | Ingeniero_% | Científico_% | Otro_% |
| power bi | 61.95 | 16.64 | 19.65 | 1.75 |
| tabla | 59.56 | 17.89 | 20.76 | 1.78 |
| qlik | 51.98 | 27.77 | 19.17 | 1.08 |
| html | 51.94 | 12.99 | 27.51 | 7.56 |
| sql server | 49.25 | 35.19 | 13.14 | 2.42 |
En el requisito HBase, el 92,30% de las vacantes se dirigían a ingenieros de datos. Cassandra, ELT, Hive y Data Warehouse también formaron parte de las habilidades más solicitadas para ingenieros de datos, ya que, en general, las habilidades relacionadas con bases de datos y big data tienen mayor peso en las funciones de ingeniero (Tabla 5).
| Habilidad | Analista_% | Ingeniero_% | Científico_% | Otro_% |
| Hbase | 2.76 | 92.30 | 4.74 | 1.197419 |
| Cassandra | 11.73 | 77.80 | 8.08 | 1.064810 |
| Salida | 19.56 | 73.63 | 5.32 | 1.149562 |
| Colmena | 7.74 | 71.46 | 20.43 | 1.335699 |
| Almacén de datos | 15.37 | 69.16 | 14.62 | 1.267120 |
En el caso de los científicos de datos, se observó que las habilidades relacionadas con la estadística y los paquetes de visualización destacaron, con la mayoría de ellas teniendo un delta de aproximadamente 80% en relación con las demás. Cabe destacar, además, que Stata presentó el 95,94% de las oportunidades orientadas a esta posición (Tabla 6).
| Habilidad | Analista_% | Ingeniero_% | Científico_% | Otro_% |
| Stata | 0.00 | 0.00 | 95.94 | 4.06 |
| Plotly | 6.77 | 0.00 | 93.23 | 0.00 |
| Regresión | 7.15 | 1.1 6 | 90.72 | 0.98 |
| Probabilidad | 6.48 | 2.53 | 89.29 | 1.70 |
| Matplotlib | 5.76 | 9.36 | 84.25 | 0.63 |
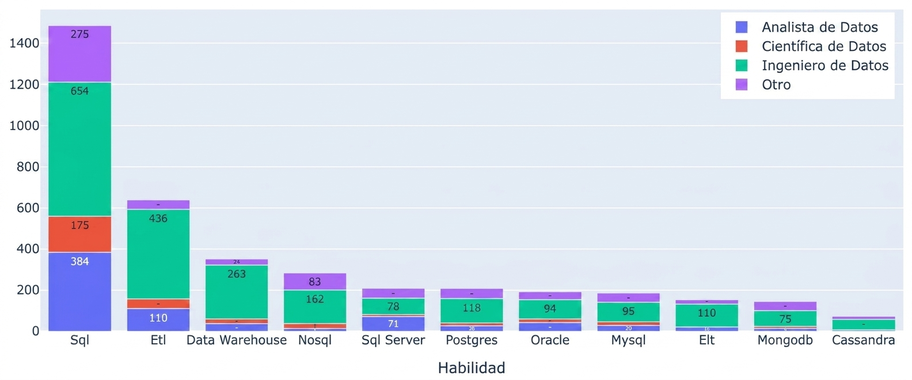
Finalmente, se exploraron las habilidades más buscadas en cada categoría y se observó que, para bases de datos, SQL destacó como la más popular (Figura 8). Del total de 2.498 vacantes de empleo analizadas, 1.488 de ellas presentaban preferencia por un candidato con conocimiento o experiencia con SQL (Figura 8).
Fuente: Resultados originales de la encuesta
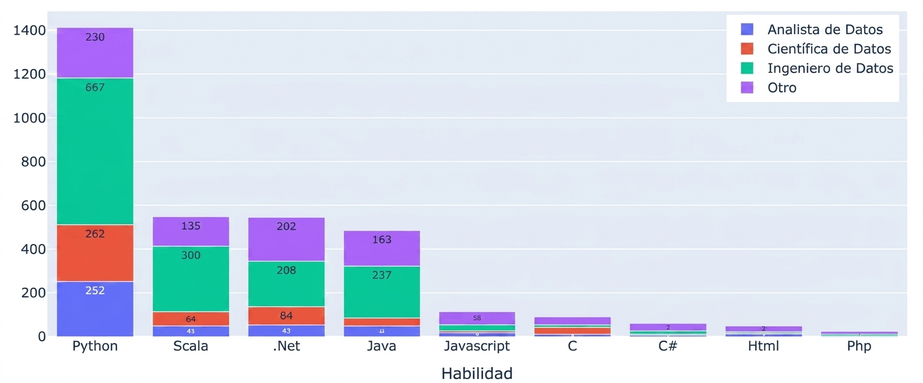
En la categoría de programación, también fue posible observar la predominancia de un lenguaje en relación con los demás. En un total de 1.411 vacantes de programación, el 56,49% citaban Python, un número más de dos veces superior al de Scala (549 vacantes), segunda clasificada (Figura 9). Si R, asignado a la categoría estadística, también fuera considerado para programación, ocuparía la quinta posición (419 vacantes), detrás de Java (486 vacantes).
Fuente: Resultados originales de la investigación
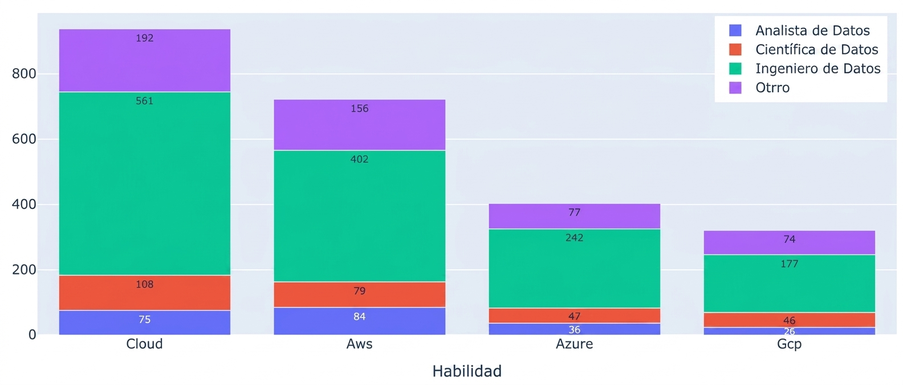
Para la categoría cloud, se optó por analizar también la propia palabra, para verificar si la habilidad también sería citada sin especificación de plataforma. El término cloud apareció 936 veces, seguido por las plataformas AWS (721 veces), Azure (402 veces) y GCP (320), reflejando el market share del mercado brasileño de nube (Figura 10).
Fuente: Resultados originales de la investigación
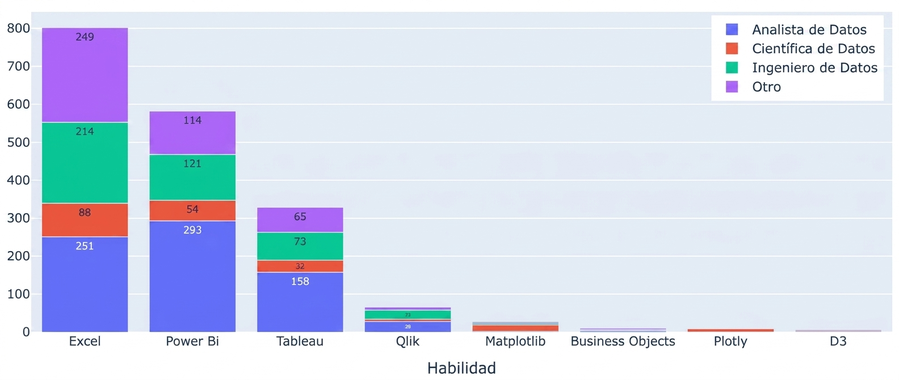
En la categoría de dashboards e informes, los más populares fueron Excel, Power BI y Tableau, y, como ya se esperaba, fueron más numerosas para los puestos de analista de datos. También tuvieron un alto volumen de aparición para los puestos “otro”, probablemente relacionado con los puestos de analista de negocios, función para la cual exigen conocimiento en herramientas de visualización y análisis de datos, principalmente Excel, visto como la puerta de entrada a esta área (Figura 11).
Fuente: Resultados originales de la encuesta
En la categoría de big data, se observó un destaque de Spark, Hadoop y Hive como las habilidades más buscadas. Es importante observar que estas son, de lejos, las más solicitadas para ingenieros de datos (Figura 12).
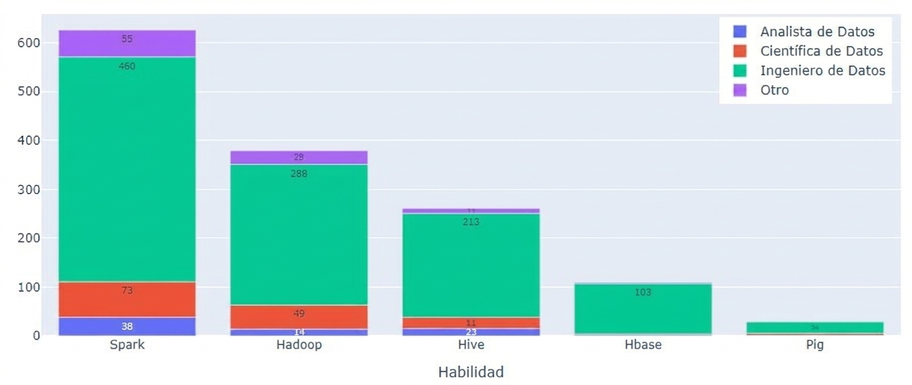
Fuente: Resultados originales de la investigación
En la categoría estadística, también se analizó la estadística como habilidad. Estuvo entre las cuatro habilidades más populares para la categoría, con un 5,5 %, junto con R, que lideró con un 16,77%. Pandas (6%) y SAS (5%) quedaron en segundo y cuarto lugar, respectivamente (Figura 13). En esta categoría se pudo percibir que los niveles de valores para científicos de datos fueron mayores o iguales en relación con las demás — lo que no sucedió en otras categorías, corroborando la importancia de la estadística para estos cargos.
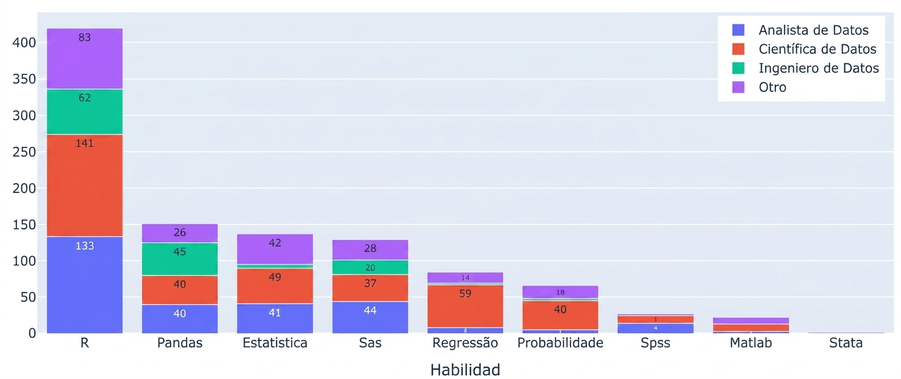
Fuente: Resultados originales de la investigación
Por último, entre las habilidades conductuales, comunicación y organización destacaron como las más predominantes (Figura 14).
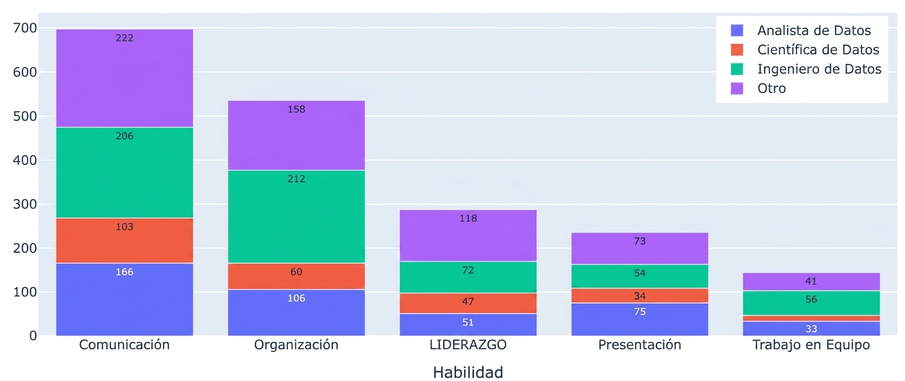
Fuente: Resultados originales de la investigación
Asociación entre las habilidades
Para analizar la asociación entre las habilidades, se consideraron las veinte principales, y fue posible identificar correlaciones positivas fuertes entre algunas de ellas. La mayor de estas asociaciones se observó entre Hadoop y Spark, tecnologías diferentes, pero consideradas estructurales para la categoría big data. En la misma línea, Spark y Python también tuvieron fuertes relaciones, demostrando que Python es ampliamente requerido en conjunto con Spark. Power BI y Tableau tuvieron una asociación destacada y, al ser herramientas análogas, se generó la hipótesis de que las empresas son flexibles en cuanto a qué herramienta de BI necesita tener el candidato, lo que lleva a la conclusión de que se solicitan por separado, no en conjunto. La asociación entre Python y SQL reafirmó la importancia de dominar ambas habilidades en el actual mercado de datos. Las altas correlaciones entre cloud y plataformas cloud, como GCP, no difirieron de lo esperado y, por lo tanto, no se consideraron como fuentes de insight. Las demás asociaciones se mostraron moderadas o débiles (Figura 15).
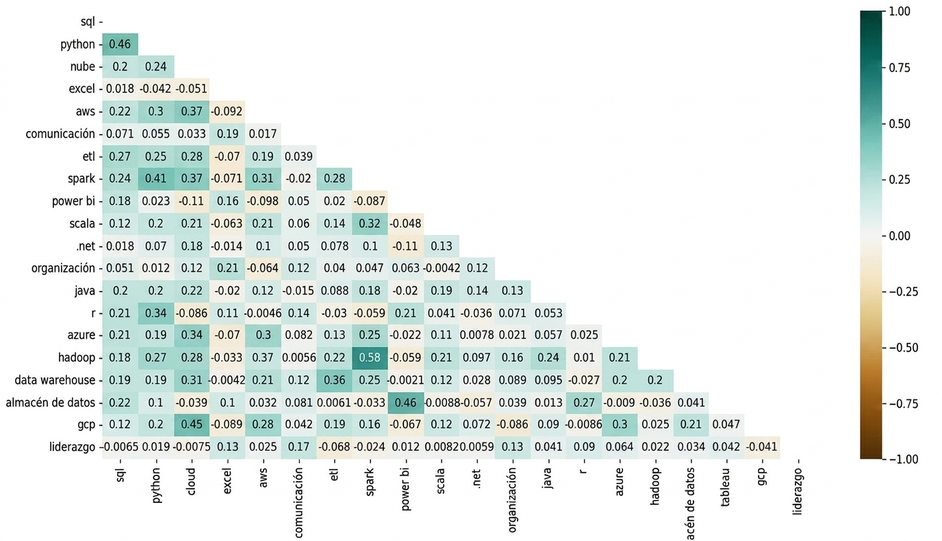
Fuente: Resultados originales de la investigación
Minería de texto
Para no limitarse a analizar solamente las habilidades preseleccionadas, también se realizó el proceso de minería de texto para buscar información desconocida que pudiera ser útil dentro de las publicaciones. Para ello se utilizó la biblioteca Tidytext para buscar los n-gramas, es decir, la ocurrencia de secuencias de palabras en los campos textuales título y descripción. Los tratamientos realizados fueron: poner todas las palabras en minúscula; remover puntuaciones, caracteres especiales y “stopwords”, en inglés y portugués — palabras comunes a los idiomas, pero que no agregaban al análisis, como, por ejemplo artículos y preposiciones (o, a, em, no).
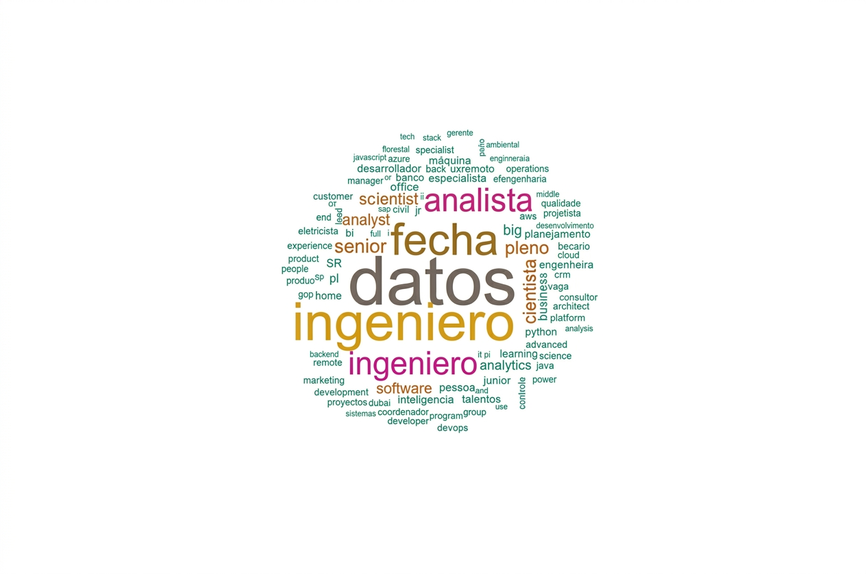
Los unigramas de los títulos de las vacantes, que son las principales palabras individuales encontradas, se representaron visualmente en una nube de palabras (Figura 16) para dar mayor énfasis a las palabras que aparecen con más frecuencia. En general, las palabras “datos”, “ingeniero”, “analista”, “científico”, y sus variaciones en inglés, fueron las que tuvieron mayor destaque. La gran ocurrencia de términos en lengua inglesa muestra la importancia de también realizar la búsqueda de vacantes a partir del uso de palabras clave en ese idioma.
Fuente: Resultados originales de la investigación
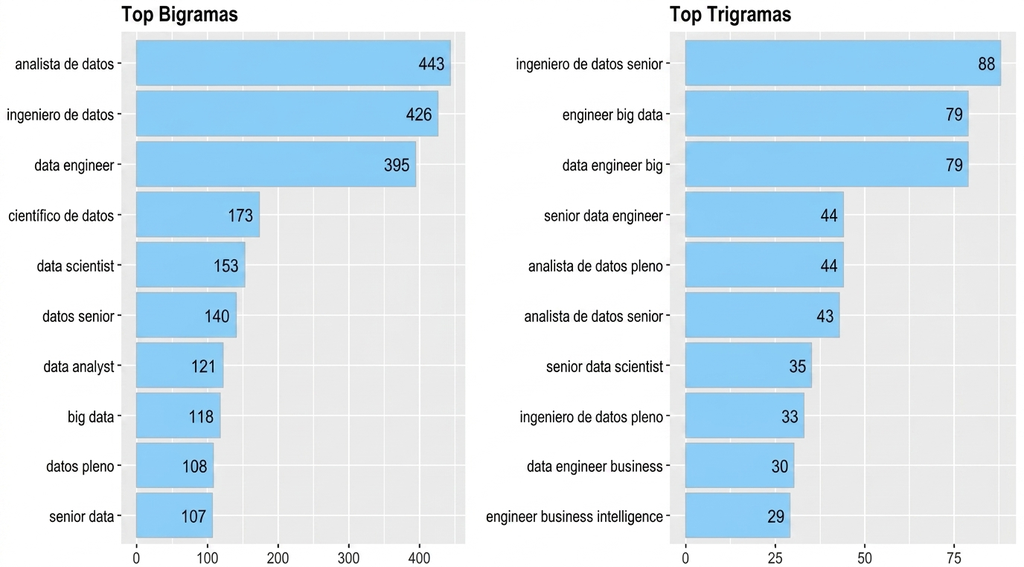
Los bigramas y trigramas mostraron cuáles fueron las combinaciones de dos y tres palabras más frecuentes en el texto (Figura 17). La mayoría de las combinaciones en los títulos de las vacantes correspondieron a los cargos que tuvieron mayor enfoque en este trabajo: analistas, científicos e ingenieros de datos y sus respectivos niveles — con excepción de big data y
business intelligence, que son variaciones de las nomenclaturas de los cargos de datos y también se mostraron relevantes.
Fuente: Resultados originales de la investigación
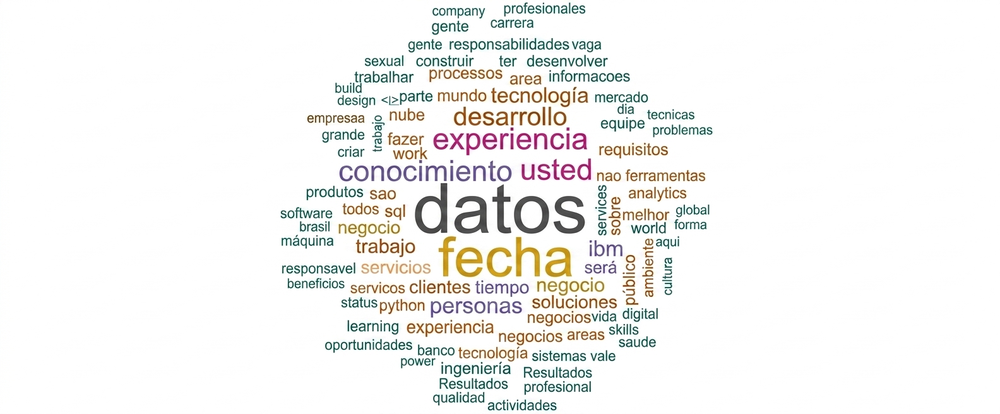
En la nube de palabras correspondiente a la descripción de las vacantes (Figura 18), destacaron Python y SQL, habilidades que fueron identificadas en este trabajo como las más solicitadas en el área de datos. La gran ocurrencia de los términos “equipo”, “negocio”, “personas”, “clientes”, “requisitos”, “procesos” y “proyectos” destaca la importancia de que los profesionales del área de datos también desarrollen habilidades en procesos y proyectos, así como habilidades interpersonales para la relación con personas, equipos y clientes.
Fuente: Resultados originales de la investigación
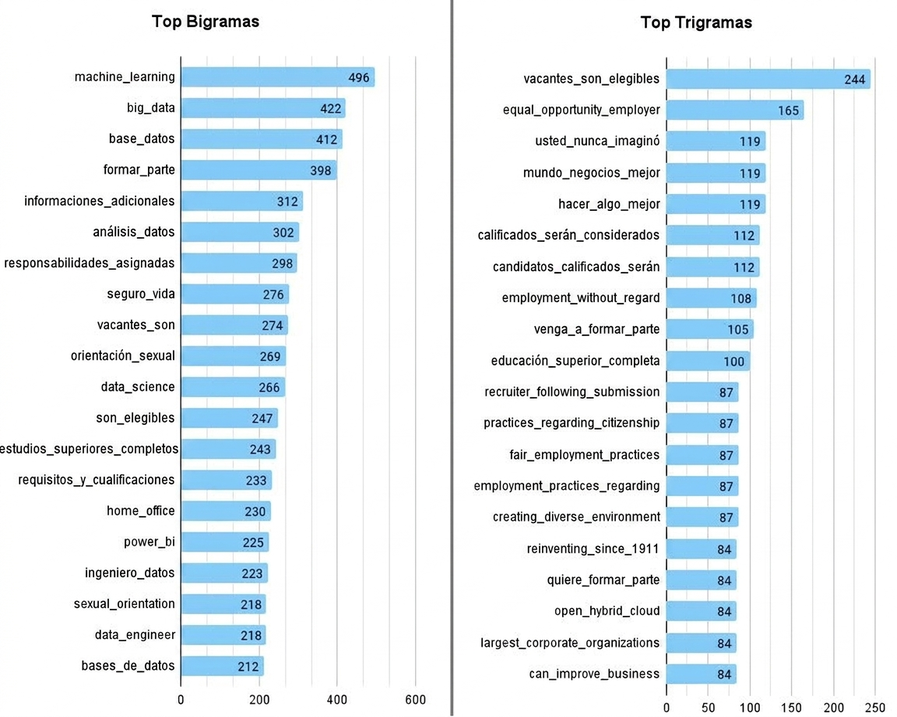
Para el análisis de cada posición por separado, se utilizó únicamente el campo descripción, ya que este generó información más relevante (Figura 19).
Fuente: Resultados originales de la investigación
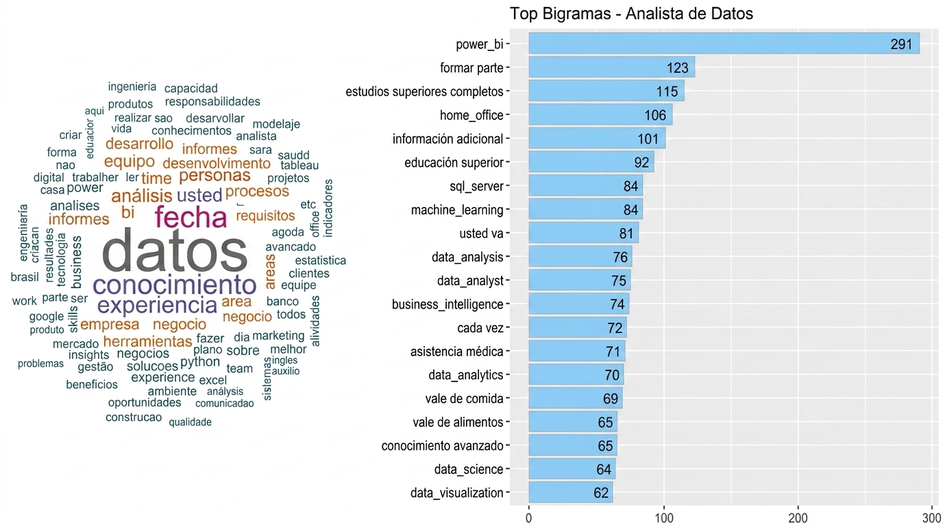
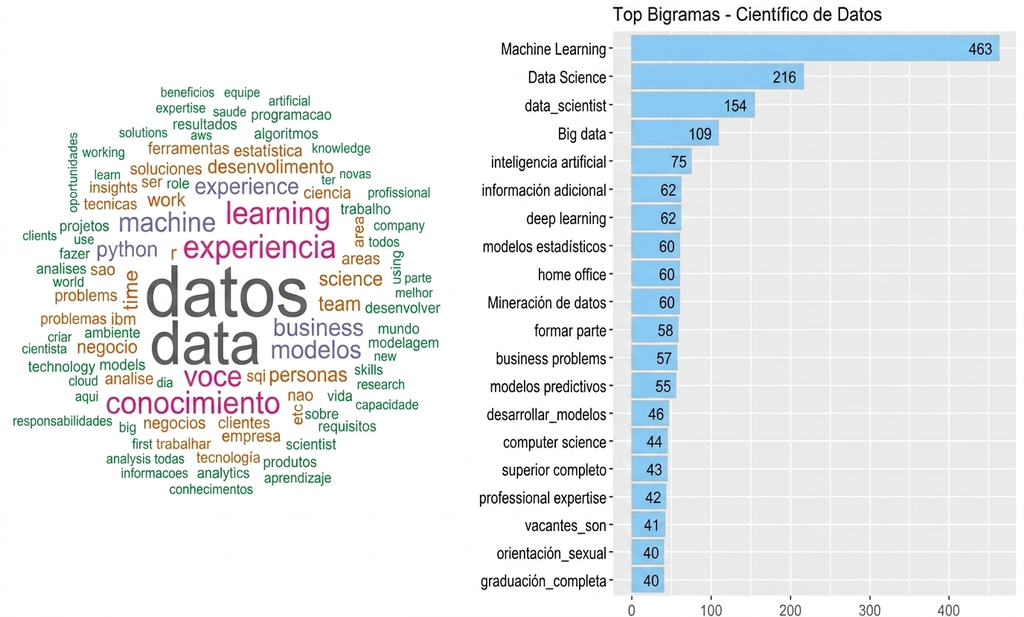
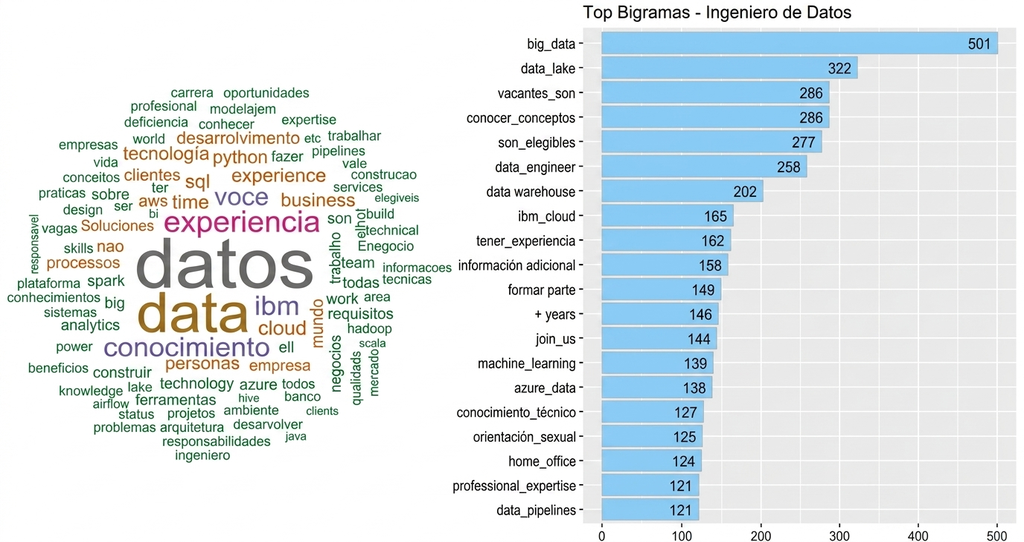
Se consideró oportuno generar también un análisis de los n-gramas de las descripciones de las vacantes para cada posición por separado. Los trigramas no arrojaron información interesante y, por este motivo, no fueron considerados.
Para las vacantes de analistas de datos, quedaron en evidencia las habilidades técnicas de análisis y visualización, como Power BI, dashboards, SQL; datos que corroboraron los hallazgos anteriormente descritos en este estudio (Figura 20).
Fuente: Resultados originales de la investigación
En cuanto a las oportunidades para científicos de datos, los términos destacados fueron: “Machine learning”, “data science”, “big data”, “inteligencia artificial”, “deep learning”, “modelos estadísticos” y “modelos predictivos” (Figura 21).
Fuente: Resultados originales de la investigación
En las vacantes destinadas a ingenieros de datos, los términos destacados fueron: “big data”, “data lake”, “data warehouse”, “data pipeline” y términos relacionados con “cloud” (Figura 22).
Fuente: Resultados originales de la investigación
La gestión personal en las organizaciones es una tarea compleja, influenciada por diversos factores internos, como cultura, estrategia y tecnología, dado que las empresas se configuran como sistemas interdependientes, en los cuales las personas desempeñan un papel central. Utilizando datos de vacantes en LinkedIn, fue posible identificar las principales habilidades técnicas específicas, además de competencias conductuales que son cruciales en todas las funciones del área de TI. Habilidades como Python y SQL se destacaron como esenciales para cualquier carrera en el área, información que puede ayudar a profesionales y estudiantes a prepararse para el mercado laboral.
Sin embargo, se observó que todavía hay una falta de definición clara sobre cargos y atribuciones, un factor importante para definir funciones, ayudar a los colaboradores a comprender su papel dentro de la empresa y orientar a los candidatos en la adquisición de competencias demandadas. El principal objetivo de este estudio fue ofrecer insights iniciales sobre el tema y, a partir de ello, proponer la posibilidad de investigaciones futuras para explorar tendencias de mercado y perfiles profesionales en el área de TI, por ser este un escenario en constante evolución.
Referencias
[1] LinkedIn. 2020. Emerging Jobs Report Brazil. Disponível em: https://business.linkedin.com/content/dam/me/business/en-us/talent-solutions/emerging-jobs-report/Emerging_Jobs_Report_Brazil.pdf. Acesso em: 10 mar. 2022.
[2] Fayyad, U.; Hamutcu, H. 2020. Toward Foundations for Data Science and Analytics: A Knowledge Framework for Professional Standards. Harvard Data Science Review, 2(2).
[3] Persaud, A. 2021. Key competencies for big data analytics professions: a multimethod study. Information Technology & People 34(1). 178-203. https://doi.org/10.1108/ITP-06-2019-0290.
[4] Dubey, R.; Gunasekaran, A. 2015. Education and training for successful career in big data and business analytics. Industrial and Commercial Training 47(4), 174–181. https://doi.org/10.1108/ICT-08-2014-0059.
[5] Verma, A.; Yurov, K.; Lane, P.; Yurova, Y. 2019. An investigation of skill requirements for business and data analytics positions: A content analysis of job advertisements. Journal of Education for Business 94. 1-8. https://doi.org/10.1080/08832323.2018.1520685.
[6] Pellaes, A. 2021. A adoção de ferramentas de atração e recrutamento online pelas organizações no Brasil: um estudo sobre motivações e impactos. Brazilian Journal of Business 3(4), 3192–3207. https://doi.org/10.34140/bjbv3n4-027
[7] Zhao, B. 2017. Web Scraping. In: Schintler, L., McNeely, C. (eds) Encyclopedia of Big Data. Springer, Cham. https://doi.org/10.1007/978-3-319-32001-4_483-1
[8] Reis, E.A.; Reis, I.A. 2002. Análise Descritiva de Dados. Relatório Técnico do Departamento de Estatística da UFMG.
[9] Chicco, D.; Jurman, G. 2020. The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics. 21(6). https://doi.org/10.1186/s12864-019-6413-7
Cómo citar
Scalioni D.L.; Sátiro R.M.; Las habilidades en análisis de datos más demandadas en el mercado laboral. Revista E&S. 2025; 6: e20240033.
Sobre los autores
Déborah Lima Scalioni – Especialista en Data Science y Analítica. Rua Antônio Jordão, 443, Residencial Jardim Califórnia, CEP: 13857-000, Estiva Gerbi, SP, Brasil
Renato Máximo Sátiro – Universidade Federal de Goiás – UFG. Doctor en el Programa de Posgrado en Administración. Avenida Esperança s/n, Câmpus Samambaia – Edificio de la Rectoría. 74690-900 Goiânia, GO, Brasil.